5.1万

ClickHouse は、ログやインフラストラクチャのメトリクスから、売上や顧客アクティビティまで、時系列データの保存先として広く利用されています。私たち自身の社内ロギングプラットフォームである LogHouse には、1,000 兆行を超える時系列データが保存されています。こうしたデータにおいて、将来の値の予測や通常とは異なる観測値の検出はよく行われるタスクですが、サービスや顧客、製品ごとに ARIMA のような古典的な時系列モデルを個別に学習・維持することは、系列数が増えるにつれて難しくなります。
時系列基盤モデル (TSFM: Time-series foundation models) は、こうした系列ごとの学習要件を不要にします。多数の系列で事前学習されているため、新しい系列の履歴からゼロショット予測を生成でき、その予測を使って期待値から外れた観測値にフラグを立てることも可能です。これは、ClickHouse のリアルタイム分析やデータウェアハウスのワークロードと非常に相性が良いアプローチです。各系列を構築するために必要な集計、タイムバケット化、フィルタリングは、すでに SQL で処理されているためです。
本記事では、実行可能ユーザー定義関数 (executable UDF) を介して TimesFM 3.0 を ClickHouse に接続します。具体例として、M5 データセットに記録された小売売上データを使用し、日次需要の予測と過去の異常な観測値の特定を行います。
セットアップ
本記事と連動する clickhouse-timeseries-ai リポジトリには、TimesFM モデルサーバー、ClickHouse の実行可能 UDF 定義、および Docker Compose 設定が含まれています。初回のビルドとモデルのダウンロードには、Git、Compose v2 対応の Docker、およびインターネット接続が必要です。目安として、約 8 GB の空きメモリと数 GB のディスク容量を確保してください (これは実測した最小要件ではありません)。GPU は不要です。
リポジトリをクローンしてデモを起動します:
git clone https://github.com/ClickHouse/clickhouse-timeseries-ai.git
cd clickhouse-timeseries-ai
docker compose up --build -d --wait --wait-timeout 1200これにより ClickHouse とモデルサーバーが起動し、固定されたチェックポイントがダウンロードされ、関数が登録されます。デフォルト設定では CPU 推論を使用し、次回以降の起動のために重みをキャッシュします。
TimesFM の推論は ClickHouse プロセスの外部で実行されます。Python の実行可能 UDF が数値配列を受け取り、HTTP 経由でモデルサービスに送信し、レスポンスを ClickHouse の配列とタプルに変換します。このサービスは 2 つのエンドポイントを公開しています:
/v1/timeseries/forecast
/v1/timeseries/anomalies予測処理は実質的に timesfm3.TimesFM3Evaluator.predict_batch をラップしたものです。以下の例では、学習やファインチューニングは一切行っていません。
ダウンロードされる TimesFM 3.0 の重みには、非商用・非本番利用の制限があります。ローカルでの評価を超えてこの構成を使用する前に、適用されるモデルの利用規約を確認してください。これらの関数はデモの一部であり、ClickHouse 組み込みの AI 関数では (まだ!) ありません。
SQL インターフェース
これらの関数は時系列全体に対して動作します:
aiForecast(values, horizon)
aiForecastMultivariate(targets, horizon, past_covariates, future_covariates)
aiDetectAnomalies(values, options_json)values は Array(Float64) です。入力はリテラル配列や保存済みの配列カラムである必要はなく、CTE、サブクエリ、結合 (JOIN)、または集計クエリの結果から構築された SQL 式を指定できます。たとえば、クエリ内でイベントをフィルタリングして日次合計に集計し、その合計を時系列順の配列にまとめてそのまま aiForecast に渡すことができます。関数が受け取るのはテーブル名やクエリ文字列ではなく、結果として得られた配列です。
予測結果は、将来の各ステップにつき 1 つの名前付きタプル (expected, lower_bound, upper_bound, quantiles) を要素とする配列を返します。expected は中央値であり、下限と上限はそれぞれ q10 と q90 で、公称 80% の予測区間を形成します。quantiles には、q10 から q90 までの TimesFM ネイティブの 9 つの分位点がすべて (level, value) のペアとして格納されます。すべての値は同一のモデル呼び出しから得られます。
SQL ヘルパーの aiForecastQuantile(prediction, 0.8) は、たとえば在庫計画で高めの需要予測値を使用したい場合などに、予測ステップから q80 を選択します。aiForecastInterval(prediction, 0.6) は、公称 60% 区間に対応する q20〜q80 の上下限を返します。これらのヘルパーは返されたタプルから値を選択するだけであり、モデルを呼び出すことはありません。このチェックポイントからの 95% 区間など、サポートされていない分位点や区間を指定した場合は、出力範囲外を外挿するのではなくエラーを送出します。
多変量入力は Array(Array(Float64)) であり、予測対象の系列 (ターゲット系列) や追加の入力特徴量ごとに 1 つの内部配列を持ちます。ターゲット系列とは日次売上などの予測したい値の並びであり、入力特徴量はプロモーションスケジュールやイベント日フラグなどのコンテキストを提供します。過去の各チャネルは時間軸で揃えられます。既知の将来共変量 (known-future covariates) は予測ホライズンもカバーしている必要があります。結果にはターゲットごとに 1 つの予測配列が含まれます。これにより、たとえば関連する複数の需要系列とプロモーションカレンダーを一緒に表現できます。
aiDetectAnomalies は options_json 内でオプションの past_covariates 配列と future_covariates 配列を受け付け、特徴量ごとに 1 つの内部配列を持ちます。すべての入力は同じ観測日をカバーします。サービスは各スコアリングウィンドウの末尾まで既知の将来チャネルを供給しますが、ターゲット値は各予測起点までしか供給しません。出力は入力と位置が揃った 1 つの配列のままです。言葉だけでは少しイメージしにくいかもしれませんが、後述の日次売上予測のセクションに完全な例があります。そこでは既知の将来イベント (この例ではクリスマスの祝日) を示す [0,0,0…1,0…] のような future_covariates を使用します。
モデルが受け取るのは順序付けられた数値であり、タイムスタンプやテーブル名ではありません。集計とサンプリング間隔の決定、欠損期間の処理、および各系列の順序付けは SQL 側で行います。したがって、ホライズンの 28 は、日次入力であれば 28 日、時間単位の入力であれば 28 時間を意味します。UDF もモデルも、元テーブルから時間グリッドを推論することはありません。
日次売上の予測
M5 には、Walmart の 10 店舗で販売された商品の 5 年間 (2011-01-29 から 2016-04-24 まで) にわたる日次販売数が含まれています。M5 がモデルの学習データに含まれている可能性はありますが、ここでの目的は時系列モデルの使い方を示すことであり、精度を証明することではありません。この例では、m5.store_daily にデータセット内の商品の日次合計が格納されており、store_id、day、units の各カラムがあります:
store_id | date | units | |
|---|---|---|---|
1 | WI_1 | 2016-04-24 | 4874 |
2 | CA_1 | 2016-04-24 | 6113 |
3 | CA_2 | 2016-04-24 | 6082 |
7 | TX_1 | 2016-04-24 | 4033 |
次のクエリは、2016年3月27日までの 730 日分の観測値を使用して、各店舗の今後 28 日間を予測します:
SELECT
store_id,
aiForecast(
arrayMap(p -> p.2, arraySort(p -> p.1, groupArray((day, units)))),
toUInt32(28)
) AS forecast
FROM m5.store_daily
WHERE day >= toDate('2014-03-29') AND day < toDate('2016-03-28')
GROUP BY store_id
ORDER BY store_id
SETTINGS max_threads = 1;groupArray が各店舗の観測値を収集します。arrayMap で値を抽出する前に (day, units) タプルをソートすることで、順序を明示的に保証しています。店舗ごとに 1 回のモデルリクエストが生成され、3月28日から 4月24日に相当する 28 個の予測タプルが返されます。このデモのモデルサーバーは同時に 1 つのアクティブな推論リクエストしか受け付けないため、max_threads = 1 でクエリの並列度を制限しています。
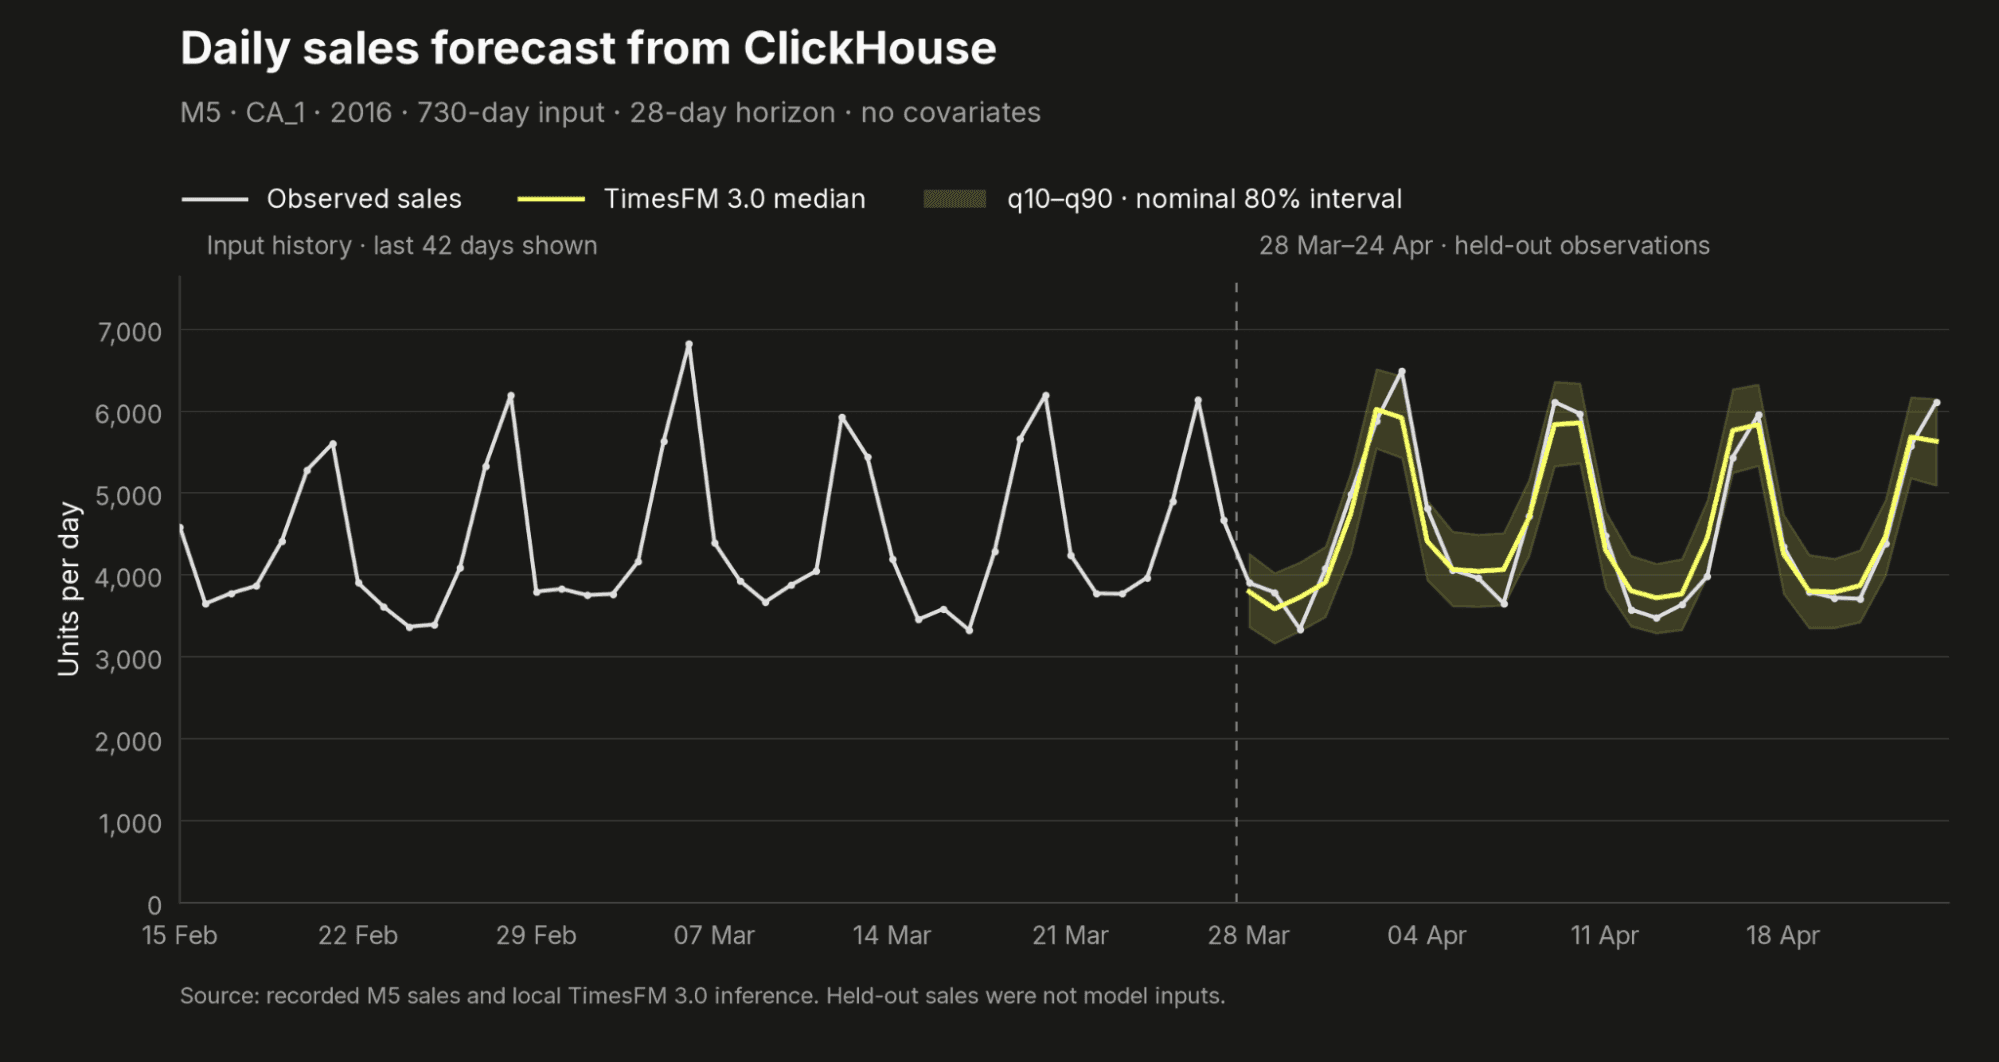
このプロットは、CA_1 における入力履歴の最後の 42 日間と、それに続く 28 日間の予測を示しています。白い線にはホールドアウト期間の実測売上も含まれていますが、これらの観測値はモデルには与えられていません。網掛けの帯はネイティブの q10〜q90 区間であり、公称カバレッジは 80% です。
返された配列は ARRAY JOIN で展開し、将来の日付と紐付けることができます。展開してしまえば、予測値は通常のクエリ結果と同じです。商品や店舗のディメンションと結合したり、後から観測された実績売上と比較したり、下流のクエリ用にテーブルへ保存したりできます。事前準備された日次テーブルではなく、トランザクションデータやイベントデータから集計した系列に対しても、同じクエリ構造をそのまま適用できます。
保存済みの予測配列に対しては、arrayMap(p -> aiForecastQuantile(p, 0.8), forecast) とすることで将来の各ステップの q80 を選択できます。別の分位点を選択するために予測をやり直す必要はなく、それによって中央値や他の分位点が変わることもありません。
異常検知
予測は、すでに到着した観測値と比較するための期待値としても利用できます。aiDetectAnomalies はこのアプローチを過去データに適用します。より前の観測値からホールドアウトウィンドウを予測し、予測値と実際の値を比較してから次のウィンドウへと進みます。各観測値は、そのウィンドウのスコアリングが完了した後に初めてコンテキストとして使われます。
次のクエリは、各店舗の入力の最後の 180 日間を 7 日間のウィンドウ単位でスコアリングします。score_last_n は末尾の何件の観測値にスコアを付与するかを選択するものであり、モデルが参照できる履歴の長さを制限するものではありません。結果は元の系列と位置が揃っているため、arrayZip を使って日付や実測販売数と結合できます:
SELECT
store_id,
point.1 AS day,
point.2 AS observed,
point.3.expected AS expected,
point.3.anomaly_score AS anomaly_score
FROM
(
SELECT
store_id,
arrayJoin(arrayZip(
arrayMap(p -> p.1, points),
arrayMap(p -> p.2, points),
aiDetectAnomalies(
arrayMap(p -> p.2, points),
'{"score_last_n":180,"horizon":7,"threshold":3}'
)
)) AS point
FROM
(
SELECT
store_id,
arraySort(p -> p.1, groupArray((day, units))) AS points
FROM m5.store_daily
WHERE day >= toDate('2013-10-28')
GROUP BY store_id
)
)
WHERE point.3.is_anomaly = 1
ORDER BY anomaly_score DESC
LIMIT 10
SETTINGS max_threads = 1;この関数は、各入力観測値に対して (expected, lower_bound, upper_bound, anomaly_score, is_anomaly) を返します。スコアリング対象外のコンテキスト位置では、予測値とスコアは null になります。スコアは予測誤差の絶対値を、中央値から誤差が生じた側の区間境界までの距離で割った値 (数値的な下限値あり) です。これは確率ではありません。threshold=3 は信頼水準を指定するのではなく、3 を超えるスコアをフィルタリングします。
異常スコアは常に q10 と q90 を基準境界として使用します。別のクエリで異なる予測分位点や予測区間を選択しても、この基準やスコア、異常のしきい値は変わりません。
M5 から返された行の一部を以下に示します (スコアが高いほど異常度が高いデータを示します):
| Store | Date | Observed units | Expected median | Anomaly score |
|---|---|---|---|---|
| TX_2 | 2015-12-25 | 0 | 3,520 | 8.65 |
| WI_3 | 2015-12-25 | 1 | 3,074 | 8.37 |
| CA_2 | 2016-03-19 | 2,779 | 6,021 | 7.82 |
| CA_2 | 2016-03-20 | 2,300 | 5,827 | 7.79 |
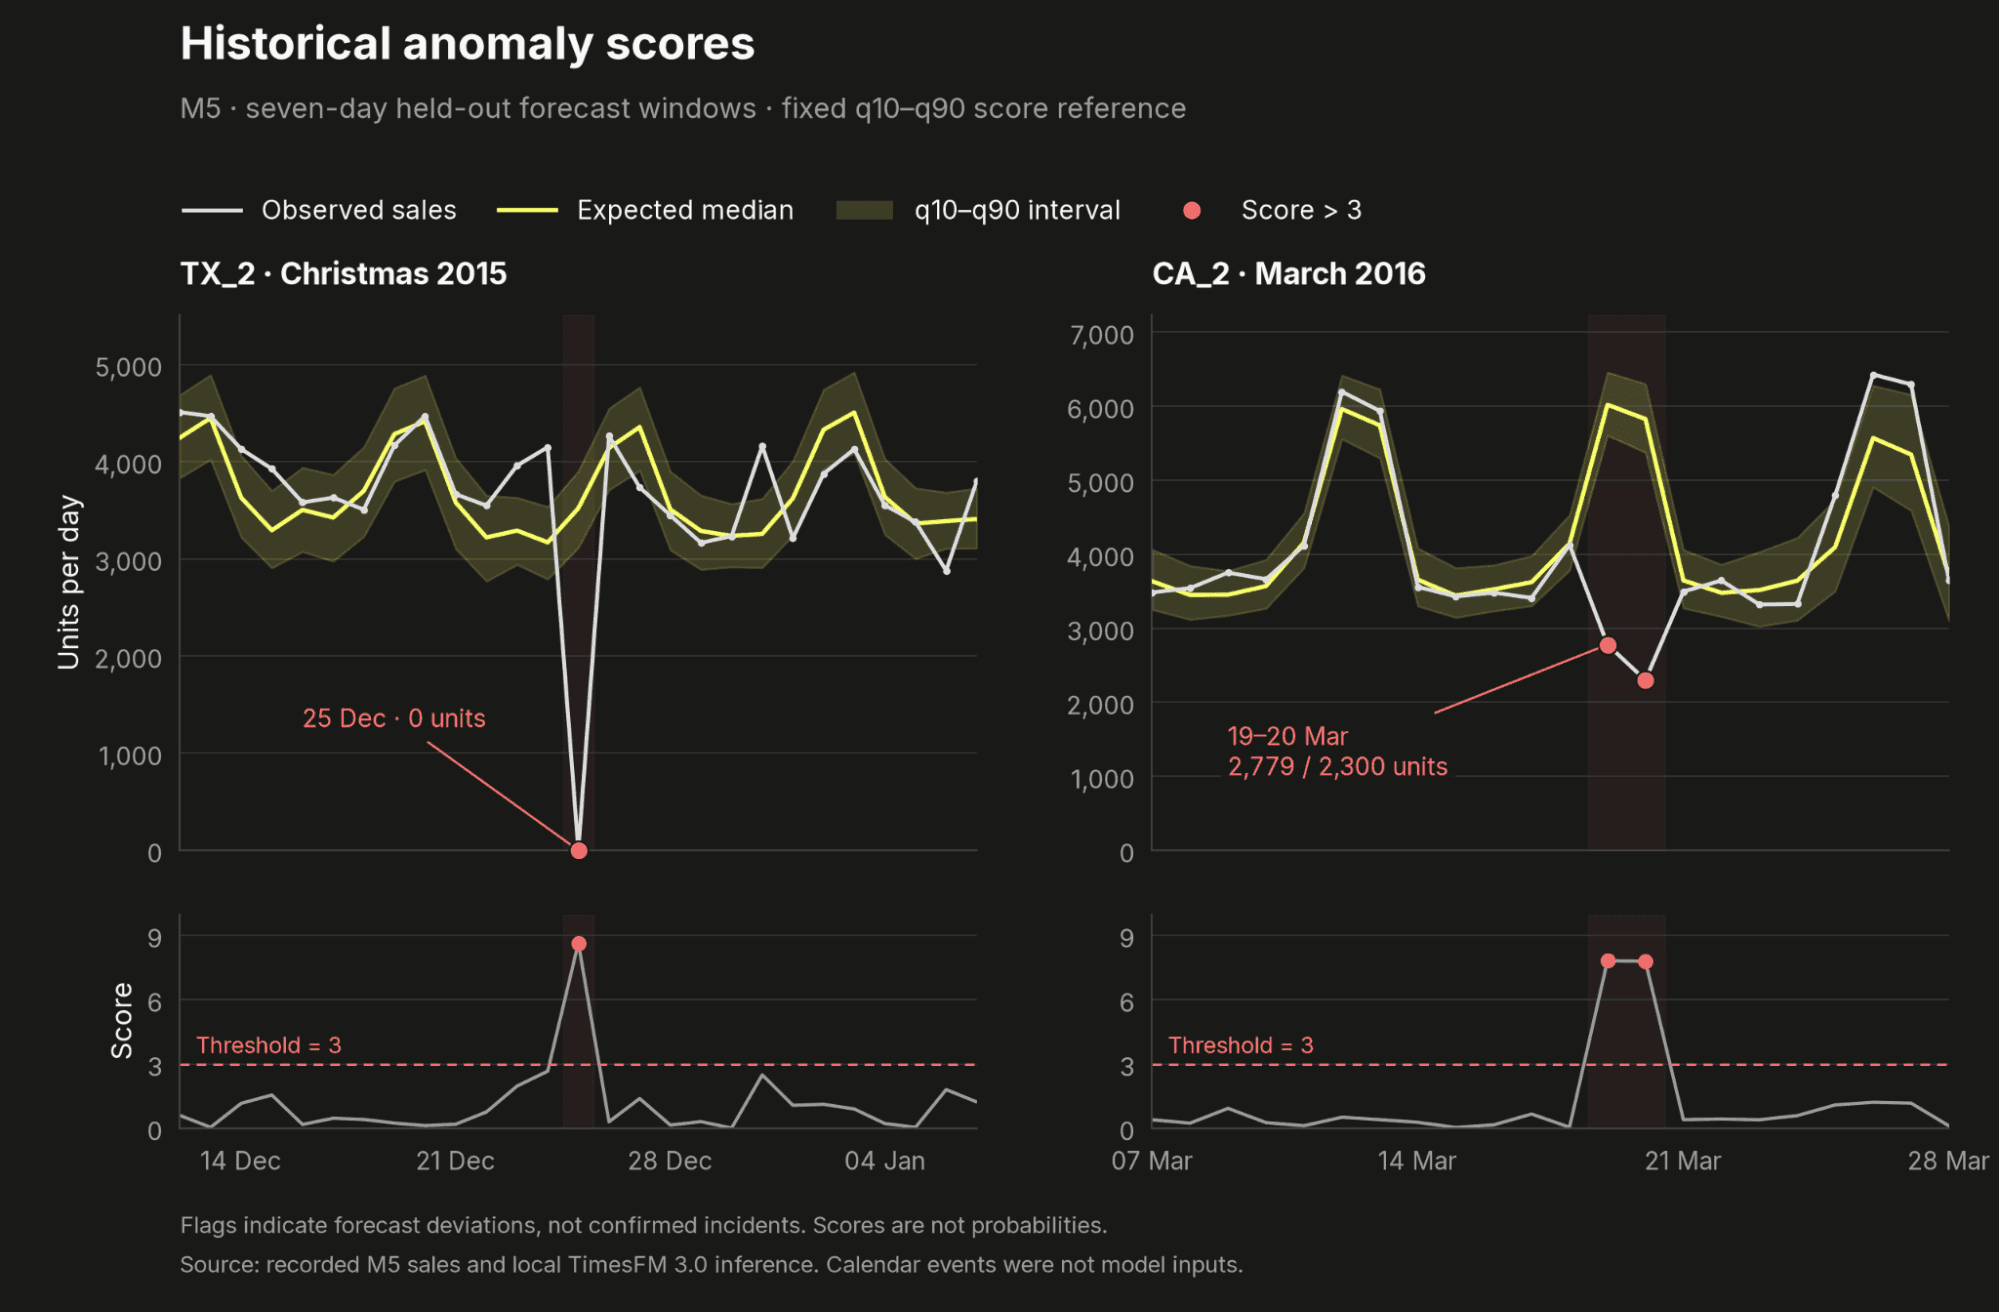
上段のパネルは観測値と直前の履歴からの予測値を比較しています。下段のパネルは対応する正規化誤差としきい値の 3 を示しています。ハイライトされている観測値は M5 の実際の値であり、人為的に注入したイベントではありません。
クリスマス当日は、各店舗で記録された売上が極めて低くなっています。履歴のみに基づく予測には祝日スケジュールが与えられていません。CA_2 の 3 月の観測値も予測を大きく下回っていますが、カレンダー上ではその日付にイベントは記録されていません。SQL を使えば、フラグが立った行を他のレコードと結合して変化の要因を調査できます。モデルのスコアだけでは、それが欠品なのか、休業なのか、あるいはデータの問題なのかまでは特定できません。M5 には異常の正解ラベル (グラウンドトゥルース) がないため、これらの行は検出精度ではなくスコアリングのワークフローを示すものです。
既知の将来イベントの供給
既知の将来特徴量 (known-future features) を使うと、祝日、計画休業、プロモーション、メンテナンスウィンドウといった予定されているイベントを記述できます。is_event_day フラグは、履歴と予測ウィンドウの両方で選択したイベントの日付をマークします。モデルが受け取るのは位置が揃えられた数値であり、イベント名ではありません。UDF 内に特別な祝日ロジックがあるわけでもありません。イベントの種類によって影響が異なる場合は、すべての祝日やイベントを 1 つのフラグにまとめるのではなく、個別の特徴量チャネルを使用すべきです。
定量的な検証例として、2015年12月23日〜29日の 7 日間のスコアリングウィンドウを、クリスマスのイベントフラグあり・なしの両方で全 10 店舗に対して再実行します。どちらの実行でも、直前の 786 日分の同じ日次観測値、モデルチェックポイント、q10〜q90 のスコア基準、およびしきい値の 3 を使用します。追加された入力はイベント日フラグのみです。
再現スクリプトは M5 の calendar.csv から m5.event_calendar を日付ごとに 1 行でロードします。この実験では、いずれかのイベント名フィールドが Christmas の場合に is_event_day=1、それ以外は 0 とします。カレンダーを売上データに結合することで、選択したイベントと各観測値の位置を揃えます:
WITH ordered_store_history AS (
SELECT
s.store_id AS store_id,
arraySort(p -> p.1,
groupArray((s.day, s.units, c.is_event_day))
) AS points
FROM m5.store_daily AS s
INNER JOIN m5.event_calendar AS c ON s.day = c.day
WHERE s.day >= toDate('2013-10-28')
AND s.day < toDate('2015-12-30')
GROUP BY s.store_id
),
store_series AS (
SELECT
store_id,
arrayMap(p -> p.1, points) AS days,
arrayMap(p -> p.2, points) AS observed_units,
arrayMap(p -> toFloat64(p.3), points) AS event_flags
FROM ordered_store_history
),
scoring_requests AS (
SELECT
store_id,
days,
observed_units,
arrayJoin([0, 1]) AS with_calendar,
toJSONString(CAST(
(7, 7, 3, if(with_calendar = 1,
[event_flags], CAST([], 'Array(Array(Float64))'))),
'Tuple(score_last_n UInt32, horizon UInt32, threshold Float64, future_covariates Array(Array(Float64)))'
)) AS options_json
FROM store_series
),
scored_history AS (
SELECT
store_id,
with_calendar,
days,
observed_units,
aiDetectAnomalies(observed_units, options_json) AS scores
FROM scoring_requests
)
SELECT
store_id,
any(observed) AS observed_units,
round(maxIf(score.expected, with_calendar = 0), 0) AS history_only_median,
round(maxIf(score.expected, with_calendar = 1), 0) AS with_calendar_median,
round(maxIf(score.anomaly_score, with_calendar = 0), 2) AS history_only_score,
round(maxIf(score.anomaly_score, with_calendar = 1), 2) AS with_calendar_score
FROM scored_history AS h
ARRAY JOIN
h.days AS day,
h.observed_units AS observed,
h.scores AS score
WHERE day = toDate('2015-12-25')
GROUP BY store_id
ORDER BY store_id
SETTINGS max_threads = 1;toJSONString は名前付きタプルをオプションオブジェクトへとシリアライズします。その future_covariates フィールドには、is_event_day という 1 つの特徴量配列が含まれます。過去のみの特徴量は存在しないため、past_covariates は省略しています。スコアリングサービスは、12月23日〜29日の売上を見ることなく、その期間のイベントスケジュールを参照できます。つまり、予測を生成する際に考慮すべき既知の将来イベントをモデルに与えるには、このように記述します。
クリスマス当日のスコアは、しきい値を変更しないままでも 10 店舗中 9 店舗でしきい値を下回りました。履歴のみの実行では全 10 店舗にフラグが立っていました。クリスマスの 2 店舗の例を以下に示します:
| Store | Observed units | History-only median | With calendar median | History-only score | With calendar score |
|---|---|---|---|---|---|
| TX_2 | 0 | 3,520 | 1,384 | 8.65 | 2.71 |
| WI_3 | 1 | 3,074 | 749 | 8.37 | 1.45 |
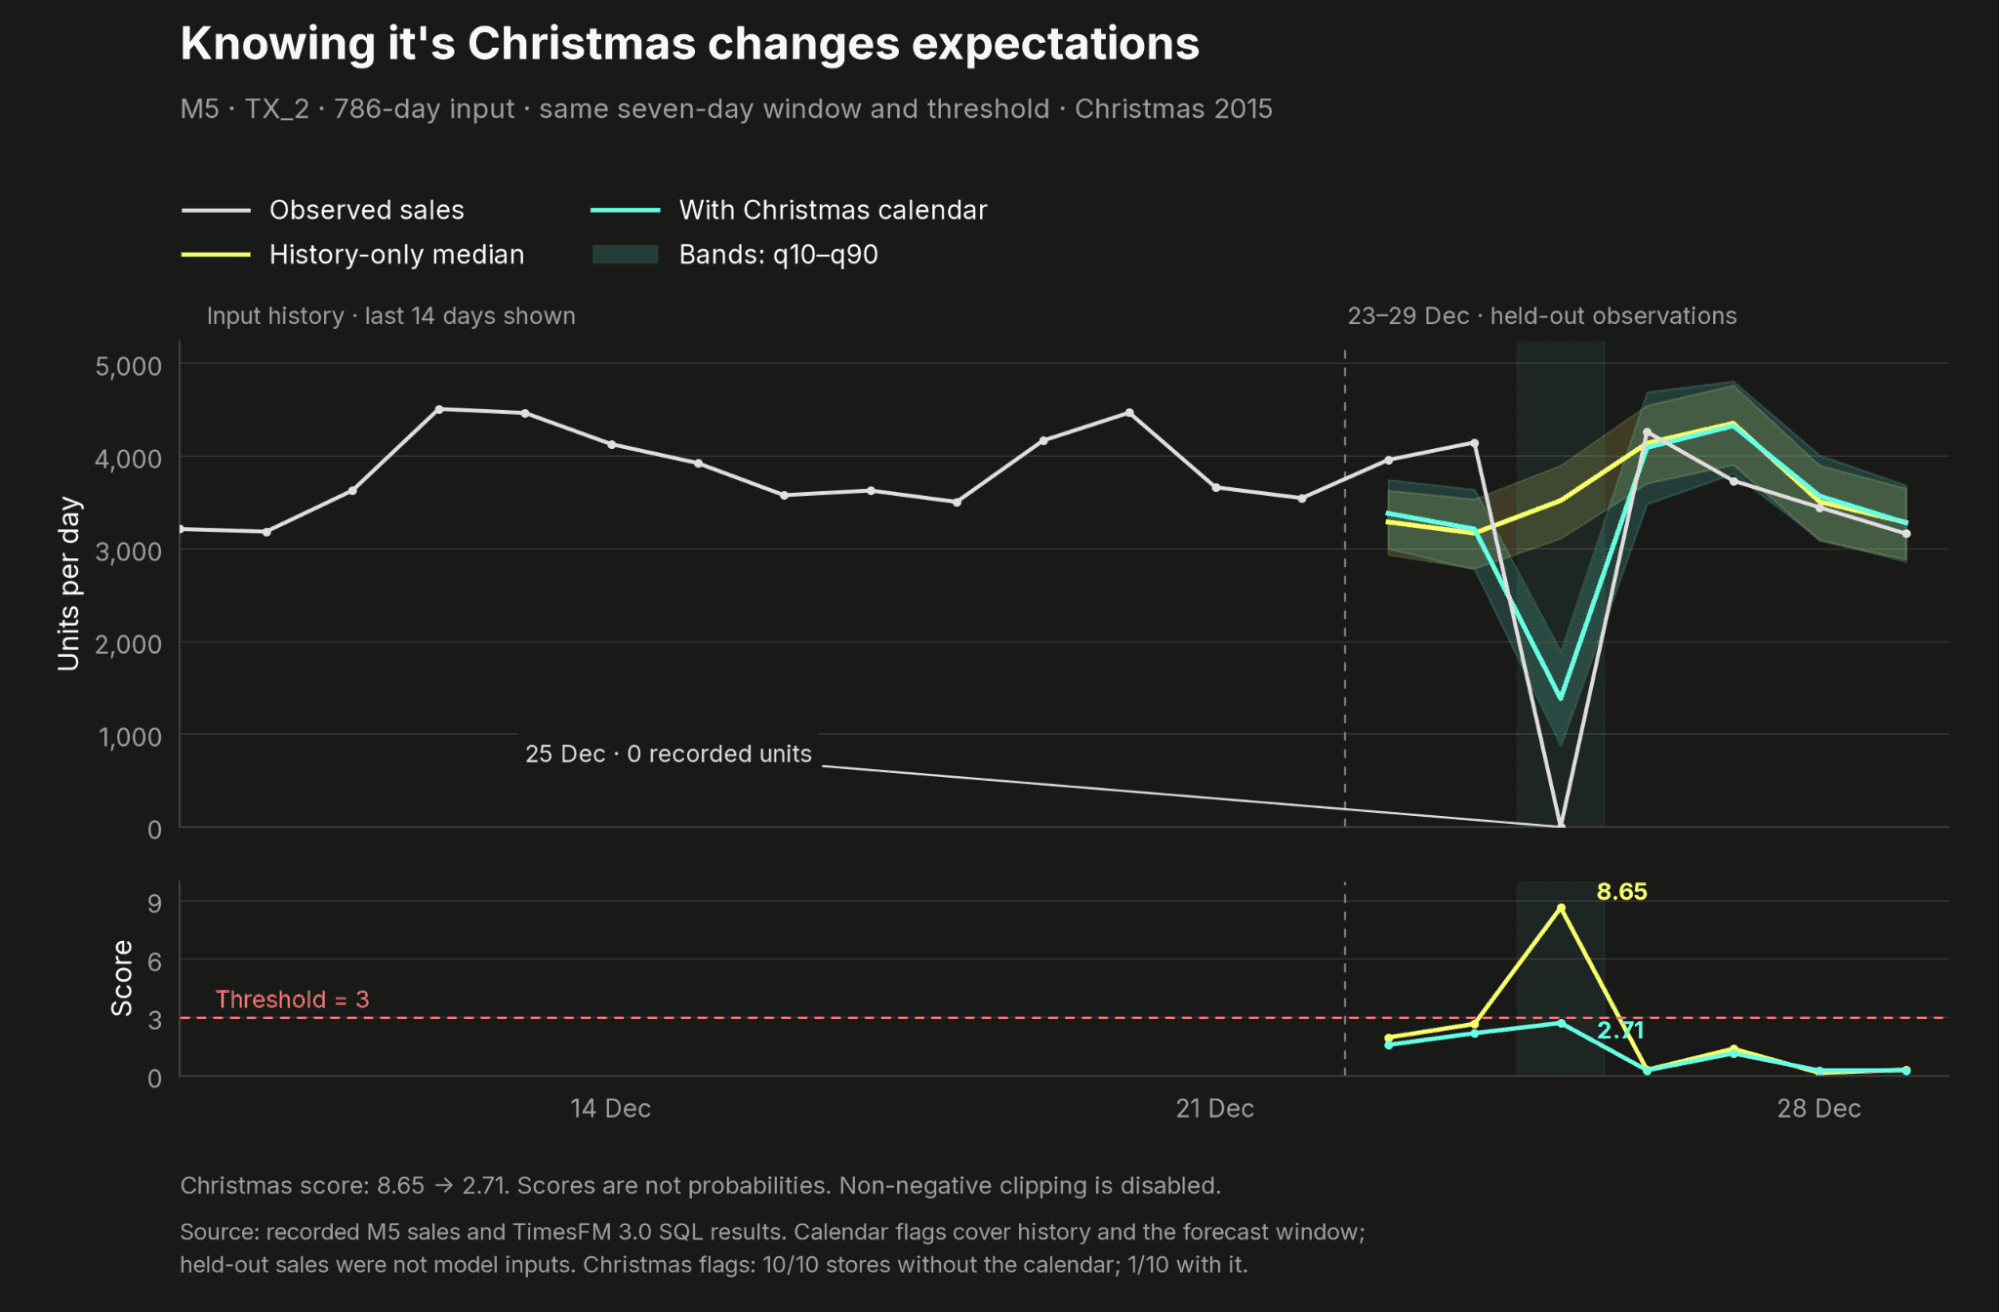
カレンダーによってモデルは落ち込みを予測できるようになりますが、ゼロに近い売上までは完全に予測しきれません。TX_2 の売上ゼロは、カレンダー考慮時の q10 下限である 874 個を依然として下回っていますが、正規化誤差は 3 を超えなくなりました。CA_2 はスコア 3.50 で引き続きフラグが立っています。これは前述の履歴のみの結果を書き換えるものではなく、カレンダーを考慮した別の比較であり、一般的な異常検知精度を保証するものではありません。
分析ワークフローでの結果の活用
このインターフェースは、リアルタイム分析システムやデータウェアハウスですでに行われている処理にそのまま組み込めます。トランザクションデータやイベントデータは ClickHouse 内で等間隔の系列に集計でき、必要に応じてマテリアライズドビューを使えばデータの到着に合わせて集計を維持できます。クエリで履歴を選択して推論を呼び出し、返された予測値をそのまま SQL でフィルタリング、結合、さらなる集計に利用できます。
定期実行するワークフローでは、予測結果を予測起点やモデルのリビジョンとともに保存しておき、新しいデータが到着した時点で実績値と比較できます。直近の観測値については、過去の履歴をコンテキストとして保持したまま、範囲を限定した末尾ウィンドウだけをスコアリングできます。これにより、実行のたびにテーブル全体を再スコアリングせずに済みます。なお、本デモではこうしたクエリのスケジュール実行や予測テーブルの自動維持までは行っていません。それらはアプリケーション側で個別に選択すべき事項です。
モデルサービスは依然としてクエリパス上の外部依存コンポーネントです。コンテキスト長、系列数、推論キャパシティ、リクエストタイムアウトには上限を設ける必要があります。本記事の SQL 例は過去データを使用しており、ストリーミングのレイテンシや本番環境でのスループットを実証するものではありません。予測区間のカバレッジやスコアリングのしきい値についても、想定する用途に合わせて検証する必要があります。
まとめ
本記事では、ClickHouse を時系列基盤モデルに接続し、SQL を使って需要予測、異常検知、および想定される変化の説明に役立つ既知の将来イベントの供給を行いました。ClickHouse がデータの準備と順序付けを担い、モデルが系列ごとの学習なしで予測を提供します。予測値は通常のクエリ結果として返されるため、データベース内でそのまま結合やフィルタリング、さらなる時系列分析に活用できます。
これと同じ SQL からモデルを呼び出すアプローチを使えば、ClickHouse を表形式基盤モデル (tabular foundation models) に接続して構造化された行に対する予測を行うことも可能です。今後の記事では、ClickHouse で表形式の入力を準備し、表形式基盤モデルを呼び出して、その予測結果を SQL で活用する方法を探っていきます。
今すぐ始める
手元のデータで ClickHouse がどのように動作するか試してみませんか? 数分で ClickHouse Cloud を始められ、$300 分の無料クレジットを受け取れます。
サインアップ