50.9 k

この記事は、もともと AWS によって公開された記事 です。
さまざまな処理エンジンからデータを扱えるようにするため、トランザクションデータや運用データを Apache Iceberg などのオープンテーブルフォーマットで保持する組織が増えています。しかし、データを効率的に保存・整理することは、全体の半分にすぎません。人間とエージェントの双方がデータへの高速で網羅的なアクセスを必要とした瞬間、異なる処理エンジンを持つ別のシステムへデータをコピーせざるを得ないことがよくあります。そうしたコピーの構築にはコストがかかり、作成された瞬間から陳腐化し、ガバナンスを分断させ、結果を単一のシステムに閉じ込めてしまいます。
Amazon S3 Tables は、Apache Iceberg 向けにフルマネージドでスケーラブル、かつコスト効率に優れたストレージを提供します。データはオープンフォーマットで保存されるため、Iceberg に対応した任意のエンジンから読み取ることができます。ClickHouse は高性能なリアルタイムデータベースであり、S3 Tables と組み合わせることで、データを移行することなく高速に分析を処理できます。
本記事では、ClickHouse と S3 Tables 間の双方向の接続性を活かし、ClickHouse の高性能エンジンを S3 Tables 内のデータに直接適用する方法をご紹介します。このアプローチにより、別システムへのデータコピーが不要になります。S3 Tables を唯一のオープンな信頼できる情報源(Single Source of Truth)として維持しながら、Iceberg テーブルをインプレースでクエリし、ClickHouse SQL を使って変換を実行し、キュレーションされた結果を書き戻すことができます。
ここでは、小売業の分析ユースケースを用いて接続ワークフローを順を追って説明します。さらに、同じパターンを、分析結果への高速で反復的なアクセスを必要とする AI エージェントのワークロードへと拡張する方法も示します。このウォークスルーは、セルフマネージドの ClickHouse デプロイメントで動作します。
インプレースでクエリする理由
このウォークスルーでは、以下の 4 つの主要な課題を解決します。
- コピーのコスト: パイプラインを構築するたびに、すでに存在するデータを複製するためにコンピュート、ストレージ、エンジニアリングの時間が消費されます。
- データの陳腐化: コピーの鮮度は前回の同期時点にとどまるため、アナリストやエージェントは日常的に古いデータをもとに推論することになりがちです。
- ガバナンスの無秩序な拡大: コピーが増えるごとに、セキュリティ保護、監査、コンプライアンス対応を行うべき場所が増加します。
- ロックイン: 分析結果が単一のエンジン独自のフォーマット内にしか存在しない場合、他のツールで利用するにはさらなるエクスポートが必要になります。
ソリューションの概要
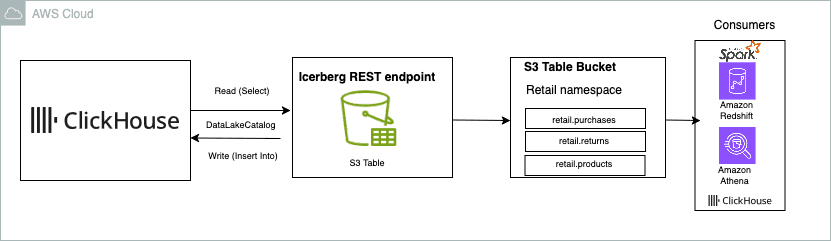
図 1: ソリューションの概要
ClickHouse は、DataLakeCatalog データベースエンジンを使用して、Iceberg REST エンドポイント経由で Amazon S3 Tables に接続します。接続すると、テーブルバケットが ClickHouse 内のデータベースとして表示されます。標準的な ClickHouse SQL を使用して、ネームスペースの検出、既存の Iceberg テーブルへのクエリ、新しいテーブルの作成、結果の書き戻しのすべてを実行できます。
2 つのシステムには明確な役割分担があります。
- Amazon S3 Tables は、ストレージ、Iceberg メタデータ、およびコンパクション、スナップショットの有効期限切れ処理、参照されていないファイルのクリーンアップなどの自動テーブルメンテナンスを管理します。現在のデフォルト設定については、S3 Tables のドキュメント を参照してください。
- ClickHouse は、列指向処理、並列クエリ実行、各クエリに関連するデータのみを読み取る機能など、分析エンジンとしての機能を提供します。
データの流れ
- ソースデータは物理的に S3 Tables 上に存在します。サブセットを意図的にマテリアライズしない限り、ClickHouse はデータをローカルに一切保存しません。
- 読み取り時、ClickHouse はまず Iceberg REST カタログを呼び出して現在のテーブルメタデータとスナップショットを解決し、関連する Parquet オブジェクトのみを S3 から直接読み取ります。
- 書き込み時、ClickHouse は新しい Parquet データと Iceberg メタデータオブジェクトを S3 に書き込みます。その後、カタログを介してテーブルのルートメタデータポインタを新しいスナップショットに更新することでコミットします。このアトミックなポインタ切り替えにより、読み取り側には古いスナップショットか新しいスナップショットのいずれかのみが見え、不完全な書き込みが見えることはありません。
- 認証には AWS Signature Version 4 を使用します。リクエストの認可は、ClickHouse が引き受ける(Assume)アイデンティティにアタッチされた AWS Identity and Access Management(IAM)ポリシーを通じて行われます。
🔗 代わりに AWS Glue Iceberg REST エンドポイントを使用すべきケース:
このウォークスルーでは、1 つのエンジンを 1 つのテーブルバケットに接続するための最も直接的な経路であるため、直接の S3 Tables エンドポイントを使用しています。組織で一元的なカタログガバナンス、複数エンジンにまたがるきめ細かなアクセス制御、またはクロスアカウントアクセスが必要な場合は、代わりに AWS Glue Iceberg REST エンドポイントを使用してください。
前提条件
開始する前に以下が必要です。
- ClickHouse 26.8 以降(オープンソース、セルフマネージド)。ここで説明する S3 Tables への読み書きパスは、マネージドオプションである ClickHouse Cloud ではまだ一般提供(GA)されていません。
- S3 Tables バケットおよび IAM ロールを作成する権限を持つ AWS アカウント。
- 少なくとも 1 つのネームスペースを含む Amazon S3 テーブルバケット。AWS リージョンとテーブルバケットの ARN(例:
arn:aws:s3tables:us-east-1:123456789012:bucket/retail-analytics)を控えておいてください。 - ClickHouse ホストからリージョンの S3 Tables エンドポイント(
s3tables.<region>.amazonaws.com)へのネットワークアクセス。 - S3 Tables に対する最小権限を持つ IAM ロール。後述のサンプルポリシーを参照してください。
最小権限を持つ IAM ロールの作成
ClickHouse が S3 Tables カタログに対して認証し、ユーザーに代わってオブジェクトを読み書きするには、AWS のアイデンティティが必要です。アカウント全体への広範なアクセスを許可するのではなく、ワークフローに必要な S3 Tables のアクションのみを許可する IAM ロールを作成します。以下のサンプルポリシーは、単一のテーブルバケット内のテーブルの一覧表示、読み取り、および書き込みの権限を ClickHouse に付与します。AWS リージョン、アカウント ID、およびバケット名は実際の値に置き換えてください。
{
"Version": "2012-10-17",
"Statement": [
{
"Sid": "AllowS3TablesReadWrite",
"Effect": "Allow",
"Action": [
"s3tables:GetTableBucket",
"s3tables:ListTables",
"s3tables:ListNamespaces",
"s3tables:GetNamespace",
"s3tables:GetTable",
"s3tables:GetTableData",
"s3tables:GetTableMetadataLocation",
"s3tables:CreateTable",
"s3tables:PutTableData",
"s3tables:UpdateTableMetadataLocation"
],
"Resource": [
"arn:aws:s3tables:us-east-1:123456789012:bucket/retail-analytics",
"arn:aws:s3tables:us-east-1:123456789012:bucket/retail-analytics/*"
]
}
]
}注: Iceberg の書き込みをコミットするための正しいアクションは s3tables:UpdateTableMetadataLocation です。これにより、ClickHouse が INSERT INTO による書き込みをコミットする際に、テーブルのルートメタデータポインタが更新されます。サポートされている Iceberg REST API と、それらが S3 Tables の IAM アクションにどのようにマッピングされるかを確認してください。セキュリティのベストプラクティス として、ClickHouse の設定ファイルや SQL 文では短期認証情報を使用してください。
ClickHouse は標準の AWS 認証情報チェーン(環境変数、インスタンスプロファイル、または設定ファイル)から認証情報を読み取るため、SQL 文の中に認証情報が露出することはありません。
ウォークスルー: Amazon S3 Tables 上の小売分析
このウォークスルーでは、ClickHouse を S3 テーブルバケットに接続し、3 つの Iceberg テーブルにまたがる小売分析の変換処理を実行し、キュレーションされた結果を S3 Tables に書き戻します。
シナリオ
ある小売事業者が、S3 テーブルバケットの retail ネームスペース配下に 3 つの Iceberg テーブルを保持しています。分析チームは、製品、日、地域ごとに分類された、純売上高、販売数量、返品数量、返品率の日次ビューを必要としています。
| テーブル | 説明 | 主要カラム |
|---|---|---|
retail.purchases | 完了したすべての購入レコード | order_id、product_id、region、purchased_at、sales_amount、units |
retail.returns | 返品された商品レコード | order_id、product_id、returned_at、refund_amount、units_returned |
retail.products | 製品カタログ | product_id、product_name、category |
現在、これには複数テーブルの結合が必要であり、アナリストがアドホックにクエリを実行すると処理が低速になります。ここでの目標は、ClickHouse 内で結合を 1 回実行し、その結果をキュレーション済みテーブルである daily_product_performance として書き戻すことです。これにより、ダッシュボード、レポート、およびダウンストリームのツールは、事前集計された結果を S3 Tables から低レイテンシかつ高同時実行性で直接読み取れるようになります。以下のステップで、ClickHouse を S3 Tables に接続する方法を説明します。
ステップ 1: ClickHouse を S3 テーブルバケットに接続する
Iceberg カタログ統合と書き込みサポートを有効にします。
-- Enable the DataLakeCatalog engine for Iceberg (required in ClickHouse 26.8)
SET allow_database_iceberg = 1;
-- Enable writing back to Iceberg tables in S3 Tables
SET allow_insert_into_iceberg = 1;次に、カタログ接続を作成します。リージョン、アカウント ID、テーブルバケット名を実際の値に置き換えてください。
CREATE DATABASE retail_lakehouse
ENGINE = DataLakeCatalog(
'https://s3tables.us-east-1.amazonaws.com/iceberg'
)
SETTINGS
catalog_type = 's3tables',
region = 'us-east-1',
warehouse = 'arn:aws:s3tables:us-east-1:123456789012:bucket/retail-analytics';ClickHouse は、ホスト上の AWS 認証情報チェーンを使用して認証します。SQL 文に認証情報は埋め込まれません。warehouse の値にはテーブルバケットの ARN を指定します。各テーブルを個別に登録する必要はありません。
ステップ 2: テーブルの検出とクエリ
カタログ経由で参照可能なすべてのテーブルを一覧表示します。
SHOW TABLES FROM retail_lakehouse;S3 Tables は単一レベルのネームスペースを使用します。ネームスペースとテーブル名は単一の識別子として ClickHouse に渡されるため、バッククォートを使用する必要があります。注: これは、このウォークスルー全体におけるすべてのテーブル参照に適用されます。
-- Query the first 10 rows from the purchases table
-- Backticks required: 'retail.purchases' is a single identifier
SELECT *
FROM retail_lakehouse.`retail.purchases`
LIMIT 10;ステップ 3: purchases と returns を結合する変換処理
分析クエリを実行します。このクエリは購入データと返品データを結合し、返金後の純売上高を計算し、その結果を日、製品、地域ごとにグループ化します。
SELECT
toDate(p.purchased_at) AS performance_date, -- Truncate timestamp to date
p.product_id,
p.region,
-- Net sales = gross sales minus refunds (ifNull handles products with no returns)
sum(p.sales_amount) - sum(ifNull(r.refund_amount, 0)) AS net_sales,
sum(p.units) AS units_sold,
sum(ifNull(r.units_returned, 0)) AS units_returned,
-- Return rate as a ratio; nullIf prevents division by zero
sum(ifNull(r.units_returned, 0)) / nullIf(sum(p.units), 0) AS return_rate
FROM retail_lakehouse.`retail.purchases` AS p
LEFT JOIN
(
-- Pre-aggregate returns per order and product to avoid row multiplication
SELECT
order_id,
product_id,
sum(refund_amount) AS refund_amount,
sum(units_returned) AS units_returned
FROM retail_lakehouse.`retail.returns`
GROUP BY order_id, product_id
) AS r
ON p.order_id = r.order_id
AND p.product_id = r.product_id
GROUP BY
performance_date,
p.product_id,
p.region;Iceberg メタデータと Parquet のカラムプルーニングのおかげで、ClickHouse はこのクエリを並列に処理し、必要なカラムと行グループのみを S3 Tables から読み取ります。
ステップ 4: 結果を S3 Tables に書き戻す
まず、同じカタログ接続を使用して、retail ネームスペース内に出力先テーブルを作成します。
CREATE TABLE retail_lakehouse.`retail.daily_product_performance`
(
performance_date Date,
product_id String,
region String,
net_sales Decimal(18, 2),
units_sold UInt64,
units_returned UInt64,
return_rate Float64
)
ENGINE = Iceberg;次に、INSERT INTO ... SELECT でデータを投入します。これにより、ステップ 3 の変換処理が再実行され、出力が S3 Tables に直接書き込まれます。
INSERT INTO retail_lakehouse.`retail.daily_product_performance`
SELECT
toDate(p.purchased_at) AS performance_date,
p.product_id,
p.region,
sum(p.sales_amount) - sum(ifNull(r.refund_amount, 0)) AS net_sales,
sum(p.units) AS units_sold,
sum(ifNull(r.units_returned, 0)) AS units_returned,
sum(ifNull(r.units_returned, 0)) / nullIf(sum(p.units), 0) AS return_rate
FROM retail_lakehouse.`retail.purchases` AS p
LEFT JOIN
(
SELECT
order_id, product_id,
sum(refund_amount) AS refund_amount,
sum(units_returned) AS units_returned
FROM retail_lakehouse.`retail.returns`
GROUP BY order_id, product_id
) AS r
ON p.order_id = r.order_id
AND p.product_id = r.product_id
GROUP BY performance_date, p.product_id, p.region;結果を確認します。
SELECT *
FROM retail_lakehouse.`retail.daily_product_performance`
ORDER BY performance_date DESC, net_sales DESC
LIMIT 20;これで、daily_product_performance テーブルは標準の Iceberg テーブルとして S3 Tables に保存されました。同じテーブルバケットに接続する Iceberg 対応エンジン(Amazon Athena、Amazon Redshift、AWS Glue、Amazon EMR、DuckDB、Apache Spark、Trino など)であれば、結合処理を再実行することなく、このテーブルを検出してクエリできます。
エージェント駆動の分析
AI エージェントは、Amazon Bedrock などの AWS サービスや自社のアプリケーション内で実行できます。エージェントは ClickHouse 内で稼働したり、S3 Tables に直接アクセスしたりはしません。代わりに、エージェントは ClickHouse をツールまたは関数として呼び出し、ClickHouse が先ほど設定した DataLakeCatalog 接続と IAM アイデンティティを使用して S3 Tables をクエリし、キュレーションされた結果を書き戻します。
特定の地域における商品の返品急増を調査するタスクを担うエージェントを考えてみましょう。エージェントのワークフローは以下のようになります。
- 読み取り: エージェントは ClickHouse を(ツールまたは関数として)呼び出し、対象の地域と期間に絞り込んで S3 Tables 内の
retail.purchasesとretail.returnsをクエリします。 - 分析: 最初の結果に基づき、エージェントは製品カテゴリ別の返品率、前期間との比較、最近のプロモーションとの相関関係など、追加のクエリを実行します。
- 書き込み: エージェントは、キュレーションした調査結果(例:
return_spike_investigationテーブル)を ClickHouse 経由で S3 Tables に書き戻します。 - 共有: 他のエージェント、ビジネスインテリジェンス(BI)ツール、およびアナリストは、分析を再実行することなく、S3 Tables から調査結果を直接読み取ることができます。
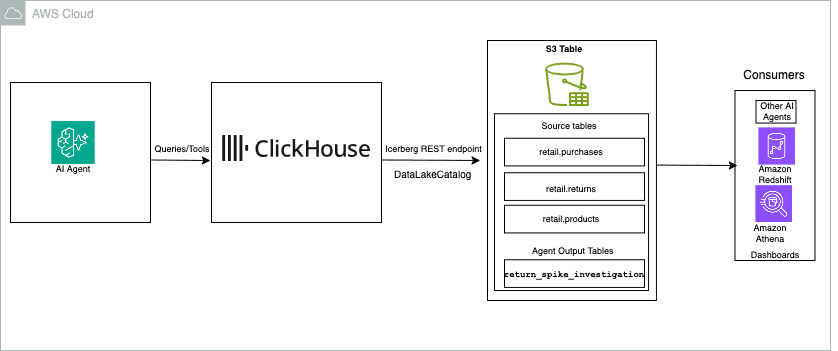
図 2: ClickHouse と Amazon S3 Tables を使用した AI エージェントのワークフロー
このアーキテクチャには主に 2 つのメリットがあります。
- 高速性: エージェントは、各クエリが直前の結果に依存するような、依存関係のあるクエリチェーンを実行することがよくあります。ClickHouse の並列・列指向実行により各ステップが高速に保たれ、エージェントの合計レイテンシが数分から数秒へと短縮されます。
- 再利用性: オープンな Iceberg フォーマットで S3 Tables に結果を書き戻すことで、ベンダーロックインなしに、さまざまなツール、エンジン、他のエージェントからそれらを利用できるようになります。
S3 Tables はソースデータと導出された結果の双方において、一元化されたオープンなストレージとして機能し続けます。ClickHouse はエージェントのワークフローを滞りなく進めるための高速な分析レイヤーを提供します。
注意事項と制限事項
- 単一レベルのネームスペース: S3 Tables は、Iceberg REST エンドポイントを介して単一レベルのネームスペースをサポートします。テーブルは
namespace.table_nameとして指定されます。 - リージョン別の提供状況: S3 Tables の提供状況は AWS リージョンによって異なります。デプロイ前に Amazon S3 Tables の ドキュメント で最新のリージョン一覧を確認してください。
- テーブルの削除: S3 Tables の Iceberg REST エンドポイントは、
purge=trueを伴うDROP TABLEのみをサポートしています。ClickHouse がこのフラグなしでドロップを発行した場合、400 Bad Requestが返される可能性があります。ドロップ操作を実行する前に、ClickHouse のデフォルトの動作を確認してください。 - パフォーマンス特性: オブジェクトストレージ上で ClickHouse を使用して Iceberg テーブルをインプレースでクエリする場合、ローカルの MergeTree テーブルをクエリする場合とはレイテンシおよびスループットの特性が異なります。探索、バッチ変換、低同時実行性のワークロードにはインプレースクエリを使用してください。高同時実行性で一貫して低いレイテンシが求められるダッシュボードやアプリケーションの場合は、データを MergeTree にマテリアライズすることをお勧めします。
- ClickHouse Cloud のサポート状況: このワークフローに対する ClickHouse Cloud でのサポートは、まだ一般提供(GA)されていません。
- 自動テーブルメンテナンス: S3 Tables は、小さなオブジェクトを大きなファイル(デフォルトターゲット: 512 MB)へと自動的にコンパクションし、古いスナップショットを期限切れにし、参照されていないファイルを削除します。これらの操作を手動でスケジュールする必要はありません。
リソースの削除
本記事の手順に沿ってリソースを作成した場合は、継続的な課金を防ぐために以下を確認してください。
- S3 Tables: S3 Tables には、ストレージ、リクエスト、コンパクションに基づく独自の料金モデルがあります。不要になったテストテーブルとネームスペースを削除してください。
- ClickHouse: ClickHouse 用に Amazon Elastic Compute Cloud(Amazon EC2)インスタンスを起動した場合は、使用していないときに終了または停止してください。
- IAM リソース: このウォークスルーのために作成した IAM ロールとポリシーが不要になった場合は削除してください。
まとめ
本記事では、データを移行することなく、ClickHouse を使って Amazon S3 Tables 内のデータを分析するための実践的なワークフローをご紹介しました。Iceberg REST エンドポイントを介して ClickHouse を S3 Tables に接続することで、Iceberg テーブルをインプレースでクエリ、変換、強化できます。さらに、キュレーションされた結果を書き戻すことで、Iceberg に対応した任意のエンジンから利用できるようになります。これにより、データコピーのコスト、データの陳腐化、ガバナンスの無秩序な拡大、およびベンダーロックインの問題が解決されます。
この「読み取り - 変換 - 書き込み」のパターンは、分析データへの高速で反復的なアクセスを必要とする AI エージェントのワークロードにも同様に適用できます。どちらのケースでも、S3 Tables が共有されたオープンな信頼できる情報源(Single Source of Truth)として機能し、ClickHouse が分析のスピードを提供します。
まずは、Amazon S3 テーブルバケットを作成し、本記事の手順に沿って ClickHouse に接続して、Iceberg テーブルのインプレースクエリを開始してみてください。
今すぐ始める
自社データで ClickHouse がどのように動作するか試してみませんか? わずか数分で ClickHouse Cloud を使い始めることができ、300 ドル分の無料クレジットも受け取れます。
サインアップ