

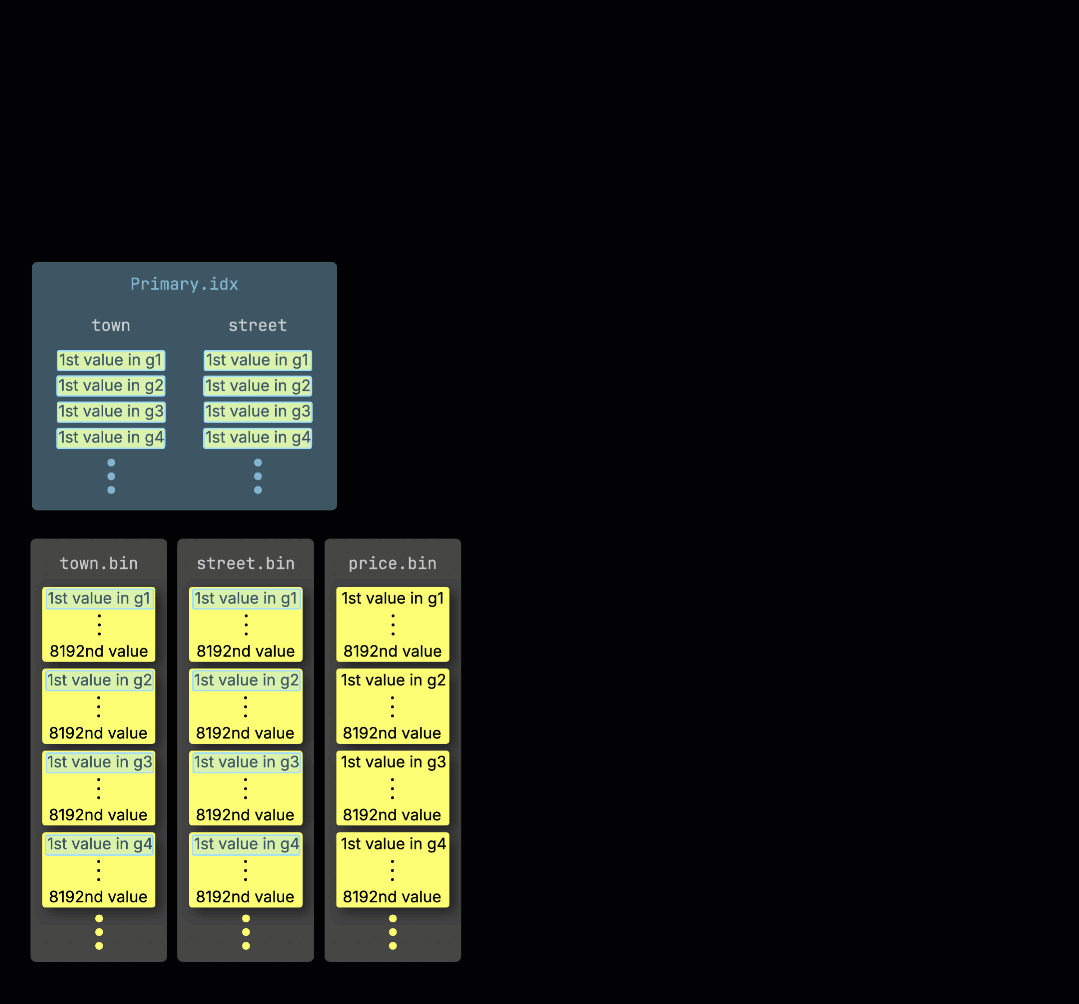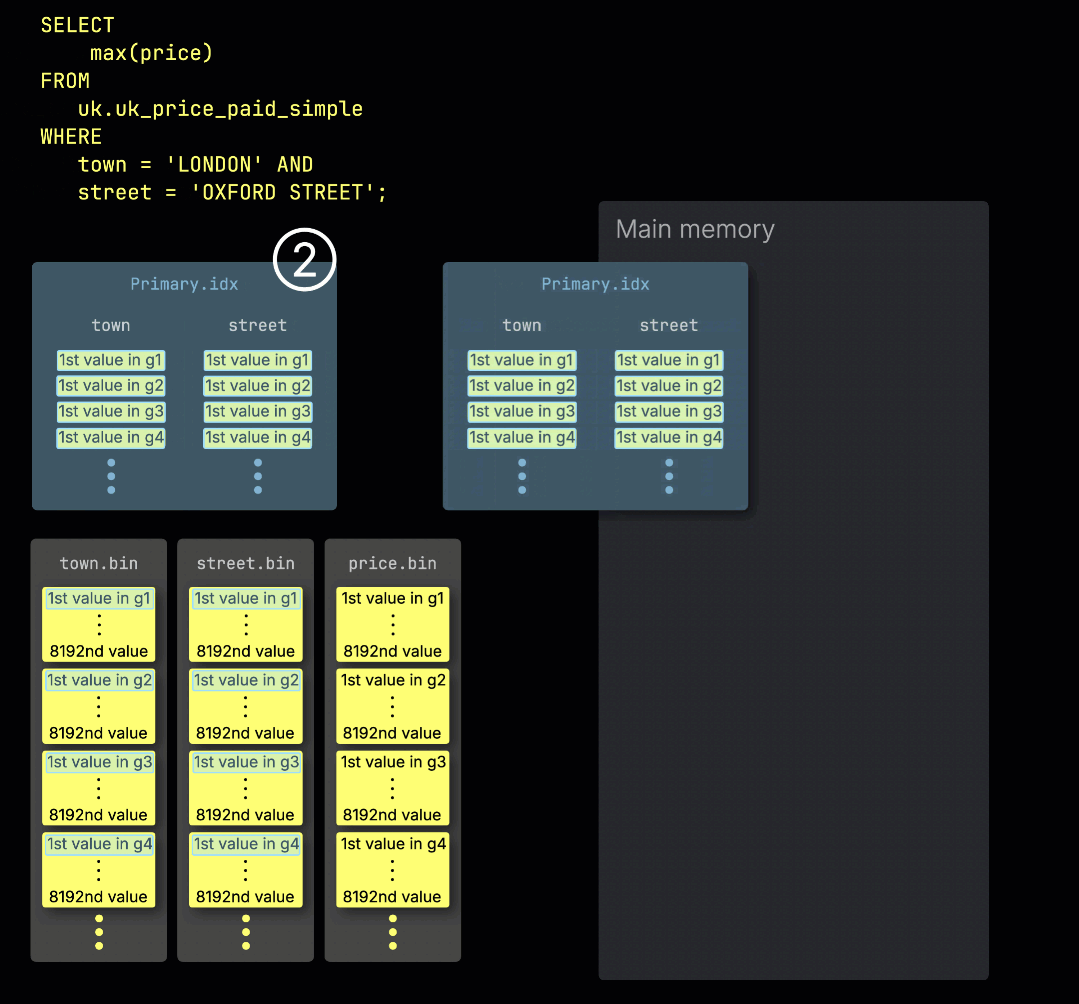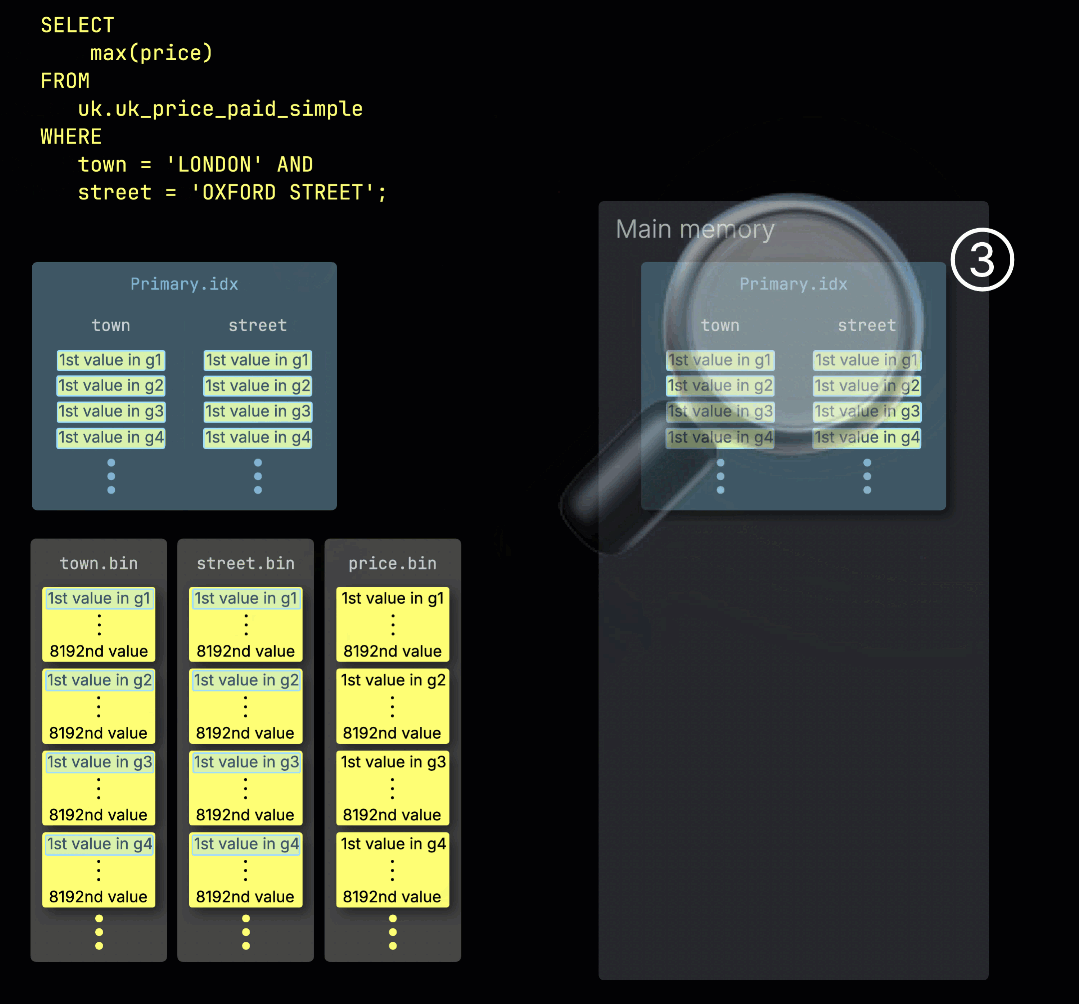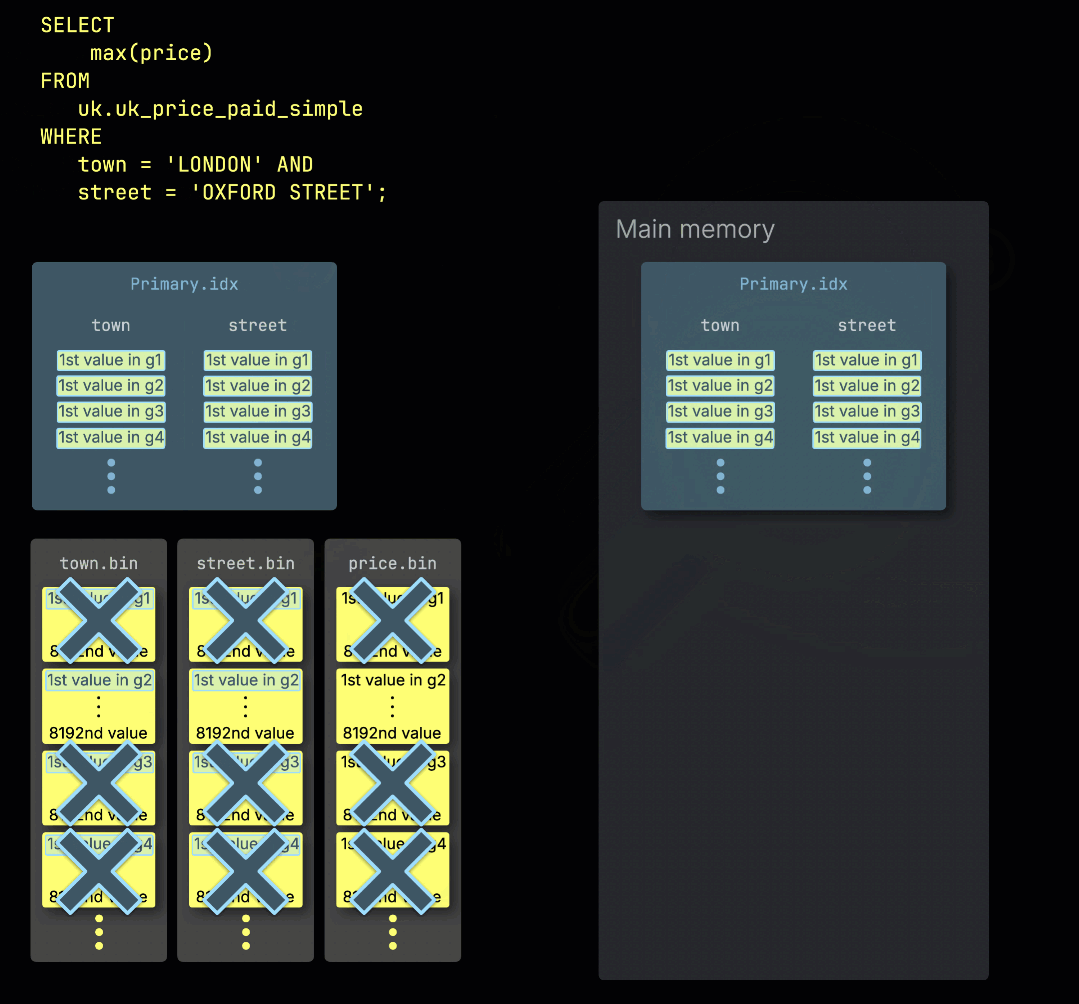
n lanes de processamento paralelas, que transmitem e processam os dados bloco a bloco até o resultado final:
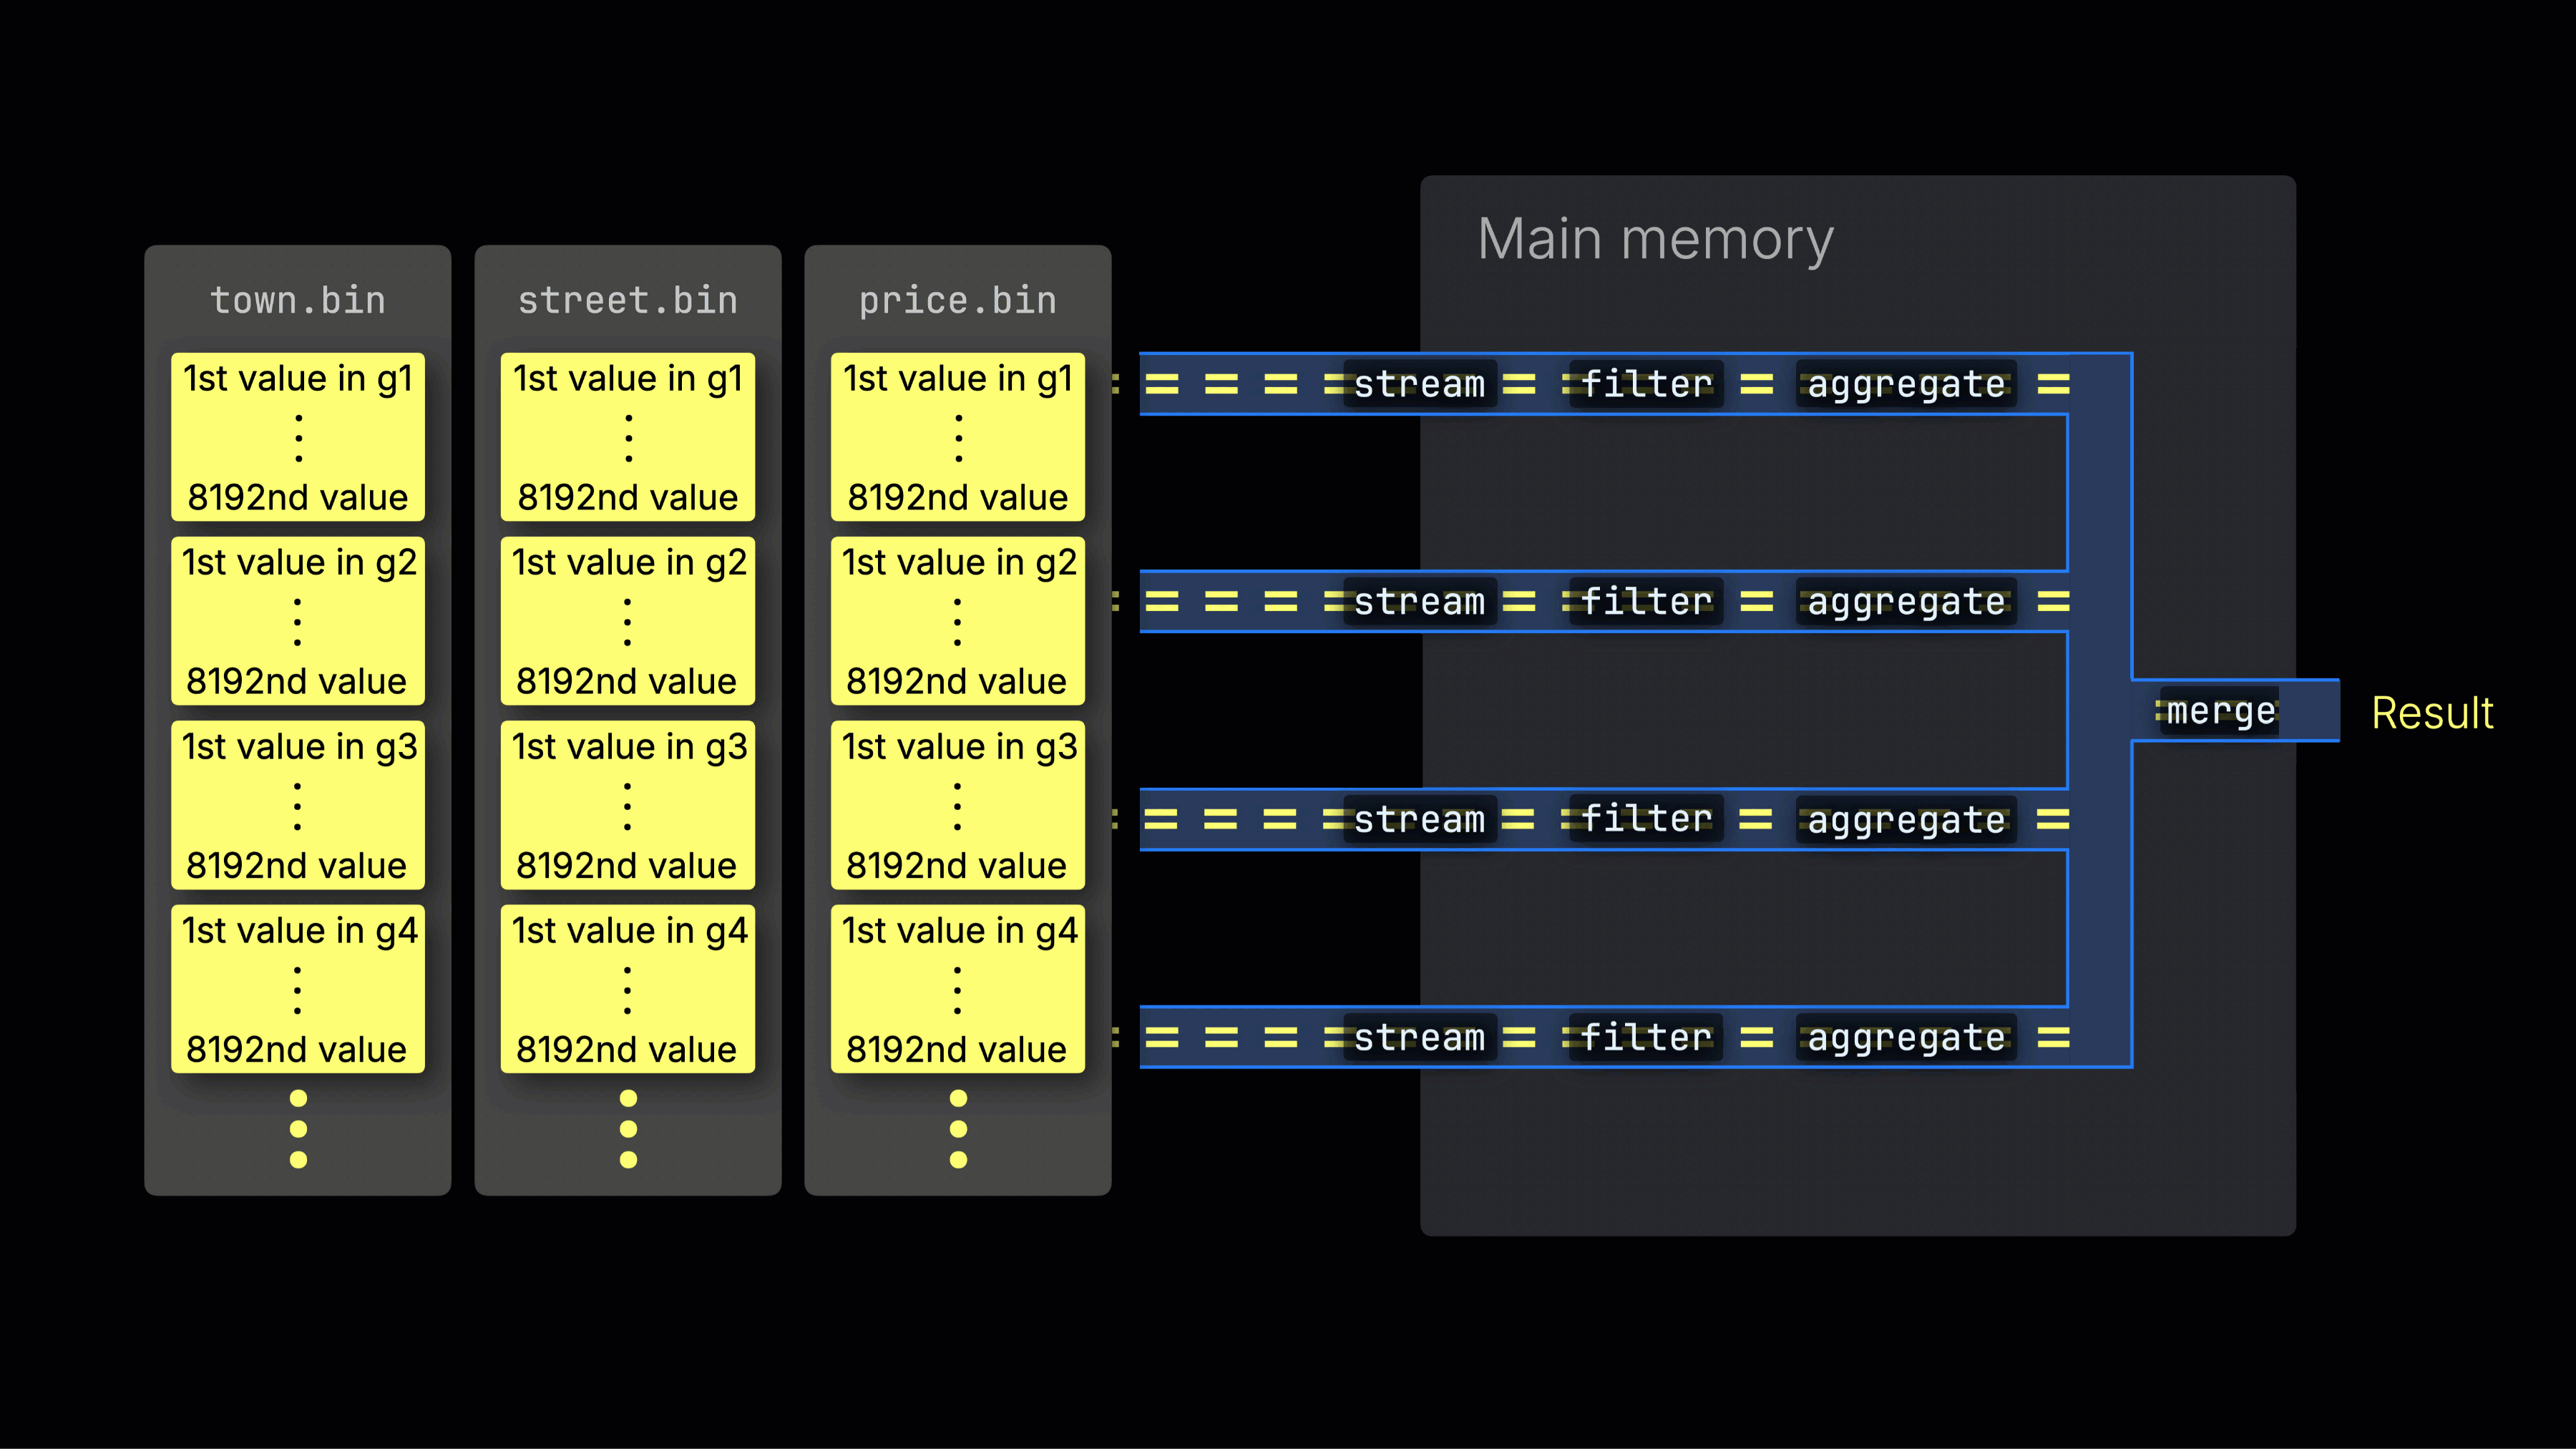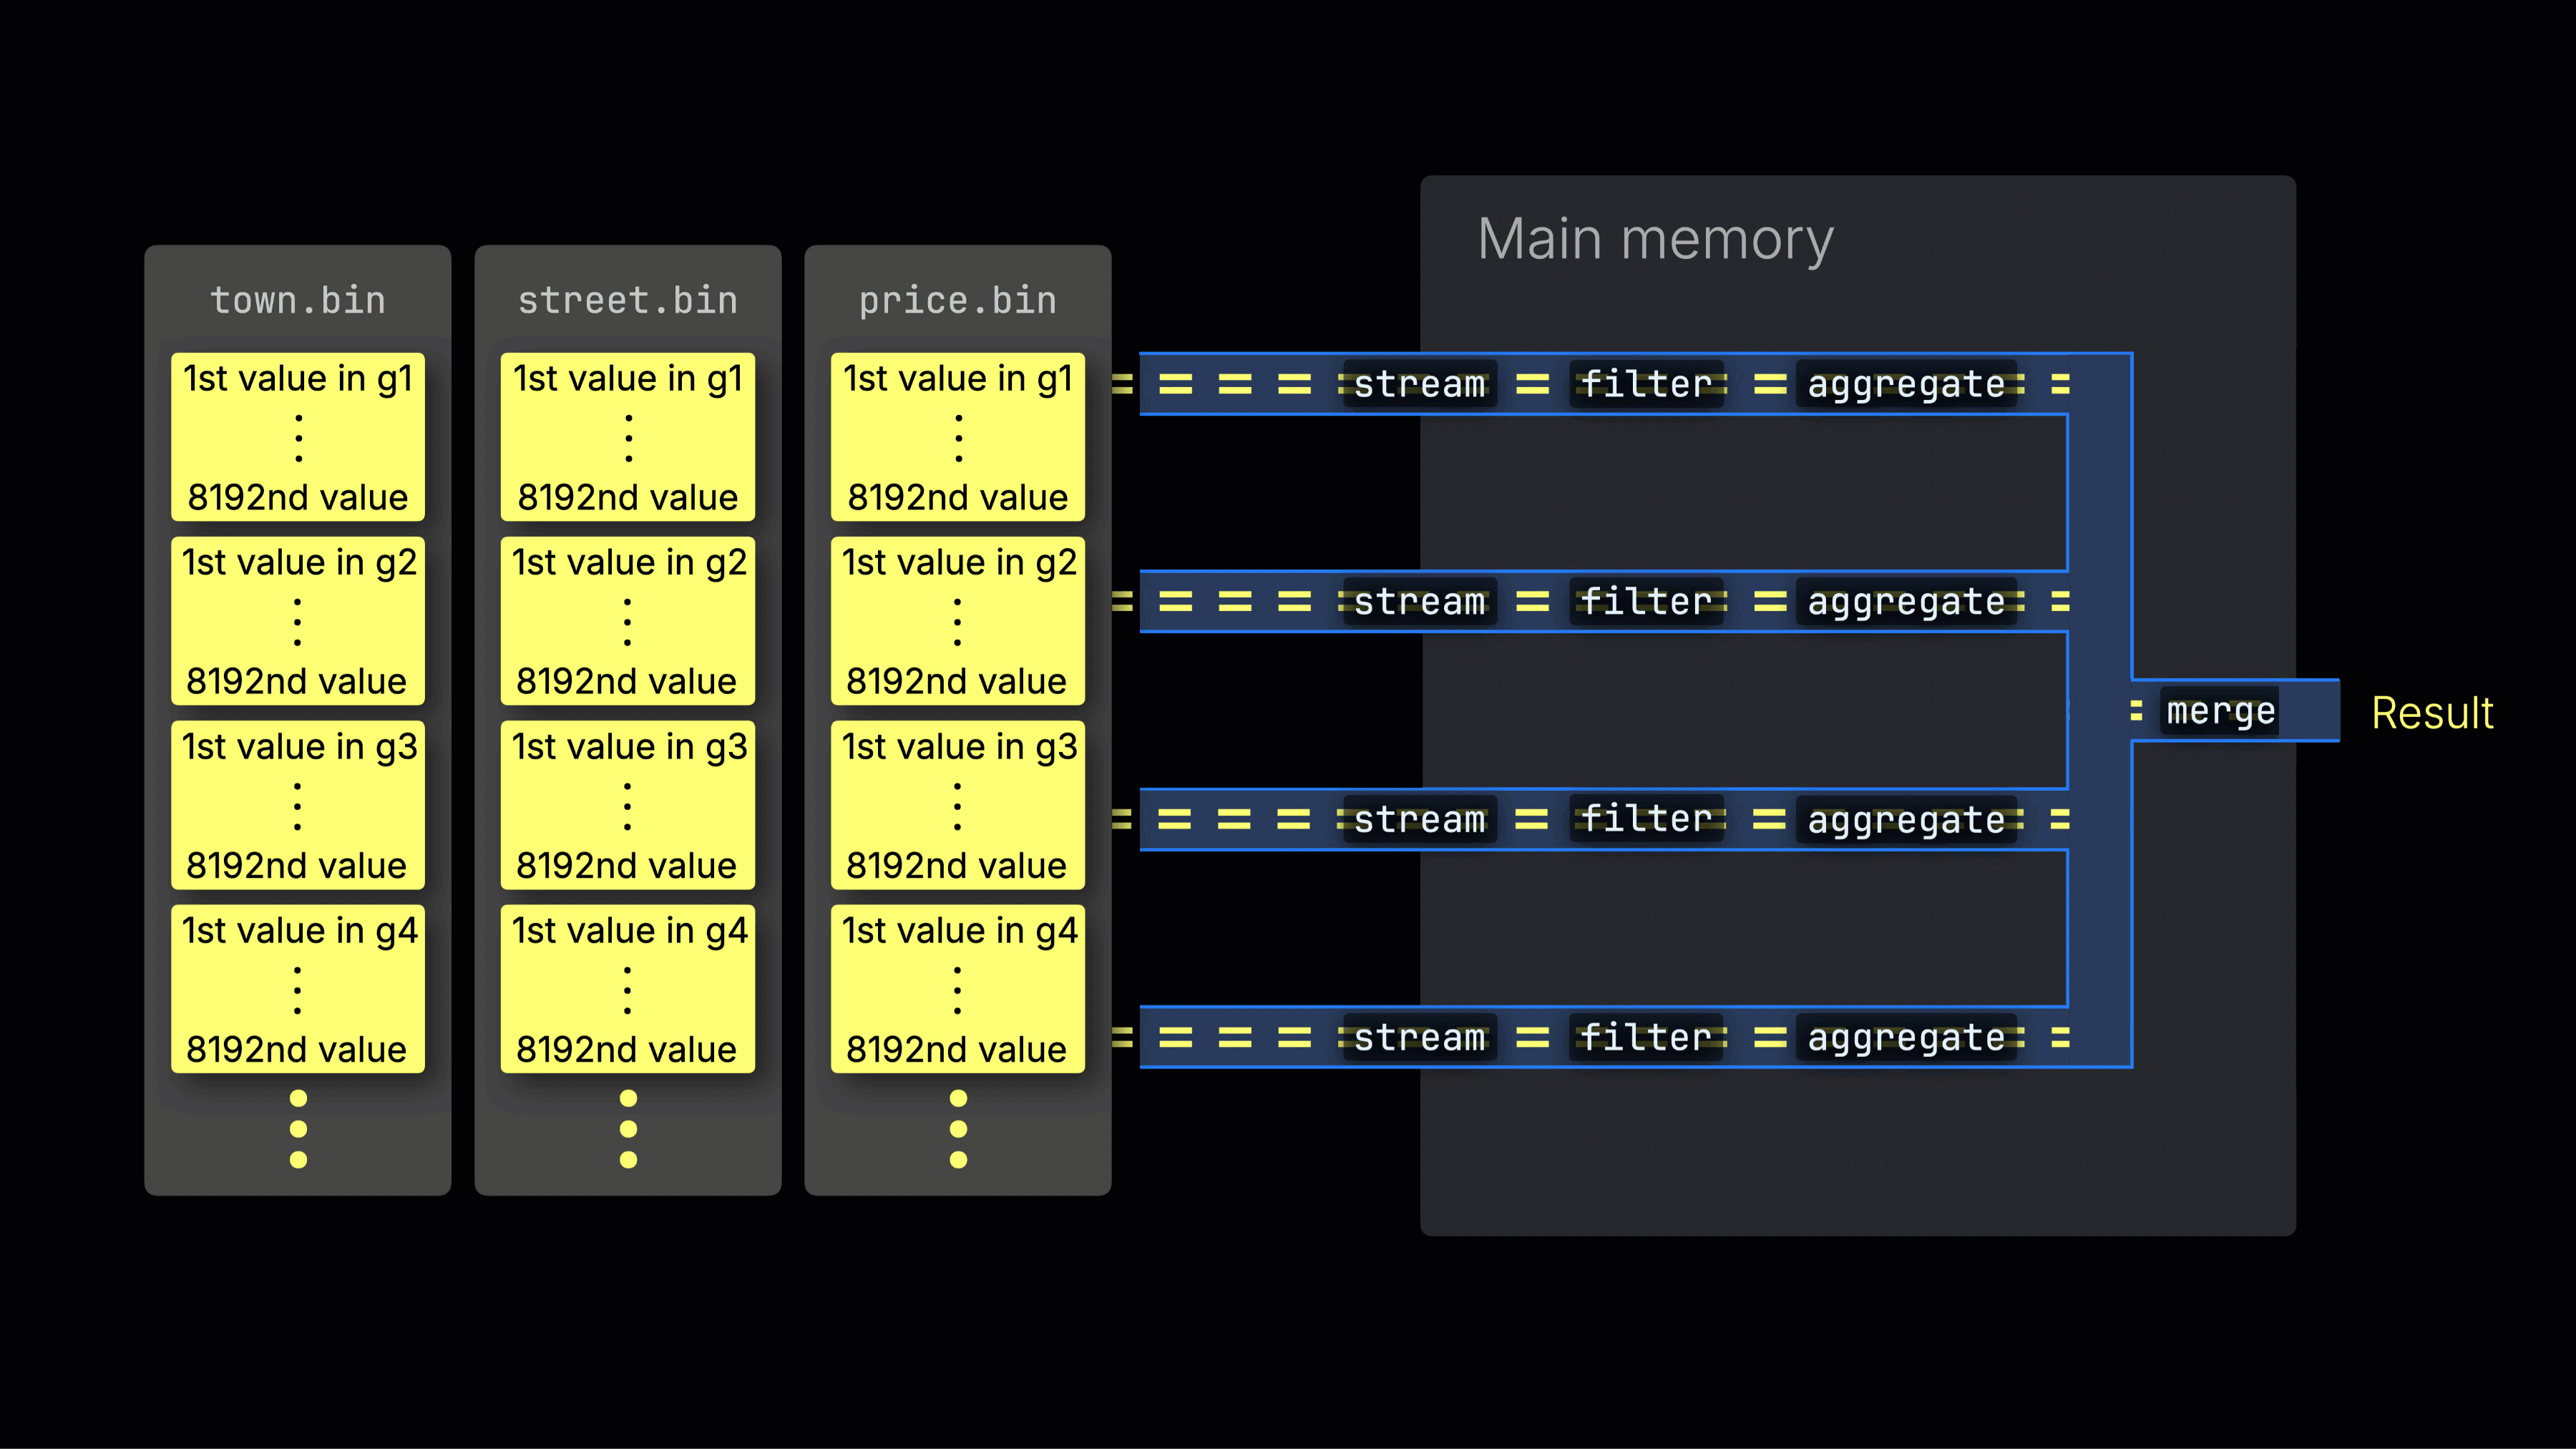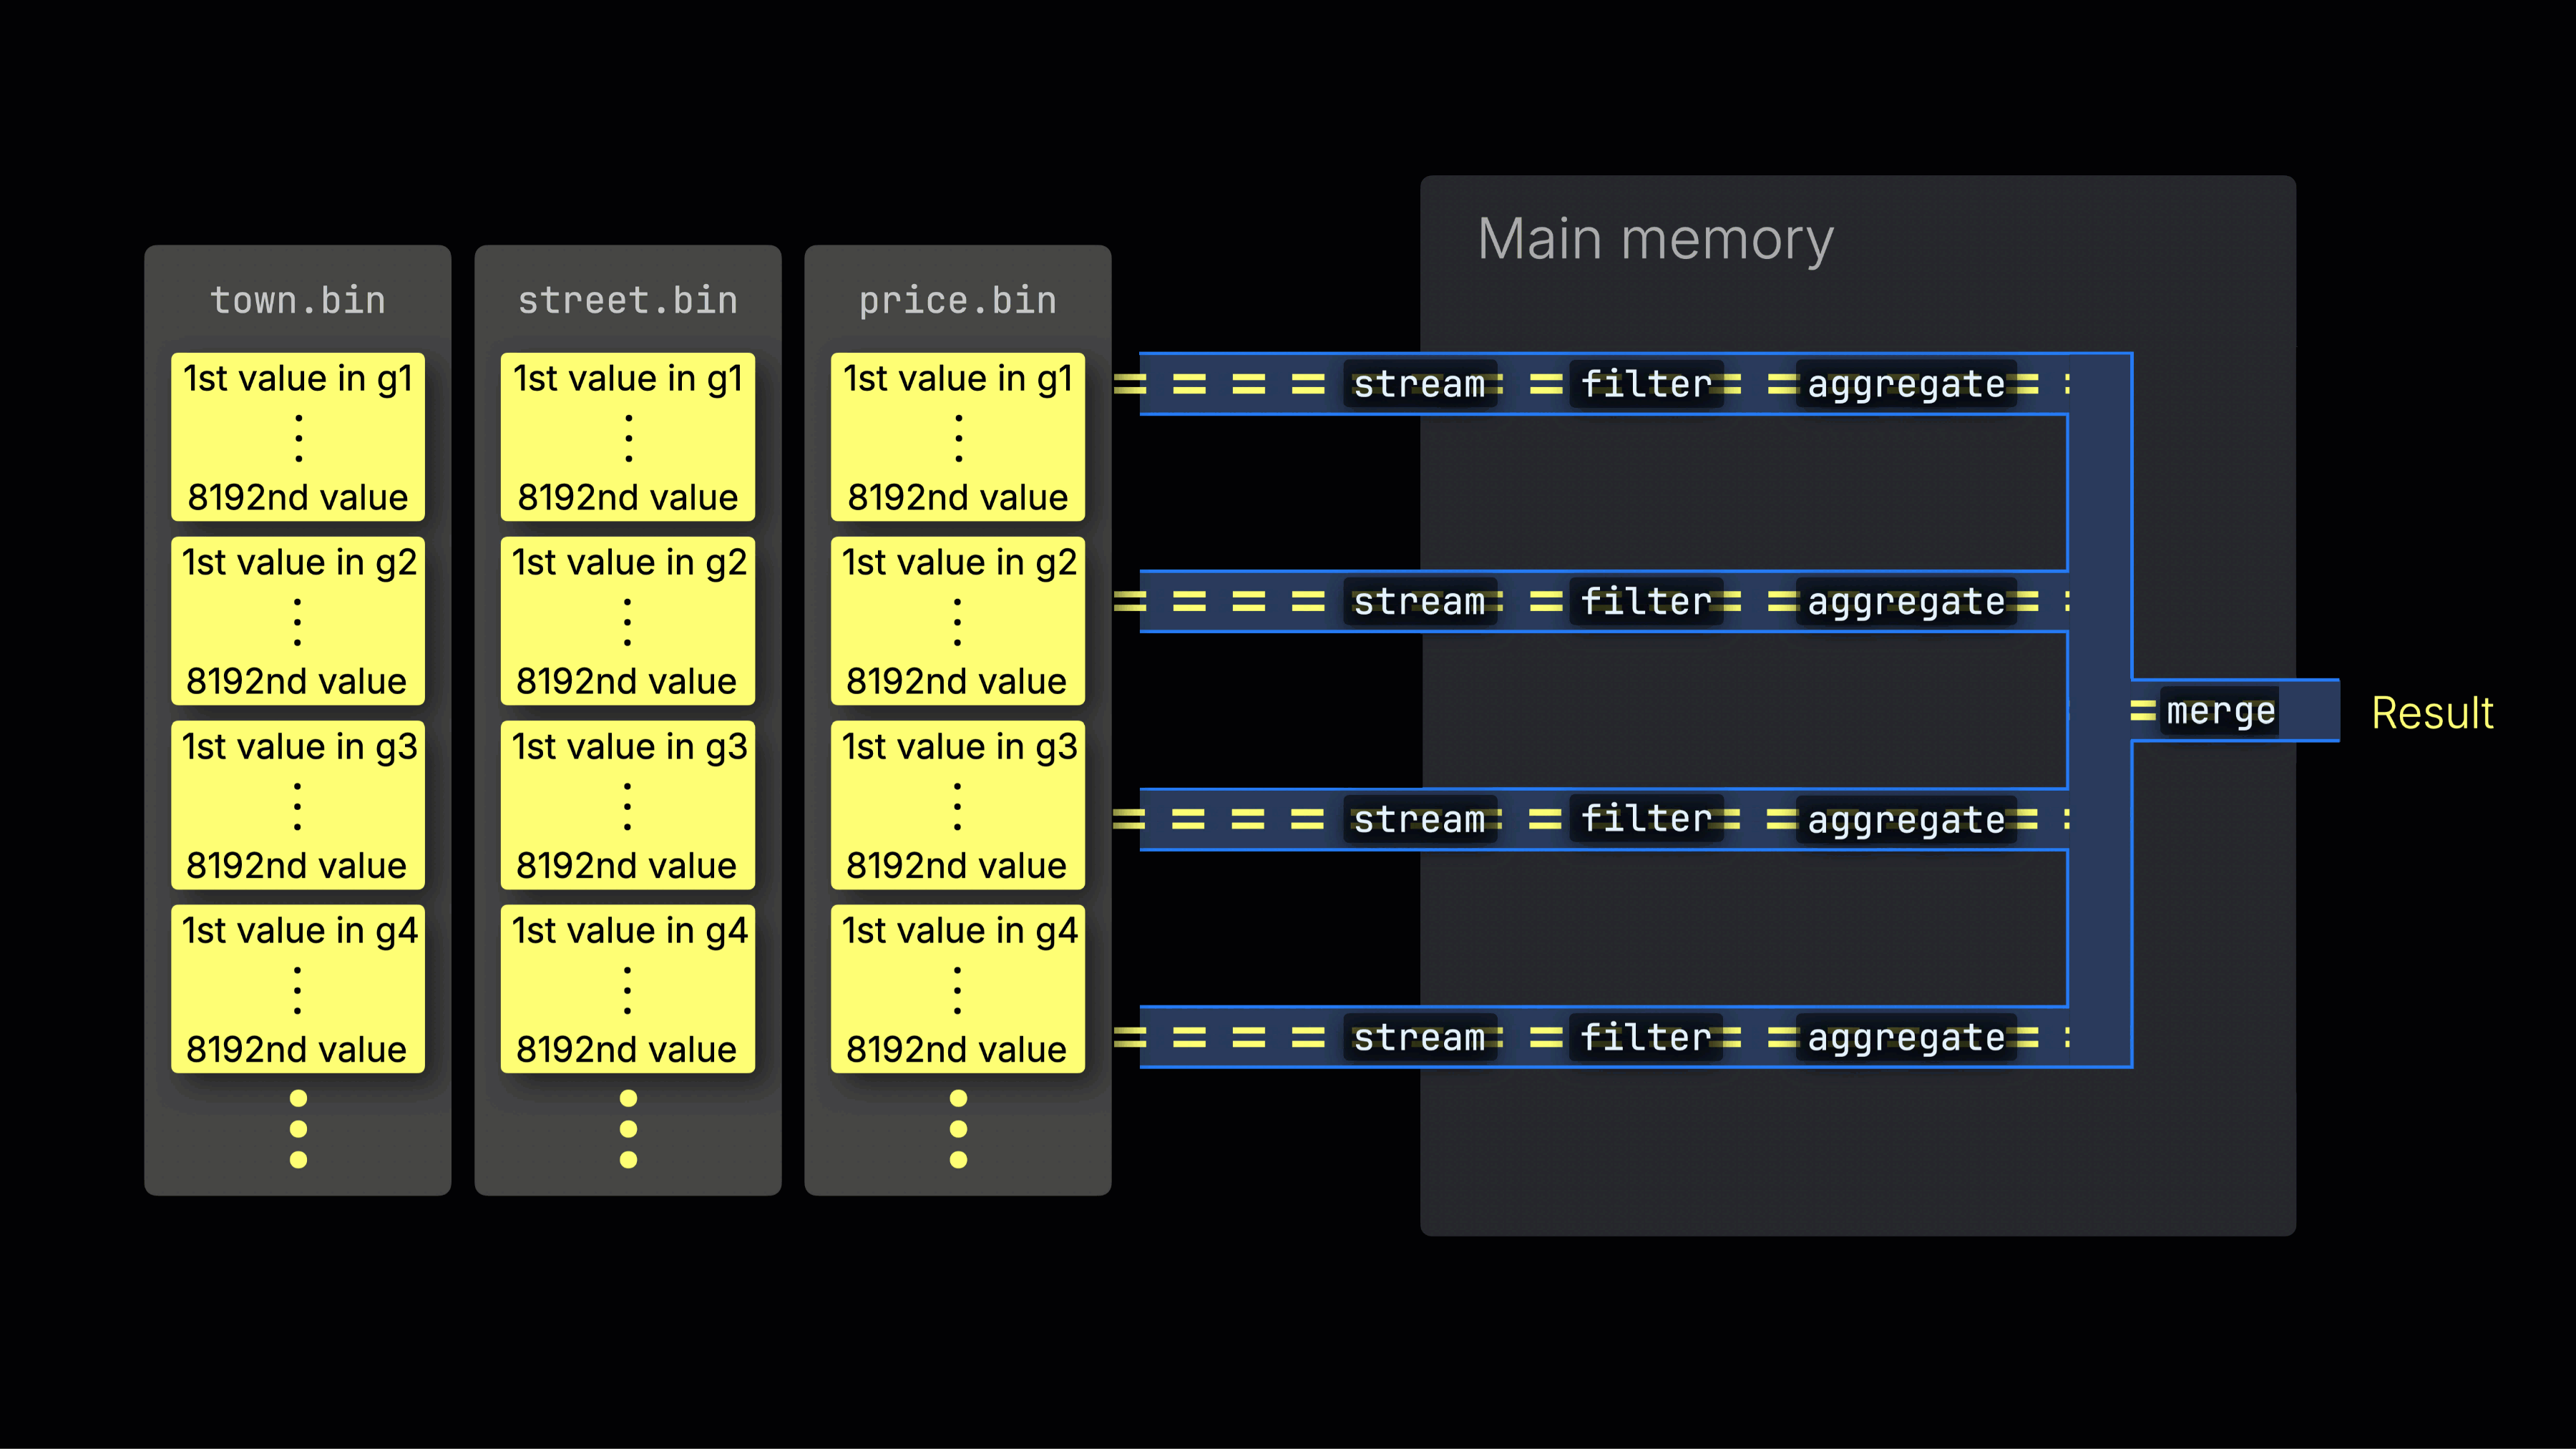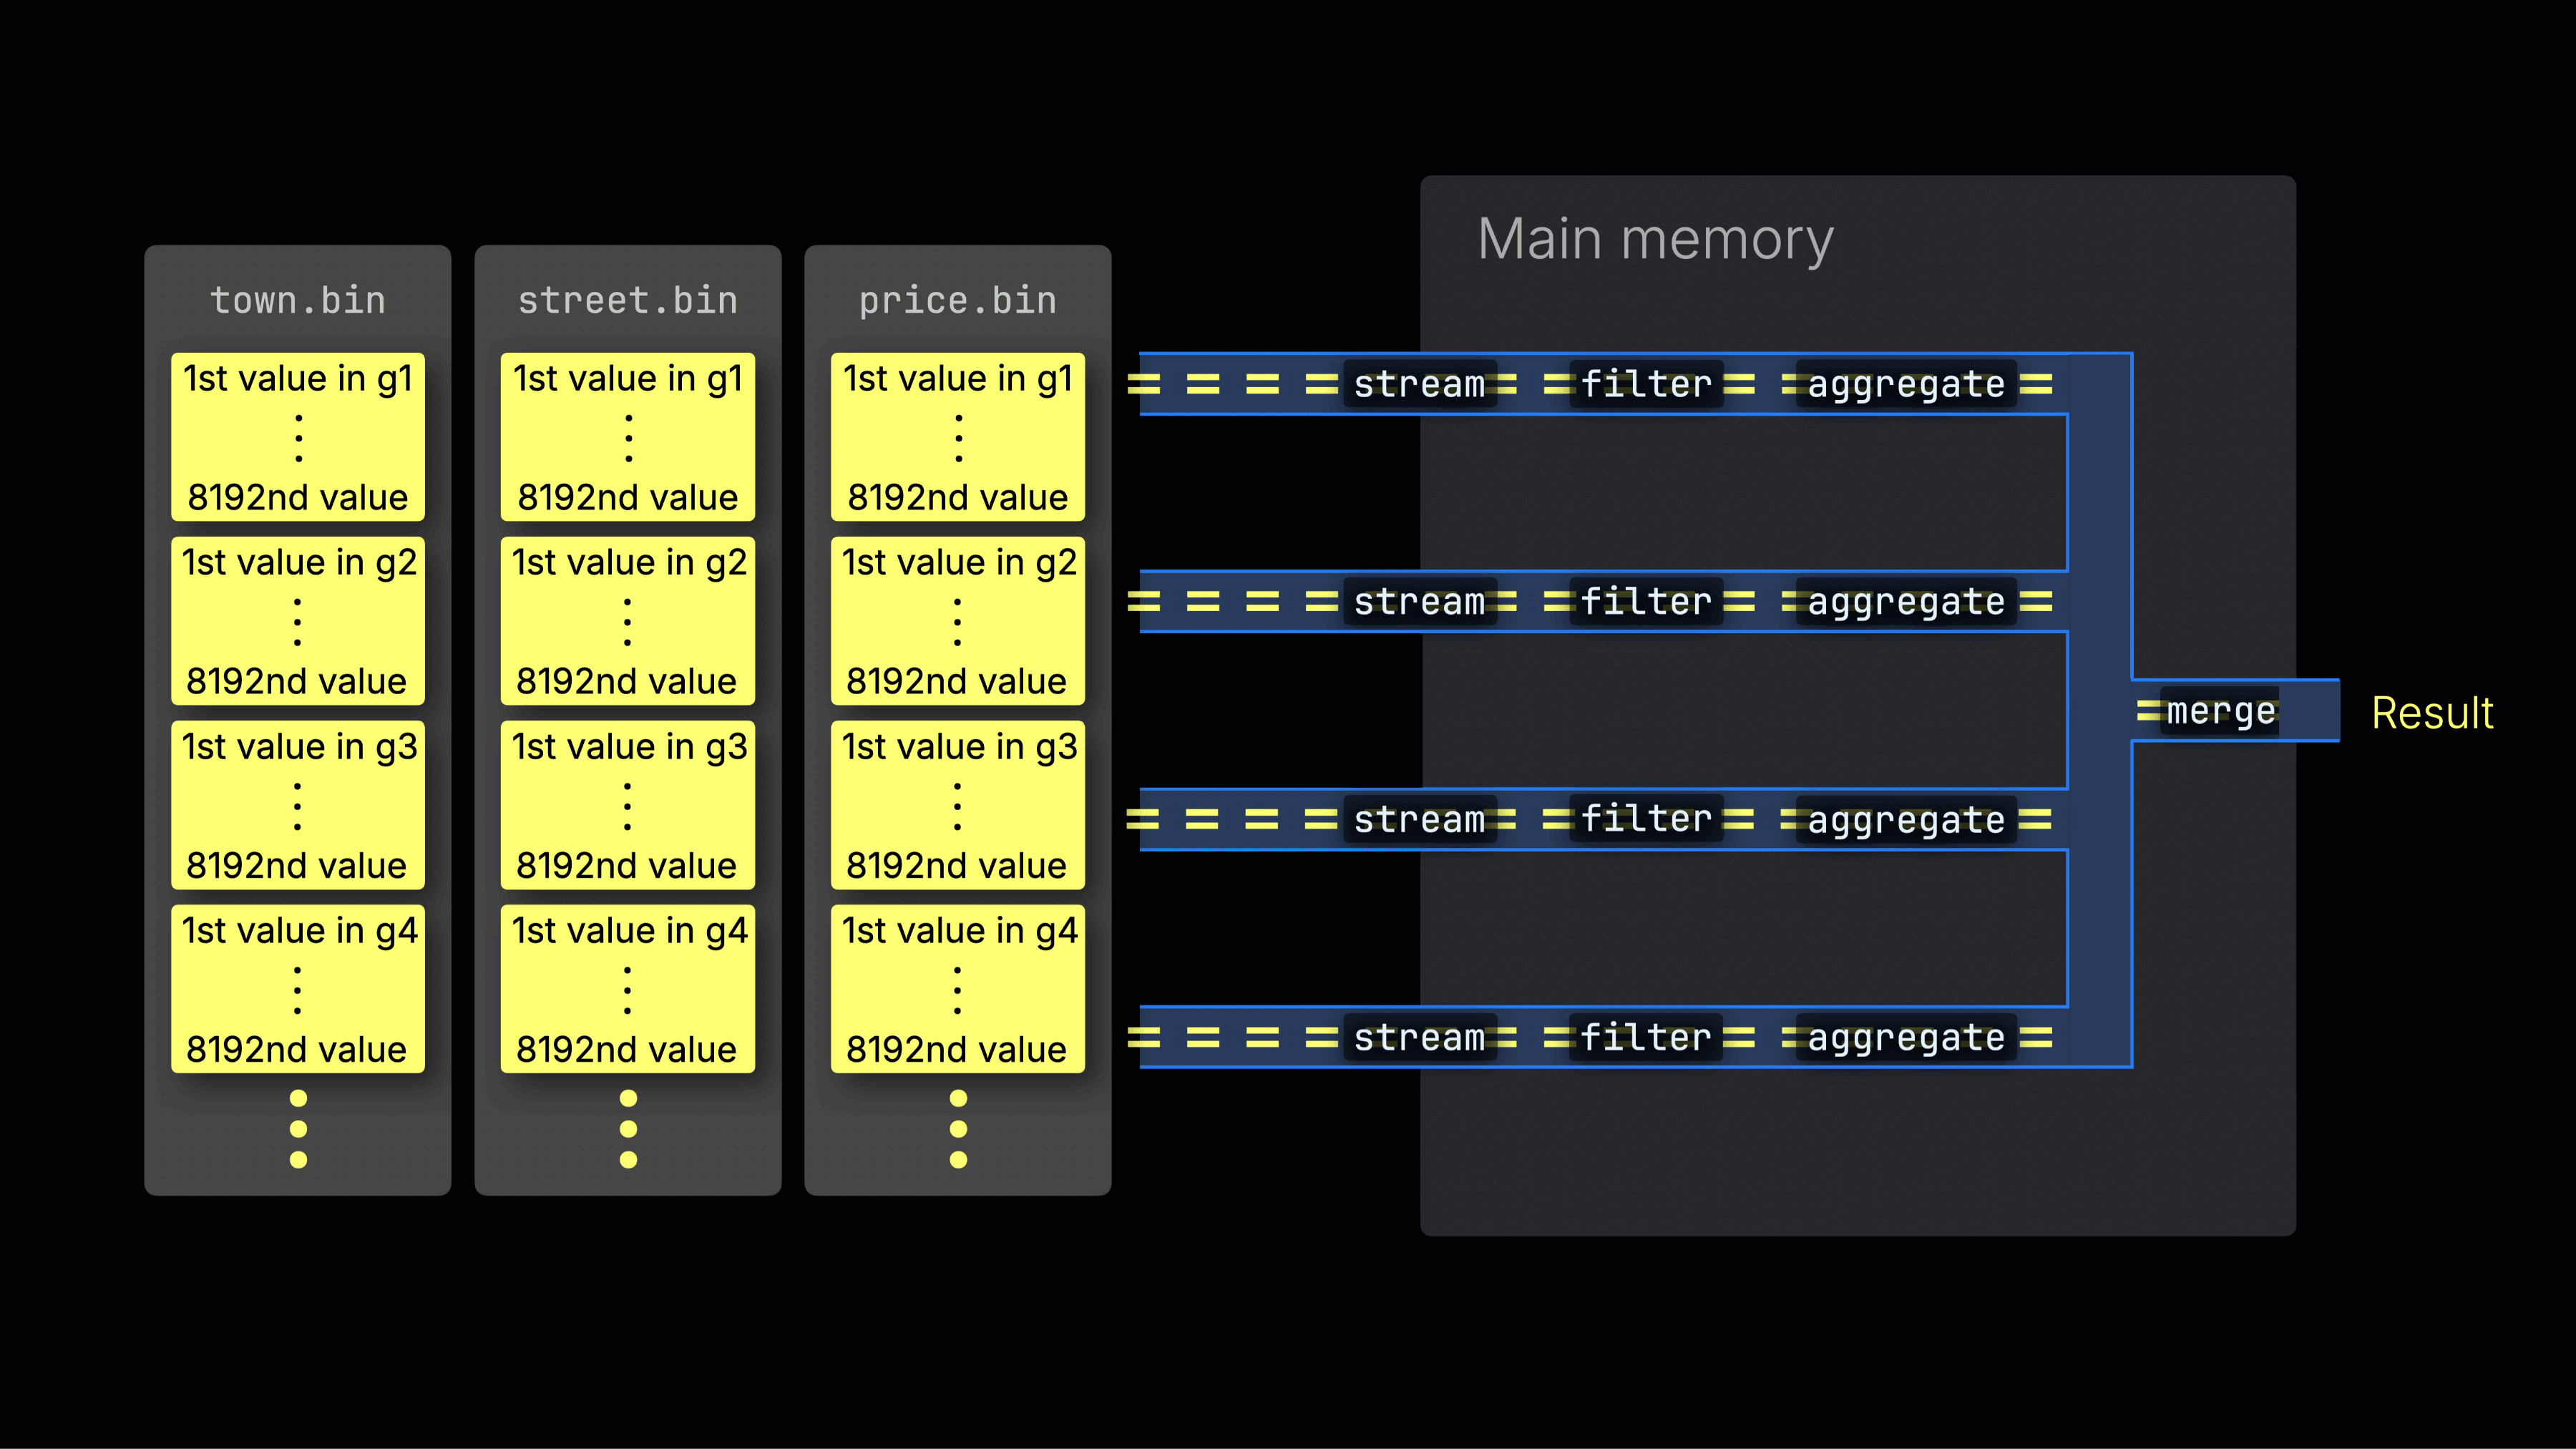
O número de
n lanes de processamento paralelas é controlado pela configuração max_threads, que, por padrão, corresponde ao número de núcleos (threads) de uma única CPU disponíveis ao ClickHouse no servidor. No exemplo acima, assumimos 4 núcleos.
Em uma máquina com 8 núcleos, a taxa de processamento de consultas praticamente dobraria (mas o uso de memória também aumentaria na mesma proporção), já que mais lanes processam dados em paralelo:
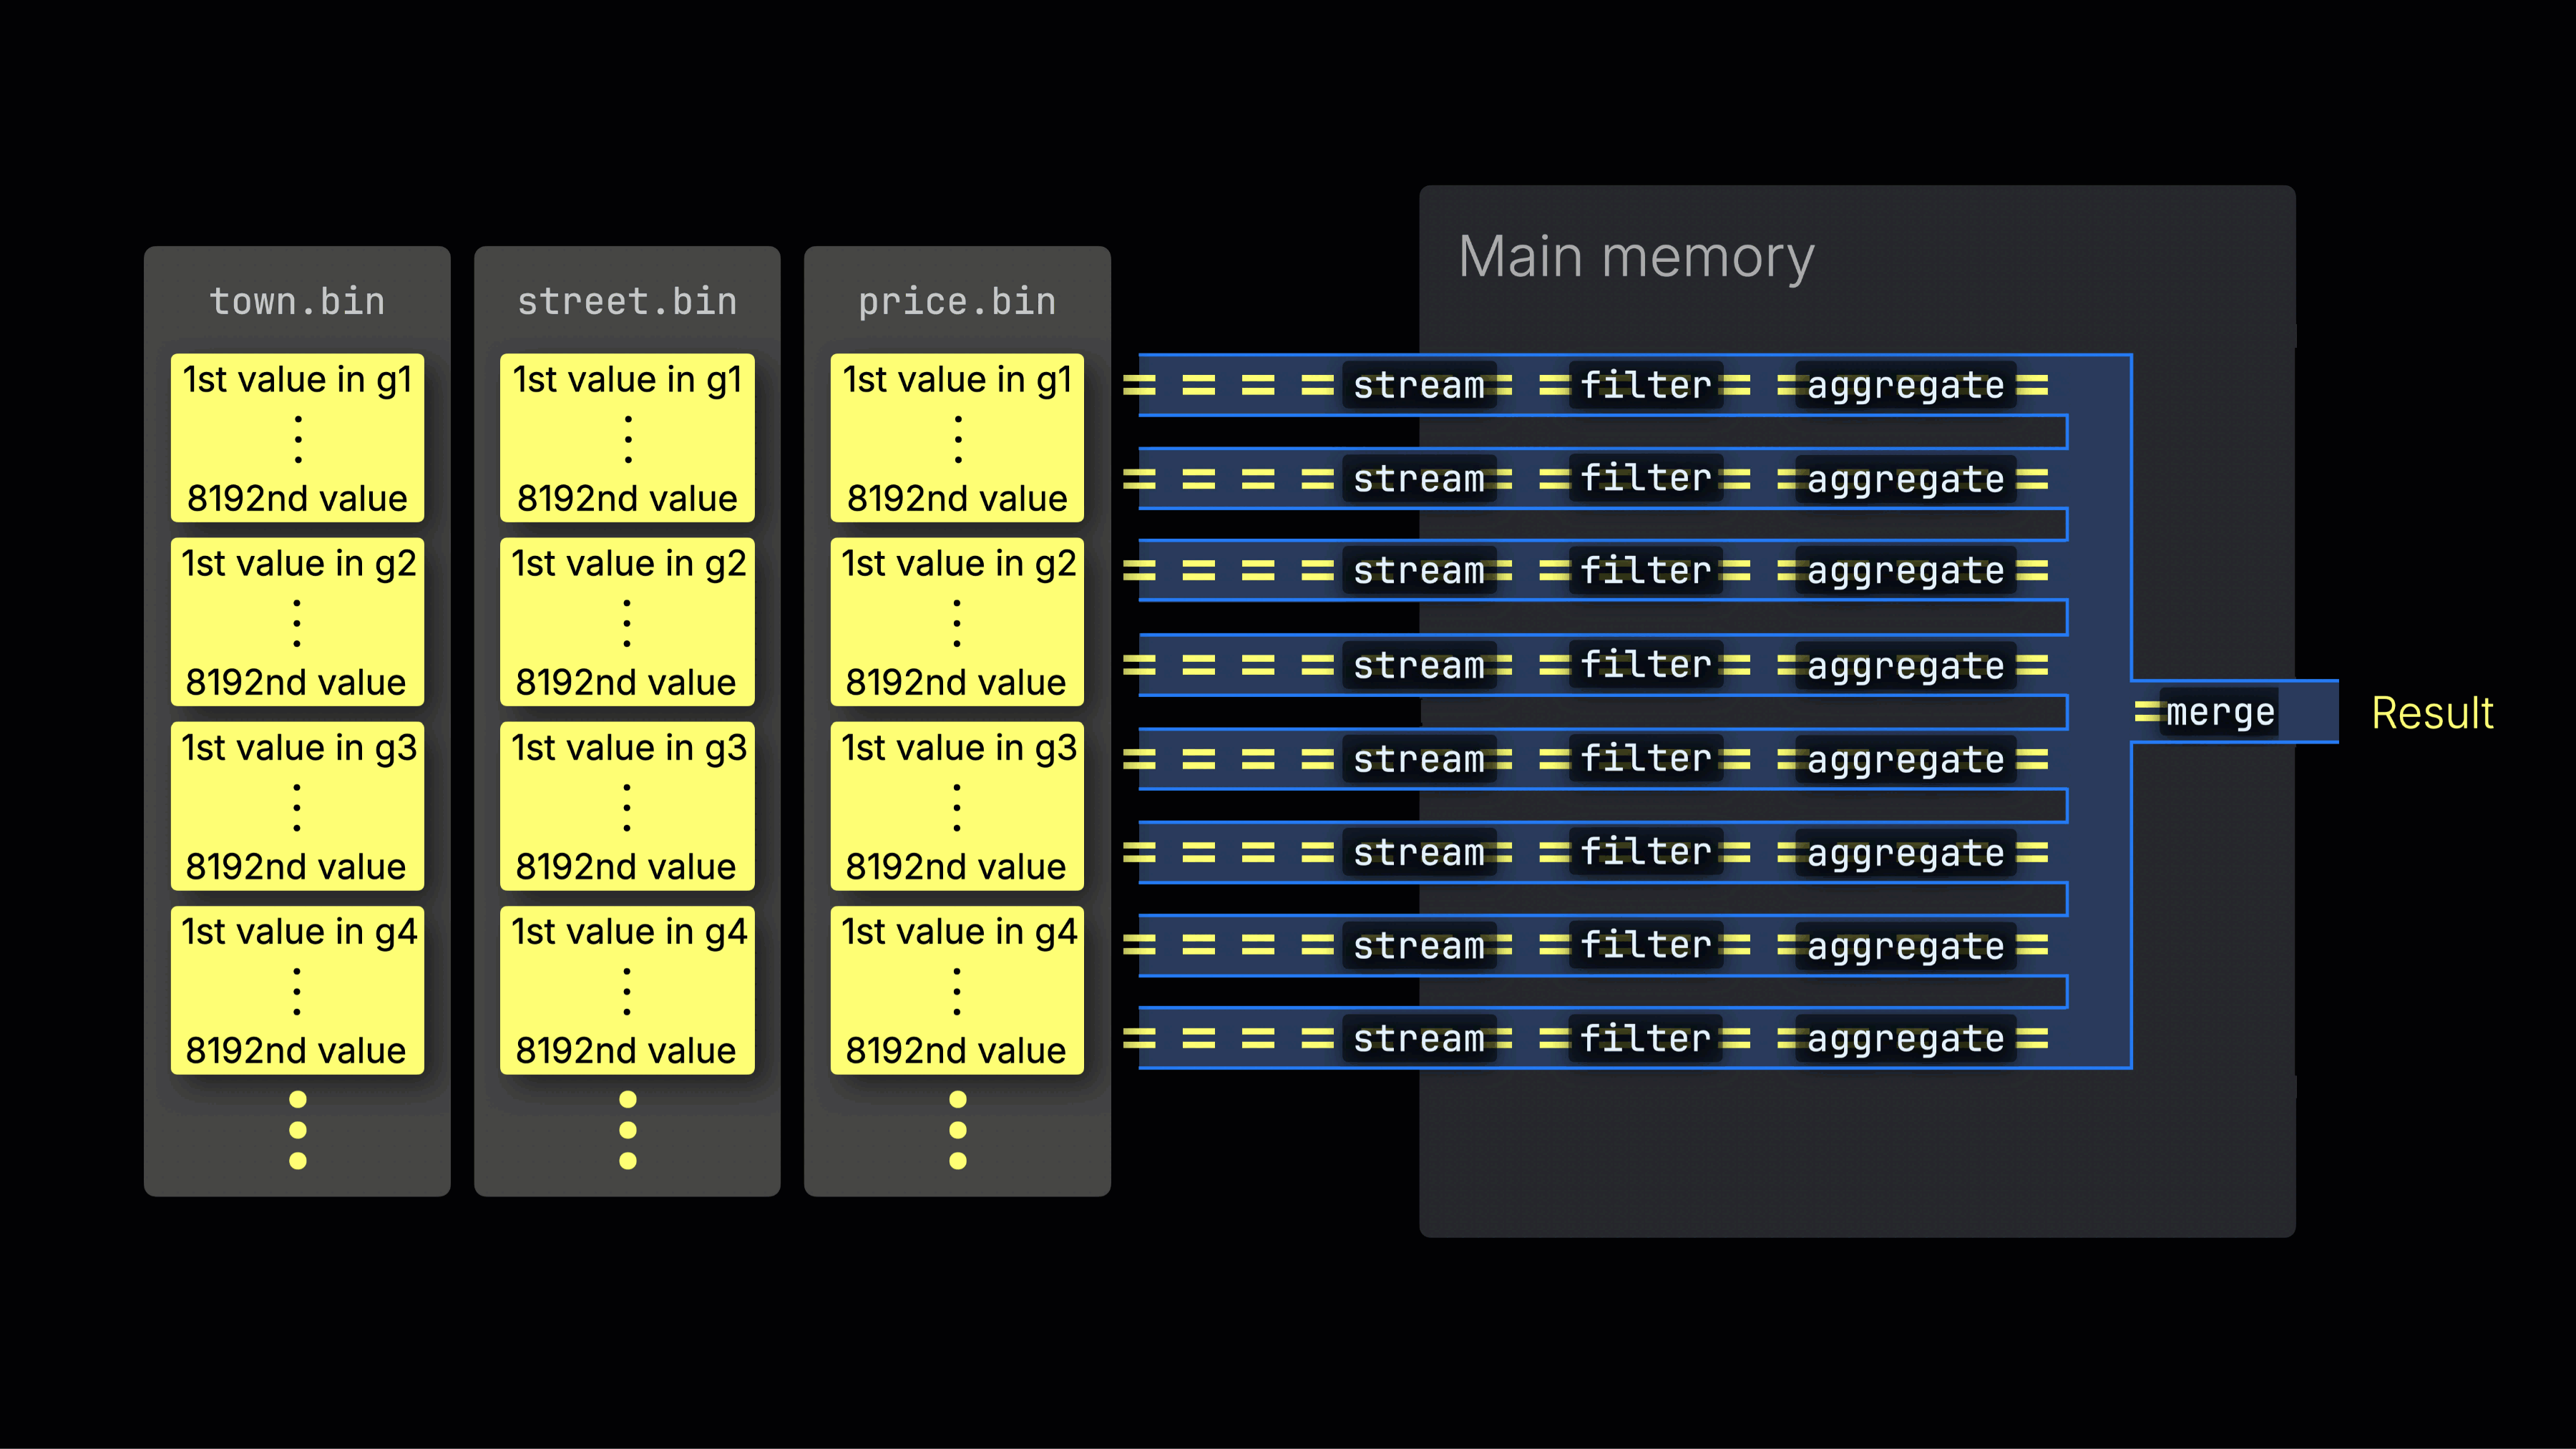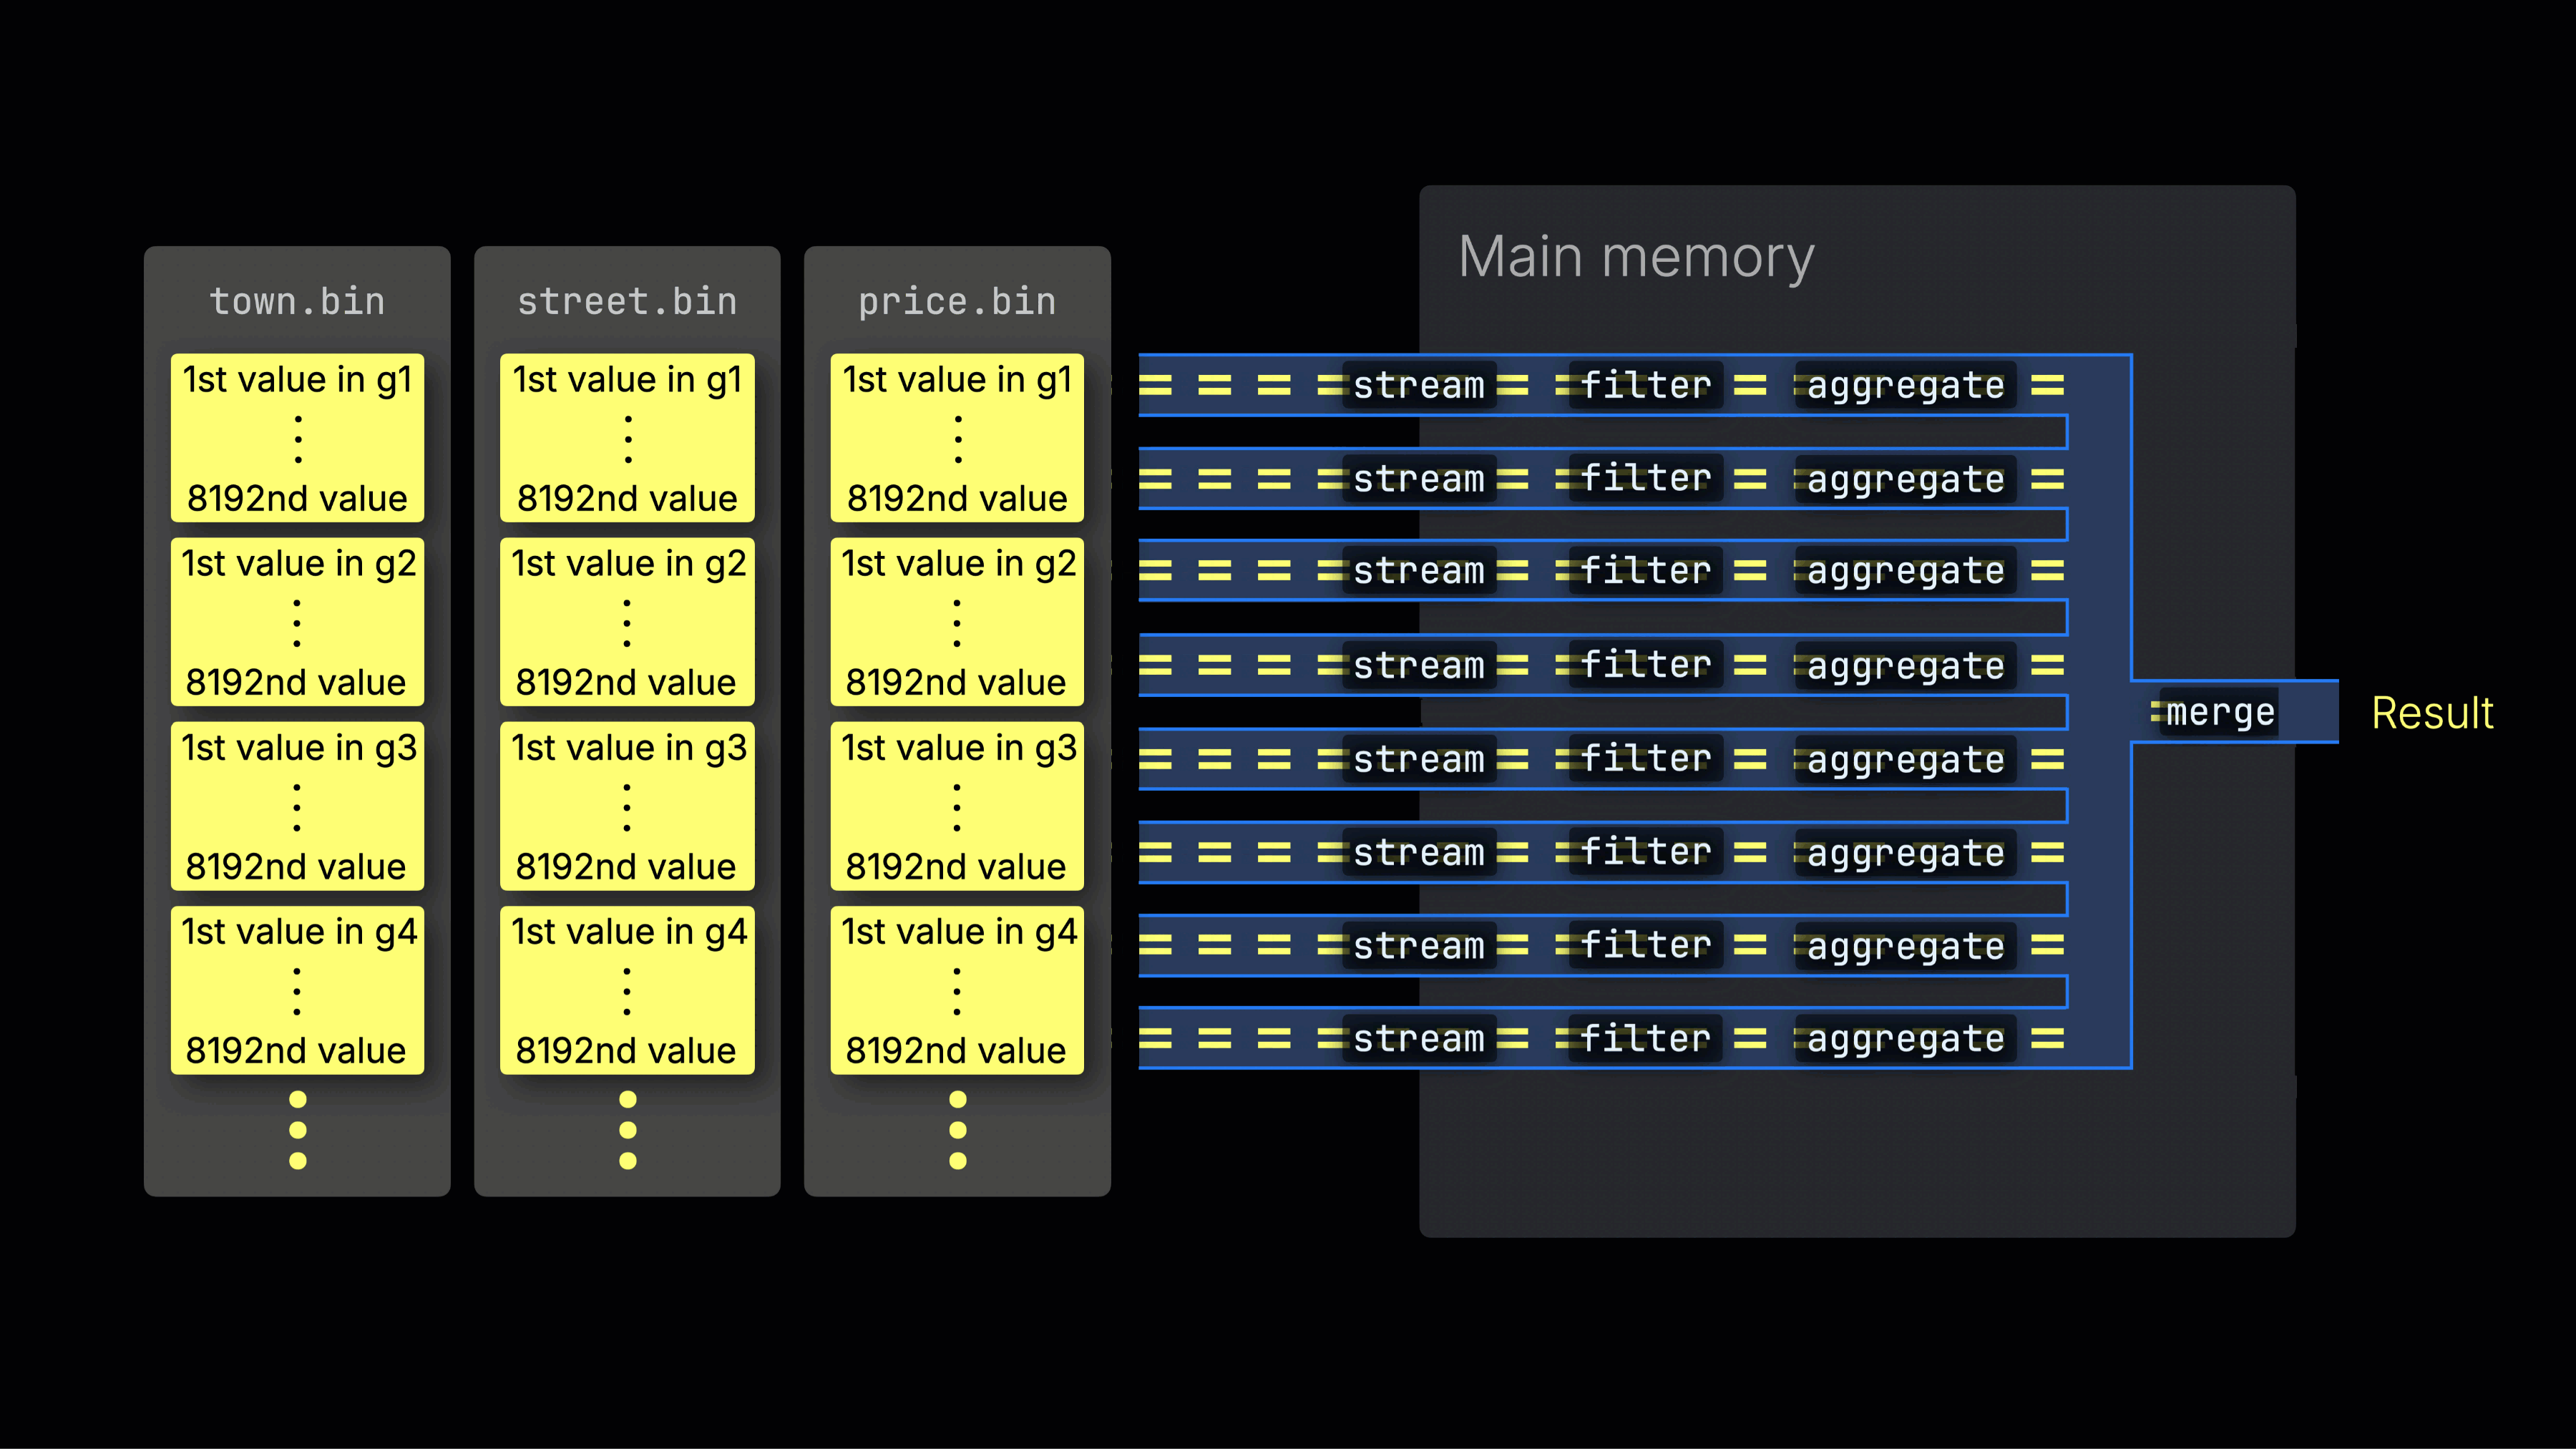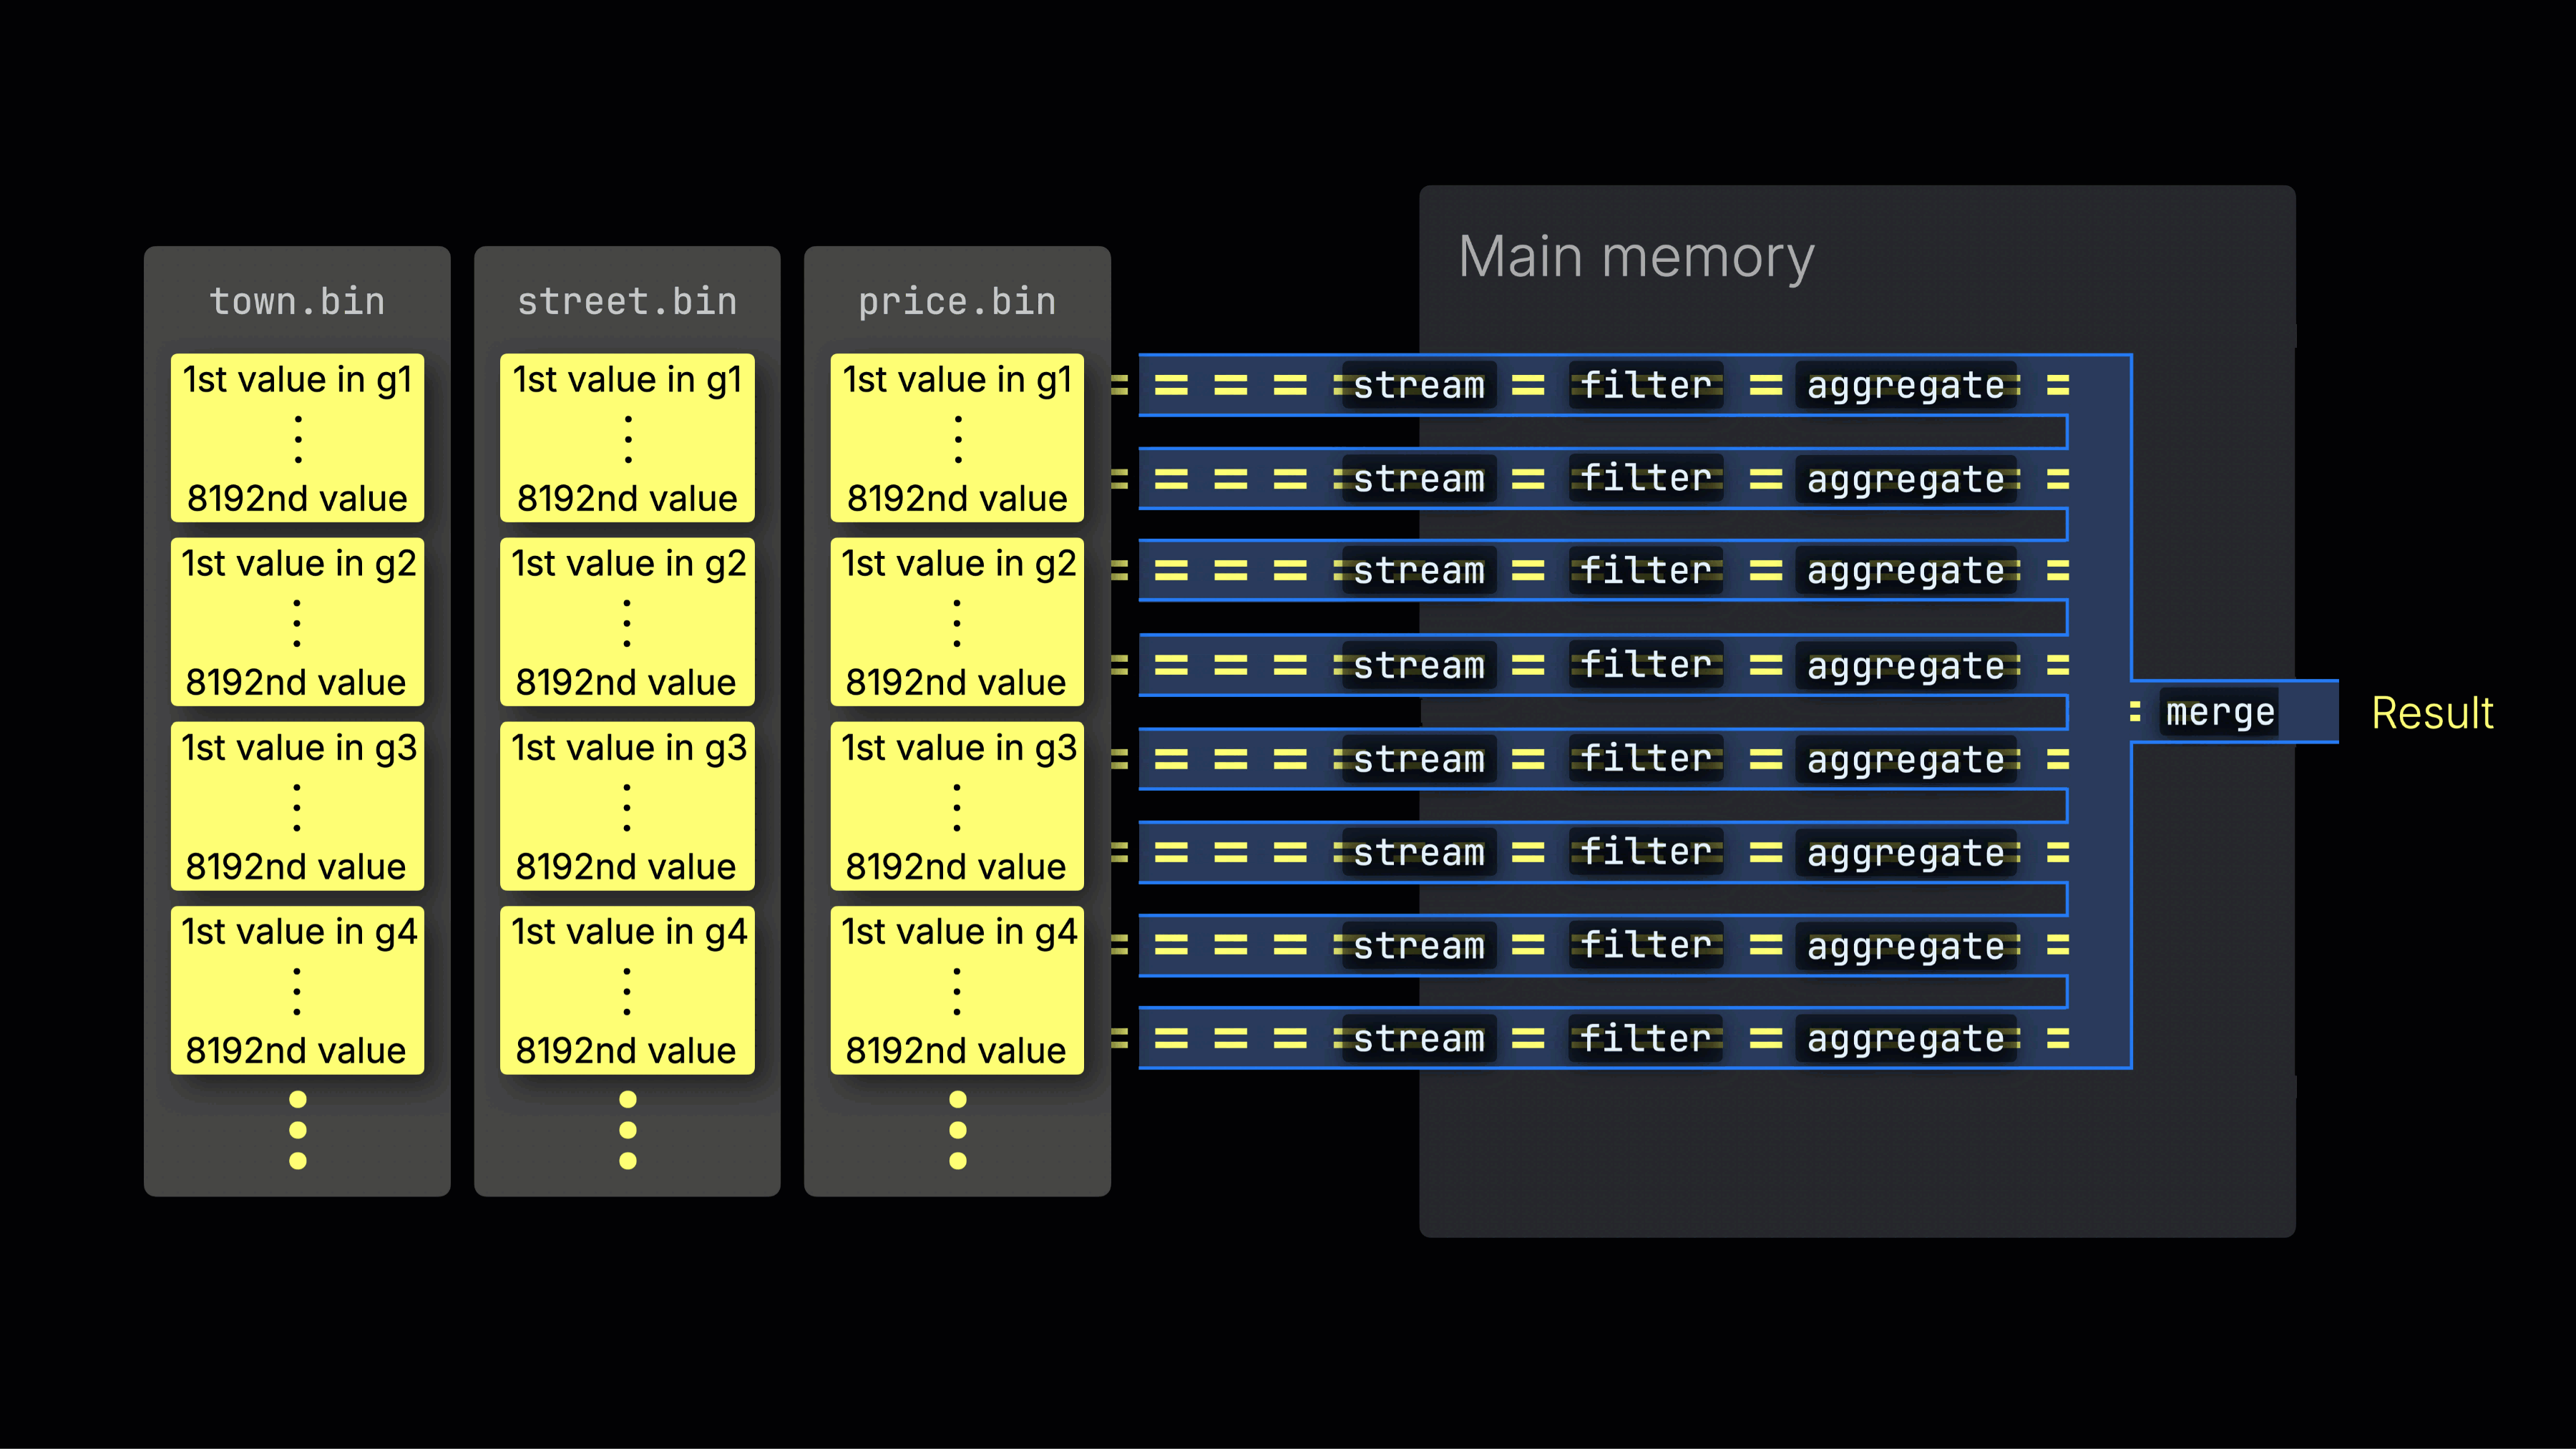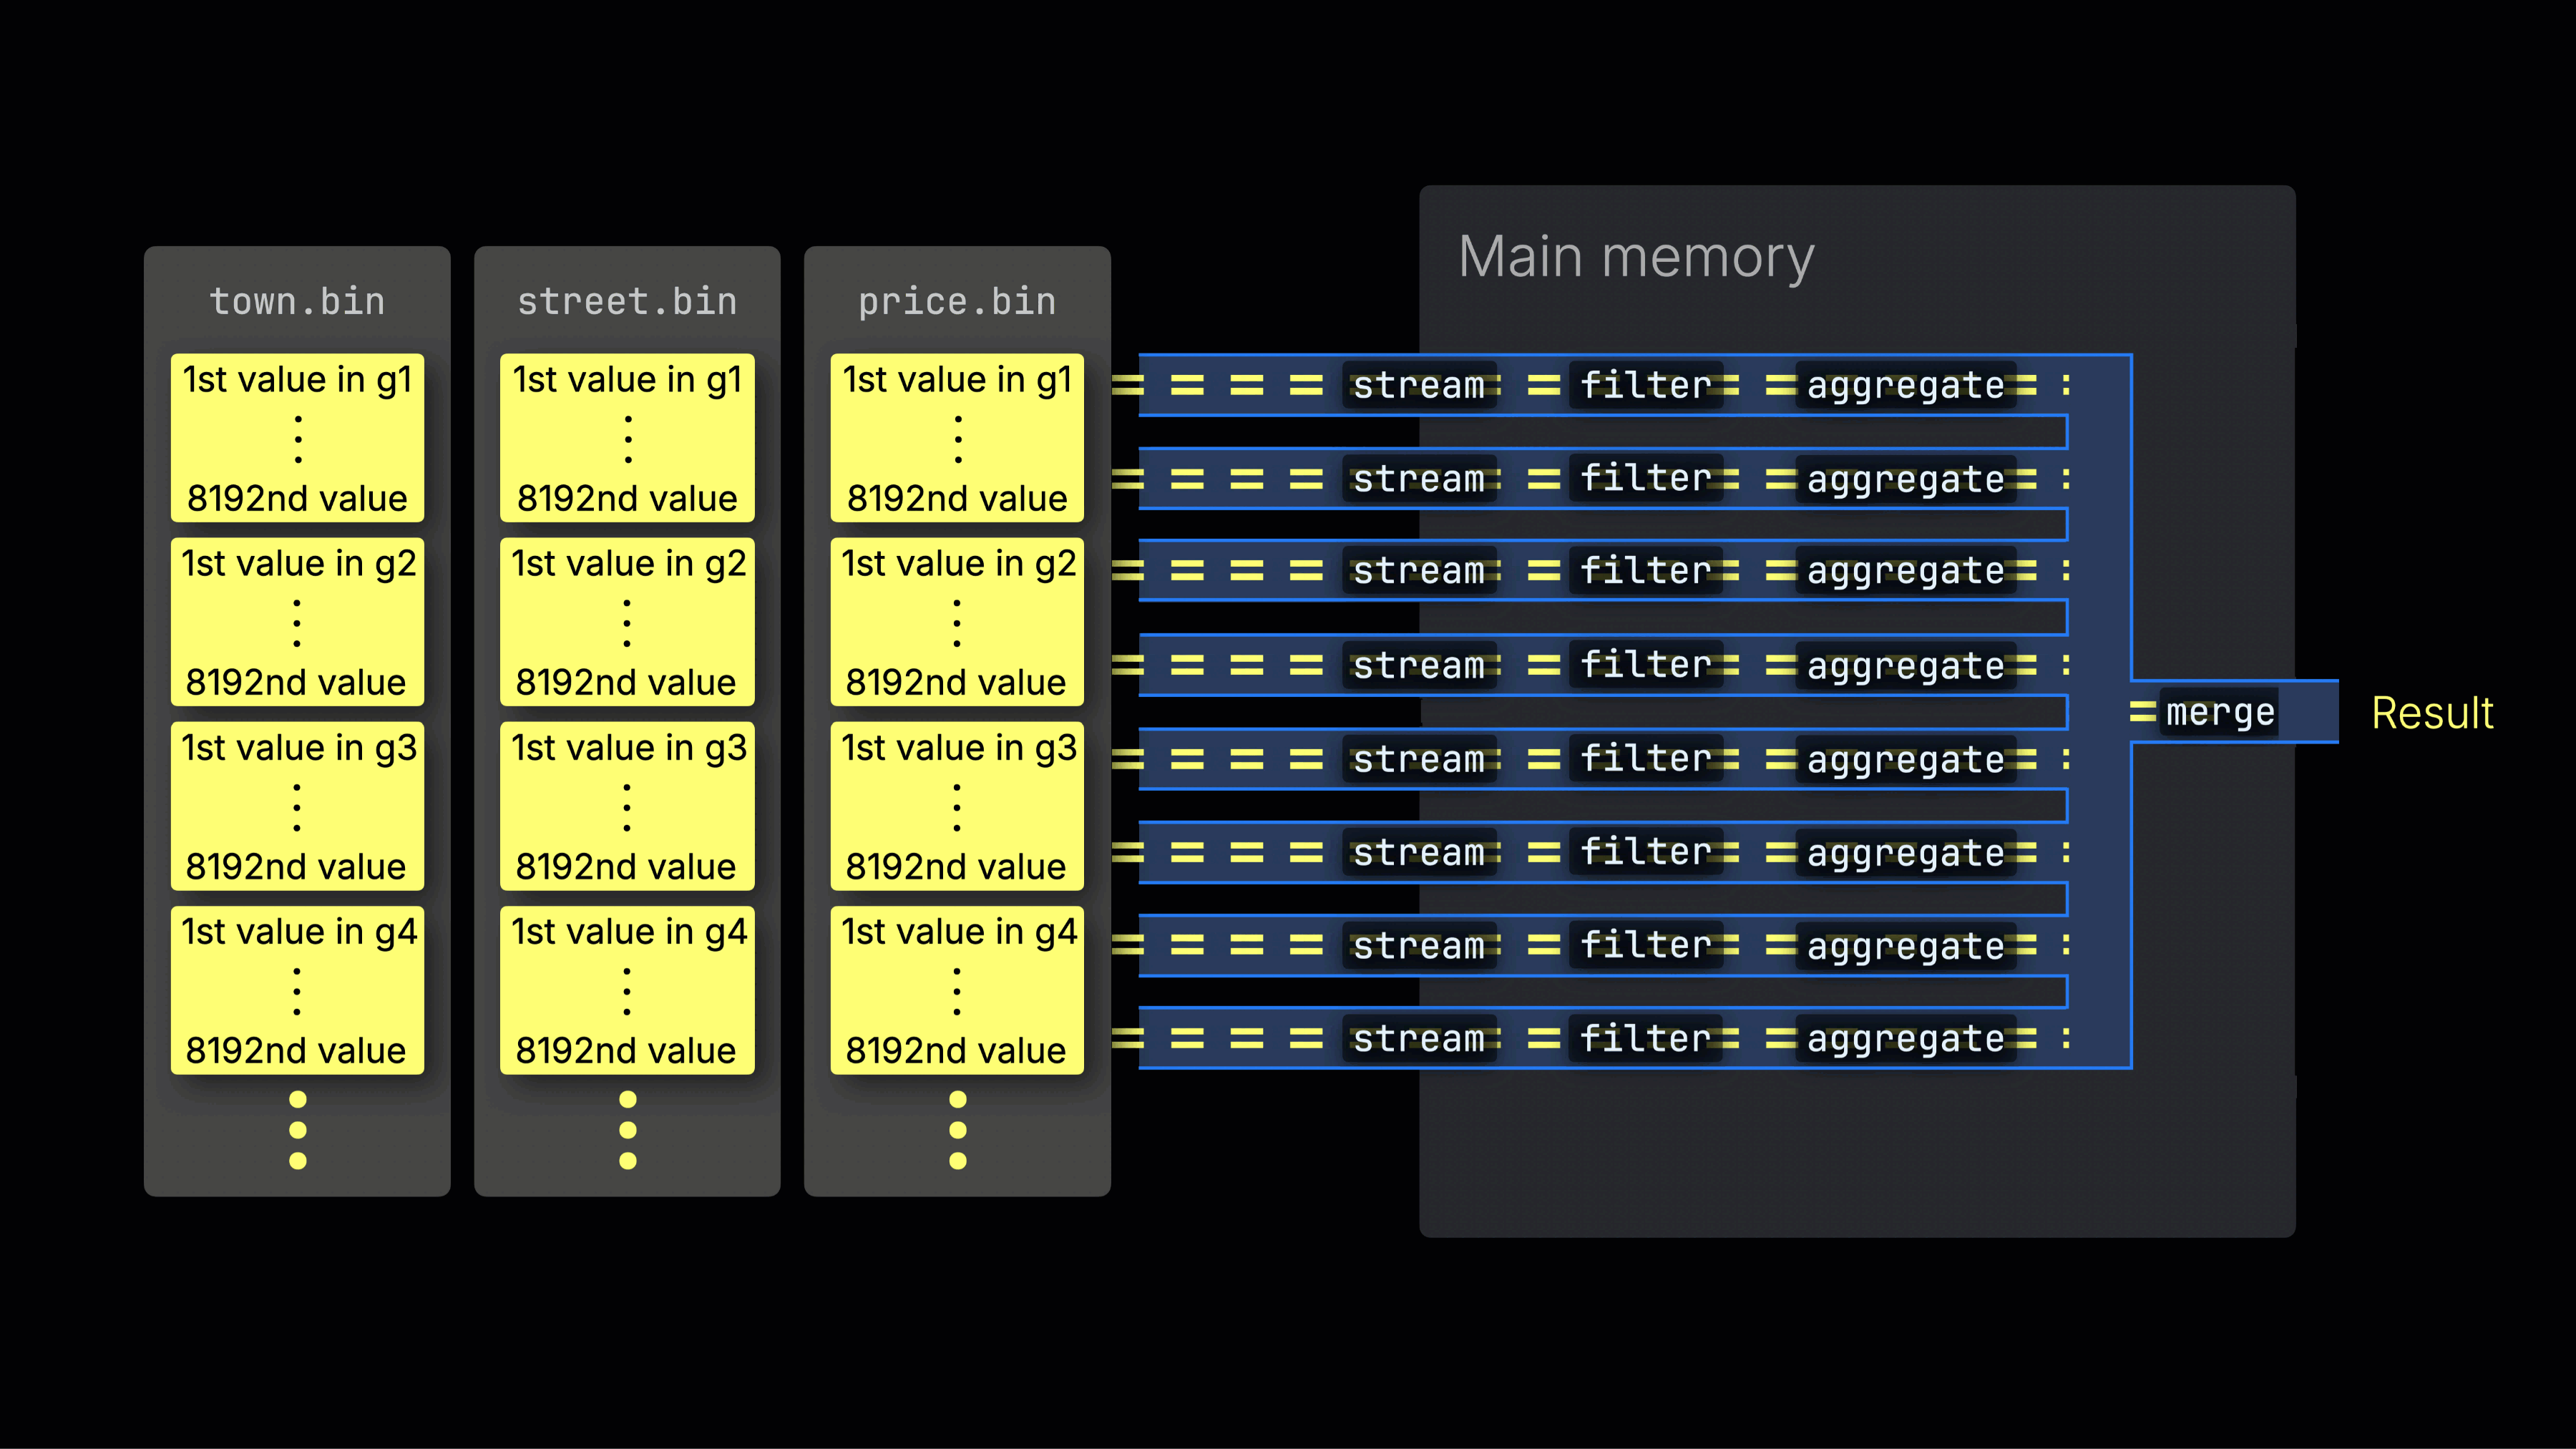
Uma distribuição eficiente das lanes é fundamental para maximizar a utilização da CPU e reduzir o tempo total da consulta. Quando os dados da tabela são distribuídos entre vários servidores em shards, cada servidor processa seu shard em paralelo. Em cada servidor, os dados locais são tratados usando lanes de processamento em paralelo, exatamente como descrito acima:
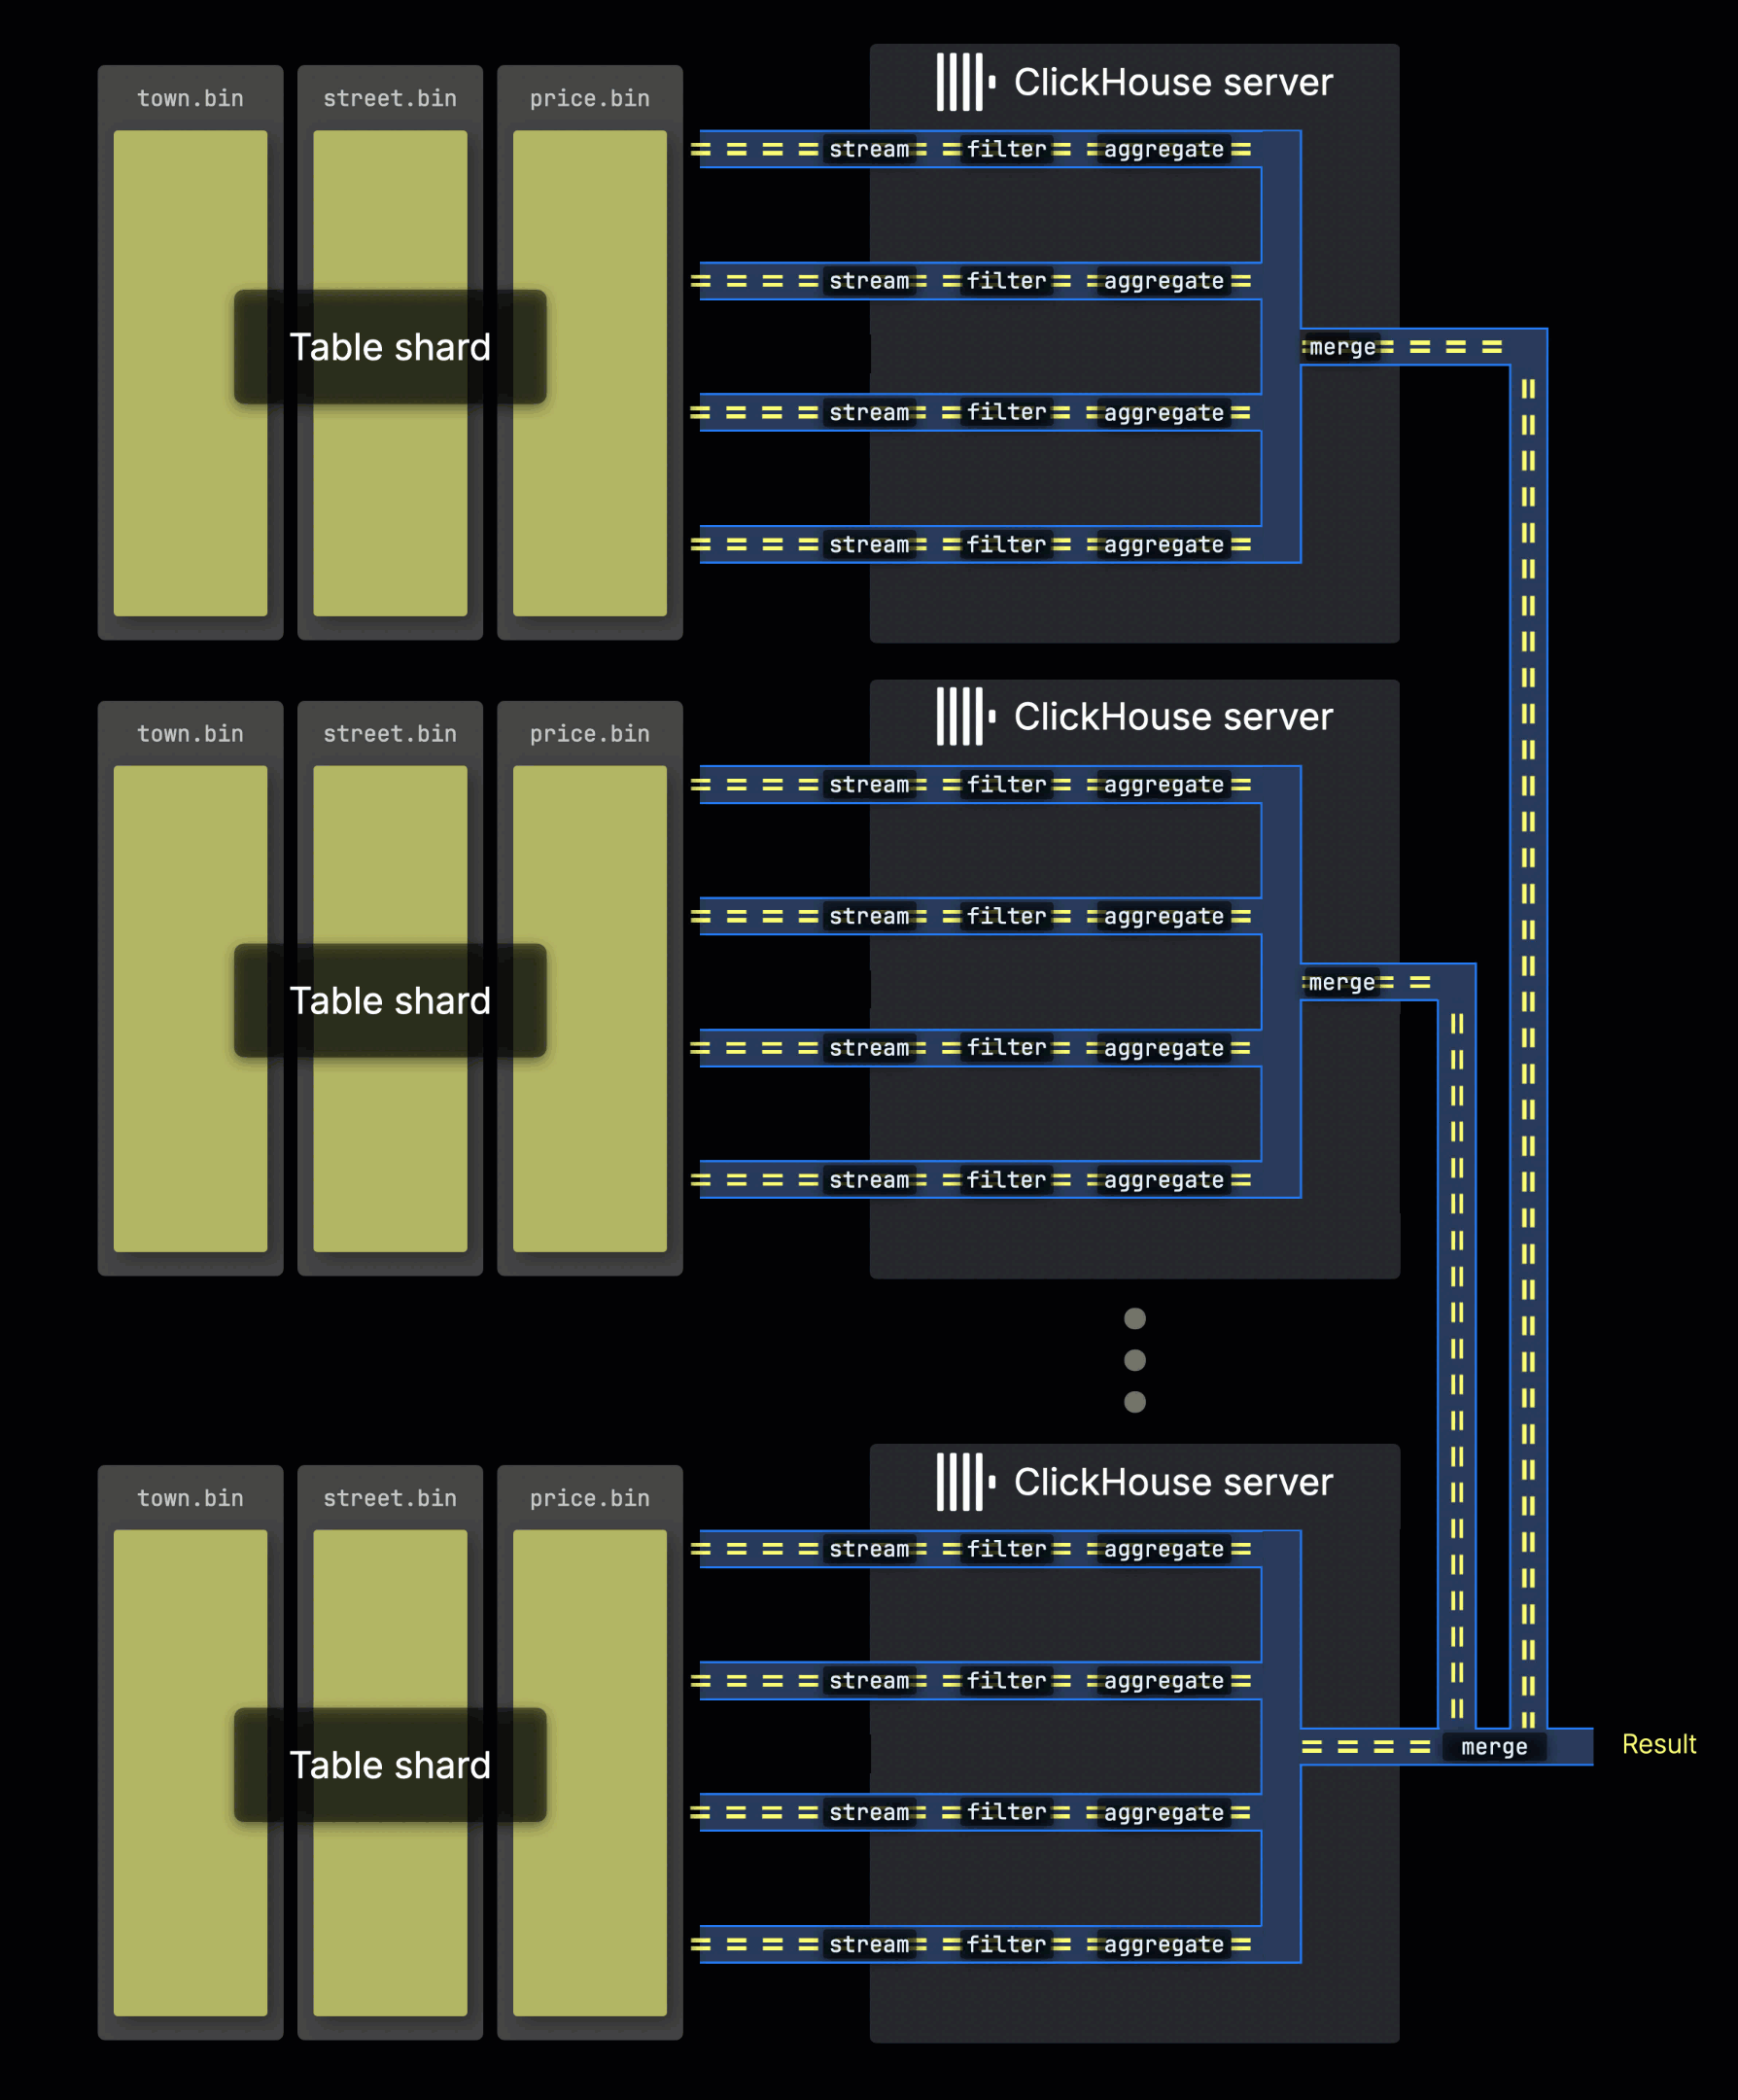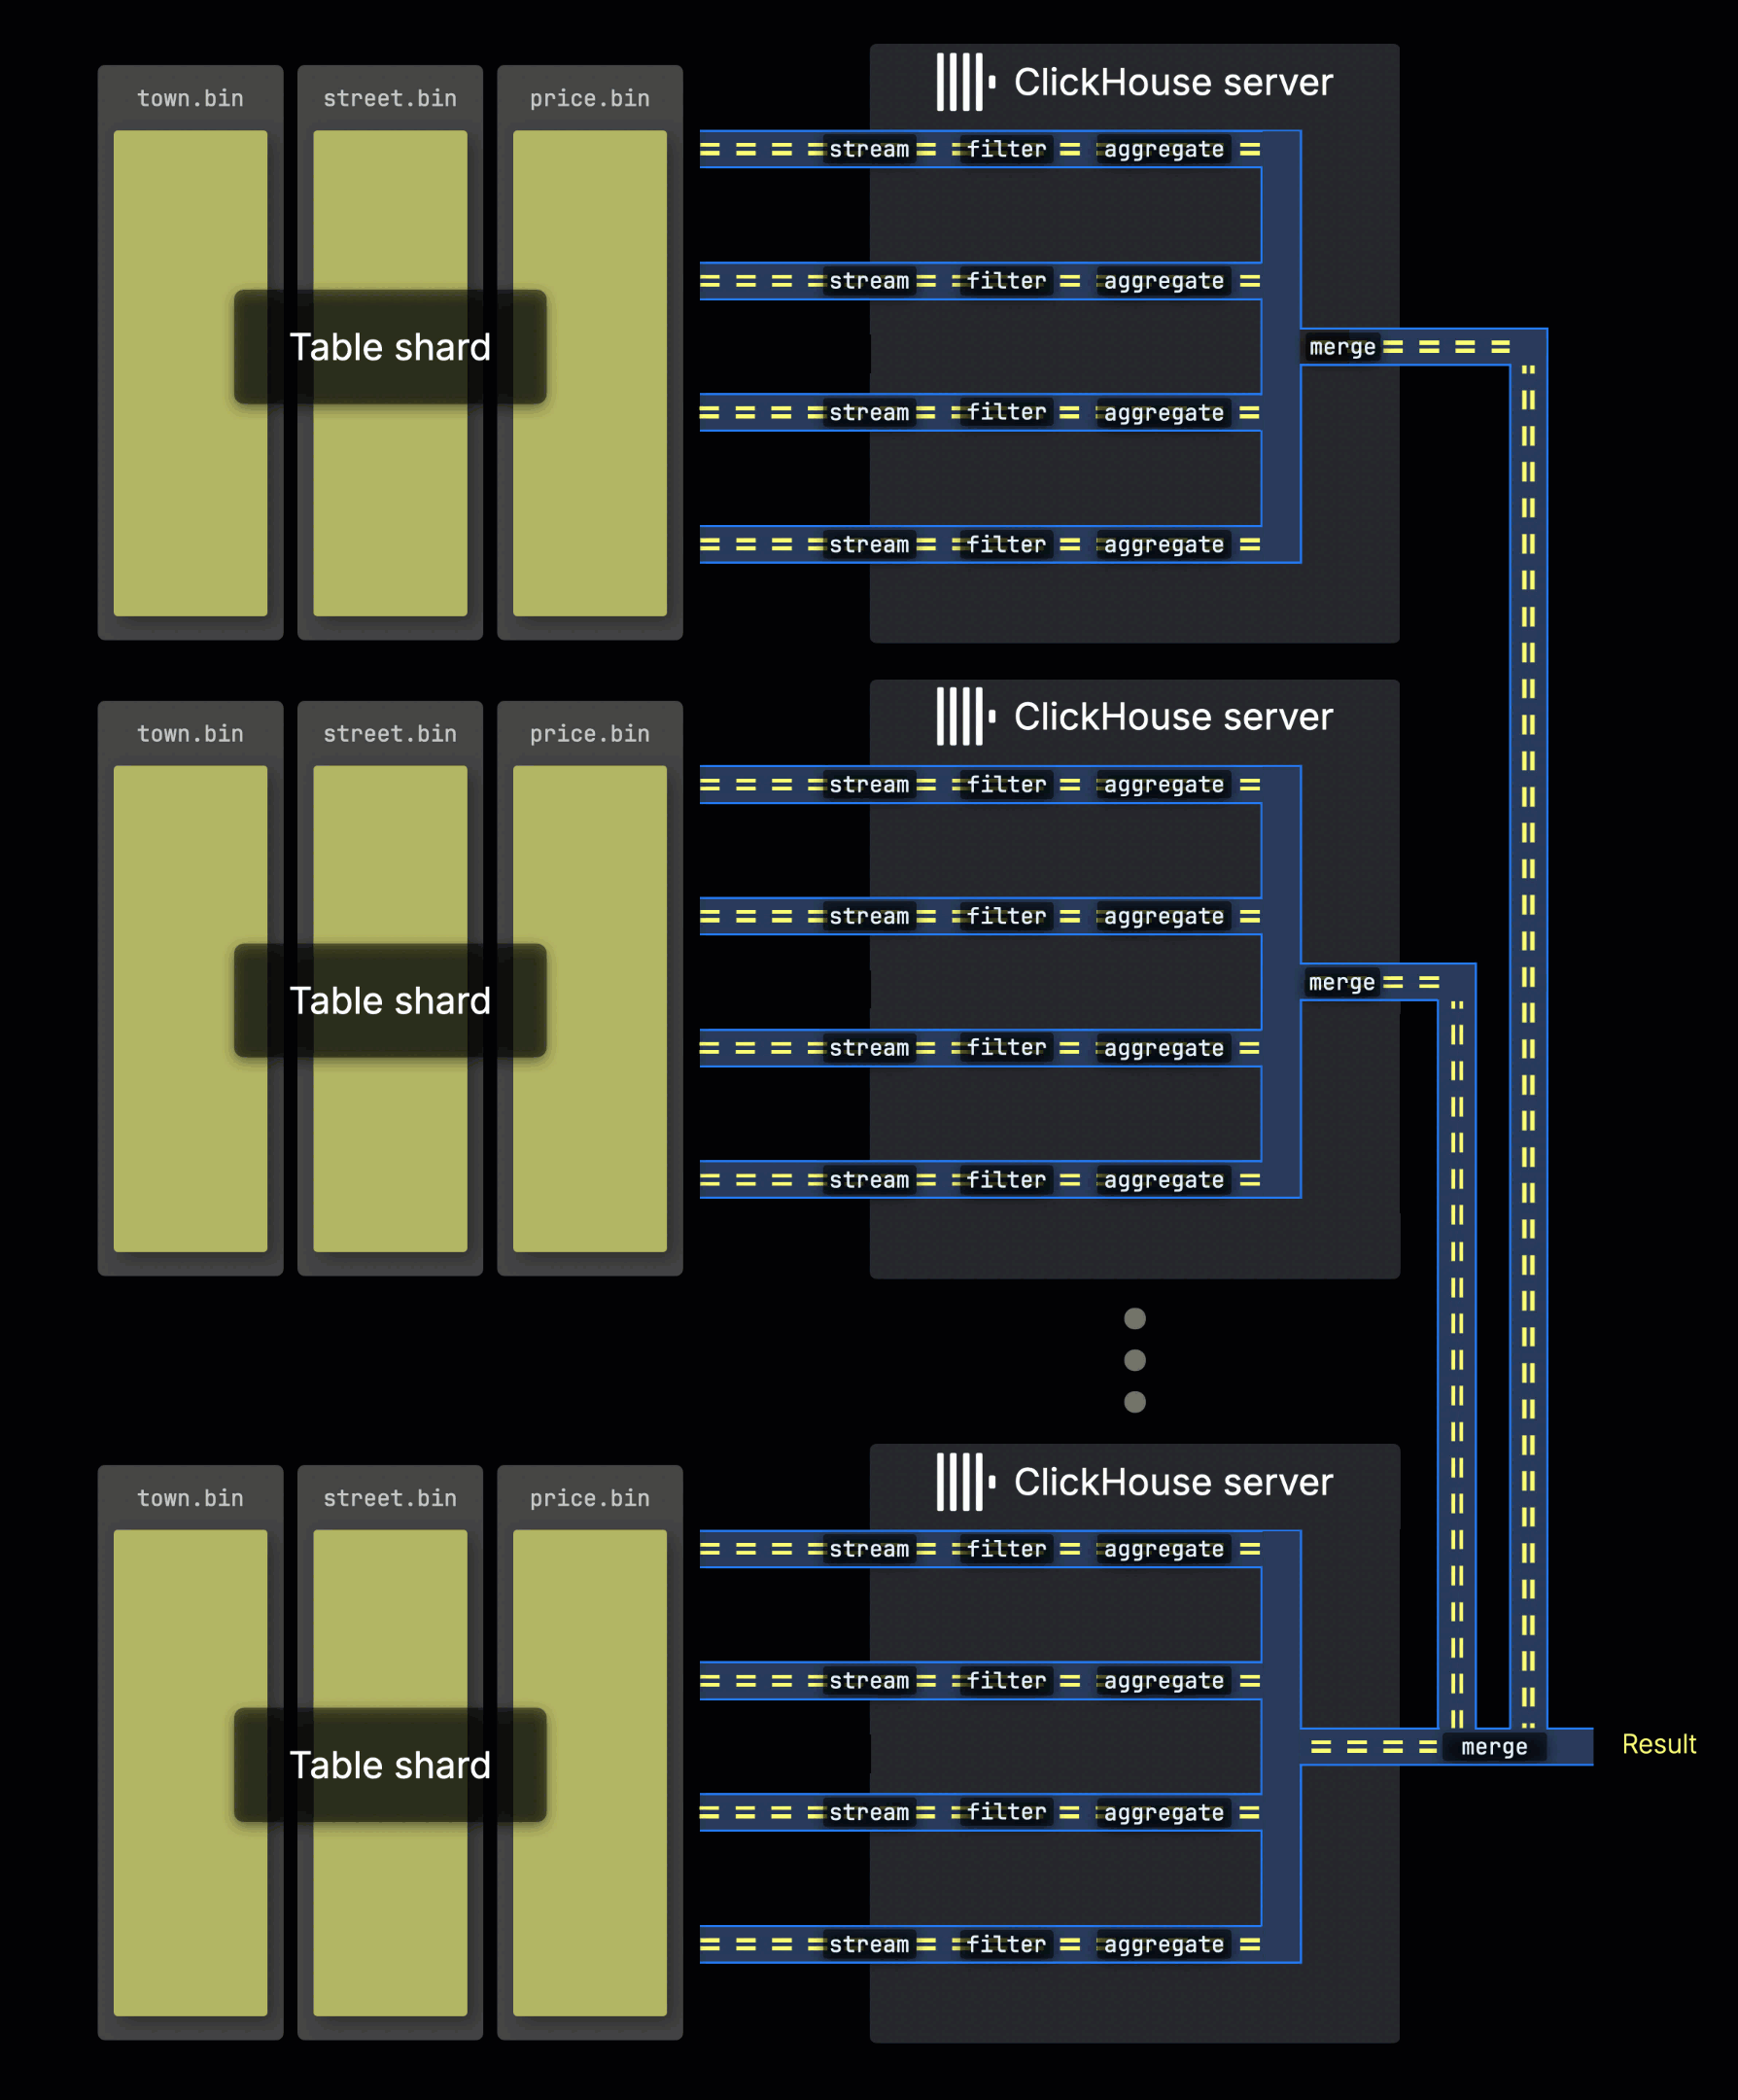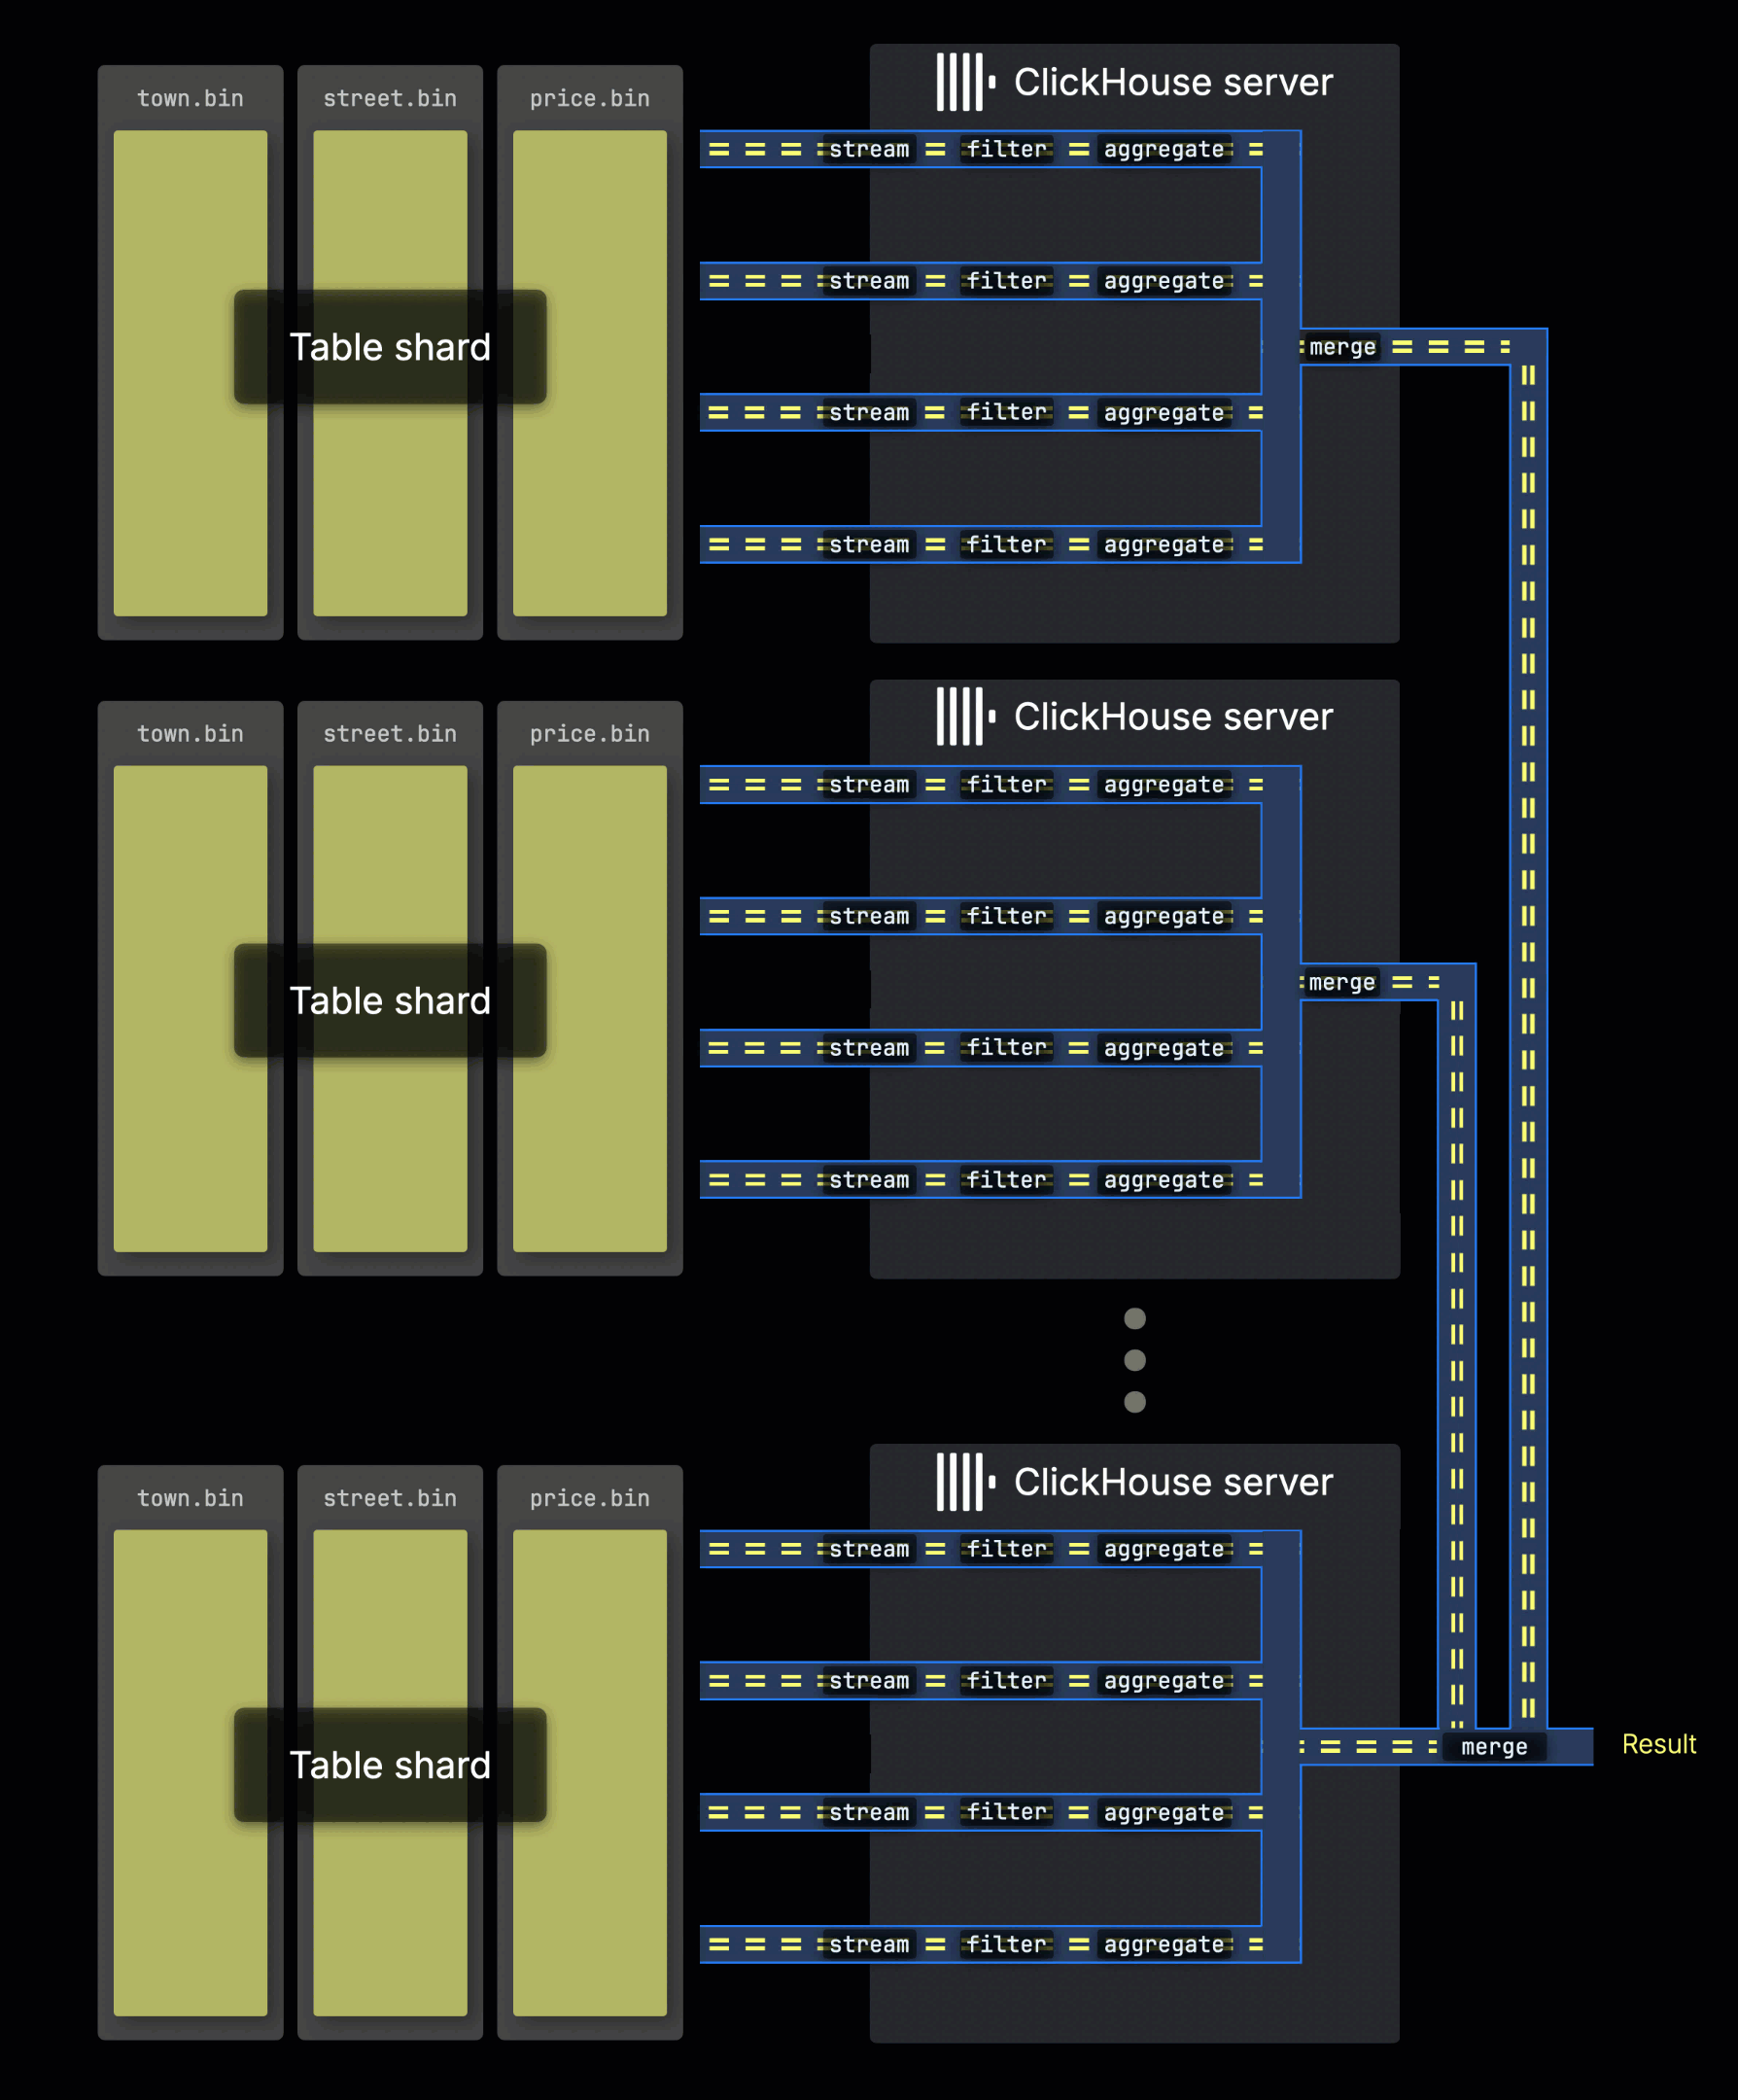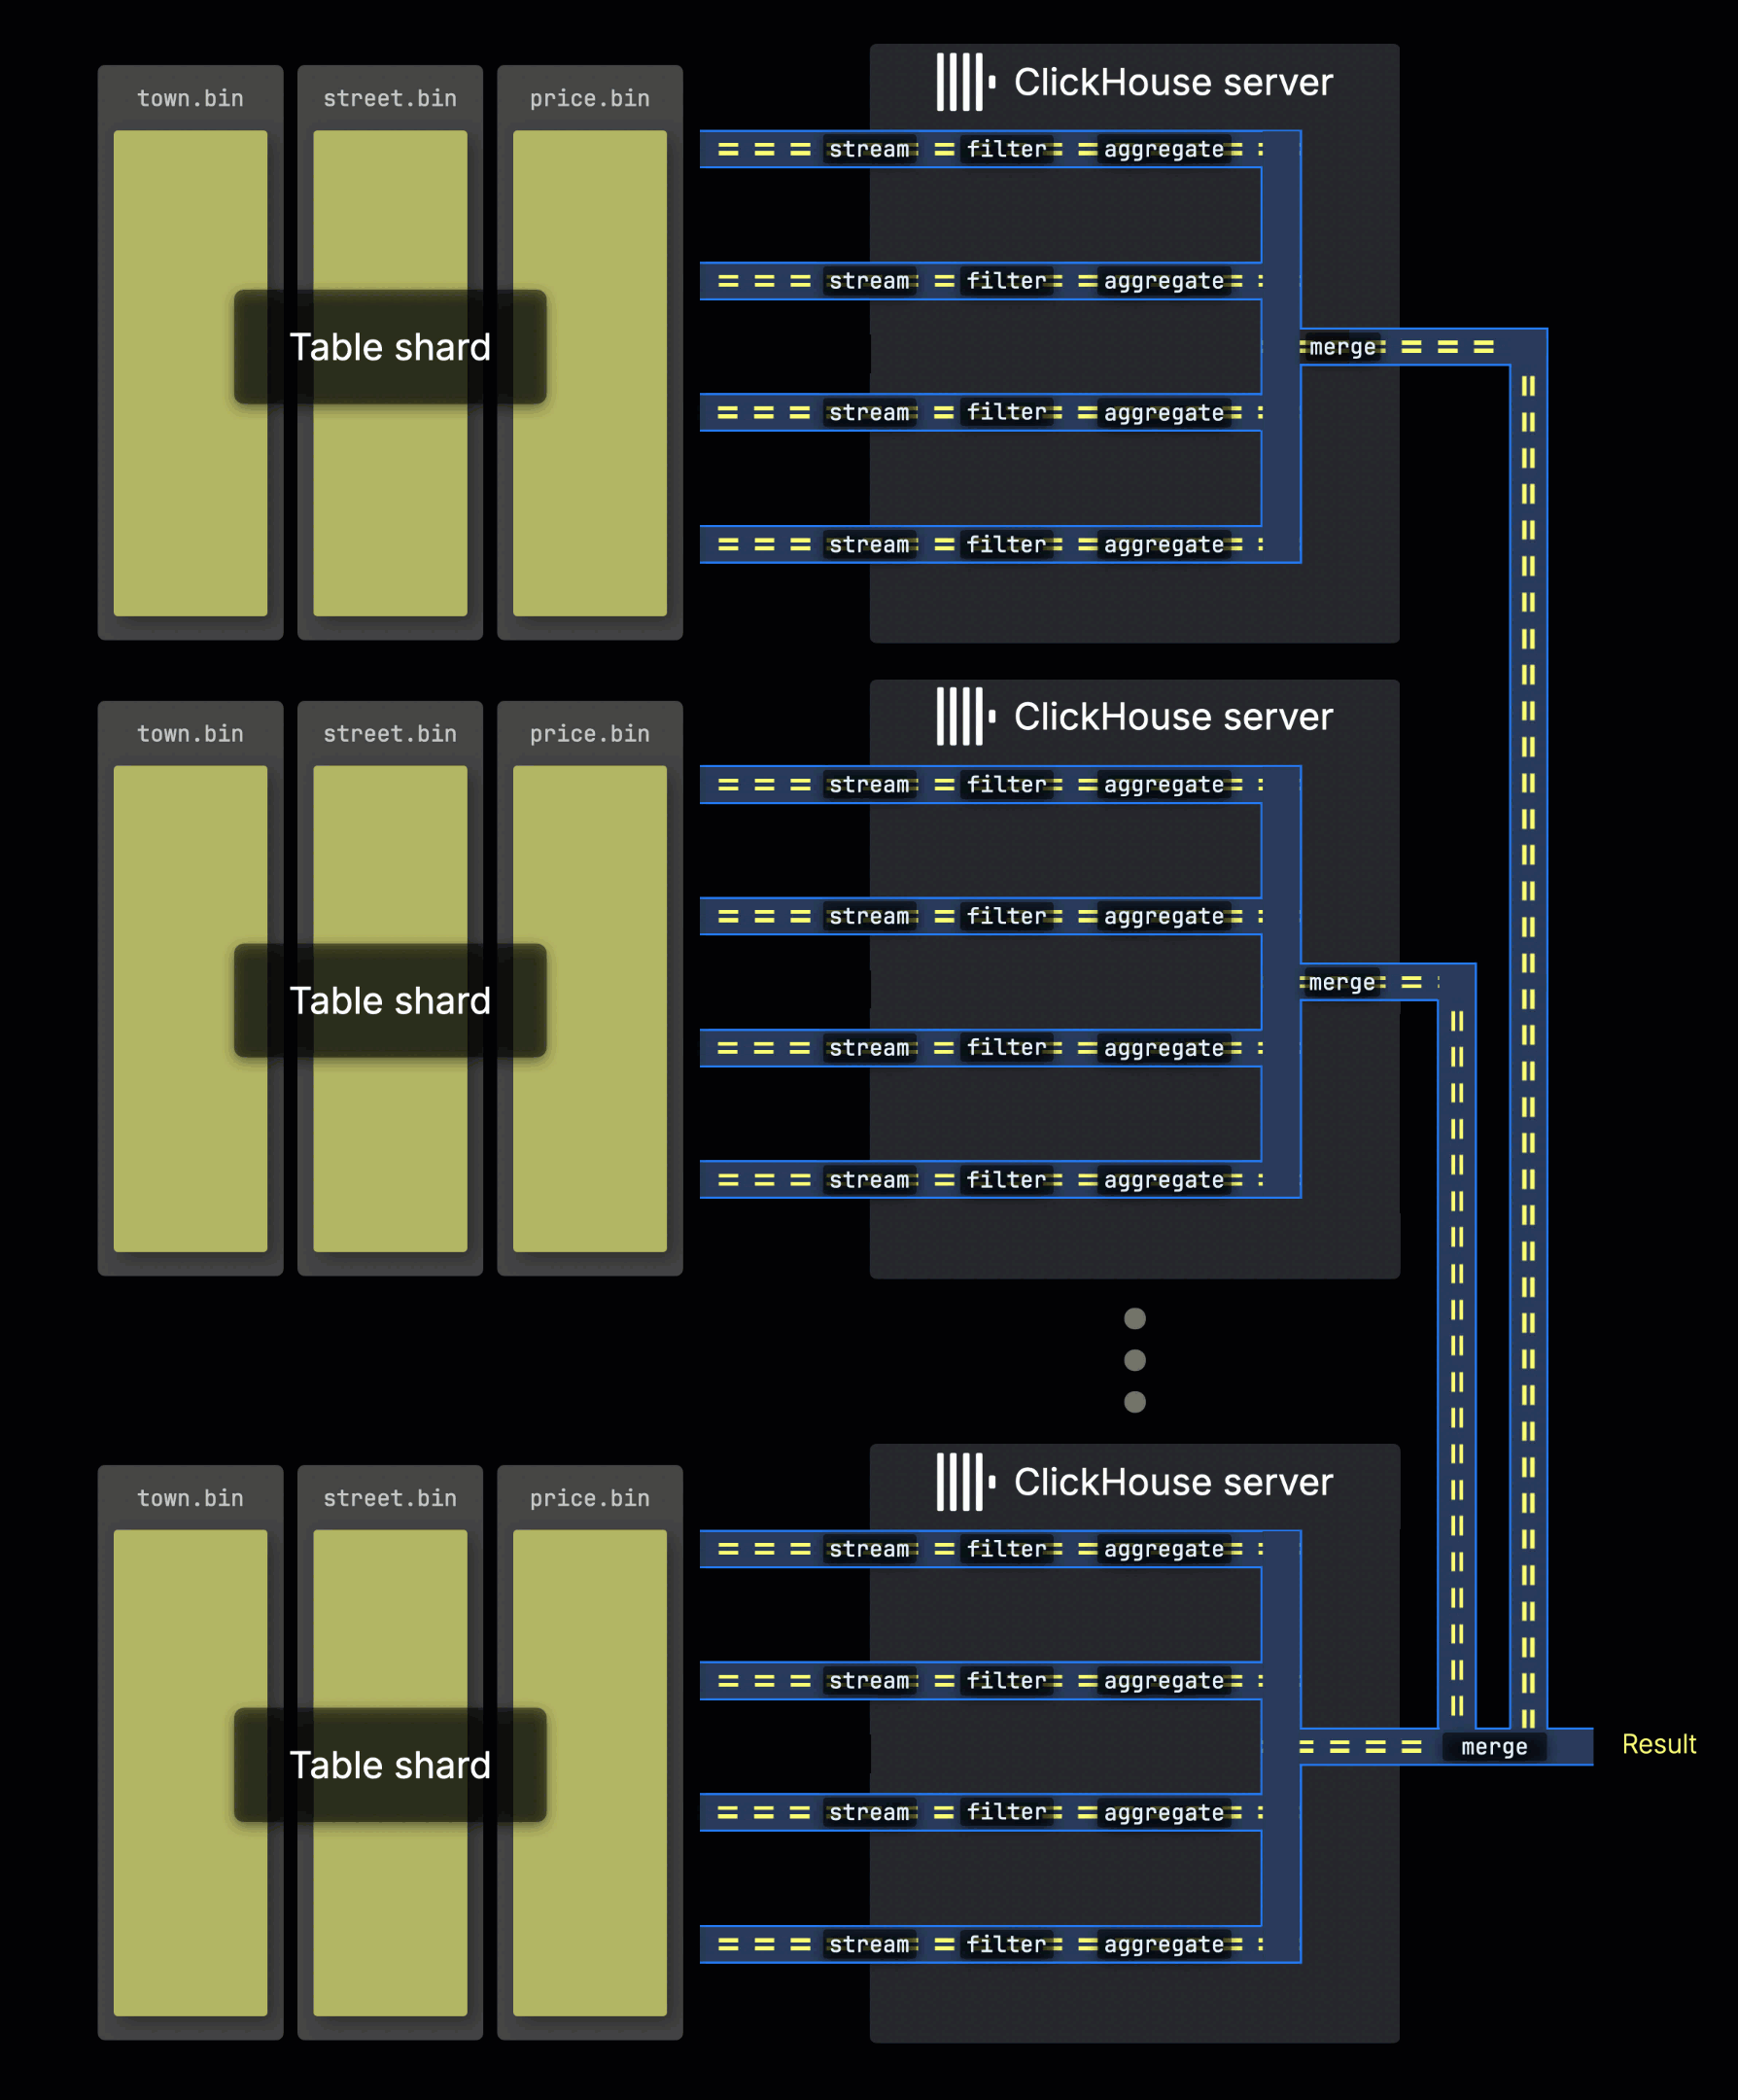
O servidor que recebe a consulta inicialmente coleta todos os sub-resultados dos shards e os combina no resultado global final. Distribuir a carga das consultas entre shards permite escalar horizontalmente o paralelismo, especialmente em ambientes de alto throughput.
ClickHouse Cloud usa réplicas paralelas em vez de shardsNo ClickHouse Cloud, esse mesmo paralelismo é obtido por meio de réplicas paralelas, que funcionam de forma semelhante aos shards em clusters shared-nothing. Cada réplica do ClickHouse Cloud — um nó de computação sem estado — processa uma parte dos dados em paralelo e contribui para o resultado final, exatamente como faria um shard independente.
- ① o ClickHouse precisa ler 3.609 grânulos (indicados como marcas nos logs no nível trace) em 3 faixas de dados.
- ② Com 59 núcleos de CPU, ele distribui esse trabalho em 59 fluxos paralelos de processamento — um por lane.
× 59 são executados de forma concorrente em regiões de dados não sobrepostas, em 59 lanes de processamento paralelas. Isso reflete o valor de max_threads e ilustra como cada etapa da consulta é paralelizada entre os núcleos de CPU.
A interface web embutida do ClickHouse (disponível no endpoint /play) pode exibir o plano físico acima como uma visualização gráfica. Neste exemplo, definimos max_threads como 4 para manter a visualização compacta, mostrando apenas 4 lanes de processamento paralelas:
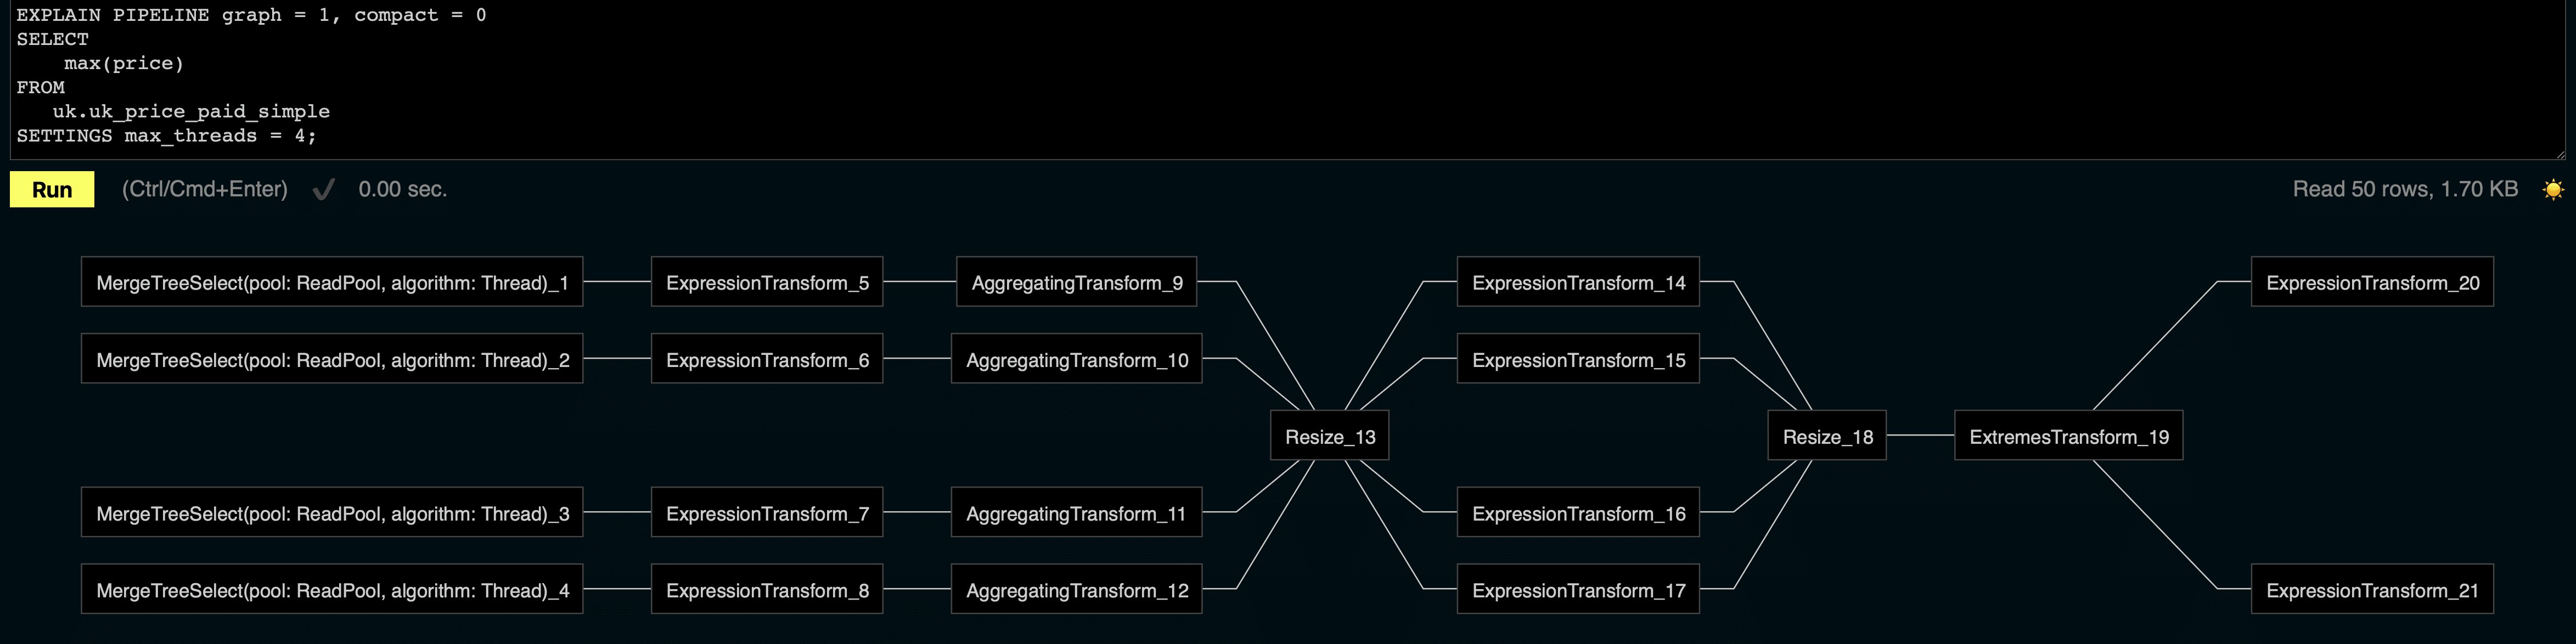
max_threads = 4.
Observe que os operadores Resize no plano físico acima reparticionam e redistribuem fluxos de blocos de dados entre as lanes de processamento para mantê-las uniformemente ocupadas. Esse rebalanceamento é especialmente importante quando os intervalos de dados variam na quantidade de linhas que correspondem aos predicados da consulta; caso contrário, algumas lanes podem ficar sobrecarregadas enquanto outras permanecem ociosas. Ao redistribuir o trabalho, as lanes mais rápidas efetivamente ajudam as mais lentas, otimizando o tempo geral de execução da consulta.
Como mencionado acima, o número de n lanes de processamento paralelas é controlado pela configuração max_threads, que, por padrão, corresponde ao número de núcleos de CPU disponíveis para o ClickHouse no servidor:
max_threads pode ser ignorado, dependendo do volume de dados selecionado para processamento:
max_threads esteja definido como 59, o ClickHouse usa apenas 30 fluxos concorrentes para varrer os dados.
Agora vamos executar a consulta:
max_threads, o ClickHouse só aloca lanes de processamento paralelas adicionais quando há dados suficientes para justificá-las. O “max” em max_threads refere-se a um limite superior, não a um número garantido de threads em uso.
O que significa “dados suficientes” é determinado principalmente por duas configurações, que definem o número mínimo de linhas (163.840 por padrão) e o número mínimo de bytes (2.097.152 por padrão) que cada lane de processamento deve processar:
Para clusters shared-nothing:
Para clusters com armazenamento compartilhado (por exemplo, ClickHouse Cloud):
- merge_tree_min_rows_for_concurrent_read_for_remote_filesystem
- merge_tree_min_bytes_for_concurrent_read_for_remote_filesystem
max_threads configurado.
Isso demonstra que, para consultas em conjuntos de dados pequenos, o ClickHouse limitará intencionalmente a concorrência. Use substituições de configuração apenas para testes — nunca em produção —, pois elas podem levar a uma execução ineficiente ou à contenção de recursos.
- O ClickHouse paraleliza consultas usando lanes de processamento vinculadas a
max_threads. - O número real de lanes depende do volume de dados selecionados para processamento.
- Use
EXPLAIN PIPELINEe logs em nível trace para analisar o uso das lanes.
- Camada de processamento de consultas – Artigo da VLDB 2024 (edição web) - Uma análise detalhada do modelo interno de execução do ClickHouse, incluindo agendamento, pipelining e design de operadores.
- Estados de agregação parciais explicados - Um aprofundamento técnico sobre como os estados de agregação parciais permitem uma execução eficiente em paralelo nas processing lanes.
- Um tutorial em vídeo que explica em detalhes todas as etapas do processamento de consultas no ClickHouse: