

As partições agrupam as partes de dados de uma tabela na família de motores MergeTree em unidades lógicas organizadas — uma forma de organizar os dados que faz sentido do ponto de vista conceitual e se alinha a critérios específicos, como intervalos de tempo, categorias ou outros atributos-chave. Essas unidades lógicas facilitam o gerenciamento, a consulta e a otimização dos dados. O particionamento pode ser habilitado quando uma tabela é inicialmente definida por meio da cláusula PARTITION BY. Essa cláusula pode conter uma expressão SQL em quaisquer colunas, cujos resultados definirão a qual partição uma linha pertence. Para ilustrar isso, expandimos a tabela de exemplo O que são partes de tabela adicionando uma cláusula
PARTITION BY toStartOfMonth(date), que organiza as partes de dados da tabela de acordo com os meses das vendas de imóveis:
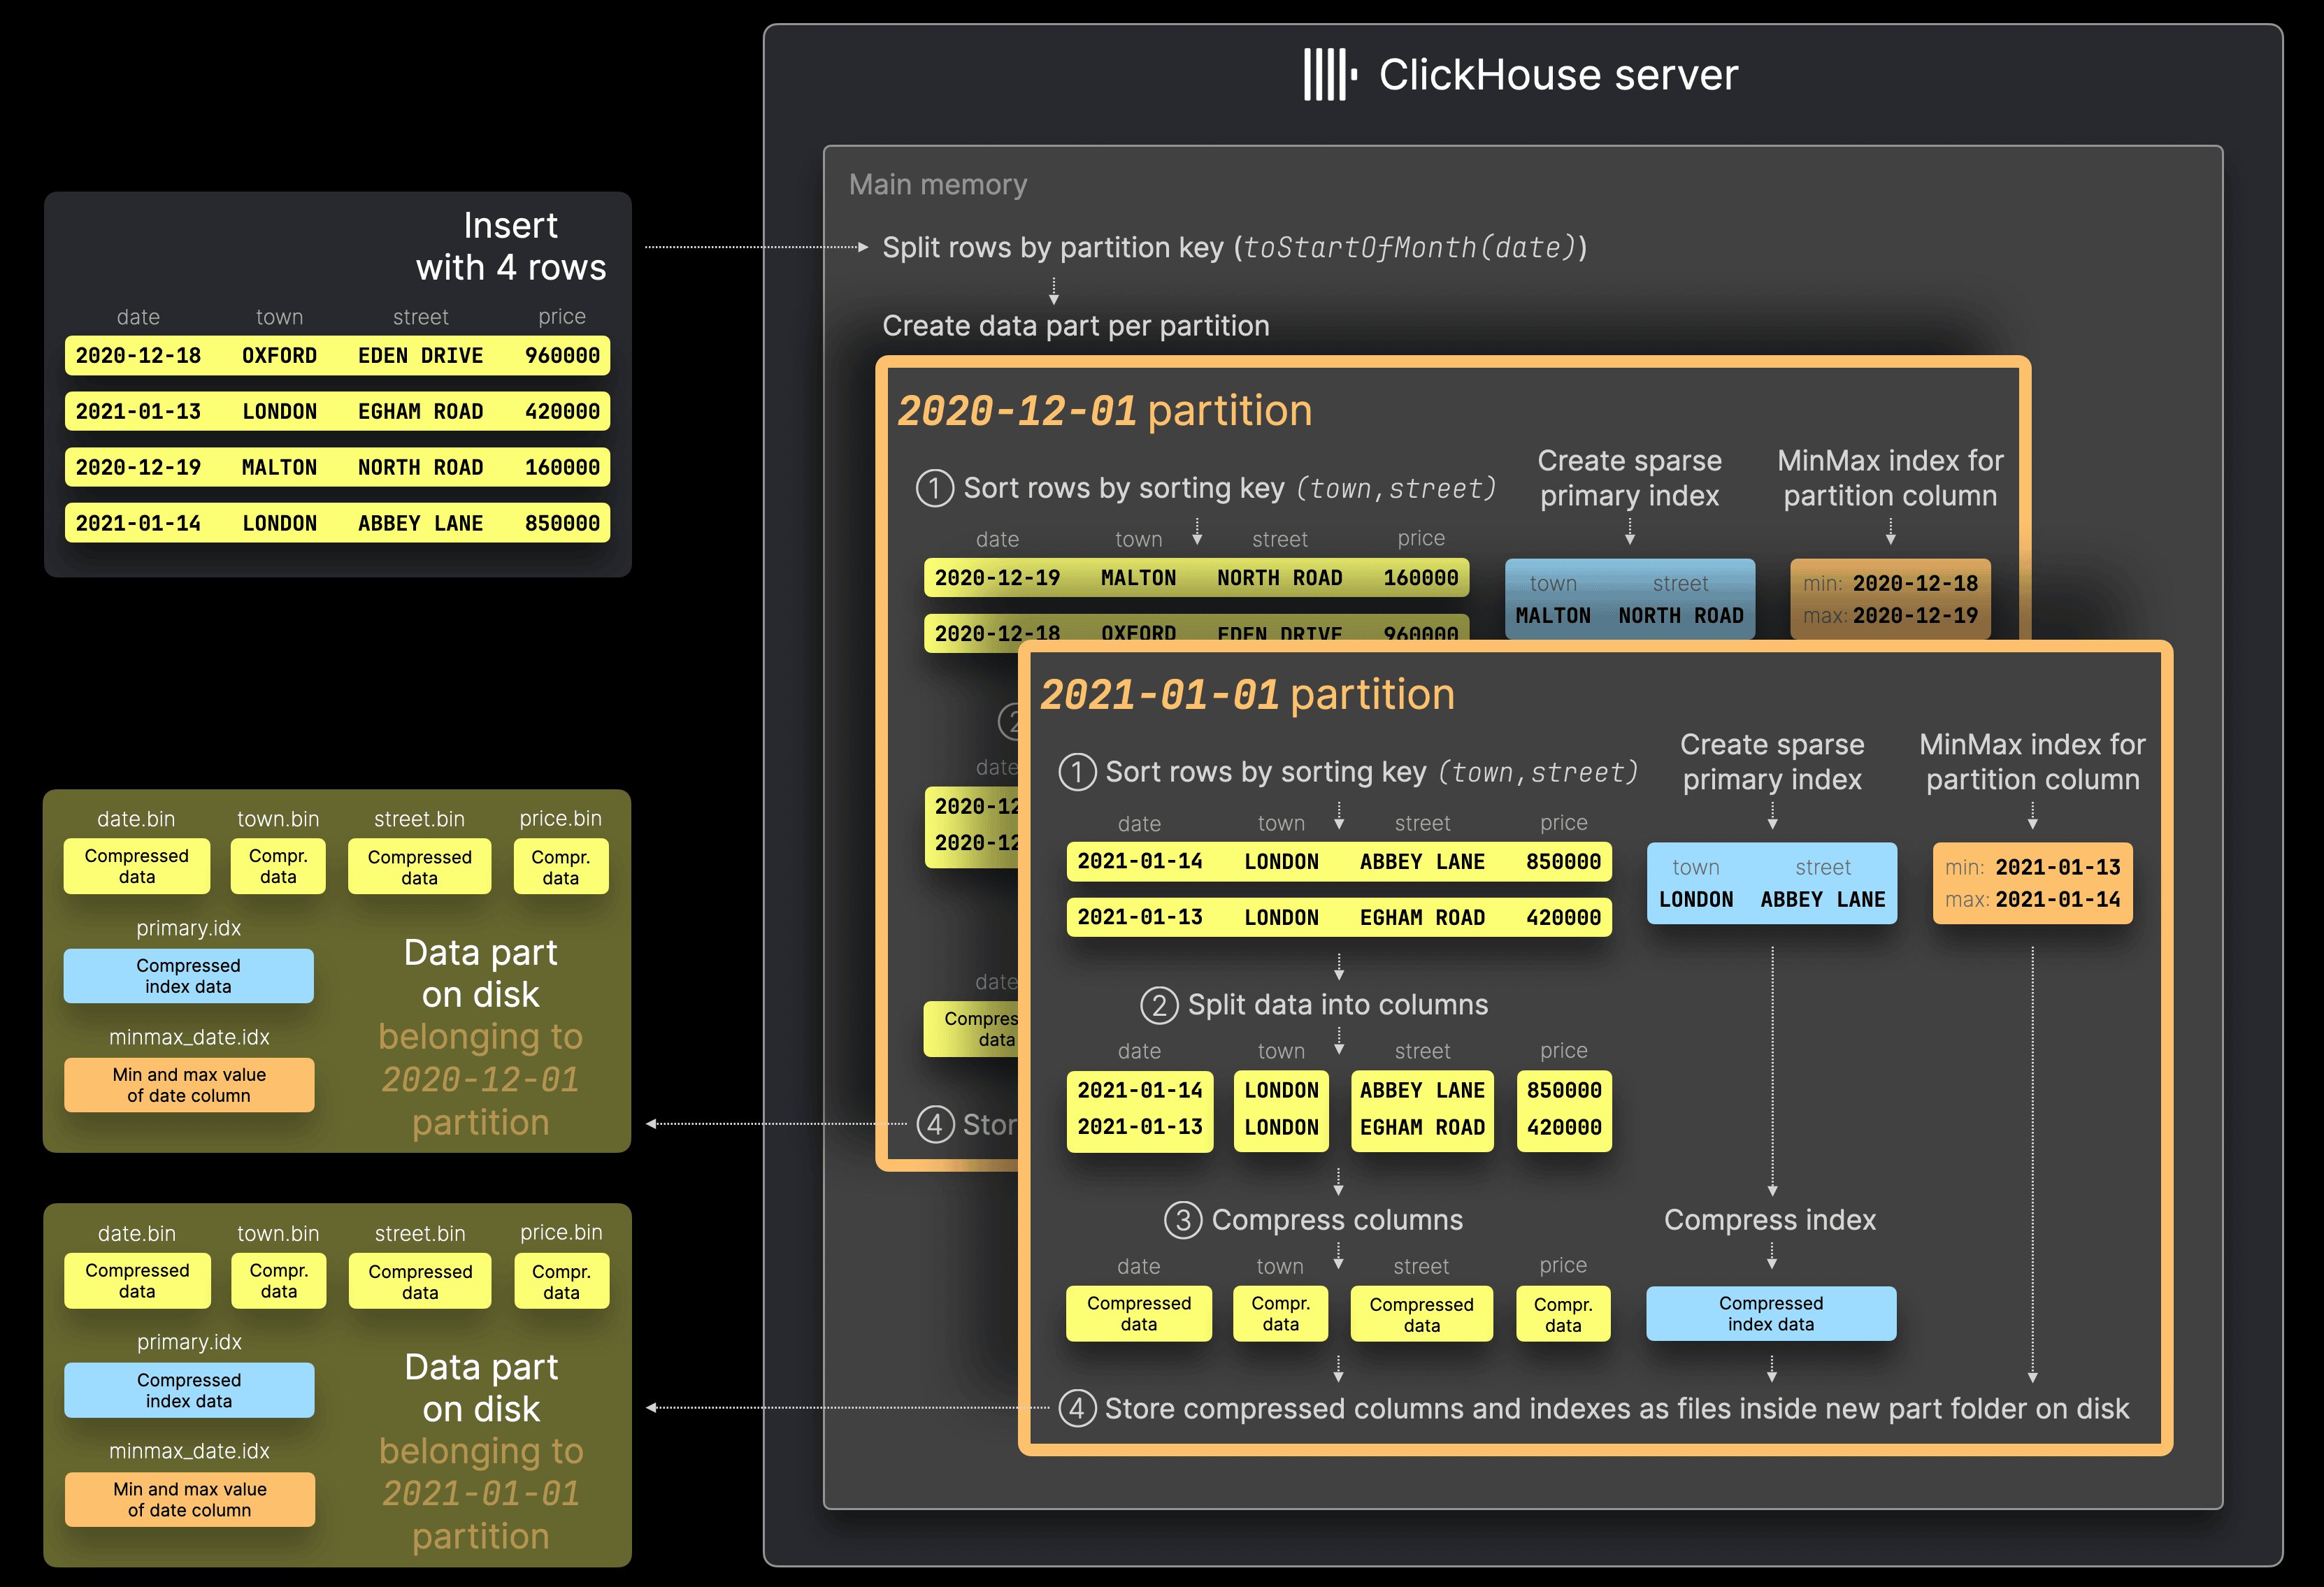
O servidor ClickHouse primeiro divide, pelo valor da chave de partição
toStartOfMonth(date), as linhas do exemplo de inserção com 4 linhas ilustrado no diagrama acima.
Em seguida, para cada partição identificada, as linhas são processadas como de costume, executando várias etapas sequenciais (① Ordenação, ② Divisão em colunas, ③ Compressão, ④ Gravação em disco).
Observe que, com o particionamento habilitado, o ClickHouse cria automaticamente índices MinMax para cada parte de dados. Eles são simplesmente arquivos para cada coluna da tabela usada na expressão da chave de partição, contendo os valores mínimo e máximo dessa coluna dentro da parte de dados.
Com o particionamento habilitado, o ClickHouse só faz mesclagem de partes de dados dentro das partições, mas não entre partições. Isso é ilustrado na nossa tabela de exemplo acima:
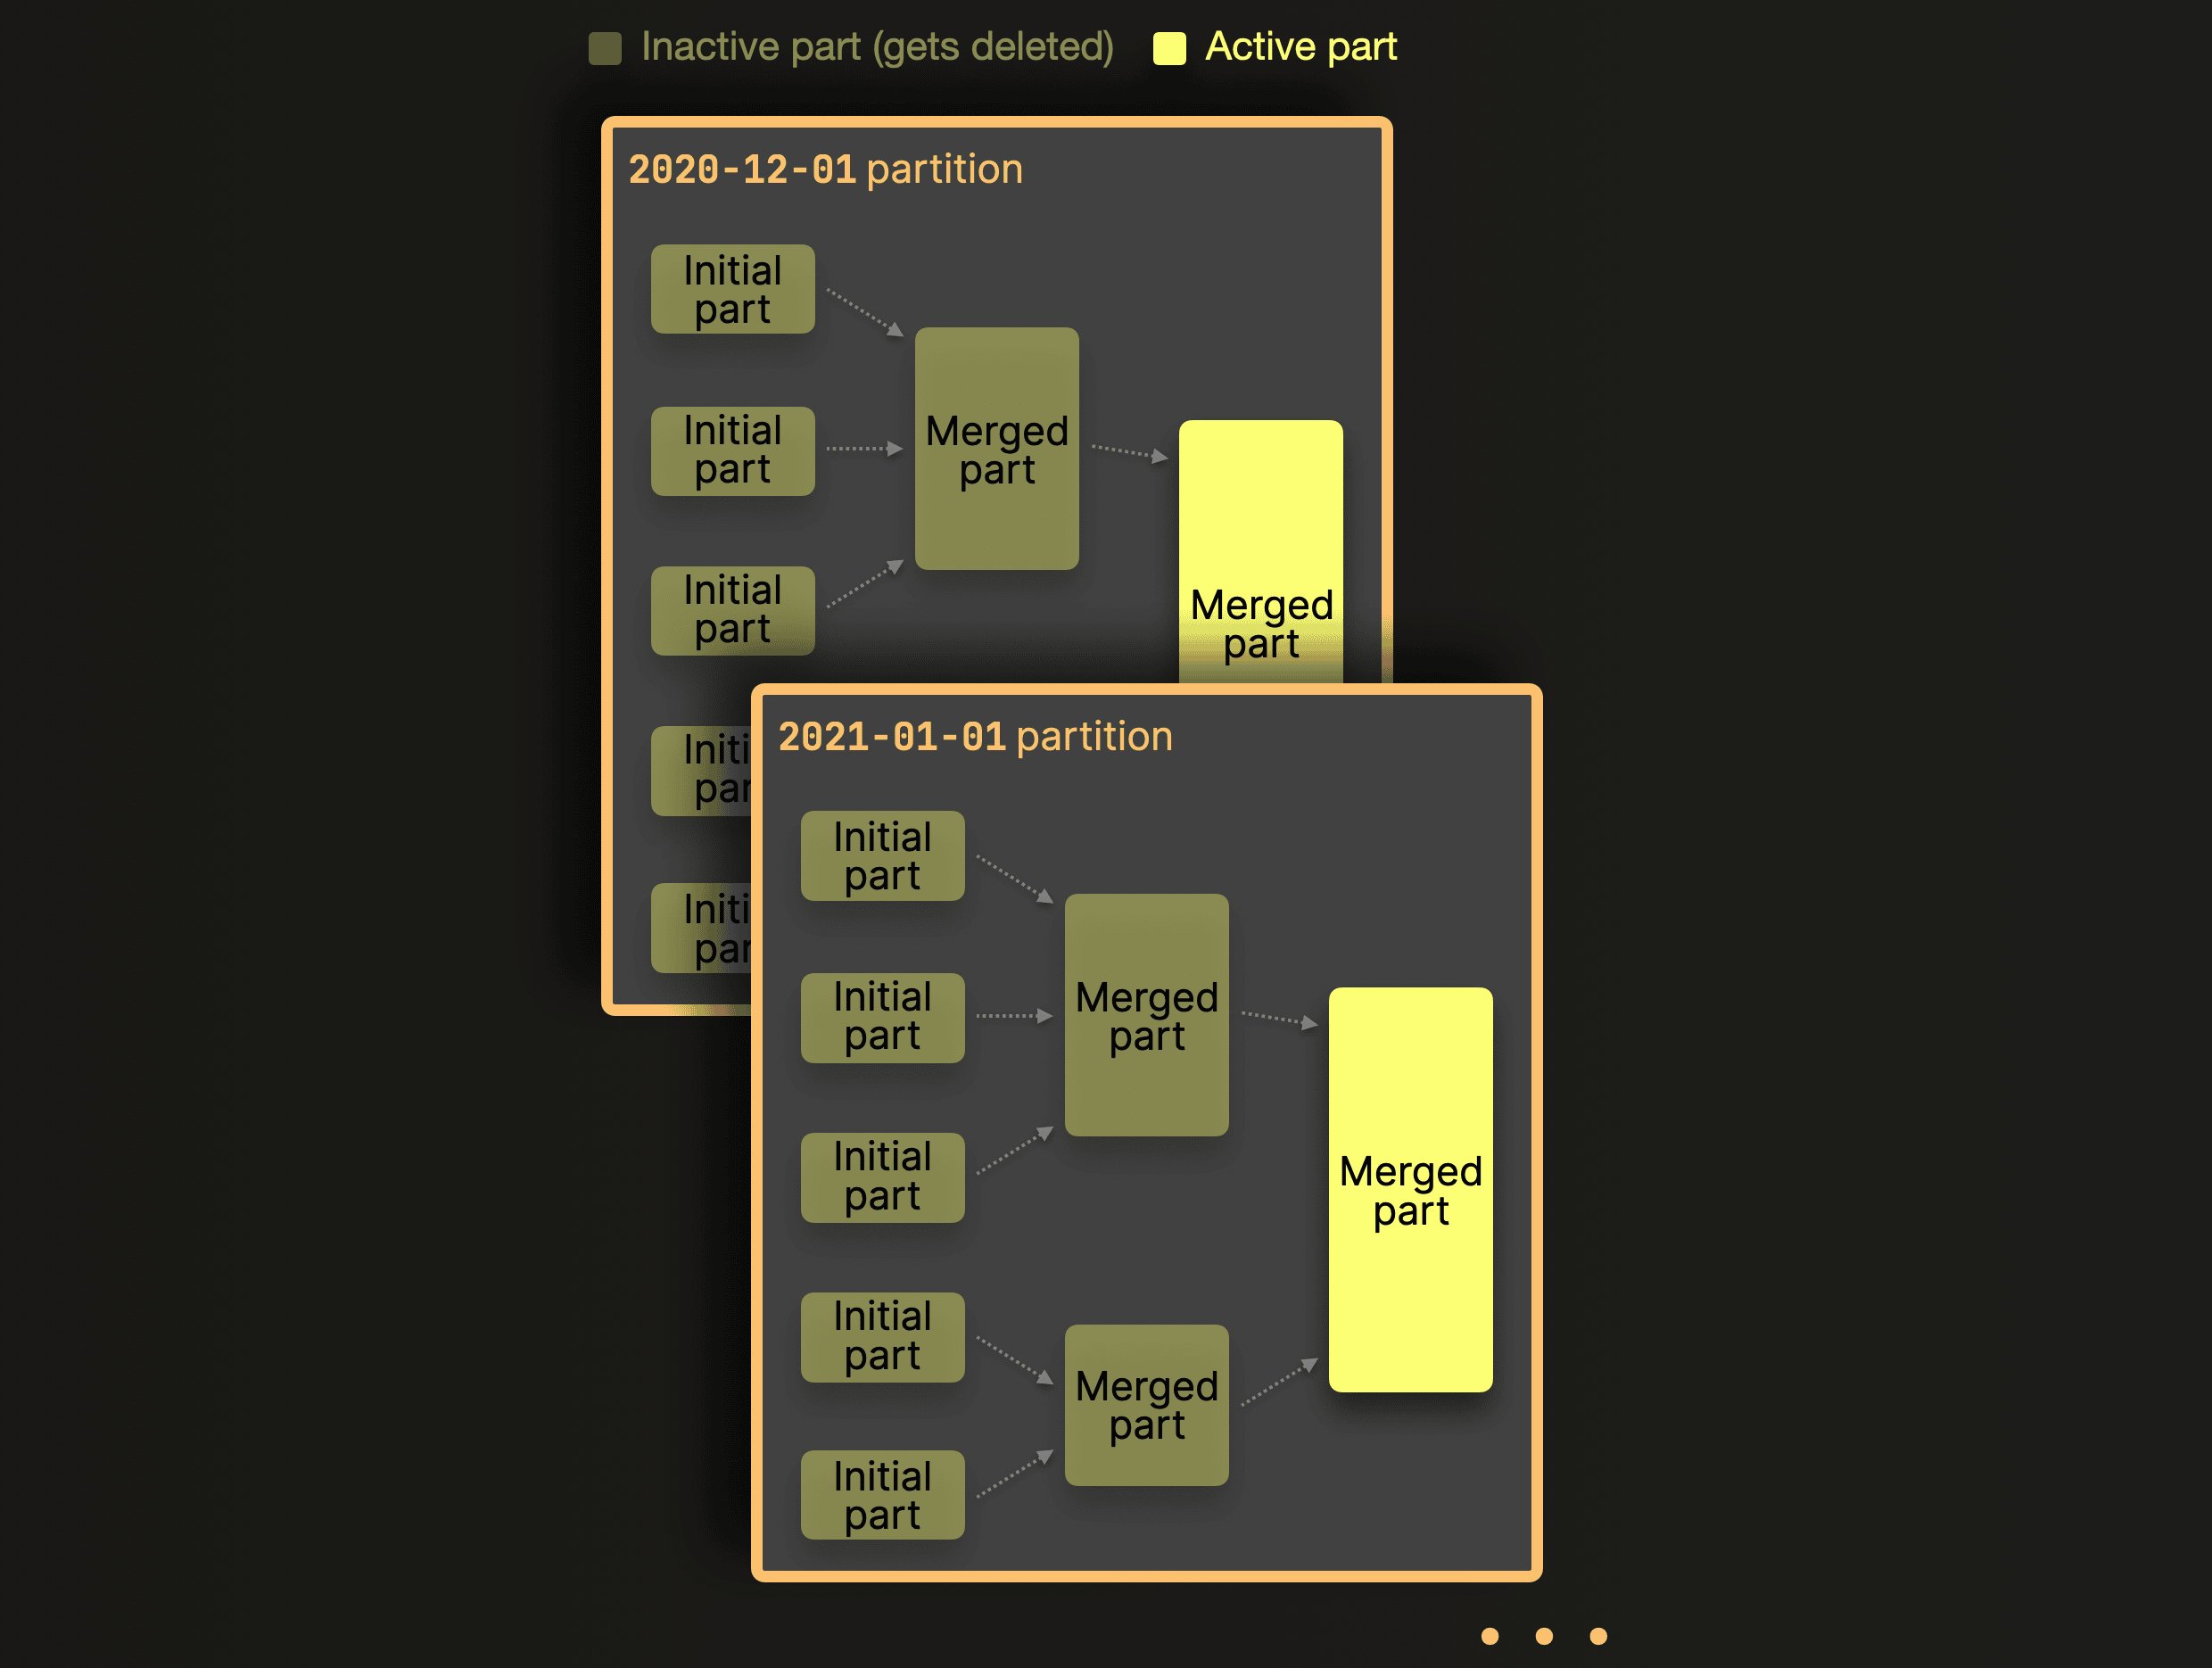
Como ilustrado no diagrama acima, partes pertencentes a partições diferentes nunca são mescladas. Se for escolhida uma chave de partição com alta cardinalidade, as partes distribuídas por milhares de partições nunca serão candidatas à mesclagem, ultrapassando os limites pré-configurados e causando o temido erro
Too many parts. Resolver esse problema é simples: escolha uma chave de partição adequada com cardinalidade abaixo de 1000..10000.
Você pode consultar a lista de todas as partições únicas existentes da nossa tabela de exemplo usando a coluna virtual _partition_value:
Como alternativa, o ClickHouse rastreia todas as partes e partições de todas as tabelas na tabela de sistema system.parts, e a consulta a seguir retorna, para a nossa tabela de exemplo, a lista de todas as partições, além do número atual de partes ativas e da soma de linhas nessas partes para cada partição:
No ClickHouse, o particionamento é, прежде de tudo, um recurso de gerenciamento de dados. Ao organizar os dados logicamente com base em uma expressão de partição, cada partição pode ser gerenciada de forma independente. Por exemplo, o esquema de particionamento da tabela de exemplo acima permite cenários em que apenas os últimos 12 meses de dados são mantidos na tabela principal, com os dados mais antigos sendo removidos automaticamente por meio de uma regra de TTL (veja a última linha adicionada na instrução DDL):
toStartOfMonth(date), partições inteiras (conjuntos de partes de tabela) que atendem à condição de TTL serão descartadas, tornando a operação de limpeza mais eficiente, sem precisar reescrever as partes.
Da mesma forma, em vez de excluir dados antigos, eles podem ser movidos automaticamente e com eficiência para uma camada de armazenamento mais econômica:
date) usada na chave de partição da tabela quanto por uma coluna (town) usada na chave primária da tabela (e date não faz parte da chave primária).
O ClickHouse processa essa consulta aplicando uma sequência de técnicas de poda para evitar avaliar dados irrelevantes:
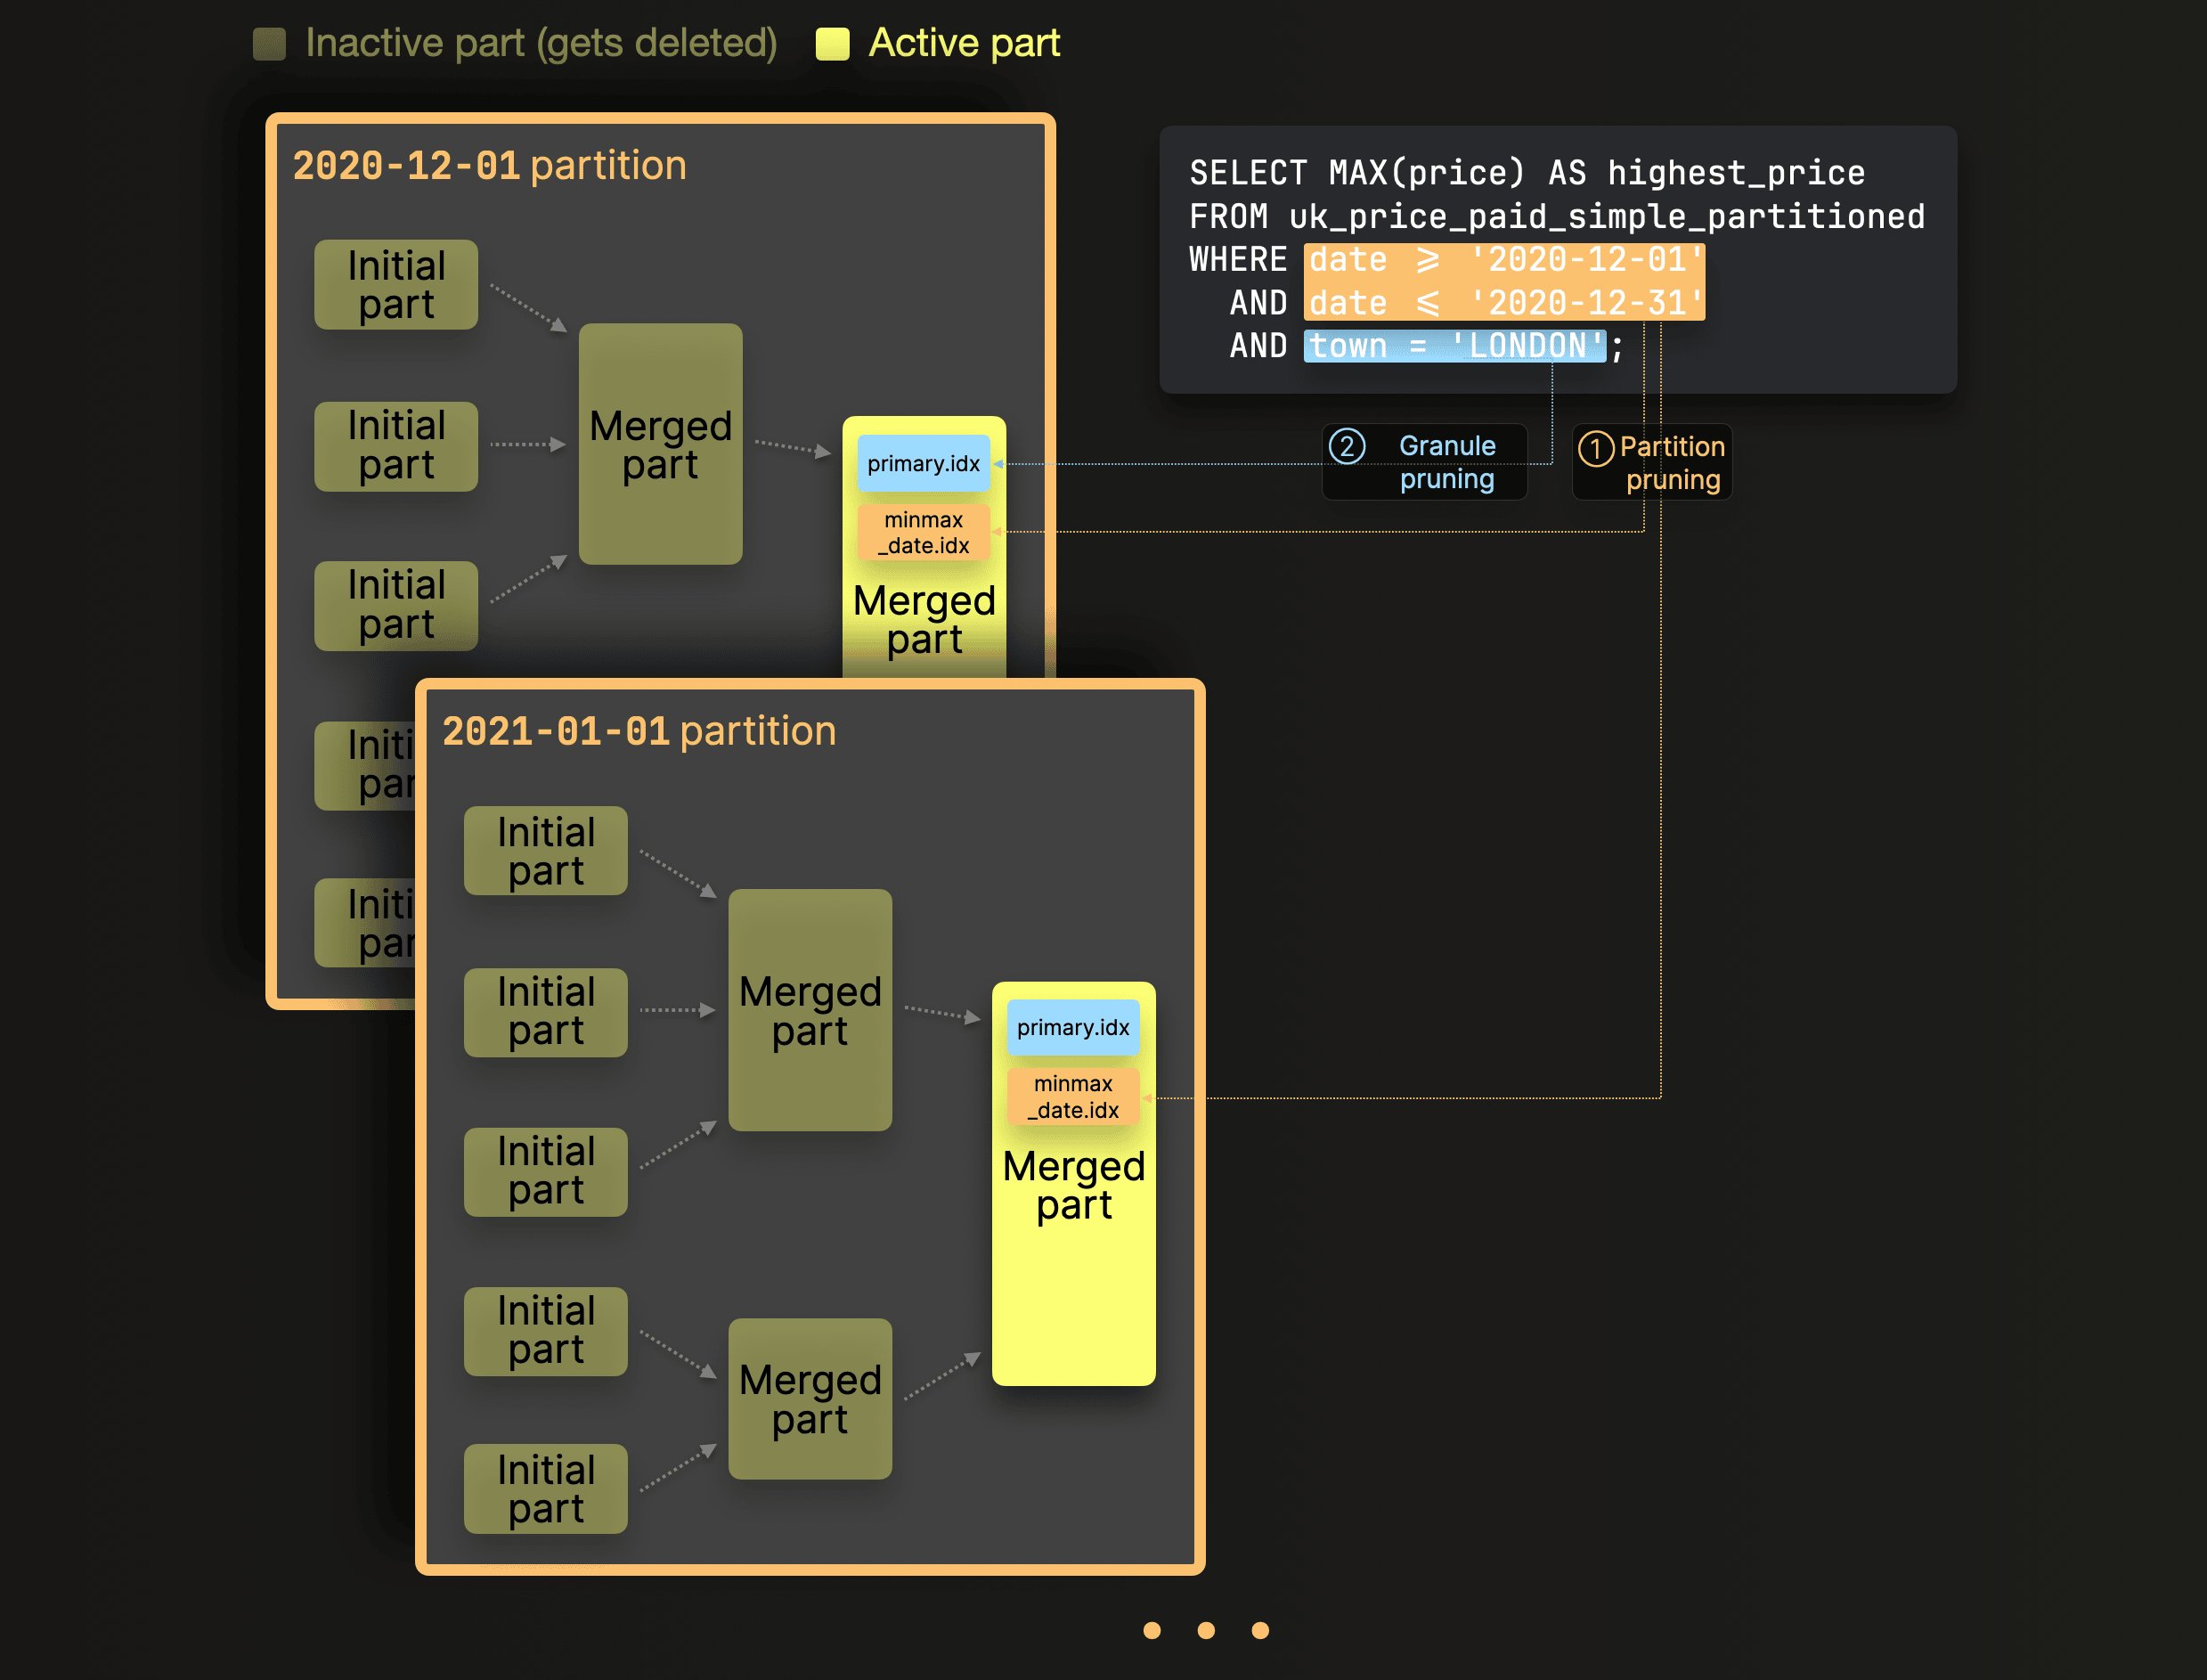
1
Poda de partições
Índices MinMax são usados para ignorar partições inteiras (conjuntos de partes) que, logicamente, não podem corresponder ao filtro da consulta em colunas usadas na chave de partição da tabela.
2
Poda de grânulos
Para as partes de dados restantes após a etapa de poda de partições, seu índice primário é usado para ignorar todos os grânulos (blocos de linhas) que, logicamente, não podem corresponder ao filtro da consulta em colunas usadas na chave primária da tabela.
1
Poda de partições
As linhas 7 a 18 da saída de
EXPLAIN acima mostram que o ClickHouse primeiro usa o índice MinMax do campo date para identificar 11 dos 3257 grânulos existentes (blocos de linhas) armazenados em 1 das 436 partes de dados ativas existentes que contêm linhas correspondentes ao filtro date da consulta.2
Poda de grânulos
As linhas 19 a 24 da saída de
EXPLAIN acima indicam que o ClickHouse então usa o índice primário (criado sobre o campo town) da parte de dados identificada na etapa de poda de partições para reduzir ainda mais o número de grânulos (que potencialmente também contêm linhas correspondentes ao filtro town da consulta) de 11 para 1. Isso também se reflete na saída do cliente ClickHouse que exibimos mais acima para a execução da consulta:uk_price_paid_simple_partitioned tem mais de 600 partições e, portanto, 600.306 partes de dados ativas. Já na nossa tabela não particionada uk_price_paid_simple, todas as partes de dados iniciais puderam ser mescladas em uma única parte ativa por mesclagens em segundo plano.
Quando verificamos o plano físico de execução da consulta com uma cláusula EXPLAIN para a nossa consulta de exemplo acima, sem o filtro de partição, executada sobre a tabela particionada, podemos ver nas linhas 19 e 20 da saída abaixo que o ClickHouse identificou 671 dos 3257 grânulos existentes (blocos de linhas), distribuídos em 431 das 436 partes de dados ativas existentes, que potencialmente contêm linhas que correspondem ao filtro da consulta e, portanto, serão examinados e processados pelo mecanismo de execução de consultas: