5万

TL;DR
ClickHouse は、更新を挿入として扱うことで行レベル更新の性能課題を回避しています。更新の詳細を掘り下げる本連載の第 1 回では、高速な更新を実現する専用エンジンを取り上げます。
第 2 回では、性能を損なうことなく SQL スタイルの UPDATE を ClickHouse に導入した方法を紹介します。
-
本パート: 専用エンジン
ReplacingMergeTree、CollapsingMergeTree、CoalescingMergeTree などの挿入ベースのエンジンを使用して、ClickHouse が低速な行レベル更新を回避する仕組みを学びます。 -
第 2 回: 宣言型 SQL スタイル UPDATE
パッチパート(patch parts)を使用し、最小限のオーバーヘッドで標準の UPDATE 構文を ClickHouse に導入した方法を探ります。 -
第 3 回: ベンチマーク
実際の速さを確認します。宣言型 UPDATE を含むすべてのアプローチでベンチマークを実施し、最大 1,000 倍の高速化を達成しました。 -
番外編: ClickHouse と PostgreSQL の比較
同一のハードウェアとデータを用いて、ClickHouse の新しい SQL UPDATE と PostgreSQL を直接対決させました。ポイント更新では同等、一括変更では最大 4,000 倍高速という結果が得られました。
UPDATE を使わずに更新を高速化する
列指向ストアは、行レベルの更新向けには作られていません。
ClickHouse も例外ではありませんでした。大規模環境でのスピードを追求して設計されており、高速な挿入と極めて高速な分析に最適化されているため、個別の行を変更する処理向けではないのです。
しかし、実世界のワークロードは必ずしも定石通りにはいきません。
ClickHouse ユーザーは、修正、更新、削除が必要な頻繁に変化するデータを扱うことがよくあります。IoT(センサー値)、E コマース(注文と在庫)、金融(支払いステータス)、ゲーム(プレイヤー統計)、**CRM/人事(ユーザーまたは従業員のプロファイル)**などがその例です。大量の読み取り向けに設計されたシステムに低速な UPDATE 処理を無理に組み込むのではなく、私たちは別のアプローチを取りました。
私たちは、更新を挿入として扱うことで、更新の問題を回避しました。
これは単なる回避策ではなく、意図的な設計上の選択です。ReplacingMergeTree、CoalescingMergeTree、CollapsingMergeTree などのエンジンにより、ClickHouse は既存の行を変更する代わりに新しい行を書き込むことで、更新や削除を処理できます。インプレースの更新による性能低下を避け、ClickHouse の高い挿入スループットとバックグラウンドのマージ処理を最大限に活かします。
これらのエンジンは現在も大規模環境の実課題を解決しており、大量の取り込みと頻繁な変更を伴うワークロードに最適であることが多いです。また、次世代の更新メカニズムの着想元にもなっているため、その動作を理解することは、ClickHouse が SQL スタイルの更新も高速化できる理由の理解につながります。
本シリーズで取り上げる内容
-
**本記事(第 1 回)**では、専用エンジンがどのように動作し、なぜ今でもこれほど効果的なのかを探ります。
-
**第 2 回**では、パッチパートと呼ばれる新しいメカニズムによって実現された、宣言型の標準 SQL スタイルの UPDATE を取り上げます。
-
**第 3 回**では、すべてのアプローチのベンチマークを実施し、それぞれの性能を比較します。
ClickHouse がどのように更新を高速化しているかを理解するには、そもそもなぜ列指向ストアで更新が難しいのかから始めると分かりやすいでしょう。
なぜ列指向ストアでは更新が難しいのか
データベースシステムにおいて、更新と分析は相反する関係にあります。一方にとって高速な処理は、もう一方にとっては低速になりがちです。
行指向ストア(PostgreSQL や MySQL など)の場合:
-
各行はディスク上に連続して格納されます。
-
これにより更新は容易で、インプレースで行を上書きできます。
-
しかし分析クエリでは性能が低下します。2 つのカラムしか必要としない場合でも、行全体をメモリに読み込む必要があります。
列指向ストア(ClickHouse など)の場合:
-
各カラムは個別のファイルに格納されます。
-
これにより分析が極めて高速になります。クエリ対象のカラムのみが読み取られるためです。
-
しかし更新は難しくなります。各カラムが個別に格納されているため、1 行を変更するだけでも複数のファイルにアクセスしてフラグメントを書き直す必要があるからです。
このトレードオフにより、効率的な行レベル更新は長らく列指向システムの課題となっていました。
それでは、更新を完全に回避するという別のアプローチでこの問題に取り組んだ、ClickHouse の最初の解決策である専用エンジンを見てみましょう。
挿入が非常に高速なため、更新を挿入に変えた
基本的な考え方はシンプルです。ClickHouse は特に挿入ワークロード向けに最適化されています。ロックや更新が必要なグローバル構造(グローバル B+ ツリーインデックスなど)が存在しないため、挿入は完全に分離され、互いに干渉することなく並列実行され、最高速度でディスクに書き込まれます(ある本番環境では毎秒 10 億行以上を達成しています)。これは、テーブルがどれだけ大きくなっても挿入性能が一定に保たれることも意味します。さらに、挿入自体は軽量のままです。レコード更新の解決など付随するすべての作業は切り離され、バックグラウンドのマージに遅延実行されます。
仕組みのポイント: 挿入が非常に高速で効率的であるため、ClickHouse は更新(さらには削除)を単なる追加の挿入として扱えます。
IoT のような高スループット環境では、従来の SQL スタイルの UPDATE は非効率になることがあります。一般的な RDBMS でさえ、UPDATE は直前の状態を持つ行を特定し、それを書き直し、多くの場合必要以上のデータをロックまたは再書き込みする必要があります。
ReplacingMergeTree、CoalescingMergeTree、CollapsingMergeTree などの専用エンジンにより、ClickHouse は直前の状態を持つ行の特定を完全に省く、より効率的な挿入専用モデルを採用しています。更新や削除でさえ高速で軽量な挿入として表現され、実際のデータ変更は後からバックグラウンドのマージを介して行われます。
このアプローチが効果的な理由: ClickHouse は、バックグラウンドですでに小さなデータパートをより大きなパートへ継続的にマージしています。それは MergeTree という名前そのものに表れています。これらのマージでは、関連するデータをメモリにロードして統合し、新しいパートを書き出します。エンジンがすでにこの処理を行っているため、マージ中に更新や削除を処理してもオーバーヘッドは最小限で済みます。行の最新バージョンのみを保持したり、キャンセルされた行を削除したりする処理のコストは、実質ゼロに近くなります。
この軽量な挿入とマージのフローは、ClickHouse のディスク上のデータ構造があって初めて実現します。つまり、バックグラウンドで常にマージされる、ソート済みでイミュータブルなデータパートです。
パートとマージの理解
ClickHouse が更新を高速化する仕組みを理解し、本記事(および次回)の図やメカニズムを追うには、すべての基盤となっているパートについて知っておくと役立ちます。
挿入によってソート済みでイミュータブルなパートが作成される
ClickHouse テーブルにデータを挿入するたびに、独立したイミュータブルなデータパートとしてディスクに書き込まれます。
各パートには行(カラムごとに格納)が含まれており、挿入とマージの履歴における位置づけが反映された名前が付けられます。たとえば、order_id、item_id、quantity、price、discount カラムを持つ空の orders テーブルに対して以下の挿入を実行したとします。
INSERT INTO orders VALUES
(1001, 'kbd', 10, 45.00, 0.00),
(1001, 'mouse', 6, 25.00, 0.00);ClickHouse は all_1_1_0 という名前の新しいパートを作成します。
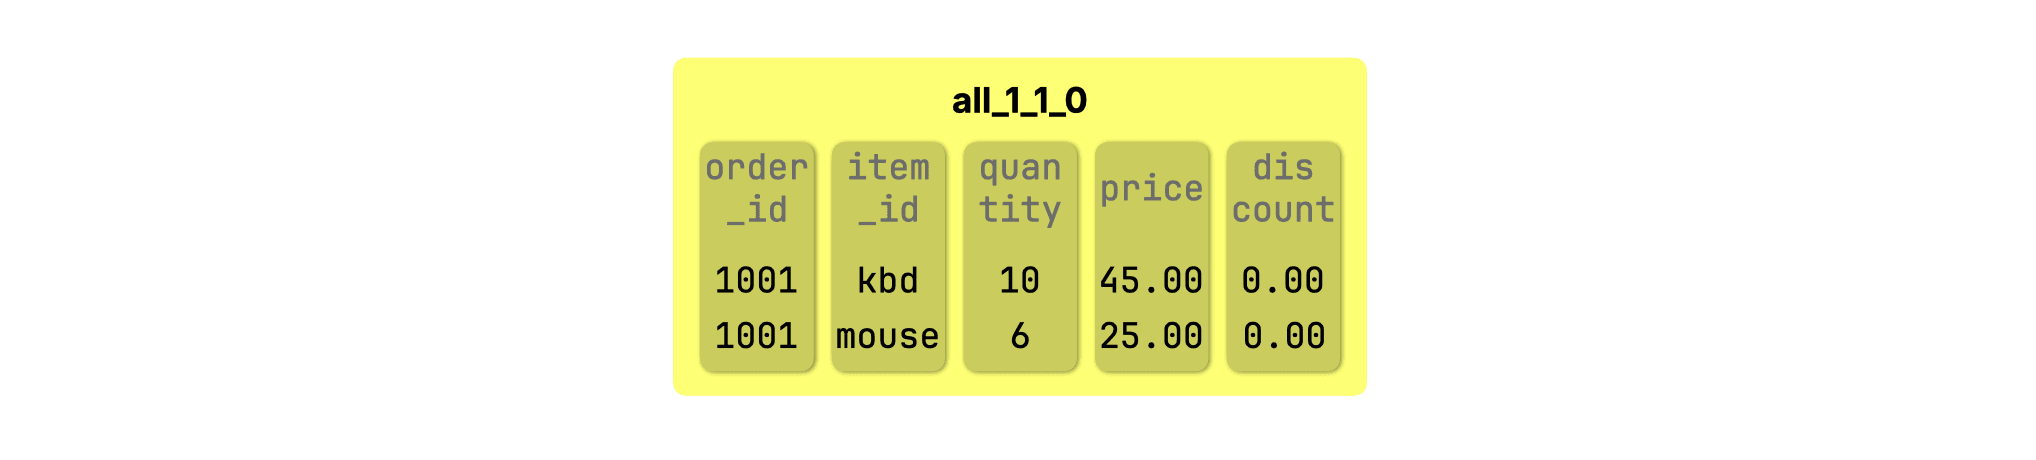
パート内では、テーブルのソートキー(この場合は (order_id, item_id))によってディスク上に行が物理的にソートされます。これは MergeTree テーブルのすべてのパートに当てはまり、ClickHouse がランダム I/O や再ソートを行わずに効率よくパートをマージするための決定的な要素です。
パート名の読み方
各パート名は partition_minBlock_maxBlock_mergeLevel という形式に従います。この場合の構成は以下の通りです。
-
all – パーティション ID(この例ではデフォルト値)
-
1 – パート内の最小ブロック番号(後述)
-
1 – パート内の最大ブロック番号(こちらも後述)
-
0 – マージレベル(0 = 初回挿入、数値が大きいほどマージが進んでいることを示す)
パートの内部構造
内部的には、このパートはディスク上で all_1_1_0 という名前のフォルダーになっています。テーブル内の各カラムに対応するファイル(order_id、item_id、quantity、price、discount)が 1 つずつ含まれています。これらの各ファイルは圧縮されており、そのパート内の行に対応するカラム値を格納しています。
上記の図では、パート内でデータがどのように配置されているかを示すために、これらのカラムファイルを描いています。
ブロックがパートを構成する仕組み
ClickHouse はデータを行のブロック単位で挿入し、各ブロックには単調増加するブロック番号が割り当てられます。パートには、単一の挿入または複数パートのマージによって生じた、これら 1 つ以上のブロックが含まれます。パート名に含まれる minBlock と maxBlock は、そのパートに含まれるブロックの範囲を示しています。
バックグラウンドで実行されるマージ
新しい挿入が発生しても、ClickHouse は既存のパートを変更せず、単に新しいパートを書き足します。そしてバックグラウンドで、パート数を抑制しデータを集約するために、それらをより大きなパートへとマージします。
ソート済みパートのおかげでマージが高速
すべてのパートがすでに同じカラムでソートされているため、ClickHouse は非常に高い効率でパートをマージできます。2 つのパートをマージする際、エンジンは両パートの線形スキャンを 1 回行うだけでデータを織り交ぜていきます。再ソートもランダムアクセスも一時バッファも必要ありません。
これはシングルマージパスとして知られています。ClickHouse は両方のパートを順番に読み取り、オンザフライで行を比較しながら、マージされた新しいパートを書き出します。マージが極めて高速かつ軽量である主な理由の 1 つです。
この効率性により、マージ中の更新や削除の処理を最小限のオーバーヘッドで行えます。同じスキャンと書き込みの処理の一部として組み込まれるだけだからです。
基礎が理解できたところで、最もシンプルなエンジンである ReplacingMergeTree から、実際の動作を見ていきましょう。
ReplacingMergeTree: 新しい行を挿入して行を置き換える
ReplacingMergeTree を実演するために、ハードウェアショップのシナリオに基づくシンプルな orders テーブルを使用します。
CREATE TABLE orders (
order_id Int32,
item_id String,
quantity UInt32,
price Decimal(10,2),
discount Decimal(5,2)
)
ENGINE = ReplacingMergeTree
ORDER BY (order_id, item_id);行を更新するには、同じソートキー (order_id, item_id) を持つ新しいバージョンを挿入するだけです。バックグラウンドのマージ中に、ClickHouse は最新のバージョン(最後に挿入されたもの)を保持します。
たとえば、ある顧客が①最初に定価でキーボード 10 個とマウス 6 個を注文したとします。
INSERT INTO orders VALUES
(1001, 'kbd', 10, 45.00, 0.00),
(1001, 'mouse', 6, 25.00, 0.00);その後、顧客がマウスの注文数を 60 個に増やし、20% の大口割引が適用されたとします。古い行を変更する代わりに、更新された数量と割引を含む新しい行を②挿入します。
INSERT INTO orders VALUES
(1001, 'mouse', 60, 25.00, 0.20);以下の図は、初回の挿入(①)と更新の挿入(②)によって作成されたデータパートを示しています。次回のバックグラウンドマージ(③)の際、ClickHouse は自動的に最新バージョンを保持し、古いバージョンを破棄します。
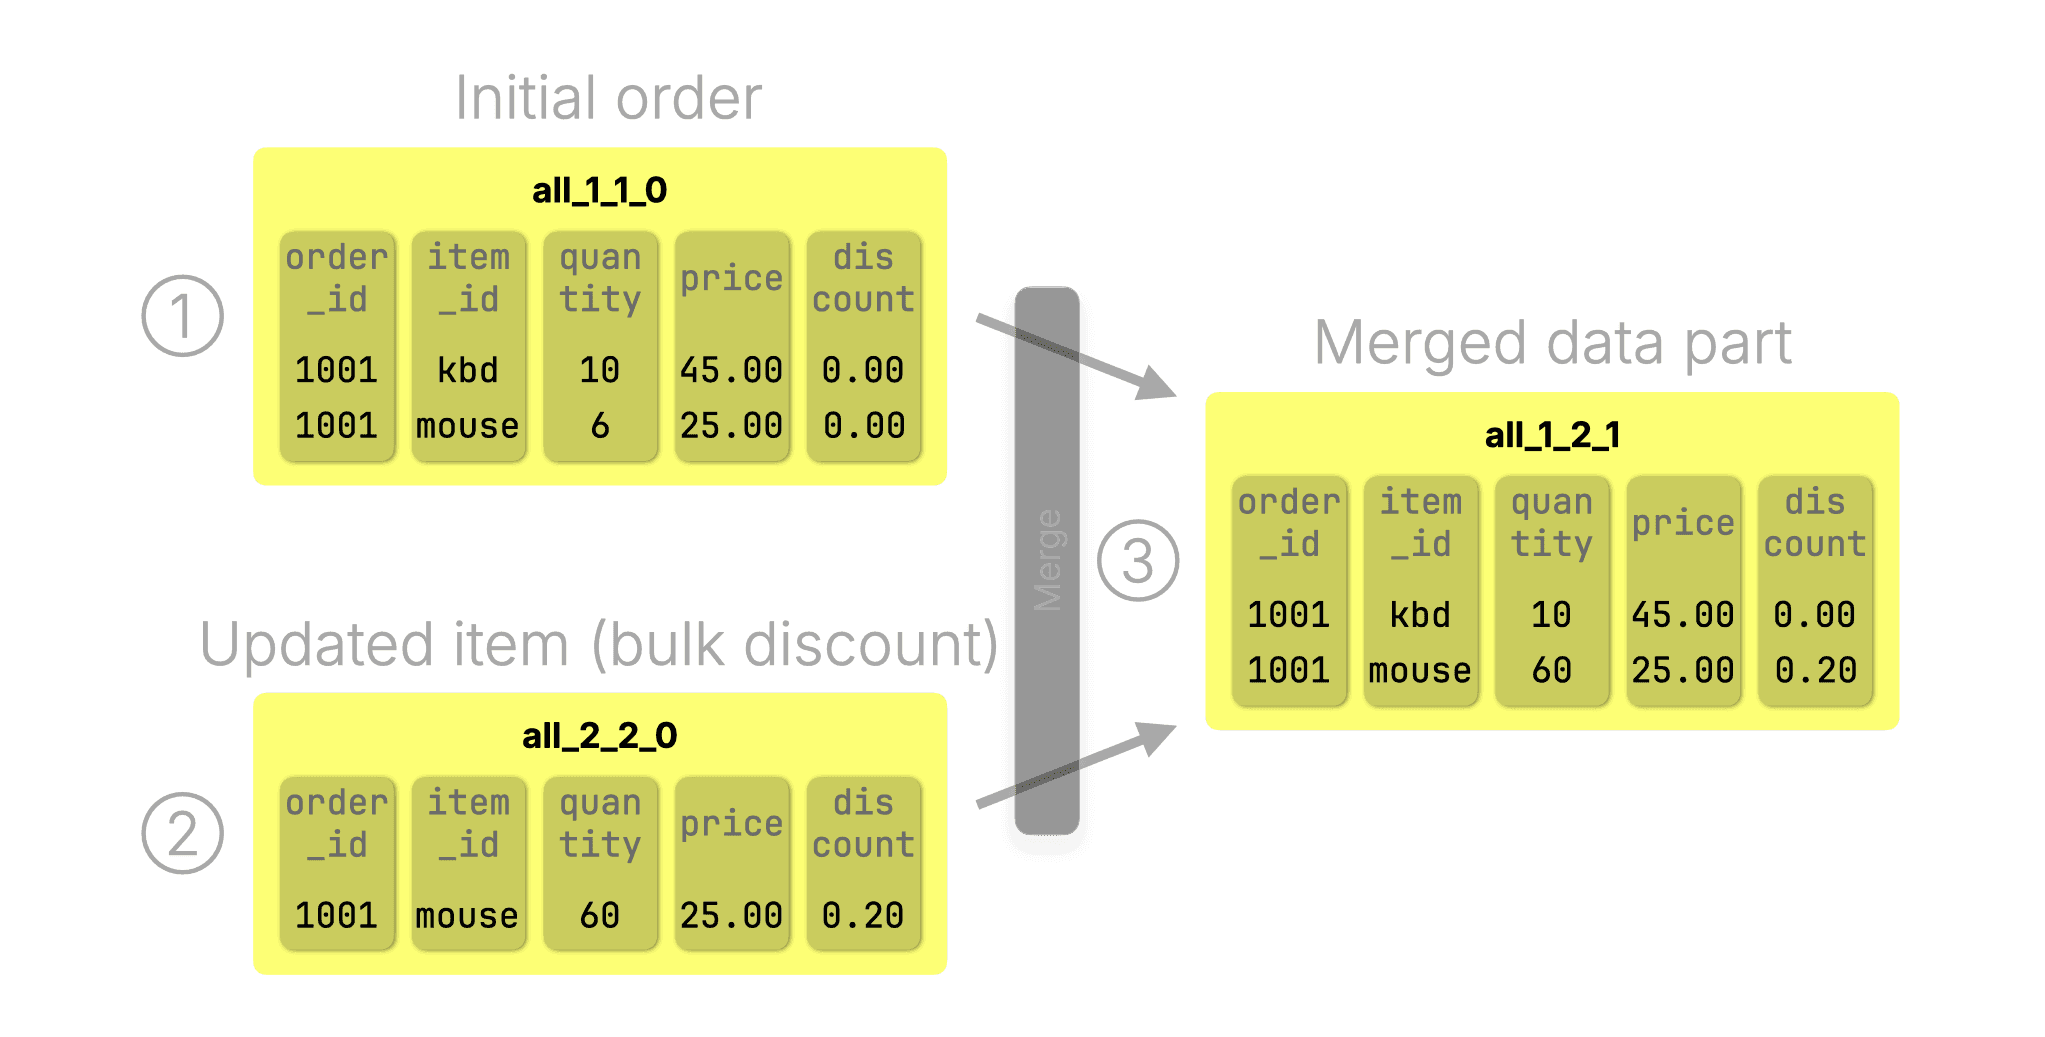
マージ後、パート①と②は破棄され、パート③がテーブルのアクティブなデータパートになります。
一部のカラムのみを変更したい場合はどうすればよいでしょうか。そこで登場するのが CoalescingMergeTree です。
CoalescingMergeTree: 部分更新を自動的に統合する
CoalescingMergeTree は ReplacingMergeTree と同様に機能しますが、1 つの大きな違いがあります。それは部分更新をサポートしている点です。行全体を指定する代わりに、変更されたカラムのみを挿入できます。
同じ orders テーブルを使用します。
CREATE TABLE orders (
order_id Int32,
item_id String,
quantity Nullable(UInt32),
price Nullable(Decimal(10,2)),
discount Nullable(Decimal(5,2))
)
ENGINE = CoalescingMergeTree
ORDER BY (order_id, item_id);注: 部分更新時にスキップできるよう、キー以外のカラムは Nullable として定義されています。これにより、変更されたフィールドのみを挿入し、残りを NULL のままにしておくことができます。
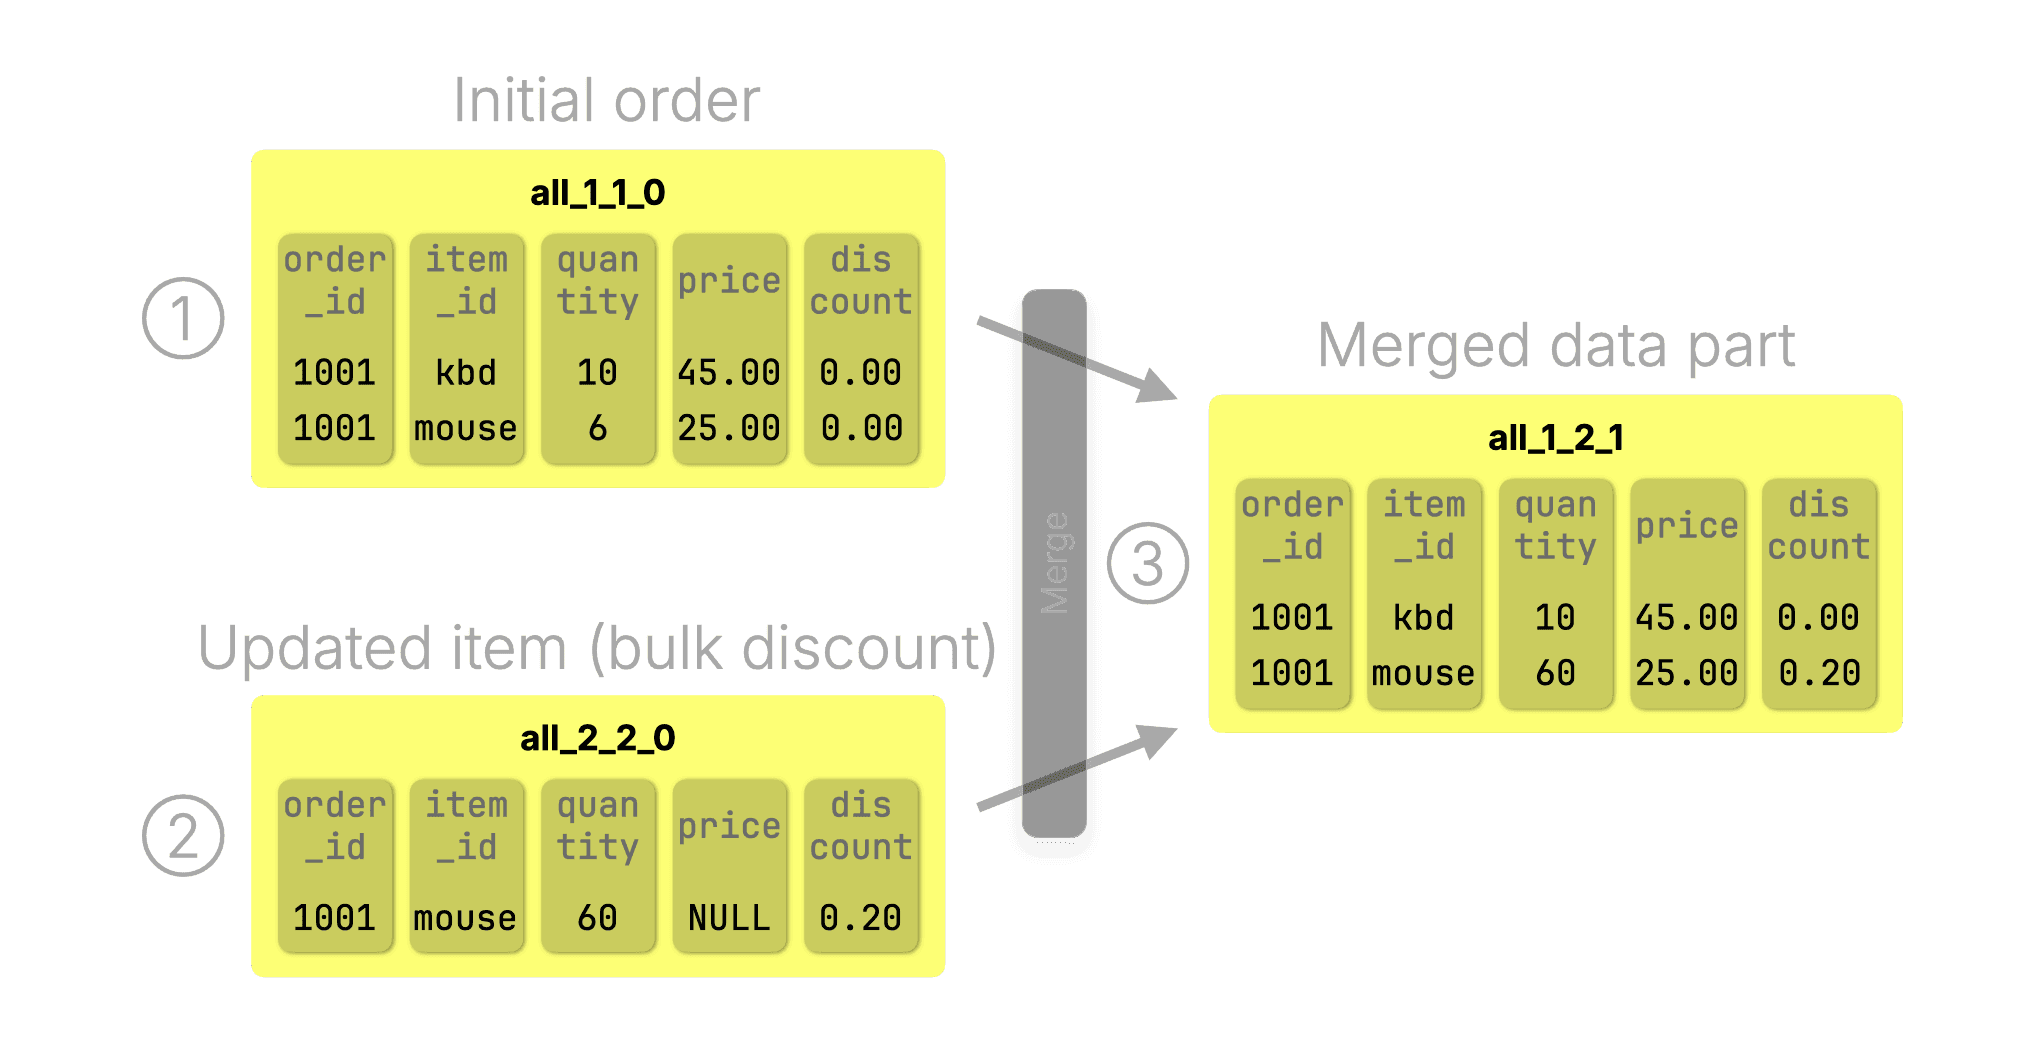
先ほどと同様に、顧客が①最初に定価でキーボード 10 個とマウス 6 個を注文します。
INSERT INTO orders VALUES
(1001, 'kbd', 0, 45.00, 0.00),
(1001, 'mouse', 6, 25.00, 0.00);②部分更新(数量と割引)を含む新しい行を挿入します。
INSERT INTO orders VALUES
(1001, 'mouse', 60, NULL, 0.20);①初回挿入と②更新挿入のバックグラウンドマージによって③新しいアクティブデータパートが生成されます。ここでは ClickHouse が各カラムの最新の非 NULL 値を保持し、スパースな更新を完全な 1 行に統合します。マージ後、ReplacingMergeTree と同様にパート①と②は破棄されます。
一般的なユースケースや**CoalescingMergeTree の内部動作**についての詳細もご覧ください。
それでは、削除はどうでしょうか。CollapsingMergeTree は巧妙な工夫で削除を処理します。
CollapsingMergeTree: 行を挿入して行を削除する
CollapsingMergeTree を使用すると、DELETE を発行することなくデータを削除できます。代わりに、元の行を無効としてマークする特殊な「キャンセル」行を挿入します。
先ほどと同じシンプルな orders テーブルです。今回はエンジンの符号パラメータ(sign parameter)として使用する is_valid カラムを追加しています。
CREATE TABLE orders (
order_id Int32,
item_id String,
quantity UInt32,
price Decimal(10,2),
discount Decimal(5,2),
is_valid UInt8 -- only required for CollapsingMergeTree
)
ENGINE = CollapsingMergeTree(is_valid)
ORDER BY (order_id, item_id);①初回の注文:
INSERT INTO orders VALUES
(1001, 'kbd', 10, 45.00, 0.00, 1),
(1001, 'mouse', 6, 25.00, 0.00, 1);②is_valid = -1 の一致する行(ソートキーのカラムのみが重要で、残りは NULL で構いません)を挿入してアイテムを削除します。
INSERT INTO orders VALUES
(1001, 'mouse', NULL, NULL, NULL, -1);③次回のマージ時、ClickHouse は同じソートキー (order_id, item_id) を持つ +1 と -1 の両方の行を検出して相殺(コラプス)し、両方の行を削除してパート①と②を破棄します。
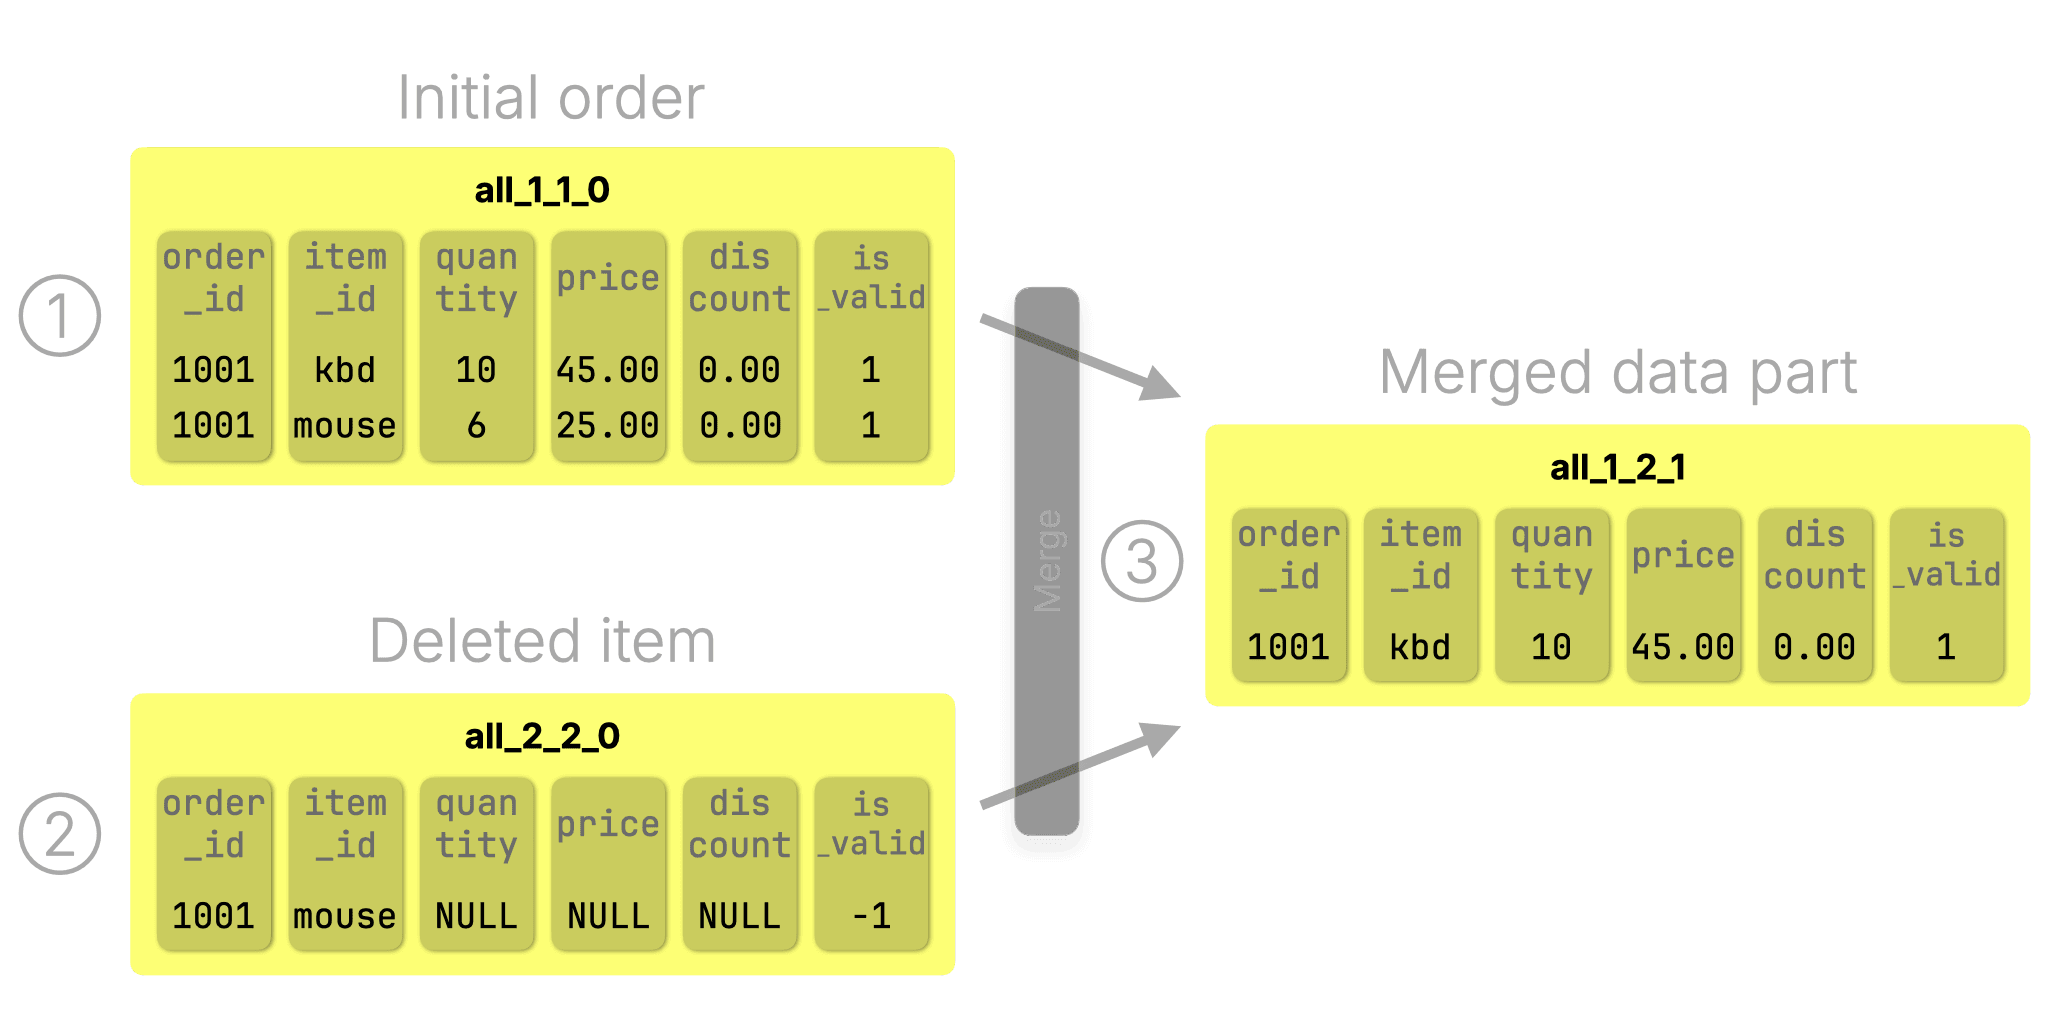
この同じメカニズムは更新にも対応しています。行を更新するには、キャンセル行を挿入し、続けて更新後の値を持つ新しい行を挿入します。次回のバックグラウンドマージ時に、ClickHouse は古い行とキャンセル行を相殺し、新しいバージョンのみを残します。
これによりソートキーの値自体を更新することも可能です。これは CollapsingMergeTree 独自の機能であり、ReplacingMergeTree や CoalescingMergeTree では不可能です。
更新や削除にとどまらず、これら 3 つのエンジンはすべて UPSERT もサポートしています。
おまけ: 組み込みの UPSERT 挙動
ReplacingMergeTree、CoalescingMergeTree、CollapsingMergeTree の 3 つのエンジンはすべて、実質的な UPSERT(挿入または更新)処理をサポートしています。新しい行を挿入すると、(ソートキーによって)一致する行が存在する場合にエンジンが適切なロジックを適用して更新を行います。
このような挿入または更新のパターンは強力な機能であり、標準の UPDATE が直接サポートしていないものです。
SQL ではこのために MERGE コマンドが定義されていますが、記述が冗長であり、実際には効率が劣ります。ClickHouse では、単なる高速な挿入として扱われます。
この挿入ベースのモデルによって、効率的な更新、削除、アップサートが実現します。しかし、マージが行われる前にクエリ側で最新の結果を取得したい場合はどうすればよいでしょうか。
FINAL で最新の結果を取得する
上述の 3 つのエンジンはすべて、バックグラウンドでのデータ集約にマージを使用します。これにより挿入ベースの更新や削除が非常に効率的になる一方で、結果整合性(Eventual Consistency)となります。データの取り込みが激しい場合、マージが遅れる可能性があります(つまり、マージは継続的に実行されるものの挿入がそれを上回る場合があり、統合ウィンドウが遅延している状態と考えてください)。
これに関わらずクエリの正確性を確保するために、ClickHouse では FINAL 修飾子を使用してテーブルエンジンのマージロジックをオンザフライで適用できます。
SELECT * FROM orders FINAL;これによりディスク上で実際のマージがトリガーされるわけではありません。代わりに、クエリ開始時点で存在していた関連するすべてのデータパートをメモリ上で統合し、完全にマージされた行を返します。
3 つのエンジンすべてで一貫して機能します。
- ReplacingMergeTree の場合、各行の最新バージョンを保持します。
- CoalescingMergeTree の場合、スパースな更新を完全な行に統合します。
- CollapsingMergeTree の場合、キャンセルロジックを適用して削除を相殺し、更新を反映します。
FINAL を使用すると、挿入ベースの処理による圧倒的な速度を維持しながら、必要なときに予測可能な最新の結果を取得できます。
FINAL を恐れる必要はありません
ClickHouse は、インテリジェントなインメモリのアルゴリズム、選択的なパート処理(不要なマージのスキップ)、ベクトル化された実行によって FINAL を最適化しており、大規模なデータセットでもオンザフライの統合を高速に行えます。競合する行を含まないパート範囲のマージを回避し、不要な作業をスキップします。カラムは独立して並列に処理され、メモリ使用量を抑えてパフォーマンスを向上させます。これは特にワイドテーブルで効果的です。
これで正しい結果が得られます。しかし、これは本当に「UPDATE」と言えるのでしょうか。少し広い視野で考えてみましょう。
「真の」更新と何が違うのか?
全体像を俯瞰してみると、馴染みのあるパターンに気づくはずです。ClickHouse の更新は、従来の行指向ストアと同じリズムを踏襲しています。すなわち、「新しいバージョンを書き込み」、その後に**「新しいバージョンを読み取る」**という流れです。
| 従来の行指向ストア | ClickHouse |
|---|---|
| 古い行をインプレースで上書きする | 古いバージョンの隣に新しいバージョンを追記する |
| クエリは即座に新しいバージョンを読み取る | クエリは即座に新しいバージョンを読み取る |
| 書き込みがコミットされると古いバージョンは消去される | 古いバージョンは後からバックグラウンドのマージ中に削除される |
つまり、特にクリーンアップ処理が遅延実行される点において仕組みは異なりますが、更新のセマンティクスは驚くほど似ています。
ただし、そのお馴染みの結果を得るには、ClickHouse のエンジニアのように考える必要があります。バックグラウンドマージを理解し、いつ FINAL を使うべきかを把握し、適切なエンジンを選択しなければなりません。また、各更新を新しい行の挿入としてモデル化し、エンジン固有の挙動に合わせてスキーマを設計することも多くなります。たとえば、ReplacingMergeTree ではソートキーによる行の更新しかできず、そのキーを変更する場合はテーブルを再作成する必要があります。
従来の SQL データベースを使ってきたユーザーにとって、これは期待する更新のあり方とは異なります。
エンジンセマンティクスから SQL のシンプルさへ
これらの専用エンジンは信じられないほど効率的ですが、トレードオフも伴います。速度と柔軟性をもたらす一方で、標準 SQL のシンプルさは損なわれます。ユーザーはマージ、ソートキー、エンジン固有の挙動について意識しなければなりません。
そこで ClickHouse は進化を遂げました。
第 2 回では、性能を損なうことなく、高速な SQL スタイルの UPDATE を ClickHouse に導入した方法を紹介します。
従来の「重い」ミューテーションから、軽量なオンザフライの更新、そしてパッチパートを活用した高速な宣言型更新に至るまでの完全な進化プロセスを解説します。パッチパートは、ここまで見てきたエンジンから着想を得つつ、完全に汎用化され、親しみのある SQL 構文にまとめられた拡張性の高い新しいメカニズムです。
ユーザーが UPDATE に期待するすべてを、ClickHouse 流に最適化した形でお届けします。