5万


TLDR
大規模環境におけるオブザーバビリティ: 社内システムは非圧縮ログ 19 PiB から 100 PB へ、約 40 兆行から 500 兆行へと拡大しました。
効率の大幅な向上: 以前必要だった CPU の 10% 未満で、イベント量の 20 倍の急増を吸収しました。
OTel の落とし穴: OpenTelemetry で必要とされるイベントのパースとマーシャリングがボトルネックとなりスケールしませんでした。カスタムパイプラインによってこの課題に対処しました。
HyperDX のご紹介: Lucene ライクな構文でシームレスな探索、相関分析、根本原因分析を実現する、ClickHouse ネイティブのオブザーバビリティ UI です。
はじめに
約 1 年前、私たちは ClickHouse Cloud の監視用に構築した社内ロギングプラットフォームである LogHouse のストーリーを公開しました。当時、このプラットフォームは 19 PiB という膨大なデータを管理していました。LogHouse は単にオブザーバビリティの課題を解決しただけでなく、増大し続けて持続不可能になりつつあった Datadog の請求を置き換えることで、数百万ドルを節約しました。その投稿への反響は圧倒的でした。従来のオブザーバビリティベンダーに対して同様の苦悩を抱える人々の共感を呼び、大規模環境において効果的なデータ管理がいかに極めて重要であるかが浮き彫りになりました。
1 年後、LogHouse は私たちの予想をはるかに超えて成長し、現在では 500 兆行近くに及ぶ 100 PB 以上の非圧縮データを保存しています。この規模への到達により、一連のアーキテクチャ変更、新しいツールの導入、そして苦労して得た教訓の数々を余儀なくされました。それらは共有する価値があると考えます。特に、OpenTelemetry(OTel)は(私たちは今でも高く評価していますが)オブザーバビリティの万能薬とは限らず、カスタムパイプラインが不可欠になる場合もあるという点です。
私たちのケースでは、この転換によって最も重要なデータソースにおいて、以前の 10% 未満の CPU でイベント量の 20 倍の増加を処理できるようになりました。これはコストと効率に絶大な影響を与える変革です。
ClickHouse による HyperDX の買収もあり、スタックの他の部分も変化しました。これによりファーストパーティの ClickHouse ネイティブ UI が得られただけでなく、ClickHouse を中心に構築された実用的なエンドツーエンドのオブザーバビリティスタックである ClickStack の誕生にもつながりました。HyperDX の導入により、Grafana ベースのカスタム UI からの移行を開始し、探索、相関分析、根本原因分析のためのより統合されたエクスペリエンスへと移行しています。
オブザーバビリティに ClickHouse を採用し、手頃なコストでどれほど多くのデータを保存・クエリできるかを実感するチームが増えている中、今回の知見が最初の投稿と同じように役立つことを願っています。この歩み、OTel が適切となる場面とケース、そしてログパイプラインを 100 PB までスケールさせた方法に興味がある方は、ぜひ読み進めてください。
汎用の先へ: 大規模環境におけるオブザーバビリティの進化
この 1 年で、私たちのオブザーバビリティへのアプローチは大きな変革を遂げました。汎用ログの収集には引き続き OpenTelemetry を活用していますが、システムのスケールに伴い、その限界に直面し始めました。OTel は依然として私たちのツールキットの大切な一部ですが、最も要求の厳しいワークロードに必要なパフォーマンスと精度を完全には発揮できませんでした。このため、クリティカルなシステムに合わせて専用ツールを開発し、汎用ソリューションが真に適する領域を再考することになりました。その過程で、収集するデータの範囲を広げ、エンジニアへのインサイトの提示方法も刷新しました。
スケールの新たなフロンティア
前回 LogHouse について書いた際、私たちは 37 兆行にわたる 19 PiB の非圧縮データを処理していることを誇りにしていました。今では、それらの数字は遠い昔のことのように思えます。LogHouse は現在、約 500 兆行に相当する 100 PB を超える非圧縮データを保存しています。 内訳の概要は次のとおりです。
| システム | 非圧縮サイズ | 保存行数 |
|---|---|---|
| SysEx | 93.6 PB | 431 兆行 |
| OTel | 14.5 PB | 16.7 兆行 |
これらの数字はあるストーリーを物語っています。以前の投稿では、テレメトリの 100% が OpenTelemetry を経由し、すべてのログ行が同じ汎用パイプラインを介して収集されていました。しかし、データの規模と複雑さが増すにつれて、特化の必要性も高まりました。 総データ量は 5 倍以上に増加しましたが、内訳を見ると戦略的な転換が明らかです。現在、データの大部分は ClickHouse 自体からの高スループットかつ高精度なシステムログを処理するために開発した新しい専用エクスポーター「SysEx」によってもたらされています。この転換は、オブザーバビリティパイプラインに対する私たちの考え方の転換点となりました。そして、これが最初の重要なトピックへとつながります。
LogHouse が稼働している規模を理解するのに、以下が役立つことを願っています。
極限の大規模環境における OpenTelemetry の効率性の課題
当初、私たちはすべてのログ収集に OpenTelemetry(OTel)を使用していました。これは素晴らしい出発点であり、確立された業界標準でもあったため、Kubernetes 環境のすべての Pod がログを ClickHouse に送信するベースラインを迅速に構築できました。しかし、スケールするにつれて、コアとなる ClickHouse サーバーのテレメトリを転送するための専用ツールを構築すべき 2 つの主な理由が判明しました。
第一に、OTel は標準出力を介して ClickHouse のテキストログを適切にキャプチャできましたが、これは ClickHouse が公開するテレメトリのごく一部にすぎません。ClickHouse のエキスパートであれば誰もが知っているように、真の宝はシステムテーブルにあります。これはログ、メトリクス、運用上のインサイトが豊富に構造化されたコレクションであり、標準出力に出力される内容をはるかに超えています。これらのテーブルは、クエリ実行の詳細からディスク I/O、バックグラウンドタスクの状態まですべてを記録し、エフェメラルなログとは異なり、クラスター内に無期限に保持できます。リアルタイムのデバッグと過去の分析の両方において、このデータは極めて貴重です。私たちはそのすべてを LogHouse に取り込みたいと考えました。
第二に、この特定のタスクにおける OTel パイプラインの非効率性が、スケールに伴って明白になったことです。
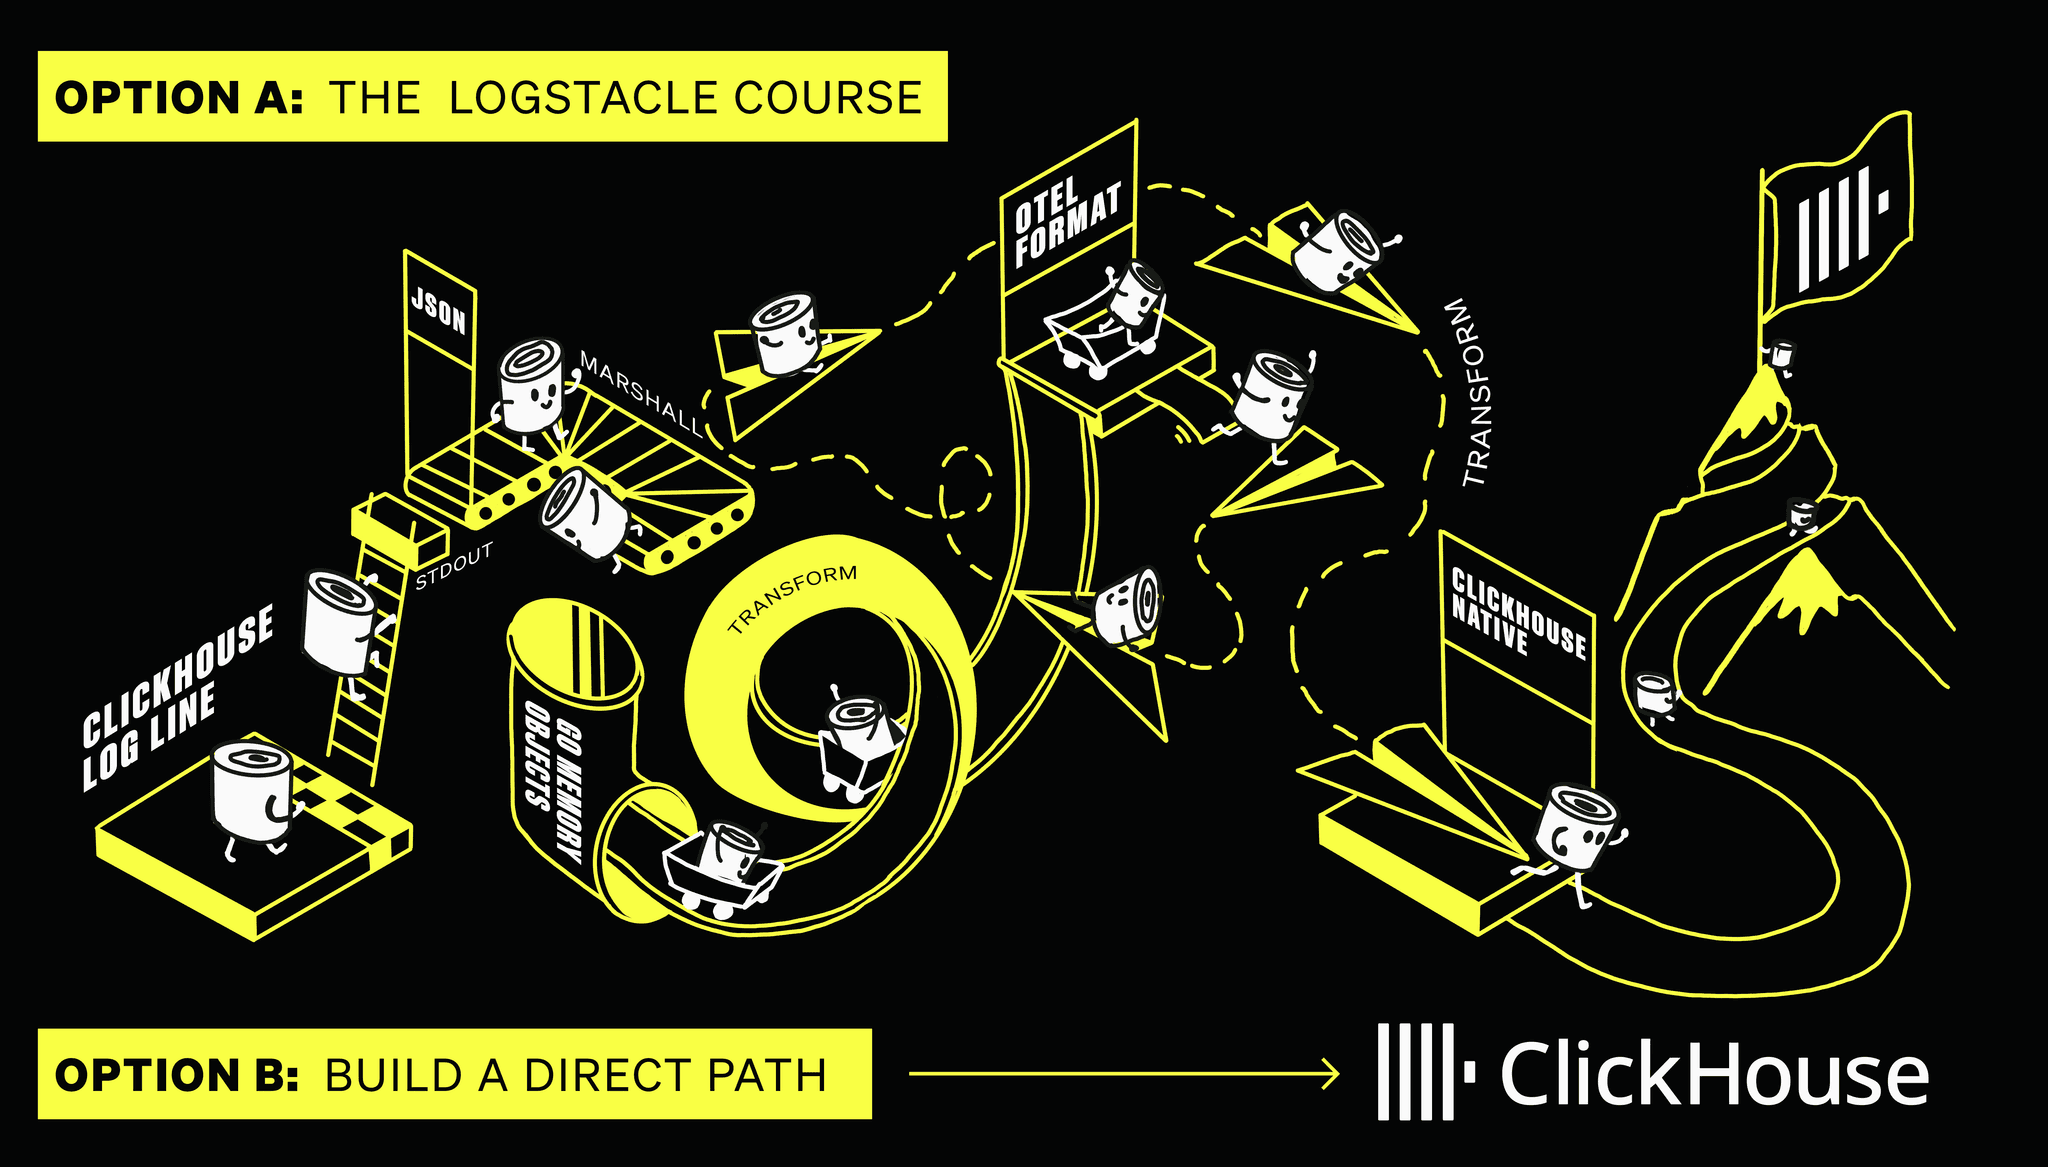
データの流れは以下のようになっていました。
- ユーザーの ClickHouse インスタンスが標準出力にログを JSON として書き込む。
- kubelet がこれらのログを
/var/log/…に永続化する。 - OTel コレクターがディスクからこれらのログを収集し、JSON をインメモリ表現にパースおよびマーシャリングする。
- コレクターがこれらを OTel ログ形式(これもインメモリ表現)に変換する。
- 最後に、ネイティブ形式を介して別の ClickHouse インスタンス(LogHouse)に再挿入される(ClickHouse Go クライアント内での再度の変換が必要)。
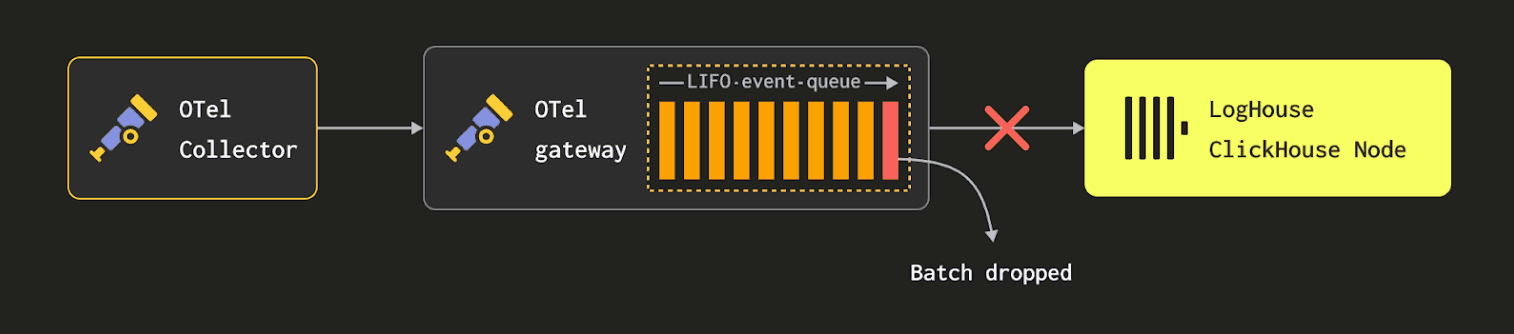
注: ここで説明したアーキテクチャは簡略化されたものです。実際には、私たちの OTel パイプラインはより複雑でした。ログはまずエッジで JSON として収集され、OTel 形式に変換され、OTLP 経由でゲートウェイインスタンスのセットに送信されていました。これらのゲートウェイ(これも OTel コレクター)は追加の処理を実行してから、最終的にデータを取り込み用に ClickHouse のネイティブ形式に変換していました。各ステップでオーバーヘッド、レイテンシ、さらなる複雑さが発生していました。
私たちの規模では、このパイプラインによって非効率性とデータ損失という 2 つの重大な問題が生じました。まず、繰り返されるデータ変換に膨大なコンピュートを浪費していました。ネイティブの ClickHouse 型が JSON にフラット化され、OTel ログ形式にマッピングされてから再取り込みされ、最終的にもう一方の ClickHouse で再解釈されていました。これにより CPU サイクルが無駄になっただけでなく、データの精度も低下しました。 さらに重要なことに、コレクター自体のハードなリソース制限に達していました。各 Kubernetes ノードのエージェントとしてデプロイされていたため、標準的な Kubernetes の制限を通じて厳しい CPU とメモリの制約を受けていました。トラフィックが急増すると、多くのコレクターが高負荷になり、ClickHouse から出力されるデータ量に追いつけず、ログ行を完全にドロップし始めました。データが LogHouse に到達する前に、エッジで失われていたのです。 私たちは岐路に立たされました。OTel エージェント(およびゲートウェイ)のリソースフットプリントを劇的にスケールアップするか、取り込みモデル全体を再考するかです。私たちは後者を選択しました。
注: コストを分かりやすく示すと、OpenTelemetry パイプラインを介してイベントをドロップせずに毎秒 2,000 万行を処理するには、エージェントとコレクター全体で推定 8,000 個の CPU コアが必要になります。これはログ収集のためだけに割り当てられる莫大なフットプリントであり、汎用的なアプローチが私たちの規模では維持不可能であることは明白でした。
SysEx の構築: ClickHouse 間転送のための専用システム
私たちの解決策は、System Tables Exporter(通称 SysEx)を開発することでした。これは、ある ClickHouse インスタンスから別のインスタンスへと可能な限り効率的にデータを転送するために設計された専用ツールです。ユーザーの Pod 内のシステムテーブルから LogHouse 内のテーブルへ、ClickHouse のネイティブ型を維持し、すべての中間変換を排除して直接転送したいと考えました。これには素晴らしい副次効果があります。テーブルスキーマが同一であり、いくつかのエンリッチメントカラム(Pod 名、ClickHouse バージョンなど)が追加されているだけなので、エンジニアが稼働中のインスタンスのトラブルシューティングに使用するクエリを、LogHouse 内の全フリートにわたる履歴データのクエリへと容易に適応させることができます。
まず強調すべき点として、SysEx は送信元から送信先へとデータを文字どおり 1 バイト単位でそのままコピー(byte-for-byte copy)します。これにより完全な精度が維持され、不要な CPU オーバーヘッドが排除され、繰り返しのマーシャリングによる落とし穴が回避されます。
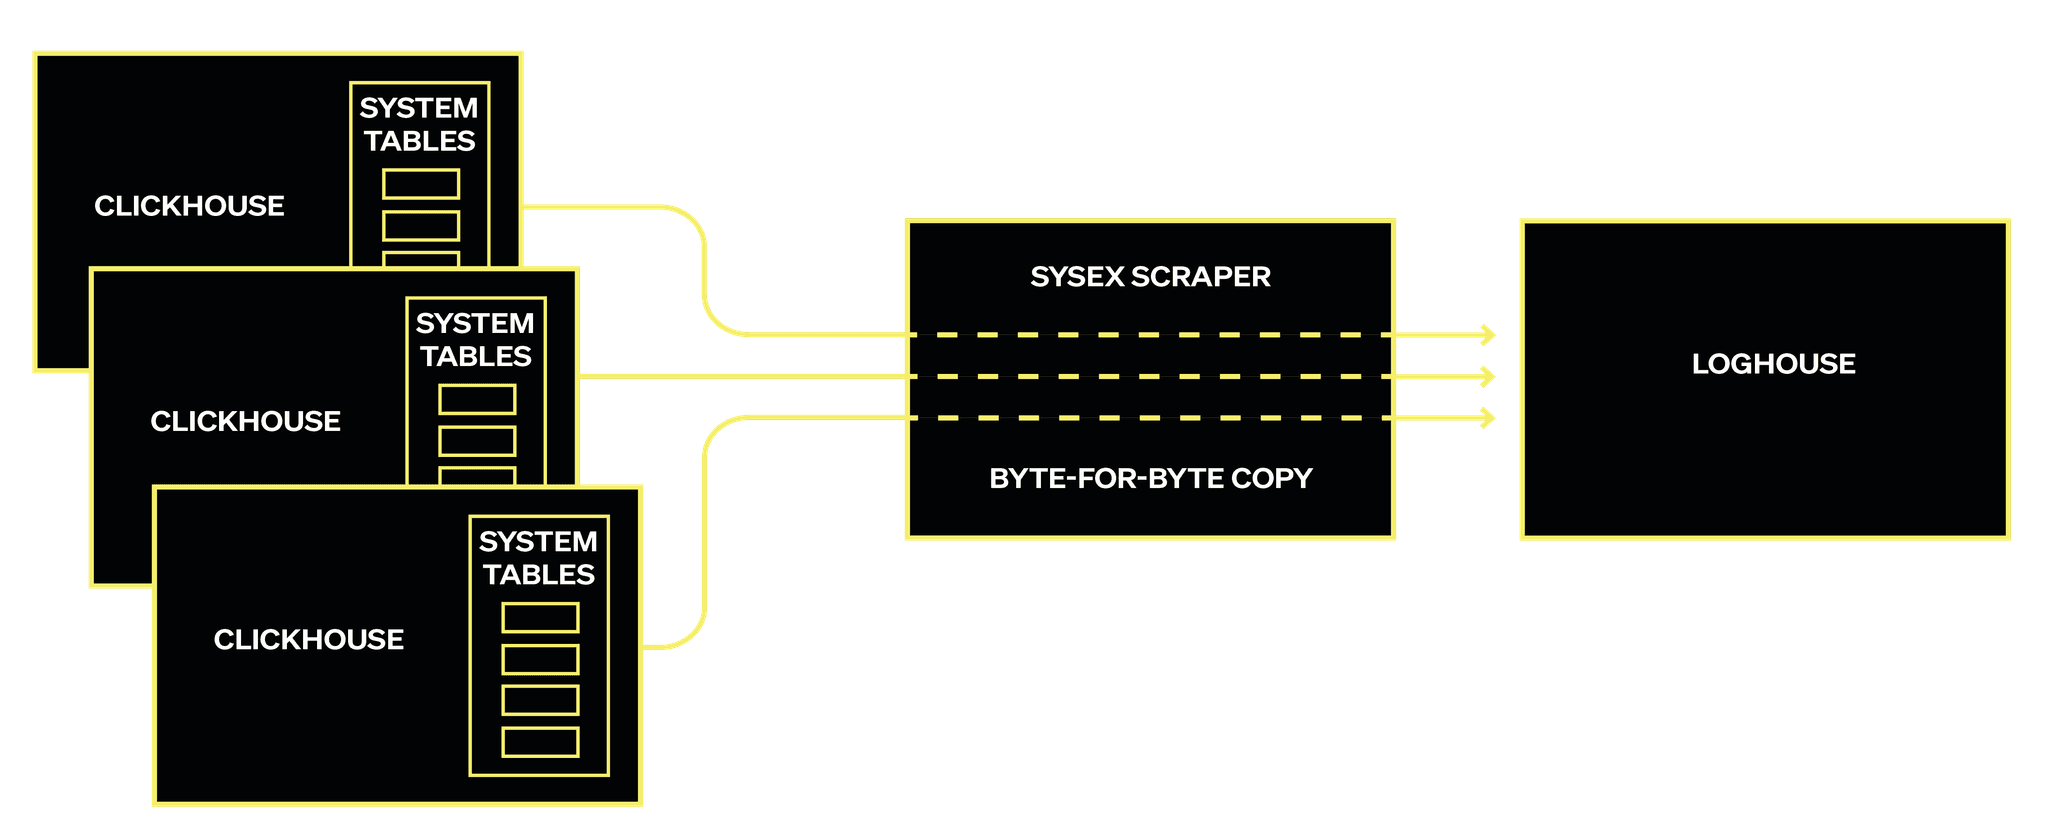
アーキテクチャはシンプルかつ強力です。ユーザーの ClickHouse インスタンスに接続する SysEx スクレイパーのプールを実行しています。ハッシュリングによって各ユーザー Pod が特定のスクレイパーレプリカに割り当てられ、負荷が分散されます。これらのスクレイパーは、送信元 Pod のシステムテーブルに対して SELECT クエリを実行し、デシリアライズを行うことなくデータを LogHouse に直接ストリーミングします。スクレイパーは単に送信元と送信先の間でバイトデータを調整して転送するだけです。 システムテーブルのスクレイピングでは、バッファのフラッシュによるデータの取りこぼしを防ぐために慎重な処理が必要です。幸いなことに、ほぼすべてのシステムテーブルデータは本質的に時系列データです。SysEx はこれを利用し、スライディング時間枠内でクエリを実行し、リアルタイムから意図的に小さなバッファ(通常は 5 分)を遅らせます。この遅延によって内部バッファがフラッシュされるため、スクレイパーがノードにクエリを実行したときに、その時間枠の関連する行がすべて完全に存在することが保証されます。この戦略は信頼性が高く、LogHouse への適時かつ完全なイベント配信に関する社内 SLA を満たしていることが実証されています。
SysEx は、ClickHouse Cloud のインフラコンポーネントの大部分と同様に Go で書かれています。当然ながら、Go の ClickHouse クライアントに詳しい方であれば、ClickHouse からの読み取りおよび書き込み時に、組み込みのデータのマーシャリングとアンマーシャリングをどのように回避しているのかという疑問が生じるでしょう。デフォルトでは、クライアントはデータを Go ネイティブの型に変換しますが、これではバイト単位のコピーの目的が損なわれてしまいます。これを解決するため、私たちは Go クライアントに改善をコントリビュートし、内部マーシャリングを完全にバイパスできるようにしました。これにより、SysEx はデコード、再エンコード、中間データ構造の割り当てを行うことなく、ネイティブ形式のデータを送信元クラスターから LogHouse に直接ストリーミングできるようになりました。
このアプローチは、大まかには次のような単純な Bash コマンドと同等です。
curl -s -u 'default:<password>' "https://sql-clickhouse.clickhouse.com:8443/?query=SELECT+*+FROM+system.query_log+FORMAT+Native" | curl -s -X POST --data-binary @- 'http://localhost:8123/?query=INSERT+INTO+query_log+FORMAT+Native'興味のある方向けの実際の Go による実装は、こちらで確認できます。
最も重要な点として、プル型モデルを採用しているため、SysEx は OTel のような大量のバッファリングを必要としません。スクレイパーは一定の制御されたレートでデータをクエリするため、LogHouse が一時的に利用できなくなった場合や、送信元でテレメトリが急増した場合でも、ログがドロップするリスクがありません。代わりに、SysEx は過去の時間枠をスクレイピングすることでバックフィルを自然に処理し、システムに過剰な負荷をかけたり複雑なリトライバッファを必要としたりすることなく、信頼性の高い配信を保証します。
動的スキーマ生成
SysEx アプローチの主な課題の 1 つは、送信元と送信先のスキーマが一致していることを前提としている点です。しかし実際には、ClickHouse ユーザーならご存じのとおり、システムテーブルのスキーマは頻繁に変更されます。エンジニアは新機能をサポートし、問題の診断を迅速化するために新しいメトリクスやカラムを継続的に追加するため、スキーマは常に変化します。
これに対処するため、スキーマを動的に生成しています。SysEx がシステムテーブルを検出すると、そのスキーマを検査してハッシュ化し、一致するテーブルがすでに LogHouse に存在するかどうかを判断します。存在する場合は、そこにデータが挿入されます。存在しない場合は、そのシステムテーブル用に新しいスキーマバージョン(例: text_log_6)が作成されます。
クエリ時には、ClickHouse の Merge テーブルエンジンを使用して、すべてのスキーマのイテレーションを単一の論理ビューに統合します。これにより、複数のバージョンのシステムテーブルにわたってシームレスにクエリを実行できます。このエンジンは、テーブル間で互換性のあるカラムのみを選択するか、要求されたカラムを含むテーブルにクエリを制限することで、スキーマの違いを自動的に解決します。これにより、クエリのシンプルさを損なうことなく、また手動でのスキーマ管理を必要とすることなく、スキーマの進化に伴う前方互換性を確保できます。
状態のスナップショット作成
オブザーバビリティ機能のスケールと改良を続ける中で、私たちが重視したことの 1 つは、system.processes などのインメモリシステムテーブルのキャプチャでした。これまでキャプチャしてきた時系列データとは異なり、これらのテーブルは特定の時点におけるサーバーの状態のスナップショットを提供します。これに対応するため、定期的なスナップショットプロセスを実装し、これらのインメモリテーブルをキャプチャして LogHouse に保存するようにしました。
このアプローチにより、特定の瞬間におけるクラスターの状態をキャプチャできるだけでなく、テーブルスキーマやクラスター設定などの重要な詳細情報をタイムトラベルで確認することも可能になります。この追加データによって、クラスター全体や ClickHouse Cloud 全体にわたる分析を実行できるようになり、診断機能が強化されました。これをサービス設定や used_functions のようなクエリ特性と結合して異常を特定できるため、問題が発生した際にその根本原因を突き止めることが容易になります。クエリを特定のスキーマと関連付けることで、ユーザーのパフォーマンスや信頼性の問題をプロアクティブに特定して解決する能力がさらに向上しました。
フリート規模のクエリ
SysEx によって実現した数多くの強力な機能の 1 つが、ユーザーが個々の ClickHouse インスタンスを監視するために使用している同じ 高度なモニタリングダッシュボードのクエリ を活用し、顧客インスタンスのフリート全体に対して同時に実行できるようになったことです。
リリース分析においては、デプロイの前後で実績のある診断クエリを実行し、フリート全体における動作の変化を即座に特定できるようになりました。これは包括的なリリース分析プロセスに組み込まれています。クエリのパフォーマンスパターン、リソース使用率の傾向、エラー率を分析するクエリがリアルタイムで完了するため、フリート規模でリグレッションを迅速に発見したり、改善を検証したりできます。
第二に、サポートダッシュボードに、ユーザーが信頼を寄せる同じ詳細な診断クエリを組み込めるようになりました。しかも、一元管理されたテレメトリによってコンテキストが強化されています。ユーザーの問題を調査する際、サポートエンジニアはおなじみの高度なダッシュボードクエリを実行しながら、ネットワークログ、Kubernetes イベント、データプレーンおよびコントロールプレーンのイベントを同時に相関分析できます。これらすべてが同一のインターフェース内で行えます。

データ量は 20 倍、CPU は 90% 削減: リライトを支える数値
この SysEx による効率の向上は驚異的です。LogHouse の以下の統計をご覧ください。
- OTel コレクター: 毎秒 200 万ログの送信に 800 個を超える CPU コアを使用。
- LogHouse スクレイパー(SysEx): 毎秒 3,700 万ログの送信に使用する CPU コアはわずか 70 個。
この専用アプローチにより、最も重要なデータソースにおいて、CPU フットプリントを 10% 未満に抑えながらイベント量の 20 倍の増加に対応できました。何よりも重要なのは、エッジでイベントがドロップすることがなくなった点です。以前の OTel ベースのパイプラインでこれと同じレベルの信頼性を達成するには、8,000 個を超える CPU コアが必要だったはずです。SysEx は、完全な精度と安定した配信を維持しながら、そのほんの一部のリソースでそれを実現しています。
OpenTelemetry が適切な選択肢となる場合
ここまで読み進めてこられた方は、OpenTelemetry が依然として適切な選択肢となるのはどのような場合なのか、そして今でも有用なのかと疑問に思われるかもしれません。 私たちは、間違いなく有用であると確信しています。極限の大規模環境における課題(毎秒 2,000 万行を超えるログのパースと処理など)に対応するためにアーキテクチャを進化させてきましたが、OpenTelemetry は依然として私たちのスタックの不可欠な要素です。標準化されたベンダーニュートラルな形式を提供し、新規ユーザーに優れたオンボーディング体験を提供します。そのため、ClickStack のデフォルトの選択肢となっています。ClickHouse の内部構造と密接に統合されている SysEx とは異なり、OpenTelemetry はプロデューサーとコンシューマーを疎結合にします。これは、特にオブザーバビリティプラットフォーム間で柔軟性を求めるユーザーにとって、大きなアーキテクチャ上の利点です。
また、SysEx が動作できないシナリオにも適しています。SysEx はプル型であり、稼働中のシステムテーブルへのクエリに依存しているため、サービスが正常かつ応答可能である必要があります。サービスがクラッシュループに陥っている場合や停止している場合、必要なシステムテーブルが利用できないため、SysEx はデータをスクレイピングできません。対照的に、OpenTelemetry はパッシブに動作します。サービスが障害状態にある場合でも、stdout や stderr に出力されたログをキャプチャします。これにより、インシデント発生時にログを収集し、サービスが完全に正常な状態に復帰しなかった場合でも根本原因分析を実行できます。
このため、私たちはすべての ClickHouse サービスにわたって引き続き OpenTelemetry を運用しています。主な違いは収集する対象にあります。以前はトレースレベルのログを含め、すべてを取り込んでいました。現在では、info レベル以上のみを収集しています。これによりデータ量が大幅に削減され、OTel コレクターとゲートウェイをはるかに少ないリソースで稼働させることができます。その結果、より小規模で焦点を絞ったパイプラインとなり、前述の毎秒 200 万ログ行を今でも処理しています。
より優れた体験をもたらす HyperDX
これらすべてのデータを収集することは、始まりにすぎません。本当に重要なのは、それを利用可能にし、アクセスしやすくすることです。LogHouse の最初のイテレーションでは、Grafana 上に高度にカスタマイズされたオブザーバビリティ体験を構築しました。それは十分に役立ちましたが、社内のデータソースが増大し多様化するにつれて(特に SysEx とワイドカラムのテレメトリの導入により)、ClickHouse とより深く統合されたものが必要であることは明らかでした。
この課題は私たちだけのものではありませんでした。ClickHouse 上にオブザーバビリティソリューションを構築する多くのチームが同じ問題に直面していました。データを ClickHouse に取り込むのは簡単でしたが、その価値を最大限に引き出す UI を構築するには、多大なエンジニアリングの取り組みが必要でした。専任のフロントエンドリソースを持たない小規模なチームや企業にとって、ClickHouse を活用したオブザーバビリティは手の届かないことが多いものでした。
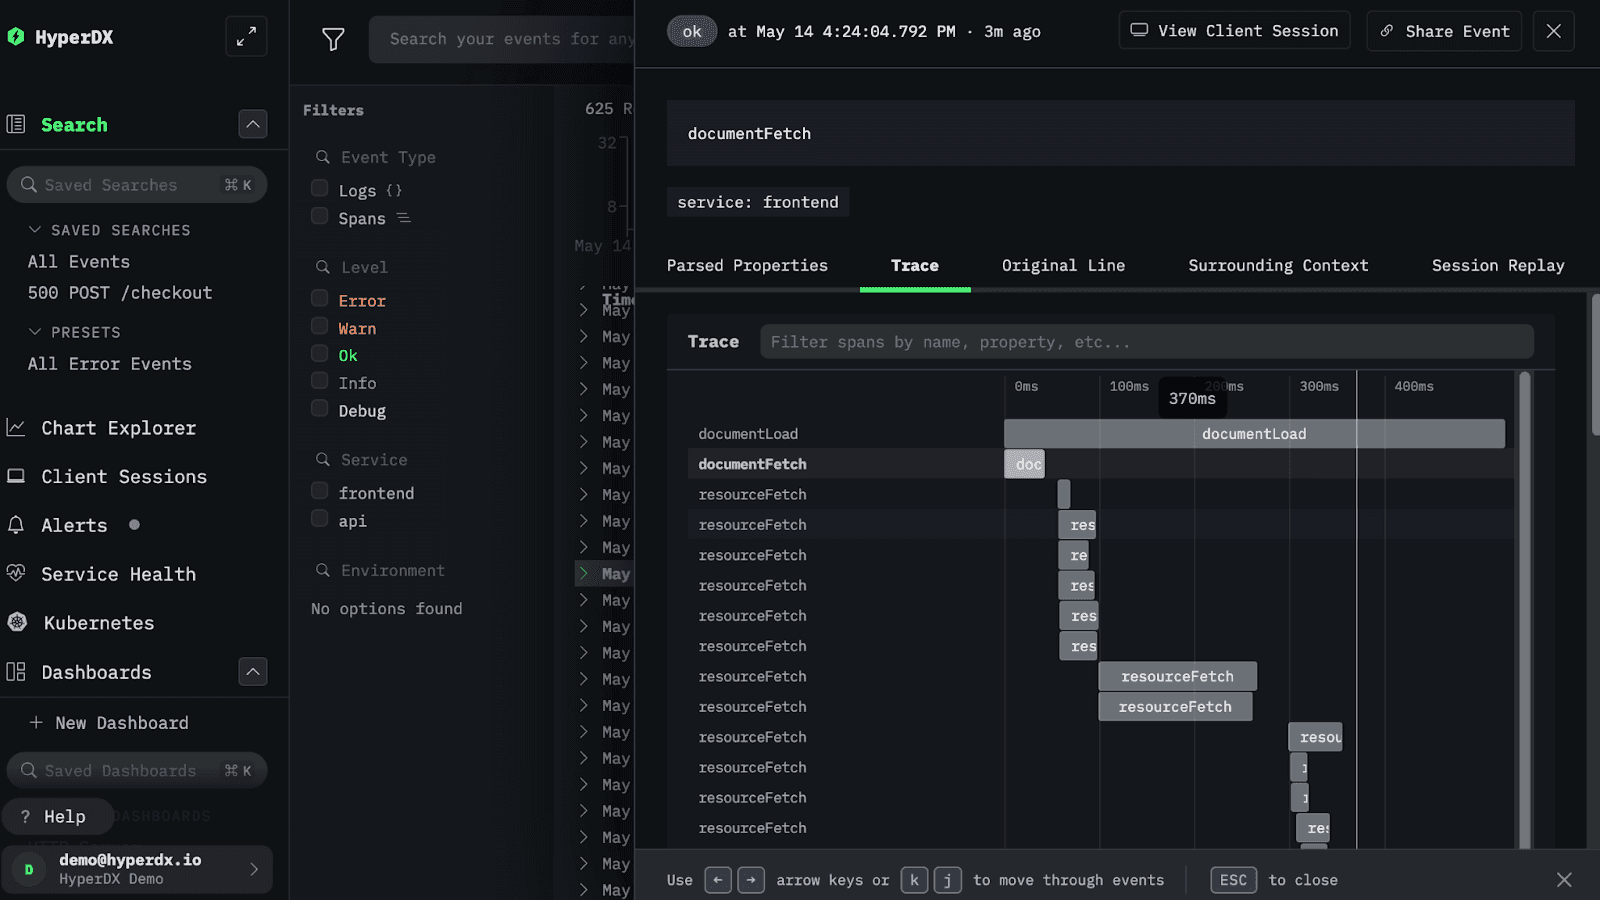
HyperDX がそれを変えました。ログやトレースの大規模な探索、相関分析、解析をサポートする、ファーストパーティの ClickHouse ネイティブ UI を提供しました。そのワークフローは ClickHouse を念頭に置いて設計されており、クエリを最適化してレイテンシを最小限に抑えます。買収前に HyperDX を評価した際、私たちや他のチームが経験してきた多くのペインポイントに対処していることはすでに明らかでした。Lucene 構文を使用してクエリを実行できる機能により、データ探索は劇的に簡素化され、多くの場合それで十分です。重要なことに、SQL によるクエリも引き続き可能です。これは、より複雑なイベント分析には今でも不可欠だと考えています(「より複雑な分析のための SQL」を参照)。
HyperDX が極めて魅力的な選択肢となった主な理由は、v2.0 で導入されたスキーマに依存しないアプローチです。ログテーブルが単一の固定された構造に従うことを強制しません。この柔軟性は、多数のソースからデータを取り込む LogHouse のようなシステムにとって不可欠です。
- OpenTelemetry パイプラインからの標準化されつつも進化するデータ形式をシームレスに処理します。
- さらに重要なことに、SysEx やその他のカスタムエクスポーターによって生成される、高度に特化したワイドカラムテーブルに対して設定不要(out-of-the-box)で機能します。SysEx のスキーマに関する予備知識や、複雑な Grok パターン による特化設定を必要とせずにこれを実現します。背後でスキーマを検査し、それらに合わせて自動的に適応するだけです。
これは、エンジニアリングチームがユーザーインターフェースを壊したり再設定したりすることを一切心配せずに、独自で最適なスキーマを持つ新しいデータソースを LogHouse に追加できることを意味します。HyperDX の強力な UI およびセッションリプレイ機能と、LogHouse の膨大なデータリポジトリを組み合わせることで、エンジニア向けの統一された柔軟なオブザーバビリティ体験を創出しました。

強調しておく価値があるのは、Grafana も私たちのオブザーバビリティスタックにおいて依然として独自の役割を果たしているという点です。Grafana をベースとした社内アプリケーションには、特にルーティングとクエリスコープの処理方法において明確な利点があります。ユーザーは、クエリ対象のネームスペース(実質的には顧客のサービス)を指定する必要があります。舞台裏では、アプリケーションは各サービスのデータがどこにあるかを正確に把握しており、クエリを LogHouse 内の適切な ClickHouse インスタンスに直接ルーティングできます。これにより、無関係なサービス間での不要なクエリ実行が最小限に抑えられ、リソース使用効率が維持されます。
これは、多くのリージョンにわたって LogHouse データベースを運用している私たちの環境では特に重要です。前回のブログ投稿で説明したように、これらの分散システム間で効率的にクエリを実行することは、パフォーマンスと信頼性にとって極めて重要です。現在、このルーティングロジックを ClickHouse 自体に組み込み、HyperDX でも同じ最適化の恩恵を受けられるようにする方法を模索していますので、続報をお待ちください。
ルーティング機能に加えて、Grafana は長年運用してきたダッシュボードやアラート、特に Prometheus メトリクスに基づいて構築されたものの拠点であり続けています。これらは依然として価値があり、移行は現在の優先事項ではありません。たとえば、kube_state_metrics はクラスターヘルスのモニタリングにおける事実上の標準となっています。これらの高レベルのメトリクスは、詳細な調査には最適ではないにしても、アラートには適しています。現時点では、それらは効果的に目的を果たし続けています。
現在のところ、これら 2 つのツールは補完的な役割を果たし、私たちのオブザーバビリティスタック内で効果的に共存しています。
高カーディナリティなオブザーバビリティの受容
すべてを保存し、何も集約しない
SysEx の開発がもたらしたものは、単なる技術的な利益にとどまりません。オブザーバビリティに対する私たちの考え方に文化的な変化をもたらしました。標準出力ログしかキャプチャされていなかった以前には利用できなかったシステムテーブルへのアクセスを解放することで、ワイドイベントと高カーディナリティデータを中心としたモデルへと舵を切りました。
これを「オブザーバビリティ 2.0」と呼ぶ人もいます。私たちは単純に、LogHouse と ClickStack の組み合わせと呼んでいます。
このアプローチは、従来の 3 つの柱モデルをより強力なもの、すなわち多数のソースから得られる高カーディナリティのテレメトリを保存できる一元化されたウェアハウスへと置き換えます。各行には、クエリ識別子、Pod 名、バージョンメタデータ、ネットワークの詳細といった豊富なコンテキストが含まれており、メトリクスストアの制限に合わせるために事前に集約したりディメンションを破棄したりする必要はありません。
エンジニアとして私たちはこの新しいモデルに適応し、カーディナリティ爆発に関する時代遅れの懸念を過去のものにしました。取り込み時に要約する代わりに、すべてをそのまま保存し、集約をクエリ実行時へと後回しにします。このアプローチにより、忠実度を犠牲にすることなく、詳細な調査と柔軟な探索が可能になります。
私たちが特に効果的だと感じたパターンの 1 つは、従来のメトリクスの代わりに時系列属性を含むワイドイベントをログに記録することです。たとえば、送信元の ClickHouse インスタンスから LogHouse クラスターへプッシュされたデータを追跡する SysEx のログ行は次のようになります。
{
"level": "info",
"ts": 1728437333.011701,
"caller": "scrape/scrape.go:334",
"msg": "pushed",
"podName": "c-plum-qa-31-server-zkmrfei-0",
"podIP": "10.247.29.9",
"spokenName": "plum-qa-31",
"azTopoName": "us-east1-c",
"srcTable": "part_log",
"windowSize": 120,
"insertDuration": 0.00525254,
"insertLag": 300.011693981,
"startGTE": 1728436913,
"stopLT": 1728437033
}ここで、**「これは Prometheus のような従来のメトリクスストアとどう違うのか?」**と疑問に思うかもしれません。
決定的な違いは、私たちがすべてのデータポイントを保存している点です。insertDuration のようなフィールドを事前に集約することはせず、個々の値をキャプチャして保持し、まとめて保存します。
対照的に、Prometheus のようなシステムは通常、シリーズごとにゲージを保存するか、より一般的には効率的なクエリをサポートするために値をヒストグラムへ事前集約します。この設計には大きな制約が伴います。たとえば、Prometheus であらゆるラベルの組み合わせに対して時系列を保存しようとすると、カーディナリティ爆発が引き起こされます。数万もの一意な Pod 名が存在する私たちの環境では、クエリ実行時の柔軟性を維持するだけでも、ラベルの組み合わせごとに個別の時系列が必要になってしまいます。ヒストグラムによる事前集約はリソース使用量の抑制に役立ちますが、忠実度が犠牲になります。その結果、次のような質問に答えることが不可能になります。
「この insertDuration のスパイクは、特定のインスタンス、テーブル、時間枠に至るまで、正確にはどの insert を表しているのか?」
私たちのアプローチでは、こうしたトレードオフを完全に回避できます。関連するすべてのディメンションとメトリクスを漏れなくキャプチャしたワイドな行として各イベントをログに記録します。これにより、集約と要約をクエリ実行時に委ねつつ、必要に応じて個々のイベントにドリルダウンする能力を維持できます。
このモデルは完全に新しいものではありません。Elasticsearch のようなシステムは、ワイドイベントや柔軟なドキュメント構造の取り込みを長年推奨してきました。違いは、ClickHouse がこのアプローチを大規模環境で運用可能にした点にあります。その列指向設計により、イベントを保存するこうしたアプローチを従来制限していた法外なストレージコストやクエリレイテンシを招くことなく、高カーディナリティかつ大容量のイベントデータを効率的に保存できます。
オブザーバビリティ分析のためのデータサイエンスツールの活用
このアプローチの強みは、その単一のイベントを使用して多様な特性を可視化し、さまざまな結論を導き出せる点にあり、グラフ上の任意のポイントからいつでも元の生ログに戻ることができます。
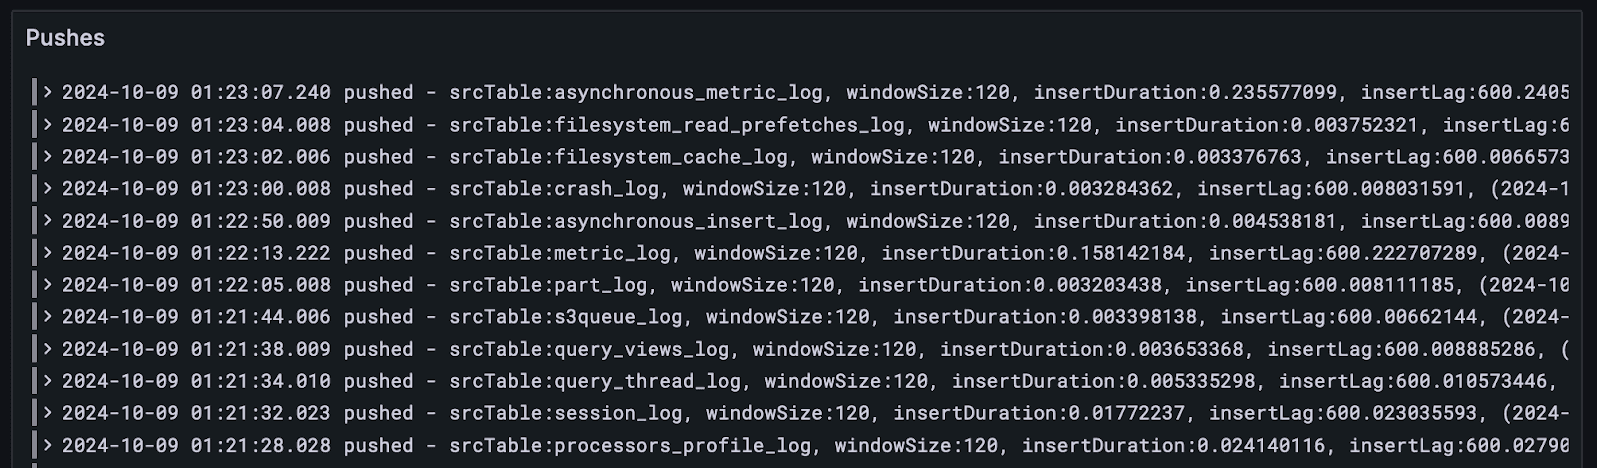
まず、特定のサービスに焦点を当て、その挿入を時系列で 1 行ずつ確認できます。これがデータの生のビューです。
この個別のインスタンスについて、すべてのテーブルの挿入遅延(insert lag)を簡単に可視化できます…
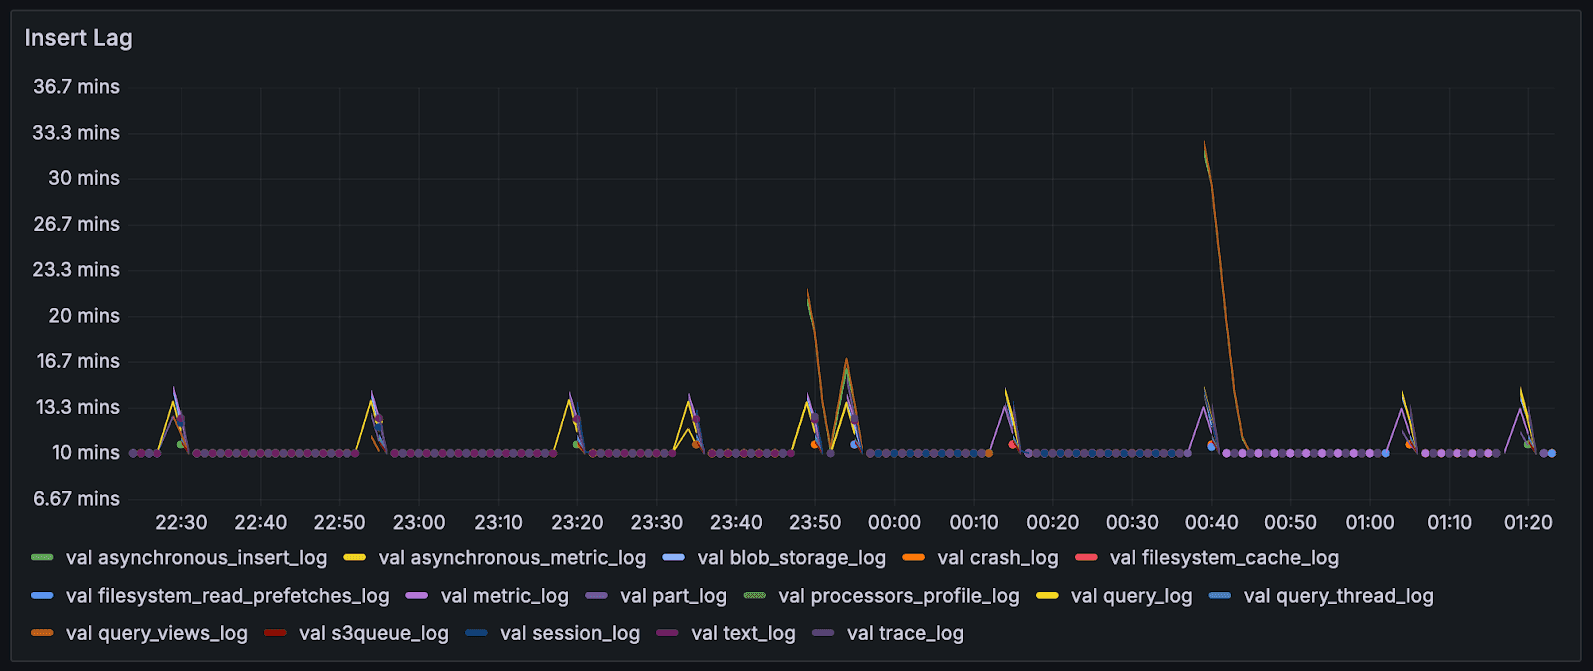
さらに 1 階層上がり、あるリージョン内のすべてのサーバーのうち、遅延が目標値を超えている(lag > desired)ものを可視化することもできます。
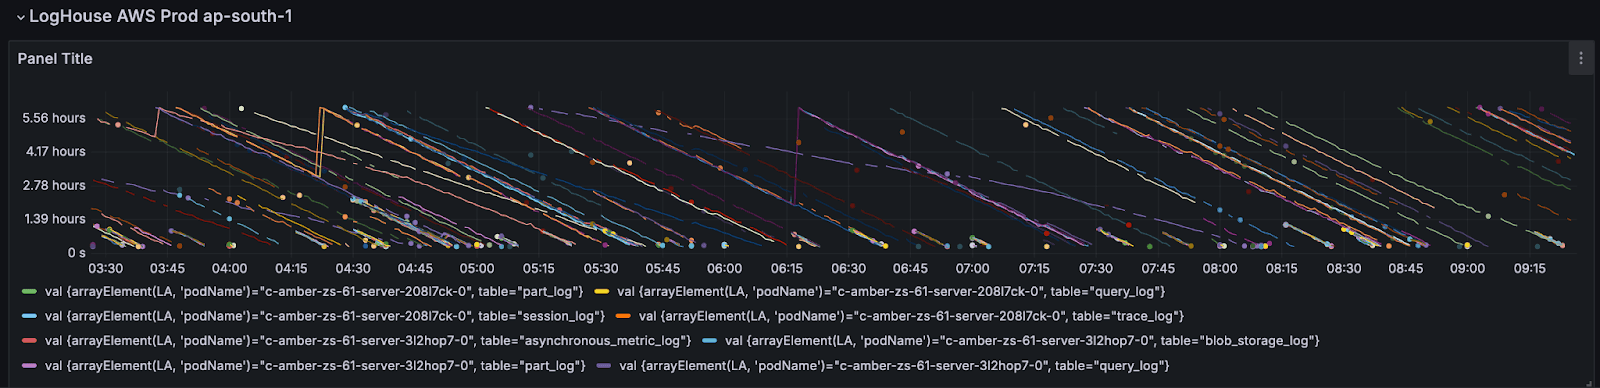
そして、オブザーバビリティとは*「もう 1 つのデータ問題にすぎない」*ため、オブザーバビリティデータに対してデータサイエンス分野のあらゆるツールを借りてくることができます。つまり、ClickHouse が直接連携しているか、クライアントライブラリを介して連携できる、好みの任意のツールでログを可視化できます。たとえば、Jupyter notebook 内の Plotly です。
import plotly.express as px
import pandas as pd
import clickhouse_connect
client = clickhouse_connect.get_client(
…
)
query = """
SELECT
toInt64(toFloat64(LA['ts'])) AS ts,
toInt64(LA['startGTE']) AS start,
toInt64(LA['stopLT']) AS stop
FROM otel.generic_logs_0
WHERE (PodName LIKE 'loghouse-scraper-%'
AND Timestamp >= '2025-06-10 16:14:00'
AND Timestamp <= '2025-06-10 18:35:00'
AND EventDate = '2025-06-10'
AND Body = 'pushed'
AND LA['srcTable'] = 'text_log'
AND LA['podName'] = 'c-plum-qa-31-server-zzvuyka-0'
)
ORDER BY EventTime DESC
"""
df = client.query_df(query)
# Convert the 'start' and 'stop' columns from Unix timestamps to datetime objects
df['start'] = pd.to_datetime(df['start'], unit='s')
df['stop'] = pd.to_datetime(df['stop'], unit='s')
fig = px.timeline(df, x_start="start", x_end="stop", y="ts")
fig.update_traces(width=40)
fig.update_layout(bargap=0.1)
fig.show()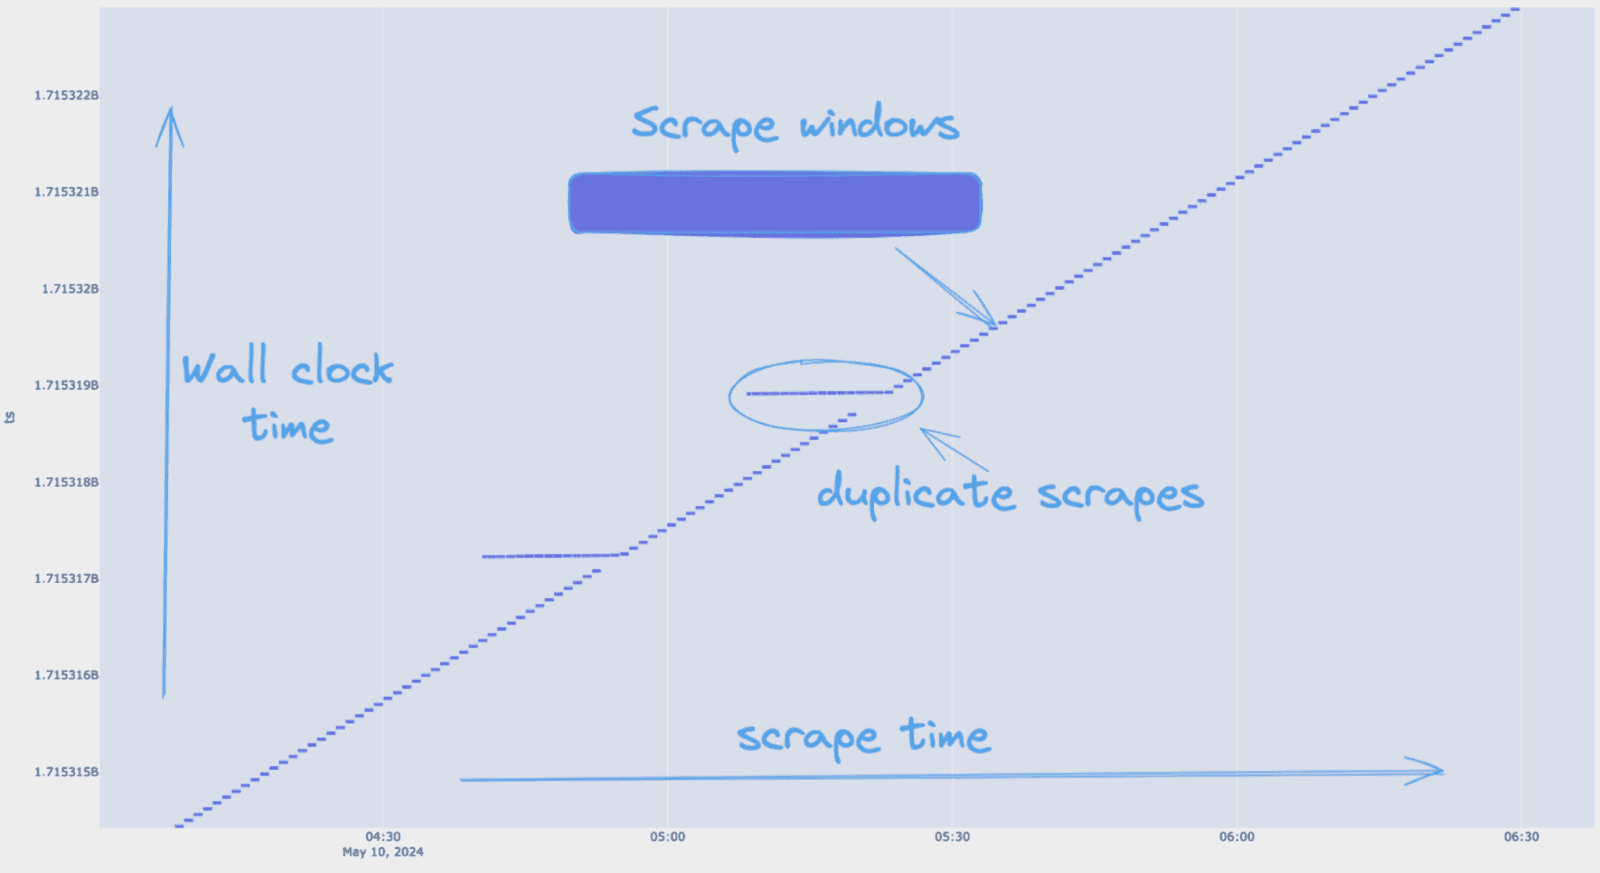
このプロットはスクレイプ時間と実時間を比較して示しており、重複がないかイベントごとに検査できます。Plotly を使用して、長方形の幅を正確な開始/終了時間としてサイズ設定できました。注釈は重複したスクレイプが発生した時間枠を強調しており、その範囲に重複データが存在することを確認しています。
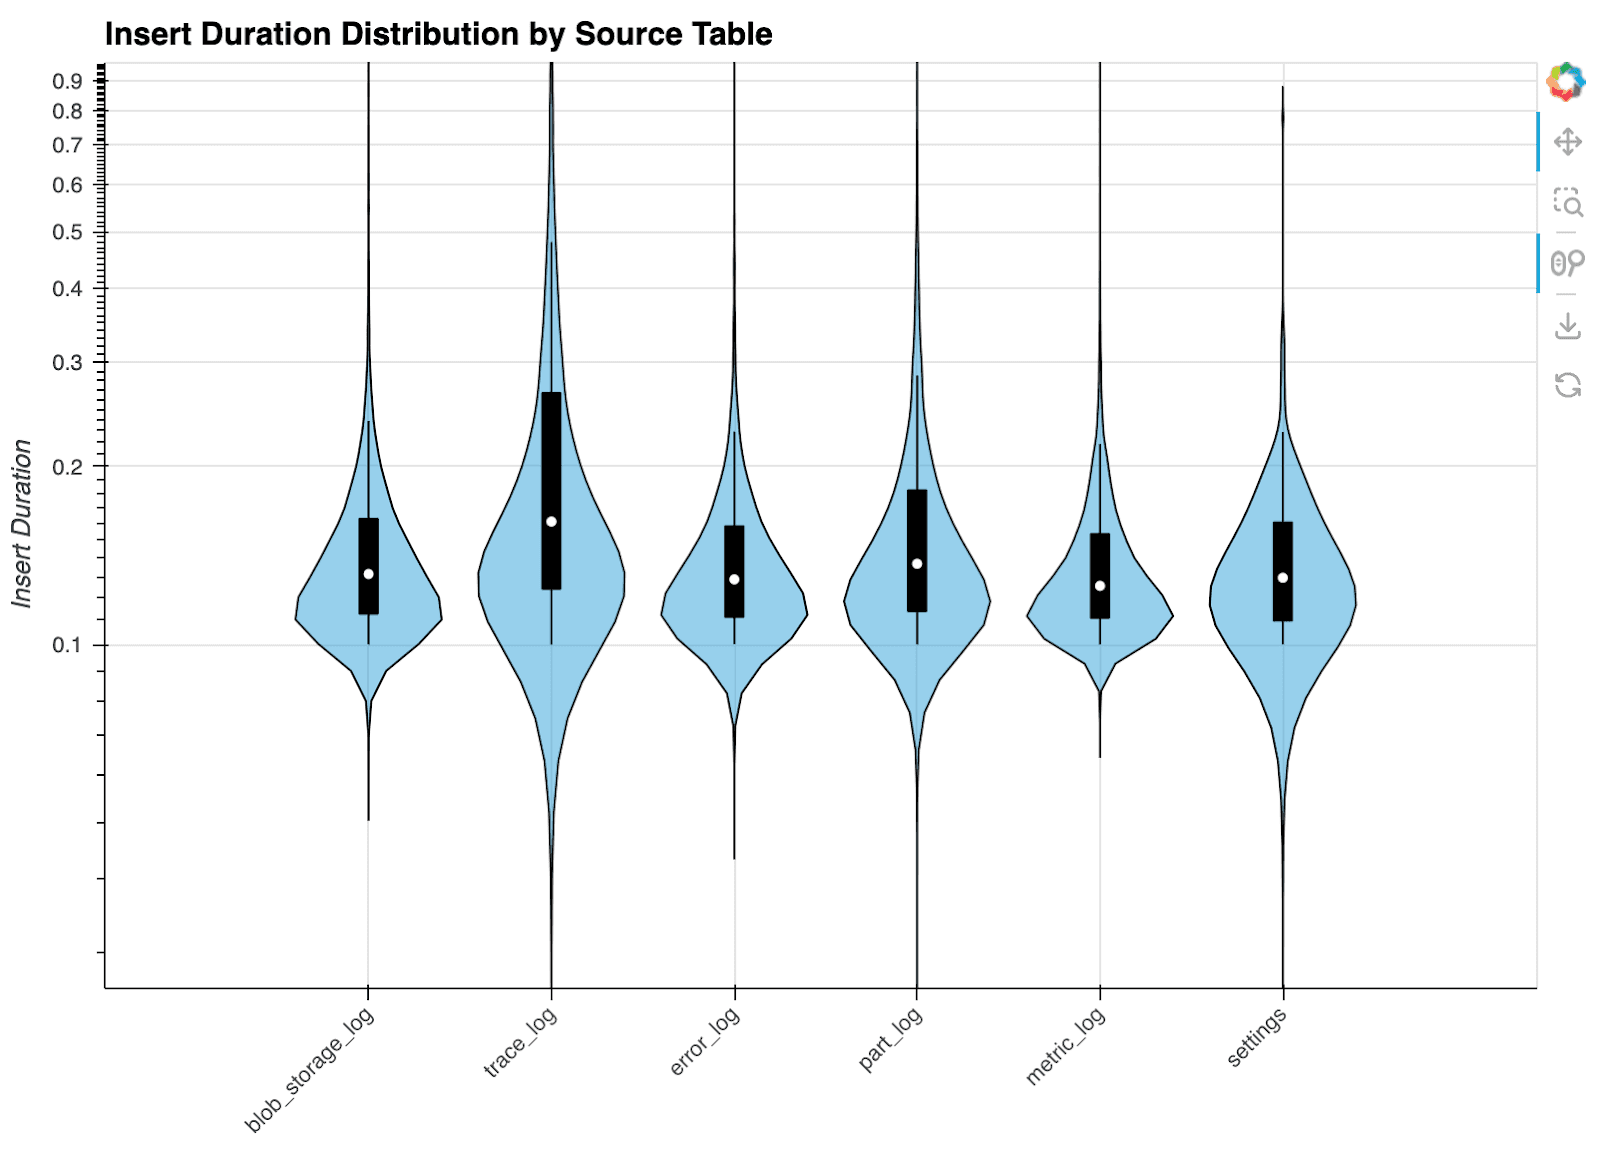
このプロットは、LogHouse Scraper によって収集された一部のテーブルについて、変動する挿入時間を視覚化しています。
筆者は Plotly を好む傾向がありますが、より現代的な可視化ライブラリを好む人もいるでしょう。ClickHouse の幅広い統合サポートのおかげで、私たちの SRE はそれぞれのワークフローに最適なツールを選択できます。Hex、Bokeh、Evidence、あるいは SQL 主導の分析をサポートするその他のプラットフォームであっても、各自に最も適したアプローチで自由に取り組むことができます。
ここでは、同じイベントの 5 つのビューを見ました。これは、さまざまなグラフ作成ツールを使用してクエリ実行時の描画方法を選択し、いつでも 1 行ずつの生のイベントへとドリルダウンできるという、私たちの柔軟性を示しています。
ログ検索だけでは不十分な場合: SQL による複雑なクエリ
HyperDX は Lucene 構文を活用した堅牢なイベント検索インターフェースを提供しており、迅速なルックアップやフィルタリングに最適です。ただし、より複雑なオブザーバビリティの問いに答えるには、より表現力の高いクエリ言語が必要です。LogHouse の背後にあるエンジンとして ClickHouse を採用しているため、いつでも本格的な SQL を活用できます。
SQL を使用すると、一般的なログクエリツールでは困難または不可能な結合、時間ベースの操作、変換を表現できます。一例として、Kubernetes のイベントストリームを相互に関連付けることで Pod の終了時間を特定することが挙げられます。以下のクエリは、ASOF JOIN を使用して同一コンテナの Killing イベントと Created イベントを突き合わせ、終了から再起動までの時間を計算します。
WITH
KE AS
(
SELECT *
FROM loghouse.kube_events
WHERE (FirstTimestamp >= '2025-03-10 01:00:00') AND (FirstTimestamp <= '2025-03-11 01:00:00') AND (Reason IN ['Killing']) AND (FieldPath LIKE 'spec.containers{c-%-server}')
),
CE AS
(
SELECT *
FROM loghouse.kube_events
WHERE (FirstTimestamp >= '2025-03-10 01:00:00') AND (FirstTimestamp <= '2025-03-11 01:00:00') AND (Reason IN ['Created']) AND (FieldPath LIKE 'spec.containers{c-%-server}')
)
SELECT
Name,
KE.FirstTimestamp AS killTime,
CE.FirstTimestamp AS createTime,
createTime - killTime AS delta,
formatReadableTimeDelta(createTime - killTime) AS readableDelta
FROM KE
ASOF LEFT JOIN CE ON (CE.Name = KE.Name) AND (CE.FirstTimestamp >= KE.FirstTimestamp)
HAVING createTime > '1970-01-01 00:00:00'
ORDER BY delta DESC
LIMIT 5┌─Name─────────────────────────────┬────────────killTime─┬──────────createTime─┬─delta─┬─readableDelta─────────────────────┐
│ c-emerald-tu-48-server-p0jw87g-0 │ 2025-03-10 19:01:39 │ 2025-03-10 20:15:59 │ 4460 │ 1 hour, 14 minutes and 20 seconds │
│ c-azure-wb-13-server-648r93g-0 │ 2025-03-10 11:30:23 │ 2025-03-10 12:28:50 │ 3507 │ 58 minutes and 27 seconds │
│ c-azure-wb-13-server-3mjrr1g-0 │ 2025-03-10 11:30:23 │ 2025-03-10 12:28:47 │ 3504 │ 58 minutes and 24 seconds │
│ c-azure-wb-13-server-v31soea-0 │ 2025-03-10 11:30:23 │ 2025-03-10 12:28:46 │ 3503 │ 58 minutes and 23 seconds │
└──────────────────────────────────┴─────────────────────┴─────────────────────┴───────┴───────────────────────────────────┘
4 rows in set. Elapsed: 0.099 sec. Processed 17.78 million rows, 581.49 MB (180.05 million rows/s., 5.89 GB/s.)
Peak memory usage: 272.88 MiB.もちろん、これをメトリクスとして追跡するコンポーネントを作成することもできますが、ClickHouse の強みはそうする必要がない点にあります。ワイドイベントのウェアハウスを保存しておき、必要なメトリクスをクエリ実行時にそれらから導き出すだけで十分です。したがって、同僚から「Pod の終了要求から再起動までの p95 時間はどれくらいか」と尋ねられた際、「新しいメトリクスをリリースするから、次のリリースが出た後に回答させてほしい」と答える代わりに、関連する一連のイベントを見つけ出すだけで済みます。
データ領域の拡大
高性能な分析エンジンの中に深く構造化されたテレメトリを保持することの計り知れない価値を確信した私たちは、LogHouse にさらなるデータシンクを追加することに注力してきました。これは主に、LogHouse を愛用し、すべての重要なデータをウェアハウス内に保持したいと望むエンジニアリングチームおよびサポートチームからの要望によるものです。2025年、私たちは上記で示したような高カーディナリティかつワイドイベントベースのオブザーバビリティへの文化的な移行を受け入れました。
このワイドイベントの哲学に従った新しいデータソースには、次のようなものがあります。
- kubenetmon: Kubernetes ネットワーキングを監視するためのオープンソースツールであり、クラスターのトラフィックに関する深いインサイトを提供します。
kubenetmonは Linux の conntrack システムを使用して、バイト数/パケット数を含む L3/L4 接続データをキャプチャします。これにより、フォレンジック(1 分あたりの帯域幅を含む時系列の接続レコード)、属性特定(接続を特定のワークロードおよび Pod にマッピング)、メータリング(リージョン間エグレスなどの高コストなデータ転送のコスト追跡)という 3 つの主要機能が実現します。このシステムは毎分何百万もの接続観測を処理し、コストのかかるリージョン間のダウンロードの特定、AZ 間トラフィックパターンの追跡、ネットワーク使用量と実際のコストの関連付けに役立っています。プロジェクトは https://github.com/ClickHouse/kubenetmon でご確認いただけます。 - Kubernetes Event Exporter: 私たちは定評のあるエクスポーターをフォークし、ネイティブな ClickHouse シンクを追加して、Kubernetes API イベントの大規模な分析を可能にしました。フォークしたリポジトリはこちらにあります。これは、時間の経過とともに K8s 内で何がなぜ変化したのかを把握するのに極めて有用です。しかし、私たちの取り組みはそれだけにとどまりません。イベントだけでなく、K8s オブジェクトモデル全体を、変更ごとのスナップショットとともに LogHouse に取り込む計画にもすでに取り組んでいます。これにより、過去 6 か月間の任意の時点におけるすべてのクラスターの完全な状態をモデル化し、すべての変更を順を追って確認できるようになります。単に「Pod X が 15:47 に終了した」と知るだけでなく、変更前後のクラスター全体の完全な状態を確認し、依存関係、リソースの制約、変更の連鎖的な影響を把握できるようになります。
- コントロールプレーンデータ: まだ LogHouse にオンボーディングされていなかったコントロールプレーン部門から、すべての運用データを収集しています。
- Real User Monitoring (RUM): 現在進行中のプロジェクトとして、ユーザーのブラウザからフロントエンドのパフォーマンスメトリクスを収集し、公開ゲートウェイ経由で OTel パイプラインにプッシュしています。
- Istio アクセスログ: Istio サービスメッシュから HTTP レベルのトラフィックデータを取り込み、リクエスト/レスポンスのパターン、レイテンシ、ルーティングの決定をキャプチャしています。これを ClickHouse の system.query_log および kubenetmon のネットワークフローと組み合わせることで、強力な三次元の相関分析機能が生まれます。ネットワーク使用量のスパイクが発生した際、サポートチームは全体像を追跡できます。具体的にどの SQL クエリが実行されていたのか、どのような HTTP リクエストがそれらをトリガーしたのか、そして正確なパケットフローパターンは何だったのかを把握できます。このレイヤー横断の可視性により、デバッグは当て推量から正確な根本原因分析へと変化します。異常なエグラストラフィックが見られた場合、それがコストのかかるリージョン間クエリによるものか、バックアップ操作によるものか、あるいは予期せぬレプリケーションによるものかを即座に特定でき、サポートチームのトラブルシューティングが信じられないほど効率的になります。
今後の展開とロードマップ
この 1 年は、LogHouse にとって驚異的な成長の年でした。画一的なアプローチを脱し、特化した高効率なツールを採用することで、コストパフォーマンスを大幅に向上させながら、オブザーバビリティプラットフォームを驚くべき新たな高みへとスケールさせました。HyperDX の統合はその進化の重要な部分であり、ペタバイト規模のデータウェアハウス上で柔軟かつ強力なユーザー体験を提供しています。この強固な基盤の上にさらなる構築を続ける中で、次の 1 年が何をもたらすのか非常に楽しみです。
ゼロインパクトスクレイピングに向けて
SysEx は効率的でリソースを意識した設計になっていますが、ユーザーがログやメトリクス内で私たちのスクレイプクエリに気付くことが時折あります。これらのクエリは厳格なメモリ制限によって厳しく制約されていますが、時としてエラーが発生すると懸念を招くことがあります。実際のリソースへの影響は極めてわずかですが、軽量なクエリであっても、繊細な環境ではノイズや混乱を引き起こす可能性があることを認識しています。
これに対処するため、SysEx の次の進化形として私たちがゼロインパクトスクレイピングと呼ぶものを模索しています。目標は、スクレイピングを実行中のシステムから完全に切り離すことで、クラスター内でのクエリ実行をすべて排除することです。有望な方向性の 1 つは、ClickHouse がすでにサービスログを書き込んでいる S3 上のプレーンな書き換え可能ディスク を活用することです。このモデルでは、SysEx ワーカーのプールがこれらのディスクベースのログテーブルを直接マウントし、実行中の ClickHouse インスタンスにクエリを発行する必要を回避します。この設計により、運用上の影響という印象すら排除しつつ、現在のシステムのすべての利点(ネイティブフォーマット、高忠実度、最小限の変換)を提供できるようになります。
OpenTelemetry は、特にサービステーブルが利用可能になる前の初期段階のデータキャプチャにおいて、依然として私たちのプラットフォームの重要なコンポーネントです。これは、構造化ログが利用できない可能性があるクラッシュループの際に特に役立ちます。しかし、ゼロインパクトスクレイピングのアプローチが成功すれば、クラスターのライフサイクル全体を通じて高忠実度で混乱の少ないログ取り込み経路が提供されるため、OTel への依存をさらに減らせる可能性があります。
この取り組みはまだ進行中であり、本番環境でアプローチを検証できた段階で詳細を共有する予定です。
JSON への移行
ClickHouse では以前から JSON 型が利用可能でしたが、バージョン 25.3 で最近一般提供 (GA) となりました。これは半構造化データを柔軟かつ効率的に保存する方法を提供し、新しいフィールドが出現するにつれて適切な型を持つカラムを動的に作成します。複数の型を持つフィールドさえサポートし、スキーマの爆発的増加にも巧みに対処します。
これらの利点がある一方で、大規模環境における一般的なオブザーバビリティのアクセスパターンに JSON がどれほど適合するかを現在も評価しています。たとえば、JSON ブロブ全体にわたって文字列をクエリすると、実質的に数千ものカラムをスキャンすることになりかねません。構造化データと並行して JSON の生の文字列バージョンも保存するなど、回避策は存在しますが、この領域におけるベストプラクティスは現在も策定中です。
また文化的な面でも、これまで役立ってきた Map 型の実用上の限界を認識するようになりました。私たちのログやリソースの属性の大半は十分に小さく安定しているため、引き続き Map が適切な選択肢となっています。多くの場合、単一レベルの JSON ログだけで十分であり、例外的なケースでも HyperDX などのツールがマップへのアクセスを JSONExtract 関数へと自動的に変換してくれることがわかりました。JSON をより広範に採用する予定ですが、これはまだ進行中の作業です。今後のアップデートで詳細をお知らせできる見込みです。
まとめ
過去 1 年間で、LogHouse は野心的なロギングシステムから、ClickHouse Cloud 全体におけるパフォーマンス分析からリアルタイムデバッグに至るすべてを支える基盤的なオブザーバビリティプラットフォームへと進化しました。コスト削減策として始まったものが文化面と技術面の両方における変革の起爆剤となり、大規模な高忠実度・ワイドイベントテレメトリへの移行をもたらしました。SysEx のような特化型ツールと OpenTelemetry のような汎用フレームワークを組み合わせ、HyperDX のような柔軟なインターフェースを重ね合わせることで、成長に追従するだけでなく、まったく新しいワークフローを切り拓くシステムを構築しました。道のりはまだ始まったばかりですが、100 PB、500 兆行へのスケールから得られた教訓は、私たちがウェアハウス規模で解決している中核的なデータ問題としてのオブザーバビリティに対する考え方を今後も形作り続けます。
謝辞
社内オブザーバビリティソリューションの展開を成功に導いたのは、オブザーバビリティチームの Rory Crispin、Xander Garbett、Tommy Li、Vlad Seliverstov による献身的な尽力によるものです。