5万

TL;DR
インデックスシャーディングは、プライマリインデックスおよびセカンダリインデックスの解析処理をレプリカ間で分散します。これにより、クエリ実行に使用できるワーキングメモリが解放され、500 億行のテーブルを対象としたテストではインデックスの解析が最大 7.7 倍高速化されました。
スケールを阻む次のボトルネック
ClickHouse は、大規模環境において高速に動作するよう構築されました。
しかし、「スケール」が意味するものは人によってさまざまです。ClickHouse のエンジニアリングチームにとって、それはひとつのサイクルです。世間から大きいと見なされている数字に焦点を当て、それが当たり前になるよう改善を重ね、そしてまた次の数字を見つけます。私たちが最近注力してきた数字は、インデックスサイズとインデックス解析時間です。
ClickHouse 23.3 で導入された**パラレルレプリカ(Parallel replicas)**により、クラスター全体にデータの読み込みを分散できるようになり、クエリ実行を水平方向にスケールさせることが可能になりました。
インデックスシャーディングは、その同じ原則をさらに一段階手前、つまりデータを読み込む前に発生するインデックス分析フェーズへと拡張します。
これまで ClickHouse は、すべてのレプリカがオブジェクトストレージからインデックス全体を作業メモリにロードするという前提で動作していました。
ほとんどのワークロードにおいて、これは問題になりません。インデックスのサイズは小さく、ワーキングメモリは十分にあり、ClickHouse のスパースインデックス設計によって本質的に無駄のない状態が保たれるからです。
しかし、数千億行、ペタバイト規模のデータ、数十台のレプリカといった真の大規模環境では、主キーインデックスだけでもレプリカあたり 100 GB 以上に達することがあります。さらにベクトル検索インデックス、ブルームフィルター、全文検索インデックスが加わると、きわめてコストのかかる状況に直面します。まったく同じ巨大なインデックスが、すべてのレプリカに重複してロードされることになるのです。
インデックスシャーディング(Index Sharding)はこの前提を変えます。すべてのレプリカが全体をロードするのではなく、インデックスはクラスター全体にパーティショニングされます。各レプリカがその一部を担当し、全体としてすべての範囲をカバーします。
その結果、相乗効果をもたらす 3 つのメリットが得られます:
- スケールアウトに伴い、レプリカあたりに必要なインデックス用の作業メモリが減少する
- より多くのマシンに処理を並列分散できるため、インデックス分析を水平スケールできる
- 参照の局所性(locality of reference)の大幅な向上により、個々の処理が高速化される
インデックス分析の仕組み
データが ClickHouse の MergeTree テーブルに書き込まれる際、データは*パート*にまとめられます。パートは、カラムデータのイミュータブル(不変)で自己完結した単位です。各パートが書き込まれると、ClickHouse はインラインでインデックスを構築し、オブジェクトストレージ内のカラムデータと同じ場所に保存します。
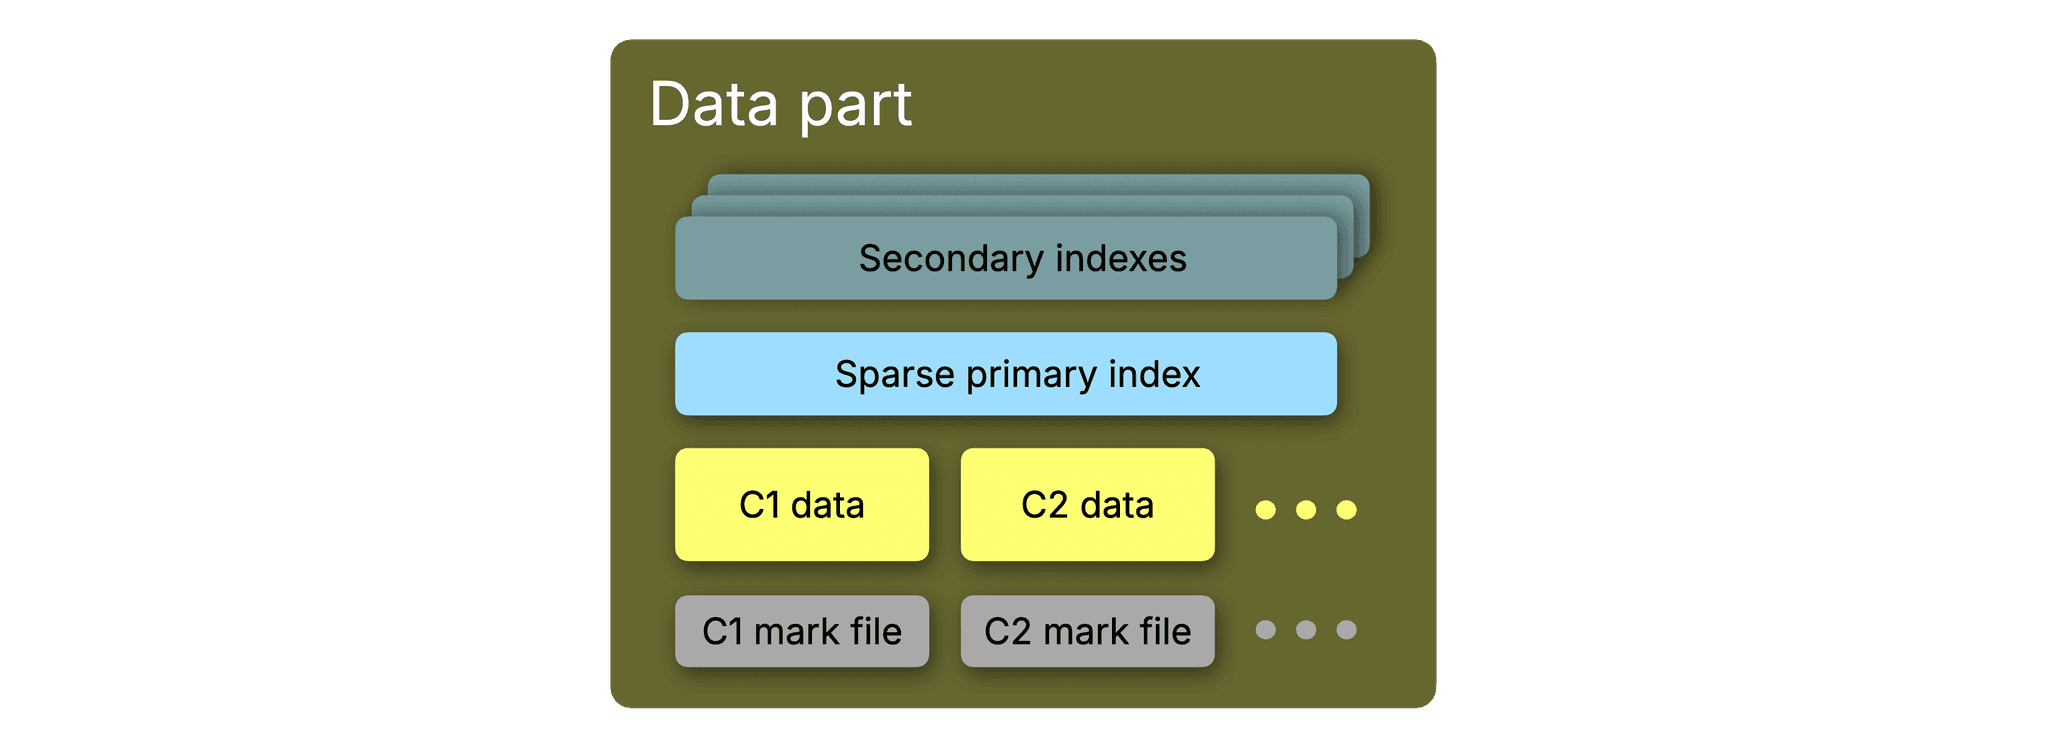
ClickHouse Cloud では、主キーインデックス、マークファイル、各種セカンダリインデックスのすべてが、パートデータそのものと同じ場所に配置されることを意味します。
インデックス付きカラムを参照するクエリが届くと、ClickHouse は読み取る価値のあるグラニュールを判断する前に、それらのインデックスファイルをオブジェクトストレージから作業メモリにロードしなければなりません。
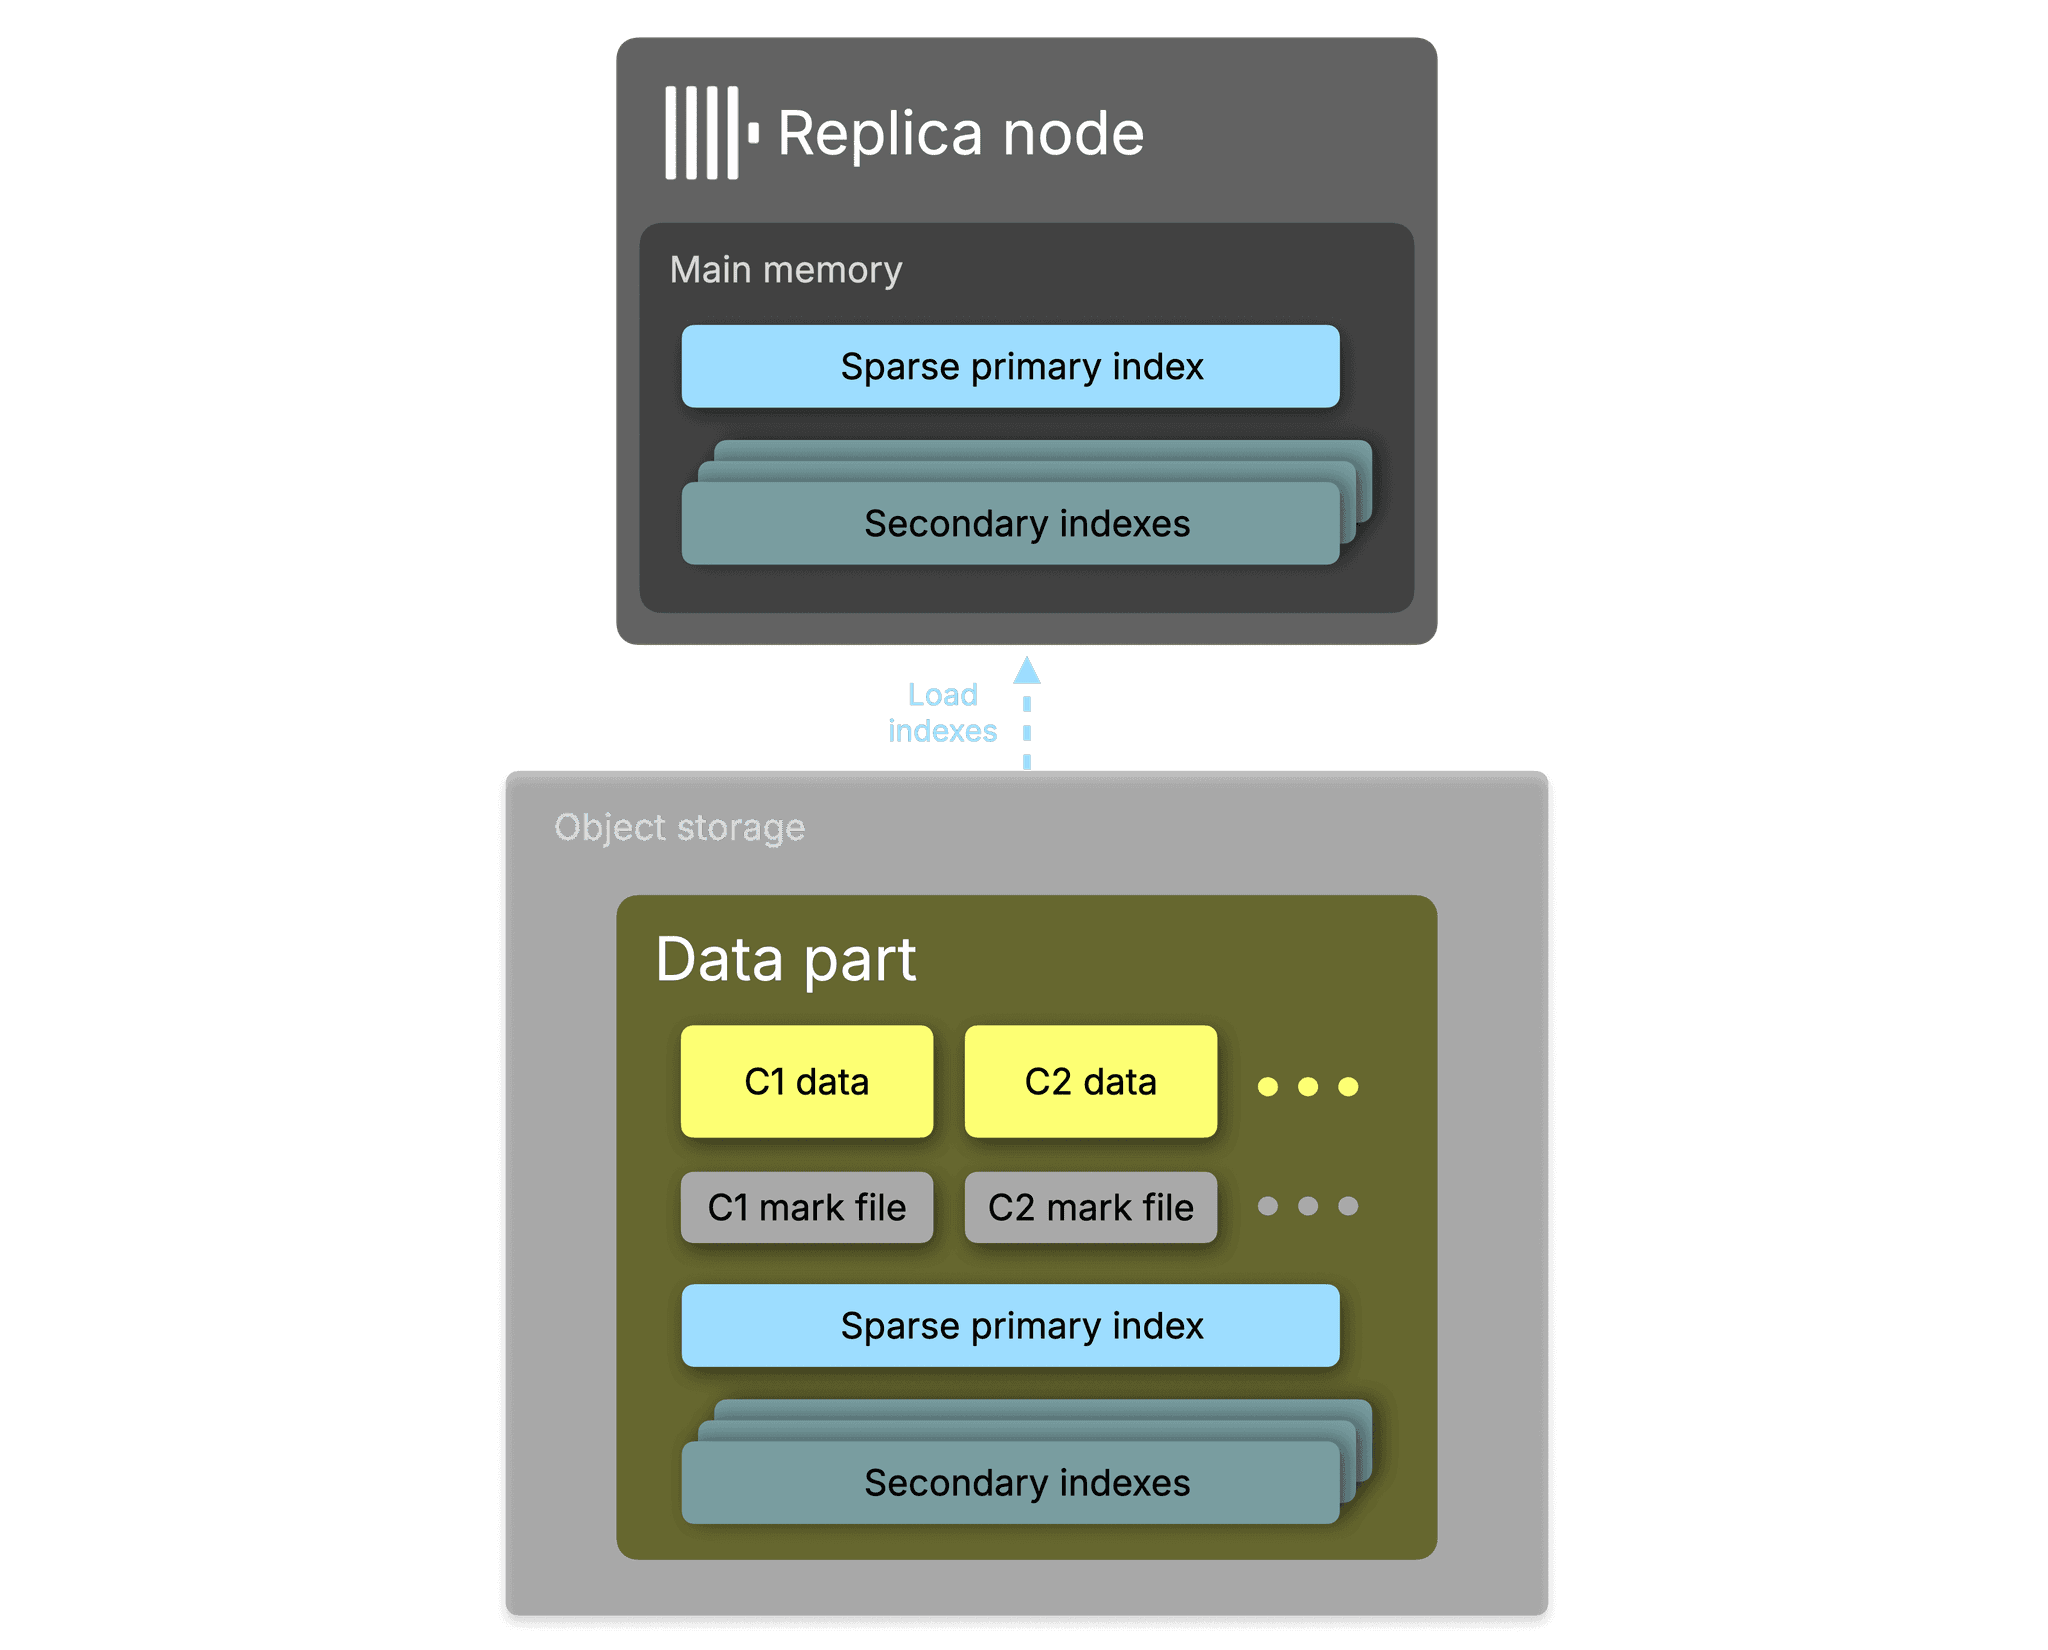
インデックスはディスク上やオブジェクトストレージ内で直接参照することはできず、分析を実行するにはメモリ上に常駐している必要があります。
このため、インデックスメモリはレプリカごとの固定コストとなります。クエリ分析に参加するすべてのレプリカは、分析を行う前に関連インデックスをロードしておく必要があります。 ClickHouse の主キーインデックスは意図的にスパース(疎)に作られています。すべての行を追跡するのではなく、グラニュール(デフォルトで 8,192 行のブロック)ごとに 1 つのエントリ(マークと呼ばれます)を保持します。
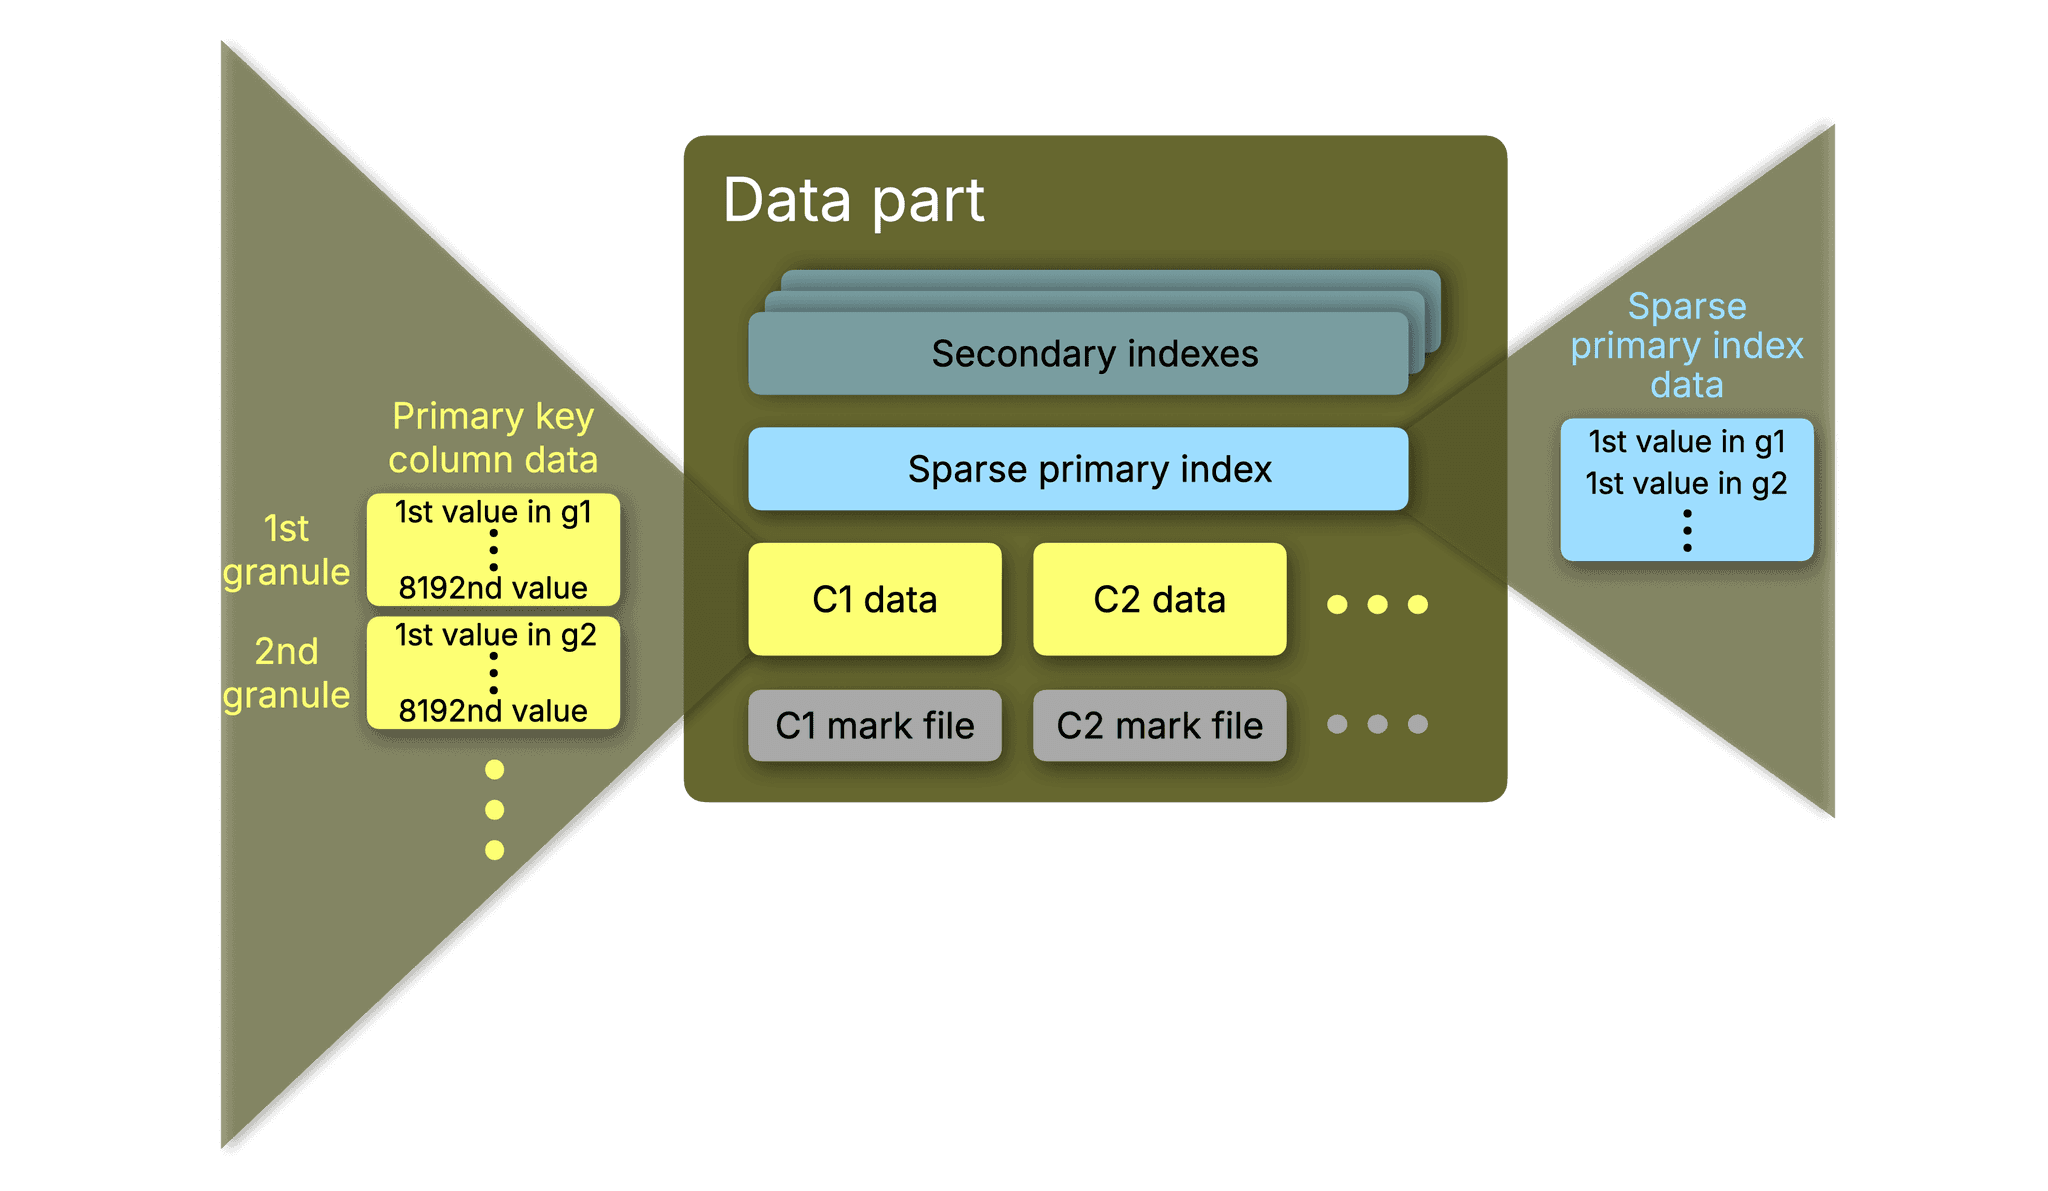
これにより、インデックスサイズをメモリに完全に収まる小ささに抑えつつ、インデックスが無関係と判断したデータをスキップするための高速な二分探索を提供できます。
インデックス付きカラムを読み取る WHERE 句を含むクエリを実行すると、ClickHouse はインデックス分析を実行します。これは 2 段階のプロセスであり、テーブルにパーティショニングキーが設定されている場合、まず無関係なパーティションをクエリ対象から除外します。続いて、各データパートのマークをスキャンして一致する行が含まれている可能性のあるグラニュールを特定し、それ以外を完全にスキップして、選択されたグラニュールのみをディスクからストリーミングします。これが ClickHouse 特有の高速性を生み出す要因です。適切にインデックスが設定されたテーブルでは、ごくわずかなデータしか読み取られません。
同様の仕組みはセカンダリインデックスにも適用されます。セットメンバーシップテスト用のブルームフィルター、全文検索用のテキストインデックス、近似最近傍探索用のベクトルインデックスなど、これらすべてがそれぞれのインデックスファイルから作業メモリにロードされ、グラニュールのスキップ処理を駆動します。
数十億行程度の典型的なテーブルであれば、これは十分に管理可能です。しかし、規模が極端に大きくなるとボトルネックが生じます。
ボトルネック: インデックスはレプリカに合わせて水平スケールしない
ClickHouse Cloud では、すべてのレプリカがストレージを共有します。オブジェクトストレージ上に 5 PB のデータが存在するテーブルであっても、そのデータをレプリカ間で重複して保持する必要はありません。複製されるのはコンピュートのみです。データは 1 か所に留まり、レプリカは必要なときに必要な分だけストリーミングします。
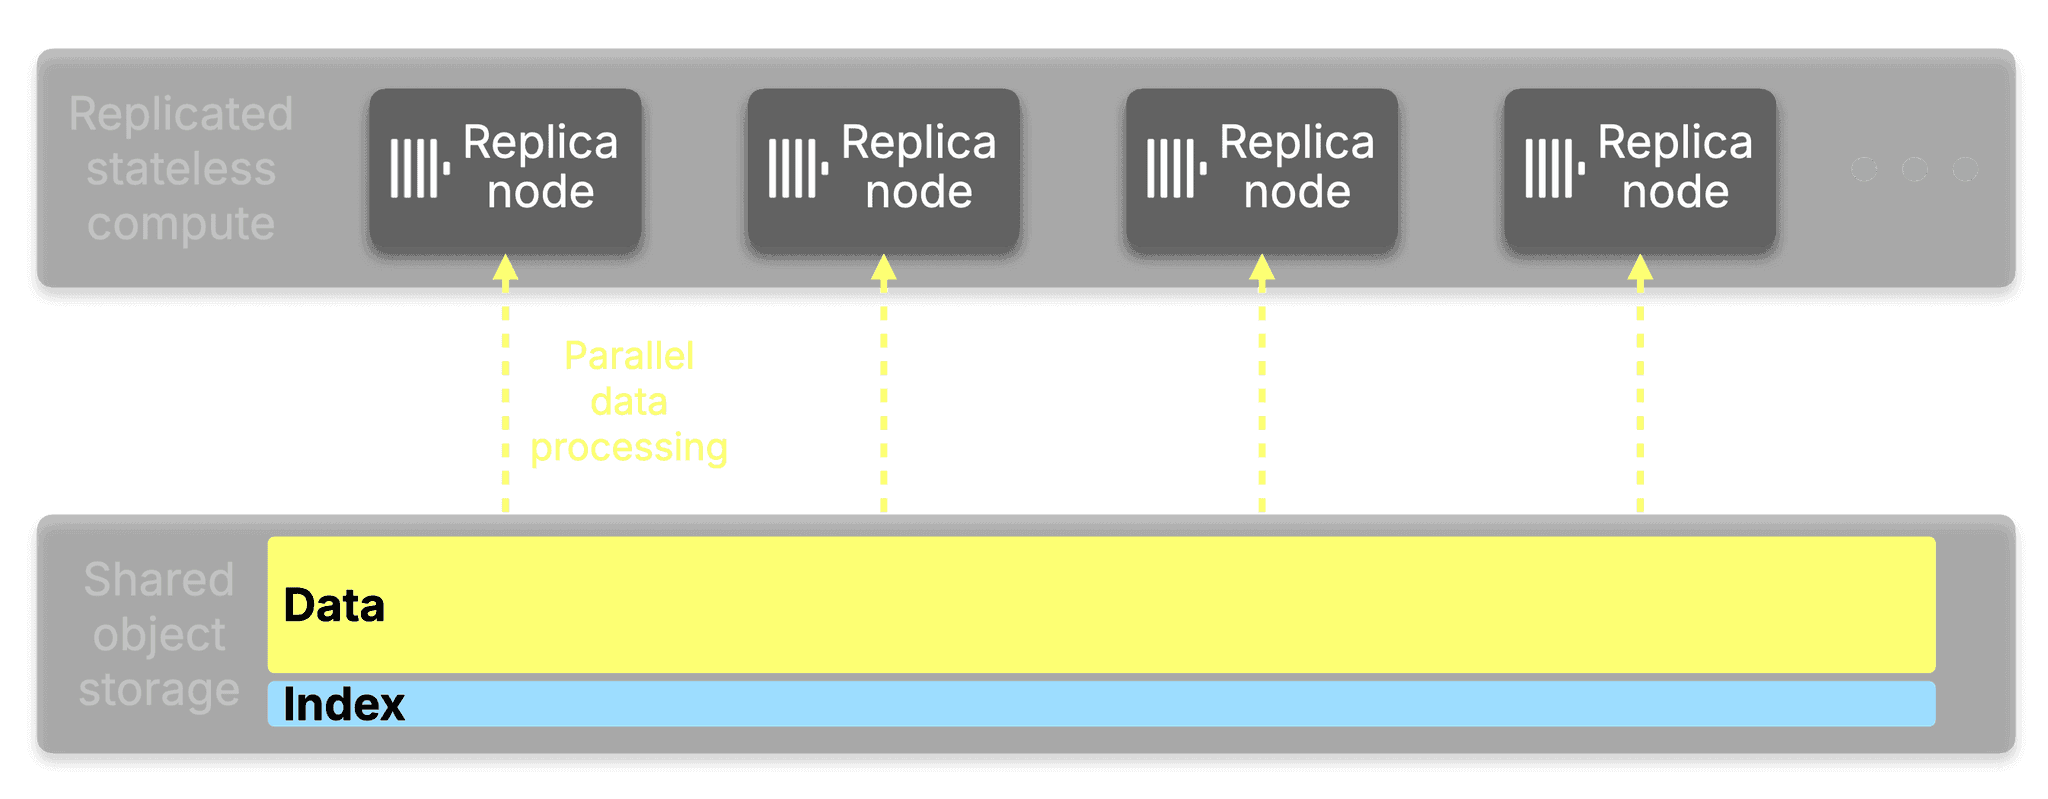
しかしこれまで、インデックスは同じようには扱われていませんでした。すべてのインデックスはオブジェクトストレージ内でデータとともに保存されますが、クエリを処理する各レプリカは、アクティブな主キーインデックスをオブジェクトストレージから自身の作業メモリにロードしなければなりませんでした。
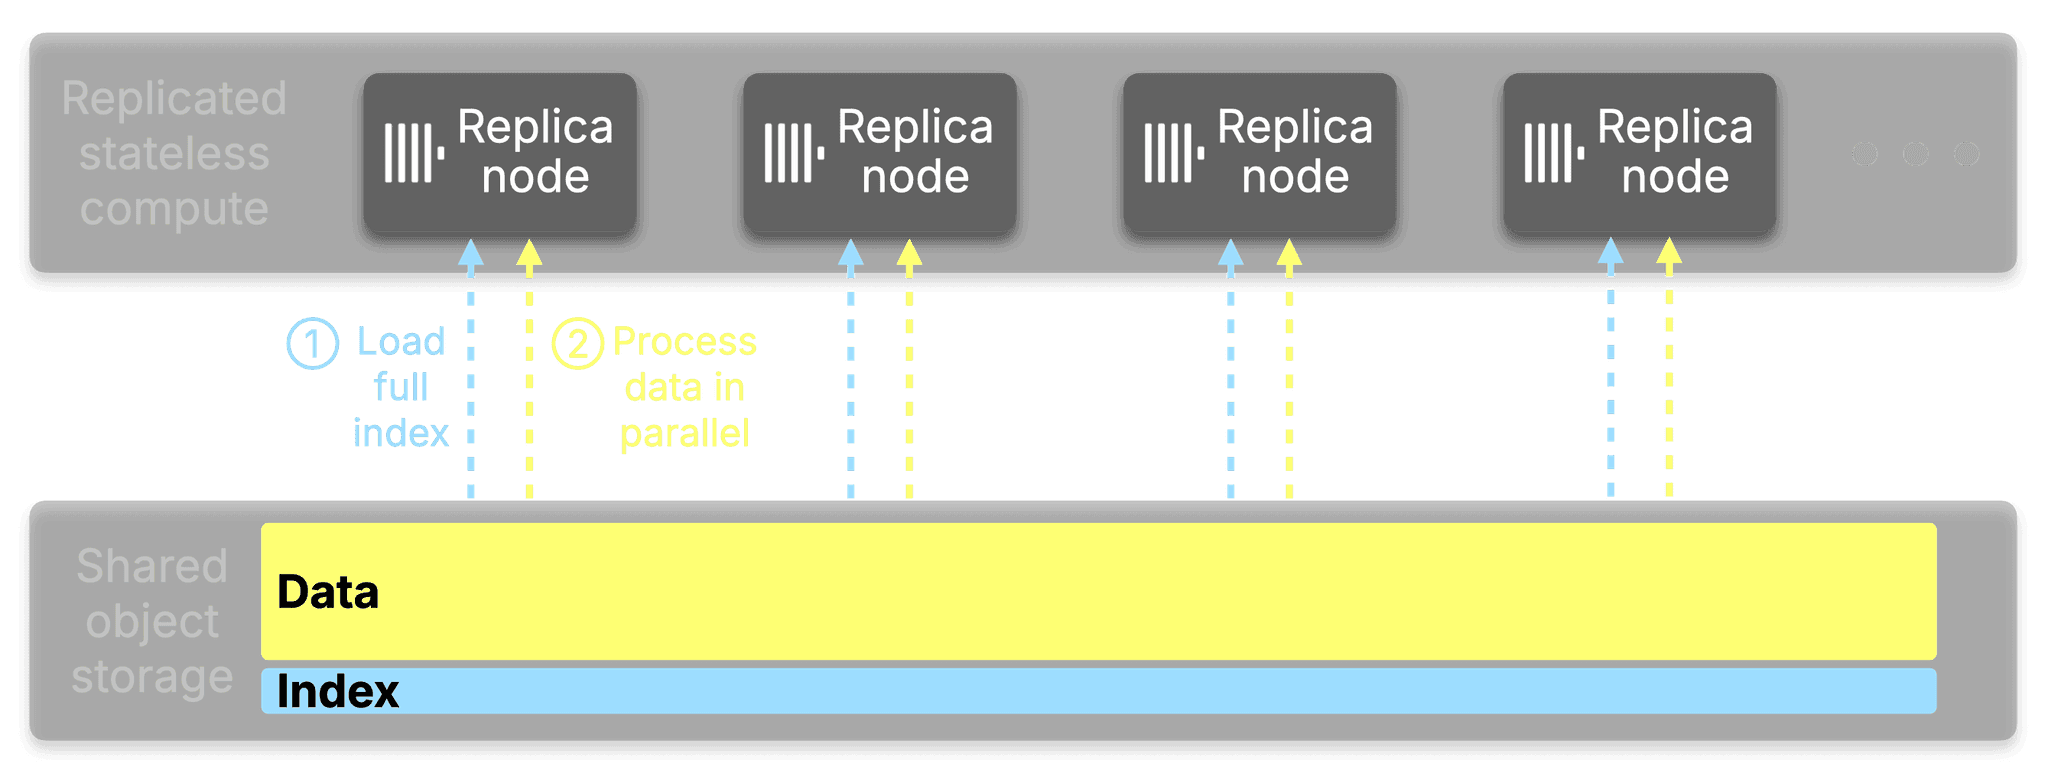
ブルームフィルターやテキストインデックスを評価するレプリカもそれらのインデックスをロードします。あるいは、use_skip_indexes_on_data_read によってスキッピングインデックスの評価をインデックス分析からデータ読み込み処理へと押し下げます。クエリの同時実行数やスループットを高めるためにレプリカを追加すると、新しいレプリカはそれぞれ完全なインデックスのコピーを自前で保持することになります。
ペタバイト規模になると、主キーだけでもレプリカあたりのメモリ消費が 100〜400 GiB に達することがあります。さらにセカンダリインデックスのマークが加わり、ベクトル検索や全文検索の普及も進んでいるため、レプリカ追加に伴うメモリコストは作業メモリの大部分を占めるようになります。これは、本来クエリの処理に使えるはずのメモリです。
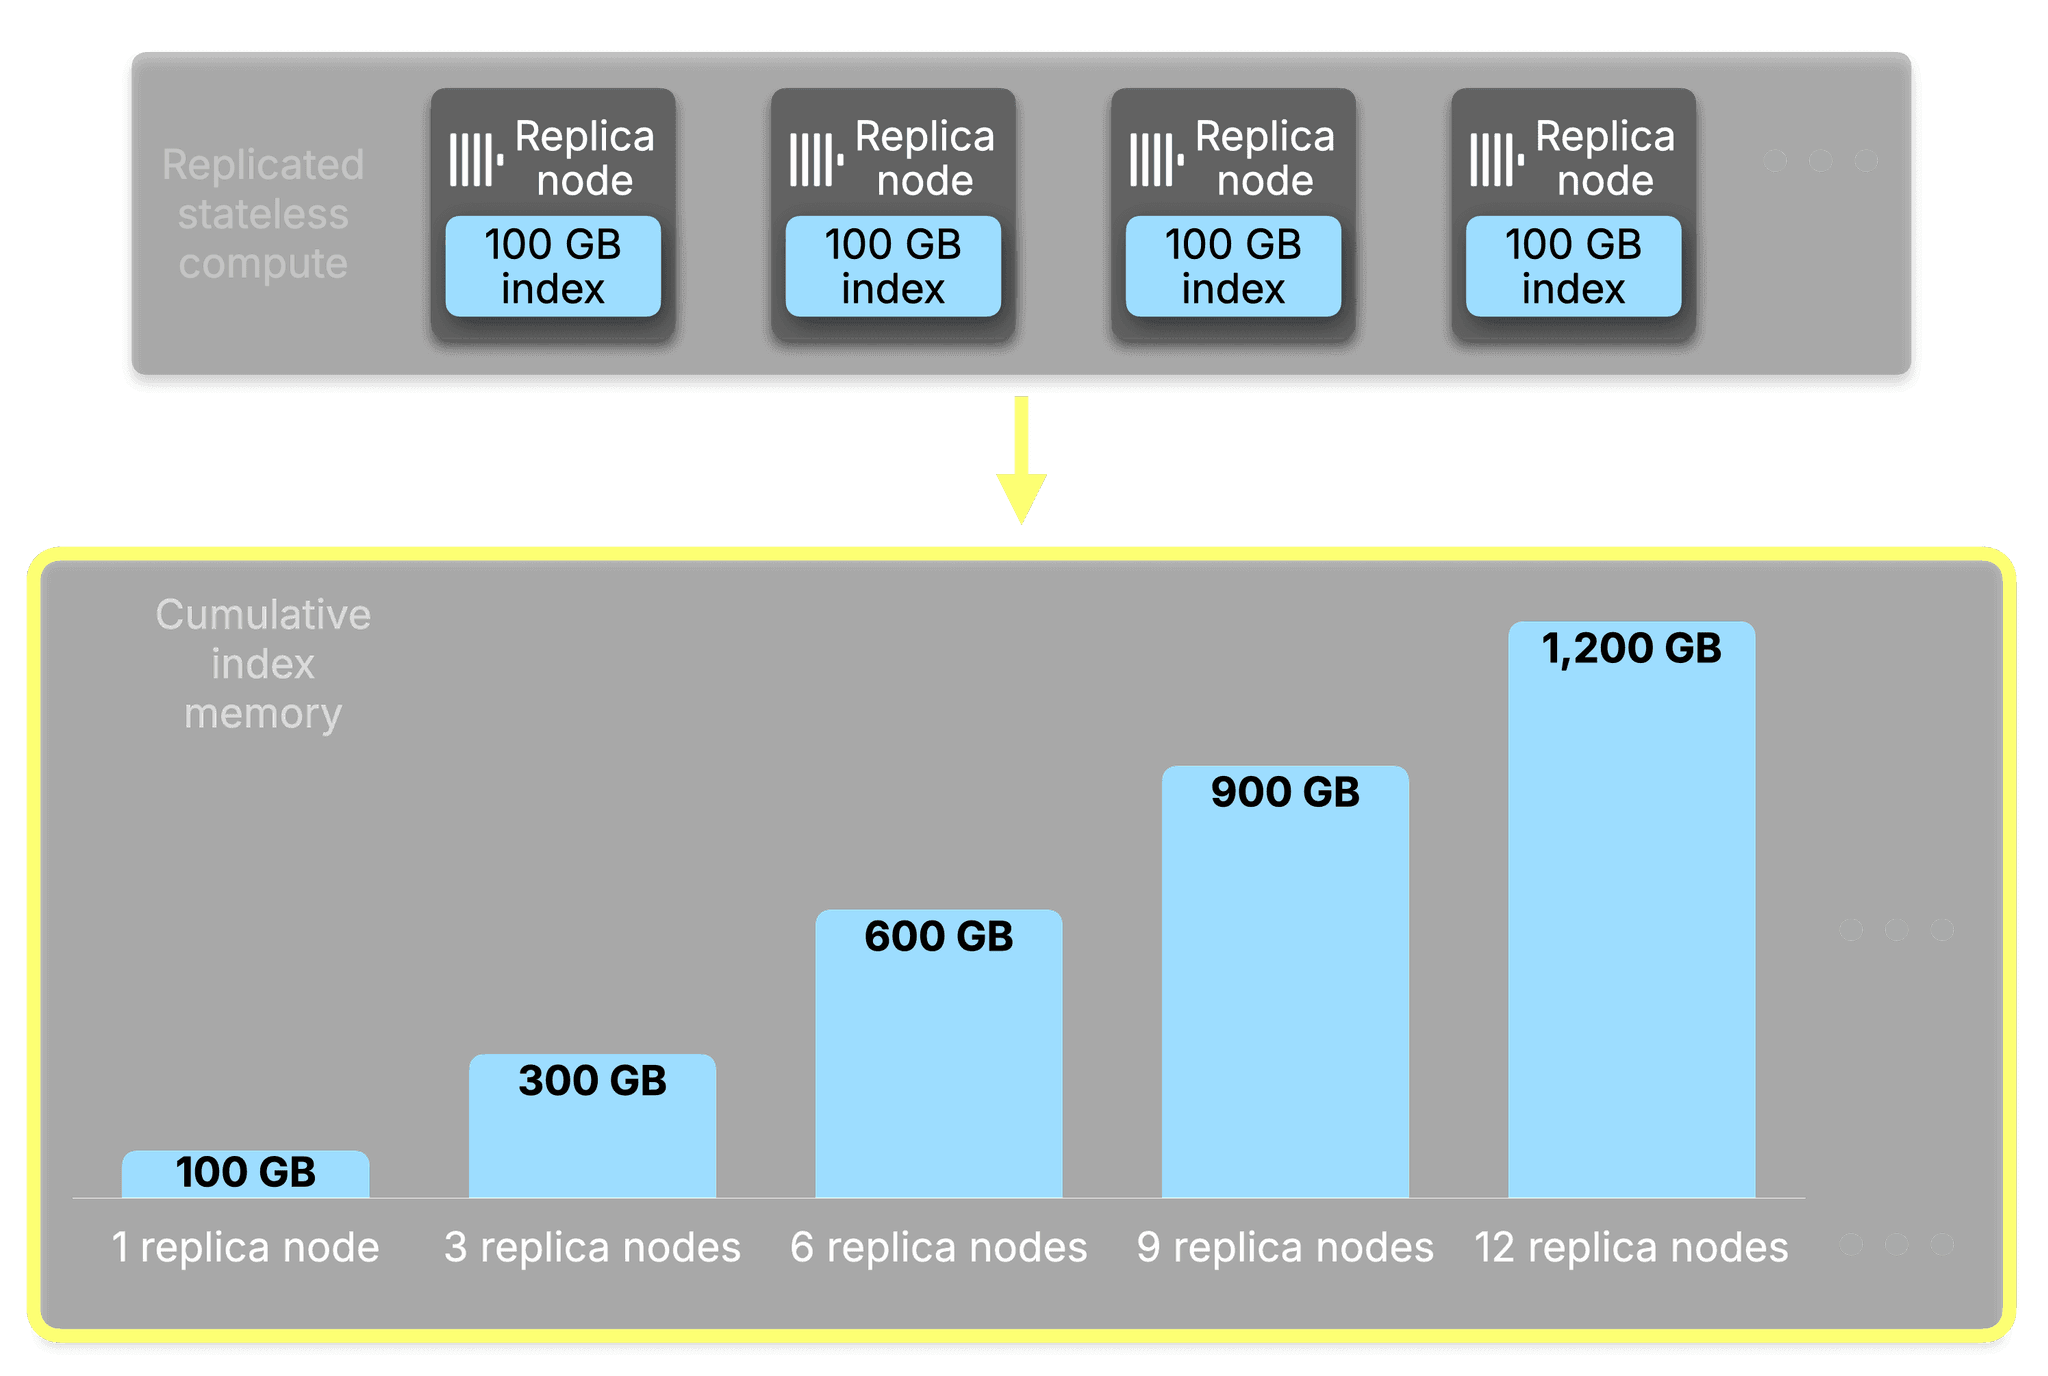
ボトルネックとなるのは、水平スケールによる性能向上を求めてレプリカを追加すればするほど、状況が悪化するという点です。100 GB のインデックスの場合、クラスター全体で消費される作業メモリの合計は、レプリカ数に正比例して増加します:
| レプリカ数 | レプリカあたりのインデックスメモリ | インデックスメモリの合計 |
|---|---|---|
| 1 | 100 GB | 100 GB |
| 3 | 100 GB | 300 GB |
| 6 | 100 GB | 600 GB |
| 9 | 100 GB | 900 GB |
| 12 | 100 GB | 1.2 TB |
すべてのレプリカがまったく同じインデックスを保持します。そのインデックスの全バイトがクラスター全体で完全に複製され、ノードを追加するたびに請求額が膨らんでいきます。
Index Sharding とそのコアコンセプト
Index Sharding の核となる着想はシンプルです:
レプリカが N 台ある場合、各レプリカはインデックス全体の 1/N だけを担当すればよいのです。
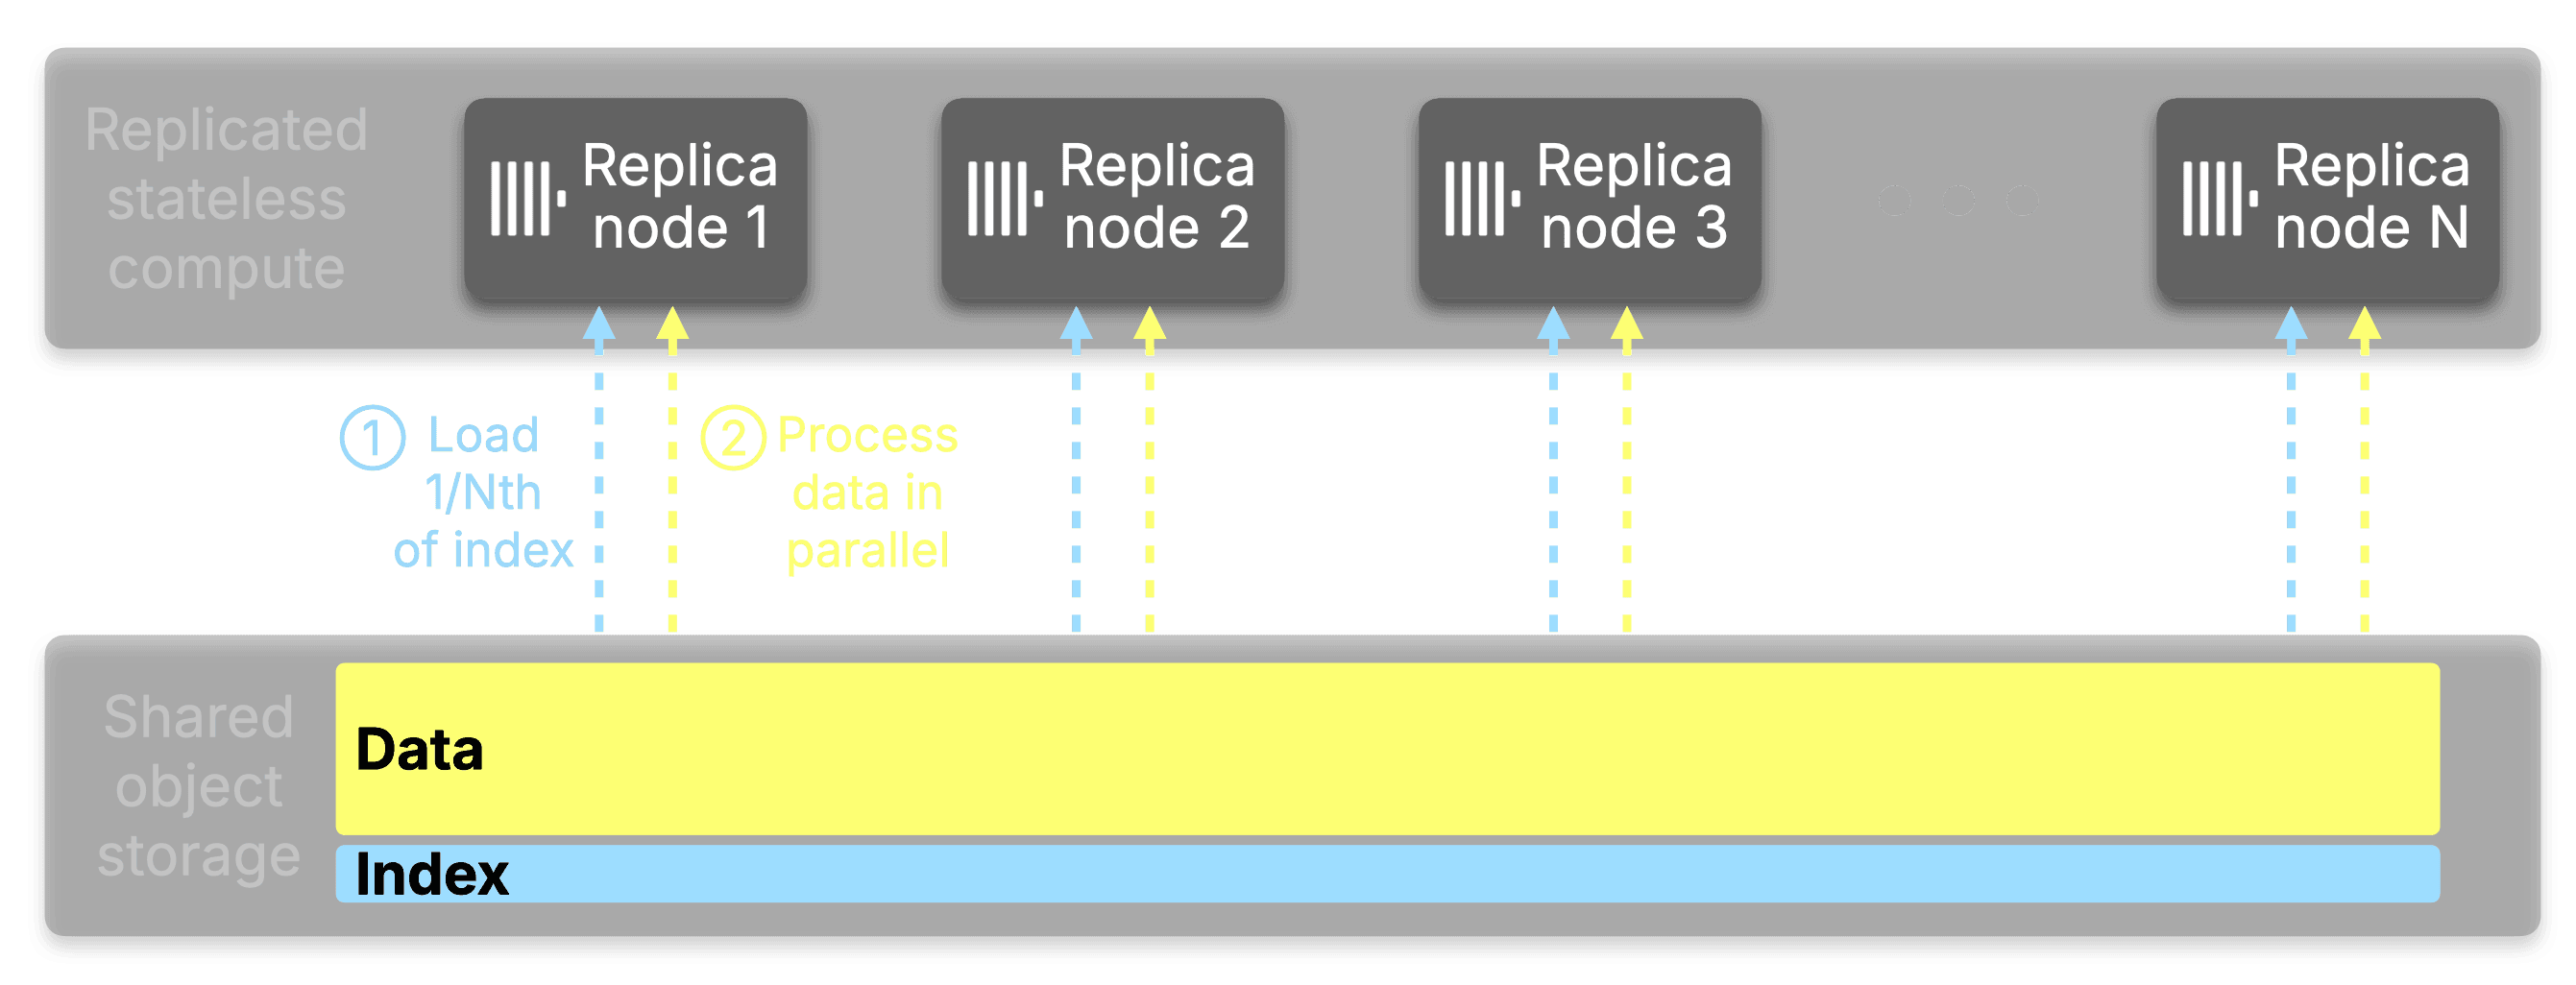
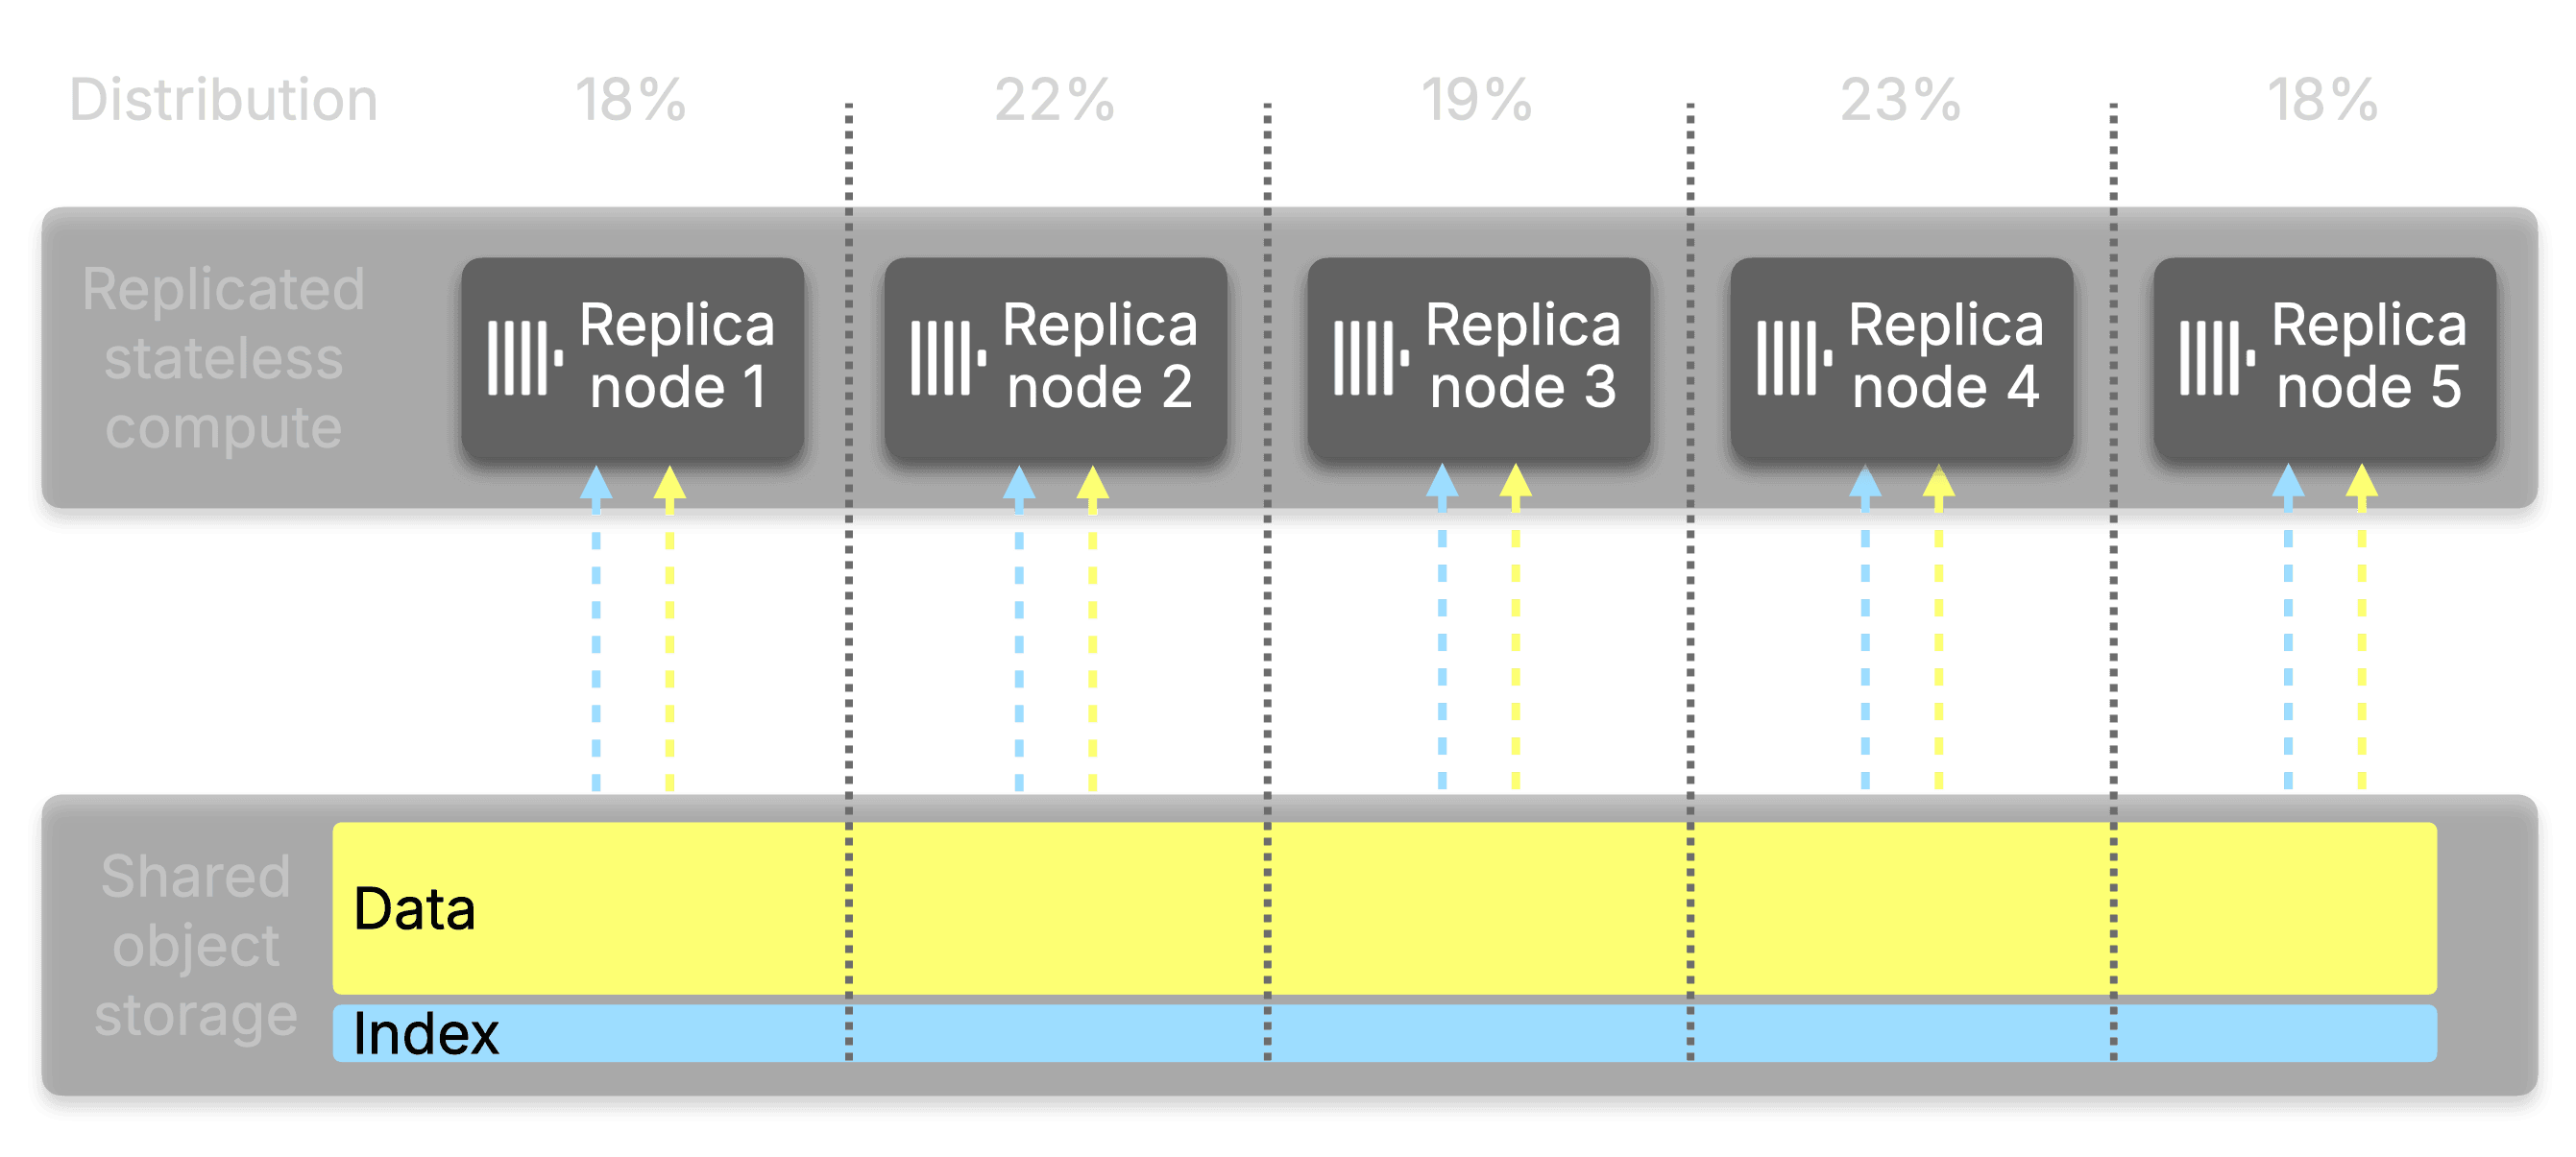
動作の仕組みは次のとおりです。クエリが届いたとき、クエリの開始ノード(イニシエーター)がインデックス全体をローカルにロードして分析するのではなく、利用可能なすべてのレプリカに作業を分散します。各レプリカはコンシステントハッシュ法(consistent hashing)と呼ばれる手法である仮想ハッシュリングを介して、分析対象となるデータパートのサブセットを受け取ります。各レプリカは割り当てられたインデックス部分をオブジェクトストレージからロードし、分析を実行して、一致したグラニュールの範囲を返します。イニシエーターはこれらの結果をマージして読み取るべき対象の全体像を構築します。単一のノードがインデックス全体に触れることはありません。
実際のデータ読み取りは、通常どおり並列レプリカ(parallel replicas)を使用して進められ、各レプリカは自身が分析したデータの読み取りを担当します。
この分散動作は EXPLAIN indexes=1 で確認できます:
EXPLAIN indexes=1
SELECT UserID FROM hits
WHERE UserID = 1
SETTINGS distributed_index_analysis = 1
FORMAT LineAsString;Indexes:
PrimaryKey
Keys: UserID
Condition: (UserID in [...])
Parts: 208/208
Granules: 247702/143169495
Distributed:
Address: replica-1:9000 Parts received: 35 Granules received: 45094
Address: replica-2:9000 Parts received: 47 Granules received: 53988
Address: replica-3:9000 Parts received: 43 Granules received: 47387
Address: replica-4:9000 Parts received: 43 Granules received: 56130
Address: replica-5:9000 Parts received: 40 Granules received: 45103この分散の様子を図で示すと次のようになります:
この分散はすべてのインデックスタイプに対応しています。
主キーインデックス、ブルームフィルター、全文検索インデックス、ベクトル検索インデックスのすべてが含まれます。これは、テーブルサイズに対してさらに大きな割合を占めることがあるセカンダリインデックスにおいて特に重要です。複数のテキストインデックスやベクトルインデックスを持つテーブルでは、インデックスデータが数百 GB に達することも珍しくなく、以前はこれを全ノードに複製する必要がありました。
サービスにレプリカが追加されるとどうなるか?
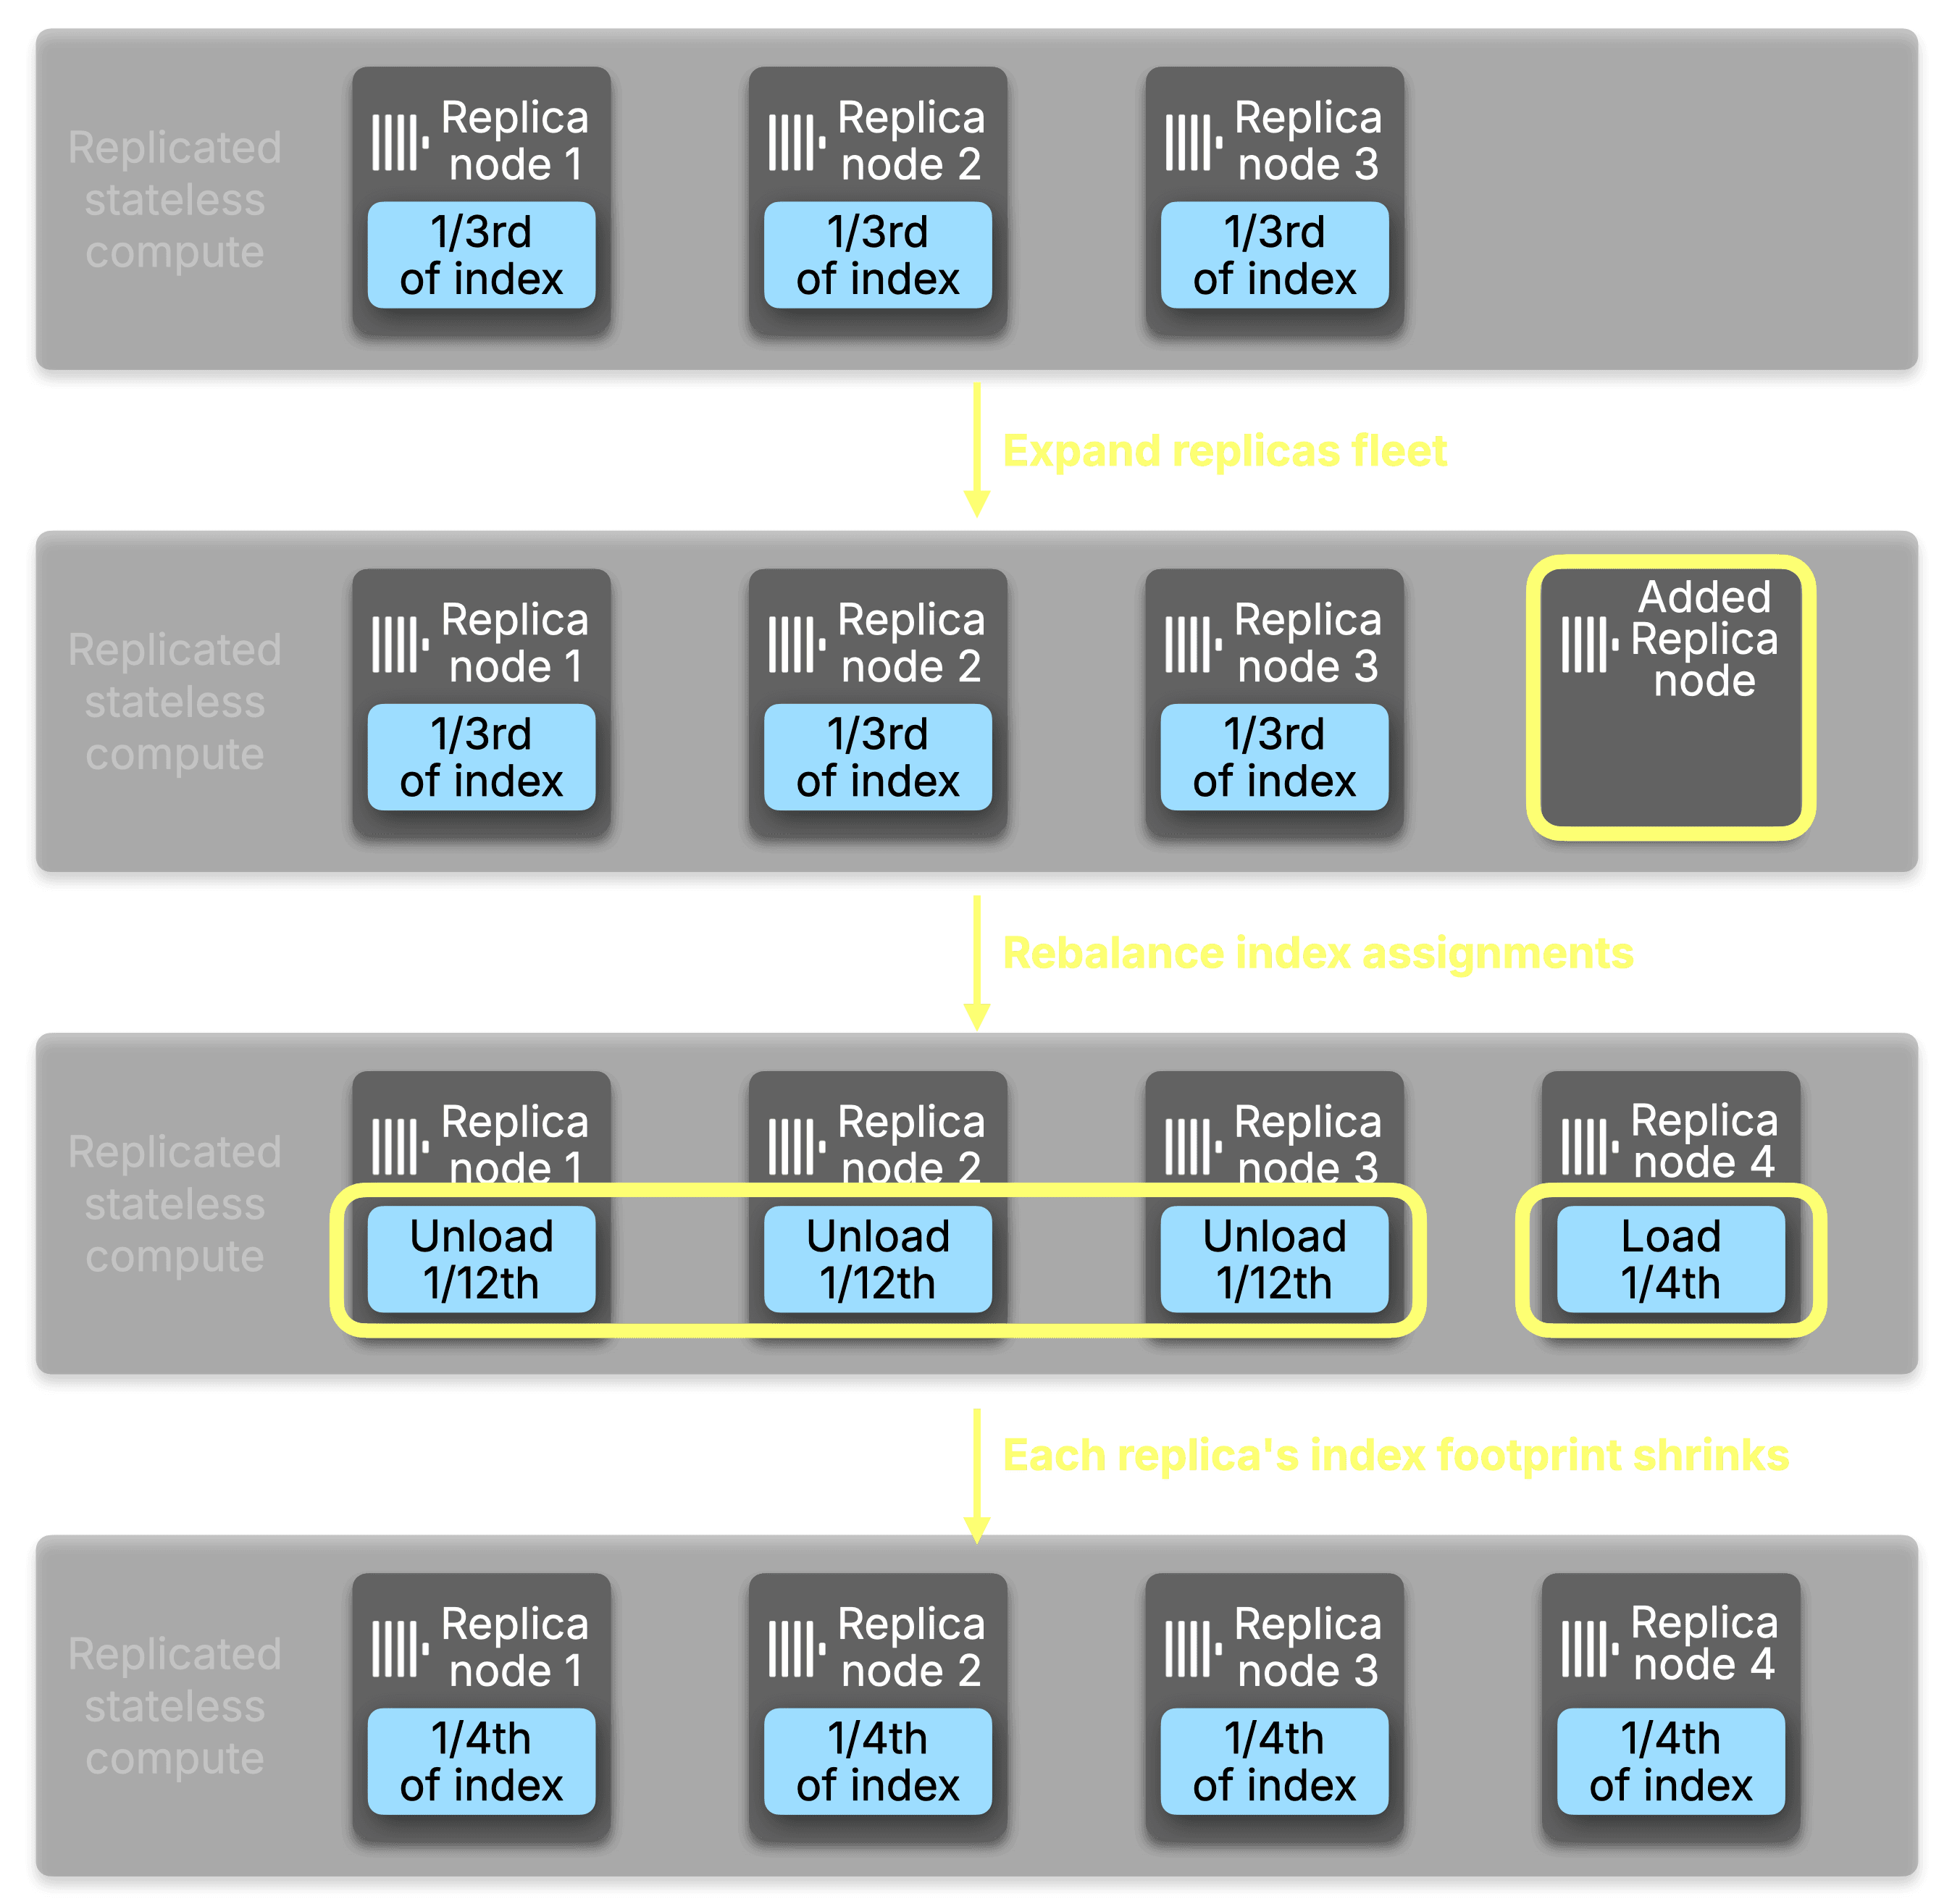
サービスにレプリカが追加されると、新しいレプリカ数に合わせてパートの割り当てがリバランスされます。新しいレプリカがサービスに参加する際、prewarm_primary_key_cache と prewarm_mark_cache の両方を有効にしておけば、主キーキャッシュとマークキャッシュを事前に入れた状態で参加させることも可能です。有効にしていない場合、新しいレプリカは最初はメモリ消費が少ない状態で起動し、分析リクエストの到着に応じて割り当てられたインデックスをオブジェクトストレージからオンデマンドでロードします。use_primary_key_cache が有効になっている場合、既存のレプリカは特定のパートが自身の担当から外れたことを検知し、バックグラウンドでアンロードして作業メモリを自動的に回収します。
ここで、ClickHouse Cloud のコンピュートとストレージの分離が真価を発揮します。
従来のシェアードナッシングアーキテクチャでは、レプリカの追加とはクエリ実行に参加できるようになる前に新しいノードへデータを移動またはコピーすることを意味していました。ClickHouse Cloud では、データが移動することは一切ありません。すべてのレプリカが同じ共有オブジェクトストレージから読み取るため、新しいレプリカは割り当てられたインデックスのスライスをロードし終えた瞬間からインデックス分析リクエストを処理できるようになります。スケールアウトのコストはデータ転送ではなく、インデックスのロード時間だけで抑えられます。
その結果、Index Sharding によるメモリ上のメリットは、まさに必要とされるタイミングで相乗効果を発揮します。スケールアウトするにつれて各レプリカのインデックスフットプリントは縮小し、次のレプリカを追加するコストはインデックス全体のごく一部をウォームアップする時間だけで済むようになります。
ClickHouse は分析の失敗からどのように自身を保護しているか?
一時的な障害への対応は、分散システムにおいて考慮すべき極めて重要な要素です。特定パートのインデックス分析リクエストが一時的に失敗する理由はいくつか考えられます。イニシエーターと担当レプリカ間のリクエスト中のネットワーク障害や、担当レプリカが要求されたパートをまだロードしていないケースなどが一般的ですが、分散システムで問題が発生する要因は日々新しいものが現れます。ここでは既知のケースへの対処方法を説明します。
イニシエーターがすべてのレプリカにインデックス分析を分散すると、レプリカは分析を依頼された各パートの分析結果を返します。特定のパートで障害が発生した場合の解決策は単純で、そのパートの分析をローカルで実行するようにフォールバックします。イニシエーターは、最初に失敗したレプリカに再試行するのではなく、そのパートのインデックスをローカルメモリにロードして分析を実行します。以降のリクエストは引き続き担当ノードへの送信を試み、失敗した場合はイニシエーターのメモリへのフォールバックが行われます。
Index Sharding はレプリカのメモリ使用量をどのように削減するか?
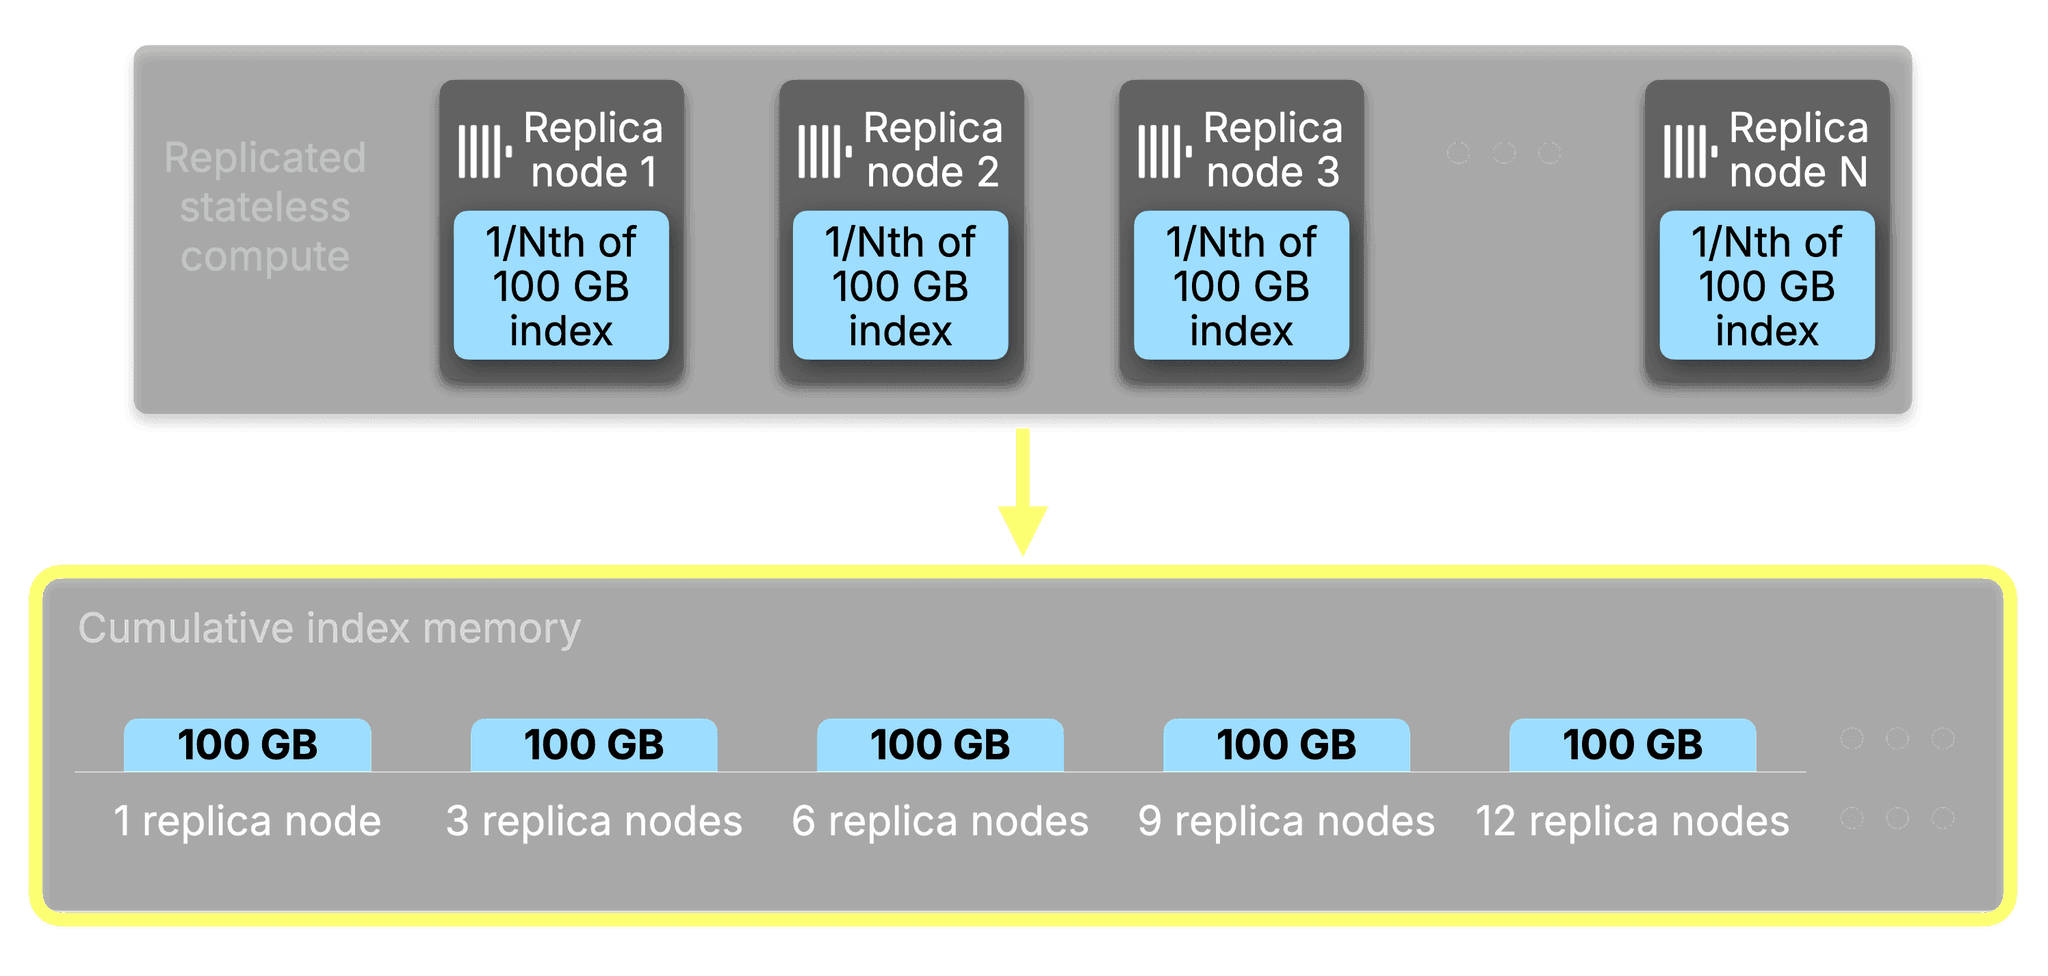
Index Sharding が登場する前は、レプリカ数とインデックスメモリの関係は線形であり、回避不能でした。100 GB のインデックスは、3 つのレプリカ全体で合計 300 GB の作業メモリを消費していました。9 つのレプリカにスケールするとその数値は 900 GB に達し、他に何台が同じ処理を行っていようとも、各レプリカがインデックス全体の負担を背負っていました。
Index Sharding の導入により、実行するレプリカ数に関係なく、クラスター全体でインデックスが消費する作業メモリの合計はインデックス自体のサイズに静的に制限されるようになりました。レプリカを追加しても全体の合計値は一定のままであり、個々のレプリカが担当する割合は反比例して減少します。
ClickHouse クラスター全体でインデックス分析がどのように割り当てられるかの例を見てみましょう。25 個のパートにまたがる 16 GB の主キーを持つテーブルで、10 台のレプリカに対して分散インデックス分析を有効にした場合、メモリの分散は以下のようになりました:
| レプリカ | 主キーのメモリ | 割り当てられたパート数 |
|---|---|---|
| replica-1 | 3.57 MB | 193 |
| replica-2 | 3.41 MB | 210 |
| replica-3 | 3.69 MB | 219 |
| replica-4 | 3.72 MB | 226 |
| replica-5 | 3.84 MB | 226 |
各レプリカは必要な分だけを保持します。16 GB のインデックスはクラスター内のノードごとに存在するのではなく、クラスター全体で合計して 1 つだけ存在します。これにより、スケールアウトの経済性が一変します。インデックスメモリのオーバーヘッドを吸収するためだけにインスタンスサイズを拡大し続ける必要はなく、同時実行数とスループット向上のためにレプリカ数を増やすことができます。
各レプリカで解放された作業メモリは、本来の目的であるクエリ処理のために利用できます。
Index Sharding はどのように分析パフォーマンスを向上させるか?
1 つ目のメリットと相乗効果を生み出す 2 つ目のメリットがあります。インデックス分析を分散すると、処理速度も高速化される点です。
Index Sharding がない場合、単一クエリの観点から見ると、インデックス分析は根本的に単一ノードに縛られます。データの読み取りを開始する前に、1 台のノードが数億個にも及ぶグラニュールのマークをスキャンする作業をすべて行います。ベクトル検索や全文検索のように負荷が高く選択性の高いセカンダリインデックスを持つテーブルでは、この分析フェーズがクエリコストの大半を占めることがよくあります。
分析をレプリカ間で分散することで、その単一のボトルネックが分散化されます。各レプリカはそれぞれの担当スライスを同時に処理し、イニシエーターは完全な評価を自身で行う代わりに、コンパクトな範囲結果をマージするだけで済みます。レプリカが増えるほど並列度が高まり、並列度が高まるほど分析が高速になります。
500 億行のテーブル(17,000 パート、600 万マーク)において、10 台のレプリカで測定したベンチマーク結果は以下のとおりです:
| クエリタイプ | 分散インデックス分析なし | 分散インデックス分析あり | 高速化 |
|---|---|---|---|
| 主キー範囲クエリ | 1.0 秒 | 0.23 秒 | 4.3 倍 |
| ブルームフィルター検索 | 8.5 秒 | 1.1 秒 | 7.7 倍 |
| ベクトル検索 | 6.5 秒 | 0.9 秒 | 7.2 倍 |
| 全文インデックス検索 | 3.1 秒 | 0.53 秒 | 5.8 倍 |
レプリカを追加すると、その効果はさらに高まります。Index Sharding を有効にした状態で、レプリカを 10 台から 20 台にスケールした場合の結果です:
| クエリタイプ | 10 レプリカ | 20 レプリカ | さらなる高速化 |
|---|---|---|---|
| 主キー範囲クエリ | 0.23 秒 | 0.16 秒 | 1.4 倍 |
| ブルームフィルター検索 | 1.1 秒 | 0.65 秒 | 1.7 倍 |
| ベクトル検索 | 0.9 秒 | 0.52 秒 | 1.7 倍 |
| 全文インデックス検索 | 0.53 秒 | 0.37 秒 | 1.4 倍 |
Index Sharding がない場合、レプリカを追加してもデータ読み取りのスループットは向上しますが、インデックス分析にはまったく寄与しません。単一ノードでの作業のままです。一方、これを使用すると、追加するすべてのレプリカが分析スループットとメモリ分散の両方に貢献します。セカンダリインデックス(特に全文検索やベクトル検索)を持つ大規模テーブルでよく見られる、インデックス分析がボトルネックとなっているクエリでは、インデックス分析が毎回のクエリで支払う「税金」となるか、レプリカへの投資から得られる「力強い推進力」となるかの分かれ目になります。
どのようなワークロードで最も効果を発揮するか?
Index Sharding は、インデックス分析がクエリコストの大きな割合を占めている環境で最も高い効果を発揮します。具体的には、複数のセカンダリインデックスを持つ大規模テーブル、多数のレプリカ構成、そしてデータ読み取りを開始する前にインデックスを多用してグラニュールを除外する選択性の高いフィルターを使用している場合です。全文検索、ベクトル類似度検索、ブルームフィルターインデックスがその最もわかりやすい例です。これらは大規模テーブルにおいてレプリカごとに数ギガバイトの作業メモリを占有することがあり、テーブルがその領域に達すると、メモリの節約と分析の並列化の両方がレプリカを追加するたびに相乗効果を生み出します。
分析の分散に伴う調整オーバーヘッドが常に正当化されるように、Index Sharding はテーブルレベルの 2 つのしきい値が満たされた場合にのみ自動的に有効化されます。1 つ目は distributed_index_analysis_min_parts_to_activate(デフォルト: 10)で、分散を試行する前に最低限必要なパート数を定めています。2 つ目、そしてより重要な設定が distributed_index_analysis_min_indexes_bytes_to_activate(デフォルト: 1073741824、つまり 1 GB)であり、ディスク上の全インデックスの非圧縮合計サイズが 1 GB を超えていることを要求します。このしきい値を下回る場合、インデックスをローカルにロードする方が高速かつ軽量です。しきい値を超えると、分析コストがクエリレイテンシやレプリカあたりの作業メモリに影響を与え始めるため、分散による効果が有意に現れます。
両方のしきい値はテーブルレベルの設定であり、ワークロードに合わせて調整可能です:
ALTER TABLE my_favorite_table MODIFY SETTING
    distributed_index_analysis_min_parts_to_activate = 20,
distributed_index_analysis_min_indexes_bytes_to_activate = 21474836480; -- 20 GBdistributed_index_analysis が有効になっている場合、分析がローカルから分散へと移行するには両方の条件を満たす必要があり、これにより規模の小さい分析でもパフォーマンスが損なわれないようになっています。
デモを見ることはできますか?
8 個のサブテーブルで構成される Merge テーブルを持つ社内データベースにおいて、SELECT * ... LIMIT 1 というクエリを実行してみます。これにより、すべてのグラニュールを選択対象としつつ、クエリ処理側で結果を制限できます。インデックス解析の簡潔な実行計画を確認すると、インデックス解析が合計 10 台のレプリカに分散されていることが分かります。
EXPLAIN indexes=1 select * from merge_table.merge_table LIMIT 1
SETTINGS distributed_index_analysis = 1
FORMAT LineAsString;

Expression ((Project names + (Projection + Change column names to column identifiers)))
  Limit (preliminary LIMIT)
    ReadFromMerge
      Expression
        ReadFromMergeTree (merge_table.merge_table)
        Indexes:
          MinMax
            Condition: true
            Parts: 1877/1877
            Granules: 292646425/292646425
          Partition
            Condition: true
            Parts: 1877/1877
            Granules: 292646425/292646425
          PrimaryKey
            Condition: true
            Parts: 1877/1877
            Granules: 292646425/292646425
            Distributed:
              Replicas: 10
              Parts send: 1074
              Parts received: 1074
              Granules send: 279134908
              Granules received: 279134908
          Ranges: 1877
Tables: 8compact=1 を外して解析結果を展開し、一部を詳しく見てみると、そのサイズから 2 つのテーブルが分散解析の対象になっていることが確認できます。
EXPLAIN indexes=1 select * from merge_table.merge_table LIMIT 1
SETTINGS distributed_index_analysis = 1
FORMAT LineAsString;

Expression ((Project names + (Projection + Change column names to column identifiers)))
...
			Expression
        ReadFromMergeTree (merge_table.table-1)
        Indexes:
				...
          PrimaryKey
            Condition: true
            Parts: 11/11
            Granules: 1314708/1314708
          Ranges: 11
      Expression
        ReadFromMergeTree (merge_table.table-2)
        Indexes:
          ...
          PrimaryKey
            Condition: true
            Parts: 112/112
            Granules: 76119629/76119629
            Distributed:
              Address: replica-1:9000
              Parts send: 24
              Parts received: 24
              Granules send: 16902011
	              Granules received: 16902011
              Address: replica-2:9000
              Parts send: 21
              Parts received: 21
              Granules send: 13104084
              Granules received: 13104084
              ...
          Ranges: 112
      Expression
        ReadFromMergeTree (merge_table.table-3)
        Indexes:
          ...
          PrimaryKey
            Condition: true
            Parts: 14/14
            Granules: 41/41
          Ranges: 14
      Expression
        ReadFromMergeTree (merge_table.table-4)
        Indexes:
          ...
          PrimaryKey
            Condition: true
            Parts: 21/21
            Granules: 1955/1955
          Ranges: 21
      Expression
        ReadFromMergeTree (merge_table.table-5)
        Indexes:
          ...
          PrimaryKey
            Condition: true
            Parts: 401/401
            Granules: 654988/654988
          Ranges: 401
      Expression
        ReadFromMergeTree (merge_table.table-6)
        Indexes:
          ...
          PrimaryKey
            Condition: true
            Parts: 962/962
            Granules: 203015279/203015279
            Distributed:
              Address: replica-1:9000
              Parts send: 195
              Parts received: 195
              Granules send: 43951345
              Granules received: 43951345
              Address: replica-2:9000
              Parts send: 172
              Parts received: 172
              Granules send: 37951746
              Granules received: 37951746
              ...
      Expression
        ReadFromMergeTree (merge_table.table-7)
        ...
          PrimaryKey
            Condition: true
            Parts: 253/253
            Granules: 11413730/11413730
          Ranges: 253
      Expression
        ReadFromMergeTree (merge_table.table-8)
        Indexes:
          ...
          PrimaryKey
            Condition: true
            Parts: 103/103
            Granules: 125095/125095
Ranges: 103得られた結果を見ると、2 回の分散解析全体でグラニュールが驚くほど均等に分散されており、残りのテーブルについては以下のようになっています。
5 台のレプリカに分散(table-2 および table-6):
| レプリカ | 割り当てられたパート | 割り当てられたグラニュール |
|---|---|---|
| replica-1 | 193 | 51,055,830 |
| replica-2 | 210 | 51,297,728 |
| replica-3 | 219 | 60,853,356 |
| replica-4 | 226 | 57,846,820 |
| replica-5 | 226 | 58,081,174 |
イニシエーター上でローカルに解析(すべてのテーブルが閾値未満):
| テーブル | パート | グラニュール |
|---|---|---|
| table-1 | 11 | 1,314,708 |
| table-3 | 14 | 41 |
| table-4 | 21 | 1,955 |
| table-5 | 401 | 654,988 |
| table-7 | 253 | 11,413,730 |
| table-8 | 103 | 125,095 |
分散インデックス解析の EXPLAIN 完全出力(クリックして展開)
EXPLAIN indexes=1 select * from merge_table.merge_table LIMIT 1
SETTINGS distributed_index_analysis = 1
FORMAT LineAsString;

Expression ((Project names + (Projection + Change column names to column identifiers)))
  Limit (preliminary LIMIT)
    ReadFromMerge
      Expression
        ReadFromMergeTree (merge_table.table-1)
        Indexes:
          MinMax
            Condition: true
            Parts: 11/11
            Granules: 1314708/1314708
          Partition
            Condition: true
            Parts: 11/11
            Granules: 1314708/1314708
          PrimaryKey
            Condition: true
            Parts: 11/11
            Granules: 1314708/1314708
          Ranges: 11
      Expression
        ReadFromMergeTree (merge_table.table-2)
        Indexes:
          MinMax
            Condition: true
            Parts: 112/112
            Granules: 76119629/76119629
          Partition
            Condition: true
            Parts: 112/112
            Granules: 76119629/76119629
          PrimaryKey
            Condition: true
            Parts: 112/112
            Granules: 76119629/76119629
            Distributed:
              Address: replica-1:9000
              Parts send: 24
              Parts received: 24
              Granules send: 16902011
              Granules received: 16902011
              Address: replica-2:9000
              Parts send: 21
              Parts received: 21
              Granules send: 13104084
              Granules received: 13104084
              Address: replica-3:9000
              Parts send: 20
              Parts received: 20
              Granules send: 12832693
              Granules received: 12832693
              Address: replica-4:9000
              Parts send: 23
              Parts received: 23
              Granules send: 16373147
              Granules received: 16373147
              Address: replica-5:9000
              Parts send: 24
              Parts received: 24
              Granules send: 16907694
              Granules received: 16907694
          Ranges: 112
      Expression
        ReadFromMergeTree (merge_table.table-3)
        Indexes:
          MinMax
            Condition: true
            Parts: 14/14
            Granules: 41/41
          Partition
            Condition: true
            Parts: 14/14
            Granules: 41/41
          PrimaryKey
            Condition: true
            Parts: 14/14
            Granules: 41/41
          Ranges: 14
      Expression
        ReadFromMergeTree (merge_table.table-4)
        Indexes:
          MinMax
            Condition: true
            Parts: 21/21
            Granules: 1955/1955
          Partition
            Condition: true
            Parts: 21/21
            Granules: 1955/1955
          PrimaryKey
            Condition: true
            Parts: 21/21
            Granules: 1955/1955
          Ranges: 21
      Expression
        ReadFromMergeTree (merge_table.table-5)
        Indexes:
          MinMax
            Condition: true
            Parts: 401/401
            Granules: 654988/654988
          Partition
            Condition: true
            Parts: 401/401
            Granules: 654988/654988
          PrimaryKey
            Condition: true
            Parts: 401/401
            Granules: 654988/654988
          Ranges: 401
      Expression
        ReadFromMergeTree (merge_table.table-6)
        Indexes:
          MinMax
            Condition: true
            Parts: 962/962
            Granules: 203015279/203015279
          Partition
            Condition: true
            Parts: 962/962
            Granules: 203015279/203015279
          PrimaryKey
            Condition: true
            Parts: 962/962
            Granules: 203015279/203015279
            Distributed:
              Address: replica-1:9000
              Parts send: 195
              Parts received: 195
              Granules send: 43951345
              Granules received: 43951345
              Address: replica-2:9000
              Parts send: 172
              Parts received: 172
              Granules send: 37951746
              Granules received: 37951746
              Address: replica-3:9000
              Parts send: 190
              Parts received: 190
              Granules send: 38465035
              Granules received: 38465035
              Address: replica-4:9000
              Parts send: 203
              Parts received: 203
              Granules send: 41708027
              Granules received: 41708027
              Address: replica-5:9000
              Parts send: 202
              Parts received: 202
              Granules send: 40939126
              Granules received: 40939126
          Ranges: 962
      Expression
        ReadFromMergeTree (merge_table.table-7)
        Indexes:
          MinMax
            Condition: true
            Parts: 253/253
            Granules: 11413730/11413730
          Partition
            Condition: true
            Parts: 253/253
            Granules: 11413730/11413730
          PrimaryKey
            Condition: true
            Parts: 253/253
            Granules: 11413730/11413730
          Ranges: 253
      Expression
        ReadFromMergeTree (merge_table.table-8)
        Indexes:
          MinMax
            Condition: true
            Parts: 103/103
            Granules: 125095/125095
          Partition
            Condition: true
            Parts: 103/103
            Granules: 125095/125095
          PrimaryKey
            Condition: true
            Parts: 103/103
            Granules: 125095/125095
Ranges: 103インデックスシャーディングを自分で試すにはどうすればよいですか?
インデックスシャーディングは、現在 ClickHouse Cloud 上の SharedMergeTree テーブルを対象にプライベートプレビューとして利用可能です。インデックスメモリが制約となっている規模、またはインデックス解析時間がクエリレイテンシのかなりの割合を占めるような規模のワークロードを実行している場合は、ぜひお声がけください。
アクセスを希望される場合は、担当の ClickHouse アカウントチームにお問い合わせいただくか、clickhouse.com/contact までご連絡ください。
今すぐ ClickHouse Cloud を始めて、$300 のクレジットを受け取りましょう。30 日間の無料トライアル終了後は、従量課金プランに移行できます。ボリュームベースの割引について詳しくは お問い合わせ ください。詳細は 料金ページ をご覧ください。