50,7 k

本記事は、筆者による PGConf.EU 2026 の講演「The Primary Is Down. Are You Sure?」に基づいています。
マネージド Postgres サービスでは、新しいスタンバイを昇格させる前に、すべての接続が旧プライマリへ書き込むのを防ぐ必要があります。これはフェンシングと呼ばれ、書き込みの喪失やスプリットブレインの発生を防ぐために不可欠です。
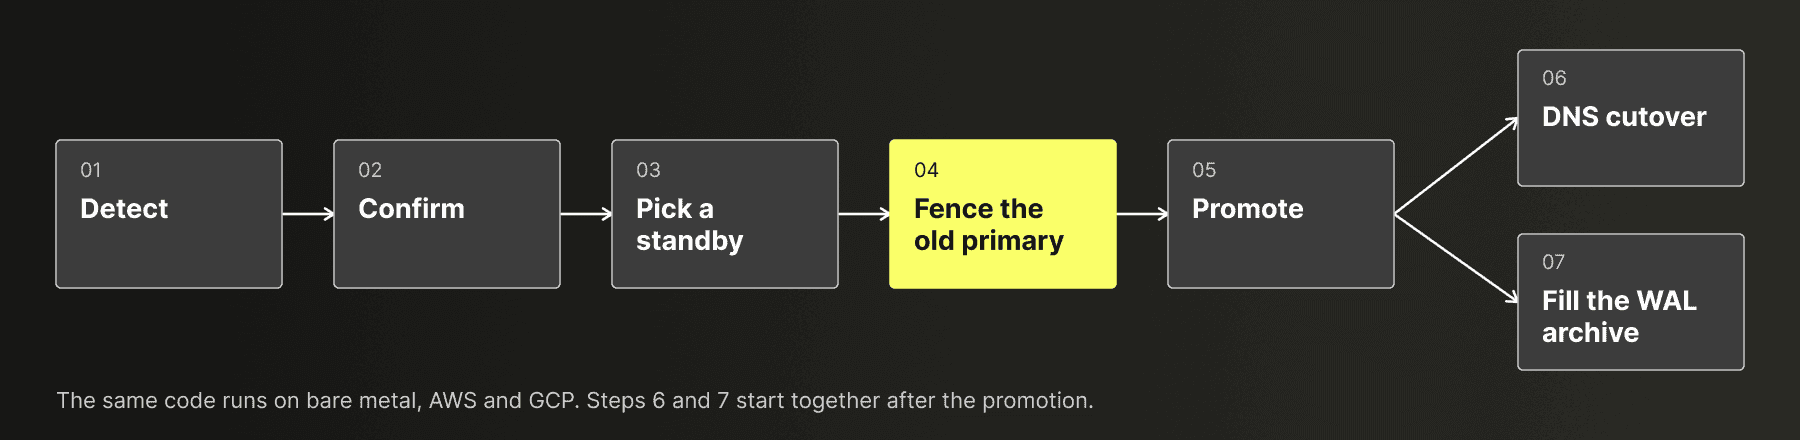
スタンバイを昇格させるのに、なぜフェンシングが必要なのか?
この疑問に答えるには、まず昇格処理の内容と、スタンバイを新プライマリにする際の一連の手順を理解する必要があります。旧プライマリが実際には停止していない可能性がある点に留意してください。クライアントはプライマリに接続できるもののコントロールプレーン側からは接続できないネットワーク分断が発生している場合、クライアントは旧プライマリへの書き込みを継続できてしまいます。
その手順は以下のとおりです。
-
SELECT pg_promote(true, 300)を実行してスタンバイを昇格させます。この時点で、このスタンバイはプライマリからのコミット確認(ACK)の送信を停止します。 -
DNS レコードを更新し、新規接続が新プライマリに向くようにします。
これらの手順はいずれも、旧プライマリが書き込みを受け付けるのを阻止するものではなく、スプリットブレインを引き起こす恐れがあります。DNS の挙動は明確です。TTL が切れるまで新規クライアントは旧プライマリに接続し続ける可能性があり、すでに接続済みのクライアントはそのまま維持されます。では、スタンバイからのコミット確認を停止した場合はどうでしょうか。これだけでは防ぎきれないシナリオが 3 つあります。
-
スタンバイが 1 台のみの場合、非同期レプリケーションで構成されているため、プライマリはスタンバイの応答を待ちません。スタンバイが 2 台ある場合でも、各セッションは
SET synchronous_commit = localまたはoffを設定して自セッションの待機を無効化できます。 -
スタンバイが 2 台ある場合、クォーラムコミット(
ANY 1)で構成されます。そのうち 1 台を昇格させた後でも、もう 1 台のスタンバイがコミットを確認する限り、旧プライマリ側でコミットが成立してしまいます。 -
両方のスタンバイが完全に切断されている場合でも、旧プライマリに接続し続けているクライアントは
COMMITを送信できます。通常、Postgres は確認応答を待ちますが、クライアントがクエリをキャンセルした場合(psql での Ctrl+C など)、または旧プライマリがクラッシュして再起動した場合、コミットはすでに旧プライマリの WAL(write-ahead log)に書き込まれているため、すべてのセッションからそのコミットが見えるようになります。これは Postgres の同期レプリケーションにおける既知の挙動です。
そのため、スタンバイを昇格させる前に、旧プライマリがあらゆる書き込みを受け付けないよう遮断する必要があります。
フェンシング時のダウンタイムの最小化
フェンシングが完了するまでスタンバイを昇格できないため、フェンシングは極めて時間に敏感な処理です。フェンシングに要した時間はそのままダウンタイムの延長につながります。この影響を最小限に抑えるため、複数のフェンシング手法を並行して試行し、いずれか 1 つが成功した時点で直ちにフェイルオーバーを進めるようにしています。
Ubicloud のコントロールプレーンは、ベアメタル、AWS、GCP の 3 つの環境でマネージド PostgreSQL をサポートしています。各環境では共通のフェンシング方式をサポートしつつ、プラットフォーム固有のアプローチでそれを補完しています。これらの手法を組み合わせることで、旧プライマリを可能な限り迅速にフェンシングします。
ClickHouse Managed Postgres は、Ubicloud と ClickHouse が共同開発している オープンソースの Ubicloud コントロールプレーン 上で稼働しています。両チームのメンバーの数名は、Citus Data や Microsoft の時代からマネージド Postgres の開発を共にしており、筆者もその 1 人です。
環境を問わず共通のフェンシングメカニズム
コントロールプレーンから基盤となる VM への SSH アクセスは可能であるものの、Postgres 自体が正常でない状況を想定してみましょう。このとき利用できる便利な手段として、pg_stop と hba の 2 つがあります。
pg_stop は単に pg_ctlcluster を使ってクラスターを停止するものですが、再起動時に問題が生じます。デフォルトでは postgresql-common の start.conf に自動起動が組み込まれており、通常は VM の再起動時に Postgres インスタンスを自動復旧させたいため、この設定を維持しています。しかしその結果、クラスターを停止しても、何らかの理由で VM が再起動するとプライマリが再び稼働してしまいます。
一方、hba メカニズムは新しい pg_hba.conf を書き込んで Postgres をリロードするため、再起動後も効果が持続します。ただし、このルールが適用されるのは新規接続の試行時のみです。Postgres の ドキュメント には、各レコードタイプについてレコードが「接続試行と一致する」と記載されています。つまり、すでに確立されているセッションは pg_hba の検証を再度通過しません。これらの接続には、長時間維持される PgBouncer のサーバー接続なども含まれます。そのため、既存の接続に対しては何の抑止力にもなりません。
さらに、これら 2 つのメカニズムはいずれも SSH アクセスが可能であることを前提としているため、コントロールプレーンが基盤 VM に到達できなければなりません。VM 自体に到達できない場合、コントロールプレーンはゲスト OS の外部から操作する手段を必要とします。ここから、基盤となる VM プロバイダーごとに対応が分かれることになります。
ベアメタル環境でのフェンシング
ベアメタル環境では、コントロールプレーンが Postgres VM を実行するホストマシン自体も管理しています。そのため、ホスト側からフェンシングを実行できます。各 VM にはホスト上で専用のネットワーク名前空間が割り当てられ、veth ペアによって両者が接続されています。vethi<vm> 側が名前空間内にあり、vetho<vm> 側がホスト上に配置されます。ホストは VM のパブリック IPv4 および IPv6 アドレスを vetho<vm> にルーティングし、レプリケーションを伝送する暗号化プライベートネットワークもこのペアを経由します。
したがって、フェンシングは基本的にホスト上で以下のコマンドを実行するだけです。
timeout 10 sudo ip link set vetho<vm> down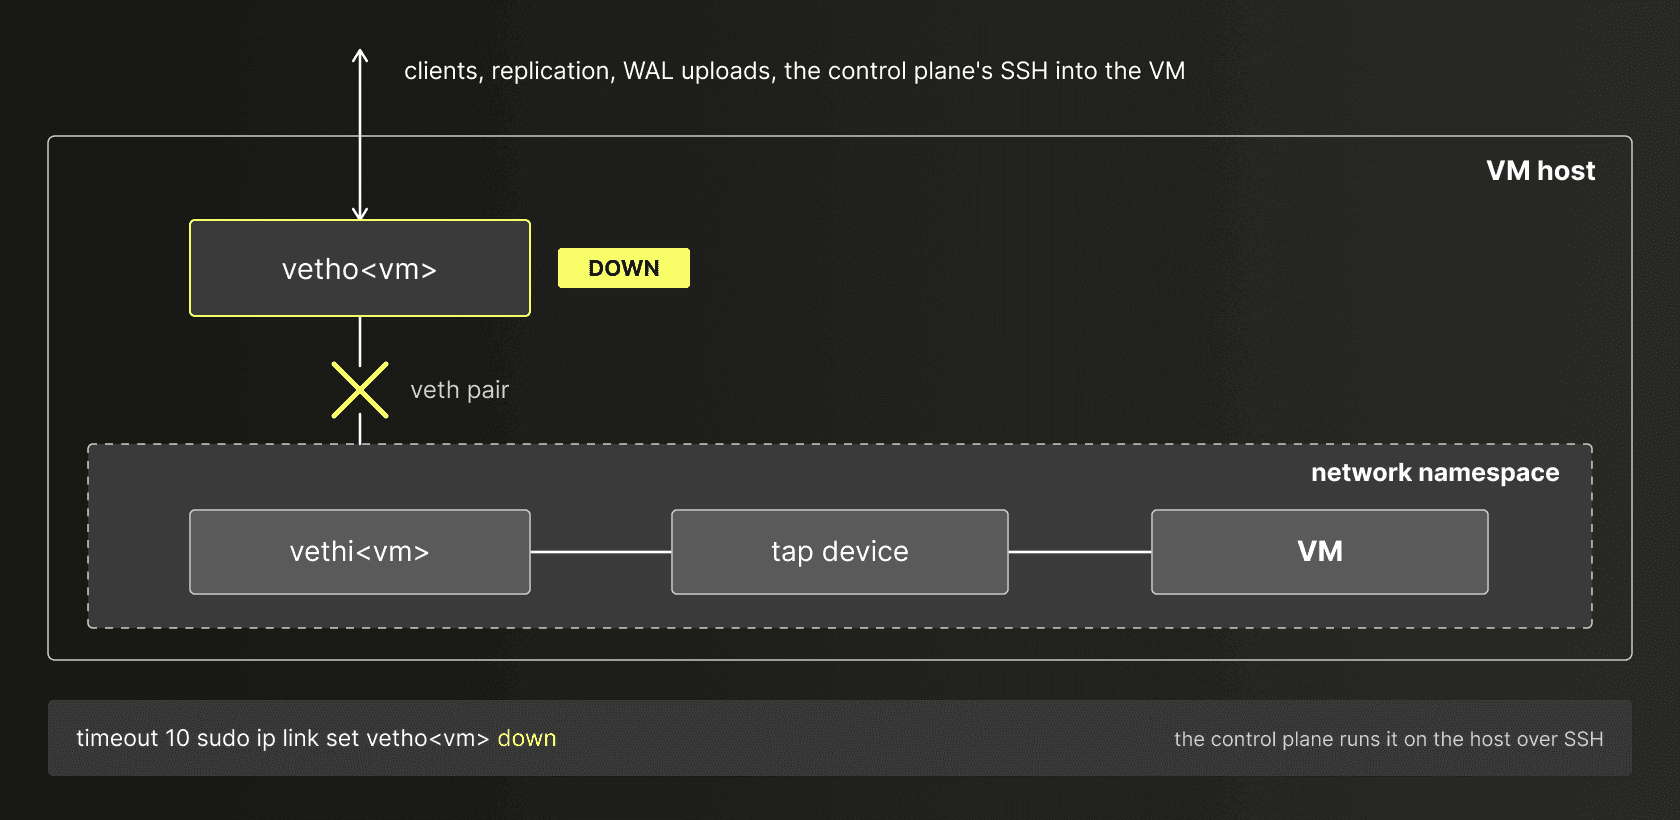
veth(4) の man ページ には、「いずれかのデバイスが停止すると、ペアのリンク状態は停止する」と記載されています。クライアント、レプリケーション、オブジェクトストレージへの WAL アップロード、そしてコントロールプレーンから VM への SSH 接続もすべてこのペアを経由するため、すべて遮断されます。Postgres 自体は内部で動作し続けますが、名前空間の外部からは一切到達できなくなり、コントロールプレーンはホスト経由で VM を破棄できます。
このフェンシングにはホストからの応答が必要です。ホスト自体に到達できない場合、pg_stop と hba もそのホスト経由でゲストにアクセスしているため、3 つのメカニズムがすべて失敗します。
AWS 環境でのフェンシング
AWS では、コントロールプレーンはホストへのアクセス権を持たないため、ゲストの外部から実行できる操作は EC2 API の呼び出しのみとなります。この API を通じたフェンシングについて 3 つの方法を検討しましたが、いずれも要件を満たしませんでした。
stop-instances --forceは、正常なシャットダウンを待機するため処理が低速です。- 2025年7月以降、
StopInstancesには OS のシャットダウンをスキップする skipOsShutdown パラメータが追加されました。しかし、筆者らが見出した別手法の方が高速であり、フェイルオーバー時にはわずかな時間も無駄にできないため採用しませんでした。
- 2025年7月以降、
- セキュリティグループは処理が高速ですが、ステートフルであるため、追跡済みの既存接続はアクティブなまま維持されてしまいます。
- ネットワーク ACL(アクセスコントロールリスト)は構造が複雑で、後でクリーンアップが必要なリソースが追加で作成されてしまいます。
最終的に採用した解決策は、ネットワークインターフェース(NIC) をデタッチ(切り離し)することでした。これにより、既存の接続と新規の接続の両方についてトラフィックが遮断されます。問題となるのは、各 EC2 インスタンスのデバイスインデックス 0 にはプライマリネットワークインターフェースが存在し、インスタンスの稼働中にプライマリネットワークインターフェースをデタッチすることはできない点です。しかし、セカンダリネットワークインターフェースであれば、インスタンスの稼働中であってもデタッチが可能です。
そこで、AWS 上のすべての Postgres サーバーに 2 つ目の NIC を持たせるようコントロールプレーンを設計しました。管理用 NIC をデバイスインデックス 0 に配置してコントロールプレーンの SSH 接続を通し、ユーザー用 NIC をデバイスインデックス 1 に配置します。ユーザー用 NIC はパブリックアドレスを保持し、データベースの DNS レコードもここを指します。クライアント接続やレプリケーションもこちらを経由します。これは、プライマリインターフェースがパブリックトラフィックを処理する AWS ドキュメントの 管理ネットワークの例 とは逆の構成です。
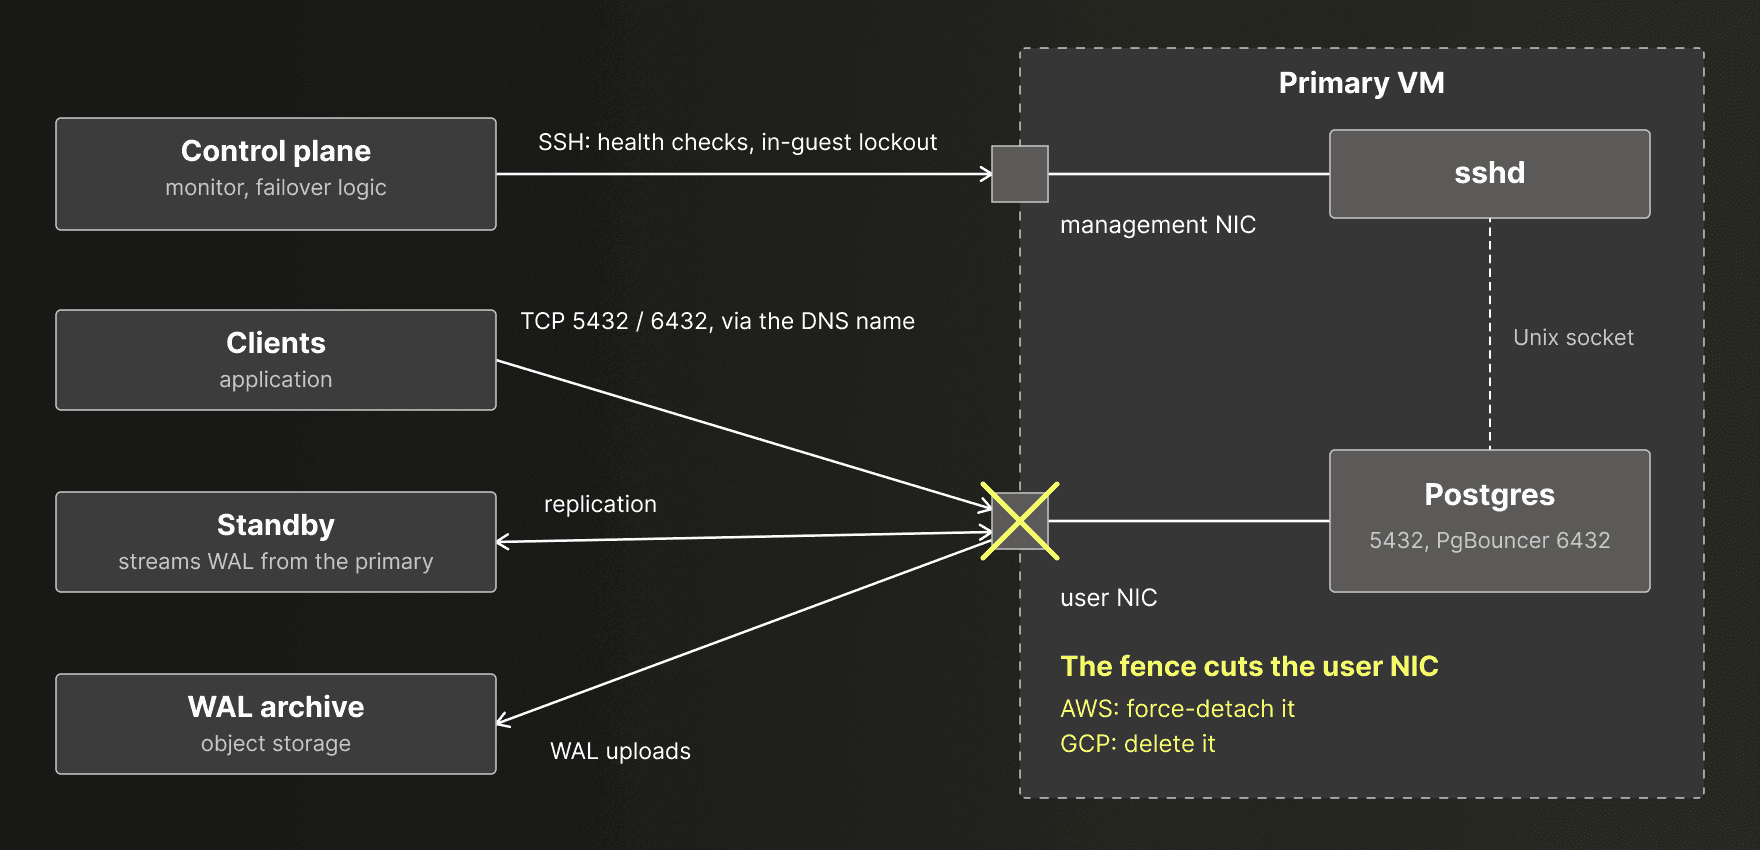
フェンシングを実行する際、コントロールプレーンはユーザー用 NIC を強制的にデタッチします。
client.detach_network_interface(
attachment_id: network_interface.attachment.attachment_id,
force: true,
)API リファレンス には、「Force パラメータは、障害が発生したインスタンスからネットワークインターフェースをデタッチするための最後の手段としてのみ使用してください」と記載されています。障害が発生した旧プライマリを再利用することはありません。コントロールプレーン側でユーザー用 NIC を再アタッチすることはなく、旧 VM が破棄されるまでデタッチされた状態が維持されるため、今回のケースでは強制オプションを使用しても問題ありません。
このフェンシングメカニズムが実際に機能した例を紹介します。以下は、AWS 上でのフェイルオーバー時のコントロールプレーンのログです。
21:19:40 respirate.2 | {"ssh":{...,"cmd":"timeout 10 sudo pg_ctlcluster 18 main stop -m immediate","exit_code":2,...,"stdout":"Cluster is not running.\n",...}
21:19:40 respirate.1 | {"ssh":{...,"cmd":"timeout 10 sudo postgres/bin/lockout-hba 18","exit_code":1,...,"stderr":"... command failed: sudo pg_ctlcluster 18 main reload (CommandFail)...
21:19:42 respirate.1 | {"fenced_unresponsive_primary":{...,"mechanism":"detach_nic"},"message":"Fenced unresponsive primary",...}
21:19:42 respirate.2 | {"strand_hopped":{...,"from":"Postgres::PostgresServerNexus.wait_representative_lockout","to":"Postgres::PostgresServerNexus.prepare_taking_over"},...}pg_stop メカニズムでは実行中のクラスターが見つからず、hba はリロードできませんでした。これは SIGKILL 後の挙動として想定どおりです。結果としてデタッチのみが成功したメカニズムとなり、スタンバイは昇格処理へと進みました。13 秒後、コントロールプレーンは管理用 NIC 経由で旧プライマリのカーネルログを保存しましたが、その最後の行は以下のようになっていました。
2026-08-26T21:19:42,694874+00:00 pcieport 0000:26:00.1: pciehp: Slot(36): Button press: will power off in 5 secGoogle Cloud 環境でのフェンシング
Google Cloud(GCP)でも、コントロールプレーンはホストにアクセスできないため、ゲストの外部からは Compute Engine API を呼び出すことしかできません。複数の方法を検討しましたが、Compute Engine の一般的な選択肢はいずれもフェンシング手段としては機能しませんでした。
| 選択肢 | 発生する挙動 |
|---|---|
| ファイアウォールの拒否ルール | 「既存の接続は維持され、関連するトラフィックは影響を受けません。」(ドキュメント) |
| 外部 IP の削除 | 内部アドレスでのレプリケーションは継続し、NIC が 1 つの VM ではそのアドレスを使用するコントロールプレーンの SSH も失われる |
| VM の停止または削除 | ゲストにはシャットダウンのために「最大 120 秒」が与えられ(ドキュメント)、ローカル SSD のデータは破棄される。skipGuestOsShutdown で待機をスキップできるが、検証では Google 側で停止完了とマークされるまでに呼び出しから 16 〜 19 秒を要した |
| セカンダリ NIC の追加 | 通常のセカンダリ NIC はデタッチできない |
幸いなことに、2025年10月30日に GCP で Dynamic NIC が 一般提供(GA) されました。Dynamic NIC は、通常の NIC の VLAN サブインターフェースです。GCP のドキュメント には、「Dynamic NIC の追加や削除にインスタンスの再起動や再作成は不要です」と記載されています。また、Dynamic NIC は親 NIC の帯域幅とキューを共有します。
GCP では、nic0 を管理用 NIC として独立した VPC(仮想プライベートクラウドネットワーク)に配置し、コントロールプレーンからの SSH を許可してすべてのアウトバウンドトラフィックを拒否します。ユーザー用 NIC はデータベースのプライベートサブネット内にある VLAN 2 の Dynamic NIC であり、パブリックアドレス、レプリケーション、デフォルトルートを担います。フェンシングでは、deleteNetworkInterface を 1 回呼び出すだけでユーザー用 NIC を削除します。
ドキュメントには Dynamic NIC を追加する際のおおよその所要時間のみが記載されており、削除後にトラフィックがいつ停止するかについては触れられていなかったため、実測を行いました。筆者らのテストでは、リクエストから 0.7 〜 2.5 秒後にユーザー向け通信の最終パケットが届き、Google 側で操作完了とマークされたのはリクエストの 5.0 〜 7.0 秒後でした。
すべての選択肢が失敗した場合
旧プライマリのステートマシンは、メカニズムごとに 1 つの子ジョブをすべて同時に起動します。
label def lockout
decr_lockout
resource.lockout_mechanisms.each do |mechanism|
bud Prog::Postgres::PostgresLockout, {"mechanism" => mechanism}
end
hop_wait_lockout_attempt
endこのコードにおいて、bud は子ジョブを開始し、hop はステートマシンを次のステップへ進めます。各 子ジョブ はそれぞれのメカニズムを試行し、コマンドや API 呼び出しから制御が戻った時点で lockout_succeeded を報告します。SSH エラー、コマンドの失敗やタイムアウト、あるいは EC2 API からのエラーが返された場合は、lockout_failed を報告します。すべての子ジョブが終了すると、その結果報告の内容にかかわらず、旧プライマリはロックアウトされたものと見なされます。スタンバイはこれを 1 秒に 1 回確認し、昇格へと進みます。
つまり、すべてのメカニズムが失敗した場合でも、コントロールプレーンは昇格を実行します。これは意図的な挙動です。システム設計はフェイルオープンとなっており、リポジトリ内のテストでもこの動作が保証されています。より厳格な設計にした場合、どのフェンシングも成功しなかった際に担当者を呼び出すことになり、誰かが対応するまでデータベースにプライマリが存在しない状態が続いてしまいます。このトレードオフにおいて、私たちは可用性を選択しました。
まとめ
フェイルオーバーのコードは AWS、ベアメタル、GCP で共通ですが、フェンシングだけは環境ごとに異なるメカニズムが必要となるステップです。AWS では、コントロールプレーンが作成するすべての Postgres サーバーに 2 つ目の NIC を持たせ、ユーザー用 NIC を強制デタッチすることでフェンシングを行います。ベアメタルでは、ホスト上で 1 つの ip link コマンドを実行してフェンシングします。GCP では、Dynamic NIC を削除することでフェンシングします。設計がフェイルオープンになっているため、すべてのメカニズムが失敗した場合でもコントロールプレーンは昇格を進めます。
今回の取り組みで得られた知見のうち、コントロールプレーンの外部でも役立つ点が 2 つあります。第 1 に、postgresql-common を使用しているサーバーでは、start.conf の設定内容と、停止したプライマリが次回の起動時にどう振る舞うかを確認しておく必要があります。第 2 に、NIC を削除するフェンシング方式は、クラウド側が稼働中の VM からどの NIC をデタッチできるかに依存します。AWS ではデバイスインデックス 0 以外のすべての NIC が対象となり、GCP では通常の NIC が VM 作成時に固定されるため Dynamic NIC のみが対象となります。
ClickHouse Managed Postgres を今すぐ始める
自社のデータで ClickHouse Managed Postgres の動作を確認してみませんか?ClickHouse Cloud は数分で使い始めることができ、300 ドル分の無料クレジットも進呈されます。
サインアップ