

allow_asynchronous_read_from_io_pool_for_merge_tree를 사용하면 읽기 스레드(스트림) 수를 나머지 쿼리 실행 파이프라인의 스레드 수보다 더 많게 할 수 있습니다.
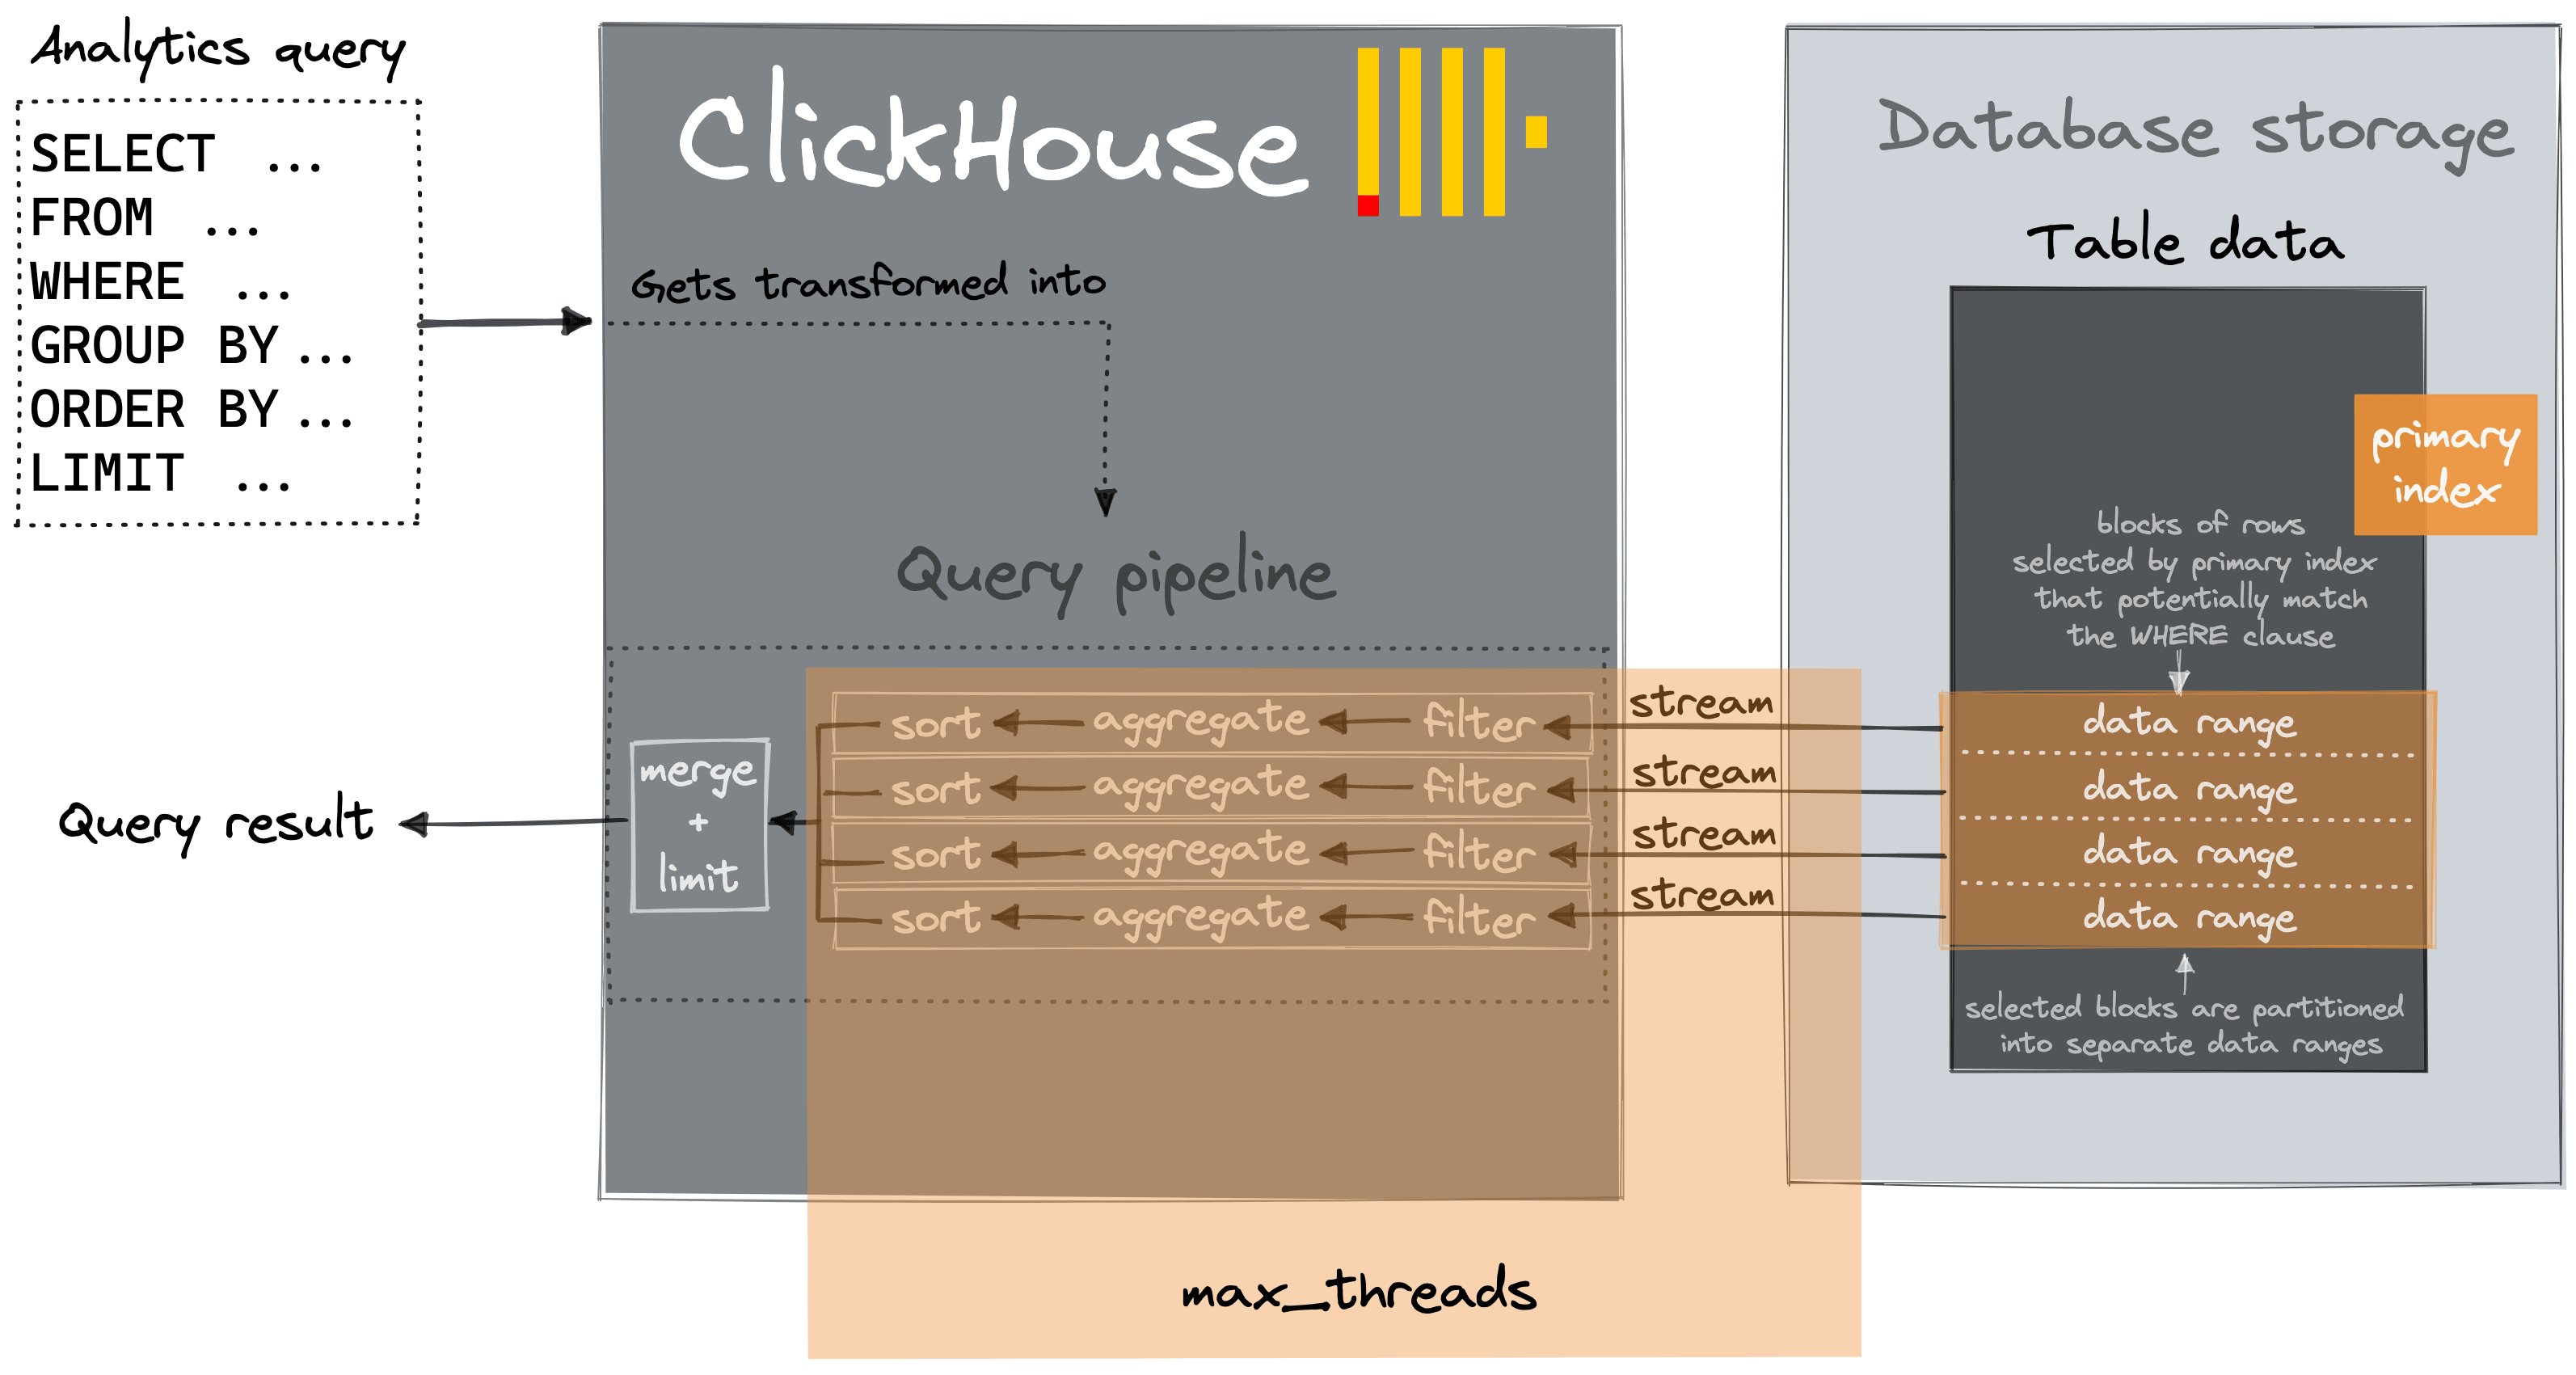
일반적으로 max_threads 설정은 병렬 읽기 스레드와 병렬 쿼리 처리 스레드 수를 제어합니다:
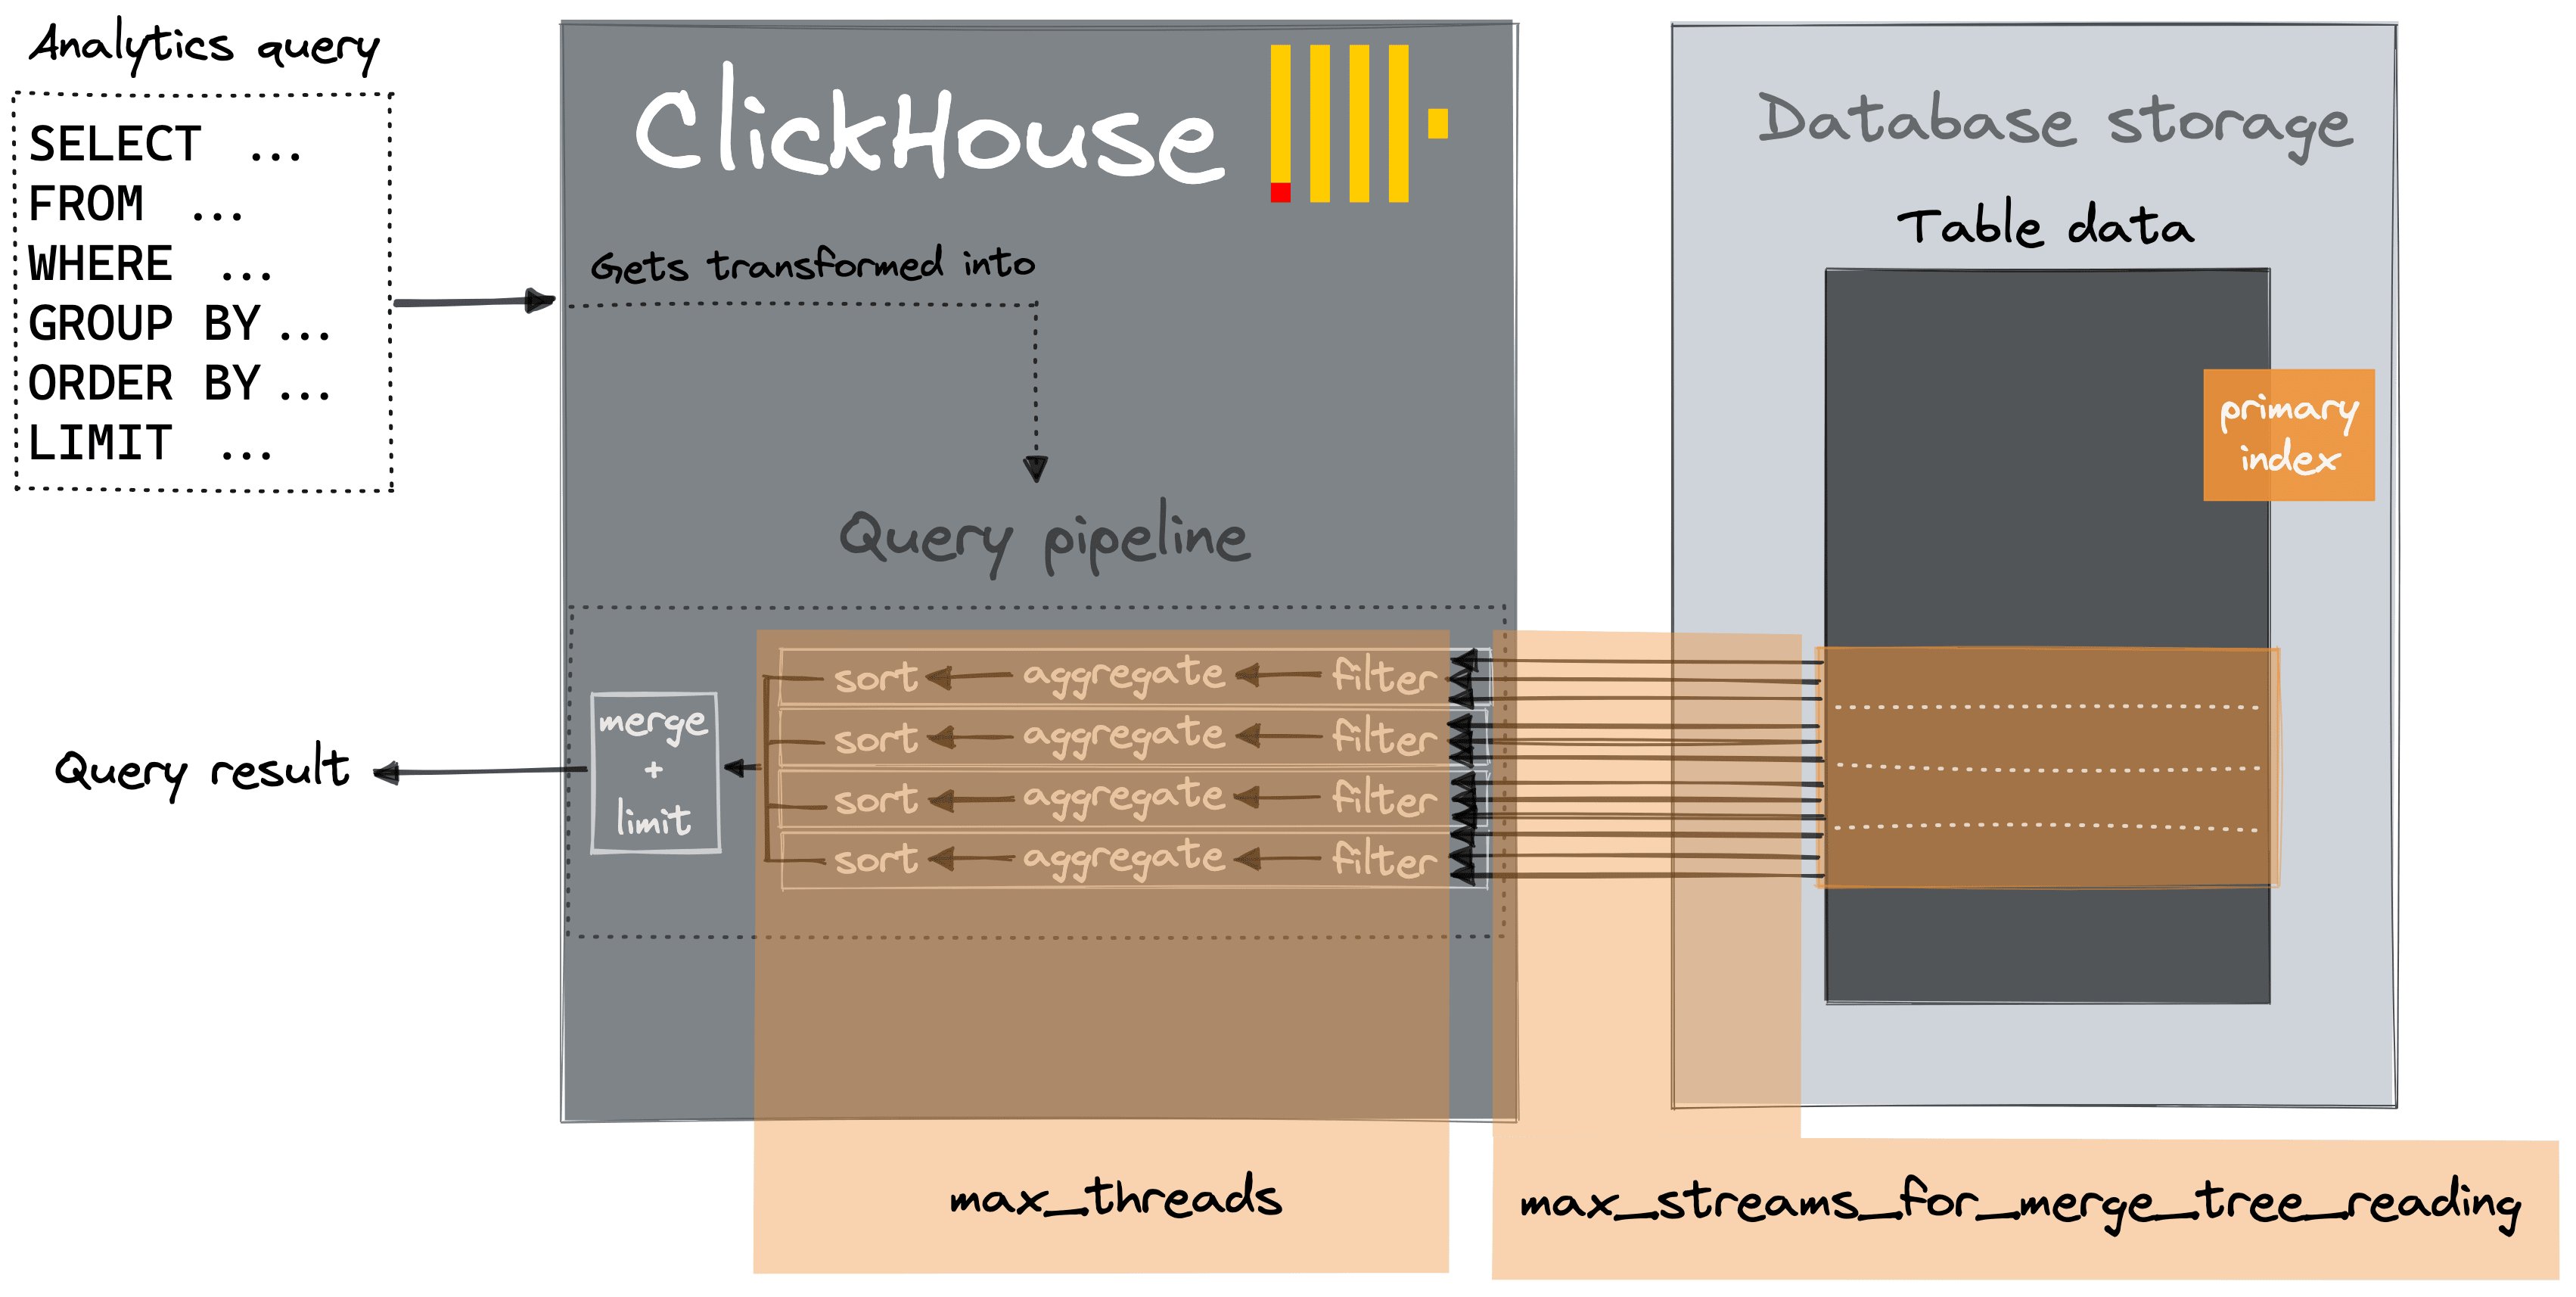
max_streams_for_merge_tree_reading 설정만큼 효과적이지 않았습니다.
optimize_read_in_order 최적화를 사용하면 쿼리의 정렬 순서가 디스크에 저장된 데이터의 물리적 순서를 반영할 때 ClickHouse는 메모리에서 데이터를 다시 정렬하는 과정을 건너뛸 수 있습니다. 하지만 이를 위해서는 데이터를 순서대로 읽어야 합니다(비동기 읽기와 반대):
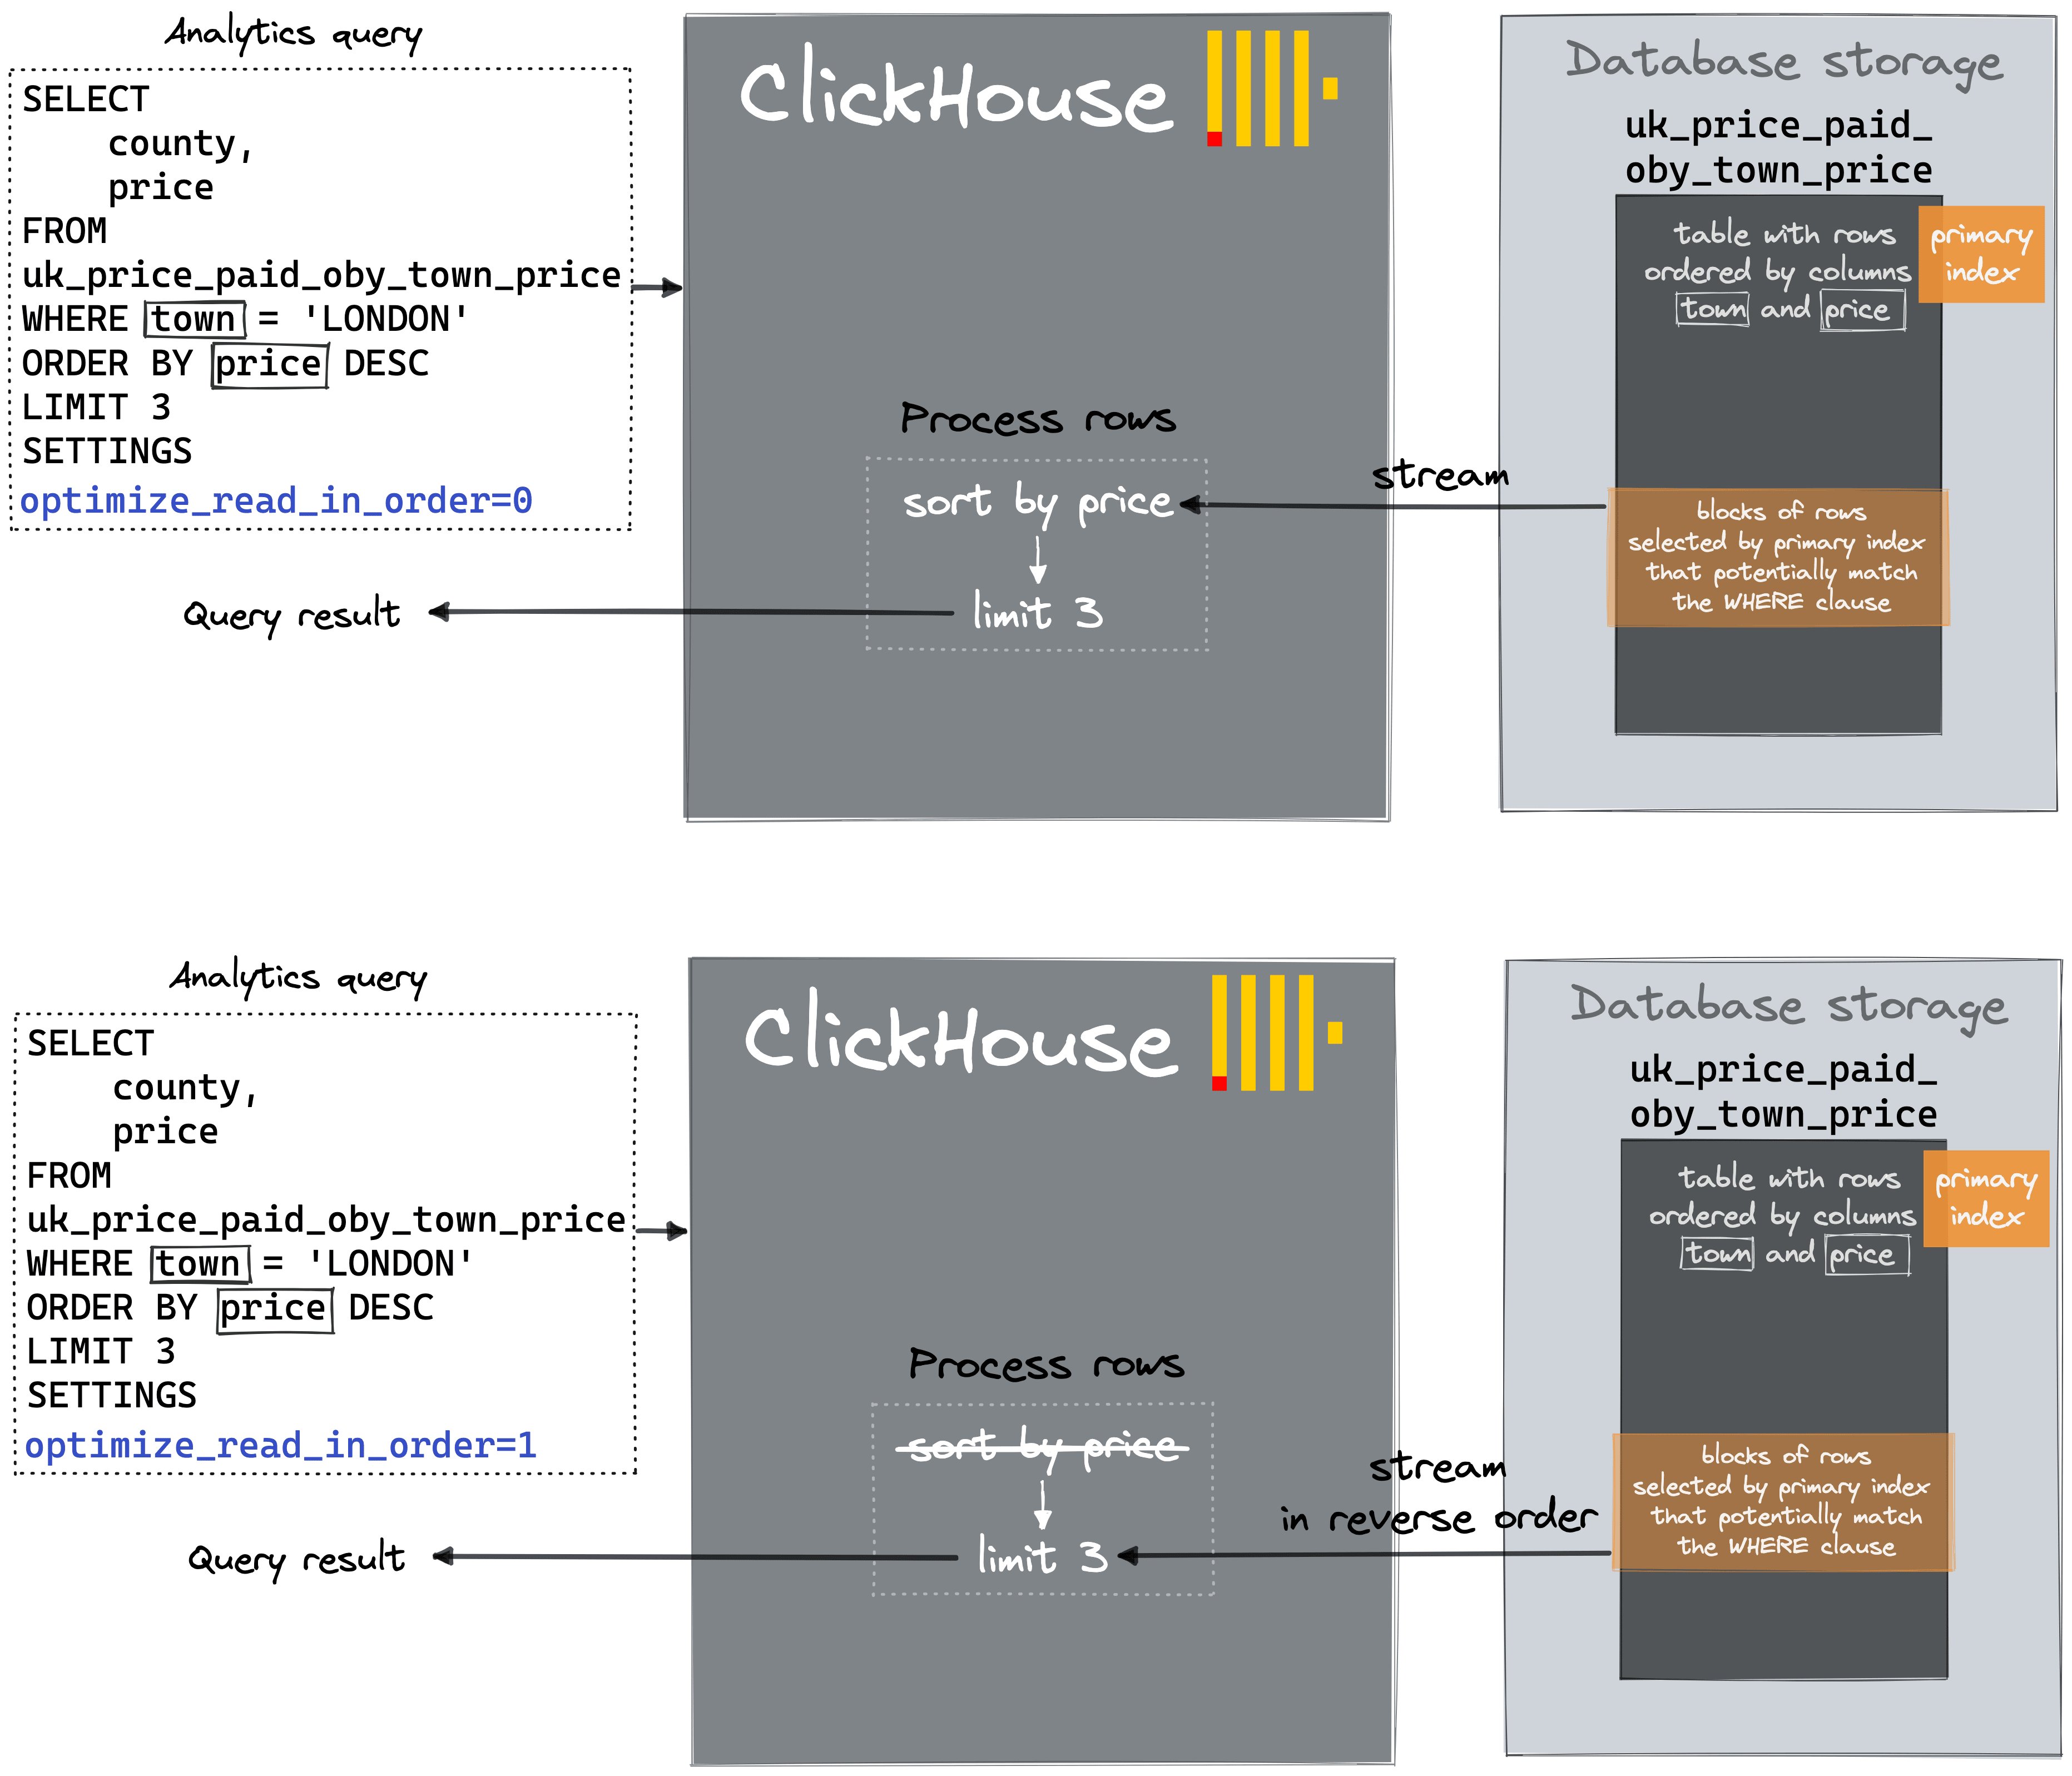
optimize_read_in_order 최적화를 적용할 수 있다고 판단하면 allow_asynchronous_read_from_io_pool_for_merge_tree 설정은 무시되거나 비활성화됩니다.
- UK Property Price Paid 테이블을 생성하고 로드하세요
- max_threads의 설정값을 확인하세요 (기본값은 쿼리를 실행하는 노드에서 ClickHouse가 인식하는 CPU 코어 수입니다
- 데이터 읽기와 처리 모두에 기본 스레드 수가 적용된 쿼리 파이프라인 확인
- 비동기 읽기 스레드 60개와 나머지 쿼리 실행 파이프라인에 대한 기본 스레드 수를 사용하는 쿼리 파이프라인을 확인합니다
- 데이터 읽기와 처리 모두에 20개의 스레드를 사용하는 쿼리 파이프라인 확인
- 비동기 읽기 스레드 60개와 나머지 쿼리 실행 파이프라인용 스레드 20개로 구성된 쿼리 파이프라인을 확인하세요
optimize_read_in_order 최적화를 적용할 수 있는 경우, 비동기 읽기 스레드 60개와 나머지 쿼리 실행 파이프라인용 스레드 20개를 사용하는 쿼리 파이프라인 확인