

- le corps des paquets
Data,Totals,Extremes,LogetProfileEventsdu protocole TCP natif (le paquetTableColumnsn’est pas un bloc Native : il transporte deux chaînes binaires, et sa disposition relève donc de la spécification du protocole natif) ; - la sortie de
SELECT ... FORMAT Nativevia HTTP ; - les fichiers exportés avec
INTO OUTFILE ... FORMAT Native; - les charges utiles de réplication interserveur.
Vue d’ensemble
Tout ce qui transporte des lignes dans le format binaire est un bloc, c’est-à-dire un fragment autodescriptif de lignes stockées colonne par colonne. Toutes les valeurs de la colonne 1 viennent en premier, puis toutes celles de la colonne 2, et ainsi de suite. Un bloc ne contient que les colonnes référencées par la requête, jamais la table entière. Lesdata d’une colonne sont organisées selon la famille à laquelle appartient son type. Voici ces familles, par ordre croissant de complexité pour le décodeur :
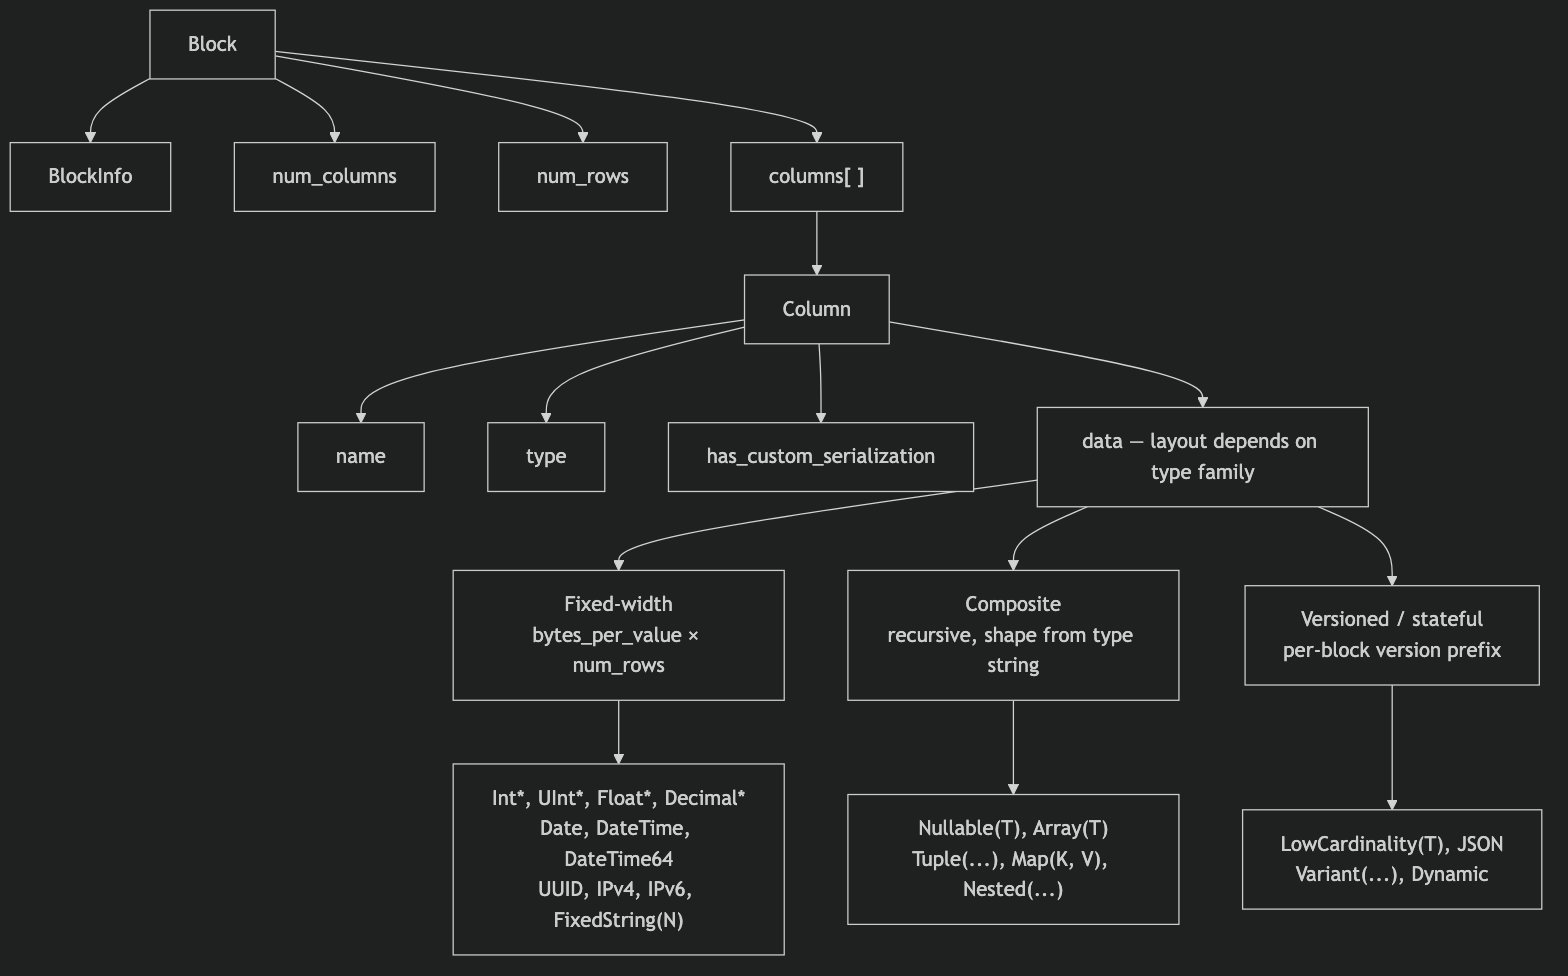
- Les types à largeur fixe organisent
datasous forme debytes_per_value × num_rowsoctets bruts, sans tramage par ligne. - Les types composés (
Nullable,Array,Tuple,Map,Nested) ont une forme récursive entièrement déductible de la chaîne de type, sans préfixe de version ni état partagé entre blocs. - Les types versionnés / avec état (
LowCardinality,JSON,Variant,Dynamic) commencent chaque bloc non vide par un préfixe de version de sérialisation / d’état. Dans le format binaireNative, ce préfixe et l’éventuel dictionnaire sont propres à chaque bloc : le format ne transporte aucun état d’un bloc à l’autre (le rédacteur crée un nouvel état de sérialisation pour chaque bloc et définitlow_cardinality_max_dictionary_size = 0). L’état partagé entre blocs relève du stockage sur disque de MergeTree, et non de la disposition binaire du format Native.
Primitives wire
Le format Native repose sur quatre encodages primitifs.VarUInt
Un entier non signé de longueur variable utilisant l’encodage LEB-128. Chaque octet contient 7 bits de données aux positions 0–6 et 1 bit de continuation à la position 7. Le bit de continuation vaut1 lorsque d’autres octets suivent, et 0 sur le dernier octet.
Encodage de la valeur
300 :
0xAC 0x02 :
Entiers à largeur fixe
Par exemple, la valeur UInt32
1 est encodée en 01 00 00 00, et la valeur Int32 -1 en FF FF FF FF.
String
Une séquence d’octets préfixée par sa longueur :0x00, et les chaînes de caractères peuvent contenir n’importe quelle valeur d’octet, y compris des octets NUL intégrés. La string "ab" est encodée sous la forme 02 61 62 ; pour la décoder, lisez la longueur VarUInt (2), puis lisez le nombre d’octets correspondant.
Bool
Un seul octet.0x00 représente false ; toute valeur non nulle représente true (0x01 sous sa forme canonique).
Structure des blocs et des colonnes
Disposition wire d’un bloc
BlockInfo dépend du canal, car le rédacteur est paramétré par une révision (voir Révision du protocole et format Native pour une explication complète, y compris le fait que client_protocol_version ne s’applique qu’en sortie) :
-
Avec le protocole TCP natif, le serveur écrit les blocs selon la révision négociée pour la connexion (une valeur élevée —
DBMS_TCP_PROTOCOL_VERSION, voirsrc/Core/ProtocolDefines.h).BlockInfoest écrit dès que cette révision est supérieure à zéro, ce qui est toujours le cas pour une connexion réelle. L’octethas_custom_serializationde chaque colonne (voir disposition wire des colonnes) est écrit à partir de la révision54454. -
Le format de sortie
Native—SELECT ... FORMAT Nativevia HTTP,INTO OUTFILE ... FORMAT Nativeet le formatNativeproduit parclickhouse-client— sérialise les données à la révision0par défaut. À la révision0, le préfixeBlockInfoet l’octethas_custom_serializationsont tous deux omis : un bloc se compose alors simplement denum_columns, denum_rowset des colonnes. Via HTTP, cette révision n’est pas figée : un client peut l’augmenter à l’aide du paramètre de requête?client_protocol_version=<n>, et le serveur utilise alors cette valeur comme révision de sérialisation pour la réponse. Avec une valeur suffisamment élevée, la sortie HTTP inclut le préfixeBlockInfo(écrit dès que la révision est supérieure à0) et l’octethas_custom_serialization(écrit à partir de la révision54454), exactement comme sur le chemin TCP. Les clients ne doivent donc pas partir du principe que toute charge utile HTTPFORMAT Nativecorrespond à la révision0.
BlockInfo décrivent la charge utile d’un paquet Data TCP. La même requête exécutée via FORMAT Native produit la forme plus courte présentée en regard.
BlockInfo
BlockInfo est une séquence de champs, chacun précédé d’un ID de champ VarUInt, et terminée par un ID de champ0. Le format wire n’est pas auto-descriptif : un ID de champ n’encode ni la longueur ni le type de sa valeur, de sorte qu’un lecteur doit déjà connaître le type de chaque ID de champ qu’il est susceptible de rencontrer. Le lecteur de ClickHouse lui-même traite un ID de champ non reconnu comme un signe de corruption et lève une exception (UNKNOWN_BLOCK_INFO_FIELD). C’est donc la révision du protocole qui assure la compatibilité ascendante : l’émetteur n’écrit un champ que si la révision négociée est au moins égale à la révision minimale de ce champ, si bien qu’un récepteur plus ancien ne voit jamais un champ qu’il ne connaît pas.
Les champs
1 et 2 ont une révision minimale de 0 ; ils sont donc présents dès lors qu’un BlockInfo est écrit. Le champ 3 n’est écrit qu’à partir de la révision 54480. Disposition wire dans le cas courant (révision inférieure à 54480) :
Disposition wire d’une colonne
Une colonne apparaîtnum_columns fois dans un bloc.
Un décodeur effectue son routage en fonction de la chaîne
type. Les chaînes de type comportent souvent des paramètres entre parenthèses ; le décodeur retire le suffixe (...) pour identifier le type de base, puis analyse les paramètres pour déterminer la taille, l’échelle ou le type interne. L’analyse d’une liste de paramètres contenant des types imbriqués (par exemple un Tuple dans un Array) exige un découpage par virgules qui tienne compte de la profondeur d’imbrication des parenthèses, plutôt qu’un découpage naïf sur ,.
Encodage binaire du typeLe champ
type n’est une String textuelle qu’en mode par défaut. Lorsque le paramètre de requête output_format_native_encode_types_in_binary_format = 1 est défini, ce champ devient un encodage binaire du type — le même encodage à base de balises que celui décrit dans encodage binaire des types de données — et les listes aplaties de types Dynamic utilisent ce même encodage binaire pour le nom de chaque type. Un décodeur qui lirait systématiquement le champ 2 comme une chaîne préfixée par sa longueur interpréterait la première balise de type binaire comme une longueur de chaîne et se désynchroniserait ; il doit donc savoir quel mode le flux utilise.Pour une requête avec query_kind = SECONDARY_QUERY (envoyée par un autre serveur pour remote, Distributed ou les réplicas parallèles, ou par clickhouse-client --query_kind secondary_query), les deux pairs ignorent output_format_native_encode_types_in_binary_format et input_format_native_decode_types_in_binary_format pour les blocs de cette requête : ceux-ci transportent des noms de types textuels dans les deux sens. Les serveurs antérieurs à cette règle appliquent ces paramètres à une requête secondaire comme à n’importe quelle autre requête.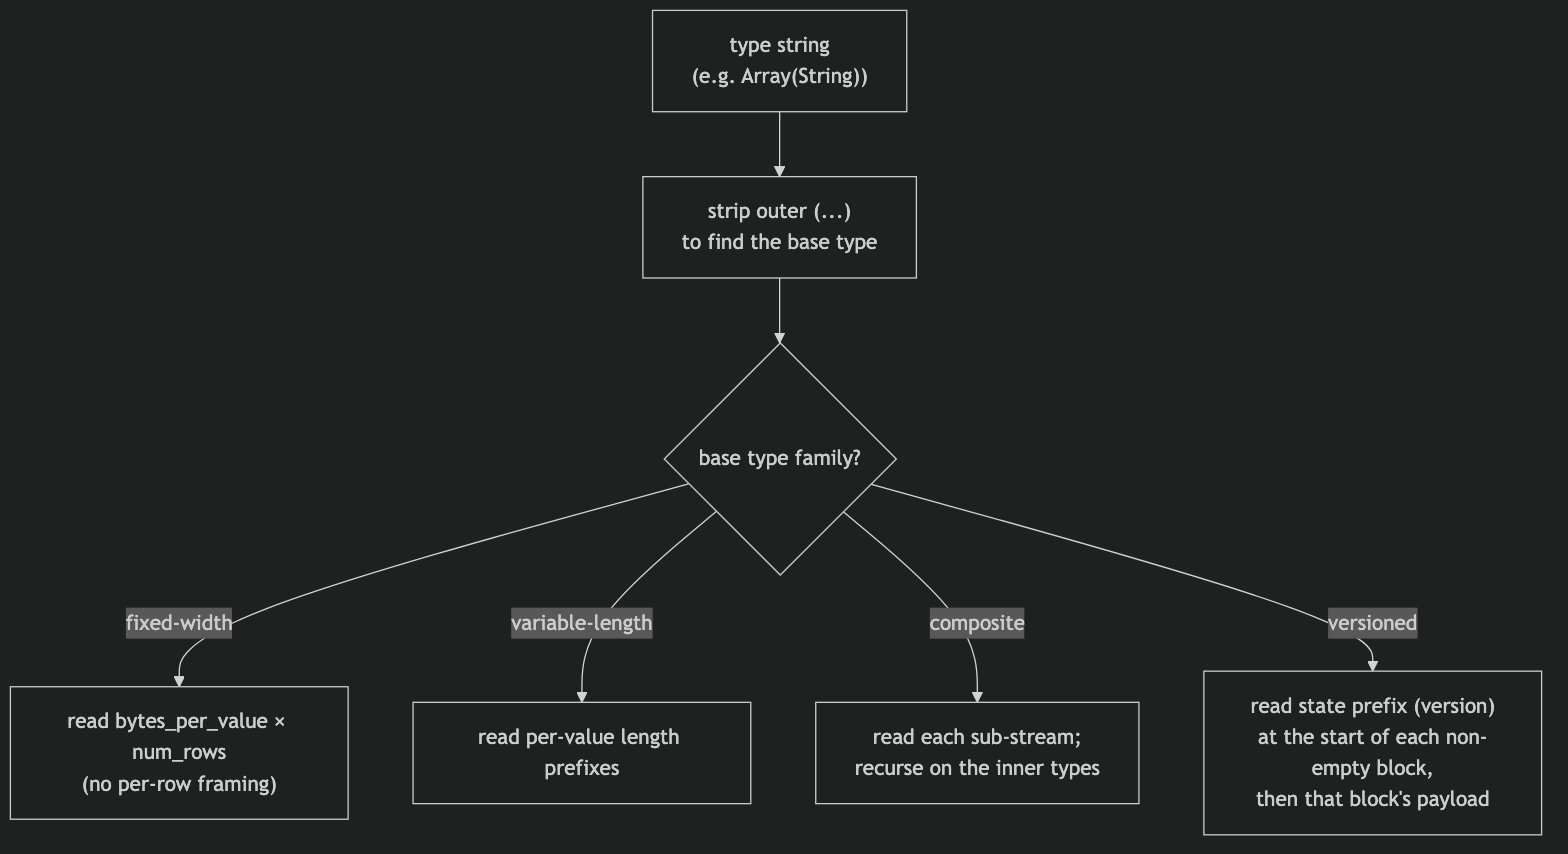
kind_stack et encodage sparse
L’octetkind_stack énumère une sérialisation par colonne autre que celle par défaut :
La charge utile de
COMBINATION utilise un enum différent. Les cinq lignes ci-dessus sont des codes compacts sur un octet. COMBINATION (0x05) sert d’échappement général pour toute pile qu’ils ne couvrent pas : il est suivi d’un VarUInt count, puis de count entrées d’un octet. Ces entrées ne sont pas les codes compacts du tableau — ce sont les valeurs brutes de ISerialization::Kind :
Les valeurs d’octet diffèrent de celles des codes compacts :
REPLICATED vaut 0x03 dans cet enum imbriqué, mais 0x04 en tant que code compact, et il n’existe pas d’entrée DETACHED_OVER_SPARSE — cette combinaison est représentée par les deux entrées consécutives SPARSE, DETACHED. Un décodeur qui continue d’utiliser la table compacte pour les octets imbriqués interprétera mal 0x03/0x04 et se désynchronisera.
Le count correspond à la longueur totale de la pile, y compris l’entrée DEFAULT initiale par laquelle commence toute pile. Les codes compacts couvrent déjà toutes les piles à une ou deux entrées ; un COMBINATION a donc toujours un count d’au moins trois.
Validité de la pile de kinds. Un décodeur rejette une pile mal formée avec INCORRECT_DATA au lieu de construire la sérialisation qu’elle décrit. Une pile valide respecte les conditions suivantes :
- la pile commence par
DEFAULT; - la pile est une sous-séquence de
DEFAULT,SPARSE,REPLICATED,DETACHED— l’ordre dans lequel les kinds s’encapsulent les uns les autres.SPARSEpeut se trouver à l’intérieur deREPLICATED, mais pas l’inverse, etDETACHEDvient toujours en dernier, car unColumnBLOBcontient la forme sérialisée de tout ce qui se trouve en dessous. Il s’ensuit également qu’aucun kind n’apparaît deux fois, ce qui bornecountpar le nombre de kinds.
ColumnSparse dont la colonne de valeurs est elle-même sparse ou répliquée reste encapsulée.
kind_stack récursif pour les colonnes Tuple. La charge utile kind_stack décrite ci-dessus est l’octet (ou la séquence COMBINATION) correspondant aux informations de sérialisation propres à une colonne. Un Tuple porte un SerializationInfoTuple, qui écrit d’abord la charge utile de pile de kinds propre au tuple, puis une charge utile de pile de kinds complète pour chaque élément, dans l’ordre ; un décodeur relit la même structure récursive. Ainsi, pour Tuple(A, B, C), les octets du champ 4 sont [tuple_kind][A_kind][B_kind][C_kind], et la charge utile de chaque élément est elle-même récursive si cet élément est à son tour composé. L’octet has_custom_serialization (champ 3) est activé dès que les informations propres au tuple ou celles de l’un de ses éléments diffèrent de la valeur par défaut ; un Tuple dont le seul élément particulier est sparse ou répliqué déclenche donc malgré tout la charge utile de pile de kinds. Un décodeur qui ne lit que l’octet d’enum initial pour un Tuple s’arrêtera trop tôt et interprétera à tort les octets de kind d’élément restants comme des données de colonne.
Format wire sparse. Lorsque kind_stack = 0x01, les data de la colonne se composent de deux flux écrits l’un à la suite de l’autre dans l’unique flux TCP partagé :
- Flux d’offsets — une séquence de
VarUInt. Chaque valeurvest :- soit
vavec le bit de poids fort en position 62 à zéro :(v & 0x3FFFFFFFFFFFFFFF)= le nombre de positions par défaut avant la prochaine valeur explicite non par défaut. Cette position non par défaut vautcursor + group_size, oùcursorest la position courante ;cursoravance ensuite degroup_size + 1. - soit
vavec le bit 62 à un (END_OF_GRANULE_FLAG) : la valeur, une fois l’indicateur effacé, correspond au nombre de positions par défaut finales après la dernière valeur non par défaut. Elle marque la fin du flux d’offsets pour le bloc.
- soit
- Flux de valeurs —
countvaleurs non par défaut encodées de manière dense dans le type interne, oùcountest le nombre de VarUInt non EOG lus ci-dessus.
num_rows entrées en remplissant chaque position non explicite avec la valeur par défaut du type interne (0 pour les entiers et les flottants, "" pour String, 0 jour pour Date, etc.).
Une colonne Nullable(T) sparse constitue un cas particulier, car la valeur par défaut de Nullable(T) est NULL. L’encodage sparse supprime entièrement le flux de null map habituel de Nullable : le flux d’offsets identifie les positions non par défaut — c’est-à-dire non NULL —, le flux de valeurs ne contient que ces valeurs non NULL, encodées de manière dense dans T, et chaque position non explicite est reconstruite comme NULL. Un décodeur ne doit donc pas chercher de null map dans le flux de valeurs, ni combler les trous avec un 0 effectif ; il les remplit avec NULL.
Format wire Replicated. Lorsque kind_stack = 0x04, les data de la colonne forment un dictionnaire : une liste de valeurs d’éléments distinctes, accompagnée d’un index par ligne pointant vers cette liste (la même structure de recherche que LowCardinality). Lorsque le type interne est lui-même versionné — par exemple LowCardinality(T) —, son préfixe d’état est écrit en premier, avant le flux d’index : la sérialisation répliquée délègue la phase de préfixe au type interne avant d’écrire num_rows. Les types internes dont le préfixe est vide (les types feuilles et les types composés simples) n’ajoutent ici aucun octet.
elements[indexes[i]] pour chaque ligne de sortie i. Les types internes composés sont traités de manière récursive : la liste d’éléments est matérialisée dans le type interne, puis indexée. Les types internes pris en charge comprennent les types terminaux, Nullable(T), Array(T), Tuple(...), Map(K, V), Nested(...) (chaque champ étant développé comme un Array) et LowCardinality(T) (le dictionnaire partagé est conservé ; seules les clés propres à chaque élément sont indexées).
Format wire détaché. DETACHED (0x02) et DETACHED_OVER_SPARSE (0x03) apparaissent bel et bien en transit : ils ne sont pas purement internes. Sur le path TCP, lorsque la compression est activée et que la révision négociée est au moins égale à DBMS_MIN_REVISON_WITH_PARALLEL_BLOCK_MARSHALLING (v54478), la colonne passe par trois étapes :
- Chaque colonne éligible (non
const, nonTuple, dans un bloc de plus d’une ligne) est encapsulée dans unColumnBLOBqui contient la colonne déjà sérialisée et compressée en dehors du thread principal. DETACHEDest ajouté à la pile de types de sérialisation de la colonne encapsulée.- Le champ
datade la colonne est écrit sous la forme d’une taille de blobVarUInt, suivie d’exactement autant d’octets de blob.
{DEFAULT, SPARSE, DETACHED}, ce qui est sérialisé en DETACHED_OVER_SPARSE. Un client qui décode une telle colonne lit la longueur et les octets du blob, puis décompresse ce dernier pour récupérer la charge utile de la colonne interne (voir la note sur ColumnBLOB dans la section consacrée à la compression).
DETACHED est directionnel : il ne peut apparaître que dans les blocs de résultat envoyés par un serveur, et uniquement pour une colonne de premier niveau entière — jamais comme l’un des kinds d’éléments d’un Tuple. Contrairement aux autres kinds, il transforme la colonne d’exécution en ColumnBLOB au lieu d’une colonne du type déclaré ; un récepteur ne l’accepte donc que si son propre pipeline reconvertit le blob. C’est pourquoi un serveur rejette DETACHED avec INCORRECT_DATA dans tout bloc envoyé par un client, qu’il s’agisse de données de table externe, de scalaires ou de données d’insertion.
Variantes de bloc
Tous les paquets de la famille Data partagent le même format wire de bloc. Les variantes ne diffèrent que par leur nombre de colonnes et de lignes :Exemples au niveau des octets
Tous les exemples de cette section sont tirés du path du paquet Data TCP : ils incluent donc le préfixeBlockInfo et l’octet has_custom_serialization. Avec FORMAT Native, ces mêmes blocs sont plus courts ; la forme courte équivalente est indiquée lorsque c’est utile.
Un bloc vide (avec BlockInfo), soit 8 octets au total :
SELECT 1 annonce une colonne nommée "1" de type UInt8, sans aucune ligne. Avec le protocole ≥ 54454, l’octet has_custom_serialization est inclus :
FORMAT Native (révision 0), le même bloc de résultat ne comporte ni BlockInfo ni octet has_custom_serialization — SELECT 1 FORMAT Native occupe 11 octets :
FORMAT Native : ce format de sortie n’émet jamais de blocs vides.)
Révision du protocole et format Native
Un flux d’octets Native est avant tout façonné par la révision du protocole utilisée par son rédacteur et son lecteur. La révision n’apparaît nulle part dans les octets eux-mêmes — il n’existe aucun champ de révision dans le format binaire —, mais c’est pourtant elle qui détermine si certaines fonctionnalités apparaissent ou non. Un décodeur doit donc connaître la révision avec laquelle une charge utile a été écrite avant de pouvoir l’analyser. Puisque la révision ne figure pas dans le flux, le lecteur et le rédacteur doivent s’accorder sur celle-ci par un autre moyen. Il s’agit d’un simpleUInt64, que NativeWriter et NativeReader reçoivent tous deux comme argument de constructeur. Le rédacteur le nomme client_revision et le lecteur server_revision, mais il s’agit bien du même nombre. La révision la plus récente connue de cette version est DBMS_TCP_PROTOCOL_VERSION (voir src/Core/ProtocolDefines.h).
Ce que la révision conditionne
Chaque fonctionnalité est soumise à un seuilDBMS_MIN_REVISION_WITH_*. Le rédacteur n’émet la fonctionnalité qu’une fois que sa révision atteint ce seuil, et le lecteur la recherche selon exactement la même règle, de sorte que les deux restent synchronisés : si la révision est erronée d’un côté ou de l’autre, ils se désynchronisent. Les conditions pertinentes pour le format Native sont les suivantes :
La révision
0 constitue donc l’encodage le plus conservateur pour presque tout : le flux ne contient ni BlockInfo ni octet has_custom_serialization, utilise Dynamic/JSON en V1, n’inclut aucune version de fonction d’agrégation et emploie un DateTime nu, sans paramètre de fuseau horaire. Les versions d’état des fonctions d’agrégation font exception à la révision 0 : il n’existe aucun pair à partir duquel déduire une version — le flux est écrit puis relu par celui qui l’a produit (un fichier de données StripeLog, une sauvegarde Set/Join, un fichier au format Native). Le rédacteur conserve donc la version épinglée sur le type (en l’indiquant explicitement dans la chaîne de type, comme d’habitude) au lieu de rétrograder l’état à la version 0, et seul un type qui n’épingle aucune version est écrit en version 0.
LowCardinality constitue la seule exception, et elle est de taille. La vérification effectuée par le rédacteur est remove_low_cardinality || (client_revision && client_revision < DBMS_MIN_REVISION_WITH_LOW_CARDINALITY_TYPE). Tout repose sur le client_revision && initial : lorsque la révision vaut exactement 0, l’évaluation de la condition est court-circuitée et renvoie false.
Ainsi, à la révision 0 — la valeur par défaut pour FORMAT Native — LowCardinality(T) n’est pas supprimé. Sa chaîne de type et son préfixe d’état par bloc restent dans le flux, et le lecteur de révision 0 les relit tels quels. La suppression n’intervient qu’à une révision non nulle inférieure à 54405, ou lorsqu’elle est forcée quelle que soit la révision.
Ce forçage passe par le flag remove_low_cardinality. La sortie FORMAT Native ne l’active jamais, contrairement au chemin TCP natif, qui l’active lorsque low_cardinality_allow_in_native_format = 0 (valeur par défaut : 1). Autrement dit, ce paramètre modifie la sortie TCP native, mais n’a aucun effet sur FORMAT Native.
En pratique : un flux FORMAT Native par défaut peut légitimement contenir LowCardinality ; ne le considérez donc pas comme une fonctionnalité absente à la révision 0.
Origine de la révision selon le mode de transport des données
Les mêmes octets au format Native peuvent transiter par différentes voies : le protocole TCP natif, une requête HTTP ou un fichier sur disque. Chaque voie détermine la révision à sa manière. Point de vigilance : la lecture et l’écriture sont configurées séparément, si bien qu’elles peuvent se retrouver à des révisions différentes.Protocole TCP natif — négocié, dans les deux sens
Avec le protocole TCP natif, la révision est déterminée lors du handshake Hello. Le client envoieDBMS_TCP_PROTOCOL_VERSION, le serveur lui renvoie la sienne, et à partir de là chaque côté sérialise selon la révision annoncée par l’autre : le serveur construit son NativeReader/NativeWriter à partir de client_tcp_protocol_version, tandis que le client utilise le server_revision qu’il a reçu. Il n’existe pas de min explicite, mais aucun des deux côtés ne peut émettre une fonctionnalité qu’il n’implémente pas ; chaque sens est donc, dans les faits, plafonné par le plus ancien des deux pairs.
Lorsque les deux pairs exécutent le même build récent, les deux sens aboutissent à la même révision (DBMS_TCP_PROTOCOL_VERSION, voir src/Core/ProtocolDefines.h) et toutes les conditions d’activation sont remplies. C’est le cas le plus courant, mais rien ne le garantit. Avec des pairs tiers ou de versions différentes, les deux sens peuvent se trouver à des révisions distinctes ; les conditions d’activation doivent donc être évaluées sens par sens : BlockInfo est présent pour toute révision non nulle, mais le reste — y compris has_custom_serialization — n’apparaît que lorsque la révision effective de ce sens atteint le seuil correspondant. Par exemple, un pair qui annonce une révision inférieure à 54454 n’envoie ni ne reçoit l’octet has_custom_serialization.
Sortie FORMAT Native — révision 0 par défaut, augmentable via HTTP
Le format de sortie Native utilise par défaut la révision 0. Cela concerne SELECT ... FORMAT Native via HTTP, INTO OUTFILE ... FORMAT Native et la sortie Native écrite par clickhouse-client ; dans chaque cas, la fabrique de sortie transmet directement FormatSettings::client_protocol_version au NativeWriter, qui détermine le tramage BlockInfo / has_custom_serialization ainsi que la disposition String à offsets. Ainsi, une requête HTTP SELECT ... FORMAT Native avec un client_protocol_version augmenté (≥ 54492) écrit la disposition à offsets, tandis que la révision par défaut 0 conserve la disposition portable par valeur.
Via HTTP, cette valeur par défaut n’est toutefois pas figée. Un client peut l’augmenter avec le paramètre de requête ?client_protocol_version=<n>, que le gestionnaire HTTP traite comme un paramètre réservé et non comme un paramètre SQL : il est appliqué au contexte de la requête, et la couche de format le copie dans FormatSettings. Avec une valeur suffisamment élevée, la sortie HTTP FORMAT Native inclut alors le préfixe BlockInfo et l’octet has_custom_serialization, exactement comme le chemin TCP — ne partez donc pas du principe qu’une charge utile HTTP FORMAT Native est toujours en révision 0.
Comme le paramètre s’applique à l’ensemble du contexte de la requête, il atteint chaque NativeWriter créé pour cette requête, et pas seulement le flux de résultats. En particulier, une écriture côté serveur telle que INSERT INTO FUNCTION file('x.native', 'Native', ...) SELECT ... via HTTP avec un ?client_protocol_version= augmenté écrit le fichier dans cette révision. Ce comportement existe de longue date (il est antérieur à la sérialisation String à offsets et s’applique également à BlockInfo et has_custom_serialization), et il est asymétrique : la révision côté lecture (voir ci-dessous) n’est pas augmentée de la même manière, si bien qu’un tel fichier ne peut pas être relu via file(...). N’indiquez pas client_protocol_version dans une requête qui écrit des données destinées à être relues. INTO OUTFILE et la sortie locale de clickhouse-client ne disposent d’aucun réglage de ce type et restent à 0.
Entrée FORMAT Native — toujours en révision 0
Le format d’entrée Native construit toujours son NativeReader en révision 0. Il n’attend jamais de préfixe BlockInfo, ne lit jamais l’octet has_custom_serialization et suppose toujours la sérialisation par défaut, qu’il analyse le corps d’un INSERT ... FORMAT Native, lise un fichier Native ou infère un schéma. ?client_protocol_version=<n> n’augmente pas la révision d’entrée (seul le côté sortie lit ce paramètre).
La révision d’entrée étant toujours 0, le format d’entrée lit systématiquement la disposition String par valeur ; un flux écrit avec la disposition à offsets (via le protocole TCP natif, ou par un SELECT ... FORMAT Native avec un client_protocol_version augmenté) ne peut pas être relu par l’entrée FORMAT Native. Il s’agit de la même asymétrie que pour le tramage BlockInfo.
Conséquences pour l’aller-retour
PourFORMAT Native, la valeur par défaut est la révision 0 aux deux extrémités. Les données écrites par SELECT ... FORMAT Native en révision 0 se relisent directement dans INSERT ... FORMAT Native, sans surprise.
Un flux produit avec une révision de sortie relevée (?client_protocol_version=<n> sur le SELECT) contient le tramage BlockInfo et has_custom_serialization ainsi que la disposition String à offsets, qu’aucun format d’entrée — toujours en révision 0 — ne sait relire. Relever client_protocol_version n’a donc de sens que pour un consommateur qui parle le protocole TCP natif, et non pour un aller-retour FORMAT Native via HTTP.
Les fichiers constituent le cas asymétrique. Un ?client_protocol_version= relevé sur un INSERT INTO FUNCTION file(...) côté serveur (ou s3, url) écrit le fichier dans cette révision, mais une lecture via file(...) analyse toujours en révision 0 : un tel fichier ne supporte donc pas l’aller-retour. Omettez client_protocol_version dans la requête d’écriture afin que le fichier reste en simple révision 0, ou transférez les données via le protocole TCP natif, où chaque sens utilise la révision négociée lors du handshake.
Révision de protocole ou version de sérialisationNe confondez pas la révision de protocole avec la version de sérialisation. La révision évoquée ici s’applique à l’ensemble de la connexion ou de la requête et n’apparaît jamais dans les octets. La version de sérialisation est propre à chaque colonne, portée par les types versionnés, et écrite dans chaque bloc non vide. La révision détermine si une fonctionnalité est présente ou non ; la version de sérialisation, une fois à l’intérieur d’une colonne versionnée, indique quelle variante de l’encodage de ce type suit.
Types de données
Cette section décrit l’encodage binaire des types que le format Native peut transporter dans le champdata d’une colonne, regroupés en quatre familles dont la complexité de décodage va croissant. Deux types — AggregateFunction(func, ...) et QBit(T, N[, stride]) — sont des types de colonne Native valides, mais leurs charges utiles sont spécifiques à la fonction ou au type et sortent du cadre de ce document ; ils sont signalés ci-dessous aux endroits où ils pourraient être confondus avec des alias.
Types à largeur fixe
Chaque valeur occupe un nombre constant d’octets. Une colonne deM lignes occupe exactement bytes_per_row × M octets dans le format binaire, concaténés sans séparateur ni remplissage.
Types integers
UInt8–UInt256 et Int8–Int256 sont des encodages binaires directs de valeurs integers. Un décodeur lit bytes_per_row × num_rows octets et les interprète selon le type.
Une colonne UInt32 contenant [1, 256, 65536] :
Int32 contenant [-1, 42] :
Float32 et Float64
Nombres à virgule flottante binaires standard IEEE 754 : 4 octets en simple précision (binary32) et 8 octets en double précision (binary64), tous deux en little-endian. Les valeurs NaN, ±Infinity, ±0.0 et les nombres sous-normaux sont tous préservés à l’aller-retour (round-trip), sans normalisation.
Valeur Float32 1.5 (0x3FC00000) :
Float64 1.5 (0x3FF8000000000000) :
BFloat16
Le format à virgule flottante « brain floating point » : les 16 bits de poids fort d’unFloat32 IEEE 754 — 1 bit de signe, 8 bits d’exposant, 7 bits de mantisse. Chaque valeur occupe 2 octets en little-endian et contient le motif brut de 16 bits. Pour retrouver la valeur numérique, réélargissez-la en Float32 en plaçant le motif dans la moitié haute et en mettant à zéro la moitié basse (bits << 16 réinterprété en Float32) ; la valeur ainsi élargie adopte alors la même mise en forme textuelle que Float32.
Valeur BFloat16 1.5 (motif 0x3FC0, soit la moitié haute du Float32 0x3FC00000) :
Bool
Compatible au niveau wire avecUInt8 : 1 octet par ligne, 0x00 = false, 0x01 = true. Dans le format binaire, la chaîne de type est littéralement Bool (et non UInt8) ; un décodeur qui s’appuie sur la chaîne de type pour aiguiller le décodage doit donc la reconnaître spécifiquement.
Une colonne Bool [true, false, true] :
Date et Date32
Les deux types encodent les dates sous forme d’un nombre integer de jours écoulés depuis l’epoch Unix1970-01-01. Aucun des deux ne comporte de composant horaire.
Valeur
Date 1970-01-02 (1 jour) :
Date32 1900-01-01 (-25567 jours) :
DateTime
Compatible au niveau wire avecUInt32 : un timestamp Unix en secondes, codé sur 4 octets en little-endian. Le type peut apparaître sous la forme DateTime ou DateTime('Timezone') ; le fuseau horaire n’influe que sur l’affichage et ne fait pas partie de la valeur wire. Deux colonnes DateTime dotées de paramètres de fuseau horaire différents produisent des octets identiques pour un même instant. Un décodeur supprime le suffixe de paramètre (...) et traite la colonne comme un UInt32.
Valeur DateTime('UTC') 2024-03-15 14:30:00 UTC (timestamp 1710513000) :
DateTime64(scale[, timezone])
8 octets : un Int64 en little-endian représentant un nombre de ticks d’une durée de10^-scale secondes écoulés depuis l’epoch Unix. Le paramètre scale (0–9) figure dans la chaîne de type et définit l’unité de temps :
Le type apparaît sous la forme
DateTime64(s) (fuseau horaire implicite, celui par défaut du serveur) ou DateTime64(s, 'TimezoneName') (fuseau horaire explicite, utilisé uniquement pour l’affichage). Les valeurs négatives représentent des ticks antérieurs à l’epoch.
Valeur DateTime64(3, 'UTC') 2024-01-15 12:30:45.123 UTC (1705321845123 ms) :
DateTime64(0) 2024-01-15 12:30:45 UTC (1705321845 s) :
Time et Time64(scale)
Une durée d’horloge plutôt qu’un instant précis.Time est un nombre signé de secondes, codé sur 4 octets en Int32 little-endian ; Time64(scale) est un nombre signé de ticks à la scale décimale indiquée (0–9), codé sur 8 octets en Int64 little-endian — soit la même forme sur le wire que DateTime64.
La forme textuelle est [-]HH:MM:SS[.fraction], mais contrairement à DateTime, le champ des heures n’est pas ramené à une journée de 24 heures : il représente le nombre total d’heures et peut dépasser 23. La valeur absolue affichée est plafonnée à 999:59:59 (3599999 secondes) ; au-delà, les secondes s’affichent au plafond tandis que la fraction stockée est conservée telle quelle : ainsi, un nombre de ticks de 3700000.25 s’affiche sous la forme 999:59:59.250000. CAST sature la valeur stockée au plus grand tick représentable à la scale cible (999:59:59.999999 pour Time64(6)), et non à la seconde entière, alors que des opérations arithmétiques peuvent toujours laisser dans la colonne un nombre de ticks hors plage, qui n’est plafonné qu’à l’affichage. Rien de tout cela n’affecte les octets sur le wire, qui correspondent simplement à l’integer signé.
Valeur Time 45296 (12:34:56) :
Time64(3) de 45296789 ticks (12:34:56.789) :
Les types
Time et Time64 sont expérimentaux et nécessitent d’activer allow_experimental_time_time64_type = 1 sur le serveur.Interval
Interval<Unit> — IntervalSecond, IntervalMinute, IntervalHour, IntervalDay, IntervalWeek, IntervalMonth, IntervalQuarter, IntervalYear, IntervalNanosecond, etc. Toutes les unités partagent le même encodage binaire : le nombre d’unités, sous forme d’Int64 signé sur 8 octets en little-endian. L’unité figure uniquement dans la chaîne de type : elle ne modifie ni les octets sur le wire ni la forme textuelle, qui se réduit à l’integer brut. Un seul path de décodage gère toutes les unités.
Valeur 5 de type IntervalDay :
UUID
16 octets par valeur. L’encodage binaire ne correspond pas aux 16 octets canoniques en big-endian : les octets de chaque moitié de 8 octets sont inversés indépendamment. Le modèle logique est un identifiant de 128 bits sous forme textuelle canoniquexxxxxxxx-xxxx-xxxx-xxxx-xxxxxxxxxxxx, dont les octets sont par convention écrits en big-endian. Le modèle wire prend ces 16 octets canoniques, les découpe en deux moitiés de 8 octets et écrit chaque moitié en little-endian :
- Octets sur le wire 0..7 = octets canoniques 0..7 inversés.
- Octets sur le wire 8..15 = octets canoniques 8..15 inversés.
550e8400-e29b-41d4-a716-446655440000 :
IPv4 et IPv6
Deux types d’adresses apparentés, mais encodés différemment.IPv4 occupe 4 octets, encodés sous la forme d’un UInt32 little-endian contenant l’adresse canonique sur 32 bits (la valeur (a << 24) | (b << 16) | (c << 8) | d calculée à partir de a.b.c.d). Les octets sur le wire sont donc les octets dans l’ordre réseau, mais inversés.
192.168.1.10 (valeur canonique sur 32 bits 0xC0A8010A) :
IPv6 occupe 16 octets, écrits tels quels dans l’ordre des octets réseau, sans permutation — soit le même ordre des octets que inet_pton(AF_INET6, ...).
2001:db8::1 :
u32 pour permettre les opérations arithmétiques et des requêtes de plage compactes, tandis qu’IPv6 conserve la disposition en ordre réseau, commune à la plupart des API réseau.
Enum8 et Enum16
Compatibles au niveau wire avecInt8 et Int16 respectivement : 1 ou 2 octets par ligne, codés en complément à deux little-endian pour la variante 16 bits. La correspondance complète des valeurs de l’énumération figure dans la chaîne de type :
(...) et effectuer le dispatch comme pour Int8 / Int16 — les octets sur le wire ne représentent que l’index integer. Un client qui expose le libellé extrait la map 'name' = value de la chaîne de type et la conserve avec la colonne : l’integer seul ne permet pas de retrouver le libellé. Une sortie textuelle affiche le libellé (active) plutôt que l’index, entre apostrophes ('active') lorsque l’enum est imbriqué dans un type composé. Comme la map ne peut pas être reconstituée à partir de la colonne d’integers, elle doit être conservée pour les enums imbriqués tels que Array(Enum8(...)) ou Map(Enum16(...), V).
Une colonne Enum8('active' = 1, 'inactive' = 2) contenant [active, inactive, active] :
Enum16(...) égale à 30000 :
Decimal(P, S)
Un integer signé mis à l’échelle par une puissance de 10. La taille en octets de l’integer est déterminée par la précisionP, tandis que la scale S correspond à l’exposant négatif (le nombre de chiffres après la virgule). Ces deux paramètres figurent dans la chaîne de type.
L’encodage binaire correspond à l’integer sous-jacent en complément à deux little-endian, et la valeur décimale logique vaut
wire_integer × 10^(-S).
ClickHouse émet toujours Decimal(P, S), quelle que soit la manière dont le type a été déclaré. Decimal32(S), Decimal64(S), etc. sont tous normalisés en Decimal(P, S) dans le format binaire (avec P fixé au maximum naturel correspondant à la taille : 9, 18, 38, 76). Un décodeur qui ne reconnaît que Decimal(P, S) prend donc en charge toutes les formes émises par le serveur.
Valeur 123.4567 de type Decimal(9, 4) → integer sous-jacent 1234567 :
-1.5 de type Decimal(18, 1) → integer sous-jacent -15 :
Decimal(38, 4) 123.4567 (16 octets au total) :
Nothing
Le typeNothing ne contient aucune valeur. En pratique, il n’apparaît que comme type interne de Nullable(Nothing), c’est-à-dire ce que le serveur renvoie pour une expression comme SELECT NULL, dont la seule valeur valide est précisément l’absence de valeur. Il s’agit conceptuellement d’un type unité.
Dans le format binaire, il occupe exactement un octet de remplissage par ligne. Le serveur émet le caractère ASCII '0' (0x30), mais le désérialiseur ignore ces octets : leur contenu est indéfini et les décodeurs ne doivent se fier à aucune valeur particulière. Le nombre d’octets écrits est num_rows × 1 ; le num_rows de l’en-tête de colonne suffit donc à déterminer la quantité de données à consommer.
Cet octet par ligne préserve l’invariant du bloc : la longueur de chaque colonne se déduit de num_rows, ce qui permet aux décodeurs de parcourir les données séquentiellement sans préfixe de longueur par cellule. Le Nullable englobant signale toujours chaque position comme NULL, si bien que les caractères de substitution ne sont jamais examinés.
Une colonne Nullable(Nothing) de 3 lignes (toutes NULL) :
Nullable standard (voir Nullable) ; les trois octets internes constituent la charge utile Nothing, que le décodeur ignore.
Types de longueur variable
Dans le format binaire, chaque valeur est accompagnée de sa propre longueur.String
Chaîne de type :String. Une colonne String possède deux dispositions wire, sélectionnées en fonction de la révision du protocole (voir Ce que la révision conditionne). La révision correspond à la révision négociée sur le protocole TCP natif et, pour la sortie FORMAT Native, à client_protocol_version (par défaut 0) ; l’entrée FORMAT Native est toujours en révision 0, et le format Buffers utilise toujours la disposition par valeur.
Disposition par valeur — en dessous de DBMS_MIN_REVISION_WITH_STRING_WITH_SIZE_STREAM_SERIALIZATION (54492), y compris la révision 0 utilisée par défaut par FORMAT Native : une séquence de num_rows séquences d’octets, chacune préfixée par sa longueur :
0x00. Le nombre total d’octets occupés par la colonne est Σ (varuint_size(len_i) + len_i) sur l’ensemble des lignes.
Une colonne de 3 chaînes de caractères ["ab", "", "c"] (6 octets au total) :
54492 : deux flux concaténés, d’abord les offsets d’octets cumulés, puis l’ensemble des données :
Array transmet ses offsets via le protocole natif. L’offset i correspond à la position de fin de la valeur i dans le blob de données ; la taille de la valeur i est donc offset[i] - offset[i-1] (avec offset[-1] = 0), et le dernier offset correspond à la taille totale du blob de données. Un décodeur lit 8 × num_rows octets d’offsets, puis lit l’intégralité du blob de données d’un seul tenant, en utilisant le dernier offset comme longueur exacte. Cela permet de préallouer exactement le tampon et d’effectuer une copie en masse plutôt qu’une analyse ligne par ligne, sans aucune conversion des tailles en offsets. Une colonne avec num_rows = 0 n’ajoute aucun octet à aucun des deux flux.
Les 3 mêmes chaînes de caractères ["ab", "", "c"] (27 octets au total) :
String du bloc, y compris aux String imbriqués dans des types composés (Array(String), Nullable(String), Map, Tuple, Variant, Dynamic, JSON), à une exception près : le dictionnaire d’une colonne LowCardinality est toujours écrit avec la sérialisation imbriquée par défaut, si bien que ses valeurs String conservent la disposition par valeur, quelle que soit la révision. Cela concerne LowCardinality(String), LowCardinality(Nullable(String)) et tout autre dictionnaire LowCardinality contenant des String.
Dans les deux dispositions, le type String de ClickHouse est orienté octets et non texte : la validité UTF-8 n’est pas vérifiée, et une valeur peut contenir n’importe quel octet, y compris des caractères NUL intégrés. Un décodeur qui cible une chaîne de type UTF-8 doit donc soit valider les données à la lecture, soit exposer les octets bruts à l’appelant.
FixedString(N)
Chaîne de type :FixedString(N), où N est un integer positif (par exemple, FixedString(16)). La colonne occupe exactement N × num_rows octets bruts, sans préfixes de longueur ni séparateurs. Un décodeur extrait N de la chaîne de type, puis lit ce nombre d’octets pour chaque ligne.
Lorsque la requête SQL insère une valeur de moins de N octets (par exemple, CAST('abc' AS FixedString(5))), le serveur la complète à droite avec des octets NUL (0x00) jusqu’à la longueur déclarée. Ces octets de remplissage font partie de la valeur stockée et sont transmis tels quels dans le format binaire ; leur suppression est du ressort du client. Comme String, FixedString(N) s’apparente davantage à un tableau d’octets qu’à du texte : il sert généralement à stocker des identifiants de taille fixe, des octets d’adresse ou des digests de hachage.
Deux valeurs FixedString(3) ["abc", "de\0"] (6 octets au total) :
Types composés
Les types composés encapsulent un ou plusieurs types internes et partagent un modèle wire commun : plusieurs flux par colonne. Une même colonne logique est encodée sous la forme de deux séquences d’octets ou plus, lues indépendamment, puis concaténées. Ils partagent trois propriétés structurelles :- Forme fixe pour un schéma donné. La structure est entièrement déterminée par la chaîne de type au moment du décodage.
Array(UInt32)présente toujours la même disposition de flux, d’un bloc à l’autre. - Aucun préfixe de version propre. L’enveloppe composée n’ajoute elle-même aucun octet de version ; son tramage (offsets, null-map, flux d’éléments) reste stable d’une version de ClickHouse à l’autre. Cela ne concerne que l’enveloppe : pour les types internes versionnés, voir la remarque sur la phase de préfixe ci-dessous.
- Aucun état inter-blocs propre. Le tramage de l’enveloppe est entièrement auto-descriptif pour chaque bloc ; toute problématique d’état inter-blocs provient d’un type interne versionné, et non de l’enveloppe.
SerializationArray exécute la phase de préfixe de son type interne avant d’écrire les offsets du tableau, et Tuple, Map, Nested et Nullable procèdent de même via les sérialisations de leurs éléments (Nullable exécute le préfixe interne avant sa null map).
Ainsi, lorsqu’un composé encapsule un type versionné/avec état (LowCardinality, Variant, Dynamic, JSON), le préfixe de version/d’état de ce type interne est émis en premier, avant les offsets et la charge utile des éléments de l’enveloppe. Par exemple, Array(LowCardinality(String)) est organisé comme suit : [LowCardinality state prefix] → [array offsets] → [flattened LowCardinality element payload], et non avec les offsets en premier.
Un décodeur qui lit les offsets avant d’exécuter la phase de préfixe interne se désynchronisera sur tout composé contenant LowCardinality, Variant, Dynamic ou JSON. Lorsque tous les types internes sont de simples types feuilles ou d’autres composés non versionnés, la phase de préfixe n’émet aucun octet et la description « offsets en premier » ci-dessous s’applique telle quelle.
Nullable(T)
Chaîne de type :Nullable(InnerType). Exemples : Nullable(UInt32), Nullable(String), Nullable(FixedString(16)), Nullable(DateTime('UTC')).
Comme les autres types composés, Nullable délègue la phase de préfixe à sa sérialisation interne avant d’écrire la null map : lorsque le type interne est versionné, son préfixe d’état est émis en premier. Ainsi, Nullable(Tuple(LowCardinality(String))) commence par le préfixe d’état de LowCardinality, et non par la null map. Lorsque le type interne est un type terminal ou un autre type non versionné, la phase de préfixe n’émet aucun octet.
La disposition wire se compose de la phase de préfixe interne (vide sauf si le type interne est versionné), suivie de deux flux concaténés, la null-map en premier :
num_rows octets, un par ligne :
Le flux de valeurs contient l’encodage standard du type interne pour toutes les
num_rows lignes, y compris aux positions nulles. Un décodeur doit tout de même lire les octets de remplissage aux positions nulles pour avancer dans le flux, mais doit consulter la null-map avant d’interpréter chaque valeur. Les émetteurs pouvant écrire n’importe quels octets aux positions nulles, les décodeurs ne doivent pas présumer d’une valeur de remplissage particulière.
Valeurs de remplissage par famille de type interne :
Nullable(T) peut apparaître à l’intérieur de Array, Tuple, Map et Nested — Array(Nullable(T)) et Tuple(Nullable(T1), T2) sont courants. La nullabilité ne peut pas être imbriquée : Nullable(Nullable(T)) est rejeté par le serveur.
Un Nullable(UInt8) avec trois lignes [5, NULL, 9] (6 octets au total) :
Nullable(String) de trois lignes ["hello", NULL, "world"] (15 octets au total) :
Array(T)
Chaîne de type :Array(InnerType). Exemples : Array(UInt32), Array(String), Array(Nullable(UInt32)), Array(Array(UInt8)).
La disposition wire se compose de la phase de préfixe du type interne (vide, sauf si le type interne est versionné), suivie de deux flux concaténés, en commençant par les offsets :
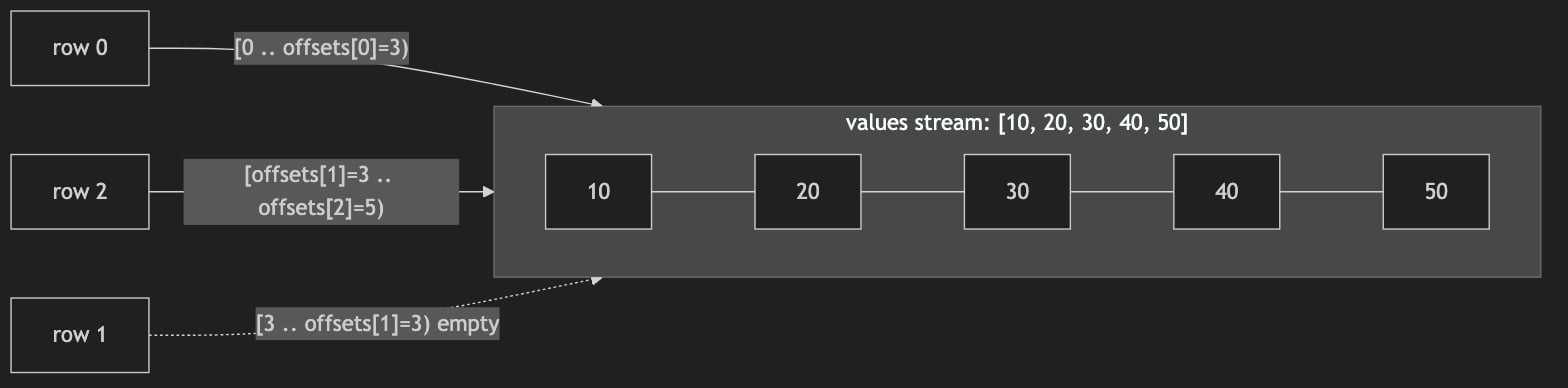
num_rows valeurs UInt64 en little-endian, chacune correspondant à la position de fin cumulée dans le flux des valeurs après les éléments de la ligne concernée :
- Index de début des éléments pour la ligne
N=offsets[N - 1](ou0lorsqueN == 0). - Index de fin des éléments (exclu) pour la ligne
N=offsets[N]. - Nombre d’éléments de la ligne
N=offsets[N] - offsets[N - 1].
offsets[num_rows - 1] correspond donc au nombre total d’éléments sur l’ensemble des lignes, et le flux des valeurs contient autant de valeurs internes, concaténées bout à bout.
Les offsets sont monotones croissants au sens large ; deux offsets consécutifs égaux signalent une ligne vide, et un décodeur doit rejeter tout offset non monotone en le traitant comme une corruption. Une colonne vide (num_rows == 0) n’écrit aucun octet — ni flux des offsets, ni flux des valeurs. Le type interne peut être n’importe quel type, y compris un autre type composé : Array(Array(T)), Array(Tuple(...)) et Array(Nullable(T)) sont tous valides.
Array(UInt32) avec les lignes [[10, 20, 30], [], [40, 50]] (44 octets au total) :
0 pour la ligne 0). Deux offsets consécutifs égaux désignent une ligne vide :
Array(String) avec les lignes [["a", "bb"], []] (20 octets au total) :
[[[1,2]], [], [[3], [4,5]]], Array(Array(UInt32)) imbrique la même structure :
- Offsets externes :
[1, 1, 3]— la ligne 0 contient 1 tableau interne, la ligne 1 n’en contient aucun, la ligne 2 en contient 2. - Le
Array(UInt32)intermédiaire décode 3 lignes avec les offsets[2, 3, 5]. - Le
UInt32le plus interne décode 5 valeurs :[1, 2, 3, 4, 5].
Tuple(T1, T2, …)
Chaîne de type :Tuple(T1, T2, ..., Tn). Exemples : Tuple(UInt32, String), Tuple(Int32), Tuple(Array(UInt32), String), Tuple(UInt8, Tuple(Int32, String)). ClickHouse prend également en charge les tuples nommés via Tuple(a UInt32, b String) ; les noms ne sont que des métadonnées et n’ont aucune incidence sur le format wire.
La disposition wire se compose de la phase de préfixe des éléments (chaque élément versionné y apporte son préfixe d’état, dans l’ordre de déclaration ; elle est vide pour les éléments non versionnés), suivie de N flux concaténés, un par type d’élément, dans l’ordre de déclaration :
num_rows valeurs. Il n’y a ni préfixe de longueur, ni flux d’offsets, ni séparateurs entre les flux. Une colonne vide (num_rows == 0) n’écrit aucun octet par flux. Les types d’éléments peuvent être de n’importe quel type, y compris d’autres types composés : Tuple(Tuple(...), ...), Tuple(Array(...), ...) et Tuple(Nullable(T1), T2) sont tous valides.
Le tuple sans élément Tuple() est également valide : il est produit par des expressions comme SELECT tuple() ou CAST(x AS Tuple()). Comme il ne possède aucun flux d’éléments, il est sérialisé à la manière de Nothing : un octet de remplissage (0x30, ASCII '0') par ligne, que le désérialiseur ignore. Le nombre de lignes est fourni par l’en-tête du bloc, exactement comme pour Nothing.
Tuple(UInt8, UInt8) avec 3 lignes (1,4), (2,5), (3,6) :
[1, 2, 3] pour l’élément 0 et [4, 5, 6] pour l’élément 1.
Tuple(UInt32, String) avec 2 lignes (10, "a"), (20, "bb") (13 octets au total) :
Map(K, V)
Chaîne de type :Map(KeyType, ValueType). Exemples : Map(String, UInt32), Map(String, Array(UInt32)), Map(UInt8, Tuple(Int32, String)), Map(Array(String), Int8). Le format wire n’impose aucune restriction sur ces types : K comme V peuvent être n’importe quel type pris en charge, y compris un type composé. (Les règles SQL de ClickHouse concernant les types de clés acceptés ont varié d’une version à l’autre ; consultez la documentation SQL correspondant à la version du serveur ciblée.)
La disposition wire est identique octet par octet à celle de Array(Tuple(K, V)) ; elle commence donc par la phase de préfixe interne (vide, sauf si K ou V est versionné) :
total_pairs = offsets[num_rows - 1] (ou 0 lorsque num_rows == 0). Le flux des offsets a la même sémantique que pour Array. Les clés sont alignées positionnellement sur les valeurs : la paire i correspond à (keys[i], values[i]).
En mémoire, ClickHouse représente une colonne Map sous la forme d’un tableau de tuples ; le système de types l’expose comme un type distinct pour des raisons d’ergonomie SQL (m['key'], mapKeys, mapValues). Le format wire est une sérialisation directe de ce stockage, si bien que Map et Array(Tuple(K, V)) sont interchangeables octet pour octet.
Les offsets sont monotones croissants au sens large, et les flux de clés et de valeurs contiennent chacun exactement total_pairs valeurs. Une colonne vide n’écrit aucun octet. Au sein d’une même ligne, les clés sont généralement uniques, mais il s’agit d’une règle sémantique et non d’une contrainte imposée par le format wire : celui-ci permet d’écrire puis de relire à l’identique des clés en double, et la sémantique côté serveur ne résout les doublons que lorsqu’une fonction compatible avec Map consomme la ligne.
Map(UInt8, UInt8) avec 2 lignes {1:10, 2:20}, {3:30} (22 octets au total) :
i est reconstruite en lisant conjointement keys[i] et values[i].
Map(String, UInt32) avec 1 ligne {'a':1, 'b':2} (20 octets au total) :
Nested(name1 T1, name2 T2, …)
La représentation on-wire deNested dépend du paramètre côté serveur flatten_nested, ce qui donne lieu à deux cas distincts.
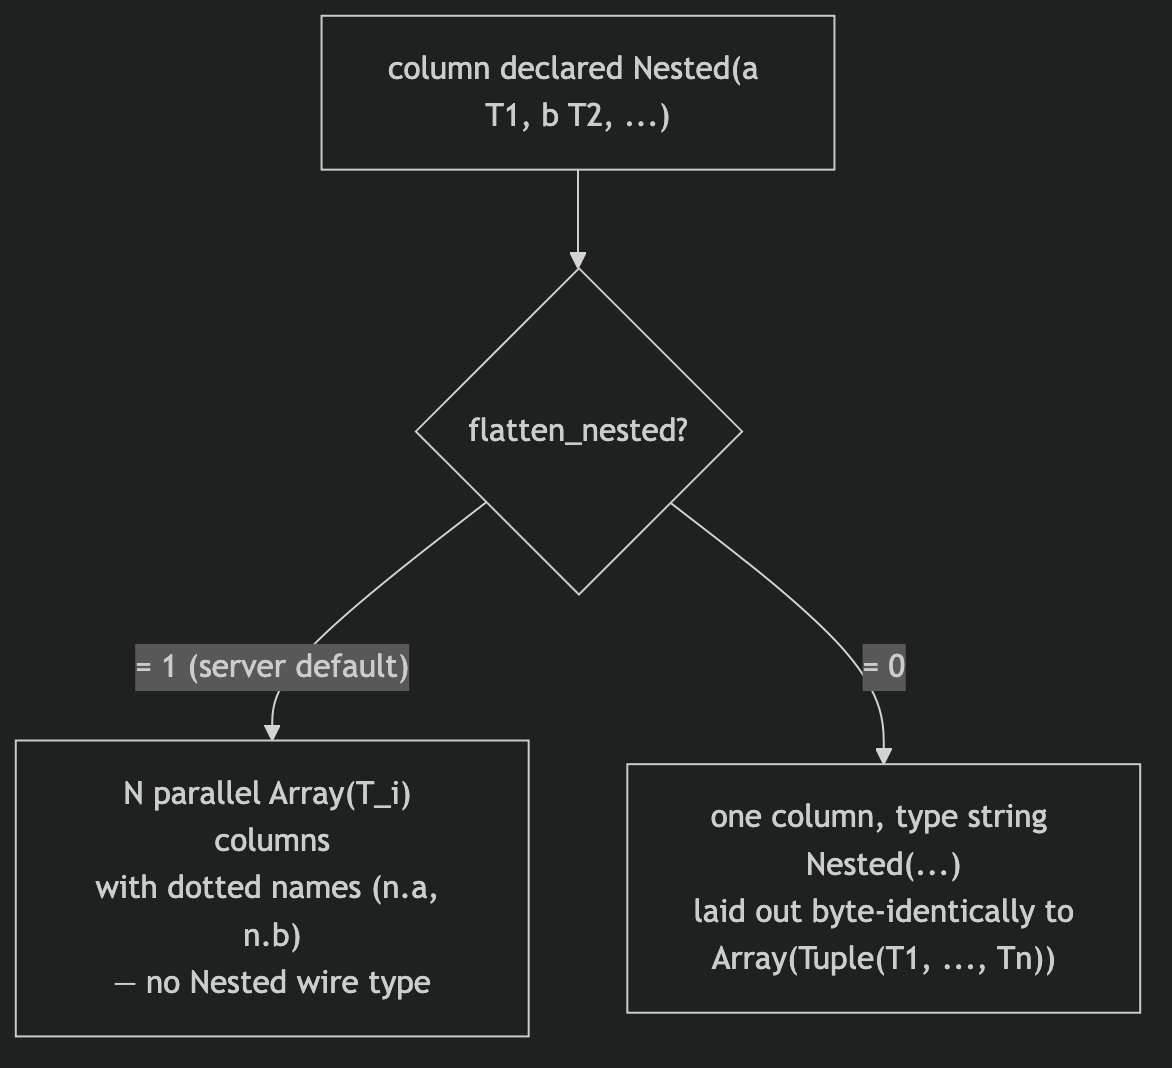
flatten_nested = 1 (valeur par défaut du serveur). Lorsque la table a été créée avec les paramètres par défaut, Nested n’est pas un wire type. Le serveur stocke et expose la colonne sous la forme de N colonnes Array(T_i) parallèles dont les noms contiennent un point (outer.field1, outer.field2, etc.). Pour la couche de format, rien ne change : chacune de ces colonnes est un Array ordinaire :
flatten_nested = 0. Lorsque la table a été créée avec flatten_nested = 0, la colonne apparaît dans le format binaire sous la forme d’une colonne unique dont la chaîne de type est Nested(name1 T1, name2 T2, ...), et sa disposition après la chaîne de type est identique octet pour octet à Array(Tuple(T1, T2, ..., Tn)), y compris la phase de préfixe interne : tout champ versionné T_i émet donc son préfixe d’état en premier, avant les offsets. L’exemple ci-dessous utilise des champs non versionnés ; la phase de préfixe est donc vide :
Nested conserve les noms de champs (a, b), ce que Array(Tuple) ne fait pas, faute de positions nommées.
Dans le cas B, la chaîne de type est une liste de paires (nom, type) séparées par des virgules. Le premier espace blanc sépare un nom de son type ; le type lui-même peut contenir d’autres espaces, des virgules et des parenthèses : l’analyse requiert donc le même découpeur sensible à la profondeur que celui utilisé pour Tuple. La disposition wire :
total_elements = offsets[num_rows - 1] (ou 0 lorsque num_rows == 0). Les offsets sont monotones croissants au sens large, et chaque flux de champ contient exactement total_elements valeurs. Lors de l’INSERT, le serveur vérifie qu’au sein d’une même ligne, tous les champs comportent le même nombre d’éléments. Une colonne vide n’écrit aucun octet.
Nested(a UInt8, b String) avec 2 lignes [(10,'x'),(20,'y')] et [(30,'z')] (25 octets après la chaîne de type) :
Alias de types
Plusieurs types sont de simples alias : le serveur envoie le nom de l’alias dans l’en-tête de colonne, mais les octets qui suivent sont ceux d’un type sous-jacent. Un décodeur associe l’alias à ce type et réutilise son codec — aucun nouveau format wire n’entre en jeu. Les types géographiques sont des alias de tableaux et de tuples imbriqués :
Ainsi, une colonne
Point est décodée exactement comme un Tuple(Float64, Float64) (avec le rendu (1,2)), une colonne Ring comme un Array(Tuple(Float64, Float64)) ([(0,0),(1,1)]), et ainsi de suite en remontant la hiérarchie.
Geometry est également un alias, mais d’un Variant plutôt que d’un tableau imbriqué : sa charge utile est le variant des sept types géographiques ci-dessus. L’en-tête de colonne ne contient que la chaîne de type Geometry — il ne détaille pas le variant —, si bien qu’un décodeur doit le développer lui-même. Contrairement à un Variant déclaré explicitement par l’utilisateur, les discriminateurs de Geometry ne suivent pas l’ordre alphabétique des noms : ils sont figés pour des raisons de compatibilité, et les nouveaux types géographiques sont toujours ajoutés à la fin. La correspondance est la suivante : 0 = LineString, 1 = MultiLineString, 2 = MultiPolygon, 3 = Point, 4 = Polygon, 5 = Ring, 6 = MultiPoint (ajouté en 26.7 — les flux provenant de serveurs plus anciens ne contiennent tout simplement jamais le discriminateur 6). Chaque valeur sélectionnée est ensuite décodée via l’alias géographique correspondant ci-dessus (NULL utilise le discriminateur NULL de Variant, à savoir 255).
SimpleAggregateFunction(func, T) est un alias de son type de valeur T. Il stocke une valeur agrégée déjà finalisée : sa forme wire et son rendu sont donc exactement ceux de T (SimpleAggregateFunction(sum, UInt64) est décodé comme UInt64). Seule la forme à type de valeur unique constitue un alias de ce genre ; le type sous-jacent peut lui-même être un type composé.
Deux types apparentés ne sont pas des alias. Ce sont des types de colonne
Native valides — un client peut par exemple recevoir une colonne AggregateFunction issue d’un combinateur -State ou d’une agrégation distribuée —, mais chacun transporte sa propre charge utile spécialisée, qui dépasse le cadre de cette page :AggregateFunction(func, ...)contient un état d’agrégation intermédiaire (et non une valeur finalisée) ; sa disposition binaire est propre à la fonction d’agrégation et à sa version. Le nom de la fonction peut comporter des paramètres, chacun écrit sous forme de littéral SQL, comme dansAggregateFunction(topK(3), UInt64). Certaines fonctions d’agrégation ajoutent un suffixe::Typeexplicite à un paramètre, comme dansAggregateFunction(topK('3'::Decimal32(0)), UInt64), car une valeurDecimalou un entier large n’a pas de forme littérale simple ; ce comportement est une propriété de la fonction et non du format : un décodeur qui inspecte les paramètres doit donc accepter les deux graphies. Un décodeur qui n’a besoin que des types d’arguments n’est pas concerné. Une fonction d’agrégation versionnée indique toute version d’état non nulle comme premier argument de la chaîne de type —AggregateFunction(1, quantileDeterministic, UInt64, UInt64)—, tandis que la version0n’est pas écrite, si bien que la chaîne de type resteAggregateFunction(quantileDeterministic, UInt64, UInt64). Sur une connexion négociée (révision supérieure à0), le rédacteur choisit la version en fonction de la révision du protocole uniquement — jamais d’une version qui se trouverait fixée sur son type local, car sur le wire, la version0ne se distingue pas de « aucune version annoncée » —, de sorte qu’une même fonction peut annoncer des versions différentes selon les connexions, et qu’un lecteur doit lire la version dans la chaîne de type plutôt que de supposer qu’il s’agit de la plus récente. À la révision0, il n’existe aucun pair pour lequel dériver une version — le flux est autodescriptif et relu par celui qui l’a écrit —, si bien qu’une version fixée sur le type est conservée dans le flux (et dans la chaîne de type annoncée) au lieu d’être ramenée à0.quantileDeterministic(ainsi que ses variantes d’écriturequantilesDeterministicetmedianDeterministic) est versionnée à partir de la révision54491: la version1ajoute unUInt8 skip_degreeen fin d’état, et son préfixe est identique octet pour octet à la version0. En deçà de cette révision, le rédacteur émet des états de version0, si bien qu’un pair plus ancien n’est pas affecté.uniqest versionnée à partir de la révision54493: la version1ajoute un octet d’indicateurs en tête de la disposition de la version0et, lorsque le bit0des indicateurs est positionné, ajoute à la fin un petit échantillon supplémentaire de hachages 64 bits complets, chacun combiné par XOR avec la constante0x9E3779B97F4A0000(UInt8 skip_degree,VarUInt count, puis les valeurs sur 8 octets), ce qui préserve la précision de l’estimation pour des cardinalités supérieures à deux milliards ; un état de version0ne contient que l’échantillon principal 32 bits. Le bit1des indicateurs signale que l’échantillon 64 bits est incomplet — l’état a absorbé un état de version0, dont les éléments n’ont jamais été soumis à un échantillon 64 bits —, auquel cas aucun échantillon 64 bits n’est écrit et un lecteur doit effectuer l’estimation à partir du seul échantillon principal 32 bits (et continuer à le signaler dans les états qu’il écrit par la suite) ; les deux bits sont donc mutuellement exclusifs, et un lecteur doit rejeter un état qui positionne les deux. Aucun autre bit n’est défini, et un lecteur doit rejeter tout état qui en positionne un. Tout cela s’applique également à un état imbriqué dans un type conteneur —Array,Tuple,Map,Nullable,Variant(où la version explicite de l’alternative modifie la chaîne de type sans modifier l’ordre des discriminateurs), ou un wrapperNested/SimpleAggregateFunction. Cela vaut aussi pour les combinateurs de fonctions d’agrégation : un combinateur transparent appliqué à une fonction versionnée —uniqIf,uniqArray,uniqForEach,uniqMap,uniqArgMin/uniqArgMax,uniqOrNull/uniqOrDefault,uniqResample, ainsi que l’adaptateur implicite pour argumentsNullable— transmet la version aux états imbriqués contenus dans sa charge utile, indique explicitement la version courante de la fonction imbriquée dans la chaîne de type d’un état fraîchement créé, exactement comme la fonction simple (AggregateFunction(1, uniqIf, UInt64, UInt8)), et dérive de la même manière la version à partir de la révision du protocole sur une connexion négociée. Le nom personnalisé d’un wrapper contient une seconde copie de son type d’argument : le rédacteur doit donc reconstruire cette copie avec la même version d’état d’agrégation négociée, faute de quoi son en-tête risque d’annoncer la version1pour une charge utile de version0. Un cas limite deVariantn’a aucune représentation sur le wire : lorsque deux alternatives ne diffèrent que par une version d’état explicite (ce qui est valide comme type de colonne, puisque les chaînes de type diffèrent), les re-versionner toutes deux pour la révision négociée les fusionnerait en une seule alternative ; l’émetteur doit alors faire échouer le transfert plutôt que d’annoncer des versions qui ne correspondent pas à celles de la charge utile.Dynamicconstitue l’exception délibérée au versionnement dérivé de la révision : une colonneDynamicannonce elle-même ses types imbriqués — via ses propres listes de types et via l’encodage binaire des types, dont le champ de version explicite porte une version d’état explicite (les valeurs de son variant partagé intègrent ainsi leur type, même au repos) —, et ces annonces font partie des données propres de la colonne, identiques pour tout pair et tout support ; elles ne sont donc jamais réécrites pour une révision négociée. Un état imbriqué dans une valeurDynamicest par conséquent écrit à la version indiquée dans son type (ce qui est le cas d’un état fraîchement créé, puisqu’un résultat de requête-Stateindique explicitement sa version), ou à la version0lorsque le type n’en indique aucune, quels que soient la connexion et le support.QBit(T, N[, stride])stocke un vecteur dont les plans de bits sont transposés pour les charges de travail de recherche vectorielle ; la disposition de son flux on-wire (flux de plans de bitsFixedStringordonnés par groupe, au nombre deelement_size * (N / stride)avec unstrideexplicite) et son encodage binaire de type (balise0x36, ou0x37QBitWithStridelorsquestride != N) sont documentés sur la page du type de donnéesQBitet dans la référence de l’encodage binaire des types : un lecteurNativen’a donc pas à les reconstituer à partir du code source C++.
Types versionnés
Les types versionnés comportent un préfixe on-wire de version de sérialisation qui indique quelle variante de l’encodage suit. Ils peuvent également utiliser plusieurs flux (comme les types composés). Sur le wireNative, le préfixe et l’éventuel dictionnaire sont propres à chaque bloc : ces types ne conservent aucun état d’un bloc à l’autre (voir la note sur le préfixe par bloc ci-dessous). Un état de sérialisation inter-blocs n’existe que dans le flux sur disque de MergeTree.
Ces types sont nettement plus complexes que les types composés à forme fixe, et un client destiné à des requêtes analytiques simples peut en reporter la prise en charge.
Version de sérialisation : concept
Une version de sérialisation est un numéro de version on-wire, propre à chaque type et à chaque colonne, qui indique quelle variante de l’encodage d’un type l’émetteur utilise. Elle constitue le premier élément du préfixe d’état de la colonne : le décodeur la lit donc en premier, puis délègue le reste de la colonne au parseur approprié. Elle se distingue de la version du protocole :
La plupart des types versionnés écrivent la version sous forme d’un UInt64 little-endian, immédiatement avant toute autre donnée du préfixe d’état ; quelques-uns utilisent VarUInt ou UInt8. Un décodeur lit d’abord la version et rejette les valeurs inconnues : une version supérieure correspond à un format d’émetteur plus récent que le décodeur ne sait pas interpréter, et une analyse erronée corrompt tous les octets suivants.
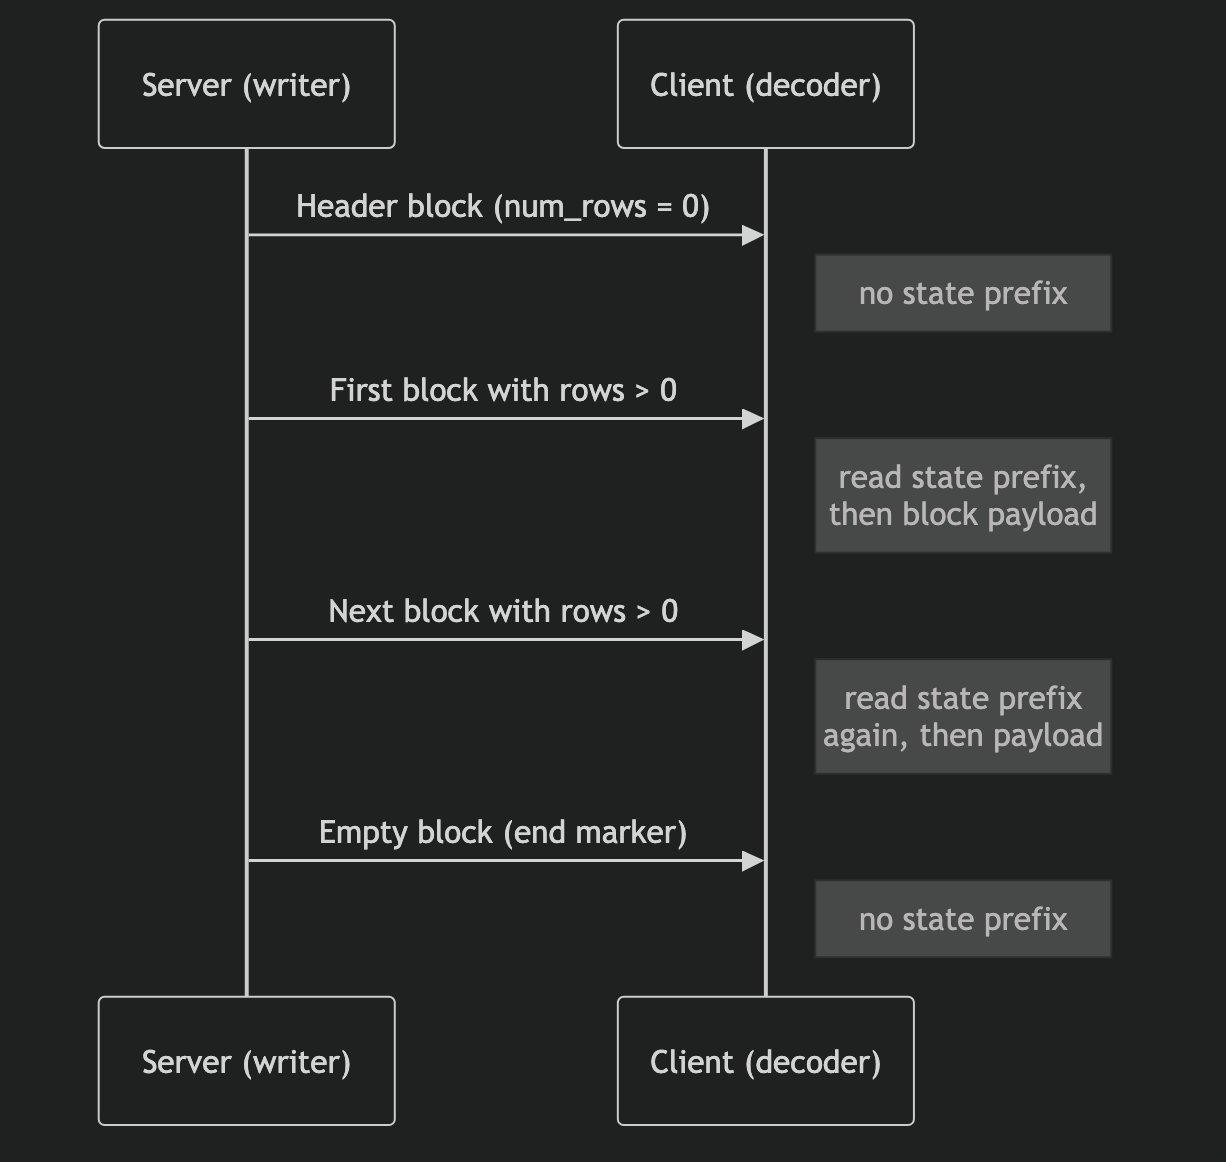
Le préfixe d’état est émis au début de chaque bloc dont le nombre de lignes est supérieur à zéro, immédiatement avant la charge utile de ce bloc.
Le rédacteur et le lecteur Native ne conservent pas l’état de sérialisation d’un bloc à l’autre :
NativeWriter crée un nouvel état de sérialisation et écrit un préfixe d’état pour chaque bloc de colonne non vide qu’il écrit, et NativeReader crée un nouvel état de désérialisation et lit ce préfixe pour chaque bloc non vide qu’il lit (tous deux ignorent entièrement le préfixe lorsque rows == 0).
Les blocs d’en-tête (rows = 0) et les blocs vides n’émettent donc rien, et un décodeur doit relire le préfixe d’état au début de chaque bloc non vide. Un décodeur qui ne lit le préfixe qu’une seule fois et traite les blocs suivants comme de simples charges utiles interprétera le préfixe du bloc suivant comme des données et se désynchronisera :
Référence des versions de sérialisation
Quelques points à noter concernant ce tableau :
- Les valeurs ne sont pas contiguës.
Dynamicutilise1,2,3et4, avecV3à4etFLATTENEDà3. Un numéro plus élevé ne correspond donc pas nécessairement à une version plus récente. - Certaines valeurs sont propres au format Native.
Object::STRING,Object::FLATTENEDetDynamic::FLATTENEDservent à assurer, via le protocole natif, la compatibilité avec les clients qui n’implémentent pas entièrement Object/Dynamic. Elles n’apparaissent pas dans le stockage sur disque de MergeTree. V3est réservé au stockage sur disque. SiObject::V3etDynamic::V3figurent dans le tableau, c’est parce que ces valeurs sont assignées et ne doivent pas être réutilisées, et non parce qu’un décodeur est susceptible de les rencontrer : ClickHouse ne les envoie jamais viaNativeet les y rejette avecINCORRECT_DATA. Tout ce qu’elles véhiculent — la sous-version des données partagées deObject::V3ainsi que ses dispositions de buckets et de granules — décrit une part et non un bloc, et sort donc du cadre de cette page. Les clients qui consomment le protocole TCP natif ne voient queV1,V2,STRINGouFLATTENED.
LowCardinality(T)
Le type versionné le plus simple. Il remplace une colonne deN valeurs internes par un petit dictionnaire de valeurs uniques, accompagné de N index pointant vers ce dictionnaire.
Chaîne de type : LowCardinality(InnerType). Exemples : LowCardinality(String), LowCardinality(FixedString(4)), LowCardinality(Nullable(String)).
sharedDictionariesWithAdditionalKeys ; les autres valeurs sont réservées.
La métadonnée UInt64 propre à chaque bloc est un champ de bits :
Pour une réponse de requête typique comportant un seul bloc de données par colonne, la métadonnée vaut
0x600 (HasAdditionalKeys + NeedUpdateDictionary).
Les valeurs du dict sont dict_size valeurs encodées selon le type interne T. Le dictionnaire réserve ses premiers emplacements à des valeurs spéciales : une colonne non nullable en réserve un (dict[0] contient la valeur par défaut du type interne, par exemple "" pour String), et les valeurs distinctes réelles commencent à dict[1].
Pour LowCardinality(Nullable(T)), le dict reste encodé en T simple (sans flux de null-map), mais deux emplacements sont réservés : dict[0] est le marqueur NULL et dict[1] la valeur par défaut du type interne (par exemple "" pour String) ; les valeurs distinctes réelles commencent à dict[2]. La clé d’une ligne NULL pointe vers dict[0], et cet emplacement est écrit dans le format wire sous la forme des octets par défaut du type interne.
Les clés sont des index dans le dict ; chaque index occupe 1 << key_type_code octets (1, 2, 4 ou 8), et la valeur N est reconstruite sous la forme dict[keys[N]].
keys_count est le nombre de valeurs LowCardinality au niveau récursif courant, et pas nécessairement le nombre de lignes du bloc. Pour une colonne LowCardinality de premier niveau, les deux coïncident. En revanche, lorsque le LowCardinality est imbriqué dans un type composé, ce nombre correspond au nombre de valeurs aplaties que le type composé lui transmet : pour Array(LowCardinality(String)) avec trois lignes contenant cinq éléments au total, keys_count vaut 5 et non 3 ; pour Map(K, LowCardinality(V)), il s’agit du nombre total de paires, et ainsi de suite. Un décodeur doit lire keys_count dans ce champ plutôt que de supposer qu’il est égal au nombre de lignes du bloc. Lorsque ce nombre aplati est nul — par exemple pour un bloc dont tous les tableaux sont vides — la phase de données LowCardinality n’écrit absolument rien : seul le préfixe d’état (émis lors de la phase de préfixe des types composés) est présent, sans métadonnée, dictionnaire ni keys_count à la suite.
Le préfixe d’état est lu au début de chaque bloc dont le nombre de lignes est supérieur à zéro — les blocs d’en-tête (rows = 0) et les blocs vides n’émettent rien. Au sein d’un bloc, keys_count est égal au nombre de lignes, dict_size est égal au nombre de valeurs du flux du dictionnaire, et chaque clé tient sur 1 << key_type_code octets.
Dans le format
Native, chaque bloc transporte un dictionnaire autonome, propre au bloc — aucun état de dictionnaire n’est partagé entre les blocs. Le rédacteur Native définit low_cardinality_max_dictionary_size = 0, si bien que SerializationLowCardinality ne construit jamais de dictionnaire partagé : chaque bloc non vide écrit ses clés sous forme de clés additionnelles propres au bloc, avec NeedGlobalDictionaryBit non positionné (métadonnées 0x600), et le lecteur Native rejette NeedGlobalDictionaryBit lorsque native_format vaut true. Un décodeur doit donc réinitialiser le dictionnaire à chaque bloc et lire les dict_size entrées présentes dans ce bloc ; réutiliser le dictionnaire d’un bloc précédent fausserait la lecture des clés du bloc suivant. (La persistance d’un dictionnaire LC entre les blocs relève du stockage sur disque de MergeTree, et non de la disposition wire de Native.)LowCardinality(String) avec les valeurs ['a', 'b', 'a', 'c', 'b'] :
dict[1], dict[2], dict[1], dict[3], dict[2] = ["a", "b", "a", "c", "b"].
Avec les valeurs ['a', NULL, '', 'b'], LowCardinality(Nullable(String)) illustre les deux emplacements réservés : dict[0] pour NULL et dict[1] pour la valeur par défaut (la string vide) :
dict[2] = "a", dict[0] = NULL, dict[1] = "", dict[3] = "b", soit ["a", NULL, "", "b"]. dict[0] et dict[1] correspondent tous deux à des octets vides dans le format wire ; la valeur NULL découle du fait que la clé pointe vers le slot 0, et non des octets eux-mêmes.
JSON (Tier 1 : String fallback)
Le typeJSON de ClickHouse dispose de plusieurs encodages binaires (voir la référence des versions de sérialisation). Le Tier 1 est le plus simple : lorsque le paramètre de requête output_format_native_write_json_as_string = 1 est activé, le serveur convertit chaque valeur JSON en sa représentation textuelle sérialisée et renvoie la colonne sous forme de String, précédée d’un marqueur de préfixe d’état.
Chaîne de type : JSON.
1 pour ce mode String fallback. Les autres valeurs correspondent à différents encodages JSON/Object : 0 = V1, 2 = V2 (la valeur par défaut avec le protocole TCP natif), 3 = FLATTENED, 4 = V3 (voir la référence des versions de sérialisation). Si un décodeur rencontre ici une valeur autre que 1, il ne s’agit pas du mode String fallback. Le préfixe est lu au début de chaque bloc comportant un nombre de lignes > 0, et le flux de valeurs est une colonne String standard de num_rows lignes.
Valeur JSON '{"a":1}' (une ligne) :
{"a":1}, l’integer restant un integer. Ce texte n’est qu’une simple valeur String : le client reçoit donc le JSON pour un transit opaque, mais ne récupère pas les chemins individuels ni leurs types ClickHouse. Pour obtenir un typage fidèle de chaque chemin, il faut recourir à l’encodage Tier 2 décrit ci-dessous.
Variant(T1, T2, …)
Une union discriminée : chaque ligne contient une valeur d’un seul des types variants, ou NULL. Chaque ligne porte un discriminateur global d’un octet qui indique son type, puis les valeurs de chaque type sont stockées de manière dense, en une séquence contiguë par type variant. Chaîne de type :Variant(T1, T2, ...). Le serveur normalise l’ordre (les types variants sont triés par nom) : la chaîne de type reçue liste donc déjà les types dans l’ordre des discriminateurs globaux. Le discriminateur 0 désigne le premier type listé, 1 le deuxième, et ainsi de suite. 255 (NULL_DISCRIMINATOR) indique que la ligne est NULL. Les éléments d’un Variant ne sont jamais Nullable : la représentation de NULL incombe au discriminateur. Exemples : Variant(String, UInt64), Variant(Array(UInt8), String).
Le préfixe d’état contient le mode des discriminateurs, sous forme de UInt64 LE : 0 = BASIC (le discriminateur de chaque ligne est écrit tel quel), 1 = COMPACT (encodage par plages, granule par granule). Par défaut, le serveur utilise BASIC avec le protocole natif (use_compact_variant_discriminators_serialization = false) ; seul BASIC est spécifié ici.
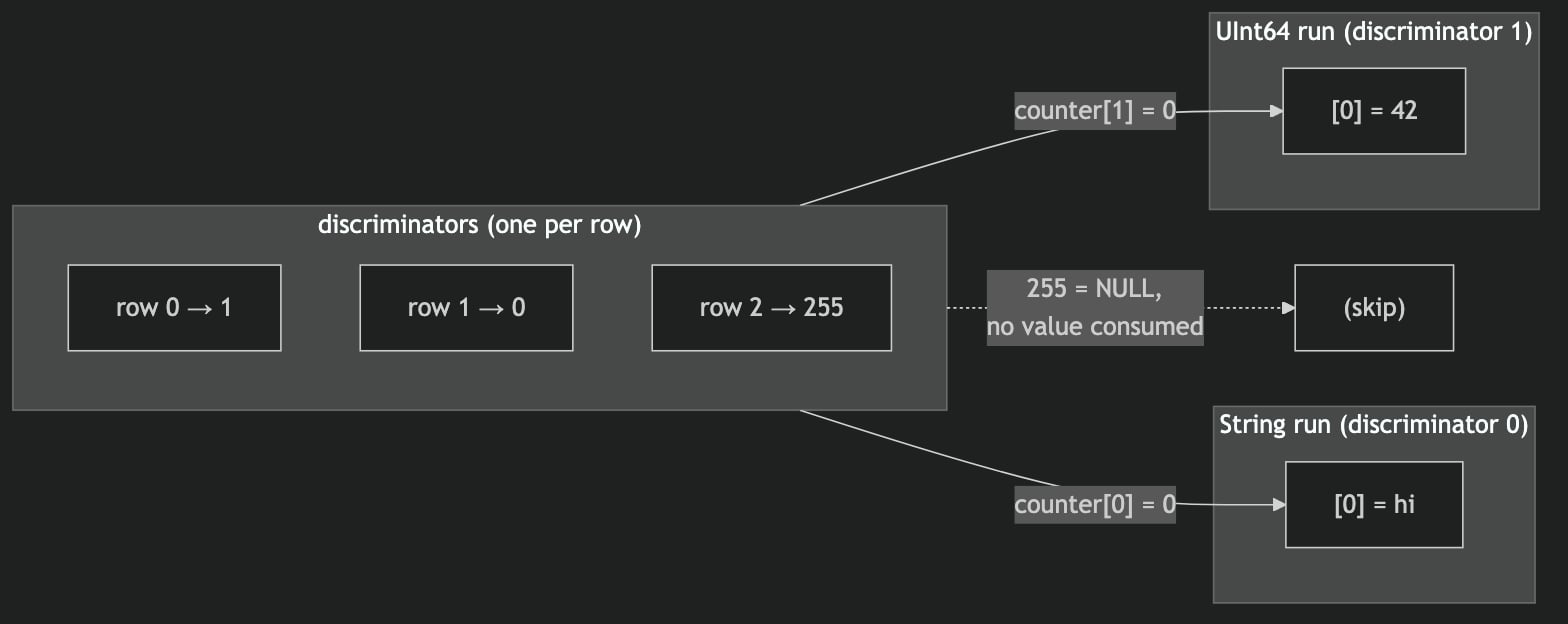
r de discriminateur d (≠ 255) prend la valeur située à l’index counter[d] dans la séquence de valeurs du type variant d, puis counter[d] est incrémenté. Les lignes de discriminateur 255 sont NULL et ne consomment aucune valeur, quelle que soit la séquence ; la somme des compteurs par type est donc égale au nombre de lignes non NULL.
Le préfixe d’état (le mode UInt64) est lu au début de chaque bloc contenant au moins une ligne ; les blocs d’en-tête et les blocs vides n’émettent rien. Chaque discriminateur non NULL est inférieur au nombre de types variants, et le type variant i est décodé pour exactement count[i] lignes.
Les éléments de Variant qui sont eux-mêmes avec état (
LowCardinality, Variant, Dynamic, JSON) émettent leur propre préfixe d’état lors de la phase de préfixe d’état propre à chaque élément, après le mode UInt64. Les types feuilles et les types composites simples (Array, Tuple, Map de types feuilles) ont des préfixes d’état vides et peuvent être combinés librement.Variant(String, UInt64) avec les valeurs [42, 'hi', NULL] (l’ordre canonique place String avant UInt64, d’où discriminateur 0 = String, 1 = UInt64) :
42 ; ligne 1 = String run[0] = "hi" ; ligne 2 = NULL.
Le flux de discriminateurs sert d’index : chaque discriminateur non NULL extrait la valeur suivante de la séquence dense de son type, tandis que 255 (NULL) ne consomme rien. Ce même parcours permet de reconstituer Dynamic, qui ne diffère que par la manière dont NULL est encodé :
Dynamic
Une colonne dont le type de valeur est découvert à l’exécution : chaque ligne contient une valeur appartenant à l’un des types d’un ensemble déterminé à l’exécution, ou NULL. Contrairement àVariant, l’ensemble des types ne figure pas dans la chaîne de type de la colonne — il est transmis dans le préfixe d’état.
Chaîne de type : Dynamic ou Dynamic(max_types=N). Le paramètre max_types limite le nombre de types distincts suivis par la colonne, mais n’a aucune incidence sur le format wire décrit ci-dessous.
Dynamic possède quatre encodages — V1 = 1, V2 = 2, FLATTENED = 3, V3 = 4. Celui qu’émet le serveur dépend du canal et des paramètres de requête :
- Via
clickhouse-clientet HTTPFORMAT Native, la révision du rédacteur est0(sauf si elle est relevée avecclient_protocol_version) ; l’encodage par défaut est donc V1. - Via le protocole TCP natif, à sa révision négociée, l’encodage par défaut est V2. Le rédacteur
Nativelaisse les statistiques désactivées : une charge utileV2par défaut ne contient donc aucune statistique par variante — la liste des types est directement suivie du préfixeVariantimbriqué, puis des données. (Les statistiques par variante relèvent du stockage sur disque de MergeTree et ne font pas partie du format wire Native.) - Le paramètre de requête
output_format_native_use_flattened_dynamic_and_json_serialization = 1prévaut dans les deux cas et produit FLATTENED (version 3), quelle que soit la révision.
PérimètreCette page spécifie uniquement la disposition
FLATTENED. Les dispositions binaires non-flat V1/V2/V3 correspondent à la représentation interne/sur disque (listes de types encodées en binaire, statistiques par variante) et ne sont pas spécifiées ici. Un client souhaitant décoder Dynamic à l’aide de cette page doit demander FLATTENED en définissant output_format_native_use_flattened_dynamic_and_json_serialization = 1 ; la disposition ci-dessous présuppose ce paramètre. Comme l’octet de version figure en tête du préfixe, un décodeur peut détecter l’encodage effectivement reçu et rejeter V1/V2/V3 s’il n’implémente que FLATTENED.num_types types plus l’emplacement NULL — UInt8 pour num_types ≤ 255, puis UInt16, UInt32, UInt64. NULL est représenté par la valeur de discriminateur num_types elle-même, contrairement à Variant, où NULL correspond à la valeur fixe 255. La reconstruction suit le même parcours dense que pour Variant : on tient un compteur par type, et la ligne r de discriminateur d (≠ num_types) prend la valeur counter[d] dans la séquence du type d.
Le préfixe d’état (version + liste de types) est lu au début de chaque bloc contenant au moins une ligne ; les blocs d’en-tête et les blocs vides n’émettent rien.
Comptage malformé
num_types est lu depuis le flux avant tout nom de type. Un décodeur doit le considérer comme non fiable et ne doit pas l’utiliser directement pour dimensionner une allocation — qu’il s’agisse d’un comptage proche de SIZE_MAX (qui peut provoquer un dépassement de capacité dans les calculs intermédiaires ou lever une exception autre que DB::Exception) ou d’un comptage élevé mais représentable tel que 100000000 (bien inférieur au max_size() d’un vecteur, mais qui allouerait plusieurs gigaoctets avant même la lecture du premier nom de type). ClickHouse lit la liste des types entrée par entrée, avec une simple indication de pré-allocation plafonnée ; ainsi, un num_types corrompu est rejeté soit avec INCORRECT_DATA (“Dynamic column has too many types”, lorsque le comptage dépasse la capacité du conteneur), soit comme une erreur de lecture ordinaire dès que le flux ne contient plus d’entrées de type — jamais comme un échec par manque de mémoire.En revanche, ne bornez pas le num_types aplati par ColumnDynamic::MAX_DYNAMIC_TYPES_LIMIT (254 dans ClickHouse) : la liste de types aplatie contient tous les types d’exécution distincts, y compris ceux qui ont débordé dans le variant partagé, de sorte qu’un bloc aplati valide peut légitimement en lister bien davantage. La borne MAX_DYNAMIC_TYPES_LIMIT s’applique uniquement au comptage num_dynamic_types des préfixes non aplatis V1/V2/V3, qui dénombre les emplacements de variants réguliers et est plafonné par cette limite (ClickHouse le valide à ce stade, avant le + 1 correspondant au variant partagé).Flux tronquésLa séquence de discriminateurs contient exactement
num_rows entrées, et un décodeur doit vérifier qu’il en a bien lu ce nombre au lieu d’accepter tout ce que le flux contenait. Une séquence plus courte n’entre en contradiction avec rien de ce qui suit : les comptages de valeurs par type étant dérivés des discriminateurs effectivement lus, ils restent cohérents avec les séquences de valeurs, et une séquence composée uniquement de marqueurs NULL n’exige aucun octet de valeur. ClickHouse rejette une séquence de discriminateurs trop courte avec INCORRECT_DATA (“Mismatch in flattened Dynamic column: N rows are expected, but the indexes stream contains only M rows”) avant toute vérification par type, car la colonne reconstruite est ensuite utilisée pour num_rows lignes, quelle que soit sa taille réelle.Les types d’exécution dont la sérialisation est avec état (
LowCardinality, Variant, Dynamic, JSON) comportent des préfixes d’état imbriqués après la liste des noms de types.Variant — les emplacements de variants réguliers sont écrits dans l’ordre de DataTypeVariant (par nom de type), si bien que l’ordre de transmission ne correspond pas à l’ordre d’insertion. Elle n’est toutefois pas toujours triée globalement : les types ayant débordé dans le variant partagé (par exemple avec Dynamic(max_types=N)) sont ajoutés après les emplacements réguliers, dans l’ordre de première apparition, de sorte que la fin de la liste peut rompre l’ordre par nom de type. Un décodeur doit donc considérer la liste de types transmise comme faisant foi pour l’attribution des discriminateurs et ne doit pas la retrier lui-même. En revanche, la liste ne peut contenir ni type répété ni Nothing : deux entrées identiques correspondent à un même discriminateur et Nothing n’est pas un variant ; dans les deux cas, une partie de la liste ne peut être reconstruite nulle part. ClickHouse rejette l’un comme l’autre avec INCORRECT_DATA. Pour les lignes [42::UInt64, "hi", NULL], les deux types sont String et UInt64, et "String" précède "UInt64" dans l’ordre de tri ; les discriminateurs sont donc 0 = String, 1 = UInt64, 2 = NULL :
42 ; ligne 1 = String run[0] = "hi" ; ligne 2 = NULL. Les séquences propres à chaque type suivent le même ordre de transmission que la liste des types (String avant UInt64).
JSON (Tier 2 : objet FLATTENED)
L’encodage JSON le plus riche : au lieu d’aplatir chaque valeur en texte (Tier 1), la colonne est divisée en une sous-colonne par chemin JSON. Cet encodage est sélectionné en ne demandant pas le repli Tier 1 (output_format_native_write_json_as_string = 0), l’indicateur de sérialisation aplatie étant activé (output_format_native_use_flattened_dynamic_and_json_serialization = 1) ; le serveur émet alors la sérialisation en version 3.
Il existe deux types de chemins :
- Les chemins typés sont déclarés dans la chaîne de type, par exemple
JSON(a UInt32, b String), et décodés selon leur type déclaré. Un nom de chemin contenant des points est encadré de backticks dans la chaîne de type. - Les chemins dynamiques sont découverts à l’exécution et chacun d’eux est décodé comme une colonne Dynamic.
num_rows valeurs.
Dynamic d’un chemin dynamique (dans la phase de préfixe) est donc séparé de ses données (dans la phase de données). Le préfixe d’état est lu au début de chaque bloc comportant plus de 0 ligne, et chaque colonne de chemin (typée ou dynamique) contient exactement num_rows valeurs. L’objet de la ligne r est assemblé en lisant la valeur de chaque chemin à l’index r ; un chemin dynamique dont le discriminateur Dynamic est NULL pour cette ligne n’ajoute aucune clé. Les noms des chemins dynamiques doivent être distincts, et aucun d’entre eux ne peut reprendre un chemin que la chaîne de type déclare déjà comme typé : dans les deux cas, l’objet assemblé aurait deux valeurs pour une même clé, et ClickHouse rejette donc ces deux situations avec INCORRECT_DATA. Il en va de même pour la liste des chemins dynamiques des encodages non plats.
Comptage malformé
num_dynamic_paths dans la disposition FLATTENED décrite ici — ainsi que le nombre de chemins dynamiques dans les encodages non plats V1/V2 — est lu dans le flux avant les noms des chemins. (Les préfixes non plats ne comportent pas de champ distinct pour les chemins aplatis : ils ne contiennent que le nombre de chemins dynamiques, ainsi qu’une valeur max_dynamic_paths dans V1, lue puis ignorée.) Comme pour Dynamic, un décodeur doit considérer ces nombres comme non fiables et ne doit pas s’en servir directement pour dimensionner une allocation — qu’il s’agisse d’un nombre de la famille SIZE_MAX ou d’un nombre élevé mais représentable. ClickHouse lit les noms des chemins une entrée à la fois, avec une simple indication de préallocation plafonnée ; un nombre corrompu est donc rejeté soit avec INCORRECT_DATA (“JSON/Object column has too many paths”, lorsqu’il dépasse la capacité du conteneur), soit par une erreur de lecture ordinaire dès que le flux ne contient plus de noms de chemins.Flux tronquésLes
num_rows valeurs par colonne de chemin constituent une exigence stricte, et non une borne supérieure : un décodeur doit vérifier chaque colonne de chemin, typée ou dynamique, par rapport au nombre de lignes du bloc, plutôt que de supposer que le flux se termine au bon endroit. L’objet assemblé n’a pas de taille propre qui permettrait une comparaison — son nombre de lignes est simplement celui que produit le désaplatissement —, si bien qu’une colonne de chemin trop courte ne peut pas être détectée plus tard, et la lecture de sa ligne r déborde au-delà de sa fin. ClickHouse la rejette avec INCORRECT_DATA (“Unexpected size of typed path / flattened path p in flattened Object column”). Pour un chemin dynamique, cette vérification s’ajoute à la vérification équivalente effectuée dans sa colonne Dynamic.JSON {"a": 42, "b": "hi"} (une ligne, les deux chemins étant dynamiques). Un integer JSON est inféré comme Int64 :
JSON non aplati (V1/V2)
Les encodagesObject non aplatis sont ceux que le serveur émet en transit lorsque l’indicateur d’aplatissement est désactivé : V1 via clickhouse-client / HTTP FORMAT Native (révision 0), V2 via le protocole TCP natif. (V3, le troisième encodage non aplati, n’est écrit que dans les parts MergeTree et est rejeté en transit.) Ces encodages comportent une colonne de données partagées et ne sont pas spécifiés sur cette page. Notez qu’ils ne transportent pas de statistiques par chemin dans le format binaire Native : NativeWriter laisse les statistiques désactivées, si bien que le préfixe de structure de l’Object ne contient aucune section de statistiques et que les octets qui le suivent sont directement les préfixes typés/dynamiques/de données partagées, puis les données. Les statistiques n’apparaissent que sur les chemins sur disque MergeTree qui les activent. Pour décoder une colonne JSON à l’aide de cette page, un client doit choisir l’un des niveaux documentés : définir output_format_native_write_json_as_string = 1 pour le String fallback, ou output_format_native_use_flattened_dynamic_and_json_serialization = 1 (avec output_format_native_write_json_as_string = 0) pour la disposition FLATTENED Object.
Trame de compression
ClickHouse peut compresser les données de colonnes d’un fluxNative à l’aide d’un format de trame interne. La disposition de trame décrite ci-dessous est indépendante du transport — les mêmes trames apparaissent aussi bien sur le protocole TCP natif que sur HTTP —, mais la manière de demander la compression, ainsi que ce qui entoure les trames, diffère selon le transport.
- Protocole TCP natif. La compression s’active à la demande, requête par requête, via l’indicateur
compressiondu paquet Query. Lorsqu’elle est active, le corps de chaque paquetData,Totals,Extremes,LogetProfileEvents— c’est-à-dire les octets qui suivent la stringtable_name— est encapsulé dans le format de trame. L’enveloppe du paquet elle-même, à savoir le code de type de paquet et la stringtable_name, n’est pas compressée ; le serveur les écrit directement dans le flux brut. Tout ce qu’émet leNativeWriterpart dans le flux compressé : le préfixeBlockInfoest donc le premier élément de la trame, suivi des dimensions et des colonnes. Un client doit par conséquent décompresser la trame avant de pouvoir lireBlockInfo. - HTTP.
SELECT ... FORMAT Native&compress=1encapsule l’intégralité du flux d’octetsFORMAT Nativedans les mêmes trames (le serveur utilise le mêmeCompressedWriteBufferinterne), et?decompress=1attend ces mêmes trames dans un corps d’entréeNative, qu’il décode via leCompressedReadBuffercorrespondant. Ce path ne comporte ni type de paquet TCP, nitable_name, ni enveloppe de paquet : la charge utile compressée se compose uniquement de blocsNativetramés (un préfixeBlockInfon’est présent que si la révision négociée est supérieure à0, exactement comme dans la disposition non compressée décrite plus haut). Ce tramage internecompress/decompressne doit pas être confondu avec la compression de transport HTTP (Content-Encoding: gzip/zstd, activée parenable_http_compression), qui encapsule la réponse au niveau de la couche HTTP et ne relève pas du format de trame décrit ci-dessous.
FORMAT Native non compressée doit tout de même prendre en charge cette couche de tramage pour lire une réponse HTTP Native compressée ou pour envoyer un corps de requête decompress=1.
Format de trame
16 + compressed_size = 16 + 9 + body_size = 25 + body_size. Notez les deux plages couvertes : la somme de contrôle porte sur l’en-tête de 9 octets et le corps, tandis que compressed_size inclut l’en-tête et le corps, mais pas la somme de contrôle elle-même :
Valeurs de l’octet de méthode
Ces trois codecs sont ceux que le serveur produit pour le tramageNative de flux complet : la sortie HTTP compress=1 utilise le codec par défaut du serveur (ZSTD(3)), et le protocole TCP natif utilise LZ4, ZSTD ou NONE selon network_compression_method. Un client Native générique n’a besoin de produire et de consommer que ces trois codecs.
L’octet de méthode encode également les codecs au niveau des colonnes. Ceux-ci s’appliquent colonne par colonne sur les paths sur disque MergeTree, et non au tramage de flux complet. Toutefois, le path d’entrée HTTP
decompress=1 lit le codec dans l’octet de méthode de chaque trame : n’importe lequel de ces octets peut donc légitimement apparaître en entrée. Un décodeur conforme doit par conséquent reconnaître l’ensemble de l’espace assigné et rejeter tout octet qu’il n’implémente pas plutôt que de mal interpréter le corps. Le corps de ces trames dépend de chaque codec et sort du cadre de ce contrat de trame générique :
DoubleDelta (0x94) stocke les différences secondes sous forme de bits préfixe/signe/magnitude, bit de poids fort en premier. Le décodage par mots préserve cet encodage, le nombre d’éléments et le remplissage du dernier octet.
0x9c (ALP) est un codec sans perte en bêta pour Float32 et Float64 (compression adaptative sans perte des nombres à virgule flottante). Une table ne peut être créée avec CODEC(ALP) que si le paramètre enable_alp_codec est activé, mais l’octet de méthode est toujours accepté lors de la décompression afin que les données déjà écrites restent lisibles. 0x9d (SZ3) est un codec avec perte expérimental, à erreur bornée, pour Float32, Float64 et les Array de ces types. Une table ne peut être créée avec CODEC(SZ3) que si le paramètre enable_sz3_codec est activé, mais l’octet de méthode est toujours accepté lors de la décompression afin que les données déjà écrites restent lisibles. 0x9f (ZXC) est un codec LZ asymétrique expérimental : lent à la compression, mais très rapide à la décompression, avec un taux de compression situé entre LZ4 et ZSTD. Une table ne peut être créée avec CODEC(ZXC) que si le paramètre enable_zxc_codec est activé, mais l’octet de méthode est toujours accepté lors de la décompression afin que les données déjà écrites restent lisibles. Les octets 0x99 (DeflateQpl) et 0x9b (ZSTD_QPL) étaient assignés à des codecs supprimés depuis ; ils restent réservés et ne sont pas réutilisés.
0x9e (Quantized) est un codec de colonne expérimental destiné aux colonnes de vecteurs denses (Array(Float32) et types apparentés). Comme NONE, il s’agit d’une transmission directe — le corps en pleine précision est stocké tel quel —, mais sa présence associe une sérialisation qui écrit un flux compagnon quantifié compact, utilisé pour accélérer la recherche vectorielle. Une table ne peut être créée avec CODEC(Quantized(...)) que si le paramètre enable_quantized_codec est activé, et l’octet de méthode est toujours accepté lors de la décompression.
Somme de contrôle
ClickHouse utilise CityHash v1.0.2 (la variante historique), et non la version moderne de Google CityHash ; les deux produisent des résultats différents. La somme de contrôle est calculée sur les 9 octets d’en-tête (method + compressed_size + uncompressed_size) ainsi que sur les N octets du corps, c’est-à-dire sur tout ce qui se trouve entre la somme de contrôle et la fin de la trame. Sur les 16 octets produits en sortie par CityHash128, les 8 premiers constituent la moitié basse (LE) et les 8 suivants la moitié haute (LE). Le décodeur recalcule le CityHash128 sur l’en-tête et le corps reçus, puis le compare aux 16 premiers octets : toute différence signale une corruption et le décodage échoue.Limites par bloc
La charge utile compressée d’un bloc est un flux d’une ou plusieurs trames, et pas nécessairement une trame unique. L’émetteur écrit le bloc sérialisé via unCompressedWriteBuffer qui émet une trame chaque fois que son tampon interne est plein (≈1 Mo, DBMS_DEFAULT_BUFFER_SIZE), puis une trame finale lors du vidage du bloc. Ainsi, un petit bloc tient en une seule trame, tandis qu’un grand bloc s’étend sur plusieurs trames consécutives.
L’invariant ne vaut que dans un sens : comme l’émetteur vide le tampon compressé à la fin de chaque bloc, chaque fin de bloc coïncide avec une limite de trame, mais la réciproque est fausse. Une limite de trame intermédiaire, émise lorsque le tampon s’est rempli en cours de bloc, tombe au milieu d’un bloc et ne constitue pas une limite de bloc. Un décodeur doit donc s’appuyer sur les dimensions propres du bloc (num_columns/num_rows) pour déterminer où celui-ci se termine ; il ne doit pas supposer que chaque trame correspond à un bloc complet.
Un récepteur traite les trames en flux : il lit 16 + 9 octets, lit exactement compressed_size - 9 octets de corps, les décompresse en exactement uncompressed_size octets, puis transmet ces octets au décodeur de blocs ; lorsque le décodeur a besoin de plus de données que n’en contient la trame courante, il récupère la trame suivante. Comme l’émetteur effectue un vidage à chaque bloc, le tampon de trame est vide une fois un bloc entièrement décodé, et le bloc suivant commence sur une nouvelle trame.
Avec le protocole TCP natif, l’enveloppe du paquet — le VarUInt du type de paquet et la string table_name — est écrite dans le flux brut, en dehors de la charge utile compressée ; seul le corps du bloc (BlockInfo + colonnes) est découpé en trames. Le path HTTP compress/decompress ne comporte pas d’enveloppe de ce type : l’intégralité du flux est constituée de blocs découpés en trames.
Négociation
Avec le protocole TCP natif, la compression s’applique par requête, et non par connexion. Le champcompression: bool du paquet Query l’active pour cette seule requête. Le serveur accède à la demande et émet des corps Data/Totals/Extremes/Log/ProfileEvents compressés pendant toute la durée de vie de la requête (Log/ProfileEvents uniquement à partir de v54481). Il s’attend également à ce que les blocs Data sortants du client — tables externes, marqueur vide de fin de données et lignes d’INSERT — soient tramés de la même manière. Les requêtes suivantes sur la même connexion peuvent se comporter différemment.
En HTTP, il n’existe pas de paquet Query : le paramètre de requête compress=1 active une sortie tramée pour cette requête, et decompress=1 indique que le corps de la requête est tramé. La sortie compress=1 est écrite avec le codec par défaut du serveur (ZSTD(3)) et non avec network_compression_method ; le lecteur decompress=1 détermine le codec à partir de l’octet de méthode de chaque trame, si bien que n’importe quel codec est accepté en entrée.
Lorsque la compression est activée, le serveur peut également faire transiter les colonnes par le path de sérialisation parallèle des blocs /
ColumnBLOB (PARALLEL_BLOCK_MARSHALLING, v54478) pour les blocs comportant plus d’une ligne. Une implémentation qui compresse les données d’INSERT doit être en mesure de gérer ce path (ou de le désactiver explicitement) afin d’éviter une désynchronisation du flux.Glossaire
Bloc — l’unité d’échange de données dans le format Native. Un fragment autodescriptif de lignes stockées en colonnes. Voir structure des blocs et des colonnes. BlockInfo — l’en-tête de métadonnées qui précède un bloc sur le path des paquets Data TCP (écrit dès que la révision de la connexion est supérieure à zéro). Il s’agit d’une séquence de champs conditionnés par la révision et identifiés par un identifiant de champ. Omis par le format de sortieNative, qui sérialise à la révision 0. Voir BlockInfo.
Corps de colonne — les octets d’une colonne qui contiennent les valeurs proprement dites, après l’en-tête de colonne (nom, type, octet has_custom_serialization). La disposition dépend du type. Voir disposition wire des colonnes.
Type composite — un type construit à partir d’un ou plusieurs types internes, encodé sous forme de plusieurs flux par colonne. Le format wire est stable et non versionné. Voir types composites.
Dictionnaire (LowCardinality) — le tableau de valeurs uniques qu’une colonne LowCardinality(T) référence au moyen d’indices entiers. Voir LowCardinality.
Bloc vide — un bloc avec num_columns = 0 et num_rows = 0. Utilisé comme sentinelle : marqueur de fin d’entrée côté client et marqueur de limite de flux côté serveur. Voir variantes de blocs.
Bloc d’en-tête — un bloc avec num_columns > 0 et num_rows = 0, envoyé par le serveur comme premier paquet Data de la réponse à une requête. Il annonce le schéma du résultat. Voir variantes de blocs.
Type interne — le type qu’enveloppe un type composite. Array(UInt32) a pour type interne UInt32 ; le type interne de Nullable(T) est T.
Flux d’offsets — le tableau UInt64 de positions de fin cumulées que Array, Map et Nested utilisent pour délimiter les éléments de chaque ligne. Voir Array.
Valeur de remplissage — les octets écrits aux positions nulles dans le flux de valeurs d’une colonne Nullable(T). Le décodeur les lit pour avancer dans le flux, mais en ignore le contenu. Voir Nullable.
Bloc de résultat — un bloc avec num_rows > 0 contenant les lignes effectives du résultat de la requête. Voir variantes de blocs.
Bloc de schéma — synonyme de bloc d’en-tête, employé pour décrire la phase INSERT, au cours de laquelle le bloc de schéma indique au client la forme attendue des colonnes.
Version de sérialisation — un numéro de version propre à chaque type et transmis sur le réseau, que les types versionnés utilisent pour indiquer quelle variante de l’encodage suit. À ne pas confondre avec la version du protocole. Voir version de sérialisation : concept.
Préfixe d’état — les octets qui précèdent la charge utile propre à chaque bloc d’un type versionné. Il contient la version de sérialisation et (pour LowCardinality) les métadonnées du dictionnaire propres au bloc. Émis au début de chaque bloc contenant au moins une ligne ; non conservé d’un bloc à l’autre.
Flux — une suite contiguë d’octets au sein d’un corps de colonne, encodant un sous-composant logique (une null-map, un tableau d’offsets, un flux de valeurs). Les types multi-flux concatènent au moins deux flux par colonne.