5万


本記事は、Intel 上海の性能最適化エンジニアである Jiebin Sun、Zhiguo Zhou、Wangyang Guo、Tianyou Li によるゲスト投稿です。
Intel の最新世代プロセッサは、Granite Rapids でソケットあたり 128 P-cores、Sierra Forest でソケットあたり 288 E-cores に達し、今後のロードマップでもソケットあたり 200 コア以上を目標に掲げるなど、サーバー内のコア数をかつてない水準へと押し上げています。マルチソケットシステムではこれらの数値がさらに掛け合わされ、400 コア以上で構成されるサーバーも登場しています。「より高速なコアではなく、より多くのコアを」というこのパラダイムは、物理的な制約によって推進されています。2000年代半ばにデナードスケーリングが終了して以来、電力密度の懸念から、シングルスレッド性能をさらに向上させることがますます困難になりました。
ClickHouse のような分析データベースにとって、超多コア環境は巨大なチャンスであると同時に、複雑な課題でもあります。コア数が増えれば、理論上はタスクを並列処理する能力が高まりますが、多くのデータベースは利用可能なハードウェアを十分に活用しきれずにいます。ロック競合、キャッシュコヒーレンシ、NUMA(Non-Uniform Memory Access)、メモリ帯域幅、協調オーバーヘッドといった並列処理のボトルネックは、コア数の増加に伴って著しく悪化します。
超多コア環境向けの最適化
過去3年間、私は仕事の一部を捧げて、Intel Xeon 超多コアプロセッサにおける ClickHouse のスケーラビリティの把握と最適化に取り組んできました。私の作業では、perf、emon、Intel VTune などの各種プロファイリングおよび分析ツールを活用し、超多コアサーバー上で ClickBench の全 43 クエリを体系的に分析してボトルネックを特定し、それに応じて ClickHouse を最適化することに注力しました。
その成果は素晴らしいものでした。個々の最適化によってクエリ単体で数倍、場合によっては最大 10 倍の高速化が日常的に得られるようになりました。ClickBench の全 43 クエリの相乗平均も、最適化ごとに 2% から 10% 着実に向上しました。この結果は、ClickHouse を超多コアシステム上で極めて良好にスケールさせられることを示しています。
コアスケーリングの課題
シングルスレッド性能の枠を超えて、超多コアシステムでの性能を最適化するには、いくつかの重要な課題に対処しなければなりません。
- キャッシュコヒーレンシのオーバーヘッド: キャッシュラインのバウンシングにより CPU サイクルが消費されます。
- ロック競合: 直列化されたコードセクションが全体のわずか 1% であっても、アムダールの法則が残酷なまでに効いてきます。
- メモリ帯域幅: メモリ帯域幅を効果的に活用することは、データ集約型システムにおける絶え間ない課題です。適切なメモリの再利用、管理、キャッシュが極めて重要になります。
- スレッド協調: スレッドの同期コストは、スレッド数に対して超線形に増大します。
- NUMA の影響: マルチソケットシステムでは、ローカルメモリかリモートメモリかによってメモリレイテンシと帯域幅が異なります。
本ブログ記事では、超多コアサーバー向けに私たちが実施した ClickHouse の最適化についてまとめます。これらの最適化はすべてメインコードラインにマージされており、現在、世界中の ClickHouse 環境でクエリの高速化に貢献しています。
ハードウェア構成: 今回の検証は、2 × 80 vCPU の Ice Lake(ICX)、2 × 128 vCPU の Sapphire Rapids(SPR)、1 × 288 vCPU の Sierra Forest(SRF)、2 × 240 vCPU の Granite Rapids(GNR)など、Intel の最新世代プラットフォームで実施しました。SMT に対応していない SRF を除き、SMT(Hyper-Threading)を有効にし、広帯域メモリ構成を採用しています。
ソフトウェア構成: perf、Intel VTune、パイプラインの可視化、その他のカスタムプロファイリング基盤を使用しました。
最適化の 5 領域
超多コアシステムにおける ClickHouse の性能を体系的に分析した結果、高い最適化余地を持つ 5 つの領域を特定しました。各領域はスケーラビリティの異なる側面に対処するものであり、それらが組み合わさることで、超多コアシステムの潜在能力を最大限に引き出す包括的なアプローチを形成しています。
私の探求は、最も基本的な課題であるロック競合から始まりました。
ボトルネック 1: ロック競合
待ち行列理論によれば、N 個のスレッドが同一のロックを奪い合う場合、消費サイクル数は二次関数的(N^2)に増大します。たとえば、8 コアから 80 コアへ増やすと、ロック待ち時間は (80/8)² = 100 倍に増加します。さらに、ミューテックス自体のキャッシュコヒーレンシトラフィックはコア数に比例して増加し、コンテキストスイッチのオーバーヘッドが問題をさらに悪化させます。このような環境では、あらゆるミューテックスがスケーラビリティを阻害する潜在的な障害となり、一見無害に見える同期パターンがシステム全体を機能停止に追い込むことさえあります。
重要な知見は、ロック競合の解消とは単にロックを取り除くことではなく、スレッドが協調して状態を共有する方法をより根本的に見直すことであるという点です。これには、クリティカルセクションの期間短縮、排他ロック(ミューテックス)からより粒度の細かい同期プリミティブへの置き換え、そして場合によっては共有状態の完全な排除といった、多角的なアプローチが必要です。
最適化 1.1: クエリ条件キャッシュ (PR #80247)
jemalloc のページフォールトを解決した後(後述する最適化)、native_queued_spin_lock_slowpath に CPU 時間の 76% を消費する新たなホットスポットが現れました。この関数は、2×240 vCPU システム上の QueryConditionCache::write から呼び出されていました。
クエリ条件キャッシュとは
ClickHouse のクエリ条件キャッシュは WHERE フィルターの結果を保存し、データベースが無関係なデータをスキップできるようにします。各 SELECT クエリにおいて、複数のスレッドがさまざまな基準に基づいてキャッシュエントリを更新すべきかどうかを確認します。
- フィルター条件のハッシュ(キャッシュキーとして使用)
- 読み取りマークの範囲
- 現在読み取っているパートにファイナルマークがあるかどうか
クエリ条件キャッシュは読み取りが中心であり、書き込みよりも読み取りのほうがはるかに多く発生しますが、元の実装ではすべての操作に排他ロックを使用していました。
読み取り中心のワークロードにおけるクリティカルパスの短縮
この最適化は、ロックの保持時間を短縮すること、とりわけ読み取り中心のコードにおいて書き込みロックの保持時間を減らすことの重要性を示しています。
単一クエリ内で 240 スレッドが動作する場合、元のコードは以下のような最悪の状況を引き起こしていました。
- 不要な書き込みロック: キャッシュエントリの読み取りしか行わない場合でも、全スレッドが排他ロックを取得していました。
- 長いクリティカルセクション: コストの高いキャッシュエントリの更新が排他ロックの内部で実行されていました。
- 冗長な処理: 複数のスレッドが同一のキャッシュエントリを複数回更新する可能性がありました。
私たちの最適化では、アトミック操作を用いたダブルチェックロッキングを採用し、これらのボトルネックを解決しました。
- まず、アトミックな読み取り(ロックなし)、あるいは共有ロック下で更新がそもそも必要かどうかを確認します(ファストパス)。
- 次に、排他ロックを取得した直後(スローパス)に、実際に更新が必要かどうかを確認します。その間に別のスレッドが同じ更新を実行した可能性があるためです。
実装
PR #80247 に基づき、この最適化では、コストの高い書き込みロックを取得する前に更新が必要かどうかを確認するファストパスを導入しています。
/// Original code
void updateCache(mark_ranges, has_final_mark)
{
acquire_exclusive_lock(cache_mutex); /// 240 threads wait here!
/// Always update marks, even if already in desired state
for (const auto & range : mark_ranges)
set_marks_to_false(range.begin, range.end);
if (has_final_mark):
set_final_mark_to_false();
release_lock(cache_mutex);
}/// Optimized code
void updateCache(mark_ranges, has_final_mark)
{
/// Fast path: Check if update is needed with a cheap shared lock
acquire_shared_lock(cache_mutex); /// Multiple threads can read simultaneously
need_update = false;
for (const auto & range : mark_ranges)
{
if (any_marks_are_true(range.begin, range.end))
{
need_update = true;
break;
}
}
if (has_final_mark && final_mark_is_true())
need_update = true;
release_shared_lock(cache_mutex);
if (!need_update)
return; /// Early out - no expensive lock needed!
/// Slow path: Actually need to update, acquire exclusive lock
acquire_exclusive_lock(cache_mutex);
/// Double-check: verify update is still needed after acquiring lock
need_update = false;
for (const auto & range : mark_ranges)
{
if (any_marks_are_true(range.begin, range.end))
{
need_update = true;
break;
}
}
if (has_final_mark && final_mark_is_true())
need_update = true;
if (need_update)
{
// Perform the actual updates only if still needed
for (const auto & range : mark_ranges)
set_marks_to_false(range.begin, range.end);
if (has_final_mark)
set_final_mark_to_false();
}
release_lock(cache_mutex);
}性能への影響
最適化されたコードは目覚ましい性能向上をもたらしました。
native_queued_spin_lock_slowpathで消費される CPU サイクルが 76% から 1% に減少- ClickBench クエリの Q10 と Q11 の QPS がそれぞれ 85% と 89% 向上
- 全 ClickBench クエリの相乗平均が 8.1% 向上
最適化 1.2: スレッドローカルなタイマー ID (PR #48778)
ClickHouse のクエリプロファイラはグローバルな timer_id 変数を頻繁に作成・削除していたため、クエリプロファイリング中にロック競合が発生していました。
クエリプロファイラのタイマー利用
ClickHouse のクエリプロファイラは、性能分析のために POSIX タイマーを使用して一定間隔でスレッドスタックをサンプリングします。元の実装には以下の問題がありました。
- プロファイリング中に timer_id を頻繁に作成および削除していた
- タイマーの読み取りや書き込みを行うすべての操作で、グローバルな同期が必要だった
ロックによる保護を必要とする共有データ構造の使用が、大きなオーバーヘッドを引き起こしていました。
スレッドローカルストレージによるグローバル状態の排除
ここでは、スレッドローカルストレージによって共有状態の必要性をなくし、ロック競合を解消しました。現在では、各スレッドが独自の timer_id を保持しています。これにより共有状態とスレッド同期のオーバーヘッドを回避できます。タイマーを更新する際、ロックを取得する必要はなくなりました。
技術的ソリューション
/// Original code
class QueryProfiler
{
static global_mutex timer_management_lock
void startProfiling()
{
timer_id = create_new_timer(); /// Expensive system call
acquire_exclusive_lock(timer_management_lock); /// Global lock!
update_shared_timer_state(timer_id); /// Modify shared state
release_lock(timer_management_lock);
}
void stopProfiling()
{
acquire_exclusive_lock(timer_management_lock);
cleanup_shared_timer_state(timer_id);
release_lock(timer_management_lock);
delete_timer(timer_id);
}
}/// Optimized code
class QueryProfiler
{
static thread_local timer_id per_thread_timer;
static thread_local boolean timer_initialized;
void startProfiling()
{
if (!timer_initialized)
{
per_thread_timer = create_new_timer(); /// Once per thread
timer_initialized = true;
}
/// Reuse existing timer - no locks, no system calls!
enable_timer(per_thread_timer);
}
void stopProfiling()
{
/// Just disable timer - no deletion, no locks!
disable_timer(per_thread_timer);
}
}性能への影響
新しい実装には以下の利点があります。
- プロファイリングトレースからタイマー関連のロック競合ホットスポットを排除
- 再利用によりタイマーの作成・削除を行うシステムコールを削減
- 超多コアサーバーでのプロファイリングのスケーラビリティを向上
スレッドローカルストレージは、共有状態の必要性を排除することでロック競合を解消できます。スレッドが独自の状態を保持すれば、グローバルな同期は不要になります。
ボトルネック 2: メモリ管理
超多コアシステムにおけるメモリの最適化は、シングルスレッドのメモリ管理とは大きく異なります。メモリアロケータ自体が競合ポイントとなり、メモリ帯域幅はより多くのコアに分散され、小規模システムでは問題なく動作する割り当てパターンが、大規模環境では連鎖的な性能問題を引き起こすことがあります。どれだけのメモリを割り当て、どのようにメモリを使用するかについて細心の注意を払うことが極めて重要です。
このカテゴリの最適化には、アロケータの挙動の調整、メモリ帯域幅への負荷軽減、場合によってはメモリ集約型の操作を完全に排除するためのアルゴリズムの根本的な再考が含まれます。
最適化 2.1: Jemalloc のメモリ再利用の最適化 (PR #80245)
この最適化は、超多コアシステム上の特定の集約クエリで観察された、高いページフォールト率と過剰な実メモリ使用量に対処するために実施されました。
ClickHouse における 2 レベルハッシュテーブルの仕組み
ClickHouse の集約処理では、データ型、データ分布、データサイズに応じて異なるハッシュテーブルが使用されます。大きな集約状態はエフェメラルハッシュテーブルで保持されます。
- 1st レベルは 256 個の静的バケットで構成され、それぞれが 2nd レベルハッシュテーブルを指します。
- 2nd レベルハッシュテーブルは、互いに独立して拡大します。
2 レベルハッシュテーブルにおけるメモリ再利用
集約クエリの終了時には、クエリで使用されたすべてのハッシュテーブルが解放されます。具体的には、256 個のサブハッシュテーブルが解放され、そのメモリはより大きな空きメモリブロックへとマージされます。
しかし、jemalloc(ClickHouse のメモリアロケータ)は、マージされたメモリブロックを将来のより小さなメモリ割り当てに再利用することを妨げていました。これはデフォルトで、要求されたサイズの最大 64 倍までのブロックのメモリしか再利用できないためです。jemalloc におけるこの問題は非常に検知しにくいものですが、超多コアシステムでは致命的となります。
jemalloc の issue #2842 に基づき、2 レベルハッシュテーブル特有の不規則なサイズの割り当てに対して、jemalloc のメモリ再利用に根本的な問題があることに気づきました。
- エクステント管理の問題: 大きな割り当てが解放された際、jemalloc はこれらのメモリエクステントを効率的に追跡および再利用できません。
- サイズクラスの断片化: 将来の割り当てパターンと一致しないサイズクラスにメモリが取り残されます。
- メタデータのオーバーヘッド: 過剰なメタデータ構造により、効率的なメモリの合体(コアレッシング)が妨げられます。
- ページフォールトの増幅: 既存のコミット済みページを再利用する代わりに、新たな割り当てによってページフォールトが発生します。
私たちは jemalloc の lg_extent_max_active_fit パラメータが根本原因であることを突き止めました。このパラメータは ClickHouse の割り当てパターンに対して制限が厳しすぎました。
私たちは jemalloc PR #2842 に修正を投稿しましたが、jemalloc は長期間にわたって新しい安定版リリースがありませんでした。幸いなことに、コンパイル時に jemalloc の設定パラメータを指定することで、この問題を解決できました。
ClickHouse の PR #80245 に基づき、jemalloc の設定パラメータを調整することで修正を行いました。
/// Original jemalloc configuration
JEMALLOC_CONFIG_MALLOC_CONF = "oversize_threshold:0,muzzy_decay_ms:0,dirty_decay_ms:5000"
/// lg_extent_max_active_fit defaults to 6, meaning memory can be reused from extents up to 64x larger than the requested allocation size/// Optimized jemalloc configuration
JEMALLOC_CONFIG_MALLOC_CONF = "oversize_threshold:0,muzzy_decay_ms:0,dirty_decay_ms:5000,lg_extent_max_active_fit:8"
/// lg_extent_max_active_fit is set to 8.
/// This allows memory reuse from extents up to 256x larger
/// than the requested allocation size (2^8 = 256x vs default 2^6 = 64x).
/// The 256x limit matches ClickHouse's two-level hash table structure (256 buckets).
/// This enables efficient reuse of merged hash table memory blocks.性能への影響
この最適化により、以下が改善されました。
- ClickBench クエリ Q35 の性能が 96.1% 向上
- 同クエリのメモリ使用量(VmRSS、実メモリ)が 45.4% 削減され、ページフォールトが 71% 減少
メモリアロケータの挙動は、超多コアシステムに劇的な影響を与える可能性があります。
最適化 2.2: メモリ削減のための AST クエリ書き換え (PR #57853)
ClickBench クエリ Q29 はメモリバウンドであり、sum(column + literal) の形式による冗長な計算が引き起こす過剰なメモリアクセスがボトルネックになっていました。
メモリボトルネックの把握
ClickBench クエリ Q29 には、リテラルを含む複数の sum 式が含まれています。
SELECT SUM(ResolutionWidth), SUM(ResolutionWidth + 1), SUM(ResolutionWidth + 2),
SUM(ResolutionWidth + 3), SUM(ResolutionWidth + 4), SUM(ResolutionWidth + 5),
SUM(ResolutionWidth + 6), SUM(ResolutionWidth + 7), SUM(ResolutionWidth + 8),
SUM(ResolutionWidth + 9), SUM(ResolutionWidth + 10), SUM(ResolutionWidth + 11),
SUM(ResolutionWidth + 12), SUM(ResolutionWidth + 13), SUM(ResolutionWidth + 14),
SUM(ResolutionWidth + 15), SUM(ResolutionWidth + 16), SUM(ResolutionWidth + 17),
SUM(ResolutionWidth + 18), SUM(ResolutionWidth + 19), SUM(ResolutionWidth + 20),
-- ... continues up to SUM(ResolutionWidth + 89)
FROM hits;元のクエリ実行では、
- ストレージから「ResolutionWidth」カラムを 1 回読み込み、
- 式を計算して一時カラムを 90 個作成し(式ごとに 1 つ)、
- 計算された各カラムに対して 90 回の個別の集約操作を実行して値を合計していました。
90 個の一時カラムを作成し、90 回の冗長な集約を実行することは、明らかに膨大なメモリ負荷を生み出していました。
メモリ効率を高めるフロントエンドクエリ最適化
この最適化は、より優れたオプティマイザルールによって冗長な計算を排除し、メモリ負荷を軽減できることを示しています。重要な知見は、多くの分析クエリには代数的に簡略化できるパターンが含まれているということです。
この最適化では、sum(column + literal) を sum(column) + count(column) * literal に書き換え可能であることを認識します。
性能への影響
- 2×80 vCPU システムにおいて、ClickBench クエリ Q29 が 11.5 倍高速化
- ClickBench の全クエリの相乗平均で全体として 5.3% の向上を達成
実行処理そのものを最適化するよりも、よりインテリジェントなクエリプランを作成するほうが効果的な場合があります。処理を効率的に行うことよりも、処理そのものを回避することのほうが優れています。
ボトルネック 3: 並列度の向上
高速な集約処理は、あらゆる分析データベースの根幹をなす強みです。データベースの観点からは、並列スレッドでデータを集約することは課題の半分に過ぎません。ローカルの結果を並列にマージすることも同様に重要です。
ClickHouse の集約オペレータには 2 つのフェーズがあります。第 1 フェーズでは、各スレッドがデータの担当部分を並列に処理し、ローカルの部分結果を作成します。第 2 フェーズでは、すべての部分結果をマージする必要があります。このマージフェーズが適切に並列化されていないと、そこがボトルネックになります。スレッド数を増やすとマージすべき部分結果が増えるため、実際にはこの問題が悪化する可能性があります。
この問題を解決するには、綿密なアルゴリズム設計、適切なデータ構造の選択、そして異なる負荷パターン下でハッシュテーブルがどのように動作するかについての深い理解が必要です。目標は、直列なマージフェーズを排除し、最も複雑な集約クエリであっても線形スケーリングを実現することです。
最適化 3.1: ハッシュテーブルの変換 (PR #50748)
ClickBench クエリ Q5 では、コア数が 80 スレッドから 112 スレッドに増加するにつれて深刻な性能低下が見られました。パイプライン分析を行ったところ、ハッシュテーブルの変換において直列処理が行われていることが判明しました。
ClickHouse におけるハッシュテーブルの仕組み
ClickHouse は、ハッシュ集約に 2 種類のハッシュテーブルを使用します。
- シングルレベルハッシュテーブル: 小さなデータセットに適した(= より高速な)フラットなハッシュテーブルです。
- 2 レベルハッシュテーブル: 256 個のバケットを持つ階層型ハッシュテーブルです。2 レベルハッシュテーブルは、大規模なデータセットにより適しています。
データベースは処理するデータのサイズに基づいて適切なハッシュテーブルタイプを選択します。集約中にシングルレベルハッシュテーブルが一定のしきい値に達すると、自動的に 2 レベルハッシュテーブルに変換されます。異なるタイプのハッシュテーブルをマージするコードは直列化されていました。
直列化のボトルネック
異なるスレッドのハッシュテーブルをマージする際、
- シングルレベルハッシュテーブルは、ht1 / ht2 → 結果、次に 結果 / ht3 のように、ペアごとに直列にマージされていました。
- 2 レベルハッシュテーブルも 1 つずつマージされますが、バケット間でマージが並列化されます。
シングルレベルと 2 レベルのハッシュテーブルが混在している場合、まずシングルレベルハッシュテーブルを 2 レベルハッシュテーブルに変換する必要がありました(これは直列処理でした)。それが完了して初めて、得られた 2 レベルハッシュテーブルを並列にマージできました。
Q5 では、スレッド数を 80 から 112 に増やすと、各スレッドが処理するデータ量が減ることを意味していました。80 スレッドでは、すべてのハッシュテーブルが 2 レベルでした。112 スレッドでは集約結果が混在シナリオとなり、一部のハッシュテーブルはシングルレベルのままで、他のハッシュテーブルは 2 レベルになりました。これにより、並列マージを実行する前にすべてのシングルレベルハッシュテーブルを 2 レベルに変換しなければならず、直列化が発生しました。
問題を診断する上で、パイプラインの可視化は極めて重要なツールでした。顕著な兆候として、スレッド数の増加に伴ってマージフェーズの所要時間が長くなっていました。これは、本来あるべき挙動とは正反対です。
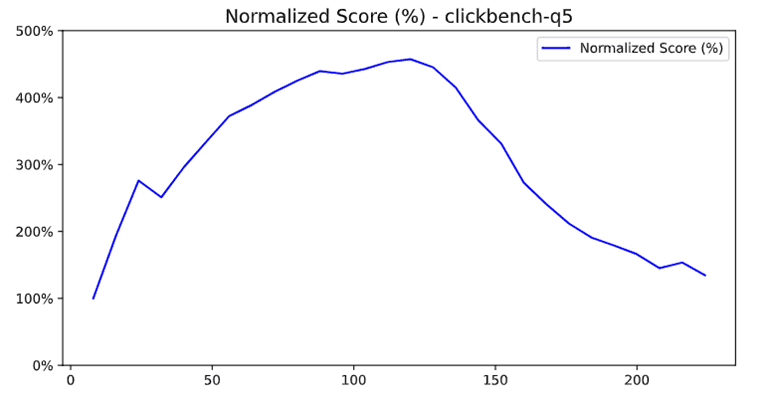
コア数の増加に伴う性能低下
 パイプラインの可視化(max_threads=80)- マージフェーズは妥当
 パイプラインの可視化(max_threads=112)- マージフェーズに 3.2 倍の時間がかかる
私たちの最適化では、変換フェーズを並列化しました。すべてのシングルレベルハッシュテーブルを 1 つずつ(直列に)2 レベルハッシュテーブルに変換するのではなく、並列に変換するようにしました。各ハッシュテーブルは独立して変換できるため、これにより直列化のボトルネックが排除されます。
/// Original code
void mergeHashTable(left_table, right_table)
{
if (left_table.is_single_level() && right_table.is_two_level())
left_table.convert_to_two_level(); /// Serial conversion blocks threads
/// Now merge
merge_sets(left_table, right_table);
}/// Optimized code
void mergeHashTableParallel(all_tables)
{
/// Phase 1: Parallel conversion
parallel_tasks = [];
for (const auto & table : all_tables)
{
if (table.is_single_level())
{
/// Parallel conversion!
task = create_parallel_task(table.convert_to_two_level());
parallel_tasks.add(task);
}
}
/// Wait for all conversions to complete
wait_for_all_tasks(parallel_tasks);
/// Phase 2: Now all sets are two-level, merge efficiently.
for (const auto & pair : all_tables)
merge_sets(pair.left_table, pair.right_table);
}性能への影響
性能が向上したのは Q5 だけではありません。この最適化により、超多コアシステムにおけるあらゆる集約負荷の高いクエリで線形スケーリングが可能になりました。
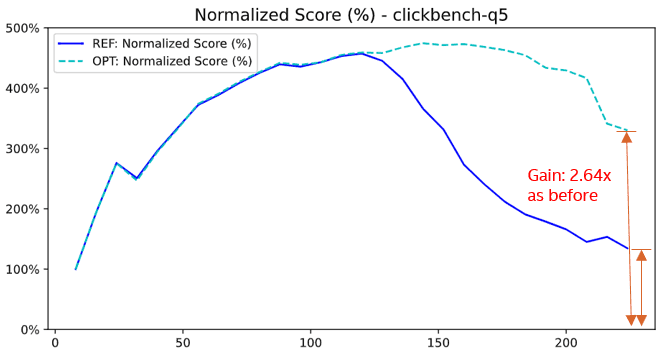
並列変換後の性能向上 - Q5 で 264% の向上を達成
- 2×112 vCPU システムにおいて、ClickBench クエリ Q5 が 264% 向上
- 24 個のクエリで 5% 以上の向上を達成
- 全体の相乗平均が 7.4% 向上
この最適化は、スケーラビリティの向上とは単に並列度を高めることだけではなく、並列度に応じて増大する直列処理部分を排除することでもあると証明しています。単にスレッドを追加するだけでなく、アルゴリズムをより深いレベルで再構築しなければならない場合もあります。
最適化 3.2: シングルレベルハッシュテーブルのマージ (PR #52973)
すべてのハッシュテーブルがシングルレベルである場合にも、性能が最適ではないことに気づきました。
並列マージのシングルレベルへの拡張
PR #50748 を発展させたこの最適化では、並列マージの利点が混在ハッシュテーブルだけに限定されないことを認識しています。すべてのハッシュテーブルがシングルレベルであっても、総データサイズが十分に大きければ、並列マージによって性能を向上させることができます。
課題となったのは、シングルレベルハッシュテーブルをどのタイミングで並列マージすべきかを判断することでした。
- データセットが小さすぎる場合、並列化によって余分なオーバーヘッドが生じます。
- データセットが大きすぎる場合、並列化による十分なメリットが得られない可能性があります。
PR #52973 の実装に基づき、この最適化ではすべてのシングルレベルのケースに並列マージを追加しました。
/// Before: Only parallelize mixed-level merges
void parallelizeMergePrepare(hash_tables)
{
single_level_count = 0;
for (const auto & hash_table : hash_tables)
if hash_table.is_single_level():
single_level_count++;
/// Only convert if mixed levels (some single, some two-level)
if single_level_count > 0 and single_level_count < hash_tables.size():
convert_to_two_level_parallel(hash_tables);
}/// Optimized code
void parallelizeMergePrepare(hash_tables):
{
single_level_count = 0;
all_single_hash_size = 0;
for (const auto & hash_table : hash_tables)
if (hash_table.is_single_level())
single_level_count++
/// Calculate total size if all hash tables are single-level
if (single_level_count == hash_tables.size())
for (const auto & hash_table : hash_tables)
all_single_hash_size += hash_table.size();
/// Convert if mixed levels OR if all single-level with average size > THRESHOLD
if (single_level_count > 0 and single_level_count < hash_tables.size())
||
(all_single_hash_size / hash_tables.size() > THRESHOLD)
convert_to_two_level_parallel(hash_tables);
}性能への影響
- シングルレベルのマージシナリオにおける性能が 235% 向上
- 体系的なテストを通じて最適なしきい値を特定
- 小規模なデータセットでのリグレッションはなし
最適化 3.3: キーをサポートした並列マージ (PR #68441)
サイズの大きなハッシュテーブルを用いた GROUP BY 操作は、直列にマージされていました。
キー付き集約への並列化の拡張
これまでの 2 つの最適化(3.1 および 3.2)は、キーのないマージ、すなわち COUNT(DISTINCT) のような単純なハッシュテーブル操作を対象としていました。この最適化を、一般的な GROUP BY セマンティクスのように、ハッシュテーブルがキーと結合対象の集約値の双方を含むキー付きマージにも適用しました。
性能への影響:
- ClickBench クエリ Q8 が 10.3%、Q9 が 7.6% 向上
- 他のクエリでのリグレッションはなし
- マージフェーズ中の CPU 使用率が向上
キャンセル処理やエラー処理に細心の注意を払うことで、並列マージを複雑な集約シナリオへと拡張できます。
ボトルネック 4: アルゴリズムの最適化
SIMD 命令の真価を引き出すのは極めて困難です。コンパイラはベクトル化に対して保守的であり、データベースのワークロードには自動ベクトル化を妨げる複雑な制御フローがしばしば存在します。
データベースで SIMD 命令を効果的に活用するには、従来のベクトル化の枠組みを超えて考える必要があります。1 つのデータではなく N 個のデータ項目を同時に処理するだけでなく、並列 SIMD 比較を利用してスマートなプルーニング(枝刈り)戦略を適用し、処理全体の作業量を削減することも可能です。このアプローチは文字列操作において特に威力を発揮します。文字列操作は実際の利用頻度が高い一方で、計算コストが非常に大きいためです。
最適化 4.1: 2 文字による SIMD 文字列検索 (PR #46289)
文字列検索(単純な部分文字列検索や LIKE パターン検索など)は、ClickBench クエリ Q20 をはじめとする多くのクエリでボトルネックとなります。
分析クエリにおける文字列検索の理解
ClickBench クエリ Q20 は数百万件の URL に対して LIKE パターンを評価するため、高速な文字列検索が不可欠です。
SELECT COUNT(*) FROM hits WHERE URL LIKE '%google%'2 文字フィルタリングによる偽陽性の削減
PR #46289 は、単純な力まかせの並列化を超えて、SIMD 命令をスマートに活用できるという洞察に基づいています。元のコードでも SIMD 命令を使用していましたが、検索パターンの 1 文字目しか考慮していなかったため、高コストな偽陽性が多数発生していました。そこで、2 文字目もチェックするようにコードを書き直しました。これにより、ごくわずかな SIMD 演算を追加するだけで選択性を大幅に向上させることができました。
/// Original code
class StringSearcher
{
first_needle_character = needle[0];
first_needle_character_vec = broadcast_to_simd_vector(first_needle_character);
void search()
{
for (position in haystack; step by 16 bytes)
{
haystack_chunk = load_16_bytes(haystack + position);
first_matches = simd_compare_equal(haystack_chunk, first_needle_character_vec);
match_mask = extract_match_positions(first_matches);
for (const auto & match : match_mask)
/// High false positive rate - many expensive verifications
if (full_string_match(haystack + match_pos, needle))
return match_pos;
}
}
}// Optimized code
class StringSearcher
{
first_needle_character = needle[0];
second_needle_character = needle[1]; /// Second character
first_needle_character_vec = broadcast_to_simd_vector(first_needle_character);
second_needle_character_vec = broadcast_to_simd_vector(second_needle_character);
void search()
{
for (position : haystack, step by 16 bytes)
{
haystack_chunk1 = load_16_bytes(haystack + position);
haystack_chunk2 = load_16_bytes(haystack + position + 1);
/// Compare both characters simultaneously
first_matches = simd_compare_equal(haystack_chunk1, first_needle_character_vec);
second_matches = simd_compare_equal(haystack_chunk2, second_needle_character_vec);
combined_matches = simd_and(first_matches, second_matches);
match_mask = extract_match_positions(combined_matches);
for (const auto & match : match_mask)
// Dramatically fewer false positives - fewer expensive verifications
if full_string_match(haystack + match_pos, needle):
return match_pos;
}
}
}性能への影響
2 文字の SIMD フィルタリングにより、性能が大幅に向上しました。
- ClickBench クエリ Q20 が 35% 高速化
- 部分文字列一致を実行する他のクエリでも全体で約 10% の向上
- すべてのクエリの相乗平均が 4.1% 向上
この性能向上は、偽陽性の削減、キャッシュ局所性の改善、分岐予測の効率化によってもたらされたものです。
2 文字による SIMD フィルタリングは、効果的な SIMD 最適化が単に「1 命令あたりのデータ処理量を増やす」だけにとどまらず、SIMD の並列比較能力を活用してアルゴリズム自体の効率を高めることでもあると示しています。このアプローチは、わずかな追加 SIMD 演算によって極めて大きな性能向上が得られるケースがあることを物語っています。
ボトルネック 5: 偽共有(False Sharing)
偽共有は、複数のスレッドが同一キャッシュライン上の変数にアクセスするときに発生します。CPU のキャッシュコヒーレンシプロトコルはキャッシュラインの粒度で動作するため、2 つの異なる変数に対する変更であっても、同一キャッシュラインへの変更は競合として扱われ、コア間で高コストな同期が必要になります。2×240 vCPU システムでは、偽共有によって単純なカウンタのインクリメントがシステム全体の深刻な性能低下を引き起こすおそれがあります。
偽共有を排除するには、ハードウェアレベルで CPU のキャッシュコヒーレンシがどのように実装されているかを理解する必要があります。アルゴリズムを最適化するだけでは不十分で、偽共有を避けるためには、頻繁にアクセスされるデータ構造がキャッシュラインの競合によって意図せず干渉し合わないよう、メモリレイアウトも最適化しなければなりません。これには、たとえば戦略的なデータレイアウトの設計や、アライメントおよびパディングの活用が含まれます。
最適化 5.1: プロファイルイベントカウンタのアライメント (PR #82697)
2×240 vCPU システムにおいて、ClickBench クエリ Q3 では CPU サイクルの 36.6% が ProfileEvents::increment で消費されていることが判明しました。性能プロファイリングの結果、キャッシュラインの深刻な競合が明らかになりました。
大規模環境における ProfileEvents カウンタ
プロファイルイベントカウンタは、ClickHouse の内部イベント監視システムです。詳細なクエリ実行ステップからメモリ割り当てに至るまで、すべての内部操作を追跡します。一般的な分析クエリでは、これらのカウンタは全スレッドで数百万回インクリメントされます。元の実装では、キャッシュラインの境界を考慮せずに複数のカウンタが同一メモリ領域に配置されていました。
これにより、次の 3 つの課題が生じていました。
-
キャッシュラインの物理的制約: 最近の Intel プロセッサは 64 バイトのキャッシュラインを使用しています。キャッシュライン内のいずれかのバイトが変更されると、他のコアのキャッシュにあるライン全体を無効化しなければなりません。
-
偽共有の増幅: 240 スレッドの環境では、カウンタが 1 回更新されるたびに、数十ものコアにわたってキャッシュラインの無効化が引き起こされる可能性があります。本来は独立しているはずの操作が、キャッシュコヒーレンシプロトコルによって直列化されてしまいます。
-
急激な性能低下: コア数が増加するにつれて、同一キャッシュラインへの同時アクセスが発生する確率は急激に高まり、キャッシュミスの影響が相乗的に悪化します。
perf を使用した調査により、ProfileEvents::increment が大量のキャッシュコヒーレンシトラフィックを発生させていることを突き止めました。決定的な証拠となったのは、1 本のキャッシュラインに 8 個もの異なるカウンタが詰め込まれていることを示すキャッシュライン使用状況レポートでした。私たちは Linux の perf c2c ツールに新機能を追加し、コミュニティとも協力して、開発者がこうした偽共有の問題をより容易に特定できるようにしました。
 ProfileEvents::increment でサイクルの 36.6% が消費されていることを示す perf の分析結果
適切なキャッシュラインアライメントを行うことで、各カウンタに独立した 64 バイトのキャッシュラインが確実に割り当てられます。これにより、偽共有(望ましくない状態)が真の共有(制御可能な状態)へと変化します。スレッドがカウンタを更新しても、影響を受けるのは単一のキャッシュラインのみとなります。
PR #82697 での実装に基づき、この修正ではプロファイルイベントカウンタのキャッシュラインアライメントを改善しました。
// Before: Counters packed without alignment
struct ProfileEvents:
atomic_value counters[NUM_EVENTS] // Multiple counters per cache line
// 8 counters sharing single 64-byte cache lines
// After: Cache line aligned counters
struct ProfileEvents:
struct alignas(64) AlignedCounter:
atomic_value value
// Padding automatically added to reach 64 bytes
AlignedCounter counters[NUM_EVENTS] // Each counter gets own cache line
// Now each counter has exclusive cache line ownership性能への影響
この最適化パターンは、頻繁に更新される共有かつコンパクトなあらゆるデータ構造に適用できます。ここから得られる教訓は、大規模環境ではメモリレイアウトが決定的に重要になるということです。8 コアでは問題なく動作する処理も、240 コアでは極端に遅くなる可能性があります。
 最適化後: ProfileEvents::increment のサイクル消費が 36.6% から 8.5% へ減少
この最適化の結果、超高コア数システムにおいて ClickBench クエリ Q3 が 27.4% 向上しました。キャッシュコヒーレンシのオーバーヘッドはコア数に対して超線形に増加するため、性能の向上幅はコア数が多くなるほど顕著になります。したがって、この最適化は単にボトルネックを解消しただけでなく、スケーラビリティのカーブそのものを変えるものとなりました。
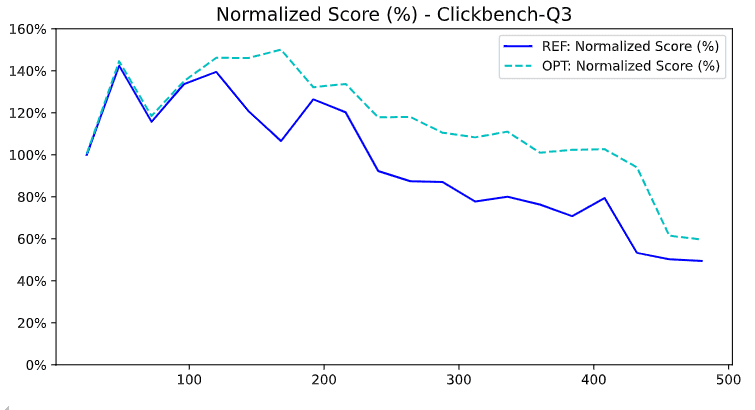 ClickBench Q3: 27.4% の向上。より高コアのシステムほどゲインが拡大
スケーラブルな基盤の構築
本記事では、次の 5 つの性能ボトルネックに対する最適化を取り上げました。
- ロック競合 - コア数の増加に伴い、協調オーバーヘッドが急激に増大します。
- メモリ最適化 - コア数の増加に伴い、1 コアあたりのメモリ帯域幅が減少します。
- 並列度の向上 - 直列処理フェーズが主要なボトルネックになります。
- SIMD の最適化 - 単純なベクトル化を超えた 2 文字フィルタリングのようなスマートなアルゴリズムにより、性能を大幅に向上させることができます。
- 偽共有 - キャッシュラインサイズの粒度に起因して発生します。
ここで紹介したボトルネックと最適化は、ClickHouse だけにとどまる話ではありません。超高コア数時代におけるデータベース最適化の根本的なアプローチの転換を示しています。プロセッサがさらなる多コア化を進める中、スケーラビリティを必要とするあらゆるシステムにおいて、これらの技術は不可欠なものとなるでしょう。
私たちの最適化によって、ClickHouse はコア数の増加に対してほぼ線形なスケーラビリティを達成できるようになりました。これにより、Intel をはじめとするハードウェアメーカーがコア数を数千単位へと引き上げていく将来においても、ClickHouse は分析用データベースとして確固たる強みを発揮し続けることができます。

参考資料およびリソース
- ソースコード: すべての最適化は ClickHouse の main ブランチで利用可能です
- スライド資料: 2025 Shanghai Meetup Presentation
- プルリクエスト: 詳細な性能分析を含む個別の PR へのリンクは本記事の随所に掲載しています
- Intel Intrinsics Guide: Intel® Intrinsics Guide
謝辞
厳密なコードレビューと性能検証を行ってくださった ClickHouse コミュニティに深く感謝いたします。これらの最適化は、最新の超高コア数プロセッサの潜在能力を最大限に引き出すための、Intel と ClickHouse 両チームによる共同の取り組みの成果です。
実装の詳細や性能の再現に関するご質問は、本記事内の各リンク先にある PR のディスカッションをご参照ください。