

INSERT, UPDATE, DELETE 작업을 기준으로 변경 사항을 스트리밍하는 더 높은 수준의 추상화입니다. 물리적 복제로도 동일한 결과를 얻을 수 있지만, 특정 테이블과 작업만 대상으로 지정하거나 데이터 변환을 수행하고 서로 다른 Postgres 버전을 지원하는 측면에서는 논리적 복제가 더 큰 유연성을 제공합니다.
반면 ClickHouse의 세그먼트와 레플리카는 데이터 분산과 중복성에 관한 두 가지 핵심 개념입니다. ClickHouse 레플리카는 최종 일관성(eventual consistency)을 가지며 프라이머리라는 개념이 없다는 점을 제외하면 Postgres 레플리카와 유사하다고 볼 수 있습니다. 또한 세그먼트 분할은 Postgres와 달리 네이티브로 지원됩니다.
세그먼트는 테이블 데이터의 일부입니다. 항상 최소 1개의 세그먼트가 존재합니다. 데이터를 여러 서버에 걸쳐 세그먼트 분할하면 단일 서버의 용량을 초과할 때 부하를 분산할 수 있으며, 모든 세그먼트가 병렬로 쿼리를 실행하는 데 사용됩니다. 서로 다른 서버에서 테이블용 세그먼트를 수동으로 생성하고 데이터도 직접 삽입할 수 있습니다. 또는 데이터가 어느 세그먼트로 라우팅될지 정의하는 sharding key와 함께 분산 테이블을 사용할 수도 있습니다. sharding key는 random일 수도 있고 hash function의 출력값일 수도 있습니다. 중요한 점은 하나의 세그먼트가 여러 레플리카로 구성될 수 있다는 것입니다.
레플리카는 데이터의 복사본입니다. ClickHouse는 항상 최소 1개의 데이터 복사본을 가지므로 레플리카의 최소 개수는 1입니다. 데이터의 두 번째 레플리카를 추가하면 장애 허용이 향상되고, 더 많은 쿼리를 처리하기 위한 추가 컴퓨트도 확보할 수 있습니다(병렬 레플리카를 사용하면 단일 쿼리의 컴퓨트도 분산할 수 있어 지연 시간을 낮출 수 있습니다). 레플리카는 ReplicatedMergeTree 테이블 엔진을 통해 구현되며, 이를 통해 ClickHouse는 서로 다른 서버에 있는 여러 데이터 복사본을 동기화된 상태로 유지할 수 있습니다. 복제는 물리적으로 이루어집니다. 즉, 노드 간에는 쿼리가 아니라 압축된 파트만 전송됩니다.
요약하면, 레플리카는 중복성과 신뢰성(그리고 경우에 따라 분산 처리)을 제공하는 데이터 복사본이며, 세그먼트는 분산 처리와 부하 분산을 가능하게 하는 데이터의 부분 집합입니다.
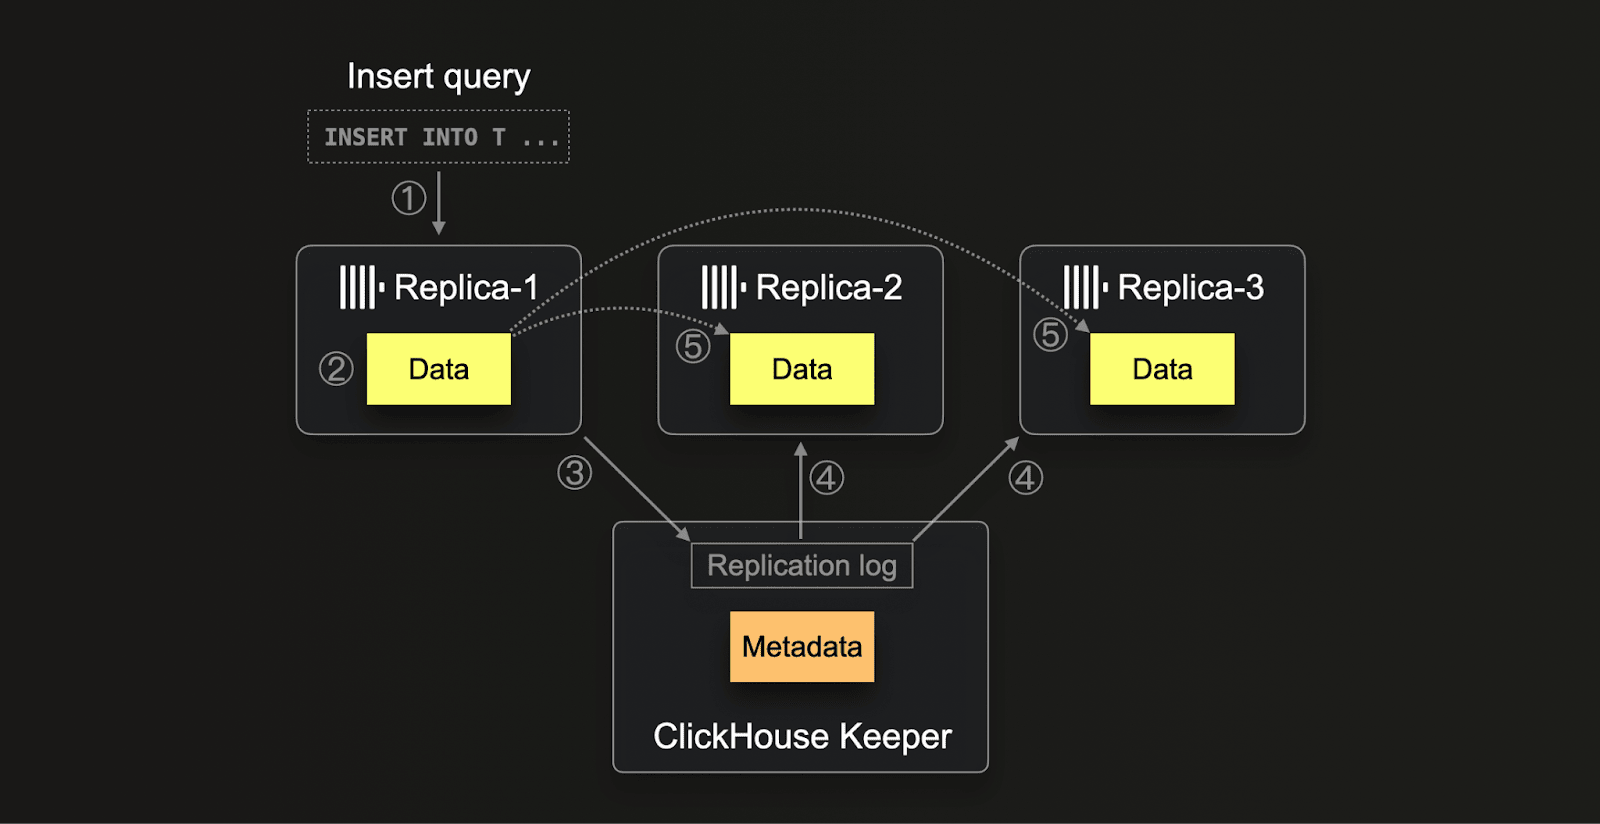
ClickHouse Cloud는 S3에 저장된 단일 데이터 복사본과 여러 컴퓨트 레플리카를 사용합니다. 데이터는 각 레플리카 노드에서 사용할 수 있으며, 각 노드에는 로컬 SSD 캐시가 있습니다. 이는 ClickHouse Keeper를 통한 메타데이터 복제에만 의존합니다.ClickHouse는 내부 복제 메커니즘을 관리하기 위해 ClickHouse Keeper(C++로 구현된 ZooKeeper 구현체이며, ZooKeeper도 사용할 수 있음)를 사용하며, 주로 메타데이터 저장과 최종 일관성 보장에 중점을 둡니다. Keeper는 분산 환경에서 각 삽입에 고유한 순차 번호를 할당하는 데 사용됩니다. 이는 작업 전반에서 순서와 일관성을 유지하는 데 매우 중요합니다. 또한 이 프레임워크는 머지 및 뮤테이션과 같은 백그라운드 작업도 처리하며, 이러한 작업이 분산되어 수행되면서도 모든 레플리카에서 동일한 순서로 실행되도록 보장합니다. 메타데이터 외에도 Keeper는 저장된 데이터 파트의 체크섬 추적을 포함해 복제 전반을 제어하는 포괄적인 제어 센터 역할을 하며, 레플리카 간 분산 알림 시스템으로도 작동합니다. ClickHouse의 복제 프로세스는 (1) 데이터가 임의의 레플리카에 삽입될 때 시작됩니다. 이 데이터는 원시 삽입 형태 그대로 (2) 체크섬과 함께 디스크에 기록됩니다. 기록이 완료되면 해당 레플리카는 (3) 고유한 블록 번호를 할당하고 새 파트의 세부 정보를 기록하여 이 새로운 데이터 파트를 Keeper에 등록하려고 시도합니다. 다른 레플리카는 복제 로그의 새 항목을 (4) 감지하면, (5) 내부 HTTP 프로토콜을 통해 해당 데이터 파트를 다운로드하고 ZooKeeper에 기록된 체크섬과 대조해 검증합니다. 이 방식은 처리 속도가 다르거나 지연이 발생하더라도 모든 레플리카가 결국 일관되고 최신 상태의 데이터를 보유하도록 보장합니다. 또한 이 시스템은 여러 작업을 동시에 처리할 수 있어 데이터 관리 프로세스를 최적화하고, 시스템 확장성과 하드웨어 차이에 대한 견고성을 높입니다.
스티키 엔드포인트에 대한 액세스는 지원팀에 문의하십시오.OSS에서 이러한 동작을 구현하는 방법은 세그먼트와 레플리카의 토폴로지, 그리고 쿼리에 분산 테이블을 사용하는지에 따라 달라집니다. 세그먼트가 하나이고 레플리카만 있는 경우(ClickHouse는 수직 확장이 일반적이므로 흔한 구성입니다), 사용자는 클라이언트 계층에서 노드를 선택하고 레플리카에 직접 쿼리하므로, 이 선택이 항상 같은 방식으로 이루어지도록 해야 합니다. 여러 세그먼트와 레플리카로 이루어진 토폴로지는 분산 테이블 없이도 가능하지만, 이러한 고급 배포는 일반적으로 자체 라우팅 인프라를 갖추고 있습니다. 따라서 세그먼트가 2개 이상인 배포는 분산 테이블을 사용한다고 가정합니다(분산 테이블은 단일 세그먼트 배포에도 사용할 수 있지만, 보통은 필요하지 않습니다). 이 경우
session_id 또는 user_id 같은 값을 기준으로 일관된 노드 라우팅이 수행되도록 해야 합니다. 설정 prefer_localhost_replica=0, load_balancing=in_order는 쿼리에서 설정해야 합니다. 이렇게 하면 각 세그먼트의 로컬 레플리카가 우선 선택되고, 로컬 레플리카가 없으면 구성에 나열된 순서대로 레플리카가 우선 선택됩니다. 단, 오류 수가 같아야 하며, 오류 수가 더 많으면 failover가 발생하고 무작위로 선택됩니다. 이러한 결정적 세그먼트 선택의 대안으로 load_balancing=nearest_hostname도 사용할 수 있습니다.
분산 테이블을 만들 때는 cluster를 지정해야 합니다. config.xml에 지정하는 이 cluster 정의에는 세그먼트(및 해당 레플리카)가 나열되므로, 사용자는 각 노드에서 사용 순서를 제어할 수 있습니다. 이를 통해 선택이 항상 같은 방식으로 이루어지도록 할 수 있습니다.
예외적인 상황에서는 순차 일관성이 필요할 수 있습니다.
데이터베이스의 순차 일관성이란 데이터베이스에 대한 연산이 어떤 순차적인 순서로 실행된 것처럼 보이며, 이 순서가 데이터베이스와 상호작용하는 모든 프로세스에서 동일하게 유지되는 것을 의미합니다. 즉, 모든 연산은 호출 시점과 완료 시점 사이의 어느 한 순간에 즉시 반영된 것처럼 보이고, 모든 프로세스가 관찰하는 연산 순서에는 단 하나의 합의된 순서가 존재합니다.
사용자 관점에서 이는 보통 ClickHouse에 데이터를 기록한 뒤 데이터를 읽을 때, 가장 최근에 삽입된 행이 반환되도록 보장해야 하는 요구로 나타납니다.
이는 다음과 같은 여러 방법으로 달성할 수 있습니다(권장 순서순).
- 동일한 노드에서 읽기/쓰기 - 네이티브 프로토콜을 사용하거나 HTTP를 통해 쓰기/읽기를 수행하는 세션을 사용하는 경우, 동일한 레플리카에 연결되어 있어야 합니다. 이 경우 쓰기를 수행한 노드에서 직접 읽으므로 읽기 결과는 항상 일관됩니다.
- 레플리카를 수동으로 동기화 - 한 레플리카에 쓰고 다른 레플리카에서 읽는 경우, 읽기 전에
SYSTEM SYNC REPLICA LIGHTWEIGHT를 실행할 수 있습니다. - 순차 일관성 활성화 - 쿼리 설정
select_sequential_consistency = 1로 활성화할 수 있습니다. OSS에서는insert_quorum = 'auto'설정도 함께 지정해야 합니다.
이 설정을 활성화하는 방법에 대한 자세한 내용은 여기를 참조하십시오.
순차 일관성을 사용하면 ClickHouse Keeper에 더 큰 부하가 발생합니다. 그 결과 삽입과 읽기가 더 느려질 수 있습니다. ClickHouse Cloud에서 기본 테이블 엔진으로 사용되는 SharedMergeTree는 순차 일관성 사용 시 오버헤드가 더 적고 확장성이 더 뛰어납니다. OSS에서는 이 방식을 신중하게 사용하고 Keeper 부하를 측정해야 합니다.PostgreSQL에서 마이그레이션하는 사용자는 ACID(Atomicity, Consistency, Isolation, Durability) 속성에 대한 PostgreSQL의 강력한 지원에 익숙할 수 있습니다. 이러한 특성 덕분에 PostgreSQL은 트랜잭션 데이터베이스에 적합한 신뢰할 수 있는 선택지로 여겨집니다. PostgreSQL의 atomicity는 각 transaction을 하나의 단위로 처리하여, 완전히 성공하거나 전체가 롤백되도록 함으로써 부분 업데이트를 방지합니다. consistency는 모든 데이터베이스 transaction이 유효한 상태에 도달하도록 constraints, triggers, 규칙을 적용해 유지됩니다. PostgreSQL은 Read Committed부터 Serializable까지의 isolation level을 지원하므로 concurrent transaction이 수행한 변경 사항의 가시성을 세밀하게 제어할 수 있습니다. 마지막으로 durability는 write-ahead logging(WAL)을 통해 보장되며, transaction이 한 번 커밋되면 시스템 장애가 발생하더라도 그 상태가 유지됩니다. 이러한 속성은 단일 진실 공급원(source of truth) 역할을 하는 OLTP 데이터베이스에서 일반적으로 기대되는 특성입니다. 이러한 기능은 강력하지만, 그에 따른 본질적인 제약도 있으며 PB 규모로 확장하기는 어렵습니다. ClickHouse는 높은 쓰기 처리량을 유지하면서 대규모에서 빠른 분석 쿼리를 제공하기 위해 이러한 속성 일부를 절충합니다. ClickHouse는 제한된 구성에서 ACID 속성을 제공합니다. 가장 단순한 예는 하나의 파티션을 사용하는 비복제 MergeTree 테이블 엔진 인스턴스입니다. 이러한 경우를 벗어나면 이런 속성을 기대해서는 안 되며, 이것이 필수 요구 사항이 아닌지 확인해야 합니다. ClickHouse’s 컬럼 지향 스토리지는 Postgres와 비교할 때 압축 효율이 훨씬 더 뛰어난 경우가 많습니다. 다음은 두 데이터베이스에서 모든 Stack Overflow 테이블의 스토리지 요구 사항을 비교한 예시입니다:
Query (Postgres)
Query (ClickHouse)
Response