

- 기본 타입 - 키의 값이 기본 타입이라면, 하위 객체에 있든 루트에 있든 관계없이 일반적인 스키마 설계 모범 사례와 타입 최적화 규칙에 따라 타입을 선택해야 합니다. 아래
phone_numbers와 같은 기본 타입 배열은Array(<type>)(예:Array(String))로 모델링할 수 있습니다. - 정적 vs 동적 - 키의 값이 복합 객체, 즉 객체 또는 객체 배열인 경우, 해당 값이 변경될 가능성이 있는지 판단하십시오. 새 키가 거의 추가되지 않고, 새 키가 추가되더라도 이를 예측하여
ALTER TABLE ADD COLUMN을 통한 스키마 변경으로 처리할 수 있다면 정적이라고 볼 수 있습니다. 여기에는 일부 JSON 문서에서 일부 키만 제공되는 객체도 포함됩니다. 반대로 새 키가 자주 추가되거나 예측할 수 없는 객체는 동적이라고 봐야 합니다. 단, 수백 개 또는 수천 개의 하위 키를 가진 구조는 편의상 동적으로 간주할 수 있습니다.
- 루트 키
name,username,email,website는String유형으로 표현할 수 있습니다.phone_numbers컬럼은Array(String)유형의 배열 원시 타입이며,dob와id의 유형은 각각Date와UInt32입니다. address객체에는 새 키가 추가되지 않고(새 address 객체만 추가됨), 따라서 정적으로 간주할 수 있습니다. 재귀적으로 보면 모든 서브컬럼은geo를 제외하고 원시 타입(유형은String)으로 간주할 수 있습니다.geo역시lat와lon이라는 두 개의Float32컬럼으로 이루어진 정적 구조입니다.tags컬럼은 동적입니다. 어떤 유형과 구조이든 새로운 임의의 태그가 이 객체에 추가될 수 있다고 가정합니다.company객체는 정적이며, 지정된 최대 3개의 키만 항상 포함합니다. 서브키name과catchPhrase의 유형은String입니다.labels키는 동적입니다. 새로운 임의의 태그가 이 객체에 추가될 수 있다고 가정합니다. 값은 항상String유형의 key-value 쌍입니다.
수백 개 또는 수천 개의 정적 키를 가진 구조는 동적으로 간주할 수 있습니다. 이런 구조에서는 컬럼을 정적으로 선언하는 것이 현실적으로 드물기 때문입니다. 다만 가능하다면 스토리지와 추론 오버헤드를 모두 줄이기 위해 필요하지 않은 스킵 경로는 제외하십시오.
Tuple을 사용해 처리하는 것을 권장합니다. 객체 배열은 튜플 배열, 즉 Array(Tuple)로 저장할 수 있습니다. 튜플 내부의 컬럼과 각 컬럼의 타입도 동일한 규칙에 따라 정의해야 합니다. 이렇게 하면 아래와 같이 중첩된 객체를 표현하기 위해 중첩된 Tuple이 사용될 수 있습니다.
이를 설명하기 위해 앞서 사용한 JSON person 예시에서 동적 객체를 제외한 형태를 사용합니다:
company 컬럼이 Tuple(catchPhrase String, name String)으로 정의되어 있다는 점에 유의하세요. address 키는 Array(Tuple)를 사용하고, geo 컬럼을 나타내기 위해 중첩된 Tuple을 포함합니다.
현재 구조 그대로 JSON을 이 테이블에 삽입할 수 있습니다:
address.street 컬럼이 Array로 반환된다는 점에 유의하십시오. 배열 안의 특정 객체를 위치로 지정해 쿼리하려면 컬럼 이름 뒤에 배열 오프셋을 지정해야 합니다. 예를 들어 첫 번째 주소의 street에 접근하려면 다음과 같습니다:
24.12부터 정렬 키에서도 사용할 수 있습니다:
Tuple 타입은 JSON payload에 모든 컬럼이 포함되어 있을 필요가 없습니다. 제공되지 않은 경우에는 기본값이 사용됩니다.
앞서 살펴본 people 테이블과 suite, geo, phone_numbers, catchPhrase 키가 빠진 다음 희소 JSON을 살펴보겠습니다.
빈 값과 NULL 구분하기값이 비어 있는 경우와 값이 제공되지 않은 경우를 구분해야 한다면 Nullable 타입을 사용할 수 있습니다. 다만 이 타입은 해당 컬럼의 저장 공간과 쿼리 성능에 부정적인 영향을 주므로, 반드시 필요한 경우가 아니라면 사용을 피해야 합니다.
nickname 키를 추가한 수정된 JSON 페이로드입니다:
nickname 키를 무시하고도 성공적으로 삽입할 수 있습니다:
ALTER TABLE ADD COLUMN 명령을 사용해 스키마에 컬럼을 추가할 수 있습니다. DEFAULT 절로 기본값을 지정할 수 있으며, 이후 삽입 시 값이 지정되지 않으면 이 값이 사용됩니다. 이 값이 없는 행(컬럼이 생성되기 전에 삽입된 행)에도 이 기본값이 반환됩니다. DEFAULT 값이 지정되지 않으면 해당 유형의 기본값이 사용됩니다.
예시:
JSON 타입을 권장합니다.
좀 더 구체적으로는, 다음과 같은 경우 JSON 타입을 사용하십시오:
- 시간에 따라 달라질 수 있는 예측 불가능한 키가 있습니다.
- 타입이 서로 다른 값을 포함합니다(예: 경로에 어떤 경우에는 문자열이, 어떤 경우에는 숫자가 들어갈 수 있습니다).
- 엄격한 타입 지정이 현실적이지 않아 스키마 유연성이 필요합니다.
- 정적이기는 하지만 명시적으로 선언하기에는 현실적이지 않은 수백 개 또는 수천 개의 경로가 있습니다. 이런 경우는 대체로 드뭅니다.
company.labels 객체가 동적이라고 판단했습니다.
company.labels에 임의의 키가 포함된다고 가정해 보겠습니다. 또한 이 구조에서는 어떤 키든 타입이 행마다 일관되지 않을 수 있습니다. 예를 들면 다음과 같습니다:
company.labels 컬럼의 키와 타입이 달라질 수 있으므로, 이 데이터를 모델링하는 방법에는 여러 가지가 있습니다:
- 단일 JSON 컬럼 - 전체 스키마를 단일
JSON컬럼으로 표현하여, 그 하위의 모든 구조를 동적으로 처리할 수 있습니다. - 대상 지정 JSON 컬럼 -
company.labels컬럼에만JSON타입을 사용하고, 다른 모든 컬럼에는 위에서 사용한 구조화된 스키마를 그대로 유지합니다.
- 데이터 검증 – 엄격한 스키마를 적용하면 특정 구조를 제외하고는 컬럼 폭증 위험을 피할 수 있습니다.
- 컬럼 폭증 위험 방지 - JSON 타입은 서브컬럼이 전용 컬럼으로 저장되는 경우 잠재적으로 수천 개의 컬럼까지 확장될 수 있지만, 이로 인해 과도하게 많은 컬럼 파일이 생성되어 성능에 영향을 주는 컬럼 파일 폭증이 발생할 수 있습니다. 이를 완화하기 위해 JSON에 사용되는 기본 Dynamic type은
max_dynamic_paths매개변수를 제공하며, 이 매개변수는 별도 컬럼 파일로 저장되는 고유 경로 수를 제한합니다. 임계값에 도달하면 추가 경로는 컴팩트한 인코딩 포맷을 사용하는 공유 컬럼 파일에 저장되므로, 유연한 데이터 수집을 지원하면서도 성능과 스토리지 효율성을 유지할 수 있습니다. 다만 이 공유 컬럼 파일에 접근할 때는 성능이 다소 떨어집니다. 하지만 JSON 컬럼은 타입 힌트와 함께 사용할 수 있습니다. “힌트가 지정된” 컬럼은 전용 컬럼과 동일한 성능을 제공합니다. - 경로와 타입을 더 쉽게 내부 검사 - JSON 타입은 추론된 타입과 경로를 확인하기 위한 인트로스펙션 함수를 지원하지만, 정적 구조는 예를 들어
DESCRIBE를 사용해 더 간단하게 확인할 수 있습니다.
JSON을 사용해 보십시오.
성능 고려 사항단일 JSON 컬럼은 필요하지 않은 JSON 경로를 스키핑(저장하지 않음)하고 타입 힌트를 사용해 최적화할 수 있습니다. 타입 힌트를 사용하면 하위 컬럼의 유형을 사용자가 명시적으로 정의할 수 있으므로, 쿼리 시점에 수행되는 추론 및 간접 처리 과정을 건너뛸 수 있습니다. 이를 통해 명시적 스키마를 사용하는 경우와 동일한 성능을 얻을 수 있습니다. 자세한 내용은 “타입 힌트 사용 및 경로 스키핑”을 참조하십시오.
username 컬럼을 정렬/프라이머리 키에 사용하므로 JSON 정의에서 이 컬럼에 대한 타입 힌트를 제공합니다. 이렇게 하면 ClickHouse가 이 컬럼이 null이 될 수 없음을 인지하고, 어떤 username 하위 컬럼을 사용해야 하는지도 올바르게 판단할 수 있습니다(유형별로 여러 개가 있을 수 있어, 그렇지 않으면 모호해질 수 있습니다).JSONAsObject 포맷을 사용할 수 있습니다:
. 표기법을 사용합니다. 예:
NULL로 반환된다는 점에 유의하십시오.
또한 동일한 유형을 가진 경로마다 별도의 서브컬럼이 생성됩니다. 예를 들어, company.labels.type에는 String과 Array(Nullable(String))에 해당하는 서브컬럼이 각각 존재합니다. 가능한 경우 둘 다 반환되지만, .: 구문을 사용해 특정 서브컬럼을 지정할 수 있습니다:
^가 필요합니다. 이는 명시적으로 요청하지 않는 한 많은 수의 컬럼을 읽는 일을 피하기 위한 설계 선택입니다. ^ 없이 접근한 객체는 아래와 같이 NULL을 반환합니다.
company.labels 컬럼에 단일 JSON 컬럼을 사용하여 모델링할 수 있습니다.
JSONEachRow 포맷을 사용하여 이 테이블에 데이터를 삽입할 수 있습니다:
company.labels 컬럼에서 추론된 경로와 타입을 확인할 수 있습니다.
company.labels 안의 JSON 키 dissolved, employees, founded에 대한 타입을 지정합니다.
SKIP and SKIP REGEXP 매개변수를 사용해 저장하지 않을 JSON 내부 경로를 건너뛸 수 있습니다. 예를 들어 위 데이터에 단일 JSON 컬럼을 사용한다고 가정해 보겠습니다. 이 경우 address 및 company 경로를 건너뛸 수 있습니다:
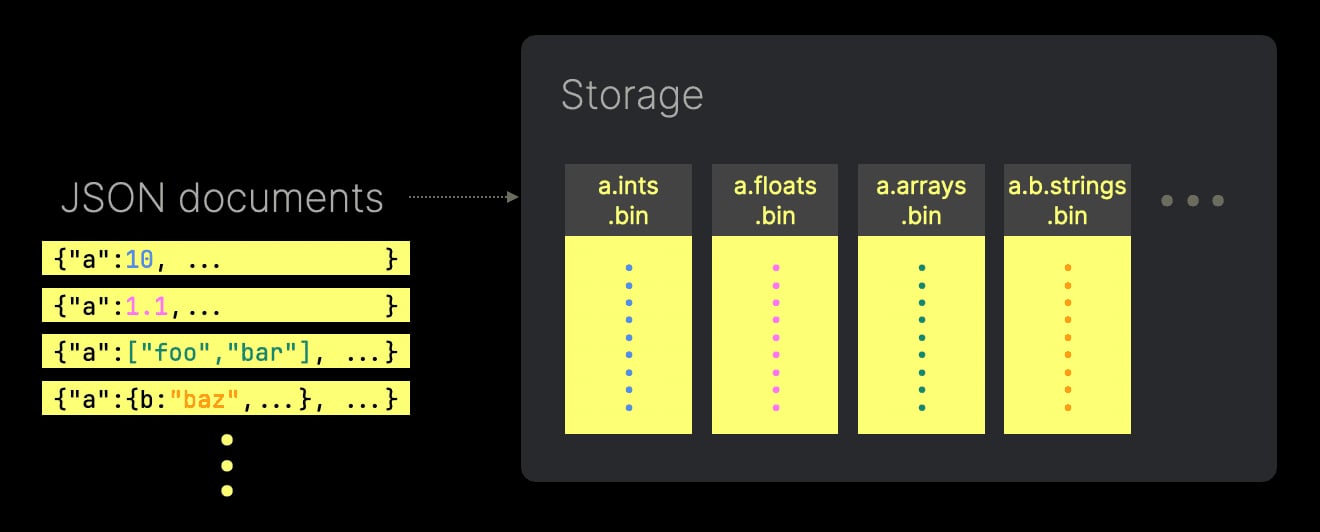
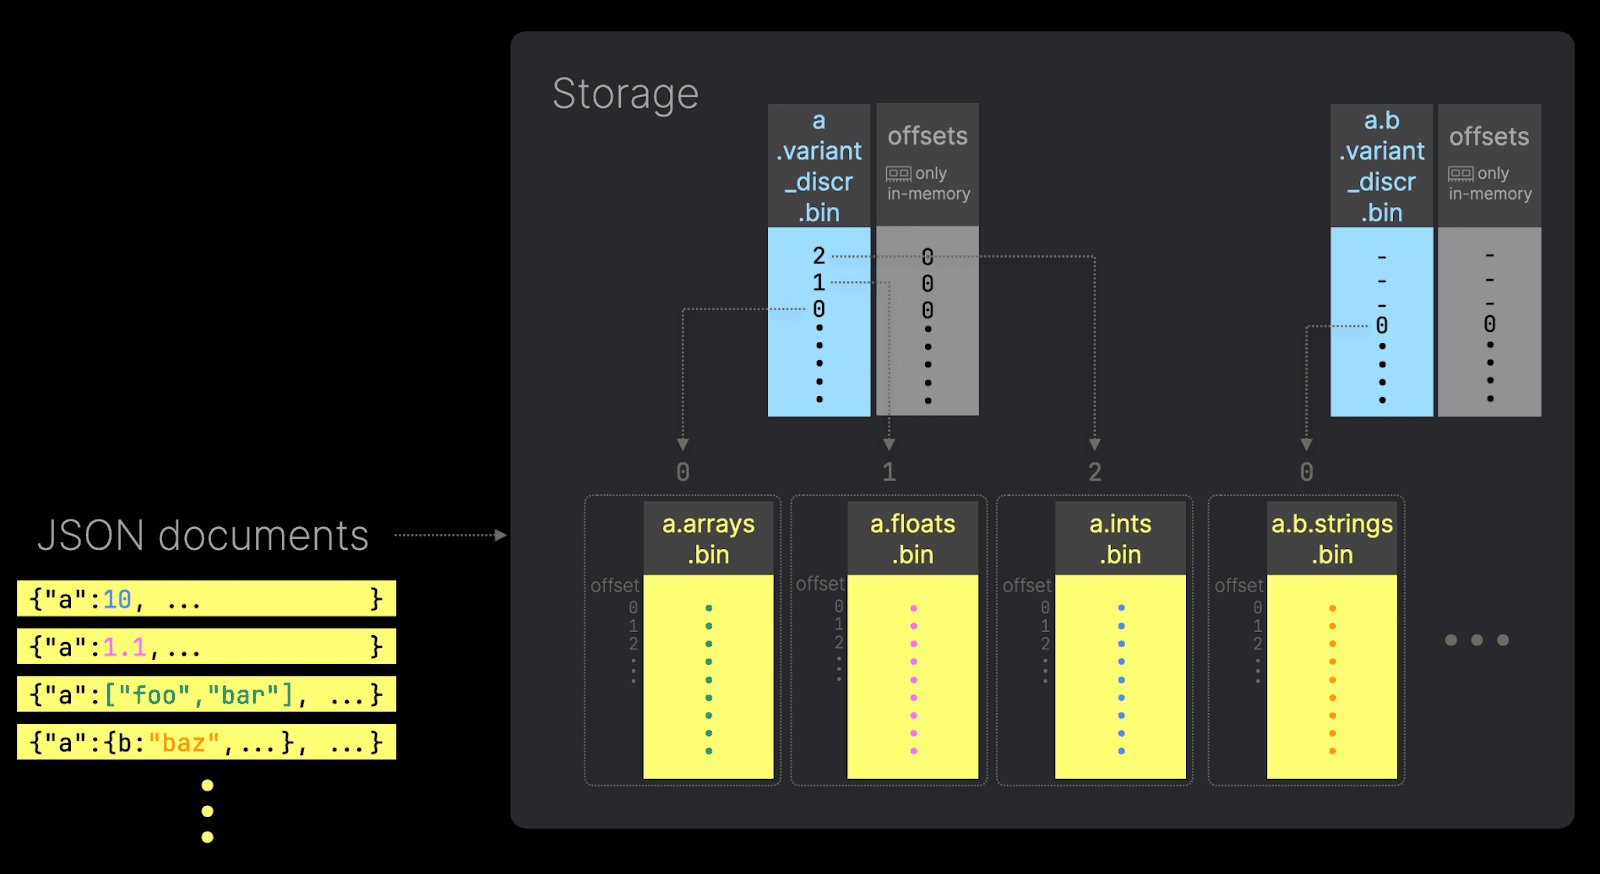
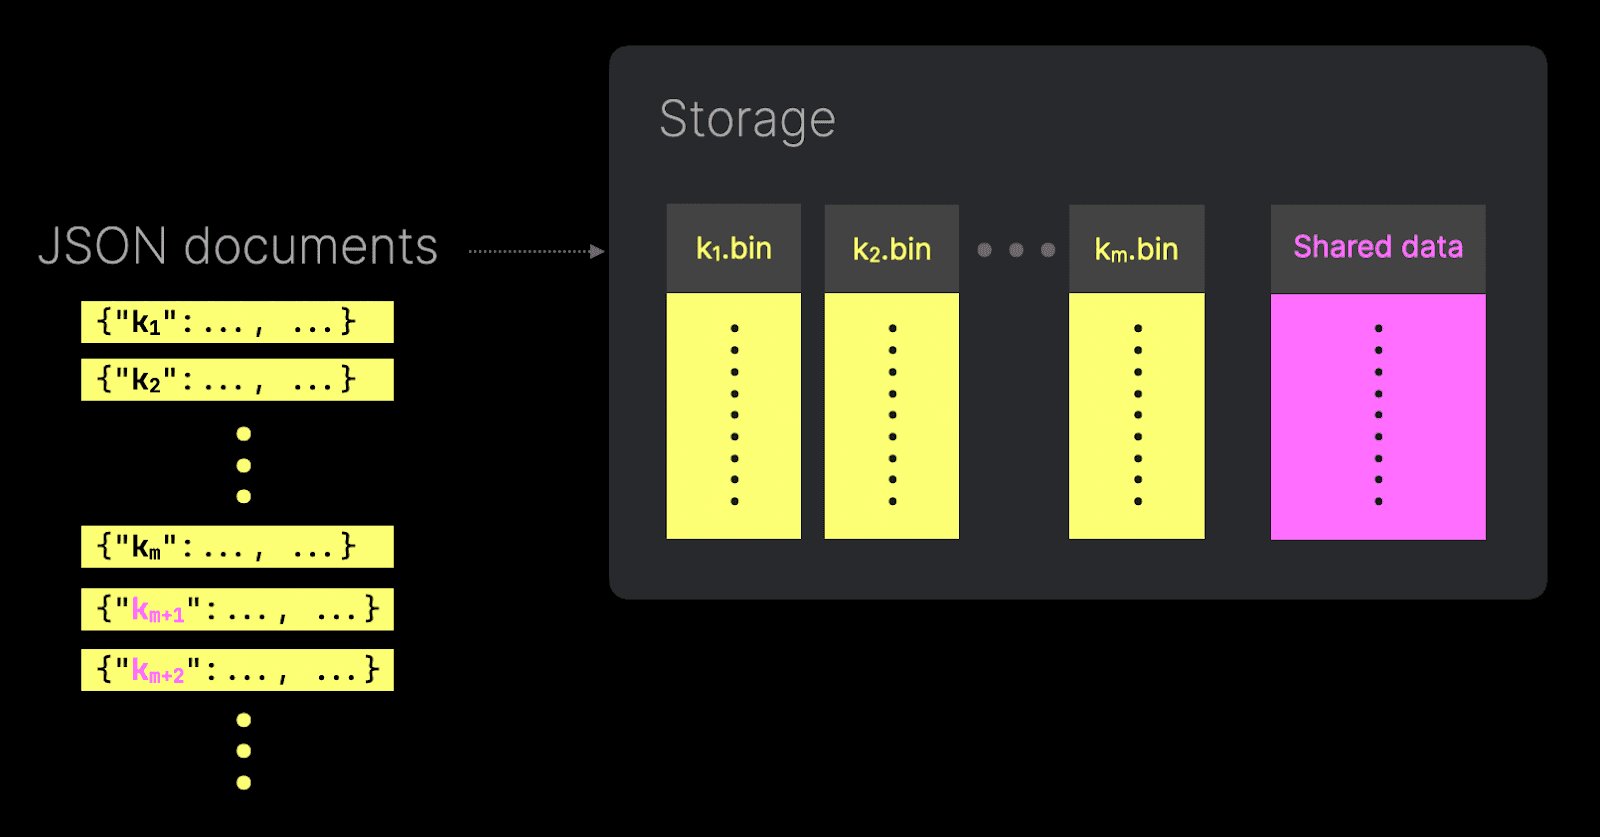
max_dynamic_paths 매개변수로 제어됩니다.
SKIP 매개변수를 사용하세요.
이 새로운 컬럼 타입의 구현이 궁금하다면 자세한 블로그 게시물 “A New Powerful JSON Data Type for ClickHouse”을 읽어보는 것을 권장합니다.