

_peerdb_version)의 행을 삽입하는 방식으로 모델링하고, DELETE는 더 최신 버전의 행을 삽입하되 _peerdb_is_deleted를 true로 표시하는 방식으로 처리합니다. ReplacingMergeTree 엔진은 백그라운드에서 데이터를 중복 제거하고 머지하며, 지정된 프라이머리 키(id)에 대해 가장 최신 버전의 행을 유지합니다. 이를 통해 UPDATE와 DELETE를 버전 기반 삽입으로 효율적으로 처리할 수 있습니다.
아래는 ClickPipes가 ClickHouse에 테이블을 생성하기 위해 실행하는 CREATE TABLE 문의 예시입니다.
users가 동기화되는 기본 예시를 보여줍니다.
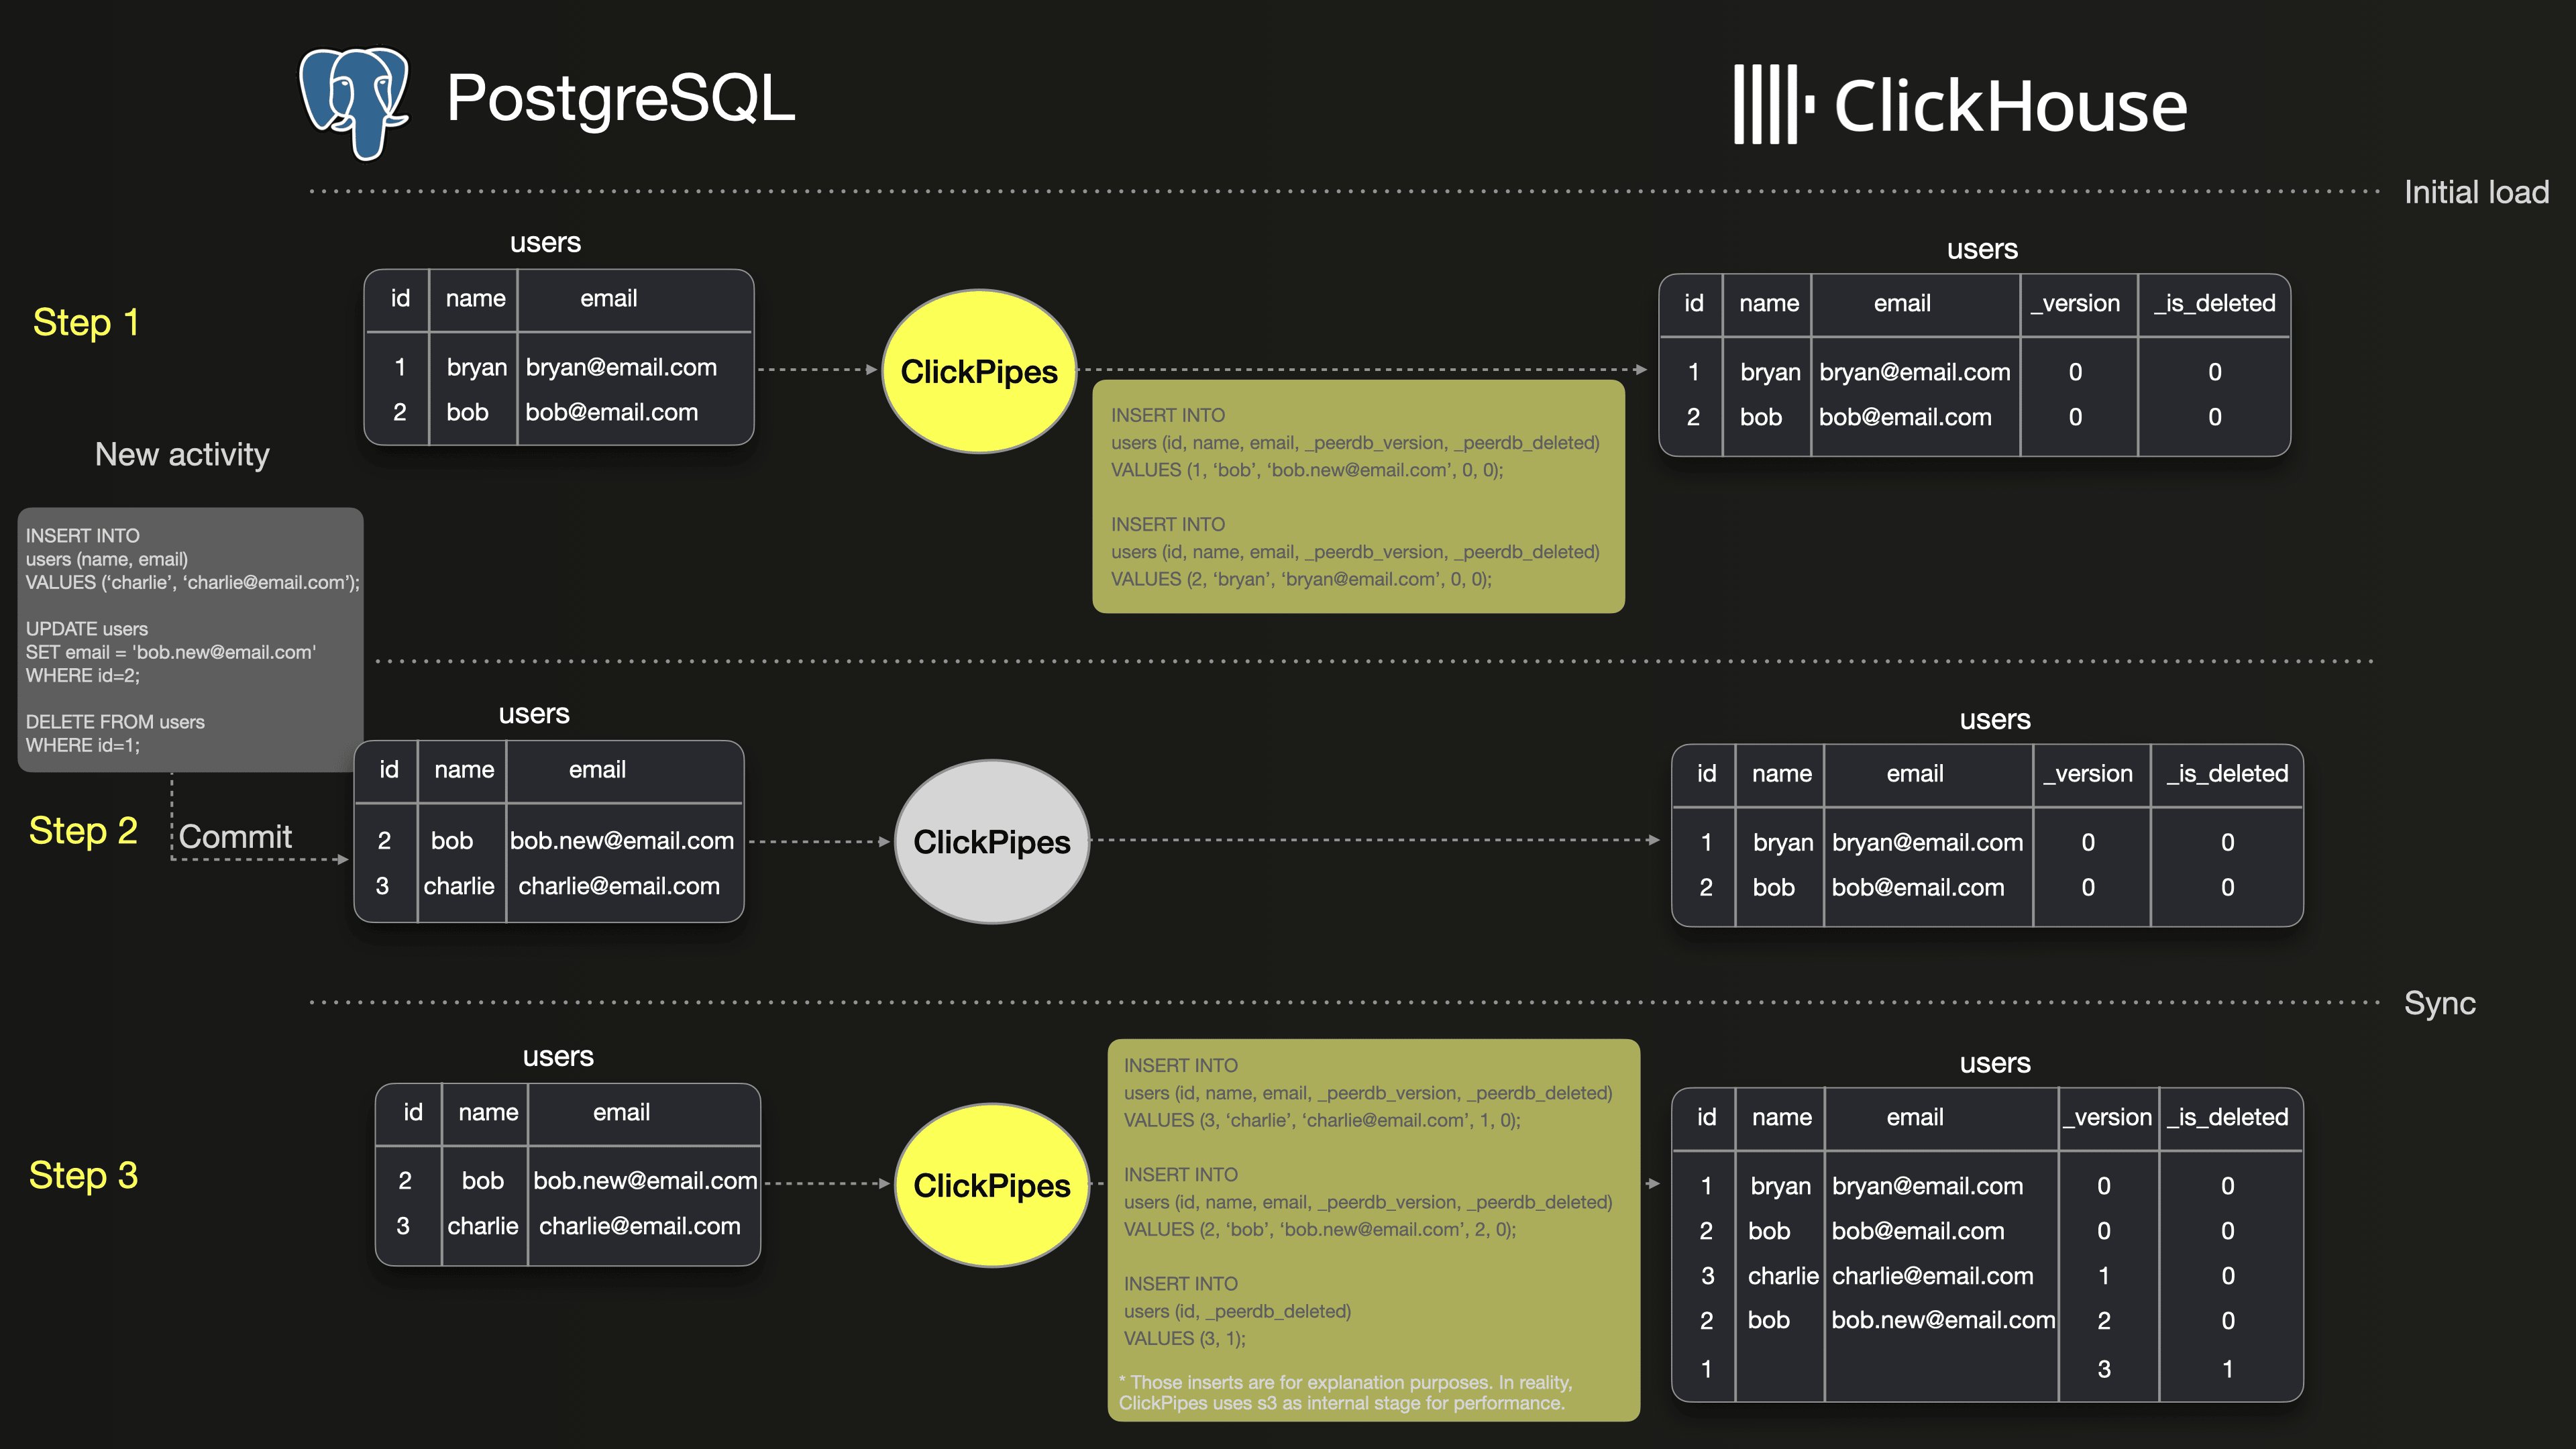
_is_deleted를 사용해 true로 표시된 ID 1의 새 버전으로 나타납니다. 이로 인해 ClickHouse에는 PostgreSQL보다 3개의 행이 더 존재하게 됩니다.
그 결과, SELECT count(*) FROM users;와 같은 단순한 쿼리를 실행하면 ClickHouse와 PostgreSQL에서 서로 다른 결과가 나올 수 있습니다. ClickHouse 머지 문서에 따르면, 오래된 행 버전은 결국 머지 과정에서 제거됩니다. 하지만 머지가 수행되는 시점은 예측할 수 없으므로, 그전까지는 ClickHouse의 쿼리가 일관되지 않은 결과를 반환할 수 있습니다.
ClickHouse와 PostgreSQL에서 동일한 쿼리 결과를 보장하려면 어떻게 해야 할까요?
ClickHouse 쿼리에서 데이터 중복을 제거하는 권장 방법은 FINAL 수정자를 사용하는 것입니다. 이렇게 하면 중복 제거된 행만 반환됩니다.
이제 이를 서로 다른 3개의 쿼리에 어떻게 적용하는지 살펴보겠습니다.
다음 쿼리의 WHERE 절에 유의하십시오. 이 절은 삭제된 행을 걸러내는 데 사용됩니다.
- 단순 count 쿼리: Posts의 수를 계산합니다.
- JOIN을 사용한 단순 집계: 조회 수를 가장 많이 누적한 상위 10명의 사용자
_peerdb_is_deleted = 0 filter를 숨기는 가장 쉬운 방법은 ROW policy를 사용하는 것입니다. 아래는 테이블 votes의 모든 쿼리에서 삭제된 행이 제외되도록 ROW policy를 생성하는 예시입니다.
행 정책은 사용자와 역할 목록을 대상으로 적용됩니다. 이 예시에서는 모든 사용자와 역할에 적용됩니다. 필요에 따라 특정 사용자 또는 역할에만 적용하도록 조정할 수 있습니다.분석용 데이터셋을 PostgreSQL에서 ClickHouse로 마이그레이션할 때는 데이터 처리 방식과 쿼리 실행 방식의 차이로 인해 애플리케이션 쿼리를 수정해야 하는 경우가 많습니다. 이 섹션에서는 기존 쿼리는 그대로 유지하면서 데이터를 중복 제거하는 기법을 살펴봅니다. 뷰는 쿼리에서 FINAL 키워드를 감추는 데 매우 효과적인 방법입니다. 데이터를 저장하지 않고, 액세스할 때마다 다른 테이블을 단순히 읽기만 하기 때문입니다. 아래는 ClickHouse에서 데이터베이스의 각 테이블에 대해 FINAL 키워드와 삭제된 행을 걸러내는 필터를 적용한 뷰를 생성하는 예시입니다.
FINAL 키워드를 사용하는 쿼리가 갱신 시 한 번만 실행된다는 점입니다. 따라서 이후 대상 테이블을 조회하는 쿼리에서는 FINAL을 사용할 필요가 없습니다.
하지만 단점은 대상 테이블의 데이터가 가장 최근 갱신 시점까지만 반영된다는 점입니다. 그럼에도 많은 사용 사례에서는 몇 분에서 몇 시간 정도의 갱신 주기로도 충분할 수 있습니다.
deduplicated_posts 테이블에 대해 평소처럼 쿼리할 수 있습니다.