---
title: "ゼロコピーのグラフ分析: LakeHouse Graph の始め方"
date: "2026-09-30T05:10:52.016Z"
author: "Maruthi Lokanathan"
category: "Community"
excerpt: "グラフ分析のためにデータをコピーする手法がスケールしない理由と、その代わりとなるアプローチについて解説します。"
---
# ゼロコピーのグラフ分析: LakeHouse Graph の始め方
## すでにご存じの課題
分析データベースには大量のデータが蓄積されています。数百万の顧客データ、数十億のトランザクションデータ。そしてあるとき、このような問いが投げかけられます。「共通の購買行動でつながっている顧客は誰か?」「トランザクションネットワーク内にどのような不正グループが存在しているか?」
リレーションに関する問いに SQL で答えようとしたことがあるなら、何が起きるかはおわかりでしょう。再帰的 CTE を書くと、3ホップでタイムアウトします。自己結合を試すと、クエリプランが爆発的に肥大化します。そこで、「やはりグラフデータベースが必要かもしれない」と考えるわけです。
そして、ここから話が複雑になります。
グラフデータベースを使うには、そこにデータをコピーする必要があります。つまり、ETL パイプラインを構築し、それを保守し、上流でスキーマが変更されるたびにパイプラインが壊れるのを見守ることになります。ある調査によると、データエンジニアは分断されたシステム間で「データを追いかける」作業だけに[週あたり 12 時間](https://www.integrate.io/blog/etl-market-size-statistics/)を費やしていると報告されています。ETL ツールの市場規模は[2033年までに 85 億ドルから 247 億ドルへと成長する](https://www.integrate.io/blog/etl-market-size-statistics/)と予測されており、データを活用するのではなく、移動させることだけに莫大な費用が投じられています。
問題の本質はここにあります。**データをコピーするたびに、同期の問題が発生するのです。**結果として 2 つのシステムと 2 つのスキーマを抱えることになり、すでに古くなったデータに対してクエリを実行することになります。
そもそもデータをまったくコピーしなくてよいとしたらどうでしょうか。
## 従来のアプローチ(とその破綻の理由)
従来のアプローチでは、OLAP データベースとグラフデータベースを別々のシステムとして扱います。
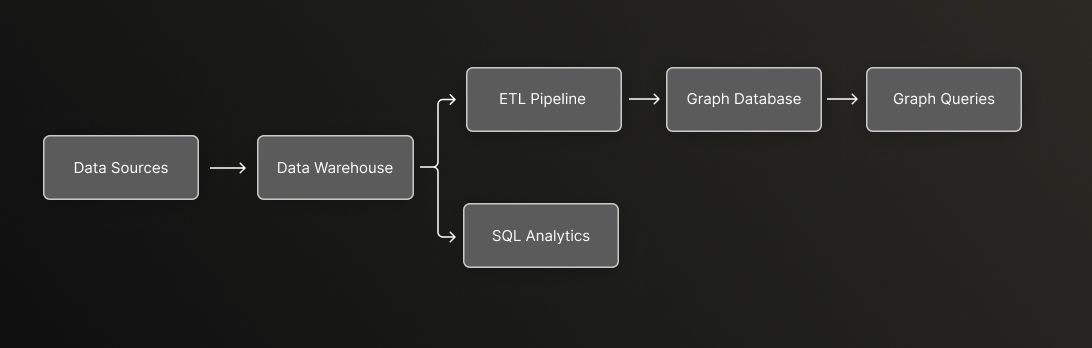
ウェアハウスからは SQL 分析を、グラフデータベースからはグラフクエリを実行できます。しかし両者をつなぐには、その間に ETL パイプラインが必要です。
課題は積み重なっていきます。
- **二重のストレージコスト** - 同じデータの保存費用を二重に支払うことになります
- **同期の遅延** - 数分から数時間前の古いデータに対してグラフクエリを実行することになります
- **スキーマの変更** - ウェアハウス側でカラムを変更すると、2 つのシステムをデバッグする羽目になります
- **パイプラインの管理責任** - 誰かがその同期ジョブを永続的に保守し続けなければなりません
ある[事例研究](https://www.isaca.org/resources/news-and-trends/industry-news/2025/the-zero-etl-paradigm-transforming-enterprise-data-integration-in-real-time)では、従来の ETL から脱却することでレイテンシを 98% 削減(30 分から 30 秒未満へ)し、運用コストを 66% 削減できたことが示されています。これはわずかな改善ではなく、働き方そのものの変革です。
## ゼロコピーという選択肢
では、既存のデータに対してリレーションを直接クエリできるとしたらどうでしょうか。
それが「ゼロコピーグラフ分析」の発想です。データを別のグラフデータベースにコピーする代わりに、分析データベースの上にグラフクエリ層を追加します。
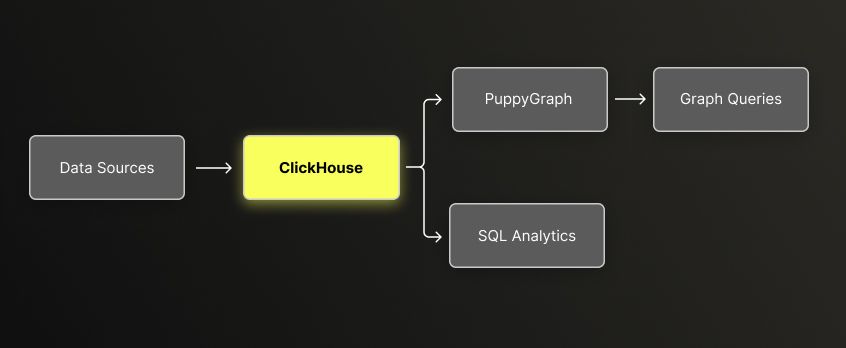
PuppyGraph は JDBC 経由で ClickHouse に接続し、グラフクエリインターフェース(Cypher/Gremlin)を提供します。データの移動は発生しません。SQL ダッシュボードを支えているのと同じテーブルから、グラフ探索も実行できます。
得られるメリットは次のとおりです。
- **リアルタイムデータ** - 前回の同期時点ではなく、現時点のデータに対してクエリを実行可能
- **単一の信頼できる情報源(Single Source of Truth)** - 1 つのスキーマ、1 つのストレージ層
- **同期パイプラインが不要** - 保守するものも、壊れるものもなし
- **コストの削減** - 重複したストレージが不要
核となる考え方はシンプルです。データにはすでにリレーションが存在しています。顧客は商品を購入し、アカウントは取引を行い、デバイスはアカウントに接続します。それらのリレーションをクエリするためにデータを移動する必要はありません。適切なクエリインターフェースがあればよいのです。
## より広い視点:Lakehouse Graph
ゼロコピーは単なる一手法にとどまりません。データアーキテクチャの捉え方における、より広範な変化の一環です。
図書館に例えてみましょう。長年、本の内容を調べたい場合(SQL 分析)はメインの閲覧室に向かいました。一方で本同士の引用関係を調べたい場合(グラフクエリ)は、すべてをコピーして街の反対側にある別の研究別館まで運ばなければなりませんでした。図書館に新しい本が入るたびに、誰かがその別館を更新する必要がありました。機能はしていましたが、遅く、コストもかかりました。
データレイクハウスはこの方程式の前半を変えました。[Delta Lake や Iceberg](https://www.puppygraph.com/blog/iceberg-vs--delta-lake) といったオープンテーブルフォーマットにより、閲覧室は本格的な研究図書館へと生まれ変わりました。低コストなオブジェクトストレージ上で、ウェアハウス水準の信頼性が得られるようになったのです。SQL エンジン、ML パイプライン、ストリーミングワークロードがすべて同じデータへと集約され始めました。1 つの図書館で、多様な使い方が可能になったのです。
しかし、グラフだけは例外のままでした。リレーションを追跡したい場合、依然としてコピーを作成し、あの研究別館を維持しなければなりませんでした。
[Lakehouse Graph](https://www.bigdatawire.com/2025/01/24/puppygraph-brings-graph-analytics-to-the-lakehouse/) アプローチは、ついにこのギャップを埋めるものです。データを別のグラフデータベースにコピーする代わりに、レイクハウスに直接グラフクエリ層を追加します。SQL ダッシュボードで利用している同じテーブルが、グラフ探索にも対応します。1 つの図書館に、必要なすべてのツールが揃います。コピーをとる必要はありません。
これが実際に何を意味するかというと、データチームが 2 つのシステムを保守する必要がなくなるということです。新しいデータが ClickHouse に到着すると、集計クエリとリレーション探索の両方ですぐに利用可能になります。スキーマ変更も 1 度で済みます。「グラフのデータが 2 時間遅れている」といった会話もなくなります。
ClickHouse は、得意とする処理を担当します。大規模な集計、時系列分析、数十億行を高速にスキャンする必要がある分析クエリなどです。PuppyGraph はその上にグラフ層を追加し、データを他へ移動することなくマルチホップのリレーションクエリを可能にします。あるシステムを別のシステムに置き換えるのではなく、既存のシステムができることを拡張するのです。
これこそが現代のデータアーキテクチャが進んでいる方向性です。専門特化したシステムを減らし、同じデータに対してより多くの機能を持たせるという方向です。もはや「SQL かグラフか?」という問いではありません。「どのような問いに答えたいのか?」であり、同じデータがその両方に答えてくれます。
## なぜグラフクエリが重要なのか
すべての問いが自然に SQL に適合するわけではありません。
SQL は集合ベースの操作に適しています。行をフィルタリングし、カラムを集計し、テーブルを結合するといった処理です。しかし、本質的にリレーションの探索を目的とする問いもあります。
- この顧客と似た商品を購入した顧客は誰か?
- フラグが付けられたアカウントとデバイスを共有しているアカウントはどれか?
- 送金ネットワークを通じて資金はどのように移動しているか?
SQL で 5 ホップのクエリ(アカウントに接続されたアカウントに接続されたアカウント……を検索する)を書いたことがある方なら、クエリプランが爆発的に肥大化するのを目にしたことがあるでしょう。ホップが 1 つ増えるごとに結合が追加され、パフォーマンスは指数関数的に低下します。
グラフデータベースはこれを異なるアプローチで処理します。「Index-Free Adjacency(インデックス不要の隣接性)」を採用しており、各ノードが隣接ノードへの直接のポインタを保持しています。リレーションの探索はテーブルスキャンではなく、一定時間で行われる操作です。複数の調査によると、マルチホップのリレーションクエリにおいて、グラフデータベースはリレーショナルシステムと比べて[50% 高速](https://www.puppygraph.com/blog/graph-database-vs-relational-database)になる場合があることが示されています。
これまでのトレードオフは常に「データを別のシステムにコピーするかどうか」でした。ゼロコピーはこのトレードオフを解消します。
## 実際の動作
この仕組みを実証するため、2 つのユースケースを含むリファレンス実装を構築しました。完全なコードは [GitHub リポジトリ](https://github.com/maruthiprithivi/zero_copy_graph_analytics)にあります。
### カスタマー 360:商品レコメンデーション
データセットには 3,540 万件のレコードが含まれています(顧客 100 万人、トランザクション 730 万件、インタラクション 2,700 万件)。
集計には SQL を使用します。
-- Customer lifetime value by segment
SELECT segment, AVG(ltv) as avg_ltv, COUNT(*) as customers
FROM customers
GROUP BY segment
ORDER BY avg_ltv DESC;
リレーションクエリには Cypher を使用します。
// Find products frequently bought together
MATCH (c:Customer)-[:PURCHASED]->(p1:Product)
MATCH (c)-[:PURCHASED]->(p2:Product)
WHERE p1.category = 'Electronics'
  AND p2.category = 'Electronics'
  AND p1 <> p2
RETURN p1.name, p2.name, COUNT(DISTINCT c) as co_purchases
ORDER BY co_purchases DESC
LIMIT 10;
どちらのクエリも同じ基盤テーブルに対して実行されます。同期も遅延もありません。
### 不正検知:隠れたネットワークの検出
不正検知データセットには 129 万件のレコードが含まれ、アカウント乗っ取りグループ、マネーロンダリングネットワーク、カード不正、架空名義詐欺、加盟店共謀という 5 つの不正パターンが組み込まれています。
個々のトランザクションは正常に見えます。ネットワークとして可視化して初めて、不正パターンが浮かび上がってきます。
// Detect accounts sharing devices (account takeover pattern)
MATCH (a1:FraudAccount)-[:USED_DEVICE]->(d:FraudDevice)<-[:USED_DEVICE]-(a2:FraudAccount)
WHERE a1 <> a2 AND d.is_suspicious = 1
RETURN d.device_id, d.location,
       COLLECT(DISTINCT a1.account_id) as connected_accounts
ORDER BY SIZE(connected_accounts) DESC
LIMIT 10;
このクエリは、不審なデバイスを共有しているアカウント(典型的なアカウント乗っ取りのパターン)を検出します。SQL でこれを行うと自己結合が必要になり、規模が大きくなると処理が遅くなります。グラフ探索として実行すれば、ミリ秒単位で完了します。
## クエリパフォーマンスについて
ネイティブのグラフストレージを持たずにグラフクエリを実行すると話すと、常に「クエリパフォーマンスへの影響はどうなのか?」という疑問が生じます。確かに、トレードオフとしてクエリレイテンシは高くなります。このクエリレイテンシが実際に問題になるほど大きなものかどうかを客観的に検証するため、前セクションで取り上げた 2 つのユースケースに沿ったクエリを作成しました。2 つのユースケースの特定領域を網羅する合計 97 件のクエリ(SQL クエリ 42 件、Cypher クエリ 55 件)を用意し、検証を行いました。ゼロコピーでのクエリパフォーマンスの概要は以下のとおりです。
| メトリクス | 値 |
| --- | --- |
| レイテンシ中央値 | 28ms |
| P95 レイテンシ | 148ms |
数値そのものよりも重要なのは、それが示す事実です。分析クエリとグラフ探索の両方を同じデータに対して実行でき、しかも対話的な利用に適した応答時間を維持できるということです。
また、このアーキテクチャはスケールします。ClickHouse は [Tesla、Anthropic、Cloudflare](https://clickhouse.com/user-stories) などの企業で、ペタバイト規模の分析を支えています。PuppyGraph はステートレスなクエリ層であるため、基盤となるデータベースに合わせて水平スケール(スケールアウト)できます。
## 実際に試す
リファレンス実装は GitHub で公開されており、必要なものはすべて揃っています。
# Start ClickHouse and PuppyGraph
make local

# Generate test data
make generate-local

# Access PuppyGraph UI
open http://localhost:8081
リポジトリには以下が含まれています。
- 現実的なデータパターンを備えた 2 つのユースケース(カスタマー 360、不正検知)
- すぐに実行できる検証済みの 97 件のクエリ
- ローカルおよびハイブリッドの両方のデプロイオプション
## まとめ
データに関するリレーションの問いがある場合、データをグラフデータベースにコピーするか、厄介な再帰的 SQL を書くかの二者択一を迫られる必要はありません。
Lakehouse Graph アプローチにより、データがすでに存在する場所へグラフクエリの機能をもたらすことができます。ゼロコピーは、より新鮮なデータ、よりシンプルなアーキテクチャ、そして保守すべきインフラの削減を意味します。レコメンデーションの構築、不正検知、サプライチェーンのマッピングなど、どの用途であってもパターンは同じです。データを移動することなく、リレーションをクエリするのです。
[リポジトリ](https://github.com/maruthiprithivi/zero_copy_graph_analytics)には 10 分で実行できる動作コードが用意されています。ぜひご覧ください。
**参考資料**
- [Integrate.io: ETL Market Size Statistics](https://www.integrate.io/blog/etl-market-size-statistics/)
- [ISACA: The Zero-ETL Paradigm](https://www.isaca.org/resources/news-and-trends/industry-news/2025/the-zero-etl-paradigm-transforming-enterprise-data-integration-in-real-time)
- [BigDataWire: Graph Analytics on the Lakehouse](https://www.bigdatawire.com/2025/01/24/puppygraph-brings-graph-analytics-to-the-lakehouse/)
- [PuppyGraph: Graph vs Relational Databases](https://www.puppygraph.com/blog/graph-database-vs-relational-database)