---
title: "よりスマートなClickHouseのオートスケーリング: 2ウィンドウアプローチ"
date: "2026-09-18T07:00:38.542Z"
author: "Ashwath Singh and Manas Alekar"
category: "Engineering"
excerpt: "ClickHouse Cloudの2ウィンドウレコメンダーと目標追従型CPUアルゴリズムにより、ハンチングを防ぎインフラコストを削減しながら、スケールダウンのレイテンシを30時間から3時間に短縮した方法を解説します。"
---
# よりスマートなClickHouseのオートスケーリング: 2ウィンドウアプローチ
はじめに
データベースリソースのオートスケーリングには慎重なバランスが求められます。スケールアップが遅すぎるとパフォーマンス低下を招き、スケールダウンが積極的すぎると絶え間ない変動(振動)を引き起こします。当社の従来のオートスケーリングシステムでは、スケーリングの判断に単一の 30 時間ルックバックウィンドウを使用していました。これによりスケールアップは高速かつ安定していましたが、設計上スケールダウンは保守的にならざるを得ませんでした。トラフィックが減少した後、クラスターが適切なサイズに戻るまでに最大 30 時間かかる場合がありました。
本記事では、この課題を**2 ウィンドウリコメンダー**によってどのように解決したかを紹介します。これは、アグレッシブにスケールアップしつつ、より素早くスケールダウンを行うデュアルウィンドウアプローチです。この 2 ウィンドウのフレームワークに新しいターゲットトラッキング型の CPU 推薦システムを組み合わせ、複数ウィンドウではうまく機能しなかった従来の CPU 推薦アルゴリズムを刷新しました。
その結果、スケールダウンの大幅な高速化、スケーリングの振動の最小化、変動の大きいワークロードにおけるインフラコストの大幅な削減を実現し、本番データベースに必要な安定性も維持できるようになりました。
**注記**: 本記事では、レプリカごとの CPU とメモリを調整する垂直方向のオートスケーリング(スケールアップ/スケールダウン)に焦点を当てています。水平方向のスケーリング(スケールアウト/スケールイン)オプションやユーザー向けの設定については、[ClickHouse Cloud のスケーリングに関するドキュメント](https://clickhouse.com/docs/ja/products/cloud/features/autoscaling/overview)をご覧ください。
課題: 長いルックバックウィンドウ
従来のオートスケーリングシステムでは、リソースの推薦を決定するために 30 時間のルックバックウィンドウを使用していました。このアプローチには明確なメリットがありました。
* **迅速なスケールアップ**: 使用量が急増した際、それを即座に検知してスケールアップ可能
* **安定性**: 長いウィンドウにより、一時的な変動への過剰な反応を防止
しかし、この方式はスケールダウンにおいて致命的な問題を引き起こしました。
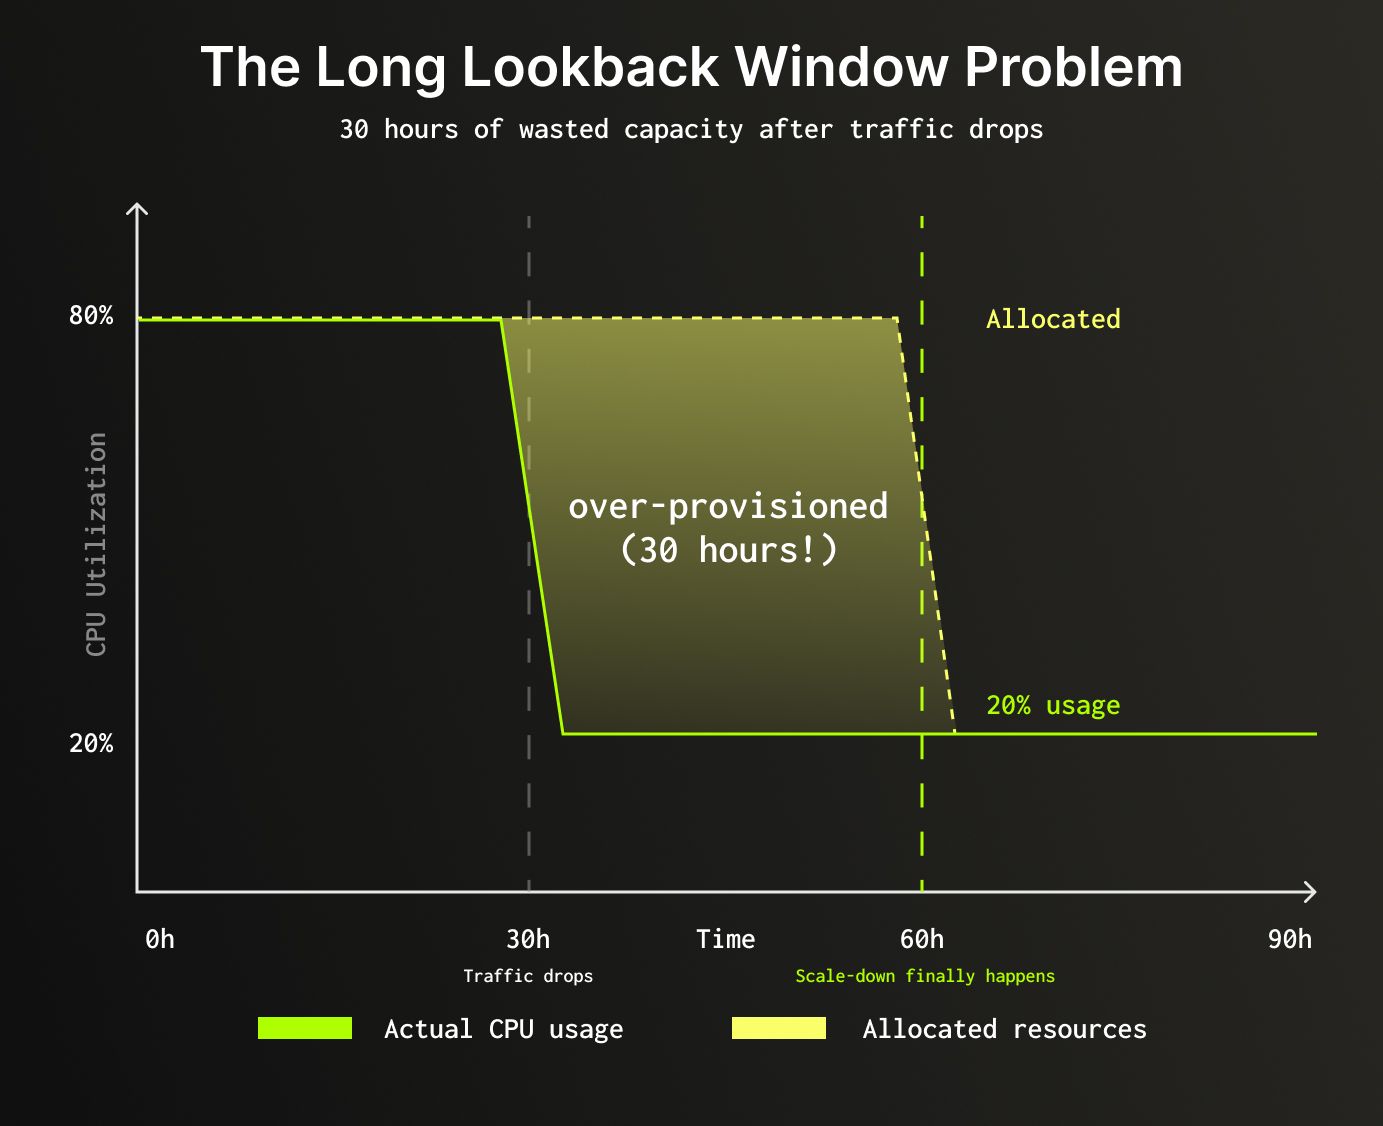
**結果**: トラフィック低下後も 30 時間にわたって過剰なリソースがプロビジョニングされたままとなり、インフラコストが必要以上に増加していました。
**主要メトリクス**: このシステムは、平均使用量ではなくルックバック期間内の**ピーク(最大)使用量**を追跡します。平均値に基づいてプロビジョニングを行うと、ピーク時に十分なキャパシティを確保できず、クエリの失敗やパフォーマンスの低下につながるためです。
迅速かつ安定したスケールアップを維持しながら、スケールダウンを大幅に高速化する方法が必要でした。
2 ウィンドウによる解決策
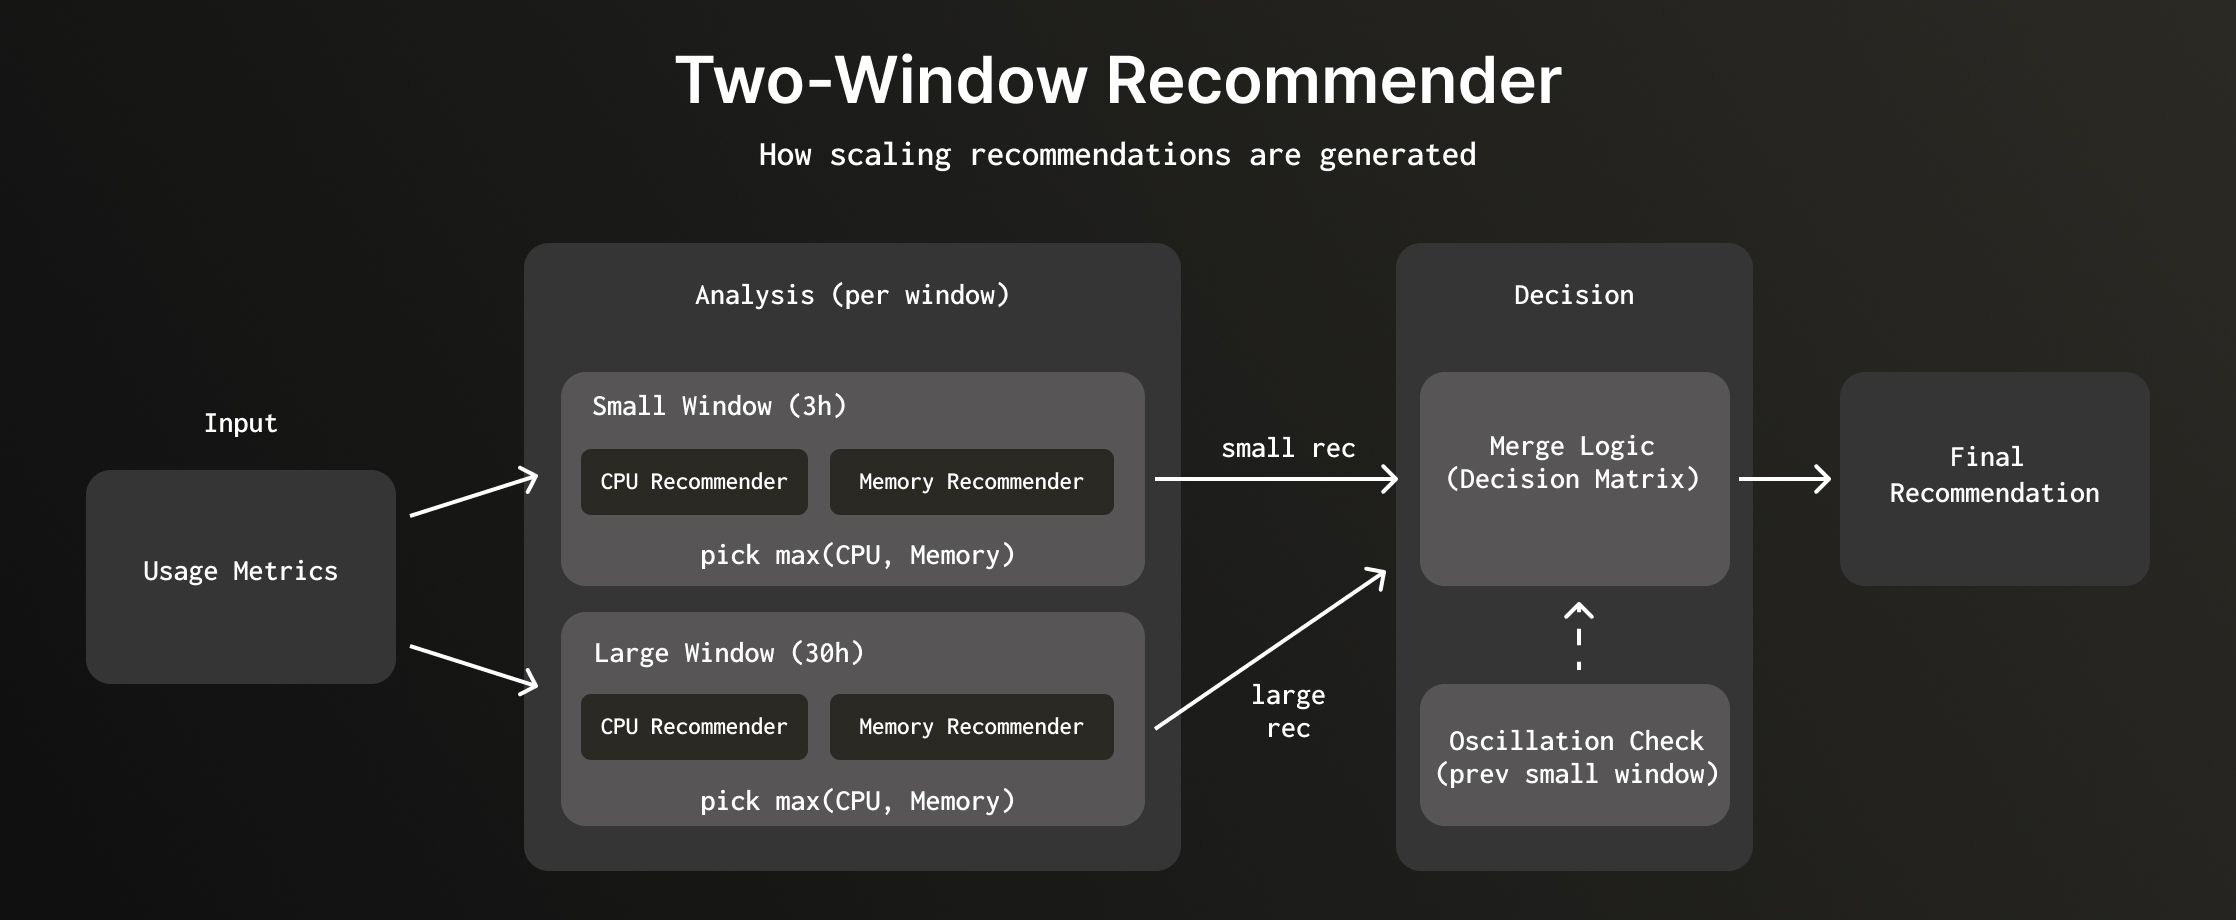
単一のウィンドウを使用する代わりに、時間幅の異なる 2 つのルックバックウィンドウを使用します。
* **スモールウィンドウ**(3 時間): 直近の使用パターンを捉え、迅速なスケールダウンを可能にする
* **ラージウィンドウ**(30 時間): 段階的にスケールアップを繰り返すのではなく、長期的なルックバックウィンドウで観測された最大使用量へ 1 回のステップでスケールアップできるようにする。スケーリングには時間がかかり、ローカルキャッシュが無効化されるため、1 ステップでスケールアップする方が安全であり不可欠です。
3 時間に決定する前、さまざまな短いウィンドウ期間を検証しました。1 時間のウィンドウでは反応が過敏になりすぎ、スケールダウンが積極的すぎて振動が発生しました。6 時間のウィンドウではスケールダウンのレイテンシが十分に改善されませんでした。3 時間という長さが、応答性と安定性の間で適切なバランスを実現しました。
各ウィンドウは、メモリと CPU の両方の分析を用いて個別に推薦値を生成します。その後、システムは各ウィンドウが提案するスケーリング方向に基づいて、これらの推薦値をマージします。
ウィンドウごとの推薦値の生成
システムは両方のウィンドウに対して並列に推薦値を生成します。
1. **スモールウィンドウ**(3 時間): 直近の**最大**使用パターンを分析
2. **ラージウィンドウ**(30 時間): 過去の長期的な**最大**使用パターンを分析
3. **前回のスモールウィンドウ**: トレンド検知のため、直前のスモールウィンドウの推薦値を取得
各ウィンドウにおいて、システムは**メモリベースと CPU ベースの両方の分析を並列で実行**し、より多くのリソースを推奨する方を選択します(CPU とメモリは 1:4 の固定比率でスケールするため、両方の要件が満たされます)。次に、各ウィンドウの推薦値が現在の割り当てと比較され、スケーリング方向が決定されます。増加を推奨する場合はスケールアップ、減少を推奨する場合はスケールダウン、それ以外は変更なしとなります。
推薦値のマージ
各ウィンドウが見ている時間範囲が異なるため、導き出される結論も異なる場合があります。スモールウィンドウは過去 3 時間トラフィックが落ち着いていると判断してスケールダウンを推奨するかもしれませんが、ラージウィンドウは前日の急増をまだ保持しており、維持またはスケールアップさえ推奨する可能性があります。問題は、両者の意見が食い違った際にどちらを採用するかです。
| ラージウィンドウ | スモールウィンドウ | 採用される推薦値 | 理由 |
| ----- | ----- | ----- | ----- |
| スケールアップ | スケールアップ | **ラージウィンドウ** | 長期的なピークへ 1 ステップでスケールするため |
| スケールアップ | 変更なし | **スモールウィンドウ** | 直近の使用量が安定しているため、まだスケールしない |
| スケールアップ | スケールダウン | **ハンティングチェック** | スモールウィンドウが増加傾向にあればハンティングを避けるためラージを採用、そうでなければスモールを採用 |
| 変更なし | スケールアップ | — | 発生不可(ラージウィンドウがスモールウィンドウのデータを含んでいるため) |
| 変更なし | 変更なし | **スモールウィンドウ** | 変更なし |
| 変更なし | スケールダウン | **ハンティングチェック** | スモールウィンドウが増加傾向にあればハンティングを避けるためラージを採用、そうでなければスモールを採用 |
| スケールダウン | スケールアップ | — | 発生不可(ラージウィンドウがスモールウィンドウのデータを含んでいるため) |
| スケールダウン | 変更なし | **ラージウィンドウ** | サービスがアイドリング中または停止している可能性が高いため |
| スケールダウン | スケールダウン | **スモールウィンドウ** | より迅速にスケールダウンするため |
両方のウィンドウが方向性で一致している場合、スケールダウンにはスモールウィンドウを(高速化のため)、スケールアップにはラージウィンドウを(ピークへの 1 ステップスケーリングのため)選択します。不一致の場合はハンティングチェックを実行します。なお、ラージウィンドウはスモールウィンドウの期間を完全に包含しているため、論理的に発生し得ない組み合わせもあります。
ハンティングの防止
ハンティング(不必要なスケーリングの繰り返し)を防ぐため、システムは前回のスモールウィンドウの推薦値を使用します。ウィンドウ間で意見が分かれた場合(ラージはスケールアップ、スモールはスケールダウンを要求)、システムはスモールウィンドウの推薦値が増加傾向にあるかどうかを確認します。
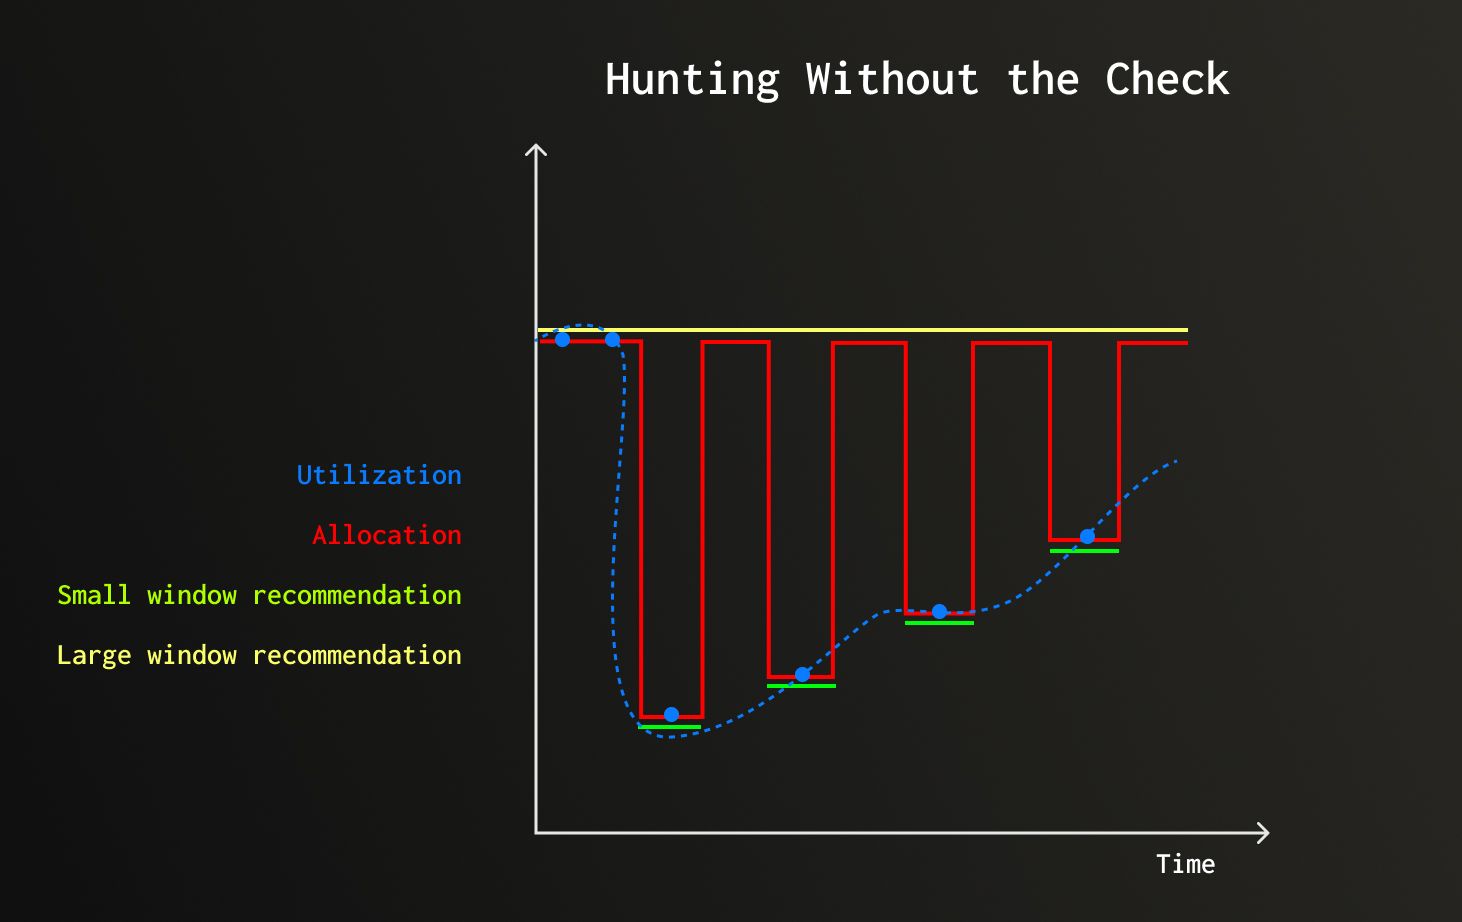
*図の説明: 高い CPU 使用率が落ち着いた後、実際のリソース使用量(青い点)は低下したのち緩やかに上昇し始めます。ラージウィンドウ(黄色)は推薦値を高く維持しています。スモールウィンドウ(緑色)はスパイク後に急速に低下します。ハンティングチェックがない場合、2 ウィンドウのマージロジックは各ウィンドウを交互に信頼してしまい、赤線のようにスケールダウンとスケールアップの間で激しくハンティングを起こします。ハンティングチェックは、スモールウィンドウが増加傾向にあるときは常にラージウィンドウを信頼することで、これを防止します。*
**ハンティングチェック**: `current_small_window > previous_small_window`
* **増加傾向の場合**: ラージウィンドウを信頼(使用量が増加傾向にあり、ハンティングを防ぎつつ段階的ではなく 1 ステップでスケールさせるため)
* **安定/減少傾向の場合**: スモールウィンドウを信頼(安全にスケールダウン可能)
2 ウィンドウのフレームワークを導入したことで、各ウィンドウに対して提案を生成する CPU およびメモリのリコメンダーが必要になりました。しかし、固定の倍率を使用していた従来の CPU リコメンダーには問題があり、2 ウィンドウアプローチと組み合わせることでそれが大幅に悪化しました。
固定倍率による CPU スケーリングの課題
従来の CPU リコメンダーは、しきい値ベースのアプローチを採用していました。
if utilization > 75%:  scale to 2× current recommendation
if utilization < 37.5%: scale to 0.5× current recommendation
otherwise: no change
この仕組みを 2 ウィンドウアプローチで使用すると、2 つの重大な問題が生じました。
ウィンドウ間の連鎖的スケールアップ
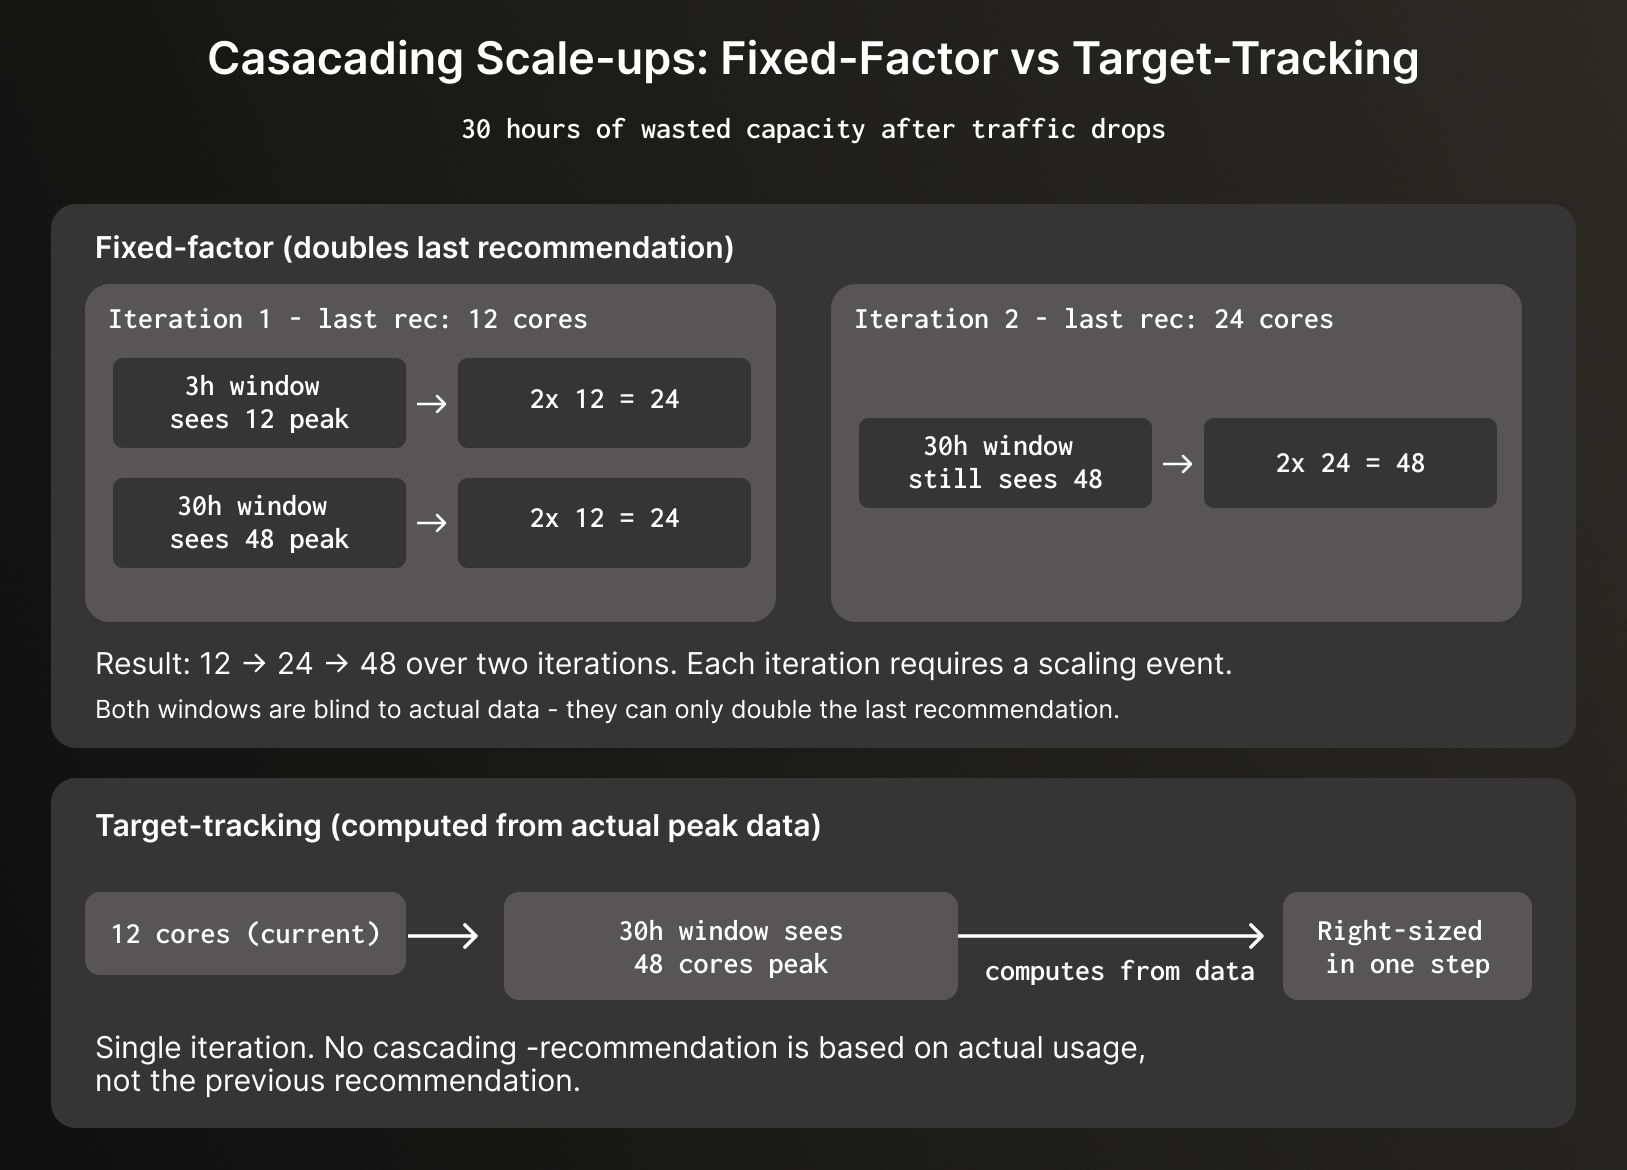
固定倍率アルゴリズムは、*前回の推薦値*を 2 倍または 0.5 倍することしかできず、実際のピーク使用量データから直接算出することができませんでした。2 つのウィンドウを並列で実行している場合、30 時間ウィンドウが大きなピークを*認識*していても、1 回のステップで適切なサイズに到達できませんでした。
例えば、前日に 48 コアまで急増したものの、現在は 12 コアまで低下したサービスを想定してみます。
短いウィンドウにおける振動
ウィンドウを短くすると、2 倍というスケーリング倍率によって激しい振動が発生しました。
Hour 0: 50 cores allocated, 40 cores used (80%) → Scale to 100 cores
Hour 3: 40 cores used / 100 allocated (40%) → Scale to 50 cores
Hour 6: 40 cores used / 50 allocated (80%) → Scale to 100 cores
Hour 9: Repeat...
結果として、わずかな使用量の変化によって数時間ごとに絶え間ないスケーリングの中断が発生しました。
過去の推薦値ではなく、実際の使用量に基づいてスケールするアプローチが必要でした。
ターゲットトラッキング型 CPU 推薦
これらの課題を解決するため、固定倍率アルゴリズムを**ターゲットトラッキング**に置き換えました。ターゲットトラッキングは、**目標とする使用率メトリクス**に基づいてキャパシティをスケーリングします。割り当てを 2 倍や半分にするのではなく、目標使用率を維持するために必要なリソースを正確に計算します。
ターゲットトラッキングの仕組み
このアルゴリズムは、現在の割り当てとウォーターマークに基づいてしきい値バンド(範囲)を計算します。スケーリングは、ピーク使用量がこのバンドを外れた場合にのみ発生します。
min_threshold = current_allocation × low_watermark
max_threshold = current_allocation × high_watermark

if peak_usage outside [min_threshold, max_threshold]:
    new_allocation = peak_usage ÷ target_utilization
else:
    maintain current_allocation
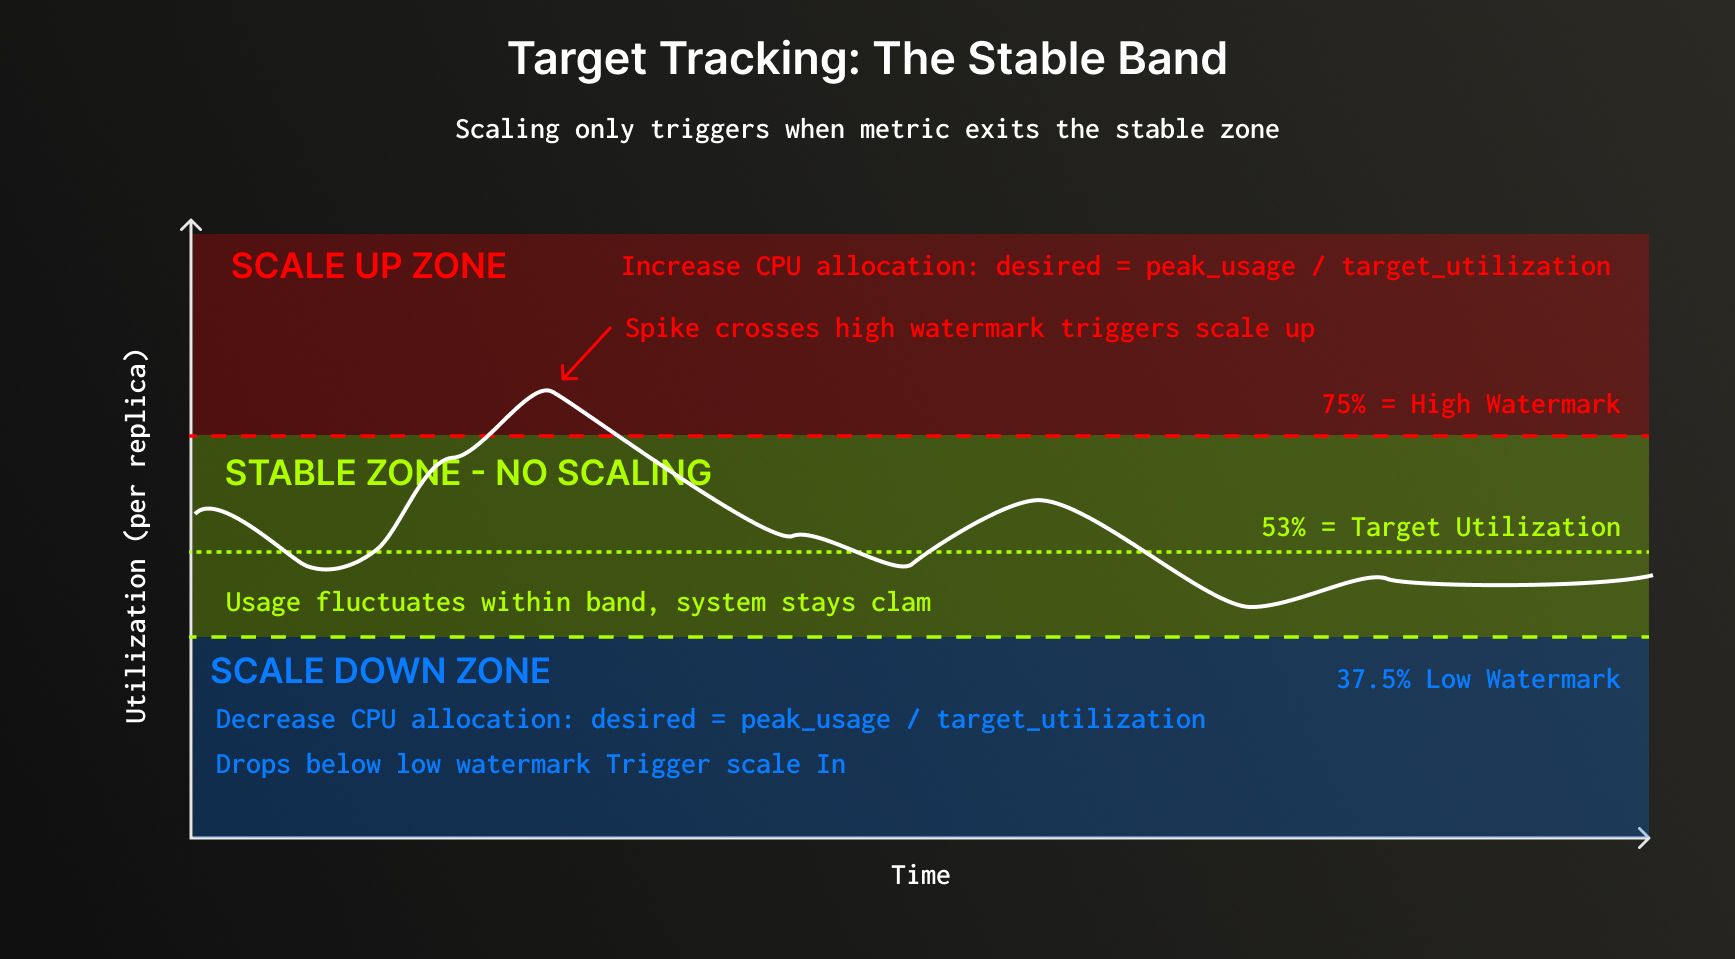
アルゴリズムは目標使用率を達成するようにスケールし、使用量が目標周辺で変動しても新たなスケーリングをトリガーしない安定したバンドを作り出します。現在の実装では、目標使用率はウォーターマークの相乗平均(幾何平均)となっています。
なぜ相乗平均なのか?可逆的なスケーリングの担保
目標使用率は、ウォーターマークの相乗平均に設定されます。
target_utilization = √(high_watermark × low_watermark)
# Example: √(0.75 × 0.375) = √0.28125 = 0.53
これにより**可逆的なスケーリング**が保証されます。つまり、使用量が以前と同じ値に戻れば、割り当てリソースも以前と同じ値に戻ります。
Start: 100 cores, 80 cores usage
Scale up to: 80 / 0.53 = 151 cores

Later, usage drops back to 80 cores:
With 151 cores: 80 / 151 = 53% (within thresholds, no change)

If usage later spikes to 120 cores:
Calculate: 120 / 0.53 = 226 cores

If usage returns to 80 cores again:
With 226 cores: 80 / 226 = 35.4% (below 37.5% low watermark)
Scale to: 80 / 0.53 = 151 cores (same as before!)
目標使用率に相乗平均を使用することで、重要な数学的保証が得られます。
* 可逆的なスケーリング(同じ使用量であれば同じ割り当てに戻る)
* 上下両方向におけるバランスの取れたヘッドルームの確保
* 時間経過に伴う割り当ての偏向(ドリフト)の防止
一時的なスパイクの平滑化
一時的なスパイクへの反応を避けるため、システムはレプリカごとに計算される**中央値の 10 分間ローリングウィンドウ**を使用して CPU 使用率を平滑化します。これにより、持続的な真の負荷上昇を維持しながら、短時間のスパイクをフィルタリングします。その後、システムはすべてのレプリカにおけるこれらの平滑化された値の最大値をピーク使用量として採用します。
ターゲットトラッキングによって CPU 側の課題は解決しました。しかし CPU は全体の一部にすぎず、各ウィンドウはメモリベースの推薦値も必要とします。
メモリベースの推薦
CPU リコメンダーと同様に、各ウィンドウはメモリベースの推薦値も生成します。メモリリコメンダーは、クエリメモリ、実メモリ(Resident Memory)、OOM イベント(ClickHouse 管理およびコンテナレベルの両方)などの複数のシグナルを追跡し、使用状況に応じた乗数を適用して十分なヘッドルームを確保します。
各ウィンドウにおいて、CPU とメモリ両方の推薦値が個別に生成され、システムはより多くのリソースを要求する方を選択します。ClickHouse Cloud では 1 CPU コアに対して 4 GB メモリという固定比率が維持されているため、CPU とメモリは連動してスケールします。
メモリシグナル、偏りに応じた乗数、推薦式の詳細については、[スケーリングに関するドキュメント](https://clickhouse.com/docs/ja/products/cloud/features/autoscaling/overview)をご覧ください。
ターゲットトラッキングを備えた 2 ウィンドウリコメンダーは、稼働中のリソース割り当てを最適化します。しかし、まったくトラフィックがなくなるサービスについてはどうでしょうか。
自動アイドリング
2 ウィンドウリコメンダーは**アクティブな利用時**のリソース割り当てを最適化しますが、ClickHouse Cloud は**完全に非アクティブな期間**向けのコスト最適化機能として、別途**自動アイドリング**も提供しています。
**主な違い**: オートスケーリングがアクティブ期間中の利用パターンに基づいてリソースを調整するのに対し、自動アイドリングは設定された期間クエリを受信しなかった場合にサービスを完全に一時停止します。
サービスがアイドリング状態になると、データはストレージに保持されたまま、コンピュートリソースが停止(CPU/メモリの課金が停止)します。新しいクエリが到達すると、サービスは自動的に再開されます。また ClickHouse Cloud にはアダプティブアイドリングが実装されており、バックグラウンドマージが必要な場合やサービスの初期化時間に応じてタイムアウトを長めに設定すべき場合に、アイドリングを抑止するスマートなロジックを備えています。
自動アイドリング、設定オプション、ユースケース、アダプティブな動作の詳細については、[自動アイドリングのドキュメント](https://clickhouse.com/docs/ja/products/cloud/features/autoscaling/overview)をご覧ください。
まとめ
ターゲットトラッキング型 CPU スケーリングを備えた 2 ウィンドウリコメンダーは、大幅な改善をもたらしました。スケールダウンのレイテンシは 30 時間から 3 時間へと短縮され、振動の課題は最小限に抑えられ、連鎖的な過剰プロビジョニングが解消され、変動の大きなワークロードにおけるインフラコストが大幅に削減されました。
重要なポイントは、**時間ウィンドウによって得意とするタスクが異なる**ということです。短いウィンドウは即応性のあるスケールダウンに適しており、長いウィンドウは安定したスケールアップの判断に適しています。両方のウィンドウからの推薦値をマージすることで、それぞれの長所を最大限に引き出すことができます。
メモリベースの推薦やアイドリング機能と組み合わせることで、これらの改善は ClickHouse のオートスケーリングシステムをより高速で、より安定し、よりコスト効率の高いものへと進化させ、ユーザーが安心して本番ワークロードを実行できるようにしました。2 ウィンドウリコメンダーとターゲットトラッキングアルゴリズムは強固な基盤を提供しており、私たちは割り当てを実際の使用率へとさらに近づけるべく、スケーリングアルゴリズムの改良を続けています。
---
## 今すぐ始める
実際のデータでClickHouseの動作を確認してみませんか?ClickHouse Cloudなら数分で利用開始でき、300ドル分の無料クレジットも進呈されます。
[サインアップ](https://console.clickhouse.cloud/signUp?loc=blog-cta-2206&utm_blogctaid=2206)
---