---
title: "リアルタイム分析のエンドツーエンドのコストパフォーマンス:Snowflake vs. ClickHouse Cloud"
date: "2026-07-23T13:29:57.500Z"
author: "Tom Schreiber, Mark Needham and Lionel Palacin"
category: "Engineering"
excerpt: "リアルタイム分析は、単にクエリが速いだけでは終わりません。CostBench は、継続的なデータ取り込み、クエリ可能な状態を保つためのデータメンテナンス、鮮度、クエリレイテンシ、コストまで含めた全経路にわたって、Snowflake と ClickHouse Cloud を比較します。"
---
# リアルタイム分析のエンドツーエンドのコストパフォーマンス:Snowflake vs. ClickHouse Cloud
## TL;DR
リアルタイム分析のベンチマークは、システムをエンドツーエンドで測定する必要があります。すなわち、新鮮なデータの取り込み、クエリ実行可能な状態で維持されるデータ、高速な回答の返却、そしてそのパイプライン全体を稼働させ続けるコストです。
CostBench が測定するのは、まさにこれです。継続的な取り込み、データ維持、クエリ実行にかかるコストとレイテンシをまとめて捉えます。というのも、システムごとに作業を費やす箇所が異なるからです。
静的データセットに対する読み取り専用のベンチマークは、データがすでに準備された状態でクエリがどれだけ速く返るかを示すことはできます。しかし、そのデータをクエリ実行可能な状態にするためのコストや、新鮮なデータが継続的に到着して並列で維持され続けている状況でクエリが高速なまま保たれるかどうかは示せません。
本記事では、CostBench を用いて、リアルタイム分析の全パスにわたって Snowflake と ClickHouse Cloud を比較します。
**動画のウォークスルーがお好みですか?**
このウェビナーでは、同じベンチマークのストーリーを動画形式で扱い、結果の背後にある仕組みをより深く掘り下げます。全パスにおけるコストパフォーマンス、継続的に変化するデータ、そしてなぜ ClickHouse は取り込み時点でクエリ実行可能であり、マテリアライズドビューがベーステーブルと同期し続けられるのかを解説します。
## リアルタイム分析はクエリが走った時点で始まるわけではない {#realtime_analytics_does_not_start_when_a_query_runs}
> リアルタイム分析は、新鮮なデータが到着した時点で始まります。
ダッシュボード、ユーザー、AI エージェントが素早い回答を得られるようになるまでに、システムは既に多くの作業をこなしています。新しい行の取り込み、プルーニングのための整理、派生テーブルの維持、鮮度の保持、そして低レイテンシクエリのための読み取り容量の確保などです。
その全パスを測定するために設計されたのが [CostBench](https://clickhouse.com/blog/costbench-data-warehouse-cost-performance) です。最終的な読み取りクエリだけでなく、新鮮なデータを高速な回答へと変換する稼働中のシステム全体を対象とします。
これは、[以前のクエリ実行可能データに関するベンチマーク](https://clickhouse.com/blog/write-side-cost-performance-snowflake-clickhouse)の中核的な考え方でもありました。そこでは、このパスの重要な一側面、つまりデータを継続的に取り込みつつ、**同時に**生データを高速な分析読み取り向けに物理的に整理された状態で保つことのコストパフォーマンスを測定しました。
Snowflake は、このベンチマークに対して[一連の推奨事項で応答](https://www.snowflake.com/en/blog/engineering/efficient-snowflake-ingestion-query-ready/)しました。異なる取り込み方式を使う、ロードにより大きなウェアハウスを使う、利用可能な場所では Snowflake の新しいリアルタイム機能を使う、といった内容です。
これらの推奨事項の中には、Snowflake のセットアップを改善するものもあります。一方で、別の問いに答えているものもあります。例えば、持続的なクエリ実行可能性ではなく最大スループットが目的である場合に、Snowflake がどれだけ速くデータをバッチロードできるか、といったものです。しかしどれもが、私たちが最初に掲げた同じ原則に立ち戻ります。
> リアルタイム分析システムは、取り込み・維持・読み取りの個別テストではなく、全パスとしてベンチマークされるべきです。
本記事はまさにそれを行います。CostBench を使って、この比較をエンドツーエンドのベンチマークとして再実行します。継続的な取り込み、生データの整理、事前集計の鮮度、そして継続的なクエリ配信です。私たちは Snowflake の 2 つのパスをテストします。広く利用可能な標準テーブル構成と、新しい Interactive Tables 構成です。
すべてのベンチマークコードと結果は、[CostBench リポジトリ](https://github.com/ClickHouse/CostBench/tree/main/full-path-realtime/quotes)で公開されています。株価データセットには[別途データライセンス](https://github.com/ClickHouse/CostBench/tree/main/full-path-realtime/quotes#data-source--licensing)が必要なため、データそのものは再配布できません。
## CostBench は分析パス全体を測定する
> 静的なデータセットをロードし、各クエリを複数回実行して、最速のホットキャッシュ結果を報告するやり方では、リアルタイム分析システムの性能もコストも反映されません。
大半のデータベースベンチマークは、静的なデータセットを一度ロードし、システムに完全に準備させ、その後に各クエリを複数回実行して最速のホットキャッシュ結果を報告します。これは、安定した既に準備済みのデータに対する繰り返しの読み取りを測定しているに過ぎません。新鮮なデータをクエリ実行可能にするための時間とコスト、あるいは、取り込み・維持・リフレッシュ作業がバックグラウンドで並行して走り続け、キャッシュも単一の静的ビューには決して落ち着かないという、絶えず変化するデータに対して継続的に走るクエリの挙動は示せません。
これが CostBench を作った動機です。
CostBench は、分析パス全体にわたってコストパフォーマンスを測定します。
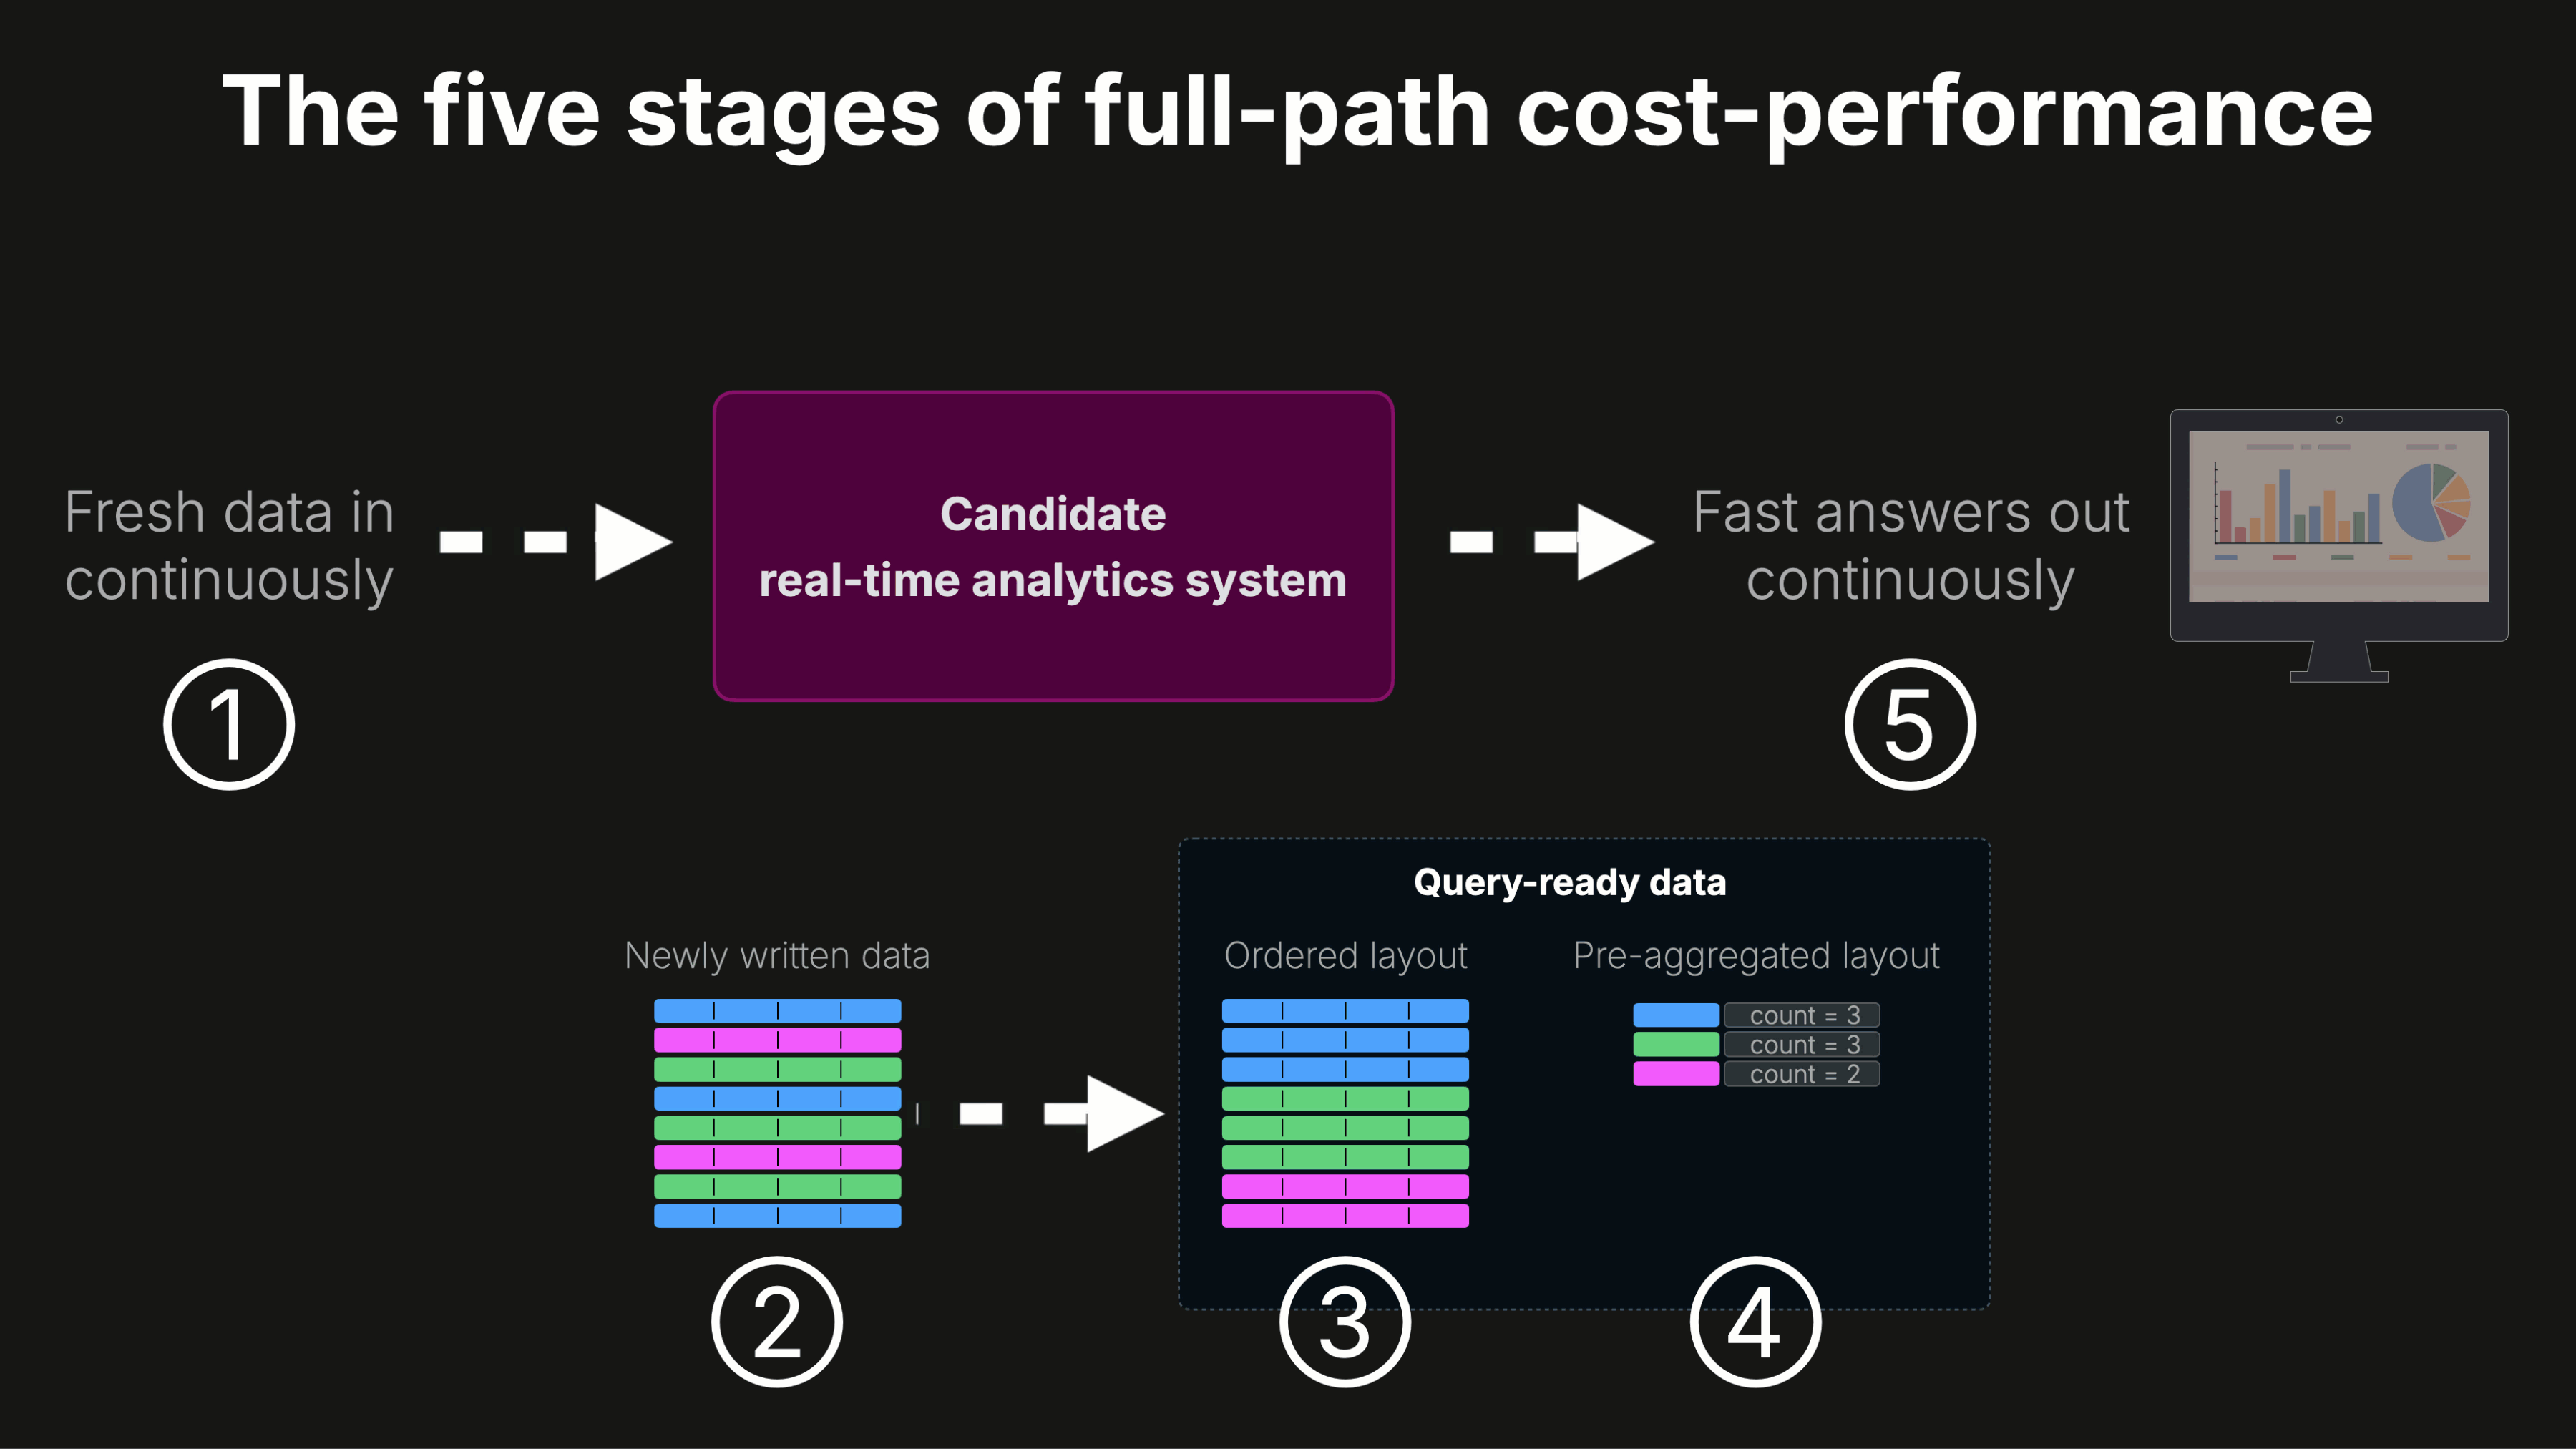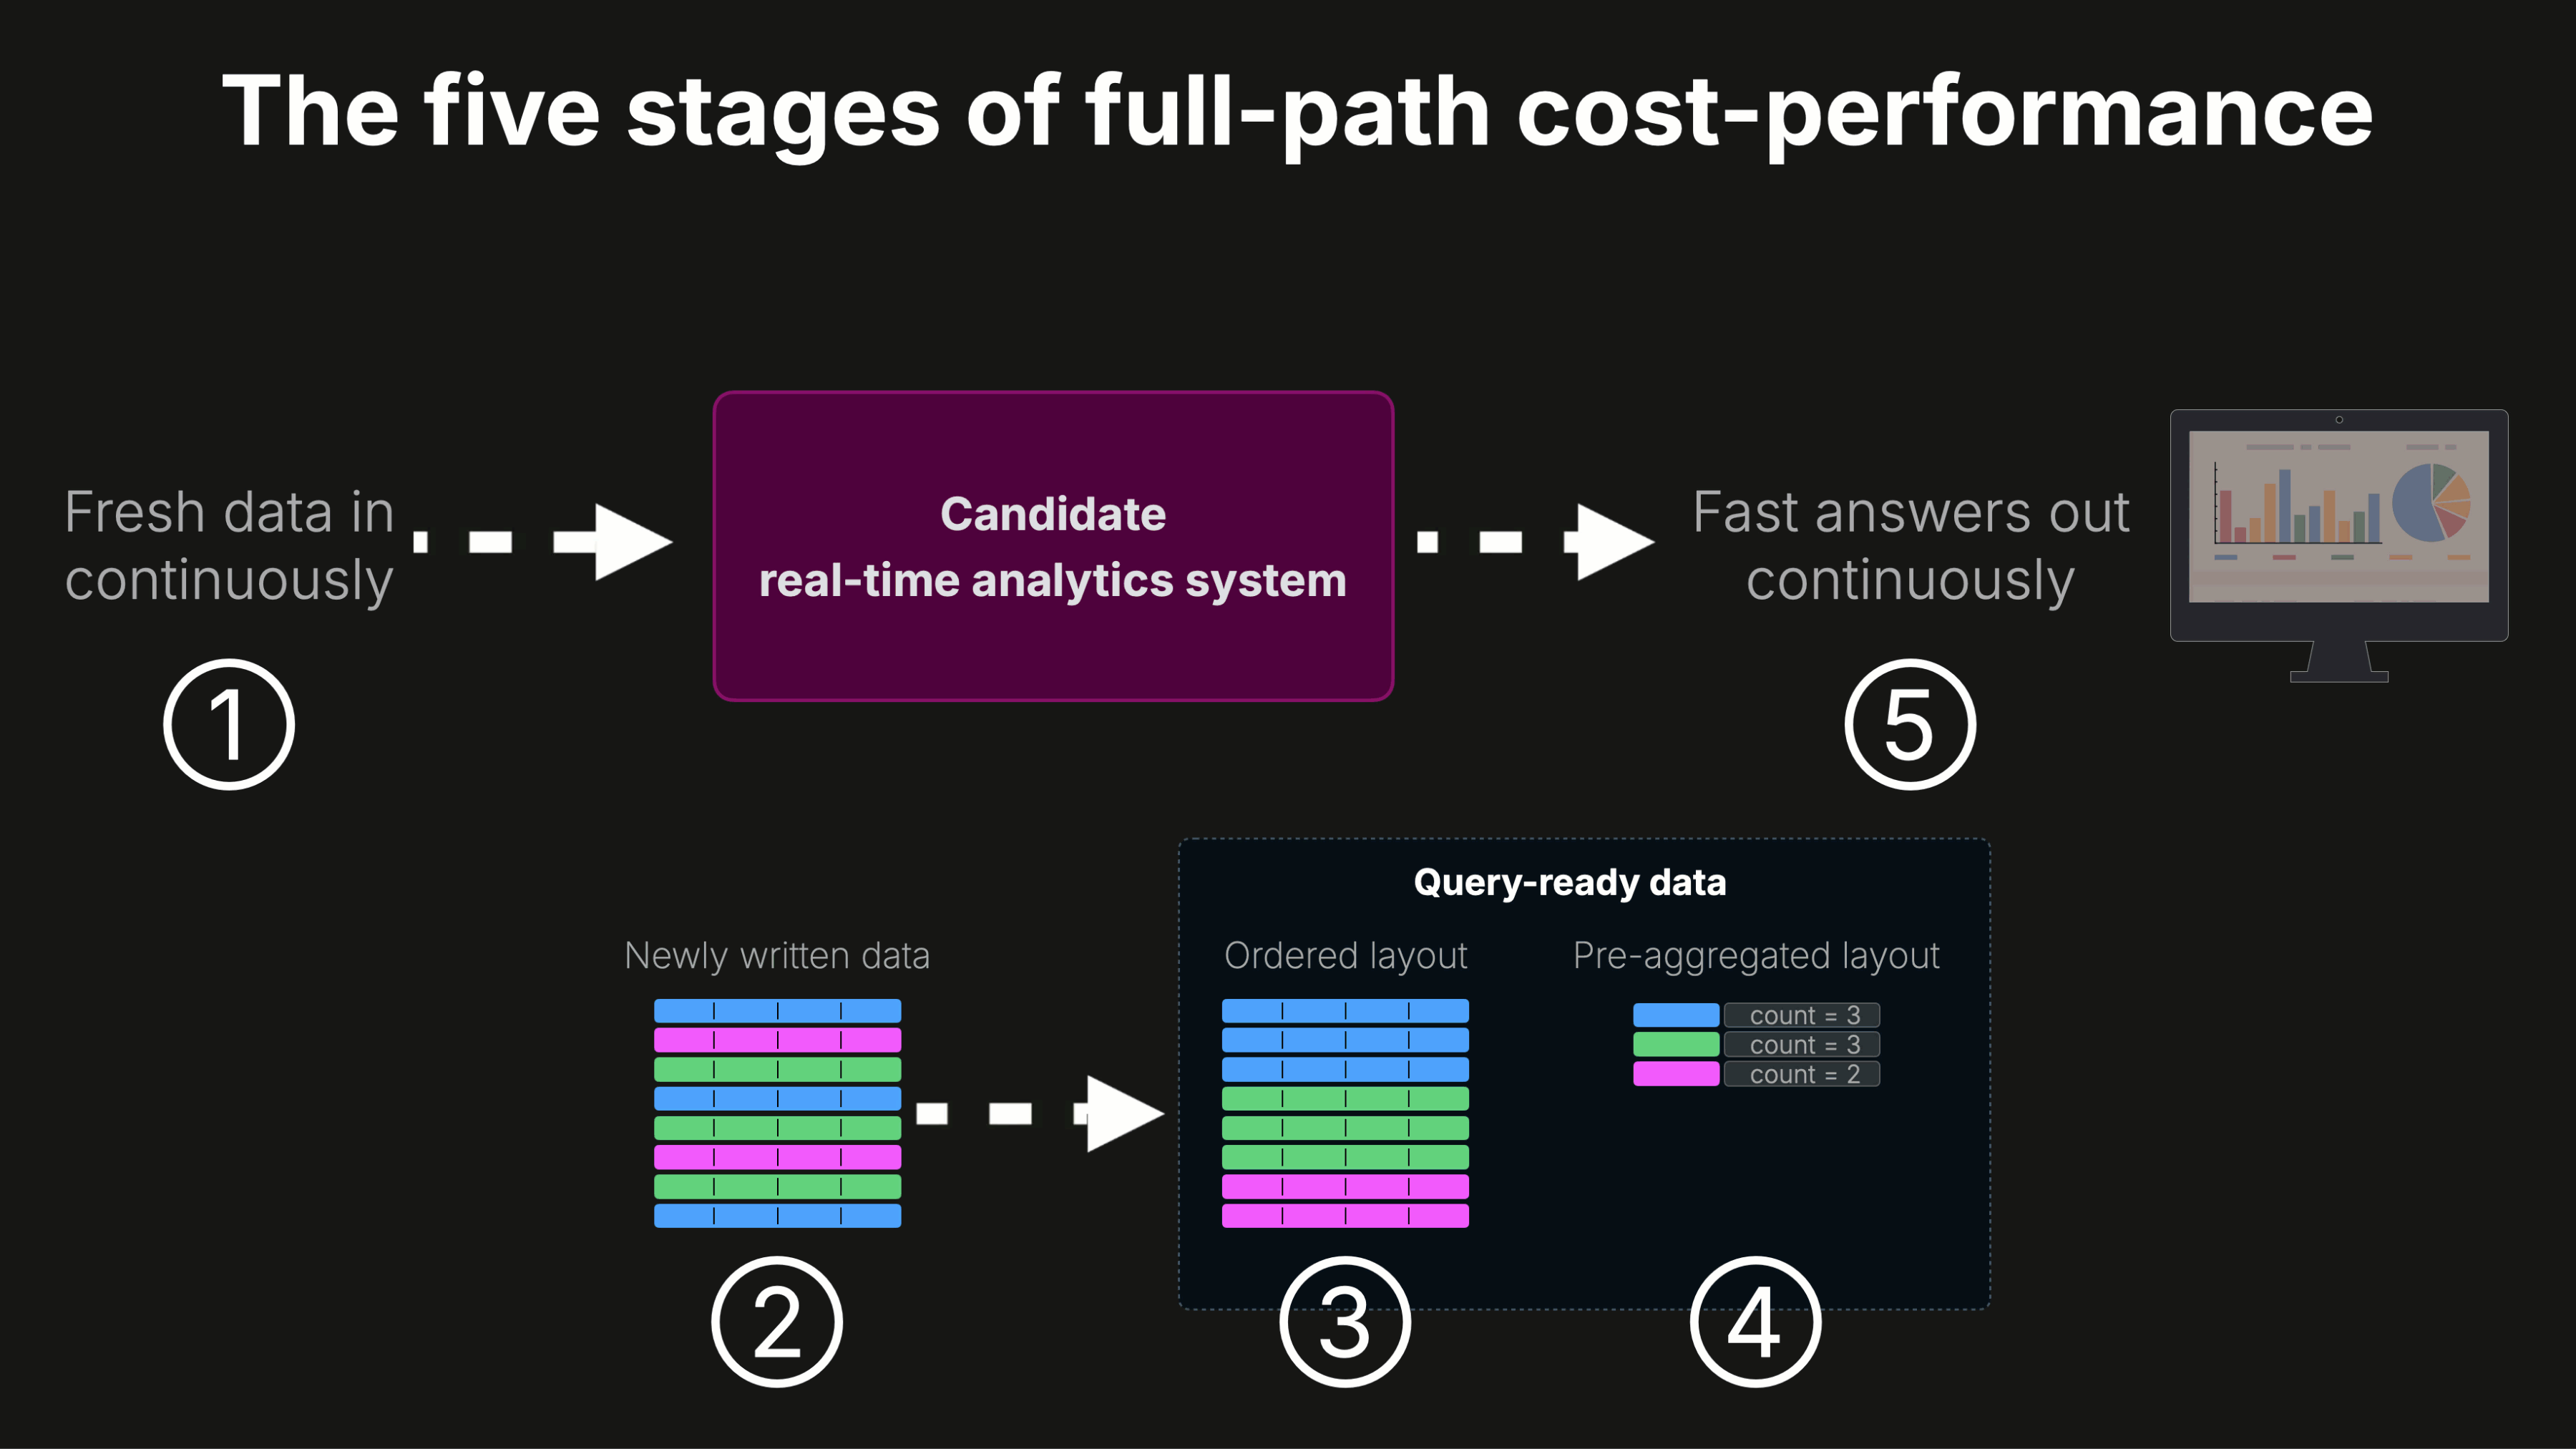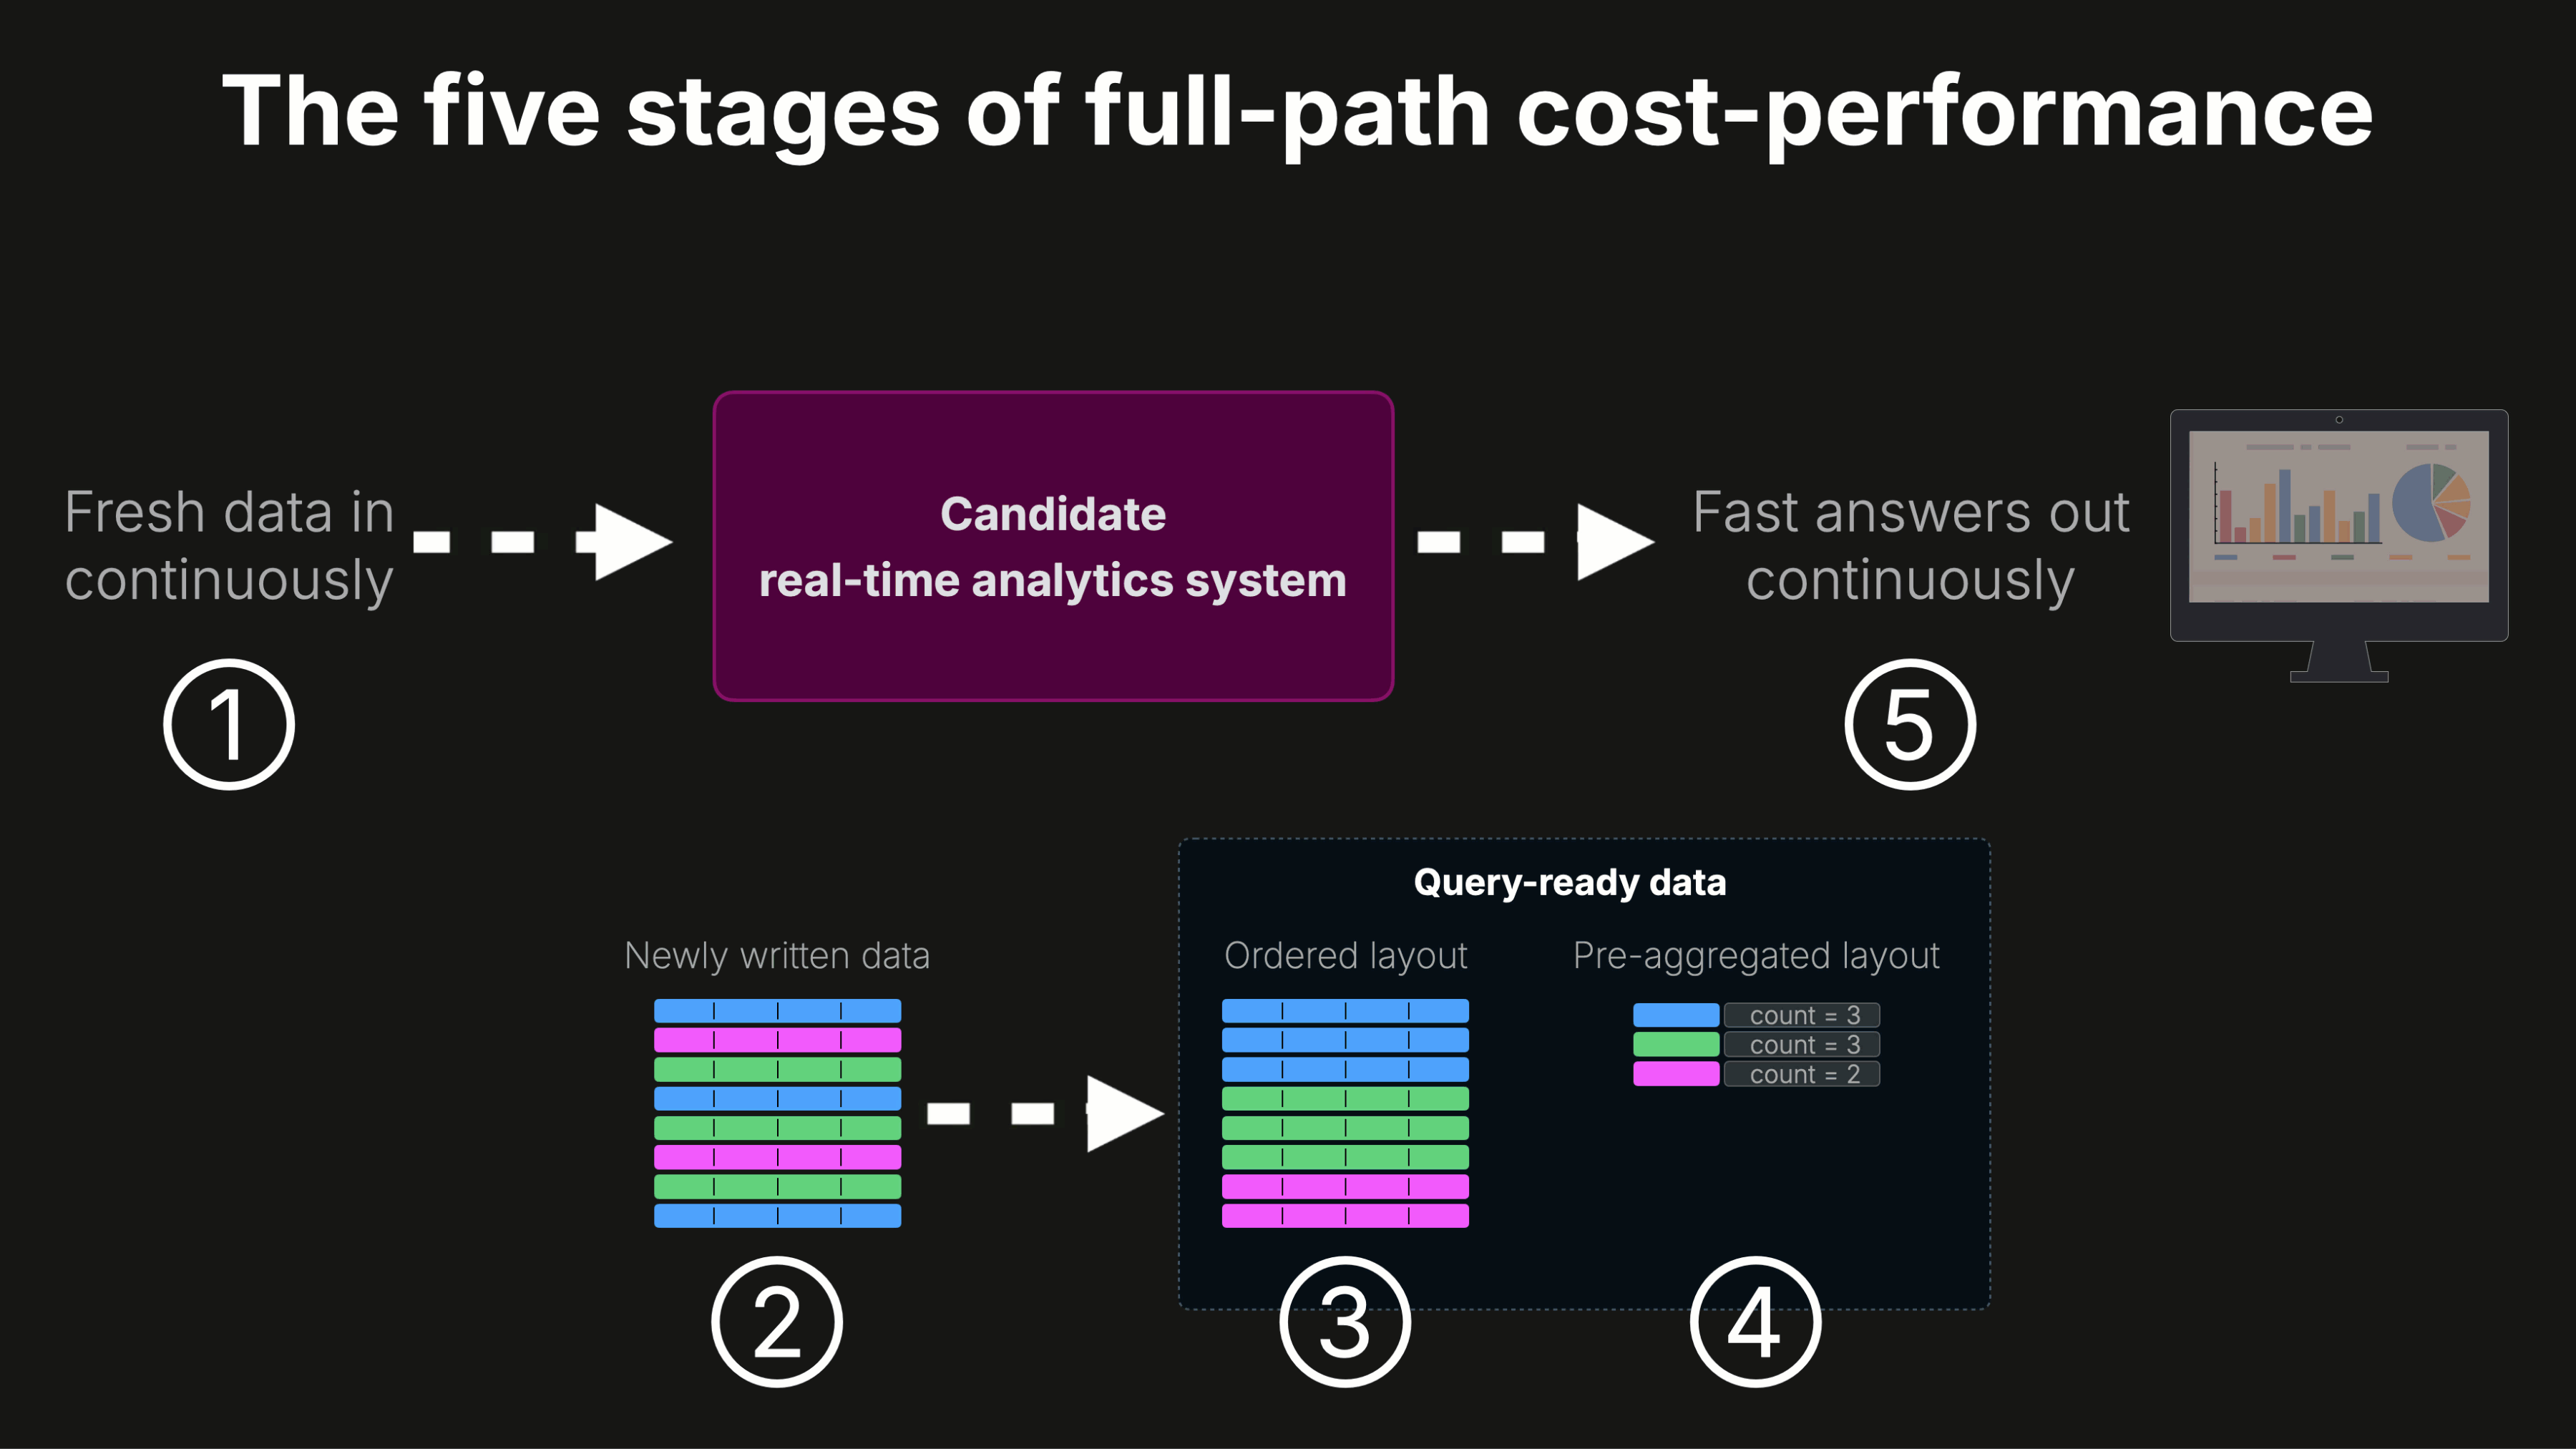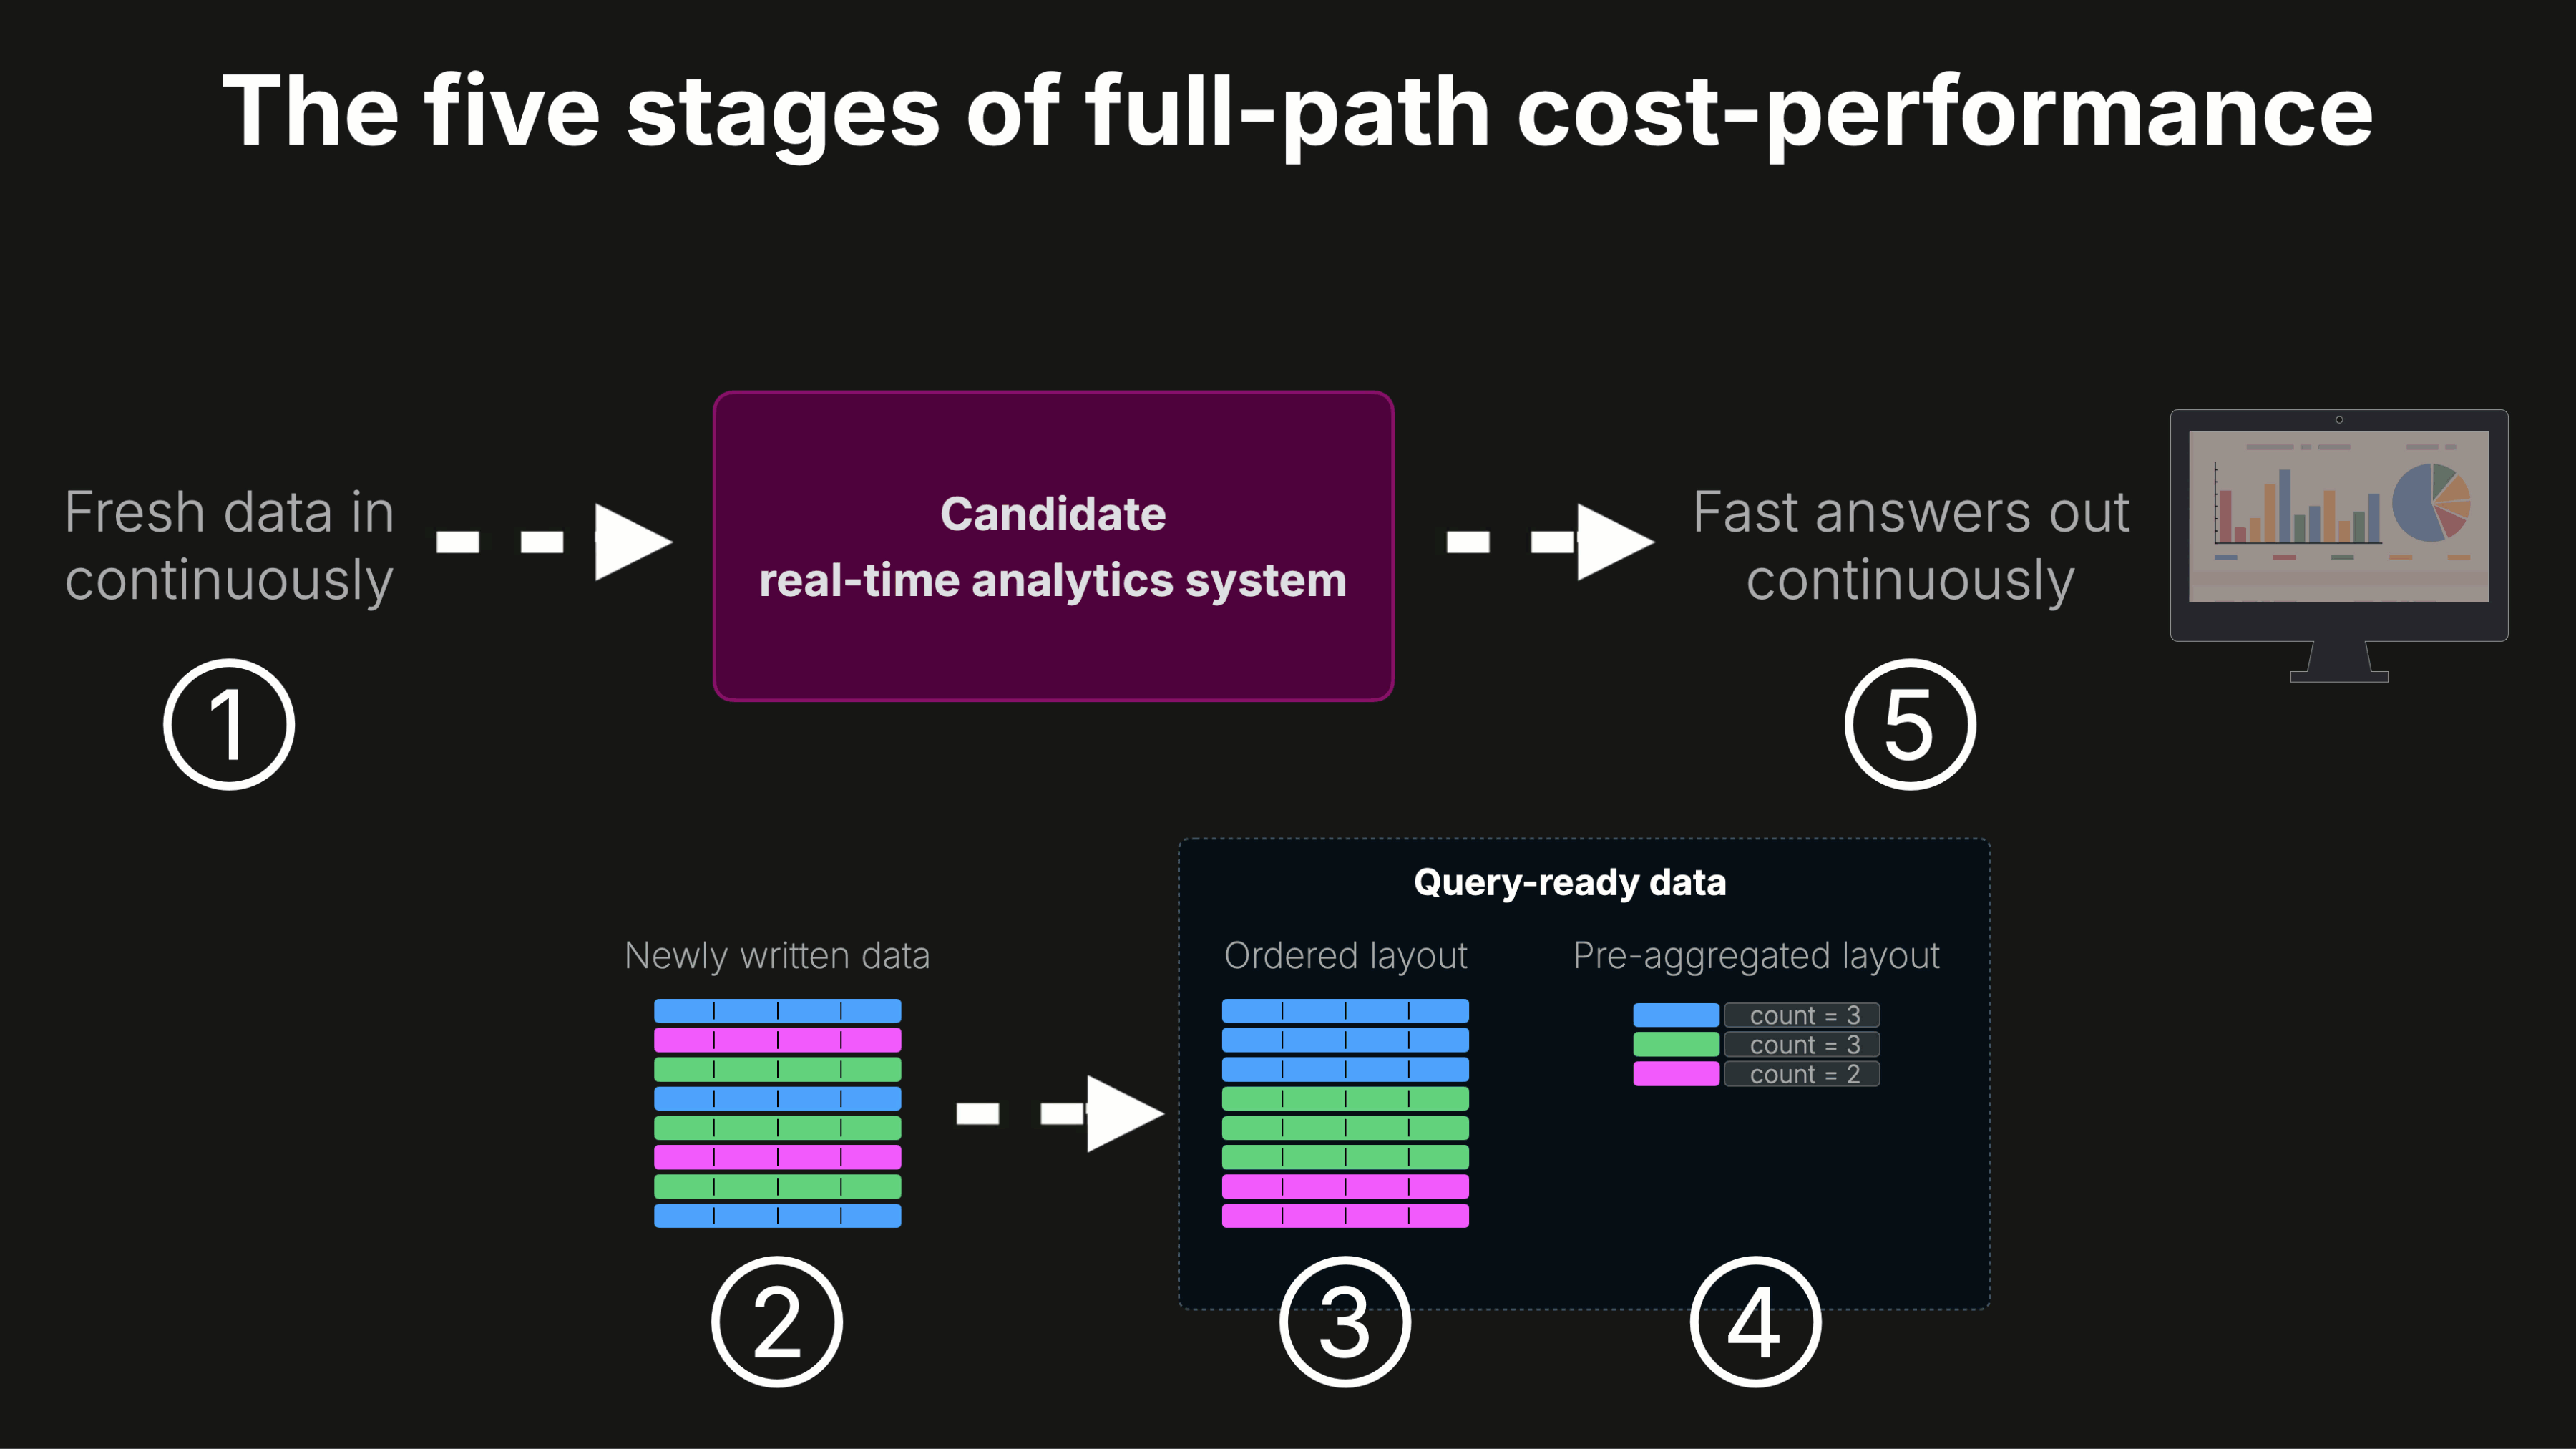
① 新鮮なデータが継続的に到着します。
② システムはそのデータを書き込み、[クエリ実行可能](https://clickhouse.com/blog/write-side-cost-performance-snowflake-clickhouse#what-does-query-ready-mean)な状態にします。
③ 生データは順序付けられたレイアウトで保持され、後続のクエリはテーブル全体をスキャンする代わりに大部分をスキップできます。
④ システムは事前集計データを維持し、最低レイテンシのクエリはクエリ時にさらに少ないデータのみを読むことになります。
⑤ 最後に、システムは絶えず変化するデータに対して継続的に高速な回答を提供しなければならず、その間も取り込み・維持・リフレッシュ作業がバックグラウンドで走り続けます。
> **CostBench はバルクロードやバックフィルのベンチマークではありません**
CostBench は、新鮮なデータがソースで継続的に生成され、到着次第クエリ実行可能とならなければならない[リアルタイム分析システム](https://clickhouse.com/blog/selecting-a-real-time-analytical-database)をシミュレートします。既に存在するデータをシステムがどれだけ速くロードできるかを問うバルクロードやバックフィルのベンチマークではありません。
本記事では、この方法論を Snowflake と ClickHouse に適用します。
---
## ClickHouse Cloudでリアルタイム分析を始める
ClickHouse Cloud で、新鮮なデータを取り込み、常にクエリ可能な状態に保ち、低レイテンシなクエリを提供しましょう。$300 分の無料クレジットで数分以内に始められます。
[Sign up](https://console.clickhouse.cloud/signUp?loc=blog-cta-1369-clickhouse-cloud-sign-up&utm_blogctaid=1369)
---
## 最初のベンチマークで測定したもの:クエリ可能な生データ {#what_our_first_benchmark_measured_queryready_raw_data}
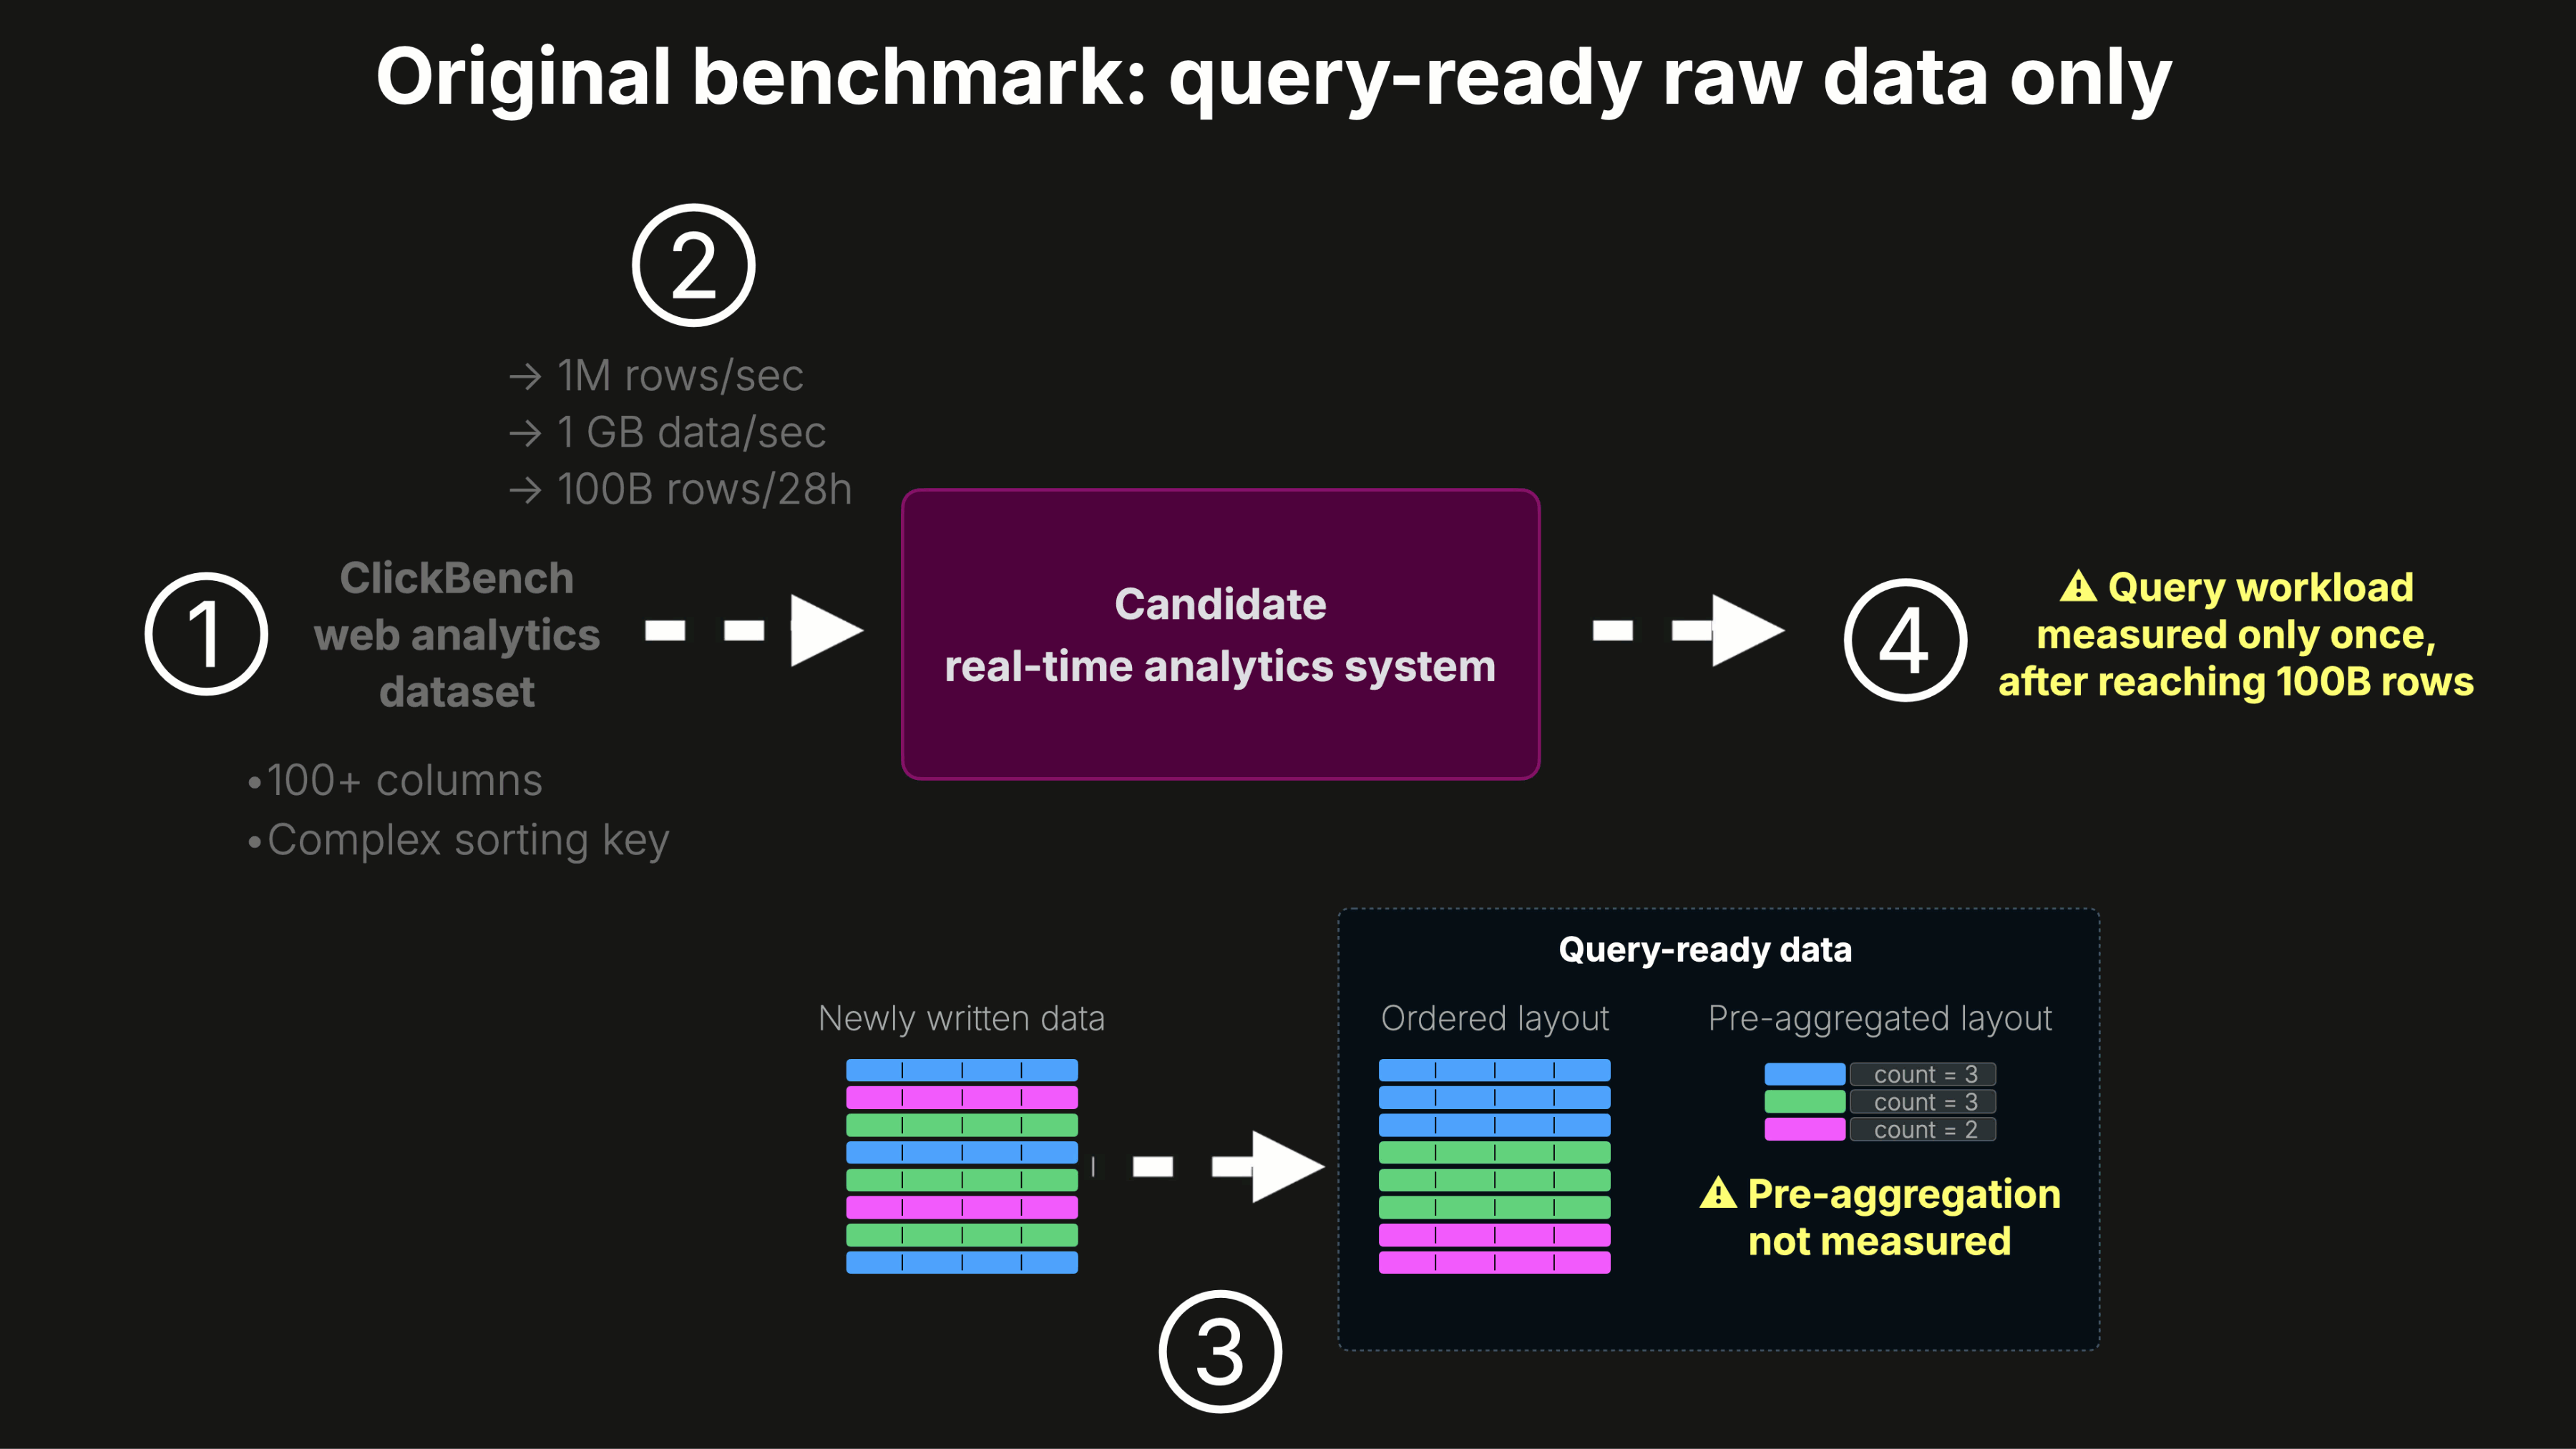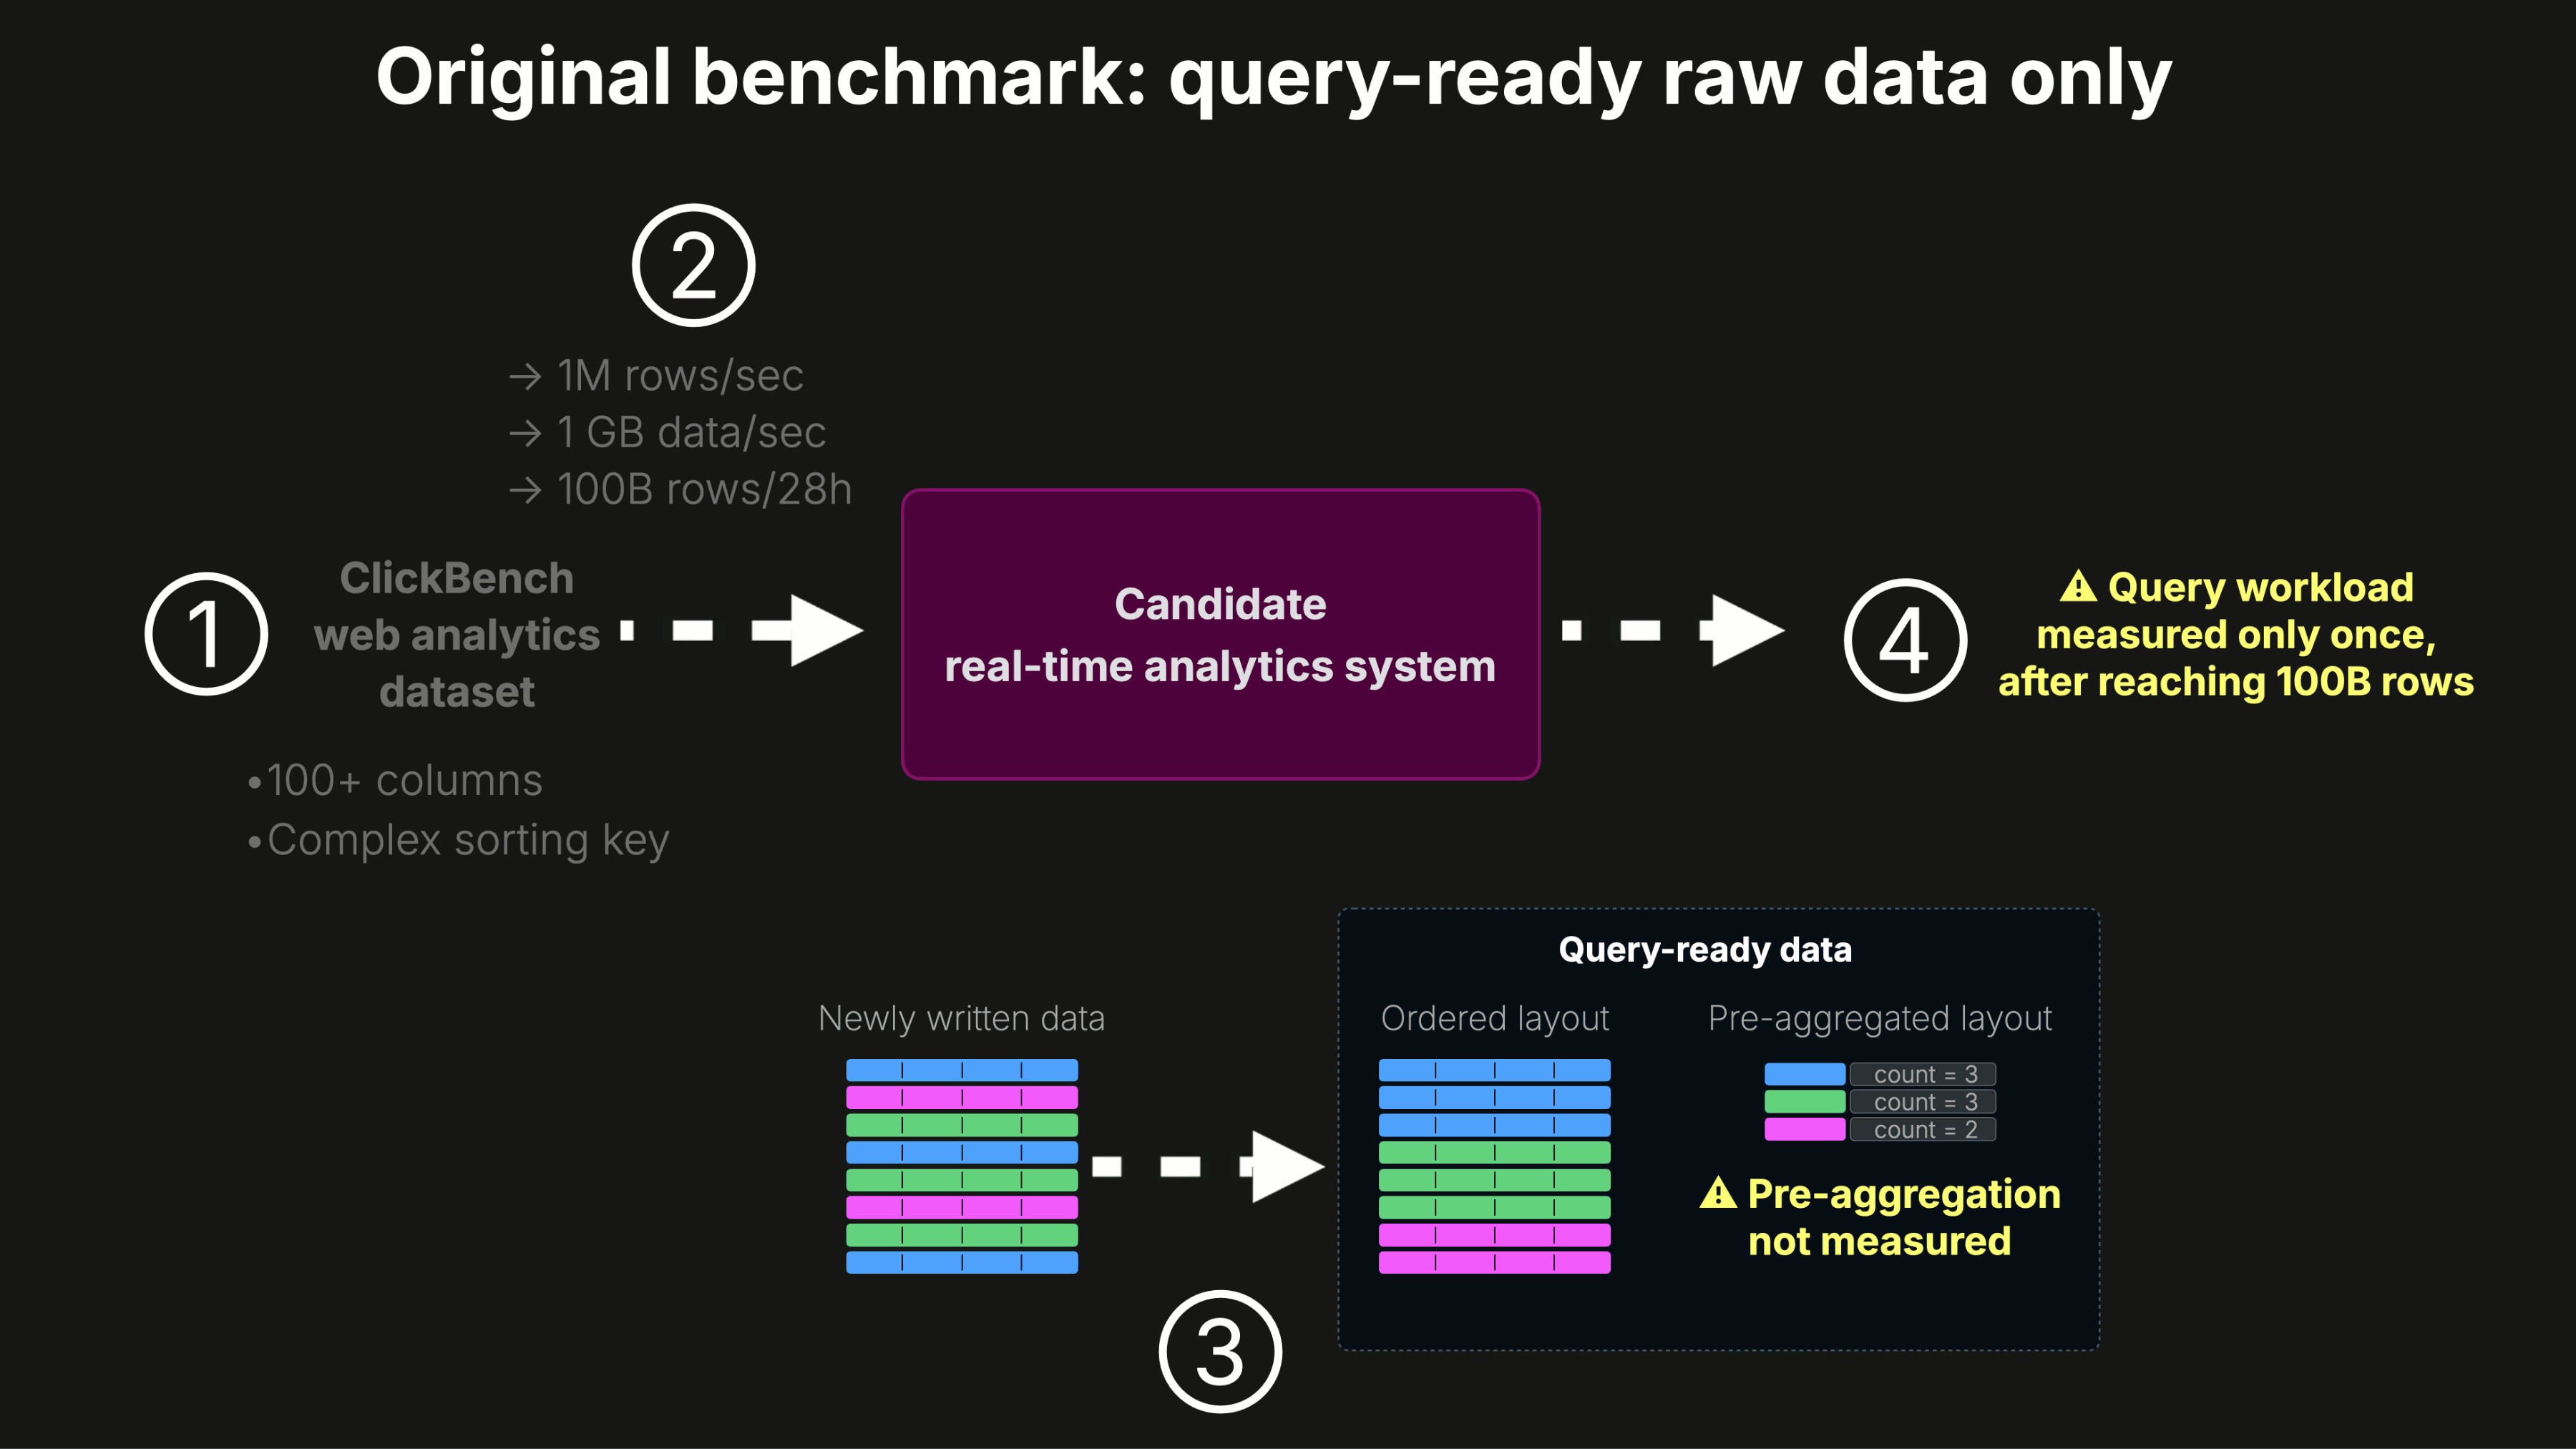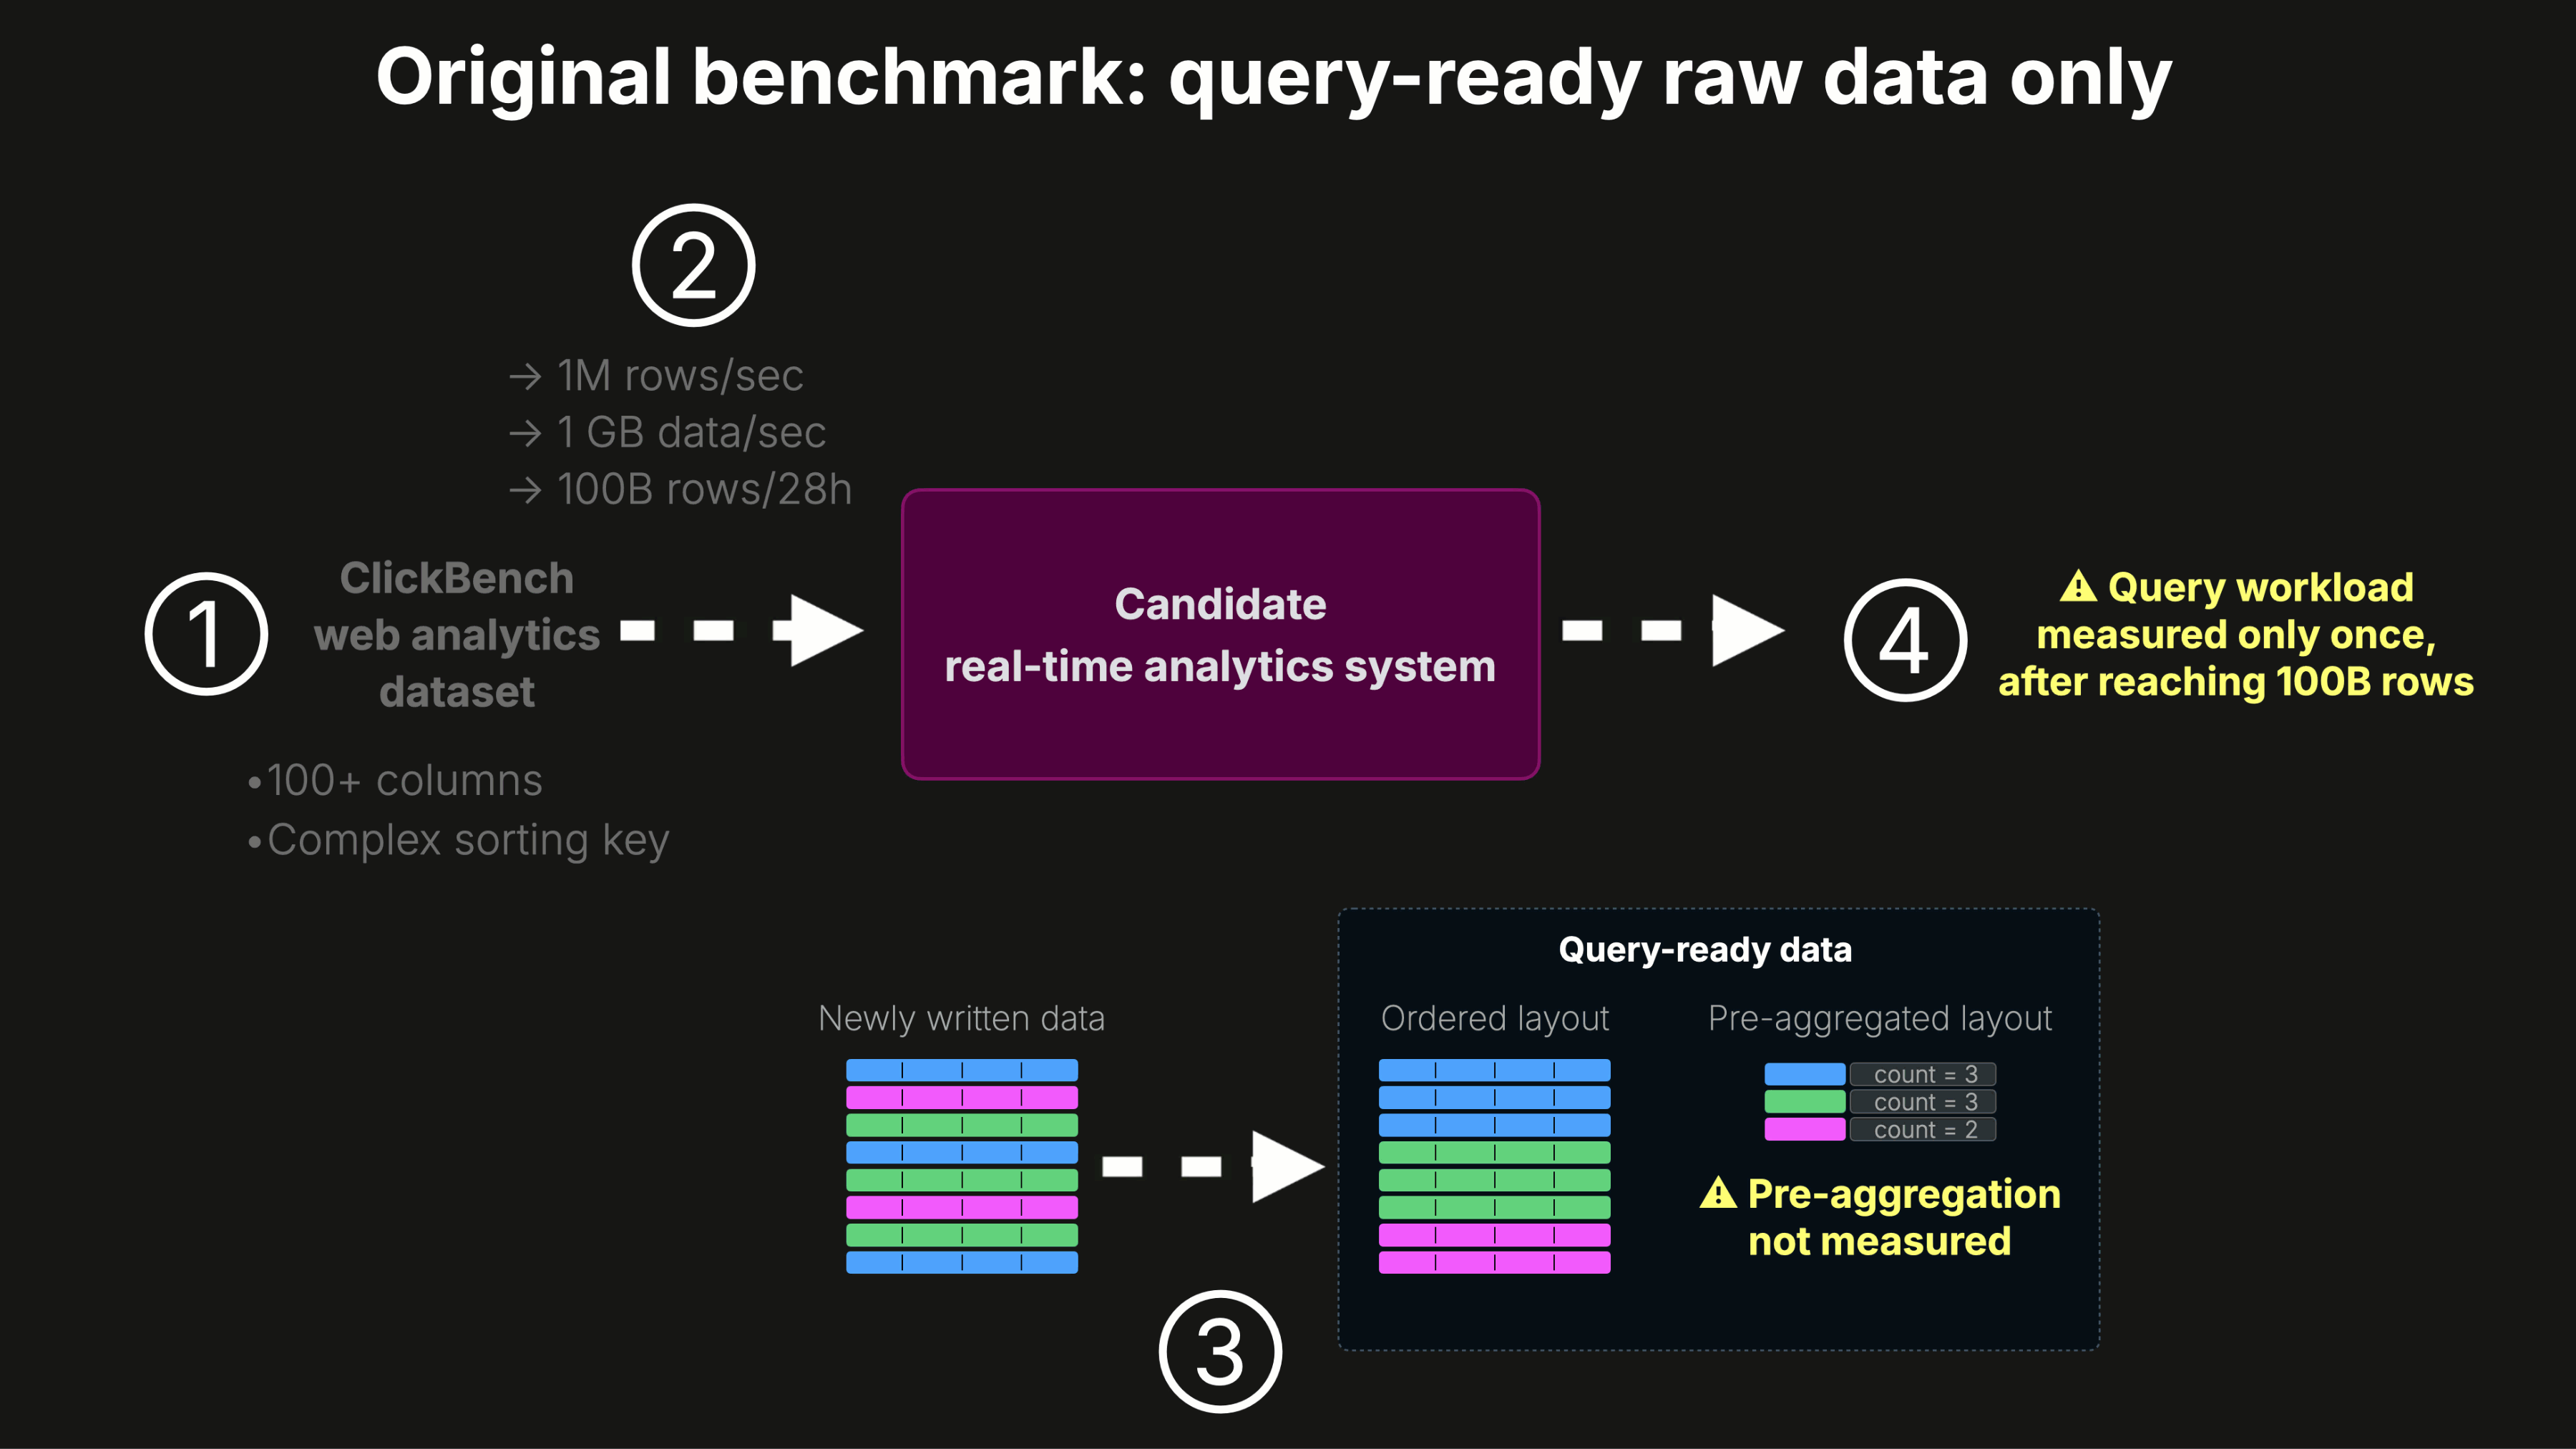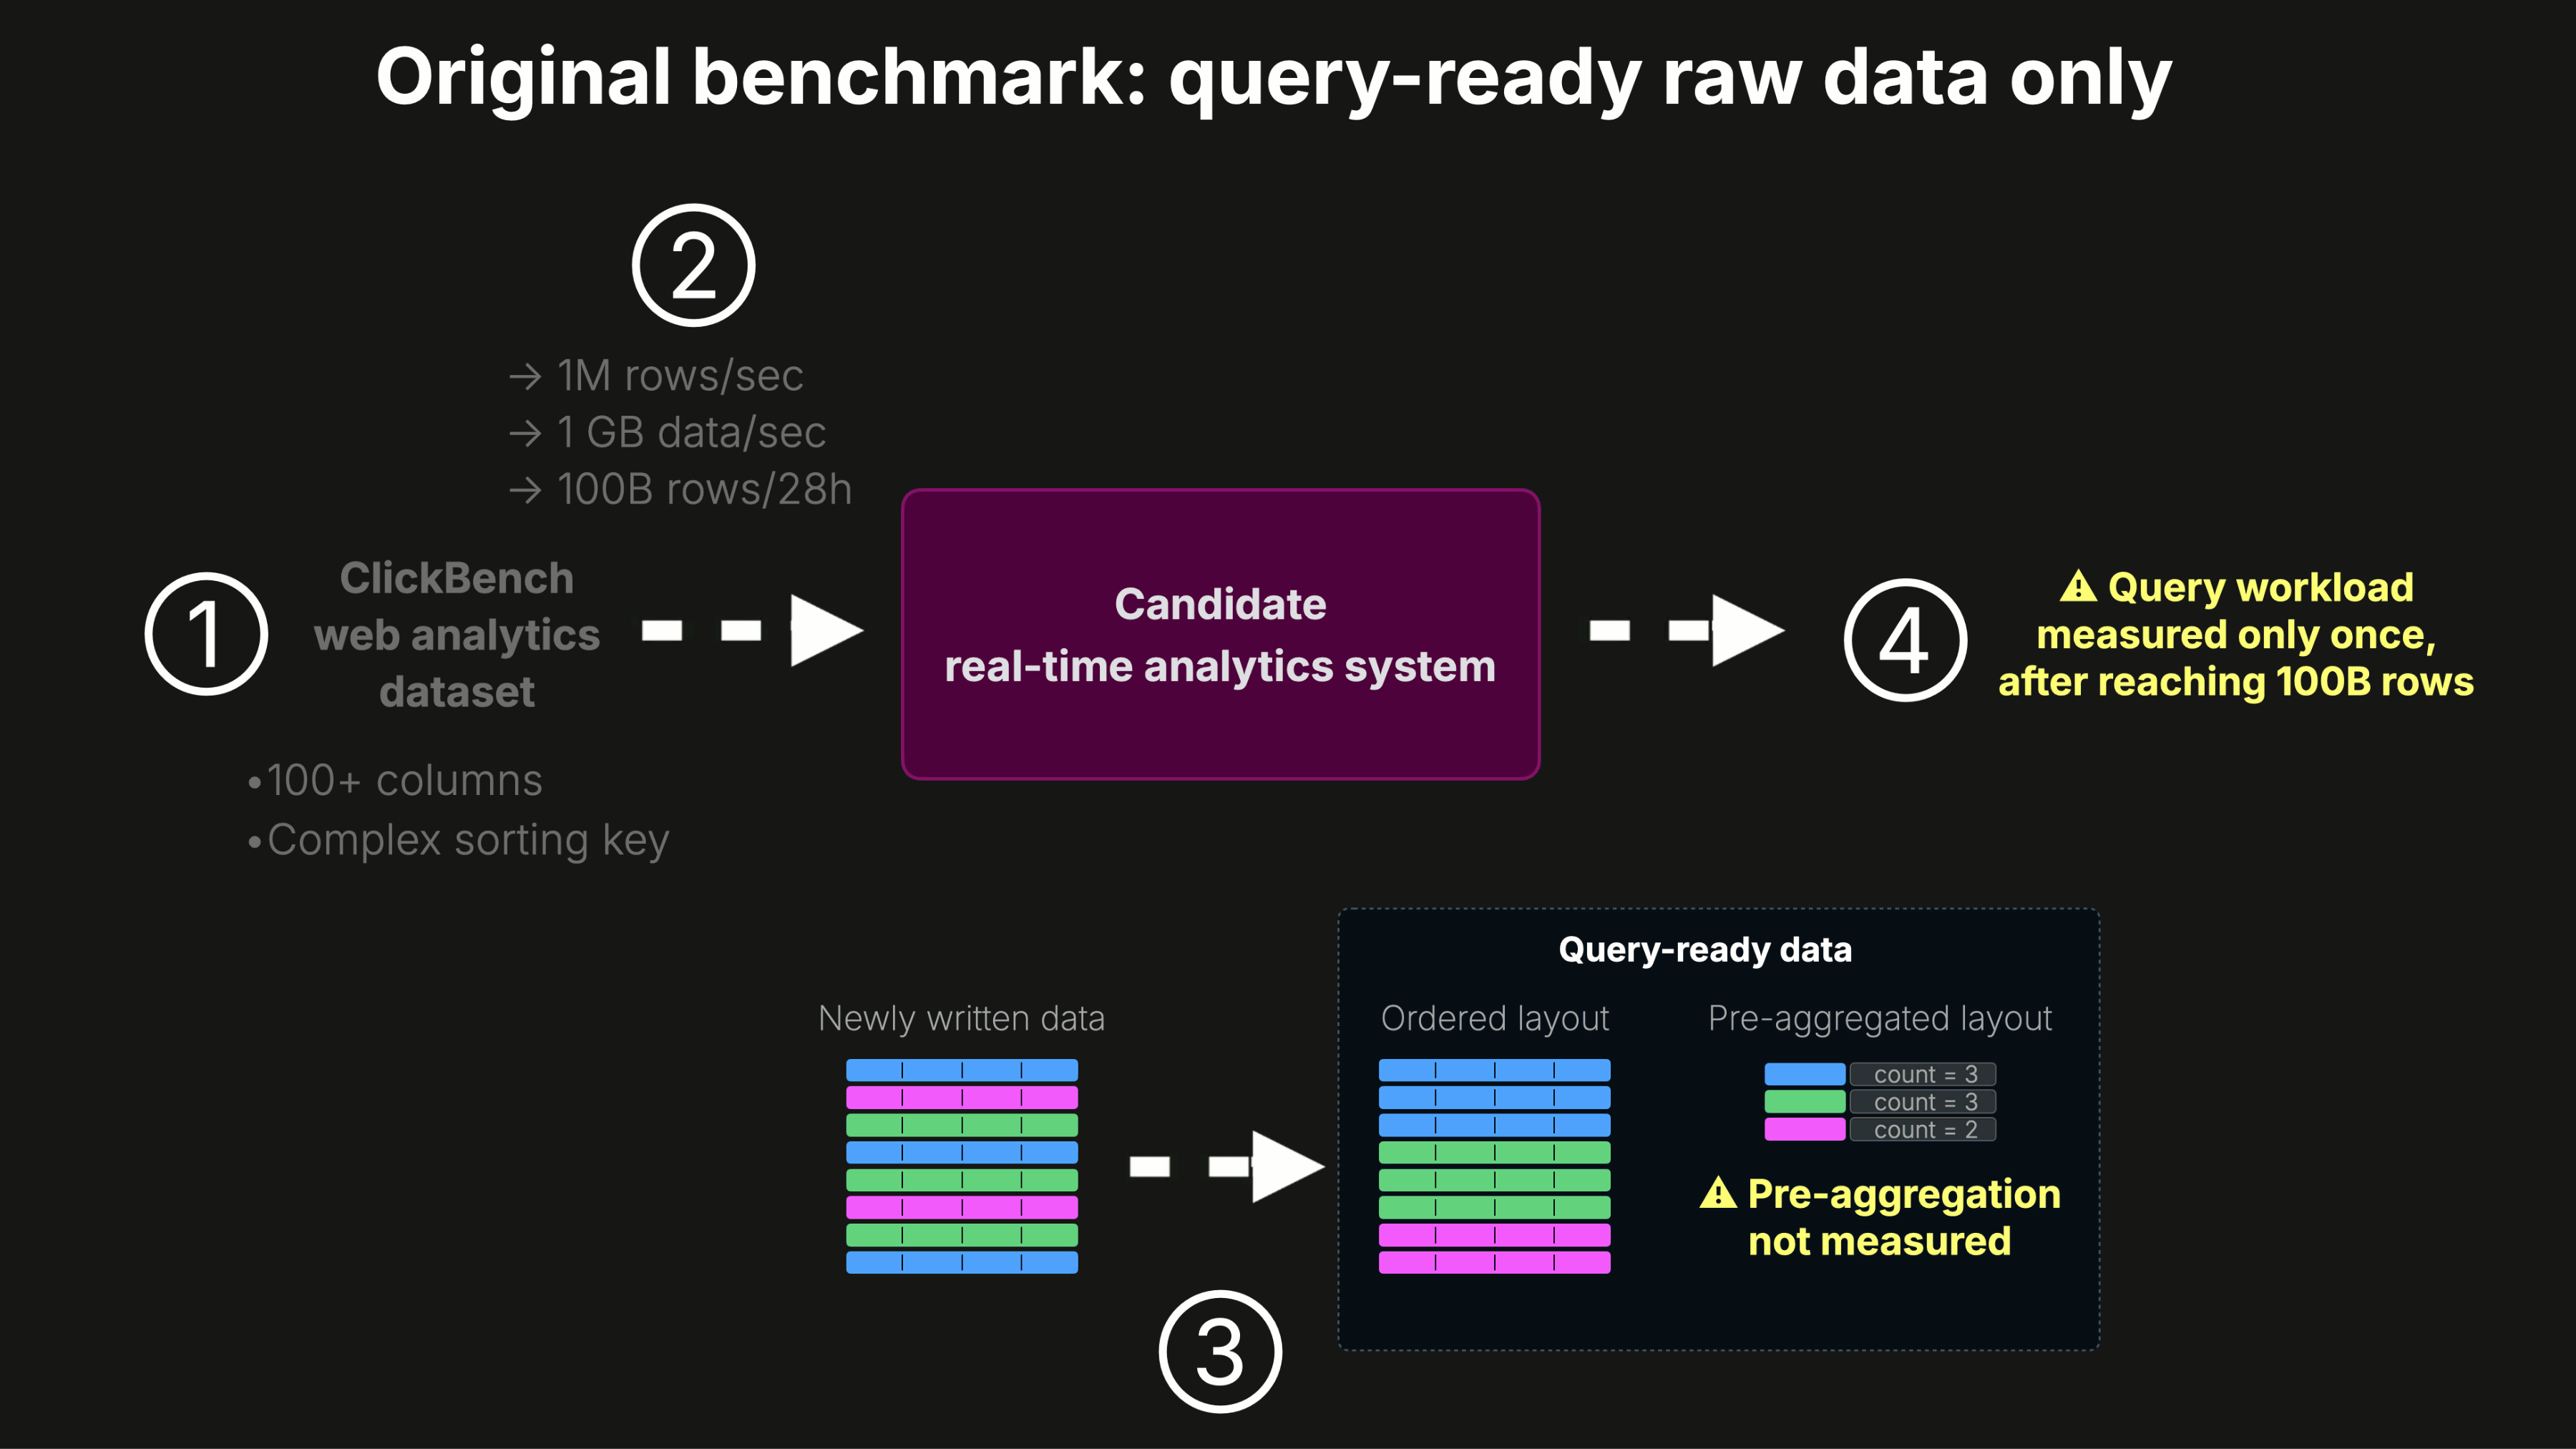
私たちの[当初のベンチマーク](https://clickhouse.com/blog/write-side-cost-performance-snowflake-clickhouse)では、[リアルタイム分析](https://clickhouse.com/blog/selecting-a-real-time-analytical-database)のフルパスにおける重要な一部を測定しました。すなわち、新たに書き込まれた生データを継続的にクエリ可能な生データに変換するコストです。
以下に元のセットアップと、それに関するSnowflakeからの主なコメントを示します。
### **① データセットと順序キー** {#dataset_and_ordering_key}
私たちは[ClickBench](https://benchmark.clickhouse.com/) のWeb分析データセットを使用し、ClickBenchの[ワークロード](https://github.com/ClickHouse/ClickBench/blob/main/clickhouse-cloud/queries.sql)で使用されている[100を超える列と元のマルチカラムソートキー](https://github.com/ClickHouse/ClickBench/blob/main/clickhouse-cloud/create.sql)を採用しました。
この選択は意図的なものでした。ClickBenchのクエリの多くは、この順序によってClickHouseで恩恵を受けるため、後続のクエリ性能測定を公平に保つため、Snowflakeでも同等のクラスタリングキーを使用しました。
> **Snowflakeのコメント:** よりシンプルなクラスタリングキーを使用し、元のClickBenchデータセットを繰り返して1000億行に到達させることで生じる人工的な到着パターンを避けるべき。
これは妥当な指摘であり、以下の拡張ベンチマークで両方に対処しています。ただし、これらは実際には異なる問いに答えています。すなわち、「データがどのように到着するか」と「ワークロードに対してシステムがどのような物理レイアウトを維持しなければならないか」という問いです。
### **② 固定レートでの連続インジェスト** {#continuous_ingest_at_a_fixed_rate}
データを毎秒約100万行、すなわち非圧縮データで約1GB/秒の速度で連続的にインジェストしました。
これは最大スループットのロードテストではありませんでした。インジェストレートは、新しいデータが継続的に到着するリアルタイムワークロードをシミュレートするために意図的に固定されており、目標はテーブルをクエリ可能な状態に保ちながらそのレートを維持できる、最小・最低コストのSnowflakeセットアップを使用することでした。
> **Snowflakeのコメント:** COPY INTO、Snowpipe Streaming、より大きなウェアハウス、Gen2ウェアハウスを使用すべき。
これらは他のインジェストテストにとっては合理的な選択です。しかし、このベンチマークでは、ロード機構は副次的なものでした。問いは、Snowflakeがいかに速く1000億行のロードを完了できるかではなく、リアルタイム分析のユースケースで一般的な、固定されたリアルタイムインジェストレートに追従するのにいくらかかるかということでした。
### **③ 事前集計ではなく、クエリ可能な生データ** {#queryready_raw_data_not_preaggregation}
最初のベンチマークはベーステーブルにフォーカスしました。新しく書き込まれた生データが入力され、クエリ可能な生データが出力されます。マテリアライズドビューは測定していません。
> **Snowflakeのコメント:** 実運用ではデータパイプラインのより広い範囲を含めるべき。
同意します。それがまさにCostBenchが次に追加するものです。すなわち、派生データの保守、鮮度、そしてインジェストと生データ整理と並行して行われる読み取りです。
### **④ ロード後に測定した読み取り** {#reads_measured_after_loading}
テーブルが1000億行に達した後、クエリ性能を検証するためにClickBenchクエリワークロードを1回実行しました。
つまり最初のベンチマークでは、インジェスト、クラスタリング、リフレッシュ、あるいはその他のメンテナンス作業がバックグラウンドで継続する中での、連続したサービングを測定していません。
> **Snowflakeのコメント:** 高い同時実行性と低レイテンシのサービングにはInteractive TablesとInteractive Warehousesを使用すべき。
もっともな指摘です。最初のベンチマークにInteractive Tablesが含まれなかったのは、ほとんどのお客様が実際に利用可能なSnowflakeのパス、すなわち標準テーブル+クラスタリングを使用したためです。Interactive Tablesは比較的新しい機能で、現在は一部のリージョンでのみ利用可能です。
したがって拡張ベンチマークでは、両方のパスをテストします。標準テーブルとマテリアライズドビューを使った広く利用可能なSnowflakeセットアップと、サポートされているリージョンでのInteractive Tablesセットアップの両方です。
## 拡張ベンチマークがより広い問いに答える {#the_expanded_benchmark_addresses_the_broader_question}
Snowflakeが応答を公開する前に、私たちは既に新しいCostBench方法論を[より広範なフルパスベンチマーク](https://github.com/ClickHouse/CostBench/tree/main/full-path-realtime/quotes)に適用し始めていました。
今回は意図的にスペクトラムの容易な端から始めました。すなわち、はるかにシンプルなデータセットと順序キー、よりクリーンな到着パターン、そしてデータが動き続けている最中の連続した読み取りです。このセットアップは、元のClickBenchテストでSnowflakeが異議を唱えたいくつかの要因を取り除いています。
これは後により重いデータセットで繰り返す予定です。しかしまず、可能な限りクリーンなケースでフルパスを測定したかったのです。
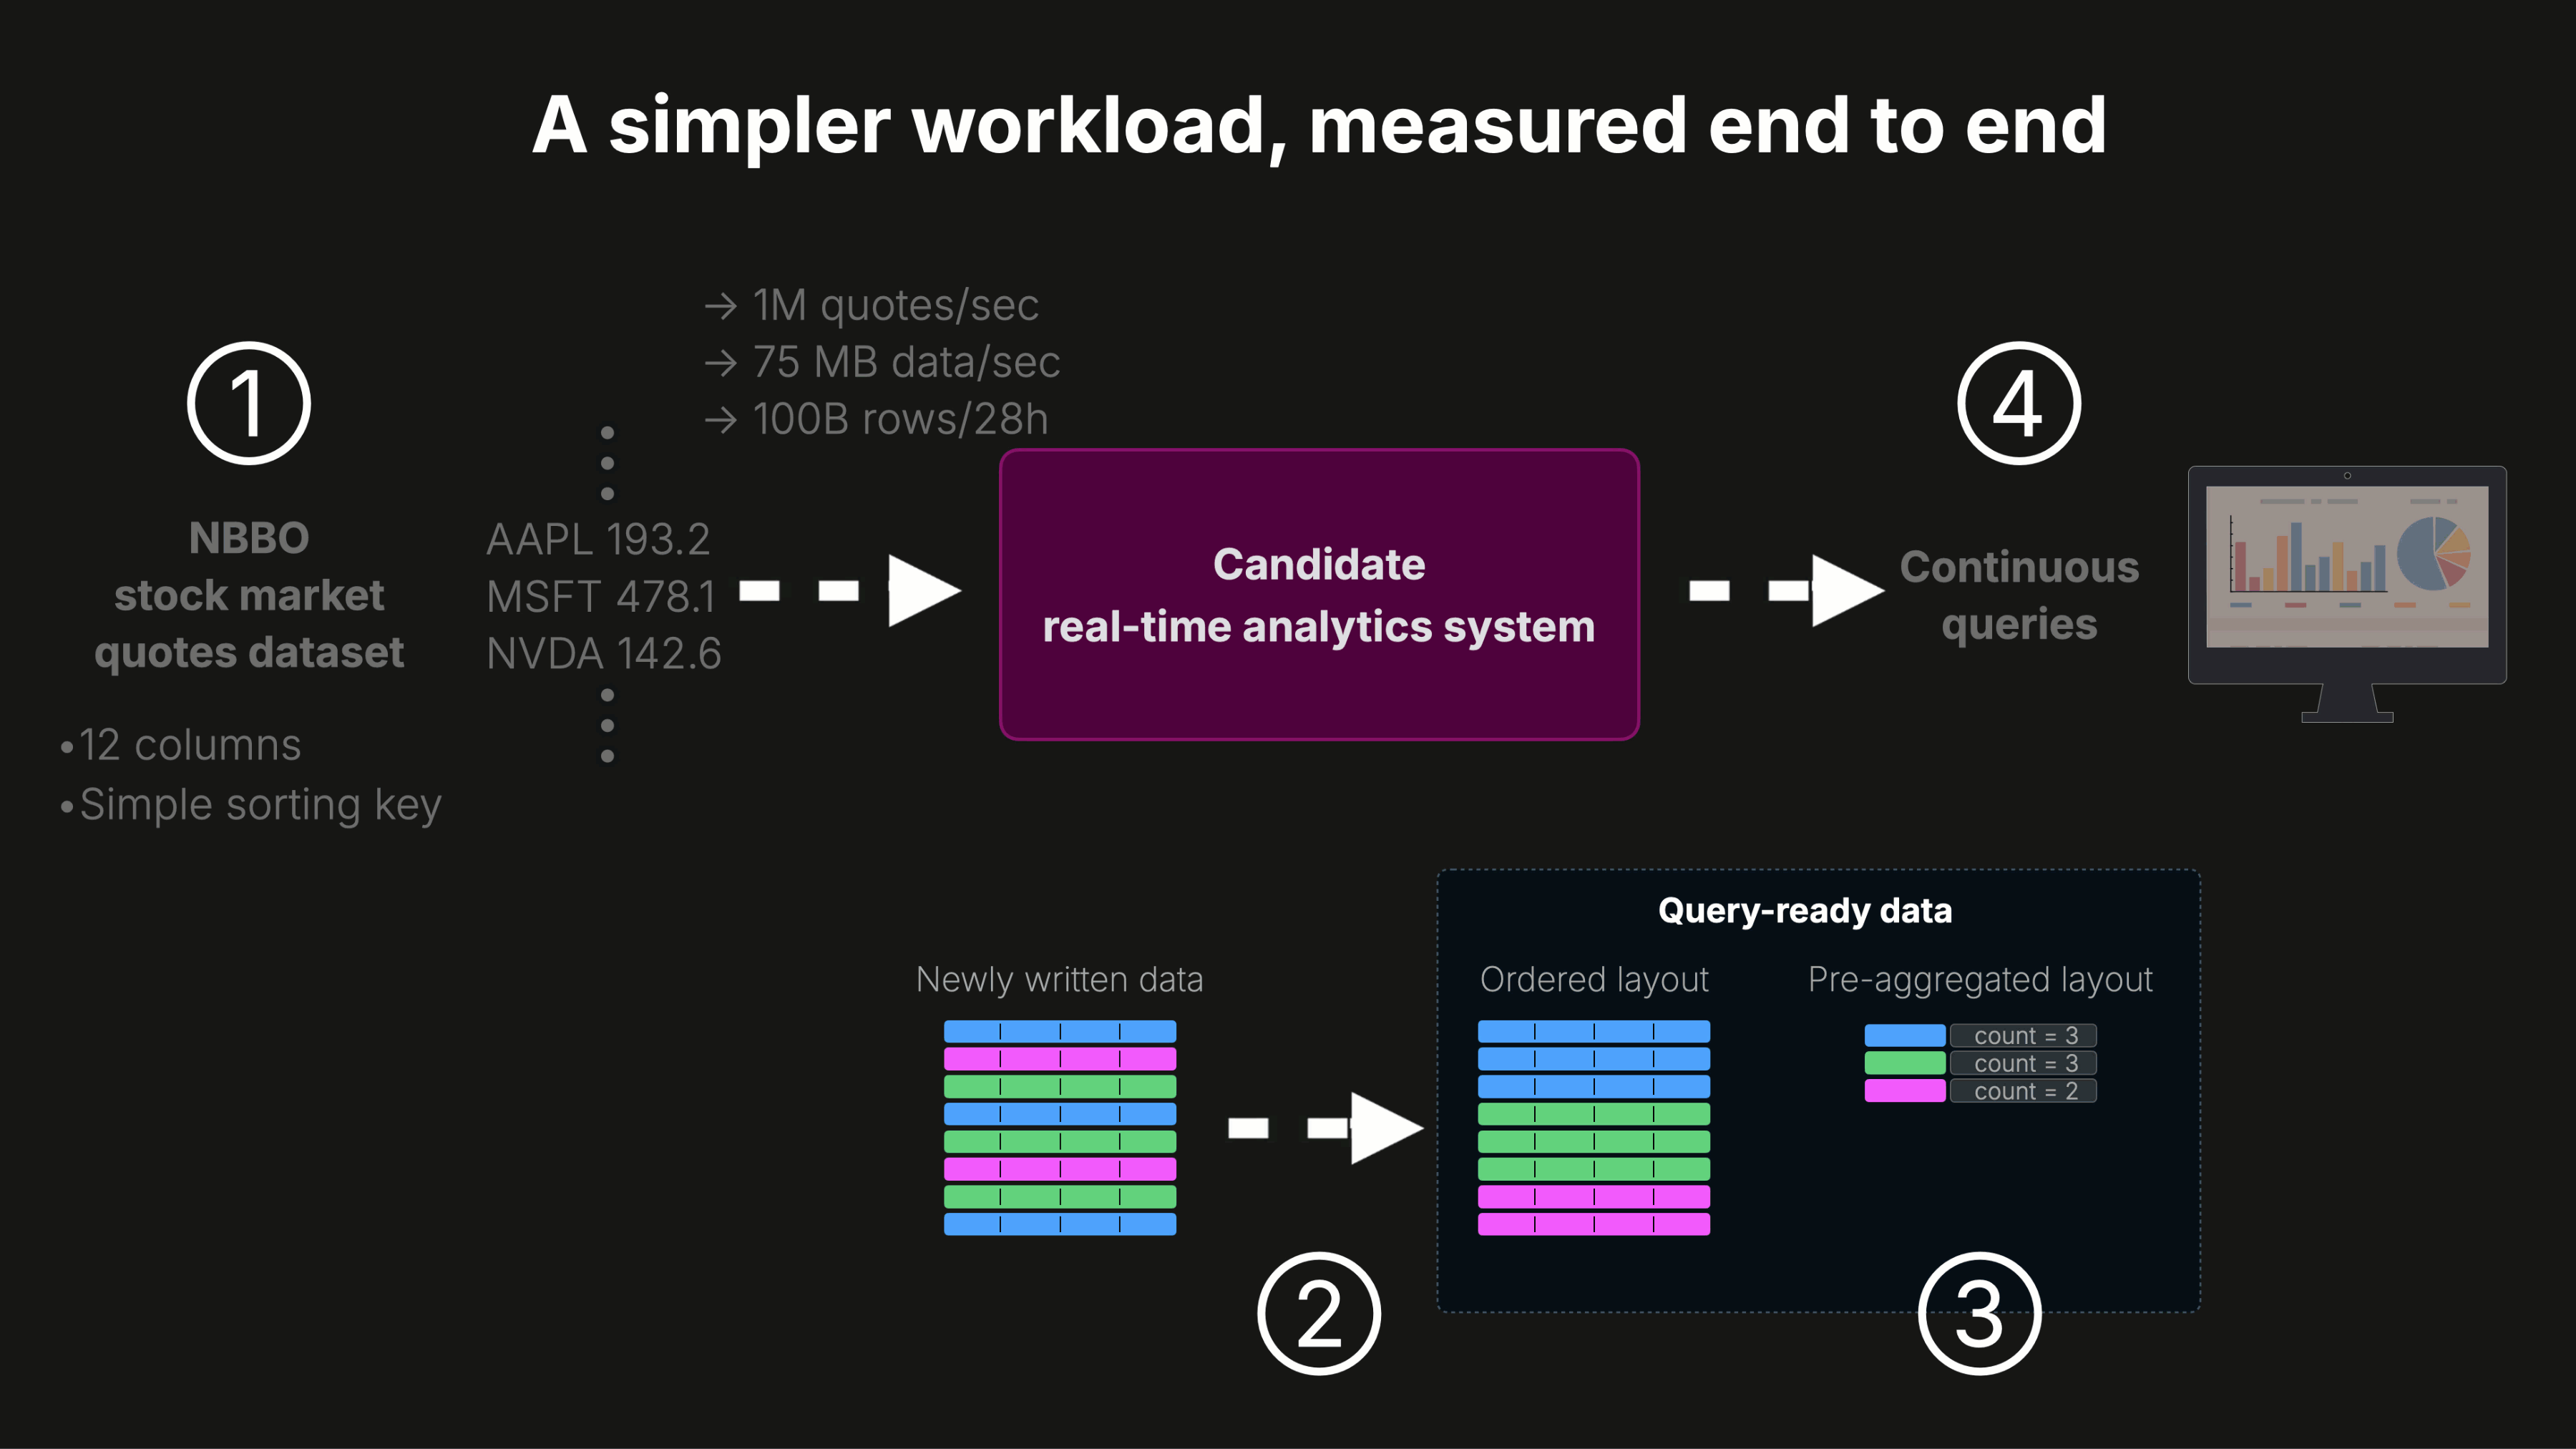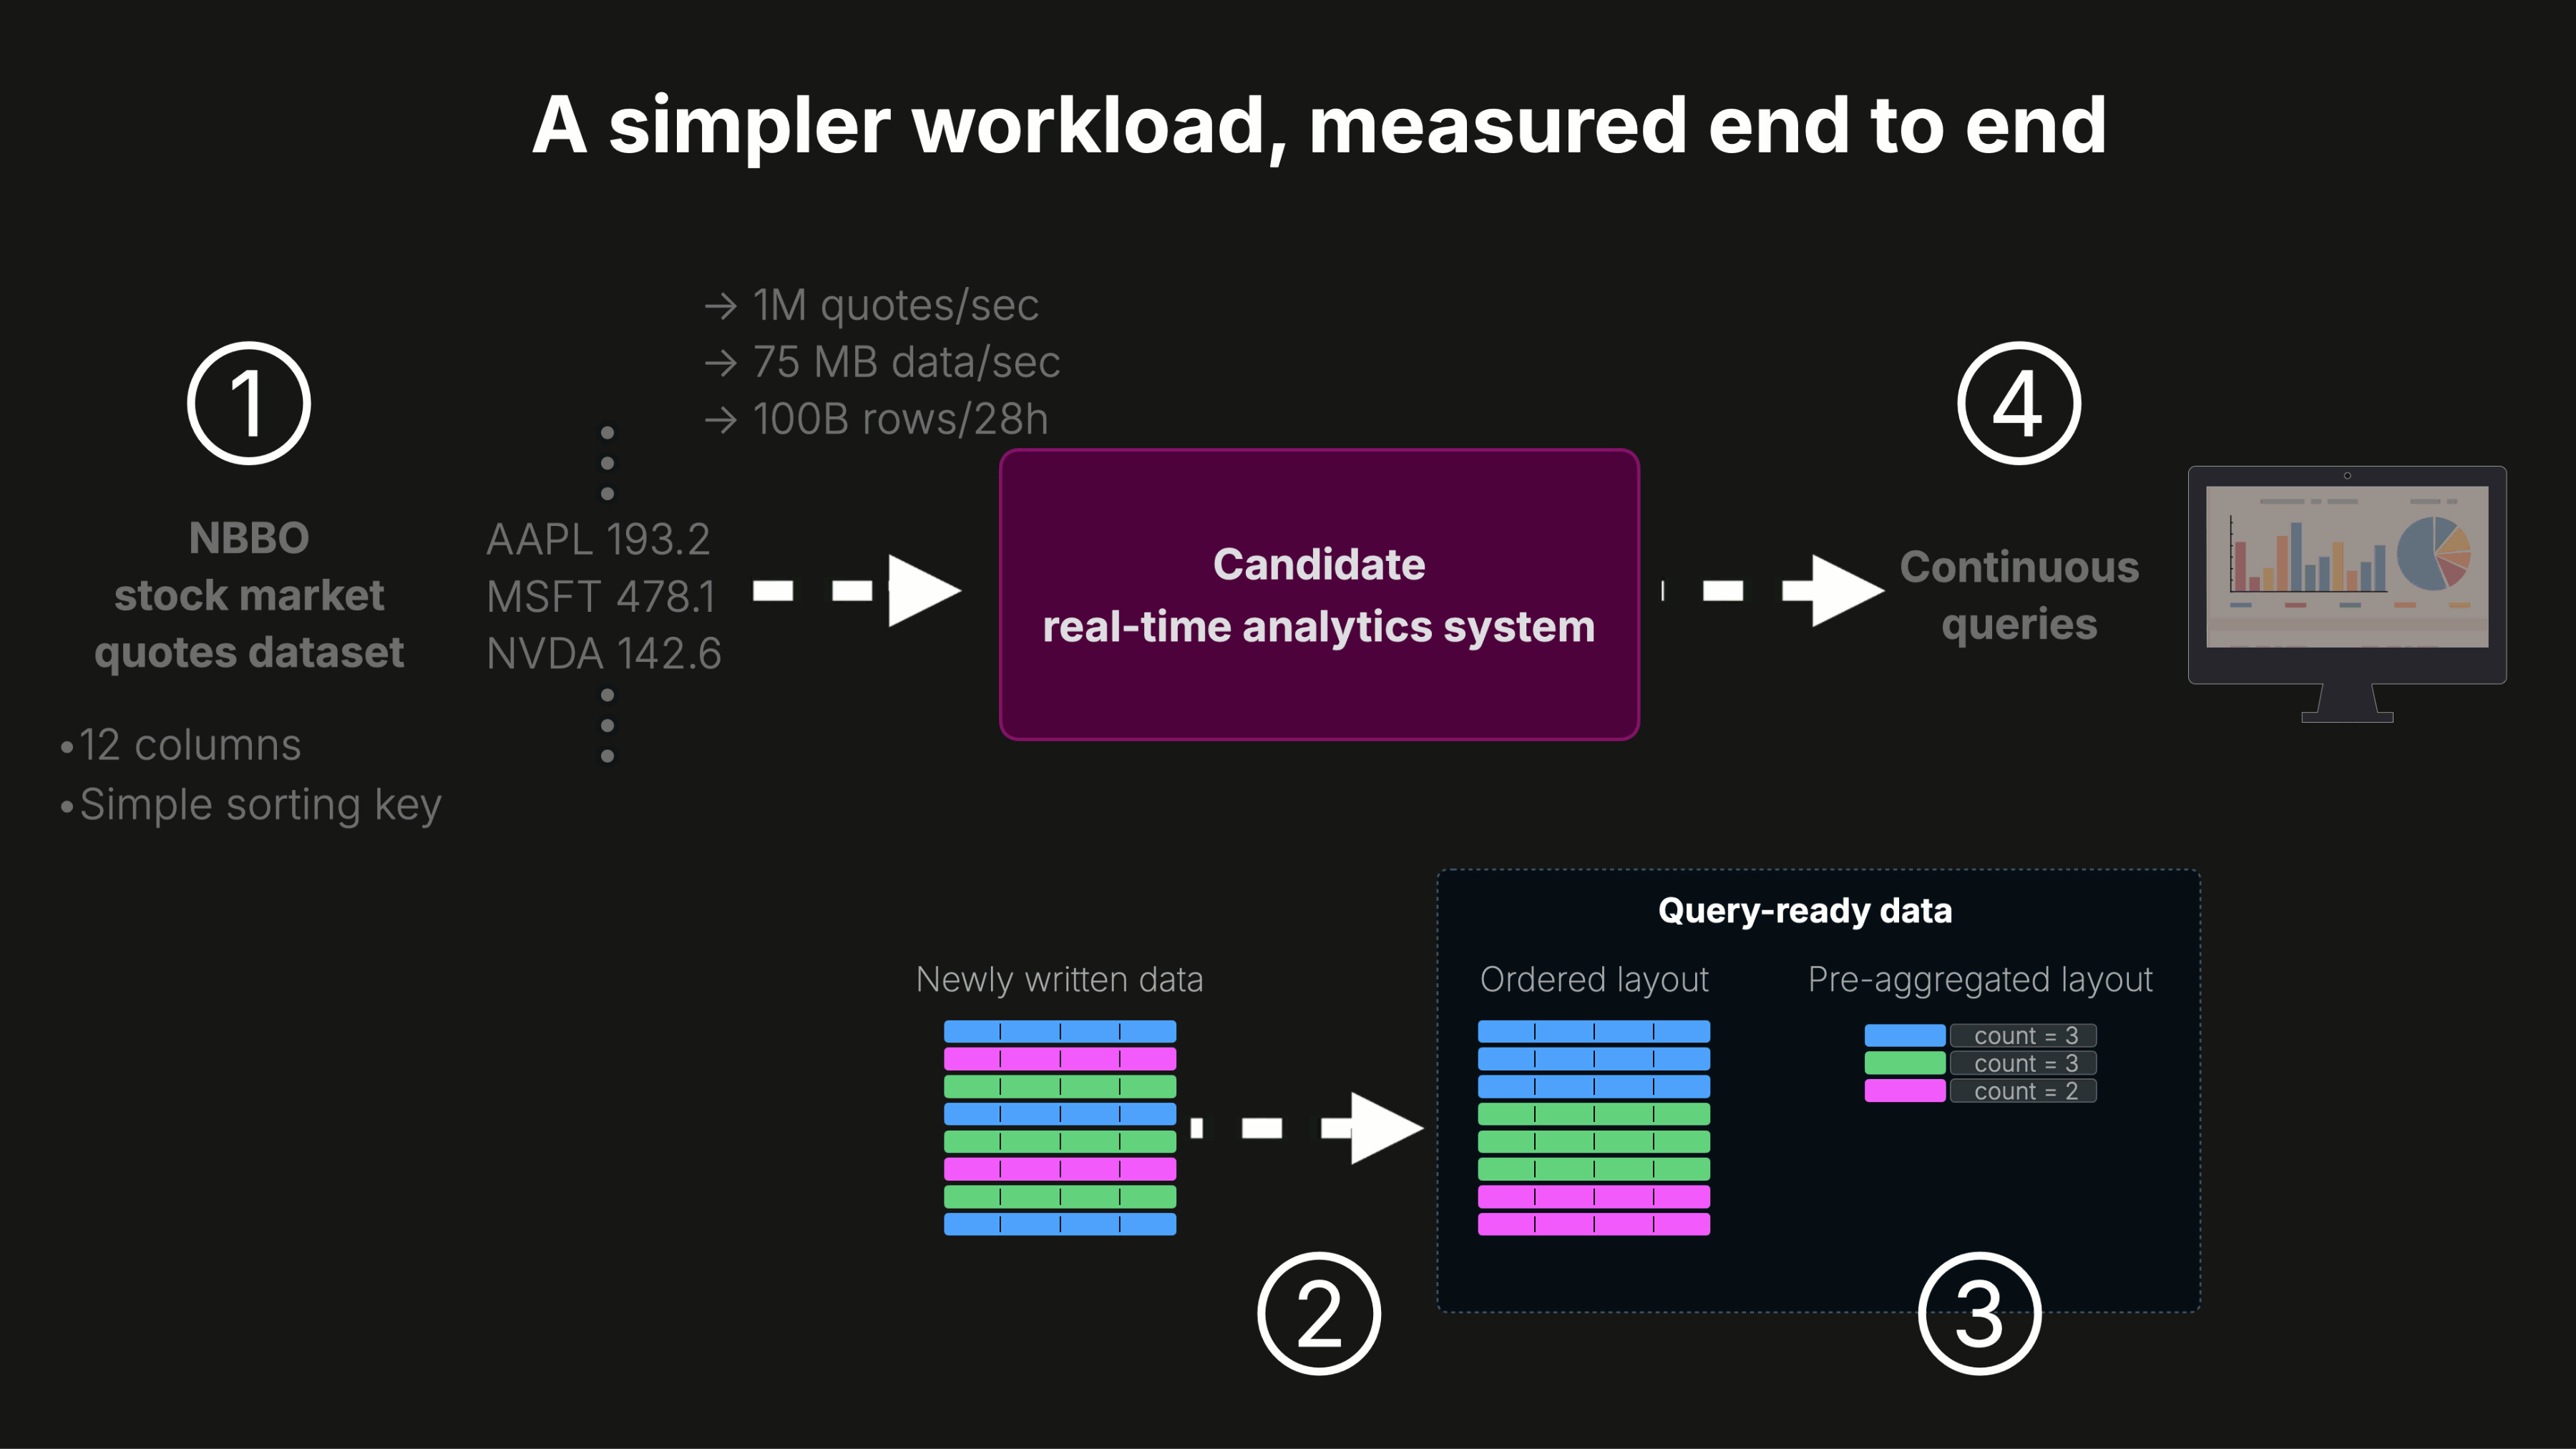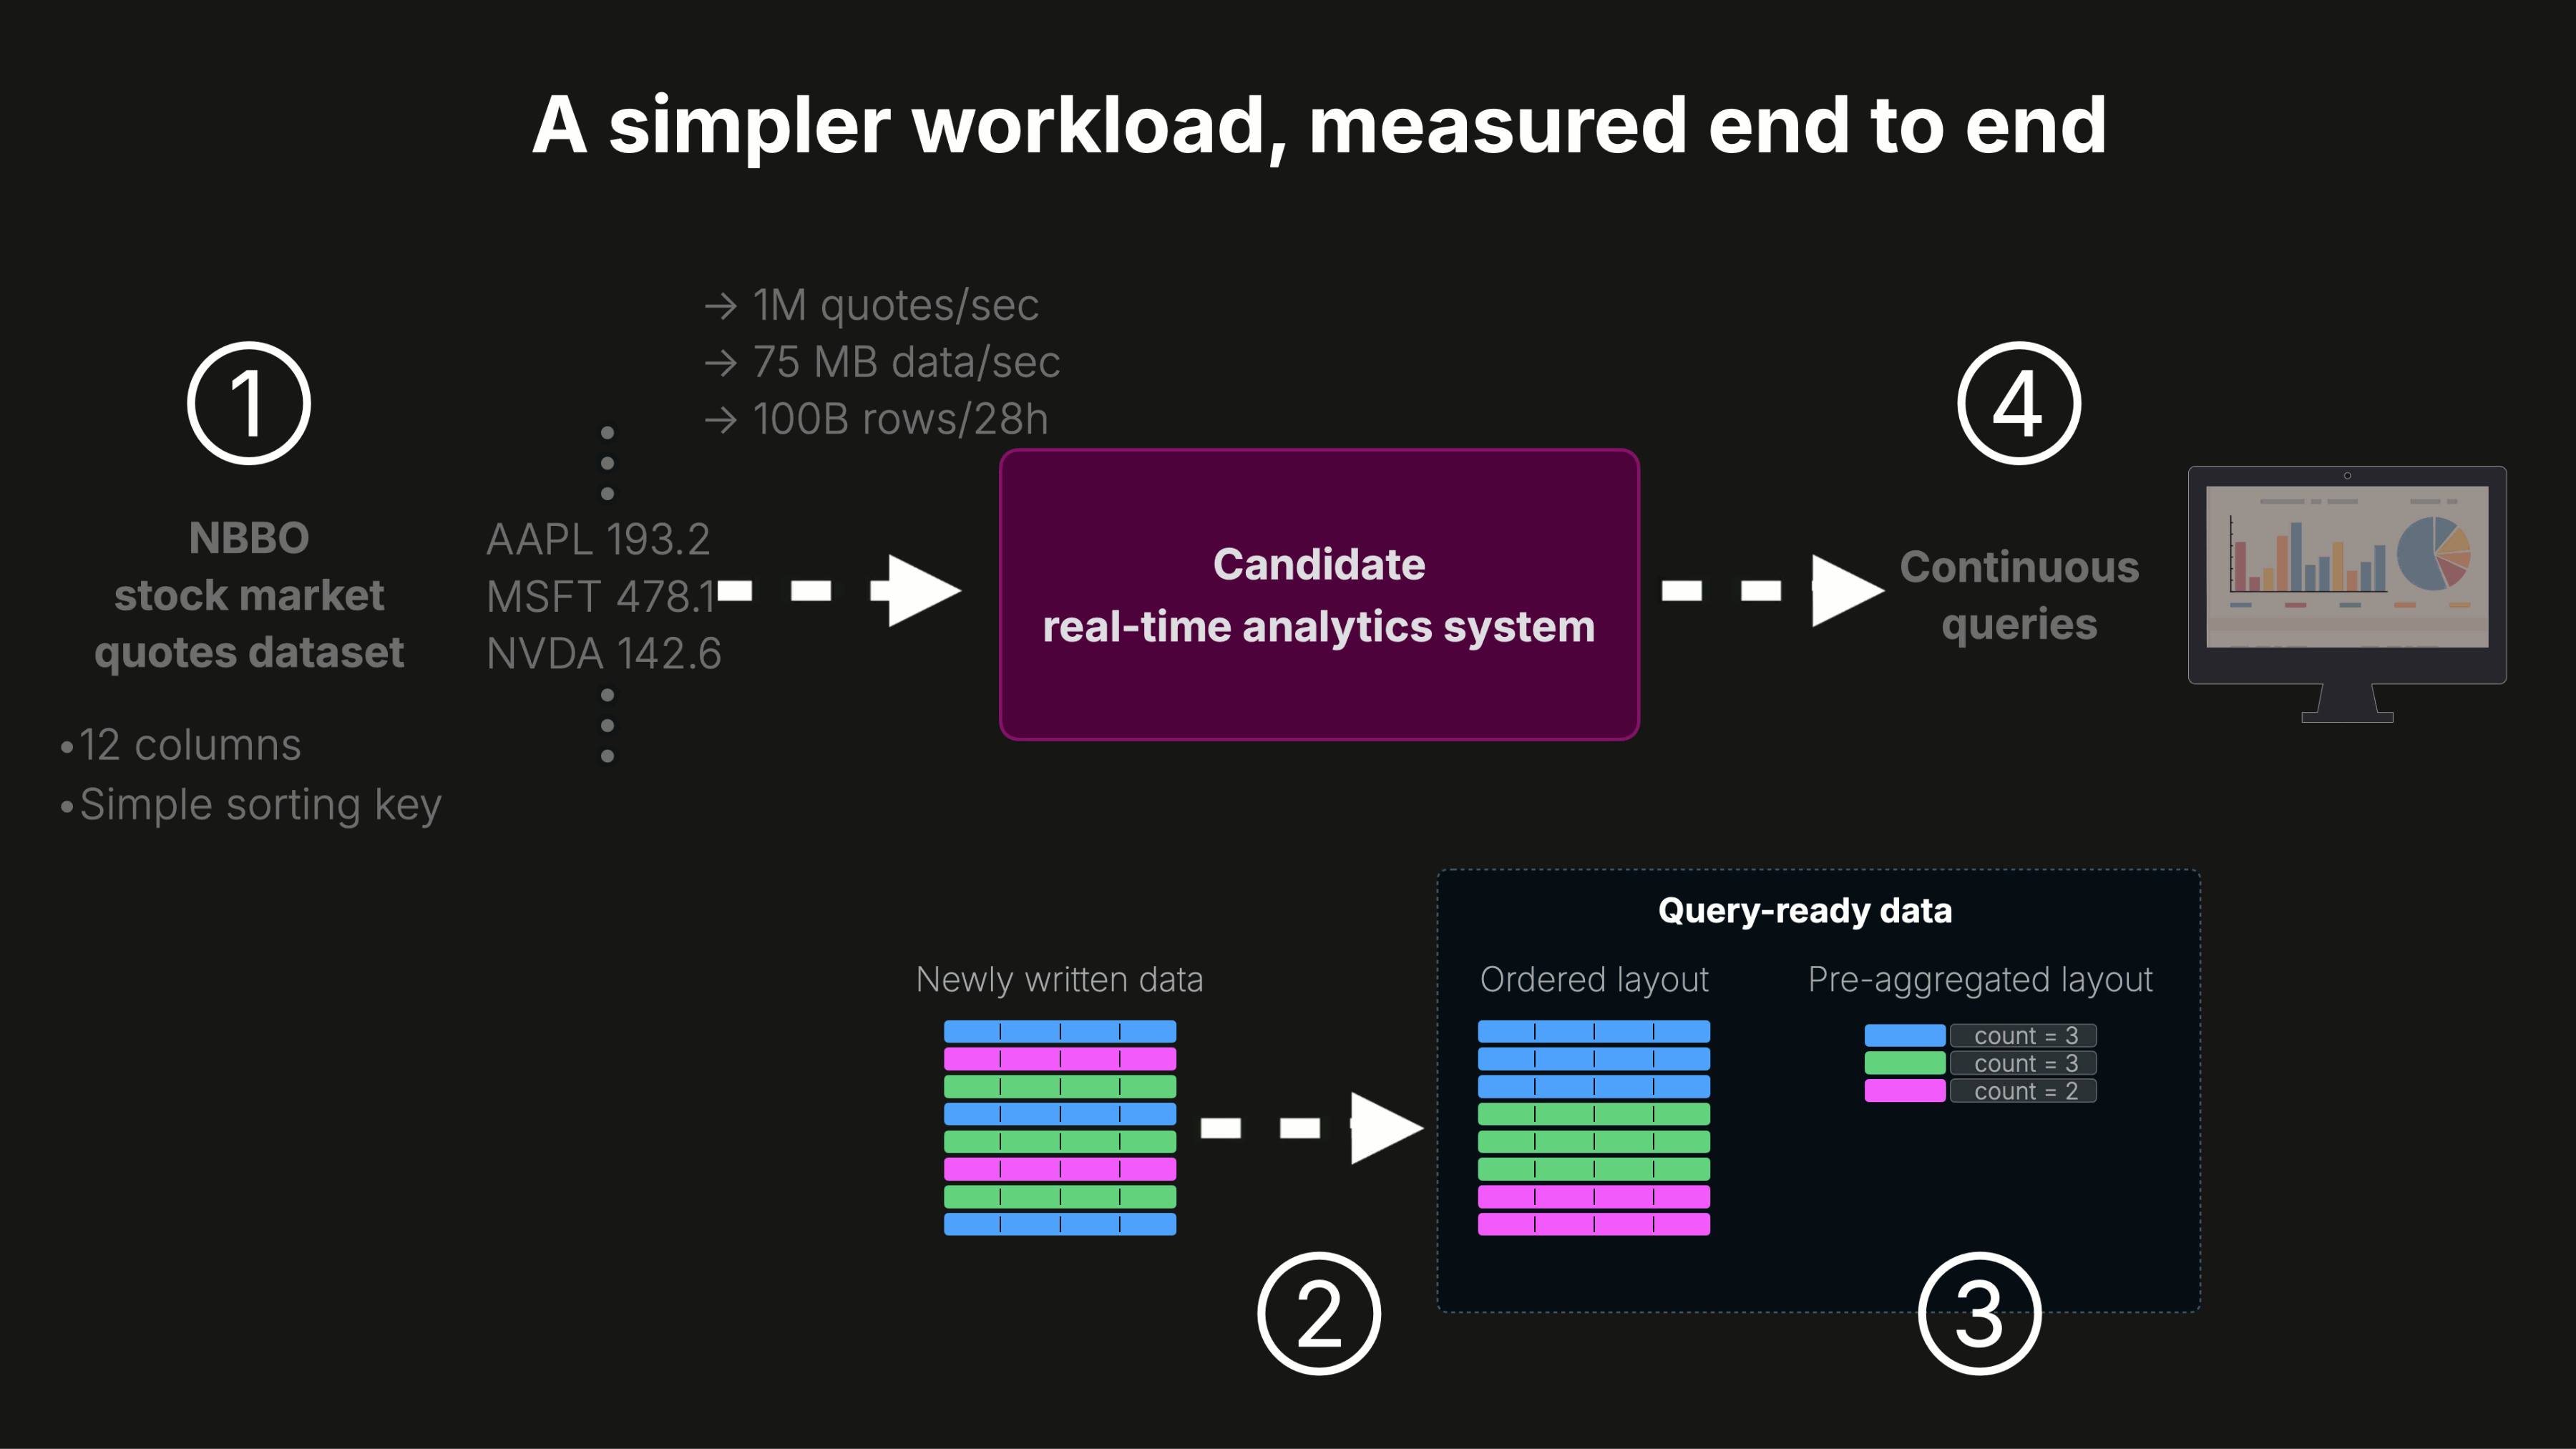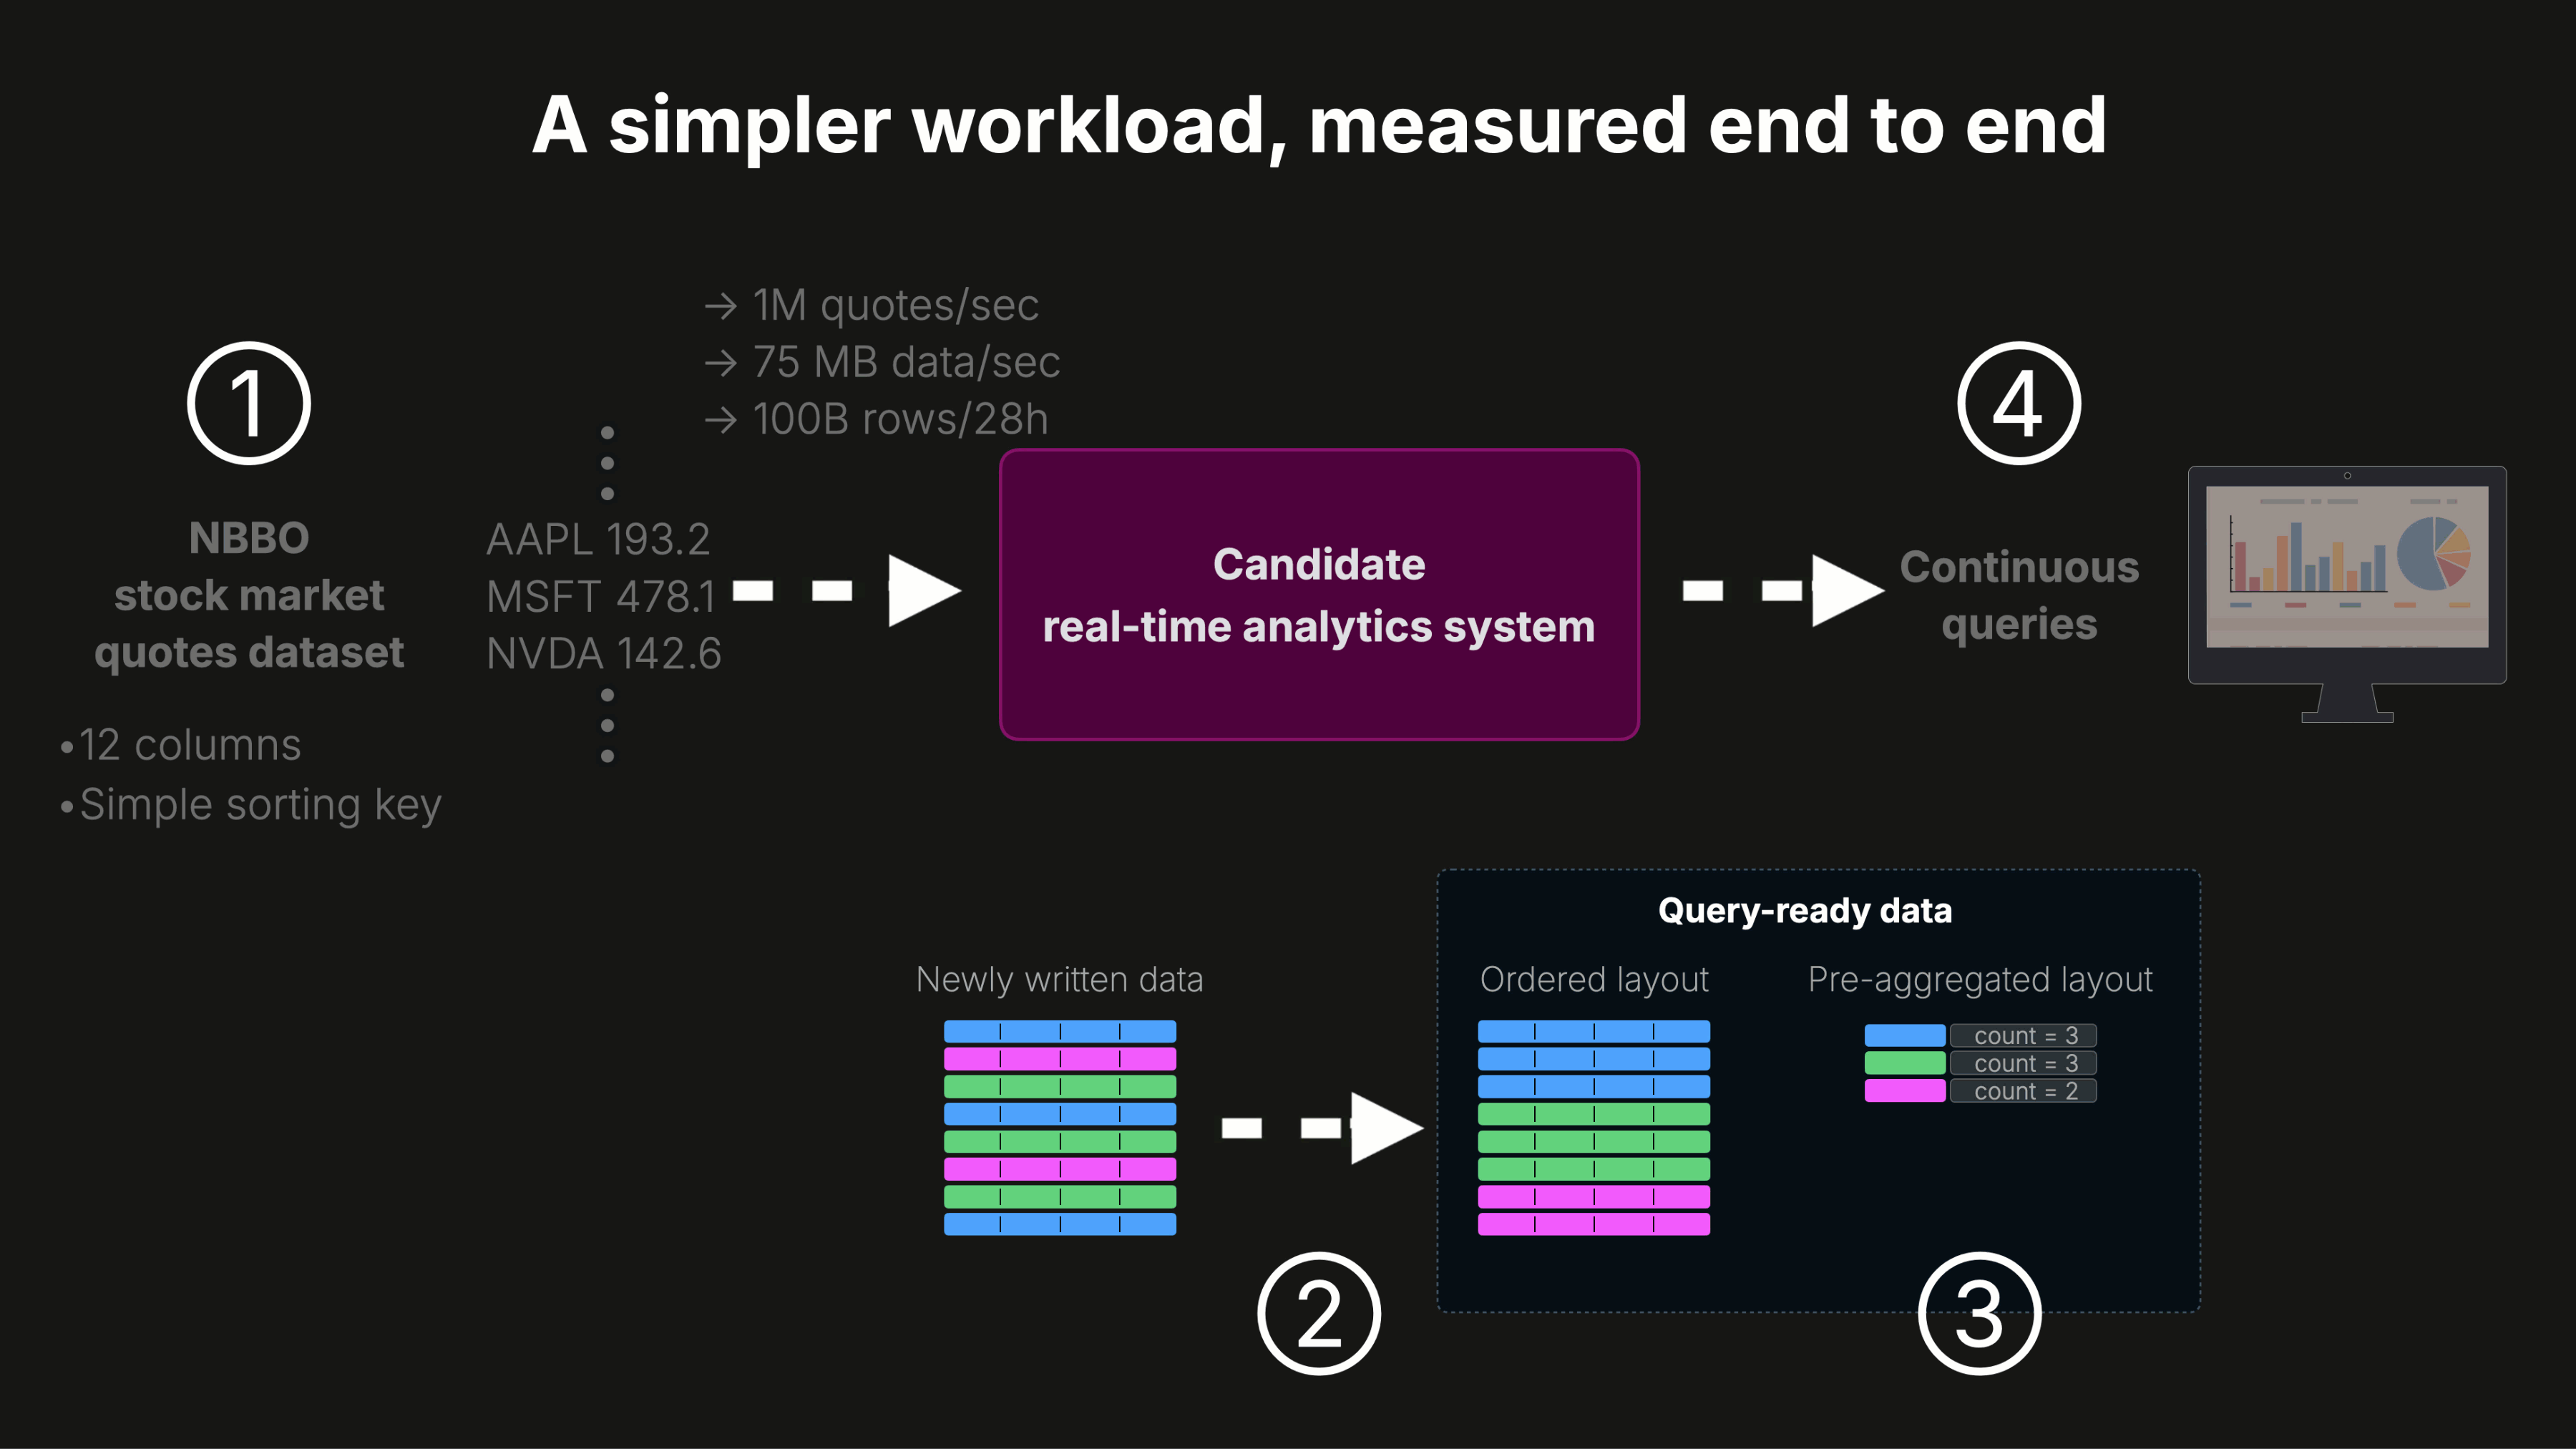
### **① よりシンプルなデータセット、タイムスタンプ順のインジェスト** {#simpler_dataset_timestampordered_ingest}
私たちは[データプロバイダー](https://github.com/ClickHouse/CostBench/tree/main/full-path-realtime/quotes#data-source--licensing)からライセンスされた[実際の株式市場の相場データセット](https://github.com/ClickHouse/CostBench/tree/main/full-path-realtime/quotes#dataset)を使用しており、数千億行にアクセスできます。
ClickBenchと比較して、はるかにシンプルな形状です。[12列](https://github.com/ClickHouse/CostBench/tree/main/full-path-realtime/quotes#schema-vendor-agnostic)、シンプルな2列のソートキー、そして自然なタイムスタンプ順です。
データを厳密なタイムスタンプ順で、100万行/秒の一定レートでインジェストします。このレートでは、システムは28時間ごとに1000億行の新鮮な行を受信します。
### **② シンプルなクラスタリングキー** {#simple_clustering_key}
今回、ソート/クラスタリングキーは`(sym, t)`のわずか2列 - 銘柄コードとタイムスタンプです。これ以上ないほど自然でシンプルです。
ClickHouseは生テーブルをこれらの列で[ソート](https://github.com/ClickHouse/CostBench/blob/6fb94fd628b100db69bc2bf9f8d6f149eec54601/full-path-realtime/quotes/clickhouse-cloud/create.sql#L22)し、Snowflakeは生テーブルをこれらの列で[クラスタリング](https://github.com/ClickHouse/CostBench/blob/6fb94fd628b100db69bc2bf9f8d6f149eec54601/full-path-realtime/quotes/snowflake/create.sql#L58)します。
### **③ 事前集計を含む** {#preaggregations_included}
元のベンチマークとは異なり、この実行では継続的に維持される事前集計を含んでいます。
つまり、新しい行が到着し続ける中で派生データを最新に保つコストも測定します。
### **④ 対応するレイアウトへの連続クエリ** {#continuous_queries_on_the_matching_layouts}
今回は、新鮮なデータが到着し続けている間もクエリが連続的に実行されます。
ワークロードには2種類のクエリが含まれます。**事前集計データに対するダッシュボードクエリ**と、生テーブルの順序/クラスタリングキーに一致するフィルタを持つ**生データに対するドリルダウンクエリ**です。
**両システムのキャッシュを有効にしたままにします。** 静的なデータのベンチマークでは、通常、純粋なエンジン性能ではなくメモリルックアップを測定するのを避けるためにクエリ結果キャッシュを無効にします。今回はデータが常に変化しているため、キャッシュの有用性は大幅に低下しており、有効のままにしておく方が実世界の使用状況をより良く反映します。
**各クエリはラウンドごとに1回実行します。** これは、これらのクエリが実際にどのように使用されているかを反映しています。ダッシュボードのリフレッシュ、ユーザーによるドリルダウン、あるいは探索的なアドホッククエリは、データの最新状態に対して1回発生します。
これは、リアルタイムシナリオをより直接的にシミュレートします。インジェスト、メンテナンス、鮮度、読み取りがすべて同時に発生します。
## ClickHouse Cloudセットアップ {#clickhouse_cloud_setup}
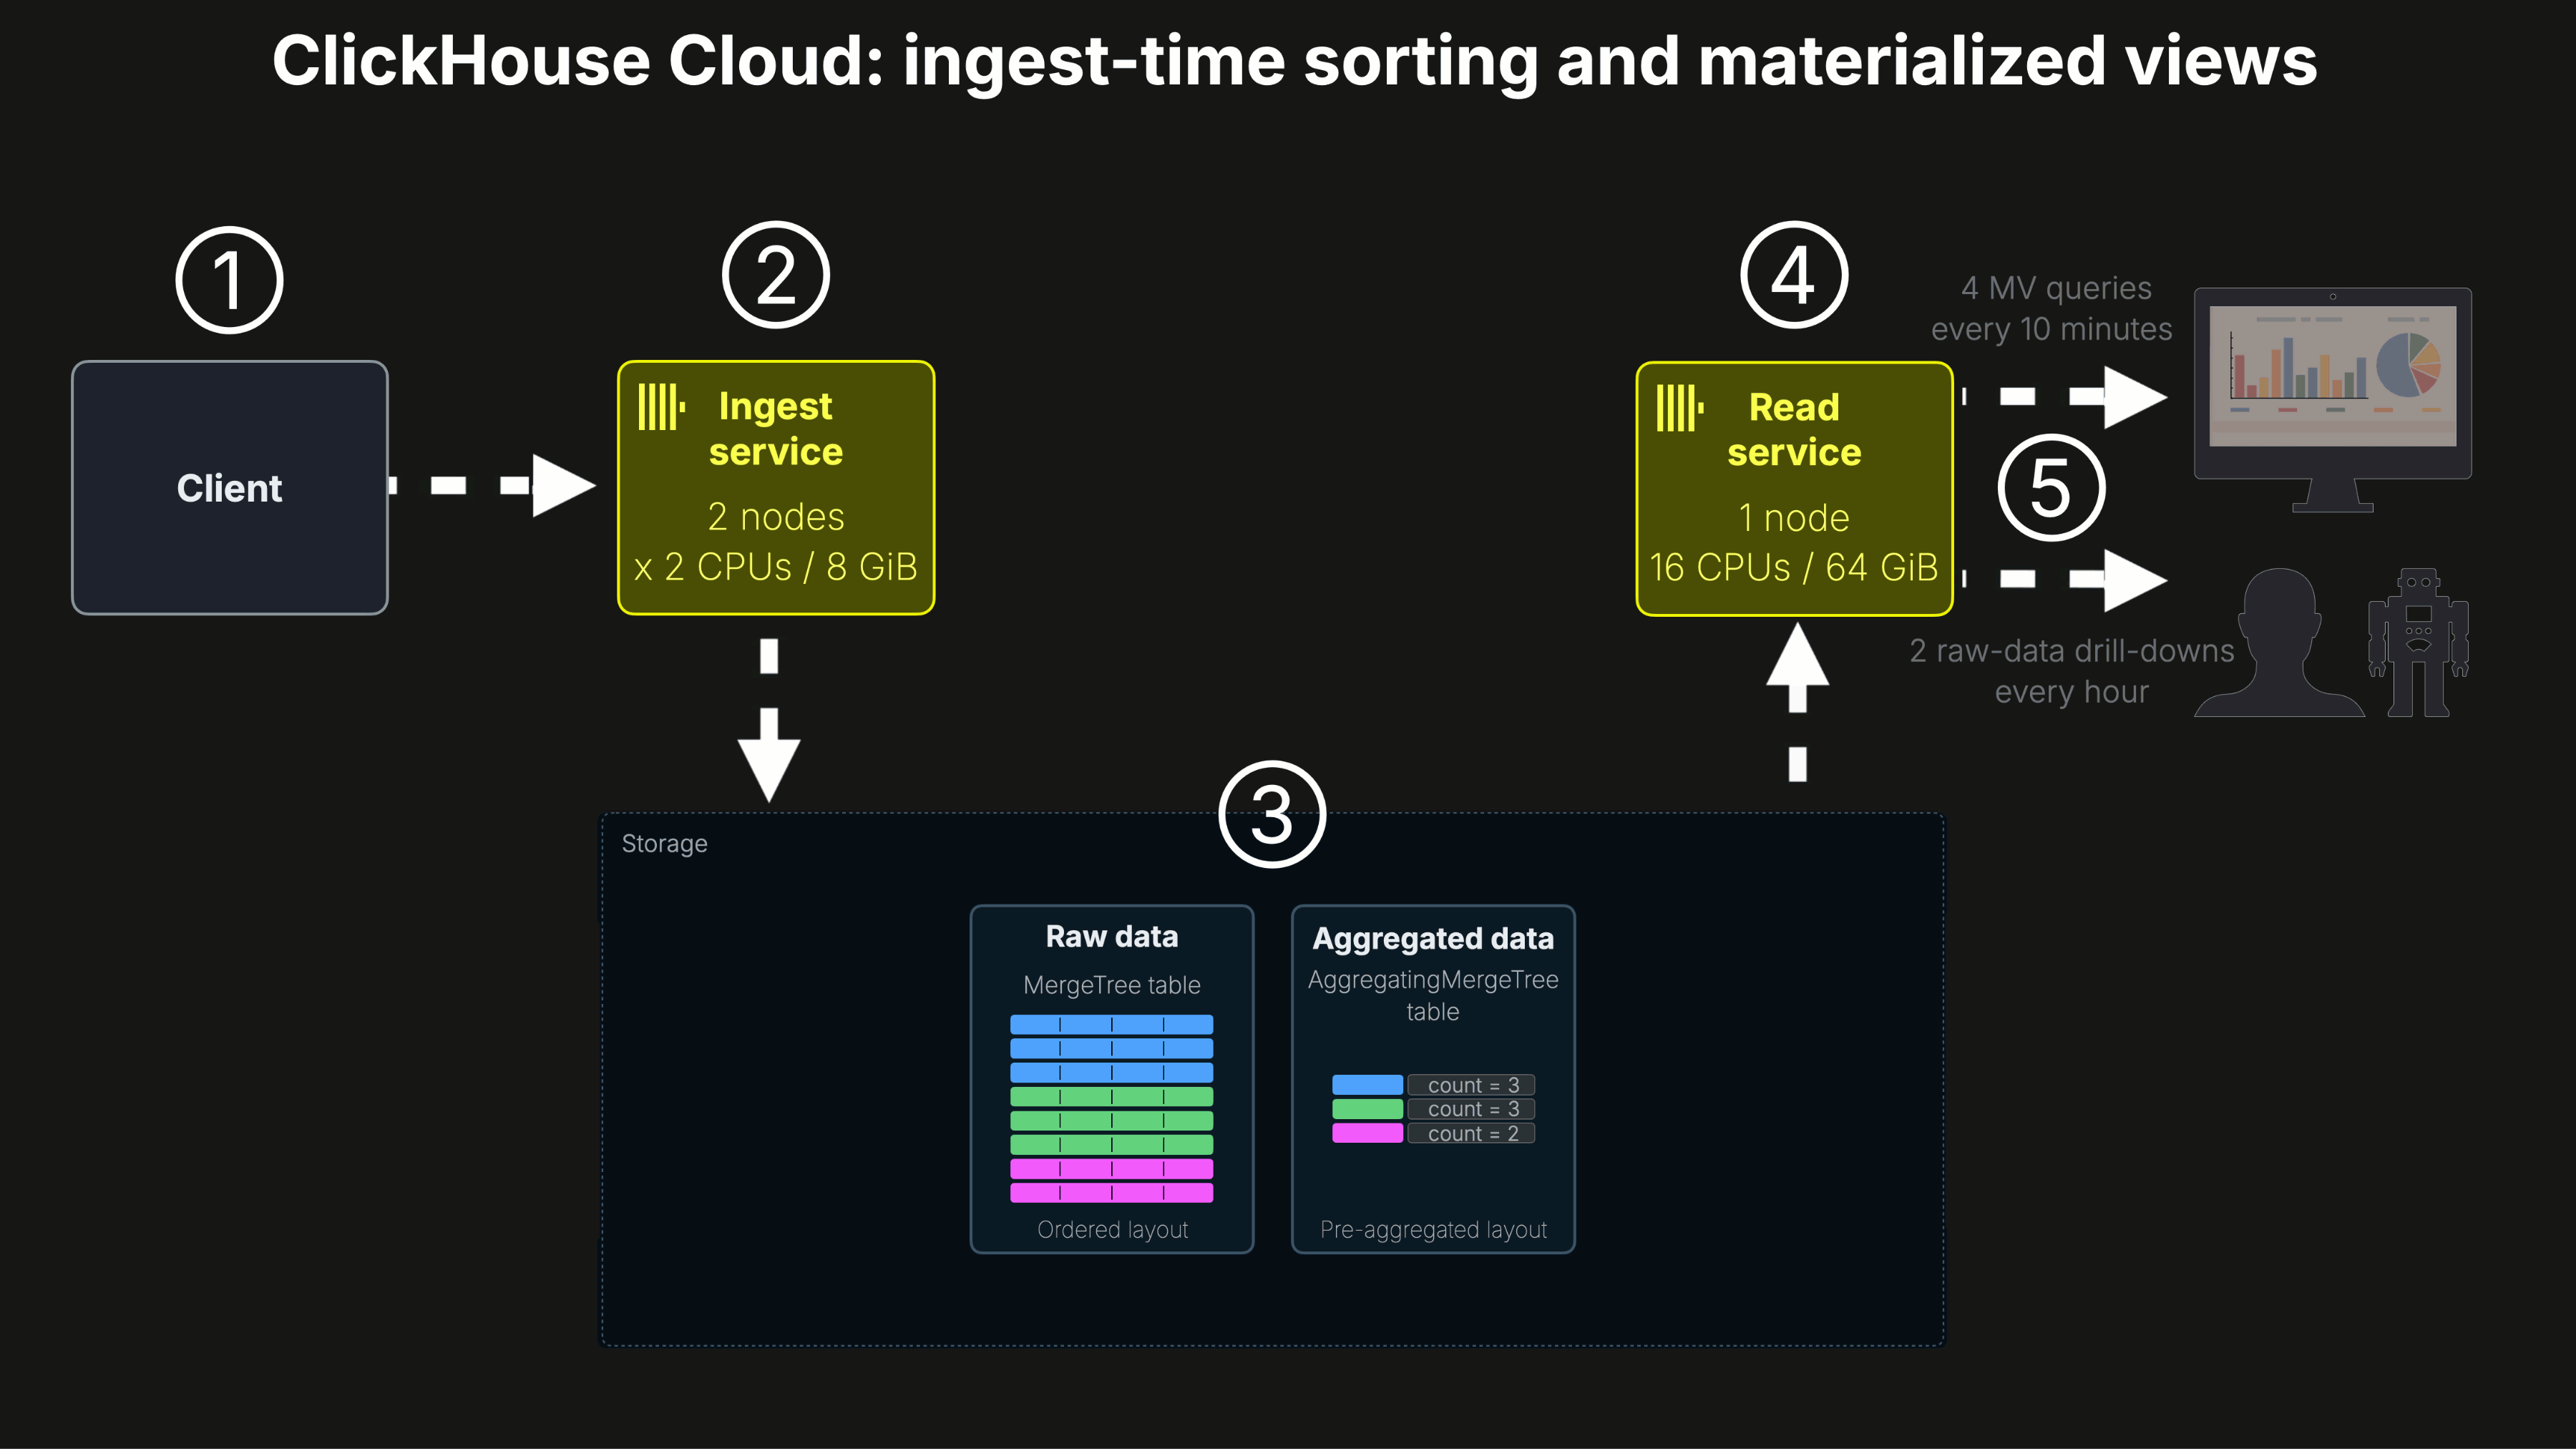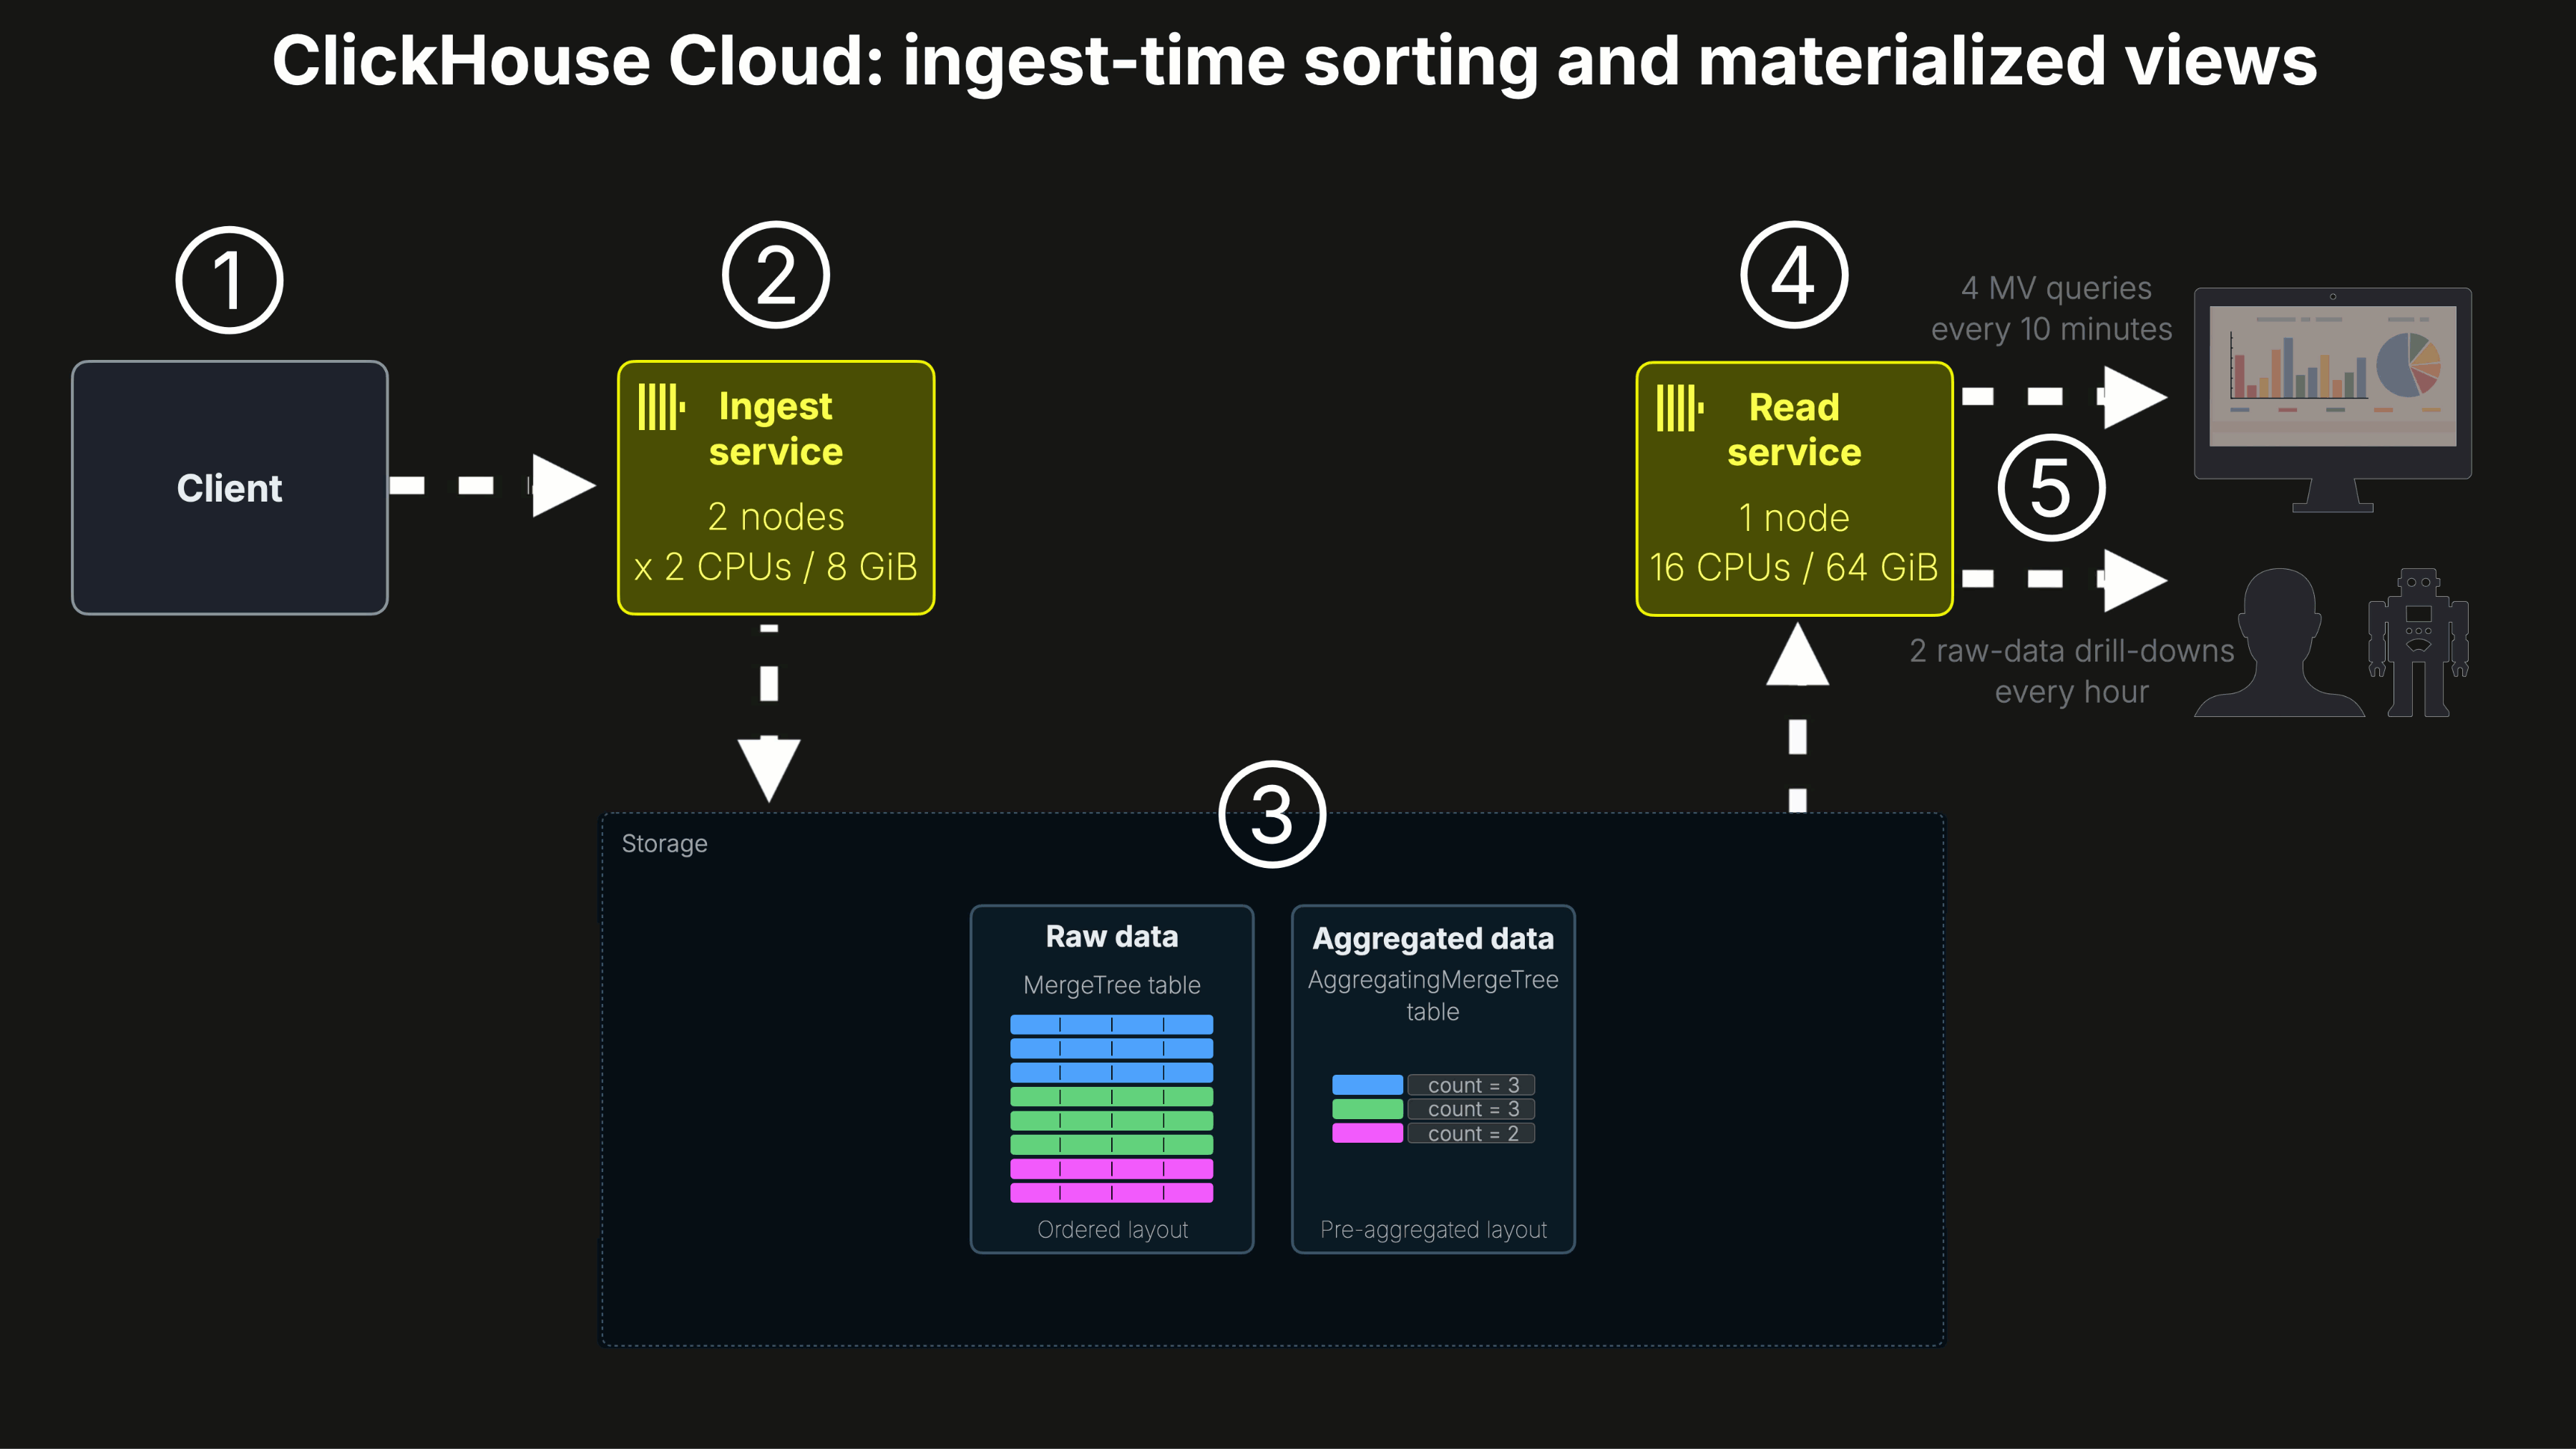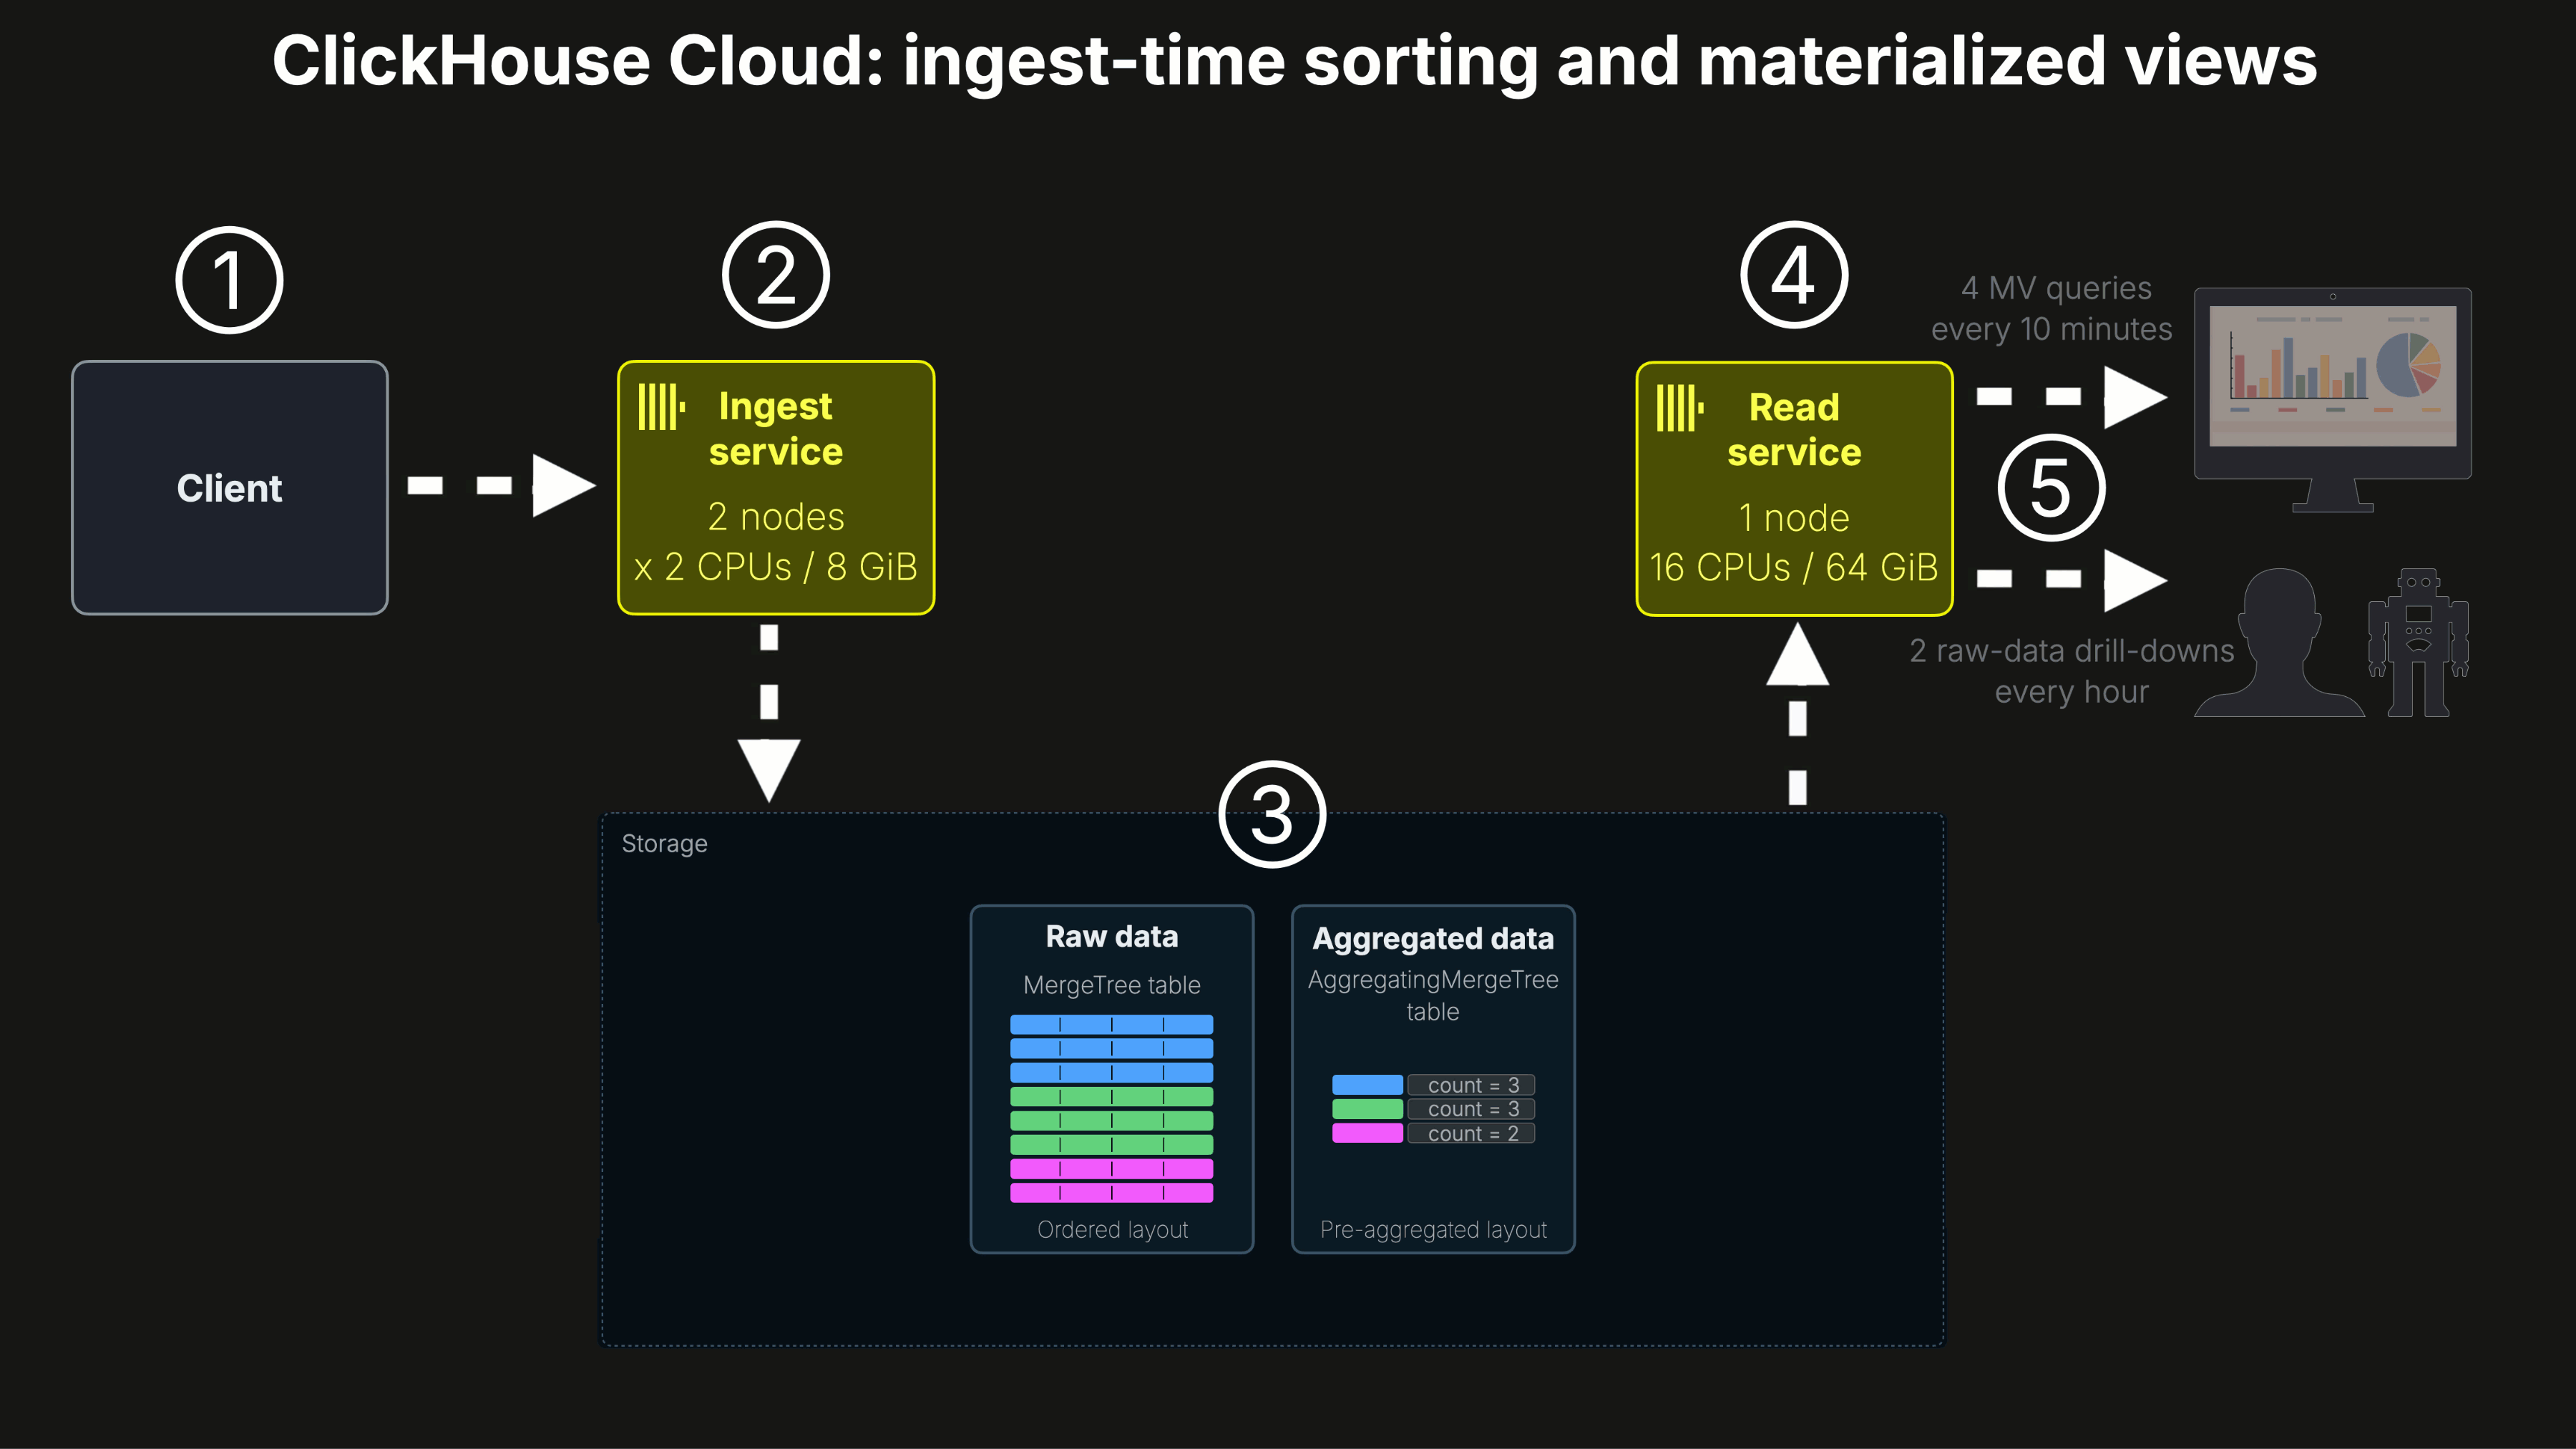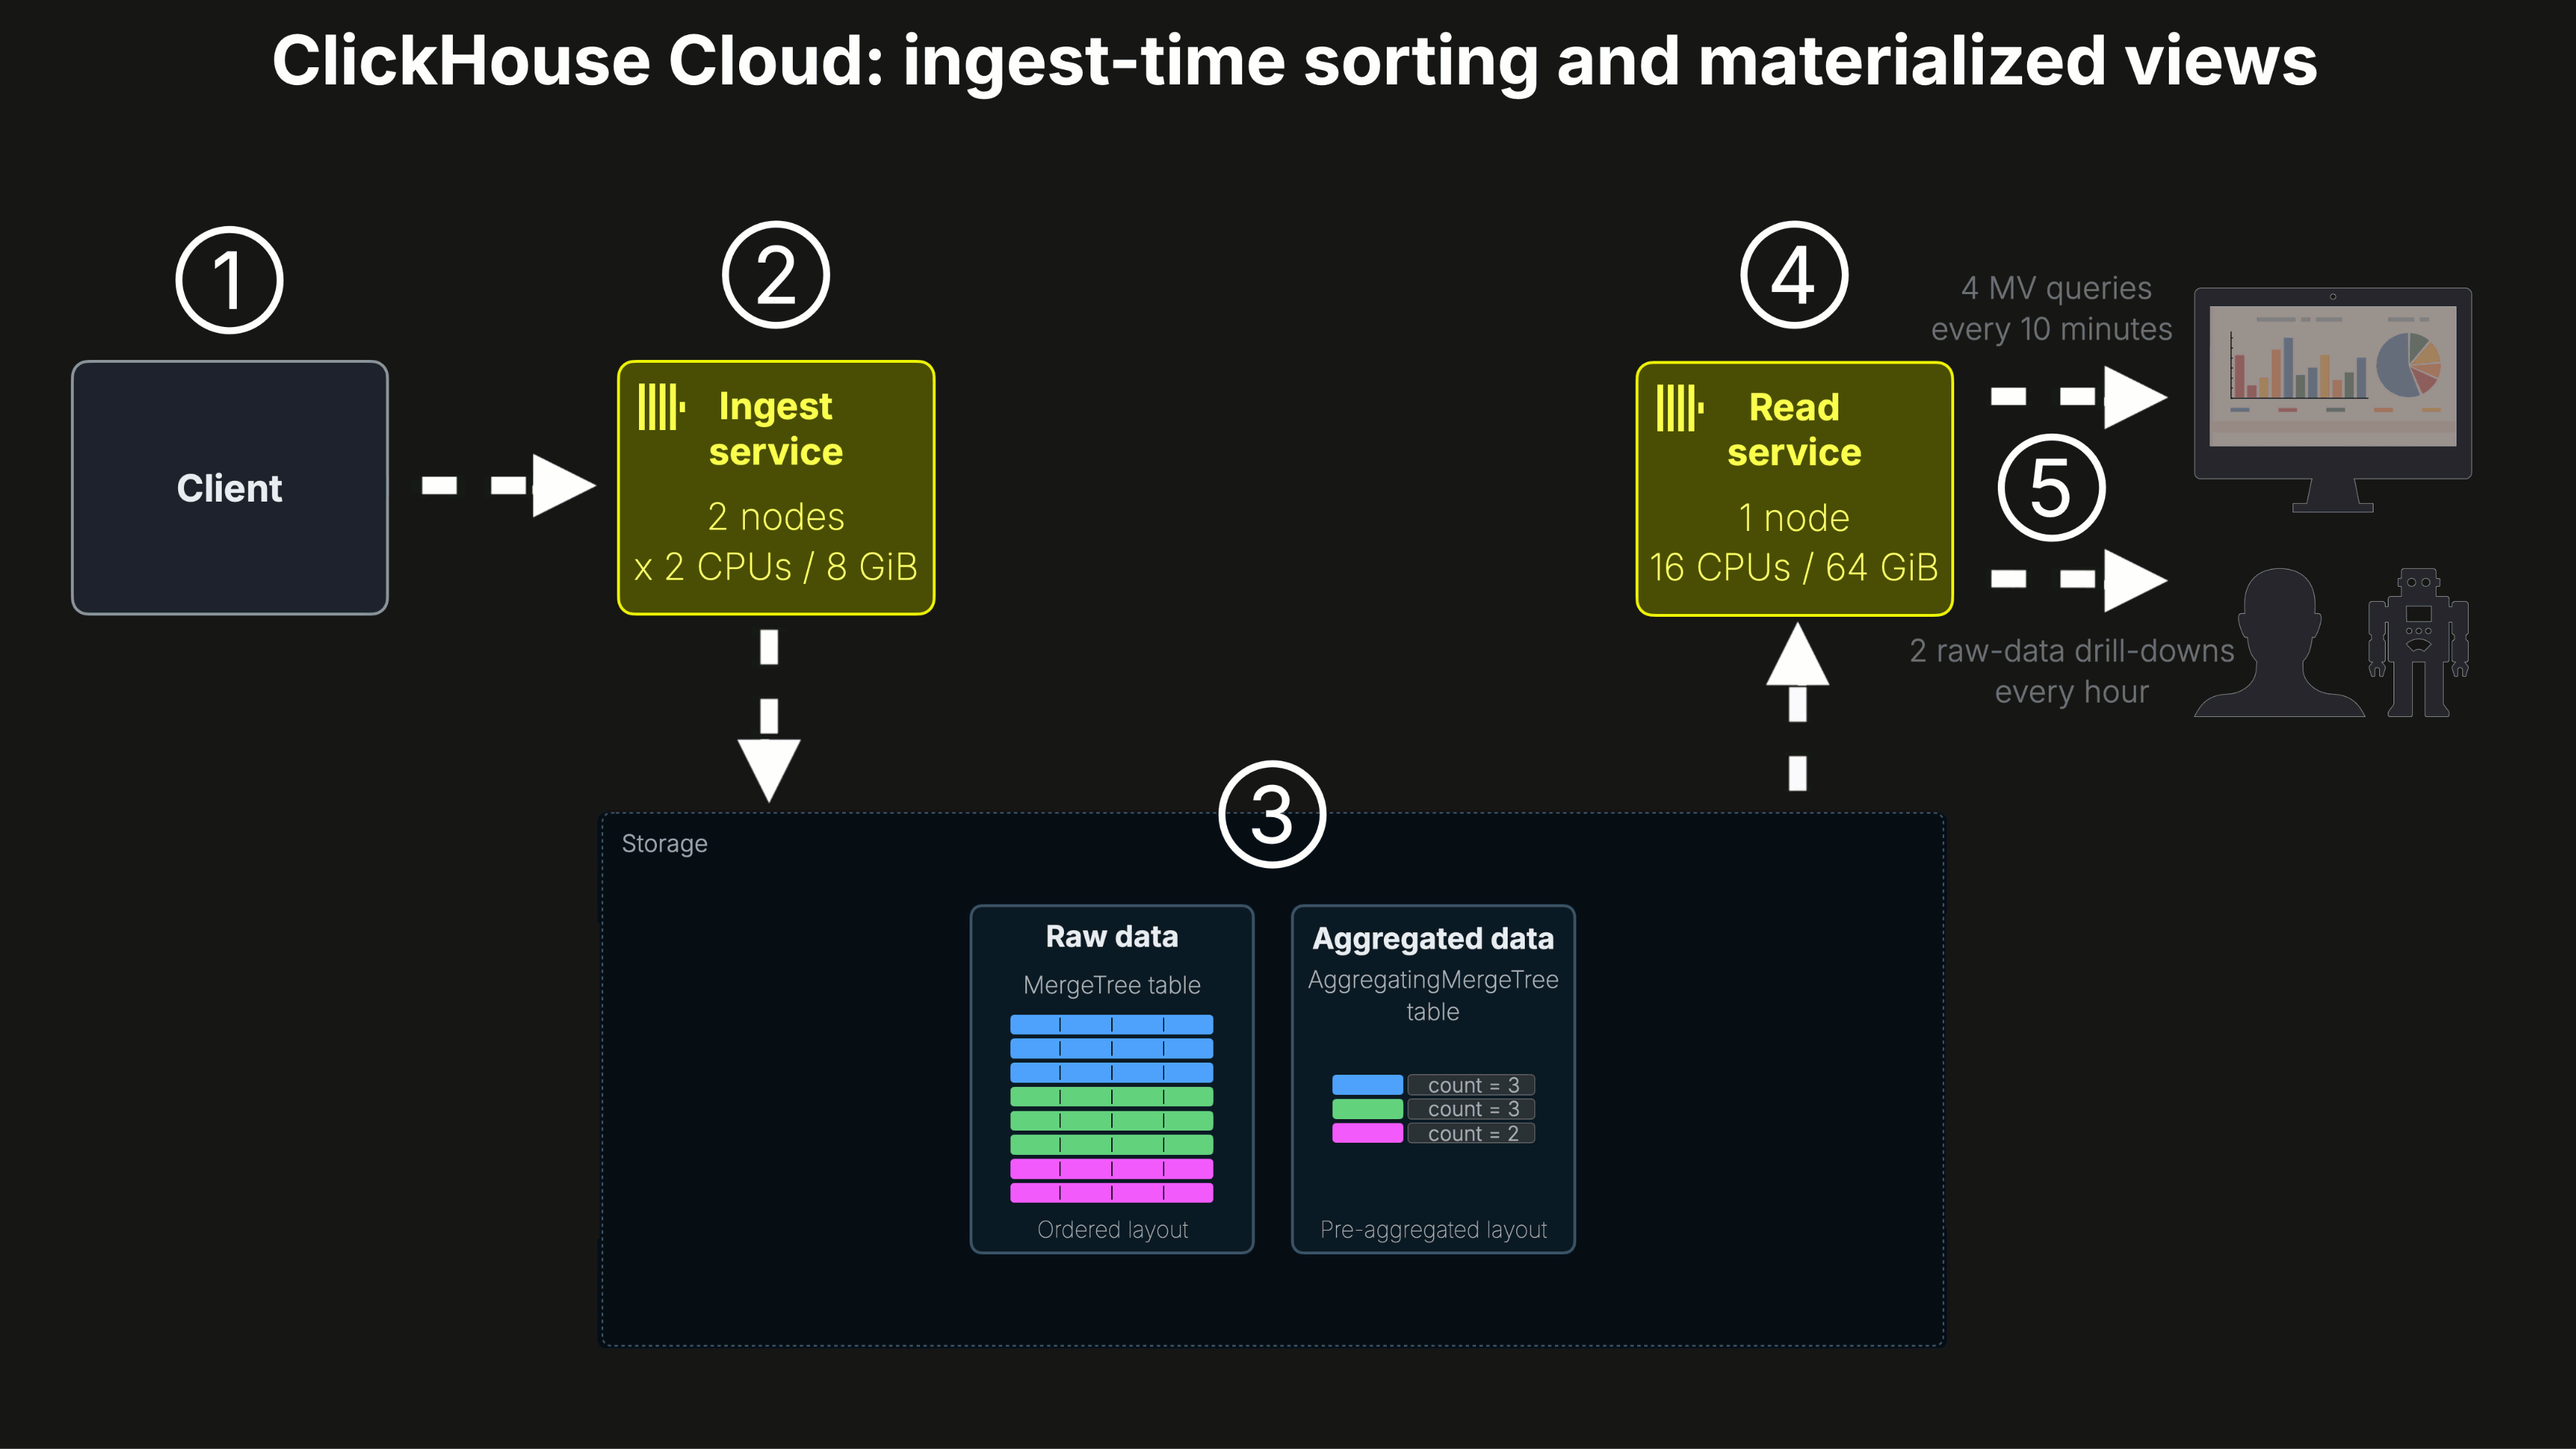
ClickHouse Cloudでは、インジェストと読み取りに別々のサービスを使用したため、書き込みパスとクエリパスは互いに[分離](https://clickhouse.com/blog/introducing-warehouses-compute-compute-separation-in-clickhouse-cloud)されていました。
### **① クライアントセットアップ** {#client_setup}
[クライアント](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/clickhouse-cloud/ingest_parquet_dir.py)(ベンチマークドライバー)は意図的にシンプルに保たれており、ClickHouseとSnowflakeに対して同じ作業を行います。
既存のParquetファイルからParquetの行グループをバイナリ形式で直接読み取り、それらを約100万行のバッチに結合してターゲットシステムに送信します。クライアント側でのデコード、解凍、エンコード、圧縮は一切ありません。
これは重要です。Snowflakeの応答では、最初のベンチマークで欠けている要因としてクライアント側のコストが指摘されていたためです。このセットアップでは、クライアント作業は両システムで同一であり、非常に少ないCPUとメモリしか使用しないため、クライアント側のコストはもはや意味のある差別化要因ではありません。
### **② インジェストサービス** {#ingest_service}
インジェストは、専用のClickHouse Cloudサービスで実行され、2ノード、各ノードは2 CPU、8 GiBのメモリを使用します。
これは、100万行/秒のデータストリームを連続的にインジェストし、入力データをソートし、事前集計データを更新するのに[十分](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/clickhouse-cloud/results/utilization/writer/README_clickhouse_writer_utilization.md)であり、[継続的なバックグラウンドマージ](https://clickhouse.com/docs/merges)により、テーブル全体でアクティブなデータパートの総数を常に約60に保っていました。
> この効率性は実際のユースケースでも重要です。同じ市場データを**ライブ**でストリーミングし、到着と同時にクエリ可能にする[StockHouse](https://stockhouse.clickhouse.com/)のようなデモをコスト効率よく実行できます。
### **③ ソートされた生データとマテリアライズドビュー** {#sorted_raw_data_and_materialized_views}
ClickHouseは、MergeTreeテーブルを使用して生データを[ソートされた形式](https://clickhouse.com/blog/write-side-cost-performance-snowflake-clickhouse#clickhouse-ordering-on-the-write-path)で直接ディスクに書き込みます。これは生データドリルダウンワークロードを提供するテーブルです。
同時に、インクリメンタルマテリアライズドビューが、新しい行が到着するとAggregatingMergeTreeテーブル内の事前集計データを維持します。これはダッシュボードワークロードを提供するテーブルです。
コード: [生MergeTreeテーブル](https://github.com/ClickHouse/CostBench/blob/6fb94fd628b100db69bc2bf9f8d6f149eec54601/full-path-realtime/quotes/clickhouse-cloud/create.sql#L7)、[AggregatingMergeTreeテーブル](https://github.com/ClickHouse/CostBench/blob/6fb94fd628b100db69bc2bf9f8d6f149eec54601/full-path-realtime/quotes/clickhouse-cloud/create.sql#L31)、[インクリメンタルマテリアライズドビュー](https://github.com/ClickHouse/CostBench/blob/6fb94fd628b100db69bc2bf9f8d6f149eec54601/full-path-realtime/quotes/clickhouse-cloud/create.sql#L53)。
> ベンチマーク中いつでも、生のMergeTreeテーブルは高速なドリルダウンのためにソートされたままで、AggregatingMergeTreeテーブルはダッシュボードクエリ用の事前集計データを格納し、ベーステーブルとの鮮度ギャップはありません。両方のテーブルは常に最新かつ[クエリ可能](https://clickhouse.com/blog/write-side-cost-performance-snowflake-clickhouse#what-does-query-ready-mean)な状態を保ちます。
### **④ 読み取りサービス** {#read_service}
読み取りクエリは、1ノードで16 CPUを持つ[別の](https://clickhouse.com/blog/introducing-warehouses-compute-compute-separation-in-clickhouse-cloud)ClickHouse Cloudサービスで実行されます。
> Snowflakeのセットアップでも同じ量の読み取りコンピュートを使用するため、システム間で読み取り側のキャパシティが揃えられています。
注: AWS上のSnowflake Gen2 Smallウェアハウスは16 AWS Graviton3コアを[使用する](https://medium.com/snowflake-engineering/deep-dive-inside-snowflakes-new-gen2-standard-warehouses-powered-by-aws-graviton3-6aacca73ae2d)ことが広く[知られています](https://select.dev/posts/snowflake-warehouse-sizing)。ClickHouse CloudもAWSデプロイメントでAWS Graviton3コアを使用するため、比較は両方の読み取りパスを同じCPU世代の16コアに揃えます。
### **⑤ 連続クエリワークロード** {#continuous_query_workload}
連続的な読み取りワークロードをシミュレートするため、ベンチマーク中に2種類のクエリを定期的に実行します。
10分ごとに、事前集計テーブルに対して[4つのダッシュボードクエリ](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/clickhouse-cloud/queries_mv.sql)を送信します。
1時間ごとに、生テーブルに対して[2つのアドホックドリルダウンクエリ](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/clickhouse-cloud/queries_raw.sql)を送信します。これらのドリルダウンクエリは、生テーブルのソート順に一致するフィルタを使用します。
> Snowflakeでも同じクエリスケジュールを、同等の物理レイアウトで実行します。生データは同じキーでクラスタリングされ、集計データは同じ方法で事前集計されています。
## Snowflakeセットアップ1: 標準テーブルとマテリアライズドビュー {#snowflake_setup_1_standard_tables_and_materialized_views}
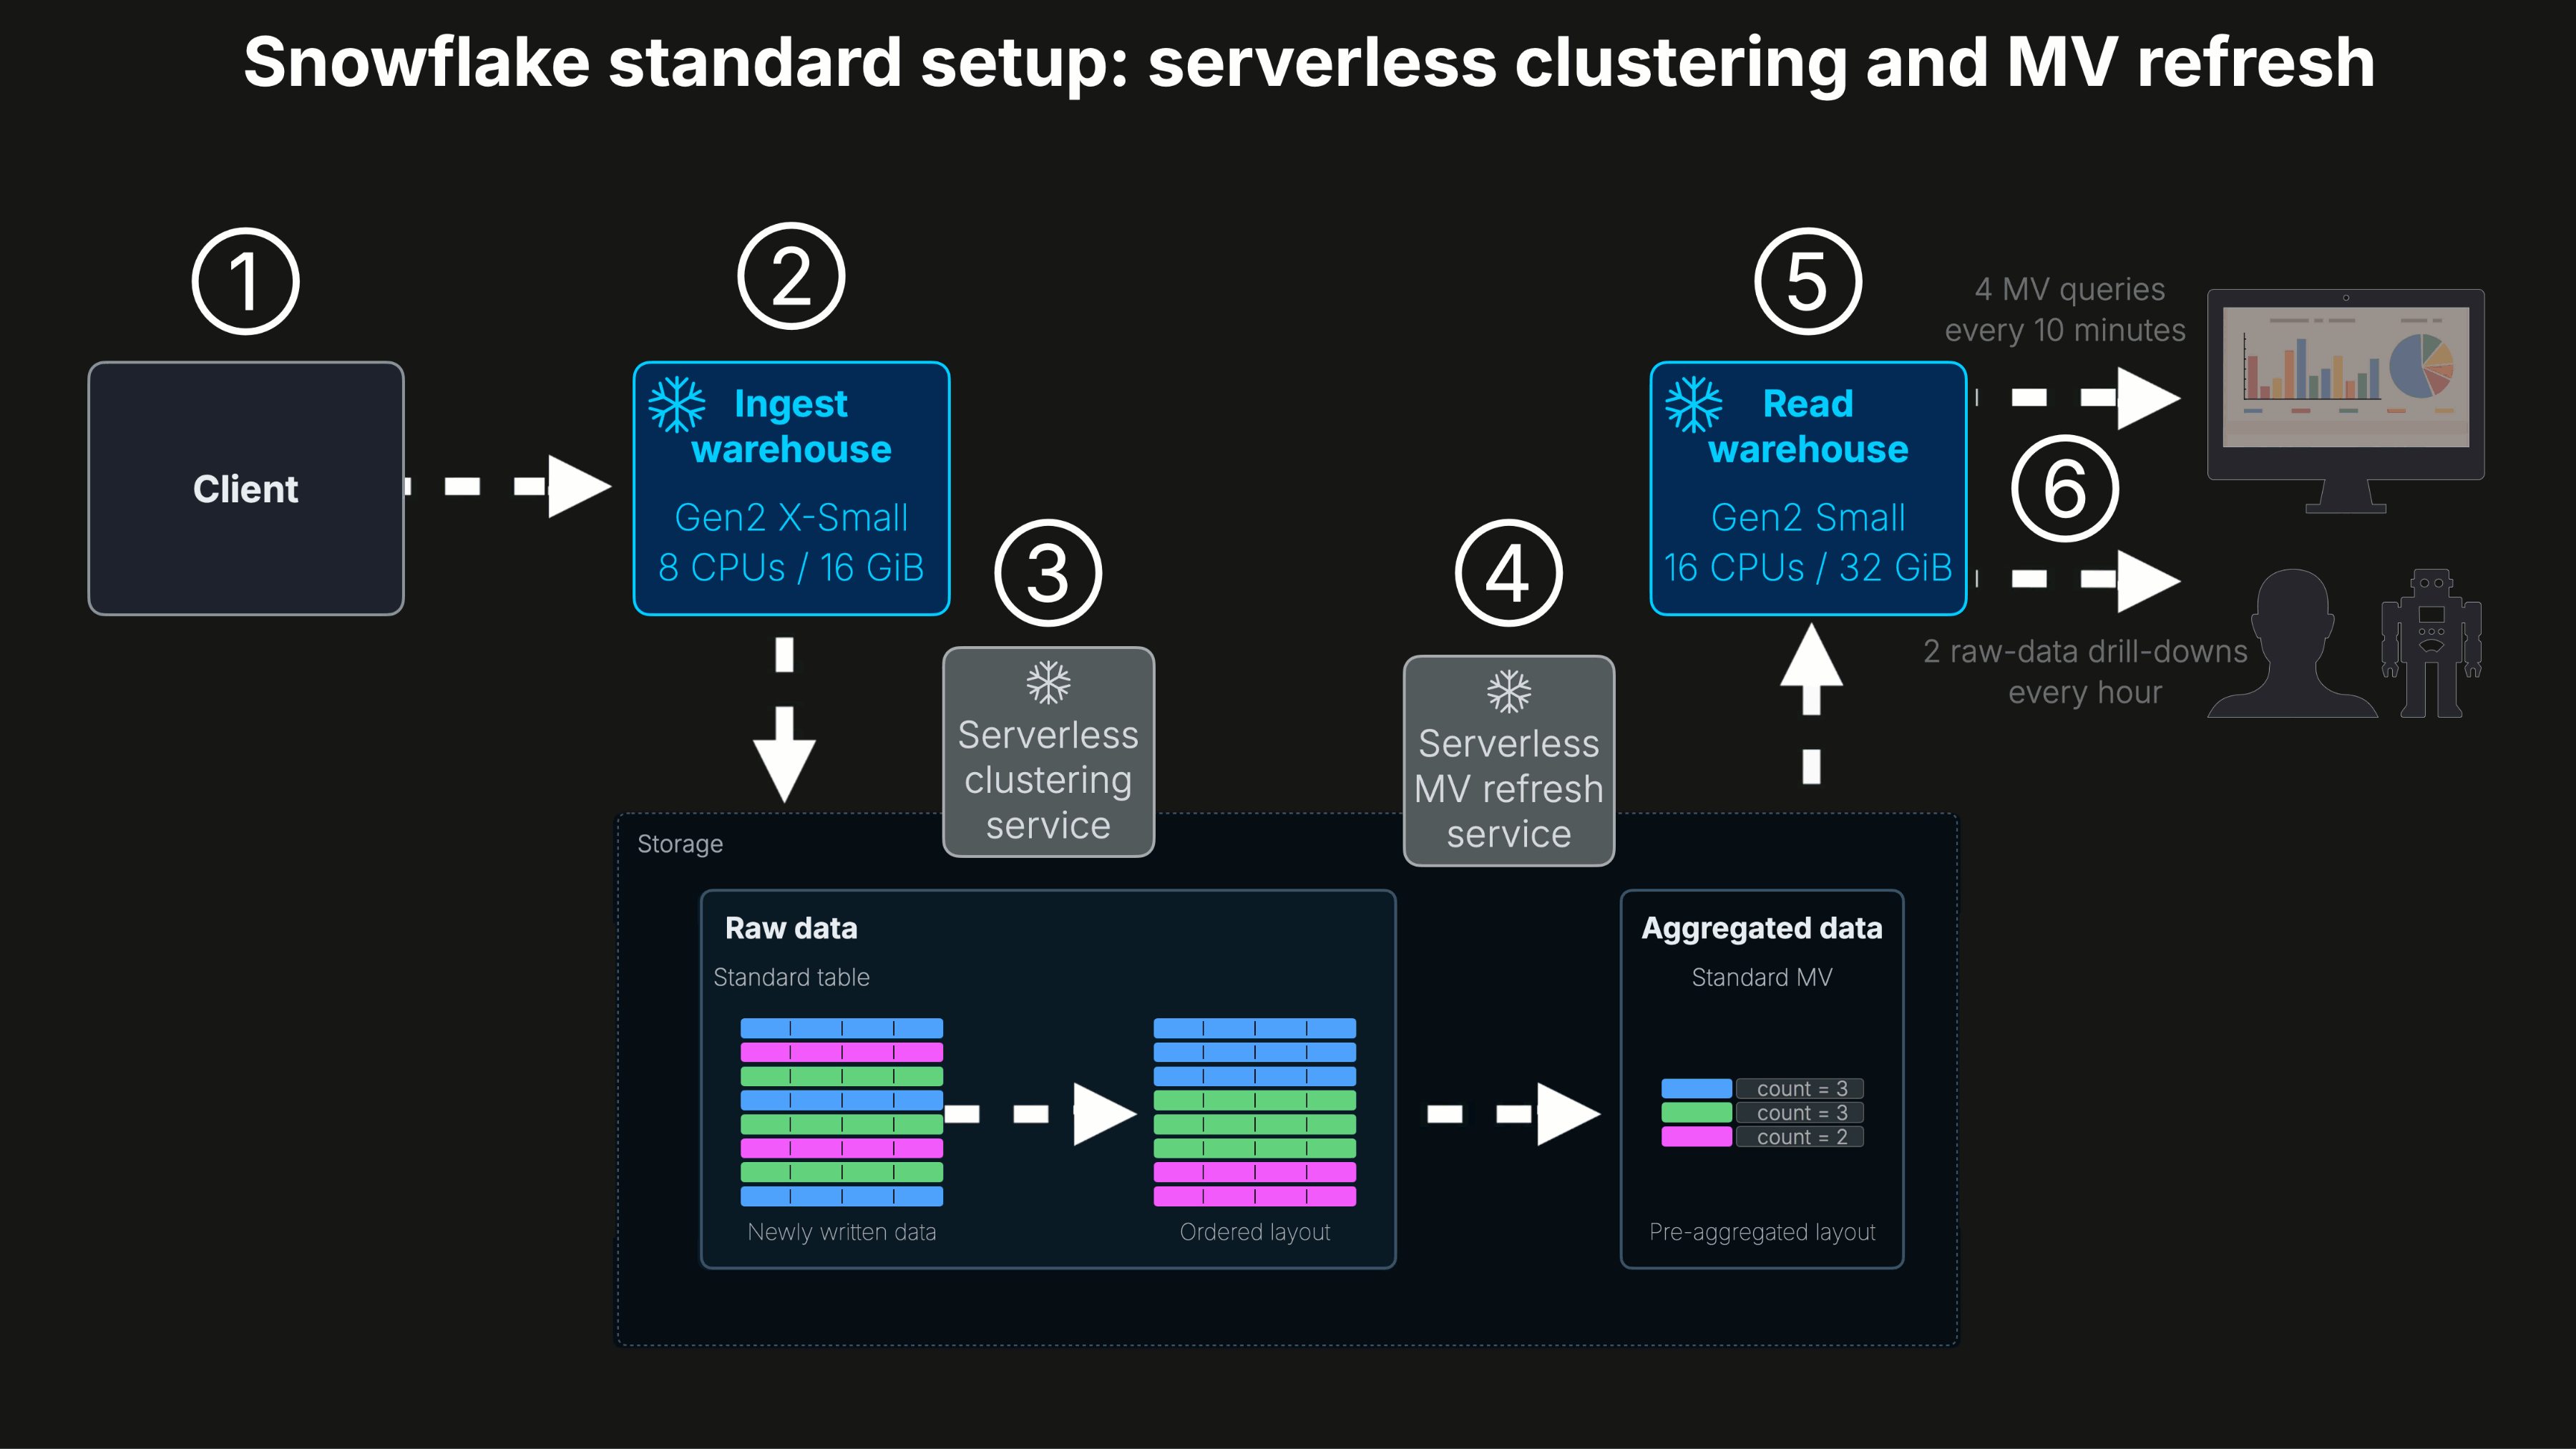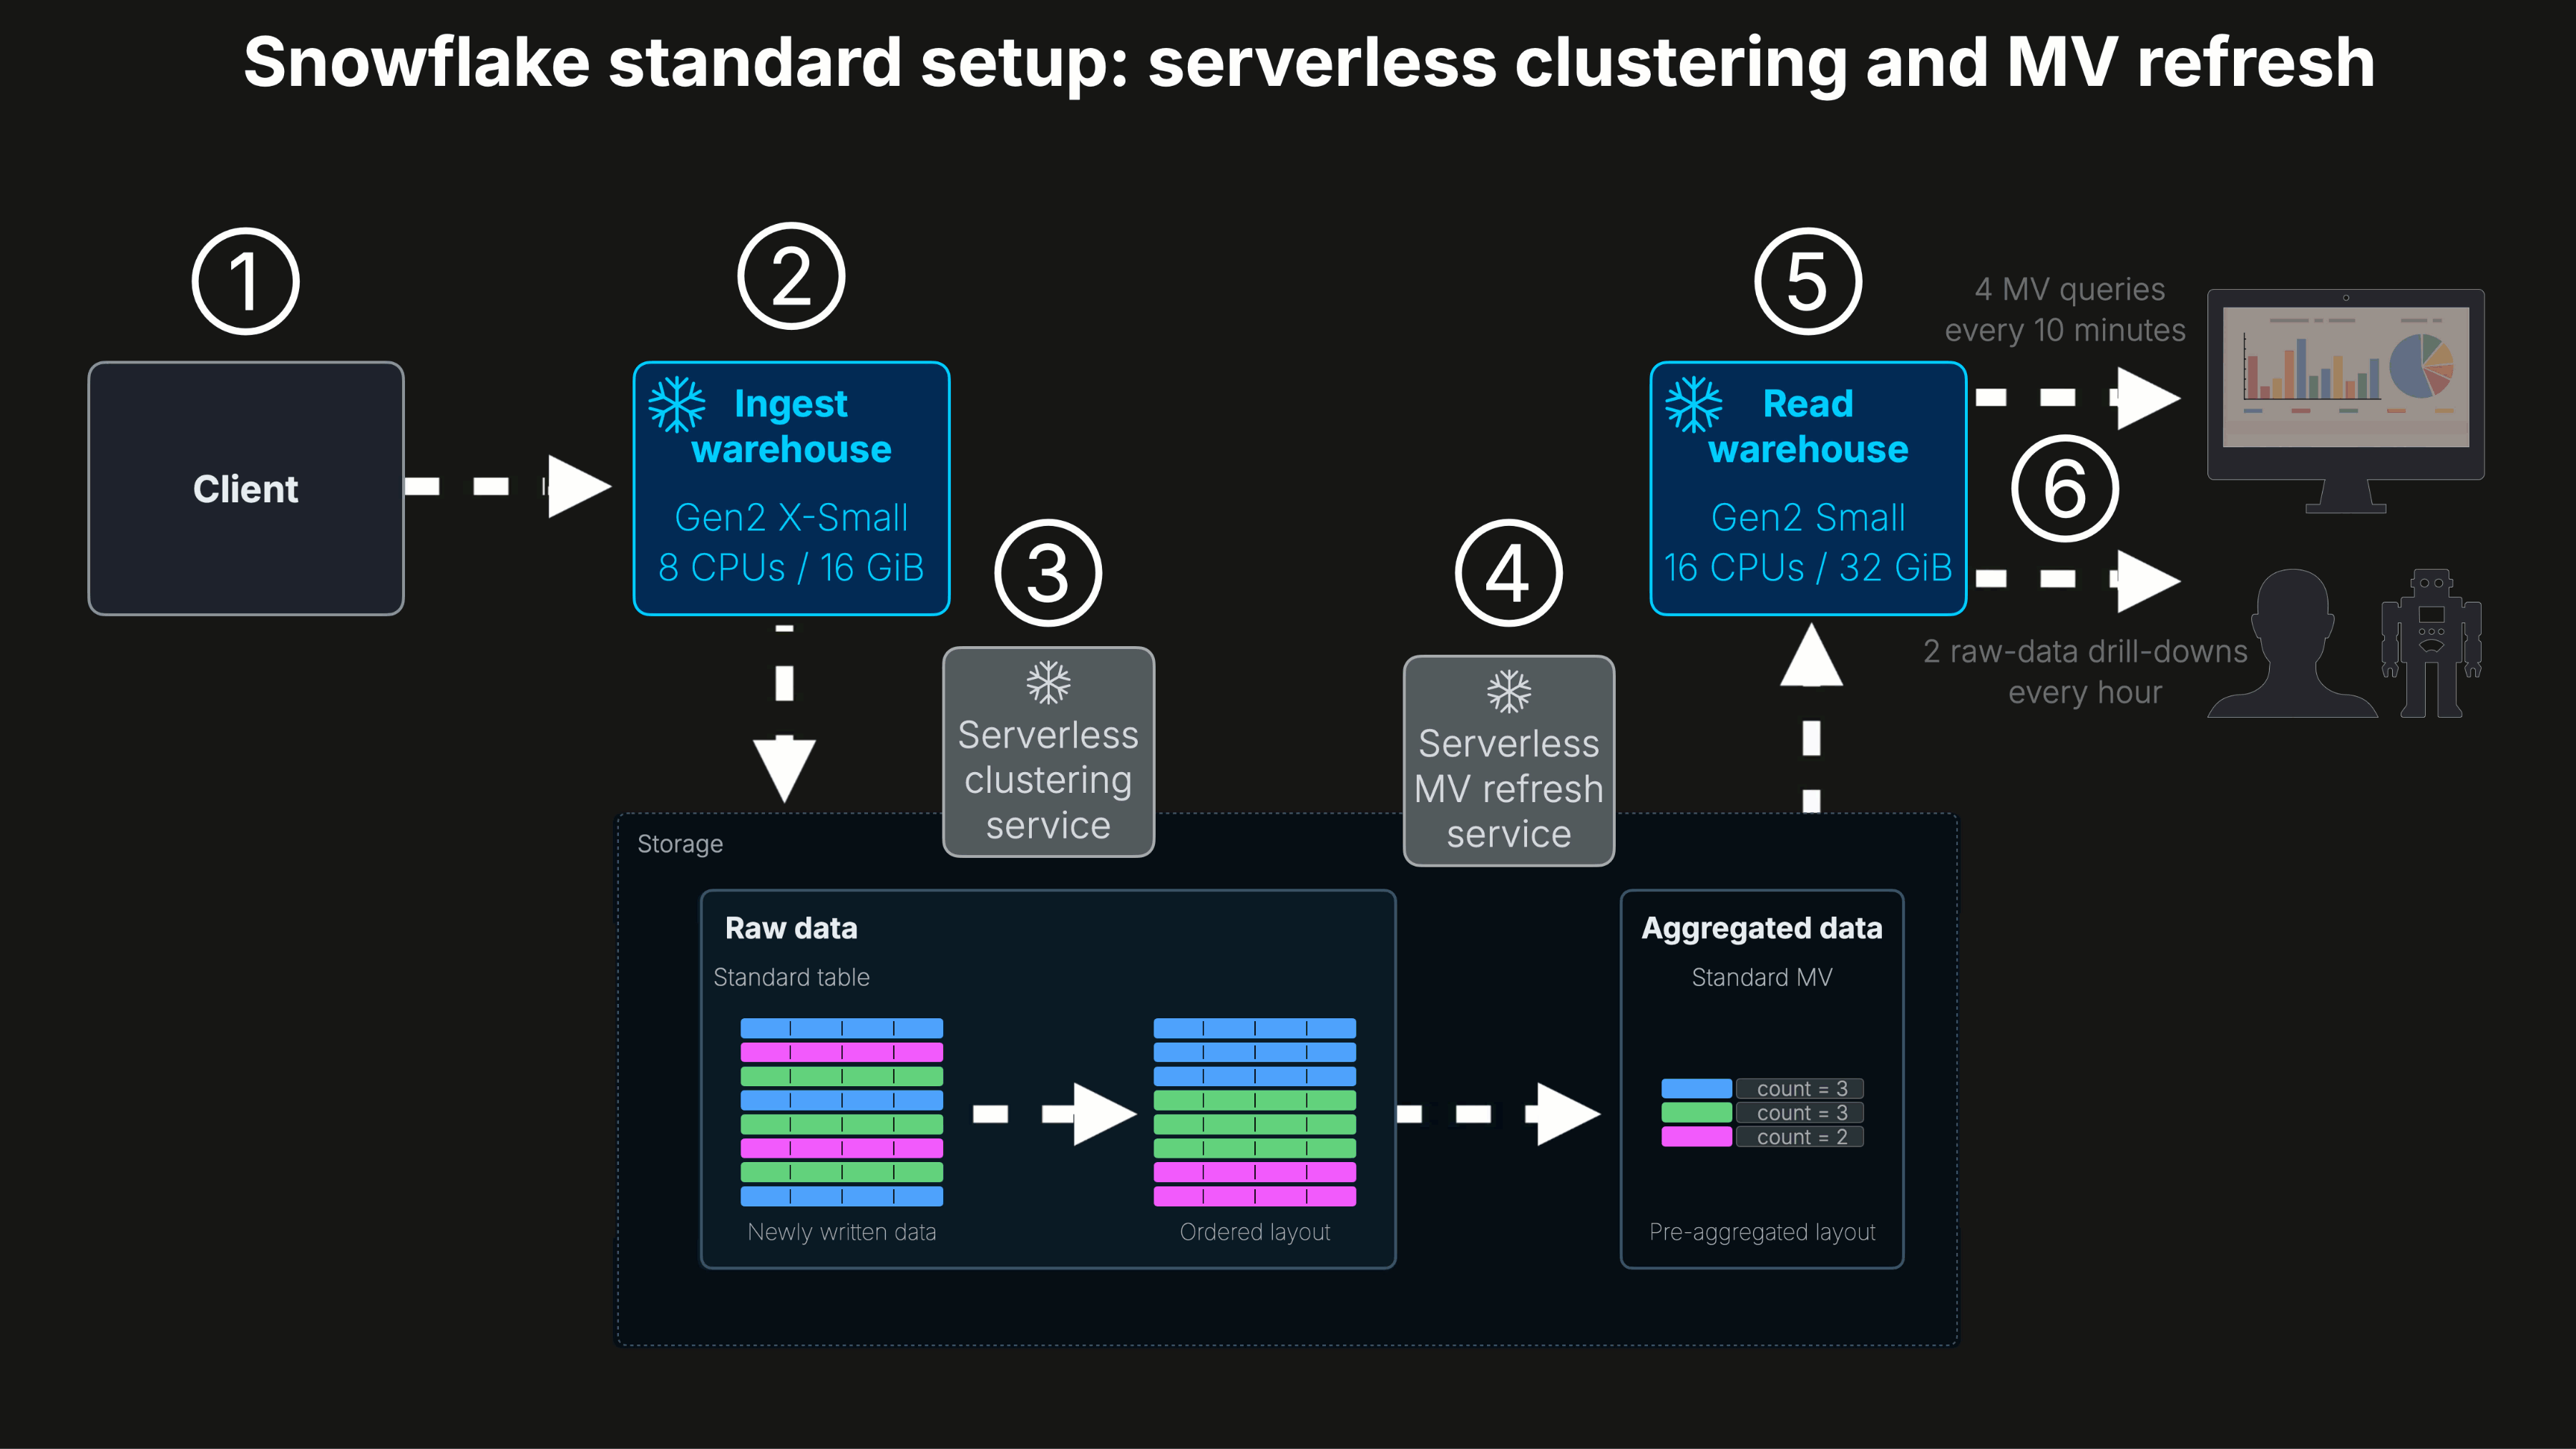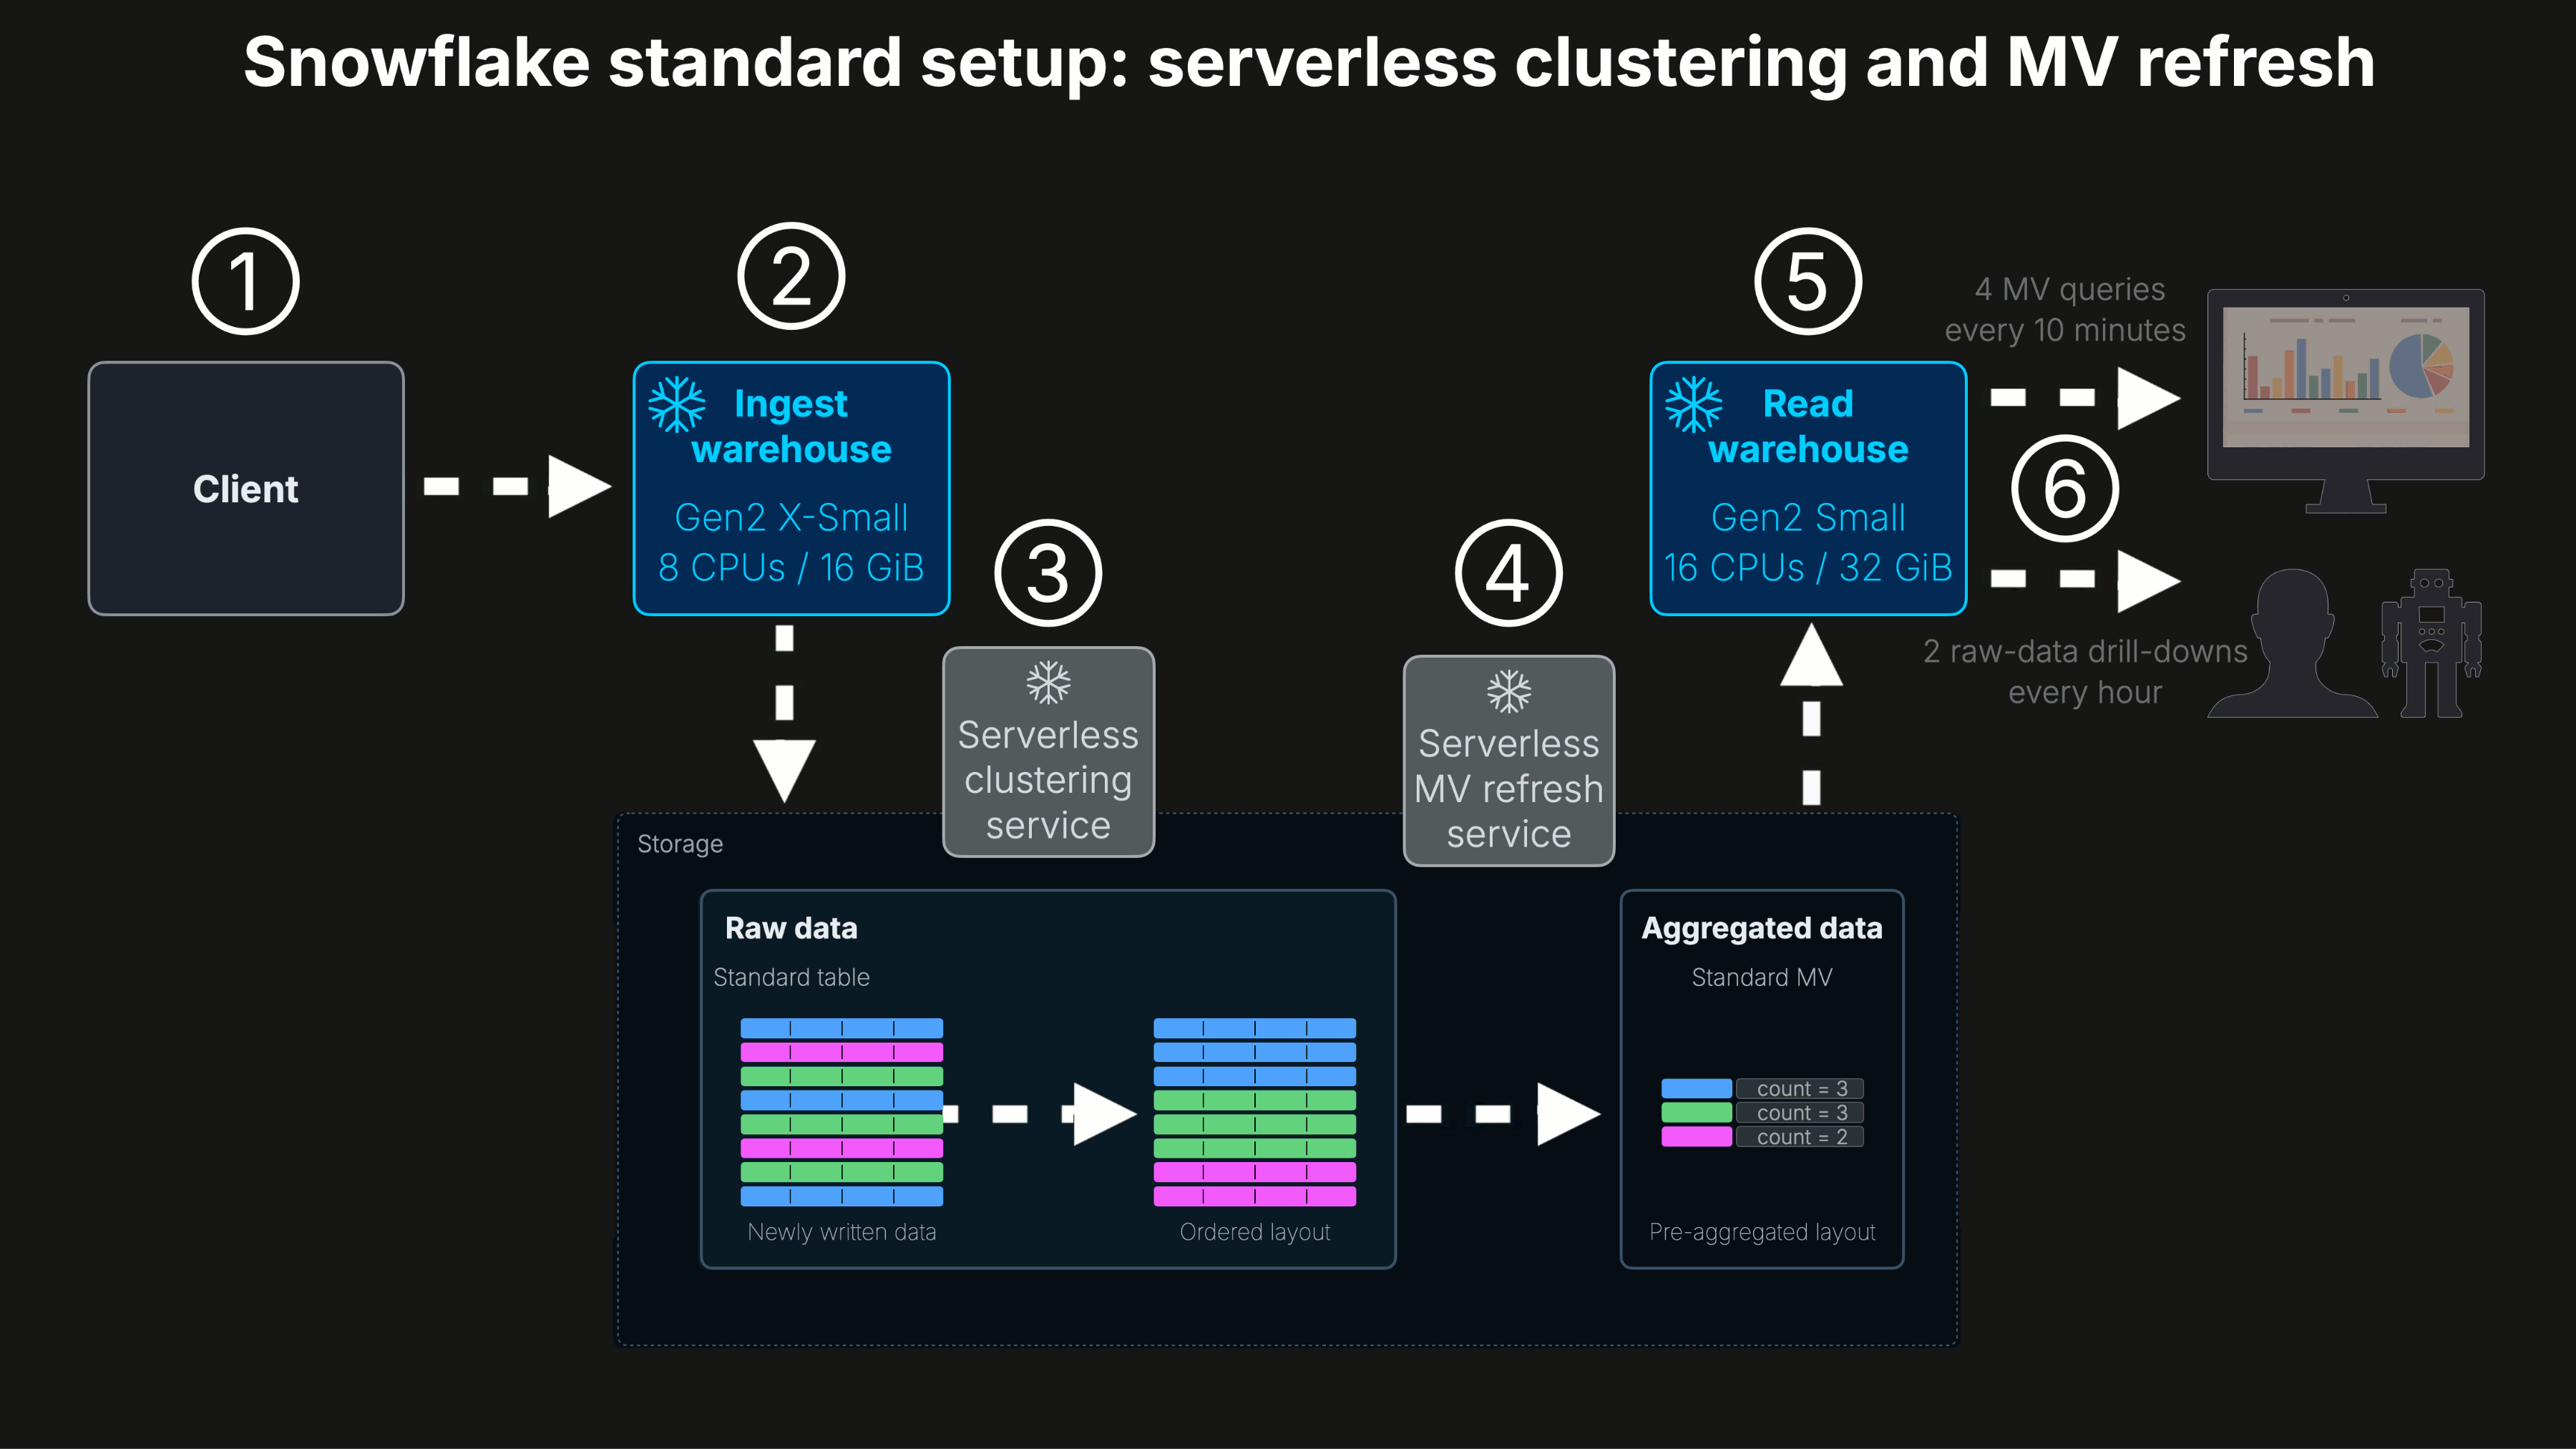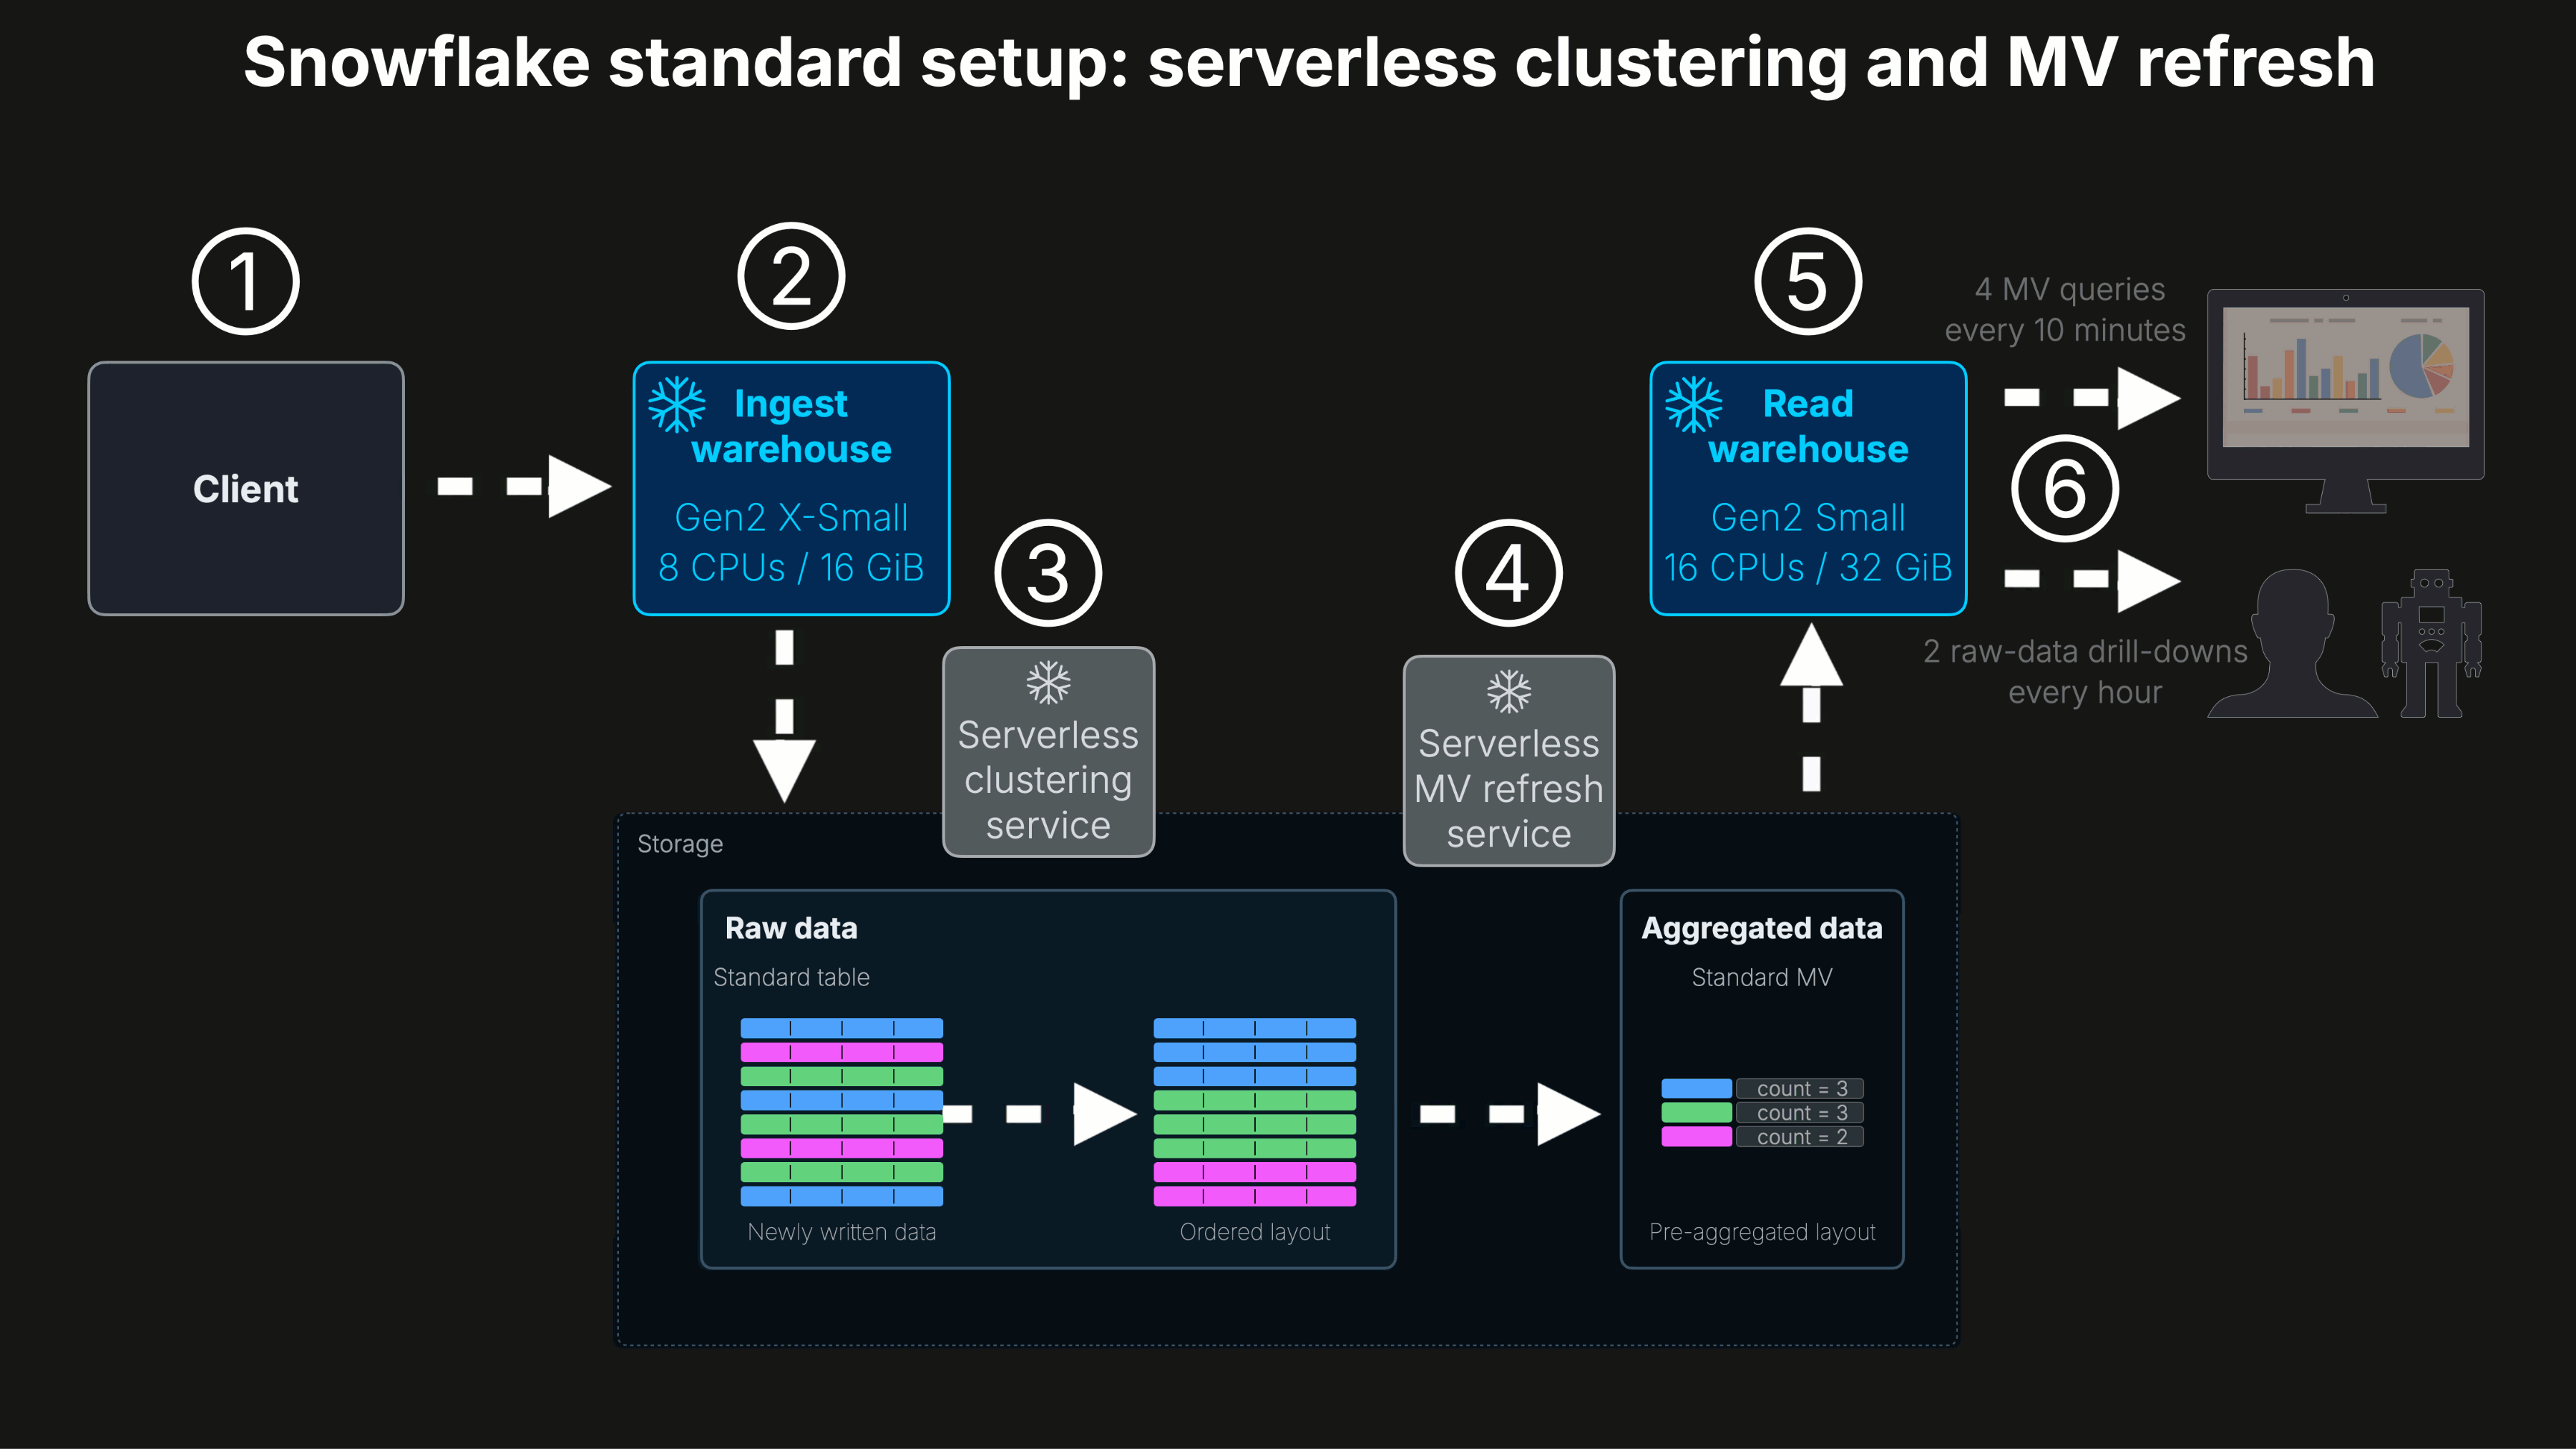
最初のSnowflakeセットアップは、ほとんどのSnowflakeのお客様が今日利用可能なパス、すなわち標準テーブル、標準[マテリアライズドビュー](https://docs.snowflake.com/en/user-guide/views-materialized)、Gen2ウェアハウスを使用します。
### **① クライアントセットアップ** {#client_setup_2}
> [クライアント](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/snowflake/ingest.py)セットアップ(ベンチマークドライバー)は、ClickHouseセットアップと同じです。
Parquetの行グループをバイナリ形式で直接読み取り、約100万行のバッチに結合して、それらのバッチをSnowflakeに送信します。今回は、クライアントは`COPY INTO`を使用してParquetデータを生テーブルにロードします。
前述のとおり、クライアントはデコード、解凍、エンコード、圧縮を一切行いません。したがって、実行されるクライアント側の作業量はClickHouseと完全に同じです。
### **② インジェストウェアハウス** {#ingest_warehouse}
インジェストには、固定された100万行/秒のインジェストレートを維持できる最小のSnowflakeウェアハウスを再度選びました。
ただし今回は、Snowflakeの推奨に従い、Gen2ハードウェアを使用します。具体的には、8 CPUのGen2 X-Smallウェアハウスです。
> 目標は依然として最大ロードスループットではありません。
目標は、新しいデータが継続的に到着するリアルタイムワークロードをシミュレートするため、固定されたインジェストレートを維持できる最低コストのセットアップです。
### **③ サーバーレスクラスタリング** {#serverless_clustering}
生データは、標準的なSnowflakeテーブルに書き込まれます。これは、毎時の生データドリルダウンワークロードを提供するテーブルです。
データの順序付けは、元のベンチマークと同様に、Snowflakeの[サーバーレスクラスタリングサービス](https://docs.snowflake.com/en/user-guide/tables-auto-reclustering)によってバックグラウンドで処理されます。目標は、ドリルダウンクエリのために生テーブルを物理的に最適化した状態に保つことです。
コード: [生Snowflakeテーブル](https://github.com/ClickHouse/CostBench/blob/6fb94fd628b100db69bc2bf9f8d6f149eec54601/full-path-realtime/quotes/snowflake/create.sql#L44)。
### **④ マテリアライズドビューのリフレッシュ** {#materialized_view_refresh}
エンドツーエンドベンチマークに事前集計を含めるため、生テーブル上のSnowflakeマテリアライズドビューを使用します。このビューはダッシュボードワークロードによってクエリされます。
マテリアライズドビューはSnowflakeのEnterprise専用機能です。リフレッシュ作業は、Snowflakeの[サーバーレスマテリアライズドビューリフレッシュサービス](https://docs.snowflake.com/en/user-guide/views-materialized#materialized-views-cost)によってバックグラウンドで処理されます。
コード: [Snowflakeマテリアライズドビュー](https://github.com/ClickHouse/CostBench/blob/6fb94fd628b100db69bc2bf9f8d6f149eec54601/full-path-realtime/quotes/snowflake/create.sql#L79)。
### **⑤ 読み取りウェアハウス** {#read_warehouse}
ClickHouseセットアップと同様に、インジェストと読み取りに別々のウェアハウスを使用するため、書き込みパスとクエリパスは互いに分離されています。
読み取りには、16 CPUのGen2 Smallウェアハウスを使用します。
> これはClickHouseで使用される読み取り側のCPU数と一致します。
### **⑥ 連続クエリワークロード** {#continuous_query_workload_2}
ClickHouseと同じ連続クエリスケジュールを実行します。
10分ごとに、[事前集計データに対する4つのクエリ](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/snowflake/queries_mv.sql)を実行し、ダッシュボードのリフレッシュをシミュレートします。
1時間ごとに、生テーブルに対して[2つの生データドリルダウンクエリ](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/snowflake/queries_raw.sql)を実行します。
## **Snowflakeセットアップ2: Interactive Tables** {#snowflake_setup_2_interactive_tables}
2つ目のSnowflakeセットアップは、生データと事前集計データの両方に[Interactive Tables](https://docs.snowflake.com/en/user-guide/interactive)を使用します。
Interactive Tablesは現在、[一部のリージョンでのみ利用可能](https://docs.snowflake.com/en/user-guide/interactive#label-interactive-region-availability)です。テストするために、サポートされているリージョンでSnowflakeアカウントを作成する必要がありました。そのため、両方のSnowflakeパスを含めます。標準テーブルとマテリアライズドビューを使用した広く利用可能なセットアップと、利用可能な場所での新しいInteractive Tablesセットアップです。
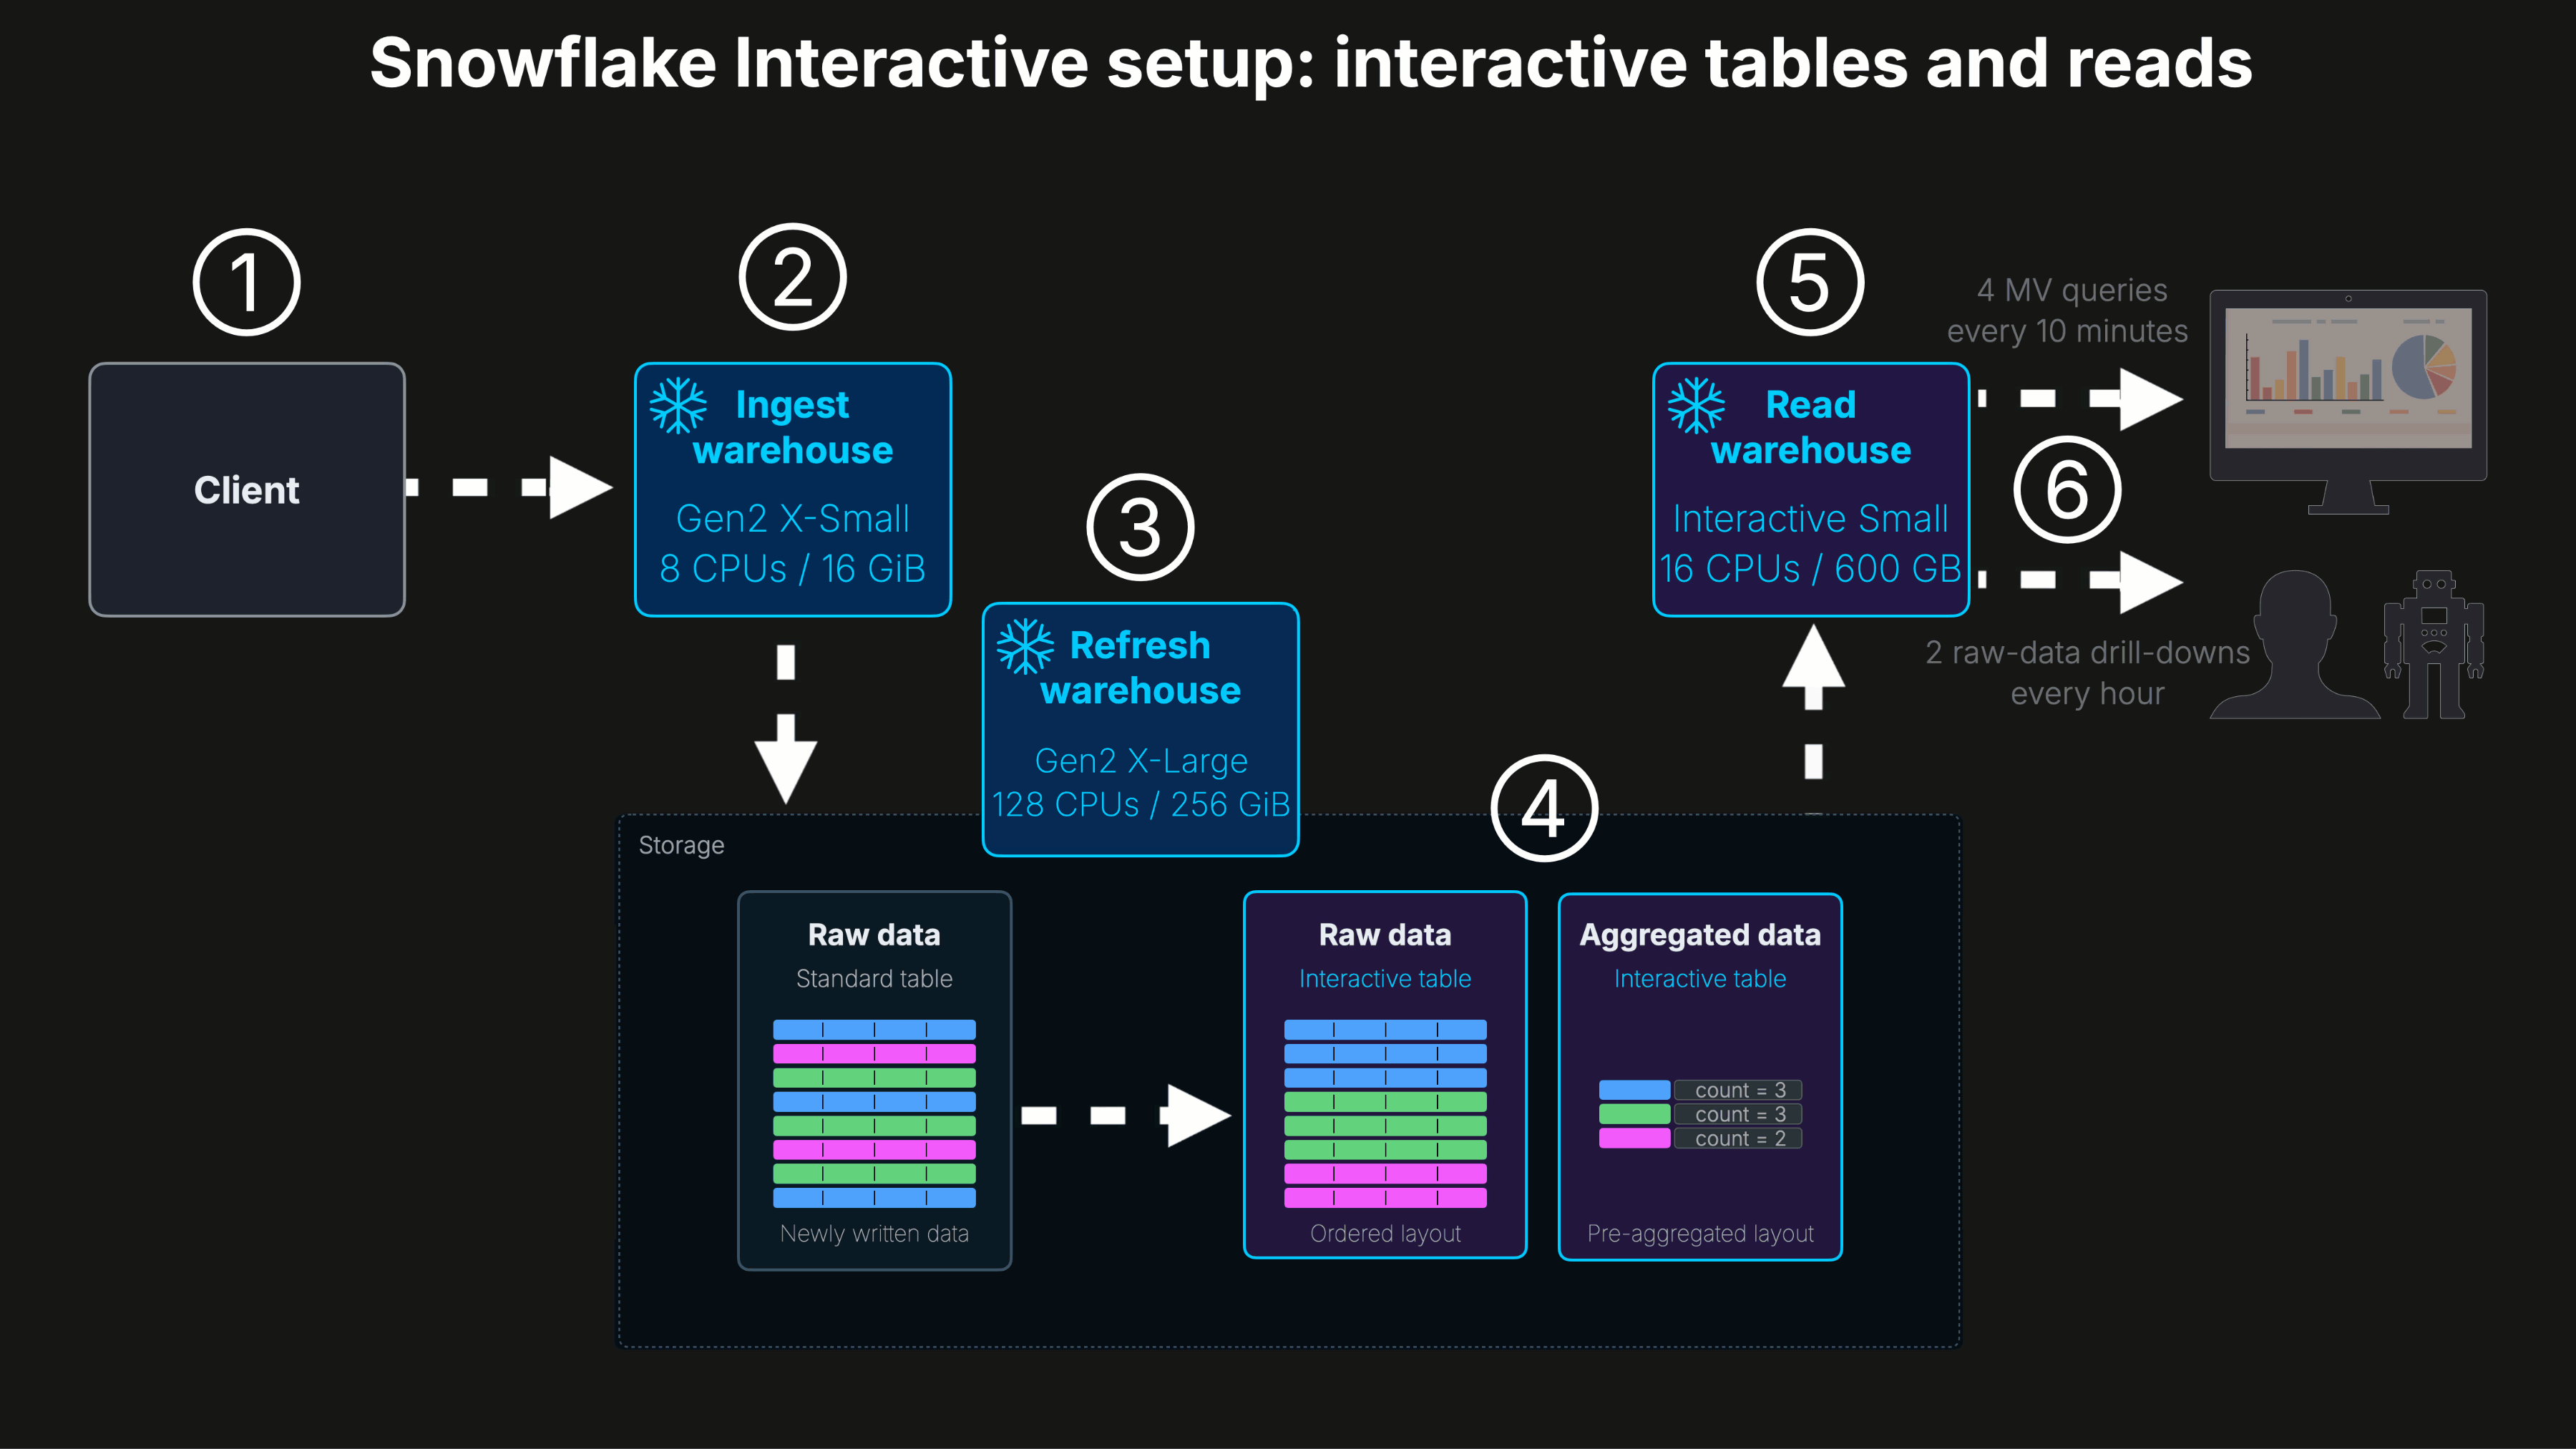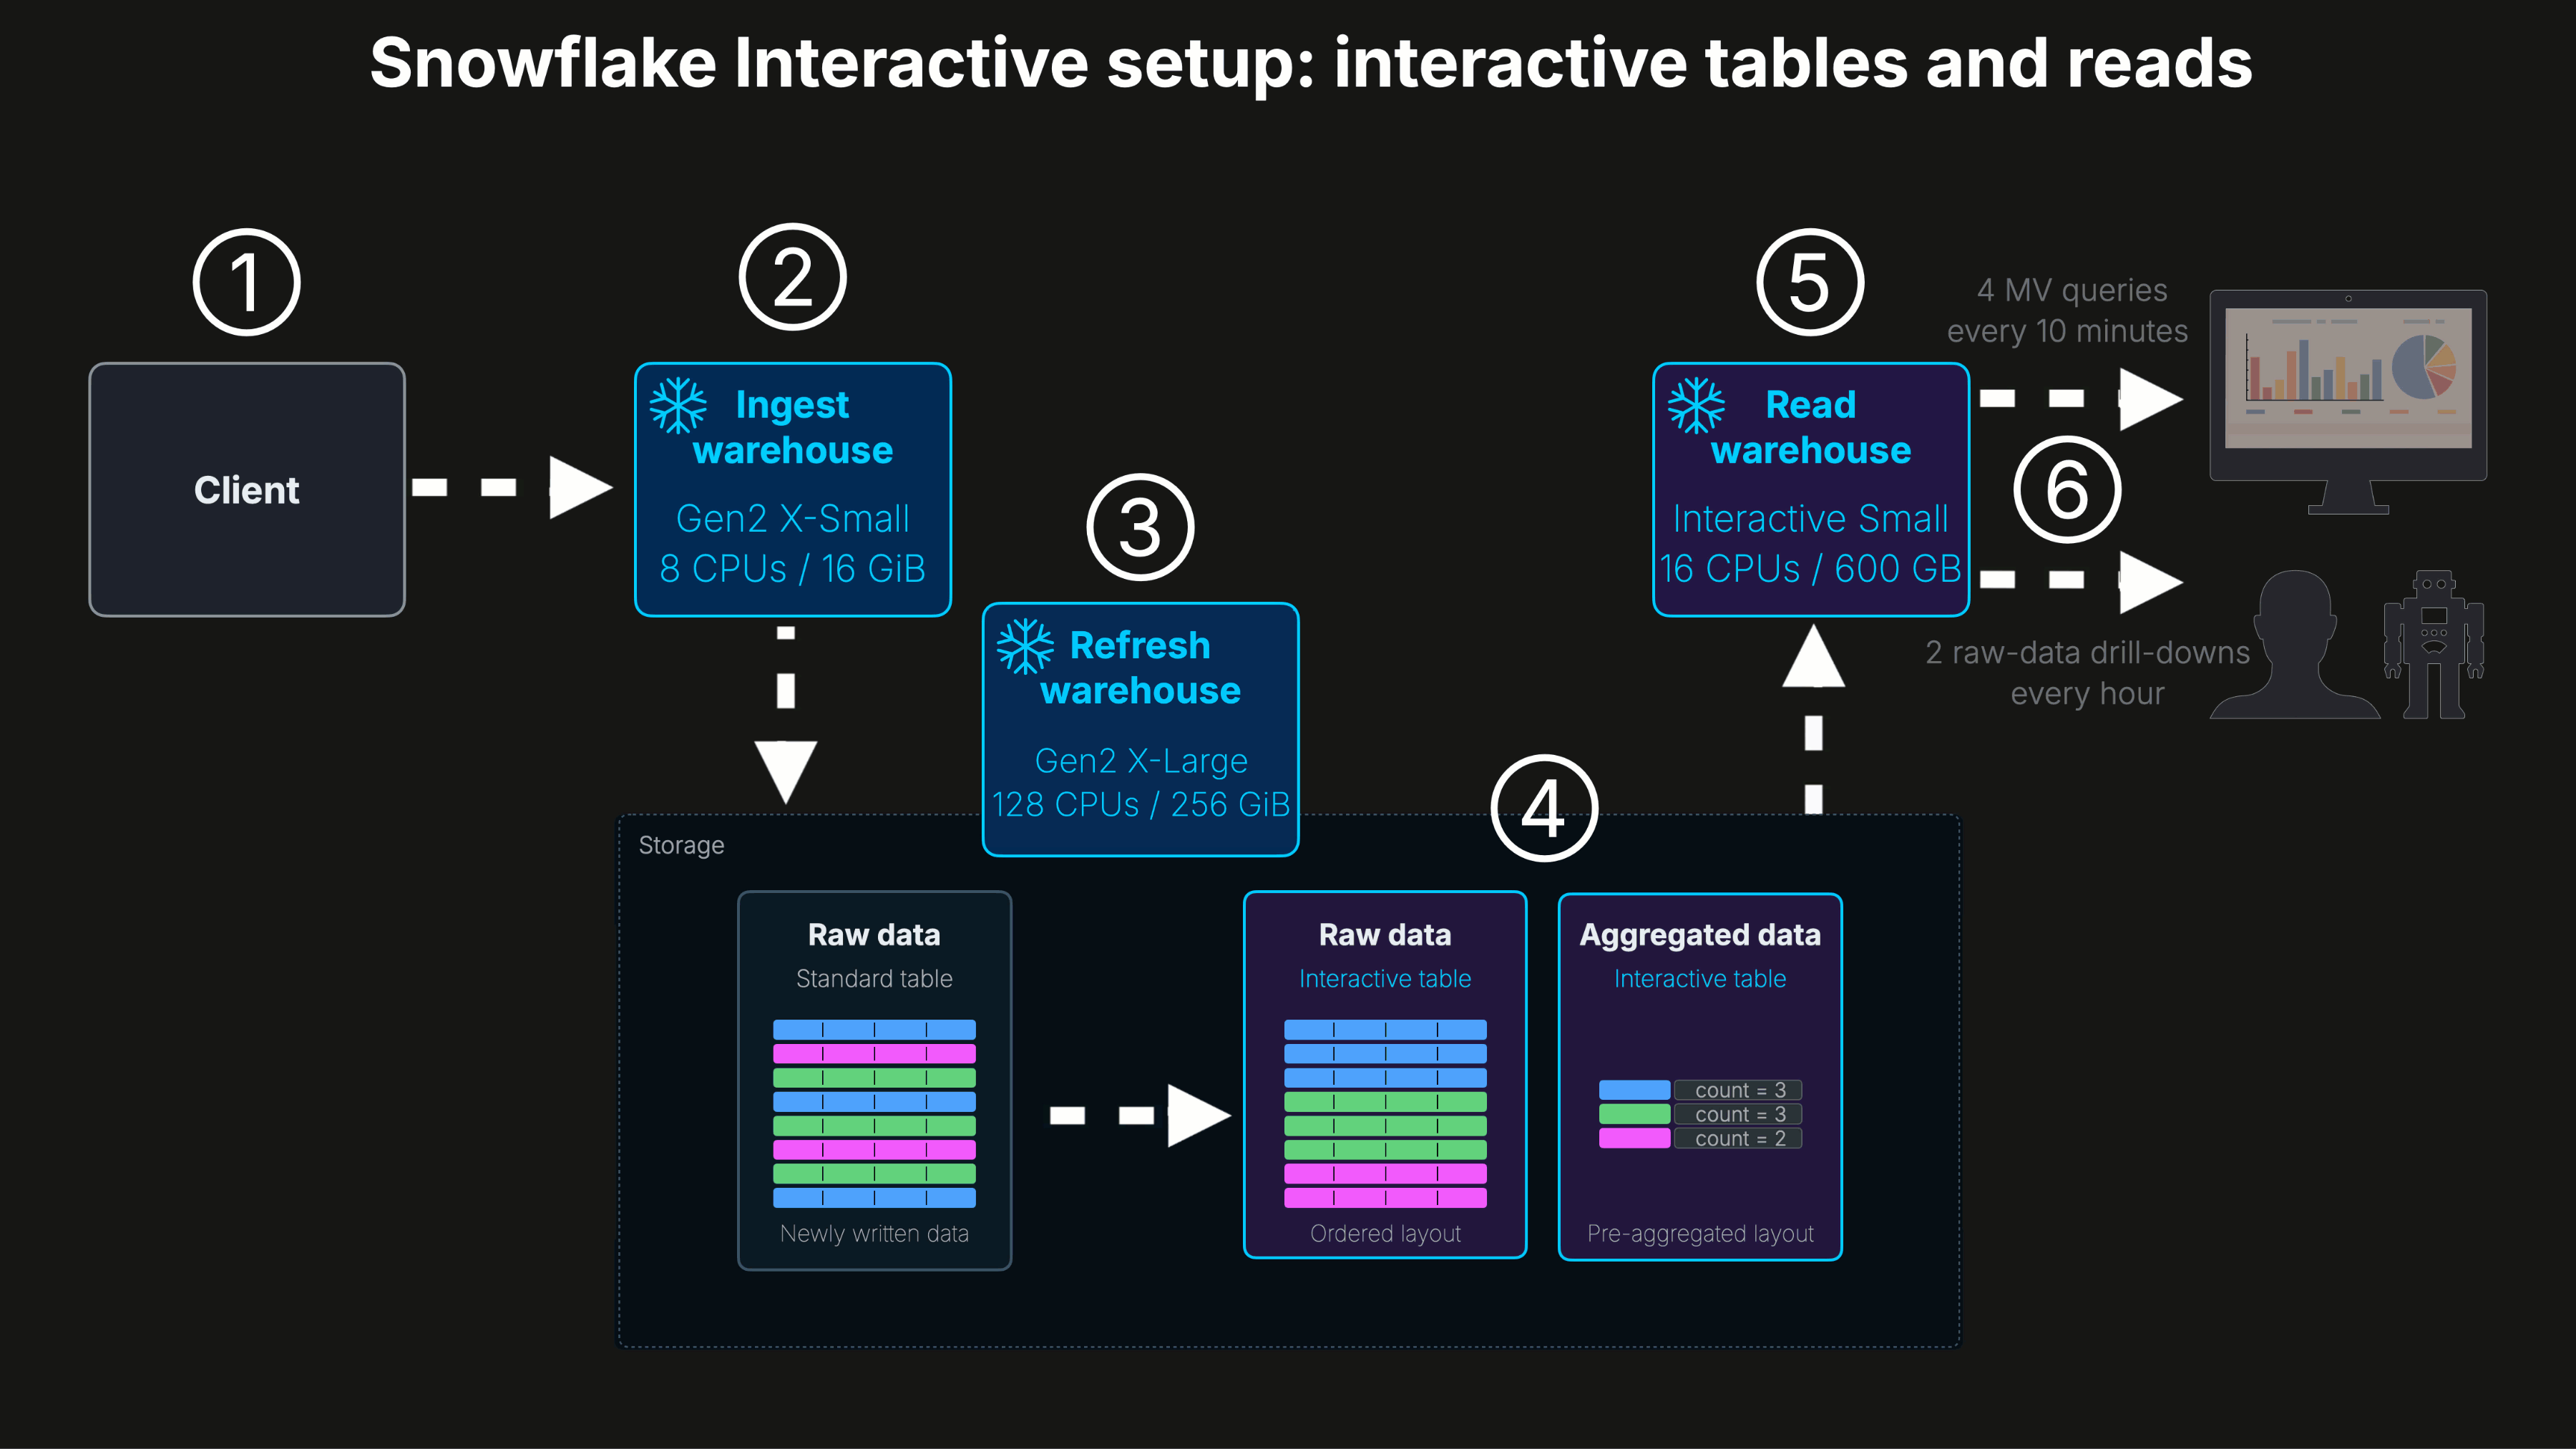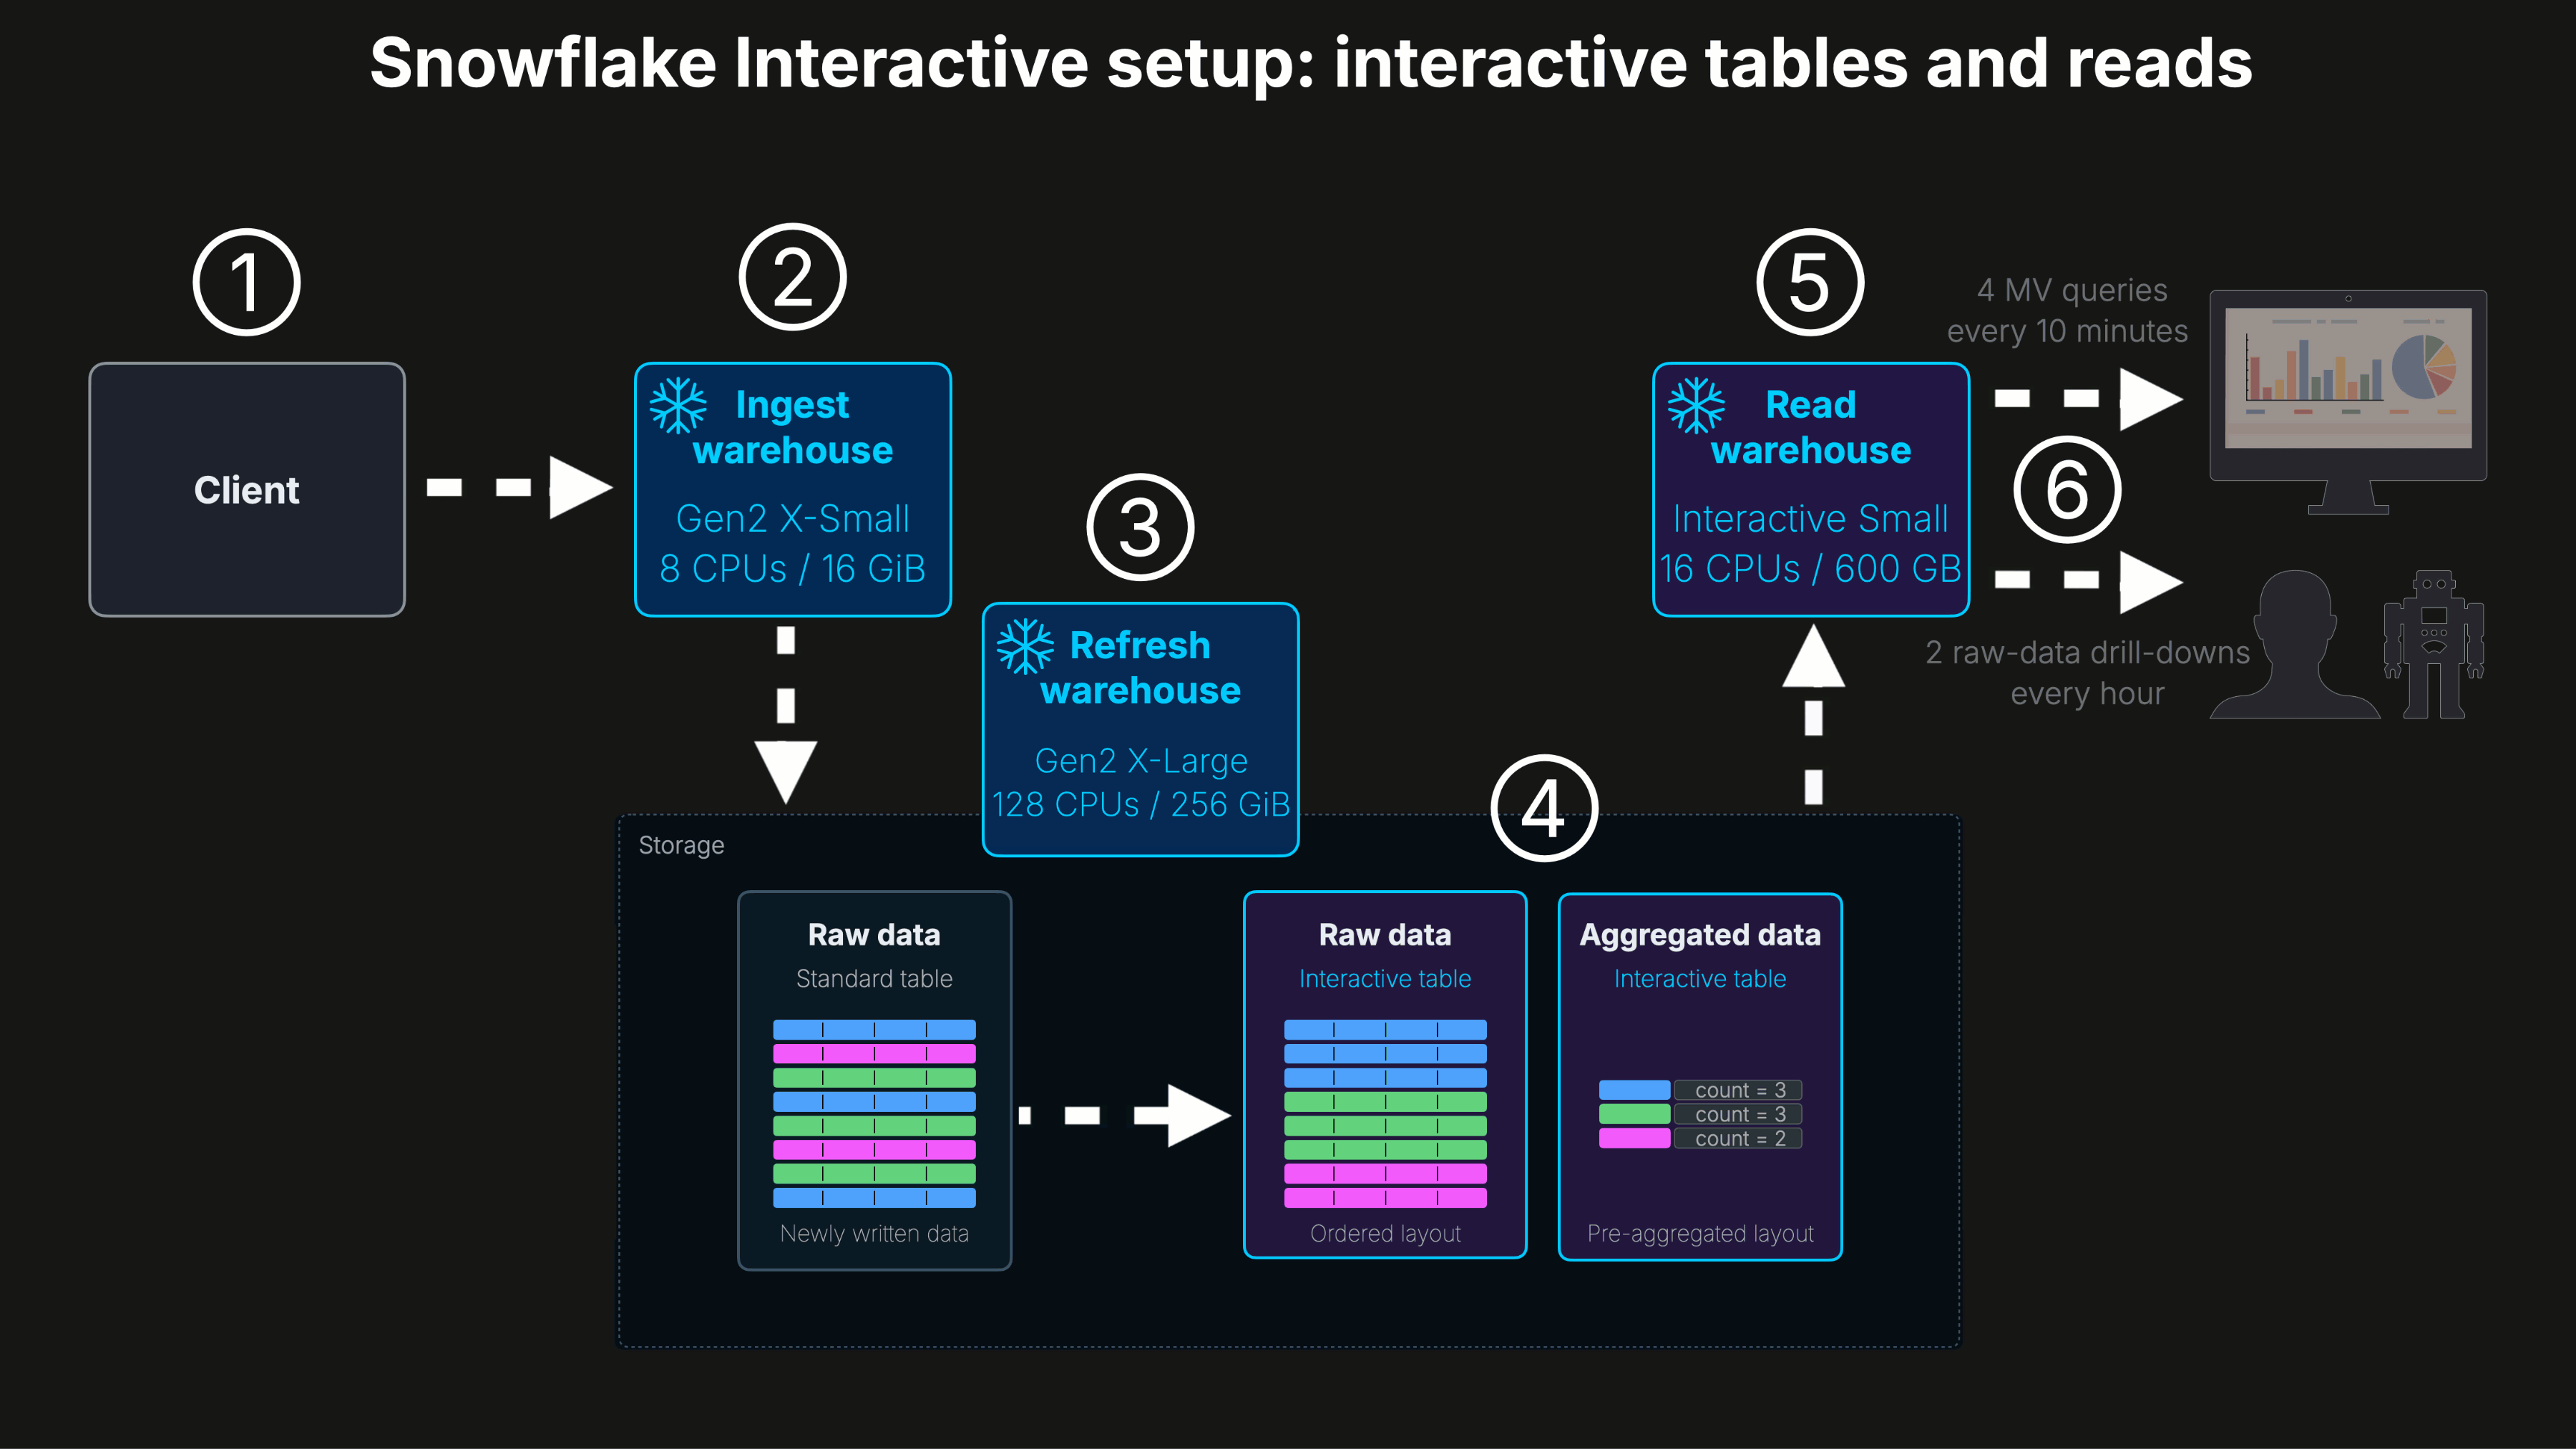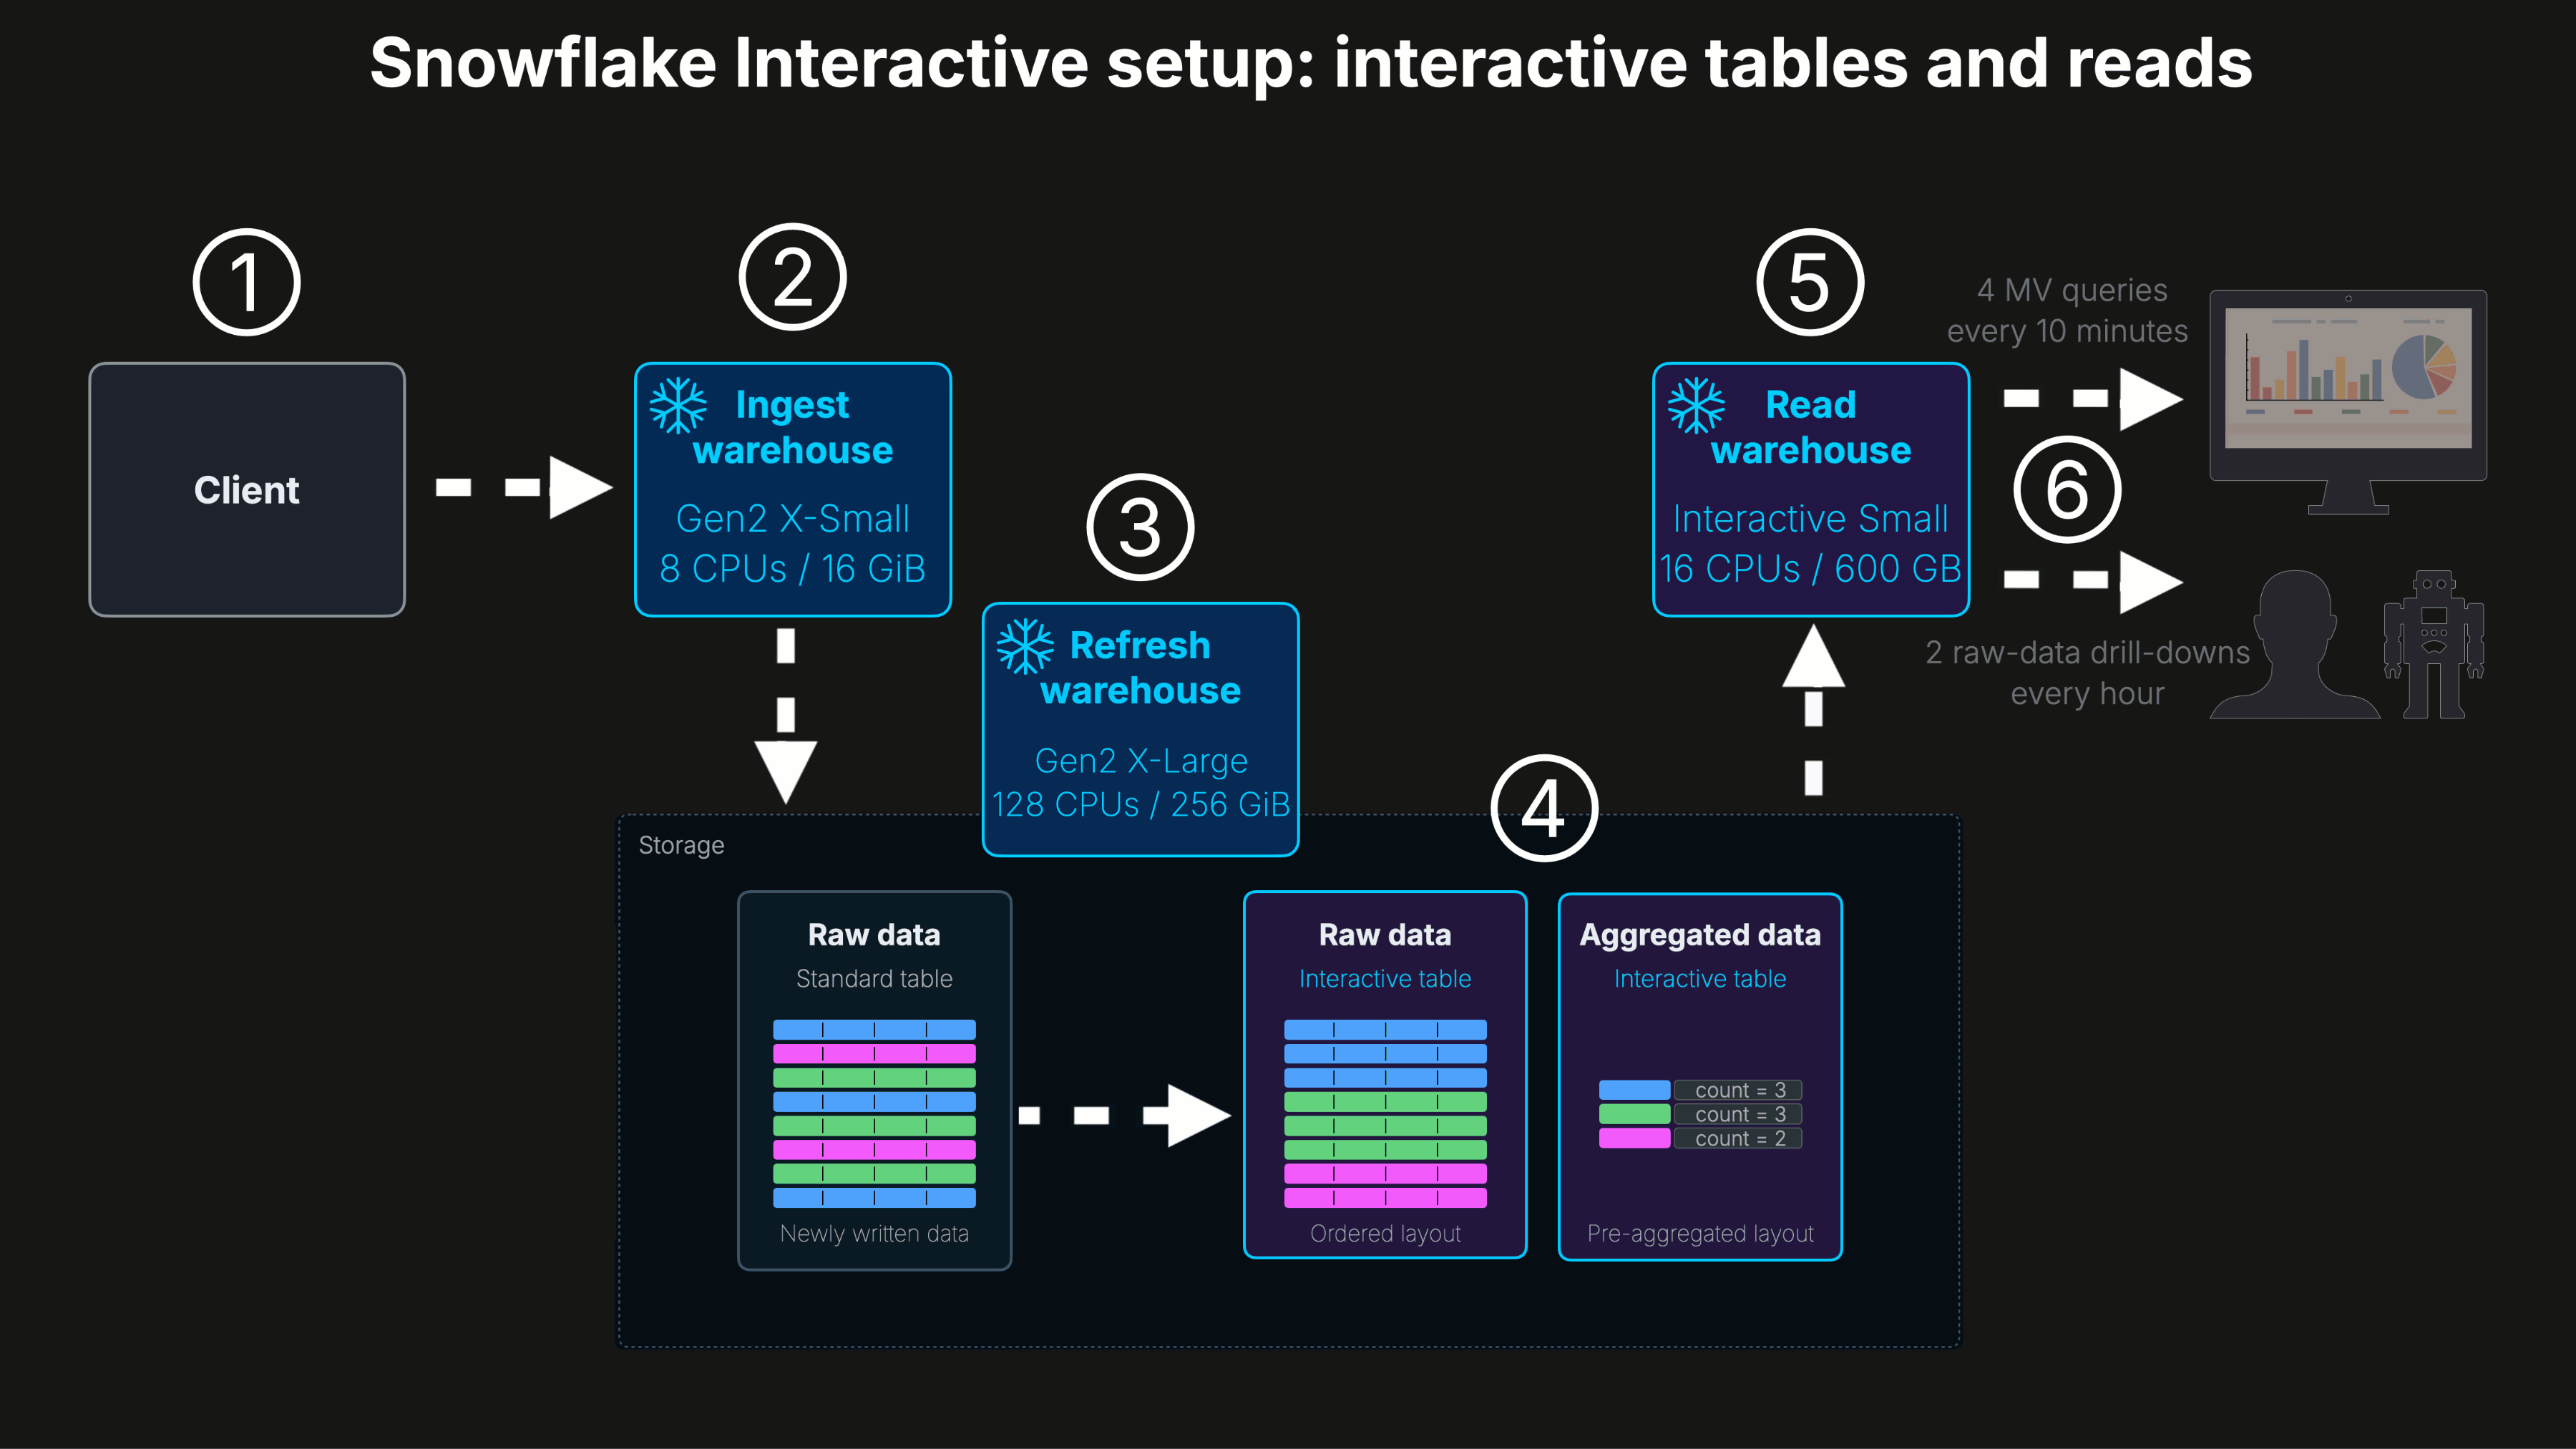
### **① クライアントセットアップ** {#client_setup_3}
[クライアント](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/snowflake/ingest.py)は、ClickHouseセットアップおよび最初のSnowflakeセットアップと同じです。
Parquetの行グループをバイナリ形式で直接読み取り、約100万行のバッチに結合し、`COPY INTO`を使用してデータをSnowflakeにロードします。クライアントはデコード、解凍、エンコード、圧縮を一切行いません。
### **② インジェストウェアハウス** {#ingest_warehouse_2}
前回と同様、インジェストは、固定された100万行/秒のインジェストレートを維持できる**最小のSnowflakeウェアハウス**を使用します。
8 CPUのGen2 X-Smallウェアハウスを使用します。
### **③ 生データのリフレッシュ** {#raw_data_refresh}
受信データはまず標準的なSnowflakeテーブルにランディングします。生のInteractive Tableは、そのソーステーブルからユーザーが管理するウェアハウスによって維持され、設定されたターゲットラグを満たすために必要に応じてリフレッシュがトリガーされます。これは標準的なInteractive Tablesのパターンに対応します。
> 毎時のドリルダウンワークロードを提供する生のInteractive Tableには、10分のターゲットラグを使用します。
*(Snowflake管理のインジェストパスを通じてInteractive Tablesに直接インジェストすることも可能ですが、ここで測定される事前集計パスをカバーしないため、[別途](/blog/real-time-analytics-cost-performance-snowflake-vs-clickhouse#outlook_more_paths_and_heavier_workloads)扱います。)*
コードとドキュメント: [標準Snowflakeテーブル](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/snowflake/create.sql#L44)、[生Interactive Table](https://github.com/ClickHouse/CostBench/blob/6fb94fd628b100db69bc2bf9f8d6f149eec54601/full-path-realtime/quotes/snowflake/ops/setup_interactive.sh#L59)、[ターゲットラグリフレッシュ動作](https://docs.snowflake.com/en/user-guide/interactive#specifying-auto-refresh-for-an-interactive-table)、[insert専用の制限](https://docs.snowflake.com/en/user-guide/snowpipe-streaming/snowpipe-streaming-table-support#insert-only-operations)。
### **④ 事前集計データのリフレッシュ** {#preaggregated_data_refresh}
事前集計データもInteractive Tableに格納されます。
ここでは、リフレッシュウェアハウスが前回のリフレッシュ以降の新しい行を定期的に転送し、集計し、その結果を事前集計されたInteractive Tableにマージします。
> 1分のターゲットラグを使用します。これは利用可能な最小のターゲットラグです。
> このテーブルはダッシュボードワークロードを提供するため、Snowflakeが許可する最も新鮮な事前集計パスを設定します。
これにより、インジェストパス上で更新されるClickHouseのインクリメンタルマテリアライズドビューと比較し、Snowflakeでその鮮度モデルにできるだけ近づけるためのコストを測定できます。SnowflakeはInteractive Materialized Viewsも提供しています。そのパスは[別途](/blog/real-time-analytics-cost-performance-snowflake-vs-clickhouse#outlook_more_paths_and_heavier_workloads)テストします。
リフレッシュにはGen2 X-Largeウェアハウスを使用します。これは、Small、Medium、Largeウェアハウスでは1分のターゲットラグ内で事前集計リフレッシュを確実に維持できなかったためです。
コードとドキュメント: [事前集計Interactive Table](https://github.com/ClickHouse/CostBench/blob/6fb94fd628b100db69bc2bf9f8d6f149eec54601/full-path-realtime/quotes/snowflake/ops/setup_interactive.sh#L50)、[集計クエリ](https://github.com/ClickHouse/CostBench/blob/6fb94fd628b100db69bc2bf9f8d6f149eec54601/full-path-realtime/quotes/snowflake/ops/setup_interactive.sh#L54)、[ターゲットラグ動作](https://docs.snowflake.com/en/user-guide/interactive#specifying-auto-refresh-for-an-interactive-table)、[Interactive Materialized Views](https://docs.snowflake.com/en/user-guide/interactive#materialized-view-support-for-interactive-tables)、[リフレッシュサイズの比較](/blog/real-time-analytics-cost-performance-snowflake-vs-clickhouse#freshness_scheduled_refresh_has_to_keep_up)。
### **⑤ Interactive読み取りウェアハウス** {#interactive_read_warehouse}
読み取りには、16 CPUのSmall [Interactive Warehouse](https://docs.snowflake.com/en/user-guide/interactive)を使用します。
> これはClickHouseと最初のSnowflakeセットアップで使用される読み取り側のCPU数と一致します。
標準ウェアハウスとは異なり、Interactive Warehouseには[大容量のキャッシュ](https://docs.snowflake.com/en/user-guide/interactive#choosing-a-size-for-an-interactive-warehouse)も付属します。Small Interactive Warehouseの場合、そのキャッシュは約600 GBで、Interactive Tablesのワーキングセットをメモリ内に保持できます。
Interactive Warehousesには1時間の最小課金時間があり、自動サスペンドの最小設定は24時間である点に注意してください。このベンチマークでは、その課金モデルはワークロードに適合しています。継続的に実行されるリアルタイム分析サービス(進行中のインジェスト、リフレッシュ、クエリを伴う)を測定しているためです。
### **⑥ 連続クエリワークロード** {#continuous_query_workload_3}
前と同じ連続クエリスケジュールを実行します。
10分ごとに、[事前集計データに対する4つのクエリ](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/snowflake/queries_mv_it.sql)を実行し、ダッシュボードのリフレッシュをシミュレートします。
1時間ごとに、生のInteractive Tableに対して[2つの生データドリルダウンクエリ](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/snowflake/queries_raw_it.sql)を実行します。
## 結果: ClickHouse対Snowflake標準テーブル {#results_clickhouse_vs_snowflake_standard_tables}
まず、ClickHouseと、ほとんどのお客様が今日利用可能なSnowflakeの[セットアップ](/blog/real-time-analytics-cost-performance-snowflake-vs-clickhouse#snowflake_setup_1_standard_tables_and_materialized_views)、すなわち標準テーブル、標準マテリアライズドビュー、サーバーレスクラスタリング、サーバーレスMVリフレッシュ、Gen2ウェアハウスを比較します。
### 性能: 連続インジェストにおけるレイテンシと鮮度 {#performance_latency_and_freshness_under_continuous_ingest}
> これらの測定では、両システムは同じ読み取り側コンピュート(16 AWS Graviton3コア)を使用します。
クエリスケジュールも同一です。
#### ダッシュボードクエリ: 事前集計は鮮度を保っている場合にのみ役立つ {#dashboard_queries_preaggregations_only_help_if_they_stay_fresh}
このチャートは、10分ごとに事前集計データに対して実行される4つのダッシュボードクエリを示しています。x軸は生テーブルにインジェストされた行数で、実行開始から約28時間後の1000億行までを示しています。y軸はクエリレイテンシです。
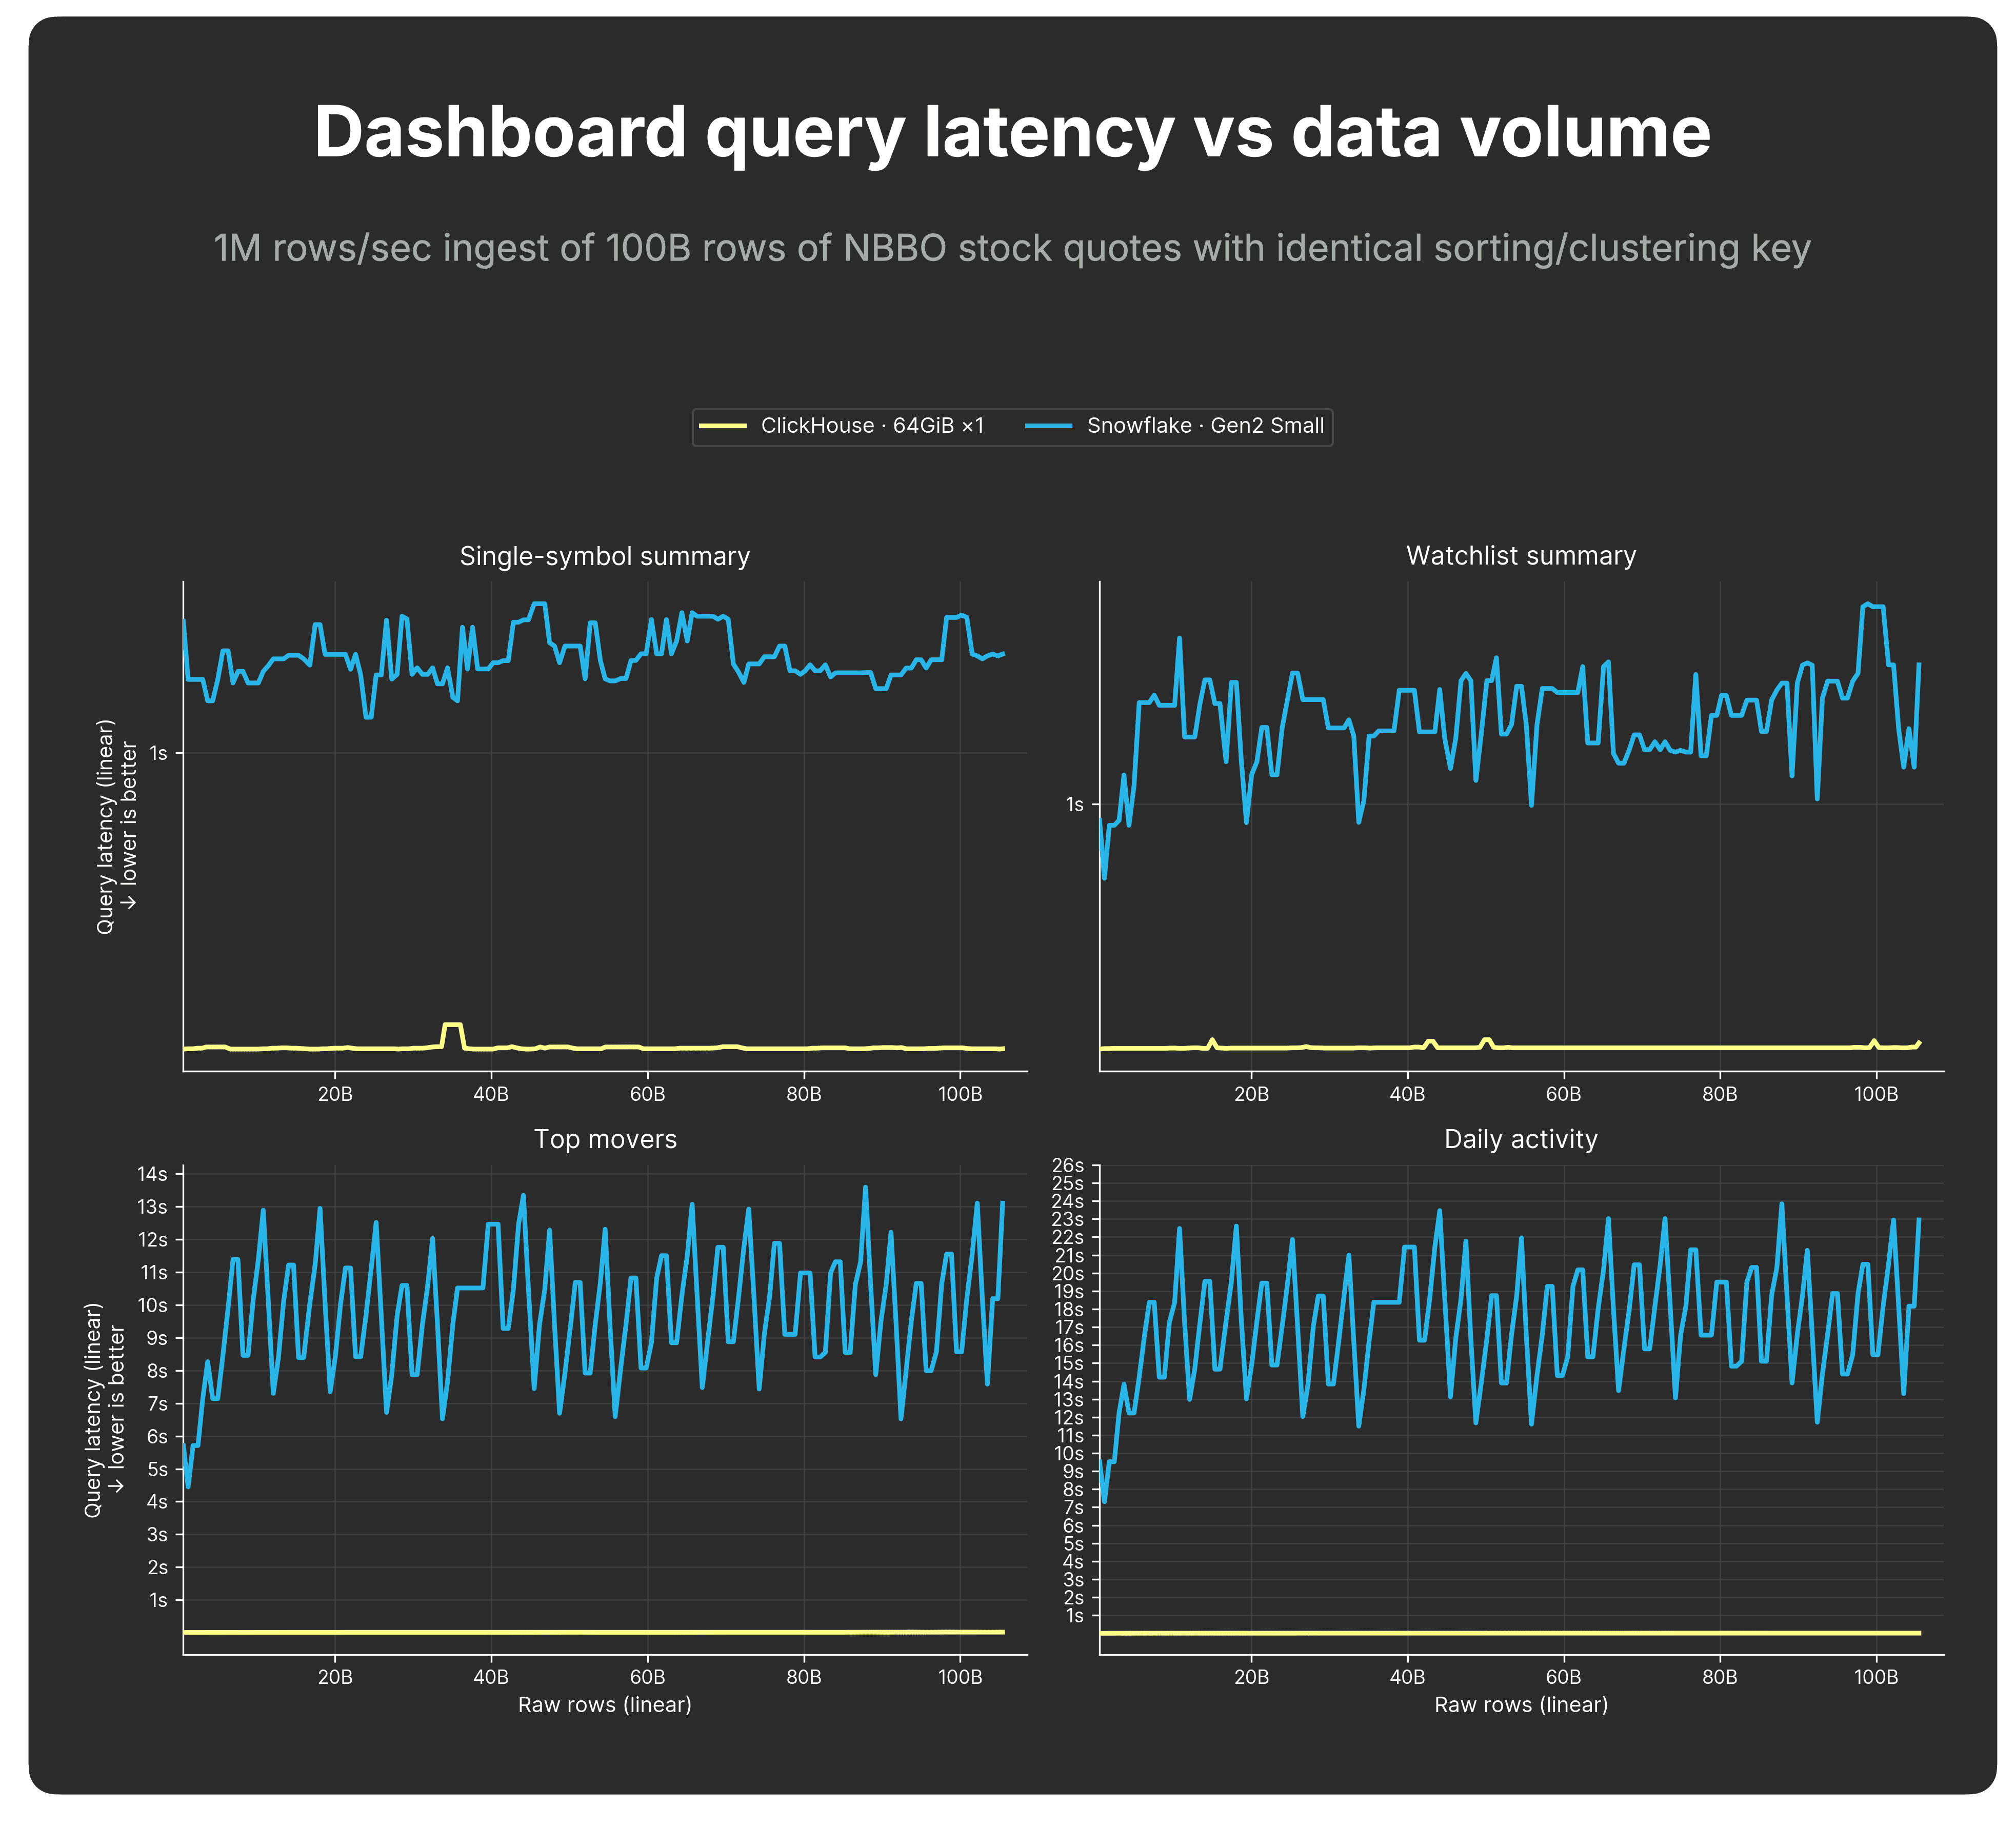
*クエリごとの実行の詳細は、CostBenchリポジトリで入手可能です: [ClickHouse](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/clickhouse-cloud/results/mv/dashboard_20260609T154019Z.jsonl)、[Snowflake](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/snowflake/results/t0/dashboard_20260609T154304Z.jsonl)。*
ClickHouseは生テーブルが成長するにつれてほぼ完全にフラットな状態を保ち、ダッシュボードクエリは1桁ミリ秒の範囲にとどまります。これはClickHouseがインジェストパス上で事前集計テーブルを更新するため、常に新鮮でクエリ可能な状態を保つからです。
Snowflakeの標準的なマテリアライズドビューセットアップは、まったく異なる動作をします。クエリレイテンシははるかに高く、大きく変動します。単純なダッシュボードクエリは数秒程度にとどまる一方、重いダッシュボードクエリは高い1桁秒から数十秒の範囲に跳ね上がります。
その理由は鮮度です。Snowflakeマテリアライズドビューは、マテリアライズドビュー自体が遅れている場合でも、最新のインジェストされたデータに対して結果を返します。その場合、Snowflakeはクエリ時にマテリアライズドビューと生テーブルから不足している行を組み合わせる必要があります。ダッシュボードワークロードでは、これはリフレッシュが単に遅くなるだけでなく、予測不可能になることを意味します。
#### 鮮度ラグ: 遅いダッシュボードの背後にある隠れたコスト {#freshness_lag_the_hidden_cost_behind_slow_dashboards}
次のチャートは、根底にある鮮度ラグを直接示しています。
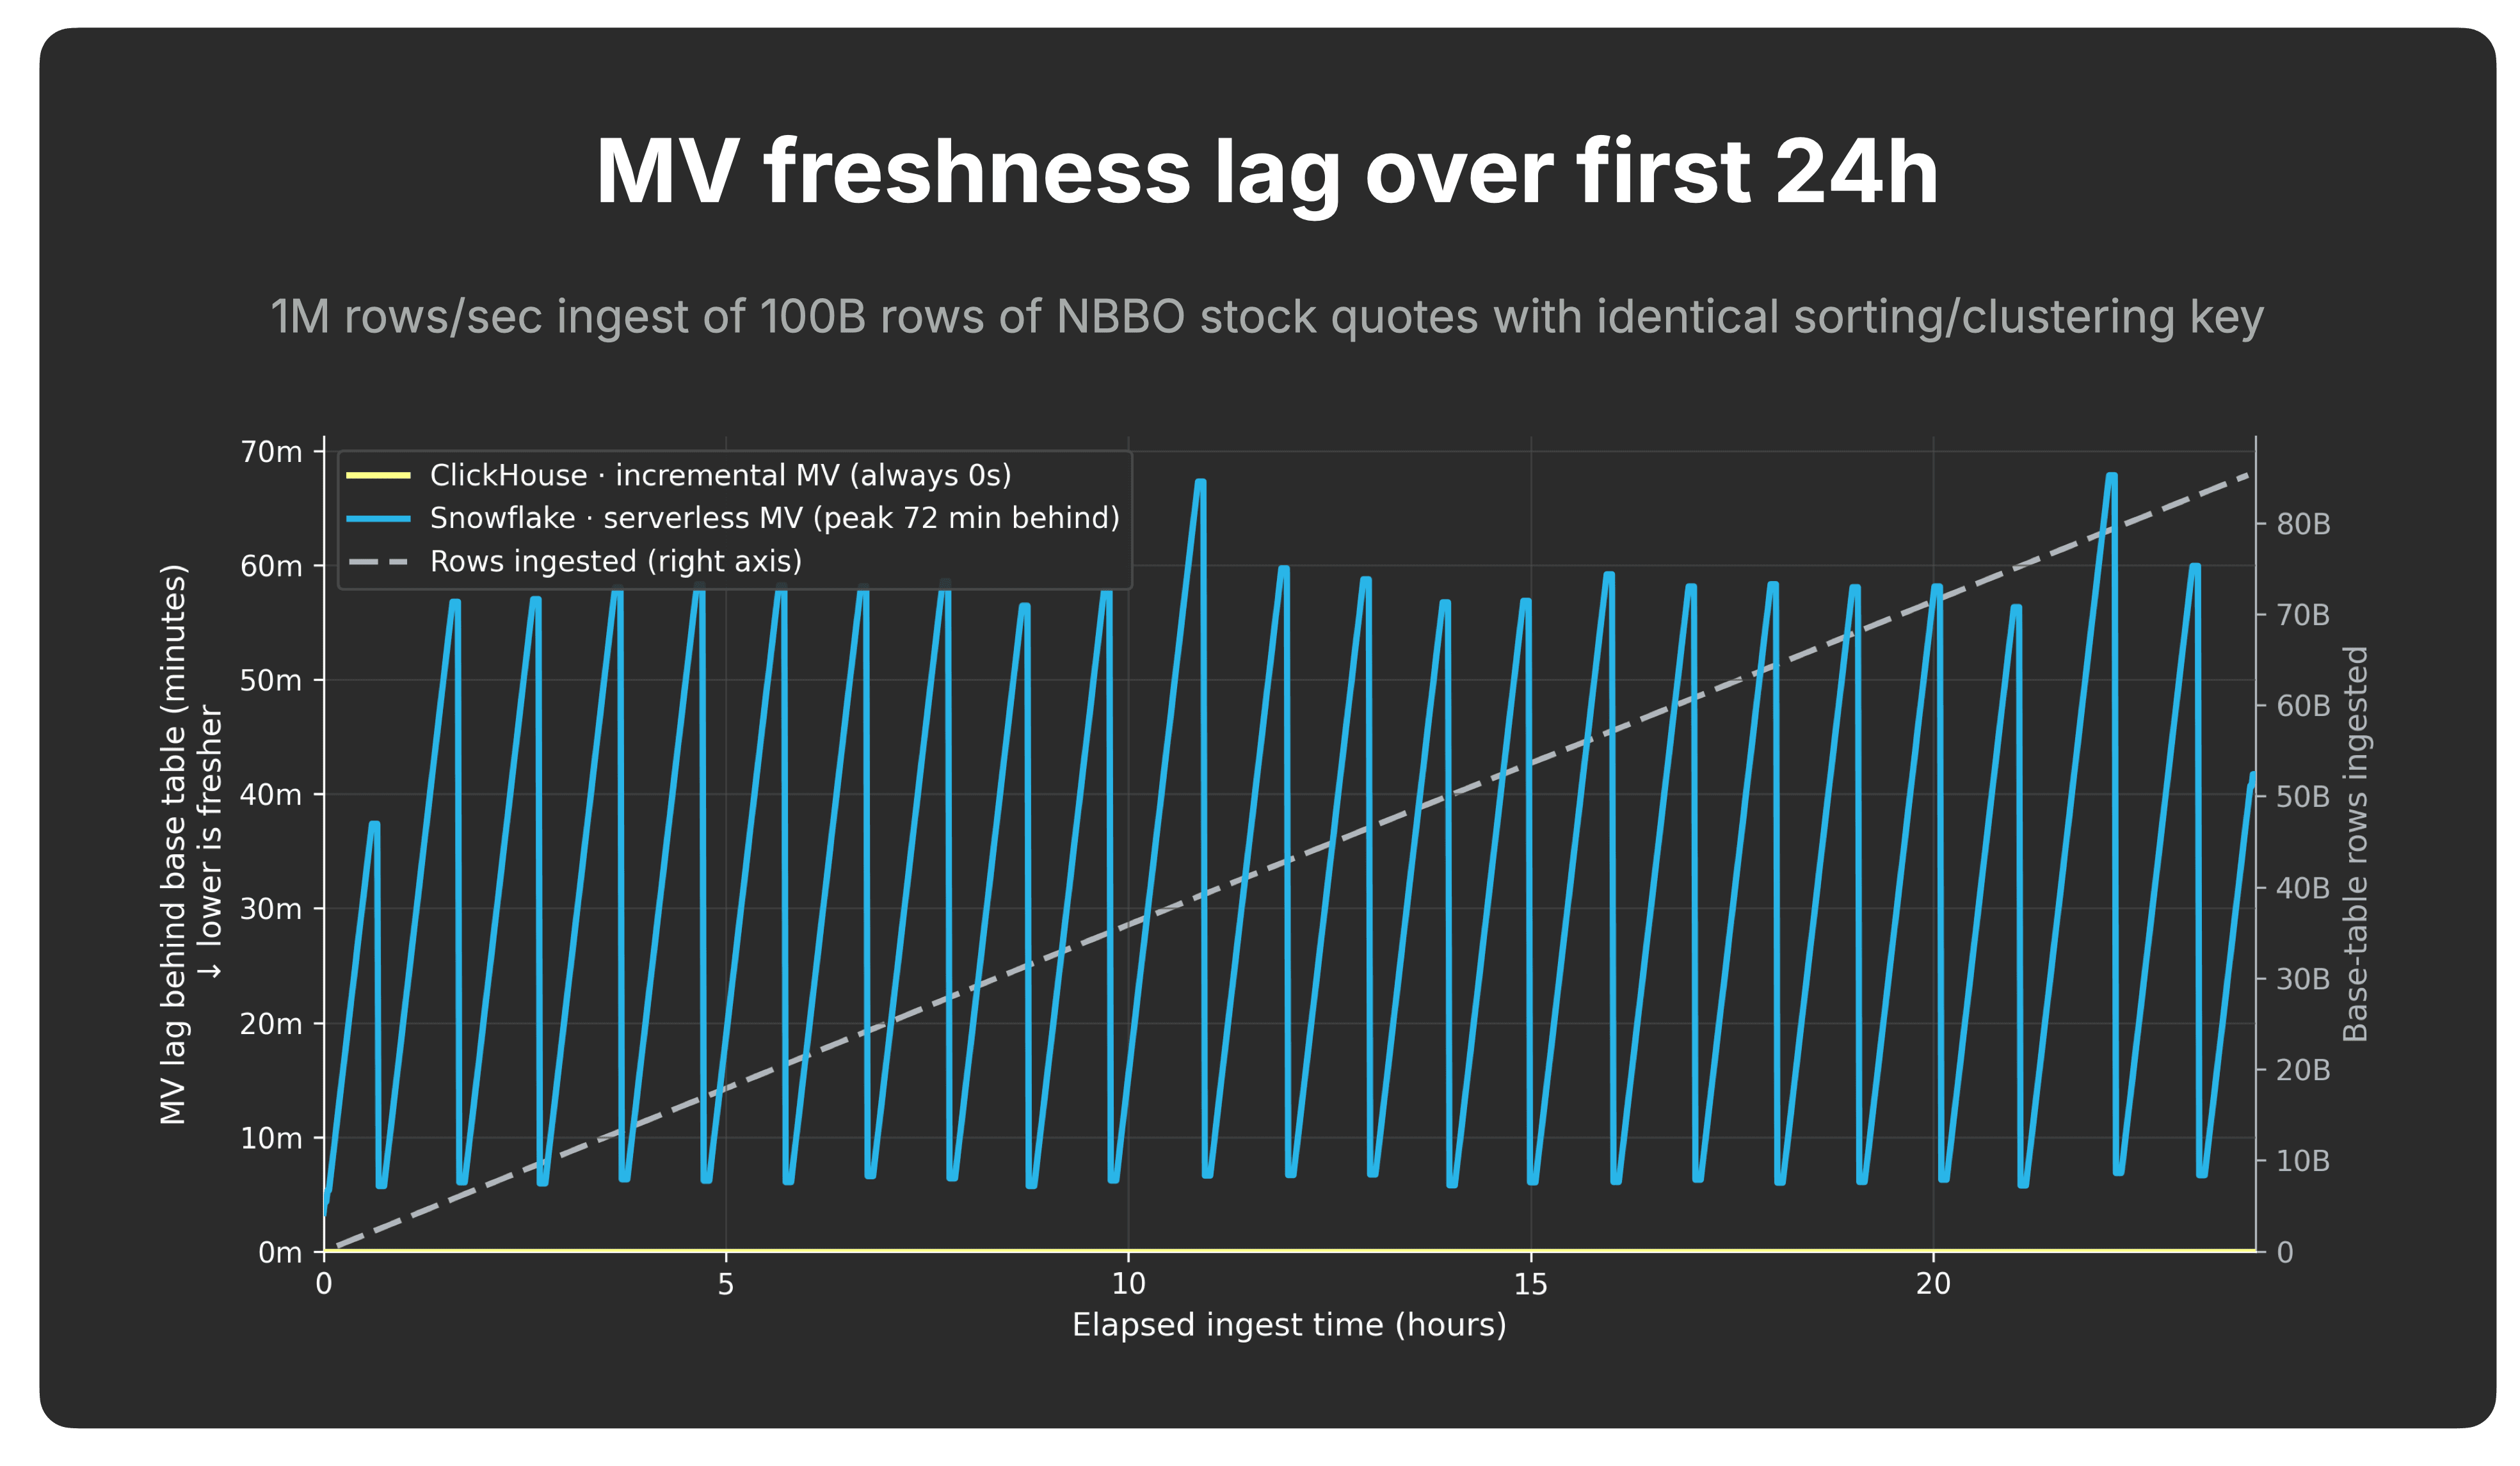
*このラグは、Snowflakeのマテリアライズドビューメタデータを`SHOW MATERIALIZED VIEWS`で1分ごとに[ポーリング](https://github.com/ClickHouse/CostBench/blob/6fb94fd628b100db69bc2bf9f8d6f149eec54601/full-path-realtime/quotes/snowflake/ops/mv_latency.sh#L39)することで測定しました。詳細な鮮度サンプルは[こちら](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/snowflake/results/t0/mv_latency_20260609T154304Z.jsonl)で入手可能です。behind_by列を参照してください。*
ClickHouseは、マテリアライズドビューがインジェストパス上で同期的に更新されるため、最新の状態を維持します。
Snowflakeのマテリアライズドビューは、鮮度SLAがなく、実行タイミングや使用するコンピュート量に対するユーザーコントロールもないサーバーレスバックグラウンドサービスによってリフレッシュされます。この実行では、Snowflakeのマテリアライズドビューは継続的に遅れており、ラグは繰り返し約60分から72分に達しました。
#### ドリルダウンクエリ: クラスタリングは役立つが、レイテンシをフラットに保つわけではない {#drilldown_queries_clustering_helps_but_does_not_keep_latency_flat}
次のチャートは、1時間ごとに生データに対して実行される2つのドリルダウンクエリを示しています。x軸は生テーブルにインジェストされた行数で、実行開始から約28時間後の1000億行までを示しています。y軸はクエリレイテンシです。
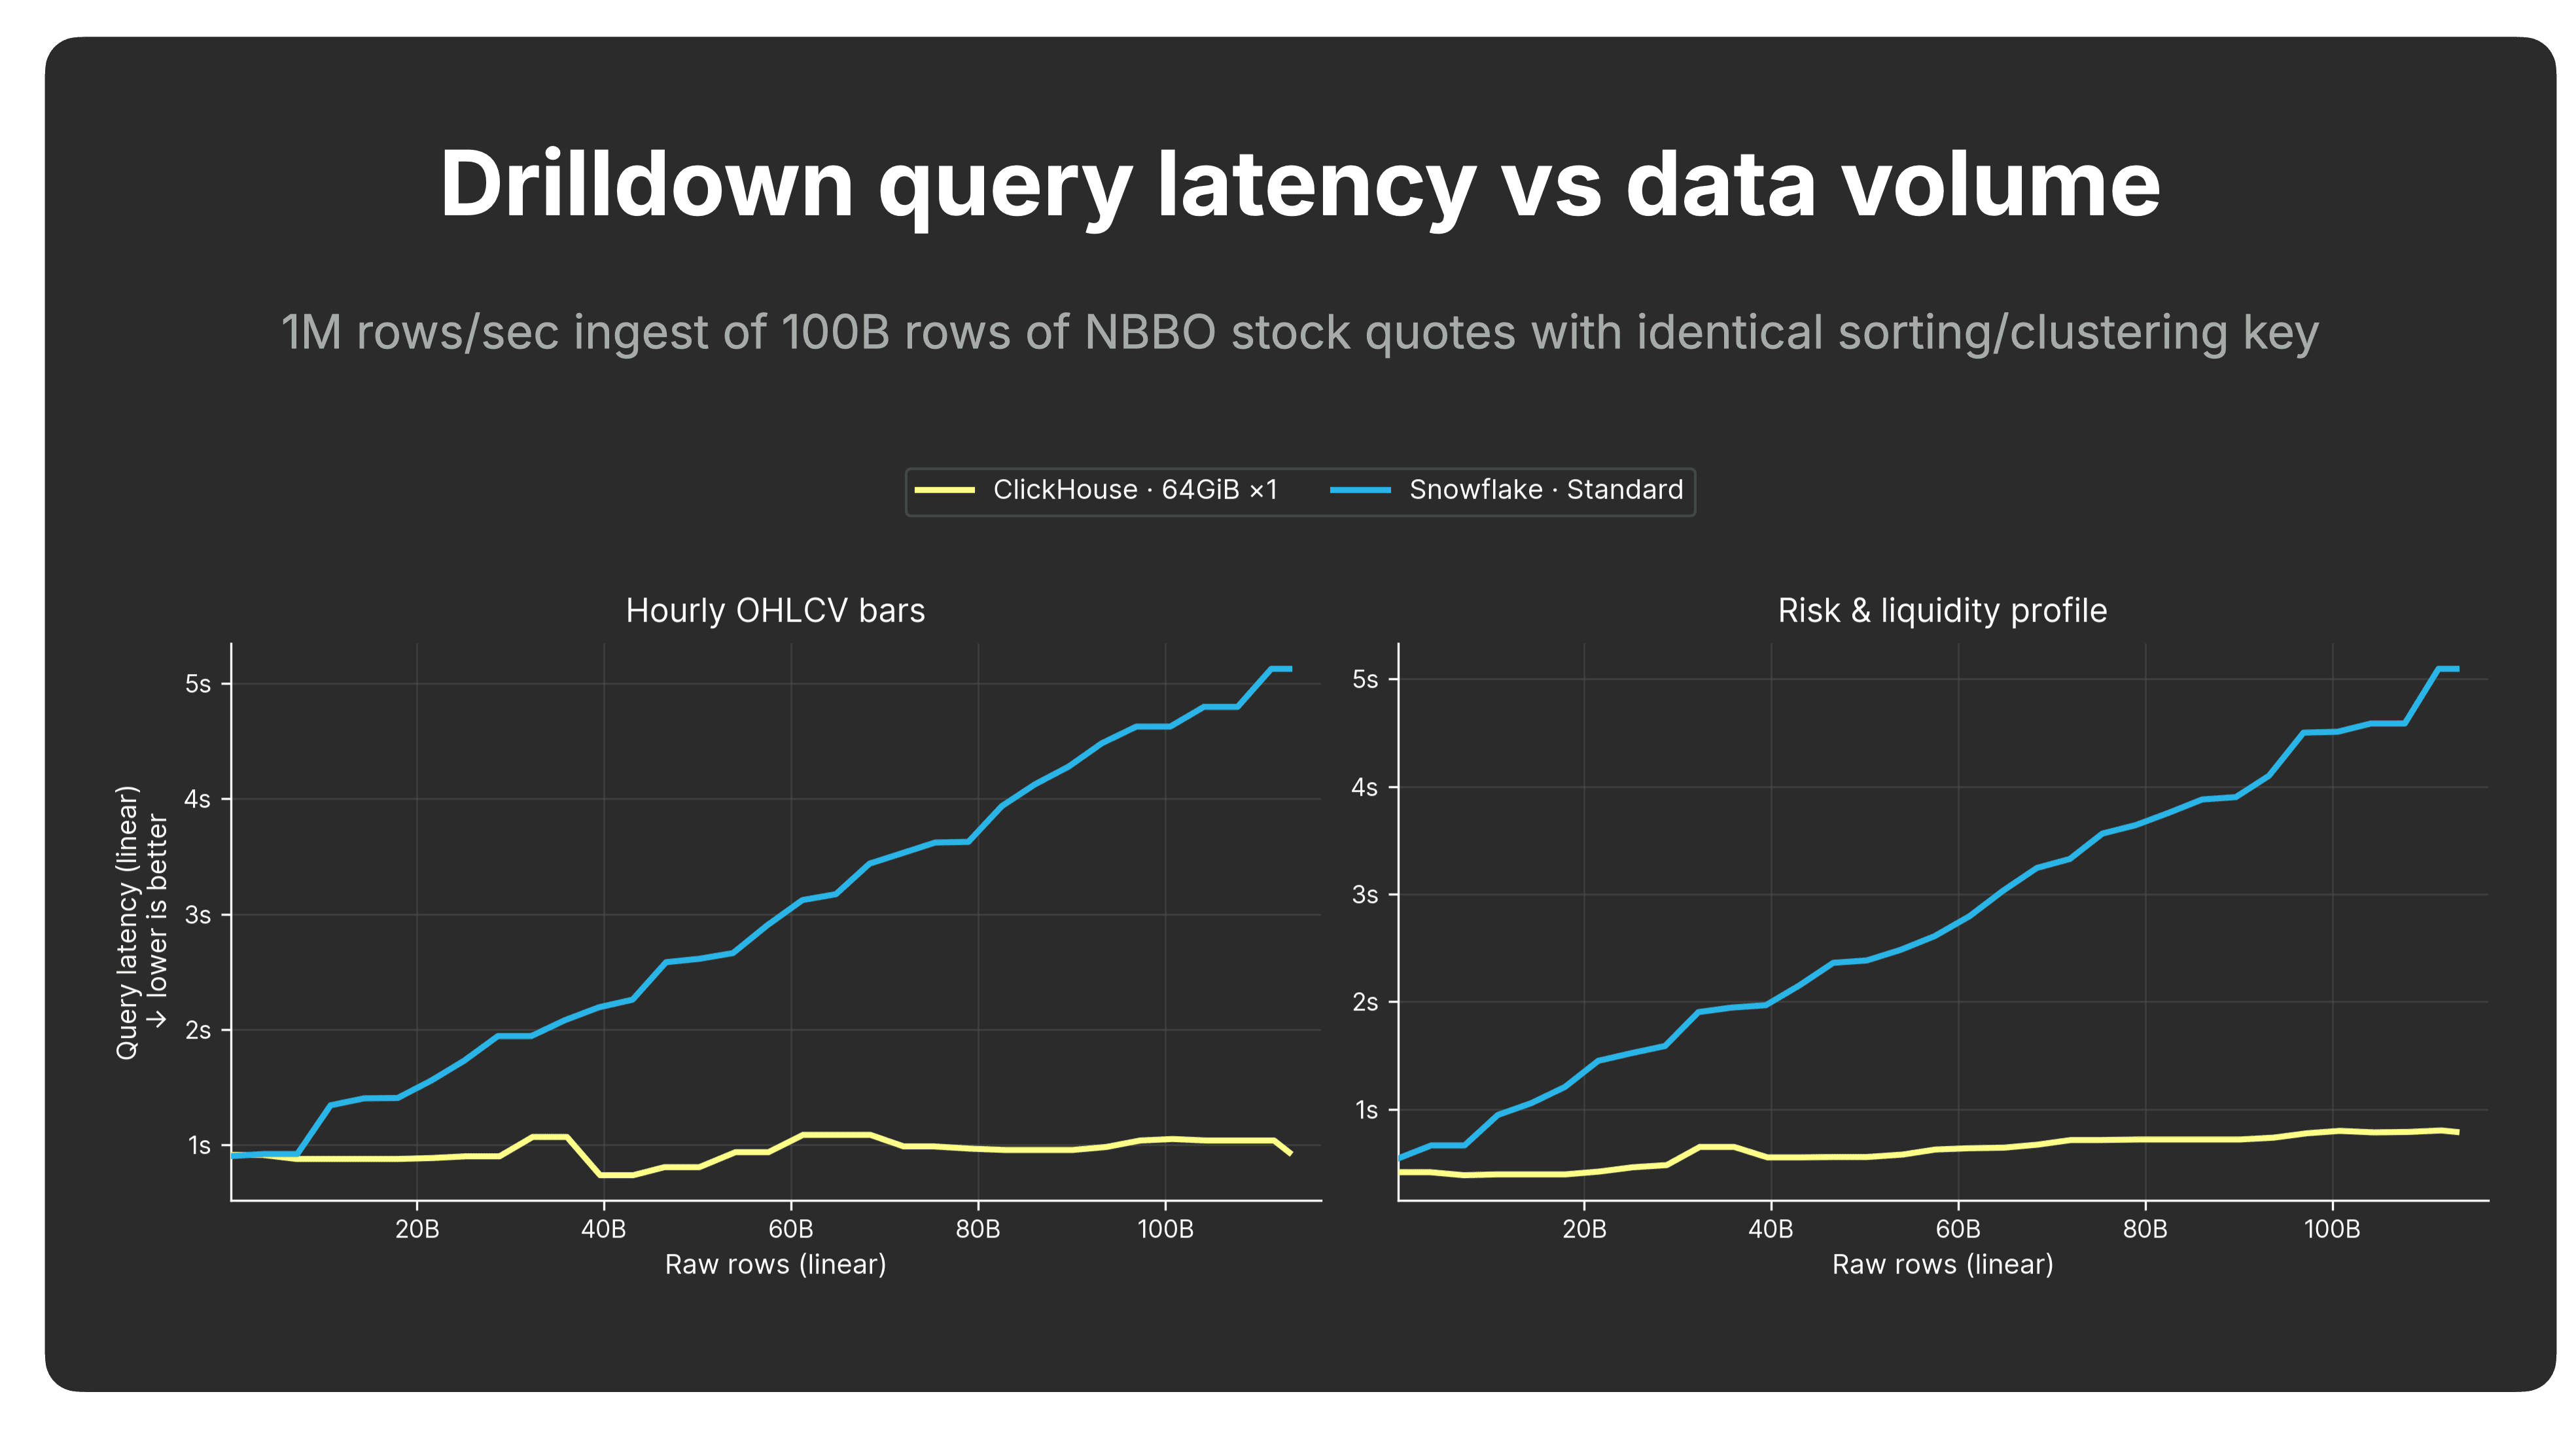
*クエリごとの実行の詳細は、CostBenchリポジトリで入手可能です: [ClickHouse](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/clickhouse-cloud/results/raw/drilldown_20260617T162929Z.jsonl)、[Snowflake](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/snowflake/results/t0/drilldown_20260617T155914Z.jsonl)。*
これらのクエリは、生テーブルの順序/クラスタリングキーに一致するフィルタを使用します。つまり、両方のシステムは同じ物理レイアウトの利点を得ます。ClickHouseはキーでソートされ、Snowflakeは同じキーでクラスタリングされます。
それでも、パターンは私たちの[最初の読み取り側ベンチマーク](https://clickhouse.com/blog/cloud-data-warehouses-cost-performance-comparison)と同じです。データセットが成長するにつれて、システムは分岐します。ClickHouseはほぼフラットな状態を保ち、データサイズにあまり影響されません。Snowflakeは徐々に遅くなり、実行の終わりまでに数秒に達します。
### コスト: インジェスト、メンテナンス、読み取り {#cost_ingest_maintenance_and_reads}
コストについては、AWS us-eastのEnterprise価格を使用します。これにより、SnowflakeはEnterprise Editionを必要とするマテリアライズドビューへのアクセスが可能になります。ClickHouseのマテリアライズドビューはオープンソース版でも利用可能です。
#### 新鮮データパスコスト: データをクエリ可能な状態に保つ {#freshdata_path_cost_keeping_data_queryready}
次のチャートは、実行の最初の28時間における新鮮データパスの総コストを示しています。100万行/秒の連続レートで1000億行の新鮮な行をインジェストしながら、生データをソート/クラスタリング状態に保ち、事前集計データを維持します。
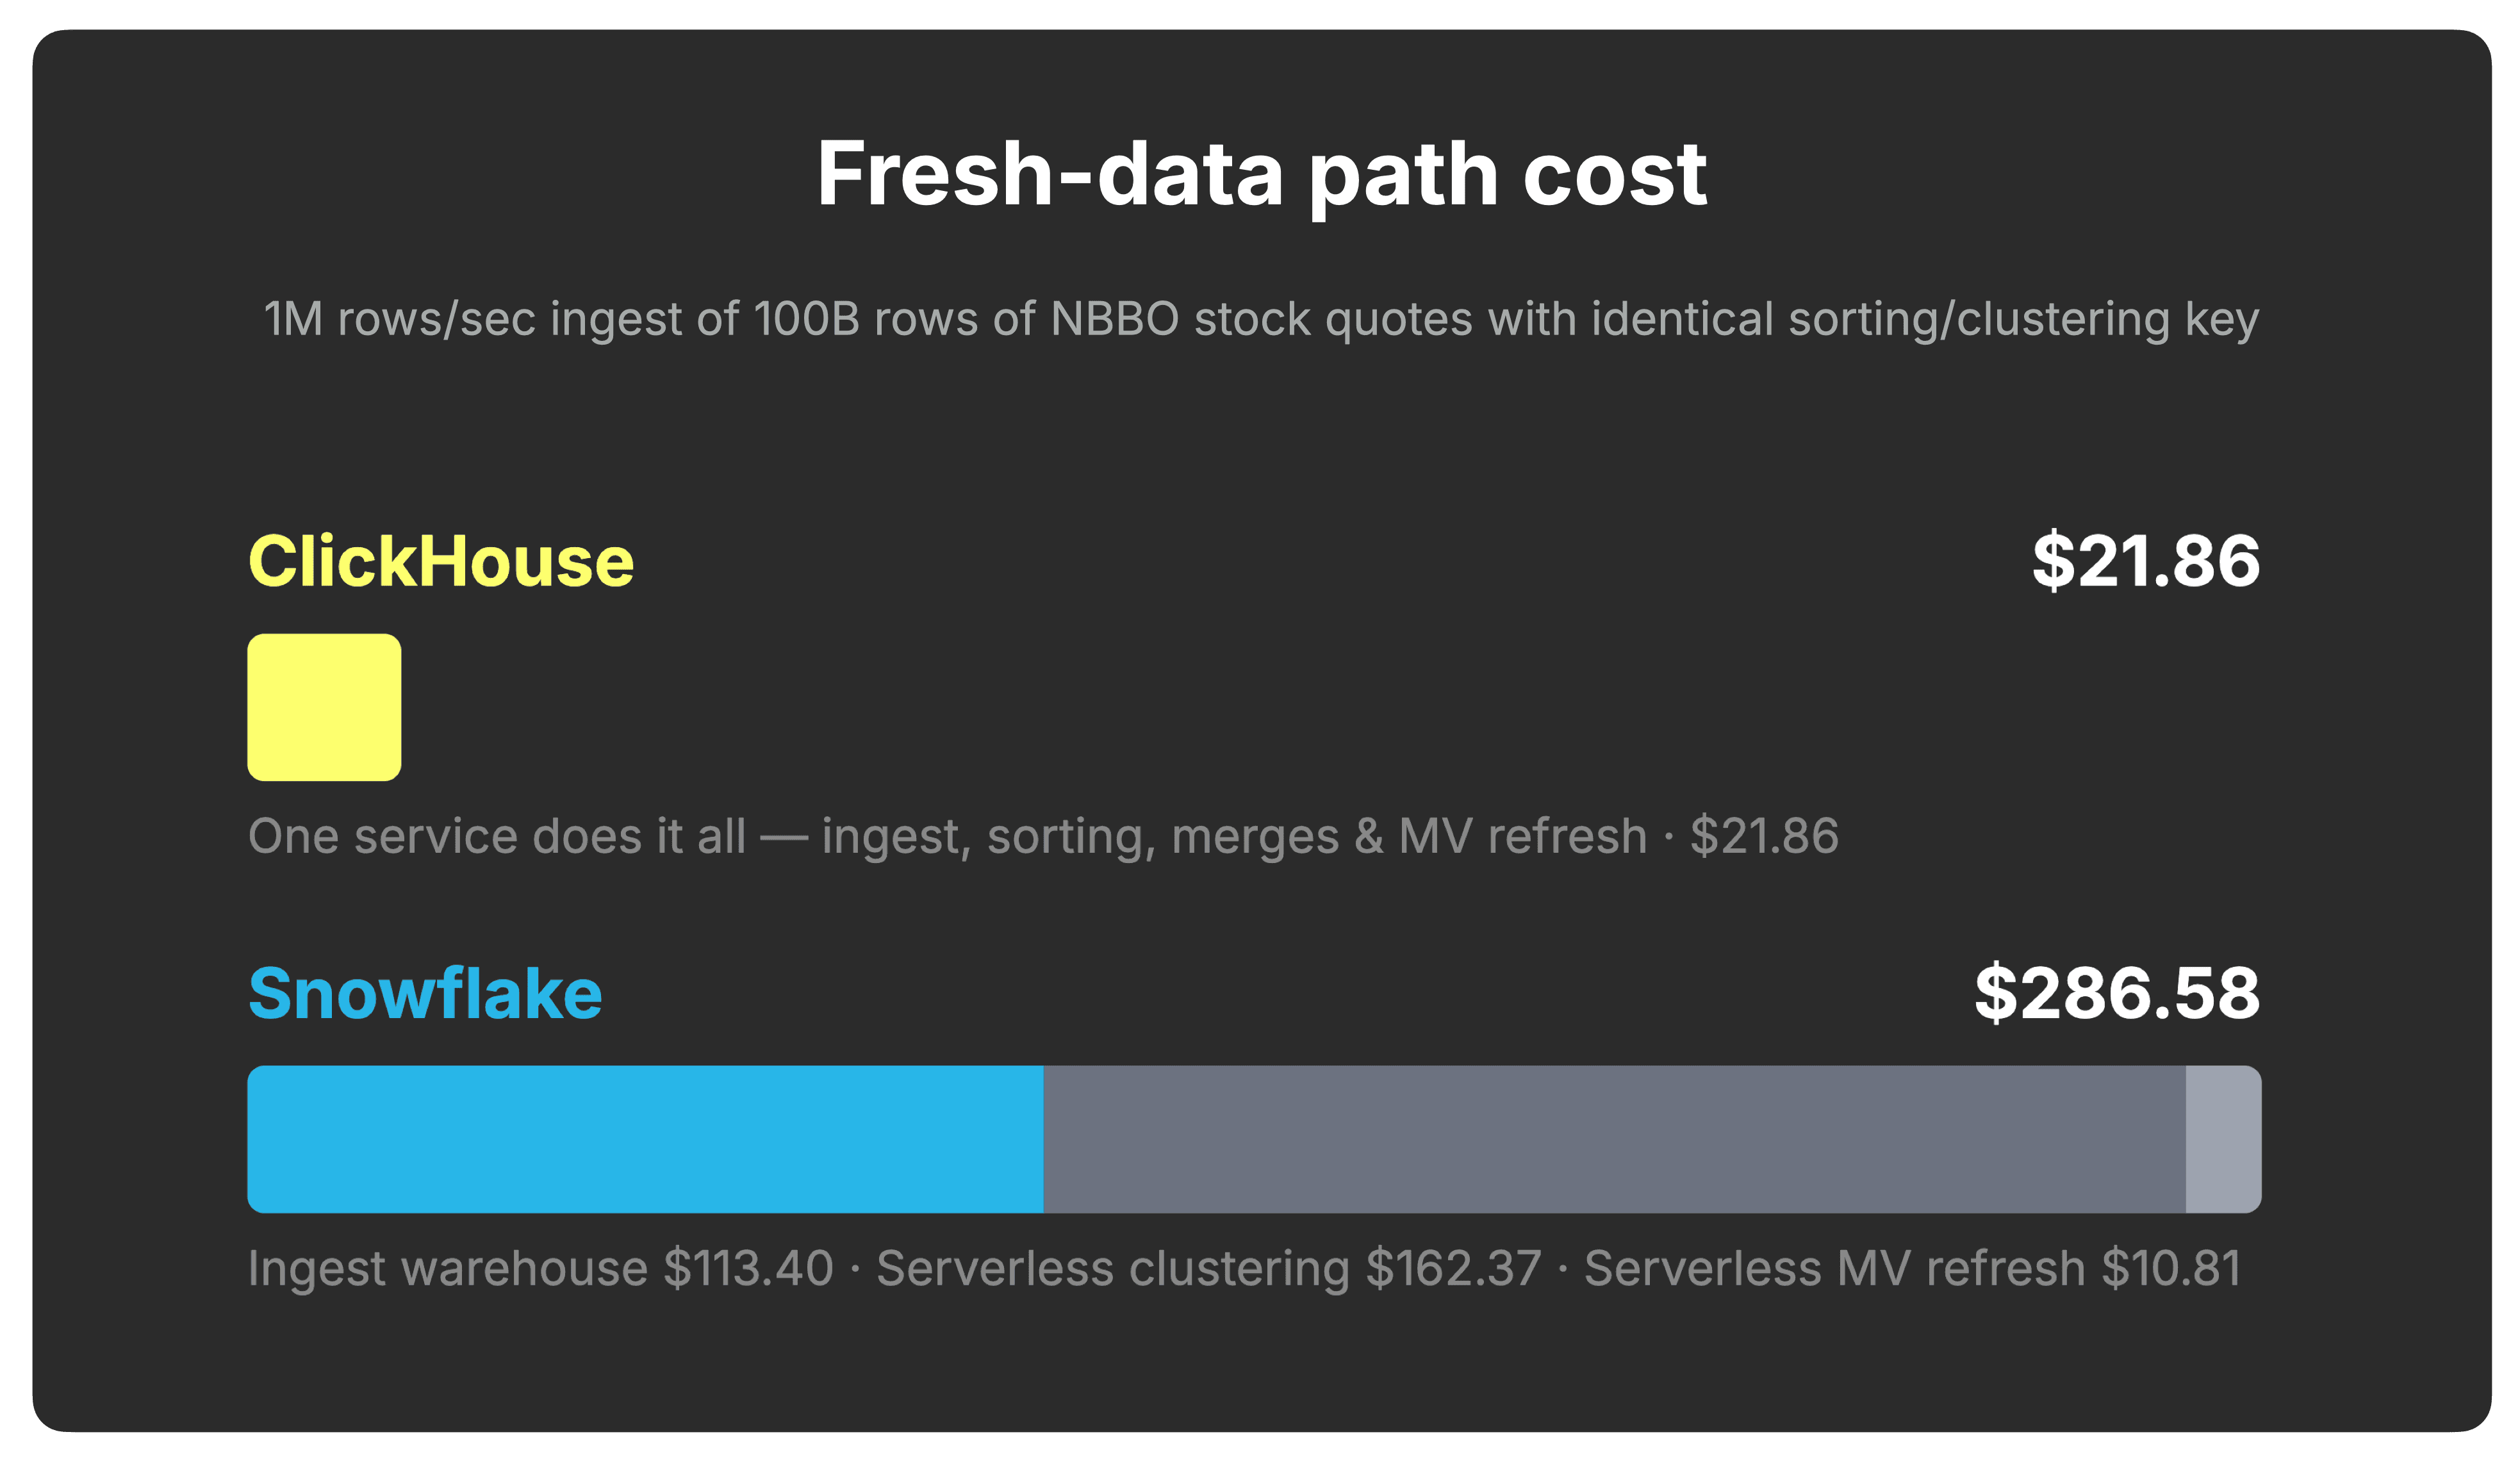
ClickHouseの場合、インジェストサービスはノードあたり2 CPUと8 GiB RAMを持つ2ノードを使用します。[ClickHouse Cloud価格](https://clickhouse.com/blog/how-cloud-data-warehouses-bill-you#clickhouse-cloud)では、これは2コンピュートユニットに対応します。28時間の実行にわたって: 2コンピュートユニット × 28時間 × $0.3903/時間 \= **$21.86。**
Snowflakeの場合、インジェストウェアハウスはGen2 X-Smallウェアハウスです。[1.35クレジット/時間](https://www.snowflake.com/legal-files/CreditConsumptionTable.pdf)と1クレジットあたり$3で、インジェストウェアハウスコストは: 1.35クレジット/時間 × 28時間 × $3/クレジット \= **$113.40。**
Snowflakeの残りの書き込み側コストはサーバーレスサービスから発生します。Snowflakeのシステムテーブルから消費されたクレジットを取得し、同じ1クレジットあたり$3の価格で乗算します。サーバーレスクラスタリング: [54.12クレジット](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/snowflake/results/system_tables/clustering-raw_table-details.md) × $3 \= **$162.37**; サーバーレスマテリアライズドビューリフレッシュ: [3.60クレジット](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/snowflake/results/system_tables/refresh-mv_table-details.md) × $3 \= **$10.8。**
合計すると、Snowflakeの新鮮データパスのコストは**$286.58**です。
クエリコストを含める前に、Snowflakeの標準セットアップは、新鮮データをクエリ可能な状態に保つのに既に**約13倍のコスト**がかかります。
#### クエリコスト: 同じスケジュールを提供する {#query_cost_serving_the_same_schedule}
最後に、読み取り側を測定します。各システムが28時間の実行にわたって同じ連続クエリスケジュールを提供するために必要なランタイムとクエリコストです。
クエリコストについては、最初の[読み取り側ベンチマーク](https://clickhouse.com/blog/cloud-data-warehouses-cost-performance-comparison)方法論と同じ[単純化](https://clickhouse.com/blog/cloud-data-warehouses-cost-performance-comparison#a-note-on-metering-granularity)を使用します。累積クエリランタイム × 読み取り側コンピュート価格、すなわちクエリコンピュートが完璧な秒単位の粒度で課金されているかのように扱います。
実際には、SnowflakeとClickHouse Cloudの両方とも、設定可能なアイドルタイムアウトに達するまで[課金](https://clickhouse.com/blog/how-cloud-data-warehouses-bill-you)を継続します。ただし、この正規化はクエリエンジンの効率を直接比較します。
> 特定量の有料コンピュート時間に対して、システムはどれだけのクエリ作業を完了できるか?
以下のチャートは結果を示しています。
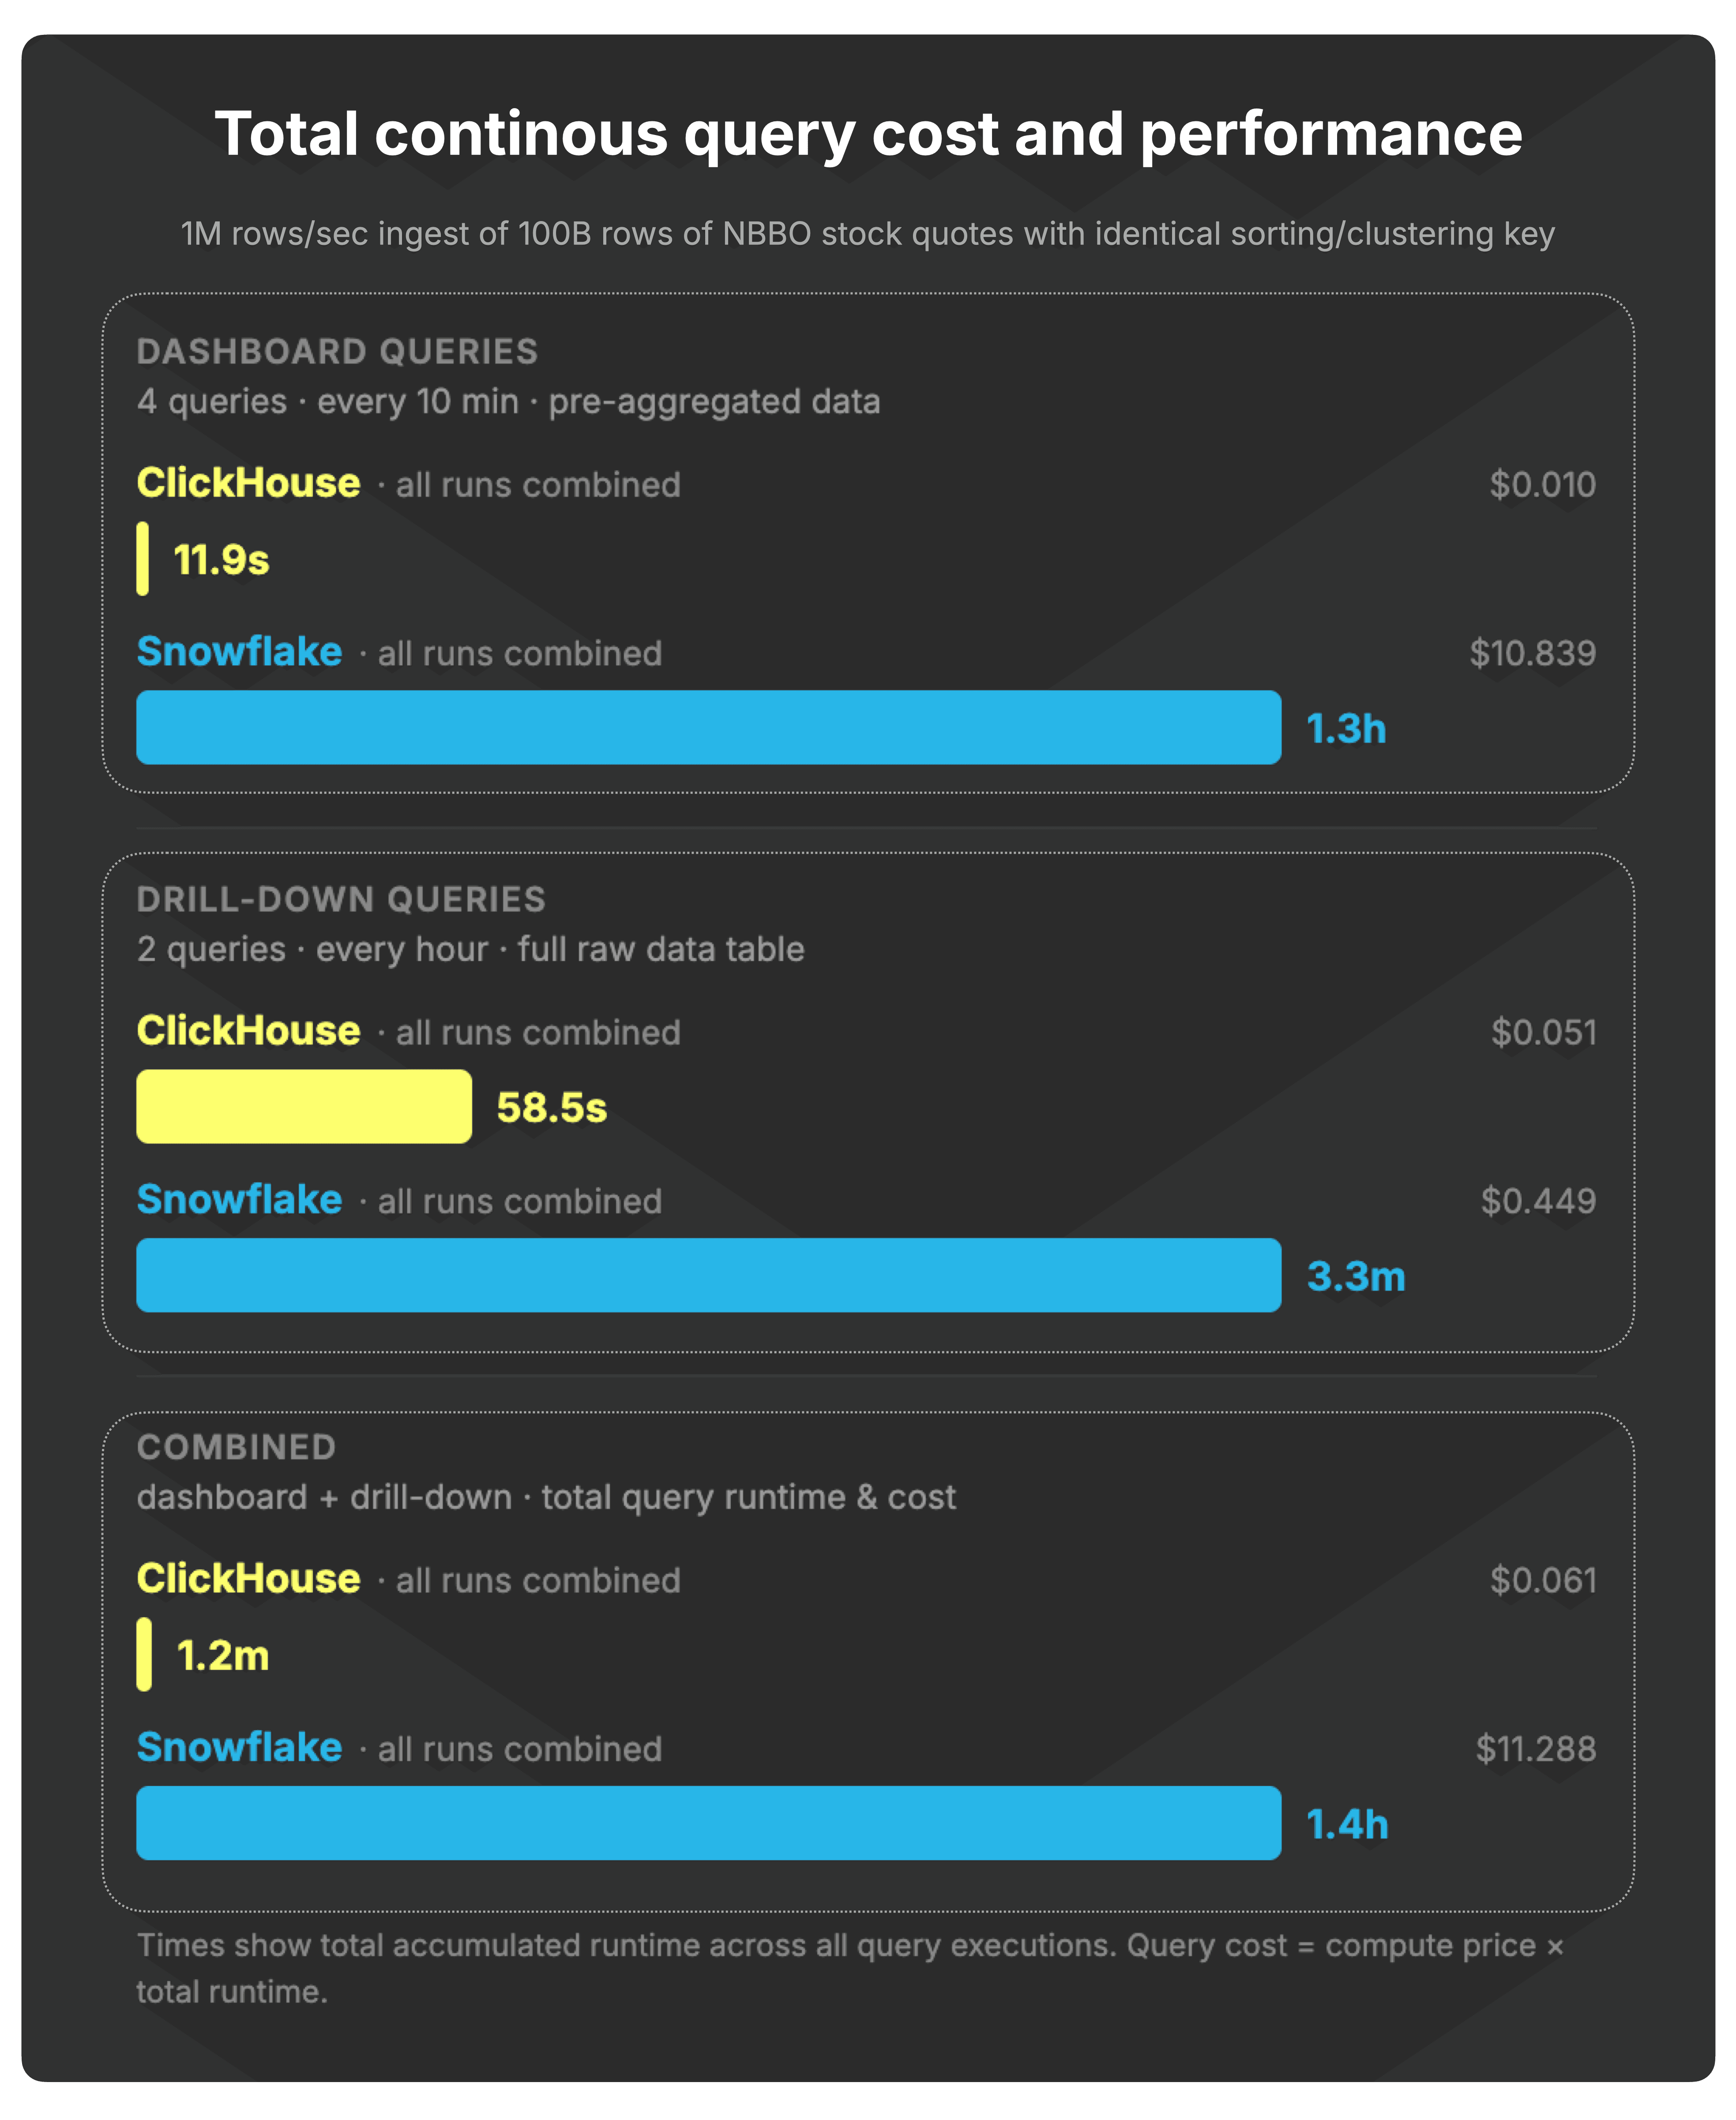
*クエリごとの実行の詳細は、CostBenchリポジトリで入手可能です: ClickHouse [ダッシュボードクエリ](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/clickhouse-cloud/results/mv/dashboard_20260609T154019Z.jsonl)と[ドリルダウンクエリ](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/clickhouse-cloud/results/raw/drilldown_20260617T162929Z.jsonl)、Snowflake [ダッシュボードクエリ](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/snowflake/results/t0/dashboard_20260609T154304Z.jsonl)と[ドリルダウンクエリ](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/snowflake/results/t0/drilldown_20260617T155914Z.jsonl)*。
クエリコストについては、連続的な読み取りワークロードの累積ランタイムを、読み取り側コンピュートの価格で乗算します。
ClickHouseは1つの読み取りサービスを使用し、16 CPUと64 GiB RAM(8コンピュートユニットに相当)を持ちます: 8コンピュートユニット × $0.3903/時間 × 70.4秒 \= **$0.061**
SnowflakeはGen2 Small読み取りウェアハウスを16 CPUで使用します。2.7クレジット/時間、1クレジットあたり$3で、$8.10/時間となります: 2.7クレジット/時間 × $3/クレジット × 5,017秒 \= **$11.288**
これにより、新鮮データパスコストと組み合わせる前に、このワークロードのクエリコンピュートでClickHouseは約185倍安くなります。
### コスト性能: フルパススコア {#costperformance_the_fullpath_score}
> 支出額あたりのフルパスリアルタイム性能が最も高いのはどこか?
フルパスリアルタイムコスト効率を直接比較するため、コストと性能を1つの「低いほど良い」スコアに集約します。
スコアは以下の通りです:
**(新鮮データパスコスト + クエリコスト) × 総クエリランタイム**
これは基本的なコスト性能のトレードオフを捉えます。システムはパスを安く保ち、クエリを迅速に提供すればスコアが良くなります。高価なシステムはスコアが悪くなります。遅いシステムはスコアが悪くなります。そして、システムが高価で遅い両方の場合、2つの効果は合成されます。
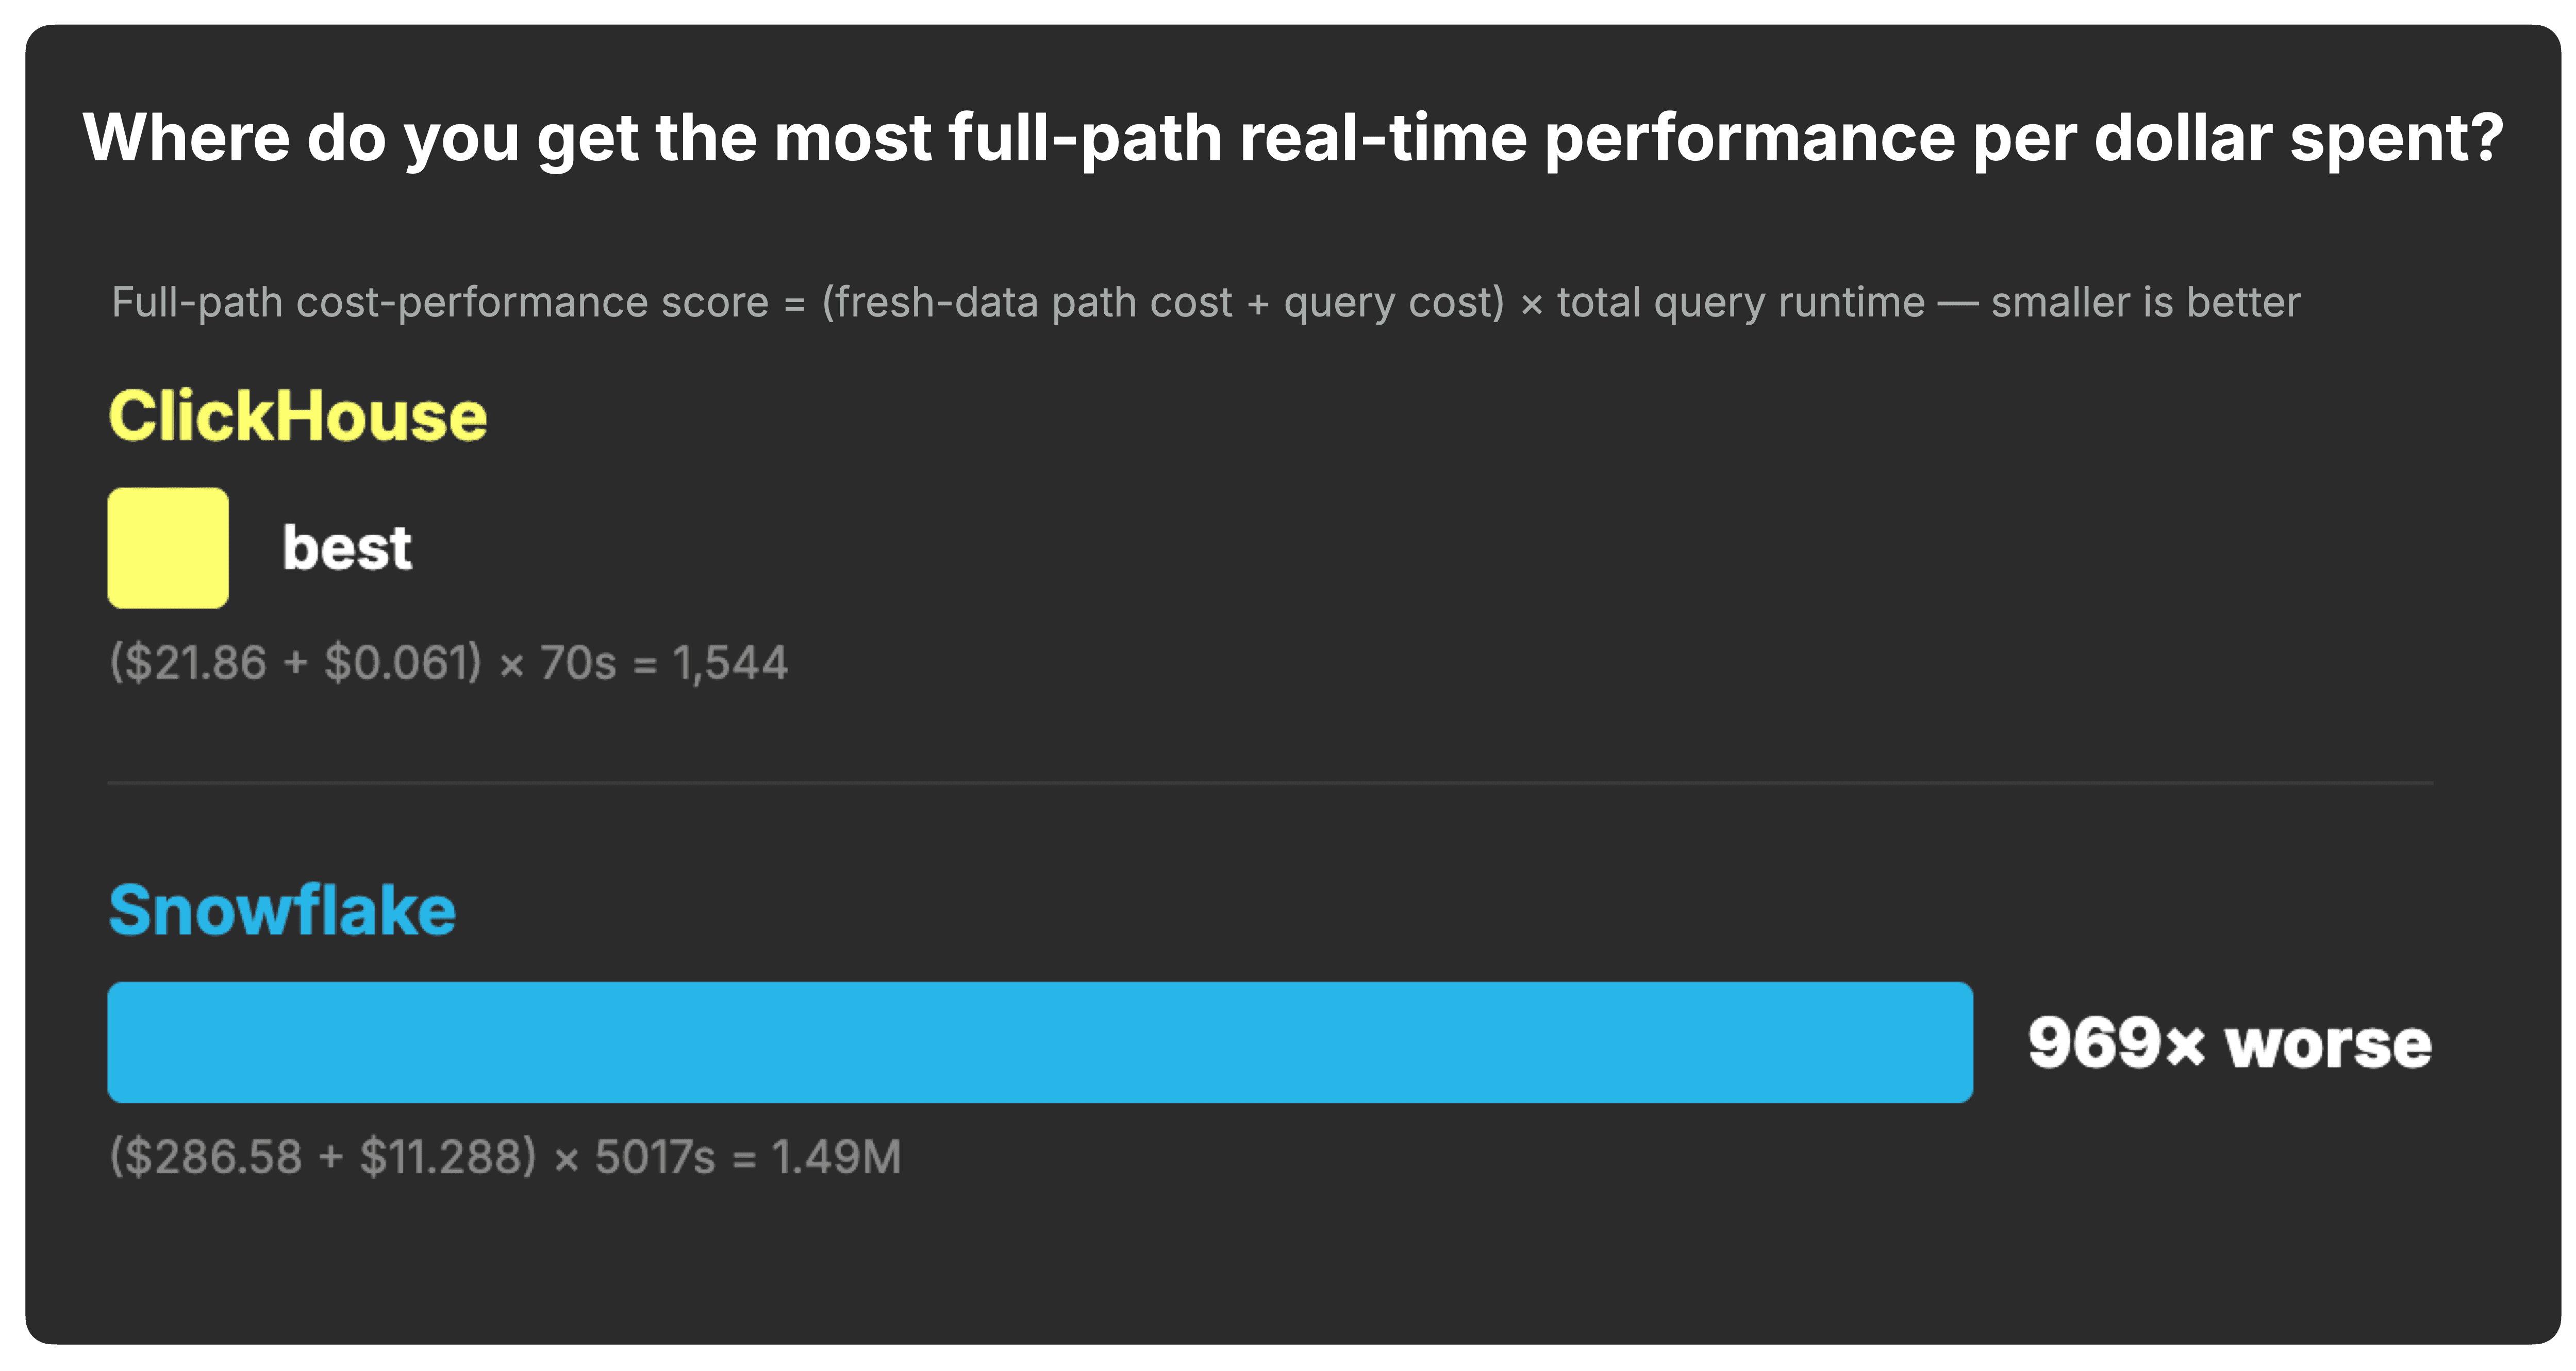
Snowflakeの標準セットアップは**969倍悪いスコア**となります。
これが合成効果です。Snowflakeはパスの実行維持により多くのコストを支払い、それでもなお同じ連続クエリスケジュールを提供するためにはるかに多くのランタイムを必要とします。
そしてこれは予算差を使う前の話です。Snowflakeの支出レベルでは、ClickHouseはさらに大きなサービスにスケールアップし、レイテンシをさらに削減しつつ、同じ総コストを下回ることができます。
## 結果: ClickHouse対Snowflake Interactive Tables {#results_clickhouse_vs_snowflake_interactive_tables}
前のセクションでは、Snowflakeの広く利用可能な標準テーブルパスに対してClickHouseを測定しました。次に、Snowflakeの[Interactive Tablesセットアップ](/blog/real-time-analytics-cost-performance-snowflake-vs-clickhouse#snowflake_setup_2_interactive_tables)に対して同じCostBenchワークロードを繰り返します。
ワークロード、クライアント動作、インジェストレート、クエリスケジュール、読み取り側CPU数は同じままです。変わるのはSnowflakeのサービングパスです。生および事前集計データはInteractive Tablesに配置され、ユーザー管理のウェアハウスによってリフレッシュされ、大容量キャッシュを持つInteractive Warehouseによって提供されます。
思い出してください:
> これらの測定では、両システムは同じ読み取り側コンピュート(16 AWS Graviton3コア)を使用します。
### 性能: Interactive Tablesは読み取りを改善するが、ギャップは解消しない {#performance_interactive_tables_improve_reads_but_do_not_remove_the_gap}
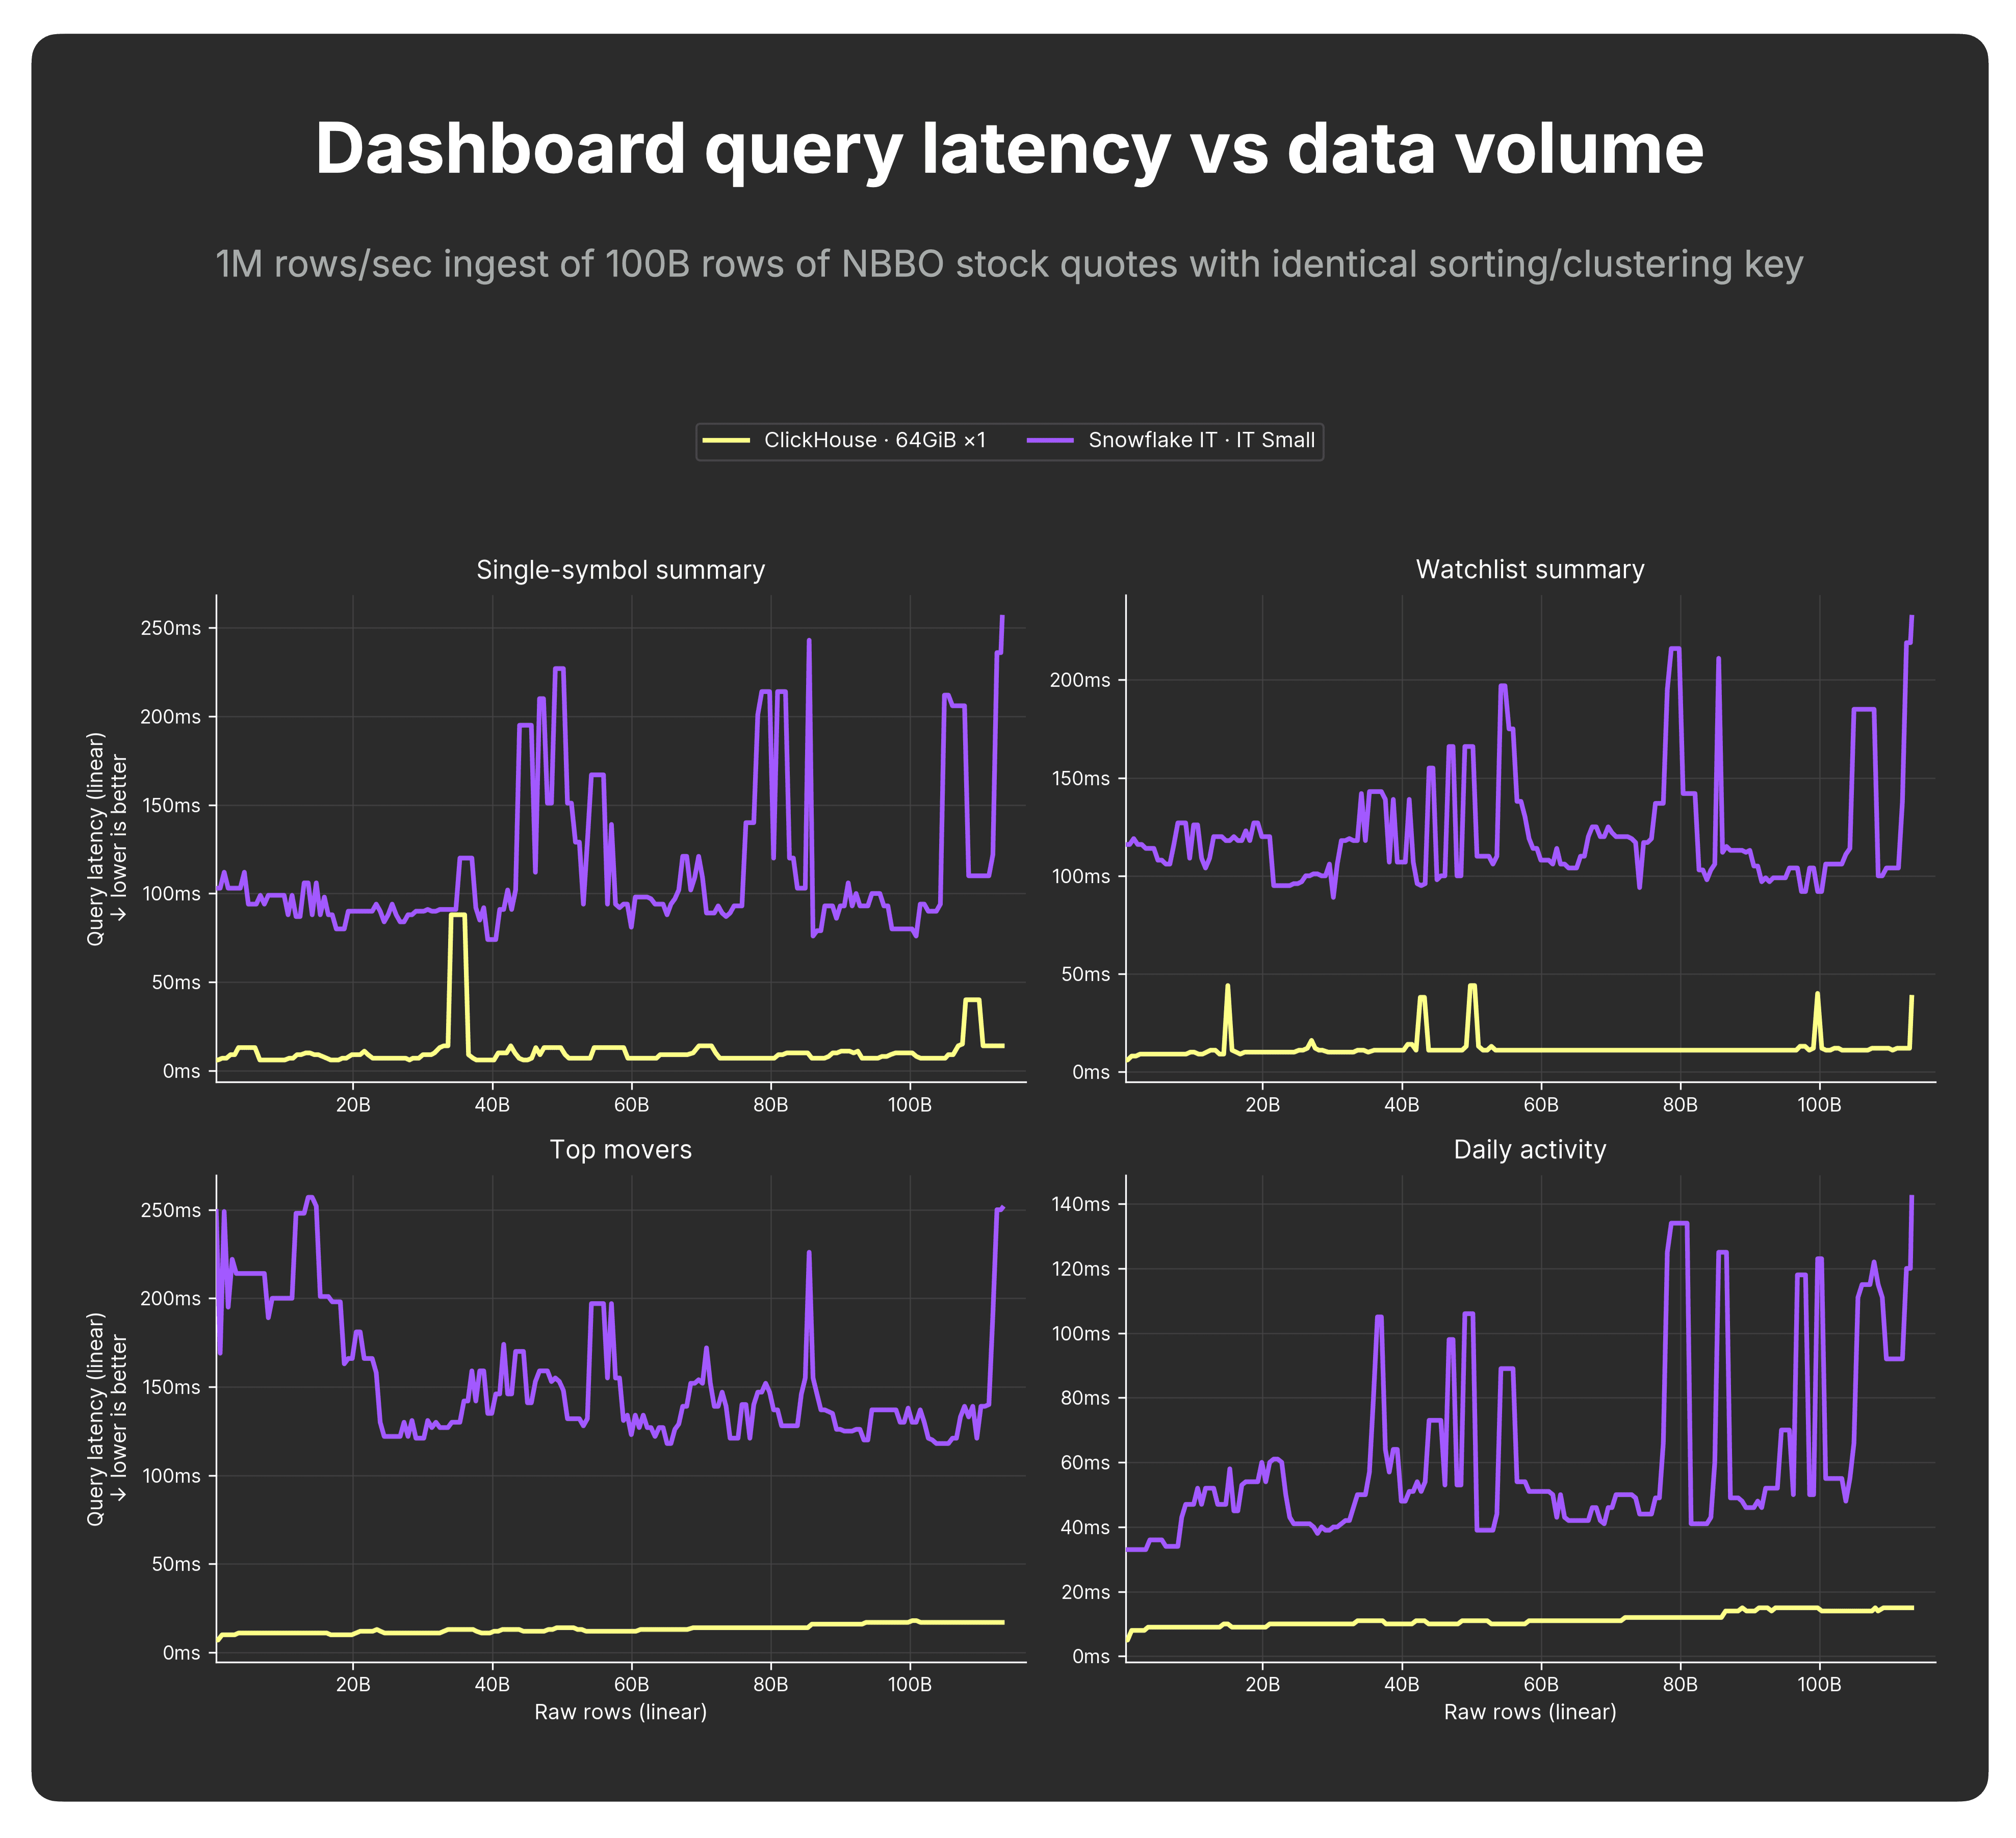
チャートは上記と同じ形式です。x軸は生テーブルにインジェストされた行数で、約28時間後の1000億行までを示しています。y軸はクエリレイテンシです。
#### ダッシュボードクエリ: Interactive Tablesで高速化するが、依然としてフラットではない {#dashboard_queries_faster_with_interactive_tables_but_still_not_as_flat}
ダッシュボードクエリでは、Interactive TablesとInteractive Warehouseを組み合わせることで、標準的なマテリアライズドビューセットアップと比較してSnowflakeのレイテンシが劇的に改善します。しかし、同じ読み取り側CPU数を使用しているにもかかわらず、ClickHouseは依然としてより低く、よりフラットな状態を保ちます。
*クエリごとの実行の詳細は、CostBenchリポジトリで入手可能です: [ClickHouse](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/clickhouse-cloud/results/mv/dashboard_20260609T154019Z.jsonl)、[Snowflake](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/snowflake/results/t1/dashboard_20260617T154602Z.jsonl)。*
> **Interactiveの事前集計結果は1回のリフレッシュサイクル分だけ遅れている**
Snowflakeのダッシュボードクエリが高速に返る場合でも、それらは1分のターゲットラグを持つ事前集計されたInteractive Tableから読み取っています。ClickHouseは、事前集計がインジェストパス上で行われるため、より高速かつ常に最新の状態を保ちます。
#### 鮮度: スケジュールされたリフレッシュが追従しなければならない {#freshness_scheduled_refresh_has_to_keep_up}
次のチャートは、Interactive Tablesセットアップで事前集計を新鮮に保つために何が必要かを示しています。
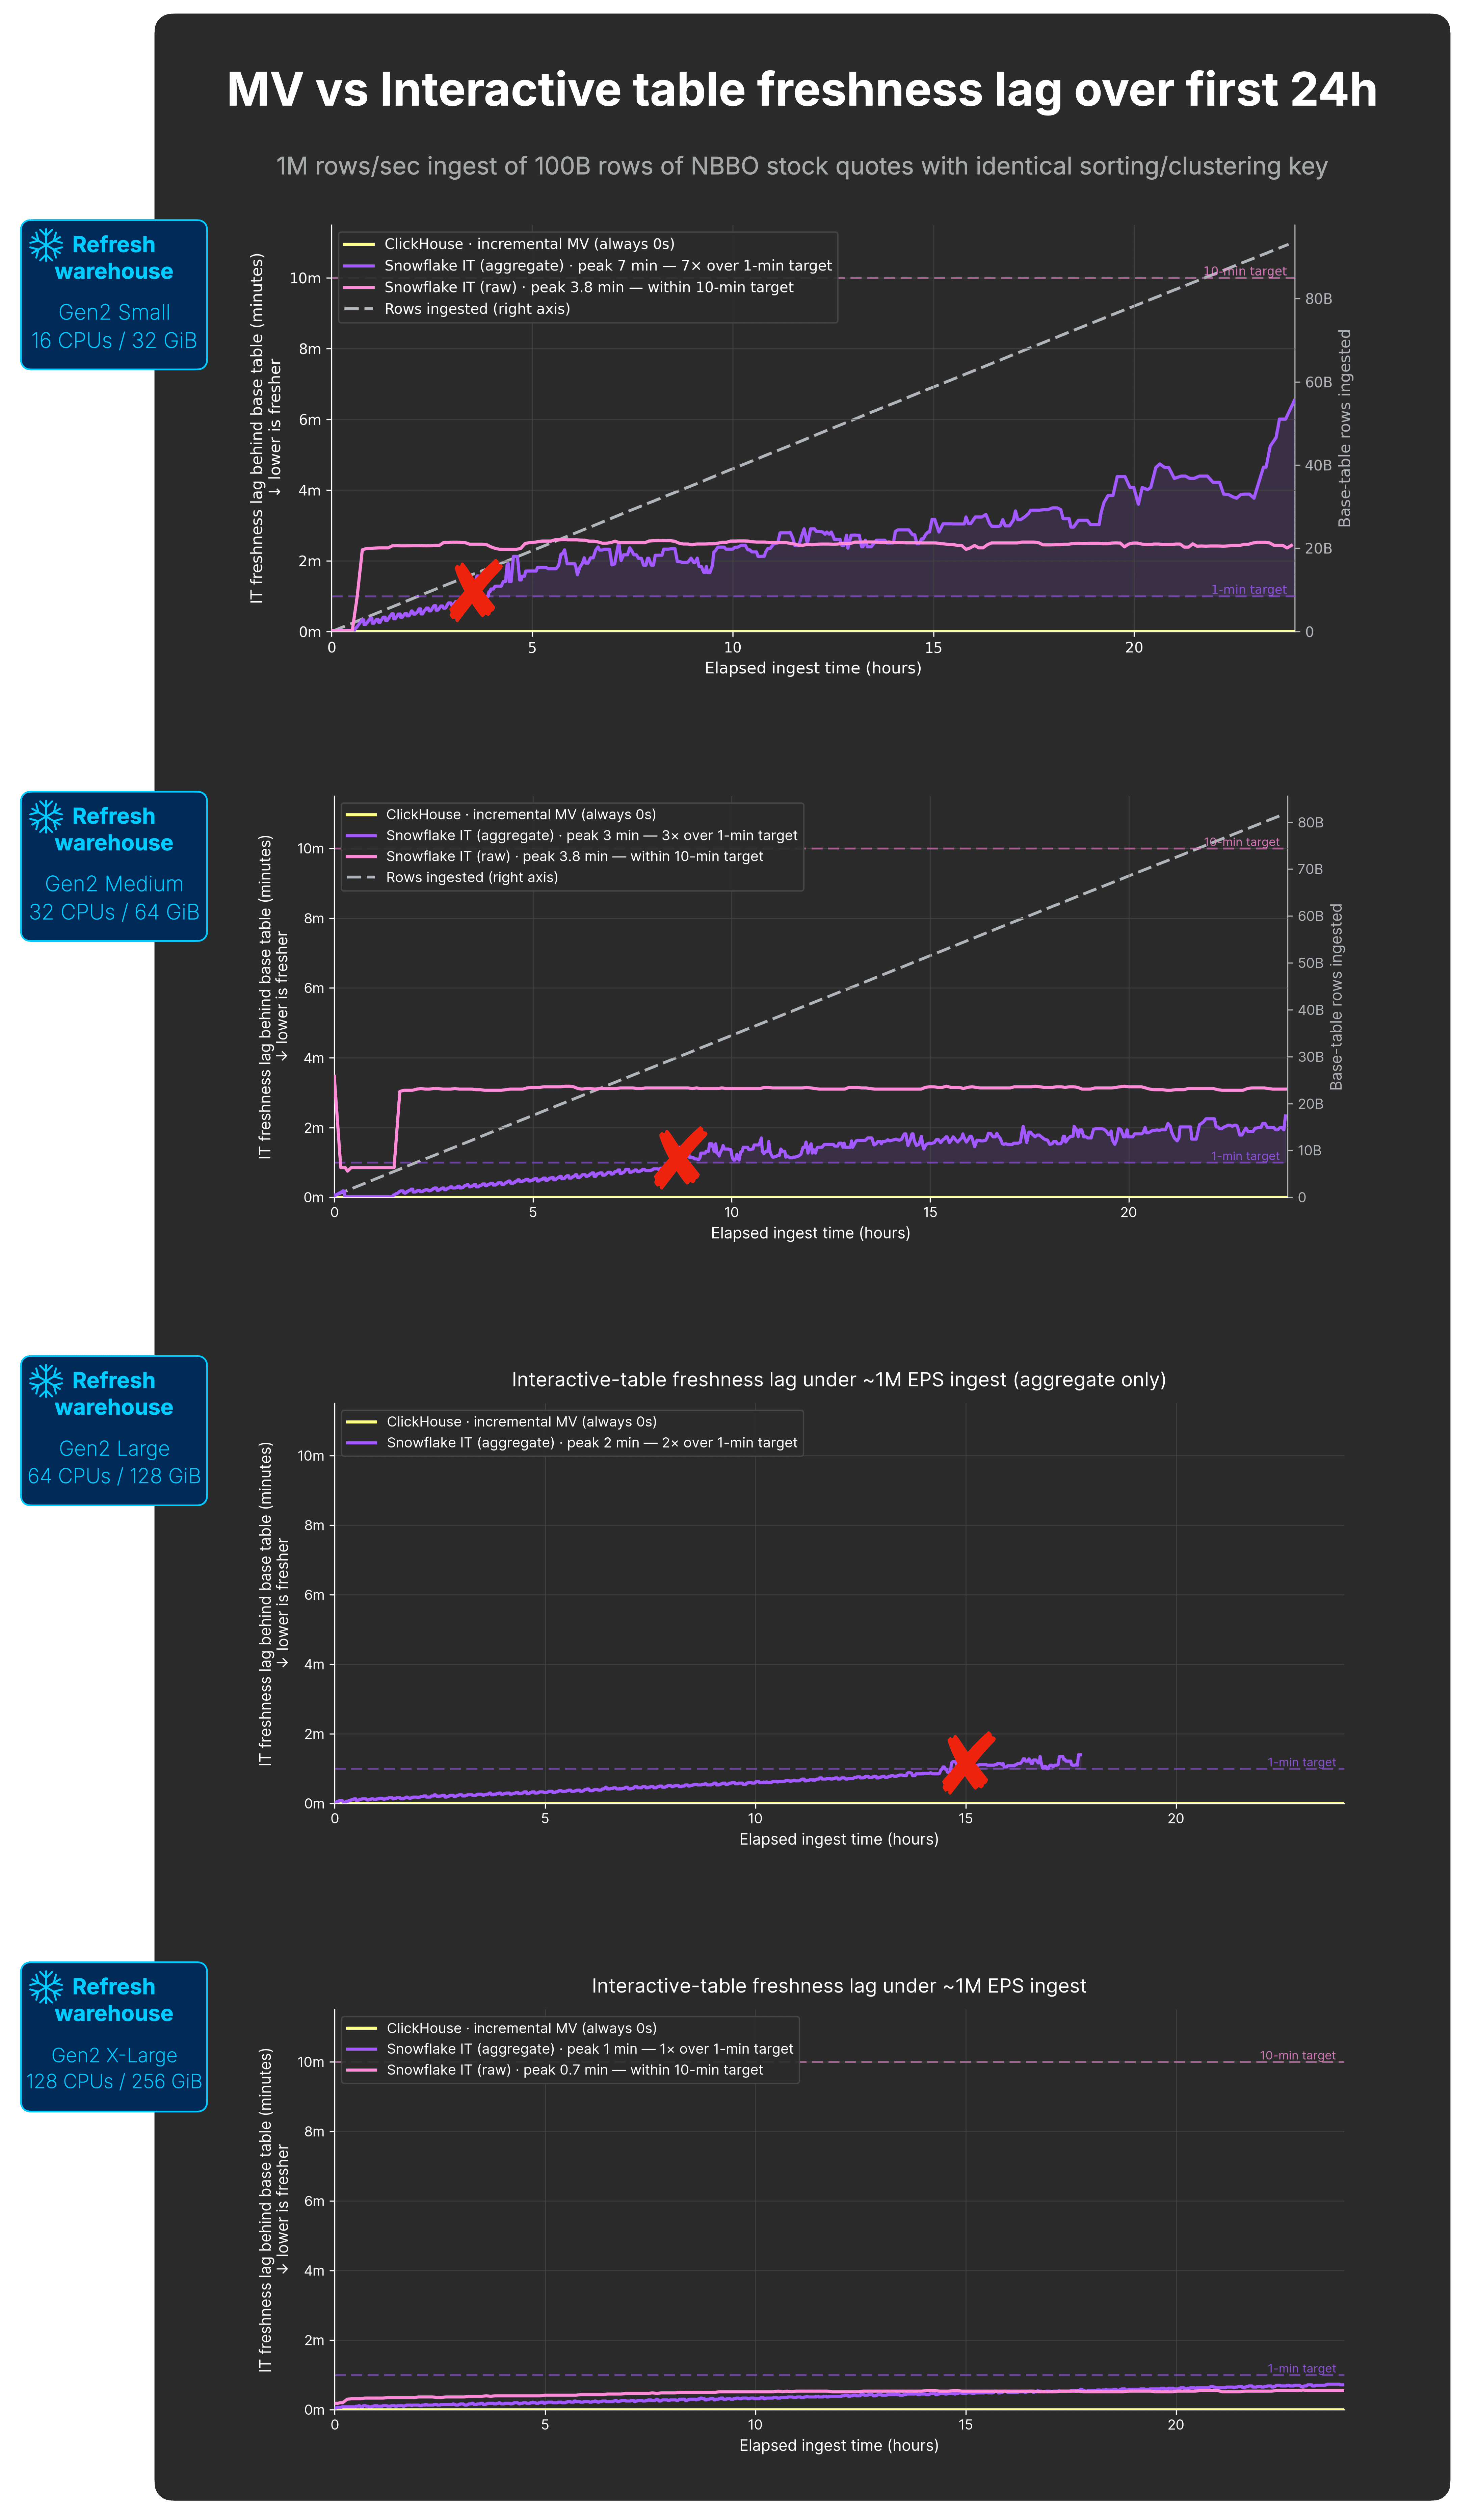
*このラグは、Snowflakeの`INFORMATION_SCHEMA.INTERACTIVE_TABLE_REFRESH_HISTORY`テーブルを1分ごとに[ポーリング](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/snowflake/ops/it_refresh.sh)することで測定しました。結果は[こちら](https://github.com/ClickHouse/CostBench/tree/main/full-path-realtime/quotes/snowflake/results/t1/it_refresh)で入手可能です。*
ClickHouseは、マテリアライズドビューが新しい行の挿入と同期して更新されるため、実行中を通じて最新の状態を維持します。
生のInteractive Tableは予想どおりの動作をしました。10分のリフレッシュターゲットでは、テストしたウェアハウスサイズ全体でそのターゲット内に収まりました。これにより、毎時のドリルダウンワークロードに対して生テーブルは十分に新鮮な状態を保ちました。
より難しかったのは、事前集計されたInteractive Tableです。前述のとおり、このテーブルは株価相場ダッシュボードワークロードを提供し、ClickHouseのマテリアライズドビューにSnowflakeが最も近づけるものであるため、Snowflakeが許可する最小のリフレッシュ間隔である1分を使用しました。
Gen2 Smallリフレッシュウェアハウスは約3時間後、Gen2 Mediumは約8時間後、Gen2 Largeは約15時間後に遅れ始めました。赤い十字は、各セットアップが事前集計されたInteractive Tableを設定された1分のターゲット内に維持できなくなった時点を示しています。
これは、Snowflakeがリフレッシュのたびに生テーブル全体を再集計するからではありません。事前集計されたInteractive Tableへのリフレッシュはインクリメンタルであり、私たちのセットアップに対するシステムテーブルクエリで確認されています。それでもなお、リフレッシュウェアハウスは、次のリフレッシュが到来する前に、新しい行を処理し、集計し、その結果をターゲットテーブルにマージしなければなりません。
これが、最終的なセットアップでGen2 X-Largeリフレッシュウェアハウスを使用する理由です。これにより、最初の24時間にわたって両方のInteractive Tableを設定されたターゲット内に維持できました。
> 事前集計のラグは依然として徐々に増加しています。初日には1分のターゲットを破ることはありませんが、曲線はフラットではありません。より長時間の実行では、Snowflakeはより多くのリフレッシュコンピュートか、より緩い鮮度ターゲットのいずれかを必要とするでしょう。
#### ドリルダウンクエリ: Interactive Warehouseのキャッシュは役立つが、スケーリングの影響は依然として現れる {#drilldown_queries_interactive_warehouse_cache_helps_but_scaling_still_shows}
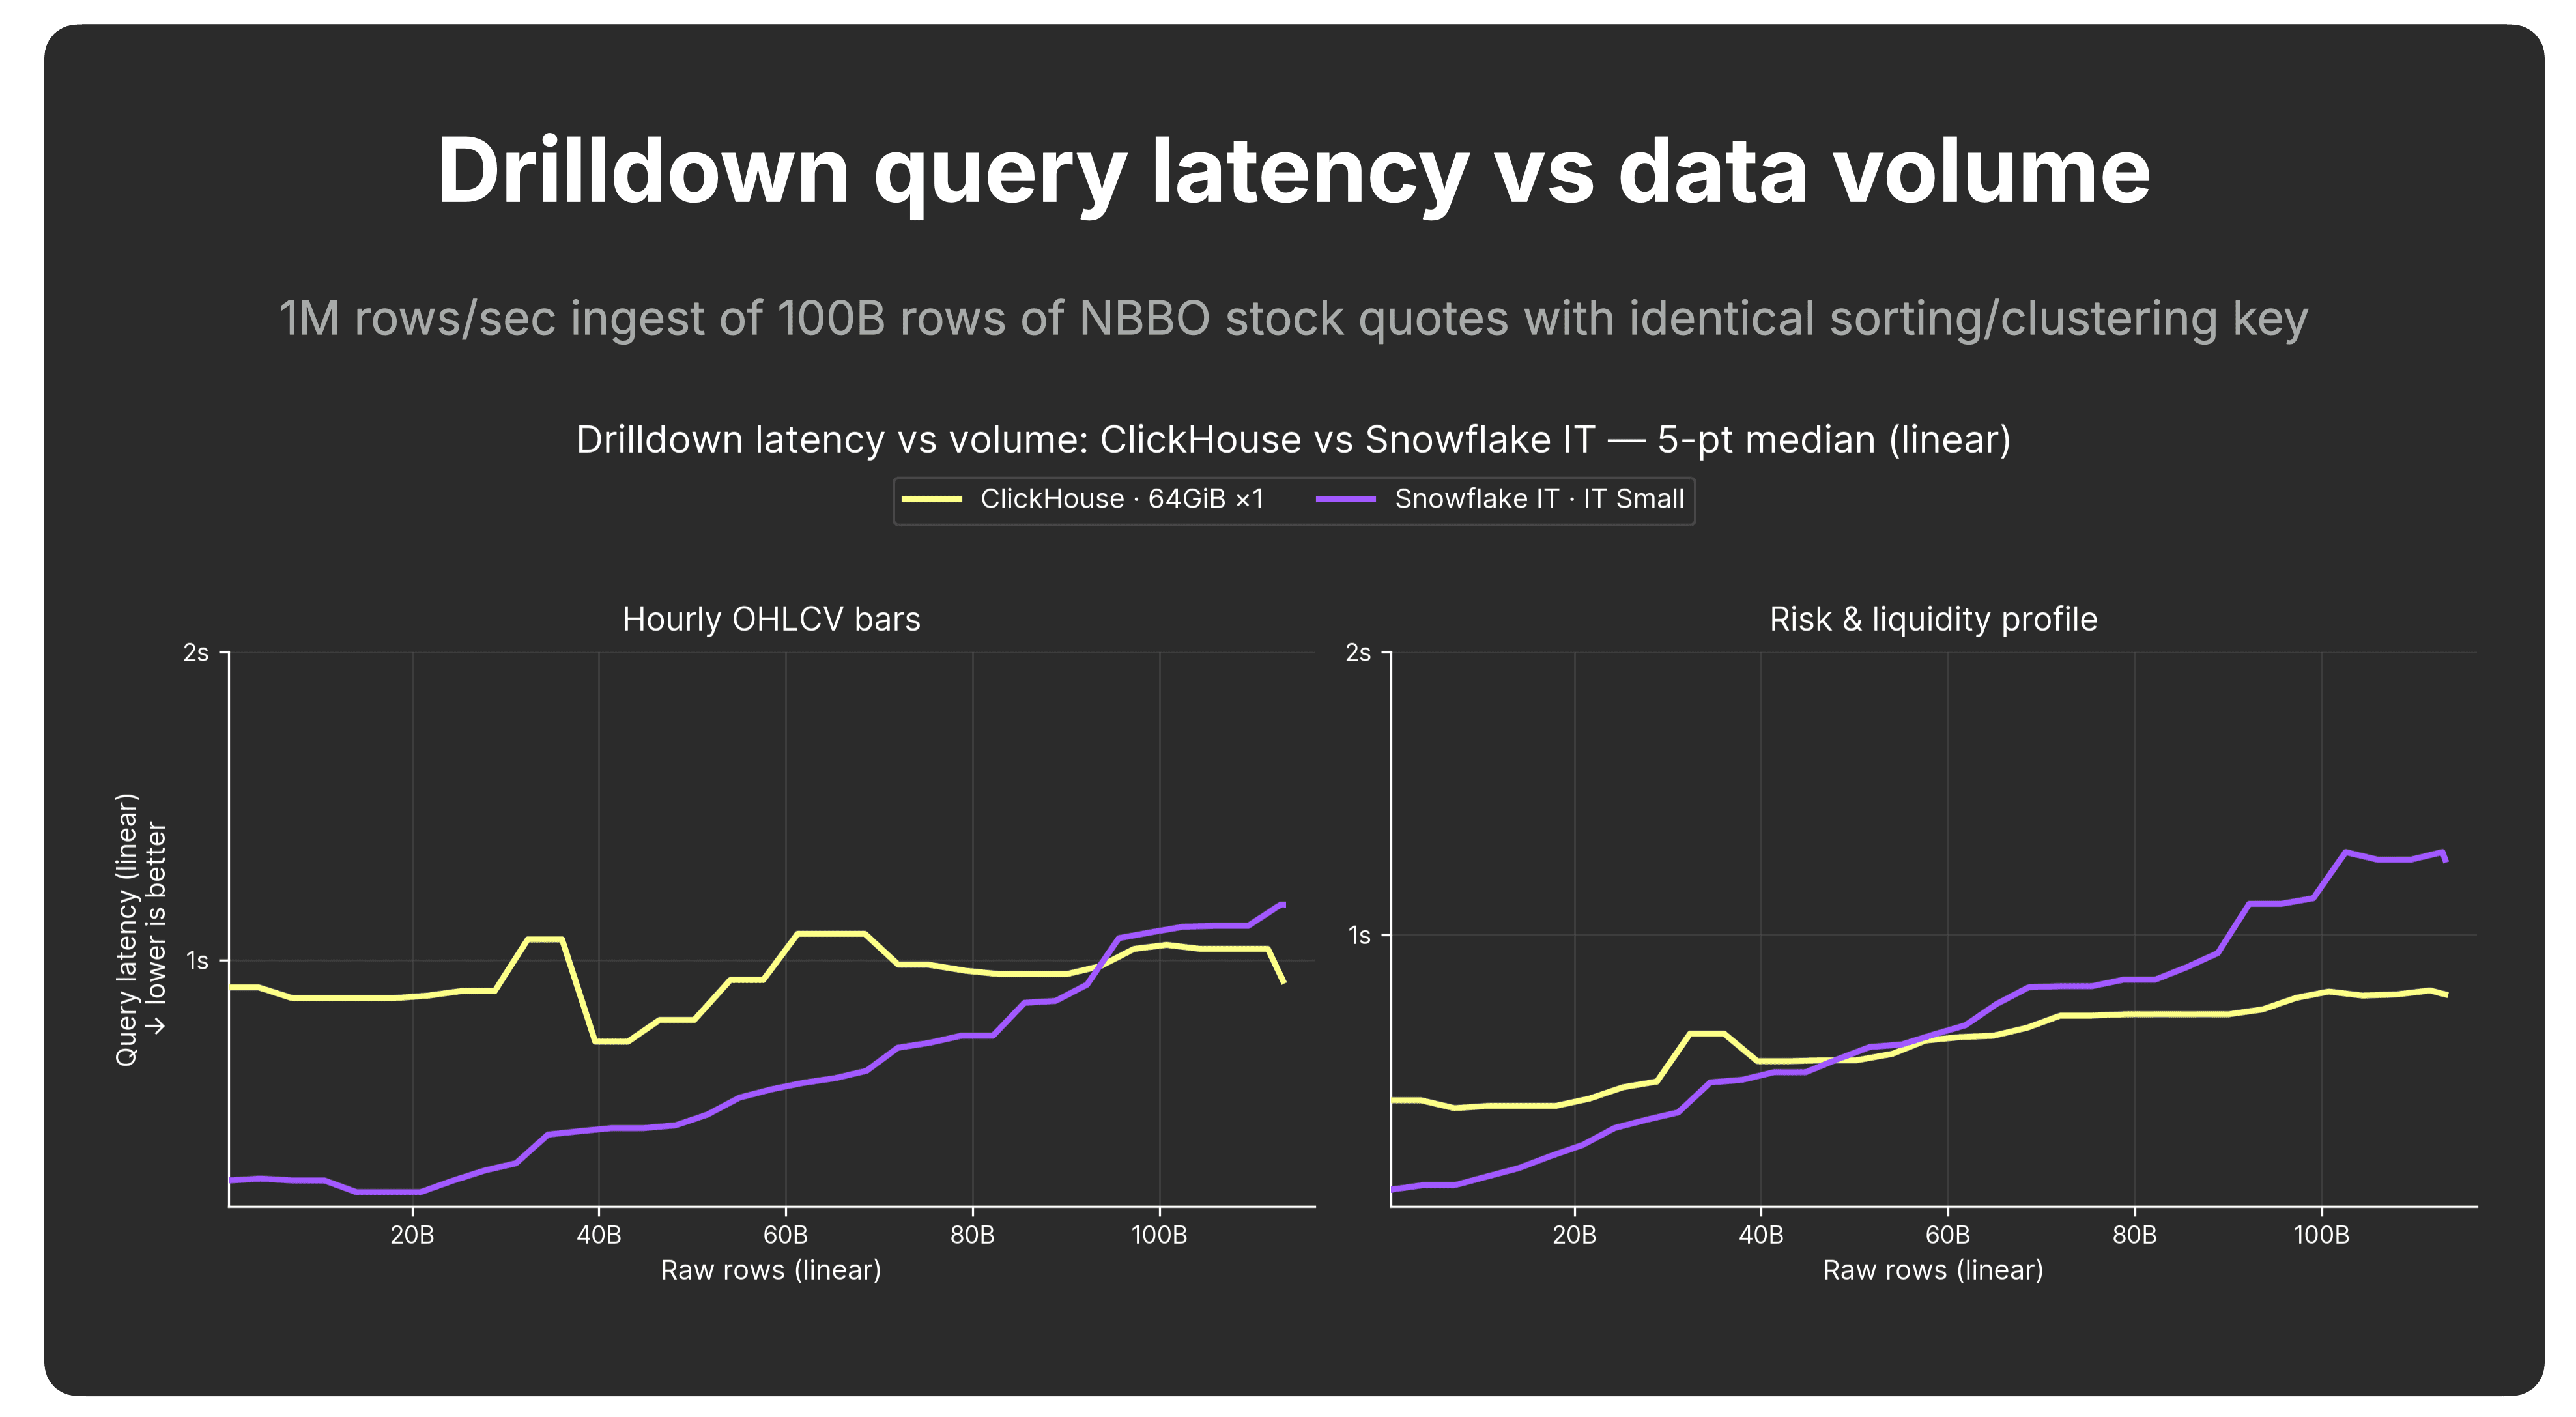
ドリルダウンクエリでは、Interactive Tablesは標準テーブルセットアップと比較してSnowflakeを大幅に改善します。
*クエリごとの実行の詳細は、CostBenchリポジトリで入手可能です: [ClickHouse](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/clickhouse-cloud/results/raw/drilldown_20260617T162929Z.jsonl)、[Snowflake](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/snowflake/results/t1/drilldown_20260617T154602Z.jsonl)。*
しかし、その改善はデータ量が増えるにつれてフラットな状態を保ちません。
最初の1000億行を通じてワーキングセットは依然としてInteractive Warehouseのキャッシュに収まっているにもかかわらず、Snowflakeのレイテンシはデータサイズとともに上昇します。ClickHouseは、Interactive Warehouseのキャッシュがなくても、はるかにフラットな状態を保ちます。あるドリルダウンクエリでは、約500億行の時点でSnowflakeはすでにClickHouseより遅くなっており、実行の終わりまでには、両方のドリルダウンクエリがClickHouseのレイテンシと同等かそれ以上になります。
> **要点:** 軽量なデータセットであっても、100万行/秒という[控えめな](https://clickhouse.com/blog/how-tesla-built-quadrillion-scale-observability-platform-on-clickhouse)インジェストをわずか約1日行っただけで、Snowflake Interactive TablesはドリルダウンワークロードにおいてすでにClickHouseのレイテンシと同等かそれ以上になっています。
**スケーリングに関する注記**
重要な点は、ワーキングセットが依然としてInteractive Warehouseのキャッシュに収まっている間でも、レイテンシがすでに増大しているということです。
これは次のスケーリングの問いを提起します。すなわち、利用可能な最大のInteractive Warehouseキャッシュにさえワーキングセットが収まらなくなったとき、何が起こるのか、ということです。
SnowflakeのInteractive Warehouseモデルには、5秒というハードなクエリタイムアウトもあります。クエリがそのしきい値を超えると、[Snowflakeはフォールバックウェアハウスを推奨](https://docs.snowflake.com/en/user-guide/interactive#automatically-handling-statement-timeouts)します。これにより、別のコスト次元が加わります。フォールバックウェアハウスは必要なときに利用可能でなければならず、ユーザーに見えるランタイムには、失敗した試行に加えて、フォールバックコンピュート上での再試行が含まれます。
### コスト: インジェストとリフレッシュ {#cost_ingest_and_refresh}
Interactive Tablesは、標準的なSnowflakeセットアップよりもクエリパスを安価にしますが、コストはリフレッシュに移動します。
#### 新鮮データパスコスト: リフレッシュが支配的な要素になる {#freshdata_path_cost_refresh_becomes_the_dominant_component}
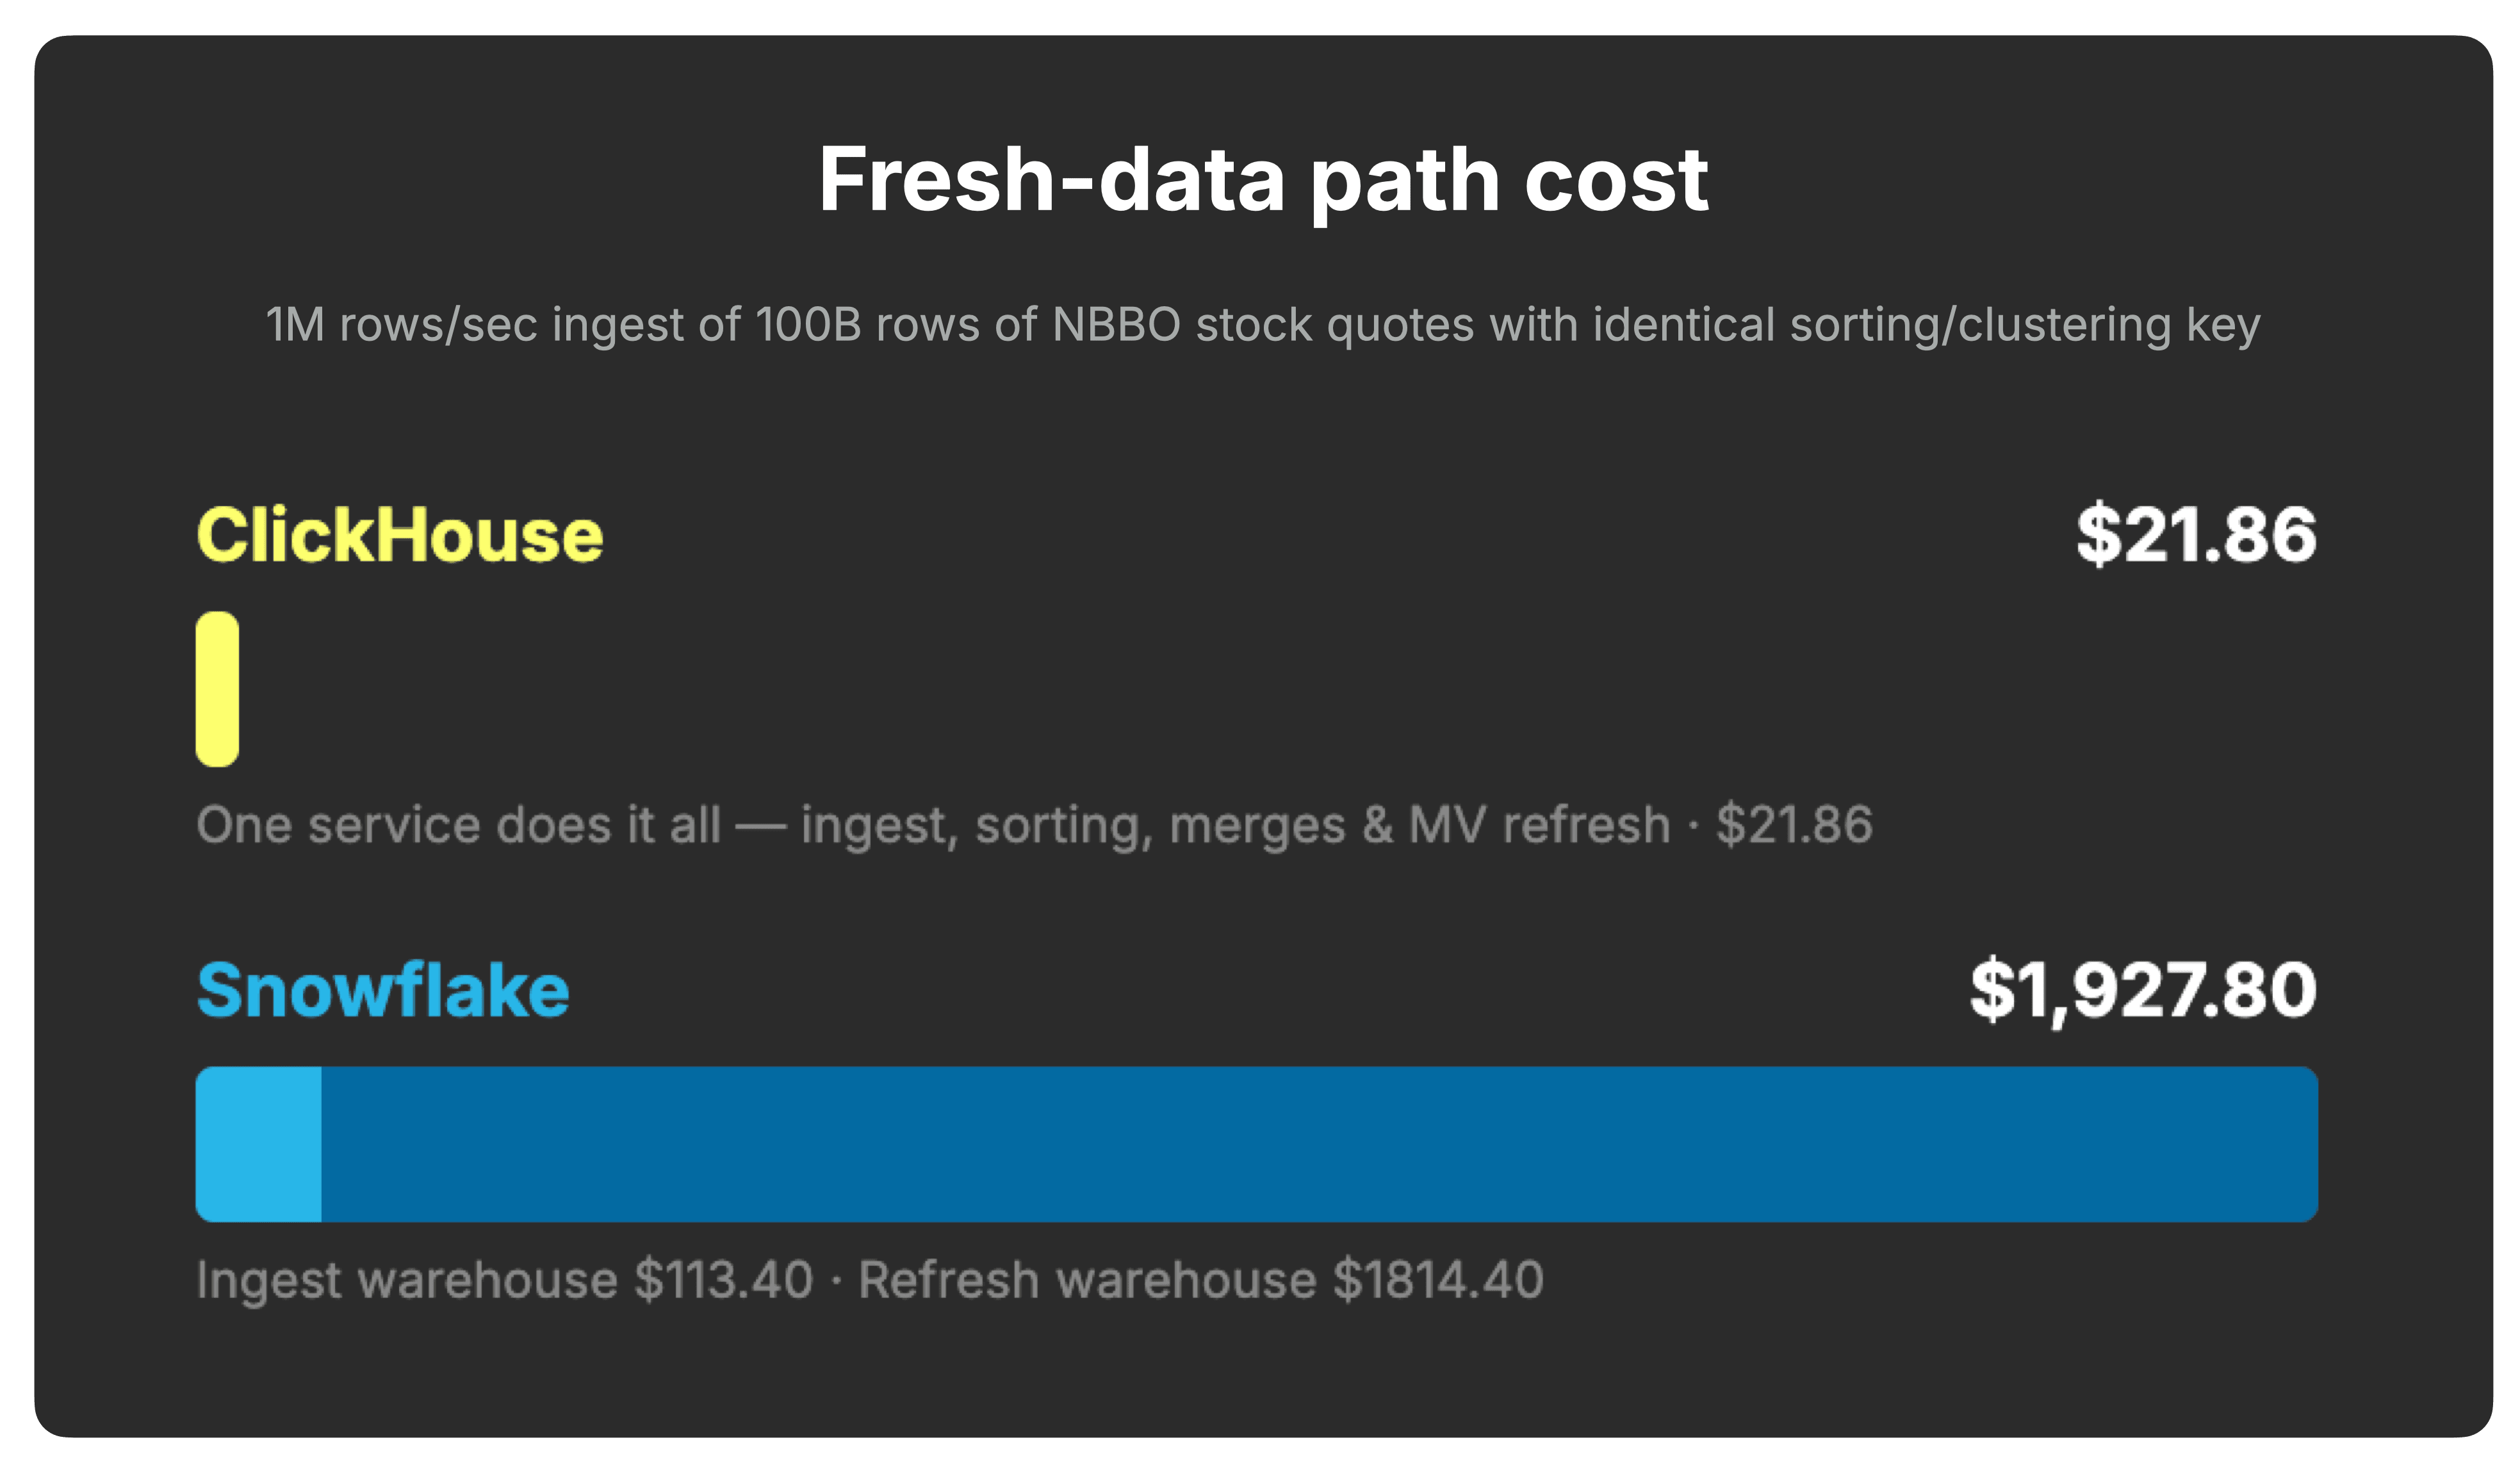
ClickHouseの場合、新鮮データパスは変わりません。同じインジェストサービスがインジェスト、ソート、マージ、マテリアライズドビューの更新を処理します。前述のとおり、これは次のコストがかかります: 2コンピュートユニット × 28時間 × $0.3903/時間 \= **$21.86。**
Snowflakeの場合、インジェストウェアハウスも変わりません。Gen2 X-Smallインジェストウェアハウスは次のコストがかかります: 1.35クレジット/時間 × 28時間 × $3/クレジット \= **$113.40。**
違いはリフレッシュです。事前集計されたInteractive TableをSnowflakeの最小1分ターゲットに維持するため、リフレッシュウェアハウスは実質的に連続稼働しなければなりません。最終的なセットアップではGen2 X-Largeリフレッシュウェアハウスを使用します。21.6クレジット/時間、1クレジットあたり$3で、これは次のコストがかかります: 21.6クレジット/時間 × 28時間 × $3/クレジット \= **$1,814.40。**
合計すると、SnowflakeのInteractive Tables新鮮データパスのコストは$1,927.80です。
クエリコストを含める前に、これは新鮮データパスをクエリ可能な状態に保つのにClickHouseの約88倍のコストです。
#### クエリコスト: Interactive Tableの読み取りは差が縮まる {#query_cost_interactive_table_reads_get_closer}
クエリコストについては、標準セットアップのセクションで[説明](/blog/real-time-analytics-cost-performance-snowflake-vs-clickhouse#query_cost_serving_the_same_schedule)したものと同じ秒単位のランタイム正規化を使用します。
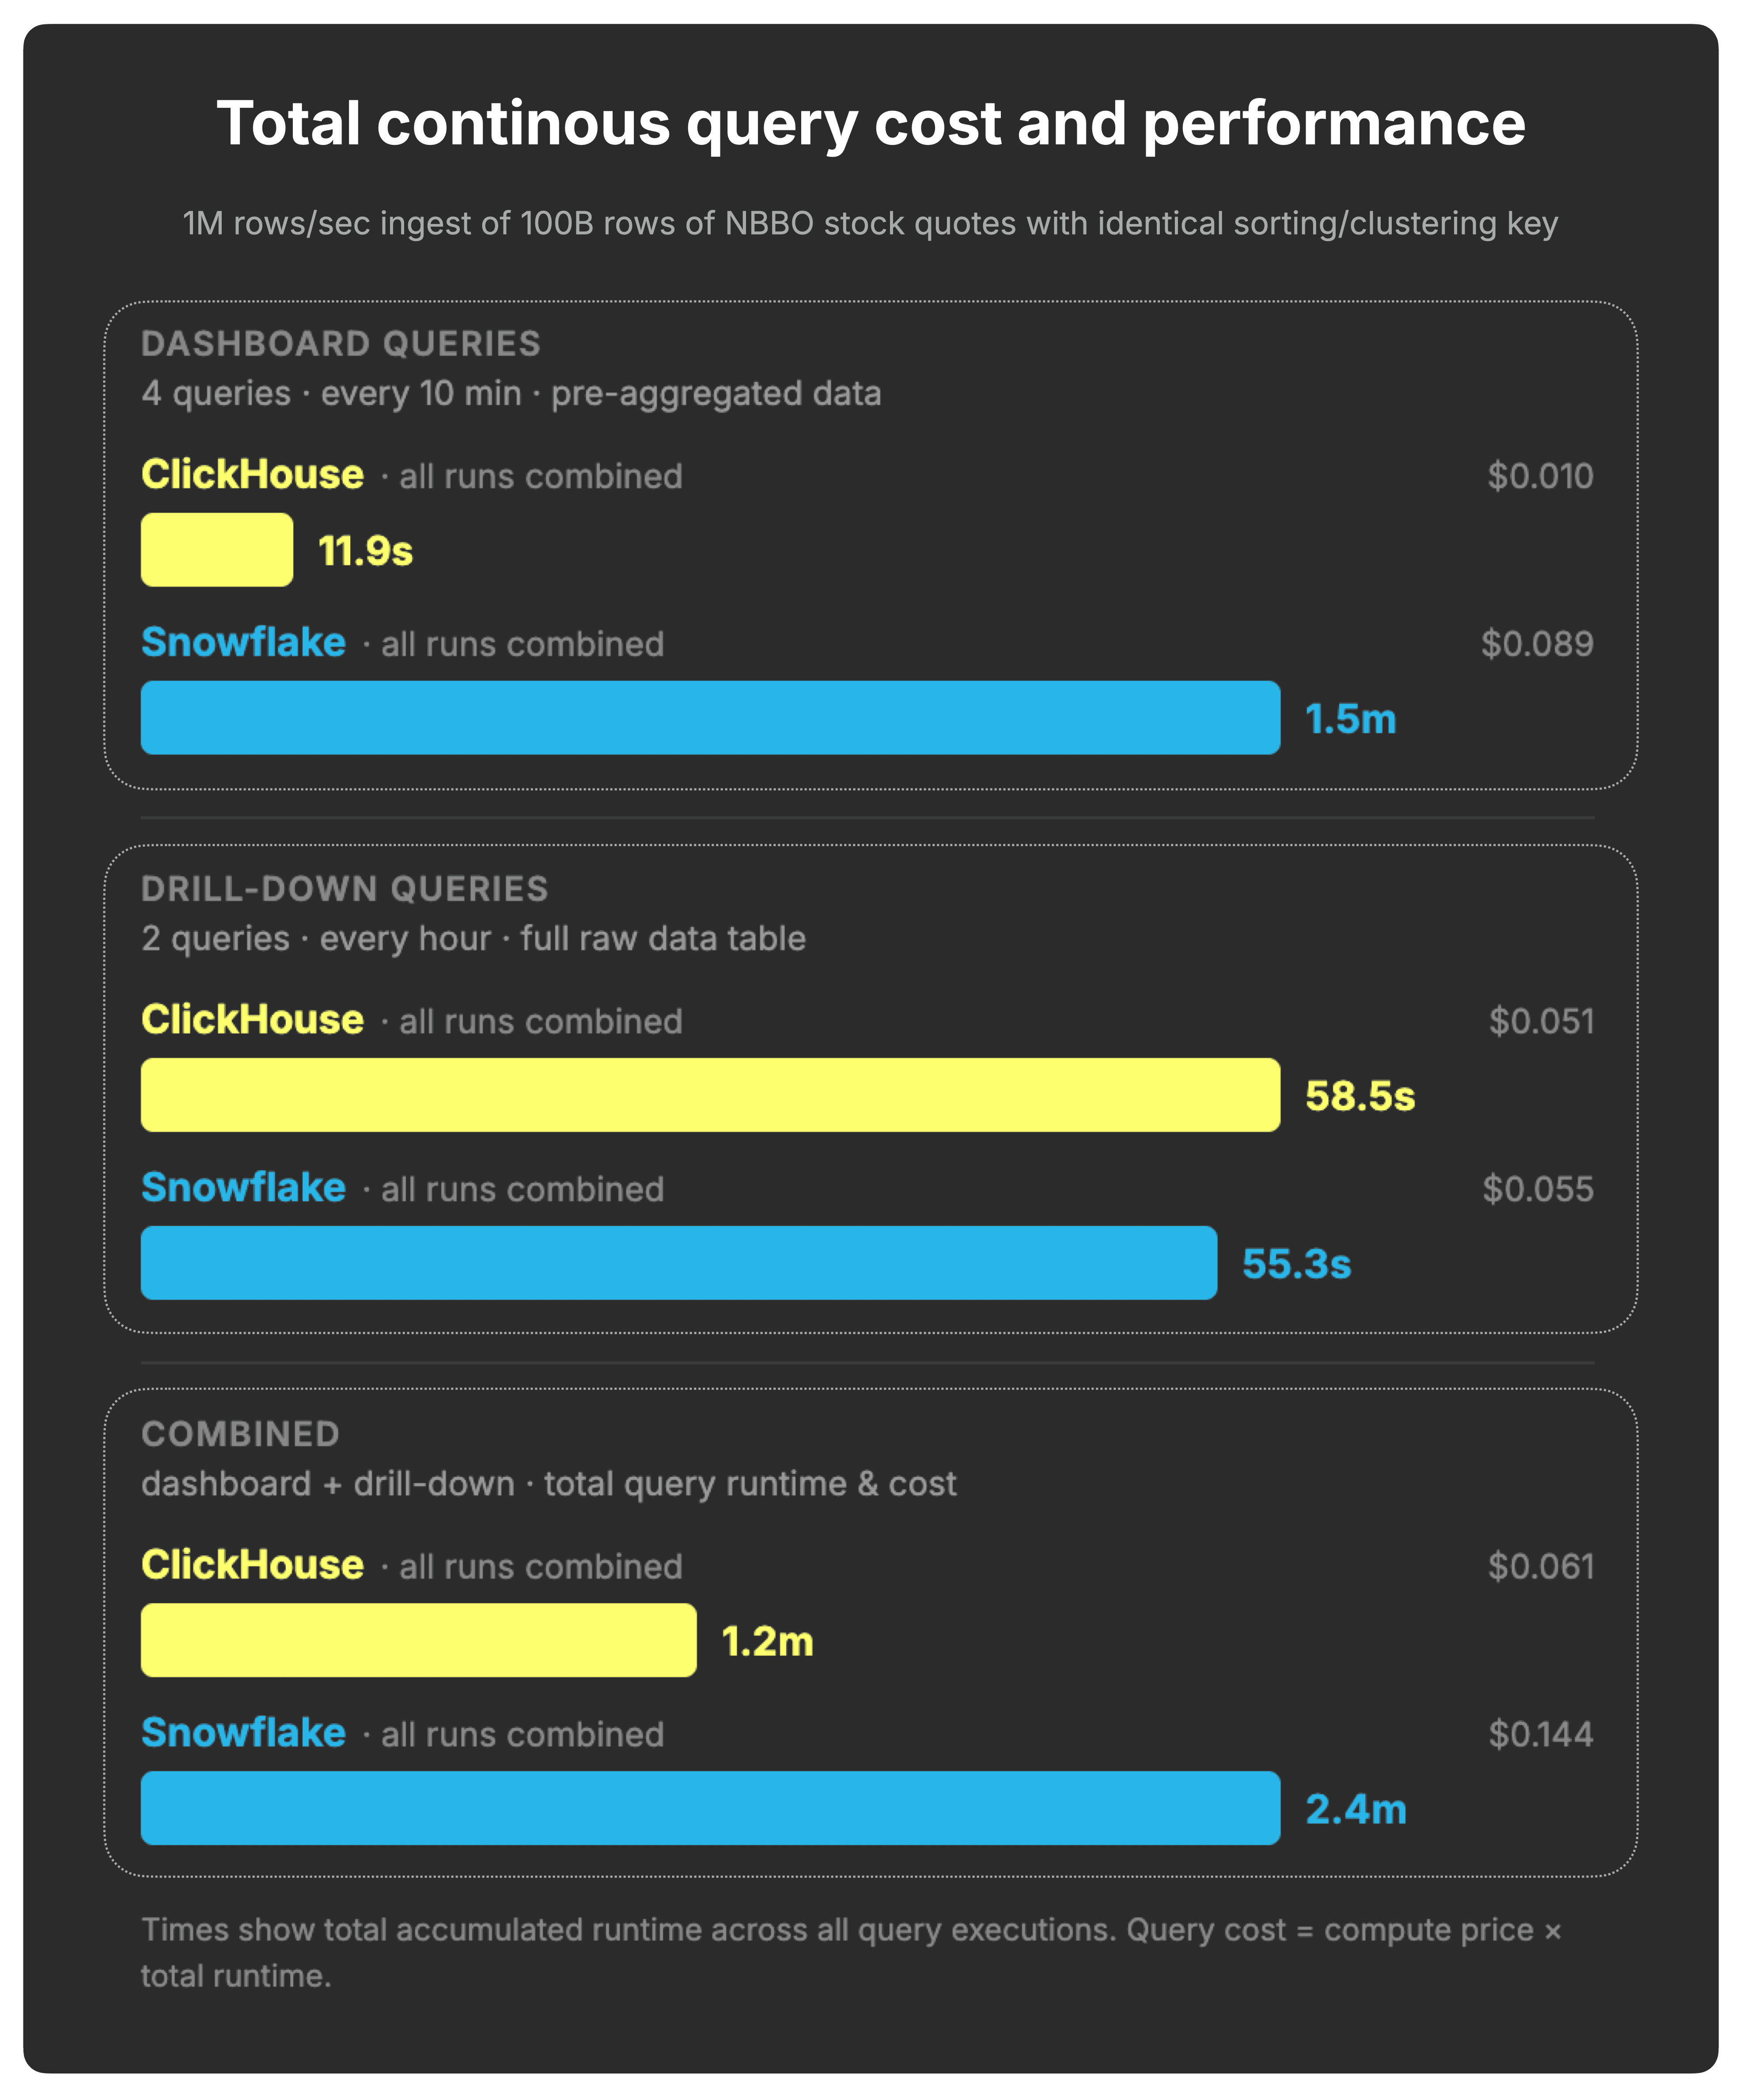
以下のチャートは、Interactive Tables読み取りワークロードの総累積ランタイムとクエリコストを示しています。
*クエリごとの実行の詳細は、CostBenchリポジトリで入手可能です: ClickHouse [ダッシュボードクエリ](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/clickhouse-cloud/results/mv/dashboard_20260609T154019Z.jsonl)と[ドリルダウンクエリ](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/clickhouse-cloud/results/raw/drilldown_20260617T162929Z.jsonl)、Snowflake [ダッシュボードクエリ](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/snowflake/results/t1/dashboard_20260617T154602Z.jsonl)と[ドリルダウンクエリ](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/snowflake/results/t1/drilldown_20260617T154602Z.jsonl)*。
ClickHouseは以前と同じ読み取りサービスを使用します。16 CPUと64 GiB RAM、すなわち8コンピュートユニットです。8コンピュートユニット × $0.3903/時間 × 70.4秒 \= **$0.061**
SnowflakeはSmall Interactive Warehouseを使用します。1.2クレジット/時間、1クレジットあたり$3で、これは$3.60/時間です。1.2クレジット/時間 × $3/クレジット × 144秒 \= **$0.144**
ClickHouseは、同じ読み取り側CPU数を使用して、クエリコンピュートで依然として約**2倍高速**かつ**2.4倍安価**です。
### コスト性能: フルパススコア {#costperformance_the_fullpath_score_2}
これでフルパスを直接比較できます。すなわち、新鮮データをクエリ可能な状態に保つのにいくらかかるか、そしてシステムが連続ワークロードを提供するのにどれだけのランタイムを必要とするかです。
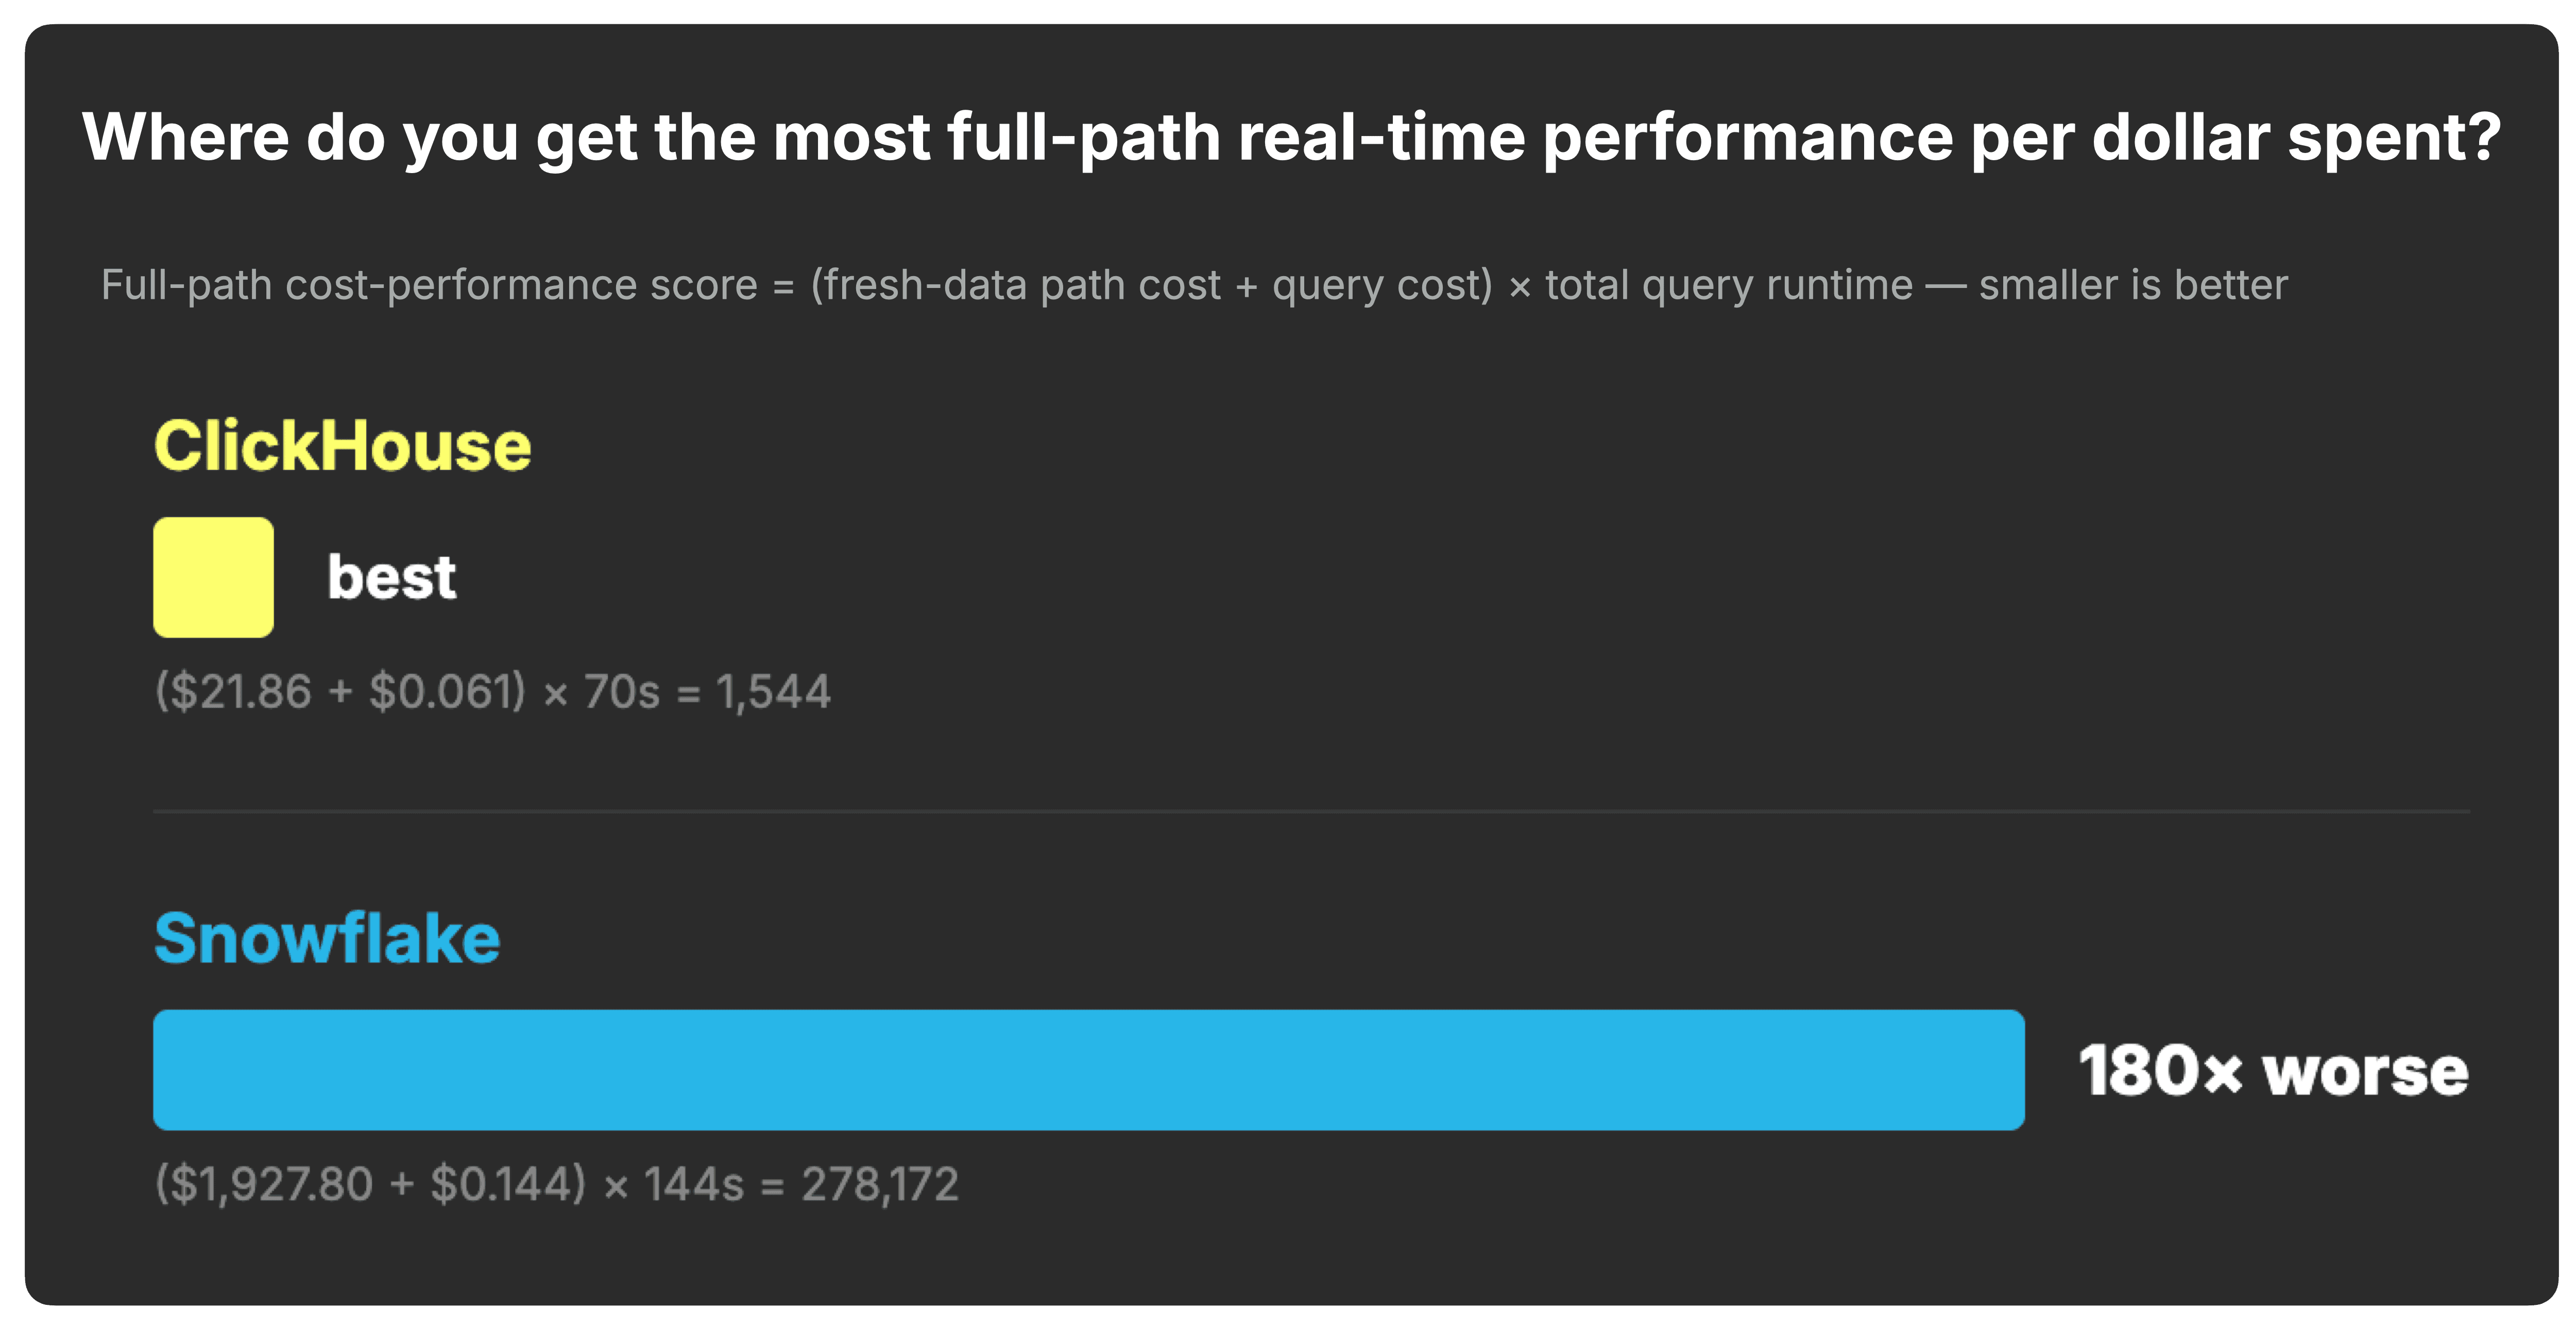
Interactive Tablesは、標準セットアップと比較してSnowflakeのスコアを大幅に改善します。
しかし、フルパスの実行維持は依然としてはるかに高価です。SnowflakeのInteractive Tablesセットアップは**180倍悪いスコア**となります。
そのギャップは重要です:
> ClickHouseユーザーは、より大きなコンピュートにより多くを支出し、Interactive Tablesのレイテンシをより大きな差で上回り、それでもなおSnowflakeの総コストを下回ることができます。
## 鮮度メカニズムが重要な理由 {#why_freshness_mechanics_matter}
上記の結果は、新しい行が到着し続ける中で各システムが派生データをどのように新鮮に保つかについて、より根本的な違いも示しています。
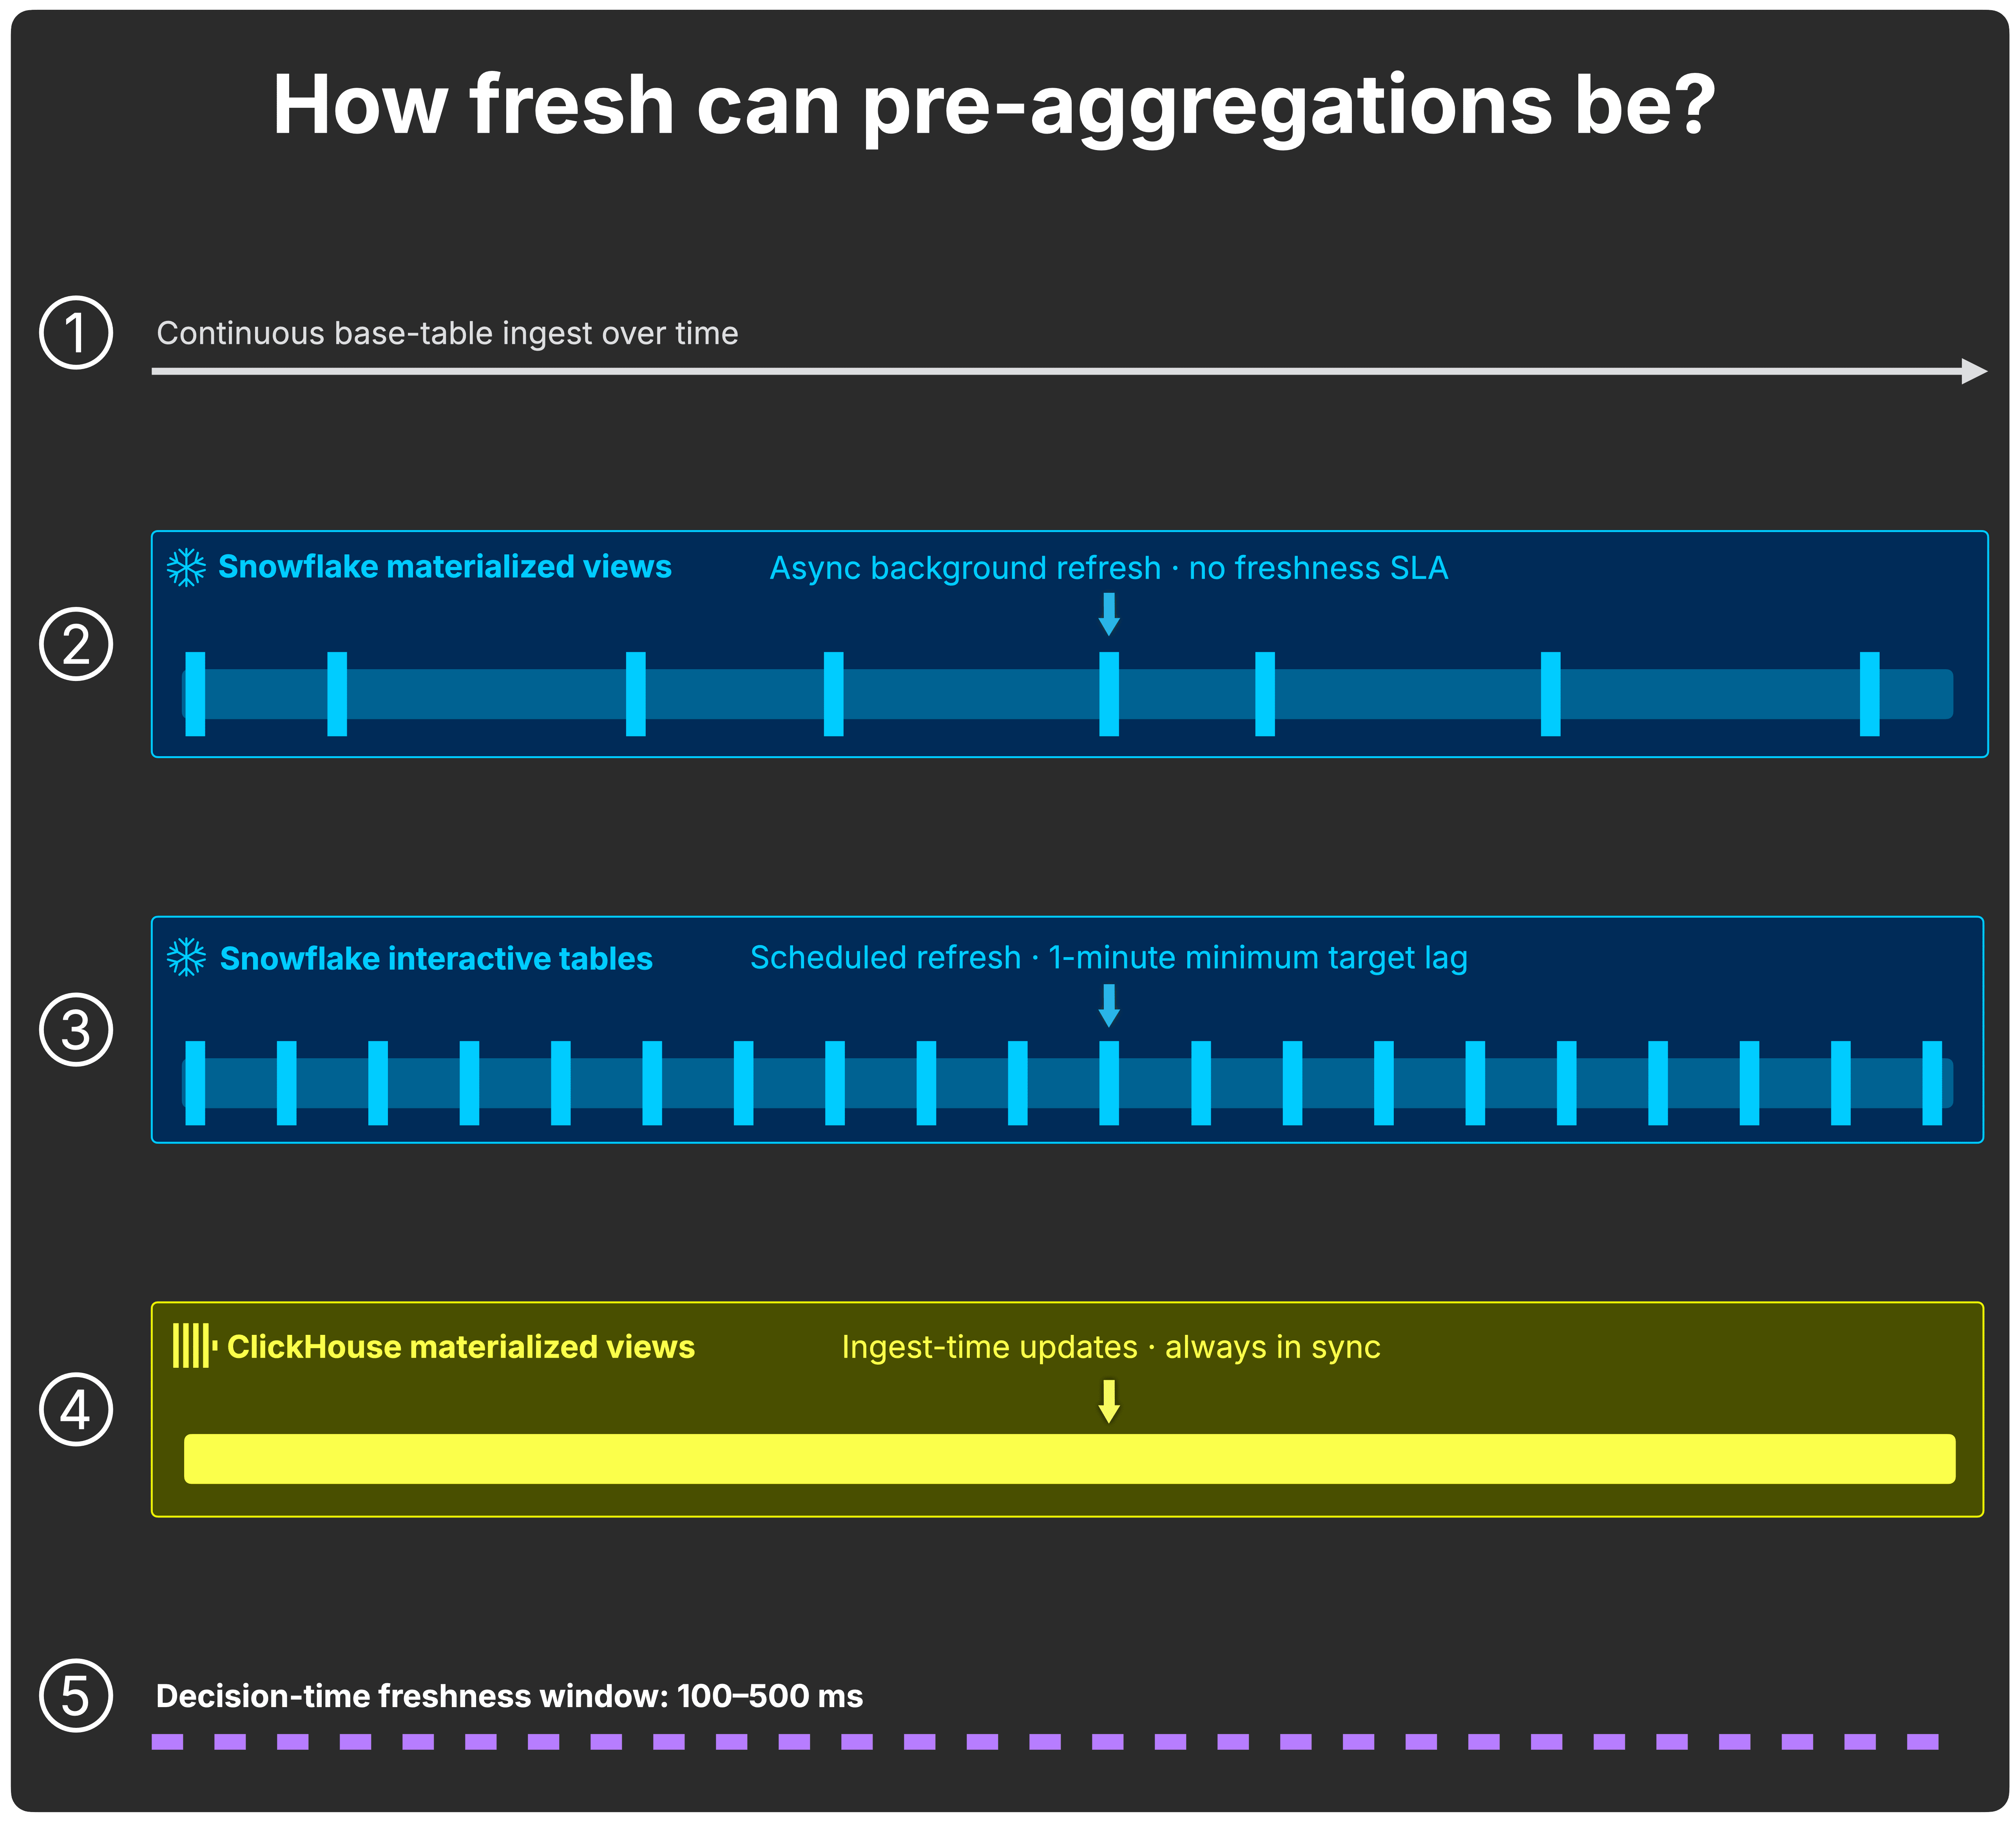
① **新鮮なデータが継続的に到着します。**
これがベンチマーク全体の出発点です。ベーステーブルは絶えず動いているため、事前集計は静的なデータセットではなくライブストリームに追従しなければなりません。
② **Snowflakeのマテリアライズドビューは非同期でリフレッシュされます。**
これは標準的なSnowflakeセットアップでまさに現れたものです。インジェストが続く間、マテリアライズドビューはベーステーブルに対して繰り返し**60〜72分遅れて**いました。Snowflakeは、クエリ時にマテリアライズドビューと生テーブルからの不足行を組み合わせることで、依然として最新のクエリ結果を返しますが、それがダッシュボードレイテンシが遅く予測不可能になった理由でもあります。
③ **Snowflake Interactive Tablesはスケジュールされたリフレッシュを使用します。**
Interactive Tablesは鮮度制御を改善しますが、依然としてスケジュールされたリフレッシュを通じて動作します。事前集計の場合、最小のターゲットラグは**1分**です。これは、リフレッシュウェアハウスが連続的な書き込みパスの一部になることを意味します。インジェスト中はそのケイデンスで実行しなければならず、各リフレッシュが次のリフレッシュの到来前に完了するようサイジングされなければなりません。それができない場合、ラグが蓄積します。テーブルが成長するにつれて、その1分のターゲットを維持することはスケーリングとコストの問題になります。
④ **ClickHouseのインクリメンタルマテリアライズドビューはインジェスト時に更新されます。**
ClickHouseは異なるパスを取ります。マテリアライズドビューは、新しいデータが挿入されると同期的に更新されます。したがって、事前集計テーブルは、別個のリフレッシュサイクルを待つことなく、ベーステーブルと整合した状態を保ちます。
⑤ **これにより、どのリアルタイムユースケースが可能かが変わります。**
ダッシュボードの場合、1分のリフレッシュターゲットは許容できるかもしれません。サブ分単位の意思決定ワークロード、特に金融サービスや不正検知など、有用な鮮度ウィンドウが数百ミリ秒で測定される場合、スケジュールされたリフレッシュはすでに遅すぎます。そうしたケースでは、鮮度がシステムがそのワークロードをそもそもサポートできるかどうかを決定します。
## ストレージフットプリント: ベンチマークの勝敗が決まる場所ではない
完全を期すため、各システムのストレージフットプリントも測定しました。
ストレージは運用上重要ですが、このベンチマークの勝敗が決まる場所ではありません。ClickHouse CloudとSnowflakeはどちらも、永続化データを低コストのオブジェクトストレージに保存します。このワークロードでは、月間ストレージ料金は、データの継続的なインジェスト、クエリ可能なレイアウトの維持、派生データのリフレッシュ、そしてクエリの提供にかかるコストと比べて小さいものです。
以下のチャートは、連続インジェストの最初の**31.4時間**後に測定したストレージフットプリントを示しています。その時点で、各システムは**100万行/秒**、すなわち約**75 MB/秒**で、およそ**1,130億行の株価相場行**をインジェストしていました。

*測定クエリ: [ClickHouse](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/clickhouse-cloud/results/storage-size-raw.md)、[Snowflake](https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/snowflake/ops/collect_storage.sh)。*
チャートは、テスト対象リージョンの現在のリストストレージ価格を使用しています。AWS US Eastで、[ClickHouse Cloudは$25.30/TB・月](https://clickhouse.com/pricing)、[Snowflakeは$23.00/TB・月](https://www.snowflake.com/en/pricing-options/)です。
**ClickHouse生データ:**
[362 GiB](https://github.com/ClickHouse/CostBench/blob/7f55e45e8f2ff45149af007d1098df87acb884f3/full-path-realtime/quotes/snowflake/results/t1/storage.json) × 2^30 / 10^12 × $25.30 = $9.83/月
**Snowflake標準生データ:**
[701 GiB](https://github.com/ClickHouse/CostBench/blob/7f55e45e8f2ff45149af007d1098df87acb884f3/full-path-realtime/quotes/snowflake/results/t1/storage.json) × 2^30 / 10^12 × $23.00 = $17.31/月
**Snowflake Interactive生データ:**
[2.9 TiB](https://github.com/ClickHouse/CostBench/blob/7f55e45e8f2ff45149af007d1098df87acb884f3/full-path-realtime/quotes/snowflake/results/t1/storage.json) × 2^40 / 10^12 × $23.00 = $74.12/月
事前集計テーブルにも同じ計算を使用します。
これは、Snowflake Interactive Tablesの注目すべきストレージ側の影響も示しています。
> 生のInteractive Tableは、Snowflake標準生テーブルの約**4.2倍**、ClickHouse生テーブルの約**8.2倍**の大きさです。
これはSnowflakeの[ドキュメント](https://docs.snowflake.com/en/user-guide/interactive#cost-and-billing-considerations)と一致します:
**「Interactive Tablesは、データエンコーディングの違いと追加のインデックスにより、同等の標準テーブルよりも大きくなる場合があります。」**
同じインジェストレートが730時間のフルマンス続いた場合、月末のストレージフットプリントはおおよそ次のようにスケールします:
| データパス | 31.4時間後 | そのサイズでのコスト | 730時間後の予測 | 予測サイズでのコスト |
|---|---:|---:|---:|---:|
| ClickHouse生データ | 362 GiB | $9.83/月 | ~8.2 TiB | ~$229/月 |
| Snowflake標準生データ | 701 GiB | $17.31/月 | ~15.9 TiB | ~$402/月 |
| Snowflake Interactive生データ | 2.9 TiB | $74.12/月 | ~67.4 TiB | ~$1,724/月 |
Interactive Tableのストレージサイズが線形に増加するかどうかは分かりません。ここでは線形に増加すると仮定しているだけです。
それでも、絶対的なストレージコストは、CostBenchで測定されたコンピュートおよびリフレッシュコストと比べると小さいままです。フルパスのコスト性能ギャップは、稼働中のシステム、すなわちインジェストコンピュート、クラスタリングまたはリフレッシュ作業、そして新鮮なデータが到着し続ける中でのクエリ実行によって左右されます。
## 展望: さらなるパスとより重いワークロード {#outlook_more_paths_and_heavier_workloads}
CostBenchは、さまざまなシステム設計の下でリアルタイム分析のフルパスをテストするためのフレームワークです。
### マネージドインジェストパス {#managed_ingest_paths}
次にテストしたいバリアントは、Snowflakeのマネージドインジェストパスです。ここでは、Snowpipe Streamingが生データのInteractive Tableに直接書き込むことができますが、[事前集計データを直接維持することはできません](https://docs.snowflake.com/en/user-guide/snowpipe-streaming/snowpipe-streaming-table-support#insert-only-operations)。
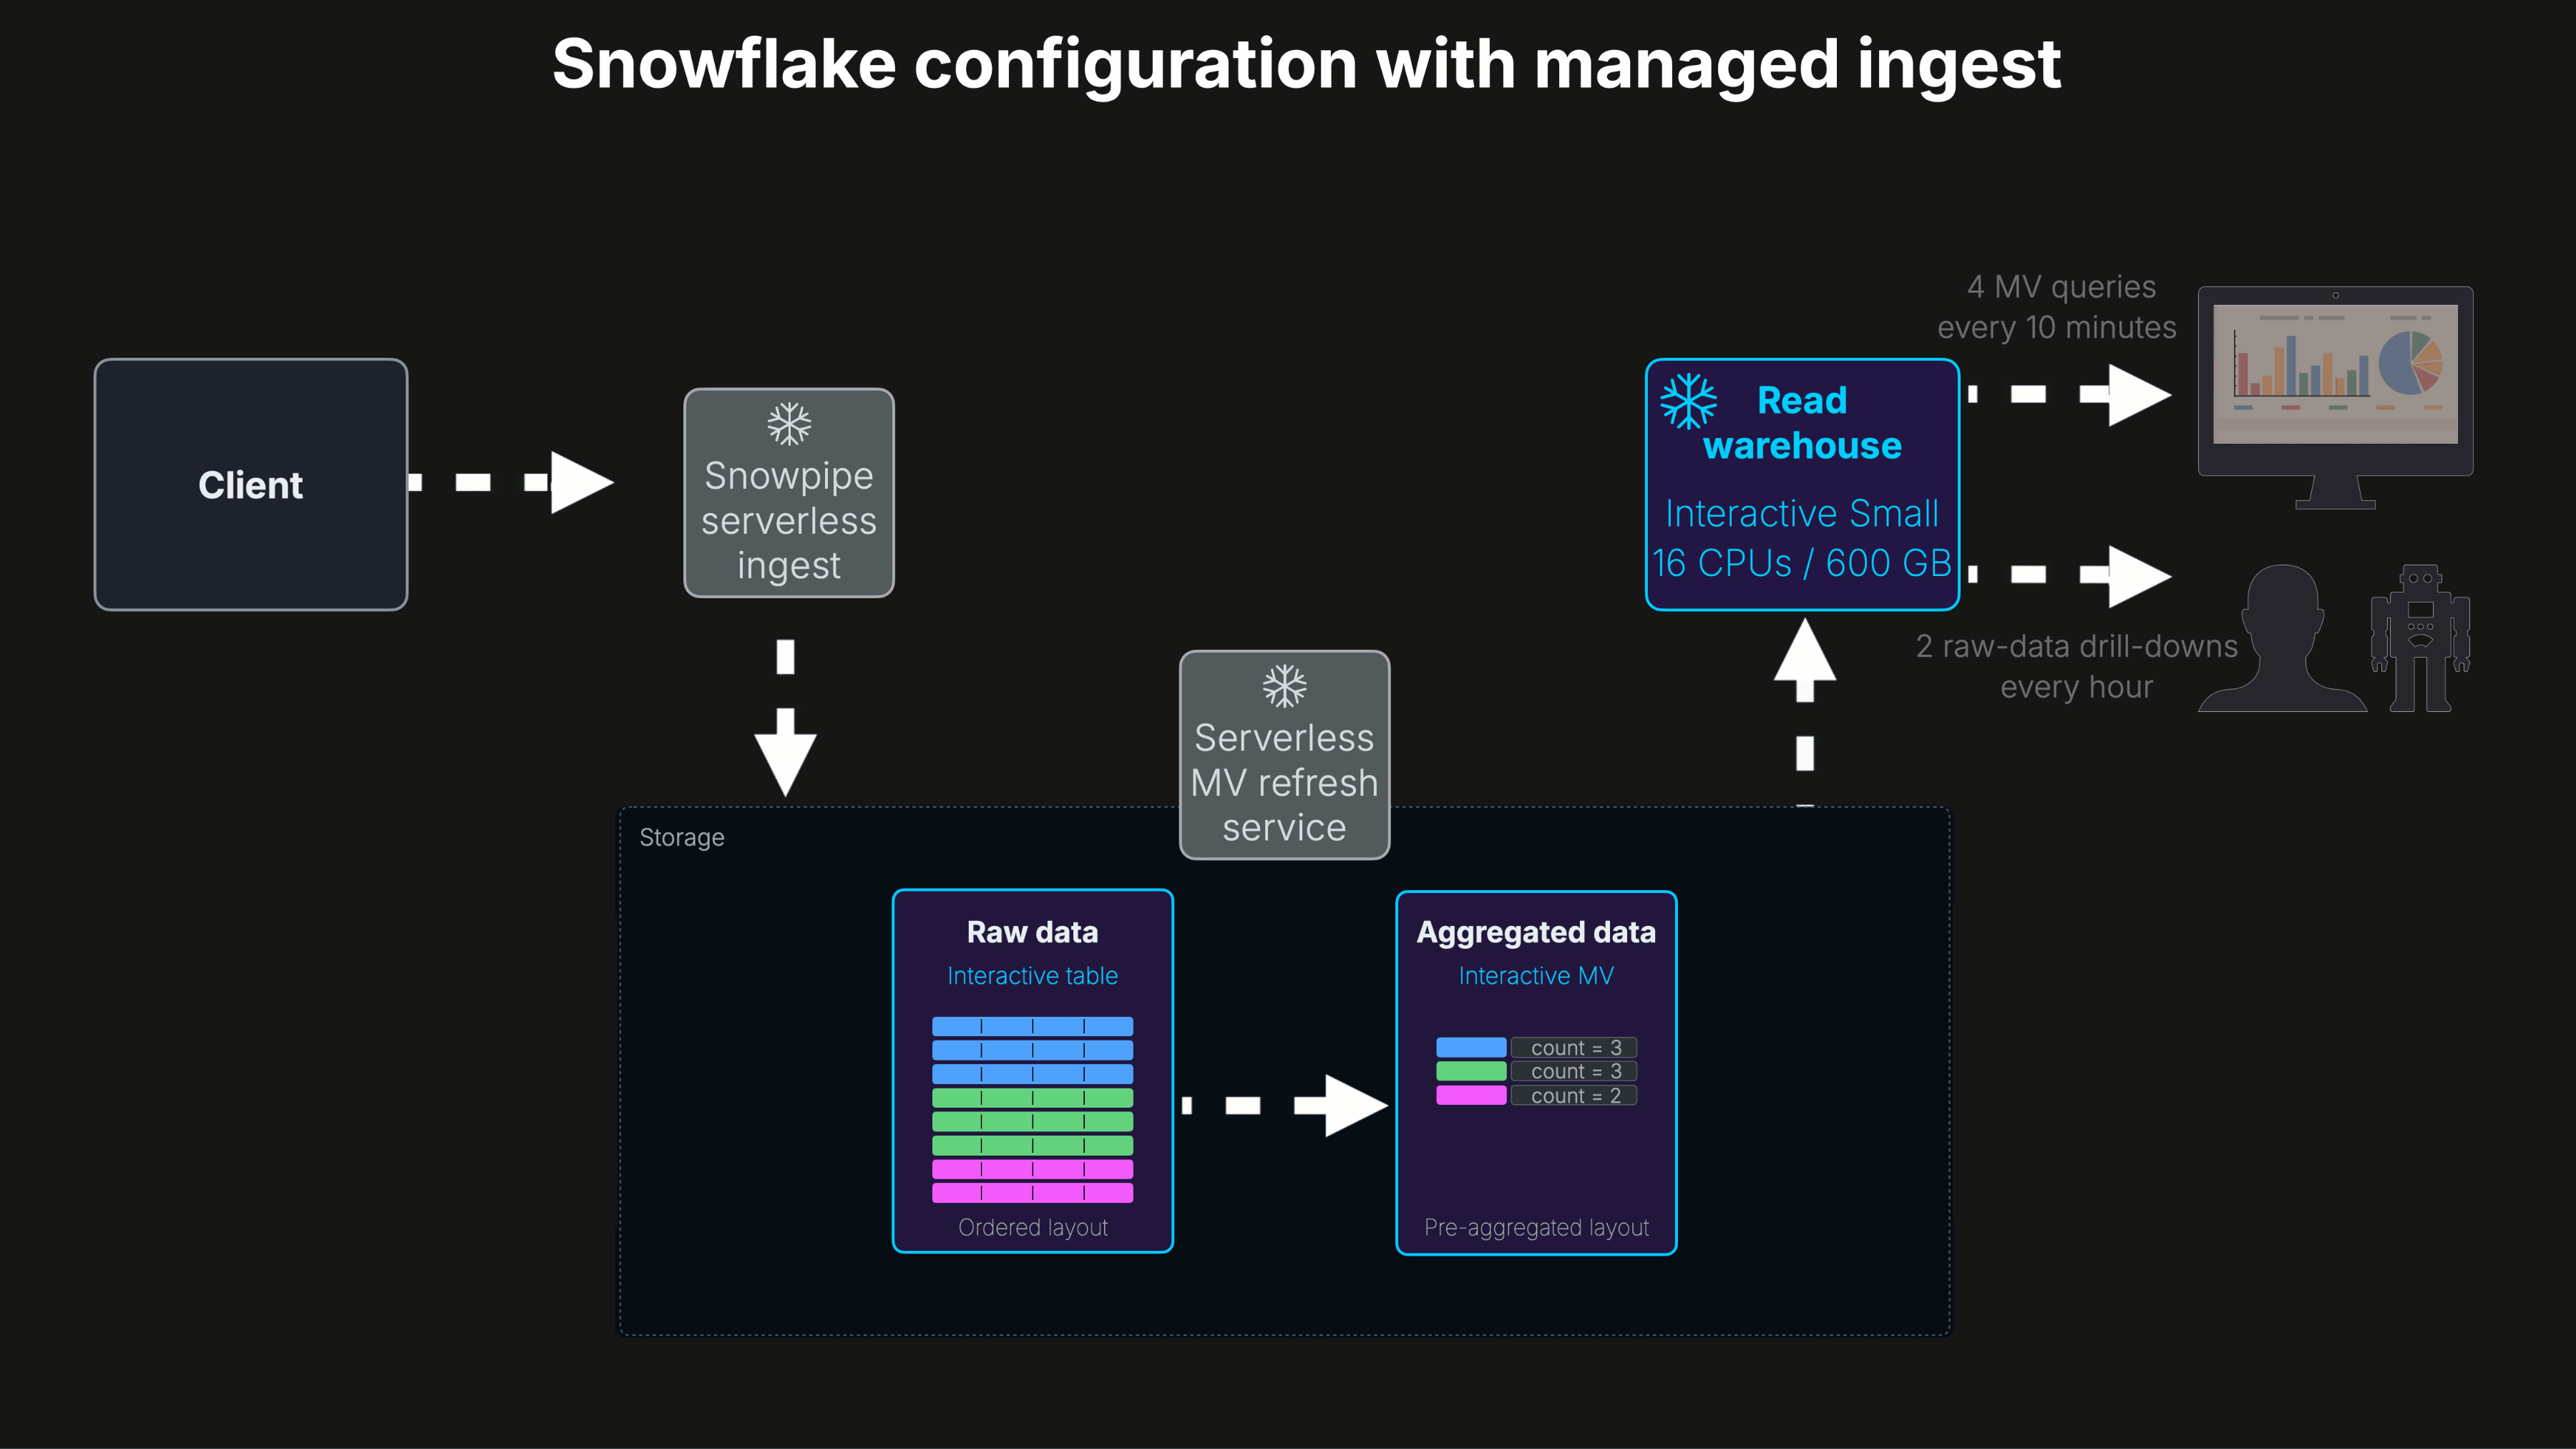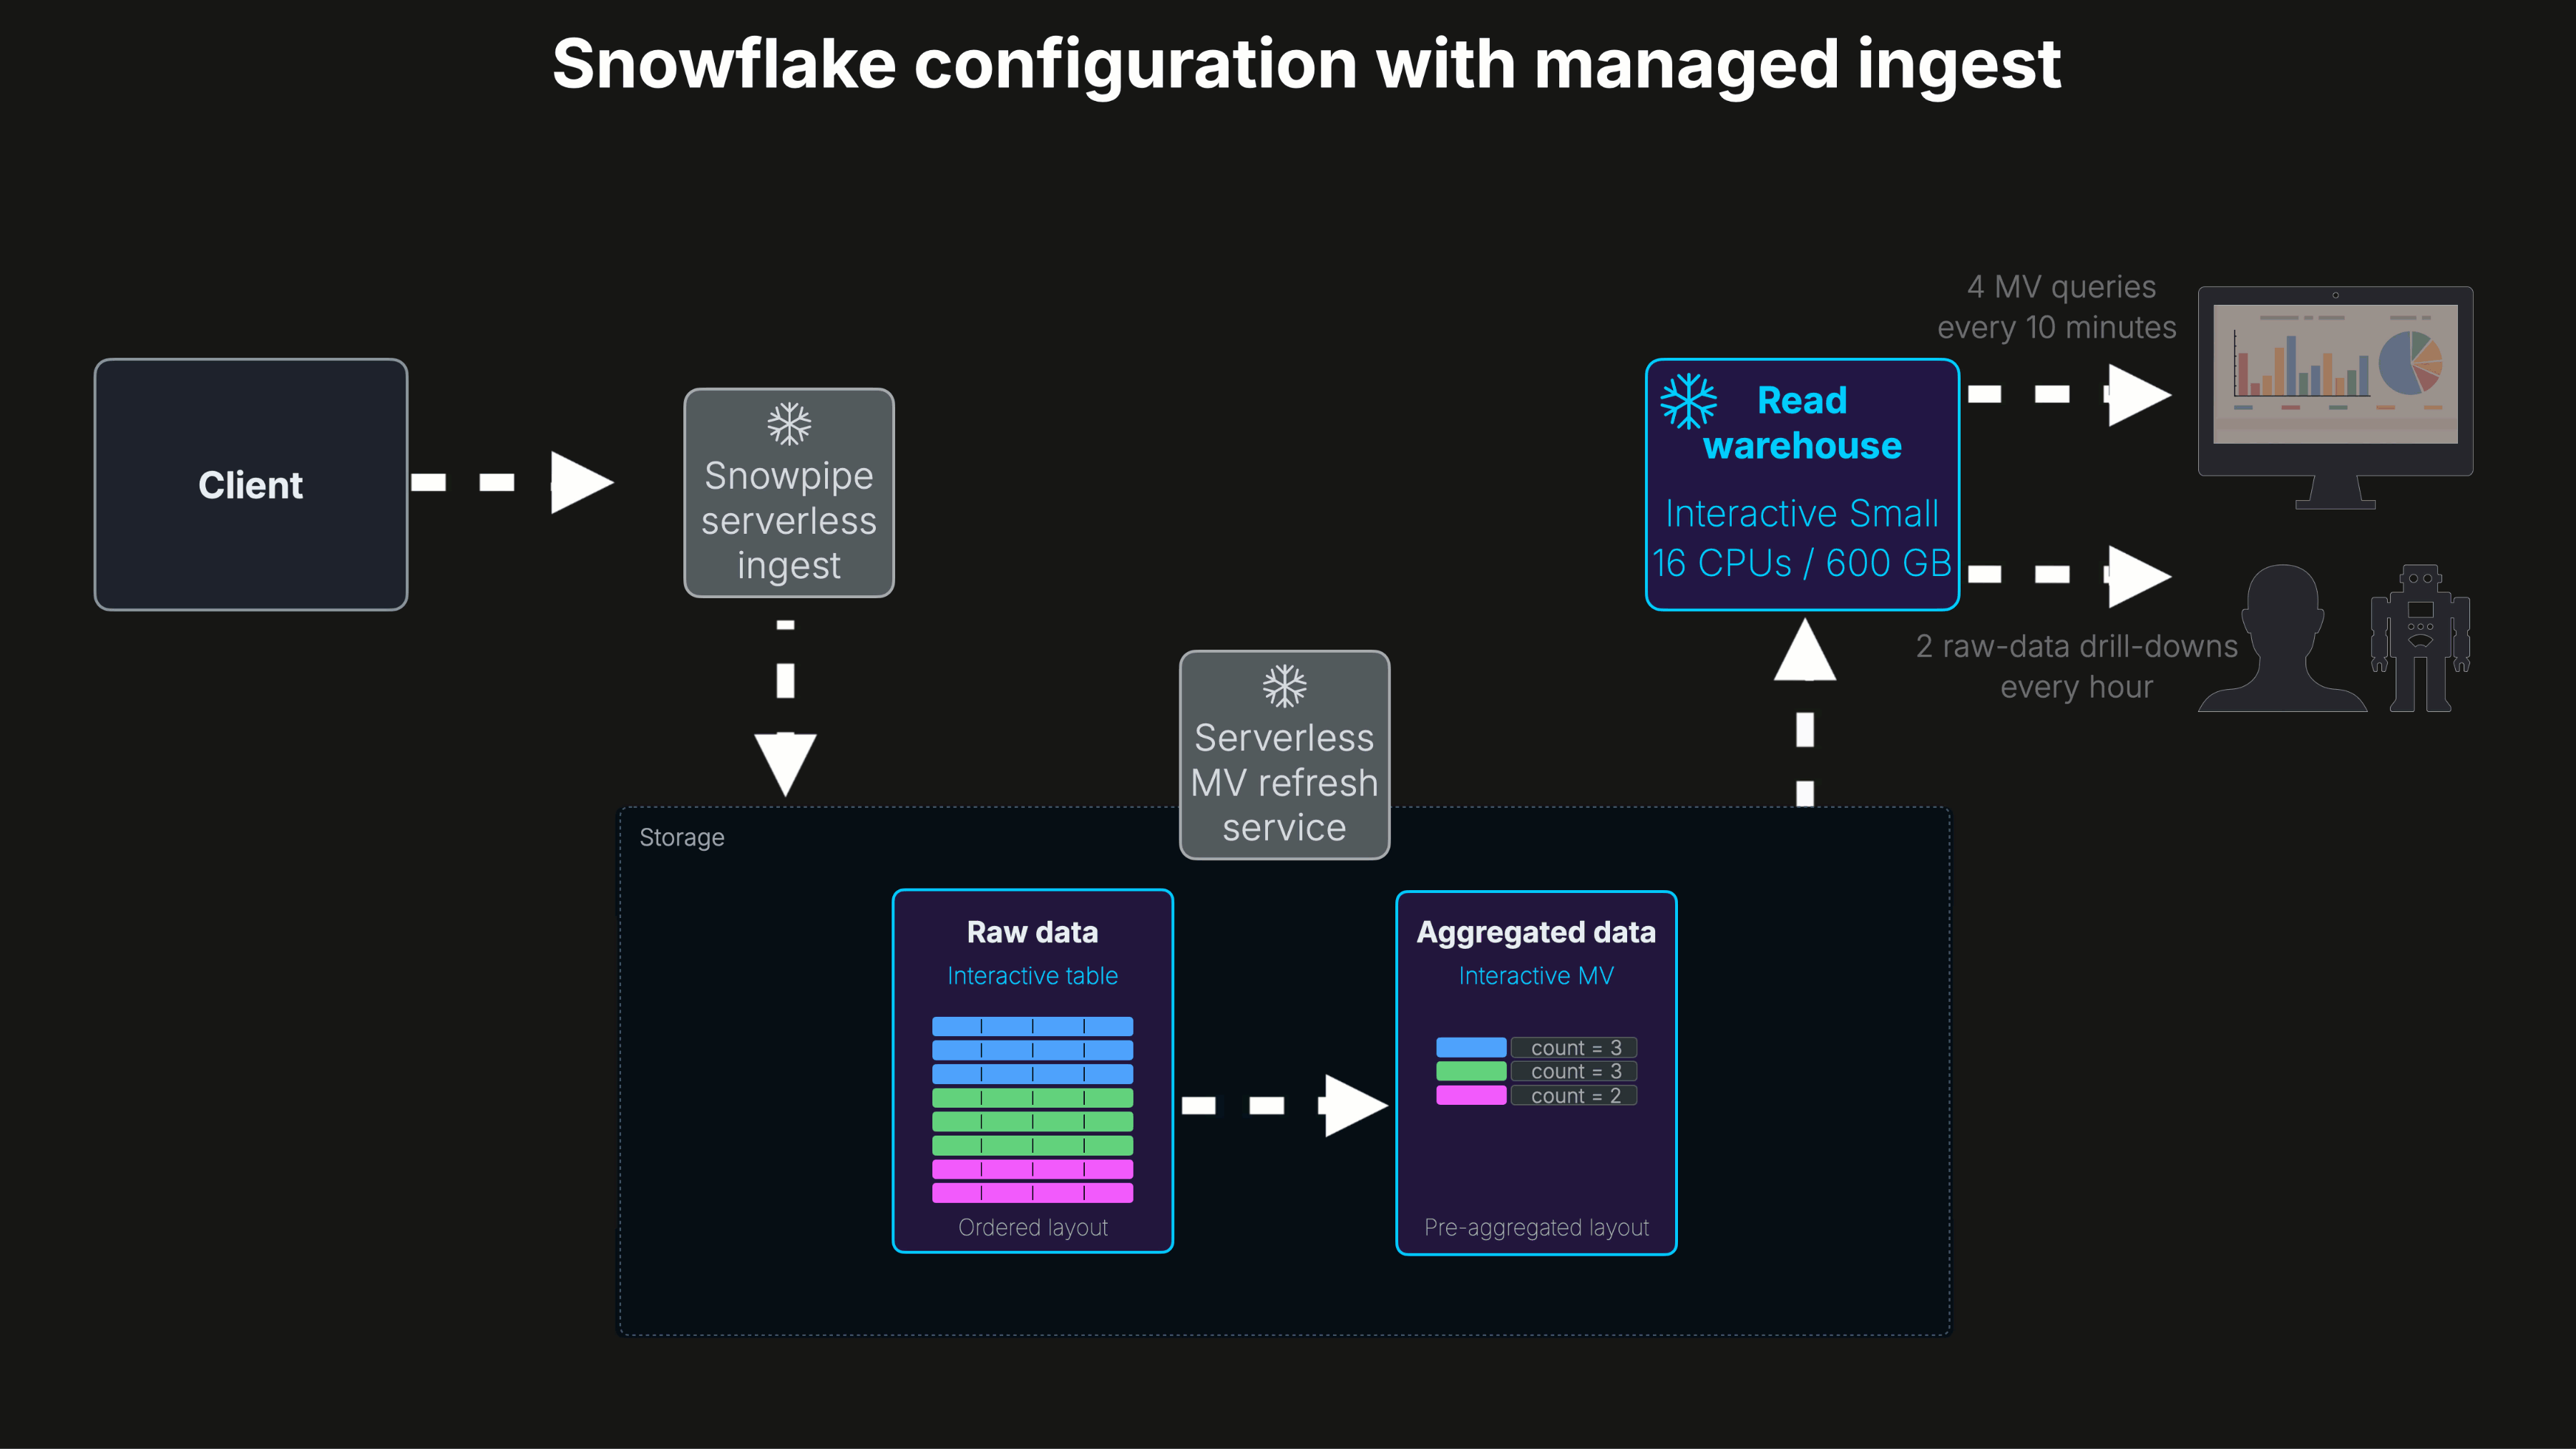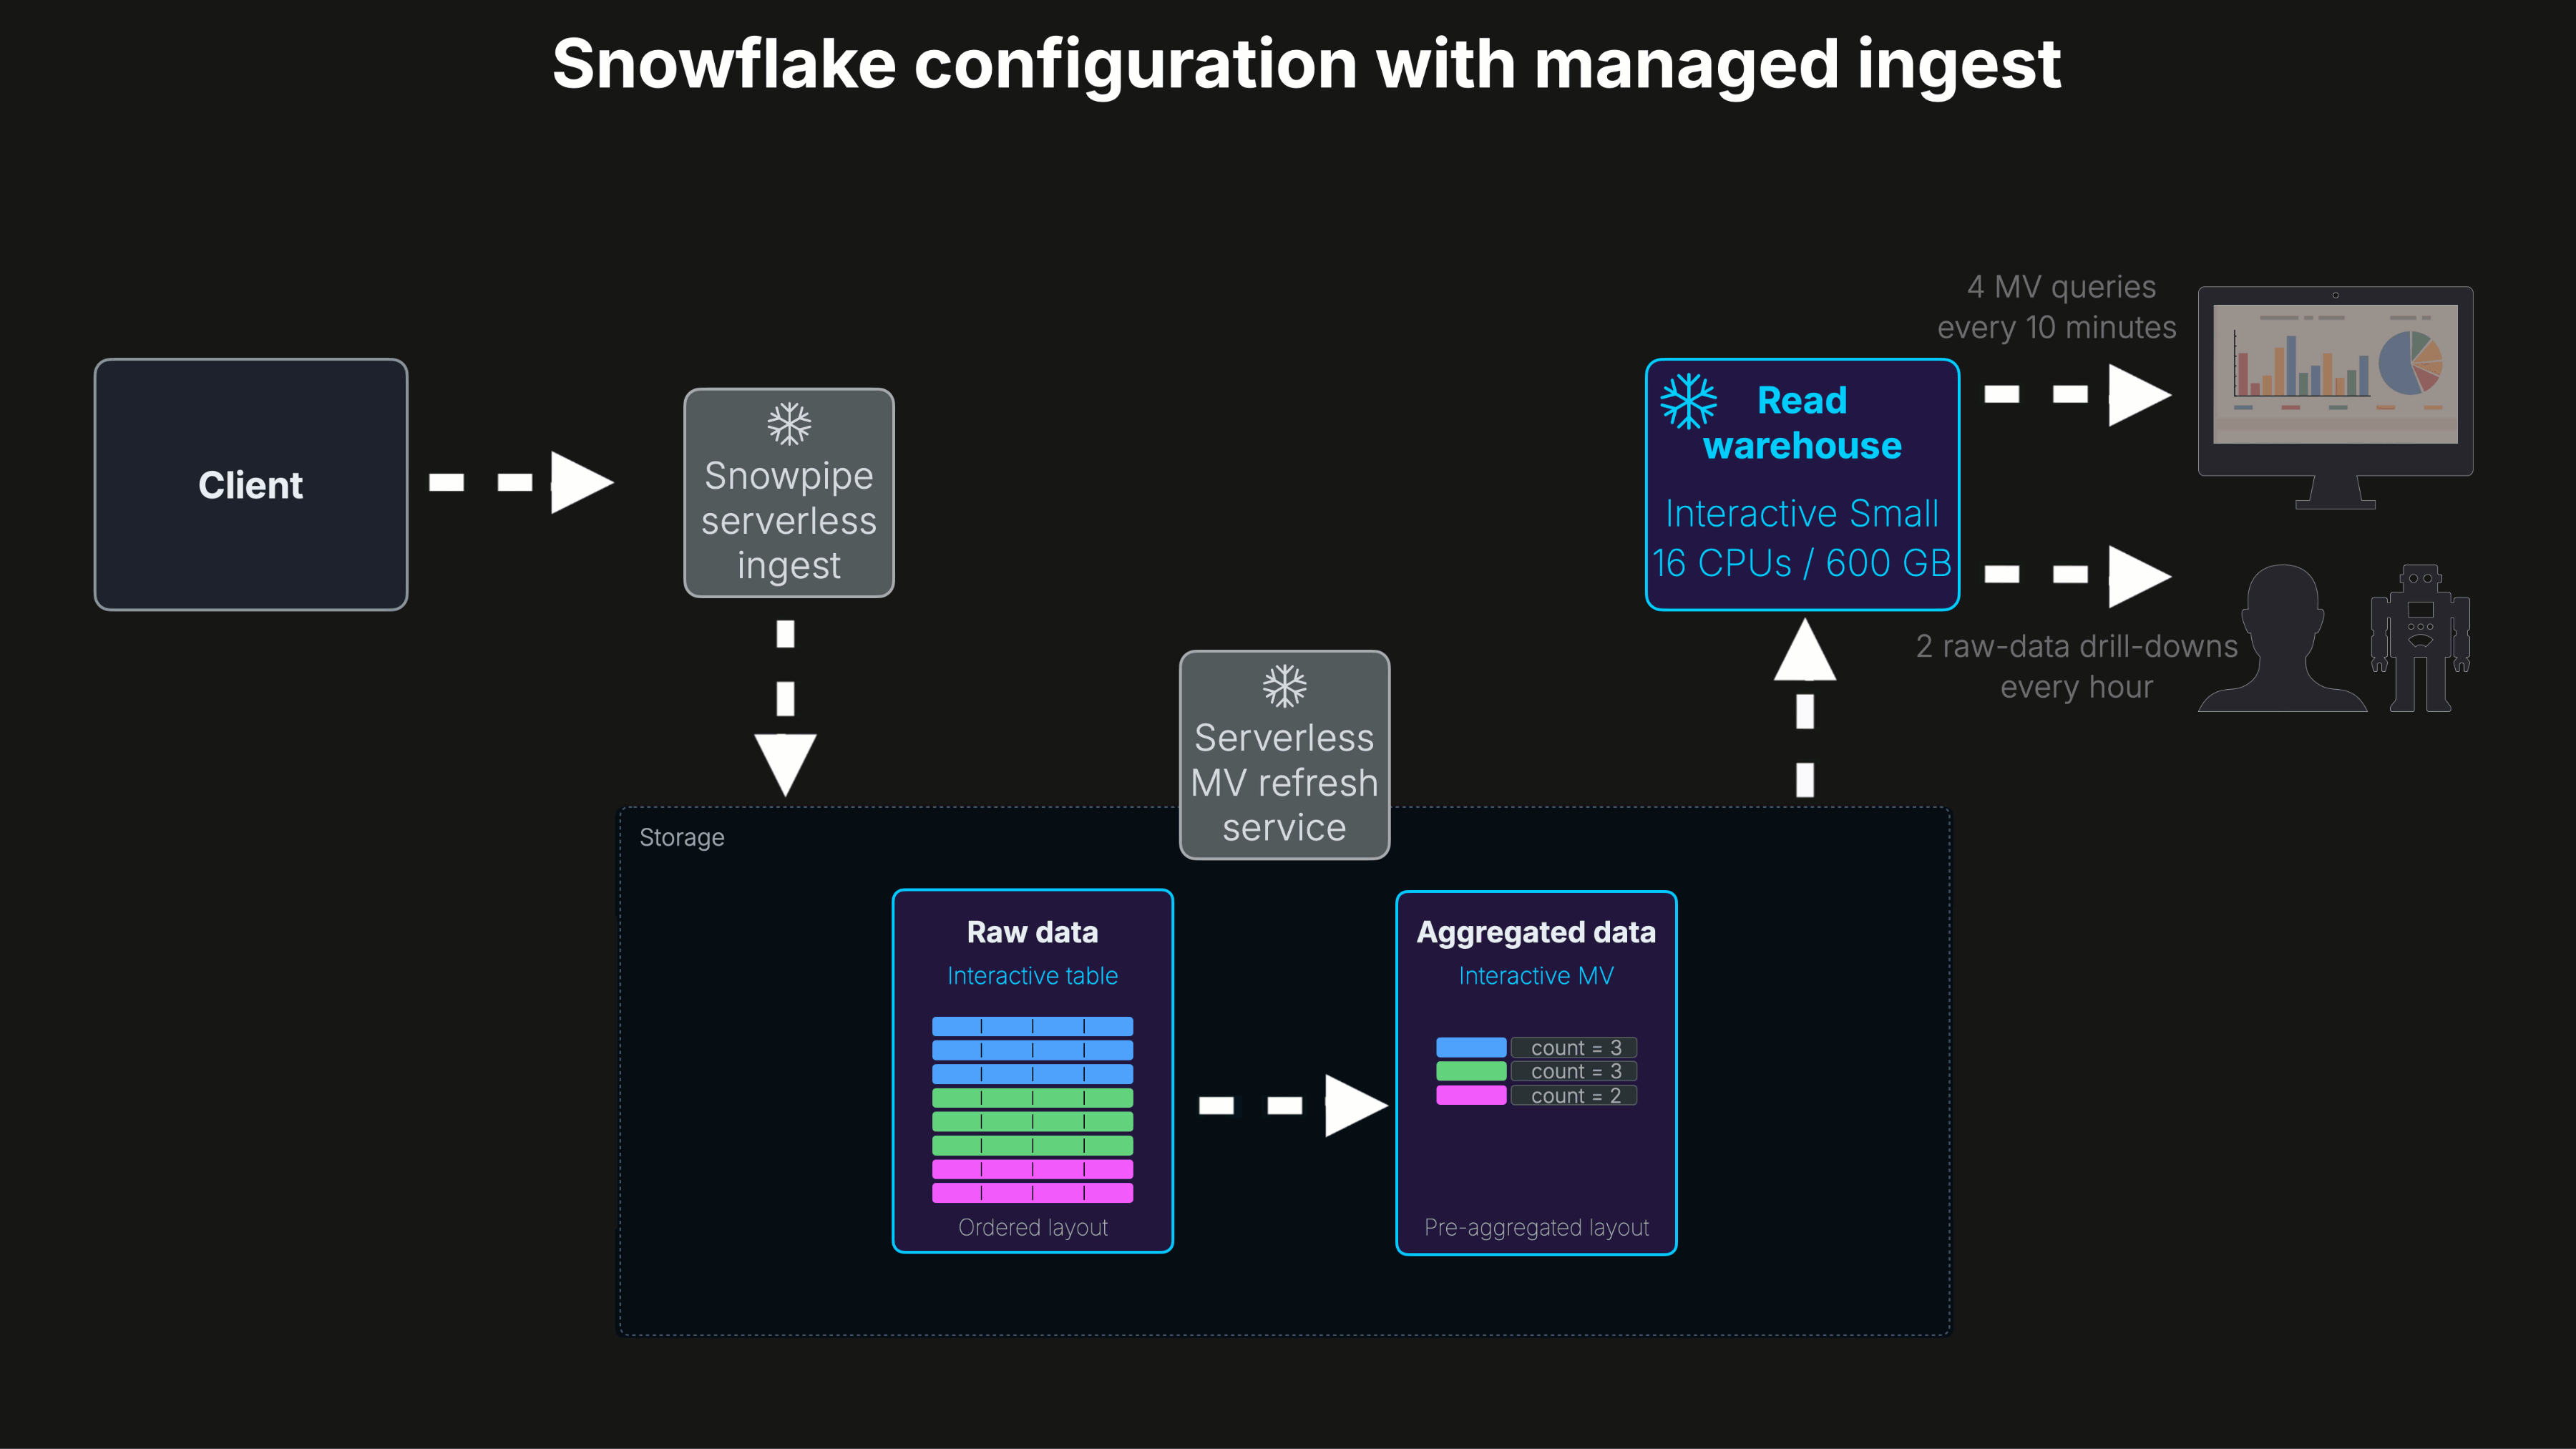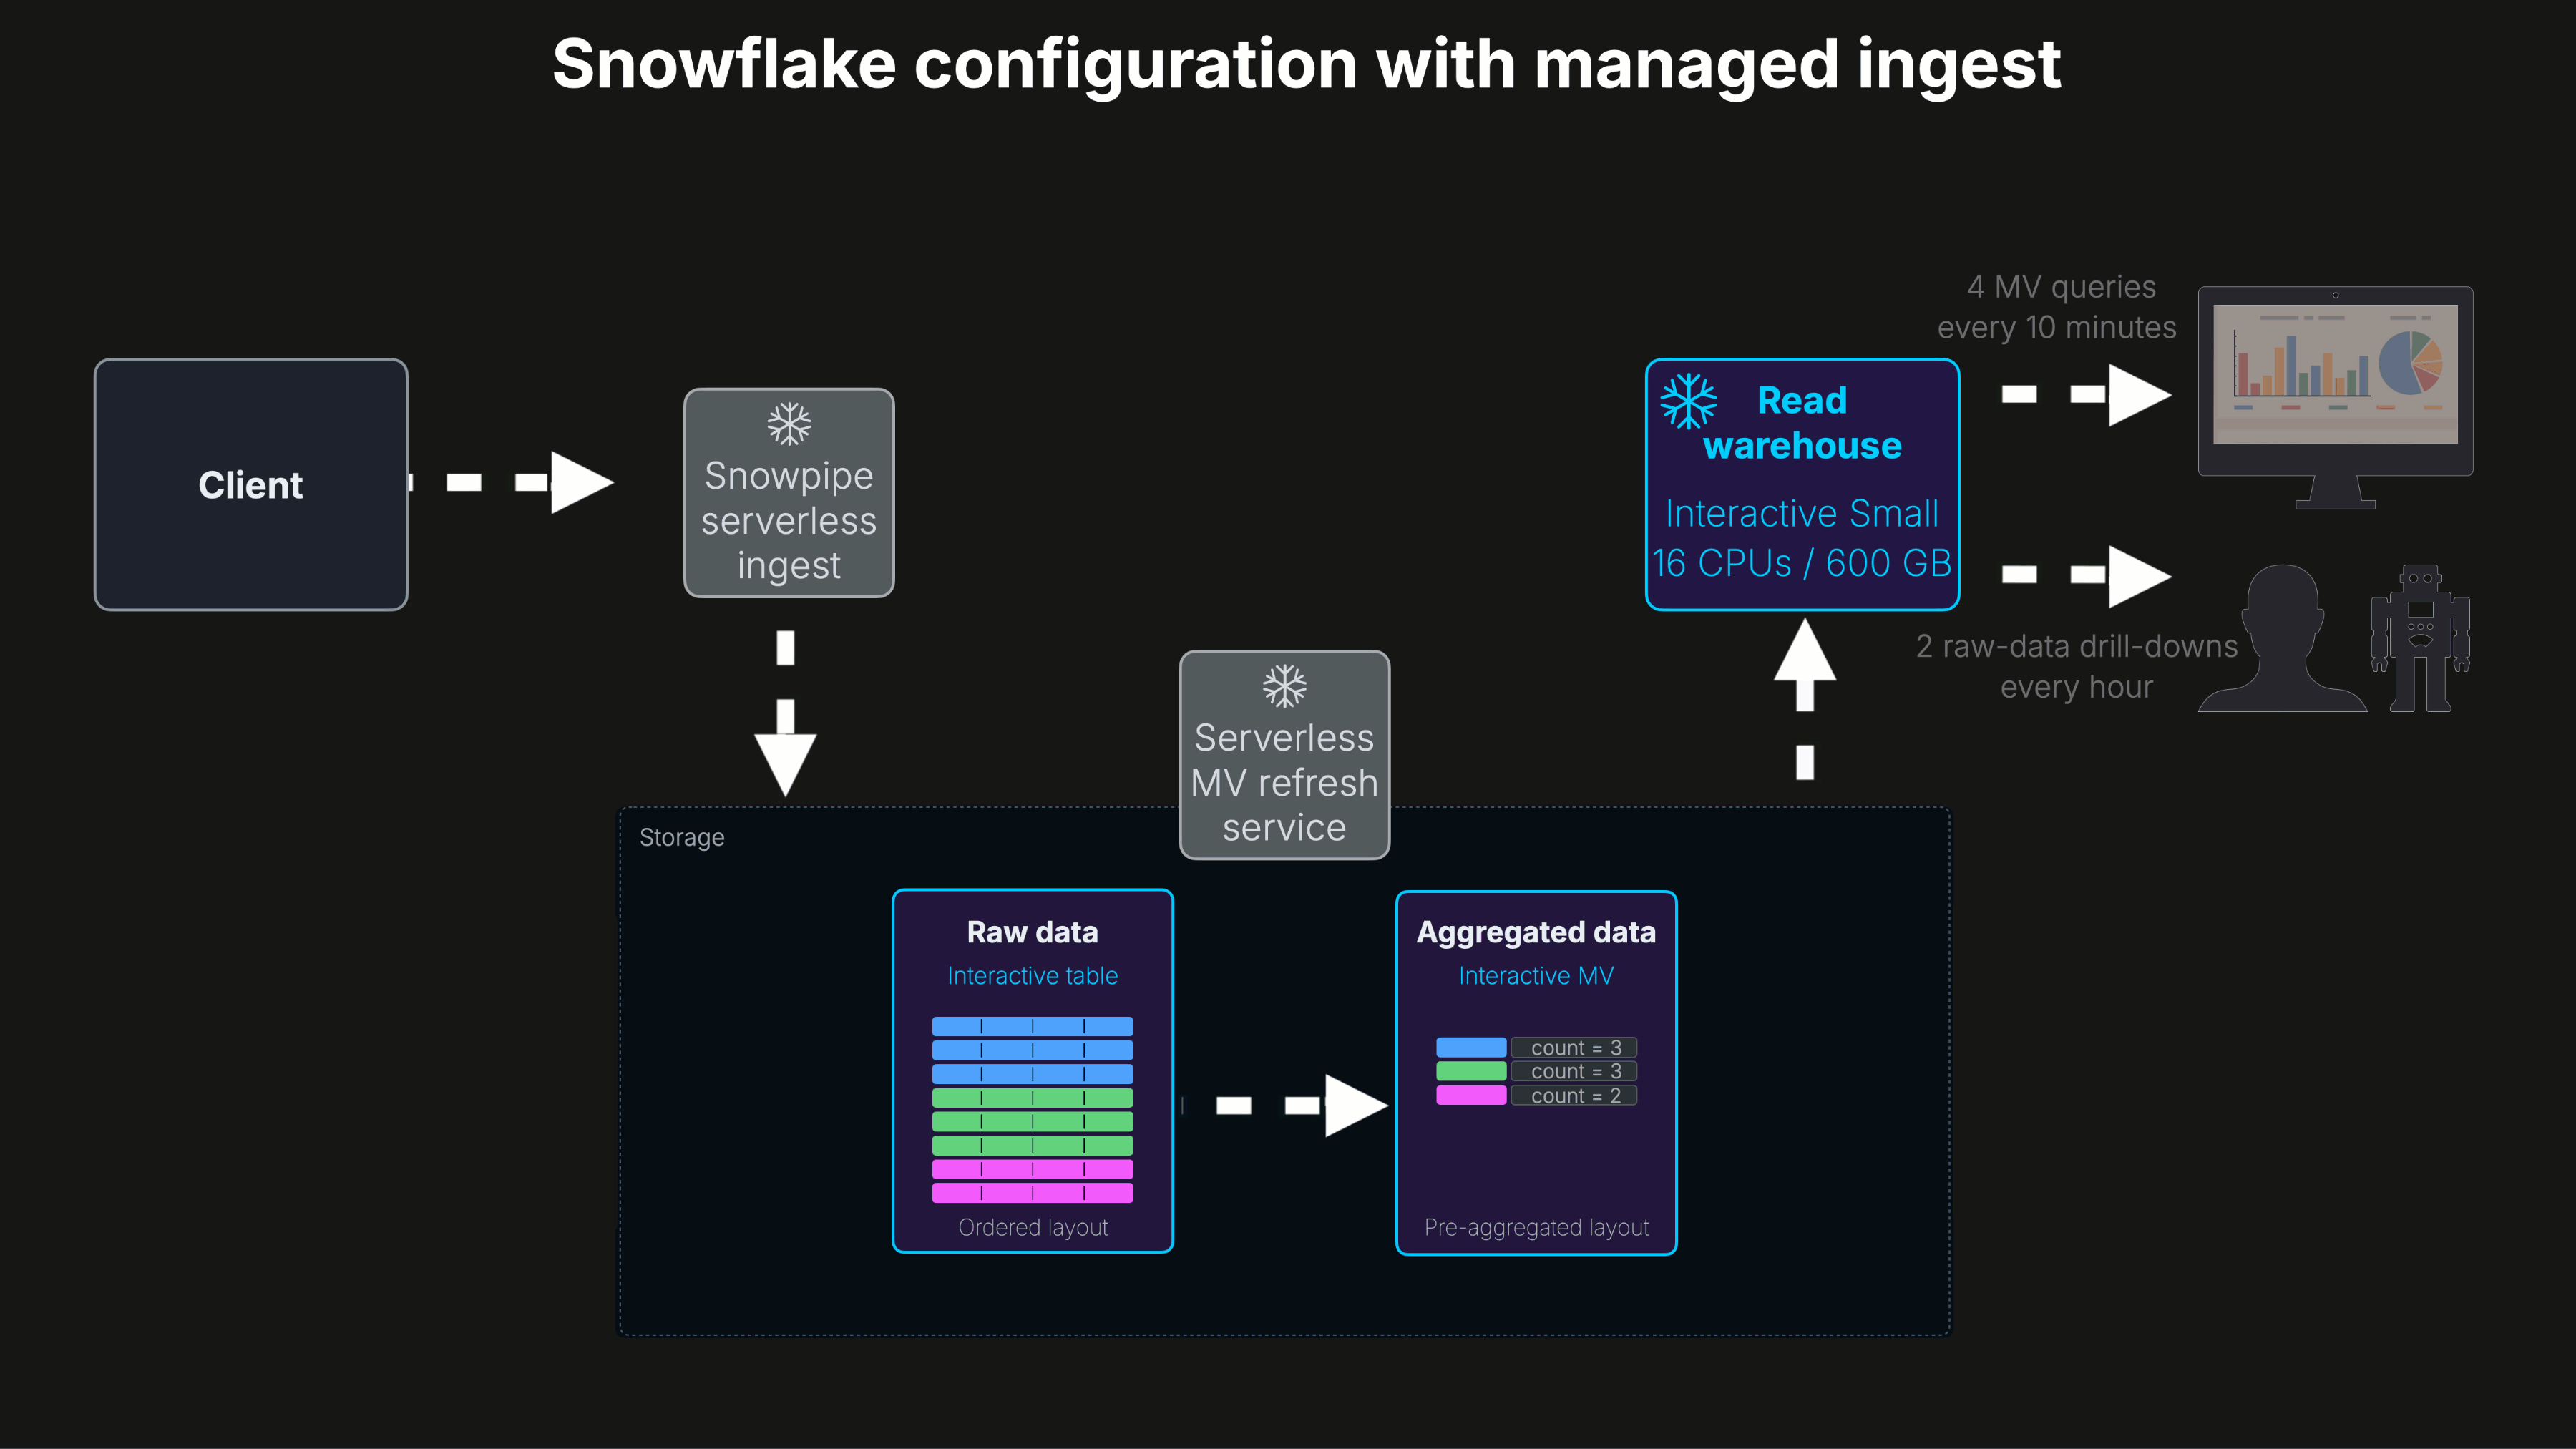
比較対象となるClickHouseのパスは[ClickPipes](https://clickhouse.com/cloud/clickpipes)です。
これにより、このベンチマークで使用した軽量クライアントがデータを直接書き込むことなく、両サイドでマネージドインジェストを比較できるようになります。
### より高いクエリ同時実行性 {#higher_query_concurrency}
同じフレームワークを使用して、読み取り側にさらに負荷をかけ、クエリワークロードを独立してスケールさせ、新鮮なデータが到着し続ける中でより高い同時実行性をテストする予定です。
### より重いリアルタイムデータセット {#heavier_realtime_datasets}
冒頭で述べたように、この実行は意図的にスペクトラムの容易な端から始めました。すなわち、小さく狭いデータセット、シンプルなソートキー、そしてSnowflakeに有利な到着パターンです。
次は、スペクトラムのもう一方の端でテストを繰り返します。すなわち、ClickHouseのリアルタイム分析ワークロードで一般的な形状を持つ、はるかに広く重いデータセットです。
これにより、スペクトラムの両側が示されます。Snowflakeに最良の機会を与えるクリーンなケースと、ClickHouseが真価を発揮するよう設計された重いケースです。
そしてもちろん、Snowflakeがテストすべきと考える他のセットアップも歓迎します。フレームワークは柔軟です。重要なのは、比較がフルパスであり続けることです。
## 結論: フルパスが答えを変える {#conclusion_the_full_path_changes_the_answer}
Snowflakeの応答は、問いを鋭くするのに役立ちました。提案の多くは有効な最適化でした。クラスタリングの簡素化、読み取りのInteractive Tablesへの移行、あるいはリフレッシュパスのチューニングです。
しかし、リアルタイムシステムはフルパスのシステムです。1つのステージを改善すると、コストが別の場所に移動することがあります。より高速な読み取りにはより多くのリフレッシュコンピュートが必要になり、より新鮮な事前集計には連続稼働するリフレッシュウェアハウスが必要になり、より優れた物理編成にはメンテナンス作業の増加が伴います。
そこで、私たちはパス全体を測定しました。
いくつかの結果は改善しました。Interactive Tablesは、標準的なマテリアライズドビューセットアップよりもSnowflakeの読み取りをはるかに高速にしました。しかし、フルパス、すなわちインジェスト、物理編成、事前集計の鮮度、リフレッシュコスト、そして連続クエリ提供を測定すると、トレードオフがより明確になりました。
元のクエリ可能データベンチマークでは、ClickHouseはSnowflakeよりも**28倍優れた**書き込み側コスト性能を実現しました。この拡張ベンチマークでは、ClickHouseはSnowflakeの標準マテリアライズドビューセットアップよりも**969倍優れた**コスト性能を、そしてSnowflakeのInteractive Tablesセットアップよりも**180倍優れた**コスト性能を実現しました。
これが主要な要点です。すなわち、[リアルタイム分析は単にクエリを高速にすることだけではなく](https://clickhouse.com/blog/selecting-a-real-time-analytical-database)、新鮮なデータをクエリ可能な状態に保ち、派生データを新鮮に保ち、そしてリフレッシュを支配的なコストにすることなく低レイテンシクエリを継続的に提供することなのです。
サブ分単位の意思決定ワークロードでは、鮮度モデルはさらに重要です。テストしたパスの中で、ClickHouseのインクリメンタルマテリアライズドビューだけが、いかなるラグもなく事前集計をベーステーブルと継続的に同期した状態に保ちます。
> ClickHouseは、フルパスにわたるコスト効率の高いリアルタイム分析のために構築されています。MergeTreeテーブルは生データを順序付けられたクエリ可能な状態に保ちます。AggregatingMergeTreeテーブルは、リフレッシュギャップなしに事前集計を新鮮に保ちます。そしてクエリエンジンは、データが成長してもレイテンシを低く保ちます。
最新の[移行事例](https://clickhouse.com/blog/appcues-customer-engagement-analytics)は、本番環境で同じフルパスの効率性を示しています。Appcuesは、リアルタイムの顧客向け分析をSnowflakeからClickHouse Cloudに移行しました。**1.31 PBのデータと4,100億イベント**にわたってです。P95クエリレイテンシは20秒以上から2秒未満に低下し、インジェストレイテンシは10分以上から約5秒に低下し、そして新しいワークロードが追加されてもなお分析支出は減少しました。
これがCostBenchが評価するために設計されたパスです。私たちは、より多くのシステム、より多くのインジェストパス、より重いデータセット、そしてより高い同時実行性のテストを続けていきます。今後もご期待ください。