---
title: "ClickHouse Cloudにマルチステージ分散クエリ実行を導入"
date: "2026-06-11T00:47:14.324Z"
author: "Alexander Gololobov"
category: "Engineering"
excerpt: "ClickHouse Cloudは、マルチステージ分散クエリ実行を導入しました。これは、単一のクエリを多数のノードにわたってスケールさせ、大規模なJOINや高カーディナリティの集計を高速化するための新たな基盤です。"
---
# ClickHouse Cloudにマルチステージ分散クエリ実行を導入
> **TL;DR**
マルチステージ分散実行により、ClickHouse Cloud は単一のクエリを多数のノードにわたってスケールさせる新しい手段を獲得しました。ステージ間で中間データを再パーティション化することで、大規模な JOIN や高カーディナリティな集計におけるボトルネックを解消します。
初期の TPC-H 結果では、JOIN を多用するクエリで最大 3.4 倍の高速化を示しつつ、集計処理ではほぼ線形のスケーリングを維持しました。8 ノードでは 1 ノードと比べて 7.4 倍の高速化を達成しています。
## 単一クエリを複数ノードでスケールさせる
ClickHouse は以前から、単一のクエリを複数のノードでスケールさせる機能を備えていました。シェアードナッシング構成では、ユーザーは物理的なシャーディングと `Distributed` テーブルエンジンを使ってこれを実現します。ClickHouse Cloud では、parallel replicas が共有ストレージにおけるクエリ内スケーリングをもたらしました。
これらの仕組みは多くの分析クエリで十分に機能しますが、現代の PB スケールのワークロードに対する最終解ではありませんでした。ノード間で処理をファンアウトすることはできても、実行ステージ間で中間結果を自由に再パーティション化することはできなかったのです。これが、ClickHouse における高カーディナリティ集計、とりわけ大規模 JOIN のスケーラビリティに制約を与えていました。
マルチステージ分散クエリ実行は、その次のステップです。従来の実行モデルが抱えていたボトルネックを排除し、ClickHouse Cloud で利用可能なすべてのノードの CPU とメモリを使って単一クエリを並列化する新しい手段を提供します。
本投稿では、ClickHouse のクエリ実行モデルに加わったこの新しい拡張を紹介し、その仕組みを順を追って説明します。例として、マルチテーブル JOIN を取り上げます。JOIN は分析ワークロードの中でも特にスケールが難しい処理ですが、本機能はそれにとどまらず、ClickHouse Cloud の分散クエリ実行に向けた新たな基盤となるものです。
新しい仕組みを見る前に、これまでのアプローチと、それが現代の PB スケールワークロードでなぜ不十分だったのかを振り返ってみましょう。
## 既存の分散実行が不十分だった理由
既存の分散実行は有用ではあったものの、PB スケールワークロードに対して十分な弾力性を備えていませんでした。
シェアードナッシングのオープンソース構成では、ClickHouse はデータをノード間で物理的に[シャーディング](https://clickhouse.com/docs/shards)し、[Distributed テーブル](https://clickhouse.com/docs/engines/table-engines/special/distributed)を通じてそれらのシャードに対してクエリを実行することでスケーリングを行います。各ノードは自身のローカルスライスを処理し、リクエスト元が結果をマージします。
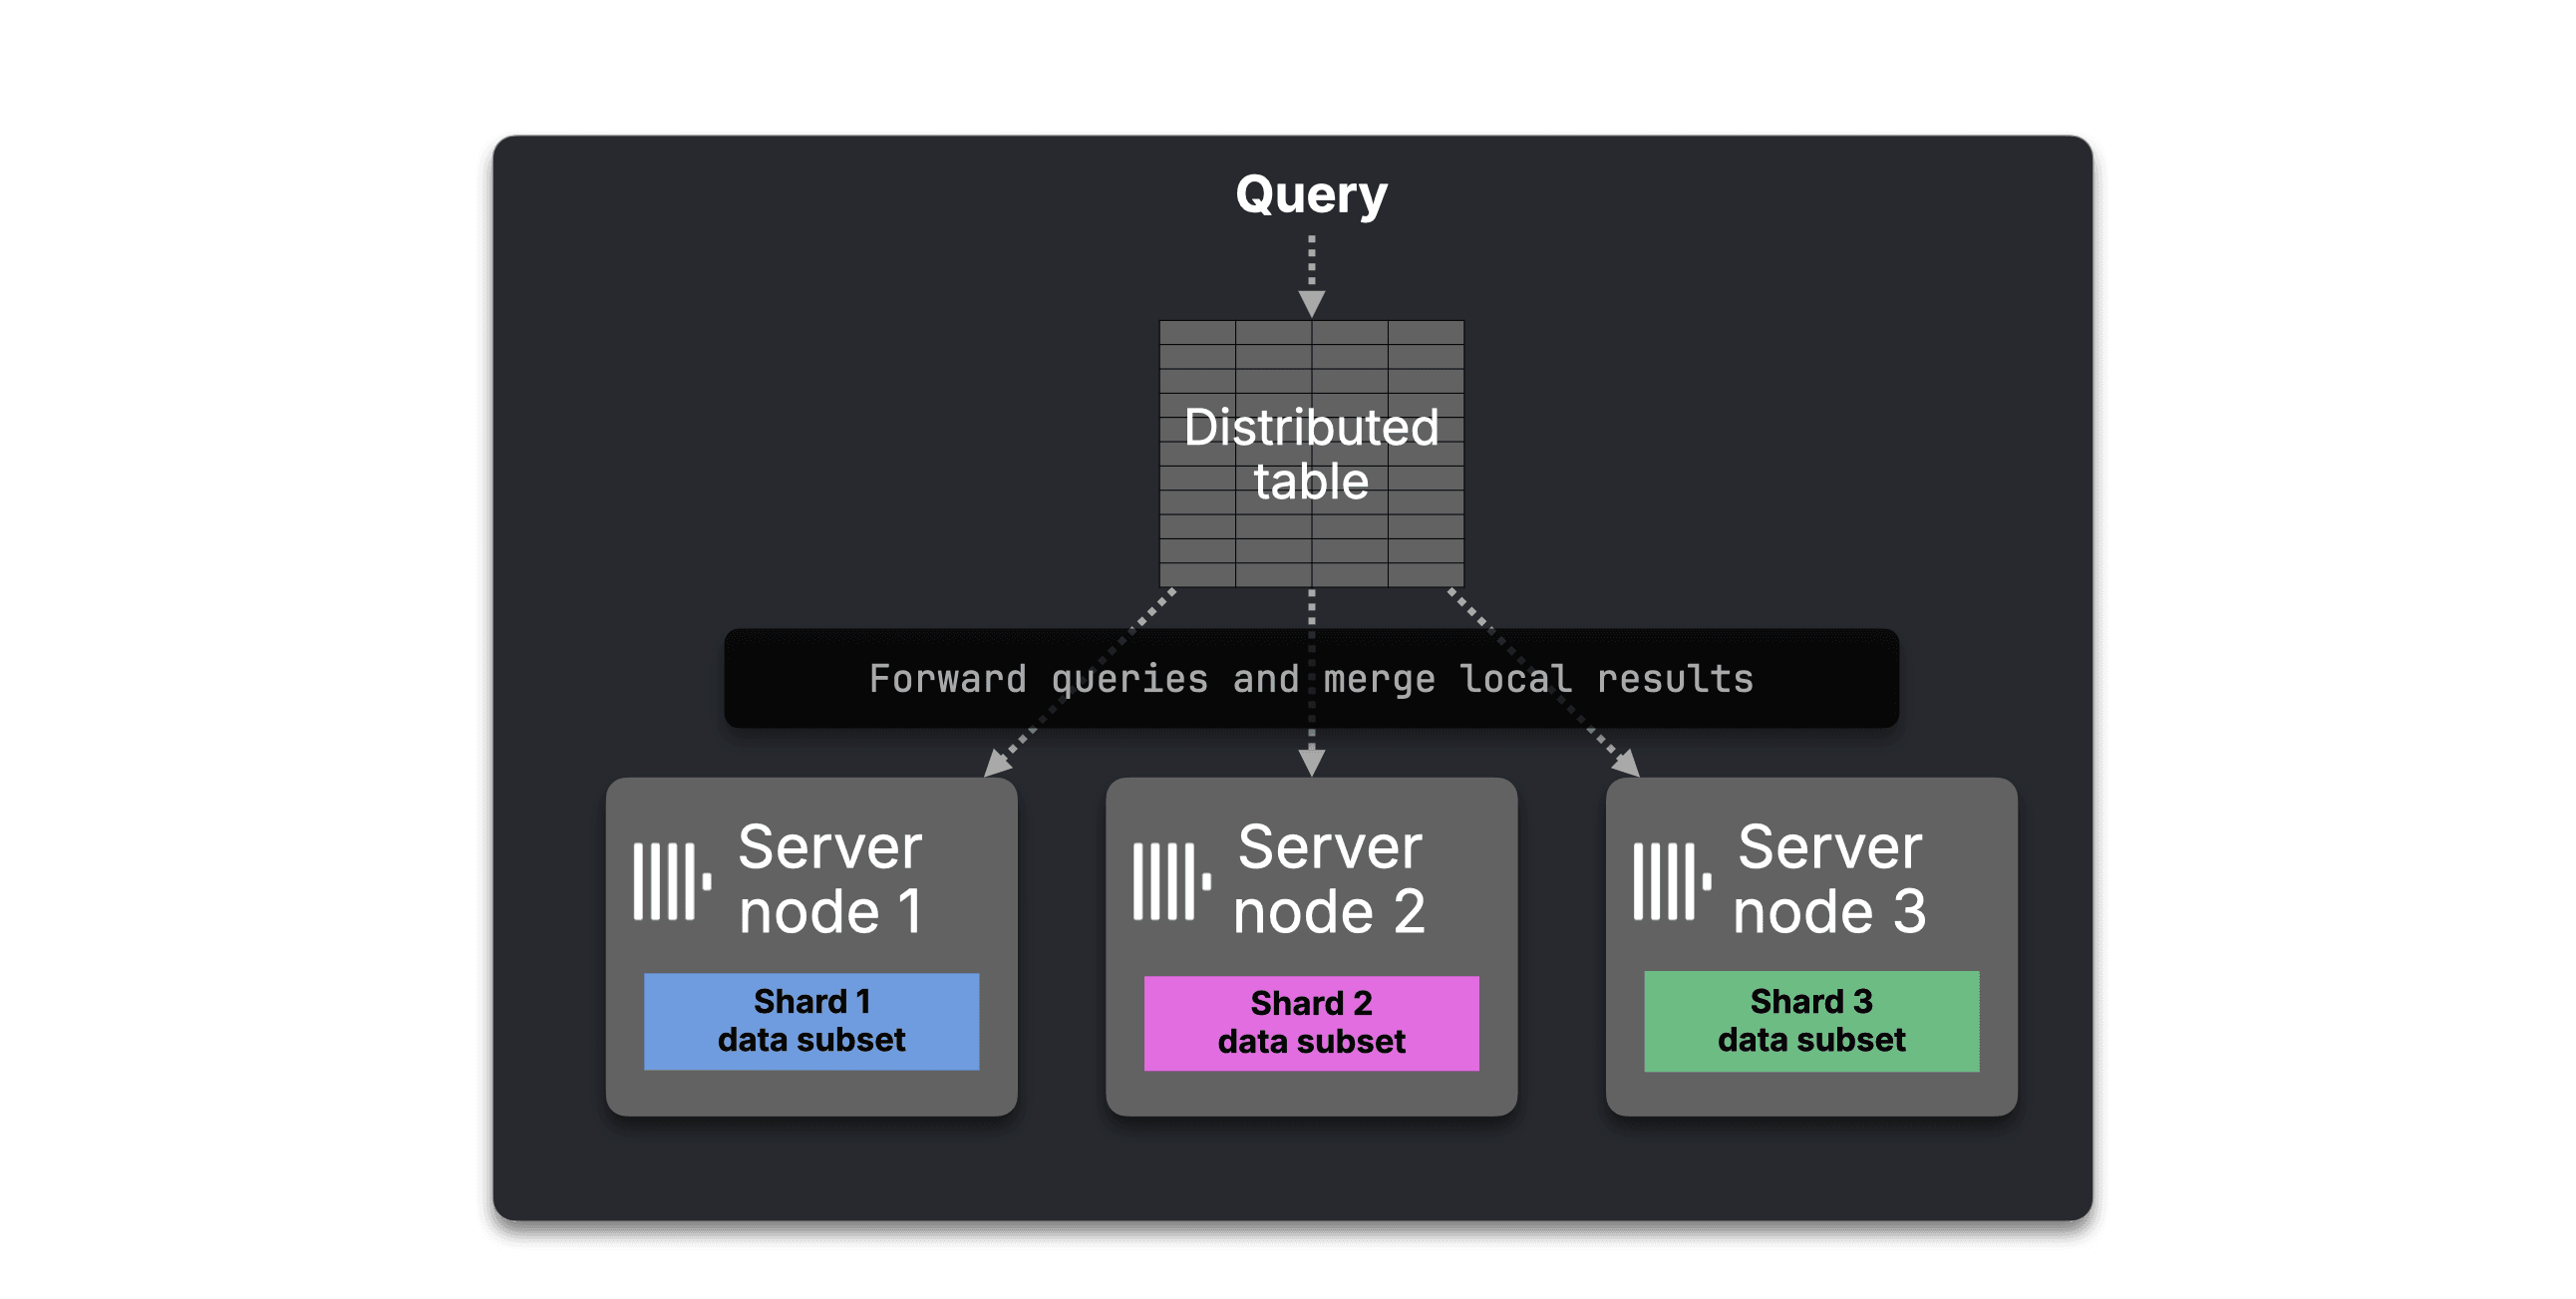
これは機能しますが、容量はシャードのレイアウトに縛られます。
> **ボトルネック:容量がシャードレイアウトに縛られる**
コンピュートを追加しても、自動的に単一クエリが高速化するわけではありません。大規模テーブルは、まずより多くのシャードに再分配する必要があります。
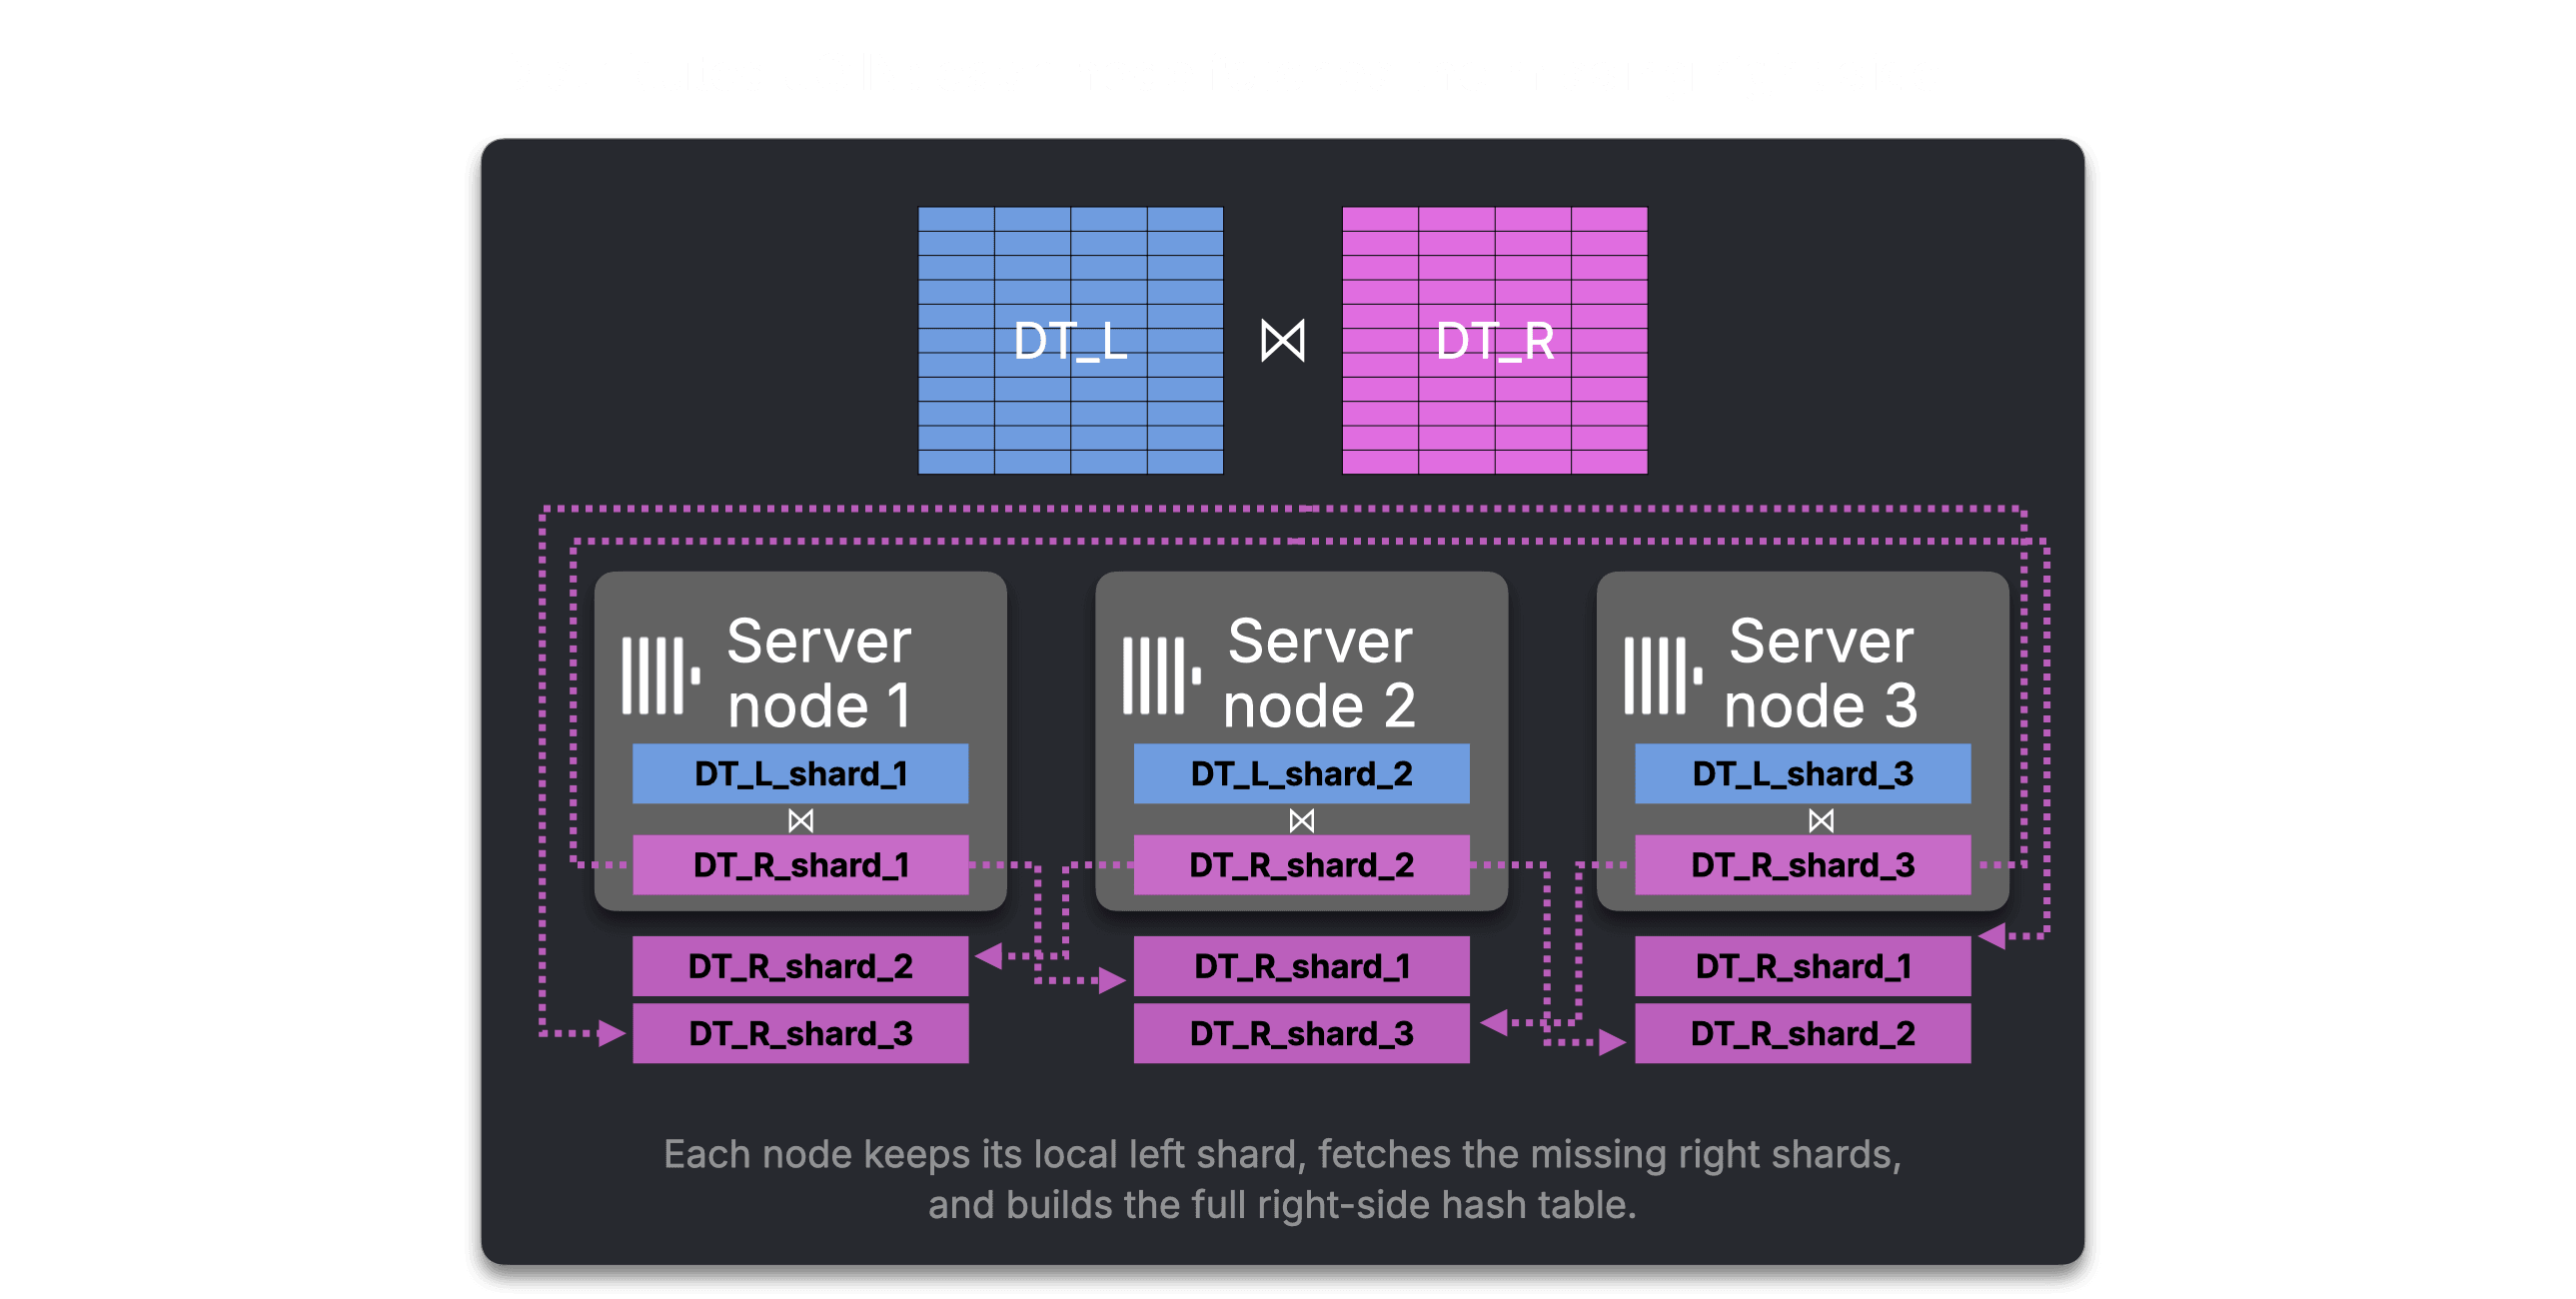
物理シャーディングされたテーブル間の大規模 JOIN では、2 つ目の制約が浮き彫りになります。JOIN は、マッチする行が同じマシン上で出会ったときにのみ機能します。Distributed JOIN では、各ノードはローカルの左側を保持したまま、足りない右側シャードを他のノードから取得し、完全な右側ハッシュテーブルを構築し、ローカルの JOIN 結果をリクエスト元に返します。
GLOBAL JOIN は、右側を一度だけ計算してすべてのノードにブロードキャストすることで、多対多のネットワーク往復を削減します。
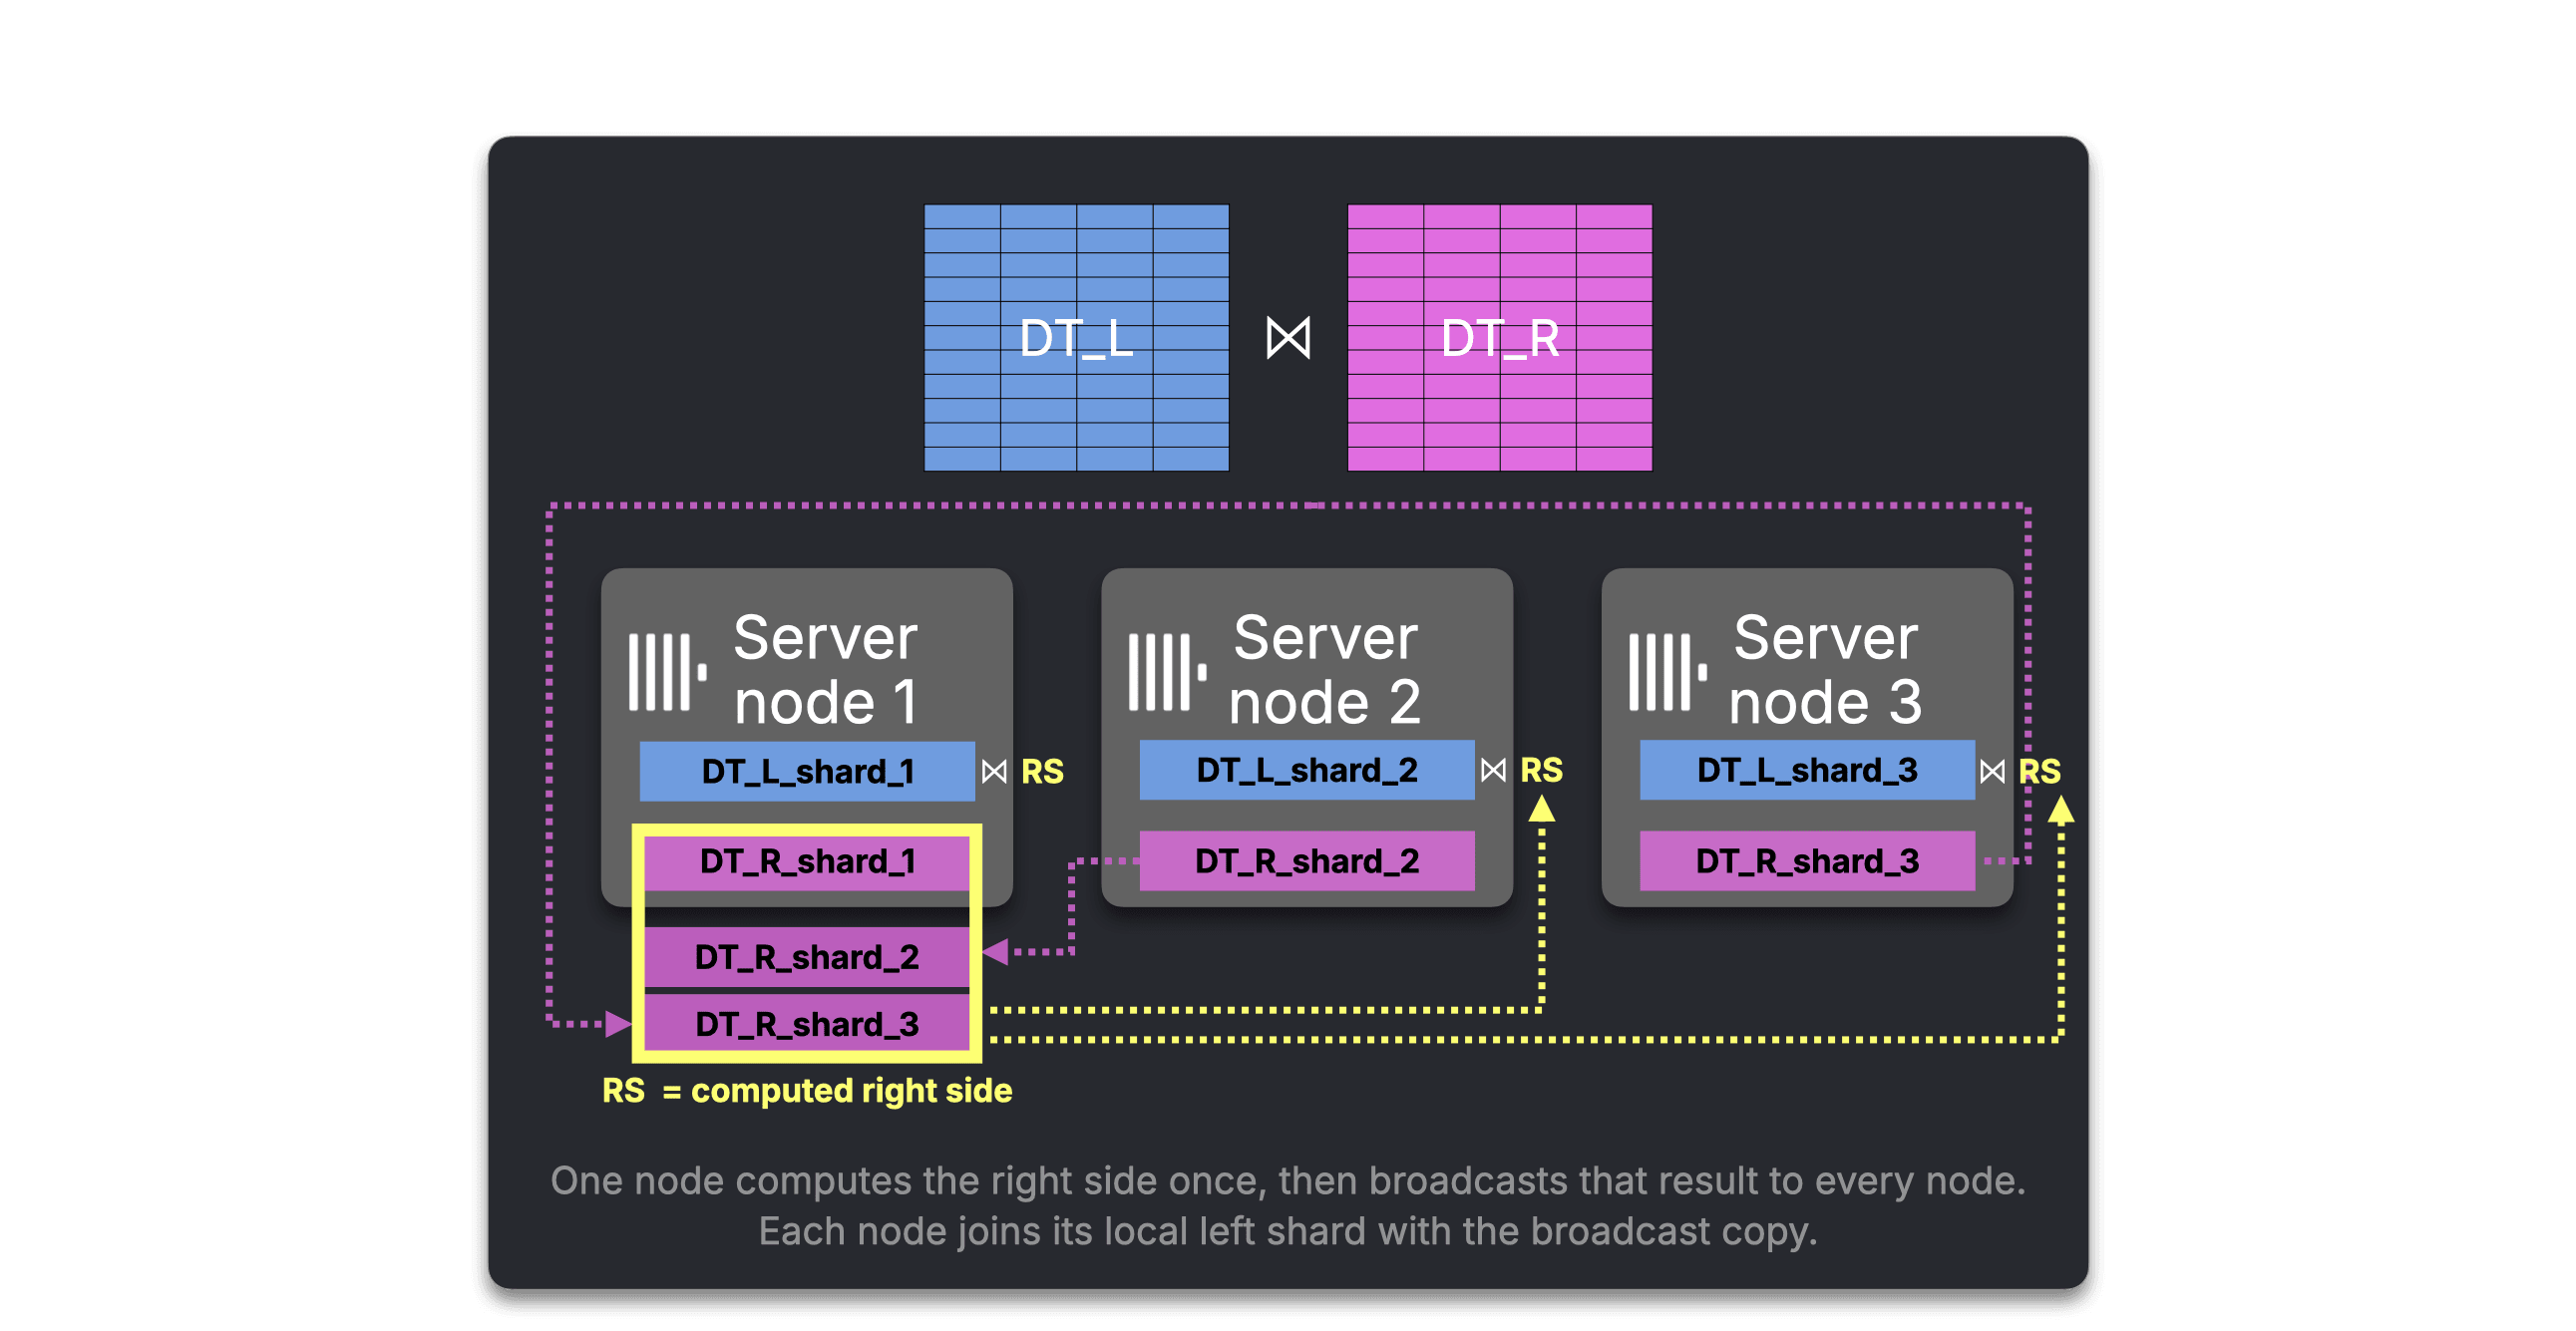
しかし、本質的な問題は残っています。大きな右側はやはりクラスタ全体にコピーされなければなりません。
> **ボトルネック:大きな右側があらゆる場所にコピーされる**
Distributed JOIN と GLOBAL JOIN はネットワークトラフィックの扱い方が異なりますが、いずれも全シャードが完全な右側に対して JOIN を行う点は変わりません。
[ClickHouse Cloud](https://clickhouse.com/cloud) は[共有ストレージ](https://clickhouse.com/blog/clickhouse-cloud-boosts-performance-with-sharedmergetree-and-lightweight-updates)に移行することで、物理シャーディングの問題を解消しました。どのノードも同じテーブルデータにアクセスでき、[parallel replicas](https://clickhouse.com/docs/deployment-guides/parallel-replicas) により複数のノードが単一のクエリに参加できます。ノードはデータコピーや再シャッフルなしに即座に追加・削除できます。
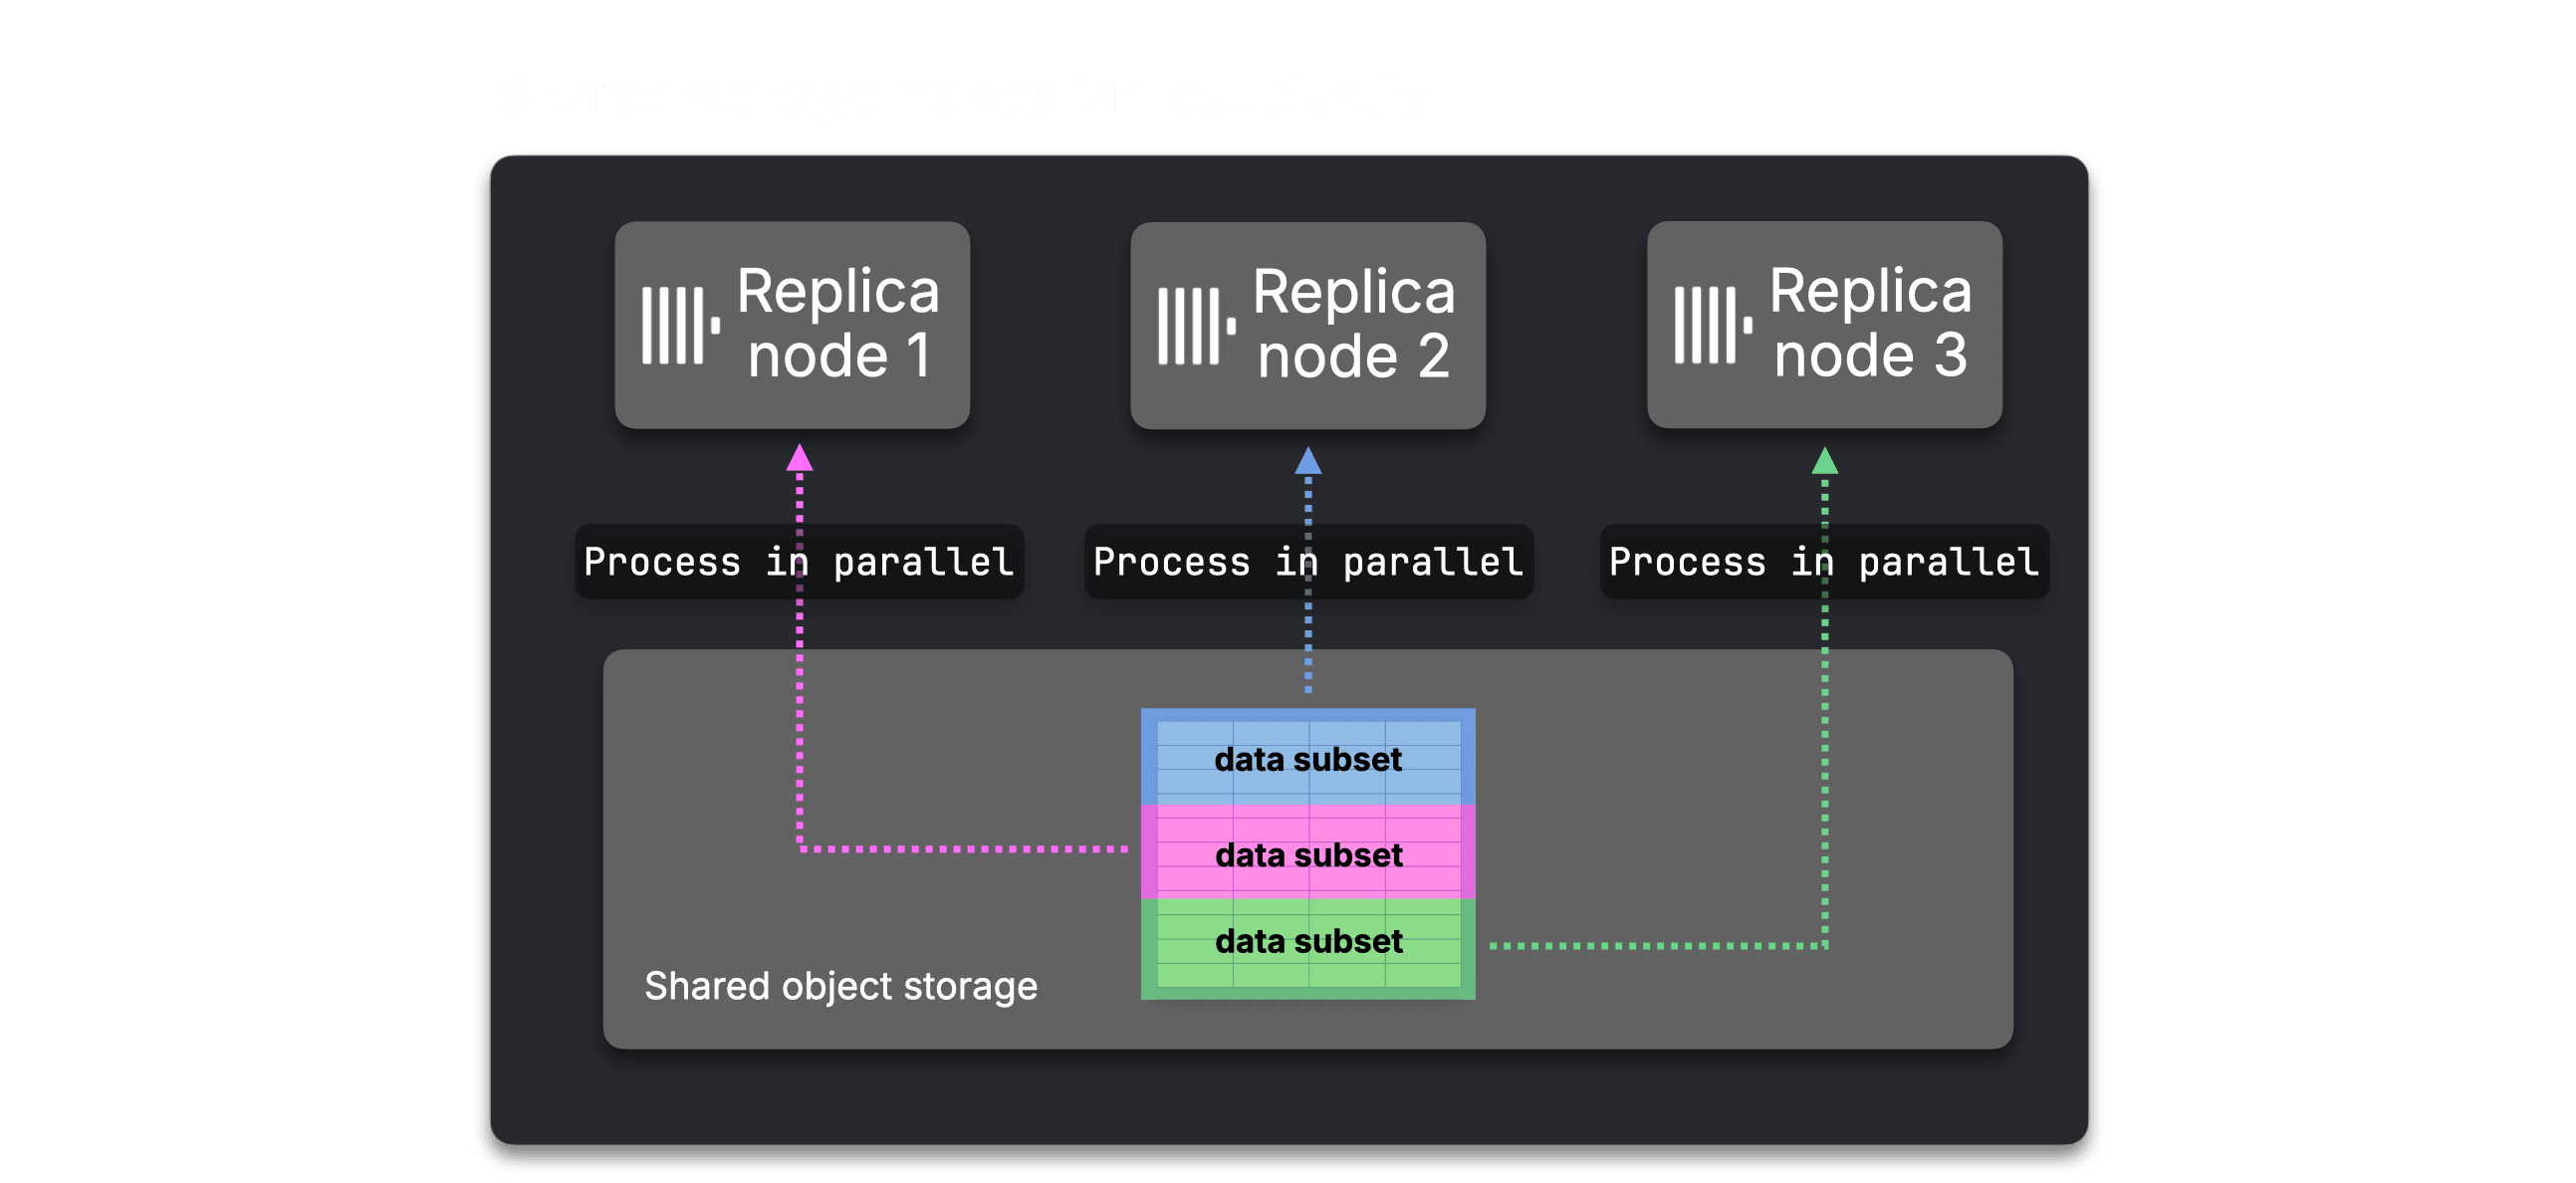
これにより ClickHouse Cloud の[クエリ内スケーリング](https://clickhouse.com/blog/clickhouse-parallel-replicas)は格段に弾力的になりました。しかし、parallel replicas には構造的な制約が依然として残っていました。レプリカ間で作業を分割することはできるものの、実行ステージ間で中間データを自由に再パーティション化することはできなかったのです。
この制約は 2 つの場面で現れます。
1 つ目は JOIN です。単一ノードでは、ClickHouse は[デフォルトのハッシュ JOIN 戦略の両側を並列化](https://clickhouse.com/blog/clickhouse-fully-supports-joins-hash-joins-part2#parallel-hash-join)できます。JOIN キーで行を複数のハッシュテーブルに分割するため、ビルドとプローブの両方の処理を CPU コア間で並列実行できます。これは parallel replicas を使用したときの各ノード内でも同様です。
制約は一段上のレベルにあります。複数ノード間でビルド側そのものを分割するには、ノード間で両入力を JOIN キーで再パーティション化するシャッフルステージが必要です。parallel replicas にはその仕組みがありません。次善の策は、[primary index による pruning](https://clickhouse.com/docs/primary-indexes) の後に左側の読み取り範囲をノード間で分散することです。これによりプローブ側の処理はノード間で並列化されますが、これらの範囲は JOIN キーでパーティション化されてはいません。ある左側範囲の行は右側テーブルのどこの行ともマッチし得るため、各ノードはローカルスライスをプローブする前に、依然として完全な右側からローカルのハッシュテーブルを構築する必要があります。
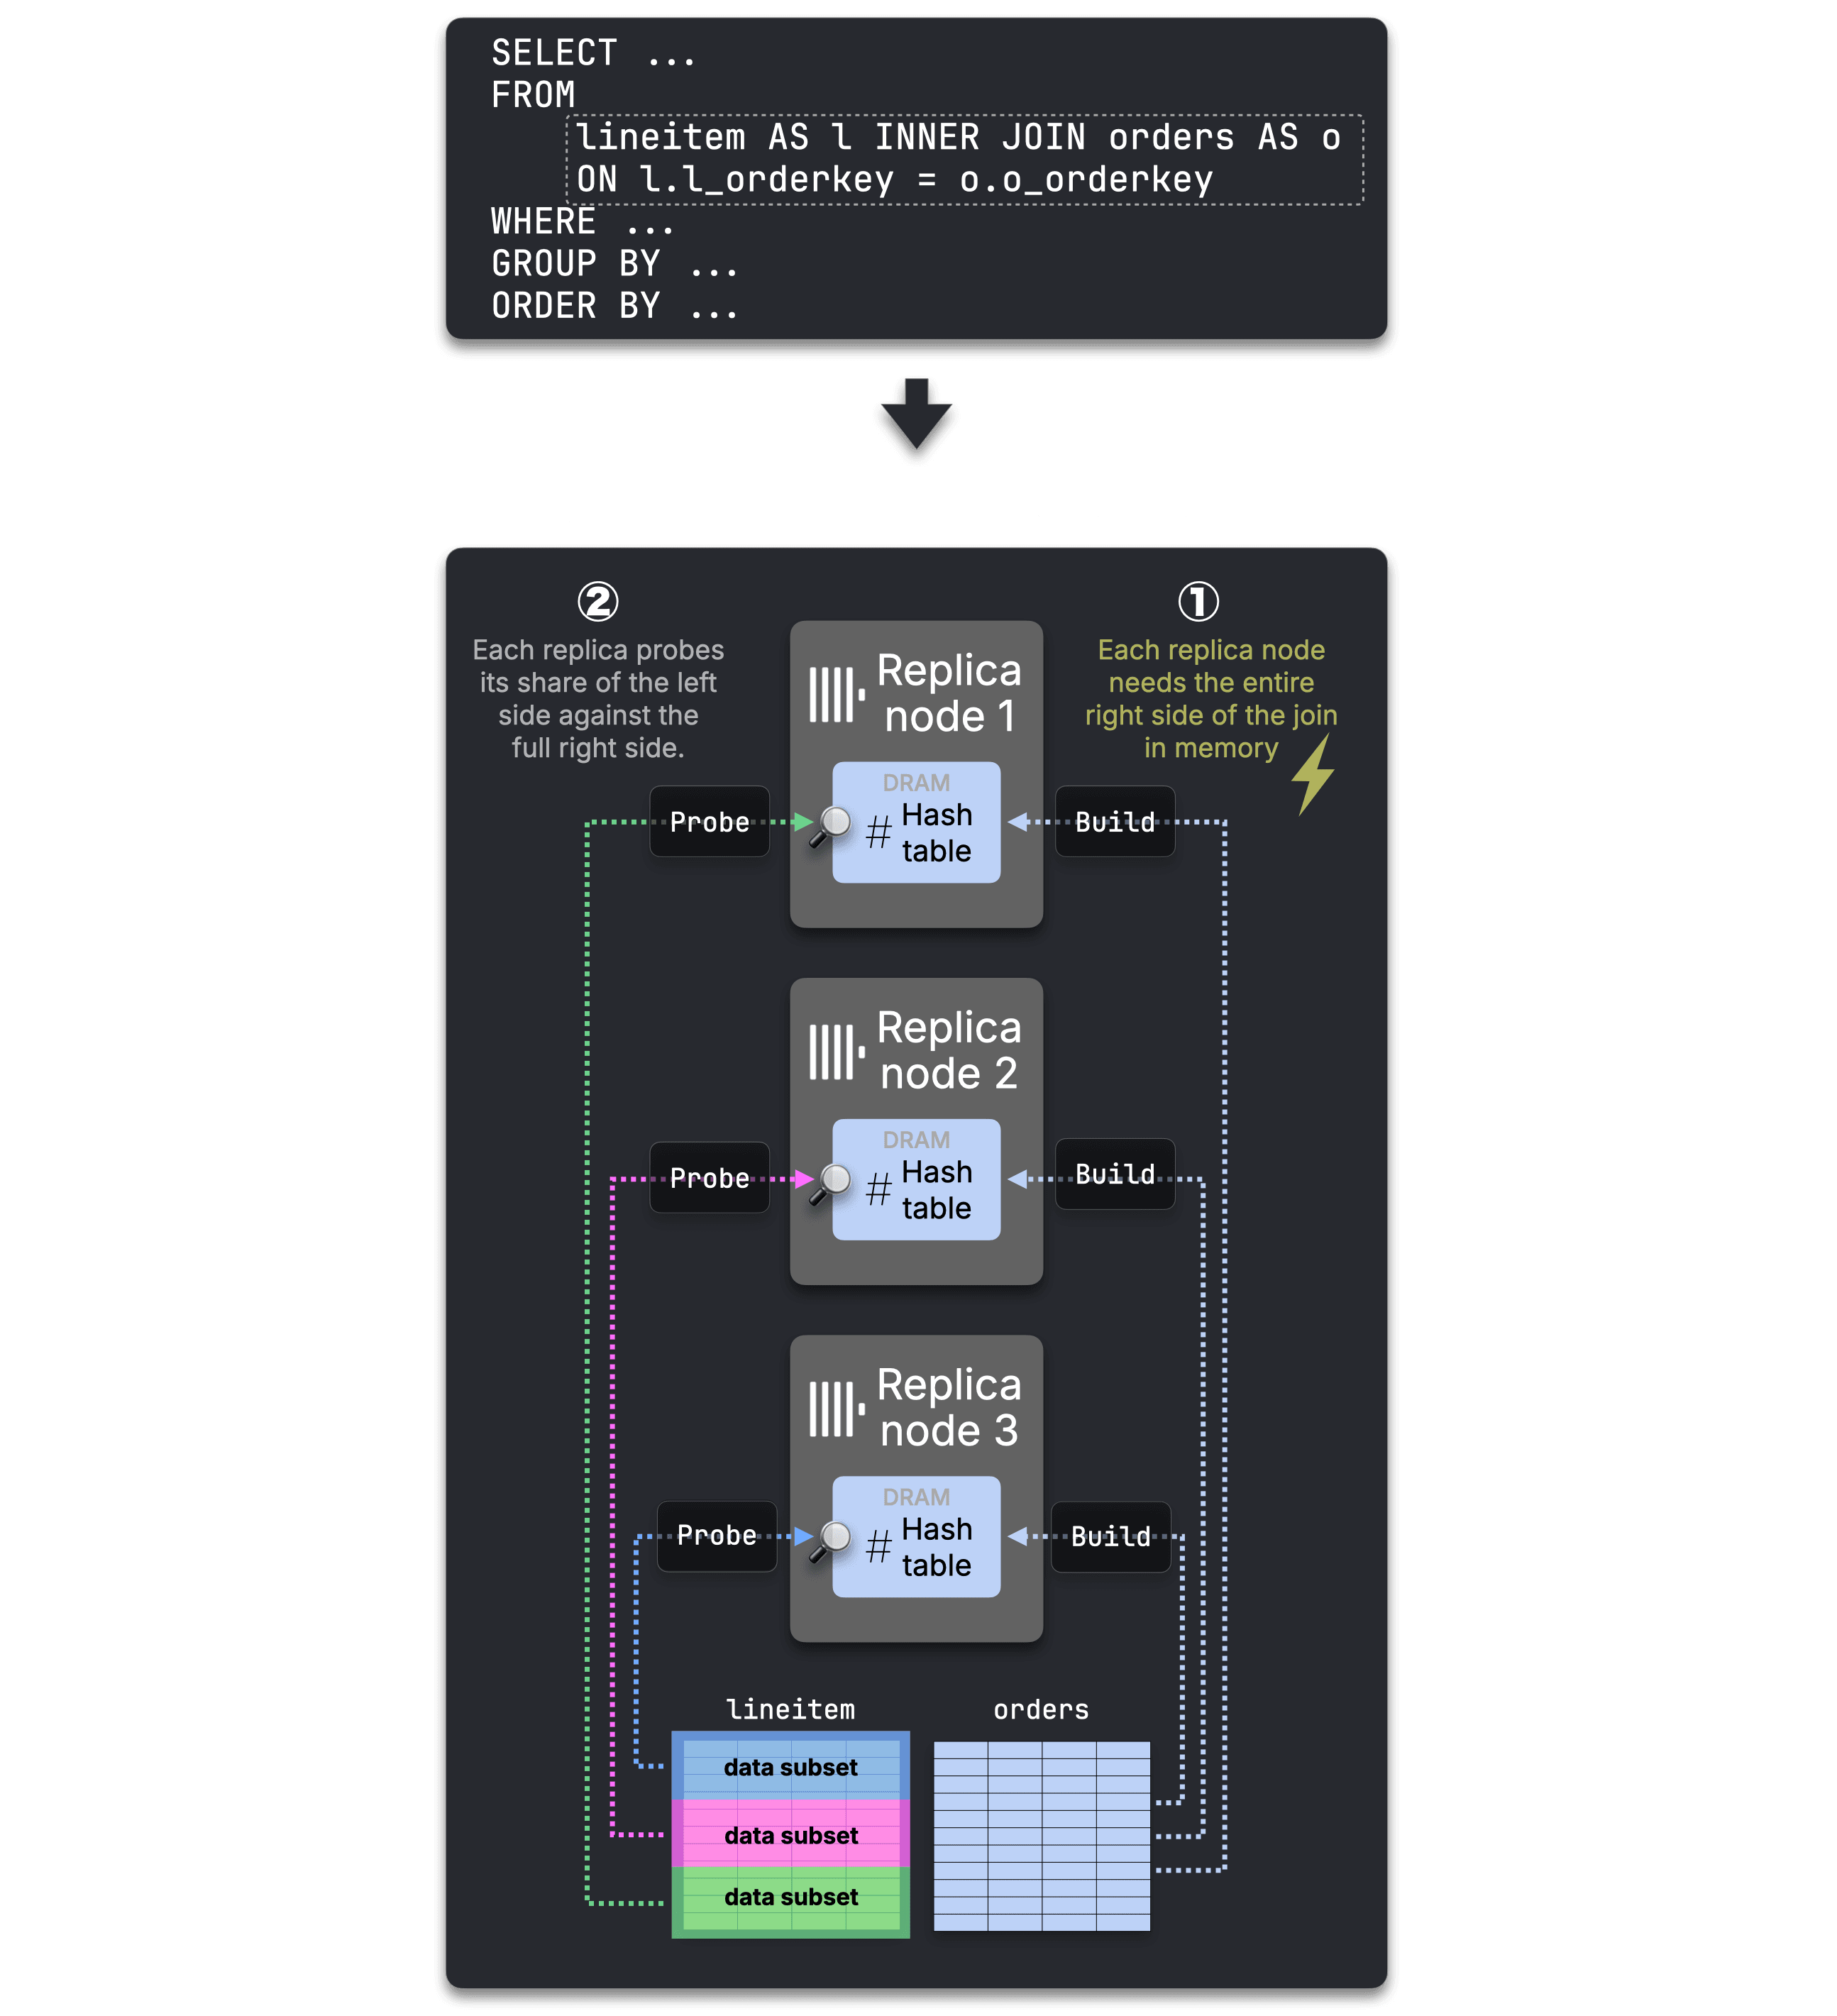
> **ボトルネック:ビルド側がスケールアウトしない**
左側のプローブはノード間で分割されますが、ビルド側はそうではありません。各ノードは依然として完全な右側から同じハッシュテーブルを構築するため、ビルドステップはクラスタ全体で分割されるのではなく、繰り返されることになります。
2 つ目は集計です。ノードはローカルでスキャンと集計を並列に実行できます。しかし、GROUP BY キーでのシャッフルがなければ、ClickHouse は同じ GROUP BY キーのすべての行が同じノードに集まることを保証できません。
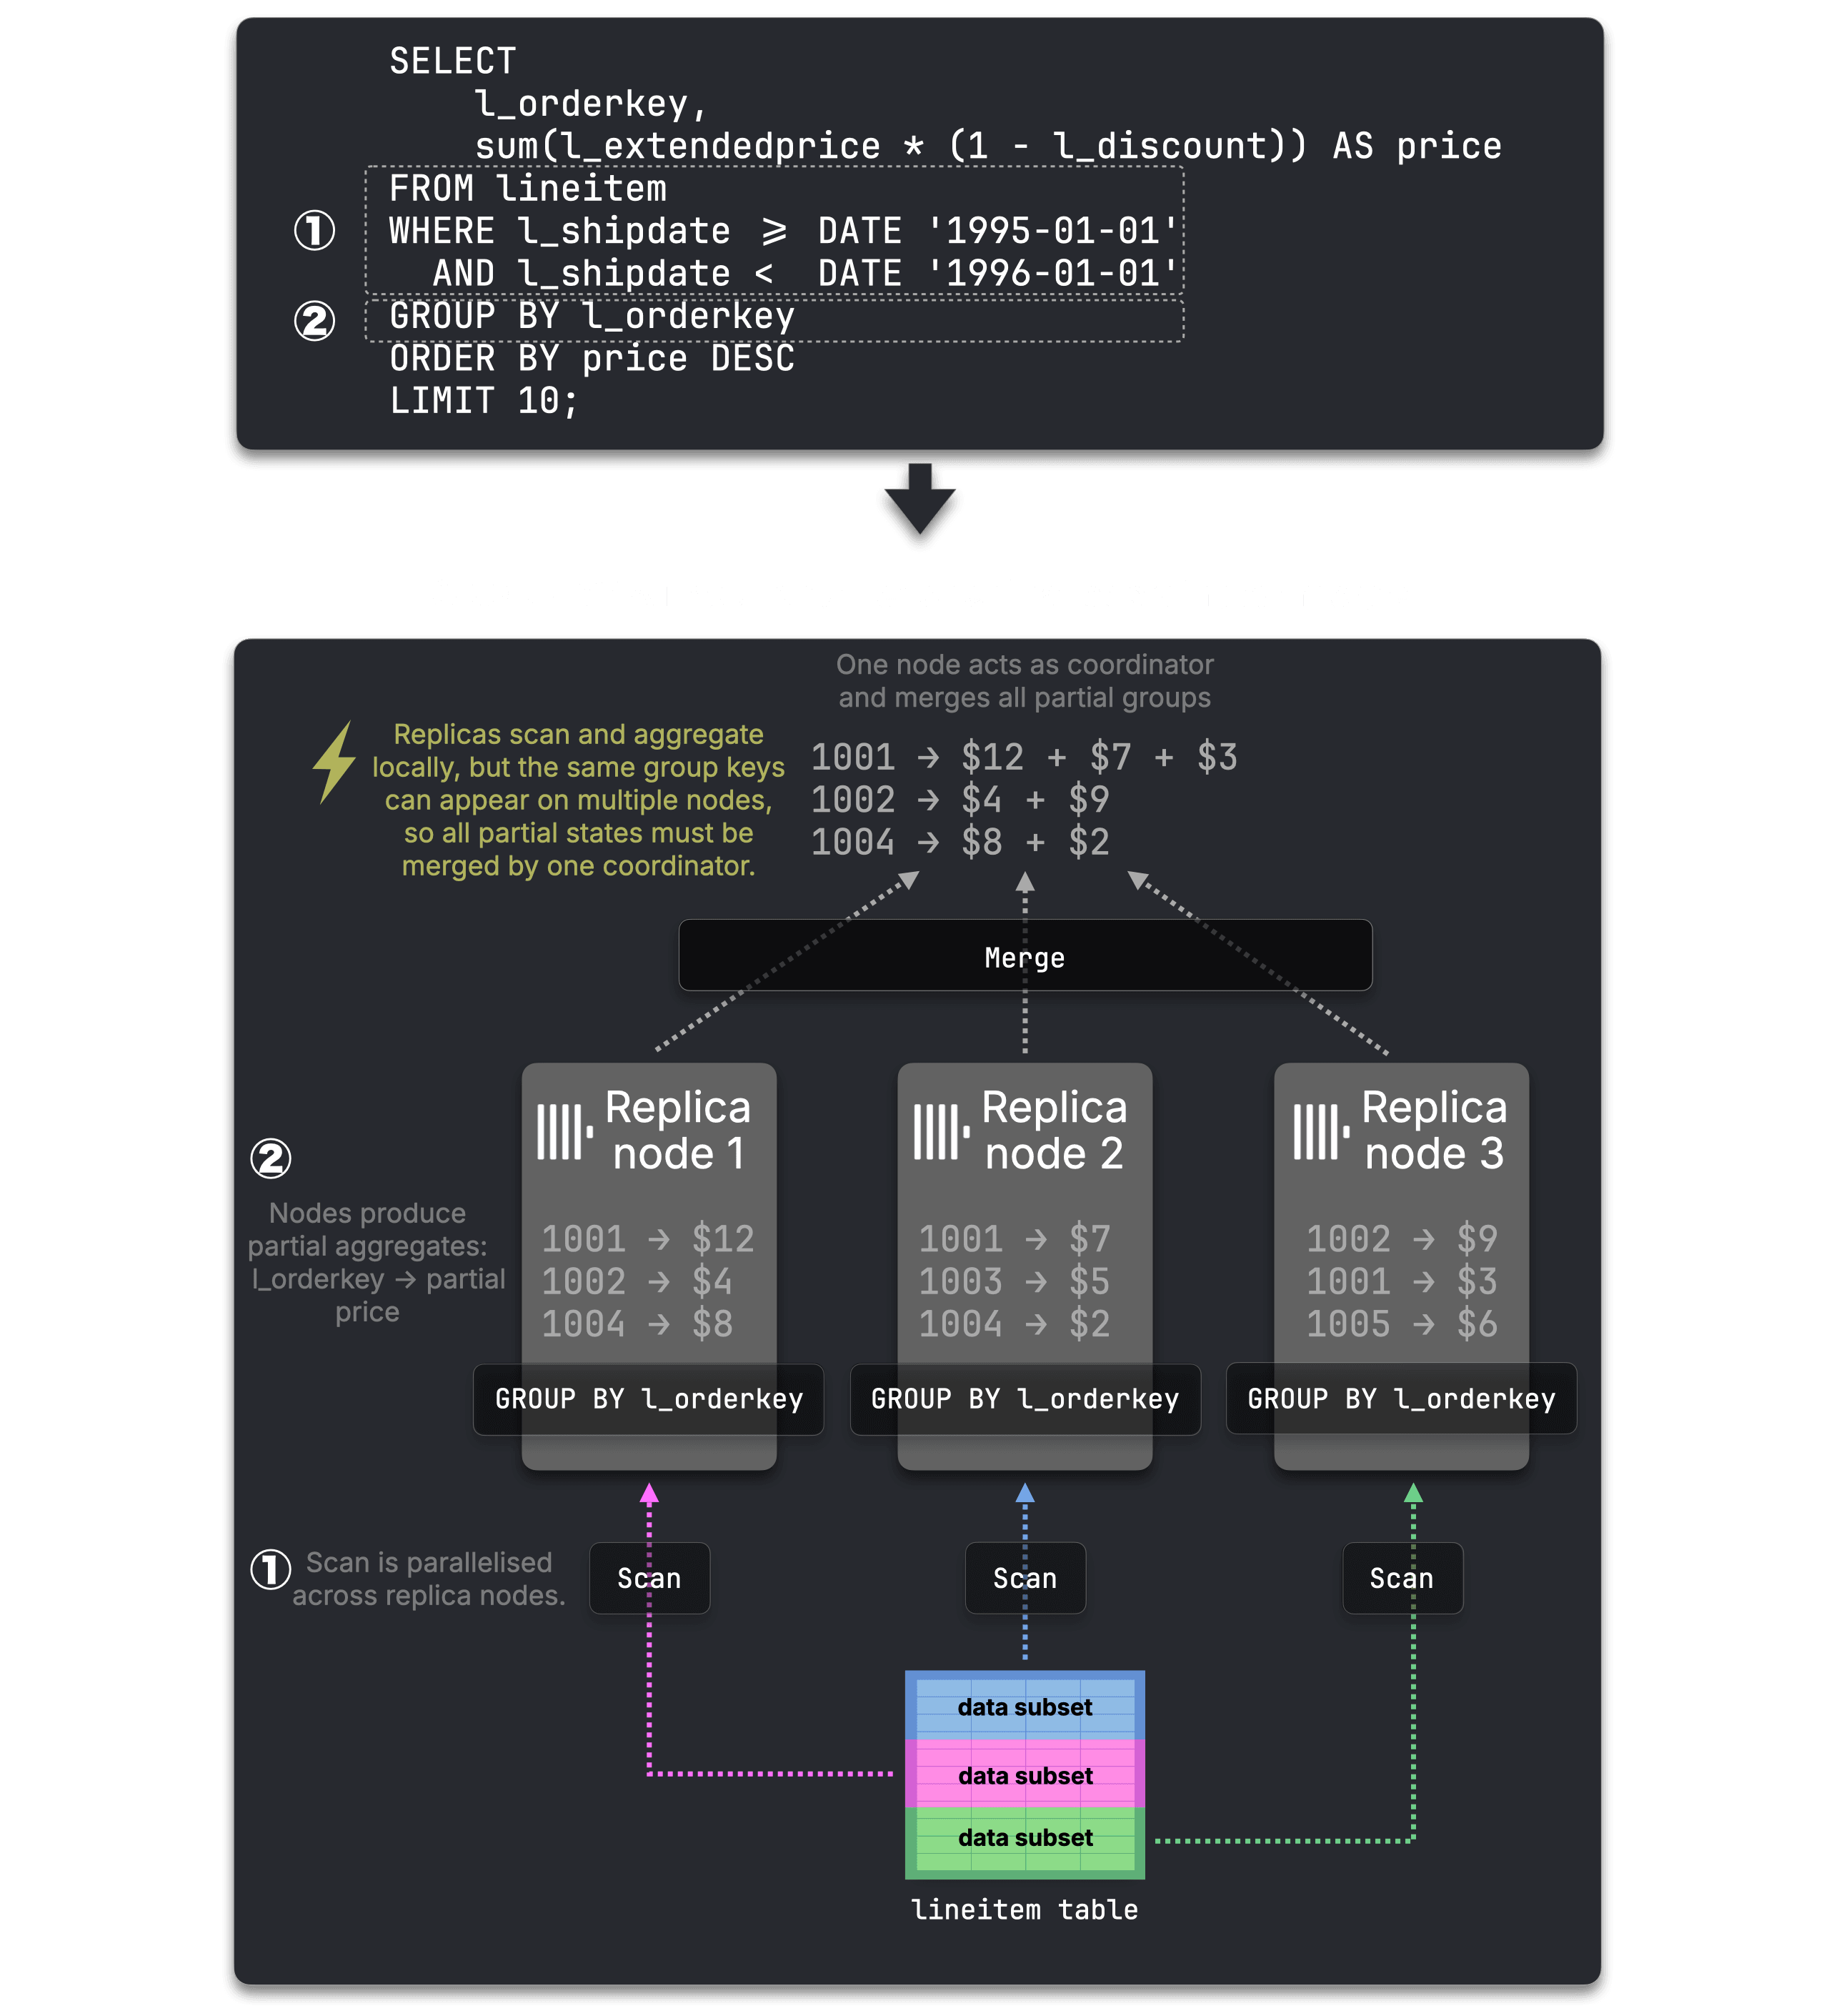
> **ボトルネック:最終集計が依然として単一ノード**
部分グループは 1 つのコーディネータでマージされる必要があります。高カーディナリティの GROUP BY では、この最終マージはクラスタではなく単一ノードの CPU とメモリに律速されます。
どちらの問題も根本原因は同じです。実行ステージ間で中間データを再パーティション化する汎用的な手段が存在しないのです。マルチステージ分散実行が追加するのは、まさにこの仕組みです。
## マルチステージ分散実行の紹介
マルチステージ分散実行は、欠けていたプリミティブを追加します。クエリ実行中に ClickHouse Cloud がノード間で中間データを移動できるようにするのです。
クエリを 1 つの分散ファンアウトと最終マージとして実行するのではなく、ClickHouse はクエリプランを複数のステージに分割し、それらをワーカーノード間で並列実行します。ステージ間では exchange オペレータが中間結果を次のステージで必要な形に整形して移動させます。
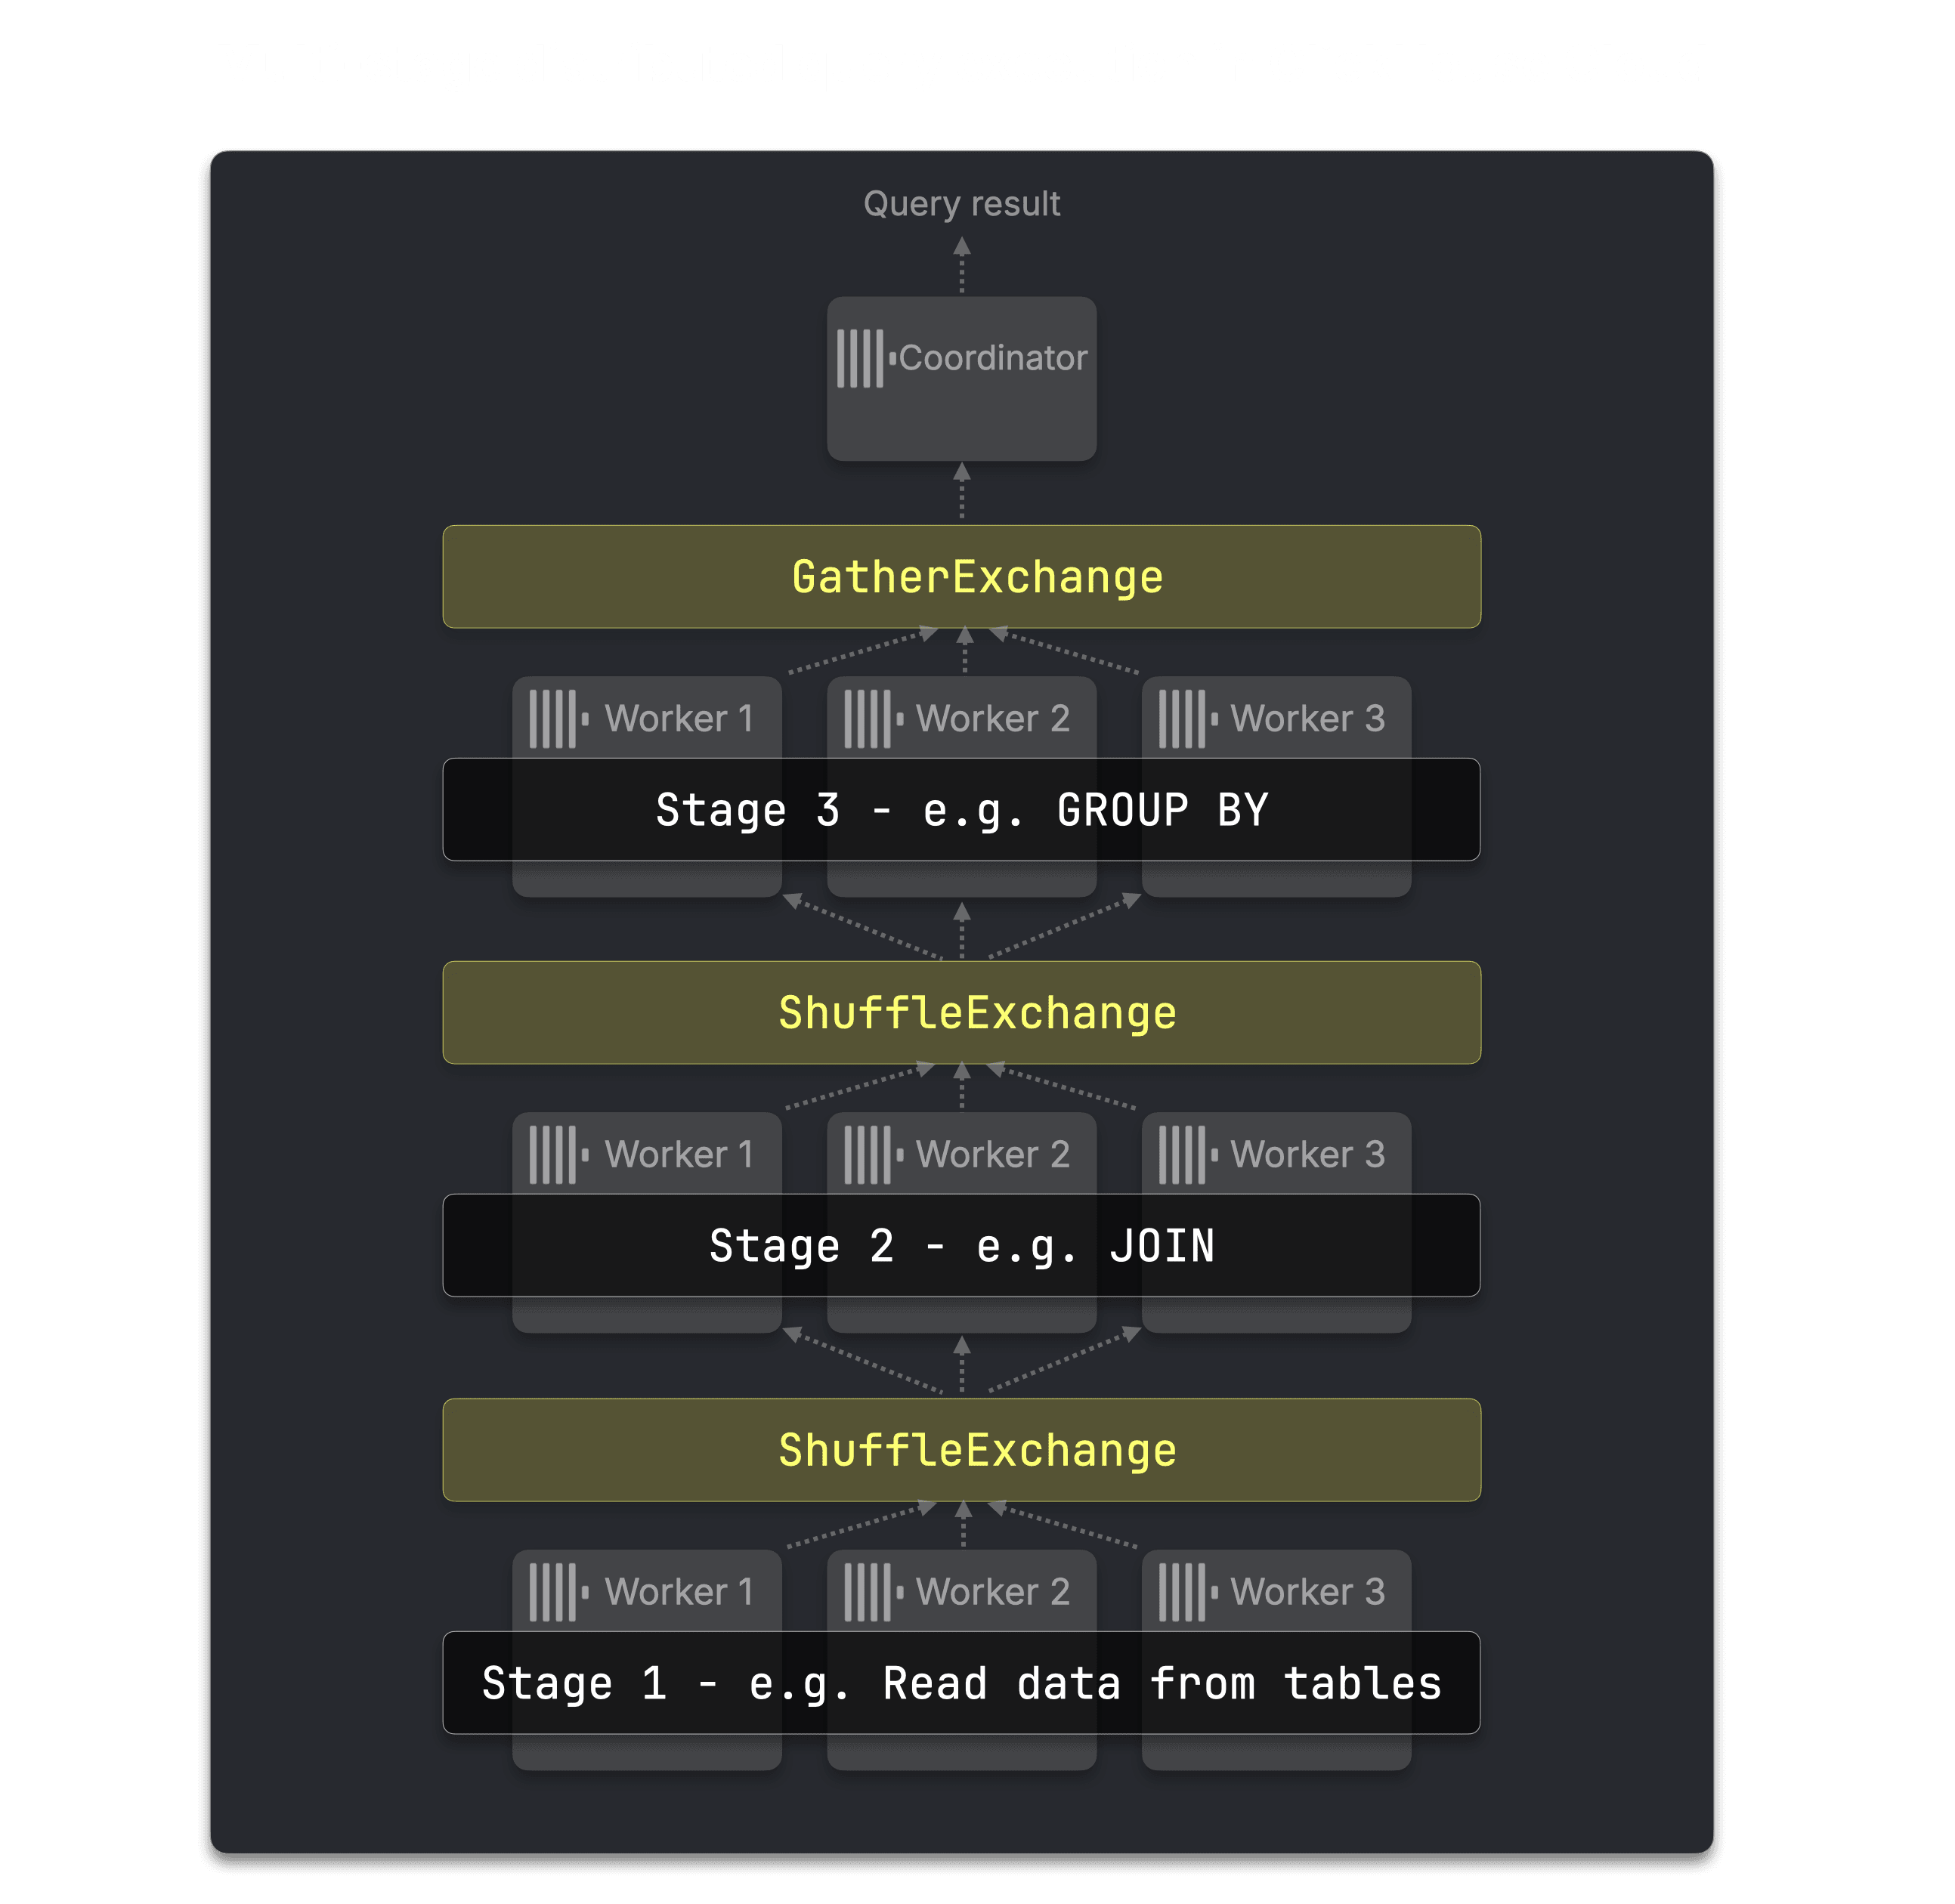
たとえば、データを JOIN キーでシャッフルすることで、各ワーカーが両入力のマッチするスライスを受け取れます。GROUP BY キーでシャッフルすれば、各ワーカーは完全なグループを保有できます。小さな入力はすべてのワーカーにブロードキャストできます。最終結果はコーディネータが集約します。
> **従来のボトルネックを排除:データはステージ間を移動可能**
大規模 JOIN は、各ノードが完全な右側ハッシュテーブルを構築する必要がなくなります。高カーディナリティ集計は、1 つのコーディネータがすべての部分グループをマージする必要がなくなります。
中核となる抽象化は exchange オペレータです。これは並列クエリ実行でよく知られている構成要素で、Volcano システムのために[導入](https://scholar.colorado.edu/concern/reports/sj139272m)され、Teradata や Greenplum のような MPP データベース、さらには SQL Server でも使われています。
exchange オペレータはプランステージ間でデータを再分配します。マルチステージ分散実行では、主に 3 種類の exchange を使用します。
1. **GatherExchange**(N 対 1): ワーカーの出力をコーディネータに送信します。通常はプラン最上位で最終結果を生成するために使われます。
2. **ShuffleExchange**(M 対 N): JOIN キーや GROUP BY キーなどのキーで行を再パーティション化します。これにより各ワーカーは、次の処理について完全かつ互いに重ならないスライスを保有できます。
3. **BroadcastExchange**(1 対 N): 小さな入力をすべてのワーカーにコピーします。JOIN の一方が安価に複製できるほど小さい場合に有用です。
このほか、行をワーカー間にランダムに配布する **ScatterExchange** もあります。
ここまでは抽象的な仕組みの話です。これらがなぜ重要なのかを最もよく理解する方法は、1 つのクエリをステージごとに追ってみることです。
### ある分析的 JOIN クエリが旧来のボトルネックをどう回避するか
[TPC-H](https://clickhouse.com/docs/getting-started/example-datasets/tpch) ライクなクエリを使って具体的に見ていきましょう。前節の 2 つのボトルネック、すなわち「すべてのワーカーノードにコピーされてはいけない大きな JOIN 側」と「単一ノードでの最終マージに集約されてはいけない集計」の両方に該当するクエリです。
このクエリは、国別の総出荷売上を計算します。lineitem を supplier と JOIN し、その結果を小さな nation テーブルと JOIN し、n_name でグループ化し、売上で並べ替えます。
SELECT n_name, sum(l_extendedprice) AS revenue
FROM lineitem
JOIN supplier ON l_suppkey = s_suppkey
JOIN nation ON s_nationkey = n_nationkey
WHERE l_shipdate >= '1994-01-01' AND l_shipdate < '1995-01-01'
GROUP BY n_name
ORDER BY revenue DESC;
分散プラン([EXPLAIN](https://clickhouse.com/docs/sql-reference/statements/explain) で確認)には、1 つの BroadcastExchange、2 つの ShuffleExchange、1 つの GatherExchange が含まれます。
┌─explain──────────────────────────────────────────────────┐
│ Output: n_name, sum(l_extendedprice)                     │
│                                                          │
│ GatherExchange (sorted by (sum(l_extendedprice) DESC))   │
│ └──Sorting (Sorting for ORDER BY)                        │
│    └──Aggregating                                        │
│       └──ShuffleExchange (by hash([n_name]))             │
│          └──JoinLogical                                  │
│             ├──ShuffleExchange (by hash([l_suppkey]))    │
│             │  └──ReadFromMergeTree (sf100.lineitem)     │
│             └──ShuffleExchange (by hash([s_suppkey]))    │
│                └──JoinLogical                            │
│                   ├──ReadFromMergeTree (sf100.supplier)  │
│                   └──BroadcastExchange                   │
│                      └──ReadFromMergeTree (sf100.nation) │
└──────────────────────────────────────────────────────────┘
下から読み上げると、プランはまず小さな supplier ⋈ nation JOIN を構築します。nation をブロードキャストし、supplier を読み込み、各ワーカーが拡張された supplier ⋈ nation 側を生成します。次に、その拡張側を s_suppkey で再パーティション化し、同時に lineitem を読み込んで l_suppkey で再パーティション化することで、マッチする行が同じワーカーで出会うようにします。JOIN された行は次に n_name でシャッフルされて集計され、ソートされた最終結果がコーディネータに集約されます。
これらのステップを順に見ていきましょう。
#### **ステップ 1:supplier と nation を JOIN**
ClickHouse はまず、小さな `nation` テーブルをすべてのワーカーにブロードキャストし、ローカルに小さな `nation` ハッシュテーブルを構築します。
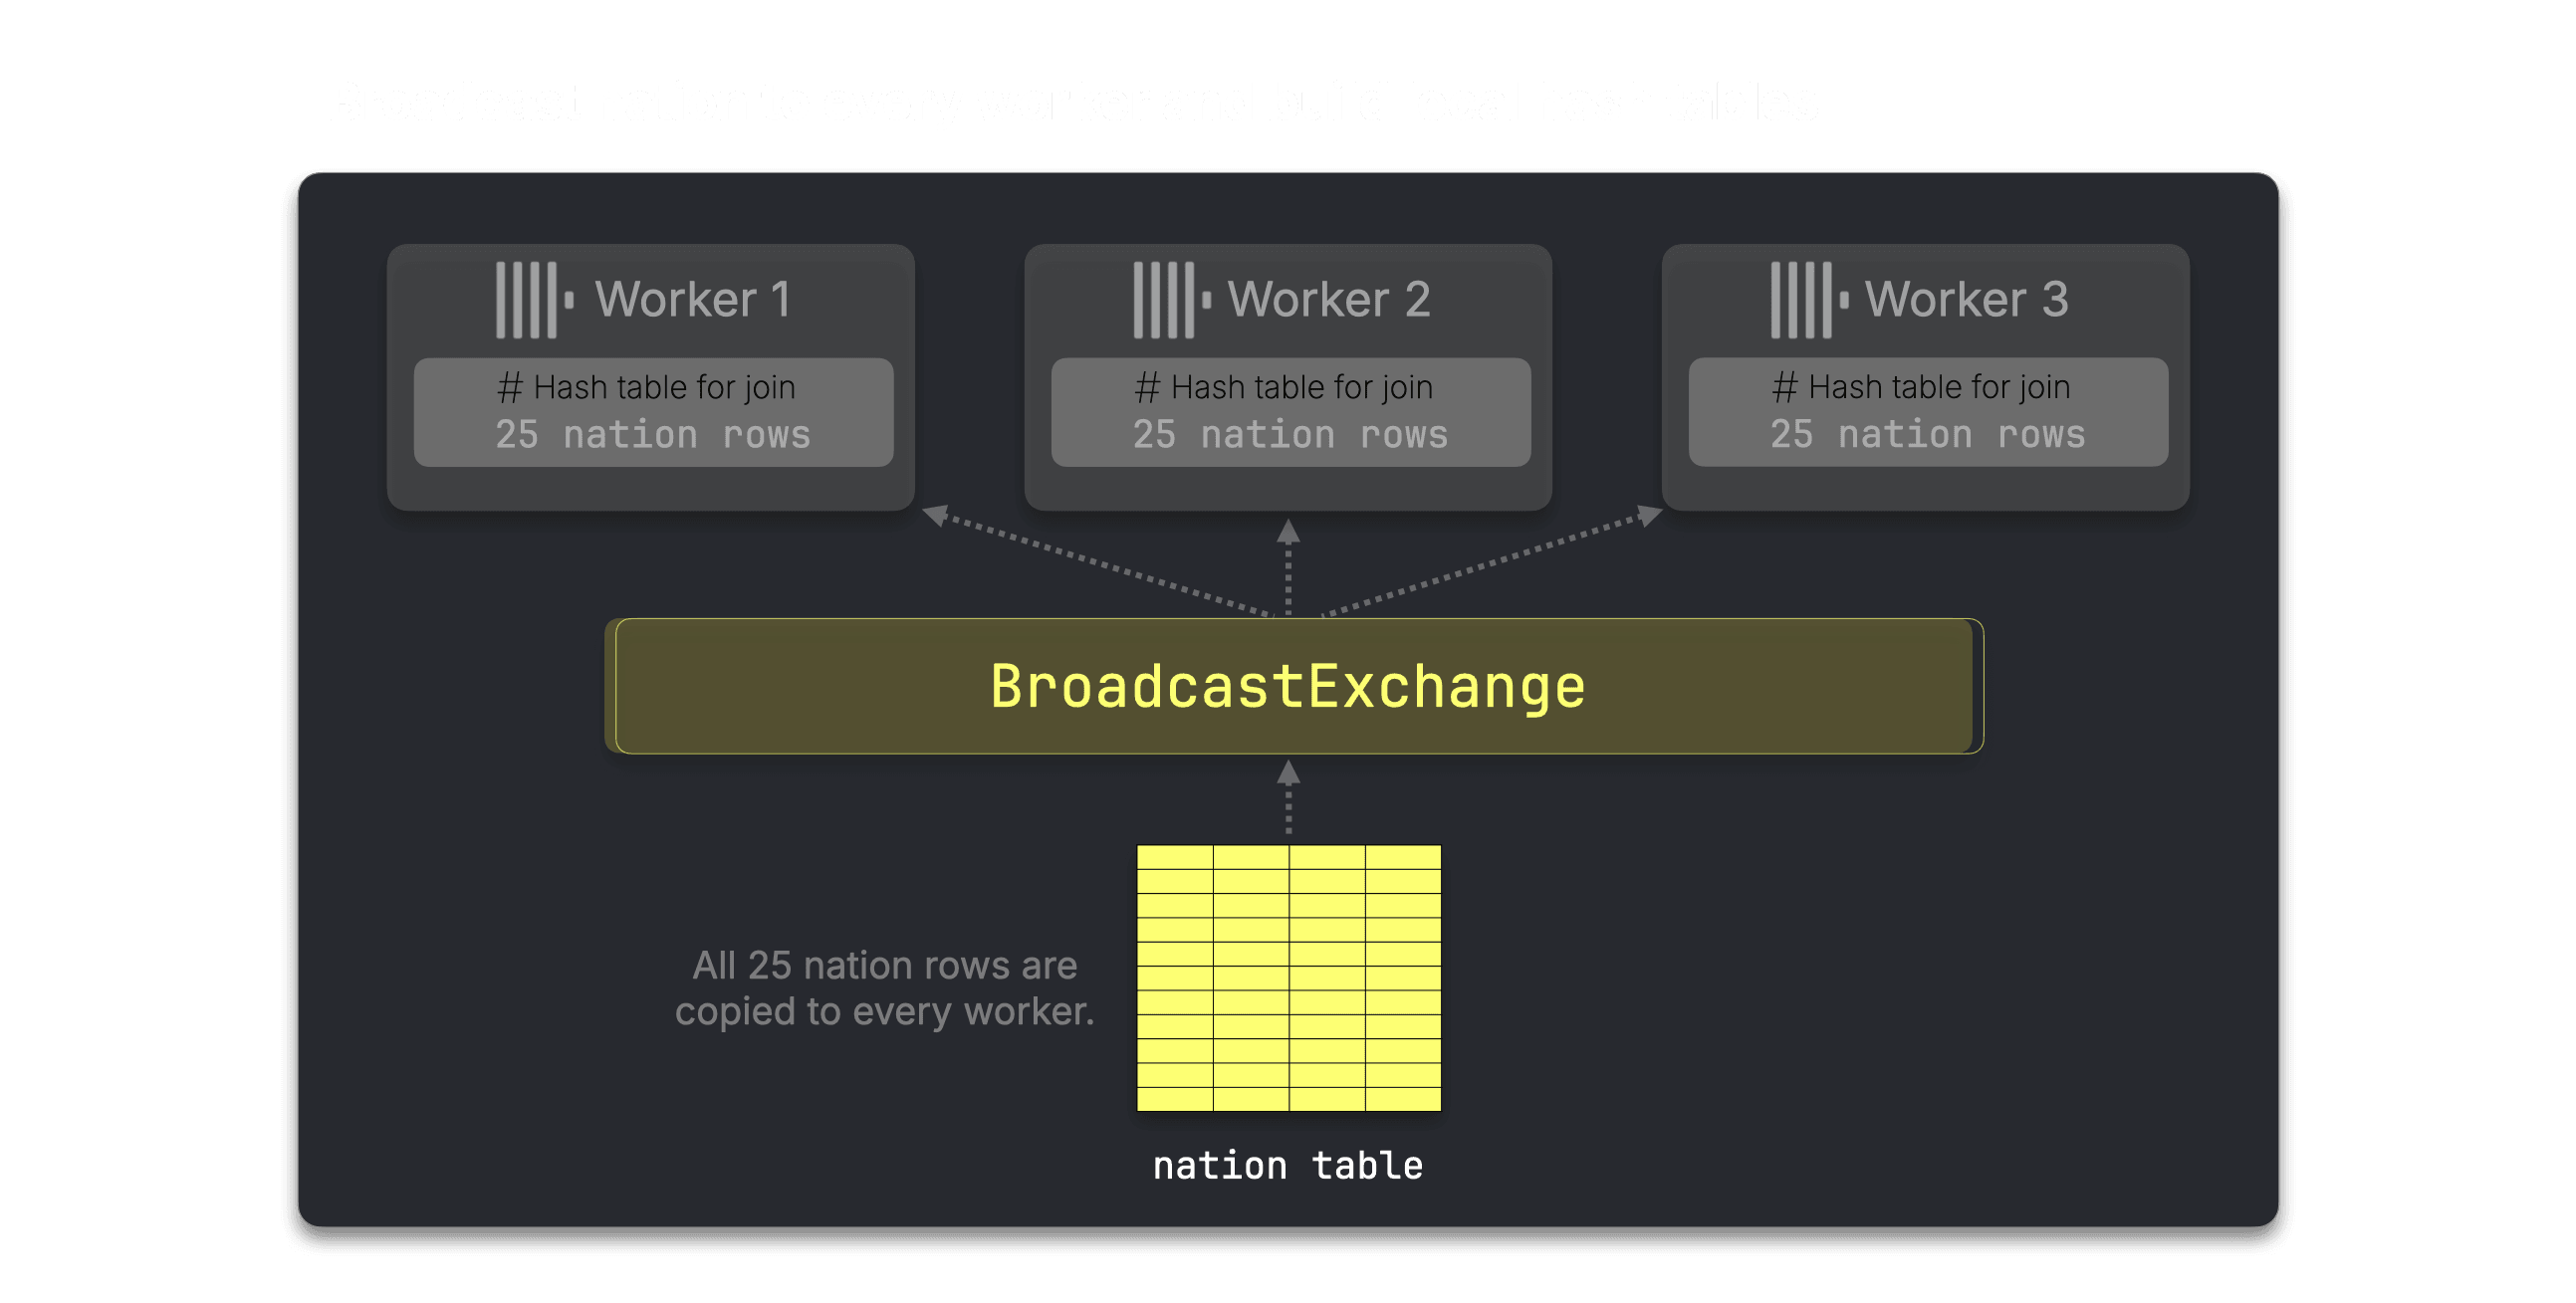
次に各ワーカーは自身の `supplier` のスライスを読み込み…
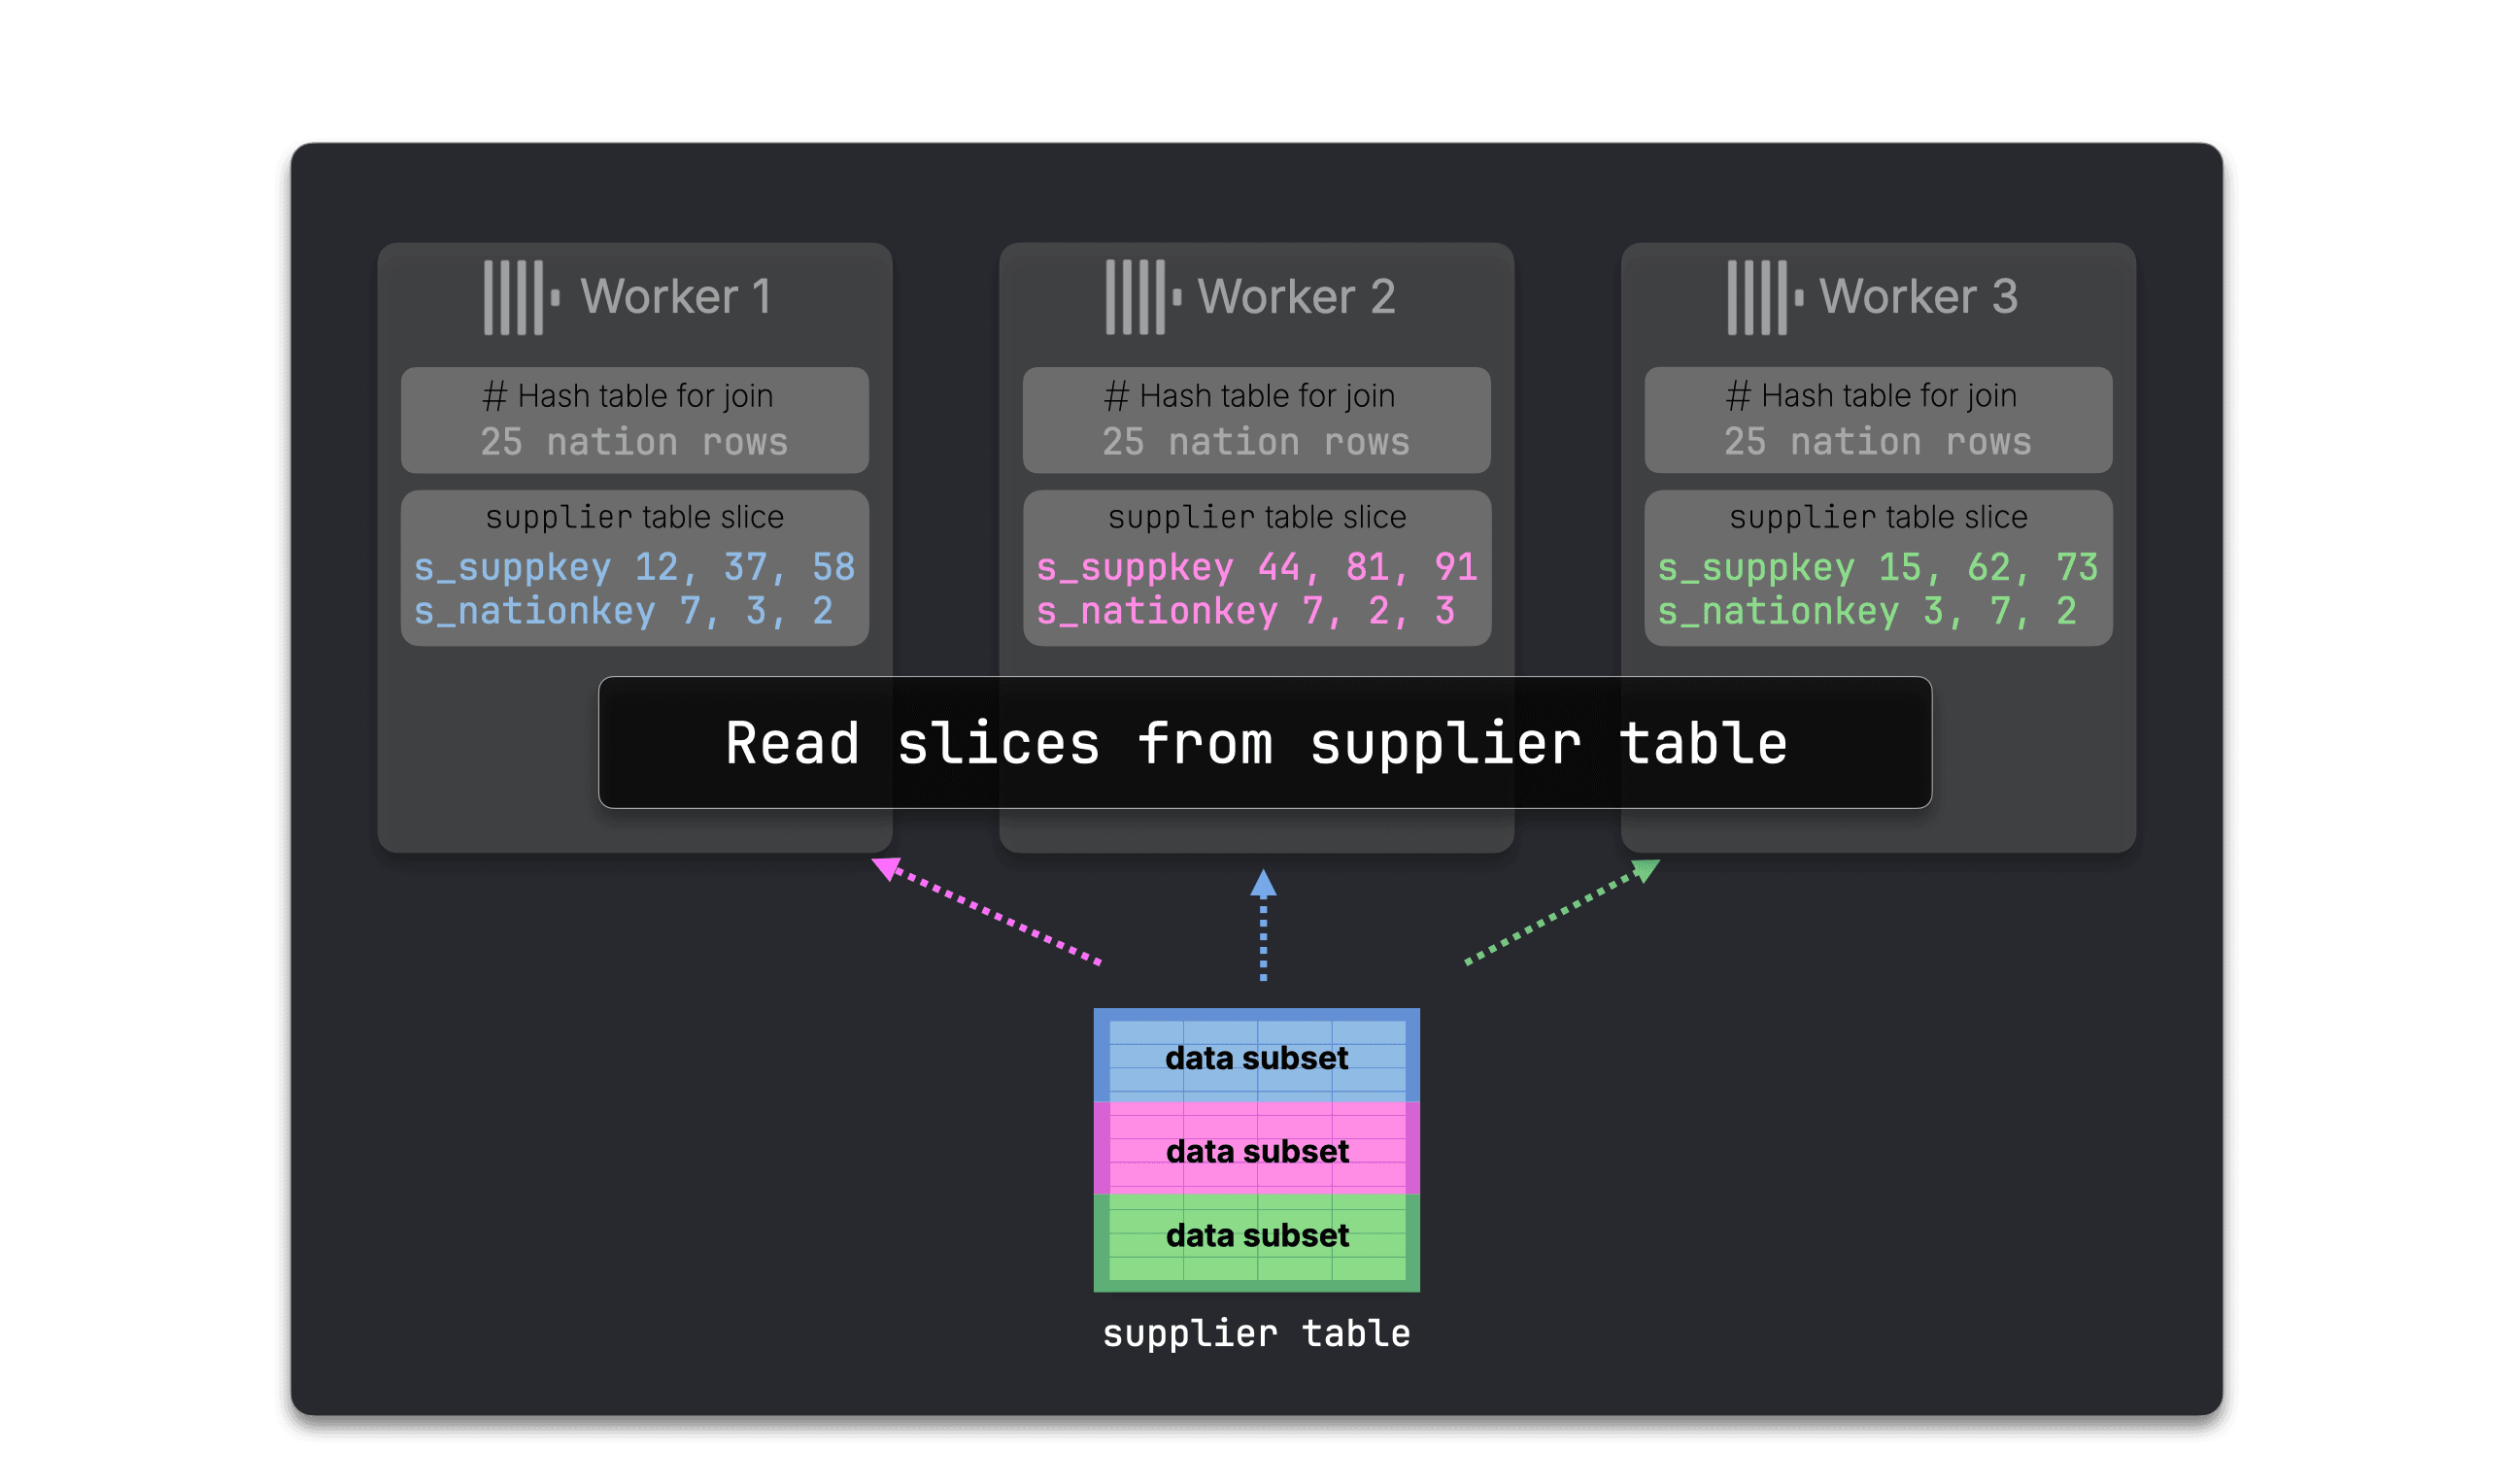
…そのローカルのハッシュテーブルをプローブします。
その結果が、拡張された `supplier ⋈ nation` 側です。
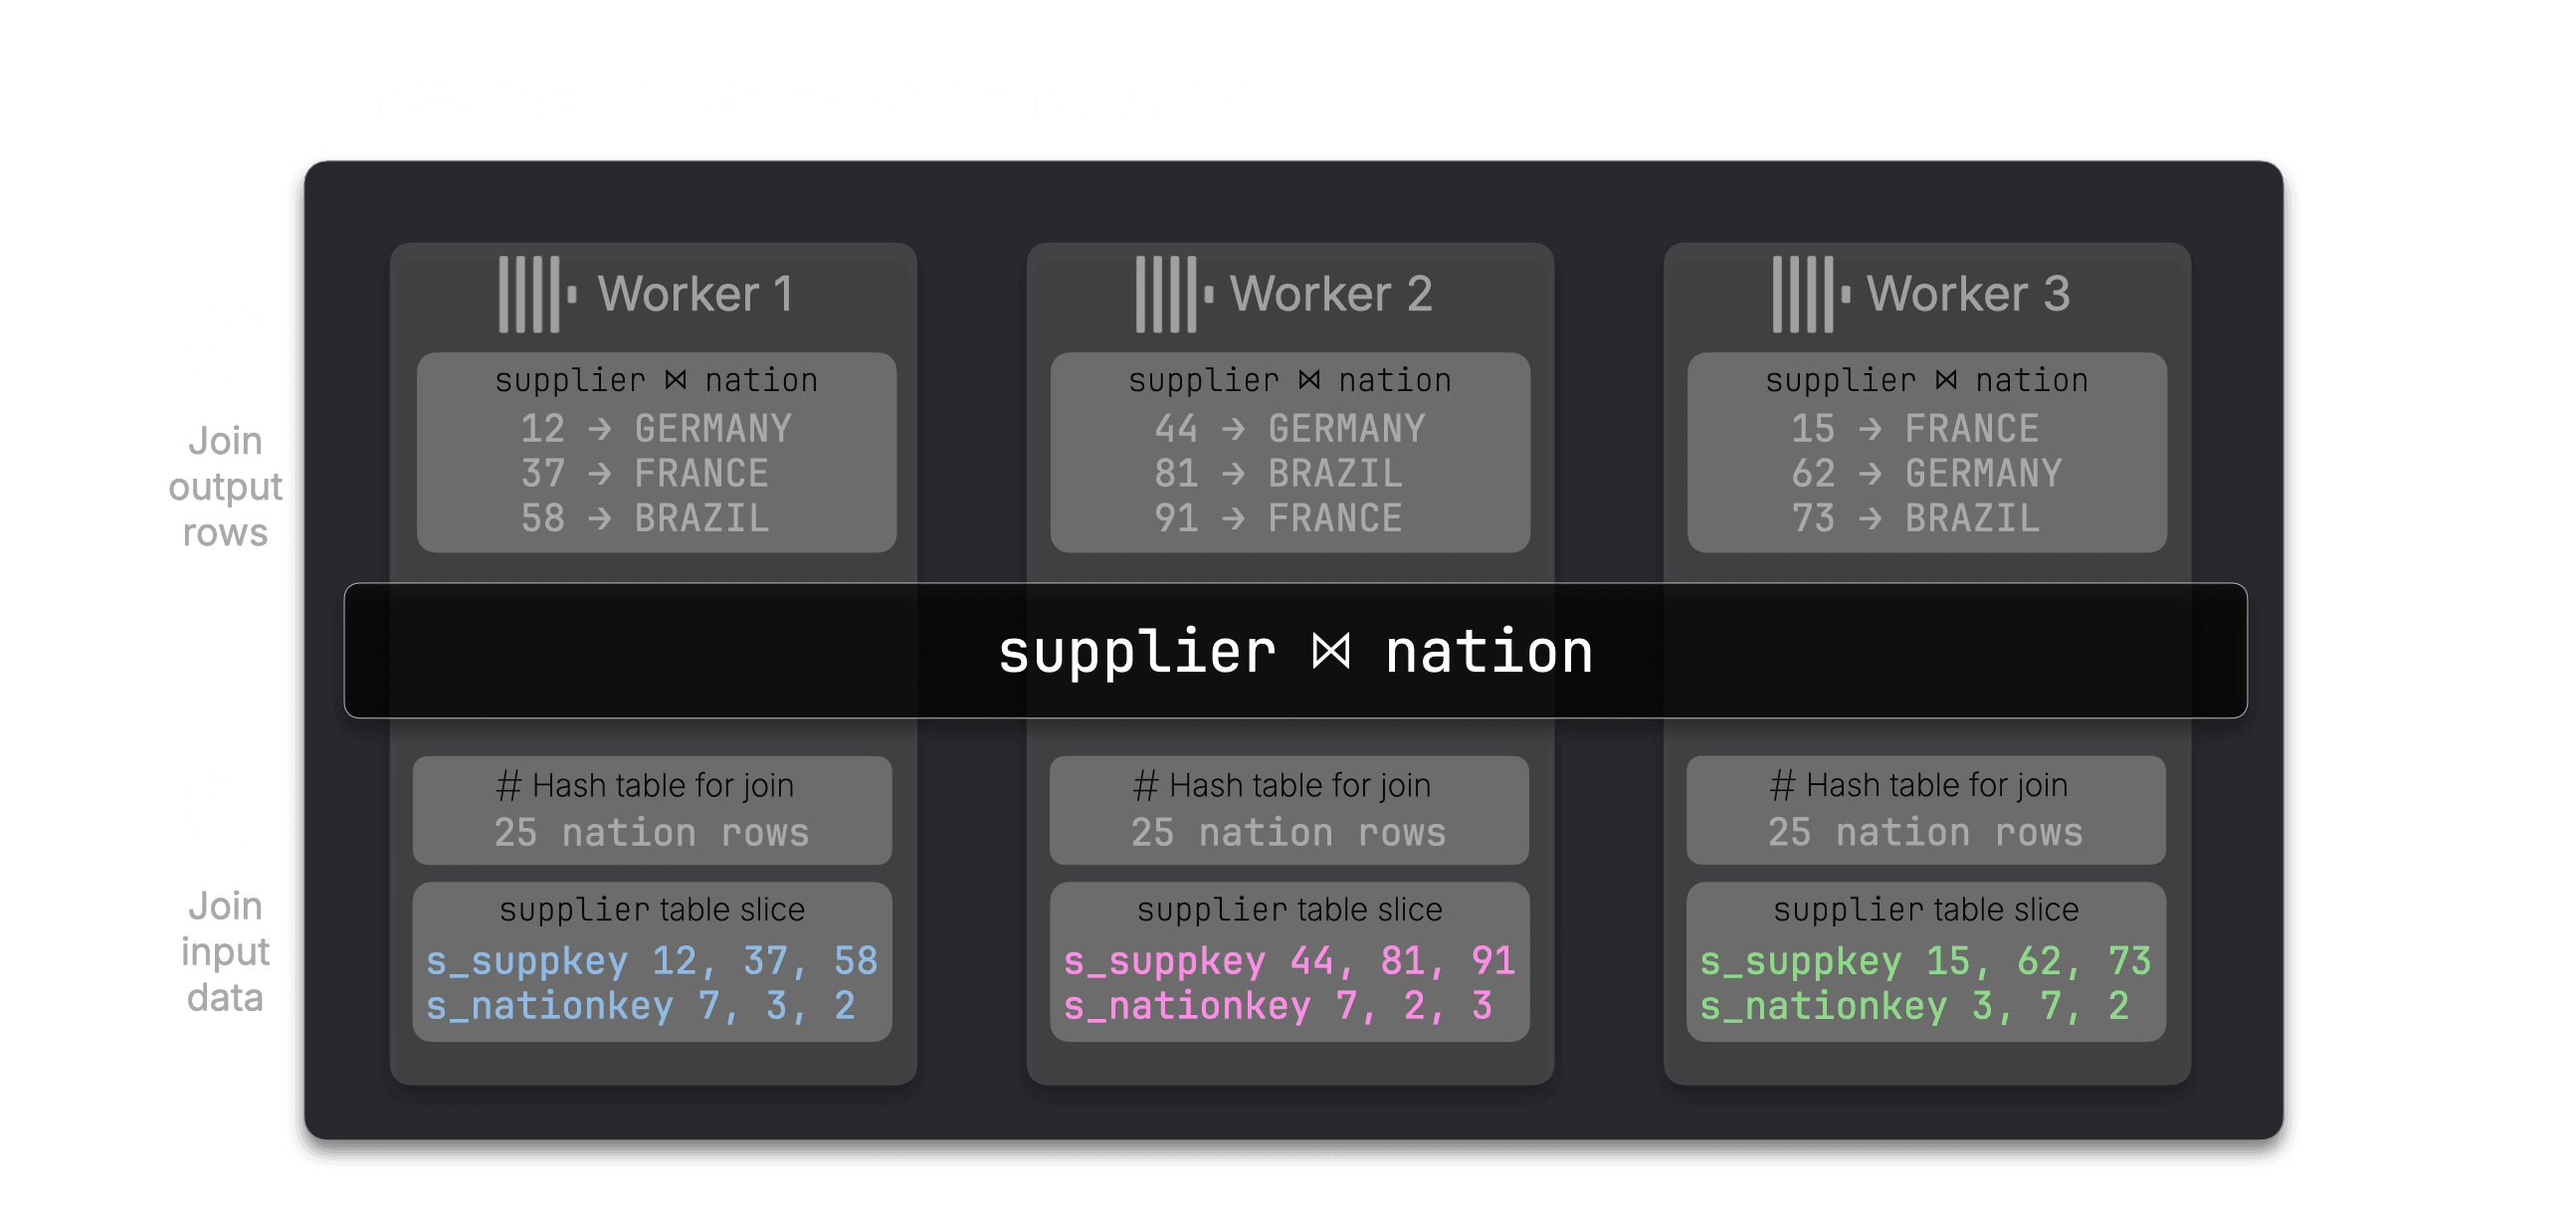
この時点でまだシャッフルは行われていません。各ワーカーは依然として自身の元の `supplier` スライス由来の行を保持しています。
#### **ステップ 2:lineitem を拡張済み supplier 行と同居させる**
次に、ClickHouse はより大きな JOIN である `lineitem` ⋈ (`supplier` ⋈ `nation`) を準備します。
ワーカーはまず `lineitem` のスライスを読み込み…
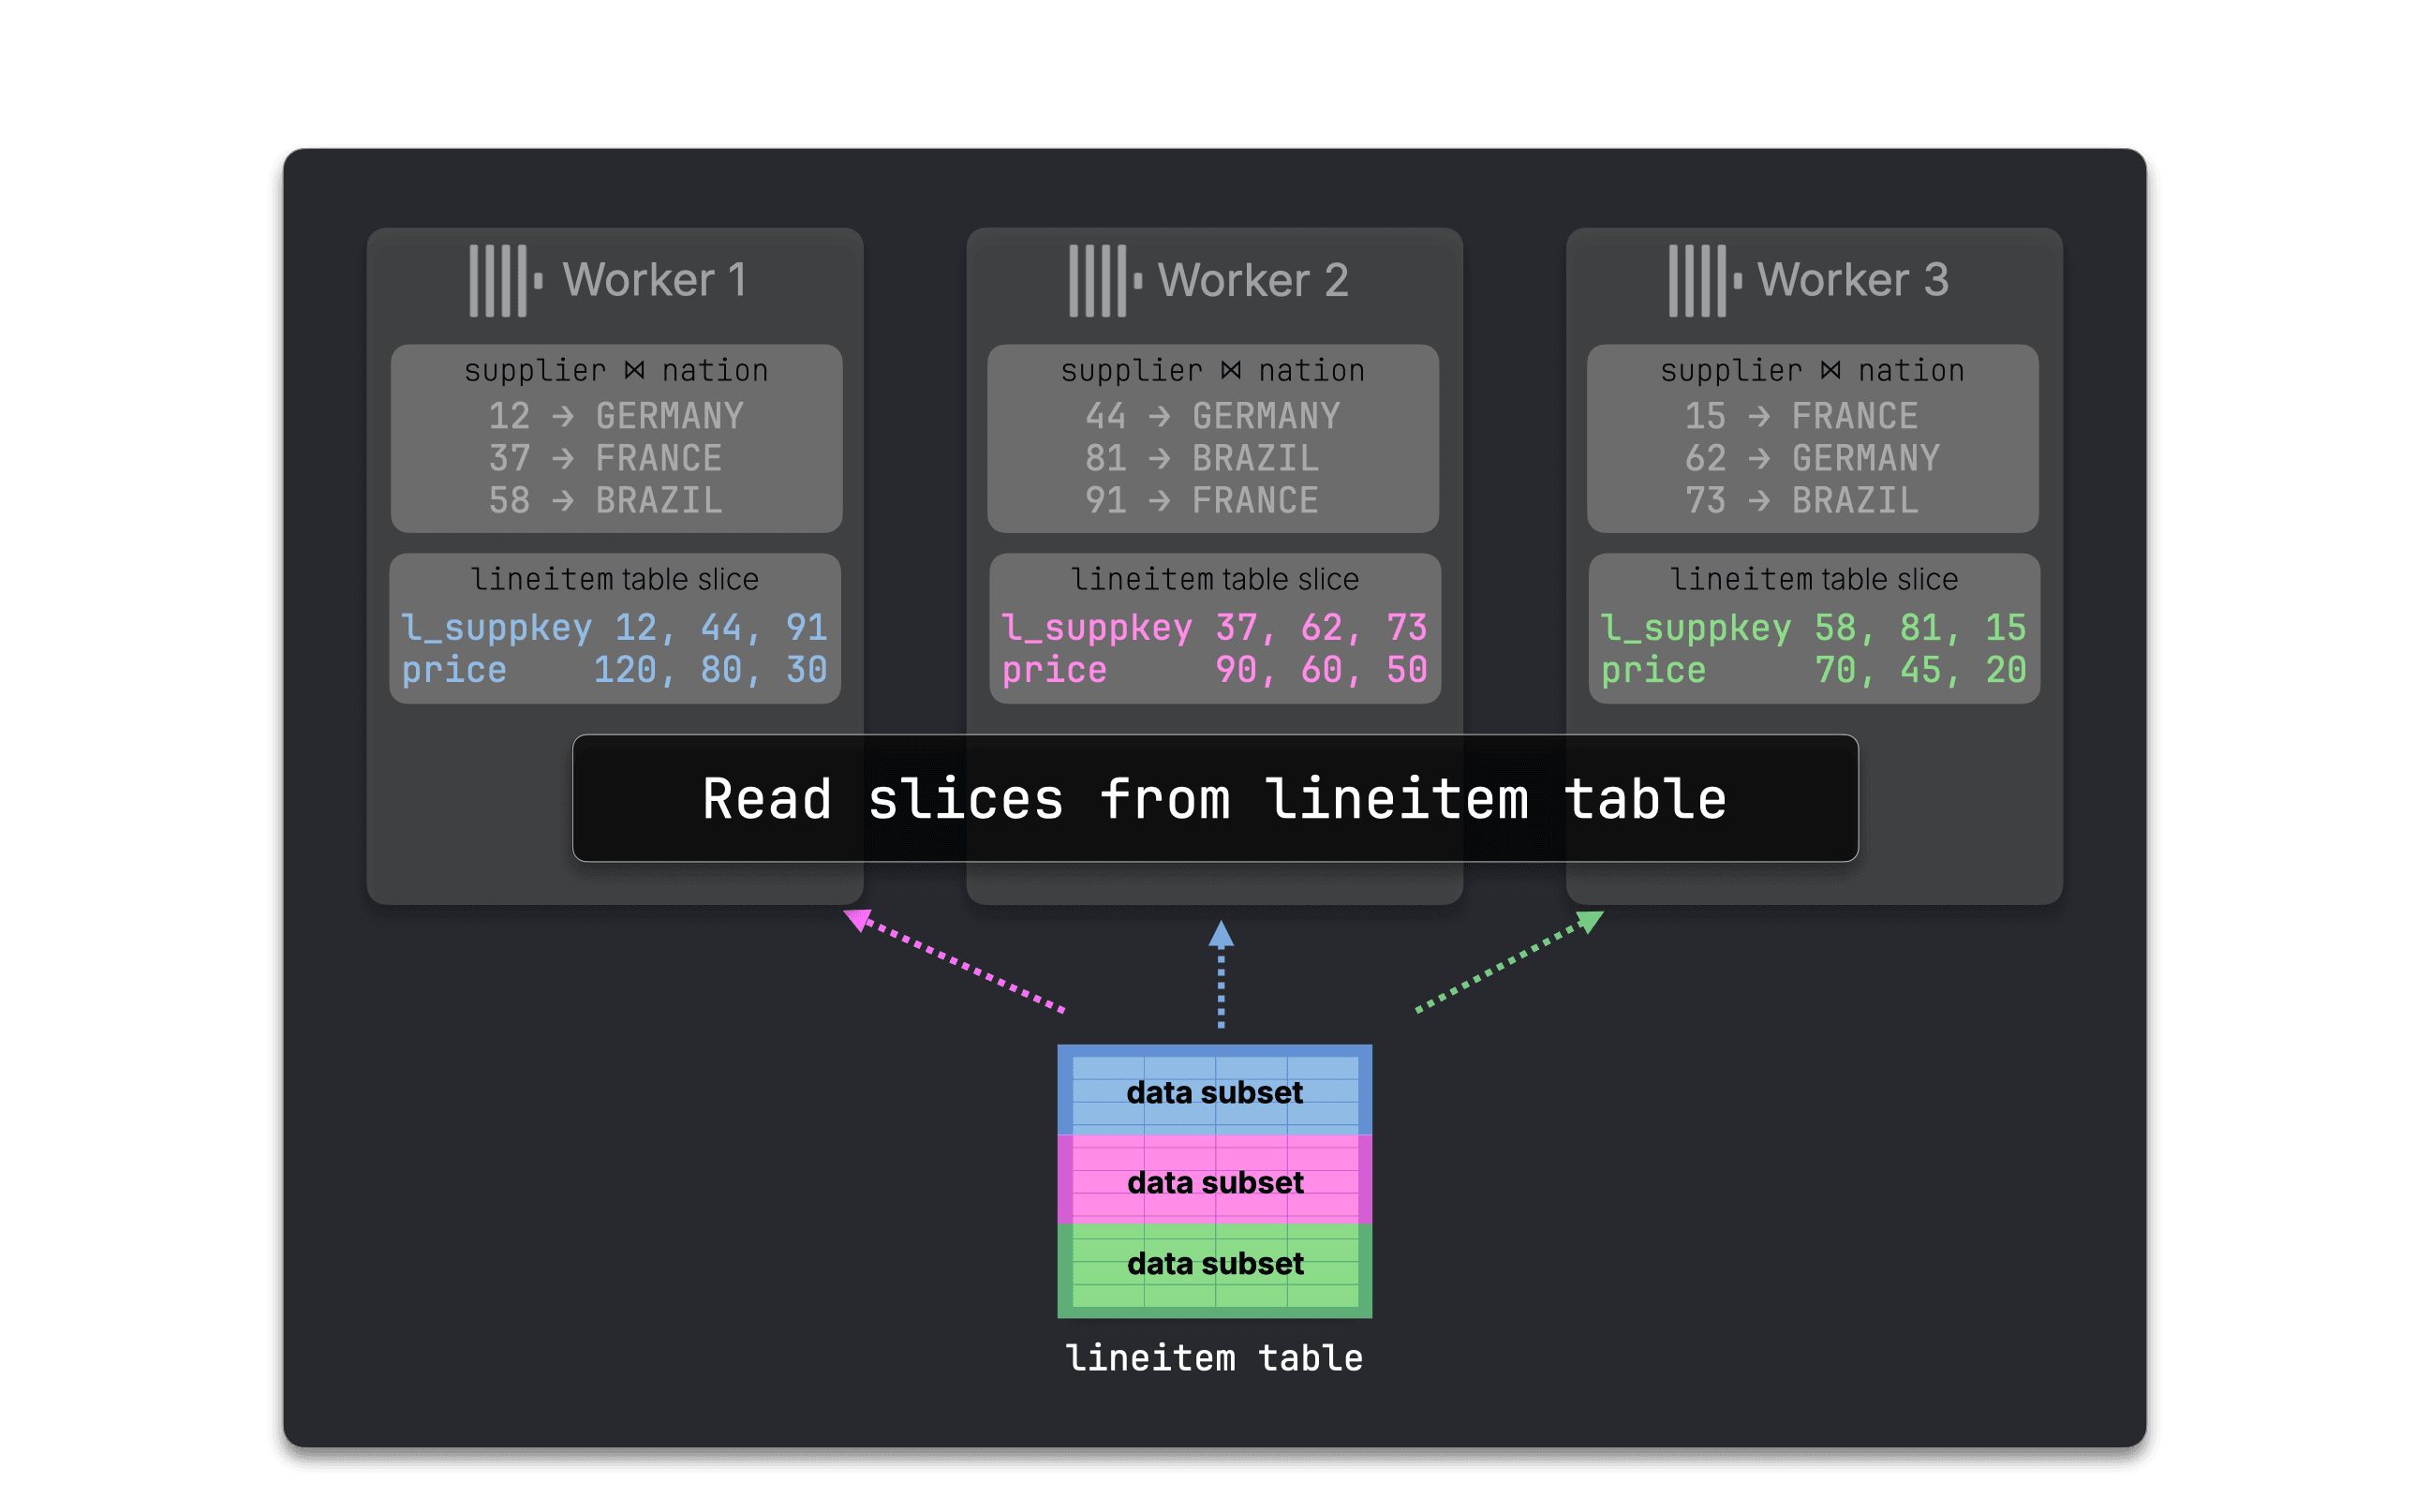
…JOIN の両側をサプライヤキーで再パーティション化します。すなわち、`lineitem` は `l_suppkey` で、拡張された `supplier ⋈ nation` 行は `s_suppkey` で再パーティション化されます。
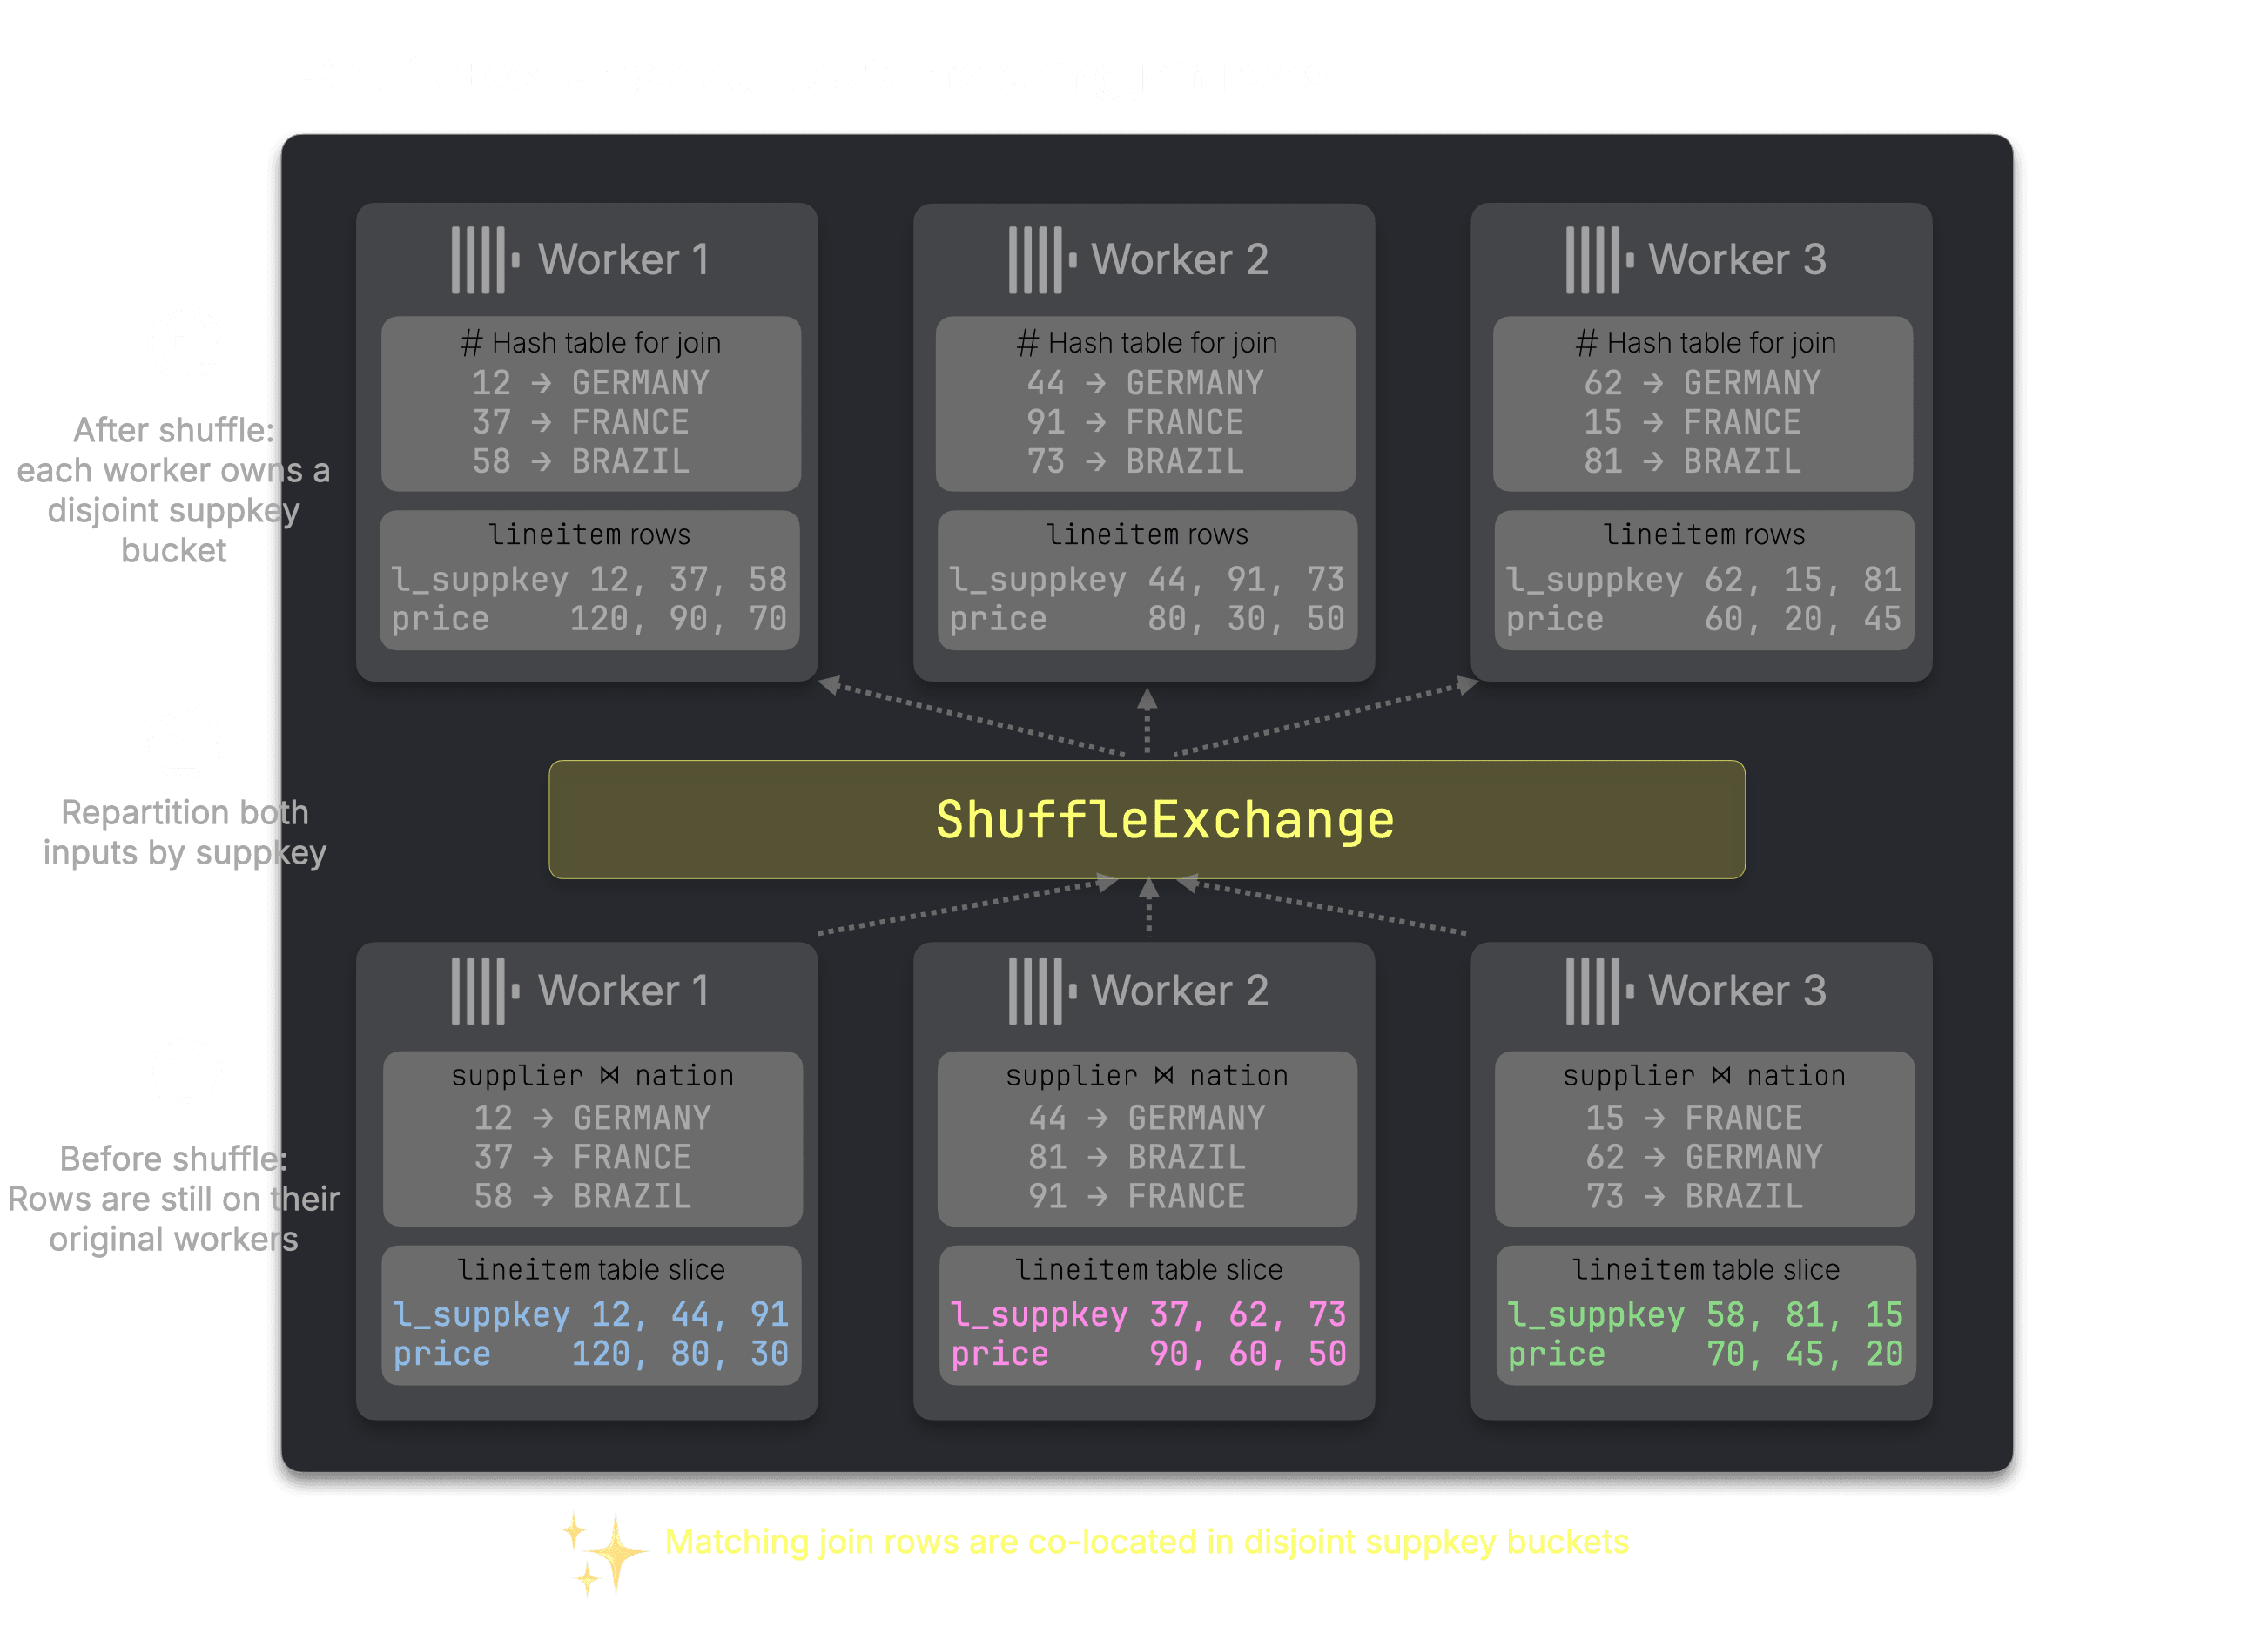
シャッフル後、各ワーカーは両側のマッチする行を含む、互いに重ならないサプライヤキーのバケットを保有し、ステップ 1 で生成された拡張済み `supplier ⋈ nation` 行がビルド側となります。
> **従来のボトルネックを排除:ビルド側の完全コピーが不要**
従来は各ノードが JOIN の右側全体をメモリに保持する必要がありました。シャッフル後、各ワーカーノードは互いに重ならないサプライヤキーのバケットだけを保有するため、構築するハッシュテーブルも自身の担当分のみで済みます。
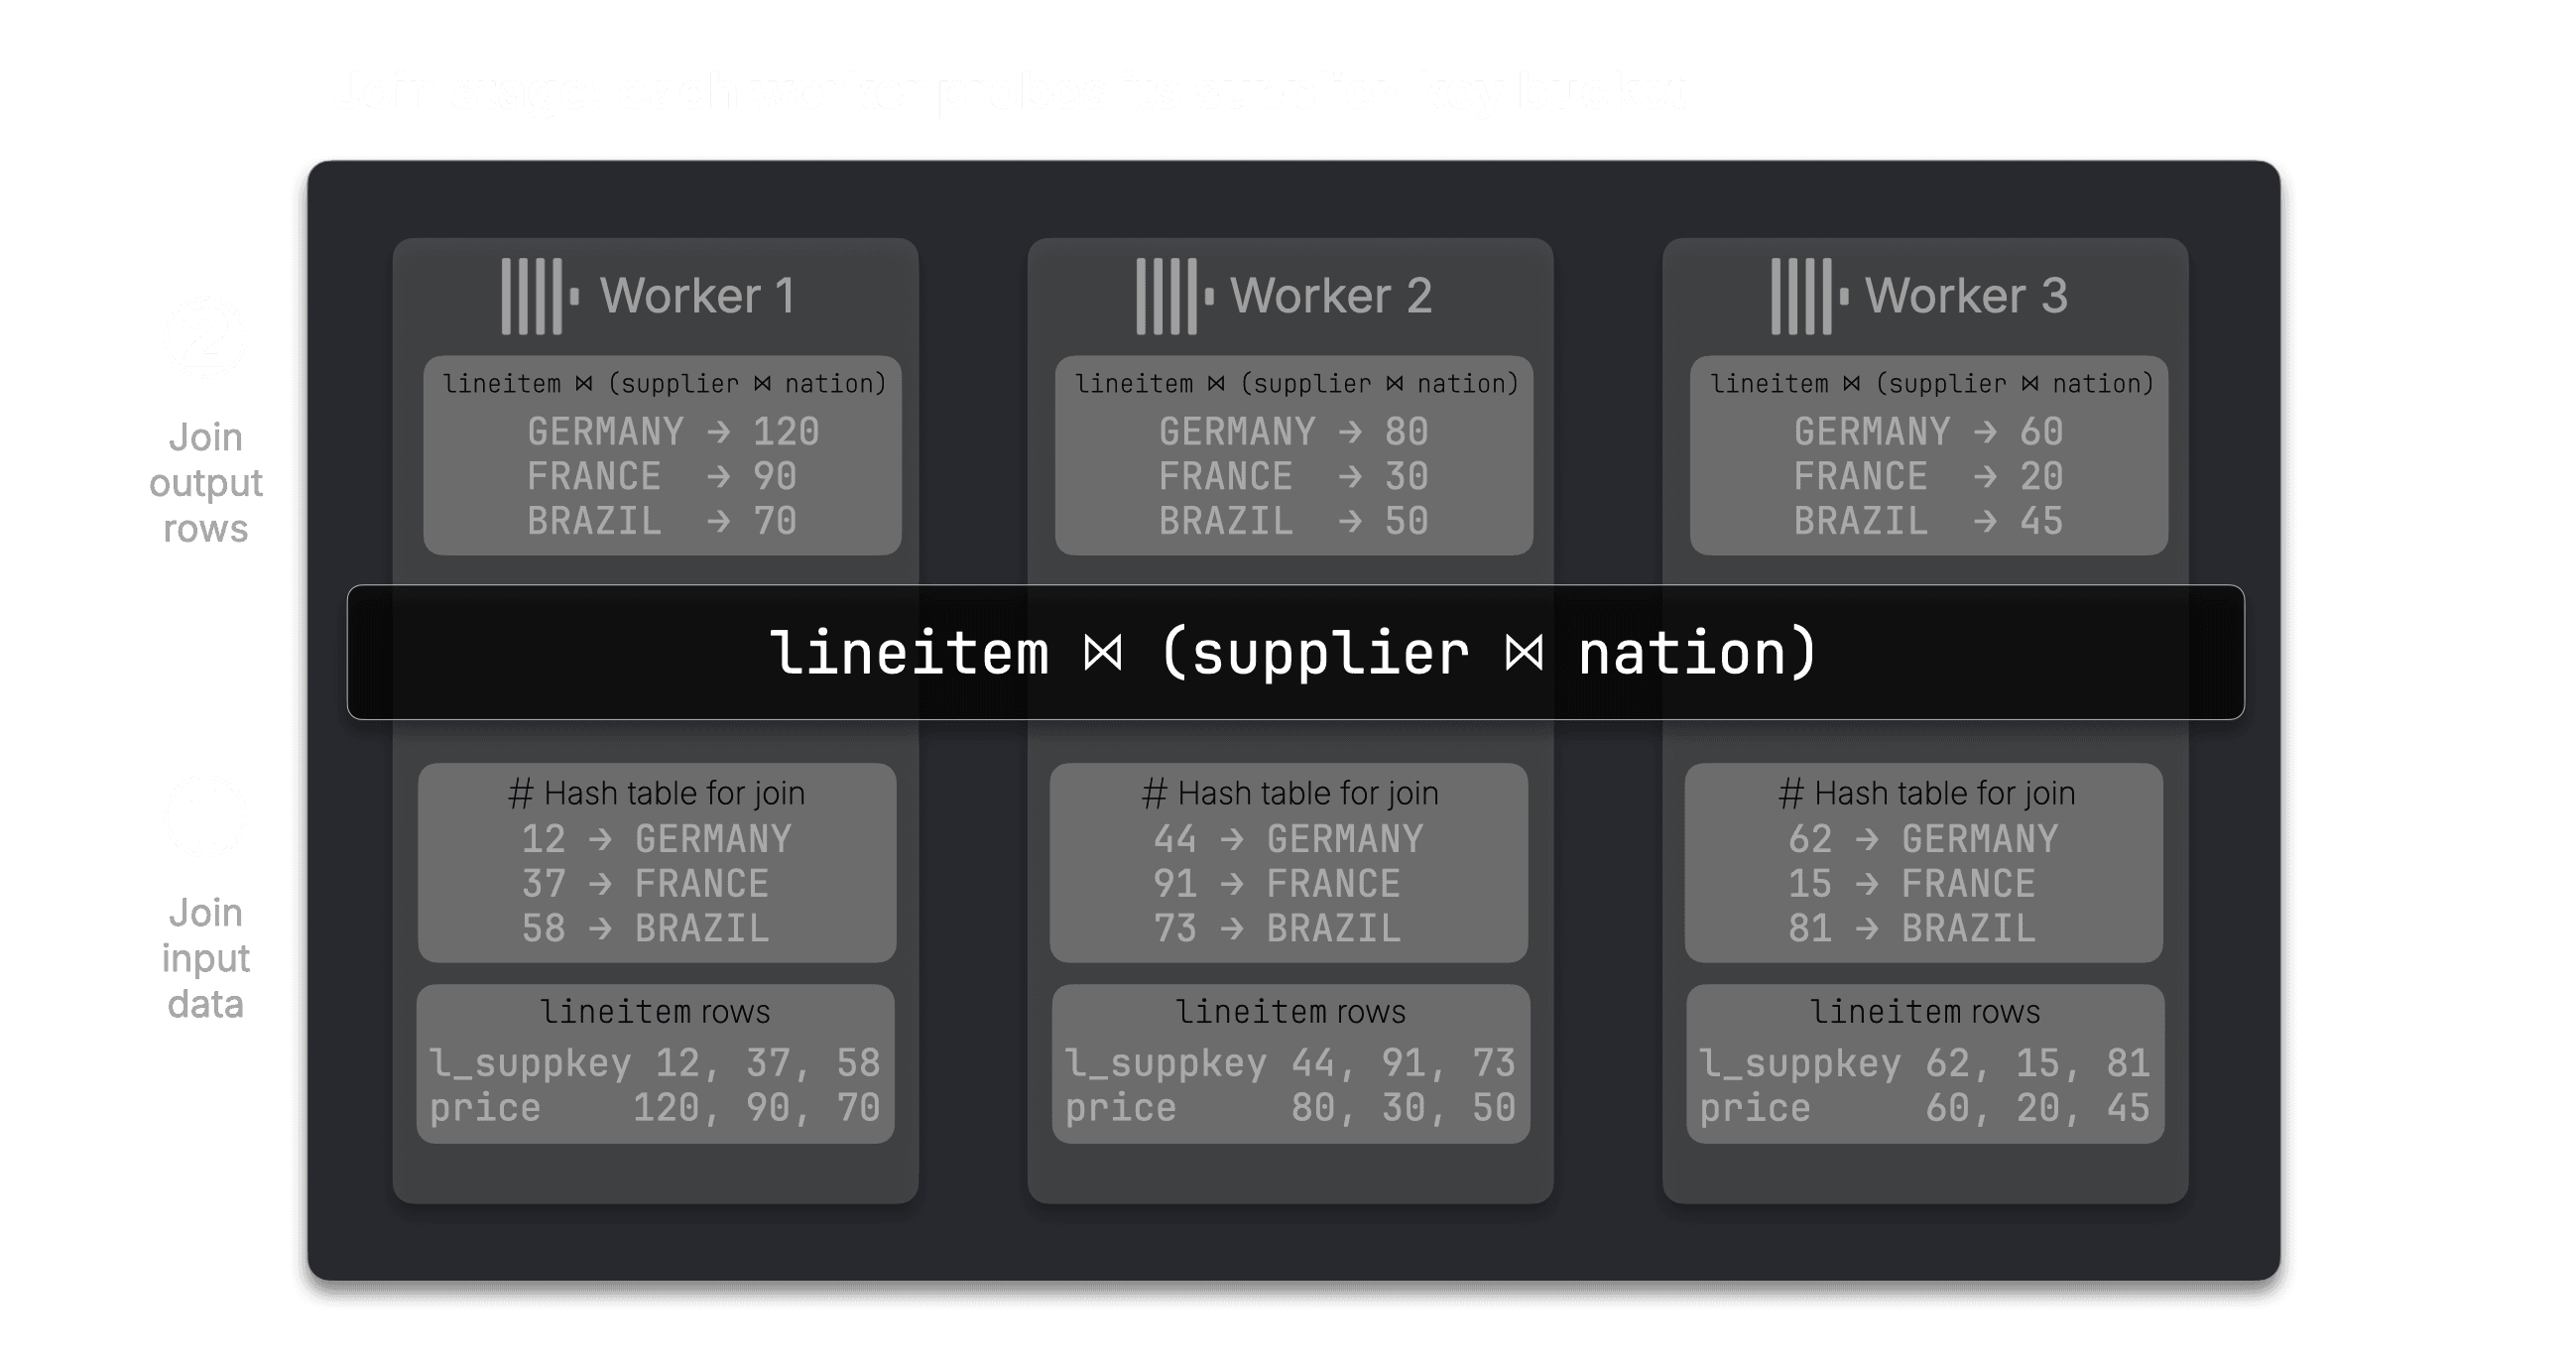
#### **ステップ 3:各サプライヤキーバケット内でローカルに JOIN**
シャッフル後、各ワーカーは 1 つのサプライヤキーバケットを保有します。そのバケットには、JOIN の両側、つまりマッチする `lineitem` 行と拡張済み `supplier ⋈ nation` 行が揃っています。
各ワーカーは、バケットローカルなハッシュテーブルをプローブすることで、ローカルに JOIN を実行できます。完全なビルド側を持つ必要があるワーカーはなく、この JOIN のために追加のネットワーク交換も不要です。
#### **ステップ 4:最終集計のために GROUP BY キーでシャッフル**
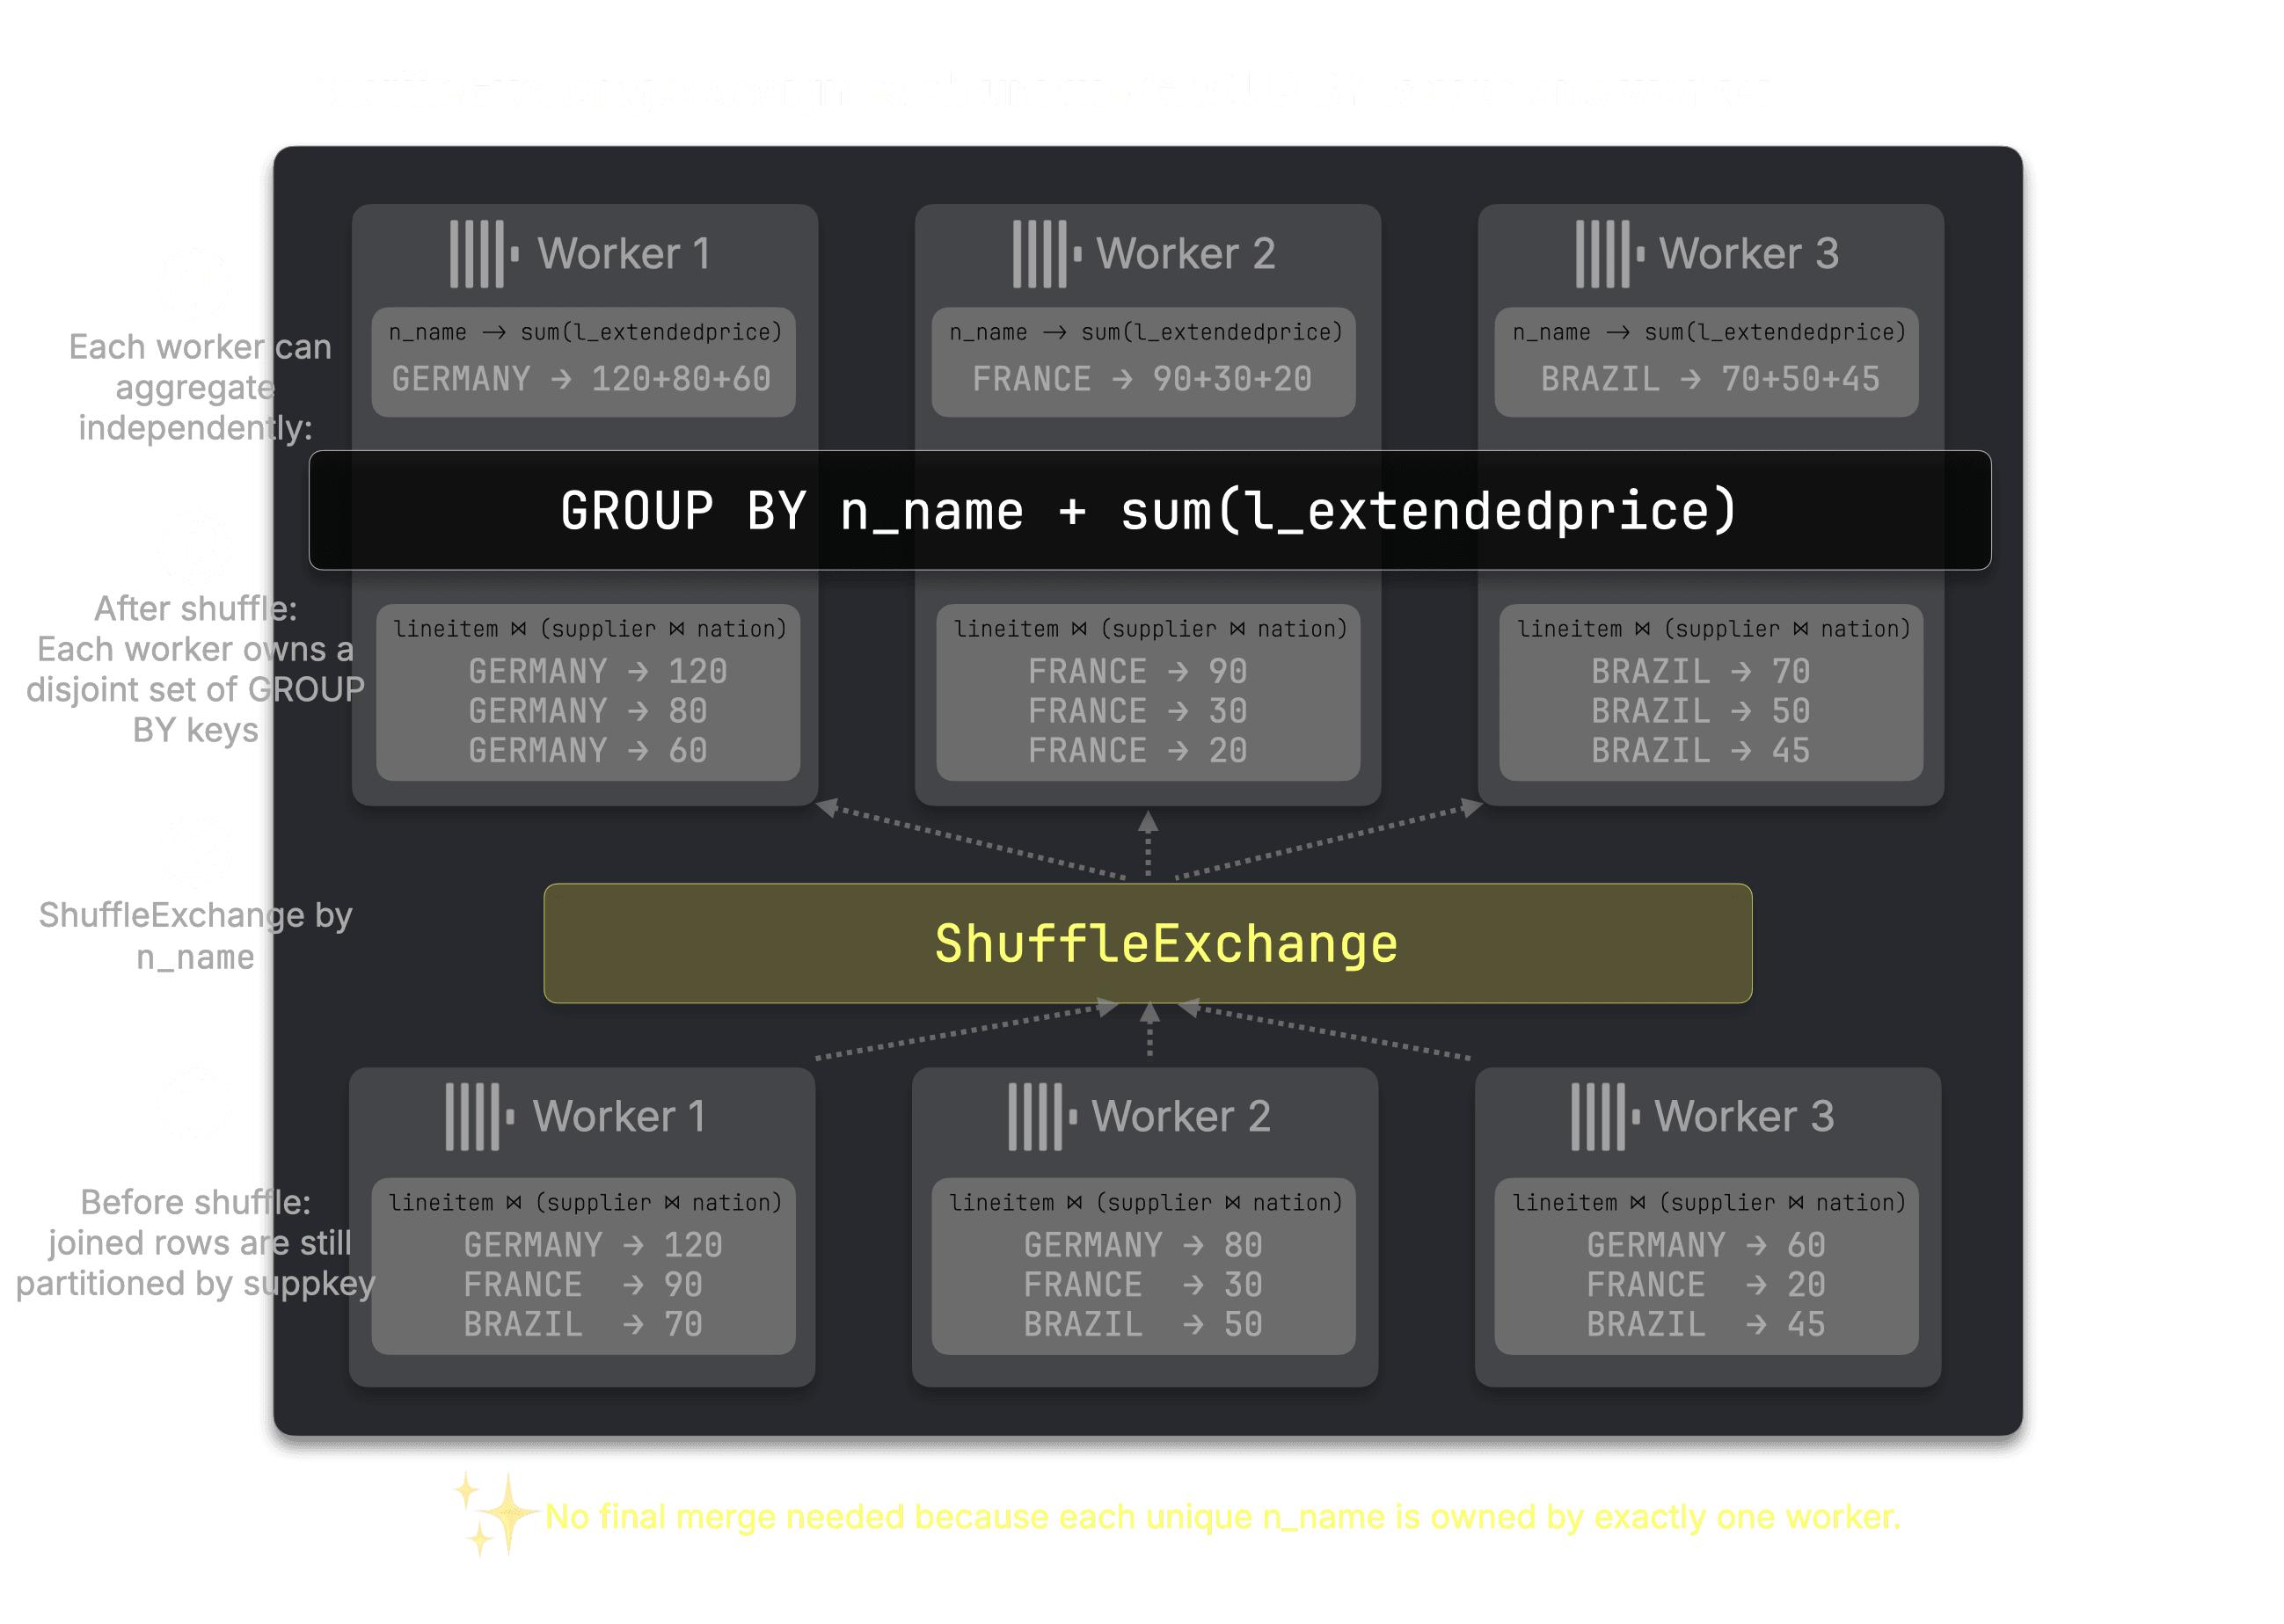
JOIN 出力は依然として `n_name` ではなくサプライヤキーでパーティション化されています。そのため同じ国が複数のワーカーに現れる可能性があります。ClickHouse は JOIN された行を `GROUP BY` キー `n_name` で再シャッフルし、各ワーカーが完全なグループを保有して `sum(l_extendedprice)` を独立に計算できるようにします。
> **従来のボトルネックを排除:単一ノードでの最終集計マージが不要**
従来は各ノードがローカルで部分グループを生成できたものの、同じ GROUP BY キーが複数ノードに現れる可能性があったため、1 つのコーディネータがすべての部分状態をマージする必要がありました。GROUP BY キーでシャッフルすることで、各ワーカーは完全なグループを保有し、自身が担当するキーの最終集計値をローカルに計算できます。
ここでは、`n_name` のディスティンクト値は 25 しかないため、最終マージは小さく済みます。しかし高カーディナリティの GROUP BY では、グルーピングキーでのシャッフルが単一コーディネータでのマージというボトルネックを回避します。このプラン上のトレードオフについては最後に再度触れます。
#### **ステップ 5:ローカルにソートし、最終結果を集約**
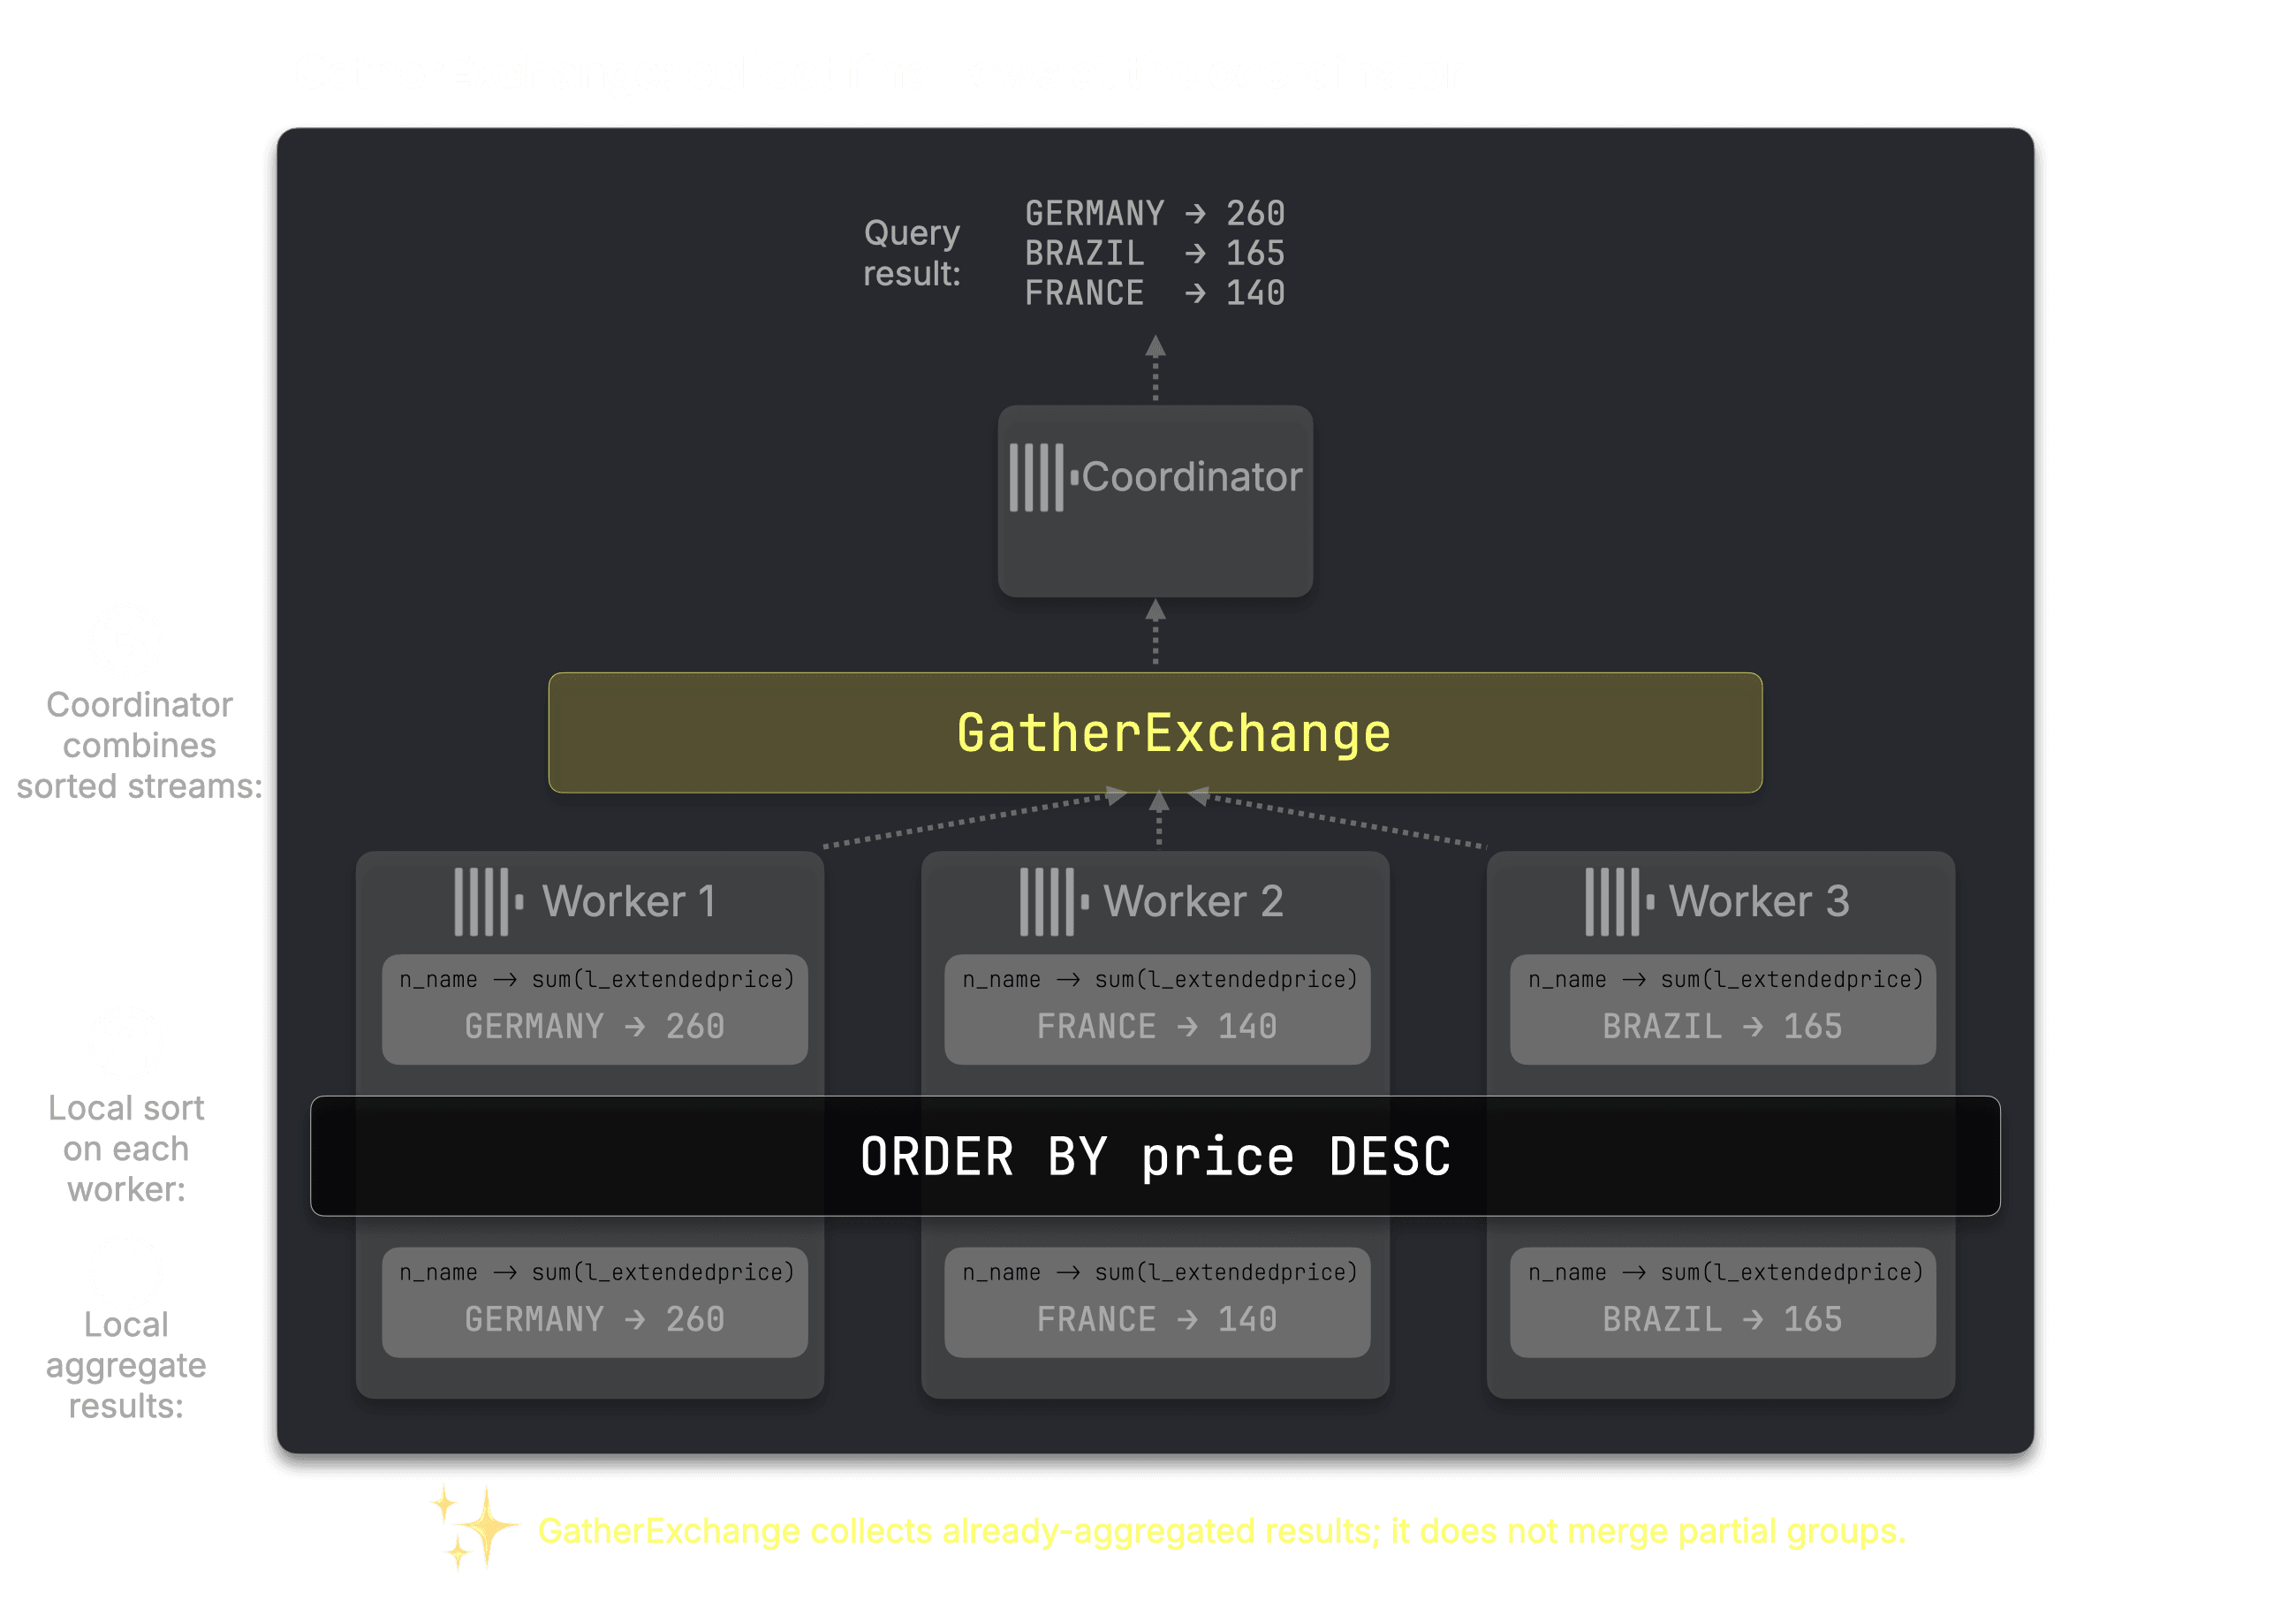
各ワーカーは集計結果を売上でソートします。GatherExchange(3 行目)が全ワーカーからのソート済み結果をコーディネータで結合し、最終出力を生成します。
> **従来のボトルネックを回避:コーディネータは最終行を集約するだけ**
コーディネータは依然としてクエリ結果を受け取りますが、コストの高い処理はすでにワーカー間で完了しています。コーディネータはソート済みで集計済みの行を集めるだけであり、大きな部分グループのマージや大きな JOIN ハッシュテーブルの構築は行いません。
上記の例は論理的なデータ移動(ここではシャッフル、あそこではブロードキャスト、最後にギャザー)を示したものです。内部的には、ClickHouse Cloud はこれらの中間ブロックをワーカー間で効率的に移動するためのトランスポート層を必要とします。
### ステージ間のデータ移動はどう行われるか
exchange は 2 つの方法でデータを移動できます。
デフォルトは **ストリーミング exchange** です。ワーカーはカスタムバイナリプロトコルを使った TCP を介して、他のワーカーに直接ブロックを送信します。データは生成され次第すぐに流れ始めます。lineitem を読み込んでいるワーカーは即座に ShuffleExchange にブロックの送信を開始でき、受信側のワーカーも入力全体を待たずに消費を始められます。言い換えれば、exchange は「すべて書き出してから、すべて読み込む」のではなく、パイプライン化されているのです。
2 つ目のモードは **永続化 exchange** です。中間ブロックをワーカー間で直接送信するのではなく、ClickHouse がそれらを共有オブジェクトストレージに書き出します。これは将来的な障害復旧や、クエリがクラスタメモリを超過したときの中間結果のスピル先として有用です。
ストリーミング exchange は高速なインタラクティブクエリ向けに最適化されており、デフォルトとなっています。ワーカーが故障した場合、クエリは失敗し、クライアントがリトライします。こうしたワークロードでは、すべての exchange でチェックポイントを取るよりもクエリを再実行するほうが通常は安価です。
### なぜ ClickHouse Cloud でこれが可能なのか
マルチステージ分散実行は、ワーカーが互換可能であることに依存しています。あるステージが任意のワーカー上で実行できるのは、そのワーカーが必要なデータとメタデータにアクセスできる場合のみです。
#### 共有ストレージがワーカーを互換可能にする
ClickHouse Cloud はすでにその基盤を備えています。テーブルデータは共有オブジェクトストレージに置かれており、すべてのノードはそれを読み込むのに必要なメタデータにアクセスできます。したがってコーディネータは、クラスタ全体でステージを動的に割り当てられます。どのワーカーもテーブルデータをスキャンしたり、シャッフルされた行を受信したり、ハッシュテーブルの自分の担当分を構築したり、割り当てられたグループを集計したり、ローカル結果をソートしたりできます。
#### シャッフルはメモリ利用効率を改善する
これによりメモリ利用効率も向上します。ShuffleExchange が大規模 JOIN を 8 ワーカーに分割すると、各ワーカーは行のおよそ 1/8 を受信し、ハッシュテーブルのおよそ 1/8 を構築します。1 ノードで 16 GiB のメモリを必要とする JOIN は、代わりに 8 ノードでワーカーあたり約 2 GiB を使って実行できます。
#### 共有ストレージにより一部のブロードキャストを回避できる
共有ストレージは将来的な最適化への扉も開きます。小さなテーブルについては、ワーカーがネットワーク経由でブロードキャストを受け取る必要すらないかもしれません。ワーカーはオブジェクトストレージから直接テーブルを読み込み、以降の読み取りのためにローカル SSD キャッシュに保持できます。これは nation や supplier のようなディメンションテーブルで有用で、ローカルキャッシュからの読み取りのほうが exchange レイヤを通じてブロードキャストするよりも安価になる可能性があります。
#### ステートレスワーカーに向けて
長期的な方向性は完全なステートレスワーカーです。オンデマンドで出現してクエリの仕事を引き受け、共有ストレージから必要なデータを読み込み、仕事が終わったら再び消える。固定的な所有権も手動でのデータ配置もありません。マルチステージ分散実行は、そうしたモデルへの一歩です。
### 単一ノードクエリはどうなるのか
ClickHouse の単一ノード実行パスは変わりません。カラム指向の MergeTree ストレージ、ベクトル化実行、積極的なパイプライン並列性は、引き続きクエリ性能の基盤です。
マルチステージ分散実行は、複数ノードでのスケールから恩恵を受けるクエリのための、追加のオプトインパスです。ClickHouse の実行モデルを拡張するものであり、単一ノードエンジンを置き換えるものではありません。
## マルチステージ分散クエリ実行の TPC-H ベンチマーク結果
TPC-H は分析的クエリ処理の業界標準ベンチマークです。8 つのテーブルにまたがる 22 のクエリで構成され、単純なスキャンから複雑なマルチテーブル JOIN までを含み、実世界の意思決定支援ワークロードをシミュレートするように設計されています。
スケールファクタ 100(約 100GB のデータ)で実行しました。各テーブルの行数は以下の通りです。
* `lineitem`(6 億行)
* `orders`(1.5 億行)
* `partsupp`(8000 万行)
* `part`(2000 万行)
* `supplier`(100 万行)
* `nation`(25 行)
ベンチマークは ClickHouse Cloud ステージング環境のマシン(ARM (Graviton)、8 コア、32 GB RAM)で実行しました。ClickHouse の SharedMergeTree とサーバーバージョン 26.2.1.261 を使用しています。
下記の表は、各クエリを 1 ノード(ベースライン)と、マルチステージ分散クエリ実行を使った 8 ノードで実行した結果を示しています。各クエリを 3 回実行し、最良の時間を採用しています。
| クエリ | 1 ノード | 8 ノード | 高速化倍率 | 備考 |
|---|---:|---:|---:|---|
| Q01 | 14.36s | 1.94s | 7.4x | フルスキャン + 集計、ほぼ線形 |
| Q02 | 1.33s | 2.31s | 0.6x | ランタイムフィルタが完全サポートされていない |
| Q03 | 3.67s | 1.27s | 2.9x | 3 テーブル JOIN |
| Q04 | 3.13s | 0.74s | 4.2x | EXISTS サブクエリを JOIN として扱う |
| Q05 | 6.16s | 2.31s | 2.7x | 6 テーブル JOIN |
| Q06 | 0.65s | 0.16s | 4.1x | 単一テーブルスキャン |
| Q07 | 3.21s | 1.24s | 2.6x | 6 テーブル JOIN |
| Q08 | 5.61s | 2.65s | 2.1x | 8 テーブル JOIN |
| Q09 | 15.42s | 4.60s | 3.4x | 6 テーブル JOIN |
| Q10 | 5.90s | 2.39s | 2.5x | 4 テーブル JOIN |
| Q11 | 1.04s | 0.58s | 1.8x | 3 テーブル JOIN |
| Q12 | 2.45s | 0.81s | 3.0x | 2 テーブル JOIN |
| Q13 | 5.18s | 1.56s | 3.3x | 2 テーブル JOIN、2 段階集計 |
| Q14 | 0.49s | 0.21s | 2.3x | 2 テーブル JOIN |
| Q15 | 0.07s | 0.07s | 1.0x | 既に高速 |
| Q16 | 1.12s | 0.58s | 1.9x | 3 テーブル JOIN |
| Q17 | 5.99s | 2.88s | 2.1x | 2 テーブル JOIN + サブクエリ |
| Q18 | 16.07s | 16.32s | 1.0x | ルールベースプランナーで EXISTS サブクエリが分散化されない |
| Q19 | 8.09s | 1.78s | 4.5x | 2 テーブル JOIN |
| Q20 | 1.54s | 1.10s | 1.4x | 4 テーブル JOIN |
| Q21 | 14.83s | 8.77s | 1.7x | EXISTS/NOT EXISTS を含む 4 テーブル JOIN |
| Q22 | 1.31s | 0.38s | 3.4x | 2 テーブル JOIN |
| **合計** | **117.6s** | **54.7s** | **2.1x** | |
### なぜ Q02 は遅いのか
一部の単一ノード最適化はまだ分散モードで完全にはサポートされていません(例:JOIN をまたぐ Bloom フィルタのプッシュダウンといったランタイムフィルタ)。Q02 はこのために回帰が見られます。
### 何が良くスケールするか
**スキャン主体のクエリにおけるほぼ線形のスケーリング**
Q01(6 億行のフルスキャン + 集計)は 8 ノードで 7.4 倍を達成しています。
処理のほぼすべてが読み取りと集計であり、これはワーカー間に均等に分割でき、exchange のオーバーヘッドも最小限です。
**マルチ JOIN クエリで良好なスケーリング(2〜5 倍)**
Q19(4.5x)、Q04(4.2x)、Q06(4.1x)、Q09(3.4x)、Q22(3.4x)、Q13(3.3x)、Q12(3.0x)、Q03(2.9x)。
これらのクエリには相応のシャッフルオーバーヘッドがあります。各 exchange はデータのシリアライズ、ネットワーク転送、デシリアライズを伴うためです。それでも、並列化された JOIN 計算と比較すれば相対的に小さなコストです。
### より賢いプランの余地はどこにあるか
ルールベースの戦略はほとんどのクエリでうまく機能しますが、一部のプランは最適ではありません。
Q08 は片側が絞り込み後にわずか 13.4 万行しかない JOIN の両側をシャッフルしています。ブロードキャストすれば 6 億行の再シャッフルを回避できます。
Q18 の `EXISTS` サブクエリは並列性を制限しています。`supplier`(100 万行)のような小さなテーブルは、各ワーカーが共有オブジェクトストレージから直接読み込めるにもかかわらず、ネットワーク経由でシャッフルされています。
これらの制約は実行エンジンの本質的な制限ではありません。エンジンは与えられたどんなプランも実行できます。問題は、どのプランを与えるか、です。
## 今後の展開
私たちはマルチステージ分散クエリ実行のためのコストベースオプティマイザに取り組んでおり、これによりクエリ性能のさらなる向上が見込まれます。
重要なテーマの 1 つは、適切な集計戦略を自動的に選択することです。GROUP BY キーでシャッフルして各ワーカーに完全なグループを持たせるほうが良いクエリもあれば、ローカルでの部分集計後に最終マージを行うほうが良いクエリもあります。コストベースオプティマイザは、カーディナリティ、データサイズ、クラスタ構成に基づいてこれらの戦略を選択できます。
今後の投稿にご期待ください。
## マルチステージ分散クエリ実行はどう使えるか
執筆時点(2026 年 5 月)では、マルチステージ分散実行は **実験的機能** であり、ClickHouse Cloud のプライベートプレビュープログラムの一部としてのみ利用可能です。
アクセスをリクエストするには、ClickHouse のアカウントチームにご連絡いただくか、support@clickhouse.com までお問い合わせください。