---
title: "LINEマンガがClickHouseを使用し、 データを1行も取り込まずにリアルタイム分析が可能なシステムを実現"
date: "2025-06-17T08:47:24.113Z"
author: "ClickHouse"
category: "User stories"
excerpt: "「社内に多数のMySQLサーバーを抱え、リアルタイム分析が複雑化していました。ClickHouseを導入する前は、分析処理ごとにカスタムスクリプトを作成する必要がありましたが、開発やレビューが難しく、実行にも時間がかかっていました。ClickHouseのインテグレーションエンジンで、これを解決しました」"
---
# LINEマンガがClickHouseを使用し、 データを1行も取り込まずにリアルタイム分析が可能なシステムを実現
「日本人はたくさんマンガを読むんですよ」と、[LINE Digital Frontier](https://ldfcorp.com/ja)の松田 一樹氏は言います。これは大袈裟ではありません。電子コミックサービスを提供する[LINEマンガ](https://manga.line.me/)には、Apple StoreやGoogle Playでランキング上位のモバイルゲームを抑えて1位に輝く日もあるほどです。
LINEマンガを運営するLINE Digital Frontierは世界最大の電子コミックプラットフォームを運営する[WEBTOON Entertainment](https://about.webtoon.com/)の子会社です。同社にはマンガや小説などを合わせておよそ1.5億人の月間アクティブユーザーがいます。(2025年3月末時点) データを活用して読者の行動を分析し、レコメンデーションを最適化したり、売上をリアルタイムで計測したりしています。
しかし、エンジニアである松田氏は、LINEマンガのこれまでの道のりには困難もあったと言います。数年前、同社はプラットフォームの基幹システムをMySQLデータベースの広範なネットワークに移行しました。速度と使いやすさは改善されたものの、分析が大規模になるにつれて課題が深刻化しました。
松田氏は[January 2025 ClickHouse meetup in Tokyo](https://clickhouse.com/videos/tokyo-meetup-line-from-stateles-servers-to-real-time-analytics)で、ClickHouseを使用してMySQLをダイレクトにクエリし、データを1行も取り込まずに分析をリアルタイムで行うことで、この問題を解決したと説明しました。
## MySQLが増えれば悩みも増える
LINEマンガは10年以上かけてユーザーベースを巨大化、拡張し、その要件に合わせてプラットフォームのアーキテクチャを進化させてきました。その重要な役割を果たしたのがMySQLです。
すべてをスムーズに稼働させるために、水平方向と垂直方向の両方でシャーディングを行いました。製品データは複数のデータベースにまとめて格納しましたが、ユーザーデータはIDで分割し、多数のデータベースに分散させました。このやり方は、アプリそのものには効率的でしたが、分析にはあまり適していませんでした。
「MySQLに関して言えば、簡単なはずのことに苦労していました」と松田氏は言います。本のメタデータをユーザーの購入データで結合させるという単純な処理でさえ、ユーザーデータが存在するシャードを探すためにスクリプトを独自に作成し、クエリごとに人の手で確認する必要がありました。売上の合計金額をプラットフォーム全体で集計するだけでも、ほぼ最初からコードを作成する必要があり、処理時間も長くかかりました。
社内で分析プラットフォームを所有していましたが、ETLパイプラインを使用していたため、データが常に最新の状態ではないという制限がありました。また、財務レコードやユーザーの個人データなど、社内のポリシーと監査上の理由から、データセット全体をアップロードできないケースもありました。「問題が起きたとき、リストされたユーザーのデータを抽出したいのに、それが見つからないのです」と松田氏は言います。「あるいは、データは見つかっているのにアクセスできないこともありました」
何をするにも時間がかかりました。開発者は解決策を探すよりもインフラと格闘するために、あまりにも多くの時間を奪われていました。アドホックのクエリ実行に時間がかかり、デバッグも簡単ではなく、システムでユーザー行動の全体像を把握することもできませんでした。
しかし、松田氏が言うように、MySQLのスタックを再構築または移行するにはリスクが伴い、費用もかかります。そのため、データを現在の場所から移動せず、処理を実行できる方法を探す必要がありました。「そこに現れたのがClickHouseです」(松田氏)
## リアルタイムクエリを可能にするClickHouse
LINEマンガでは、アーキテクチャをオーバーホールすることも、新しいパイプラインを揃えて管理することも選択しませんでした。代わりに、ClickHouseを使用してMySQLをダイレクトにクエリするという、データのインジェストも重複も不要になる方法を選びました。「ClickHouseにデータを取り込むのではなく、オンザスポットでMySQLを参照するのです」(松田氏)
そのために、まずClickHouseの[MySQLテーブルエンジン](https://clickhouse.com/docs/engines/table-engines/integrations/mysql)と[MySQLデータベースエンジン](https://clickhouse.com/docs/engines/database-engines/mysql)を使用し、既存のMySQLインスタンスに関連付ける仮想テーブルを作成しました。これらのテーブルは、他のClickHouseテーブルと同じ方法でクエリできますが、背後ではMySQLにクエリがプッシュダウンされており、結果を受け取って処理に使用しています。これにより、製品データとユーザートランザクションを、たとえデータが別々のサーバーに格納されていようと結合できるため、SQLのダイレクトな回答をリアルタイムに得ることができます。
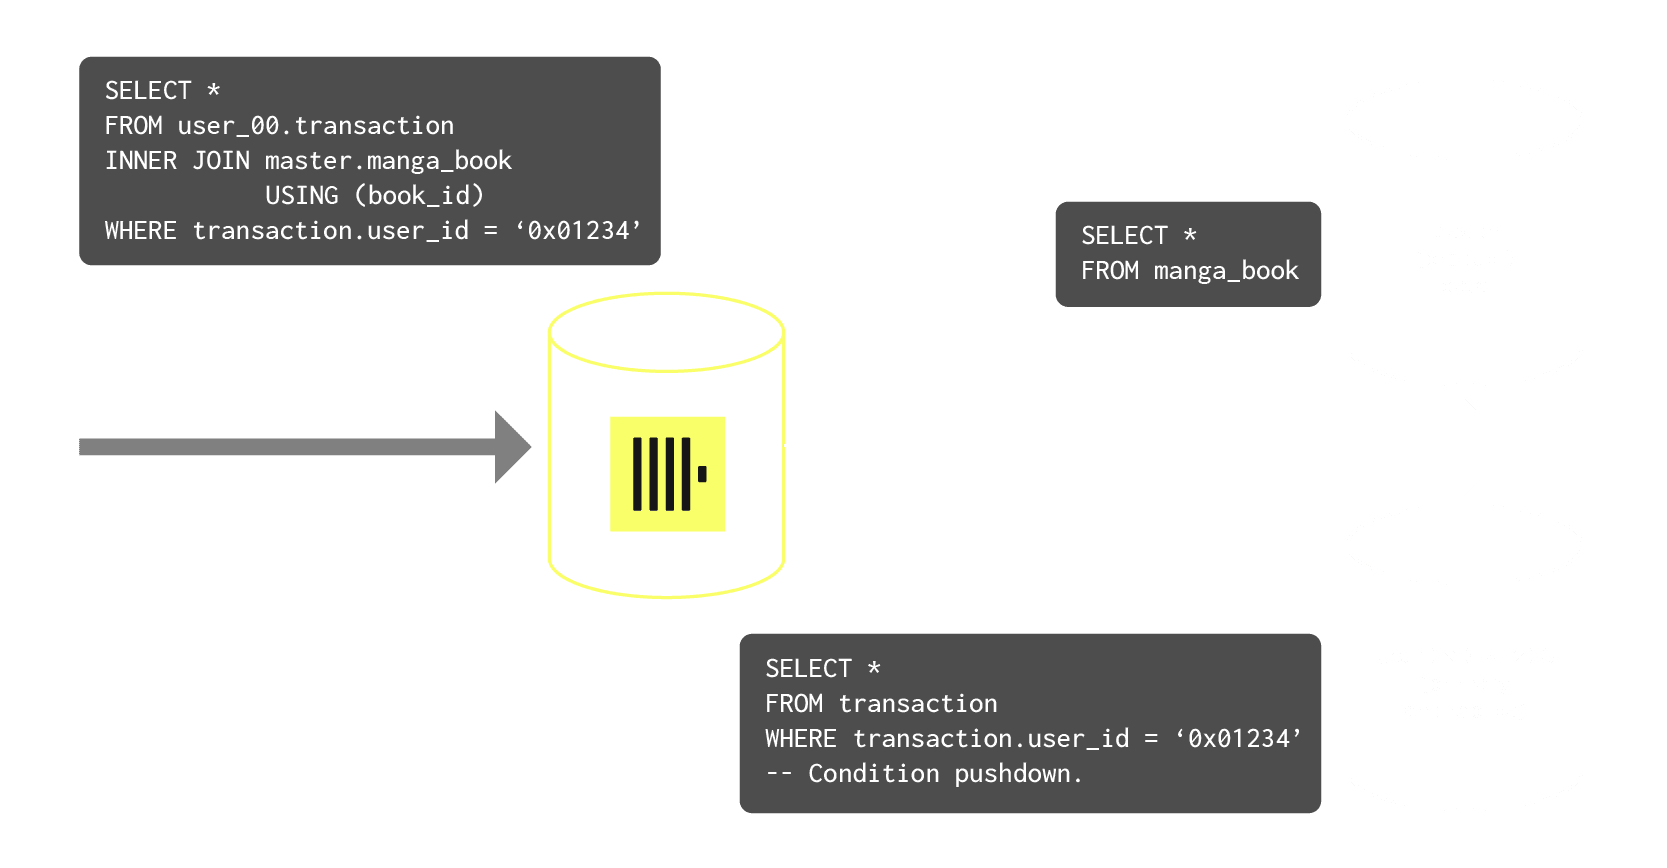
ClickHouseがMySQLシャードにクエリフィルタをプッシュし、製品データとユーザーデータを結合。
シャードデータを水平方向に統合させるために、[MergeTreeテーブルエンジン](https://clickhouse.com/docs/engines/table-engines/mergetree-family/mergetree)を使用し、全ユーザーのシャードで仮想テーブルを定義しました。これにより、1回のクエリ実行ですべてのユーザーの売上合計を取得できます。その際、ClickHouseは各シャードをクエリして結果をつなぎ合わせるロジックを処理します。
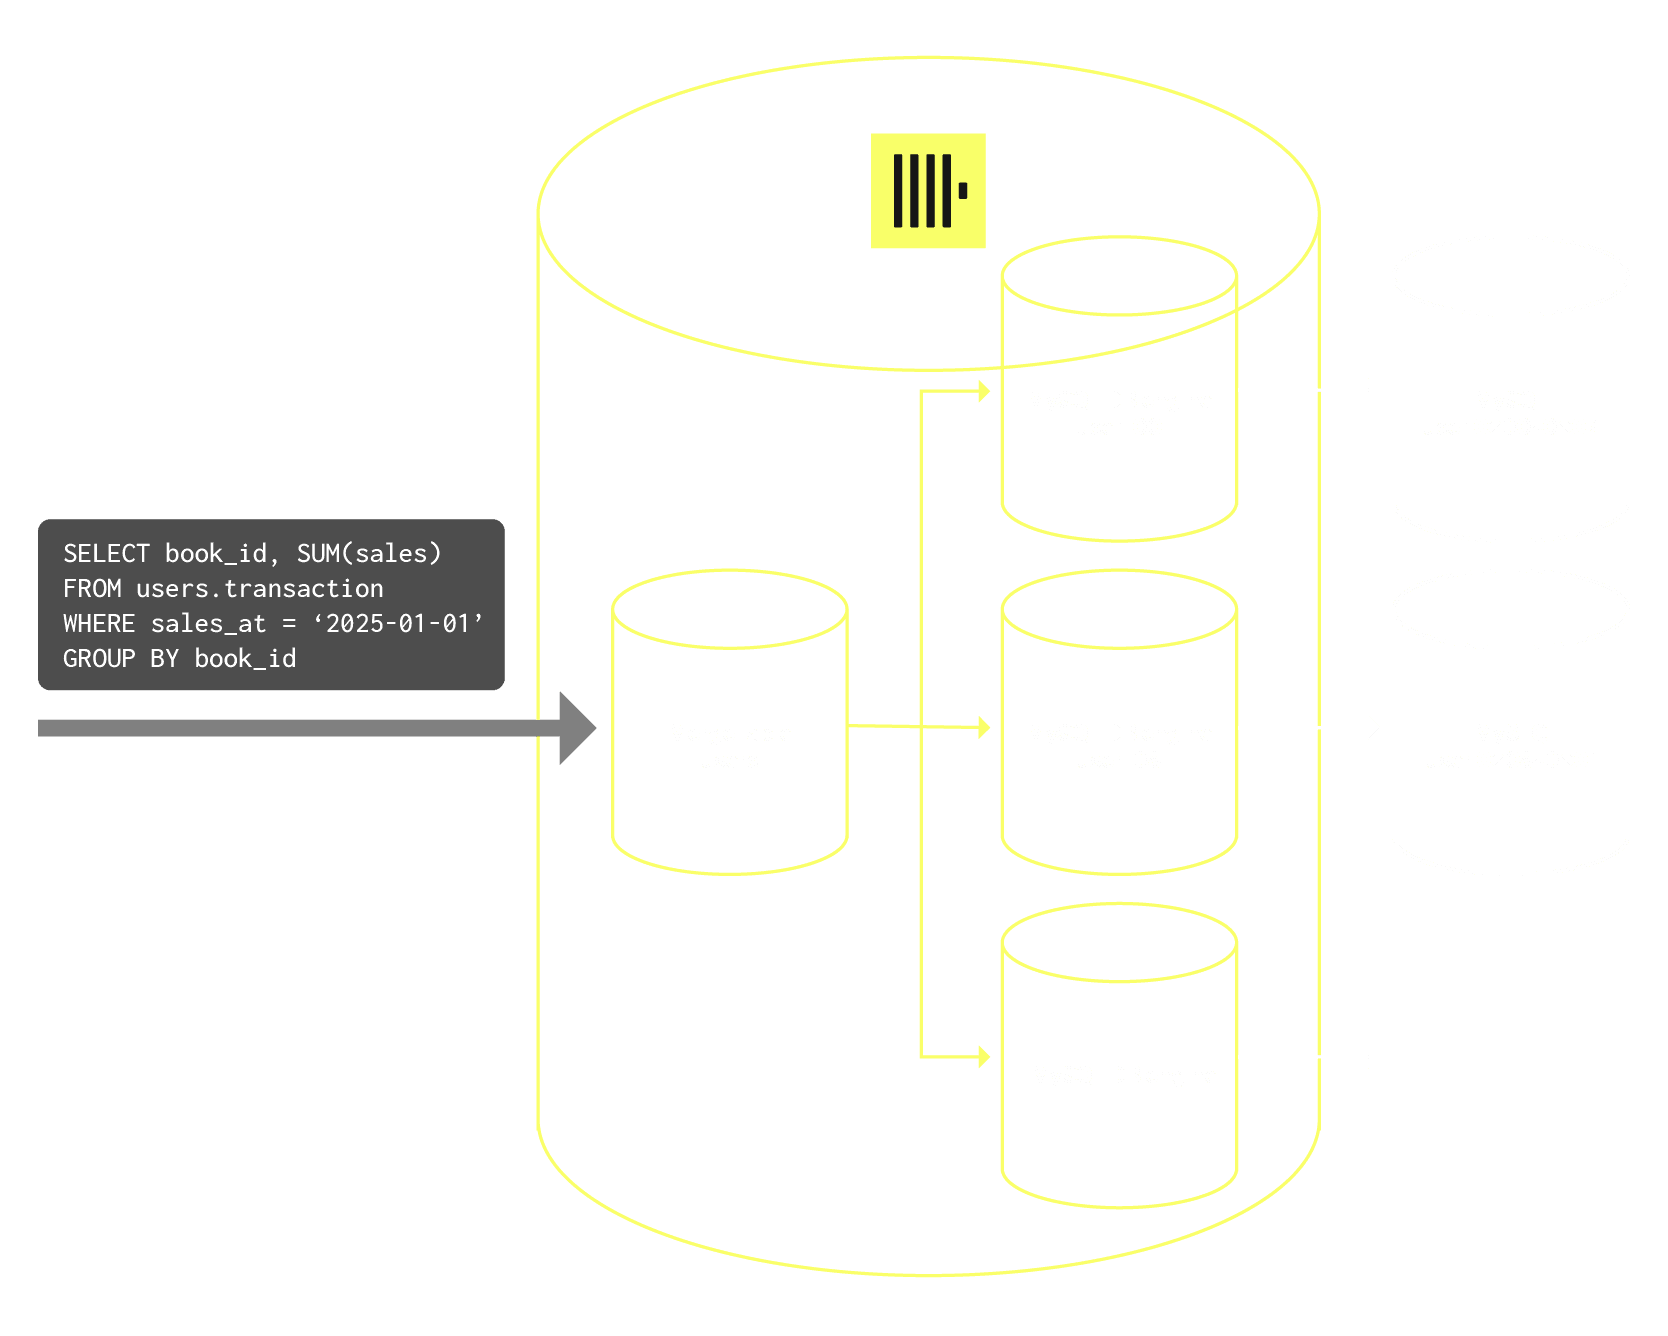
シャーディングされたMySQLデータをClickHouseがMergeTreeテーブルでクエリし、売上をリアルタイムで集計する。
条件プッシュダウンを使用し、ソースのデータをフィルタした後にClickHouseが検索を実行するため、処理がさらに効率化されます。「ここが重要なポイントです。データがMySQLに送られ、結果だけをClickHouseに戻して集計するので、水平方向にシャーディングしながら垂直方向に分析を処理できます」(松田氏)
## ローカルで開発し、リアルに結果を出す
[ClickHouse Tokyo Meetup](https://clickhouse.com/videos/tokyo-meetup-line-from-stateles-servers-to-real-time-analytics)で、松田氏はClickHouseのデモを行いました。3台のMySQLサーバー(1つはマスターデータ、残り2つはユーザーのシャードを格納)をMacに接続し、Docker Composeをスピンアップしました。スキーマはどれも同じですが、ユーザーデータは本番環境と同様にID範囲で分割されています。松田氏は[clickhouse-local](https://clickhouse.com/docs/operations/utilities/clickhouse-local)を使用し、1回のSQLクエリで、全ユーザーのシャードにある購入履歴を、本のメタデータを使用して結合しました。日付でフィルタ処理を行い、ClickHouseにデータを一切コピーせず正確な結果が得られることを説明しました。
このデモで紹介されたのは、LINEマンガでの実際の運用方法です。開発環境では、エンジニアが各自のマシンで同じ環境をスピンアップし、IntelliJを使用してクエリをテストおよび検証したのちに、システムを本番に移行させます。処理が高速で、デバッグも簡単であるため、すべてのシャードで何が起きているかをリアルに確認でき、各データがどこに存在するかを気にする必要もありません。
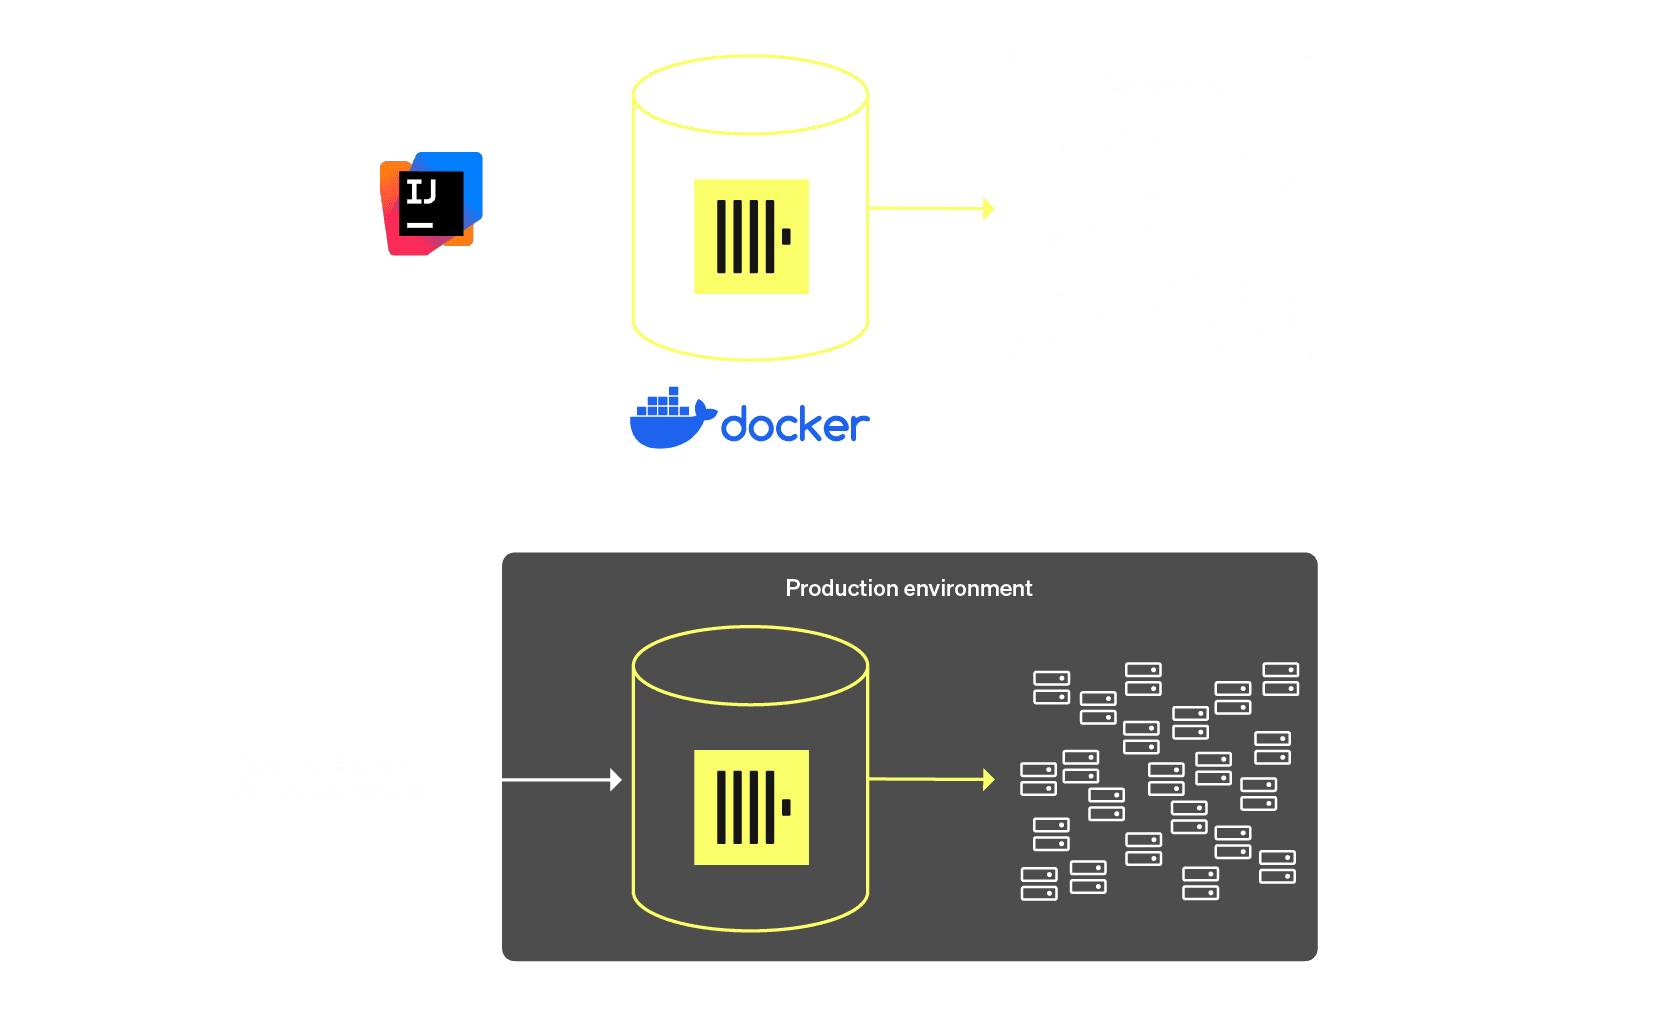
LINEマンガがローカルでの開発に使用するClickHouseとIntelliJおよびDocker。実稼働ではクエリが監査対応ゲートウェイを通過する。
本番環境ではシステム管理がさらに強化されています。「監査対応のゲートウェイを含めてセットアップしています」と松田氏が説明するように、すべてのクエリにゲートウェイを通過させて、規制を遵守し、要件をモニタリングしています。シャードを追跡するタスクの作成も、スクリプトのカスタマイズも、SQLで簡単に行えるようになりました。デバッグでも分析機能の強化でもチームですばやく行い、簡単にクエリを拡張することができます。
## 大規模なリアルタイム分析
MySQLを置き換える必要がないことは、LINEマンガにとって非常に重要でした。MySQLをレコードシステムとして残し、ClickHouseで簡単にデータを探索、デバッグして、リアルタイムに分析を行っています。NoSQLと分散データベースを使用するなど他のオプションも検討しましたが、同社にはMySQL関して強力なエンジニアリング文化があり、最大限活用するためのノウハウも備わっていました。「クエリをサブミリ秒で実行できるなどのメリットを重視しました」(松田氏)
ClickHouseはデータインジェストを実装する必要がないため、比較的簡単に始められます。東京ミートアップで松田氏は、開発だけでもClickHouseを皆さんに使って欲しいと伝えました。[clickhouse-local](https://clickhouse.com/docs/operations/utilities/clickhouse-local)などのツールを使用し、ローカルでインスタンスをスピンアップして、既存のデータベースやフラットファイルに接続し、クエリを実行できます。「ターゲットユーザーのリストやIDをローカルファイルに簡単に保存し、テーブルとして参照しながら結合して、出力結果を書き出すことができます」(松田氏)
LINEマンガは今回のアプローチについて、課題に対するソリューションのみならず、他の開発者のためのモデルにもなると考えています。「開発作業の効率化の参考にもなるし、ClickHouse導入の第一歩として役立つと思います」(松田氏)ClickHouseはすべてをシンプルにすることで、過度に複雑な作業を減らし、リアルタイム分析への扉を開きます。
ClickHouseの詳細について、また、ClickHouseで大規模なリアルタイム分析を行う方法について、[30日間無料のClickHouse Cloud](https://clickhouse.com/cloud)でご確認ください。