 ## 評価対象システム
このセクションでは、ベンチマーク対象のシステムが備えるJSON機能、データ圧縮技術、およびインデックスやキャッシュのようなクエリ高速化手段を概説します。これらの技術的詳細を理解することで、今回のベンチマークを公正かつ正確に行うためにどのような設定を行ったかがより明確になります。
> 技術的な詳細に興味のない方は、[こちら](/blog/json-bench-clickhouse-vs-mongodb-elasticsearch-duckdb-postgresql#benchmark-setup)からスキップしていただけます。
### ClickHouse
ClickHouseは列型の分析用データベースです。本記事では、JSONデータの取り扱いにおける高い能力を示すため、他のシステムとの比較を行っています。
#### JSONサポート
私たちは最近、ClickHouse向けに[新しい強力なJSONデータ型](https://clickhouse.com/blog/a-new-powerful-json-data-type-for-clickhouse)を構築しました。これは、本格的なカラム指向ストレージ、動的に変化するデータ構造への[対応](https://clickhouse.com/blog/a-new-powerful-json-data-type-for-clickhouse#challenge-2-dynamically-changing-data-without-type-unification)(タイプ統一が不要)、そして個々のJSONパスへの高速アクセスを可能にするものです。
#### JSONストレージ
ClickHouseは、[こちら](https://clickhouse.com/blog/a-new-powerful-json-data-type-for-clickhouse)で詳しく解説しているように、各ユニークなJSONパスの値を[ネイティブカラム](https://clickhouse.com/blog/a-new-powerful-json-data-type-for-clickhouse#traditional-data-storage-in-clickhouse)として保存します。これにより高いデータ圧縮率を実現でき、さらに古典的なデータ型と同等の[高いクエリ性能](https://benchmark.clickhouse.com/)を保てます。
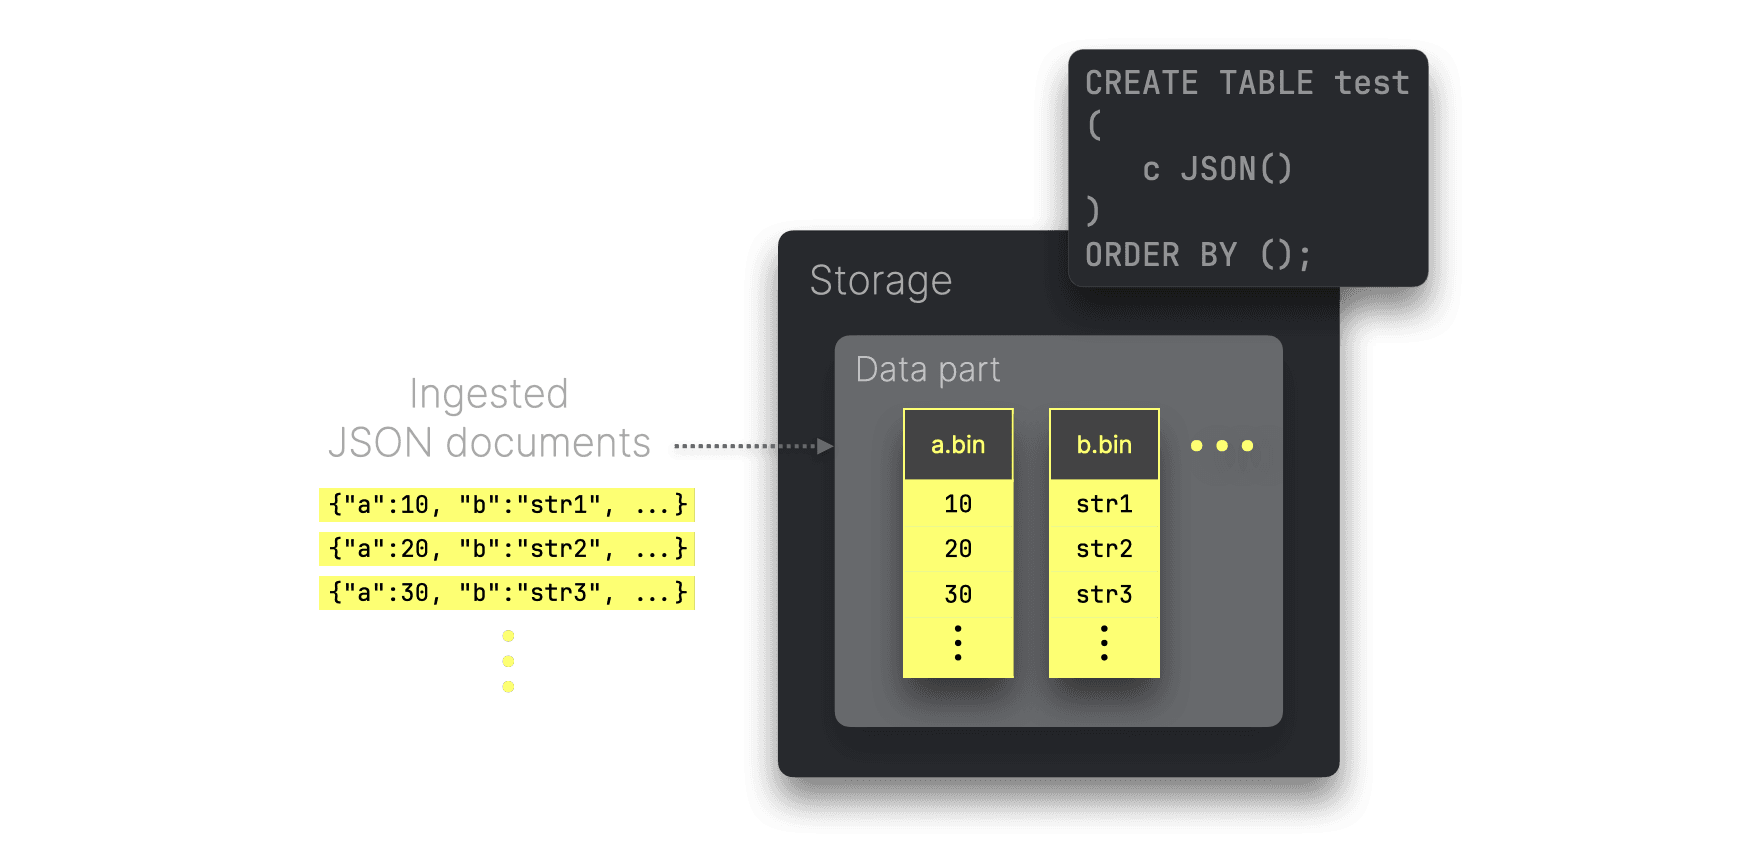
上の図は、各ユニークなJSONパスから取り出された値がどのようにディスク上で別々の(高圧縮された)カラムファイルとして格納されるかの概要を示しています([data part](https://clickhouse.com/docs/en/parts#what-are-table-parts-in-clickhouse)内のファイル)。これらのカラムは独立して参照でき、数個のJSONパスのみを参照するクエリでは不要なI/Oを最小限に抑えられます。
#### データソートと圧縮
ClickHouseのJSON型では、JSONパスを[primary key](https://clickhouse.com/docs/en/guides/best-practices/sparse-primary-indexes)に利用できます。これにより、ロードされたJSONドキュメントは各テーブルパーツ内で、これらのパスの値で[並べ替え](https://clickhouse.com/docs/en/guides/best-practices/sparse-primary-indexes#data-is-stored-on-disk-ordered-by-primary-key-columns)られた形でディスクに保存されます。さらに、ClickHouseは[疎なプライマリインデックス](https://clickhouse.com/docs/en/guides/best-practices/sparse-primary-indexes#introduction)を生成し、プライマリキーに対するフィルタクエリを[自動的](https://clickhouse.com/docs/en/guides/best-practices/sparse-primary-indexes#the-primary-index-is-used-for-selecting-granules)に[高速化](https://clickhouse.com/docs/en/guides/best-practices/sparse-primary-indexes#the-primary-index-is-used-for-selecting-granules)します。
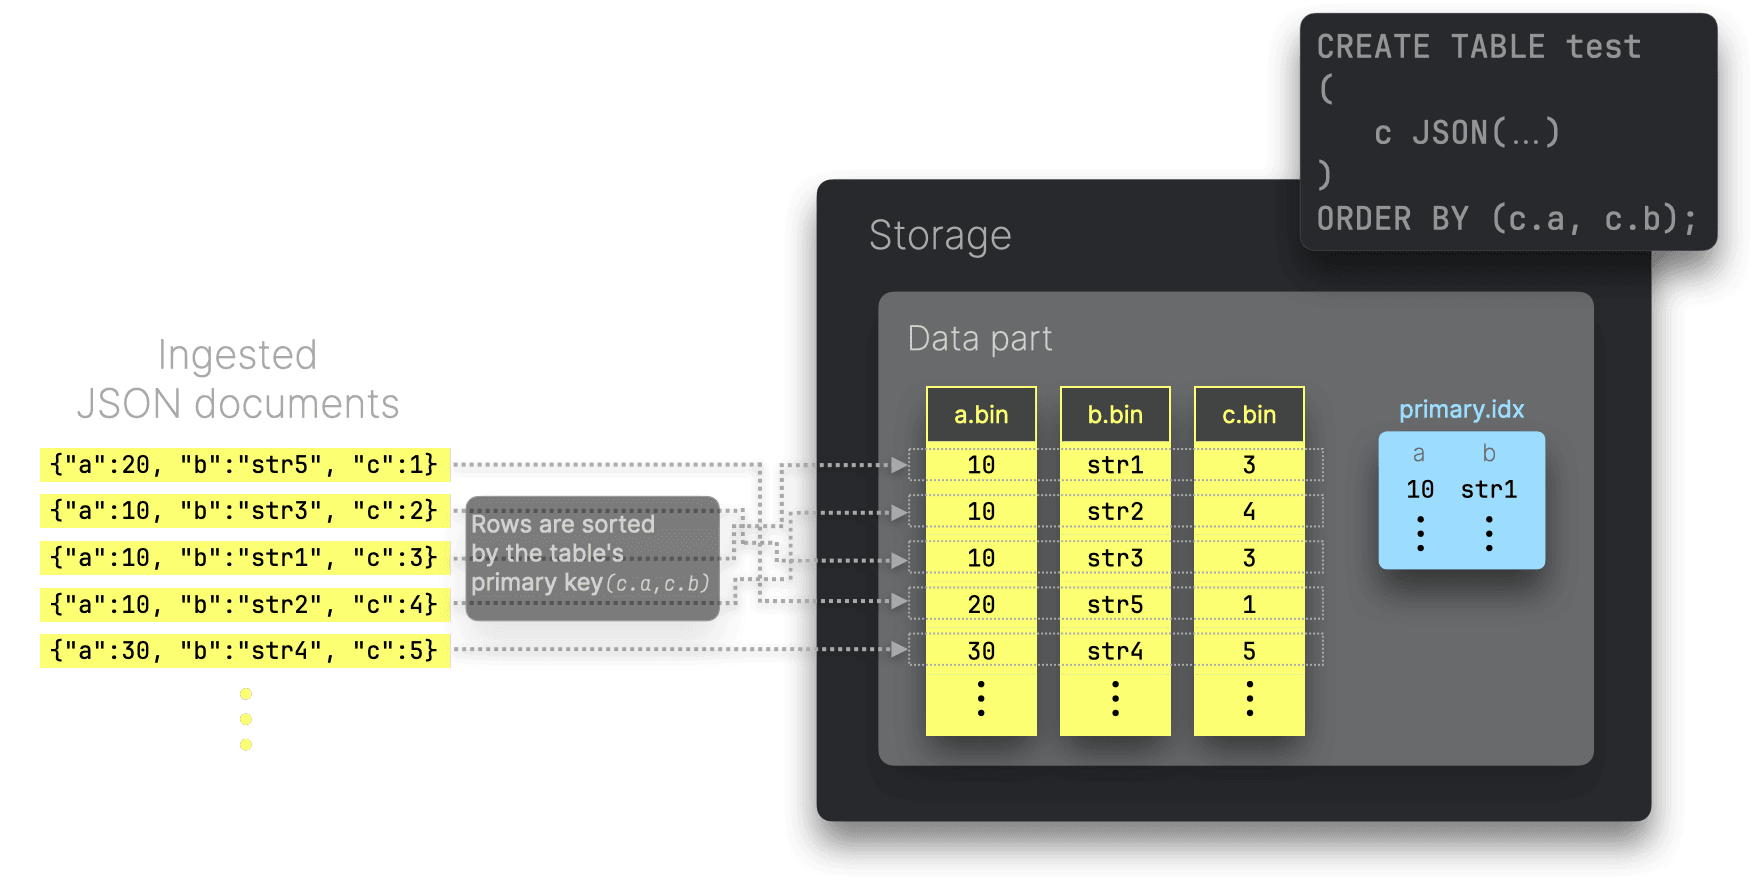
JSONサブカラムをプライマリキーに使うことで、同様のデータが各カラムファイル内でより密に固まるので、[適切な](https://clickhouse.com/docs/en/guides/best-practices/sparse-primary-indexes#optimal-compression-ratio-of-data-files)順序(カーディナリティの低い順に)並べることで、カラムファイルの[圧縮率が高まる](https://clickhouse.com/docs/en/guides/best-practices/sparse-primary-indexes#optimal-compression-ratio-of-data-files)可能性があります。さらにオンディスクのデータが[ソート済み](https://clickhouse.com/blog/clickhouse-faster-queries-with-projections-and-primary-indexes#utilize-indexes-for-preventing-resorting-and-enabling-short-circuiting)なので、クエリの検索ソート順と物理データのソート順が一致する場合には再ソートが不要になり、早期終了などの最適化も可能です。
#### 柔軟な圧縮オプション
ClickHouseは、[デフォルト](https://clickhouse.com/docs/en/sql-reference/statements/create/table#column_compression_codec)ではセルフマネージド版で`lz4`、[ClickHouse Cloud](https://clickhouse.com/cloud)では`zstd`を、各データカラムファイルに対して[ブロック単位](https://clickhouse.com/docs/en/data-compression/compression-modes#block)で適用します。
また、[個々のカラムごと](https://clickhouse.com/docs/en/sql-reference/statements/create/table#column_compression_codec)に使用する圧縮コーデックをCREATE TABLEクエリで指定することもできます。ClickHouseは、[汎用コーデック](https://clickhouse.com/docs/en/sql-reference/statements/create/table#general-purpose-codecs)、[特殊コーデック](https://clickhouse.com/docs/en/sql-reference/statements/create/table#specialized-codecs)、[暗号化コーデック](https://clickhouse.com/docs/en/sql-reference/statements/create/table#encryption-codecs)などを[連結](https://clickhouse.com/blog/optimize-clickhouse-codecs-compression-schema)して利用することも可能です。
JSON型に対しては、現在のClickHouseでは、JSONフィールド全体に対してコーデックを指定できます(例:[こちら](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/ddl_zstd.sql#L8)ではデフォルトの`lz4`から`zstd`に変更)。将来的には、[JSONパス単位](https://github.com/ClickHouse/ClickHouse/issues/68428)でコーデック指定を行う機能も計画されています。
#### 多様なJSONフォーマット対応
ClickHouseは、データ読み込みやクエリ結果出力用に[20種類以上のJSONフォーマット](https://clickhouse.com/docs/en/interfaces/formats)をサポートしています。
#### クエリ処理
今回のベンチマーク結果で示すように、ClickHouseのクエリ処理は非常に優れています。どのようにJSONデータに対してクエリを実行するのかを簡単に解説します。
前述のとおり、ClickHouseは各ユニークなJSONパスの値を、従来のデータ型(例:整数)と同様に格納しているため、JSONデータであっても[高パフォーマンスの集計](https://clickhouse.com/blog/clickhouse_vs_elasticsearch_mechanics_of_count_aggregations#high-performance-aggregations-in-clickhouse)を可能にします。
インターネット規模のアナリティクス向けに構築されたClickHouseは、[90種類以上](https://clickhouse.com/docs/en/sql-reference/aggregate-functions/reference)の組込み集計関数をフルに並列化し、利用可能なすべてのリソースを使って[効率的に](https://youtu.be/ZOZQCQEtrz8?si=XrQ-vMDiHEsgsrYq&t=103)データをフィルタ・集計します。たとえば、`avg`集計関数の場合は以下のイメージです。
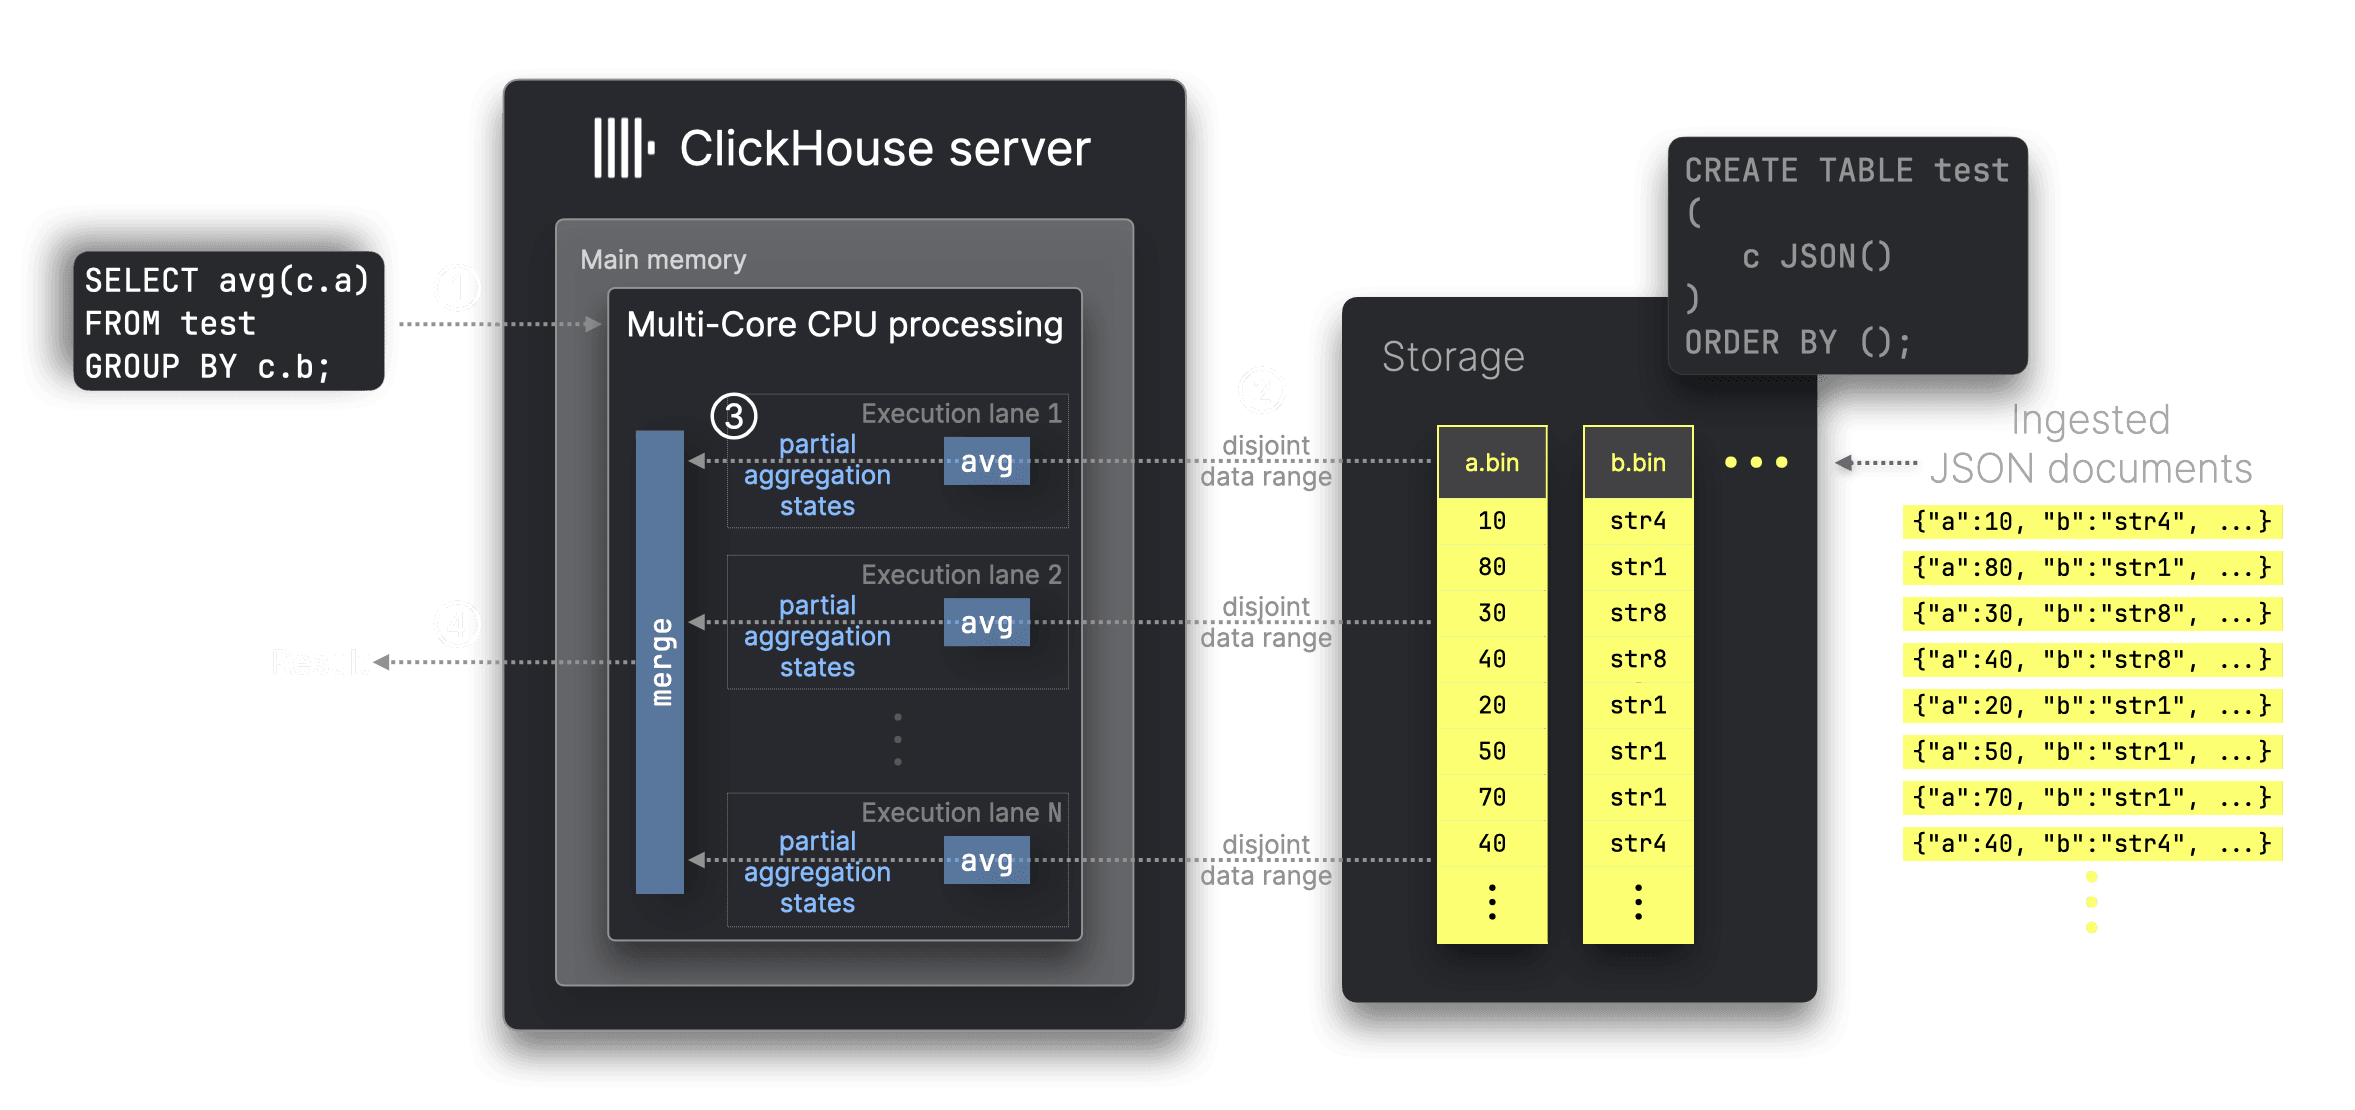
上の図では、① `c.a`と`c.b`という2つのJSONパスに対する`avg`集計クエリを処理しています。ClickHouseは対応するカラムファイル`a.bin`と`b.bin`のみを読み込み、単一サーバ内の32CPUコアなどで`N`個のデータ範囲を並列に処理します(クエリ対象の行を`N`分割して並列計算)。集計キーとは無関係にデータ範囲を[動的に分割](https://www.vldb.org/pvldb/vol17/p3731-schulze.pdf)できるため、負荷分散が最適化されます。この並列化は[部分集計ステート](https://clickhouse.com/blog/clickhouse_vs_elasticsearch_mechanics_of_count_aggregations#-multi-core-parallelization)を用いることで可能になります。
本ベンチマークのClickHouseでは、[物理実行プラン](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/physical_query_plans.sh)も取得しています。たとえば、[こちら](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/results/_physical_query_plans/_m6i.8xlarge_bluesky_1000m_zstd.physical_query_plans#L15)では、[benchmark query ①](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/queries_formatted.sql#L2)の10億行フルスキャン集計を、CPUコア32個をフル活用して並列実行している様子が分かります。
#### マルチノードでの並列化
今回のベンチマークはシングルノード性能のみを比較していますが、もしテーブルがシャード分割されて複数ノードにデータが分散している場合、ClickHouseはすべてのノードのCPUコアを使って集計関数を[並列化](https://www.vldb.org/pvldb/vol17/p3731-schulze.pdf)し、全体を処理できます。
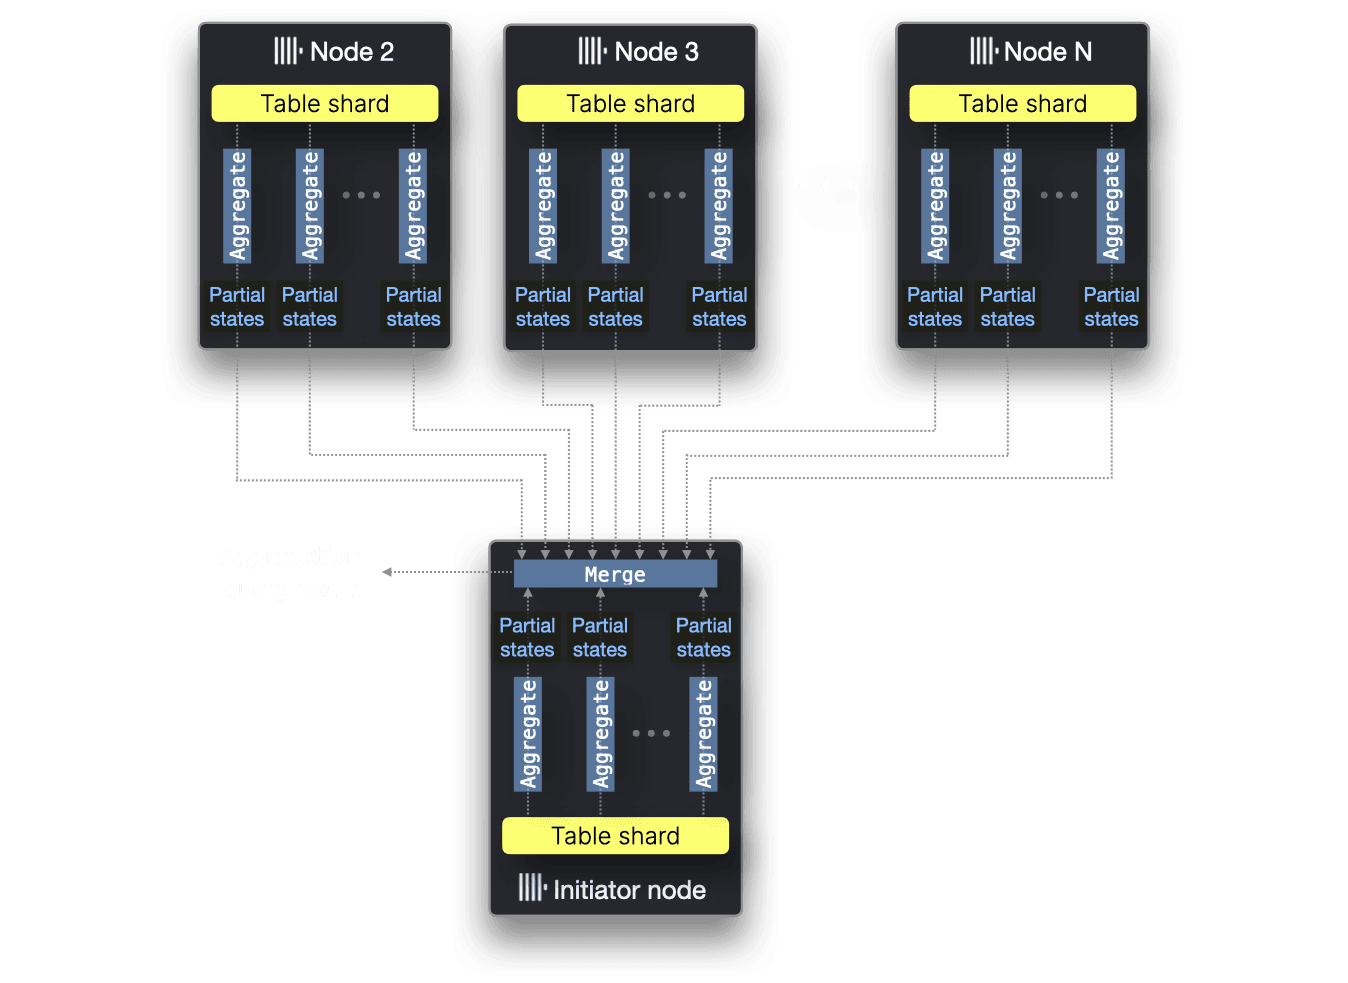
#### キャッシュ
ClickHouseはクエリ処理中に[組込みのキャッシュ](https://www.youtube.com/watch?v=-N6N-WKEiLs)やOSページキャッシュを使います。たとえば[デフォルトでは無効](https://clickhouse.com/docs/en/operations/settings/settings#use_query_cache)になっていますが、[クエリ結果キャッシュ](https://clickhouse.com/docs/en/operations/query-cache)も備えています。
### MongoDB
[MongoDB](https://www.mongodb.com/)は最も有名な[JSONデータベース](https://clickhouse.com/engineering-resources/json-database)の一つです。
#### JSONサポート
MongoDBは、あらゆるデータを[BSON](https://www.mongodb.com/resources/basics/json-and-bson)ドキュメントとしてネイティブに格納します。BSONは[JSONをバイナリ表現](https://en.wikipedia.org/wiki/BSON)した形式です。
#### JSONストレージ
MongoDBのデフォルトストレージエンジン[WiredTiger](https://www.mongodb.com/docs/manual/core/wiredtiger/#wiredtiger-storage-engine)は、ディスク上のデータを[ページ](https://source.wiredtiger.com/11.0.0/arch-data-file.html)単位の[B-Tree](https://en.wikipedia.org/wiki/B-tree)構造で管理します。ルートノードおよび中間ノードにはキーと他ノードへの参照が格納され、リーフノードにはBSONドキュメントを保持するデータブロックがあります。
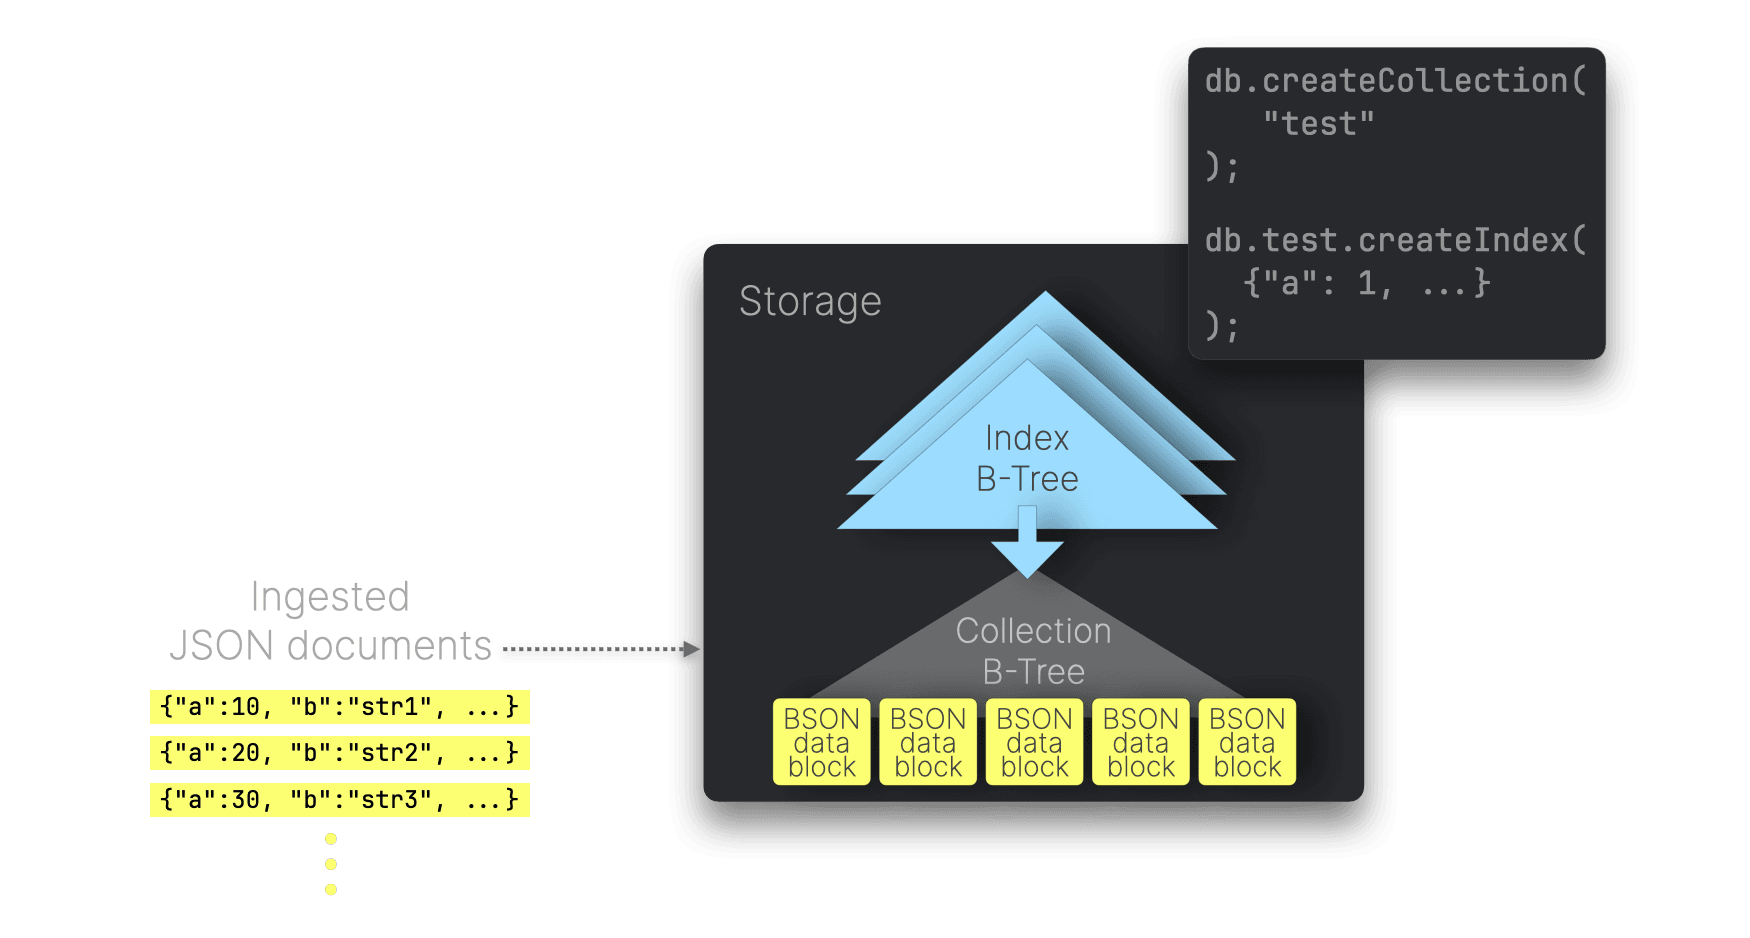
MongoDBでは、JSONパス上に[セカンダリインデックス](https://www.mongodb.com/docs/manual/indexes/#details)を作成できます。これらのインデックスはB-Treeで構成され、挿入された各JSONドキュメントに対して該当のJSONパスの値がノードに格納されます。これらのインデックスはメモリに読み込まれ、クエリプランナーが[高速](https://www.slideshare.net/slideshow/mongodb-days-uk-indexing-and-performance-tuning/54794973#2)にツリーを探索して該当ドキュメントを特定し、その後ディスクから読み込んで処理します。
#### Covered index scans
クエリがインデックス化されたJSONパスのみを参照する場合、MongoDBはディスク上のドキュメントを読み込まずにインデックスのみでクエリを完了できます。これを[covered query](https://www.mongodb.com/docs/manual/core/query-optimization/#covered-query)と呼び、[covered index scan](https://www.slideshare.net/slideshow/mongodb-days-uk-indexing-and-performance-tuning/54794973#2)によって実現されます。
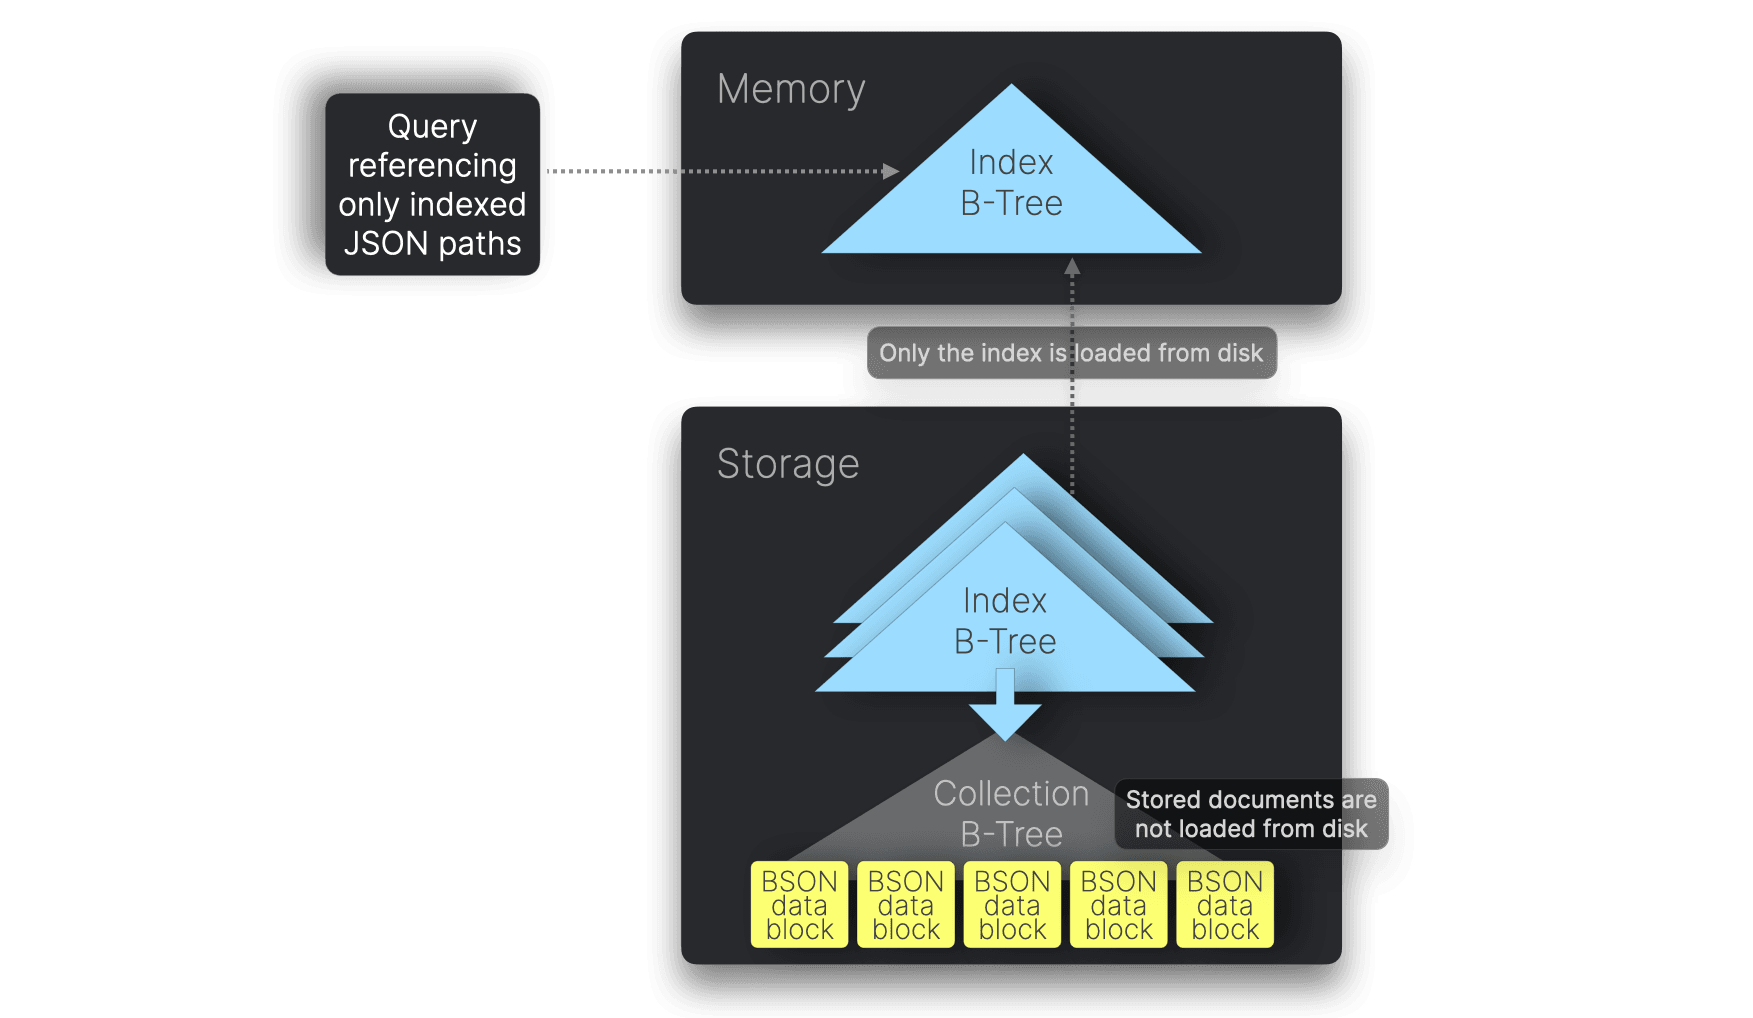
> 私たちのベンチマークでのMongoDBクエリ5種はすべてcovered queryです。これは、[デフォルトの複合インデックス](/blog/json-bench-clickhouse-vs-mongodb-elasticsearch-duckdb-postgresql#some-json-paths-can-be-used-for-indexes-and-data-sorting)がクエリに必要なすべてのフィールドを含んでいるためです。[ベストプラクティス](https://www.mongodb.com/docs/manual/core/query-optimization/#performance)に従い、明示的に[covered index scansを有効化](/blog/json-bench-clickhouse-vs-mongodb-elasticsearch-duckdb-postgresql#no-tuning)しています。
[こちら](https://github.com/ClickHouse/JSONBench/tree/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/results/_index_usage)のクエリ実行プランを見れば確認できます。例えば10億ドキュメントを格納したコレクションに対するクエリでは、[IXSCAN](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/results/_index_usage/_m6i.8xlarge_bluesky_1000m_zstd.index_usage)ステージのみが表示され、`COLLSCAN`や`FETCH`ステージがありません。一方、covered index scanを有効にする前の古いプラン([参考](https://github.com/ClickHouse/JSONBench/tree/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/results_without_covered_index_scans/_index_usage))では、`COLLSCAN`や`FETCH`が含まれ、ドキュメントをディスクから読み込んでいたことが分かります。
このメソッドはインデックスがメモリに載ることが条件となります。今回の[テストマシン](/blog/json-bench-clickhouse-vs-mongodb-elasticsearch-duckdb-postgresql#hardware-and-operating-system)(128 GB RAM)では、10億件データセットでの[27 GBインデックス](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/results/m6i.8xlarge_bluesky_1000m_zstd.json#L20)を十分格納できますが、[シャーディング](https://www.mongodb.com/docs/manual/sharding/)されたセットアップなどでは、インデックスのメモリ搭載性に注意が必要です(インデックスがシャードキーを[含む](https://www.mongodb.com/docs/manual/core/query-optimization/#restrictions-on-sharded-collection)必要など)。
#### データ圧縮
WiredTigerは、コレクションに[snappy](https://google.github.io/snappy/)を使ったブロック圧縮、インデックスに[prefix compression](https://www.mongodb.com/docs/manual/reference/glossary/#std-term-prefix-compression)を[デフォルト](https://www.mongodb.com/docs/manual/core/wiredtiger/#compression)で適用します。代わりに`zstd`圧縮を有効にして圧縮率を高めることも可能です。
#### データソート
MongoDBは、[clustered collections](https://www.mongodb.com/docs/manual/core/clustered-collections/)を介してドキュメントを特定の[clustered index](https://www.mongodb.com/docs/manual/reference/method/db.createCollection/#std-label-db.createCollection.clusteredIndex)の順に格納し、類似データをまとめることで圧縮率を向上させる機能を備えます。しかし、clustered indexキーは[ユニーク](https://www.mongodb.com/docs/manual/core/clustered-collections/#set-your-own-clustered-index-key-values)であり、8 MBという最大サイズ制限があるため、今回のテストデータには適用できませんでした。
#### キャッシュ
MongoDBは[WiredTiger内部キャッシュ](https://www.mongodb.com/docs/manual/core/wiredtiger/#memory-use)やOSページキャッシュを利用し、専用のクエリ結果キャッシュは持ちません。WiredTigerキャッシュには最近アクセスされたデータとインデックスが格納され、デフォルトでは利用可能RAMの50% - 1GBが割り当てられます。このキャッシュはMongoDBサーバを再起動しない限りクリアされません。
#### 制限事項
ベンチマークに含まれるJSONの`time_us`フィールドはマイクロ秒精度の日付です。しかしMongoDBは[ミリ秒精度](https://www.mongodb.com/docs/manual/reference/method/Date/#behavior)しかサポートしていません。一方でClickHouseは[ナノ秒精度](https://clickhouse.com/docs/en/sql-reference/data-types/datetime64)まで扱えます。
また、MongoDBの集計フレームワークはビルトインの`COUNT DISTINCT`演算子を備えていません。代替として、ベンチマークの[クエリ②](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/queries_formatted.js#L31)では、より非効率な[$addToSet](https://www.mongodb.com/docs/manual/reference/operator/aggregation/addToSet/)を使っています。
### Elasticsearch
[Elasticsearch](https://www.elastic.co/elasticsearch)はJSONベースの検索・分析エンジンです。
#### JSONサポート
Elasticsearchは[JSONドキュメント](https://www.elastic.co/guide/en/elasticsearch/reference/current/docs-index_.html)をネイティブに受け取って格納します。
#### JSONストレージとデータ圧縮
Elasticsearchで取り込まれたJSONデータは、特定のアクセスパターンに最適化された[複数の](https://github.com/ClickHouse/examples/tree/main/blog-examples/clickhouse-vs-elasticsearch/on-disk-format-and-insert-processing#logical-and-physical-on-disk-data-structures)データ構造としてインデックス化・保存されます。これらの構造は[Lucene](https://lucene.apache.org/)が管理する[セグメント](https://github.com/ClickHouse/examples/tree/main/blog-examples/clickhouse-vs-elasticsearch/on-disk-format-and-insert-processing#logical-and-physical-on-disk-data-structures)内に格納されます。LuceneはElasticsearchの検索と分析の中核となるJavaライブラリです。
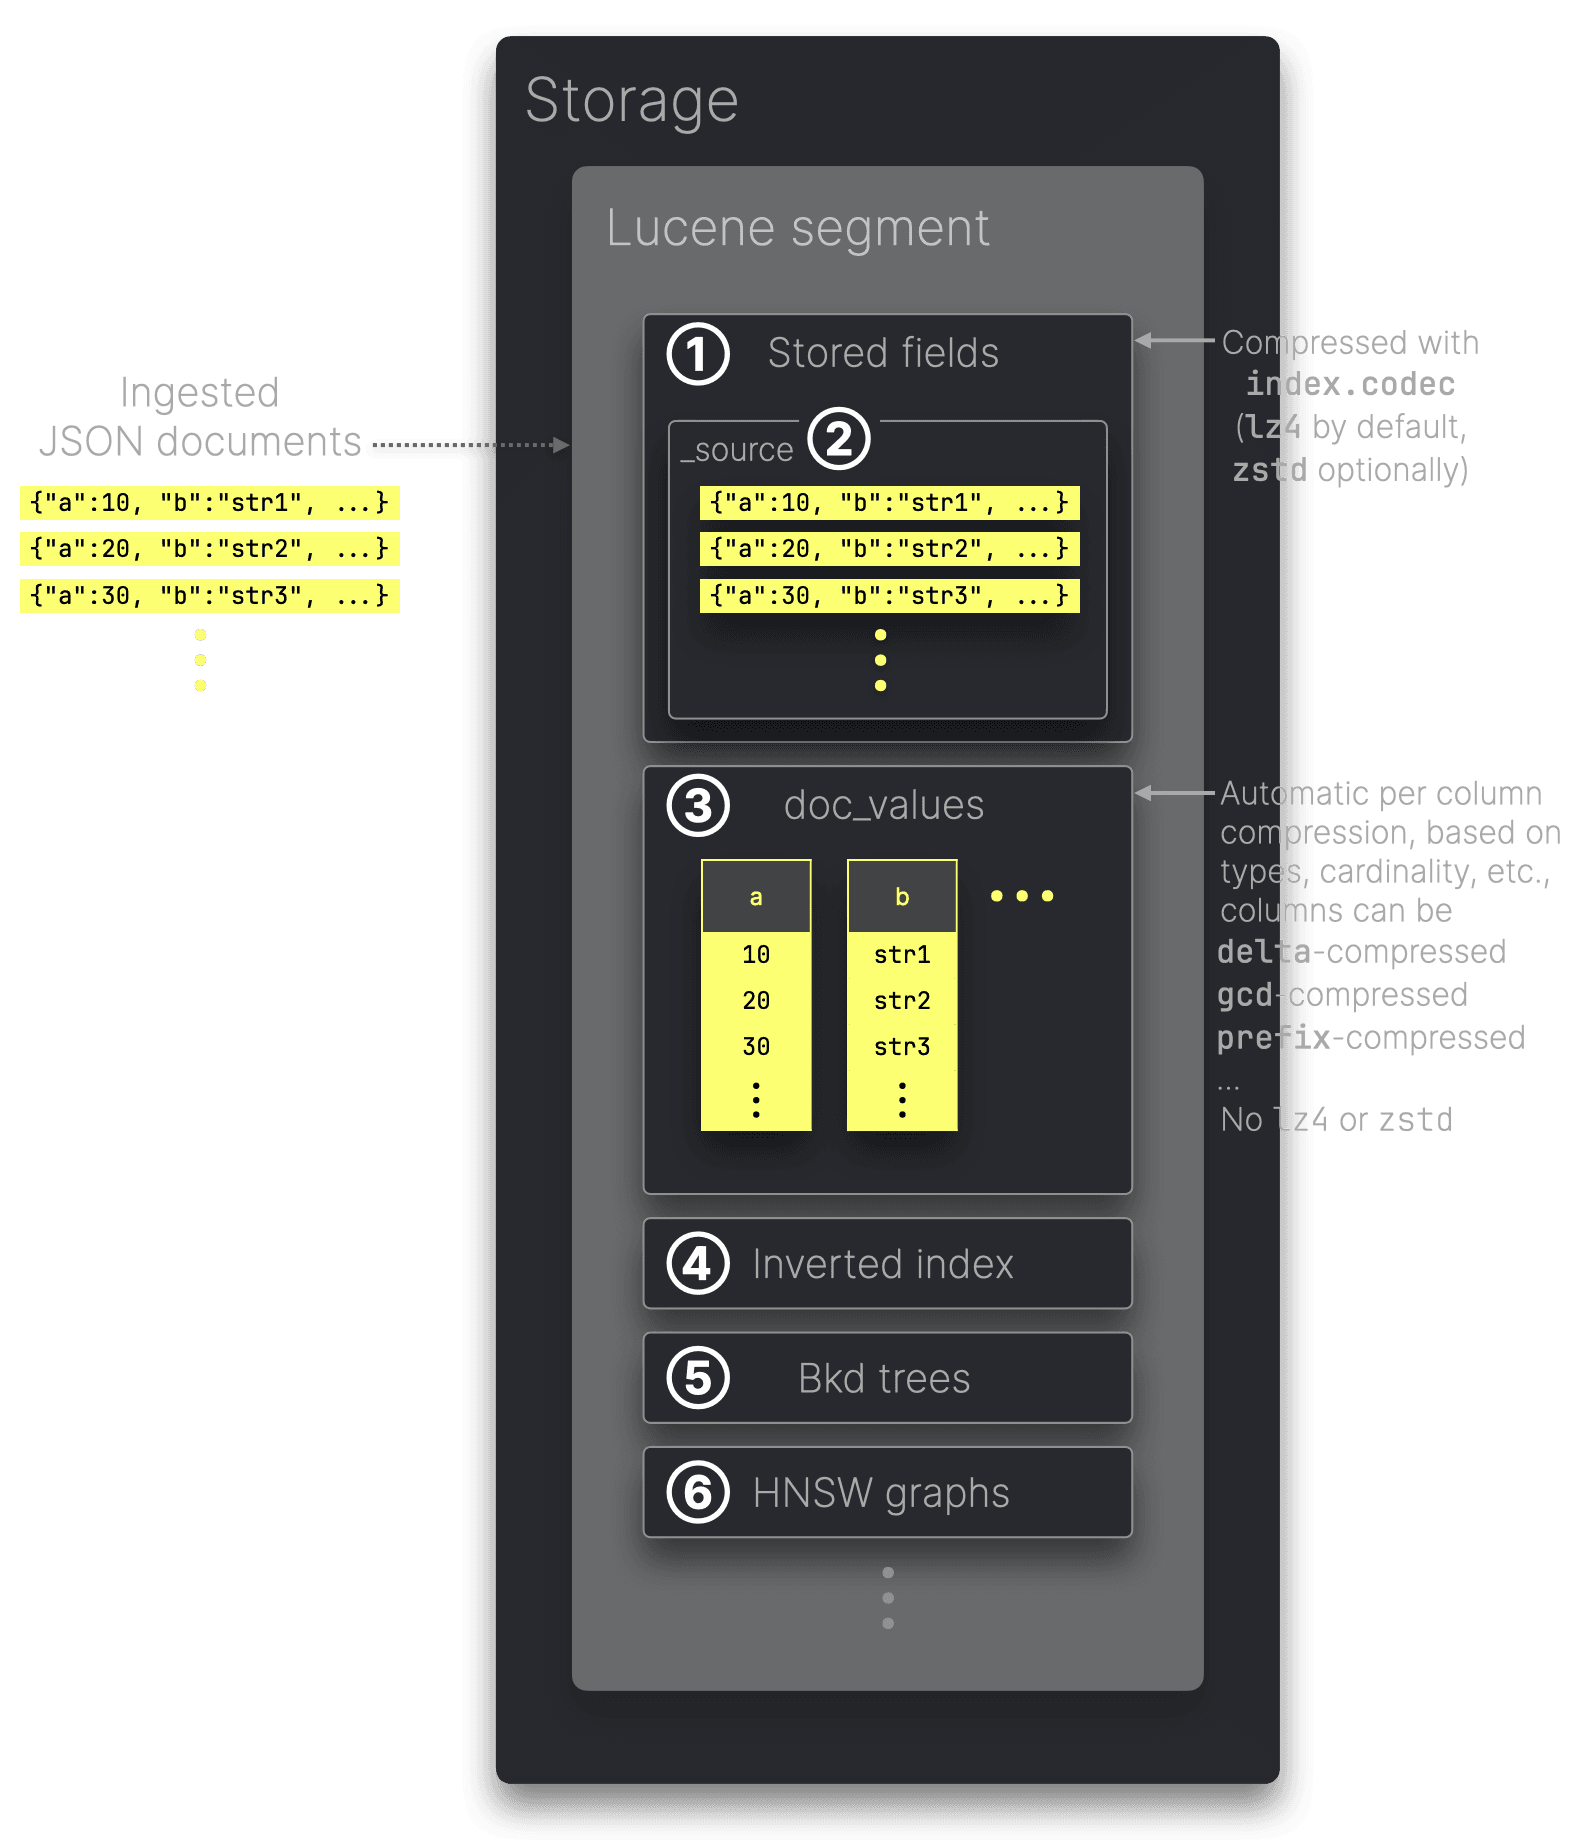
① [Stored fields](https://www.elastic.co/guide/en/elasticsearch/reference/current/mapping-store.html)はフィールドのオリジナル値を返却するためのドキュメントストアとして機能します。デフォルトでは② [_source](https://www.elastic.co/guide/en/elasticsearch/reference/current/mapping-source-field.html)もここに含まれ、取り込まれたJSONドキュメントの原文を保持します。`_source`やその他`stored fields`は、[index.codec](https://www.elastic.co/guide/en/elasticsearch/reference/current/index-modules.html)設定(デフォルトは`lz4`、より圧縮率の高い`zstd`も可)で指定されるアルゴリズムで圧縮されます。
③ [Doc_values](https://www.elastic.co/guide/en/elasticsearch/reference/current/doc-values.html)には、JSONドキュメントのフィールド値がカラム指向のオンディスク構造で格納されます。分析クエリでの集計・ソートのパフォーマンス向上を目的としています。ただし、`doc_values`には`lz4`や`zstd`は使われません。各カラムは[Luceneのエンコーディング](https://lucene.apache.org/core/9_9_0/core/org/apache/lucene/codecs/lucene90/Lucene90DocValuesFormat.html)によって特殊に圧縮され、データ型やカーディナリティなどに応じて最適なエンコーディング方式が選択されます。
[こちら](https://github.com/ClickHouse/examples/tree/main/blog-examples/clickhouse-vs-elasticsearch/on-disk-format-and-insert-processing#logical-and-physical-on-disk-data-structures)で、④ `inverted index`、⑤ `Bkd-tree`、⑥ `HNSQ graphs`などの他のLuceneセグメント構造についても詳しく解説しています。
#### `_source`の役割
オープンソース版Elasticsearchにおいて、`_source`フィールドは[reindexing](https://www.elastic.co/guide/en/elasticsearch/reference/current/docs-reindex.html)や[新バージョンへのアップグレード](https://www.elastic.co/guide/en/elasticsearch/reference/current/setup-upgrade.html#upgrade-index-compatibility)などで必要不可欠であり、またオリジナルドキュメントを返すクエリでも使われます。一方、これを無効化するとストレージサイズは大きく削減されるものの、これらの機能が失われます。
Elasticsearchのエンタープライズ版では、[synthetic _source](https://www.elastic.co/guide/en/elasticsearch/reference/current/mapping-source-field.html#synthetic-source)を利用して、`_source`を他のLuceneデータ構造から再構築することが可能です。
今回の[ベンチマーククエリ](/blog/json-bench-clickhouse-vs-mongodb-elasticsearch-duckdb-postgresql#benchmark-queries)は`doc_values`を利用して集計結果を返すため、オリジナルドキュメントを返す必要はありません。したがって、OSS版Elasticsearchで`_source`をオフにすることでEnterprise版の`synethic _source`機能による省ストレージ効果をシミュレートしています。比較のため、`_source`を有効にした場合も計測しています。
#### 公平なストレージ比較のためのElasticsearch設定
前述のように、Elasticsearchは様々なデータ構造(inverted index、doc_values など)にデータを格納し、用途ごとに最適化しています。今回のベンチマークは分析処理を中心とするため、以下のように設定しました:
- **Inverted indexのサイズを最小化**: 文字列をすべて[keyword](https://www.elastic.co/guide/en/elasticsearch/reference/current/keyword.html)として扱い、フルテキスト検索を無効化(これにより `doc_values` に値が格納され、分析クエリに最適化)。
- **日付フィールドマッピング**: 取り込んだドキュメントの日時フィールドを[date](https://github.com/ClickHouse/examples/tree/main/blog-examples/clickhouse-vs-elasticsearch/on-disk-format-and-insert-processing#elasticsearch)型としてマッピングし、Luceneの[Bkd](https://www.elastic.co/blog/numeric-and-date-ranges-in-elasticsearch-just-another-brick-in-the-wall)ツリーを利用。
- **ストレージオーバーヘッドの削減**: [meta-fields](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/elasticsearch/config/filebeat.yml#L82)を無効化し、JSONデータからのフィールドのみを保持。_sourceをオフにして、synthetic _sourceに近い状態をシミュレート。
- **Index sortingの有効化**: [ClickHouseのソートキー](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/ddl_zstd.sql#L10)と同じフィールドで[ソート](https://www.elastic.co/guide/en/elasticsearch/reference/current/index-modules-index-sorting.html)し、データの圧縮とクエリ性能を向上。
- **シングルノード最適化**: レプリカを[無効化](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/elasticsearch/config/index_template_no_source_best_compression.json#L44)。
- **ロールオーバーとマージの最適化**: [ベストプラクティス](https://www.elastic.co/guide/en/elasticsearch/reference/current/size-your-shards.html#shard-size-recommendation)に従い、[ロールオーバーとマージ](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/elasticsearch/config/ilm.json#L7)を設定。
以下の図は、本ベンチマークにおけるElasticsearchのデータ構造構成を要約したものです。
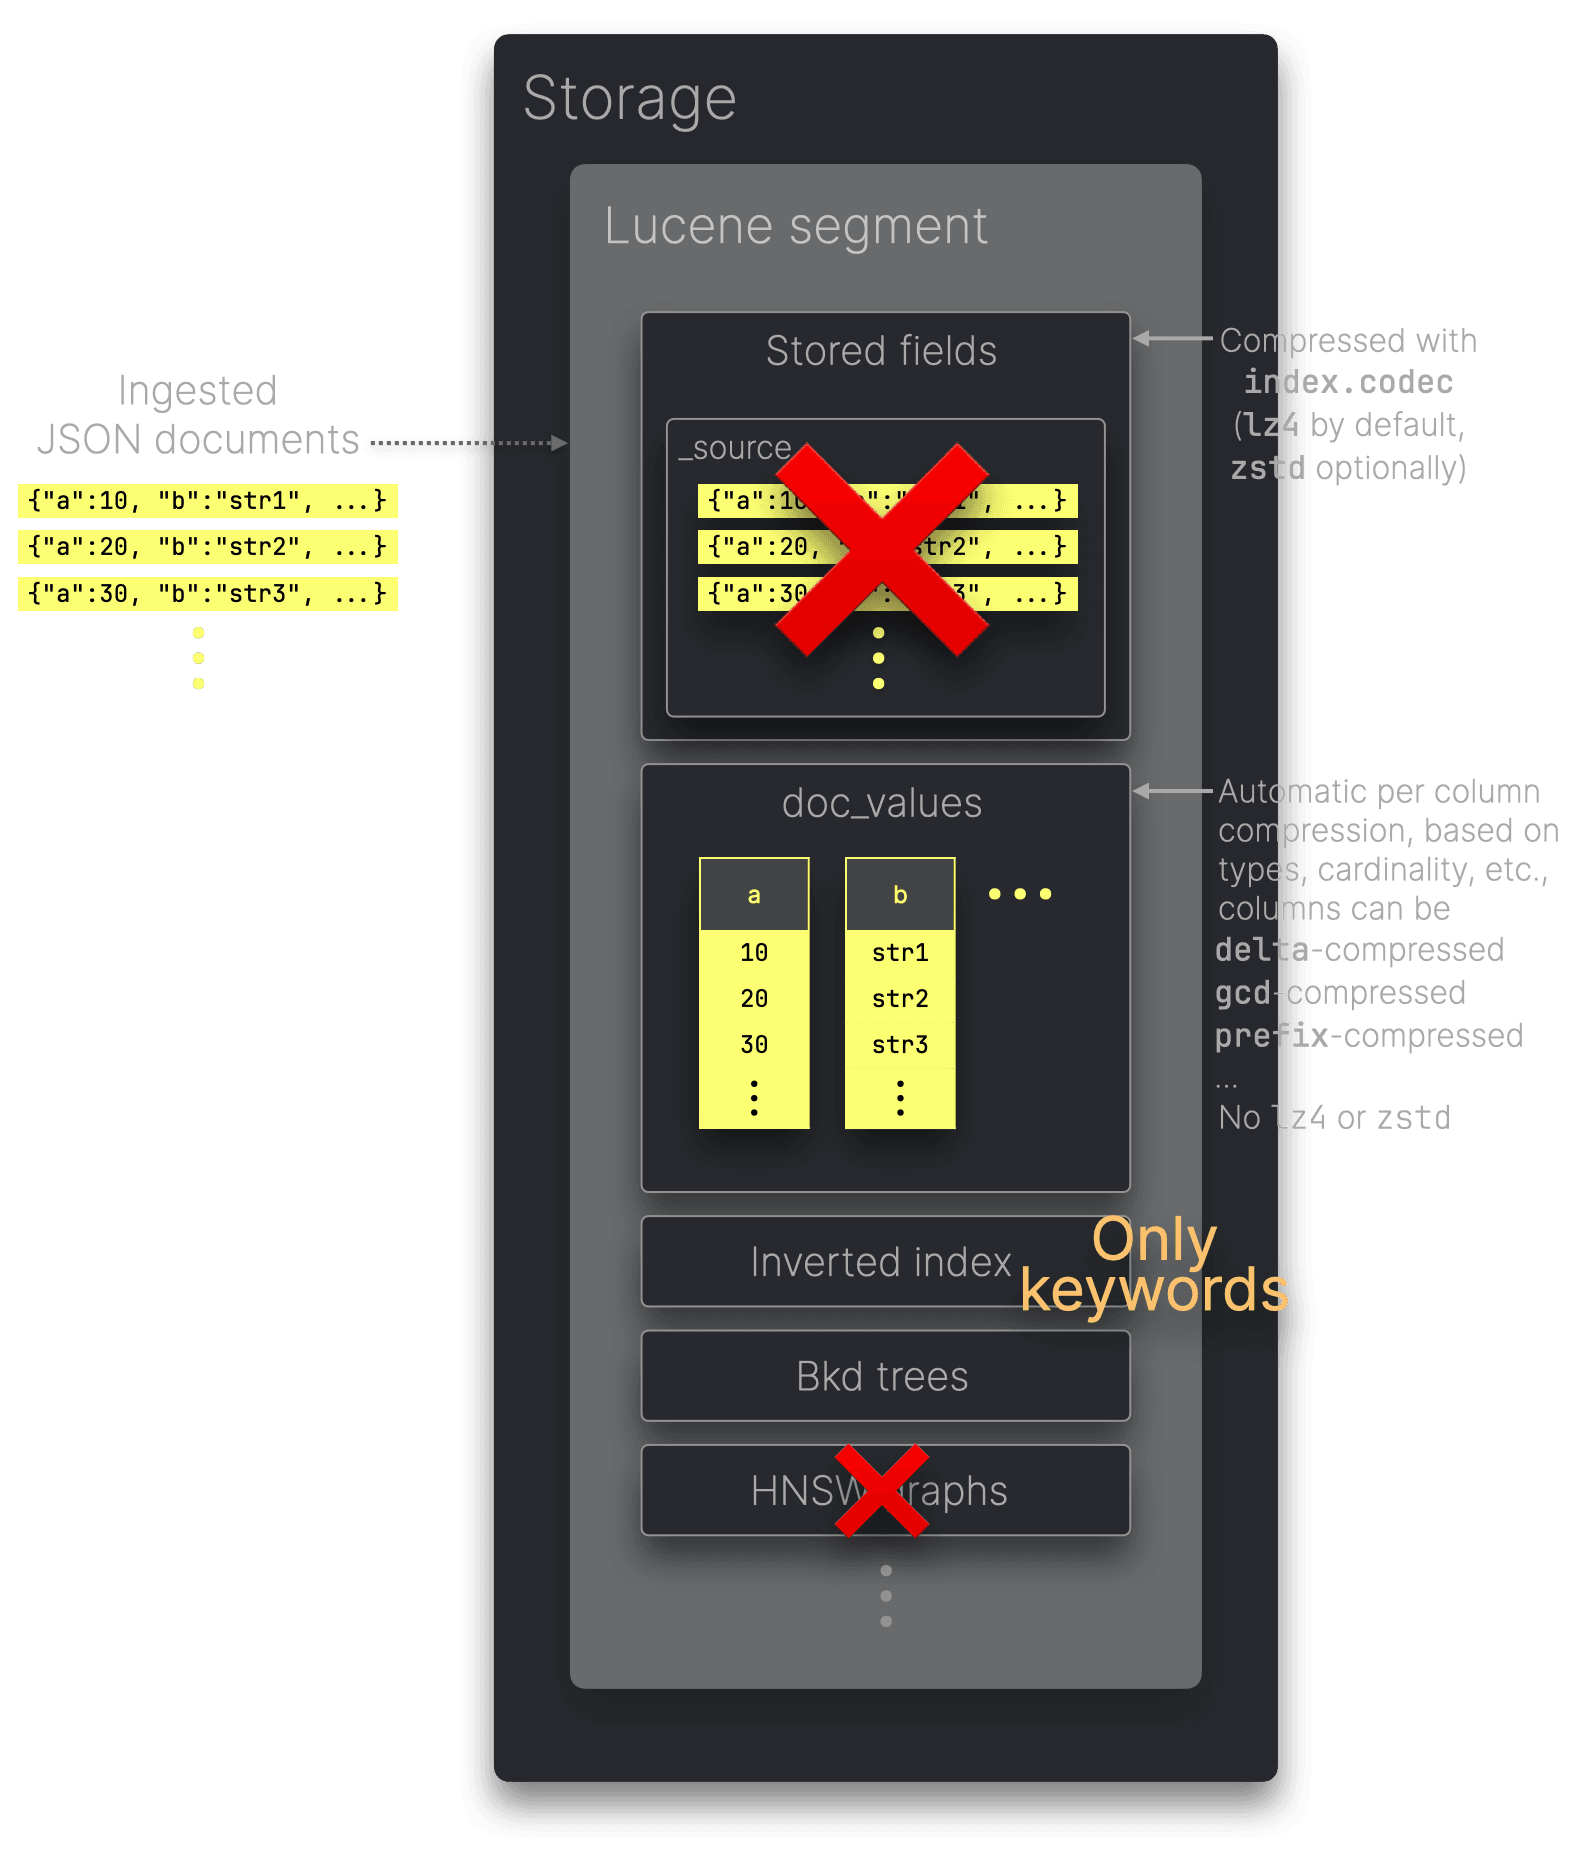
なお、`_source`をオフにすると、`index.codec`で指定した圧縮アルゴリズムはほぼ意味をなしません。`stored fields`として扱うデータが無くなるためです。同様の設定で`lz4`と`zstd`を比較してもディスク使用量がほとんど変わらないのはこのためです。
#### データソート
Elasticsearchは[データのソート](https://www.elastic.co/guide/en/elasticsearch/reference/current/index-modules-index-sorting.html)を有効化することで、`stored fields`や`doc_values`が[連続した似通ったデータ](https://www.elastic.co/guide/en/elasticsearch/reference/current/tune-for-disk-usage.html#_use_index_sorting_to_colocate_similar_documents)として圧縮される形を促進し、クエリの早期終了([early termination](https://github.com/ClickHouse/examples/tree/main/blog-examples/clickhouse-vs-elasticsearch/on-disk-format-and-insert-processing#on-disk-data-ordering))を可能にします。これはClickHouseの仕組みにも似ています。
#### キャッシュ
ElasticsearchはOSページキャッシュに加え、シャードレベルの[request cache](https://www.elastic.co/guide/en/elasticsearch/reference/current/shard-request-cache.html)やセグメントレベルの[query cache](https://www.elastic.co/guide/en/elasticsearch/reference/current/query-cache.html)など[複数のキャッシュ](https://www.elastic.co/blog/elasticsearch-caching-deep-dive-boosting-query-speed-one-cache-at-a-time)を使用します。
さらに、ElasticsearchはJavaのJVM上でクエリを実行するため、起動時に物理RAMの半分程度をヒープとして割り当てます([最大32 GB](https://www.elastic.co/guide/en/elasticsearch/guide/current/heap-sizing.html#compressed_oops)まで)。残りのRAM領域はOSページキャッシュ経由でディスクI/Oを高速化します。
#### 制限事項
大規模分析やオブザーバビリティのようなユースケースでは、数十億行にわたるテーブルに対して`count(*)`や`count_distinct(...)`を行うクエリが[非常に一般的](https://clickhouse.com/blog/clickhouse_vs_elasticsearch_mechanics_of_count_aggregations#count-aggregations-in-clickhouse-and-elasticsearch)です。
この観点から、私たちの[ベンチマーククエリ](/blog/json-bench-clickhouse-vs-mongodb-elasticsearch-duckdb-postgresql#benchmark-queries)も`count(*)`を多用し、`query ②`では`count_distinct(...)`も実行します。
Elasticsearchで`count(*)`を実行すると、複数[シャード](https://github.com/ClickHouse/examples/tree/main/blog-examples/clickhouse-vs-elasticsearch/on-disk-format-and-insert-processing#elasticsearch)にまたがる場合は[近似値](https://clickhouse.com/blog/clickhouse_vs_elasticsearch_mechanics_of_count_aggregations#elasticsearch)しか得られません。ES|QLの[COUNT_DISTINCT](https://www.elastic.co/guide/en/elasticsearch/reference/current/esql-functions-operators.html#esql-count_distinct)集計関数も同様で、[HyperLogLog++](https://static.googleusercontent.com/media/research.google.com/fr//pubs/archive/40671.pdf)アルゴリズムを用いた近似値となります。
一方、ClickHouseは`count(*)`を[完全に正確](https://clickhouse.com/blog/clickhouse_vs_elasticsearch_mechanics_of_count_aggregations#elasticsearch)に計算し、`count_distinct(...)`についても[近似](https://clickhouse.com/docs/en/sql-reference/aggregate-functions/reference/uniq#agg_function-uniq)と[厳密](https://clickhouse.com/docs/en/sql-reference/aggregate-functions/reference/uniqexact)の両方をサポートしています。`query ②`では厳密なバージョンを使用しています。
また、今回の[Blueskyテストデータ](/blog/json-bench-clickhouse-vs-mongodb-elasticsearch-duckdb-postgresql#the-json-dataset---a-billion-bluesky-events)に含まれる`time_us`はマイクロ秒精度のタイムスタンプです。Elasticsearchでも[date_nanos](https://www.elastic.co/guide/en/elasticsearch/reference/current/date_nanos.html)型でナノ秒精度の日付を保存できますが、ES|QLの[日付/時刻関数](https://www.elastic.co/guide/en/elasticsearch/reference/current/esql-functions-operators.html)は[date](https://www.elastic.co/guide/en/elasticsearch/reference/current/date.html)型(ミリ秒精度)しか対応していません。そのため、本ベンチマークでは`time_us`をミリ秒精度の`date`型として[格納](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/elasticsearch/config/filebeat.yml#L88)しています。
ClickHouseでは[日付/時刻関数](https://clickhouse.com/docs/en/sql-reference/functions/date-time-functions)がナノ秒精度まで扱えます。
### DuckDB
[DuckDB](https://duckdb.org/)はシングルノード環境向けに設計された列指向型分析データベースです。
#### JSONサポート
DuckDBは2022年に[JSON論理型](https://duckdb.org/docs/data/json/json_type.html)を導入しました。
#### JSONストレージ
DuckDBは[列指向型](https://clickhouse.com/engineering-resources/what-is-columnar-database)データベースですが、現状ClickHouseほどJSONを分解して格納しません。DuckDBテーブル内のJSONカラムでは、取り込まれたJSONドキュメントが文字列として保存されます(解析済みの構造として保存されない)。
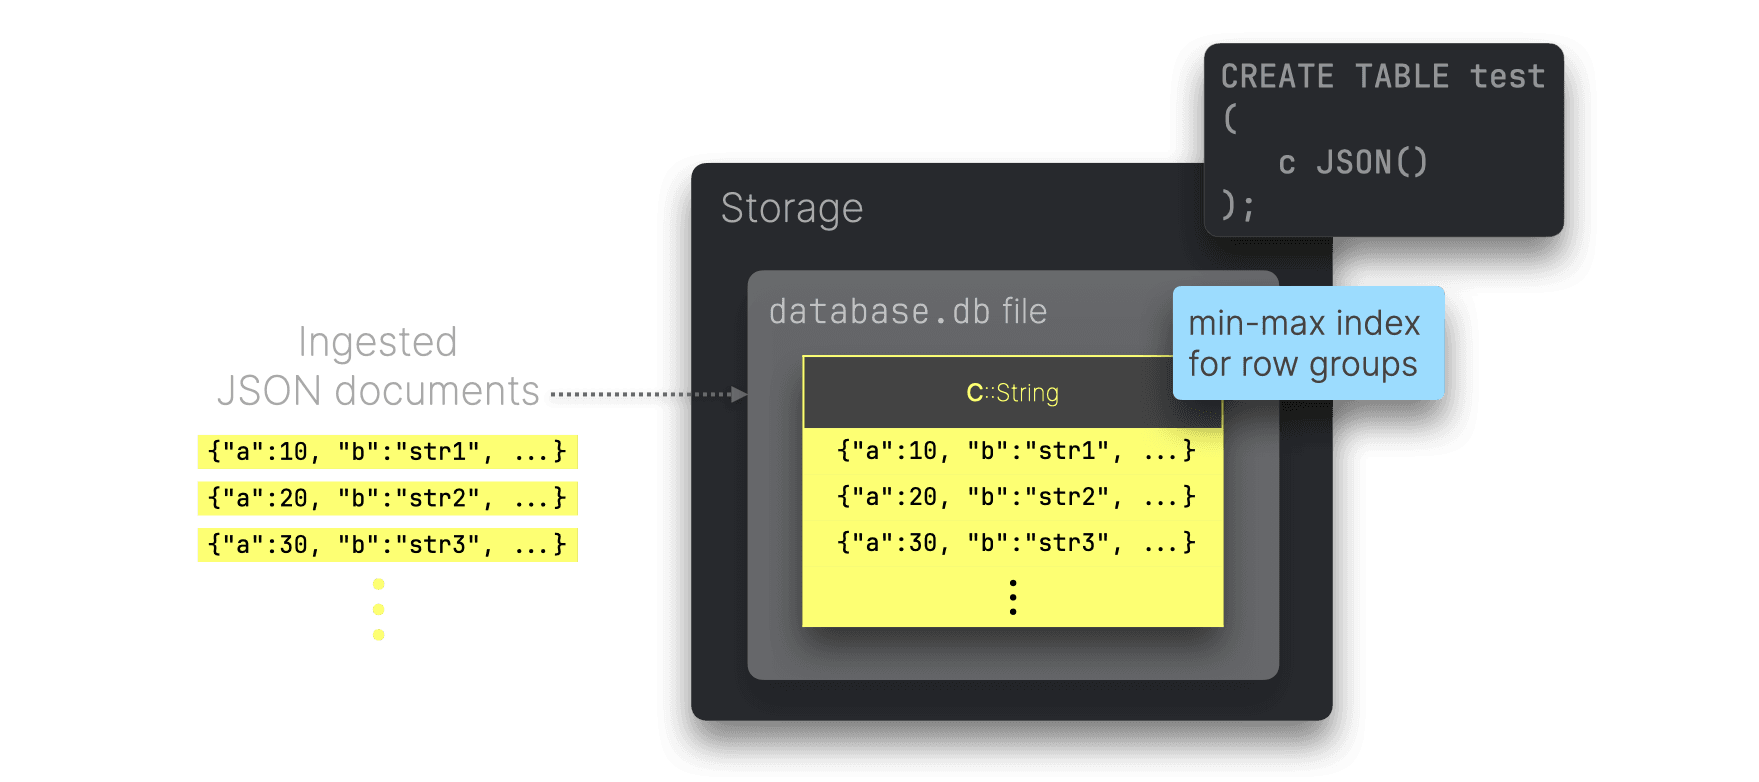
DuckDBはデフォルトで[最小最大インデックス](https://en.wikipedia.org/wiki/Block_Range_Index)を自動生成します。これにより、高速なフィルタリングや集計をサポートしますが、これは[行グループ](https://duckdb.org/docs/guides/performance/how_to_tune_workloads.html#the-effect-of-row-groups-on-parallelism)ごとに保存された最小値と最大値を利用するしくみです。
また、[Adaptive Radix Tree(ART)インデックス](https://db.in.tum.de/~leis/papers/ART.pdf)を指定して作成できますが、[制限](https://duckdb.org/docs/guides/performance/indexing.html#art-indexes)があり、非常に選択度の高いポイントクエリや約0.1%以下の行を対象とするフィルタクエリでしか効果を発揮しません。
#### データ圧縮
DuckDBは[自動的](https://duckdb.org/2022/10/28/lightweight-compression.html)に軽量圧縮アルゴリズムを選択し、カラムごとに[圧縮](https://duckdb.org/docs/internals/storage.html#compression)を適用します。
#### データソート
DuckDBのドキュメントでは、[事前にソートした状態](https://duckdb.org/docs/guides/performance/indexing.html#the-effect-of-ordering-on-zonemaps)でデータを挿入し、類似値をまとめることで圧縮効率や最小最大インデックスの効果を高めることが推奨されています。ただしDuckDB自体が自動でデータをソートするわけではありません。
#### キャッシュ
DuckDBはOSページキャッシュと内部の[バッファマネージャ](https://duckdb.org/2024/07/09/memory-management.html)を使用し、ストレージから読み込んだページをキャッシュします。
### PostgreSQL
[PostgreSQL](https://www.postgresql.org/)は古くからある行指向のリレーショナルデータベースで、JSONを一級サポートしています。私たちは、行指向データベースとしてDuckDBやClickHouseのような最新列指向型データベースと比較するために取り上げました。ただし、PostgreSQLは大規模分析向けではないため、JSONBenchのようなテストではスペック的に不利で、他のシステムと直接競合するわけではありません。
#### JSONサポート
PostgreSQLはJSONとJSONBの2種類のJSONデータ型をネイティブサポートしています。
- [JSON型](https://www.postgresql.org/docs/current/datatype-json.html):2012年リリースのPostgreSQL 9.2で導入。文字列として保存し、使用時に再度パース。
- [JSONB型](https://www.postgresql.org/docs/current/datatype-json.html):2014年リリースのPostgreSQL 9.4で導入。BSONに類似するバイナリ形式で保存され、高速な検索や機能が利用可能。
最新の推奨は性能面でも機能面でも優れる[JSONB](https://www.postgresql.org/docs/current/datatype-json.html)となります。
#### JSONストレージ
PostgreSQLは[行指向](https://clickhouse.com/engineering-resources/what-is-columnar-database#row-based-vs-column-based)データベースなので、JSONBタプルをディスク上で行単位に順次格納します。
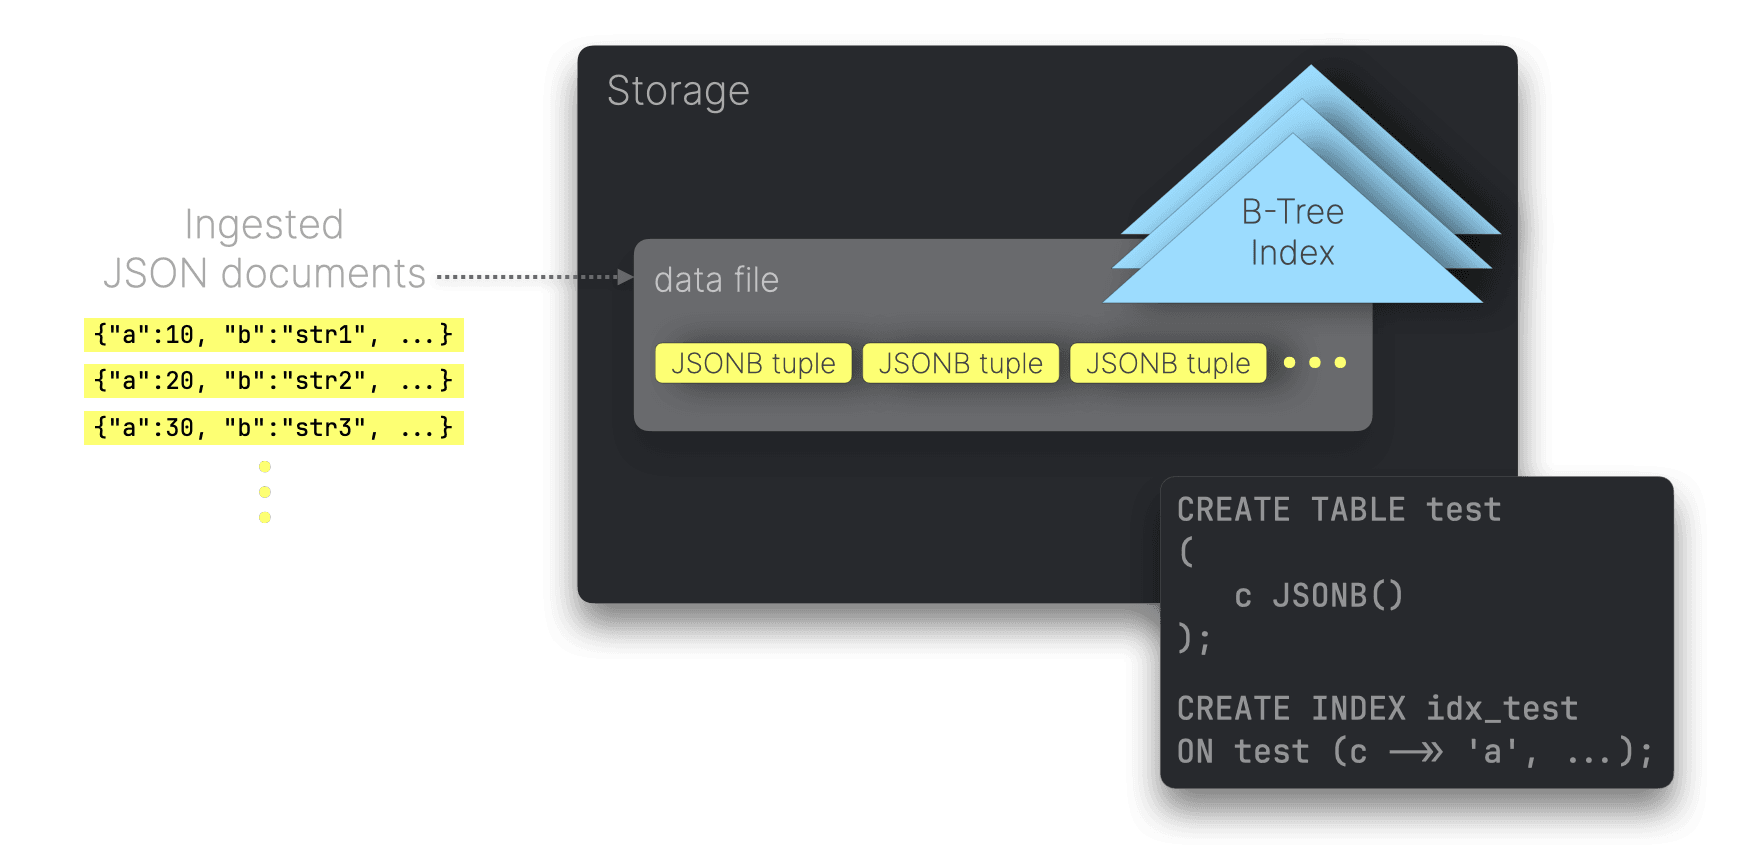
ユーザーは[CREATE INDEX](https://www.postgresql.org/docs/current/sql-createindex.html)によって特定のJSONパスにセカンダリインデックスを作成できます。[デフォルト](https://www.postgresql.org/docs/current/sql-createindex.html)ではB-Treeインデックスで、各行に対してインデックスのエントリが1つ、インデックスにはJSONパスの値が格納されます。
#### Index-only scan
PostgreSQLはB-Treeインデックスで[index-only scan](https://www.postgresql.org/docs/current/indexes-index-only-scans.html)をサポートしており、[covered index scans](/blog/json-bench-clickhouse-vs-mongodb-elasticsearch-duckdb-postgresql#covered-index-scans)に類似した最適化が可能です。ただし、自動ではなく[可視性マップ](https://www.postgresql.org/docs/current/indexes-index-only-scans.html)によりテーブルの行が「可視」としてマークされている必要があります。これによりテーブルを読まずにインデックスだけでクエリを完結できます。
私たちのベンチマークでは、PostgreSQLの[クエリ実行プラン](https://github.com/ClickHouse/JSONBench/tree/c7afa7078aed72c55ff4441a2da635424fde7724/postgresql/results/_index_usage)を取得して、index-only scanが行われているか検証しています。
#### データ圧縮
PostgreSQLは行ごとに8 KBの[ページ](https://en.m.wikipedia.org/wiki/Page_(computer_memory))をディスク上に配置し、各ページにできるだけ多くのタプルを詰め込みます。理想的にはタプルは2 KB以内が望ましいです。2 KBを超えるタプルは[TOAST](https://www.postgresql.org/docs/current/storage-toast.html)機構によって[圧縮](https://www.postgresql.org/docs/17/sql-createtable.html#SQL-CREATETABLE-PARMS-COMPRESSION)・分割されます。TOASTは`pglz`や`lz4`などをサポートし、2 KB以下のタプルは圧縮されません。
#### データソート
PostgreSQLは[CLUSTER](https://www.postgresql.org/docs/current/sql-cluster.html)コマンドで物理的にテーブルをソートする「clustered tables」をサポートします。しかし、ClickHouseやElasticsearchのようにデータのソート順で圧縮率が向上するわけではなく、PostgreSQLは行指向なので行内のデータがまとめて格納されるためです。実際には2 KB以上のタプルのみTOASTで圧縮され、データソートによる恩恵は限定的です。
#### キャッシュ
PostgreSQLは[クエリ実行プラン](https://www.postgresql.org/docs/current/plpgsql-implementation.html#PLPGSQL-PLAN-CACHING)や[テーブル/インデックスブロック](https://www.postgresql.org/docs/current/pgbuffercache.html)をキャッシュし、OSページキャッシュも利用します。ただし、専用のクエリ結果キャッシュはありません。
## ベンチマーク設定
[ClickBench](https://benchmark.clickhouse.com/)を参考に、私たちは[JSONBench](https://jsonbench.com/)という完全再現可能なベンチマークを作成しました。詳細な利用手順は[こちら](https://github.com/ClickHouse/JSONBench/?tab=readme-ov-file#usage)からご覧いただけます。
### ハードウェアとOS
ベンチマークはすべて、専用のAWS EC2 **m6i.8xlarge**インスタンス(**32 CPUコア**、**128 GB RAM**、**10 TB gp3ボリューム**)上で行いました。OSは**Ubuntu Linux 24.04 LTS**です。
### 評価システムのバージョン
以下のOSSバージョンを使用してベンチマークを行いました(すべてJSONを一級サポート):
- ClickHouse 25.1.1
- MongoDB 8.0.3
- Elasticsearch 8.17.0
- DuckDB 1.1.3
- PostgreSQL 16.6
### 測定項目
ベンチマークでは、**ストレージサイズ**と**クエリ性能**を評価し、それぞれ**デフォルトの圧縮設定**と**最高の圧縮設定**でテストしました。
システムの introspection 機能に応じて、以下の項目も計測しています:
- **インデックスのストレージサイズ**
- [ClickHouse](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/results/m6i.8xlarge_bluesky_1000m_zstd.json#L19) 例
- [MongoDB](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/results/m6i.8xlarge_bluesky_1000m_zstd.json#L19) 例
- [PostgreSQL](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/postgresql/results/m6i.8xlarge_bluesky_1000m_lz4.json#L19) 例
- **データのみのストレージサイズ**(インデックスを除く)
- [ClickHouse](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/results/m6i.8xlarge_bluesky_1000m_zstd.json#L17) 例
- [MongoDB](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/results/m6i.8xlarge_bluesky_1000m_zstd.json#L17) 例
- [PostgreSQL](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/postgresql/results/m6i.8xlarge_bluesky_1000m_lz4.json#L17) 例
- **トータルストレージサイズ**(データ + インデックス)
- [ClickHouse](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/results/m6i.8xlarge_bluesky_1000m_zstd.json#L15) 例
- [MongoDB](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/results/m6i.8xlarge_bluesky_1000m_zstd.json#L15) 例
- [Elasticsearch](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/elasticsearch/results/m6i.8xlarge_bluesky_no_source_1000m_best_compression.json#L15) 例
- [DuckDB](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/duckdb/results/m6i.8xlarge_bluesky_1000m.json#L15) 例
- [PostgreSQL](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/postgresql/results/m6i.8xlarge_bluesky_1000m_lz4.json#L15) 例
- **各クエリの実行プラン**(**インデックス利用**などの検証用)
- ClickHouseの[論理プラン](https://github.com/ClickHouse/JSONBench/tree/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/results/_index_usage)と[物理プラン](https://github.com/ClickHouse/JSONBench/tree/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/results/_physical_query_plans)の例
- [MongoDB](https://github.com/ClickHouse/JSONBench/tree/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/results/_index_usage)の例
- [DuckDB](https://github.com/ClickHouse/JSONBench/tree/c7afa7078aed72c55ff4441a2da635424fde7724/duckdb/results/_physical_query_plans)の例
- [PostgreSQL](https://github.com/ClickHouse/JSONBench/tree/c7afa7078aed72c55ff4441a2da635424fde7724/postgresql/results/_index_usage)の例
- **クエリごとの最大メモリ使用量**
- [ClickHouse](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/results/m6i.8xlarge_bluesky_1000m_zstd.json#L36)の例
## ベンチマーククエリ
各システムについて、[コールド/ホットのパフォーマンス](/blog/json-bench-clickhouse-vs-mongodb-elasticsearch-duckdb-postgresql#cold-and-hot-query-runtimes)を含め、5種類の分析クエリを8つのデータセットに対して順番に実行しました。
ClickHouse、DuckDB、PostgreSQL向けにはSQL、MongoDBには[aggregation pipeline](https://www.mongodb.com/docs/manual/aggregation/#std-label-aggregation-pipeline-intro)、Elasticsearchには[ES|QL](https://www.elastic.co/guide/en/elasticsearch/reference/current/esql.html)を使用しました。それらが同等の処理であることを示すため、1百万件データセットに対する実行結果をリンク先に載せています(1百万件なら[完全に](https://jsonbench.com/#eyJzeXN0ZW0iOnsiQ2xpY2tIb3VzZSAobHo0KSI6dHJ1ZSwiQ2xpY2tIb3VzZSAoenN0ZCkiOnRydWUsIkR1Y2tEQiI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAobm8gc291cmNlLCBiZXN0IGNvbXByZXNzaW9uKSI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAobm8gc291cmNlLCBkZWZhdWx0KSI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAoYmVzdCBjb21wcmVzc2lvbikiOnRydWUsIkVsYXN0aWNzZWFyY2ggKGRlZmF1bHQpIjp0cnVlLCJFbGFzdGljc2VhcmNoIjp0cnVlLCJNb25nb0RCIChzbmFwcHksIGNvdmVyZWQgaW5kZXgpIjp0cnVlLCJNb25nb0RCICh6c3RkLCBjb3ZlcmVkIGluZGV4KSI6dHJ1ZSwiTW9uZ29EQiAoc25hcHB5KSI6dHJ1ZSwiTW9uZ29EQiAoenN0ZCkiOnRydWUsIlBvc3RncmVTUUwgKGx6NCkiOnRydWUsIlBvc3RncmVTUUwgKHBnbHopIjp0cnVlfSwic2NhbGUiOiIxMDAwMDAwIiwibWV0cmljIjoicXVhbGl0eSIsInF1ZXJpZXMiOlt0cnVlLHRydWUsdHJ1ZSx0cnVlLHRydWVdfQ==)ロードできるので結果を完全比較可能)。
#### Query ① - Blueskyのイベント種類トップ
- [ClickHouse](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/queries_formatted.sql#L2)版 + [結果](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/results/_query_results/_m6i.8xlarge_bluesky_1m_lz4.query_results#L2)
- [MongoDB](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/queries_formatted.js#L2)版 + [結果](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/results/_query_results/_m6i.8xlarge_bluesky_1m_snappy.query_results#L2)
- [Elasticsearch](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/elasticsearch/queries_formatted.txt#L1)版 + [結果](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/elasticsearch/results/_query_results/_m6i.8xlarge_bluesky-no_source_best_compression-1m.query_results#L2)
- [DuckDB](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/duckdb/queries_formatted.sql#L2)版 + [結果](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/duckdb/results/_query_results/_m6i.8xlarge_bluesky_1m.query_results#L2)
- [PostgreSQL](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/postgresql/queries_formatted.sql#L2)版 + [結果](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/postgresql/results/_query_results/_m6i.8xlarge_bluesky_1m_lz4.query_results#L2)
#### Query ② - Blueskyのイベント種類トップとユーザー数
- [ClickHouse](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/queries_formatted.sql#L12)版 + [結果](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/results/_query_results/_m6i.8xlarge_bluesky_1m_lz4.query_results#L22)
- [MongoDB](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/queries_formatted.js#L17)版 + [結果](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/results/_query_results/_m6i.8xlarge_bluesky_1m_snappy.query_results#L67)
- [Elasticsearch](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/elasticsearch/queries_formatted.txt#L10)版 + [結果](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/elasticsearch/results/_query_results/_m6i.8xlarge_bluesky-no_source_best_compression-1m.query_results#L23)
- [DuckDB](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/duckdb/queries_formatted.sql#L12)版 + [結果](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/duckdb/results/_query_results/_m6i.8xlarge_bluesky_1m.query_results#L27)
- [PostgreSQL](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/postgresql/queries_formatted.sql#L12)版 + [結果](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/postgresql/results/_query_results/_m6i.8xlarge_bluesky_1m_lz4.query_results#L24)
#### Query ③ - Blueskyはいつ使われるか
- [ClickHouse](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/queries_formatted.sql#L25)版 + [結果](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/results/_query_results/_m6i.8xlarge_bluesky_1m_lz4.query_results#L40)
- [MongoDB](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/queries_formatted.js#L47)版 + [結果](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/results/_query_results/_m6i.8xlarge_bluesky_1m_snappy.query_results#L150)
- [Elasticsearch](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/elasticsearch/queries_formatted.txt#L20)版 + [結果](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/elasticsearch/results/_query_results/_m6i.8xlarge_bluesky-no_source_best_compression-1m.query_results#L42)
- [DuckDB](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/duckdb/queries_formatted.sql#L25)版 + [結果](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/duckdb/results/_query_results/_m6i.8xlarge_bluesky_1m.query_results#L50)
- [PostgreSQL](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/postgresql/queries_formatted.sql#L25)版 + [結果](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/postgresql/results/_query_results/_m6i.8xlarge_bluesky_1m_lz4.query_results#L44)
#### Query ④ - もっとも古参の投稿者トップ3
- [ClickHouse](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/queries_formatted.sql#L39)版 + [結果](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/results/_query_results/_m6i.8xlarge_bluesky_1m_lz4.query_results#L48)
- [MongoDB](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/queries_formatted.js#L85)版 + [結果](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/results/_query_results/_m6i.8xlarge_bluesky_1m_snappy.query_results#L176)
- [Elasticsearch](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/elasticsearch/queries_formatted.txt#L30)版 + [結果](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/elasticsearch/results/_query_results/_m6i.8xlarge_bluesky-no_source_best_compression-1m.query_results#L51)
- [DuckDB](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/duckdb/queries_formatted.sql#L40)版 + [結果](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/duckdb/results/_query_results/_m6i.8xlarge_bluesky_1m.query_results#L61)
- [PostgreSQL](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/postgresql/queries_formatted.sql#L39)版 + [結果](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/postgresql/results/_query_results/_m6i.8xlarge_bluesky_1m_lz4.query_results#L54)
#### Query ⑤ - もっとも活動期間が長いユーザートップ3
- [ClickHouse](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/queries_formatted.sql#L53)版 + [結果](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/results/_query_results/_m6i.8xlarge_bluesky_1m_lz4.query_results#L56)
- [MongoDB](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/queries_formatted.js#L117)版 + [結果](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/results/_query_results/_m6i.8xlarge_bluesky_1m_snappy.query_results#L193)
- [Elasticsearch](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/elasticsearch/queries_formatted.txt#L41)版 + [結果](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/elasticsearch/results/_query_results/_m6i.8xlarge_bluesky-no_source_best_compression-1m.query_results#L60)
- [DuckDB](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/duckdb/queries_formatted.sql#L55)版 + [結果](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/duckdb/results/_query_results/_m6i.8xlarge_bluesky_1m.query_results#L72)
- [PostgreSQL](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/postgresql/queries_formatted.sql#L56)版 + [結果](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/postgresql/results/_query_results/_m6i.8xlarge_bluesky_1m_lz4.query_results#L64)
## ベンチマーク手法
この記事では、**最大10億件のBluesky JSONドキュメント**を取り込み時のストレージサイズと、**5種類の典型的分析クエリ**(連続実行)の性能を比較しました。
評価は、**5つのオープンソースJSON対応データストア**を**単一ノード**で動かし、定義済みの手法に従って行いました。以下に手法を説明します。
### チューニングなし
[ClickBench](https://github.com/ClickHouse/ClickBench?tab=readme-ov-file#installation-and-fine-tuning)と同様に、すべてのシステムは標準設定のまま、特別なチューニングは行っていません。
例外として、MongoDBの[クエリ②](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/queries_formatted.js#L17)で以下のエラーが発生しました。
```shell
MongoServerError[ExceededMemoryLimit]: PlanExecutor error during aggregation :: caused by :: Used too much memory for a single array. Memory limit: 104857600. Current set has 2279516 elements and is 104857601 bytes.
```
これは[`COUNT DISTINCT`がない](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/queries_formatted.js#L31)ために使っている[$addToSet](https://www.mongodb.com/docs/manual/reference/operator/aggregation/addToSet/)演算子がデフォルトで100MBの制限を超えてしまったことが原因です。対応として、[internalQueryMaxAddToSetBytes](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/run_queries.sh#L24)を引き上げました。
また、[ベストプラクティス](https://www.mongodb.com/docs/manual/core/query-optimization/#performance)に従い、MongoDBの[カバードインデックススキャン](https://github.com/ClickHouse/ClickBench/blob/96994da9b0cd61b04e543224dd89c9de32486415/mongodb/benchmark.sh#L14)を有効化するため、[internalQueryPlannerGenerateCoveredWholeIndexScans](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/run_queries.sh#L36)をオンにしました。結果として、ベンチマーククエリのMongoDBはすべてcoveredクエリとなり、これが有効でない場合の実行時間よりも大幅に速くなります。
### クエリ結果キャッシュなし
ElasticsearchやClickHouseのように、クエリ結果キャッシュを有効化すると、その後の実行はキャッシュから即座に結果を返せます。しかしこれではベンチマークとして有意義な比較にならないため、全システムでクエリ結果キャッシュを無効化・クリアしています。
### トップレベルのフィールド抽出はなし
今回の目的は、「各システムのJSONデータ型」の性能比較に集中することです。そこで、テスト対象の各システム・データ構成では、単一のJSON型フィールドのみを持つテーブル*に制限しました。
**ClickHouse**の[DDL例](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/ddl_zstd.sql#L1):
CREATE TABLE bluesky (
    data JSON
) ORDER BY();
**DuckDB**の[DDL例](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/duckdb/ddl.sql#L1):
CREATE TABLE bluesky (
    data JSON
);
**PostgreSQL**の[DDL例](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/postgresql/ddl_lz4.sql#L1):
CREATE TABLE bluesky (
    data JSONB
);
*MongoDBやElasticsearchはリレーショナルDBではないため、DDLはやや異なりますが、同様に「単一フィールド(ドキュメント単位)でJSONを扱う」概念で比較しています。*
[ClickHouseのDDL](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/ddl_zstd.sql#L1)ではプライマリキーを指定するためにJSONパスと型ヒントをJSON型の定義内部で指定しています。一方、DuckDBやPostgreSQLはセカンダリインデックスをCREATE TABLE後に作成し、同じ目的を達成しています。詳細は次のセクションを参照してください。
### 一部のJSONパスだけインデックス&データソート可
今回のベンチマーククエリを高速化するため、各システムで以下のJSONパスに対するインデックス(または相当する機能)を作成できるようにしました:
- **kind**: 大部分のBlueskyイベント構造を分岐させるパス(`commit`, `identity`, `account`などがある)
- **commit.operation**: `commit`イベントが`create`, `delete`, `update`のどれかを表す
- **commit.collection**: `commit`イベントの種類(例:`post`, `repost`, `like`など)
- **did**: イベントを引き起こしたBlueskyユーザーのID
- **time_us**: Blueskyタイムスタンプの不一致問題を簡単化するため、すべてのイベントがこのタイムスタンプ(実際にはAPI取得時刻)を持つとみなす
DuckDBとElasticsearchを除く全システムでは、これらのパスを1つの複合インデックスにまとめました(カーディナリティの低い順で並べる)。
(kind, commit.operation, commit.collection, did, time_us)
**ClickHouse**では、[プライマリキー/ソートキー](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/ddl_zstd.sql#L10)を同等に設定しました:
ORDER BY (
    data.kind,
    data.commit.operation,
    data.commit.collection,
    data.did,
    fromUnixTimestamp64Micro(data.time_us));
**MongoDB**では、[セカンダリインデックス](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/ddl_snappy.js#L6)を作成:
db.bluesky.createIndex({
    "kind": 1,
    "commit.operation": 1,
    "commit.collection": 1,
    "did": 1,
    "time_us": 1});
**PostgreSQL**では、[セカンダリインデックス](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/postgresql/ddl_lz4.sql#L5)を作成:
CREATE INDEX idx_bluesky
ON bluesky (
    (data ->> 'kind'),
    (data -> 'commit' ->> 'operation'),
    (data -> 'commit' ->> 'collection'),
    (data ->> 'did'),
    (TO_TIMESTAMP((data ->> 'time_us')::BIGINT / 1000000.0))
);
**DuckDB**では、[利用可能なインデックス](https://duckdb.org/docs/guides/performance/indexing.html#art-indexes)を使っても今回のベンチマーククエリに利点がないと判断し、データソートも自動化されません。
**Elasticsearch**はセカンダリインデックスの概念はありませんが、[doc_values](#json-storage-and-data-compression)を自動的に作成し、[index sorting](#data-sorting-1)によって最適化を行います。[ClickHouseのソートキー](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/ddl_zstd.sql#L10)と同じJSONパスで[インデックスソート](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/elasticsearch/config/index_template_no_source_best_compression.json#L28)を行っています。
#### MongoDBとPostgreSQLでインデックスオンリースキャンを許容
多くの[ベンチマーククエリ](#benchmark-queries)で`kind`, `commit.operation`, `commit.collection`によるフィルタ(3つ同時)が行われますが、これらも複合インデックスを利用しています。
`did`や`time_us`はクエリでフィルタされませんが、MongoDBやPostgreSQLで[index-only scan](/blog/json-bench-clickhouse-vs-mongodb-elasticsearch-duckdb-postgresql#covered-index-scans)を有効化するには、クエリが参照する列をすべてインデックスに含める必要があります。ClickHouseの場合は、`did`や`time_us`もプライマリキーに含めることでディスクサイズ比較をより正確にできるようにしています。
#### クエリ実行プランからインデックス利用を検証
[前述](#measurements)したように、私たちは各システムのクエリ実行プランを解析して、ベンチマーククエリが意図したインデックスを正しく利用しているかを検証しました。
### データセット件数に多少の差異は許容
大規模なJSONデータセットでは、一部のシステムが特定ドキュメントをパースできず読み込めないケースがしばしば起こります。実装の違いやフォーマットの例外などが原因です。
今回のベンチマークでは、**100%完璧にロードできなくても構わない**という前提としました。ロードできたドキュメント数が元データセットサイズに**近似**していれば、性能やストレージ比較には十分だと考えています。
結果として、ベンチマークでは`dataset_size`(予定行数)と、実際にロードできた行数(`num_loaded_documents`)を記録しています。
例えば10億ドキュメントの場合、各システムでロードできた行数は以下のとおりでした:
- ClickHouse: [999,999,258件](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/results/m6i.8xlarge_bluesky_1000m_zstd.json#L13)
- MongoDB: [893,632,990件](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/results/m6i.8xlarge_bluesky_1000m_zstd.json#L13)
- Elasticsearch: [999,998,998件](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/elasticsearch/results/m6i.8xlarge_bluesky_no_source_1000m_best_compression.json#L13)
- DuckDB: [974,400,000件](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/duckdb/results/m6i.8xlarge_bluesky_1000m.json#L13C27-L13C36)
- PostgreSQL: [804,000,000件](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/postgresql/results/m6i.8xlarge_bluesky_1000m_lz4.json#L13)
[JSONBenchオンラインダッシュボード](https://jsonbench.com/)の`Data Quality`メトリクスで、システムごとのロード完了率も確認できます。1百万、1千万、1億、10億件など各サイズでのロード率を比較可能です。
私たちは、ロード方法の改良や不具合修正によって、より多くのドキュメントをロードできるようにする貢献を歓迎します。
### コールドとホットクエリ時間
[ClickBench](https://github.com/ClickHouse/ClickBench?tab=readme-ov-file#results-usage-and-scoreboards)と同様に、各ベンチマーククエリをそれぞれ3回実行し、**1回目の実行をコールドランタイム**、**2回目と3回目のうち最短をホットランタイム**とします。1回目の実行前には、OSレベルのページキャッシュをクリア(例:[ClickHouseのケース](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/run_queries.sh#L16C5-L16C40))します。
以下はご要望に沿って、元の英文ブログ記事を日本語に翻訳したものです。リンクや参照先は原文のまま残してあります。
---
## ベンチマーク結果
いよいよベンチマーク結果の紹介です。前述した手法に従い、**10億件の JSON ドキュメントを扱うデータセット**に対する結果を示します。実運用で考えられるデータ量に注目するため、このような大きな規模のデータセットを対象にしています。
また、比較をシンプルかつ実際的にするために、各システムで利用可能な**最適な圧縮オプション**を使った場合の結果のみを掲載しています。多くのシステムが同じ `zstd` アルゴリズムを採用していること、そしてペタバイト級の現実的なシナリオではストレージコスト削減のために圧縮が極めて重要となることを考慮して、この方針としました。
小規模データセットの結果は重複を避けるため、そして実際のユースケースではあまり意味がないため、ここでは割愛しています。たとえば Bluesky のようなプラットフォームでは 1 秒間に数百万件のイベントが生まれる可能性があるので、あまりに小さいデータセットは現実的ではありません。
> もっと詳しく知りたい方のために、デフォルト圧縮オプションや小規模データセットを含むすべての結果を [JSONBench のオンラインダッシュボード](https://jsonbench.com/) で公開しています。すべてのシステムについて結果を簡単に分析・比較できるようになっています:
>
> - 1 million JSON ドキュメント(100万件): [storage sizes](https://jsonbench.com/#eyJzeXN0ZW0iOnsiQ2xpY2tIb3VzZSAobHo0KSI6dHJ1ZSwiQ2xpY2tIb3VzZSAoenN0ZCkiOnRydWUsIkR1Y2tEQiI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAobm8gc291cmNlLCBiZXN0IGNvbXByZXNzaW9uKSI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAobm8gc291cmNlLCBkZWZhdWx0KSI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAoYmVzdCBjb21wcmVzc2lvbikiOnRydWUsIkVsYXN0aWNzZWFyY2ggKGRlZmF1bHQpIjp0cnVlLCJFbGFzdGljc2VhcmNoIjp0cnVlLCJNb25nb0RCIChzbmFwcHksIGNvdmVyZWQgaW5kZXgpIjp0cnVlLCJNb25nb0RCICh6c3RkLCBjb3ZlcmVkIGluZGV4KSI6dHJ1ZSwiTW9uZ29EQiAoc25hcHB5KSI6dHJ1ZSwiTW9uZ29EQiAoenN0ZCkiOnRydWUsIlBvc3RncmVTUUwgKGx6NCkiOnRydWUsIlBvc3RncmVTUUwgKHBnbHopIjp0cnVlfSwic2NhbGUiOiIxMDAwMDAwIiwibWV0cmljIjoic2l6ZSIsInF1ZXJpZXMiOlt0cnVlLHRydWUsdHJ1ZSx0cnVlLHRydWVdfQ==), [cold runtimes](https://jsonbench.com/#eyJzeXN0ZW0iOnsiQ2xpY2tIb3VzZSAobHo0KSI6dHJ1ZSwiQ2xpY2tIb3VzZSAoenN0ZCkiOnRydWUsIkR1Y2tEQiI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAobm8gc291cmNlLCBiZXN0IGNvbXByZXNzaW9uKSI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAobm8gc291cmNlLCBkZWZhdWx0KSI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAoYmVzdCBjb21wcmVzc2lvbikiOnRydWUsIkVsYXN0aWNzZWFyY2ggKGRlZmF1bHQpIjp0cnVlLCJFbGFzdGljc2VhcmNoIjp0cnVlLCJNb25nb0RCIChzbmFwcHksIGNvdmVyZWQgaW5kZXgpIjp0cnVlLCJNb25nb0RCICh6c3RkLCBjb3ZlcmVkIGluZGV4KSI6dHJ1ZSwiTW9uZ29EQiAoc25hcHB5KSI6dHJ1ZSwiTW9uZ29EQiAoenN0ZCkiOnRydWUsIlBvc3RncmVTUUwgKGx6NCkiOnRydWUsIlBvc3RncmVTUUwgKHBnbHopIjp0cnVlfSwic2NhbGUiOiIxMDAwMDAwIiwibWV0cmljIjoiY29sZCIsInF1ZXJpZXMiOlt0cnVlLHRydWUsdHJ1ZSx0cnVlLHRydWVdfQ==), [hot runtimes](https://jsonbench.com/#eyJzeXN0ZW0iOnsiQ2xpY2tIb3VzZSAobHo0KSI6dHJ1ZSwiQ2xpY2tIb3VzZSAoenN0ZCkiOnRydWUsIkR1Y2tEQiI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAobm8gc291cmNlLCBiZXN0IGNvbXByZXNzaW9uKSI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAobm8gc291cmNlLCBkZWZhdWx0KSI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAoYmVzdCBjb21wcmVzc2lvbikiOnRydWUsIkVsYXN0aWNzZWFyY2ggKGRlZmF1bHQpIjp0cnVlLCJFbGFzdGljc2VhcmNoIjp0cnVlLCJNb25nb0RCIChzbmFwcHksIGNvdmVyZWQgaW5kZXgpIjp0cnRlLCJNb25nb0RCICh6c3RkLCBjb3ZlcmVkIGluZGV4KSI6dHJ1ZSwiTW9uZ29EQiAoc25hcHB5KSI6dHJ1ZSwiTW9uZ29EQiAoenN0ZCkiOnRydWUsIlBvc3RncmVTUUwgKGx6NCkiOnRydWUsIlBvc3RncmVTUUwgKHBnbHopIjp0cnVlfSwic2NhbGUiOiIxMDAwMDAwIiwibWV0cmljIjoiaG90IiwicXVlcmllcyI6W3RydWUsdHJ1ZSx0cnVlLHRydWUsdHJ1ZV19)
> - 10 million JSON ドキュメント(1000万件): [storage sizes](https://jsonbench.com/#eyJzeXN0ZW0iOnsiQ2xpY2tIb3VzZSAobHo0KSI6dHJ1ZSwiQ2xpY2tIb3VzZSAoenN0ZCkiOnRydWUsIkR1Y2tEQiI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAobm8gc291cmNlLCBiZXN0IGNvbXByZXNzaW9uKSI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAobm8gc291cmNlLCBkZWZhdWx0KSI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAoYmVzdCBjb21wcmVzc2lvbikiOnRydWUsIkVsYXN0aWNzZWFyY2ggKGRlZmF1bHQpIjp0cnVlLCJFbGFzdGljc2VhcmNoIjp0cnVlLCJNb25nb0RCIChzbmFwcHksIGNvdmVyZWQgaW5kZXgpIjp0cnVlLCJNb25nb0RCICh6c3RkLCBjb3ZlcmVkIGluZGV4KSI6dHJ1ZSwiTW9uZ29EQiAoc25hcHB5KSI6dHJ1ZSwiTW9uZ29EQiAoenN0ZCkiOnRydWUsIlBvc3RncmVTUUwgKGx6NCkiOnRydWUsIlBvc3RncmVTUUwgKHBnbHopIjp0cnVlfSwic2NhbGUiOiIxMDAwMDAwMCIsIm1ldHJpYyI6InNpemUiLCJxdWVyaWVzIjpbdHJ1ZSx0cnVlLHRydWUsdHJ1ZSx0cnVlXX0=), [cold runtimes](https://jsonbench.com/#eyJzeXN0ZW0iOnsiQ2xpY2tIb3VzZSAobHo0KSI6dHJ1ZSwiQ2xpY2tIb3VzZSAoenN0ZCkiOnRydWUsIkR1Y2tEQiI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAobm8gc291cmNlLCBiZXN0IGNvbXByZXNzaW9uKSI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAobm8gc291cmNlLCBkZWZhdWx0KSI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAoYmVzdCBjb21wcmVzc2lvbikiOnRydWUsIkVsYXN0aWNzZWFyY2ggKGRlZmF1bHQpIjp0cnVlLCJFbGFzdGljc2VhcmNoIjp0cnVlLCJNb25nb0RCIChzbmFwcHksIGNvdmVyZWQgaW5kZXgpIjp0cnVlLCJNb25nb0RCICh6c3RkLCBjb3ZlcmVkIGluZGV4KSI6dHJ1ZSwiTW9uZ29EQiAoc25hcHB5KSI6dHJ1ZSwiTW9uZ29EQiAoenN0ZCkiOnRydWUsIlBvc3RncmVTUUwgKGx6NCkiOnRydWUsIlBvc3RncmVTUUwgKHBnbHopIjp0cnVlfSwic2NhbGUiOiIxMDAwMDAwMCIsIm1ldHJpYyI6ImNvbGQiLCJxdWVyaWVzIjpbdHJ1ZSx0cnVlLHRydWUsdHJ1ZSx0cnVlXX0=), [hot runtimes](https://jsonbench.com/#eyJzeXN0ZW0iOnsiQ2xpY2tIb3VzZSAobHo0KSI6dHJ1ZSwiQ2xpY2tIb3VzZSAoenN0ZCkiOnRydWUsIkR1Y2tEQiI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAobm8gc291cmNlLCBiZXN0IGNvbXByZXNzaW9uKSI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAobm8gc291cmNlLCBkZWZhdWx0KSI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAoYmVzdCBjb21wcmVzc2lvbikiOnRydWUsIkVsYXN0aWNzZWFyY2ggKGRlZmF1bHQpIjp0cnVlLCJFbGFzdGljc2VhcmNoIjp0cnVlLCJNb25nb0RCIChzbmFwcHksIGNvdmVyZWQgaW5kZXgpIjp0cnVlLCJNb25nb0RCICh6c3RkLCBjb3ZlcmVkIGluZGV4KSI6dHJ1ZSwiTW9uZ29EQiAoc25hcHB5KSI6dHJ1ZSwiTW9uZ29EQiAoenN0ZCkiOnRydWUsIlBvc3RncmVTUUwgKGx6NCkiOnRydWUsIlBvc3RncmVTUUwgKHBnbHopIjp0cnVlfSwic2NhbGUiOiIxMDAwMDAwMCIsIm1ldHJpYyI6ImhvdCIsInF1ZXJpZXMiOlt0cnVlLHRydWUsdHJ1ZSx0cnVlLHRydWVdfQ==)
> - 100 million JSON ドキュメント(1億件): [storage sizes](https://jsonbench.com/#eyJzeXN0ZW0iOnsiQ2xpY2tIb3VzZSAobHo0KSI6dHJ1ZSwiQ2xpY2tIb3VzZSAoenN0ZCkiOnRydWUsIkR1Y2tEQiI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAobm8gc291cmNlLCBiZXN0IGNvbXByZXNzaW9uKSI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAobm8gc291cmNlLCBkZWZhdWx0KSI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAoYmVzdCBjb21wcmVzc2lvbikiOnRydWUsIkVsYXN0aWNzZWFyY2ggKGRlZmF1bHQpIjp0cnVlLCJFbGFzdGljc2VhcmNoIjp0cnVlLCJNb25nb0RCIChzbmFwcHksIGNvdmVyZWQgaW5kZXgpIjp0cnVlLCJNb25nb0RCICh6c3RkLCBjb3ZlcmVkIGluZGV4KSI6dHJ1ZSwiTW9uZ29EQiAoc25hcHB5KSI6dHJ1ZSwiTW9uZ29EQiAoenN0ZCkiOnRydWUsIlBvc3RncmVTUUwgKGx6NCkiOnRydWUsIlBvc3RncmVTUUwgKHBnbHopIjp0cnVlfSwic2NhbGUiOiIxMDAwMDAwMDAiLCJtZXRyaWMiOiJzaXplIiwicXVlcmllcyI6W3RydWUsdHJ1ZSx0cnVlLHRydWUsdHJ1ZV19), [cold runtimes](https://jsonbench.com/#eyJzeXN0ZW0iOnsiQ2xpY2tIb3VzZSAobHo0KSI6dHJ1ZSwiQ2xpY2tIb3VzZSAoenN0ZCkiOnRydWUsIkR1Y2tEQiI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAobm8gc291cm5lLCBiZXN0IGNvbXByZXNzaW9uKSI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAobm8gc291cmNlLCBkZWZhdWx0KSI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAoYmVzdCBjb21wcmVzc2lvbikiOnRydWUsIkVsYXN0aWNzZWFyY2ggKGRlZmF1bHQpIjp0cnVlLCJFbGFzdGljc2VhcmNoIjp0cnVlLCJNb25nb0RCIChzbmFwcHksIGNvdmVyZWQgaW5kZXgpIjp0cnZlLCJNb25nb0RCICh6c3RkLCBjb3ZlcmVkIGluZGV4KSI6dHJ1ZSwiTW9uZ29EQiAoc25hcHB5KSI6dHJ1ZSwiTW9uZ29EQiAoenN0ZCkiOnRydWUsIlBvc3RncmVTUUwgKGx6NCkiOnRydWUsIlBvc3RncmVTUUwgKHBnbHopIjp0cnVlfSwic2NhbGUiOiIxMDAwMDAwMDAiLCJtZXRyaWMiOiJjb2xkIiwicXVlcmllcyI6W3RydWUsdHJ1ZSx0cnVlLHRydWUsdHJ1ZV19), [hot runtimes](https://jsonbench.com/#eyJzeXN0ZW0iOnsiQ2xpY2tIb3VzZSAobHo0KSI6dHJ1ZSwiQ2xpY2tIb3VzZSAoenN0ZCkiOnRydWUsIkR1Y2tEQiI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAobm8gc291cmNlLCBiZXN0IGNvbXByZXNzaW9uKSI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAobm8gc291cmNlLCBkZWZhdWx0KSI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAoYmVzdCBjb21wcmVzc2lvbikiOnRydWUsIkVsYXN0aWNzZWFyY2ggKGRlZmF1bHQpIjp0cnVlLCJFbGFzdGljc2VhcmNoIjp0cnVlLCJNb25nb0RCIChzbmFwcHksIGNvdmVyZWQgaW5kZXgpIjp0cnVlLCJNb25nb0RCICh6c3RkLCBjb3ZlcmVkIGluZGV4KSI6dHJ1ZSwiTW9uZ29EQiAoc25hcHB5KSI6dHJ1ZSwiTW9uZ29EQiAoenN0ZCkiOnRydWUsIlBvc3RncmVTUUwgKGx6NCkiOnRydWUsIlBvc3RncmVTUUwgKHBnbHopIjp0cnVlfSwic2NhbGUiOiIxMDAwMDAwMDAiLCJtZXRyaWMiOiJob3QiLCJxdWVyaWVzIjpbdHJ1ZSx0cnVlLHRydWUsdHJ1ZSx0cnVlXX0=)
> - 1 billion JSON ドキュメント(10億件): [storage sizes](https://jsonbench.com/#eyJzeXN0ZW0iOnsiQ2xpY2tIb3VzZSAobHo0KSI6dHJ1ZSwiQ2xpY2tIb3VzZSAoenN0ZCkiOnRydWUsIkR1Y2tEQiI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAobm8gc291cmNlLCBiZXN0IGNvbXByZXNzaW9uKSI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAobm8gc291cmNlLCBkZWZhdWx0KSI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAoYmVzdCBjb21wcmVzc2lvbikiOnRydWUsIkVsYXN0aWNzZWFyY2ggKGRlZmF1bHQpIjp0cnVlLCJFbGFzdGljc2VhcmNoIjp0cnVlLCJNb25nb0RCIChzbmFwcHksIGNvdmVyZWQgaW5kZXgpIjp0cnZlLCJNb25nb0RCICh6c3RkLCBjb3ZlcmVkIGluZGV4KSI6dHJ1ZSwiTW9uZ29EQiAoc25hcHB5KSI6dHJ1ZSwiTW9uZ29EQiAoenN0ZCkiOnRydWUsIlBvc3RncmVTUUwgKGx6NCkiOnRydWUsIlBvc3RncmVTUUwgKHBnbHopIjp0cnVlfSwic2NhbGUiOiIxMDAwMDAwMDAwIiwibWV0cmljIjoic2l6ZSIsInF1ZXJpZXMiOlt0cnVlLHRydWUsdHJ1ZSx0cnVlLHRydWVdfQ==), [cold runtimes](https://jsonbench.com/#eyJzeXN0ZW0iOnsiQ2xpY2tIb3VzZSAobHo0KSI6dHJ1ZSwiQ2xpY2tIb3VzZSAoenN0ZCkiOnRydWUsIkR1Y2tEQiI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAobm8gc291cmNlLCBiZXN0IGNvbXByZXNzaW9uKSI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAobm8gc291cmNlLCBkZWZhdWx0KSI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAoYmVzdCBjb21wcmVzc2lvbikiOnRydWUsIkVsYXN0aWNzZWFyY2ggKGRlZmF1bHQpIjp0cnZlLCJFbGFzdGljc2VhcmNoIjp0cnZlLCJNb25nb0RCIChzbmFwcHksIGNvdmVyZWQgaW5kZXgpIjp0cnZlLCJNb25nb0RCICh6c3RkLCBjb3ZlcmVkIGluZGV4KSI6dHJ1ZSwiTW9uZ29EQiAoc25hcHB5KSI6dHJ1ZSwiTW9uZ29EQiAoenN0ZCkiOnRydWUsIlBvc3RncmVTUUwgKGx6NCkiOnHJ1ZSwiUG9zdGdyZVNRTCgpcGduo...), [hot runtimes](https://jsonbench.com/#eyJzeXN0ZW0iOnsiQ2xpY2tIb3VzZSAobHo0KSI6dHJ1ZSwiQ2xpY2tIb3VzZSAoenN0ZCkiOnRydWUsIkR1Y2tEQiI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAobm8gc291cmNlLCBiZXN0IGNvbXByZXNzaW9uKSI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAobm8gc291cmNlLCBkZWZhdWx0KSI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAoYmVzdCBjb21wcmVzc2lvbikiOnRydWUsIkVsYXN0aWNzZWFyY2ggKGRlZmF1bHQpIjp0cnZlLCJFbGFzdGljc2VhcmNoIjp0cnZlLCJNb25nb0RCIChzbmFwcHksIGNvdmVyZWQgaW5kZXgpIjp0cnZlLCJNb25nb0RCICh6c3RkLCBjb3ZlcmVkIGluZGV4KSI6dHJ1ZSwiTW9uZ29EQiAoc25hcHB5KSI6dHJ1ZSwiTW9uZ29EQiAoenN0ZCkiOnRydWUsIlBvc3RncmVTUUwgKGx6NCkiOnHJ1ZSwiUG9zdGdyZVNRTCgpcGdu...))
これから、`best available compression`(最適な圧縮オプション)で 10億件の JSON ドキュメントを取り込んだ際の、[総ストレージサイズ](/blog/json-bench-clickhouse-vs-mongodb-elasticsearch-duckdb-postgresql#measurements)および分析系クエリのパフォーマンスを示します。
### 最適な圧縮を適用した場合のストレージサイズ
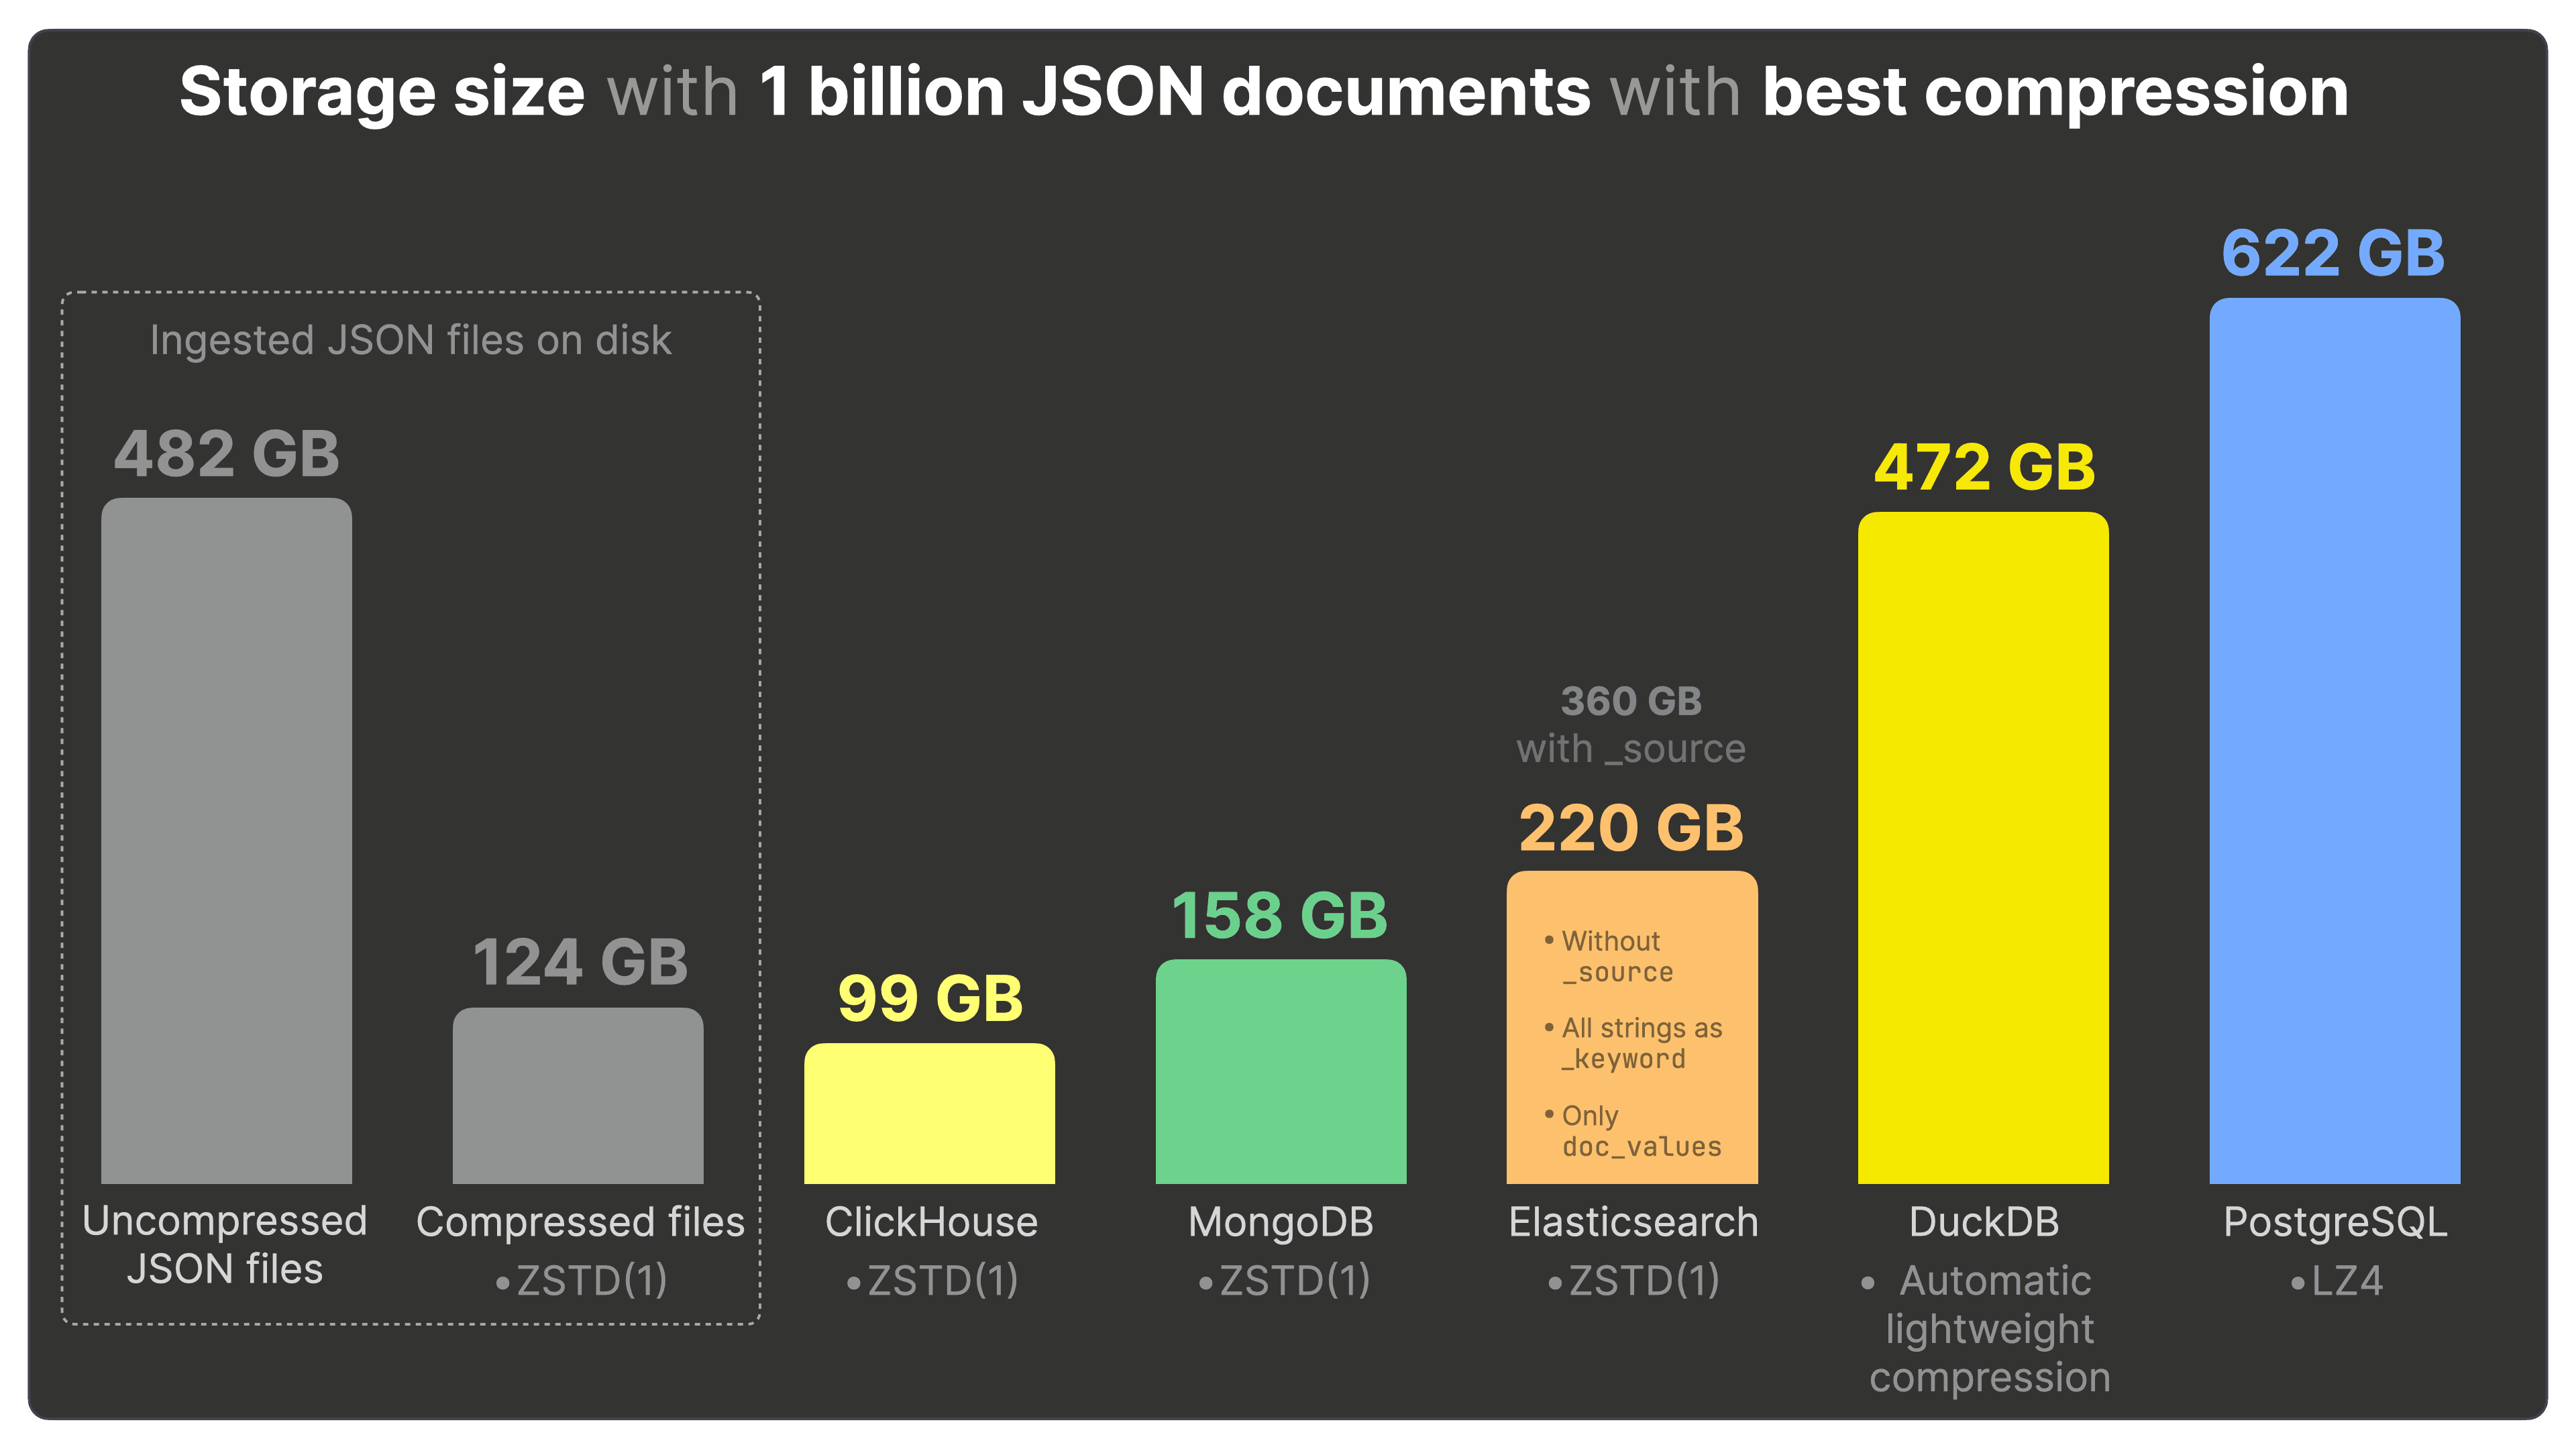
上の図は 7 つの棒グラフで示されるストレージサイズを、左から右へ順に解説していきます。
まず、[Bluesky](/blog/json-bench-clickhouse-vs-mongodb-elasticsearch-duckdb-postgresql#the-json-dataset---a-billion-bluesky-events) の **JSONファイル** は、圧縮しない状態で [482 GB](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/_files_json/results/_files_bluesky_json_1000m.json#L13) のディスク容量を占めます。これを `zstd` で圧縮すると [124 GB](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/_files_zstd/results/_files_bluesky_zstd_1000m.json#L13) まで削減されます。
**ClickHouse** に `zstd` 圧縮を[設定](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/ddl_zstd.sql#L8)した状態でこれらのファイルを取り込むと、合計のディスクサイズは [99 GB](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/results/m6i.8xlarge_bluesky_1000m_zstd.json#L15) となります。
> 注目すべきは、ClickHouse がソースファイルを `zstd` で直接圧縮したものよりさらに小さくデータを保持している点です。これは[上記](/blog/json-bench-clickhouse-vs-mongodb-elasticsearch-duckdb-postgresql#json-storage)で説明したように、ClickHouse が各 JSON パスの値をネイティブなカラムに分割して格納し、それぞれを個別に圧縮していることが大きく寄与します。また、プライマリキーが[使用され](/blog/json-bench-clickhouse-vs-mongodb-elasticsearch-duckdb-postgresql#data-sorting-and-compression)ている場合は、カラムごとに類似するデータをまとめ、ソートした上で圧縮できるため、圧縮率がさらに高まります。
**MongoDB** では `zstd` 圧縮を[有効化](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/ddl_zstd.js#L3)した状態で JSON データを保持すると、ディスクサイズは [158 GB](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/results/m6i.8xlarge_bluesky_1000m_zstd.json#L16) となり、ClickHouse より 40% 大きいサイズとなります。
**Elasticsearch** は[できる限り公平](/blog/json-bench-clickhouse-vs-mongodb-elasticsearch-duckdb-postgresql#configuring-elasticsearch-for-fair-storage-comparison)に構成を整えました。`_source` を無効にした状態で、[設定](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/elasticsearch/config/index_template_no_source_best_compression.json#L12) された `zstd` 圧縮を用いると [220 GB](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/elasticsearch/results/m6i.8xlarge_bluesky_no_source_1000m_best_compression.json#L16) が必要で、ClickHouse より 2 倍以上多い容量が必要です。
すでに[説明済み](/blog/json-bench-clickhouse-vs-mongodb-elasticsearch-duckdb-postgresql#json-storage-and-data-compression)のとおり、設定した圧縮アルゴリズムは `_source` のような “stored fields” のデータにしか適用されません。`_source` を無効にすると、そのメリットがほとんど失われるということは、同じ構成で `lz4` 圧縮を使った[サイズ](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/elasticsearch/results/m6i.8xlarge_bluesky_no_source_1000m_default_compression.json#L16)を比較すれば明らかです。
もし `_source` が[必要](/blog/json-bench-clickhouse-vs-mongodb-elasticsearch-duckdb-postgresql#the-role-of-_source)(たとえばエンタープライズ版の「synthetic _source」が使えない OSS 版など)であれば、同じ構成で `_source` を有効にするとディスクサイズは [360 GB](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/elasticsearch/results/m6i.8xlarge_bluesky_source_1000m_best_compression.json#L16) になり、ClickHouse の 3 倍以上となります。さらにデフォルトの `lz4` 圧縮を使うと [455 GB](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/elasticsearch/results/m6i.8xlarge_bluesky_source_1000m_default_compression.json#L16) に膨れ上がります。
**DuckDB** には[専用の圧縮アルゴリズムを選択する機能はなく](/blog/json-bench-clickhouse-vs-mongodb-elasticsearch-duckdb-postgresql#data-compression-1)、内部で軽量な圧縮アルゴリズムを自動的に適用しています。取り込んだ JSON ドキュメントのディスク使用量は [472 GB](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/duckdb/results/m6i.8xlarge_bluesky_1000m.json#L16) で、ClickHouse のほぼ 5 倍になります。
**PostgreSQL** は[“巨大な”タプルにだけ](/blog/json-bench-clickhouse-vs-mongodb-elasticsearch-duckdb-postgresql#data-compression-2)圧縮を適用し、しかもタプル単位でのみ行います。今回のようにほとんどのタプルが閾値を下回るケースでは、ほぼ圧縮が効きません。最適な `lz4` を使ってもディスク容量は [622 GB](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/postgresql/results/m6i.8xlarge_bluesky_1000m_lz4.json#L16) となり、デフォルトの `pglz` でもほとんど同じ [サイズ](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/postgresql/results/m6i.8xlarge_bluesky_1000m_pglz.json#L16) です。ClickHouse より 6 倍以上大きなサイズになります。
続いて、この取り込んだ JSON データに対して各システムでベンチマーククエリを実行した際のランタイムを見ていきます。
### クエリ①の集計パフォーマンス
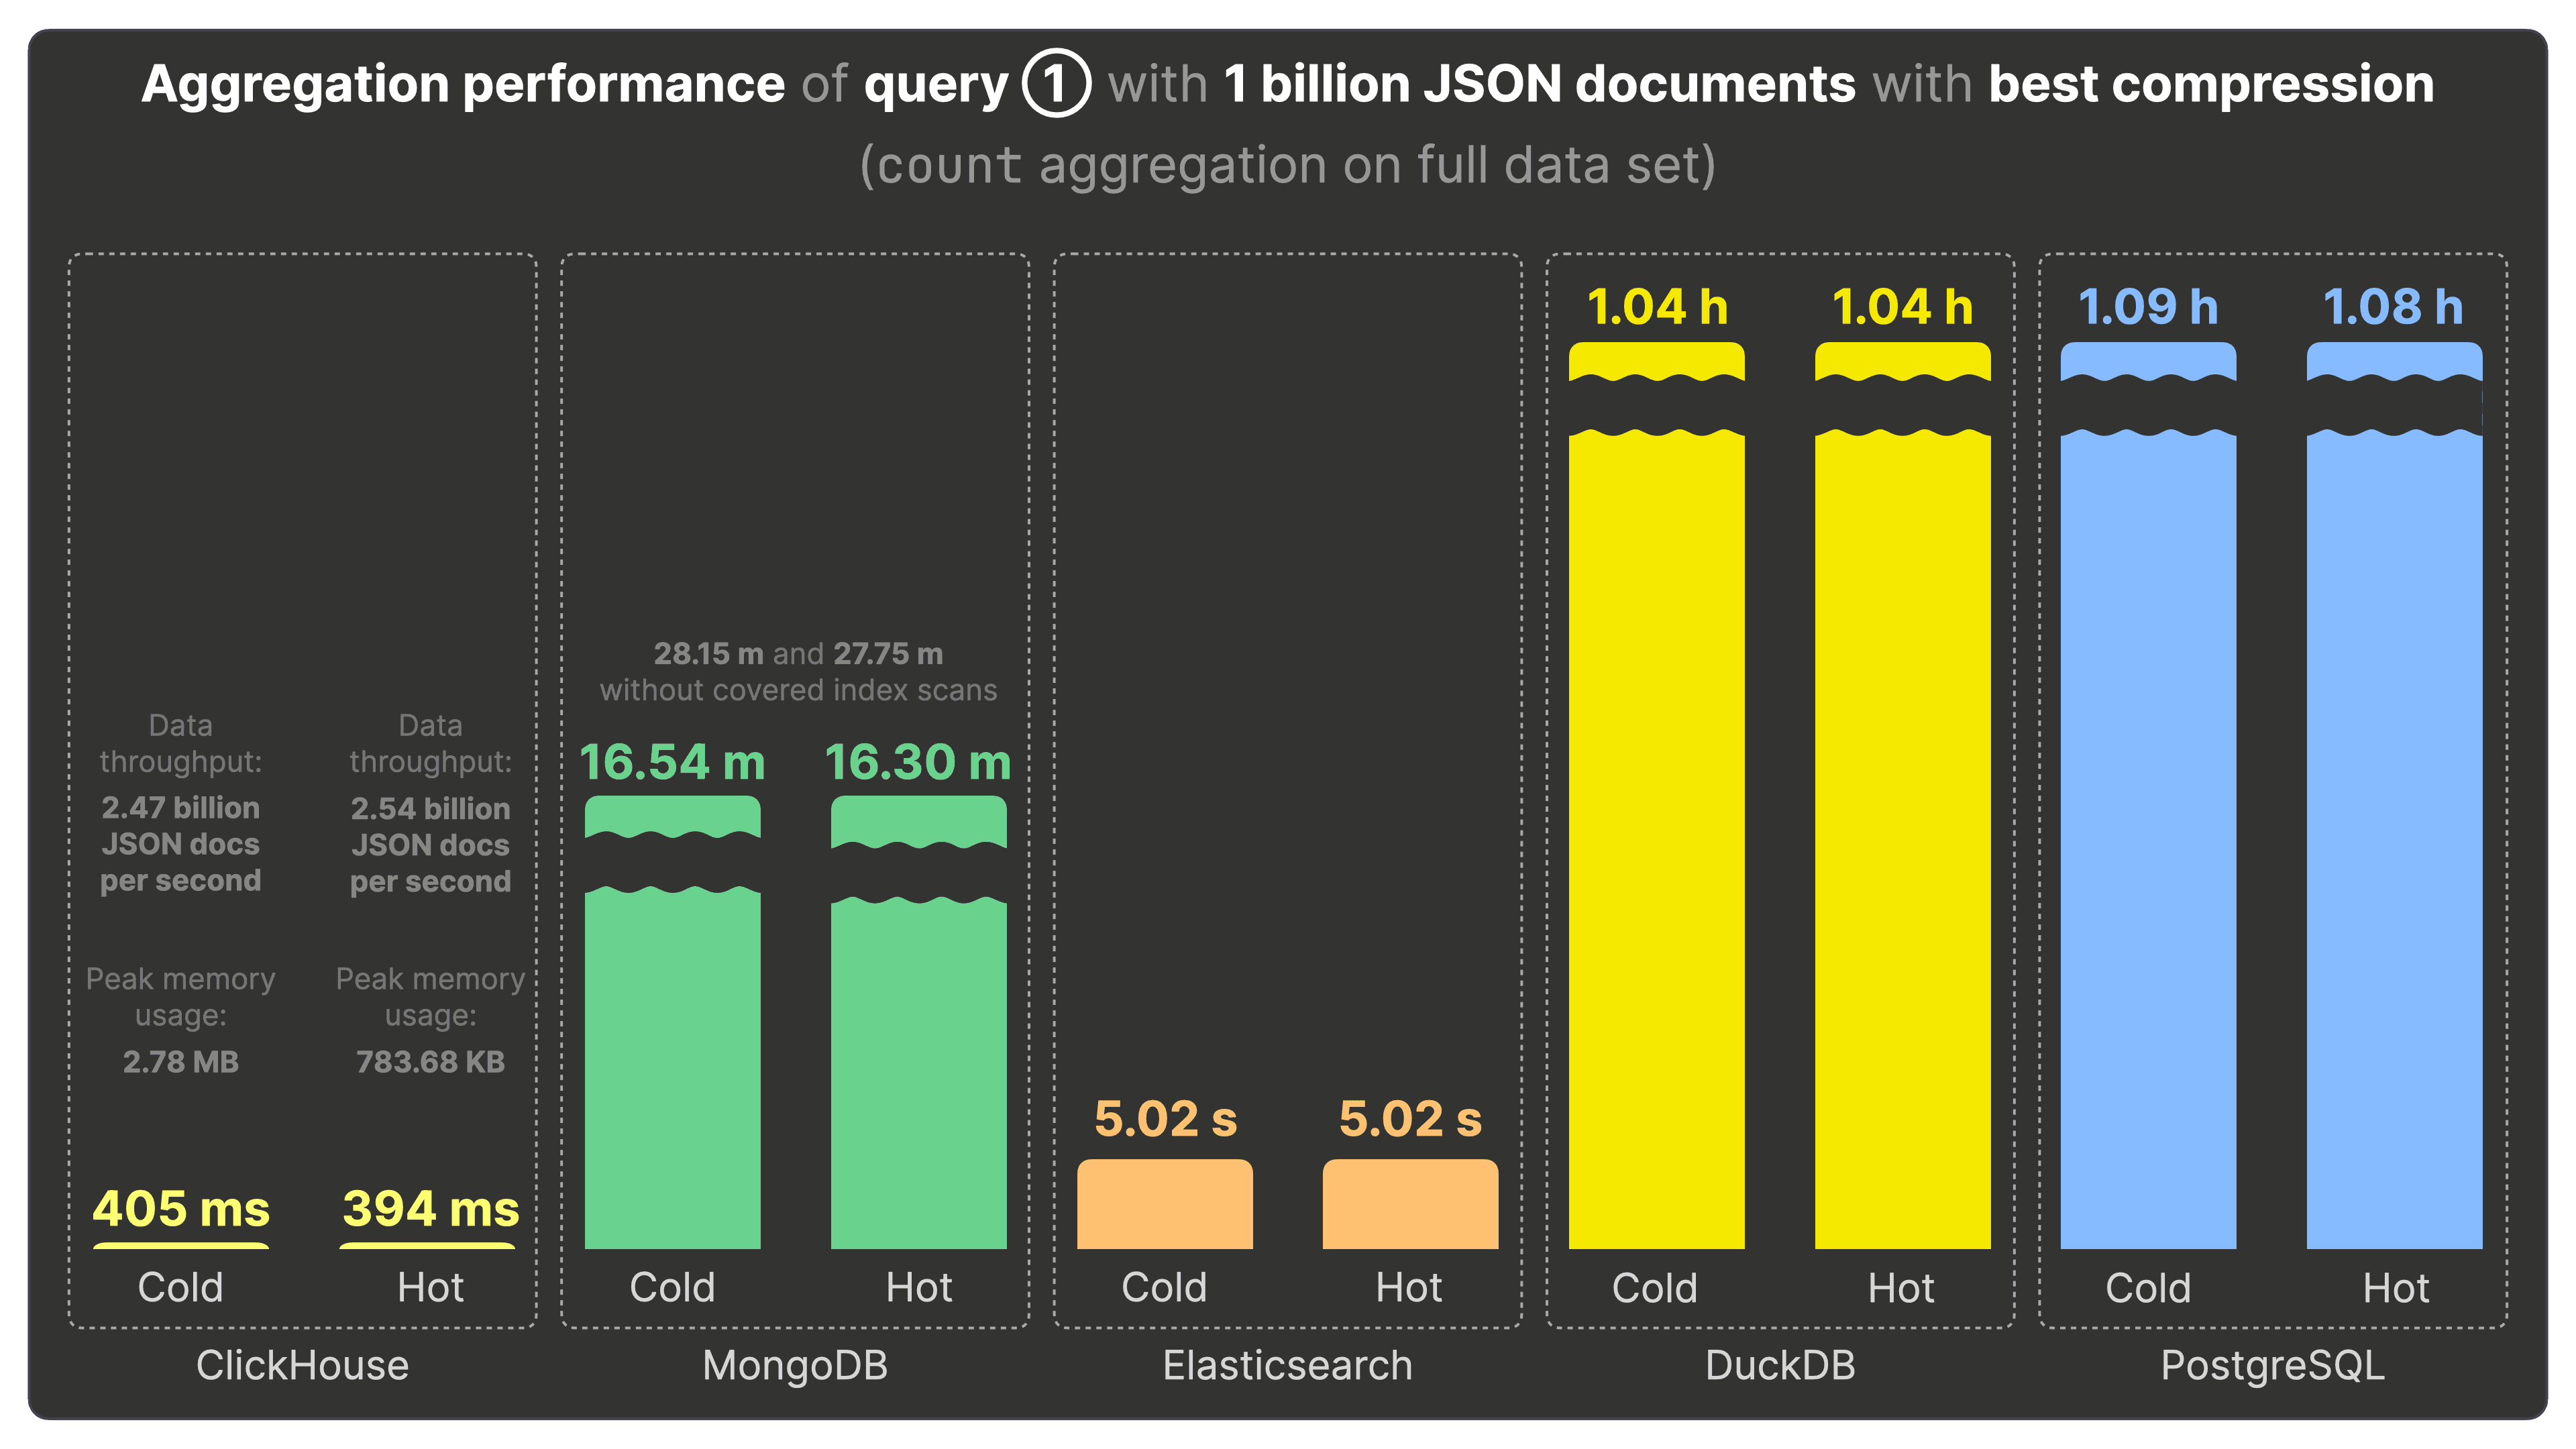
下の図は、10億件の JSON ドキュメントを最適な圧縮オプションで各システムに格納した状態で、ベンチマークの[クエリ①](/blog/json-bench-clickhouse-vs-mongodb-elasticsearch-duckdb-postgresql#query--top-bluesky-event-types)をコールド実行およびホット実行したときの[ランタイム](/blog/json-bench-clickhouse-vs-mongodb-elasticsearch-duckdb-postgresql#cold-and-hot-query-runtimes)を示しています。クエリ①はデータセット全体に対して `count` 集計を行い、Bluesky イベントタイプの人気度を求めるものです。
左から右に 5 つのセクションを順に見ていきましょう。
- **ClickHouse** はコールド実行で [405ミリ秒](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/results/m6i.8xlarge_bluesky_1000m_zstd.json#L29)、ホット実行で [394ミリ秒](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/results/m6i.8xlarge_bluesky_1000m_zstd.json#L29) でクエリ①を完了します。これは秒間 24.7 億~25.4 億レコードを処理している計算になります。ClickHouse ではクエリ実行ごとのメモリ使用量も[測定](/blog/json-bench-clickhouse-vs-mongodb-elasticsearch-duckdb-postgresql#measurements)しており、コールド・ホットともに [3 MB 未満](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/results/m6i.8xlarge_bluesky_1000m_zstd.json#L43) で済んでいる点も注目です。
- **MongoDB** では、すべてのベンチマーククエリに対し[カバードインデックススキャン](/blog/json-bench-clickhouse-vs-mongodb-elasticsearch-duckdb-postgresql#covered-index-scans)を有効にしています。その結果、クエリ①のコールド・ホット実行ともに [約16分](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/results/m6i.8xlarge_bluesky_1000m_zstd.json#L29) かかり、ClickHouse より 2500 倍遅いという結果でした。カバードインデックススキャンにより、クエリに必要なデータがすべてインデックス上のメモリに存在しているため、ディスクアクセスの必要がなく、コールドとホットで大きな差はありません。
参考までに、カバードインデックススキャンなしの場合はコールド・ホットともに [約28分](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/results_without_covered_index_scans/m6i.8xlarge_bluesky_1000m_zstd.json#L29) かかり、ClickHouse より 4200 倍遅くなります。
- **Elasticsearch** は ES|QL 版のクエリ①をコールド・ホットともに [約5秒](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/elasticsearch/results/m6i.8xlarge_bluesky_no_source_1000m_best_compression.json#L18) で実行し、ClickHouse より 12 倍遅いという結果です。
- **DuckDB** はクエリ①のコールド・ホット実行ともに [約1時間](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/duckdb/results/m6i.8xlarge_bluesky_1000m.json#L25) かかり、ClickHouse より 9000 倍遅くなりました。
- **PostgreSQL** も同様にコールド・ホットともに [約1時間](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/postgresql/results/m6i.8xlarge_bluesky_1000m_lz4.json#L29) を要し、ClickHouse より 9000 倍遅いという結果です。
> **DuckDB** と **PostgreSQL** は 10億件規模の JSON を扱う際に非常に時間がかかり、すべてのベンチマーククエリで極めて遅い実行時間を示しました(同一ハードウェア、デフォルト構成での比較です)。詳しいボトルネック分析はまだ行えていませんが、専門的な知見やプルリクエストをお待ちしています。
### クエリ②の集計パフォーマンス
[クエリ②](/blog/json-bench-clickhouse-vs-mongodb-elasticsearch-duckdb-postgresql#query--top-bluesky-event-types-with-unique-users-per-event-type) は、クエリ①にフィルタ条件と `count_distinct` 集計を加え、人気のある Bluesky イベントごとにユニークユーザー数を算出するものです。
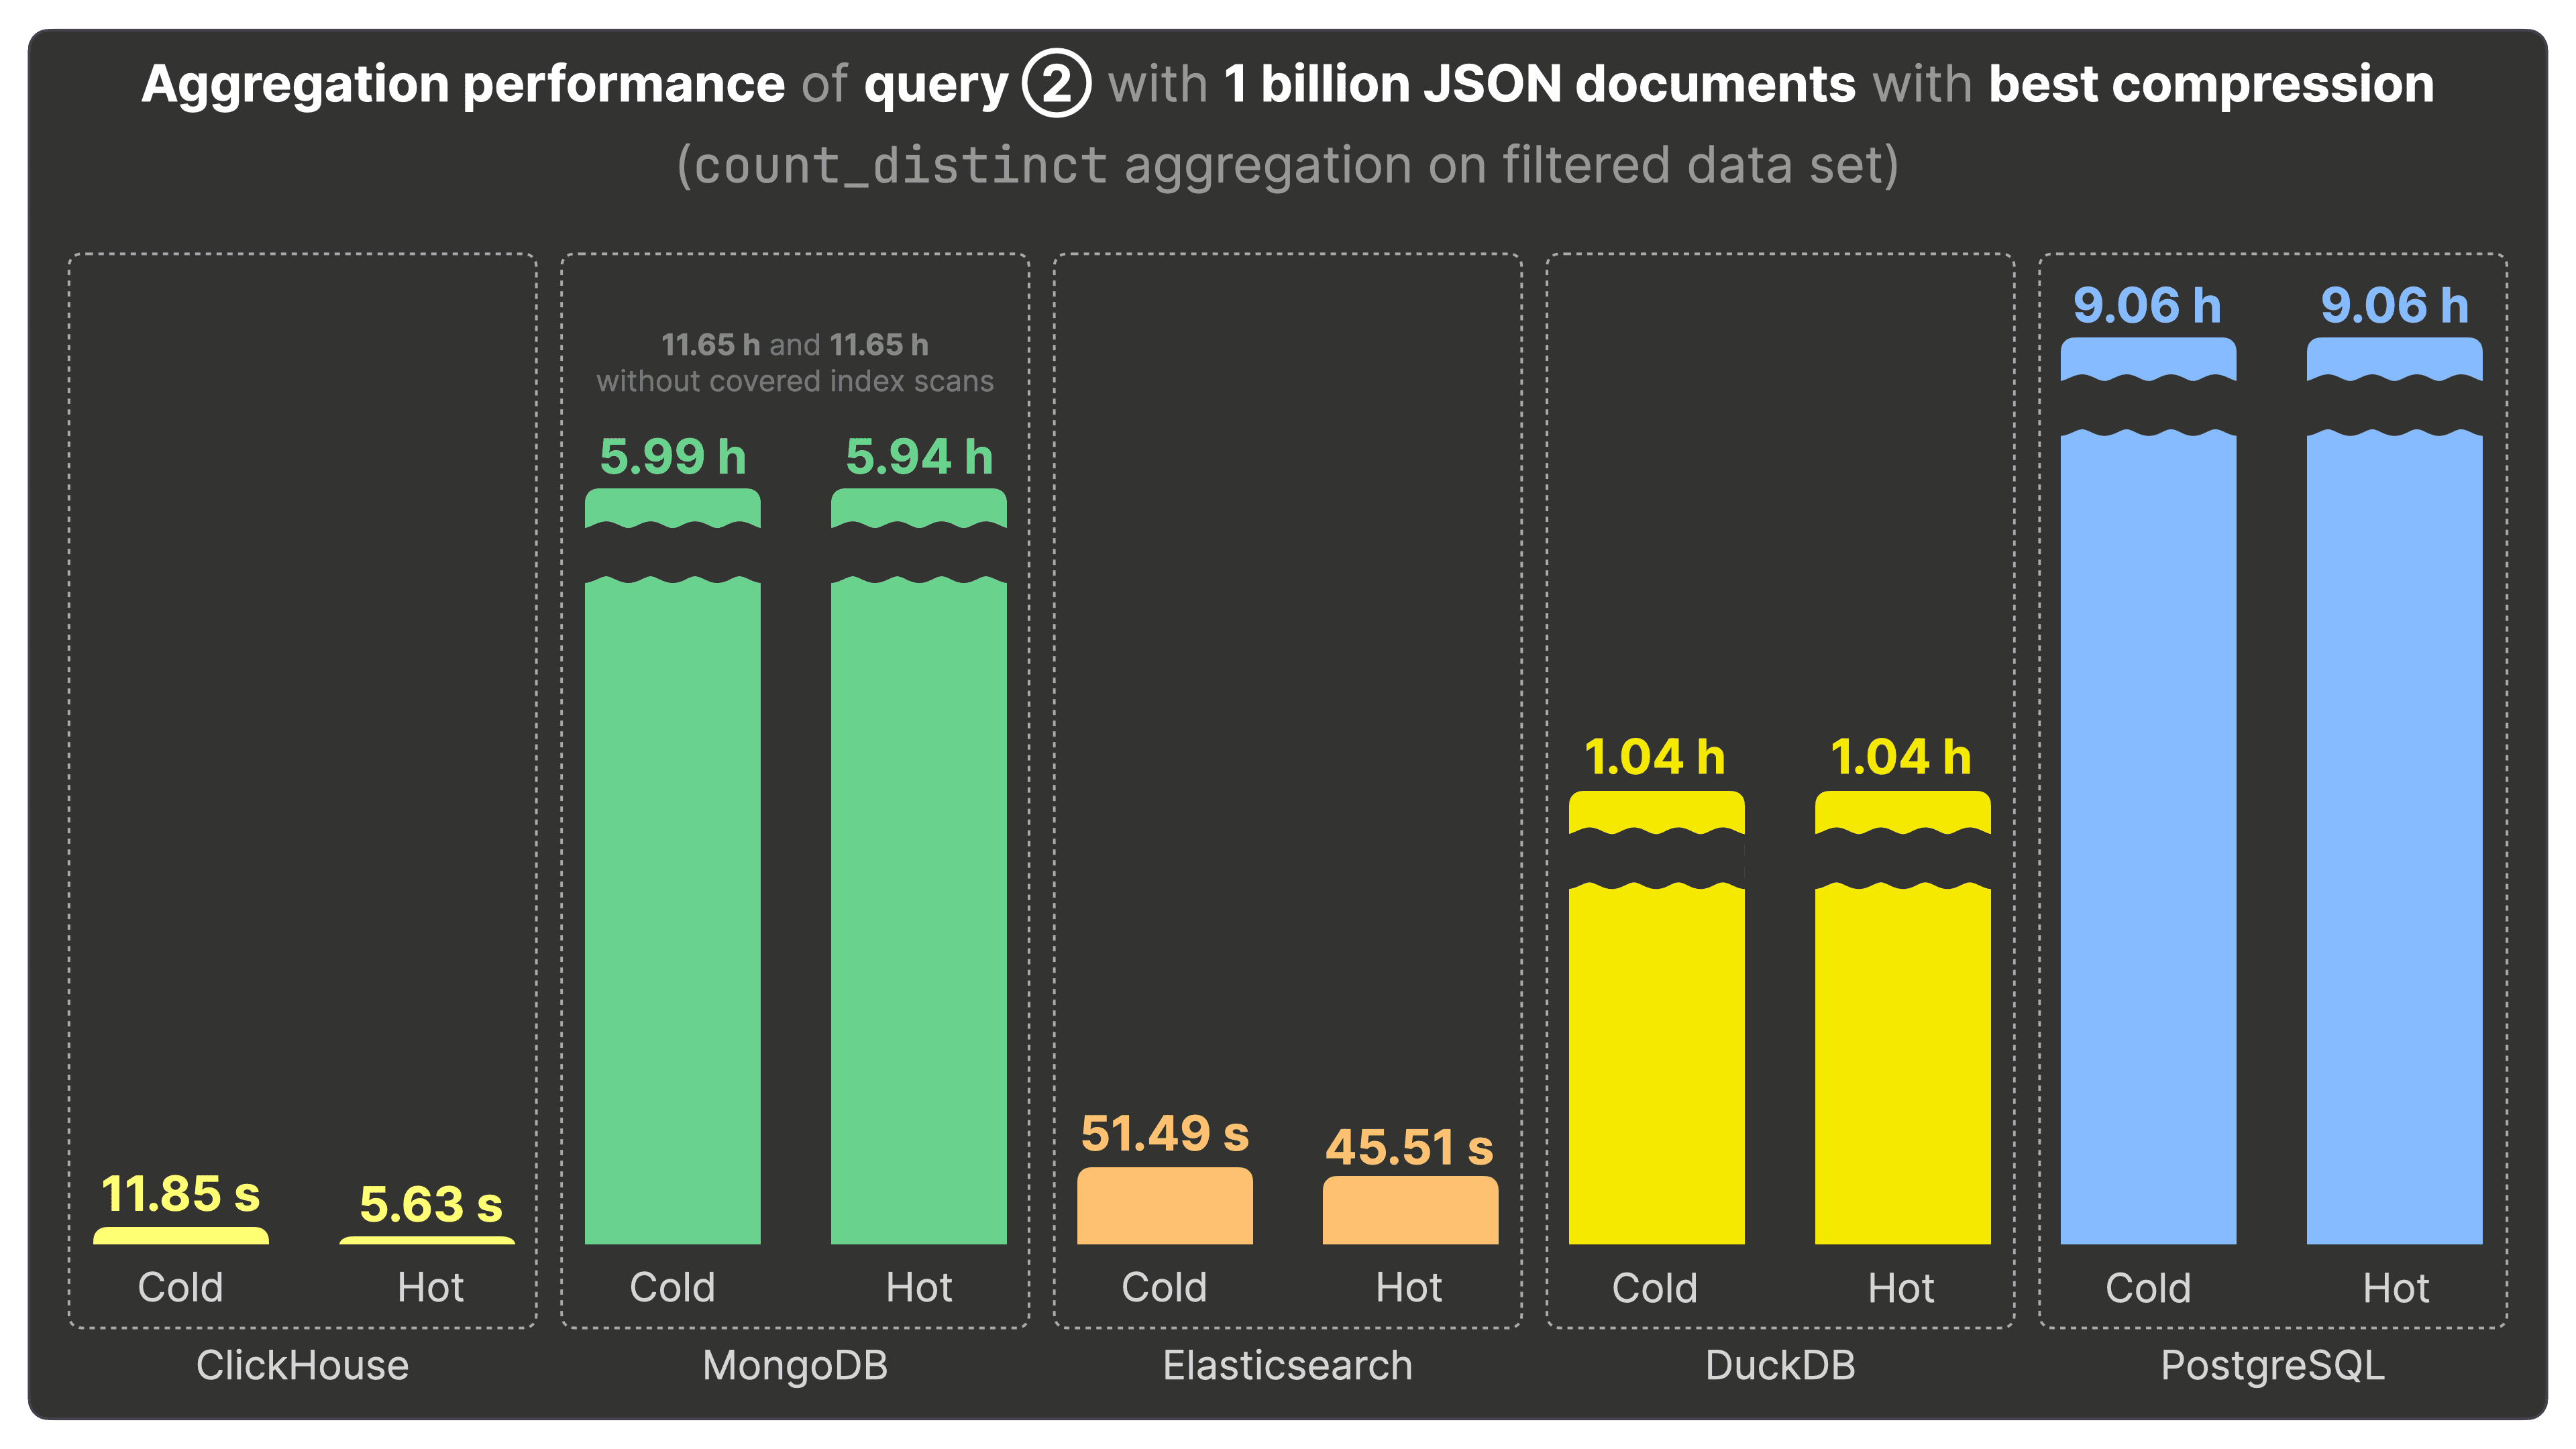
- **ClickHouse** はクエリ②をコールドで [11.85秒](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/results/m6i.8xlarge_bluesky_1000m_zstd.json#L30)、ホットで [5.63秒](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/results/m6i.8xlarge_bluesky_1000m_zstd.json#L30) で完了します。以下はその比較になります:
- **MongoDB** より 3800 倍高速(MongoDB はコールド・ホットとも [約6時間](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/results/m6i.8xlarge_bluesky_1000m_zstd.json#L30))
- カバードインデックスなしの MongoDB と比べると 7000 倍高速([約11時間](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/results_without_covered_index_scans/m6i.8xlarge_bluesky_1000m_zstd.json#L30))
- **Elasticsearch** より 8 倍高速([コールド51.49秒](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/elasticsearch/results/m6i.8xlarge_bluesky_no_source_1000m_best_compression.json#L19)、[ホット45.51秒](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/elasticsearch/results/m6i.8xlarge_bluesky_no_source_1000m_best_compression.json#L19))
- **DuckDB** より 640 倍高速([約1時間](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/duckdb/results/m6i.8xlarge_bluesky_1000m.json#L26))
- **PostgreSQL** より 5700 倍高速([約9時間](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/postgresql/results/m6i.8xlarge_bluesky_1000m_lz4.json#L30))
### クエリ③の集計パフォーマンス
[クエリ③](/blog/json-bench-clickhouse-vs-mongodb-elasticsearch-duckdb-postgresql#query--when-do-people-use-bluesky) は、イベントのタイムスタンプから時刻(時)の部分を取り出し、それぞれの Bluesky イベントが一日のどの時間帯にもっとも利用されているかを調べるため、`hour-of-the-day` でグルーピングして集計を行います。
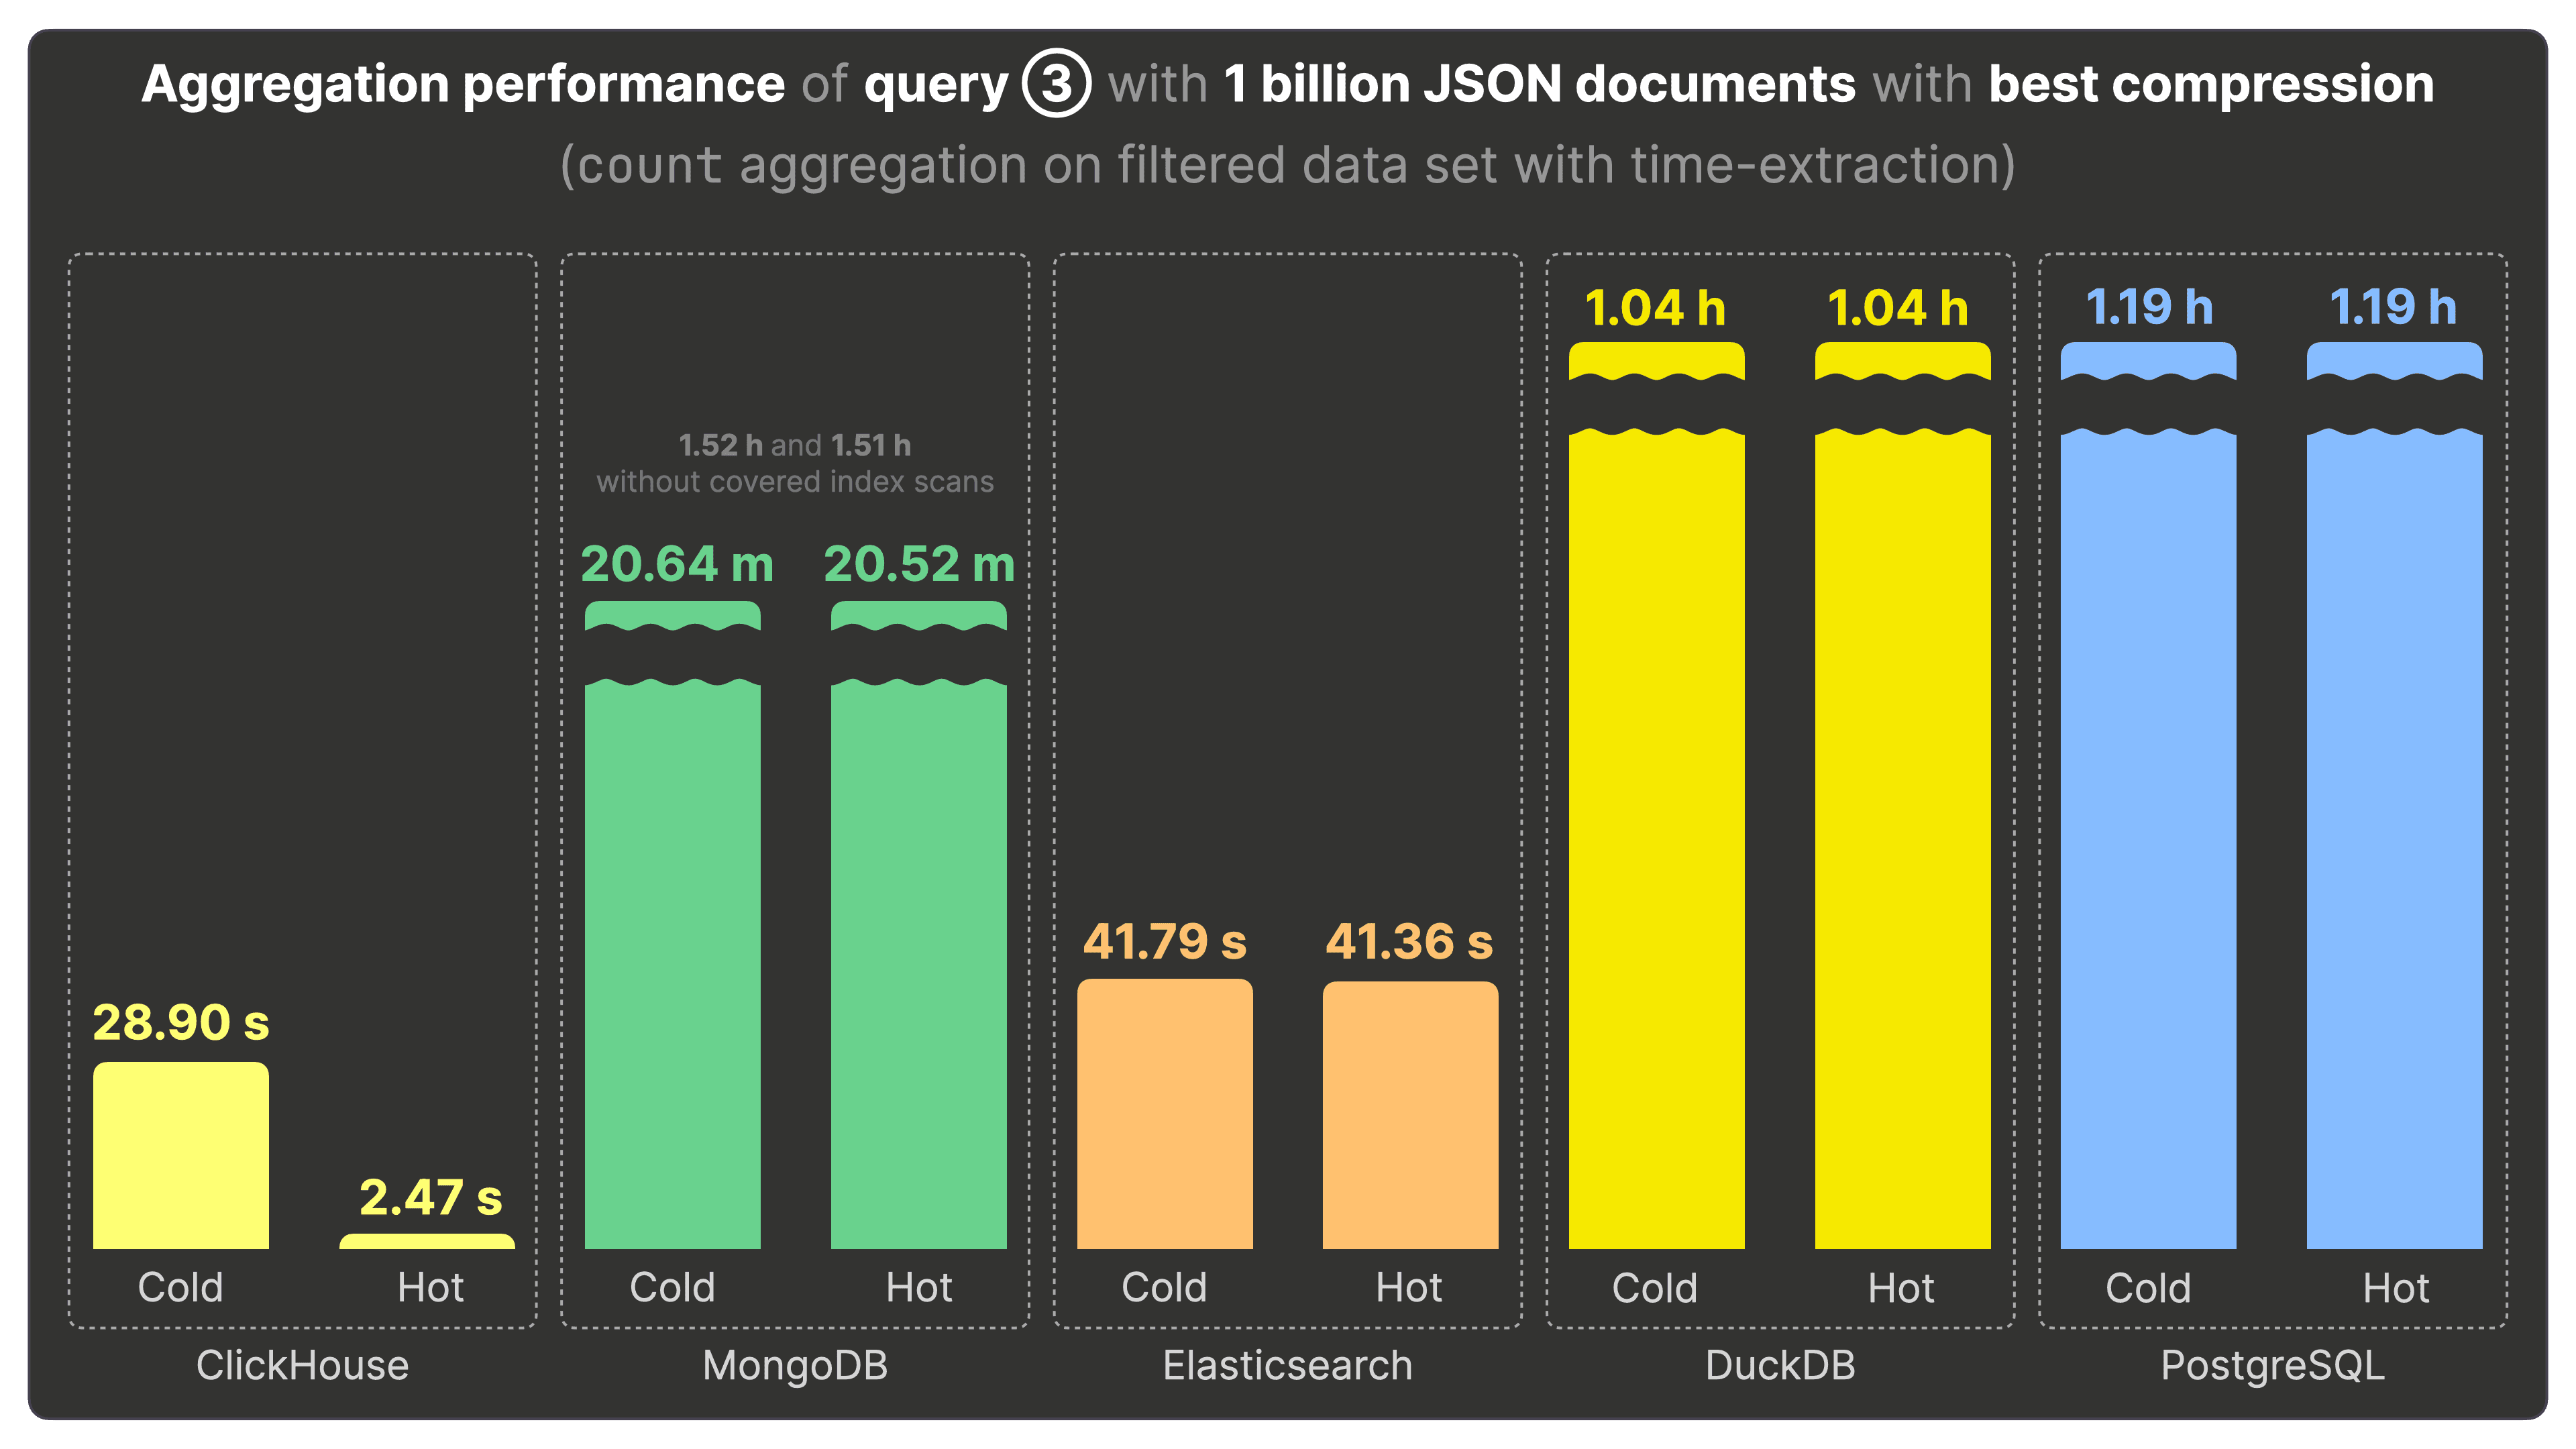
- **ClickHouse** のクエリ③のランタイムは、コールド時が [28.90秒](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/results/m6i.8xlarge_bluesky_1000m_zstd.json#L31)、ホット時が [2.47秒](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/results/m6i.8xlarge_bluesky_1000m_zstd.json#L31) です。以下の比較結果になります:
- **MongoDB** より 480 倍高速([約20分](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/results/m6i.8xlarge_bluesky_1000m_zstd.json#L31))
- カバードインデックスなしの MongoDB より 2100 倍高速([約1.5時間](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/results_without_covered_index_scans/m6i.8xlarge_bluesky_1000m_zstd.json#L31))
- **Elasticsearch** より 16 倍高速([約41秒](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/elasticsearch/results/m6i.8xlarge_bluesky_no_source_1000m_best_compression.json#L20))
- **DuckDB** および **PostgreSQL** より 1400 倍高速(どちらも[約1時間](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/duckdb/results/m6i.8xlarge_bluesky_1000m.json#L27)、[約1時間](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/postgresql/results/m6i.8xlarge_bluesky_1000m_lz4.json#L31))
### クエリ④の集計パフォーマンス
[クエリ④](/blog/json-bench-clickhouse-vs-mongodb-elasticsearch-duckdb-postgresql#query--top-3-post-veterans) は、最も古い投稿を行ったユーザー、つまり「ポストベテラン」上位3名を探すため、データセットに対して `min` 集計を行います。
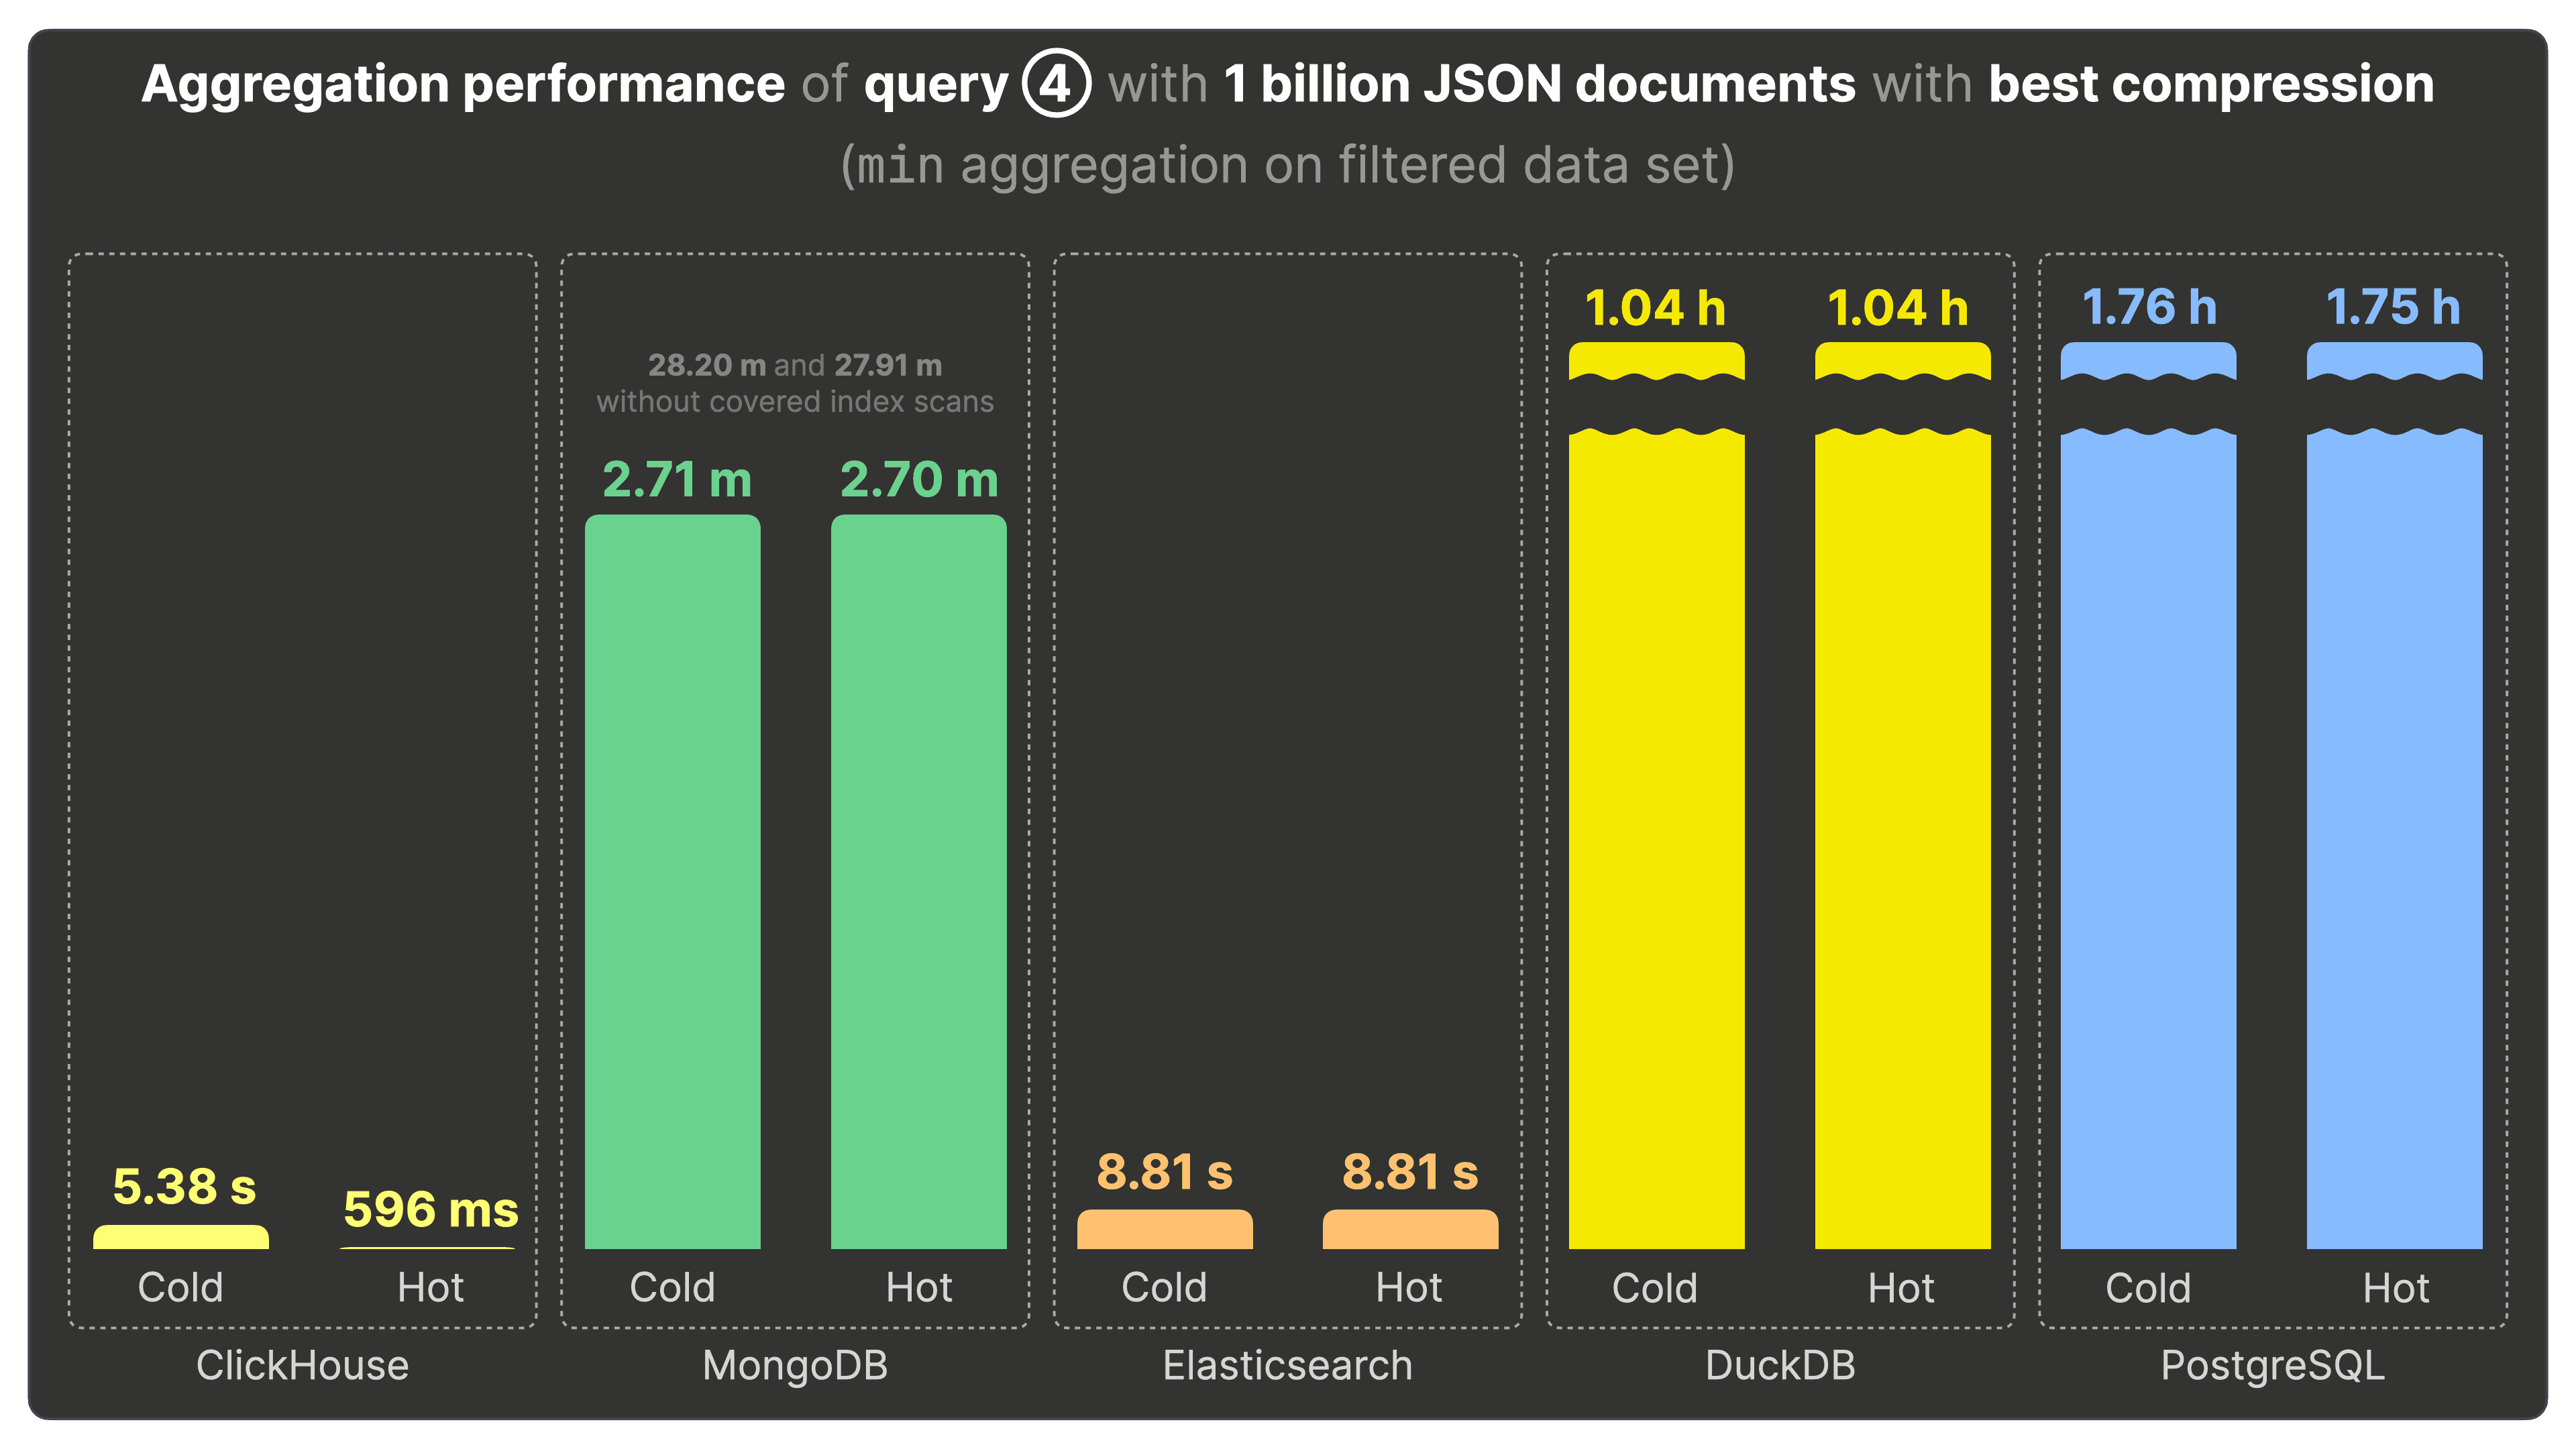
- **ClickHouse** はクエリ④をコールドで [5.38秒](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/results/m6i.8xlarge_bluesky_1000m_zstd.json#L32)、ホットで [596ミリ秒](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/results/m6i.8xlarge_bluesky_1000m_zstd.json#L32) で実行します。以下は比較結果です:
- **MongoDB** より 270 倍高速([約2.7分](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/results/m6i.8xlarge_bluesky_1000m_zstd.json#L32))
- カバードインデックスなしの MongoDB より 2800 倍高速([約28分](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/results_without_covered_index_scans/m6i.8xlarge_bluesky_1000m_zstd.json#L32))
- **Elasticsearch** より 14 倍高速([8.81秒](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/elasticsearch/results/m6i.8xlarge_bluesky_no_source_1000m_best_compression.json#L21))
- **DuckDB** より 6000 倍高速([約1時間](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/duckdb/results/m6i.8xlarge_bluesky_1000m.json#L28))
- **PostgreSQL** より 10000 倍高速([約1.75時間](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/postgresql/results/m6i.8xlarge_bluesky_1000m_lz4.json#L32))
### クエリ⑤の集計パフォーマンス
[クエリ⑤](/blog/json-bench-clickhouse-vs-mongodb-elasticsearch-duckdb-postgresql#query--top-3-users-with-the-longest-activity-span) は、`date_diff` 集計を使って Bluesky 上で最も長い活動期間を持つユーザー上位3名を抽出します。
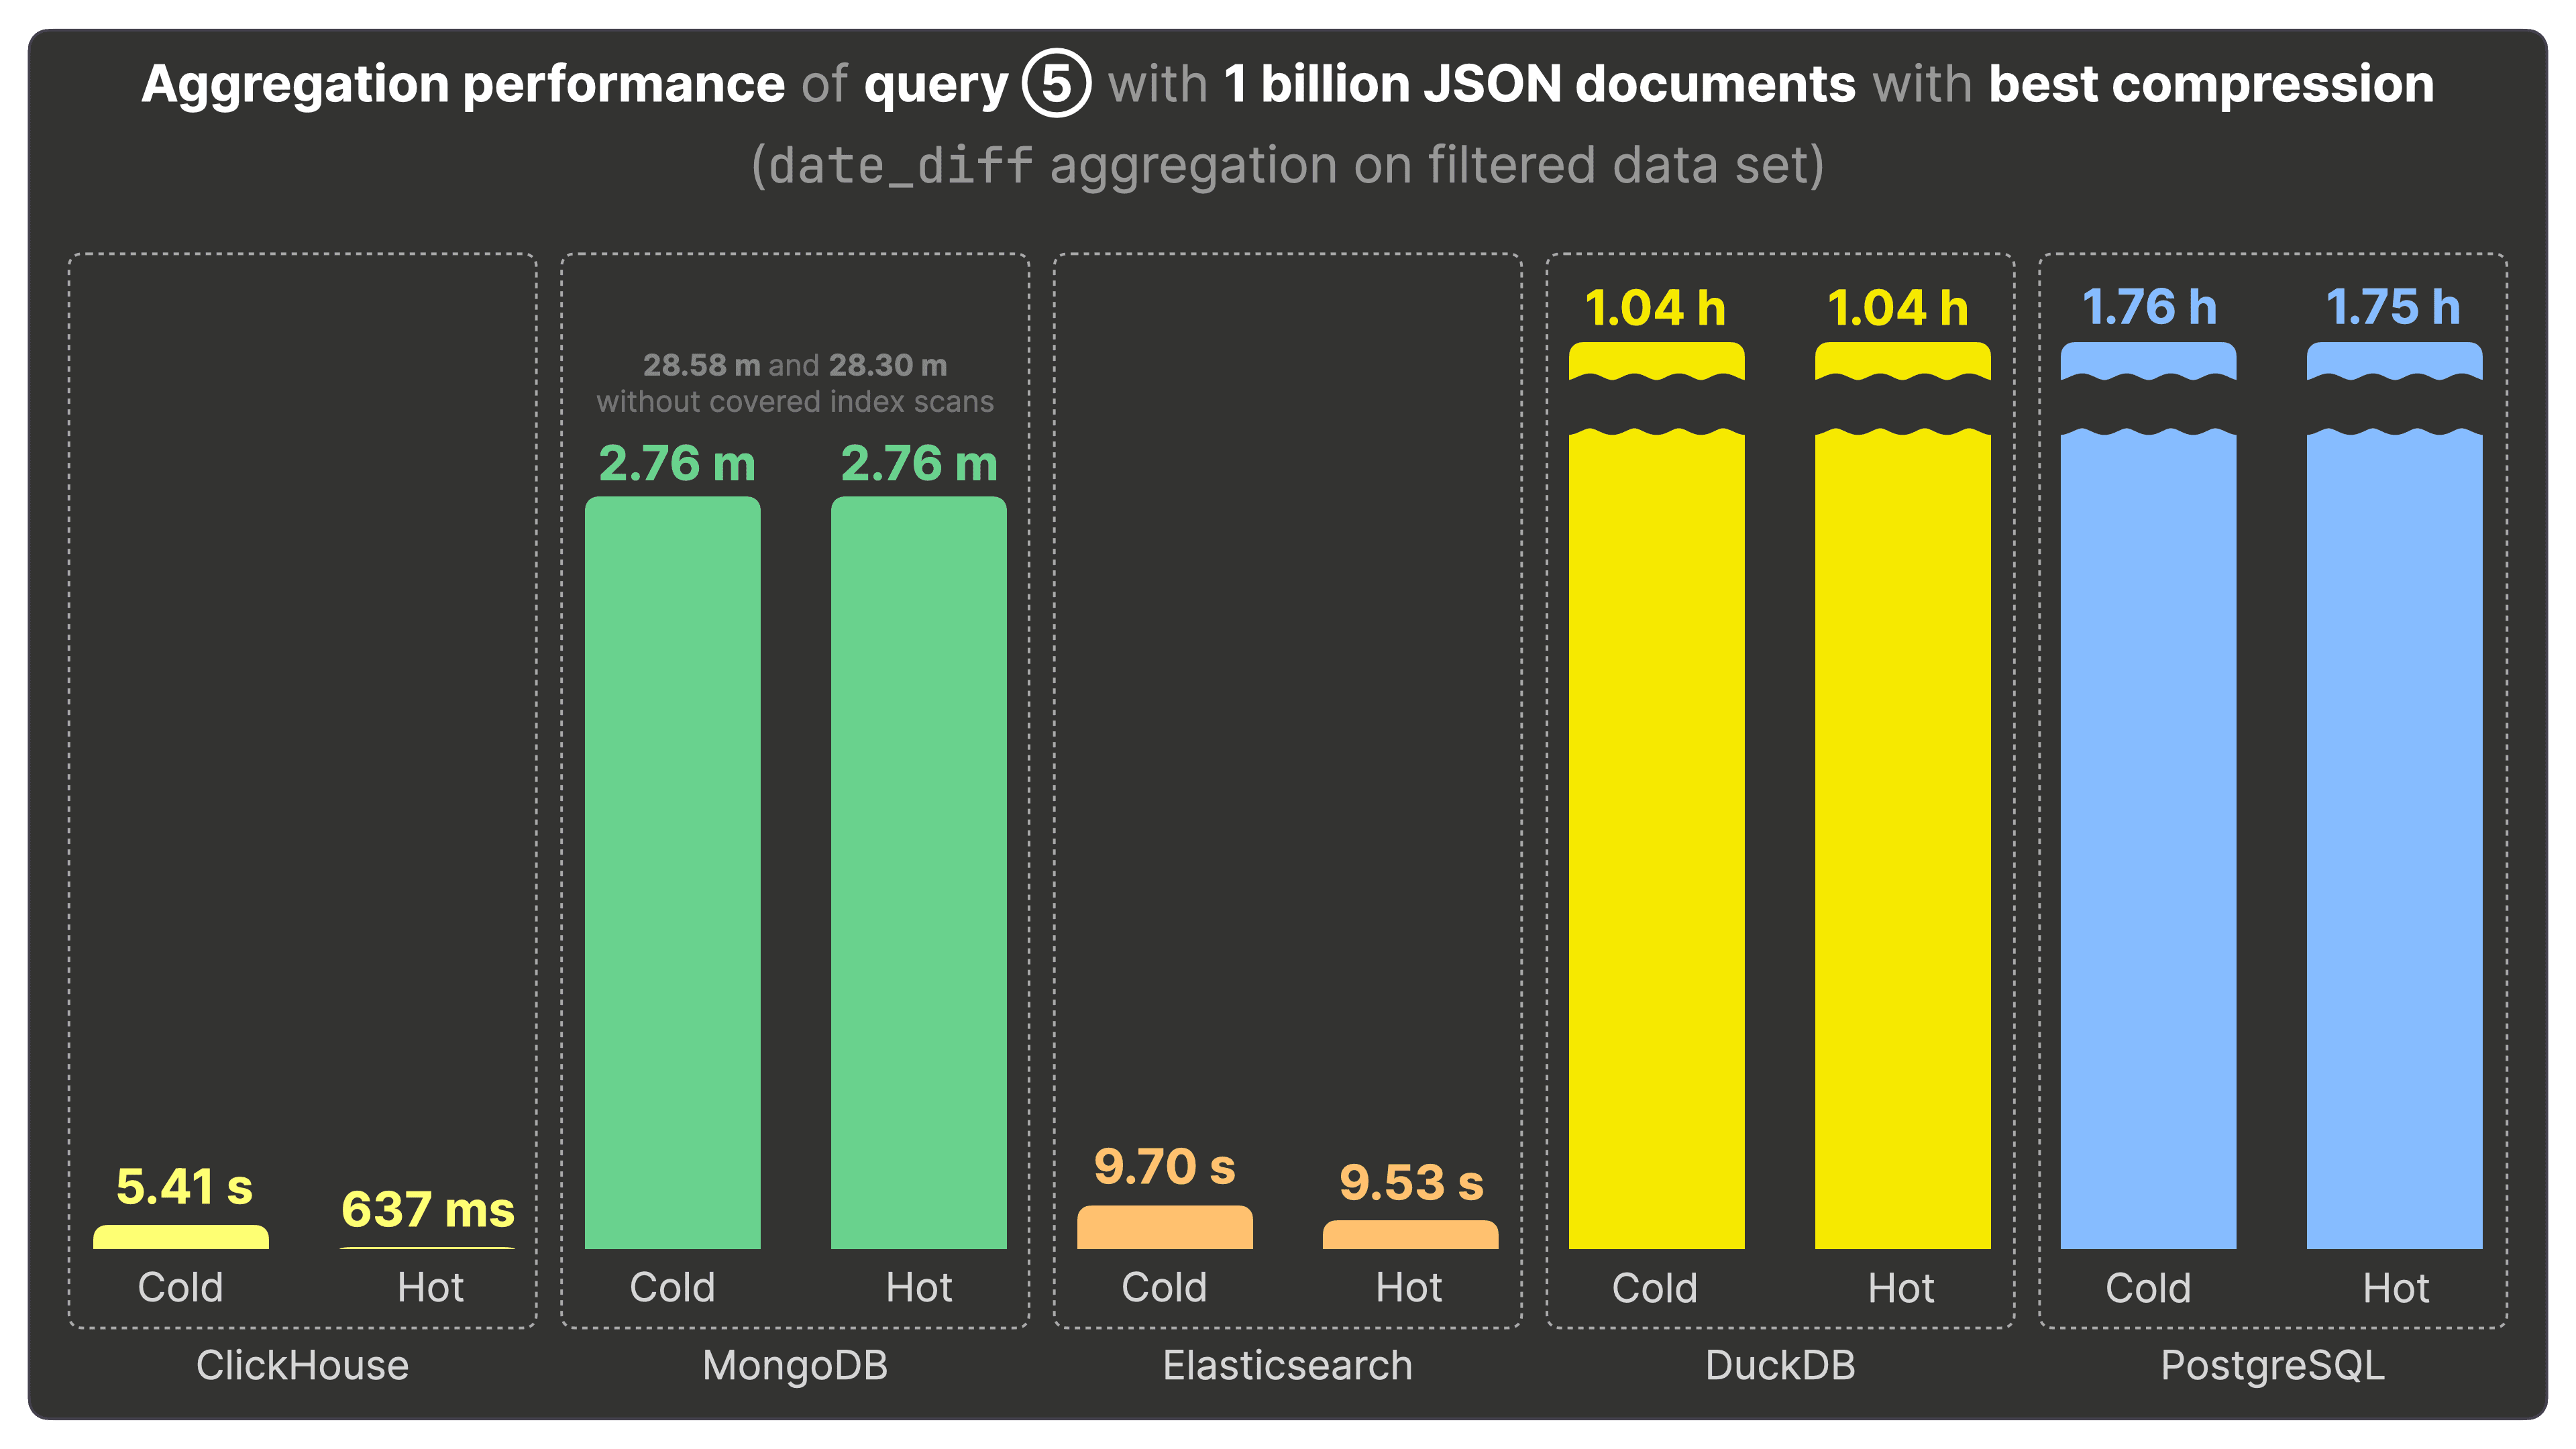
- **ClickHouse** はクエリ⑤をコールドで [5.41秒](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/results/m6i.8xlarge_bluesky_1000m_zstd.json#L33)、ホットで [637ミリ秒](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/clickhouse/results/m6i.8xlarge_bluesky_1000m_zstd.json#L33) で実行します。以下は比較結果です:
- **MongoDB** より 260 倍高速([約2.76分](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/results/m6i.8xlarge_bluesky_1000m_zstd.json#L33))
- カバードインデックスなしの MongoDB より 2600 倍高速([約28分](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/mongodb/results_without_covered_index_scans/m6i.8xlarge_bluesky_1000m_zstd.json#L33))
- **Elasticsearch** より 15 倍高速([約9.5秒](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/elasticsearch/results/m6i.8xlarge_bluesky_no_source_1000m_best_compression.json#L22))
- **DuckDB** より 5600 倍高速([約1時間](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/duckdb/results/m6i.8xlarge_bluesky_1000m.json#L29))
- **PostgreSQL** より 9900 倍高速([約1.75時間](https://github.com/ClickHouse/JSONBench/blob/c7afa7078aed72c55ff4441a2da635424fde7724/postgresql/results/m6i.8xlarge_bluesky_1000m_lz4.json#L33))
## まとめ
このベンチマーク結果から、ClickHouse はストレージ効率・クエリパフォーマンスの両面で、JSON をサポートする他のデータストアを大きく上回ることがわかりました。
分析系クエリにおいては、MongoDB などの主要な JSON データストアに比べて数千倍もの高速性を示し、DuckDB や PostgreSQL に対しても数千倍、Elasticsearch と比較しても桁違いに高速でした。さらに、ディスク上の JSON ドキュメントの圧縮効率も高く、同じ `zstd` で圧縮したファイルよりも小さくなるため、大規模分析用途での TCO(総所有コスト)削減にも寄与します。
ClickHouse の [ネイティブ JSON データ型](https://clickhouse.com/blog/a-new-powerful-json-data-type-for-clickhouse) を使えば、スキーマ設計や調整を事前に厳密に行わなくても、ディスク上で最適に圧縮され、かつ高速な分析クエリを実行できます。これは特にイベントの多くが JSON 形式でやり取りされるユースケースや、[SQL ベースのオブザーバビリティ](https://clickhouse.com/blog/evolution-of-sql-based-observability-with-clickhouse) など、コスト効率と分析クエリ性能が重要となる場面で非常に有効です。ClickHouse は、汎用的な JSON データストアとして比類ない存在だと言えます。
今回の記事では、主要なデータストアが持つ JSON サポートの特徴や性能を実際のベンチマークを通じて比較・考察しました。より詳細に学んでみたい方、またベンチマークに貢献してみたい方は、ぜひ JSONBench(オープンソースの JSON ベンチマーク)にご参加ください。すでにあるベンチマークの改善や新たなシステムの追加など、The Billion Docs JSON Challenge に挑戦してみてください!🥊