---
title: "ClickHouseがLakehouse Runtime Catalogと連携"
date: "2026-09-30T05:03:54.857Z"
author: "Melvyn Peignon"
category: "Product"
excerpt: "ClickHouseとGoogleのLakehouse Runtime Catalogの新たな連携についてお知らせします。"
---
# ClickHouseがLakehouse Runtime Catalogと連携
ClickHouse と Google の [Lakehouse Runtime Catalog](https://docs.cloud.google.com/biglake/docs/blms-rest-catalog) との新しい統合を発表できることを嬉しく思います。これにより、[Apache Iceberg REST Catalog](https://iceberg.apache.org/) を介して、[Google Cloud Lakehouse Iceberg テーブル](https://docs.cloud.google.com/biglake/docs/biglake-iceberg-tables-in-bigquery) を ClickHouse から直接クエリできるようになります。
この統合は ClickHouse 26.2 でベータ機能として提供が開始され、その後まもなく ClickHouse Cloud でも利用可能になります。
## **なぜ Iceberg REST Catalog なのか?** {#why_iceberg_rest_catalog}
データチームにとって共通の課題は、データの保存場所を問わず、すべてのデータにアクセスできるようにすることです。検出、ガバナンス、アクセス制御は、データレイク、ウェアハウス、運用ストアを横断して機能する必要があります。
Lakehouse Runtime Catalog は、Google Cloud 内の Apache Iceberg テーブル向けに一元化されたカタログを提供することで、この課題を解決します。これにより、BigQuery、Apache Spark、Trino、そして今回の ClickHouse といった、Iceberg と互換性のあるあらゆるエンジンとの相互運用性が実現します。
REST Catalog に接続することで、ClickHouse は Cloud Storage に保存された Google Cloud Lakehouse Iceberg テーブルを、データの移動や専用コネクター、メタデータの同期を必要とせずに検出してクエリできます。データエンジニアは Spark や BigQuery を使って Google Cloud Lakehouse Iceberg テーブルにデータを書き込み、アナリストは同じデータを ClickHouse で即座にクエリして、高速で複雑な分析を実行できます。さらに、この統合を利用すれば、単一のクエリでデータを ClickHouse のネイティブ形式にロードすることも可能です。
## **統合の仕組み** {#how_does_the_integration_work}
この統合を利用するには、次の 2 つが必要です。
* ClickHouse インスタンス (ClickHouse および [ClickHouse local](https://clickhouse.com/docs/ja/concepts/features/tools-and-utilities/clickhouse-local) に対応)
* Lakehouse Runtime Catalog が有効化された [Google Cloud プロジェクト](https://cloud.google.com/)
Lakehouse Runtime Catalog は Iceberg テーブルの Iceberg メタデータを追跡し、`https://biglake.googleapis.com/iceberg/v1/restcatalog` の Iceberg REST Catalog API 経由で公開します。ClickHouse はこのエンドポイントに接続して、背後にあるテーブルを直接検出してクエリします。
認証には、Google の [アプリケーションのデフォルト認証情報 (ADC)](https://docs.cloud.google.com/docs/authentication/provide-credentials-adc) メカニズムと統合されています。
## **はじめに** {#getting_started}
[Google Cloud](https://clickhouse.com/partners/gcp) 上に ClickHouse をデプロイするか、[ClickHouse local](https://clickhouse.com/docs/ja/concepts/features/tools-and-utilities/clickhouse-local) を使用し、バージョン 26.2 以降が実行されていることを確認してください。インスタンスの準備ができたら、以下の手順に従って Lakehouse Runtime Catalog に接続します。詳細については、[Lakehouse Runtime Catalog に関する ClickHouse ドキュメント](https://clickhouse.com/docs/ja/guides/use-cases/data-warehousing/biglake-catalog) をご覧ください。
## **Google アプリケーションのデフォルト認証情報による認証** {#authentication_with_google_application_default_credentials}
ClickHouse は Google ADC をネイティブにサポートしており、Lakehouse Runtime Catalog に対する認証には 2 つのオプションがあります。
### **オプション 1: ADC 認証情報ファイルを指定する**
ローカル環境にアプリケーションのデフォルト認証情報がすでに設定されている場合 (例: `gcloud auth application-default login` を実行済み)、JSON 認証情報ファイルを ClickHouse に指定するだけで済みます。これは、ローカルでの開発やテストに最も簡単な方法です。
SET allow_database_iceberg = 1;

CREATE DATABASE Lakehouse_catalog
ENGINE = DataLakeCatalog('https://biglake.googleapis.com/iceberg/v1/restcatalog')
SETTINGS
  catalog_type = 'biglake',
  google_adc_credentials_file = '/path/to/application_default_credentials.json',
  warehouse = 'gs://<bucket_name>/<optional-prefix>';
ClickHouse は JSON ファイルから `client_id`、`client_secret`、`refresh_token`、`quota_project_id` を直接読み取るため、これらを個別に指定する必要はありません。
### **オプション 2: 認証情報をインラインで指定する**
本番環境へのデプロイや、認証情報ファイルが利用できない環境では、クエリ設定で OAuth 認証情報を直接指定できます。
SET allow_database_iceberg = 1;

CREATE DATABASE Lakehouse_catalog
ENGINE = DataLakeCatalog('https://biglake.googleapis.com/iceberg/v1/restcatalog')
SETTINGS
  catalog_type = 'biglake',
  google_adc_client_id = '<client-id>',
  google_adc_client_secret = '<client-secret>',
  google_adc_refresh_token = '<refresh-token>',
  google_adc_quota_project_id = '<gcp-project-id>',
  warehouse = 'gs://<bucket_name>/<optional-prefix>';
どちらのアプローチも、背後では同じ OAuth フローを使用して Iceberg REST Catalog エンドポイントを認証し、Cloud Storage 内のデータへのアクセスを認可します。
## **ClickHouse から Google Lakehouse Iceberg テーブルをクエリする** {#querying_google_lakehouse_iceberg_tables_from_clickhouse}
上記のいずれかの認証方法で接続を作成した後は、Google Lakehouse Iceberg テーブルへのクエリを簡単に行えます。
### **利用可能なテーブルの一覧表示**
カタログ内で利用可能なすべてのテーブルを一覧表示します。
SHOW TABLES FROM Lakehouse_catalog;
```shell
┌─name─────────────────────────┐
│ public_data.nyc_taxicab │
│ public_data.nyc_taxicab_2021 │
└──────────────────────────────┘
```
### **テーブルのクエリ**
任意の Google Cloud Lakehouse Iceberg テーブルを直接クエリします。
SELECT count(*)
FROM Lakehouse_catalog.`public_data.nyc_taxicab`
WHERE vendor_id = 1;
完全なスキーマを確認することもできます。
SHOW CREATE TABLE Lakehouse_catalog.`public_data.nyc_taxicab`;
ClickHouse は複数の階層を持つ名前空間をサポートしていないため、テーブル名をバッククォートで囲む必要があります。
### **クエリを高速化するための ClickHouse へのデータロード**
低レイテンシで繰り返しクエリを実行する必要があるユースケースでは、Google Cloud Lakehouse Iceberg テーブルのデータを ClickHouse テーブルにロードできます。
CREATE TABLE local_taxi_data
(
    `vendor_id` Int64,
    `pickup_datetime` DateTime64(6),
    `dropoff_datetime` DateTime64(6),
    `passenger_count` Int64,
    `trip_distance` Float64,
    `total_amount` Float64,
    `pickup_location_id` Int64,
    `dropoff_location_id` Int64
)
ENGINE = MergeTree
ORDER BY (pickup_datetime, vendor_id);

INSERT INTO local_taxi_data
SELECT
    vendor_id, pickup_datetime, dropoff_datetime,
    passenger_count, trip_distance, total_amount,
    pickup_location_id, dropoff_location_id
FROM lakehouse_catalog.`public_data.nyc_taxicab`;
これにより、ClickHouse ネイティブ形式の local_taxi_data を直接クエリして、低いクエリレイテンシを実現できます。
## **今後の展望** {#whats_next}
今回のリリースは、Google Cloud のデータエコシステムとのより深い統合に向けた最初のステップにすぎません。
今後のリリースに向けて、私たちは以下を含むいくつかの機能強化にすでに取り組んでいます。
* **書き込みのサポート:** ClickHouse から Google Cloud Lakehouse Iceberg テーブルへのデータ書き戻し機能の追加。
* **クラウド統合の強化:** ClickHouse Cloud に新しいユーザーインターフェースを導入し、Lakehouse Runtime Catalog への接続を簡単に作成して、UI から直接データをクエリできるように改善。
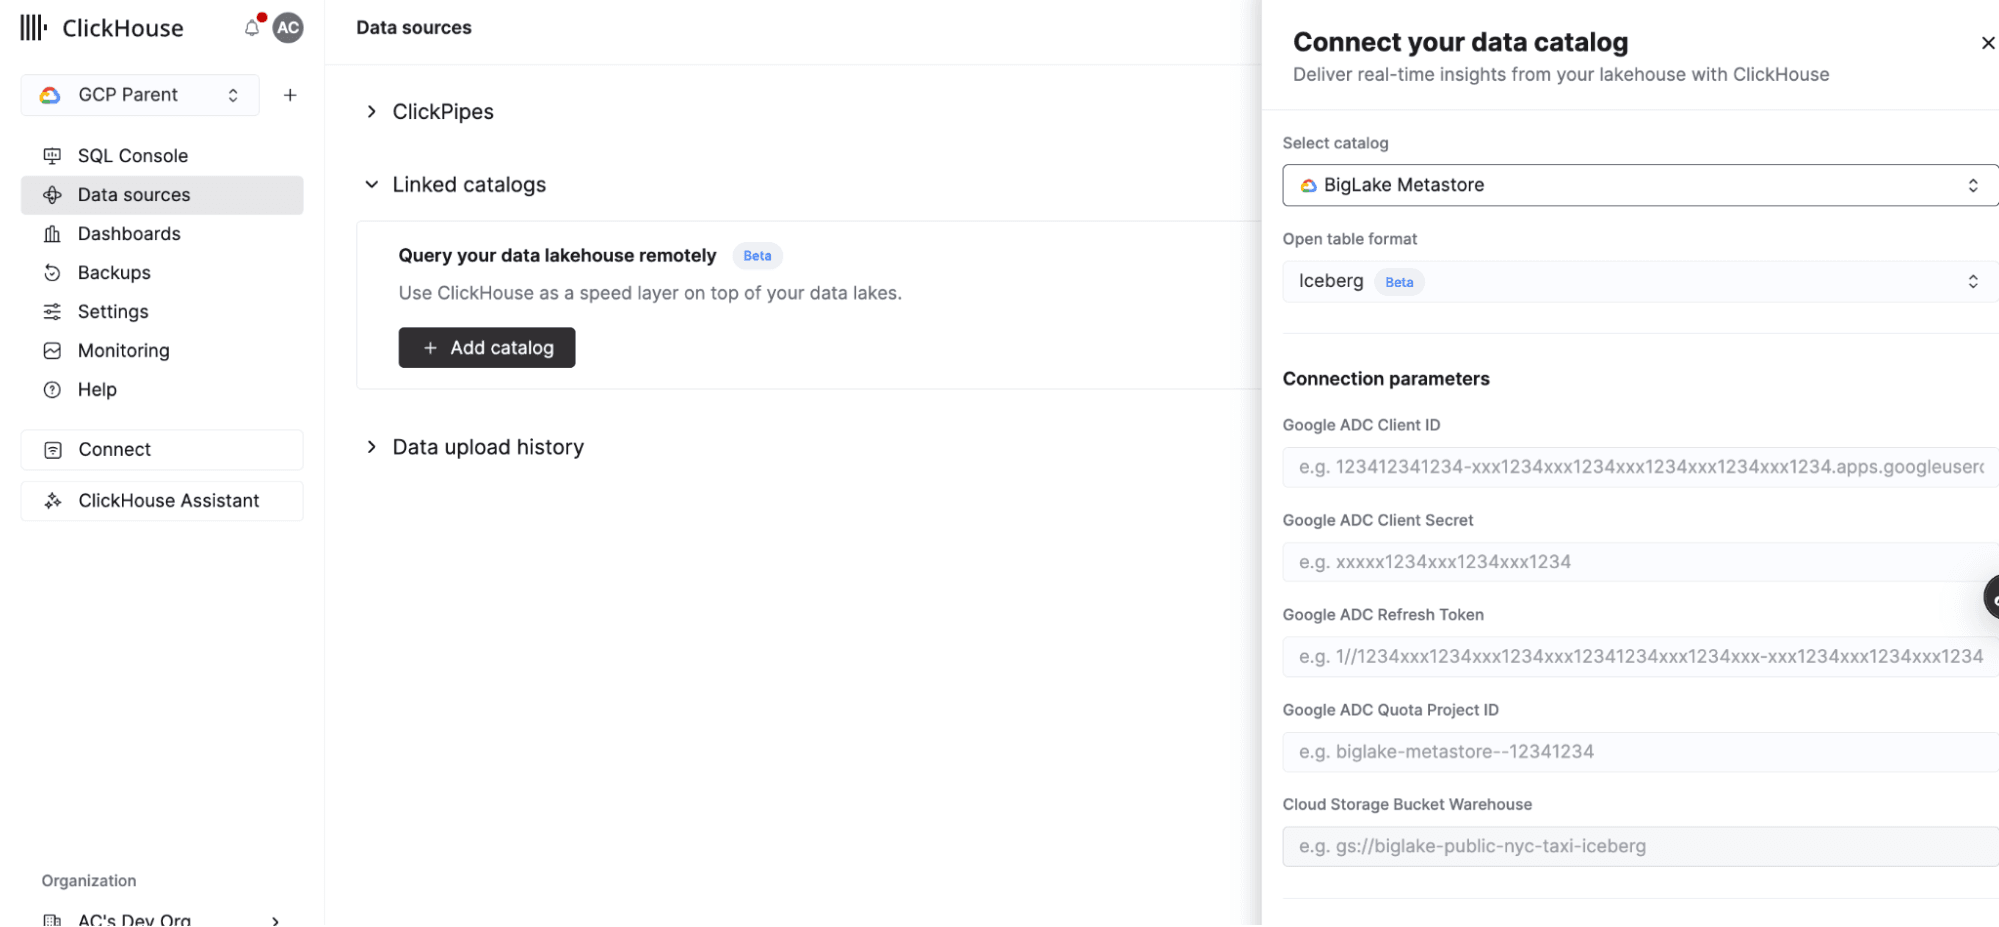
ClickHouse と Lakehouse Runtime Catalog を組み合わせることで、Google Cloud 内のすべての Google Cloud Lakehouse Iceberg テーブルに対して、データを移動することなく、複製することなく、またチームがすでに使っているツールを手放すことなく、高速な分析を実行できます。
## **今すぐ始める** {#get_started_today}
[Google Cloud](https://clickhouse.com/pricing?plan=scale&provider=gcp®ion=gcp-us-central1&hours=8&storageCompressed=false) 上に ClickHouse をデプロイするか、[ClickHouse local](https://clickhouse.com/docs/ja/concepts/features/tools-and-utilities/clickhouse-local) を使用してください。インスタンスの準備ができたら、以下の手順に従って Lakehouse Runtime Catalog に接続します。詳細については、[Lakehouse Runtime Catalog に関する ClickHouse ドキュメント](https://clickhouse.com/docs/ja/guides/use-cases/data-warehousing/biglake-catalog) をご覧ください。
---
## 今すぐ始める
自社のデータでClickHouseがどのように動作するか試してみませんか? ClickHouse Cloudなら数分で利用開始でき、300ドル分の無料クレジットも受け取れます。
[サインアップ](https://console.clickhouse.cloud/signUp?loc=blog-cta-2440&utm_blogctaid=2440)
---