---
title: "継続的な負荷環境におけるリアルタイムのコストパフォーマンスを測定: CostBench 初のエンドツーエンド結果"
date: "2026-09-18T07:00:58.587Z"
author: "Tom Schreiber and Lionel Palacin"
category: "Engineering"
excerpt: "CostBench はクラウドデータウェアハウスに継続的な負荷をかけるベンチマークです。最新データの取り込みから高速な応答までの全工程において、ClickHouse Cloud は 412〜1,996 倍優れたコストパフォーマンスを実現しました。"
---

# 継続的な負荷環境におけるリアルタイムのコストパフォーマンスを測定: CostBench 初のエンドツーエンド結果

<style>
details.note-box {
  margin: 28px 0;
  background: #2B2B2B;
  color: #E2E8F0;
  border-left: 5px solid rgba(255,255,255,.1);
  border-radius: 12px;
}

details.note-box > summary {
  position: relative;
  padding: 18px 48px 18px 24px;
  cursor: pointer;
  list-style: none;
  font-size: 14px;
  font-weight: 600;
  line-height: 1.5;
  text-transform: uppercase;
  border-radius: 10px;
}

details.note-box > summary::-webkit-details-marker {
  display: none;
}

details.note-box > summary:hover {
  background: rgba(255,255,255,.05);
}

details.note-box > summary::after {
  content: "▶";
  position: absolute;
  right: 20px;
  color: #A0AEC0;
  font-size: 12px;
  transition: transform .2s;
}

details.note-box[open] > summary::after {
  transform: rotate(90deg);
}

details.note-box > .note-body {
  padding: 8px 24px 28px;
}

/* Comfortable line spacing */
details.note-box > .note-body > p,
details.note-box > .note-body li {
  font-size: 15px;
  line-height: 1.7;
}

/* Space between paragraphs */
details.note-box > .note-body > p {
  margin: 0 0 14px;
  padding: 0;
}

/* Larger breaks before main sections */
details.note-box > .note-body > p.note-heading {
  margin: 28px 0 8px;
  font-size: 14px;
  line-height: 1.5;
  letter-spacing: .025em;
  color: #E2E8F0;
}

/* Smaller breaks before subsections */
details.note-box > .note-body > p.note-subheading {
  margin: 22px 0 8px;
  line-height: 1.5;
  color: #E2E8F0;
}

details.note-box > .note-body > .note-heading:first-child {
  margin-top: 0;
}

/* Consistent list spacing */
details.note-box > .note-body > ul {
  margin: 0 0 16px;
  padding: 0 0 0 22px;
}

details.note-box > .note-body li {
  margin: 0;
  padding: 0;
}

details.note-box > .note-body li + li {
  margin-top: 8px;
}

details.note-box > .note-body > :last-child {
  margin-bottom: 0;
}
</style>

## TL;DR

**リアルタイムのコストパフォーマンスは、受信データをクエリ可能な状態に維持するコストと、その事前準備によってクエリエンジンの処理負荷をどれだけ軽減できるかの双方に左右されます。**

* CostBench は、この両方の影響を持続的な負荷環境における 1 つの継続的ワークロードとして測定します。集計クエリやドリルダウンクエリを実行し続けながら、最新の行を取り込んでクエリ可能な状態にします。
* ClickHouse Cloud、Snowflake、BigQuery、Redshift Serverless を対象に、各ベンダーが推奨するリアルタイム取り込みパスを使用し、毎秒 100 万行を目標レートとして 1,000 億行以上の株式市場クオートデータをストリーミングしてテストしました。
* ClickHouse Cloud は、最新データ処理パスのコスト、クエリ提供コスト、累積実行時間のすべてで最も低い数値を記録しました。比較対象となった他社製品は、**エンドツーエンドのコストパフォーマンスにおいて 412〜1,996 分の 1 という結果になりました。**
* 本記事は、これらの結果の背景にあるアーキテクチャと課金体系を追究する 1 対 1 の分析シリーズの第 1 弾です。

## 最新データから高速なクエリへの道筋が1ドルあたりの性能を左右する


[リアルタイム分析システム](https://clickhouse.com/ja/blog/selecting-a-real-time-analytical-database-jp)は、絶えず変化するデータセットに対してクエリを実行します。ユーザー、アプリケーション、エージェントが、すでに数十億行や[数兆行](https://clickhouse.com/ja/blog/how-tesla-built-quadrillion-scale-observability-platform-on-clickhouse-jp)に及ぶ可能性のあるデータにクエリを実行している最中にも、新しい行が届き続けます。クエリが実行され続ける中で、届いたすべての新しい行をクエリ可能な状態にしなければなりません。

[CostBench](https://clickhouse.com/ja/blog/costbench-data-warehouse-cost-performance-jp) は、各種クラウドデータウェアハウスにおけるリアルタイム分析のエンドツーエンドの性能とコストを測定します。その最初の結果から、各システムの違いを生み出している要因はクエリエンジンだけではないことが明らかになりました。

> 到着したデータをクエリ可能な状態にするまでのコストと効率は、システムによって劇的に異なります。  

**持続的な負荷がかかる状況では、その処理自体に直接的なコストがかかり、またその処理によって生じるデータ状態がクエリエンジンに残される作業量を決定するため、クエリの実行自体と同等以上に1ドルあたりの性能を左右することがあります。**

今回の最初のエンドツーエンドのラウンドでは、プッシュ型の取り込みを使用して、ClickHouse Cloud、Snowflake、BigQuery、Redshift Serverless をテストしました。  

CostBench では、データの取り込み、クエリ可能な状態を維持するための継続的な処理、集計クエリやドリルダウンクエリの処理をすべて同時に実行して測定しました。本記事ではまず、クエリ可能とはどういう意味かを説明し、ベンチマークの仕組みを示した上で、全体的な結果を紹介します。それに続く各プロバイダーとの比較記事では、それぞれのアーキテクチャや課金モデルに沿ってこれらの結果を詳しく解説します。


## データをクエリ可能にする要素

株価に関する一般的な分析の問いを考えてみましょう。**AAPL の株価更新は日ごとに何件届いたか?**

このクエリは AAPL でフィルタリングし、株価を日ごとにグループ化して、各グループの行数をカウントします。

<pre>
<code type='click-ui' language='sql' show_line_numbers='false'>
SELECT
    Day,
    COUNT(*) AS quotes
FROM quotes
WHERE Symbol = 'AAPL'
GROUP BY Day;
</code>
</pre>

これはまさに、分析システムが高速に実行できるように作られている種類のクエリです。

> **クエリ可能なデータ**とは、クエリ時にクエリエンジンが読み取るデータ量を減らし、処理量を抑えられるように整理・準備されたデータのことです。

この**「日ごとの AAPL」クエリ**では、エンジンが読み取るデータ量を減らし、処理量を抑えるために、3つのステップが役立ちます。

### データをカラムごとに保存する

このクエリでは、AAPL の株価を見つけるために `Symbol` が、それらをグループ化するために `Day` が必要です。他のカラムは必要ありません。

[列指向ストレージ](https://en.wikipedia.org/wiki/Data_orientation)を使用すると、エンジンはこれら2つのカラムのみを読み取り、残りをスキップできます。以下の例では、**7つのカラムではなく2つのカラム**を読み取るだけで済みます。


![01_columnar_storage_skips_unrelated_columns.png](https://clickhouse.com/uploads/01_columnar_storage_skips_unrelated_columns_37569868e8.png)

また、列指向レイアウトは、エンジンが読み取ったデータを処理する際にも役立ちます。カラムの値がメモリ上にまとまっているため、エンジンは単純なループで値のバッチに対して処理を適用できます。この[ベクトル化実行](https://www.cidrdb.org/cidr2005/papers/P19.pdf)により、行を個別に処理するオーバーヘッドが削減されます。適切な処理であれば、1つの命令で複数の値を処理する [SIMD 命令](https://en.wikipedia.org/wiki/Single_instruction,_multiple_data)を使用することもできます。


### チャンクプルーニングのためにデータを整理する

前述のバッチは、**連続するカラム値のチャンク**です。エンジンは保存されたデータのチャンクを読み取る前に、そのメタデータをチェックし、クエリのフィルターに一致する値が含まれ得ないことがメタデータからわかる場合に、そのチャンクをスキップします。これが**チャンクプルーニング**です。

今回のクエリはすでに `Symbol` と `Day` のカラムしか読み取っていません。しかしソートされていない例では、3チャンクすべてに AAPL の株価が含まれているため、エンジンは3つすべてを読み取る必要があります。

`Symbol` で[ソート](https://en.wikipedia.org/wiki/Database_index#Clustered)すると、銘柄ごとの株価がまとまります。`WHERE Symbol = 'AAPL'` に対して、エンジンは **AAPL の1つのチャンク**のみを読み取り、MSFT と NVDA のチャンクをスキップできるようになります。これにより、日ごとにグループ化してカウントする対象は **AAPL の株価3件**だけになります。


![02_ordered_data_enables_chunk_pruning.png](https://clickhouse.com/uploads/02_ordered_data_enables_chunk_pruning_60b03a2e68.png)

### 事前集計によってクエリ時の処理を削減する

データが数十億行や数兆行になると、元データをスキャンして集計する処理は、インタラクティブな分析には遅すぎる場合があります。ダッシュボードなどでこれらのクエリが繰り返し実行されると、コンピュートコストもかさみます。

[事前集計](https://en.wikipedia.org/wiki/Aggregate_\(data_warehouse\))は、その処理を個々のクエリからデータ準備の段階へと移します。はるかに小さなサマリー行のセットを維持することで、クエリ時に読み取るデータ量と、グループ化および集計の処理量の両方を削減します。サマリーにはクエリが必要とするグループ化ディメンションと集計結果が保持されるため、エンジンは個々の行から計算する代わりに、事前に準備された結果を結合して利用できます。

今回の例では、プルーニングによって日ごとにグループ化してカウントすべきデータが **AAPL の株価3件**に絞り込まれました。事前集計では、これらのカウントを前もって準備します。株価を `Symbol` と `Day` ごとにグループ化し、各グループの `COUNT(*)` を計算しておきます。これにより、**9件の株価が4つのサマリー行**へと変換され、各行には特定の銘柄の特定の日におけるカウントが含まれます。

クエリでサマリー行に対してさらにフィルターを適用する場合もあるため、事前集計されたデータもプルーニングしやすい物理レイアウトの恩恵を受けます。この例のサマリー行は `Symbol` 順に並んでいます。`WHERE Symbol = 'AAPL'` に対して、エンジンは **AAPL の2つのサマリー行**のみを読み取り、MSFT と NVDA の行をスキップします。これらの2行には日ごとのカウント(**D1 に2件、D2 に1件**)がすでに入っているため、実行のたびに個々の AAPL の株価をグループ化してカウントする必要はもうありません。

市場動向のモニタリングのような時間に敏感なユースケースでは、これらのサマリーを基礎となる株価データに合わせて最新の状態に保つ必要があり、理想的には新しい株価がクエリ可能になると同時に更新されるべきです。


![03_pre_aggregation_reduces_query_time_work.png](https://clickhouse.com/uploads/03_pre_aggregation_reduces_query_time_work_6e34a64c31.png)


今回の AAPL クエリでは、**列指向ストレージ**によって不要なフィールドをスキップし、**`Symbol` によるソート**によって関係のない銘柄をスキップし、**最新の事前集計**によって個々の株価のグループ化とカウントをスキップできました。これらの準備が組み合わさることで、データは**このような分析クエリに対してクエリ可能な状態**になり、クエリエンジンが読み取るデータ量と実行する計算量を削減できます。

---

## リアルタイムのコストパフォーマンスが最大 1,996 倍向上

これは、CostBench の継続的な負荷環境下で ClickHouse Cloud が達成した結果です。自社のデータでどのような成果が得られるか、ぜひご確認ください。今すぐサインアップしましょう。

[ClickHouse Cloud を試す](https://console.clickhouse.cloud/signUp?loc=blog-cta-2212-1-996-clickhouse-cloud&utm_blogctaid=2212)

---

## リアルタイムシステムは、到着した最新データを即座にクエリ可能な状態にしなければならない


データセットが固定されている場合、そうした準備はクエリの開始前に行えます。しかしリアルタイムシステムでは、クエリが実行され続ける中で、新しい行が絶え間なく到着します。

> 「リアルタイムシステムは、**最も新しいデータ**に基づいてリアルタイムな意思決定を行えるよう、リアルタイムデータへアクセスできる必要があります。」 — [Instacart Engineering](https://tech.instacart.com/real-time-fraud-detection-with-yoda-and-clickhouse-bd08e9dbe3f4)

私たちは、新しく到着した各行をクエリ可能な状態にまで導く一連の継続的な処理を、**最新データパス (fresh-data path)** と呼んでいます。これには、並行して稼働し続けなければならない 3 つの役割が含まれます:

<video autoplay="1" muted="1" loop="1" controls="0">
  <source src="https://clickhouse.com/uploads/04_real_time_system_always_in_motion_loop_ba40840b7a.mp4" type="video/mp4" />
</video>

① 新鮮なデータが到着した時点で**列指向ストレージへ取り込む**。

② ソート、クラスタリング、パーティショニング、または同等の構造を通じて、イベントレベルのデータおよび事前集計データに対して**プルーニングしやすい物理レイアウトを維持する**。

③ 新しいデータが到着するたびに**最新の事前集計を維持し**、頻出のグループ化や集計の処理をクエリ実行時から除外しておく。

これらは論理的な責務であり、厳密な実行順序ではありません。システムによっては、これらを単一の書き込みパスに統合することもあります。たとえば、受信した行をソートし、事前集計を計算し、その結果をソートした上で、どちらの表現もストレージに書き込むといった具合です。他のシステムでは、この処理の一部を取り込み後に非同期で完了します。

インデックス、メタデータ、コンパクション、その他のプロバイダー固有の構造も、この処理のコストと効率に影響を与えます。

**最新データパスと並行して、クエリエンジンは 2 つの典型的な分析パスを処理します。どちらも上記の準備に依存しています:**

* **事前集計パス:** インタラクティブな集計クエリは、繰り返しのグループ化や集計処理をクエリ実行時から除外するために ③ に依存します。要約された行をフィルタリングする場合は、不要なチャンクをプルーニングするために ② にも依存します。

* **イベントレベルパス:** 選択的なドリルダウンクエリは、イベントレベルのデータを直接読み取るため、データの大部分のスキャンを回避するために ② に依存します。これらのクエリに数秒かかる場合でも、プルーニングこそが大規模環境での実行を可能にする要素です。残りの行に対してグループ化や集計を行うこともあります。

## 効率的な最新データパスは、自身のコストを抑えるだけでなく、クエリに残される作業も削減する

> 取り込みを維持できているシステムでも、クエリ準備の即応性が追いつかなくなることがあります。

受信データに追いついているからといって、効率的なクエリ実行に必要なあらゆる処理にシステムが追いついているとは限りません。

そのギャップは**回答の鮮度**に影響を与える可能性があります。新しい株価が迅速に取り込まれていても、リスク評価クエリが古い市場ビューに基づいた結果を返してしまうことがあります。

また、クエリが最新データを参照できる場合であっても、**クエリ効率**に影響を与えることがあります。ソートや事前集計が遅れると、クエリエンジンはより多くのデータをスキャンしたり、新しい行の突合を行ったり、クエリ実行時にグループ化や集計をやり直したりする必要が生じる可能性があります。

以下のインタラクティブな図は、データが継続して流れている最中のこの 2 つ目の影響を示しています。ループを観察するかスライダーをドラッグして、ソートと事前集計が追いつくにつれてクエリエンジンのスキャンや集計の作業がどのように減少し、準備が遅れるとどのように増大するかを確認してください。

<iframe src="/uploads/05_fresh_data_path_query_work_balance_26275697d3.html" frameborder="0" style="width: 100%; height: 500px; max-height: 800px;"></iframe>

その余分なクエリ処理は読み取り側のコンピュートを消費し、レイテンシとクエリ提供コストを増大させます。したがって、最新データへの効率的なデータパスは、**データを準備するコスト**と**データを処理するクエリの実行時間およびコスト**という 2 つの側面で成果をもたらします。

## CostBench は両方の影響をまとめて測定

CostBench では、集計クエリやドリルダウンクエリを決められたスケジュールで実行しながら、継続的に増加する同一のデータセットを取り込みから行の可視性、イベントレベルのレイアウト維持、事前集計の鮮度に至るまで追跡します。クエリの定義は固定されたままですが、その結果には新しく届くデータが継続的に反映されなければなりません。これにより、データをクエリ可能な状態に維持するための直接コストと、システムが実際に到達した状態からクエリを処理する性能およびコストという、両方の側面が可視化されます。

> 初回の結果では、事前集計の遅延が蓄積したりクエリレイテンシが上昇したりする中で取り込みを維持したシステムがあることが示されました。その結果、読み取りパスにより多くの負荷がかかり、クエリ提供コストが押し上げられました。

### CostBench が比較の公平性を保つ方法

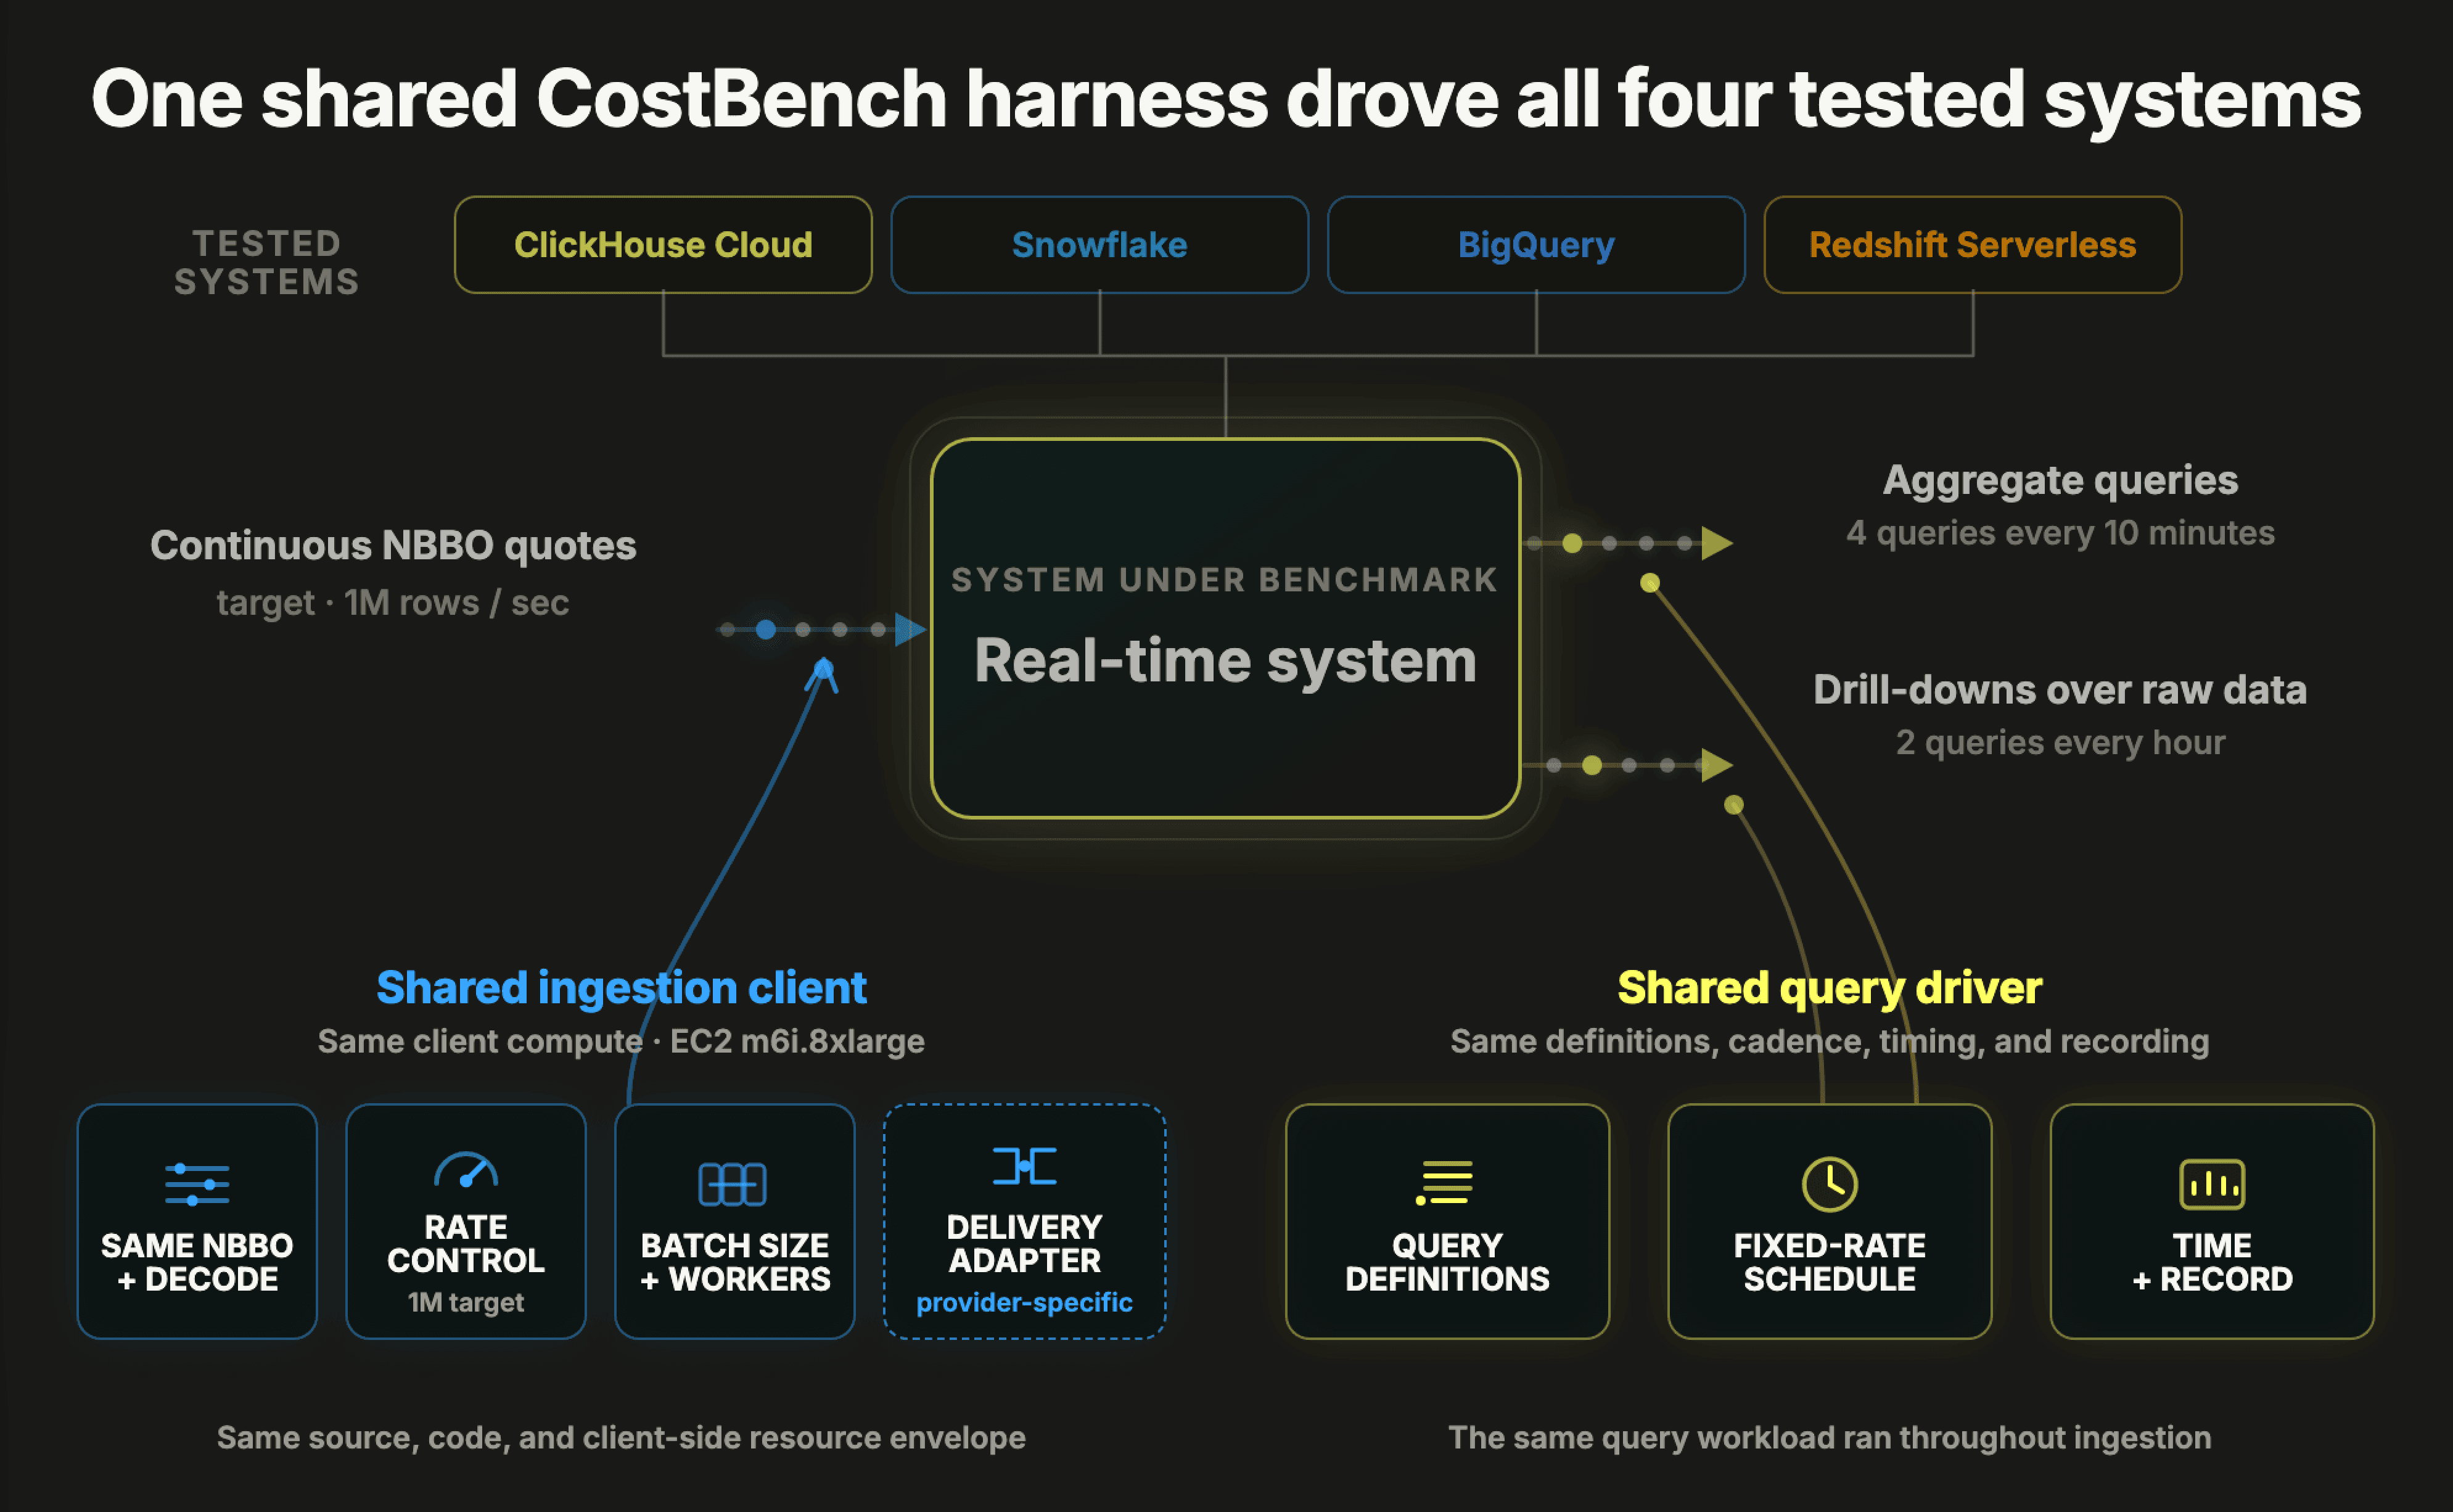
今回のラウンドでは、**ClickHouse Cloud**、**Snowflake**、**BigQuery**、**Redshift Serverless** にわたって**プッシュ型の取り込み**を採用しました。1 つの共通クライアントが、各システムが推奨する低レイテンシの取り込みパスを通じてストリームを直接送信しました。各システムのアーキテクチャを尊重しつつ、同等の条件下で比較するために 4 つの統制を行いました。

* **同一のワークロード:** 各システムは、1,132 億行の National Best Bid and Offer (NBBO) 株式市場気配値データセット、スキーマ、レイアウト設計、毎秒 100 万行の目標取り込みレート、クエリ、実行頻度をすべて同じ条件で受け取ります。

* **同等のリソース:** 有意義な比較が可能な範囲で読み取り側のコンピュートを揃え、キャリブレーション中に目標レートを維持できた最小の設定可能な最新データパス向けコンピュートを使用しました。

* **完全なプラットフォームパス:** 各システムは、低レイテンシのプッシュ型取り込みパスを備えた推奨リアルタイムアーキテクチャを使用しました。マネージドサービスおよびサーバーレスサービスはそれぞれのネイティブなスケーリングを維持し、従量課金された処理はベンチマークのコストに計上されました。

* **1 つの共通ハーネス:** 同一のソースファイル、デコードロジック、クライアントホスト、レートコントローラー、スケジューラー、タイミング測定、記録ロジックがすべてのシステムを駆動し、変更されたのは送信先のアダプターのみです。

未加工データと日次事前集計の両方について、システム間で一致するソートキーまたはクラスタリングキーを設定しました。これらのレイアウトは、ワークロードの銘柄コードによるフィルターを支えています。事前集計では気配値データを銘柄コードと日ごとにグループ化し、集計クエリで使用される件数、合計、価格の最小値・最大値を維持します。したがって、新しい行が届くにつれて、各システムは同一のクエリワークロードに対して同じデータ準備を最新の状態に保つ必要がありました。

今後のラウンドでは、1 ドルあたりのリアルタイム性能をより完全に把握するため、1 つの共通外部ストリームを使用する**プル型**のバリエーションもテストする可能性があります。

> 共通のハーネスでワークロードを一定に保ち、各システムがそれをどのように処理するかを CostBench で測定します。


<details class="note-box">
  <summary>ベンチマークの手法と公平性の制御 (クリックして展開)</summary>
  <div class="note-body">  
  <img
  src="/uploads/Screenshot_2026_09_08_at_15_35_28_099ff75240.png"
  alt="The shared CostBench ingestion client and query driver used across all four tested systems."
  width="2000"
  height="1240"
  loading="lazy"
  style="display: block; width: 100%; height: auto; margin-bottom: 24px;"
   />
    <p class="note-heading"><strong>取り込みモデル</strong></p>
    <p>
      クライアントは Parquet ファイルから NBBO データを読み取って生データ行へとデコードし、各ベンダーが推奨する低レイテンシのリアルタイム取り込みパスを介して、各プラットフォームのターゲットテーブルへ直接ストリームをプッシュしました。今後のラウンドでは、共通の単一外部ストリームを用いたプル型のバリアントもテストする予定です。
    </p>
    <p class="note-heading"><strong>ワークロードモデル</strong></p>
    <p>
      <a href="https://clickhouse.com/ja/blog/selecting-a-real-time-analytical-database-jp">リアルタイム分析システム</a>では、送信元でアプリケーションに応じたペースで新しいイベントが継続的に生成されます。将来の行はまだ存在しないため、可能な限り早くロードするような完全なバックログがデータベースに一度に渡されることはありません。CostBench では、Parquet ファイルを決定的(deterministic)なデータソースとして扱い、行をデコードした上でペースを調整した連続ストリームとして送出しながら、各プラットフォームが到着するデータをクエリ可能な状態に保ち、スケジュールされたクエリを処理することで、その運用条件を再現しています。
    </p>
    <p class="note-heading"><strong>データセットとアクティブウィンドウ</strong></p>
    <p>
      すべてのシステムに対して、12 カラムのナローな NBBO (National Best Bid and Offer) 株式気配値データからなる、同一の完全な 1,132 億行のデータセットを送信しました。
    </p>
    <p>
      すべてのシステムで以下のソートキーまたはクラスタリングキーを使用しました。
    </p>
    <ul>
      <li>
        <strong>イベントレベルのデータ:</strong> <code>(sym, t)</code> — 銘柄コードとイベントのタイムスタンプ。
      </li>
      <li>
        <strong>日次の事前集計:</strong> <code>(sym, day)</code> — 銘柄コードと日。
      </li>
    </ul>
    <p>
      ハーネスはソース全体を毎秒 100 万行の目標レートに向けて 1 つの連続ストリームとして再生し、最後のソース行が取り込まれるまで継続しました。目標レートどおりに推移した場合、このアクティブな取り込みウィンドウは約 31.4 時間続きます。実測の所要時間はシステムごとに異なりました。
    </p>
    <p class="note-heading"><strong>共通の取り込みクライアント</strong></p>
    <p>
      ClickHouse Cloud、Snowflake、BigQuery、Redshift Serverless のいずれに対しても、同一のソースファイル、スキーマ、行デコードロジック、ワークロード生成コードを使用しました。すべてのシステムにおいて、クライアントは同一の AWS EC2 m6i.8xlarge インスタンス上で動作し、同一のレートコントローラーを使用しながら、ターゲット側へのペース配分を目標に合わせるようにバッチサイズとワーカーの並列度を調整しました。
    </p>
    <p class="note-heading"><strong>ベストプラクティスに基づくプラットフォーム構成</strong></p>
    <p>
      変更したのは送信先ごとの配信アダプターのみです。各プラットフォーム内部では、ベンダーが推奨する低レイテンシのプッシュ型リアルタイム取り込みパスと、受信データをクエリ可能な状態に維持するためのドキュメント化されたベストプラクティスを採用しました。これらのパスの違い自体もベンチマークの対象となります。
    </p>
    <p class="note-heading"><strong>リソースサイジングポリシー</strong></p>
    <p>
      プラットフォーム間で有意義な比較が可能な場合は、推定 CPU キャパシティに基づいて読み取り側のコンピュートを揃えました。構成可能な最新データパスのコンピュートについては、キャリブレーション時に受信データをクエリ可能な状態に維持しつつ、毎秒 100 万行の目標レートを維持できたテスト済み構成のうち最小のものを使用しました。マネージドコンポーネントおよびサーバーレスコンポーネントはネイティブのスケーリングを使用し、従量課金された処理はベンチマークのコストとして計上されています。実際に観測されたエンドツーエンドのスループットは、設定上の目標とは別に報告しています。
    </p>
    <p class="note-heading"><strong>共通のクエリドライバー</strong></p>
    <p>
      取り込みの開始から最後のソース行に至るまで、同一の固定レートスケジューリング、タイミング、結果記録ロジックを使用して、同一の 4 つのインタラクティブ集計クエリを 10 分ごと、同一の 2 つの選択的なドリルダウンクエリを 1 時間ごとに実行しました。
    </p>
    <p class="note-heading"><strong>クエリワークロード</strong></p>
    <p>
      このワークロードは、最新データパスの効率をストレステストするように意図して設計されています。クエリは取り込み中ずっと実行され、その結果には固定された過去のスライスではなく、新たに到着したデータが反映されなければなりません。したがって、各システムはそれらのクエリを処理し続けながら、届いたばかりの最新データをクエリに向けて準備し続ける必要があります。
    </p>
    <p>
      クエリの分類ラベルは、SQL 自体に集計が含まれているかどうかではなく、データパスを表しています。集計クエリは維持管理されている事前集計を読み取り、ドリルダウンクエリはイベントレベルの行から直接計算します。
    </p>
    <p class="note-subheading"><strong>到着した最新データがクエリに反映される仕組み</strong></p>
    <p>
      6 つのクエリはすべて、日付や時刻のカットオフなしに、その時点までに取り込まれた全履歴を対象とします。
    </p>
    <ul>
      <li>
        <strong>シンボルでフィルタリングされるクエリ (A1、A2、D1、D2):</strong> 選択されるシンボルは固定ですが、気配値が届くにつれて一致するデータが増え続けます。たとえば、sym = 'AAPL' には、以前の気配値に加えて新しく取り込まれた Apple の気配値が含まれます。8 銘柄のウォッチリストも同様に動作します。
      </li>
      <li>
        <strong>シンボルフィルターのないクエリ (A3、A4):</strong> これらは、維持管理された日次の事前集計を介してすべてのシンボルを対象とします。新しく取り込まれた気配値は、過去の価格帯や日次の市場動向を調べる集計結果に反映されます。
      </li>
    </ul>
    <p>
      集計クエリの場合、到着した気配値を事前集計に取り込む必要があります。ドリルダウンクエリの場合、新しいイベントレベルの行を効率的なフィルタリングが可能なレイアウトで利用できるようにする必要があります。
    </p>
    <p class="note-subheading"><strong>各クエリの処理内容</strong></p>
    <p>
      <strong><a href="https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/clickhouse-cloud/queries_mv.sql">インタラクティブ集計クエリ (A1–A4)</a></strong> は、継続的に維持管理される日次の事前集計を読み取ります。A1 は 1 つのシンボルの全期間サマリーを返し、A2 は 8 銘柄のウォッチリストを集計し、A3 はシンボルごとの過去最大の価格帯を特定し、A4 は日別の市場全体の動向を返します。A1 と A2 はレイアウトキーの先頭にある sym を利用し、A3 と A4 は全体のロールアップを読み取ります。
    </p>
    <p>
      <strong><a href="https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/clickhouse-cloud/queries_raw.sql">選択的ドリルダウンクエリ (D1–D2)</a></strong> は、1 つのシンボルの全履歴にわたってイベントレベルのデータを直接読み取ります。D1 は VWAP、ボラティリティ、スプレッド、気配値数を含む 1 時間ごとの OHLCV バーを生成します。D2 は、仲値ボラティリティ、スプレッド分布とテールパーセンタイル、オーダーブックのインバランス、スプレッドと板の厚みの相関をカバーする、1 行のリスクおよび流動性プロファイルを返します。
    </p>
    <p class="note-subheading"><strong>データ準備とクエリの整合性</strong></p>
    <p>
      このワークロードは、両方のデータ準備手法を検証します。D1/D2 は <code>(sym, t)</code> の先頭カラムである <code>sym</code> で生データをフィルタリングします。A1/A2 は <code>(sym, day)</code> の同じ先頭カラムで日次サマリーをフィルタリングし、A3/A4 は全シンボルのサマリーを読み取ります。
    </p>
    <p>
      日次の事前集計は <code>(sym, day)</code> でグループ化され、A1–A4 で使用される件数、合計、最小値、最大値を維持管理します。たとえば、気配値の総数は準備済みの気配値数を合算して求められ、平均スプレッドは累積スプレッド合計を累積気配値数で割ることで算出されます。
    </p>
    <p class="note-heading"><strong>キャッシュポリシー</strong></p>
    <p>
      測定された実行時間が計算済み結果の取得ではなく実際のクエリ実行を反映するように、すべてのシステムでクエリ結果キャッシュを無効化しました。これは、新しく到着したデータが結果に反映される必要があり、過去にキャッシュされた結果は最新ではなくなる可能性があるという、ワークロードの鮮度要件にも合致します。
    </p>
    <p>
      通常の基盤データキャッシュは、継続的な運用を反映してウォーム状態を維持することを許可しました。これらのキャッシュはデータ読み取りのコストを削減できますが、クエリの実行自体を代替するものではありません。エンジンは依然として新規到着データを反映し、各クエリに必要なフィルタリング、照合、集計を実行する必要があります。
    </p>
  </div>
</details>

[ベンチマークの完全な定義、承認された実行結果、コスト概要、再現手順](https://github.com/ClickHouse/CostBench/tree/main/full-path-realtime/quotes)は、CostBench リポジトリで公開されています。

*Databricks Lakehouse/RT は現在も[ベータ](https://docs.databricks.com/gcp/en/compute/sql-warehouse/real-time)段階であるため、今回の初回比較からは除外しており、一般提供 (GA) 後にテストを実施する予定です。*


## 最新データが届き続ける中でも高速に応答

まずは、取り込みとクエリを並行して実行した際に各システムが示した結果を見てみましょう。下のグラフは、データセットが増加するにつれて、測定対象の集計クエリおよびドリルダウンクエリの応答に費やされた時間を累積したものです。


<iframe src="/uploads/07_accumulated_query_runtime_7e77f5d310.html" frameborder="0" style="width: 100%; height: 500px; max-height: 800px;"></iframe>


継続的な取り込み負荷において、ClickHouse Cloud の累積クエリ実行時間は最も短くなりました。

> ClickHouse Cloud は、絶えず更新される最新データに対して高速に応答できるよう、エンドツーエンドで専用設計されています。その優位性は、入力される各行の準備から最新の回答の提供に至るまで、システム全体が一体となって機能することから生まれます。

これらのクエリを素早く処理できることは、結果の一面にすぎません。受信データをクエリ可能な状態に保ち、そのワークロードを処理するのにどれだけのコストがかかったのでしょうか。CostBench はこれらの側面を総合的に評価します。


## CostBench による 1 ドルあたりのリアルタイム性能ランキング

クラウドプラットフォームは、根本的に異なる課金モデルを採用しており、多くの場合、最新データパスやクエリエンジンも大きく異なります。これらを横断してコストと性能を比較するため、CostBench は 3 つの要素を統合し、数値が低いほど優れているスコアを算出します。


**① 最新データパスのコスト:** 継続的な取り込み、イベントレベルのレイアウト維持、および事前集計にかかる完全取り込みコスト。


**② 正規化されたクエリ処理コスト:** 各システムに適用される読み取り側の料金レートで、同じスケジュールされたクエリを実行した際のコスト。

**③ 総クエリ実行時間:** アクティブな取り込み中にそのクエリワークロードに費やされたエンドツーエンドの累積実行時間。

<video autoplay="1" muted="1" loop="1" controls="0">
  <source src="https://clickhouse.com/uploads/08_costbench_end_to_end_score_loop_f8cdebff11.mp4" type="video/mp4" />
</video>

> このスコアは、継続的に届くデータを経済的にクエリ可能な状態に保ち、ワークロードを高速に処理できるシステムを評価するものです。数値が小さいほど優れています。

データベースのストレージコストは、ベンチマーク実行期間全体に対する影響が小さいためスコアから除外しています。詳細は以下の計算に関する注記を参照してください。

<details class="note-box">
  <summary>スコアの算出方法と従量課金の正規化(クリックして展開)</summary>
  <div class="note-body">
    <p class="note-heading"><strong>フルパススコアが意味するもの</strong></p>
    <p>
      このスコアは、次のひとつの問いに答えるものです:<br>
      <strong>費やした1ドルあたりで最も高いフルパスのリアルタイム性能を得られるのはどこか？</strong>
    </p>
    <p>
      この指標は、継続的に届くデータをクエリ可能な状態に保つコストと、同じクエリ実行スケジュールを処理する際のコストおよび合計実行時間を組み合わせたものです。スコアが低いほど、継続的な取り込み下において、エンドツーエンドのコストの低さとより高速なクエリ提供の組み合わせが優れていることを意味します。
    </p>
    <p class="note-heading"><strong>算出方法</strong></p>
    <p>
      エンドツーエンドスコア = (最新データパスのコスト + 正規化されたクエリ処理コスト) × クエリ合計実行時間。数値が小さいほど優れています。
    </p>
    <p class="note-heading"><strong>最新データパスのコスト</strong></p>
    <p>
      最新データパスの要素には、1,132 億行のストリーム全体を受け入れ、イベントレベルおよび事前集計データをクエリ可能な状態に保つための完全取り込みコストを使用します。構成されたコンピュートは実際にアクティブだった時間に対して価格が計算され、マネージドサービスおよびサーバーレスサービスでは計測された処理量が使用されます。
    </p>
    <p class="note-heading"><strong>正規化されたクエリ処理コスト</strong></p>
    <p>
      クエリコストは、コンピュートが秒単位で請求されるものと仮定し、<strong>累積エンドツーエンド実行時間 × 読み取り側コンピュート単価</strong>として正規化しています。<strong>これにより、支払ったコンピュート時間に対して各システムがどれだけのクエリ作業を完了できるかを比較できます。</strong>秒単位の正規化により、アイドル時のタイムアウトや最小請求単位の違いが排除されます。
    </p>
    <p class="note-heading"><strong>今回のベンチマークでは、データセットの進行状況を合わせたうえで、取り込み実行中の同数のクエリ実行に対してその計算を適用しています。各実行の完全なエンドツーエンド実行時間に対象の読み取り側コンピュートレートを乗算し、それらのコストを合計します。得られる結果は、実際の請求額の再現ではなく、正規化された比較コストです。</strong>
    </p>
    <p class="note-heading"><strong>ストレージコストの扱いについて</strong></p>
    <p>
      データベースストレージはスコアから除外しています。約 1,132 億行を用いた以前の CostBench の実験は、短い取り込み実行においてストレージの影響が限定的であることを示しています。ベンチマークで記録された <a href="https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/clickhouse-cloud/costs/summarize_queries.sh#L43-L47">ClickHouse</a> および <a href="https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/snowflake/costs/pricings/gen2_warehouse.json">Snowflake</a> のストレージレートを使用した場合、<a href="https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/snowflake/results/t2/storage.json">測定された生データテーブルと事前集計のフットプリント</a>は、月額換算でおよそ <strong>ClickHouse Cloud が 9.83 ドル、Snowflake が 16.07 ドル</strong>に相当しました。
    </p>
    <p>
      1か月を 730 時間として計算すると、<strong>37 時間の実行全体</strong>に対してこれらの完全なフットプリント全体を課金した場合、それぞれ約 <strong>0.50 ドルと 0.81 ドル</strong>の追加にしかなりません。なお、取り込み中にデータセットが増加するにもかかわらず、ここでは意図的に最初から最終フットプリント全体で課金しています。参考として、今回の比較における最新データパスのコストは、それぞれ <strong>28.69 ドルと 79.42 ドル</strong>です。これらのストレージ見積もりは規模感を示すためのものであり、今回の実行で測定されたストレージ請求額ではありません。<a href="https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/snowflake/results/t2/charts/run14/full_path_cost_performance_clickhouse_vs_snowflake_summary.json">今回のコスト結果</a>。
    </p>
    <p>
      保持期間が長くなるにつれて、ストレージコストの重要性は高まります。この除外はデータベースストレージに関するものであり、<a href="https://github.com/ClickHouse/CostBench/blob/main/full-path-realtime/quotes/redshift-serverless/results/t2/msk_cost.json">Redshift の MSK ブローカーストレージ</a>を含む、取り込みに必要なインフラストラクチャは引き続き最新データパスのコストに含まれます。
    </p>
    <p class="note-heading"><strong>測定範囲と除外項目</strong></p>
    <p>
      最新データパスのコストは、1,132 億行の完全な取り込みを対象としています。クエリ処理コストと合計実行時間は、アクティブな取り込み中に条件を揃えて受理されたクエリを対象とします。ストレージ、無料利用枠、割引、アイドルキャパシティ、最小請求単位、取り込み完了後のクエリ、失敗した試行、および常時待機するフォールバックキャパシティは除外されます。受理されたクエリのコストモデルに含まれるプロバイダー固有のフォールバック割り当ては、引き続き対象に含まれます。
    </p>
    <p class="note-heading"><strong>ランキング</strong></p>
    <p>
      絶対スコアが最も低いシステムが 1 倍のベースラインとなります。他のすべてのシステムは、N 倍劣る(N× worse)として報告されます。
    </p>
    <p class="note-heading"><strong>関連する測定手法</strong></p>
    <p>
      これは、CostBench の以前の<a href="https://clickhouse.com/ja/blog/cloud-data-warehouses-cost-performance-comparison-jp">計測粒度</a>および<a href="https://clickhouse.com/ja/blog/cloud-data-warehouses-cost-performance-comparison-jp">ランキング手法</a>を、クエリ側のテストから完全な最新データパスへと拡張したものです。
    </p>
  </div>
</details>

## 最新データパスが 1 ドルあたりの性能差をさらに拡大


私たちはひとつの仮説から始めました: 

> 継続的な負荷のもとでは、データをクエリ可能な状態に保つことが、クエリの実行そのものと同等に 1 ドルあたりの性能を左右する可能性がある。  

今回の結果は、その影響がいかに大きいかを明確に示しています。


### クエリ側のみの場合: 32〜101 倍の開き

 
前回の[クエリ側の比較](https://clickhouse.com/ja/blog/cloud-data-warehouses-cost-performance-comparison-jp)では、クエリ処理のコストと実行時間を切り離すため、ロード済みでクエリ可能な状態のデータを測定しました。

その範囲内において、Snowflake、Redshift Serverless、および BigQuery Capacity は、**ClickHouse よりもクエリ側のコストパフォーマンスが 32〜101 倍劣るという結果になりました。**

<video autoplay="1" muted="1" loop="1" controls="0">
  <source src="https://clickhouse.com/uploads/09_query_side_performance_per_dollar_loop_0787c8307a.mp4" type="video/mp4" />
</video>

### 最新データ経路を含めた場合: 412〜1,996 倍の差

エンドツーエンドの比較では、新しい行の取り込みとクエリ可能な状態の維持にかかる継続的なコストが加わります。本ベンチマークでは、そのコストを正規化されたクエリ処理コストに加え、アクティブな取り込み中に蓄積されたクエリ実行時間と合計を組み合わせています。

<video autoplay="1" muted="1" loop="1" controls="0">
  <source src="https://clickhouse.com/uploads/10_end_to_end_performance_per_dollar_loop_a0325be914.mp4" type="video/mp4" />
</video>

この結果により、すべてのピースがつながります。

> 新鮮なデータのパスを含めると、コストパフォーマンスの差は、クエリ単体の **32〜101 倍**から、エンドツーエンドでは **412〜1,996 倍**へと広がります。

最後のアニメーションでは、この広がったスコアの背景にある 2 つの側面、すなわちエンドツーエンドのコストと累積クエリ実行時間を個別に示しています。

<iframe src="/uploads/11_end_to_end_cost_vs_accumulated_query_d084c54eb9.html" frameborder="0" style="width: 100%; height: 500px; max-height: 800px;"></iframe>

最後の比較では、実行時間の優位性をコストの全体像と結びつけて考察します。ClickHouse Cloud は、本ベンチマークにおいて最も短いクエリ累積実行時間と、最も低い最新データパスおよび正規化クエリ提供コストを両立させました。

* **最新データパス:** 個別比較分析で示すとおり、ClickHouse Cloud は最も低コストな最新データパスを備え、取り込みが継続するなかでイベントレベルと事前集計済みの両方のデータを最新状態に維持できた唯一の検証対象システムでした。

* **クエリ提供:** 行が到着した時点でその処理を完了していたため、クエリエンジンが実行すべきフィルタリング、グループ化、集約の処理量が減り、結果として最も短い累積クエリ実行時間と最も低い正規化クエリ提供コストを実現しました。

> **ClickHouse Cloud の優位性の相乗効果:** 最も低コストな最新データパスによって到着したデータを即座にクエリ可能な状態に保ち、測定対象のクエリワークロードに残される作業量、ひいては実行時間とコストを削減しました。

CostBench エンドツーエンドのリアルタイムパスシリーズは、各プロバイダーのアーキテクチャと課金モデルに関する個別比較分析へと続き、クエリ準備処理がどこで実行され、どこで遅延が生じ、それらの設計上の選択が 1 ドルあたりの性能にどのように影響するかを追跡していきます。