---
title: "CostBenchのご紹介: データウェアハウスのコストパフォーマンスを測るオープンベンチマーク"
date: "2026-06-10T00:51:05.072Z"
author: "Tom Schreiber and Lionel Palacin"
category: "Engineering"
excerpt: "CostBenchを発表します。クラウドデータウェアハウスのランタイムと課金モデルを、比較可能な「価格あたりの性能」結果へと変換するオープンベンチマークです。"
---
# CostBenchのご紹介: データウェアハウスのコストパフォーマンスを測るオープンベンチマーク
> **TL;DR**
CostBenchは、クラウドデータウェアハウスのコストパフォーマンス、すなわち速度だけでなく「1ドルあたりの性能」を測るためのオープンベンチマークです。
リアルタイム分析ワークロードにおいて、1ドルあたり最も高い性能を発揮するシステムを選ぶ手助けをします。
## 性能だけでは話の半分にすぎない
ほとんどのベンチマークは、クエリがどれだけ速く実行されるかを示してくれます。それは有用ですが、不完全です。
> クラウドデータプラットフォームにおいて、速度とコストは切り離せません。
ウェアハウスAがウェアハウスBより速ければ、性能チャート上ではAが優れて見えます。しかし、Aの運用コストがBの3倍だったら、比較の様相は変わります。同じ予算をBのより大規模な構成に費やせば、より多くの計算リソースが得られ、結果的にBがAよりも速くなり、しかも全体のコストは安く済むかもしれません。
この比較が難しいのは、各プラットフォームがコストを異なる形で提示しているからです。クレジット、DBU、スロット秒、コンピュートユニット、RPU——。
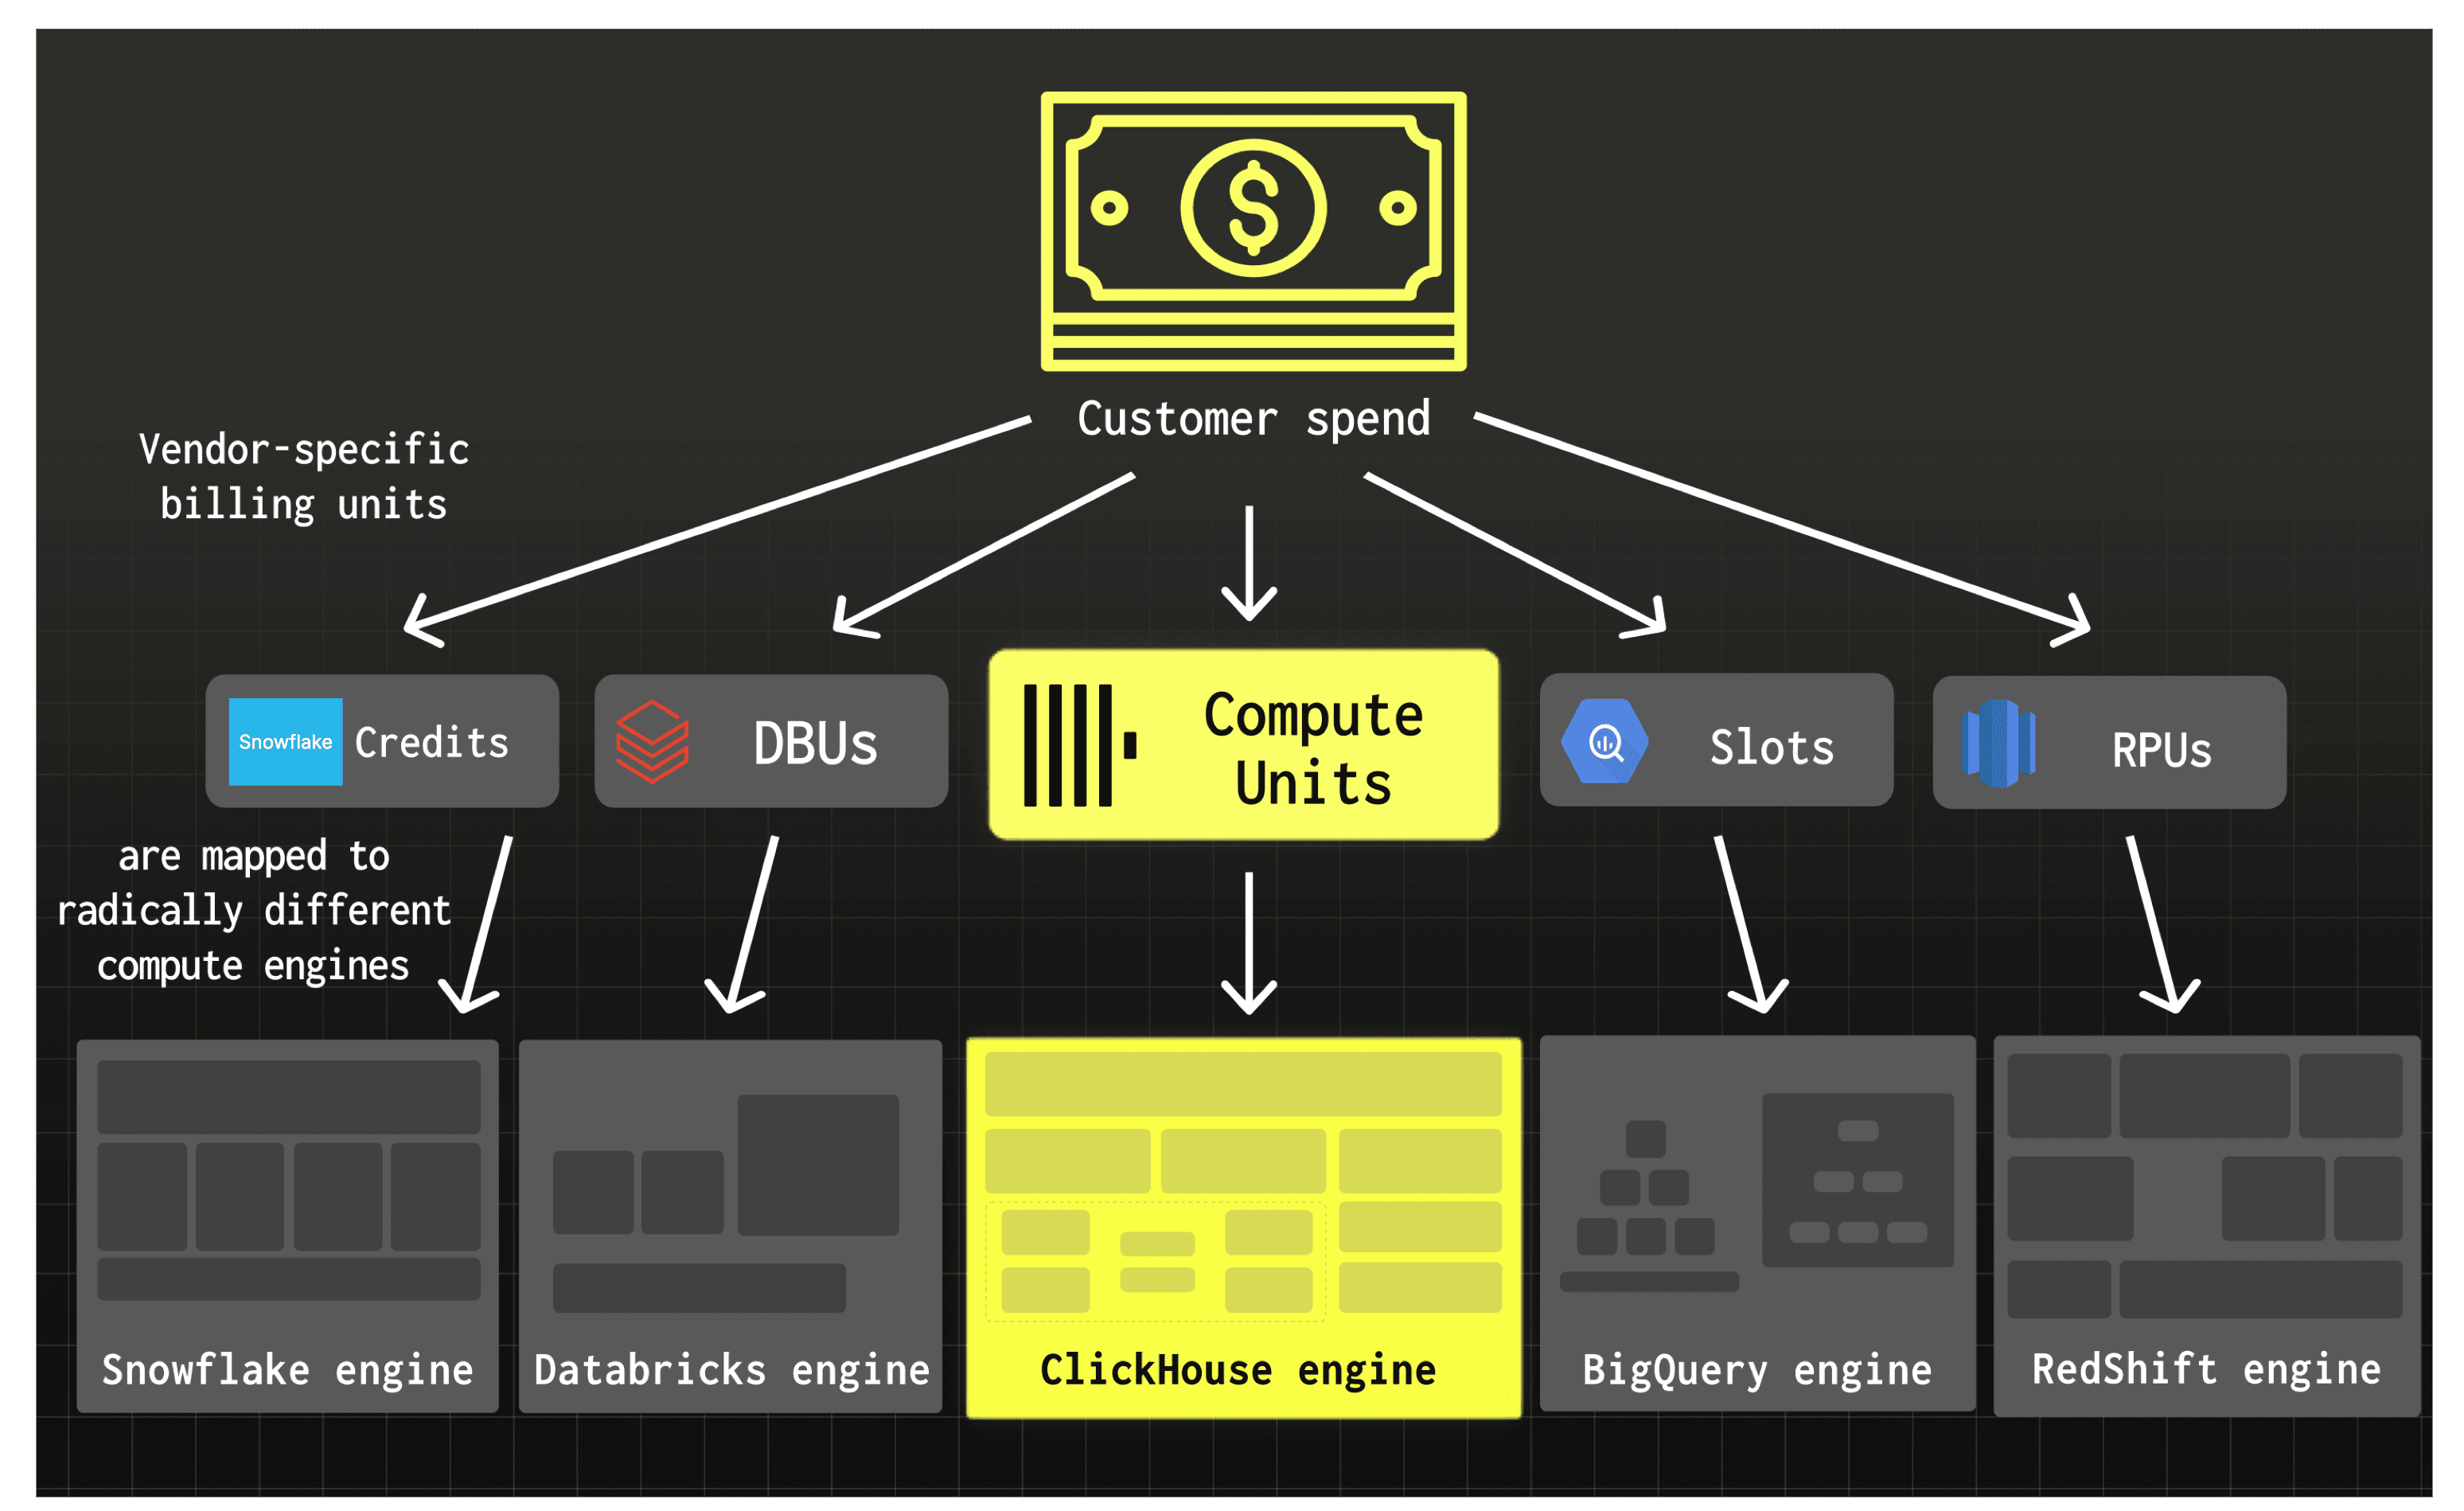
単位の名称は異なりますが、根底にある問いは同じです。
> ワークロードを完了するためにシステムはどれだけの計算リソースを必要とし、その計算リソースにはいくらかかったのか?
CostBenchはこの問いに直接答えます。さらに、コストパフォーマンスがどこで崩れるか——インジェスト時、データをクエリ可能な状態にする際、または読み取り処理中——も明らかにします。
## なぜAI時代にこれが重要なのか
エージェント型分析は、データベースのあらゆる層への負荷を高めます。
新しいデータは絶え間なく流入します。イベント、トランザクション、ログ、トレース、ユーザーアクティビティ、不正検知シグナル、運用ステート。同時に、ユーザーとエージェントは新鮮なデータに対する高速な回答を期待します。
> データベースが遅ければエージェントも遅くなります。データベースが高価であれば、チームはエージェントの行動を制限し始めます。リトライを減らし、データセットを小さくし、コンテキストを削り、古いデータで我慢する——。
AI時代において、高速かつ低コストであることは、分析パス全体——継続的インジェスト、クエリ可能な状態への準備、読み取り——を通じて保たれなければなりません。
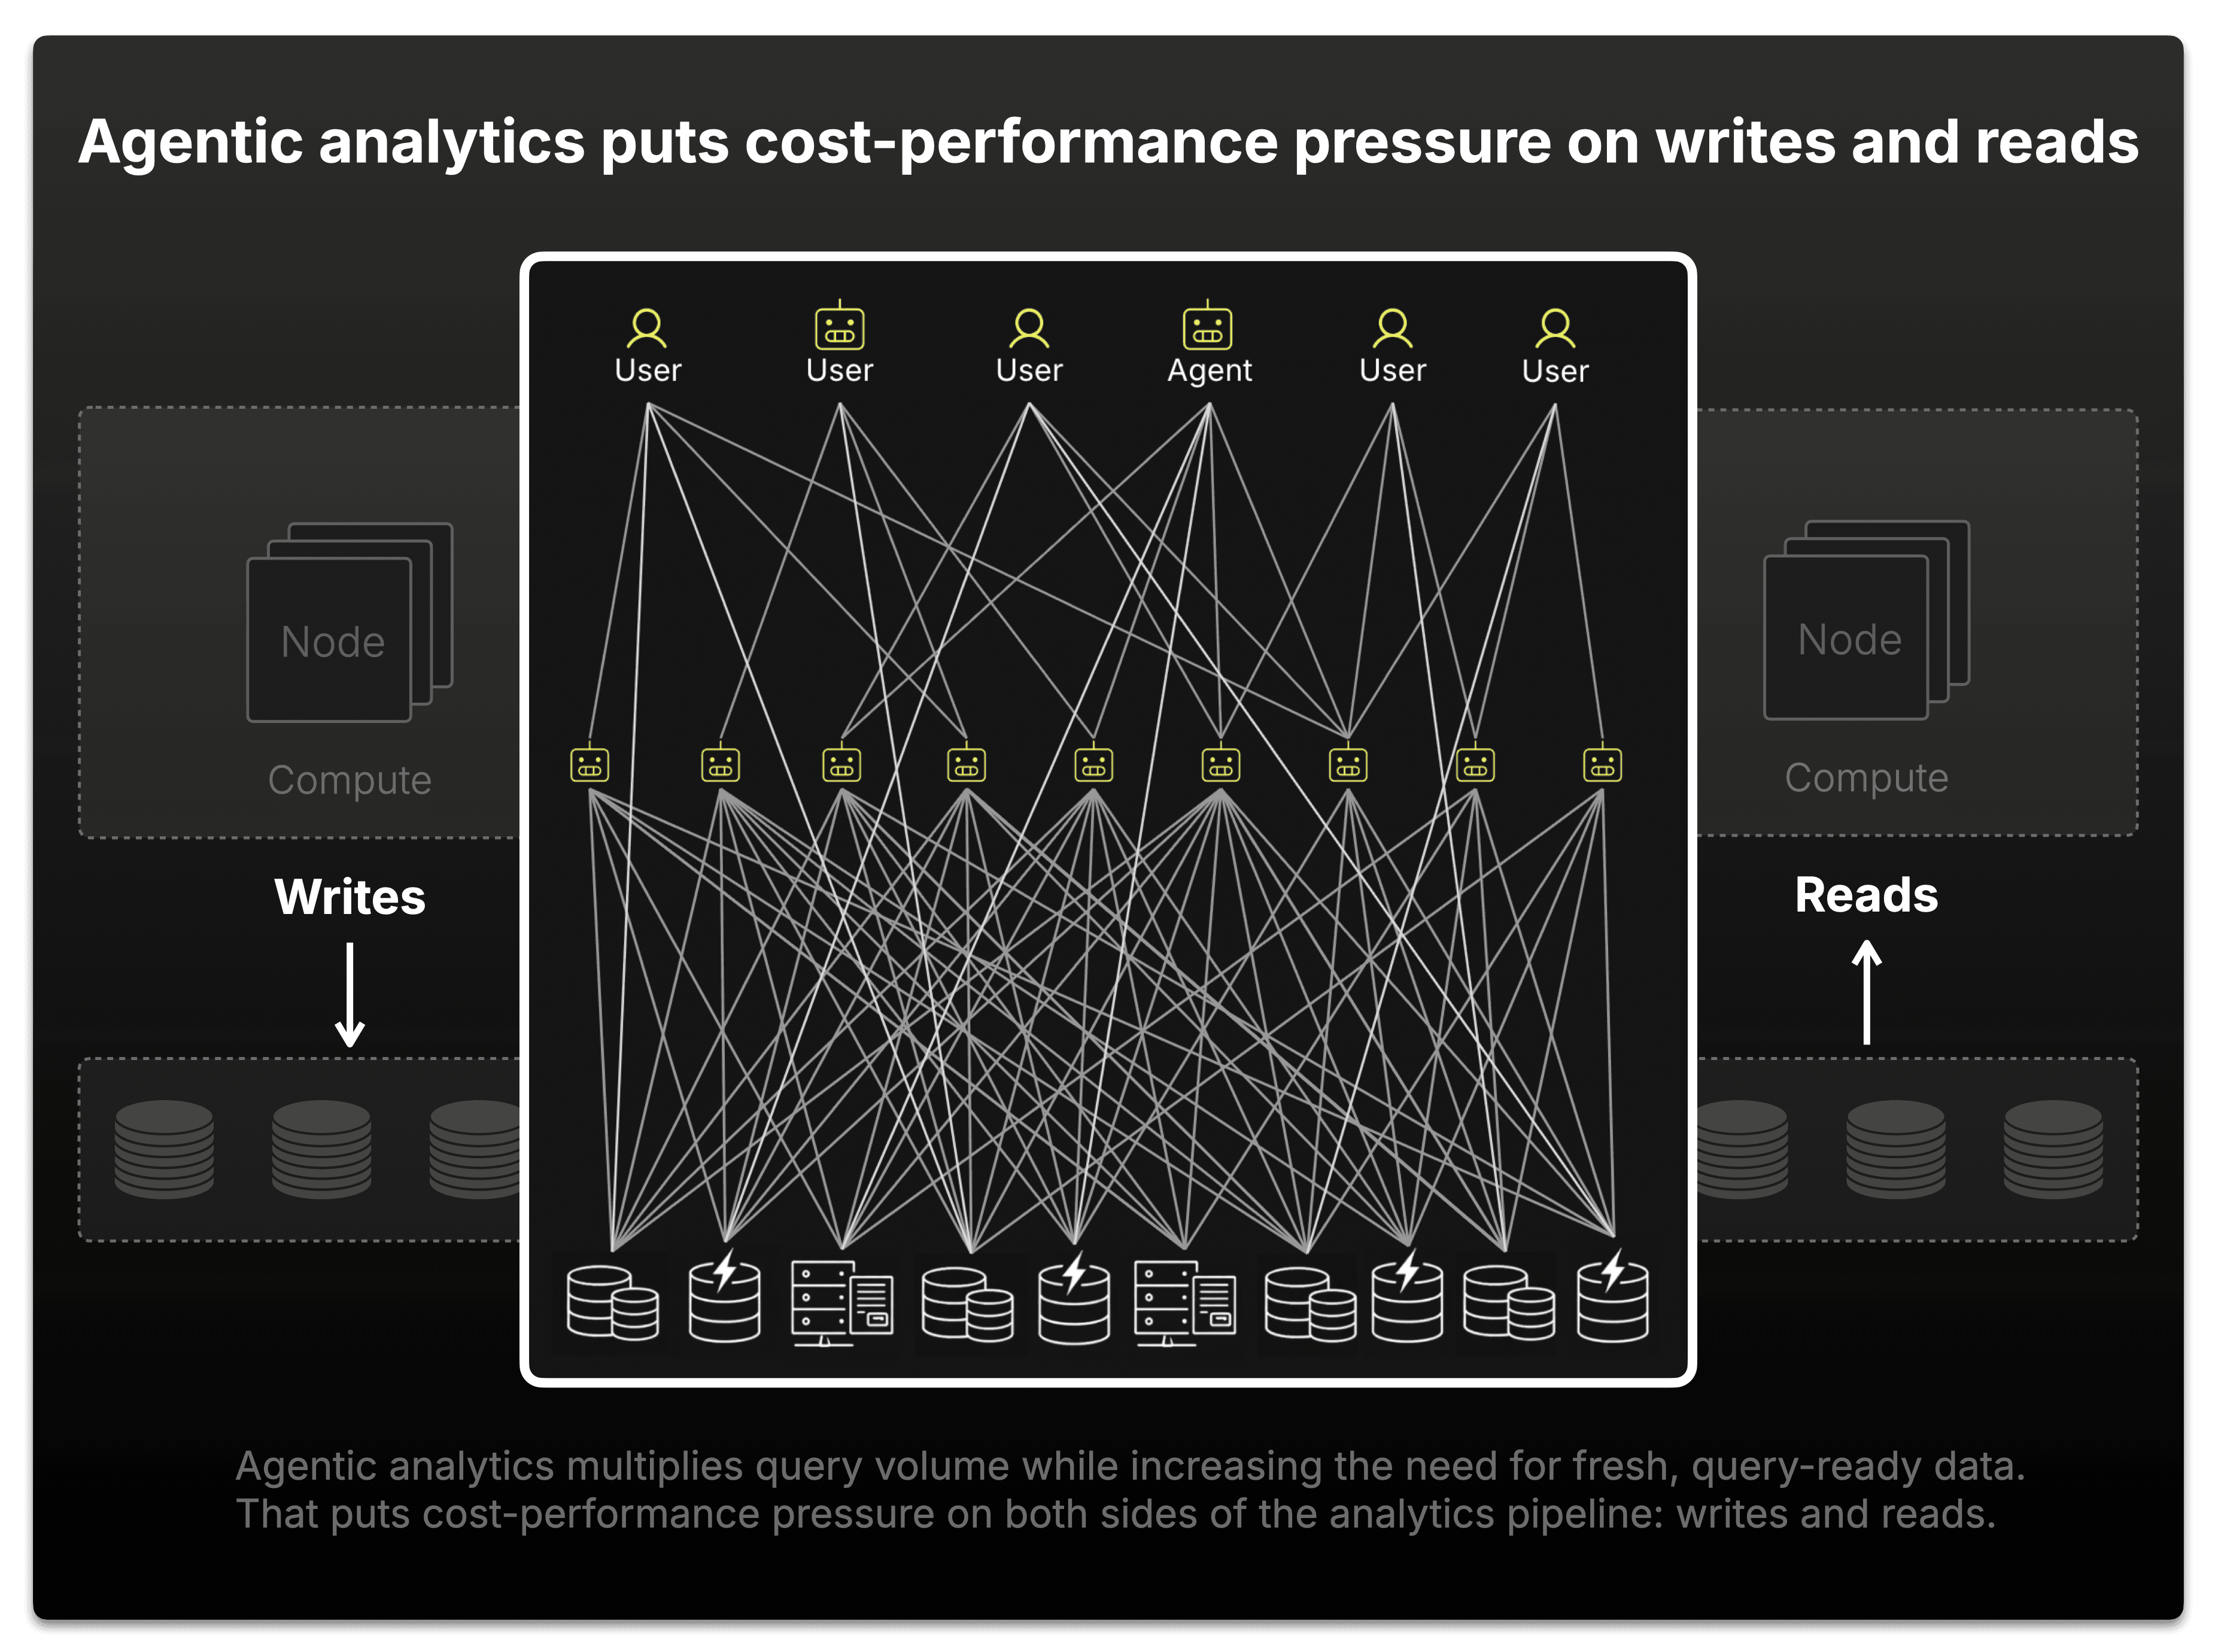
**読み取り側の負荷**はクエリ量から生まれます。ユーザーの1つの質問は、多数のSQLクエリを引き起こす可能性があります。スキーマ探索、検証、リトライ、絞り込み、ドリルダウン、フォローアップなどです。追加のクエリごとに計算リソースが消費されます。エージェント規模では、クエリ量はそのままコスト圧力に直結します。
**書き込み側の負荷**はリアルタイムの鮮度から生まれます。新鮮なデータは継続的に取り込まれ、圧縮され、クエリがより多くのデータをスキップできるように整理されなければなりません。この処理は最初のクエリが実行される前に計算リソースを消費し、後でそれらのクエリがどれだけ計算リソースを消費するかをも左右します。
## CostBenchが測定するもの
CostBenchはその負荷を、測定可能な2つの軸でフルパスのコストパフォーマンスとして可視化します。
* **読み取り側のコストパフォーマンス**: 1ドルあたりどれだけのクエリ性能が得られるか。
* **書き込み側のコストパフォーマンス**: 各ドルが、新鮮なインジェストをクエリ可能なデータへ変換する効率はどれほどか。
両者を組み合わせることで、プラットフォーム選定時に重要となる問いに答えられます。
> リアルタイム分析ワークロードにおいて、1ドルあたり最も高い性能を発揮するのはどのシステムか?
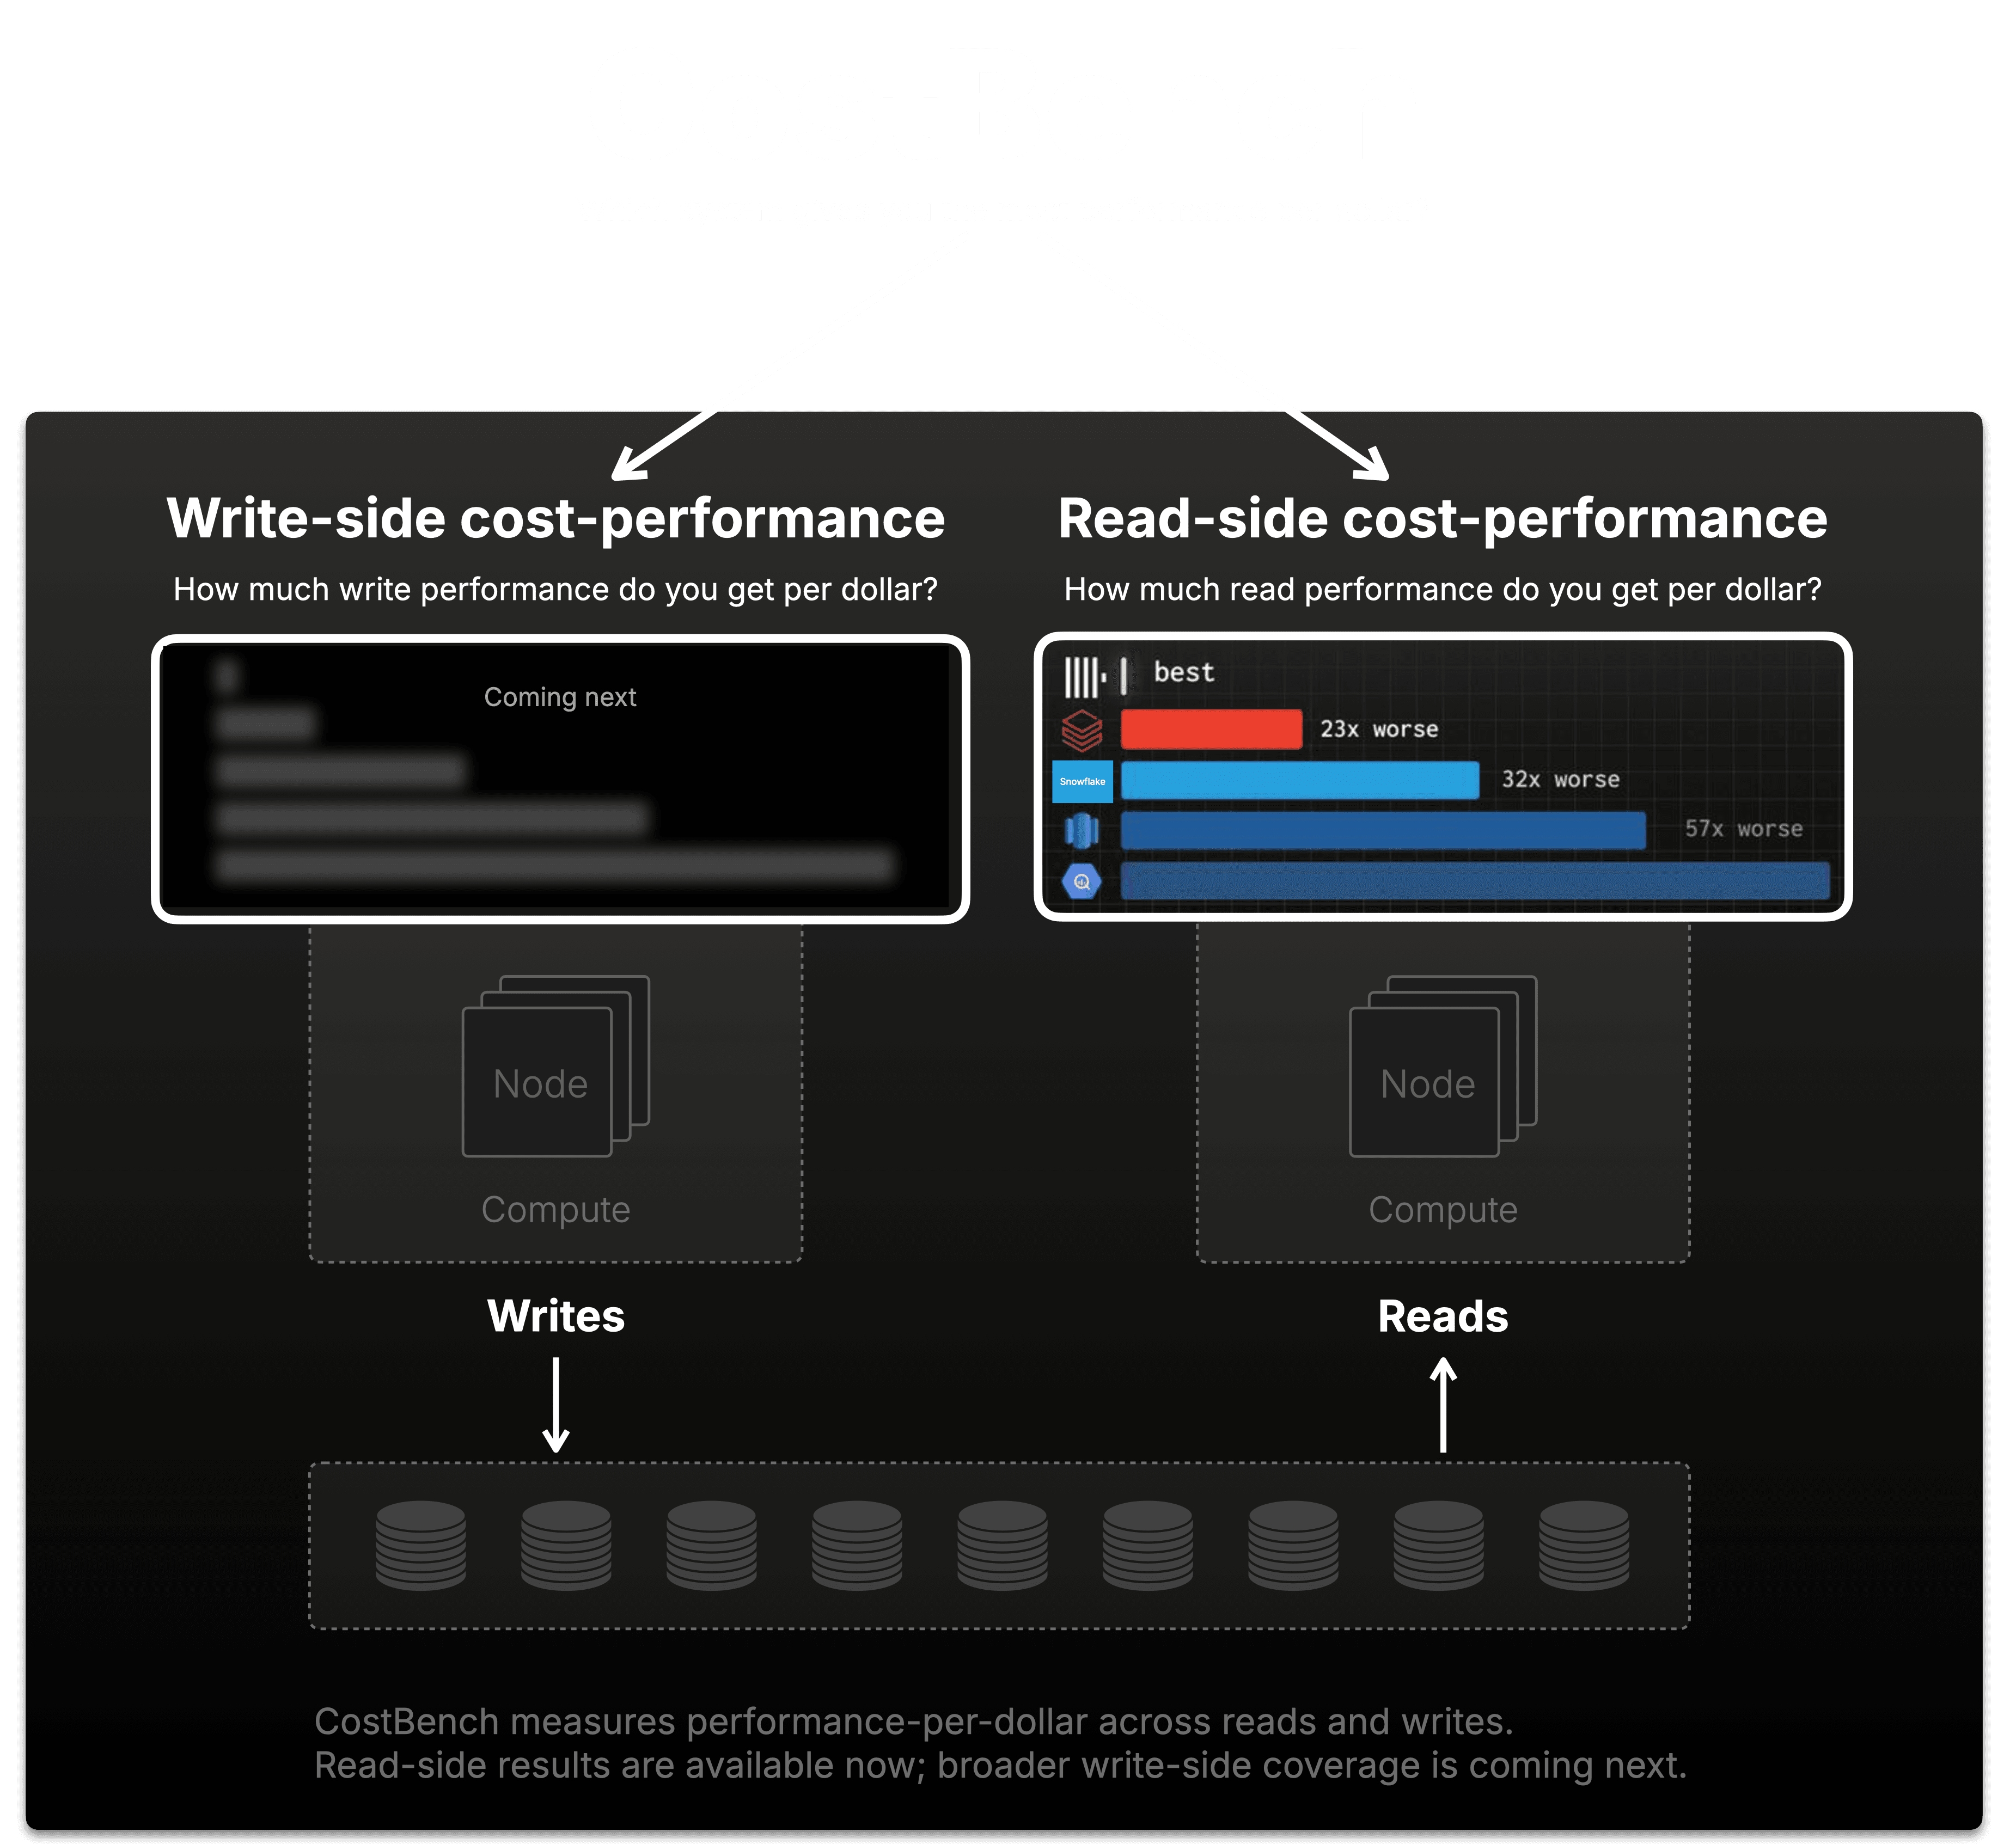
最初のリリースでは、すでにロードされたデータに対する分析クエリ、すなわち読み取り側に焦点を当てています。書き込み側についても測定を開始しており、まずは[ClickHouseとの対比としてSnowflake](https://clickhouse.com/blog/write-side-cost-performance-snowflake-clickhouse)からスタートしています。より広範な書き込み側のカバレッジは順次追加していきます。
これによりCostBenchはシンプルなロードマップを持ちます。新鮮なデータをクエリ可能にする工程から、それを効率的にクエリする段階まで、分析パイプライン全体でリアルタイムのコストパフォーマンスが維持されるかどうかを明らかにすることです。
## 最初の結果: 読み取り側のコストパフォーマンス
CostBenchの最初のリリースでは、読み取り側の性能を、主要なクラウドデータウェアハウス間で比較可能な「1ドルあたりの性能」として示しています。
実際の匿名化データセットに対して、本番由来の43本の分析クエリを用いて、ClickHouse Cloud、Snowflake、Databricks、BigQuery、Redshiftを比較しました。その上で、[各ベンダーの実際のコンピュート課金モデル](https://clickhouse.com/blog/how-cloud-data-warehouses-bill-you)を適用し、すべてのシステムを同じコストパフォーマンス平面——速いか遅いか、低コストか高コストか——にプロットしています。
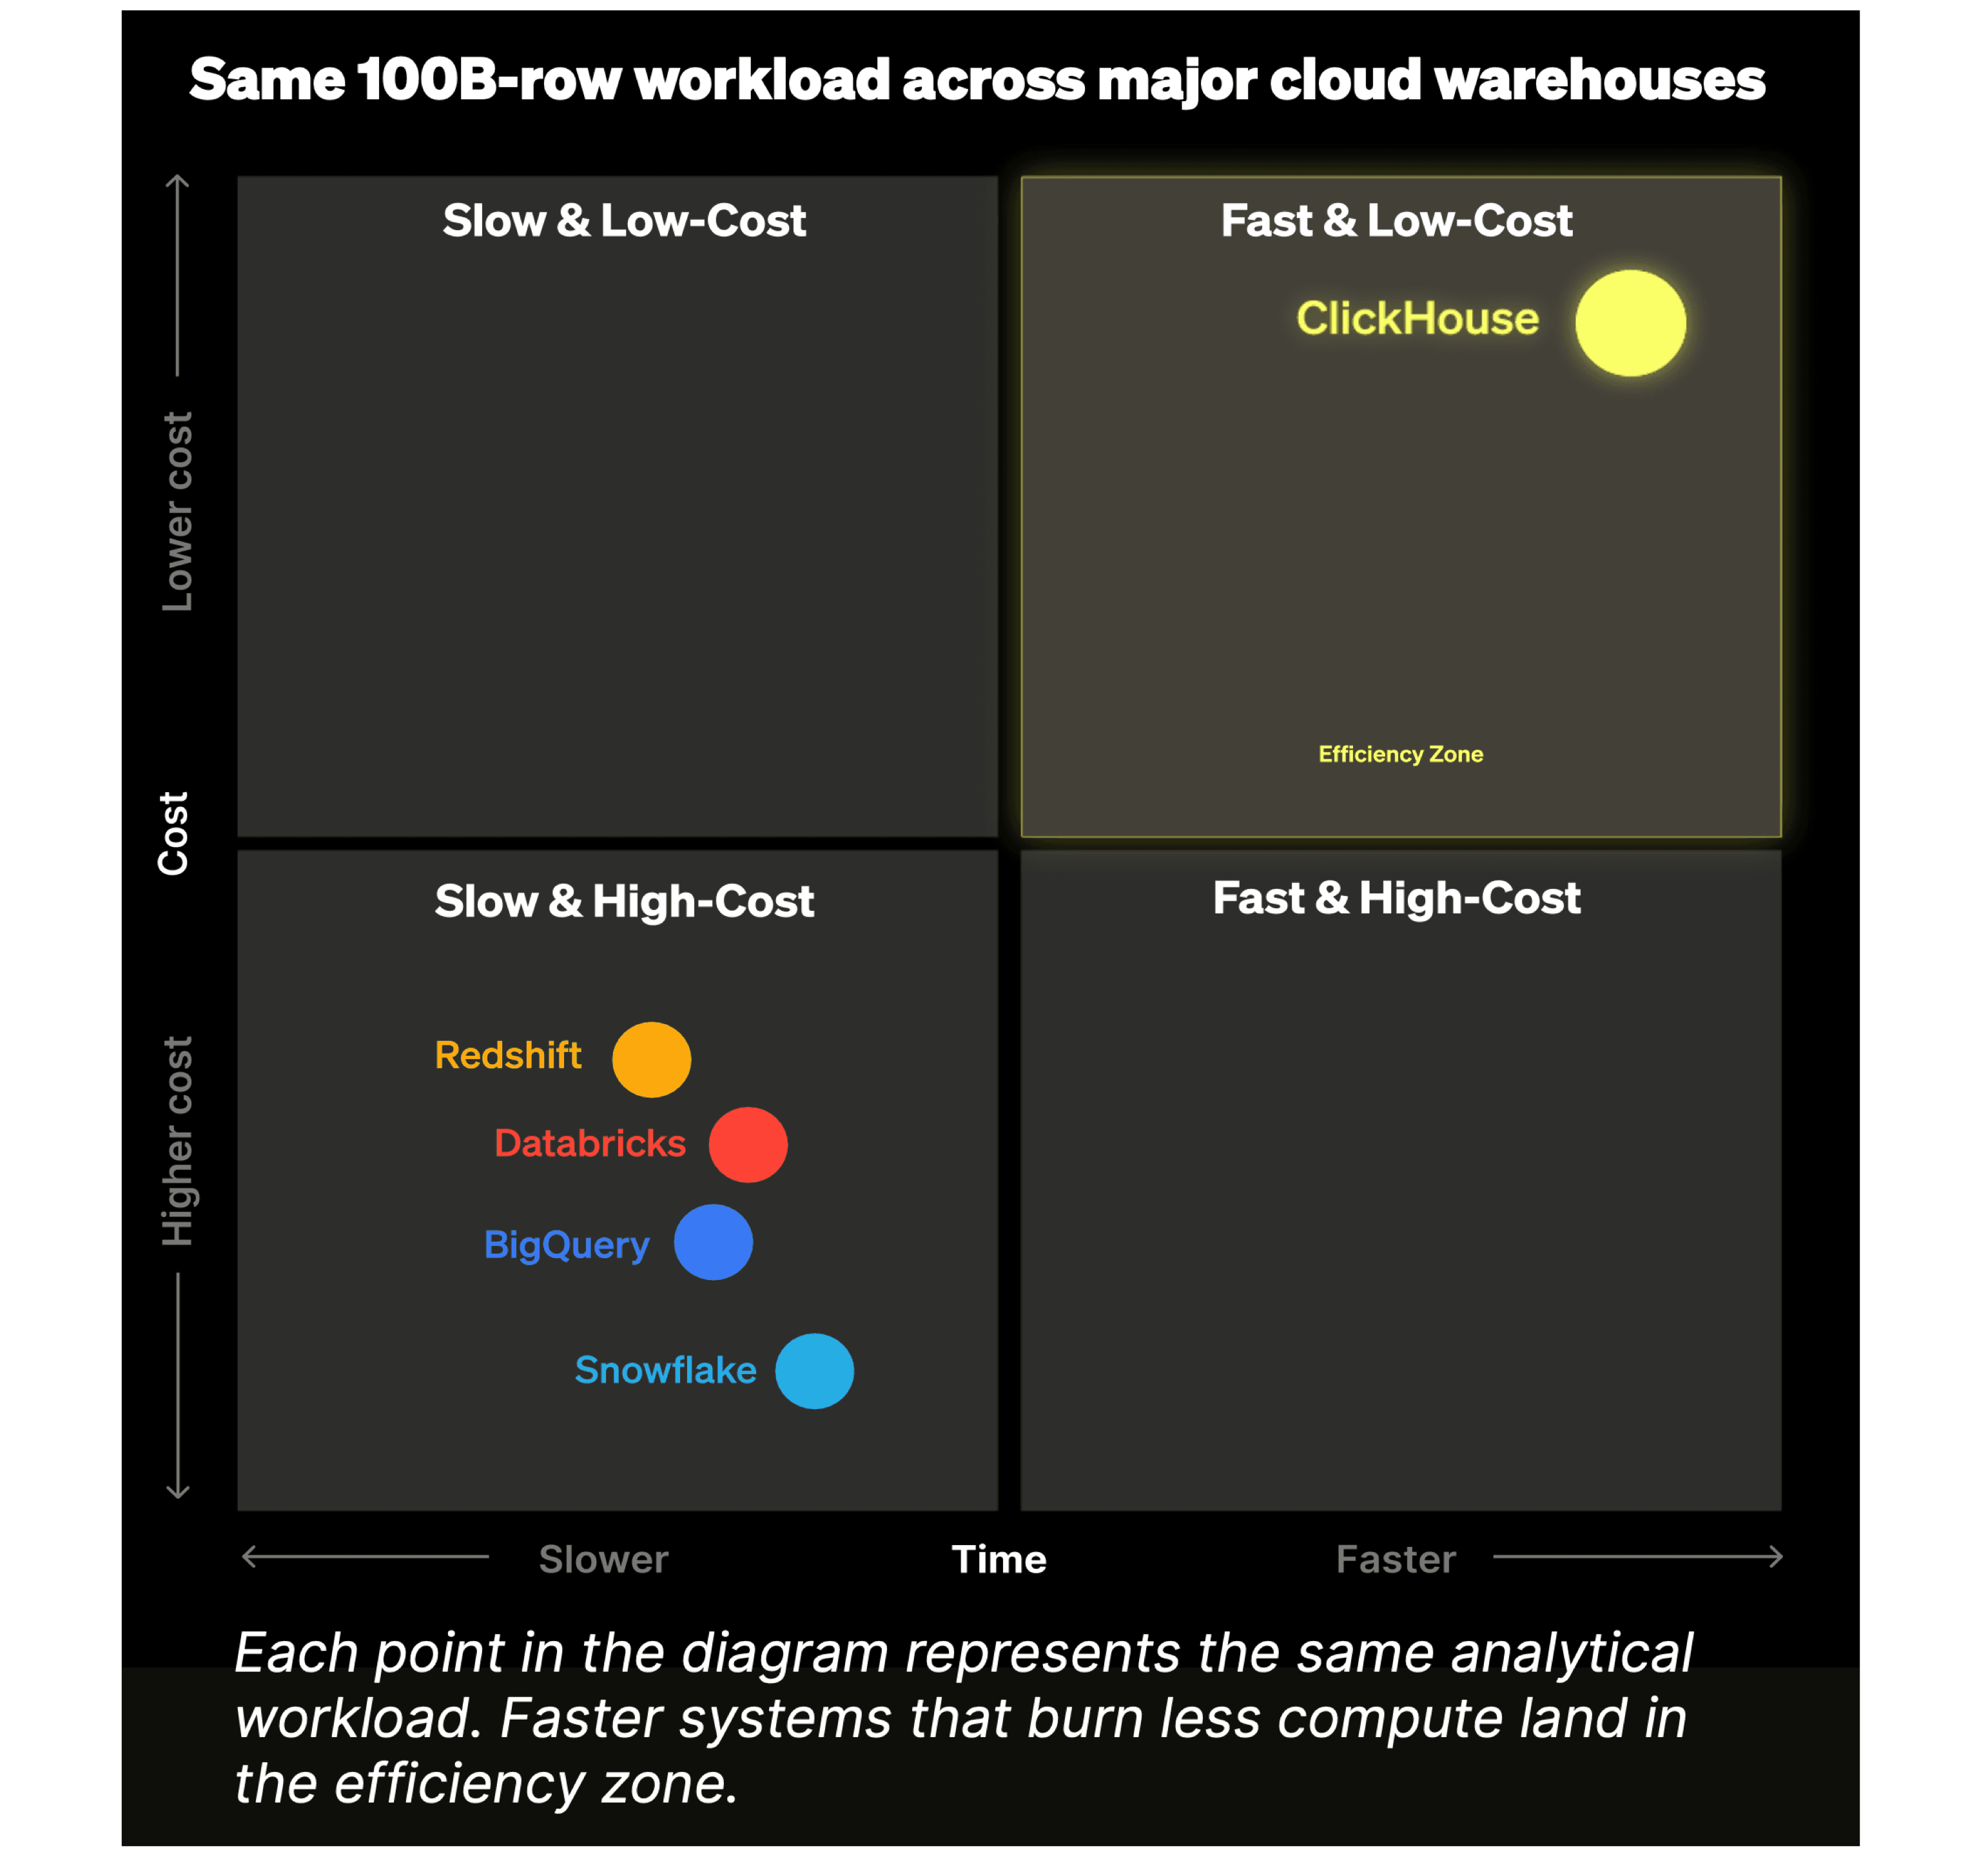
ClickHouse Cloudは、データ規模が拡大しても「高速かつ低コスト」のゾーンに留まる唯一のシステムです。最も近い競合でもコストパフォーマンスで23倍劣ります。
これこそがCostBenchの価値です。ベンダー固有のランタイムや課金モデルを、チームがプラットフォームを選ぶ際に活用できる結果へと変換します。
## 設計からしてオープンかつ再現可能
CostBenchはオープンです。なぜなら、コストパフォーマンスに関する主張は検証可能であるべきだからです。
このベンチマークは、ワークロード、スクリプト、構成、価格の前提、生のJSON結果、方法論をすべて公開しています。結果が意外に見えた場合は、それを生み出したセットアップを実際に検証できます。
## 試してみる
[ClickHouseベンチマークハブ](https://clickhouse.com/benchmarks)で結果を確認したり、生データを調べたり、[CostBenchリポジトリ](https://github.com/ClickHouse/CostBench)をクローンして自分でベンチマークを実行することができます。
コストパフォーマンスはブラックボックスであってはなりません。CostBenchはそれを検証可能にします。