---
title: "ClickHouse と Parquet: 高速なレイクハウス分析の基盤"
date: "2026-09-25T07:20:59.353Z"
author: "Tom Schreiber"
category: "Engineering"
excerpt: "ClickHouse は、Iceberg や Delta Lake などのオープンテーブルフォーマットを支えるストレージ形式である Parquet を高速に処理するよう設計されています。本記事では、その高速性を実現するクエリエンジンの仕組みと今後の展開を詳しく解説します。"
---
# ClickHouse と Parquet: 高速なレイクハウス分析の基盤
> **TL;DR**
ClickHouse は、Iceberg や Delta Lake などのオープンテーブルフォーマットを支えるストレージフォーマットである Parquet を高速に処理できるよう構築されており、長年にわたって最適化を重ねてきました。
**本記事ではクエリエンジンの内部を詳しく掘り下げ**、多くのシステムが自社のネイティブフォーマットをクエリするよりも高速に、Parquet ファイルを直接(取り込み不要で)クエリできる仕組みと、さらなる高速化に向けた今後の展望を解説します。
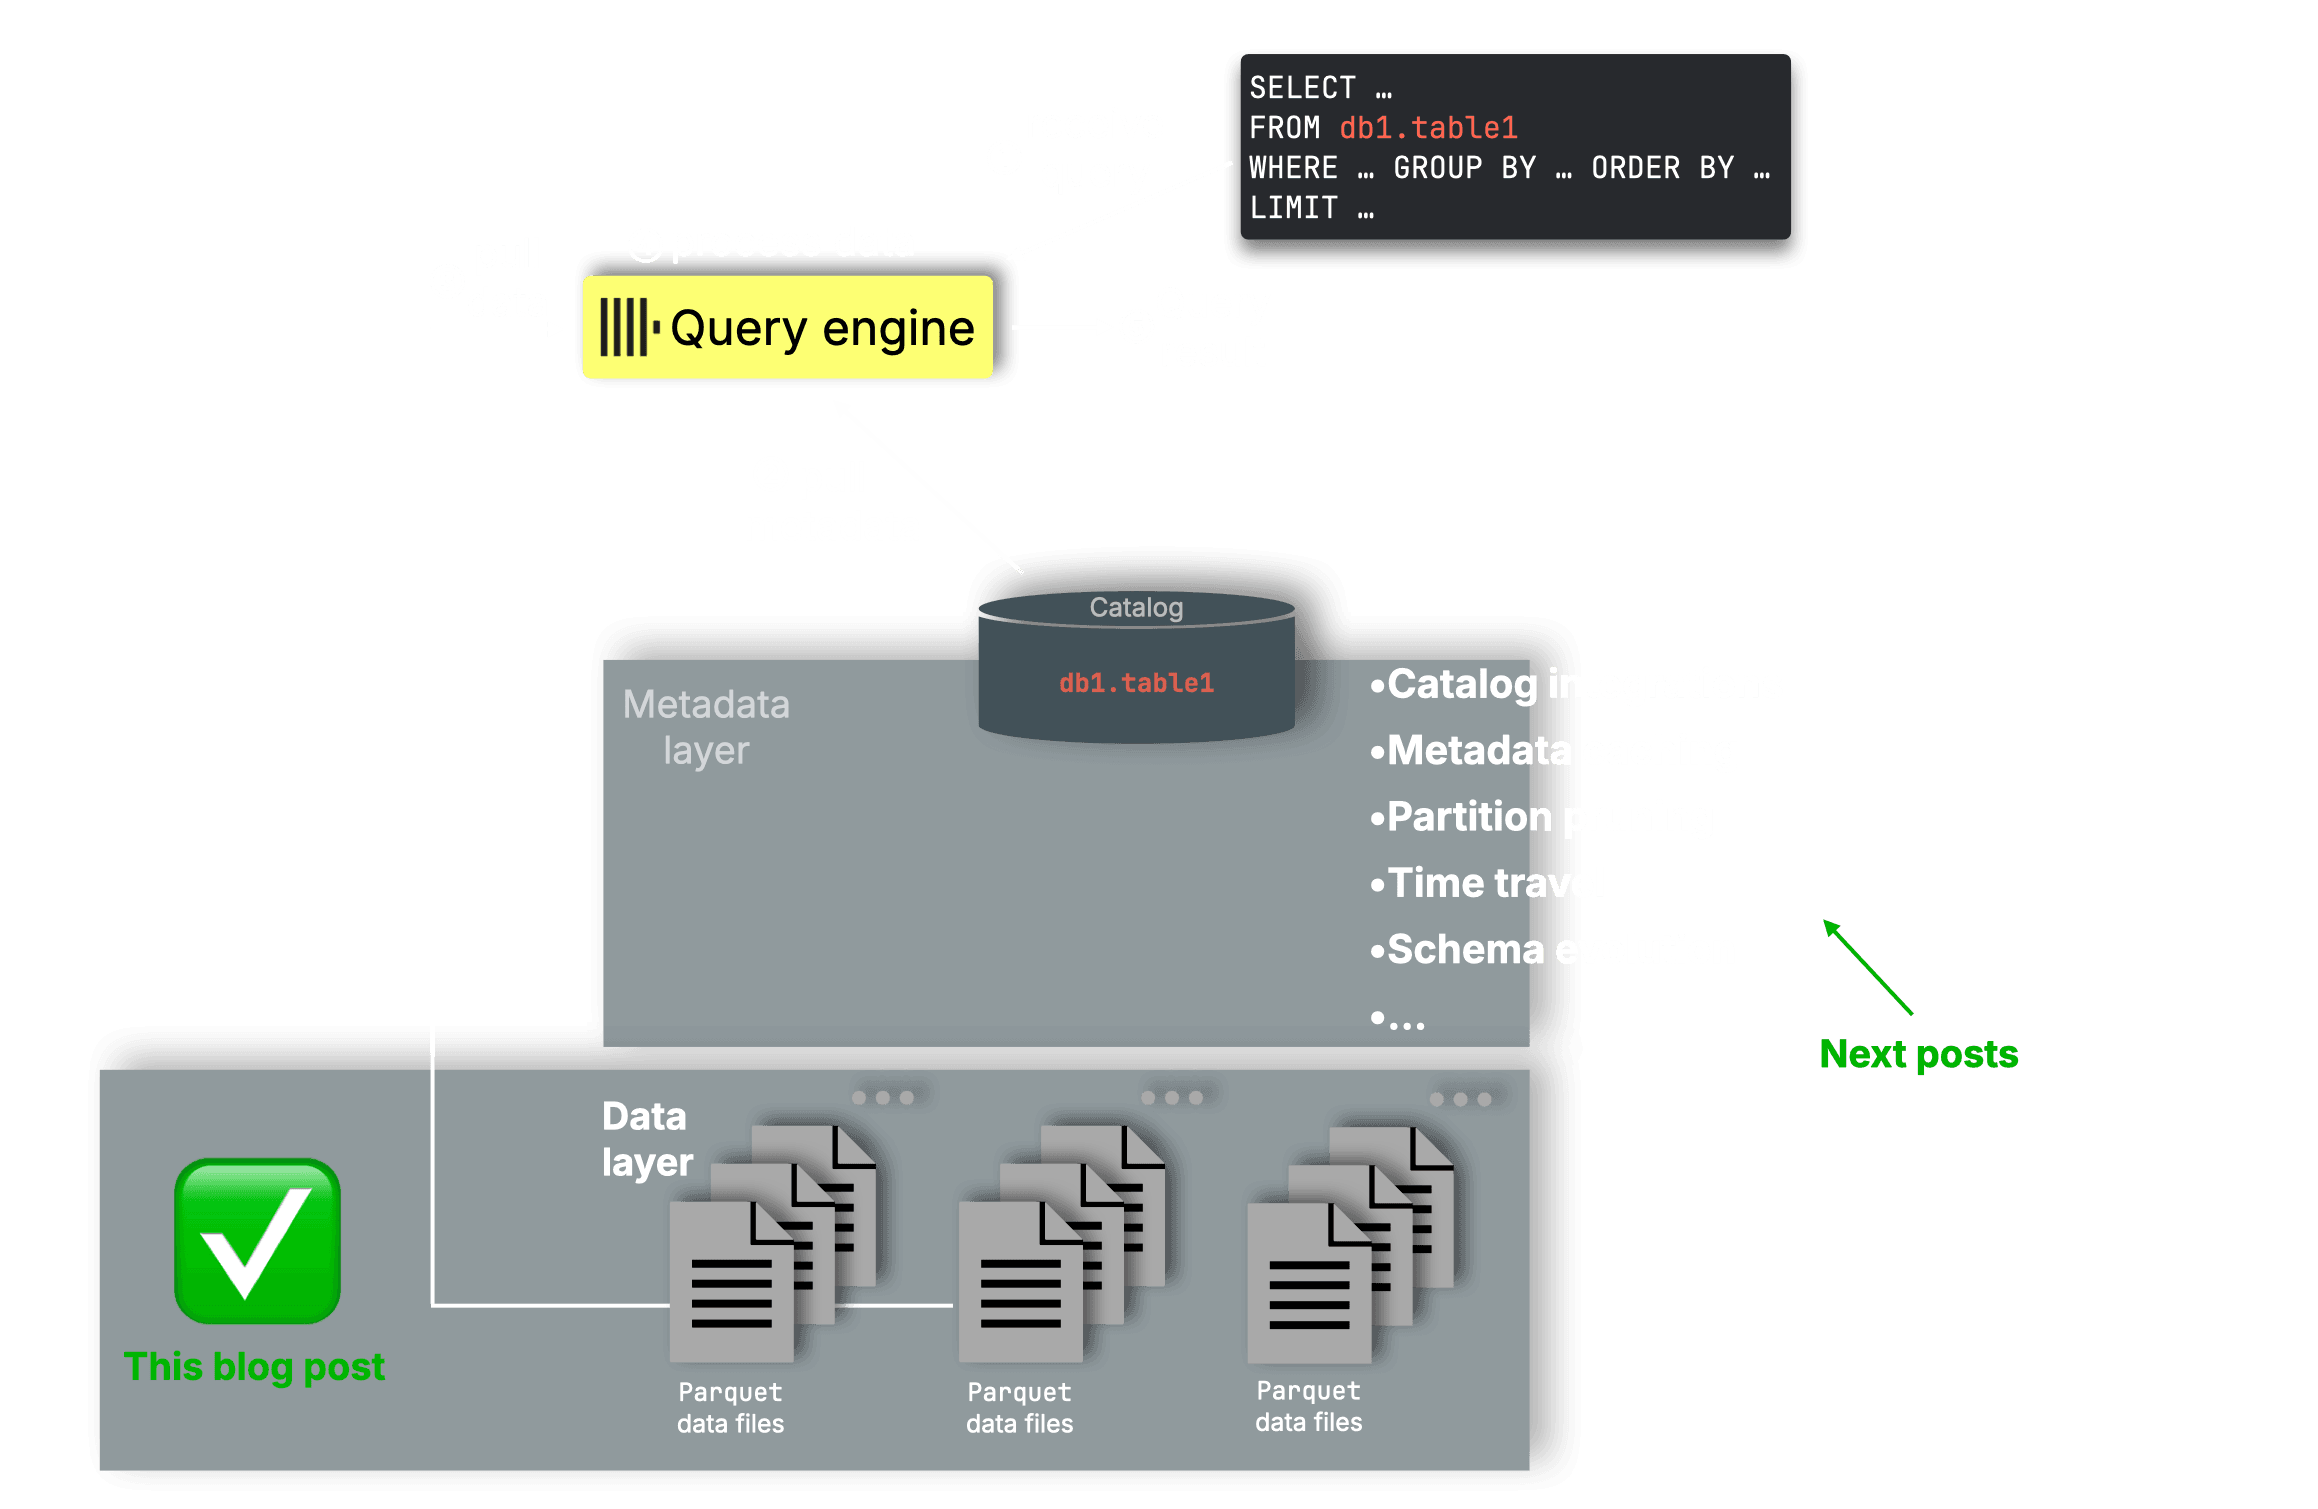
本記事は、ClickHouse がいかにして高速なレイクハウス分析を一から支えているかを紹介する新シリーズの第 1 回です。
**結論から言えば、ClickHouse はレイクハウスに対応しつつあるのではなく、すでに完全に対応しています。**
## 偶然と必然が生んだ、レイクハウス対応エンジン
時に、未来のほうがすでに実践していたことに追いついてくることがあります。
ClickHouse は[レイクハウス](https://en.wiktionary.org/wiki/data_lakehouse)向けに開発されたわけではありません(Iceberg や Delta Lake フォーマットが登場した時点で、ClickHouse はすでに成熟した DBMS でした)。しかし、結果として完璧な相性を発揮することになりました。Parquet への最高水準のサポートと直接ファイルクエリ機能により、ClickHouse は以前から多くのレイクハウススタイルのパターンをネイティブでサポートしてきました。
ClickHouse の[クエリエンジン](https://clickhouse.com/docs/ja/concepts/core-concepts/academic-overview)は、オブジェクトストレージを含むあらゆる場所から、Parquet を含むあらゆるフォーマットのデータをクエリすることを、常にコア機能として位置づけてきました。データを取り込む場合でも、取り込まずに直接クエリする場合でも、それは以前から当たり前の動作でした。
現代のレイクハウスアーキテクチャは、ClickHouse がすでに長年実践してきたこと、すなわち「どこでも実行でき、あらゆるものをクエリでき、どこからでもデータにアクセスできる」という点に名前をつけたにすぎません。
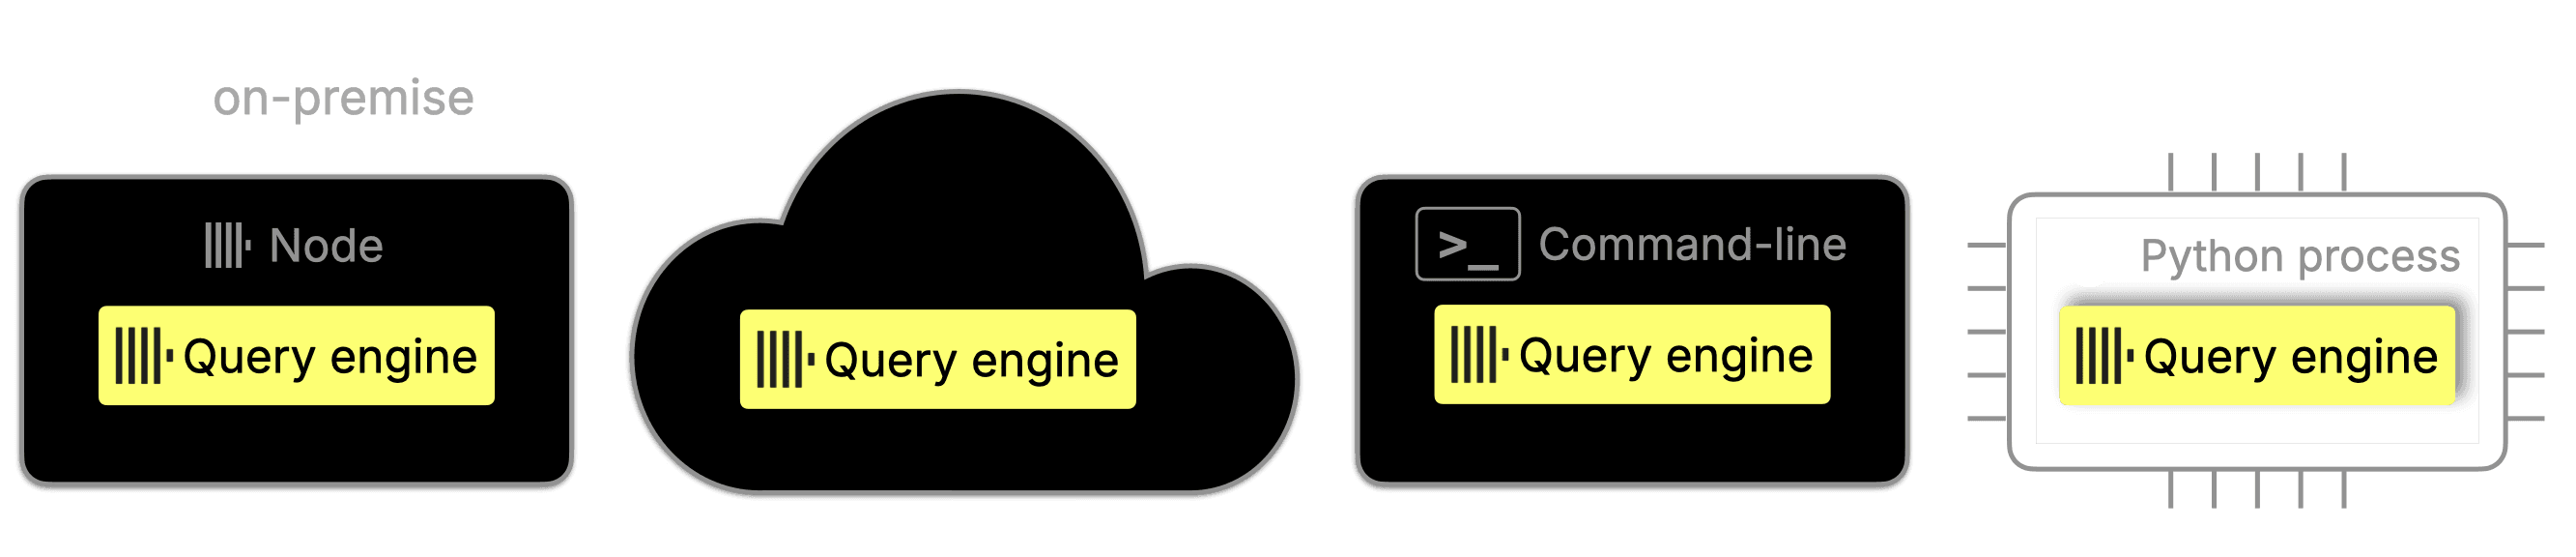
**どこでも実行**: エンジンは、オンプレミス、クラウド、スタンドアロン、インプロセスの各モードで[運用](https://www.youtube.com/watch?v=EOXEW_-r10A)できます。
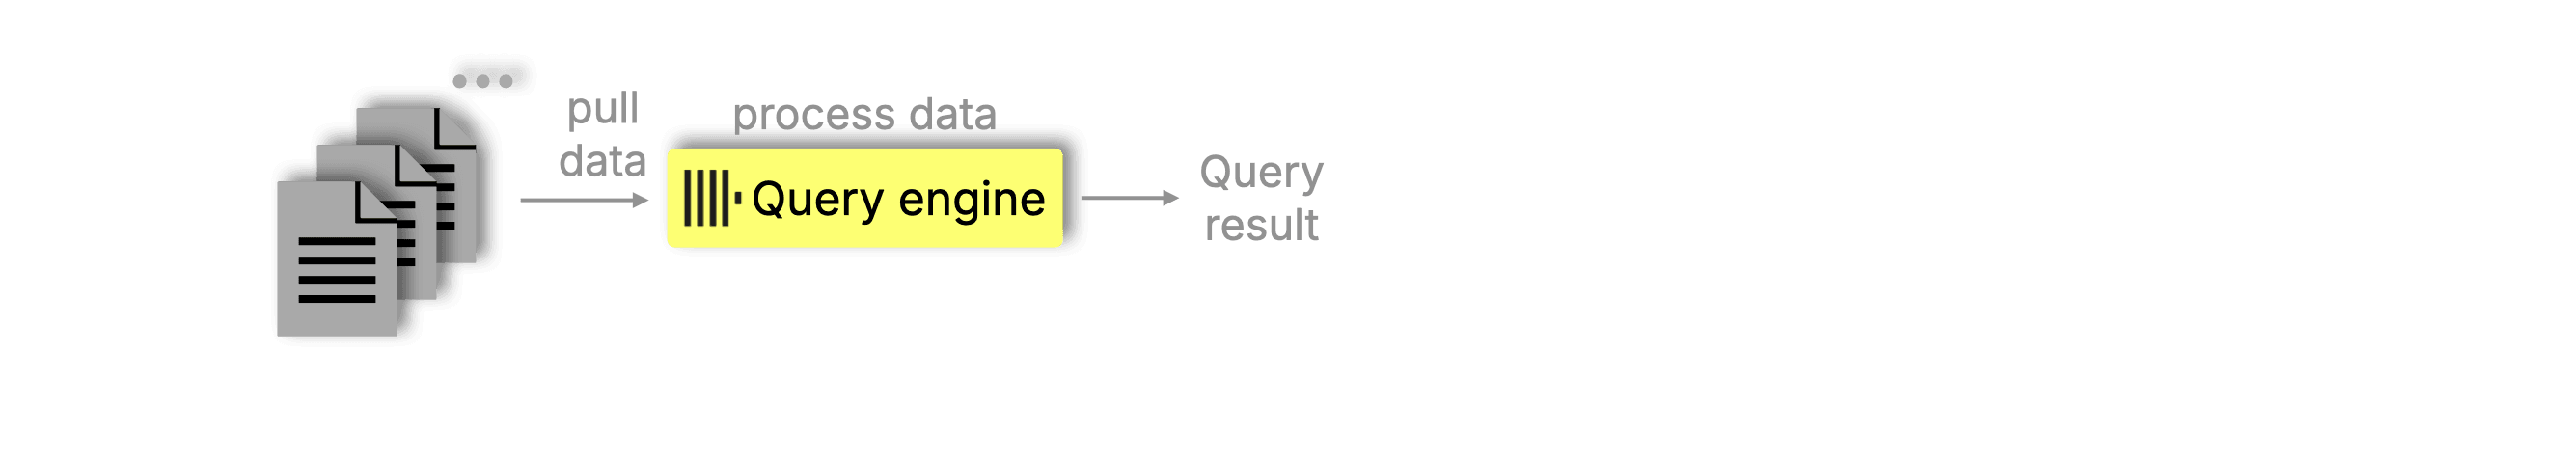
**あらゆるものをクエリ**: ネイティブの [MergeTree テーブル](https://clickhouse.com/docs/ja/concepts/core-concepts/parts)向けに最適化されている一方で、ClickHouse は外部フォーマットも最初に取り込むことなく直接クエリできます。大半のデータベースでは、クエリを実行する前に Parquet などのファイルを独自のネイティブフォーマットに取り込む必要があります。ClickHouse ではその工程を完全に省くことができ、クエリエンジンは標準で [70 以上のファイルフォーマット](https://sql.clickhouse.com/?query=U0VMRUNUICogCkZST00gc3lzdGVtLmZvcm1hdHMKV0hFUkUgaXNfaW5wdXQKT1JERVIgQlkgbmFtZTs&chart=eyJ0eXBlIjoibGluZSIsImNvbmZpZyI6eyJ4YXhpcyI6InllYXIiLCJ5YXhpcyI6Ijk5dGhfYXZnX3RlbXAiLCJzZXJpZXMiOiJjb3VudHJ5IiwidGl0bGUiOiJUZW1wZXJhdHVyZSBieSBjb3VudHJ5IGFuZCB5ZWFyIn19&run_query=true&tab=results)を制限なく直接クエリできます。JOIN、ウィンドウ関数、[160 以上の集約関数](https://sql.clickhouse.com/?query=U0VMRUNUICogCkZST00gc3lzdGVtLmZ1bmN0aW9ucwpXSEVSRSBpc19hZ2dyZWdhdGUKQU5EIGVtcHR5KGFsaWFzX3RvKQpPUkRFUiBCWSBuYW1l&chart=eyJ0eXBlIjoibGluZSIsImNvbmZpZyI6eyJ4YXhpcyI6InllYXIiLCJ5YXhpcyI6Ijk5dGhfYXZnX3RlbXAiLCJzZXJpZXMiOiJjb3VudHJ5IiwidGl0bGUiOiJUZW1wZXJhdHVyZSBieSBjb3VudHJ5IGFuZCB5ZWFyIn19&run_query=true&tab=results)を含む完全な SQL サポートを、すべて**データを事前に取り込むことなく**利用可能です。サポートされているフォーマットには、Parquet、JSON、CSV、Arrow などが多数含まれます。
**どこからでもデータにアクセス**: [80 以上の組み込み連携機能](https://sql.clickhouse.com/?query=V0lUSCBib3RoIEFTICgKICAgICAgICBTRUxFQ1QgbmFtZSwgJ1RhYmxlIGZ1bmN0aW9uJyBhcyBjYXRlZ29yeQogICAgICAgIEZST00gc3lzdGVtLnRhYmxlX2Z1bmN0aW9ucyAKICAgIFVOSU9OIEFMTAogICAgICAgIFNFTEVDVCBuYW1lLCAnVGFibGUgZW5naW5lJyBhcyBjYXRlZ29yeQogICAgICAgIEZST00gc3lzdGVtLnRhYmxlX2VuZ2luZXMKKQpTRUxFQ1QgKiAKRlJPTSBib3RoCldIRVJFIAogICAgTk9UIG5hbWUgaWxpa2UgJyVtZXJnZVRyZWUlJyBBTkQKICAgIE5PVCBuYW1lIGlsaWtlICcldmlldyUnIEFORAogICAgTk9UIG5hbWUgaWxpa2UgJyV2YWx1ZXMlJyBBTkQKICAgIE5PVCBuYW1lIGlsaWtlICclemVyb3MlJyBBTkQKICAgIE5PVCBuYW1lIGlsaWtlICclY29zbiUnIEFORAogICAgTk9UIG5hbWUgaWxpa2UgJyVjb3NuJScgQU5ECiAgICBOT1QgbmFtZSBpbGlrZSAnJWJ1ZmZlciUnIEFORAogICAgTk9UIG5hbWUgaWxpa2UgJyVyZXBsaWNhJScgQU5ECiAgICBOT1QgbmFtZSBpbGlrZSAnJWRpc3RyaWJ1dGVkJScgQU5ECiAgICBOT1QgbmFtZSBpbGlrZSAnJWpzb24lJyBBTkQKICAgIE5PVCBuYW1lIGlsaWtlICclcmFuZG9tJScgQU5ECiAgICBOT1QgbmFtZSBpbGlrZSAnJW1lcmdlJSdBTkQKICAgIE5PVCBuYW1lIGlsaWtlICclbnVsbCUnQU5ECiAgICBOT1QgbmFtZSBpbGlrZSAnJW51bWJlcnMlJ0FORAogICAgTk9UIG5hbWUgaWxpa2UgJyVvc3MlJ0FORAogICAgTk9UIG5hbWUgSU4gWydjbHVzdGVyJywgJ2Zvcm1hdCcsICdpbnB1dCcsICdKb2luJywgJ0tlZXBlck1hcCcsICdMb2cnLCAnTWVtb3J5JywgJ1NldCcsICdTdHJpcGVMb2cnLCAnVGlueUxvZyddICAgIApPUkRFUiBCWSBsb3dlcihuYW1lKQ&chart=eyJ0eXBlIjoibGluZSIsImNvbmZpZyI6eyJ4YXhpcyI6InllYXIiLCJ5YXhpcyI6Ijk5dGhfYXZnX3RlbXAiLCJzZXJpZXMiOiJjb3VudHJ5IiwidGl0bGUiOiJUZW1wZXJhdHVyZSBieSBjb3VudHJ5IGFuZCB5ZWFyIn19&run_query=true&tab=results)により、エンジンは外部システムや、S3、GCP、Azure のオブジェクトストレージなどのストレージプラットフォームとシームレスに接続します。
これらの機能により、ClickHouse は[データレイク](https://en.wiktionary.org/wiki/data_lake#English)に最適な選択肢となっています。通常 S3 や GCS などのオブジェクトストレージ上で、主に **Parquet ファイル**としてデータを[格納](https://iceberg.apache.org/spec/?h=parquet#parquet)する [Apache Iceberg](https://iceberg.apache.org/) などのオープンテーブルフォーマットをクエリできます。

また、柔軟な実行モードのおかげで、ClickHouse クエリエンジンはレイクハウスが存在するあらゆる場所にデプロイできます。オブジェクトストレージの近く、マルチテナント SaaS 環境の内部、pandas データフレームを使用してノートブックで対話型分析を行う Python ワークフローへの組み込み、さらには AWS Lambda などの環境におけるステートレスなワーカーとしてもデプロイ可能です。
## エンジンの内部:ClickHouse が Parquet をクエリする仕組み
レイクハウスにおける極めて重要な構成要素の 1 つである [Parquet](https://parquet.apache.org/) を、ClickHouse がどのように処理しているのかを詳しく見てみましょう。
* 現在の ClickHouse エンジンは、Parquet ファイルをどれほど効率的に直接クエリできるのか?
* ネイティブの MergeTree テーブルと比較した場合の性能はどの程度か?
* ClickHouse がサポートする 70 以上の外部フォーマットの中に、さらに高速なフォーマットはあるのか?
* さらなる向上のために、今後はどのような機能が予定されているのか?
本記事ではこれらすべてに回答し、高速かつ柔軟なレイクハウスエンジンとしての ClickHouse を扱う新しいブログシリーズをスタートします。まずは、Iceberg や [Delta Lake](https://delta.io/) などのオープンテーブルフォーマットの基盤となる **Parquet データレイヤー**から取り上げます。
はじめに、現在の Parquet リーダーの仕組みと、それが高速である理由を検証します。続いて、実際の分析クエリを用いてベンチマークを実施し、現在の性能と今後の改善点について解説します。
冒頭で触れたように、ClickHouse クエリエンジンは取り込みを行わずに Parquet を含む 70 以上のファイルフォーマットの直接クエリをサポートしています。以下に示すように、[フォーマット固有のリーダー](https://github.com/ClickHouse/ClickHouse/tree/775b7d30c814bf9f28614b472d4ae8c10b39fa92/src/Processors/Formats/Impl)がエンジンに組み込まれています。
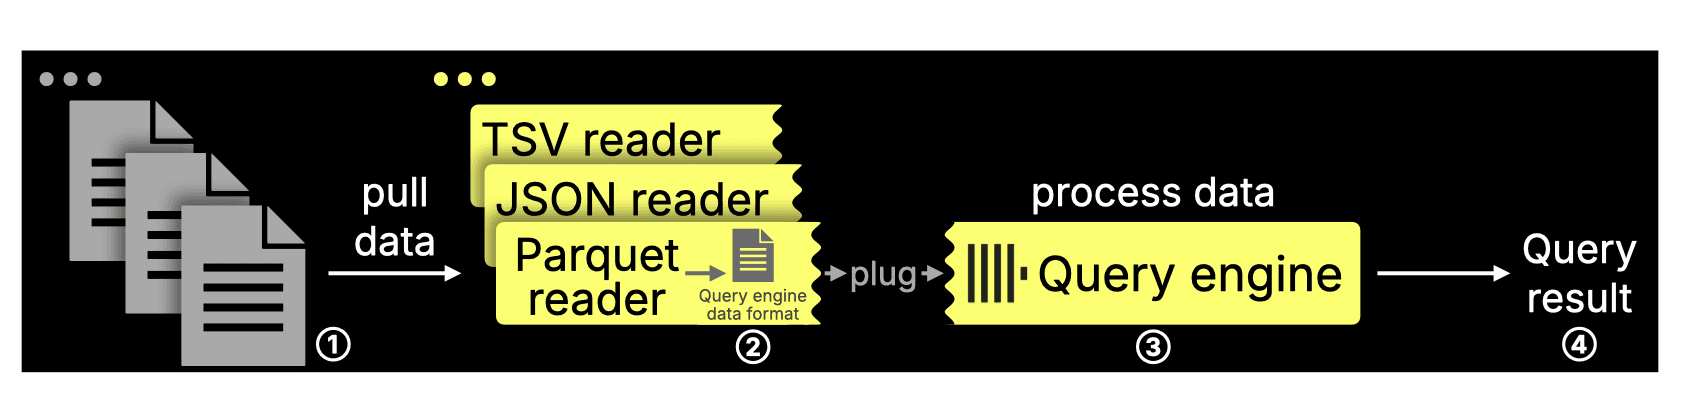
① 外部ファイルをクエリする際、フォーマット固有のリーダーがデータを読み取ってパースし、② ClickHouse のインメモリフォーマットへ変換してクエリエンジンに渡します。そしてクエリエンジンが ③ 処理を実行し、④ 最終結果を出力します。
本セクションの以降では、Parquet リーダーに焦点を当てます。Parquet リーダーは ClickHouse クエリエンジンと組み合わさることで、Parquet ファイルの直接クエリにおける高いパフォーマンスを支える中核コンポーネントとなっています。
### 現在の Parquet リーダーの仕組みと今後の展望
興味深い事実として、MergeTree がネイティブのデータストレージフォーマットであることに変わりはありませんが、ClickHouse は 3 年以上にわたって Parquet 向けのチューニングと最適化を積極的に進めてきました。これはすべて、大規模な Parquet クエリにおいて ClickHouse を世界最速のエンジンにするという目標の一環です。
[現在の Parquet リーダー](https://github.com/ClickHouse/ClickHouse/blob/775b7d30c814bf9f28614b472d4ae8c10b39fa92/src/Processors/Formats/Impl/ParquetBlockInputFormat.h#L14)は、[Arrow ライブラリ](https://github.com/apache/arrow/tree/main/cpp)を使用してファイルを [Arrow](https://arrow.apache.org/) フォーマットへとパースし、実行のためにデータを ClickHouse ネイティブのインメモリフォーマットへ[コピー](https://github.com/ClickHouse/ClickHouse/blob/775b7d30c814bf9f28614b472d4ae8c10b39fa92/src/Processors/Formats/Impl/ArrowColumnToCHColumn.cpp)します。続くセクションでは、このリーダーの機能について詳しく見ていきます。
現在、Arrow レイヤーを完全に排除し、ファイルを直接 ClickHouse ネイティブのインメモリフォーマットへと読み込む新しいネイティブ Parquet リーダーの[開発](https://github.com/ClickHouse/ClickHouse/pull/78380)が進められています。これにより、並列性と I/O 効率も向上します。このプロジェクトは、その名のとおり **Yet Another Parquet Reader**(もうひとつの Parquet リーダー)と呼ばれています。まさにその言葉どおり、ClickHouse にとって 3 番目のネイティブ Parquet リーダー実装となるためです。最初の実装(`input_format_parquet_use_native_reader`)は着手されたものの完成には至りませんでした。2 番目(v2)は [プルリクエスト](https://github.com/ClickHouse/ClickHouse/pull/70611) まで進みましたが、プロダクション環境への導入前に停滞しました。そして現在、[v3](https://github.com/ClickHouse/ClickHouse/pull/78380) が進行中です。
> 新しいリーダーが完成するまで本記事の公開を待つこともできましたが、現行リーダーのベンチマークを取得しておくことは優れたベースラインになります。今後の続編記事では、新しいリーダーによってパフォーマンスと効率がどのように向上するかを取り上げる予定です。
ClickHouse における Parquet ファイルのクエリ性能は、主に以下の 2 つの要因によって決まります。
1. **並列度の高さ**: ClickHouse が並列で読み取りおよび処理できるファイル数、ならびにそれらのファイル内の重複しない領域の数が多いほど、スループットが向上し、クエリはより高速に完了します。
2. **I/O 削減の度合い**: 不要な作業(無関係なデータのスキャンや処理など)を減らすほど、クエリはより高速に完了します。
続く 2 つのセクションでは、クエリエンジンと現行の Parquet リーダーがどのように連携して並列性と I/O 削減を実現しているかを分析し、ネイティブリーダーでの今後の改善点についても紹介します。また、パフォーマンスチューニングのためにこれらの動作を制御できる設定項目についても解説します。
### 並列処理:エンジンがいかにスケールするか
ClickHouse が現在 Parquet ファイルのクエリ時にどのように並列処理を実現しているかを説明する前に、まず Parquet ファイルのディスク上の物理構造を簡単に確認しておく必要があります。Parquet がデータをどのように構造化しているかは、データを独立した作業単位へとどれだけ効率的に分割できるか、ひいてはクエリ実行時にどれだけの並列度を適用できるかを根本的に左右します。
以下の図は、ディスク上に Parquet ファイルとして格納されたウェブアナリティクスデータセット(後のベンチマークで使用)のデータ[構造](https://parquet.apache.org/docs/file-format/)を簡略化して示したものです。
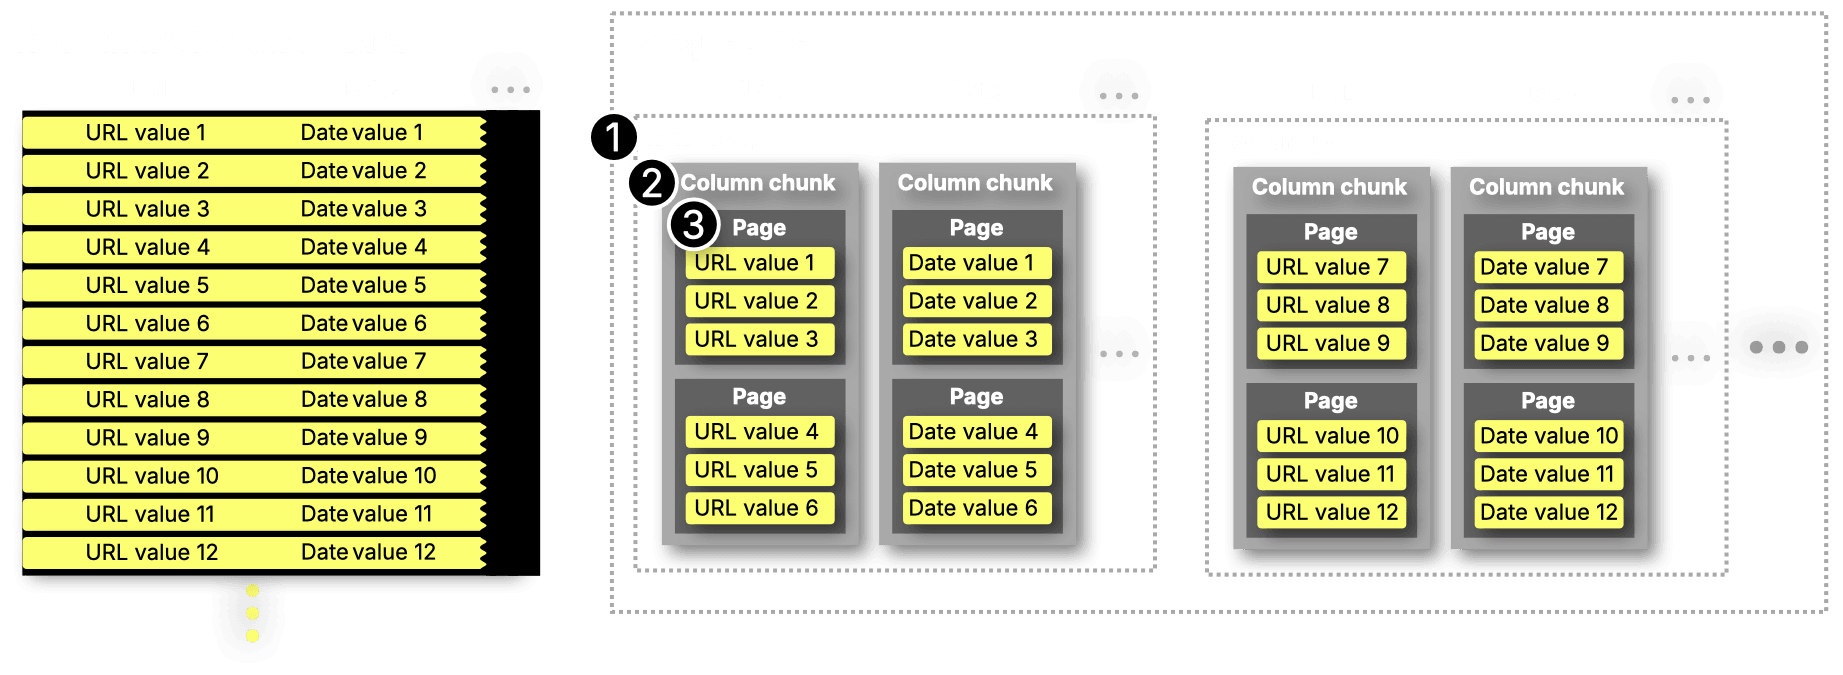
Parquet では、論理的に行とカラムで構成される[テストデータセット](/ja/blog/clickhouse-and-parquet-a-foundation-for-fast-lakehouse-analytics-jp)が、1 つまたは複数の**ファイル**に格納されます。各ファイルはデータを以下のように階層構造で管理します。
① **行グループ(Row groups)**: 格納されるデータは、行グループと呼ばれる 1 つ以上の水平方向のパーティションに分割されます。ClickHouse で Parquet ファイルを書き出す場合、デフォルトでは各行グループに [100 万行](https://clickhouse.com/docs/ja/reference/settings/formats)または[約 500 MB のデータ](https://clickhouse.com/docs/ja/reference/settings/formats)(圧縮前)が含まれます。
② **カラムチャンク(Column chunks)**: 各行グループは、データセット内のカラムごとに、垂直方向のカラムチャンクへとさらに分割されます。各チャンクには、該当する行グループ内の全行にわたるそのカラムの値が格納されます。
③ **データページ(Data pages)**: 各カラムチャンクの内部では、実際の値がデータページに格納されます。デフォルトでは、ClickHouse は [1 MB](https://clickhouse.com/docs/ja/reference/settings/formats)(圧縮前)のデータページを書き込みます。ページには、カラムのデータ型と使用されているエンコーディング方式に応じて、固定数または可変数の[エンコード](https://parquet.apache.org/docs/file-format/data-pages/encodings/)および[圧縮](https://parquet.apache.org/docs/file-format/data-pages/compression/)された値が格納されます。
注: わかりやすさを重視し、上図では行グループに 6 行、データページにカラムあたり 3 つの値が含まれる構成として示しています。
データ配置が明確になったところで、ClickHouse クエリエンジンが現行の Parquet リーダーと連携し、クエリ性能を最大化するために利用可能な CPU コア全体へデータ処理をどのように並列化しているかを見ていきましょう。
ClickHouse は、どこでも実行できてあらゆるものをクエリできるだけでなく、特に Parquet のクエリ時には**ほぼすべての処理を並列化**します。以下の図は、クエリ実行中に Parquet リーダーと ClickHouse クエリエンジンの内部で、さまざまなレイヤーの並列処理がどのように組み合わさるかを示しています。
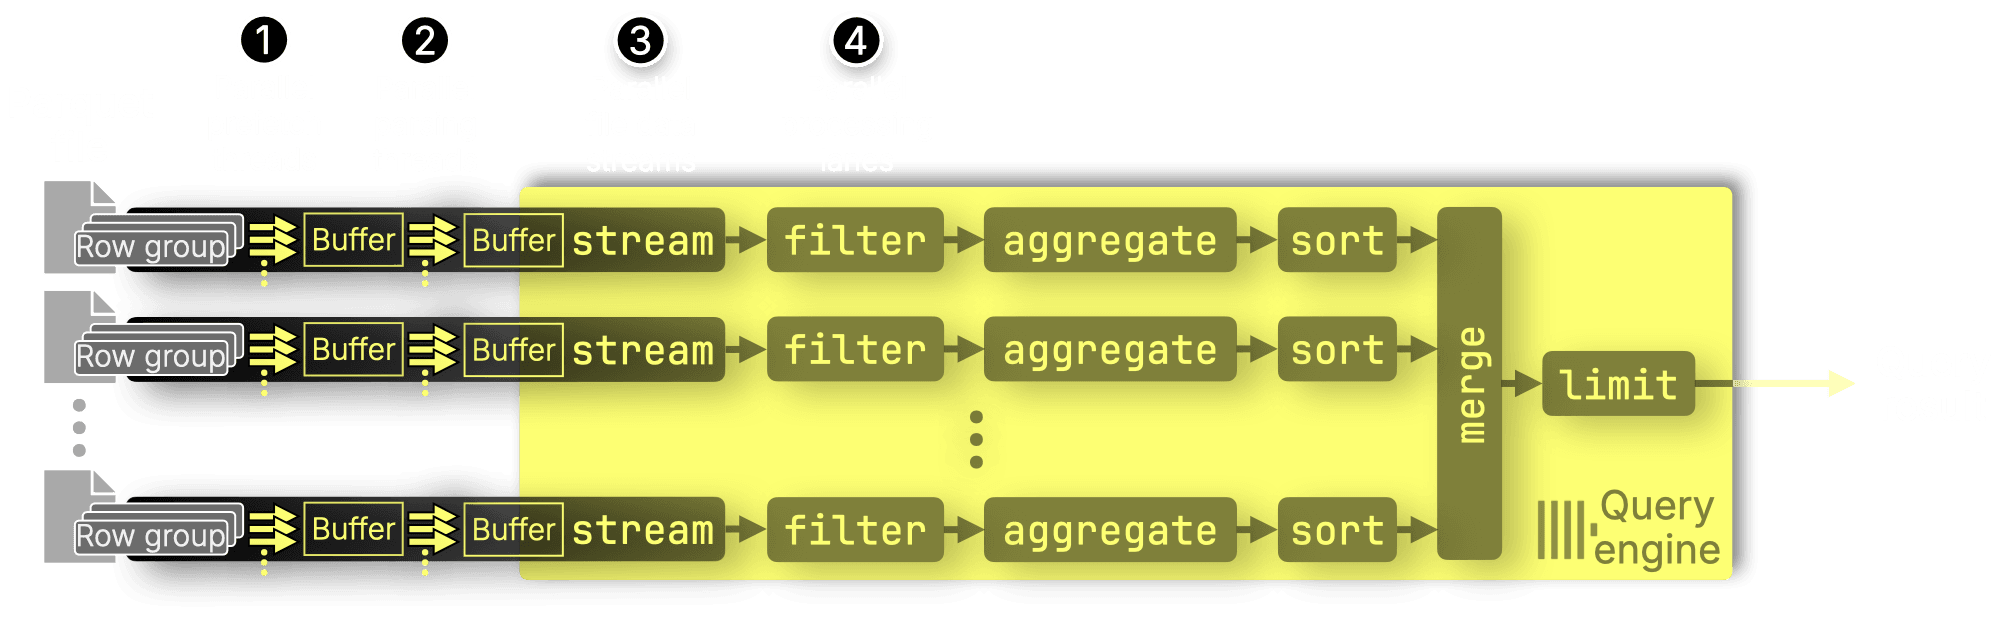
① **並列プリフェッチスレッド**: 単一の Parquet ファイル内において、Parquet ファイルリーダーは複数の行グループを並列で読み取ります(*ファイル内・行グループ間並列処理*)。デフォルトでは、行グループのプリフェッチが[有効](https://clickhouse.com/docs/ja/reference/settings/formats)になっており、4 つの並列プリフェッチスレッド([max_download_threads](https://clickhouse.com/docs/ja/reference/settings/session-settings) 設定で制御)が動作します。これは、パース処理が最大並列度に達した場合(後述)、あるいはネットワーク経由でデータを読み込む必要がある場合など、パース処理が停滞するおそれがある場合に機能します。
② **並列パーススレッド**: パーススレッドは、同一ファイル内の複数の行グループからデータを並列で読み取ってパースします(*ファイル内・行グループ間並列処理*)。プリフェッチが有効な場合はプリフェッチバッファから読み取り、そうでない場合はファイルから直接読み取ります。パーススレッドの数(すべてのファイルストリームの合計、後述)は [max_parsing_threads](https://clickhouse.com/docs/ja/reference/settings/session-settings) 設定で制御され、デフォルトでは利用可能な CPU コア数と一致します。
③ **並列ファイルストリーム**: 異なる Parquet ファイルが並行して処理され、各ファイルがそれぞれ独自の並列プリフェッチスレッドおよびパーススレッドを持つことで、ファイル全体でのスループットを最大化します(*ファイル間並列処理*)。ファイルストリームの数は、クエリのコンパイル時に動的に決定されます(後述)。
④ **並列処理レーン**: データが Parquet リーダーコンポーネントからクエリエンジンへと[ブロック](https://clickhouse.com/docs/ja/resources/develop-contribute/introduction/architecture#block)単位かつストリーミング形式で渡される際、最大限の同時実行性を得るために、フィルタリング、集約、ソートが独立した[レーン](https://clickhouse.com/docs/ja/concepts/core-concepts/query-parallelism#distributing-work-across-processing-lanes)全体で実行されます(オペレーター間およびオペレーター内並列処理)。並列処理レーンの数は [max_threads](https://clickhouse.com/docs/ja/reference/settings/session-settings) 設定によって決定され、デフォルトでは ClickHouse クエリエンジンが利用可能な CPU コア数と一致します。
多数の小さなファイルをクエリする場合でも、1 つの大きなファイルをクエリする場合でも、ClickHouse は Parquet ファイルの処理を自動的にバランス調整し、クエリ実行の効率を維持します。これを実現するため、Parquet ファイルを選択するために使用されたファイルパスパターン(例: [file テーブル関数](https://clickhouse.com/docs/ja/reference/functions/table-functions/file)など)はクエリコンパイル時に解決され、一致したファイル数(`num_files`)が物理クエリプランに直接反映されます。
* 多数の小さなファイルは、多数のファイルストリームにわたってファイルごとに 1 スレッドでパースされます。
* 1 つの大きなファイルは、単一ストリーム上で並列に動作する多数のスレッドによってパースされます。
この計算にはシンプルなルールが適用されます。
* 並列ファイルストリーム数 [=](https://github.com/ClickHouse/ClickHouse/blob/d66f2f168249888d7672045389350493a05a98fe/src/Storages/StorageFile.cpp#L1677-L1686) `min(max_threads, num_files)`
* 利用可能な並列パーススレッド(`max_parsing_threads`)は、[こちら](https://github.com/ClickHouse/ClickHouse/blob/d66f2f168249888d7672045389350493a05a98fe/src/Storages/StorageFile.cpp#L1442)の数式によって各ファイルストリームに均等に割り振られます: `max(max_parsing_threads / num_files, 1)`
ここで `/` は整数除算(端数切り捨て)を示し、`max()` は各ファイルに少なくとも 1 つのパーススレッドが割り当てられることを保証します。
ファイルストリームとパーススレッドのバランス調整が実際にどのように機能するか、3 つの例を挙げて簡単に見てみましょう。
### 実践における並列処理:3 つの例
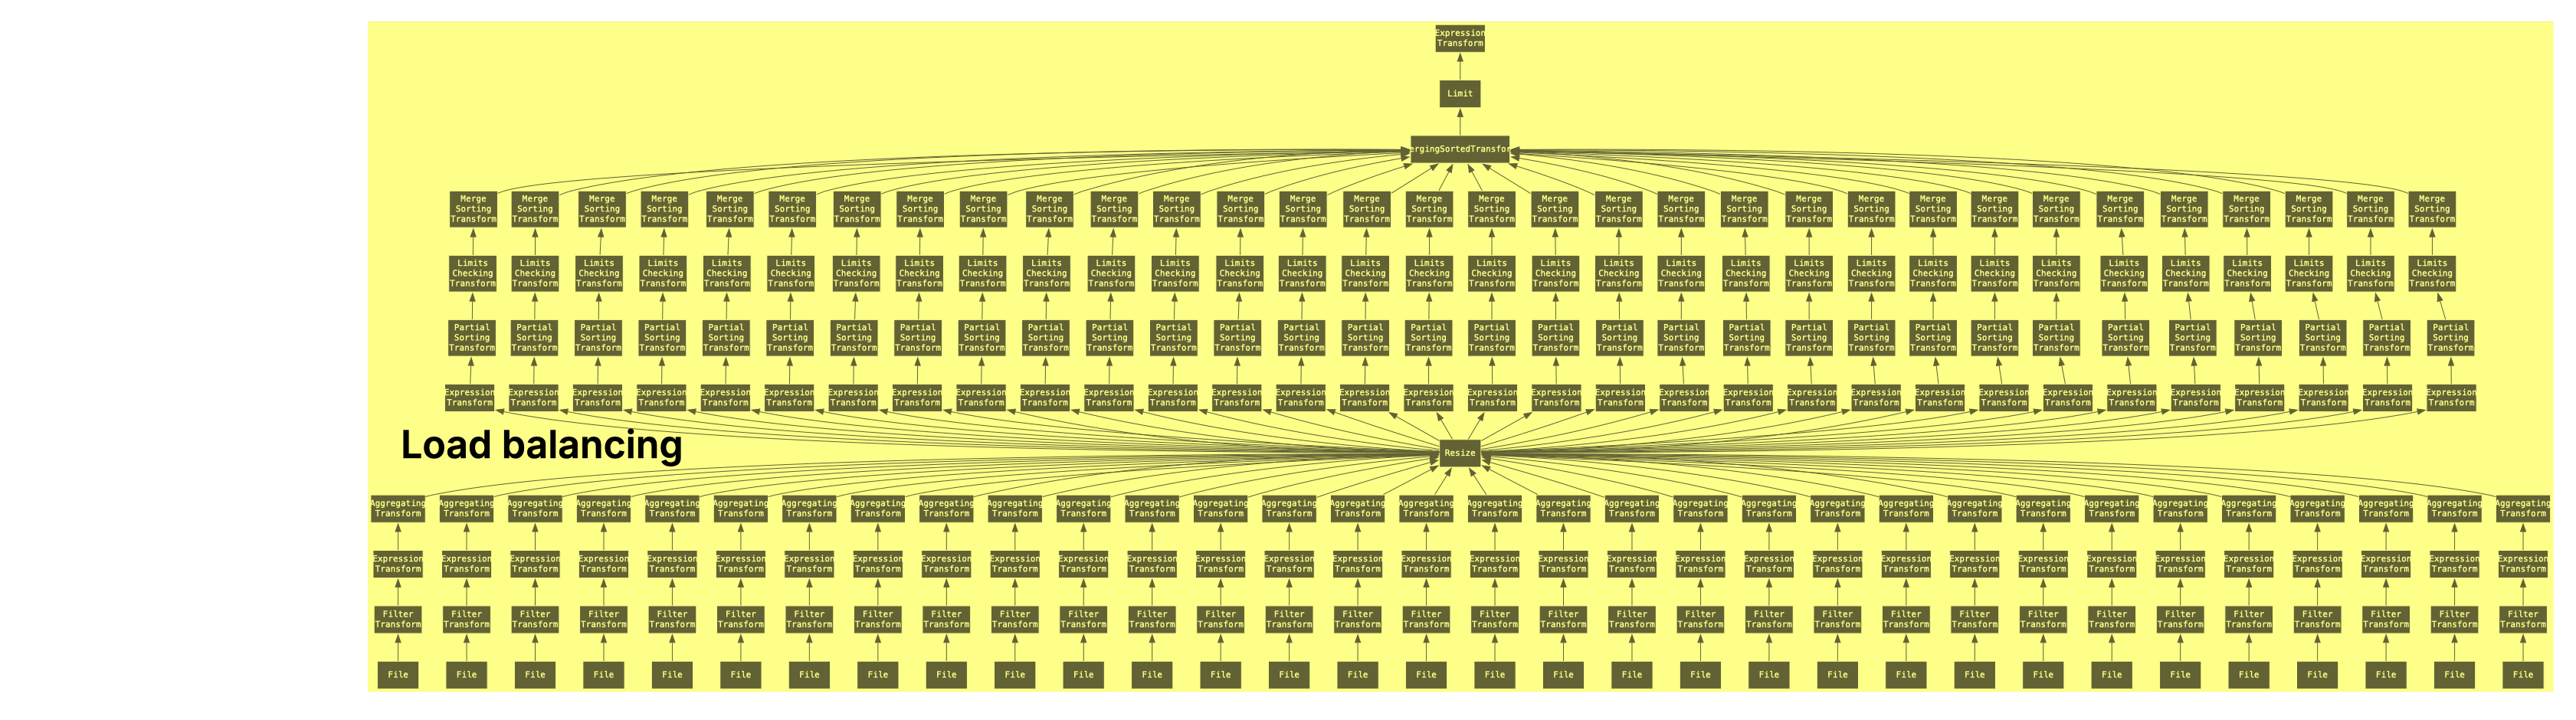
以下では、[EXPLAIN](https://clickhouse.com/docs/ja/reference/statements/explain#explain-pipeline) 句を使用して、Parquet ファイルとして格納されたウェブアナリティクスデータセット(後のベンチマークで使用)に対する [ClickBench クエリ 11](https://github.com/ClickHouse/ClickBench/blob/f1178a21fbfdf3b2f9c71e7ed1602bb171d0cb2a/clickhouse/queries.sql#L11)(定義は [ClickBench リポジトリのクエリ一覧](https://github.com/ClickHouse/ClickBench/blob/f1178a21fbfdf3b2f9c71e7ed1602bb171d0cb2a/clickhouse/queries.sql) を参照)の 3 回の異なる実行における[物理オペレータープラン](https://clickhouse.com/docs/ja/concepts/core-concepts/academic-overview#4-2-multi-core-parallelization)(「クエリパイプライン」とも呼ばれます)を確認します。このクエリは、LIMIT を適用する前にデータのフィルタリング、集約、ソートを実行します。`graph` オプションを指定すると、ClickHouse はプランを [DOT](https://en.wikipedia.org/wiki/DOT_(graph_description_language)) 形式で出力し、[Graphviz](https://en.wikipedia.org/wiki/Graphviz) を使用して PDF にレンダリングできます。
#### 例 1: Parquet ファイル 1 件、4 コア
最初の例として、**max_threads と max_parsing_threads を 4 に設定し**(4 コアマシンをシミュレートし、プランの可読性を保つため)、**ちょうど 1 つの Parquet ファイル**に一致するパスパターンを使用します。
clickhouse local --query "
EXPLAIN Pipeline graph = 1, compact = 0
SELECT MobilePhoneModel, COUNT(DISTINCT UserID) AS u
FROM file('./output/Parquet/100000000/1000000/sorted/zstd/chunk_00.parquet')
WHERE MobilePhoneModel <> ''
GROUP BY MobilePhoneModel
ORDER BY u DESC LIMIT 10
SETTINGS max_threads = 4, max_parsing_threads = 4;
" | dot -Tpdf > pipeline.pdf
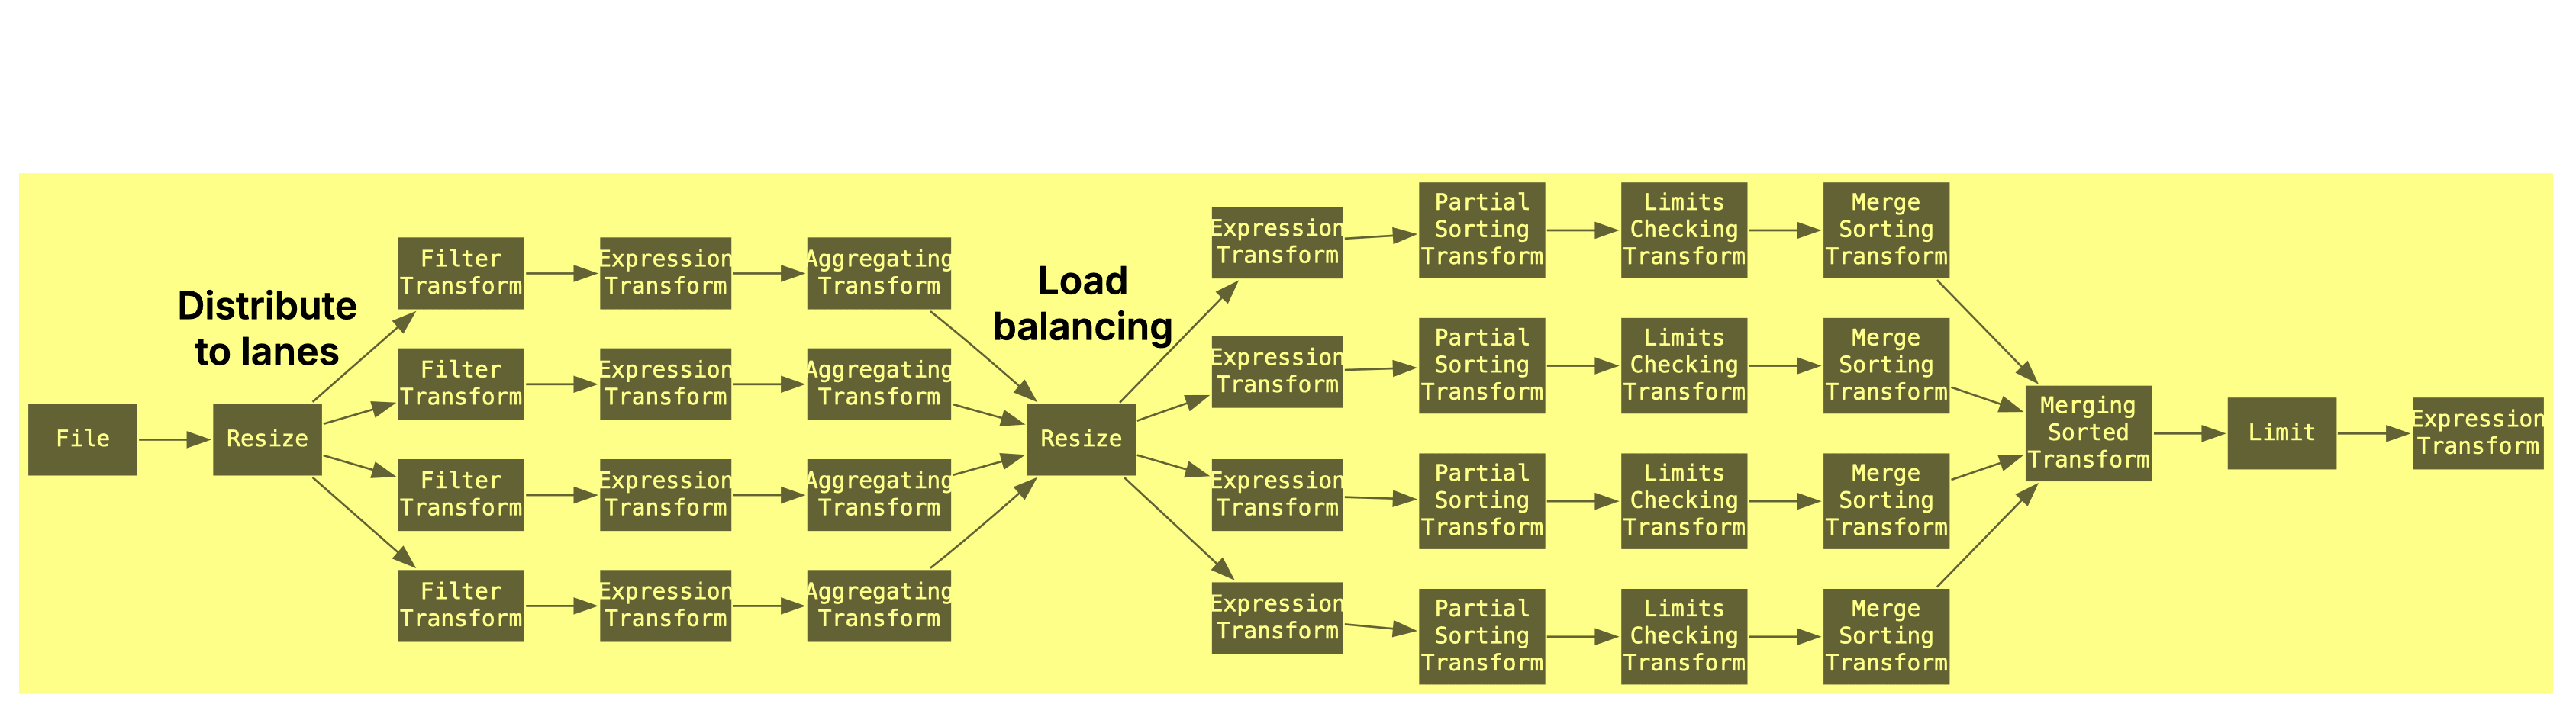
ご覧のとおり、クエリエンジンは 1 つのファイルストリーム(`min(max_threads = 4, num_files = 1)` の式に基づく)と、1 つの Parquet ファイルのデータに対してクエリを実行するための 4 つの並列処理レーン(`max_threads = 4`)を使用しています。
上記の可視化は左から右へと流れます。`Resize` オペレーターがパースされたファイルデータを 4 つの処理レーンに均等に分散し、そこでフィルタリングと[部分集約](https://clickhouse.com/blog/clickhouse_vs_elasticsearch_mechanics_of_count_aggregations#-multi-core-parallelization)が実行されます。2 つ目の `Resize` はストリームをリバランスして均一な CPU 使用率を維持します。これは、データの範囲によって述語の選択性が異なり、一部のレーンに過度な負荷がかかって他のレーンがアイドル状態になる可能性がある場合に極めて重要です。この動的な再分散によって高速なレーンが低速なレーンを支援し、全体的なパフォーマンスが向上します。ソートは[3 つの段階](https://clickhouse.com/blog/clickhouse-just-in-time-compiler-jit#clickhouse-compilation-of-sorting)で進行します。
1. `PartialSortingTransform` が各レーンの個々のブロックをソートします。
2. `MergeSortingTransform` が [2-way マージ](https://en.wikipedia.org/wiki/K-way_merge_algorithm) を介してレーンごとに局所的にソートされたストリームを維持します。
3. `MergingSortedTransform` がレーン間で [k-way マージ](https://en.wikipedia.org/wiki/K-way_merge_algorithm) を実行し、続いて `LIMIT` が適用されて最終結果が生成されます。
ファイルごとの並列パーススレッド数を直接ログに出力したり、簡単に確認したりする方法はありません。しかし、[ソースコード内の数式](https://github.com/ClickHouse/ClickHouse/blob/d66f2f168249888d7672045389350493a05a98fe/src/Storages/StorageFile.cpp#L1442)である `max(max_parsing_threads / num_files, 1)` に基づくと、ファイルが 1 件で `max_parsing_threads = 4` の場合、4 つのスレッドを使用して複数の行グループが並列にパースされていると推測できます。
#### 例 2: Parquet ファイル 2 件、4 コア
2 つ目の例では、`max_threads` と `max_parsing_threads` を 4 に設定したまま、ファイルパスパターンを変更してちょうど 2 つの Parquet ファイルに一致させます。
clickhouse local --query "
EXPLAIN Pipeline graph = 1, compact = 0
SELECT MobilePhoneModel, COUNT(DISTINCT UserID) AS u
FROM file('./output/Parquet/100000000/1000000/sorted/zstd/chunk_0{0..1}.parquet')
WHERE MobilePhoneModel <> ''
GROUP BY MobilePhoneModel
ORDER BY u DESC LIMIT 10
SETTINGS max_threads = 4, max_parsing_threads = 4;
" | dot -Tpdf > pipeline.pdf
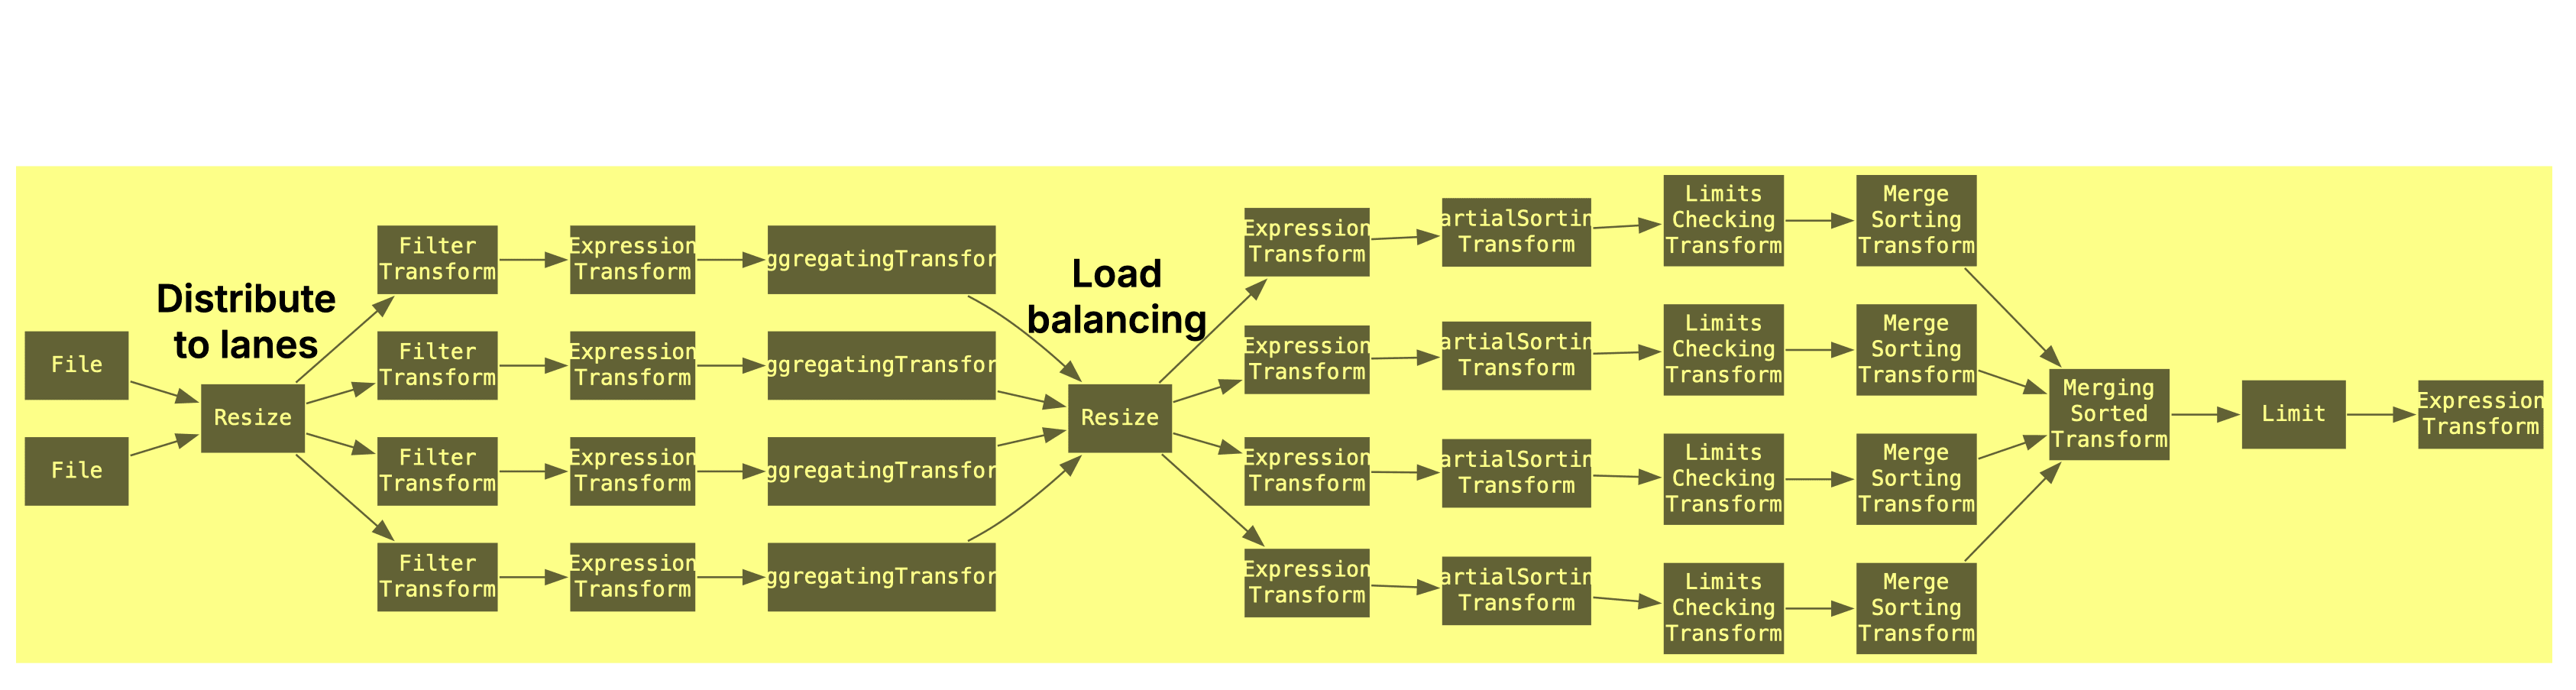
これで、クエリエンジンは 2 つの並列ファイルストリーム(= `min(max_threads = 4, num_files = 2)`)と、2 つの Parquet ファイルのデータに対してクエリを実行するための 4 つの並列処理レーン(`max_threads = 4`)を使用するようになります。
ただし、ファイルストリームあたりの並列パーススレッド数は、4 ではなく 2 になります(`max(max_parsing_threads = 4 / num_files = 2, 1)`)。
#### 例 3: Parquet ファイル 100 件、32 コア
最後に、`max_threads` と `max_parsing_threads` のしきい値を意図的に制限しない例を示します。32 CPU コアを搭載した[テストマシン](/ja/blog/clickhouse-and-parquet-a-foundation-for-fast-lakehouse-analytics-jp)では、どちらもデフォルトで `32` に設定されています。ファイルパスパターンは、サンプルデータセットの全 [100](/ja/blog/clickhouse-and-parquet-a-foundation-for-fast-lakehouse-analytics-jp) 件の Parquet ファイルに一致します。
clickhouse local --query "
EXPLAIN Pipeline graph = 1, compact = 0
SELECT MobilePhoneModel, COUNT(DISTINCT UserID) AS u
FROM file('./output/Parquet/100000000/1000000/sorted/zstd/chunk_*.parquet')
WHERE MobilePhoneModel <> ''
GROUP BY MobilePhoneModel
ORDER BY u DESC LIMIT 10;
" | dot -Tpdf > pipeline.pdf
### スケールアウト: クラスター全体での実行
ここまで、単一の ClickHouse クエリエンジンインスタンスが CPU コア全体で Parquet 処理を並列化する方法を見てきました。[並列クラスターエンジンモード](https://clickhouse.com/blog/clickhouse-release-25-03#automatic-parallelization-for-external-data)では、クエリエンジンは利用可能な全ノードの全 CPU コアに処理を分散し、クラスター全体で並列処理をスケールさせます。
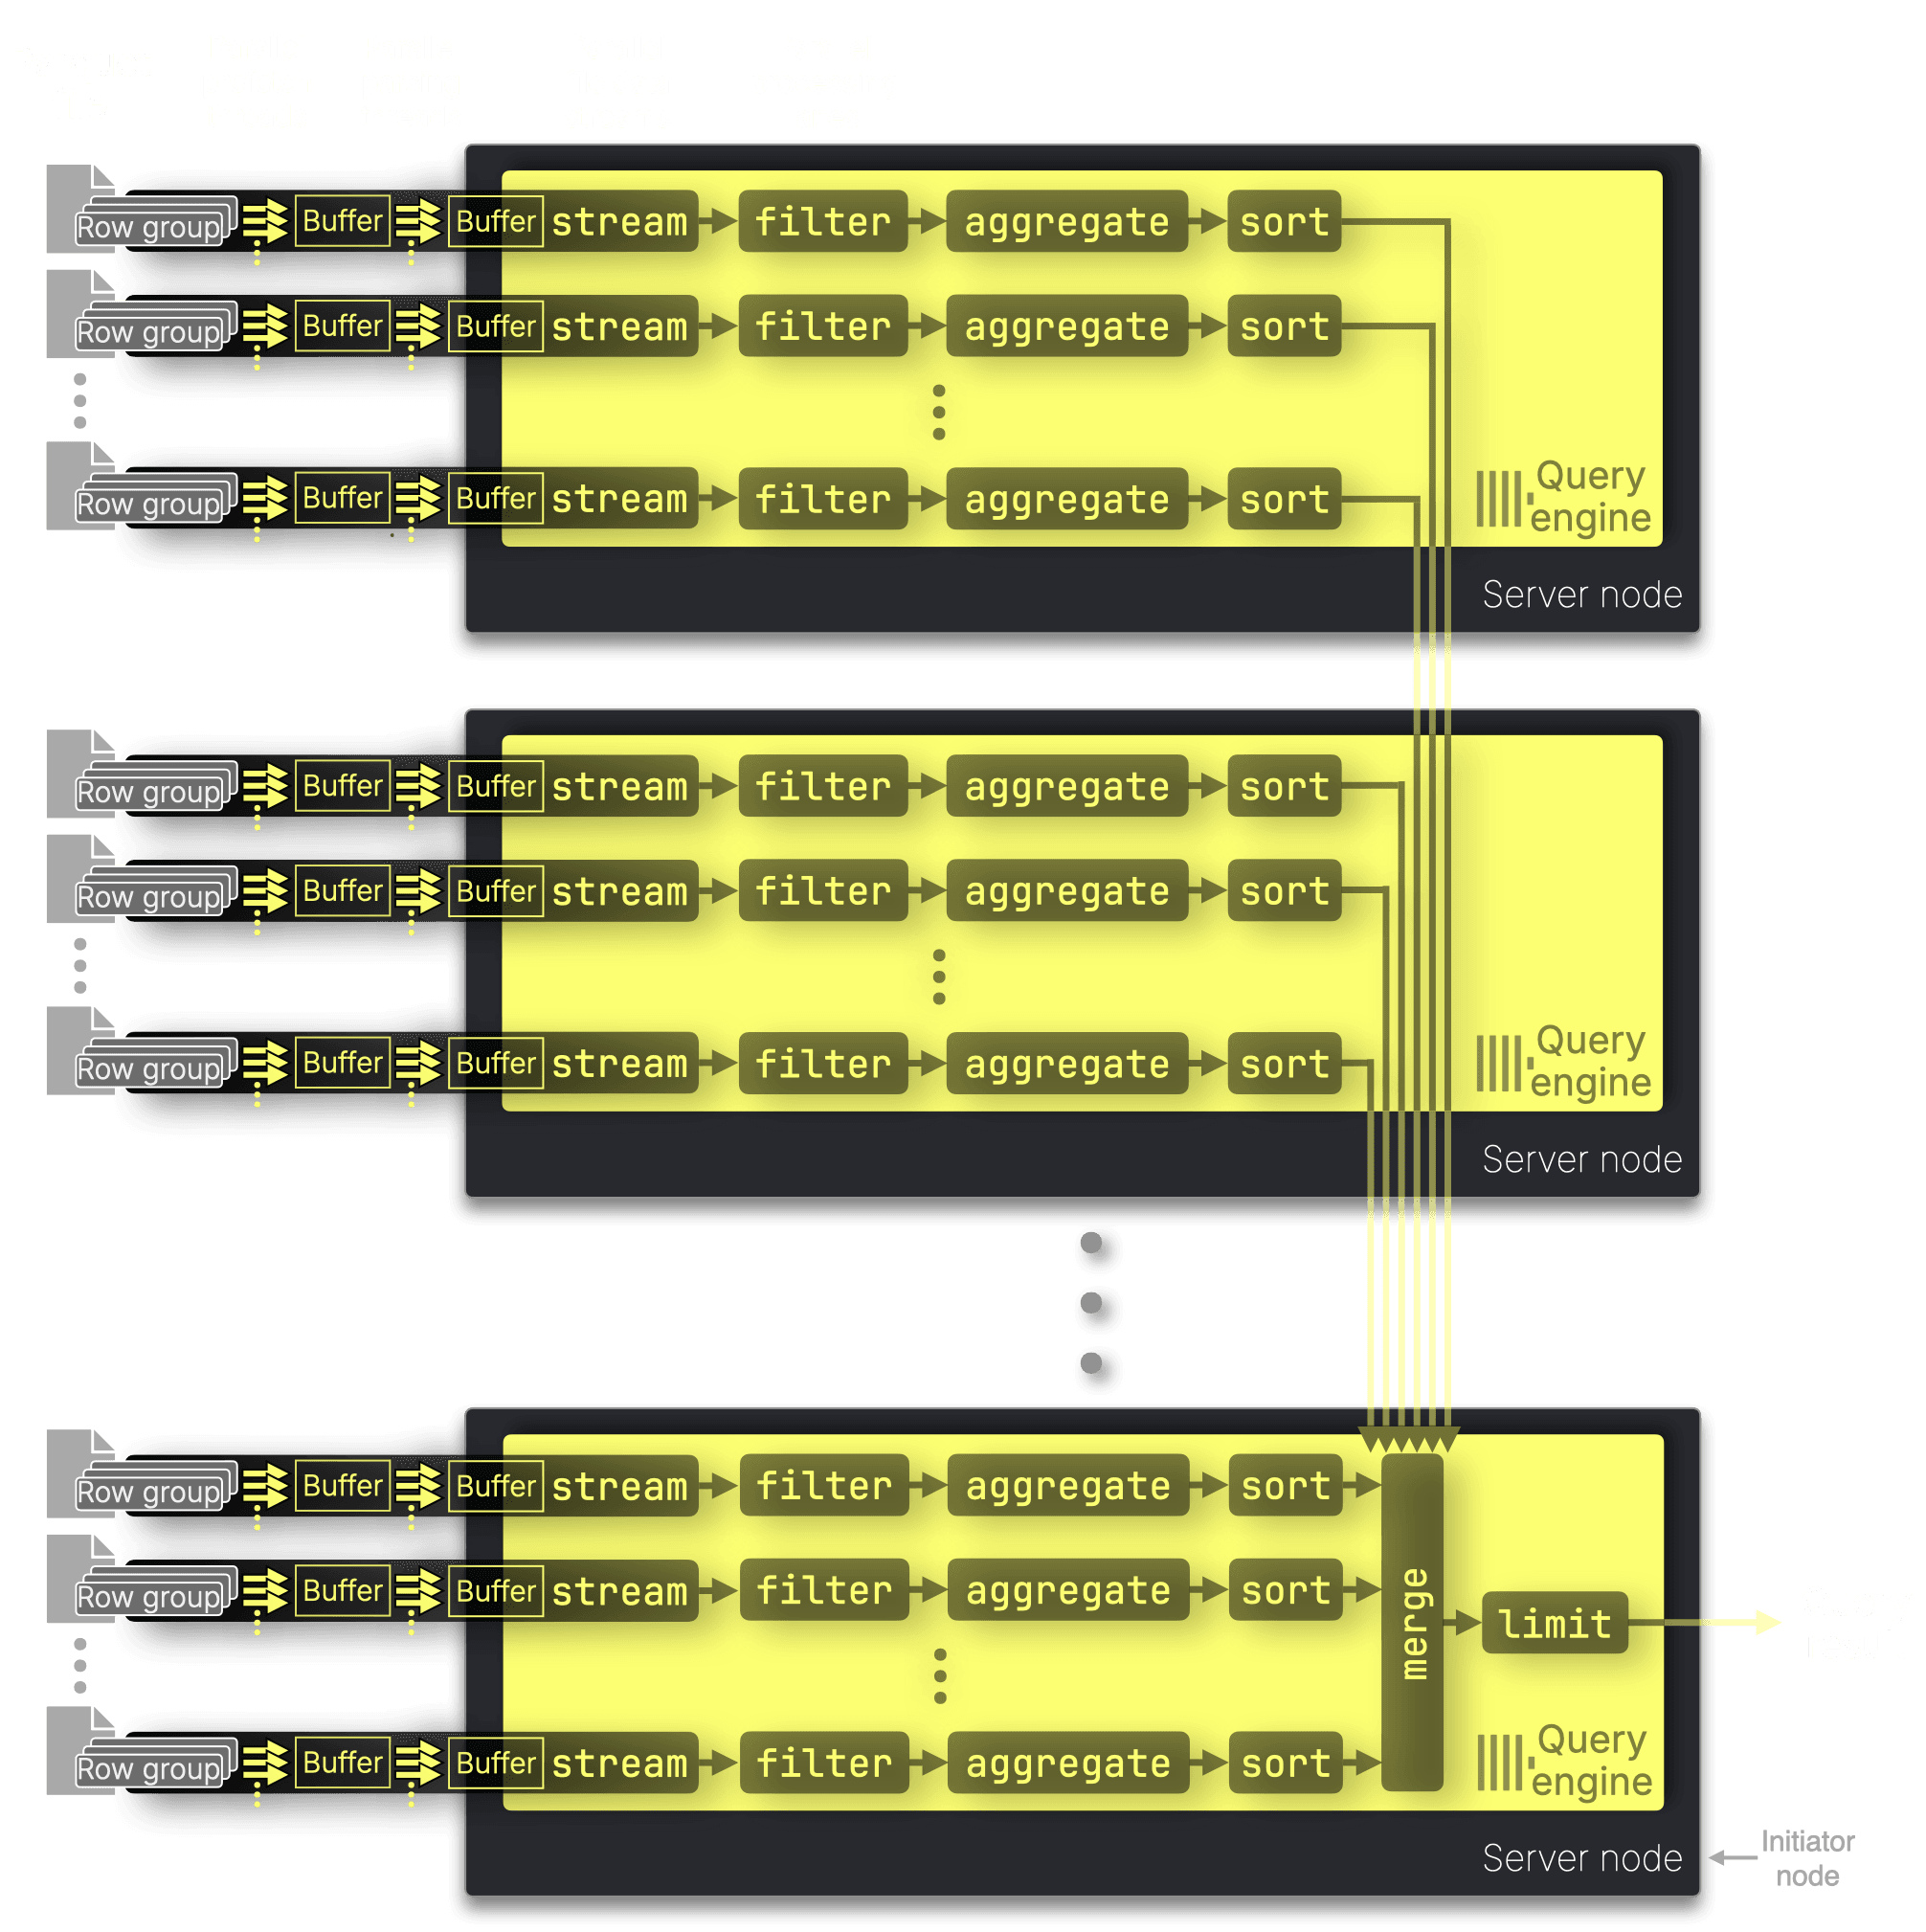
イニシエーターノード(クエリを受信したサーバー)上のクエリエンジンは、ファイル glob パターンを解決し、他のノード上のエンジンに接続してファイルを動的に割り当てます。リモートノードは処理を完了すると、全ファイルが処理されるまでイニシエーターに次のファイルを要求します。
### パフォーマンスの今後: よりスマートできめ細かな並列化
[開発中のネイティブ Parquet リーダー](https://github.com/ClickHouse/ClickHouse/pull/78380)は、[Arrow への依存関係](/ja/blog/clickhouse-and-parquet-a-foundation-for-fast-lakehouse-analytics-jp)を排除して Arrow データから ClickHouse 内部フォーマットへのメモリ内コピーをなくし、時間とメモリを節約するだけでなく、よりきめ細かく適応的な並列処理を可能にします。
* **行グループ内でのカラムレベルの並列化**: 行グループ全体を一括で並列処理するだけでなく、同一の行グループから異なるカラムを同時に読み取れるようになるため、利用可能な行グループ数が少ない場合でも CPU を有効活用できます。
* **I/O リクエストのマージ**: 読み取り予定のファイル範囲を事前登録することで、細かく隣接した I/O 操作を検出し、より少数の大きな読み取りリクエストにまとめることができます。これにより、特にレイテンシが高いストレージでのスループットが向上します。
* **並列性を意識したスケジューリング**: ステージやメモリフットプリントに応じて異なる並列度を割り当てられるようになります。例えば、[Bloom フィルター](/ja/blog/clickhouse-and-parquet-a-foundation-for-fast-lakehouse-analytics-jp)のような小さな構造体には高い並列度を適用し、大量のカラムデータにはメモリ負荷を抑えるために控えめな並列度を適用します。
これらの変更は、システムリソースをより有効に活用し、規模や複雑さが異なるワークロード全体で安定したスループットを維持することを目的としています。
並列化について説明したところで、次は ClickHouse で Parquet クエリを高速化する 2 つ目の重要な要素である「不要な I/O の最小化」に移りましょう。無関係なデータのスキャン、パース、処理を減らせば減らすほど、クエリは高速に動作します。次のセクションでは、現在 ClickHouse が適用している I/O 削減技術と、ネイティブリーダーで近日登場予定の技術について見ていきます。
### I/O 削減: スキップする対象とその手法
ClickHouse が不要な読み取りを最小限に抑える仕組みを理解するために、Parquet のファイル構造によって実現される I/O 削減技術を見ていきましょう。
**カラムプロジェクション**
Parquet は列指向フォーマットであるため、リーダーと ClickHouse クエリエンジンはクエリに必要なカラムにのみアクセスします。
**圧縮とエンコーディング**
データへのエンコード(辞書やランレングスエンコーディングなど)およびカラムごとの圧縮により、Parquet はディスクに保存されるデータ量と読み取りデータ量を削減します。これは容量の節約になるだけでなく、クエリの高速化にもつながります。ClickHouse はスキャンするデータ量を減らし、必要なデータのみを解凍し、エンコードされたメタデータに基づいてセクション全体をスキップできます(詳細は後述)。
Parquet は[ページ](/ja/blog/clickhouse-and-parquet-a-foundation-for-fast-lakehouse-analytics-jp)レベルでさまざまなエンコーディングおよび圧縮方式をサポートしています。
* ページエンコーディング: Parquet は効率的な値の格納のためにいくつかの[エンコーディング方式](https://parquet.apache.org/docs/file-format/data-pages/encodings/)を定義しています。代表的な例として、辞書エンコーディング(後述)やランレングスエンコーディングが挙げられます。
* ページ圧縮: エンコード後、ページを Snappy、LZ4、ZSTD などのアルゴリズムで[圧縮](https://parquet.apache.org/docs/file-format/data-pages/compression/)し、ファイルサイズと I/O をさらに削減できます。
**述語プッシュダウン**
Parquet は、複数の粒度レベルで格納されたメタデータを通じて、粗粒度の[述語プッシュダウン](https://homepages.cwi.nl/~boncz/msc/2018-BoudewijnBraams.pdf)を可能にします。このメタデータは[先ほどの図](/ja/blog/clickhouse-and-parquet-a-foundation-for-fast-lakehouse-analytics-jp)には含まれていませんでしたが、以下の図ではそれらを含め、再度[Web アナリティクスデータセット](/ja/blog/clickhouse-and-parquet-a-foundation-for-fast-lakehouse-analytics-jp)を使って図示しています。ここでも分かりやすさを重視し、行グループはわずか 6 行、データページはカラムあたり 3 つの値のみを持つ構成で示しています。
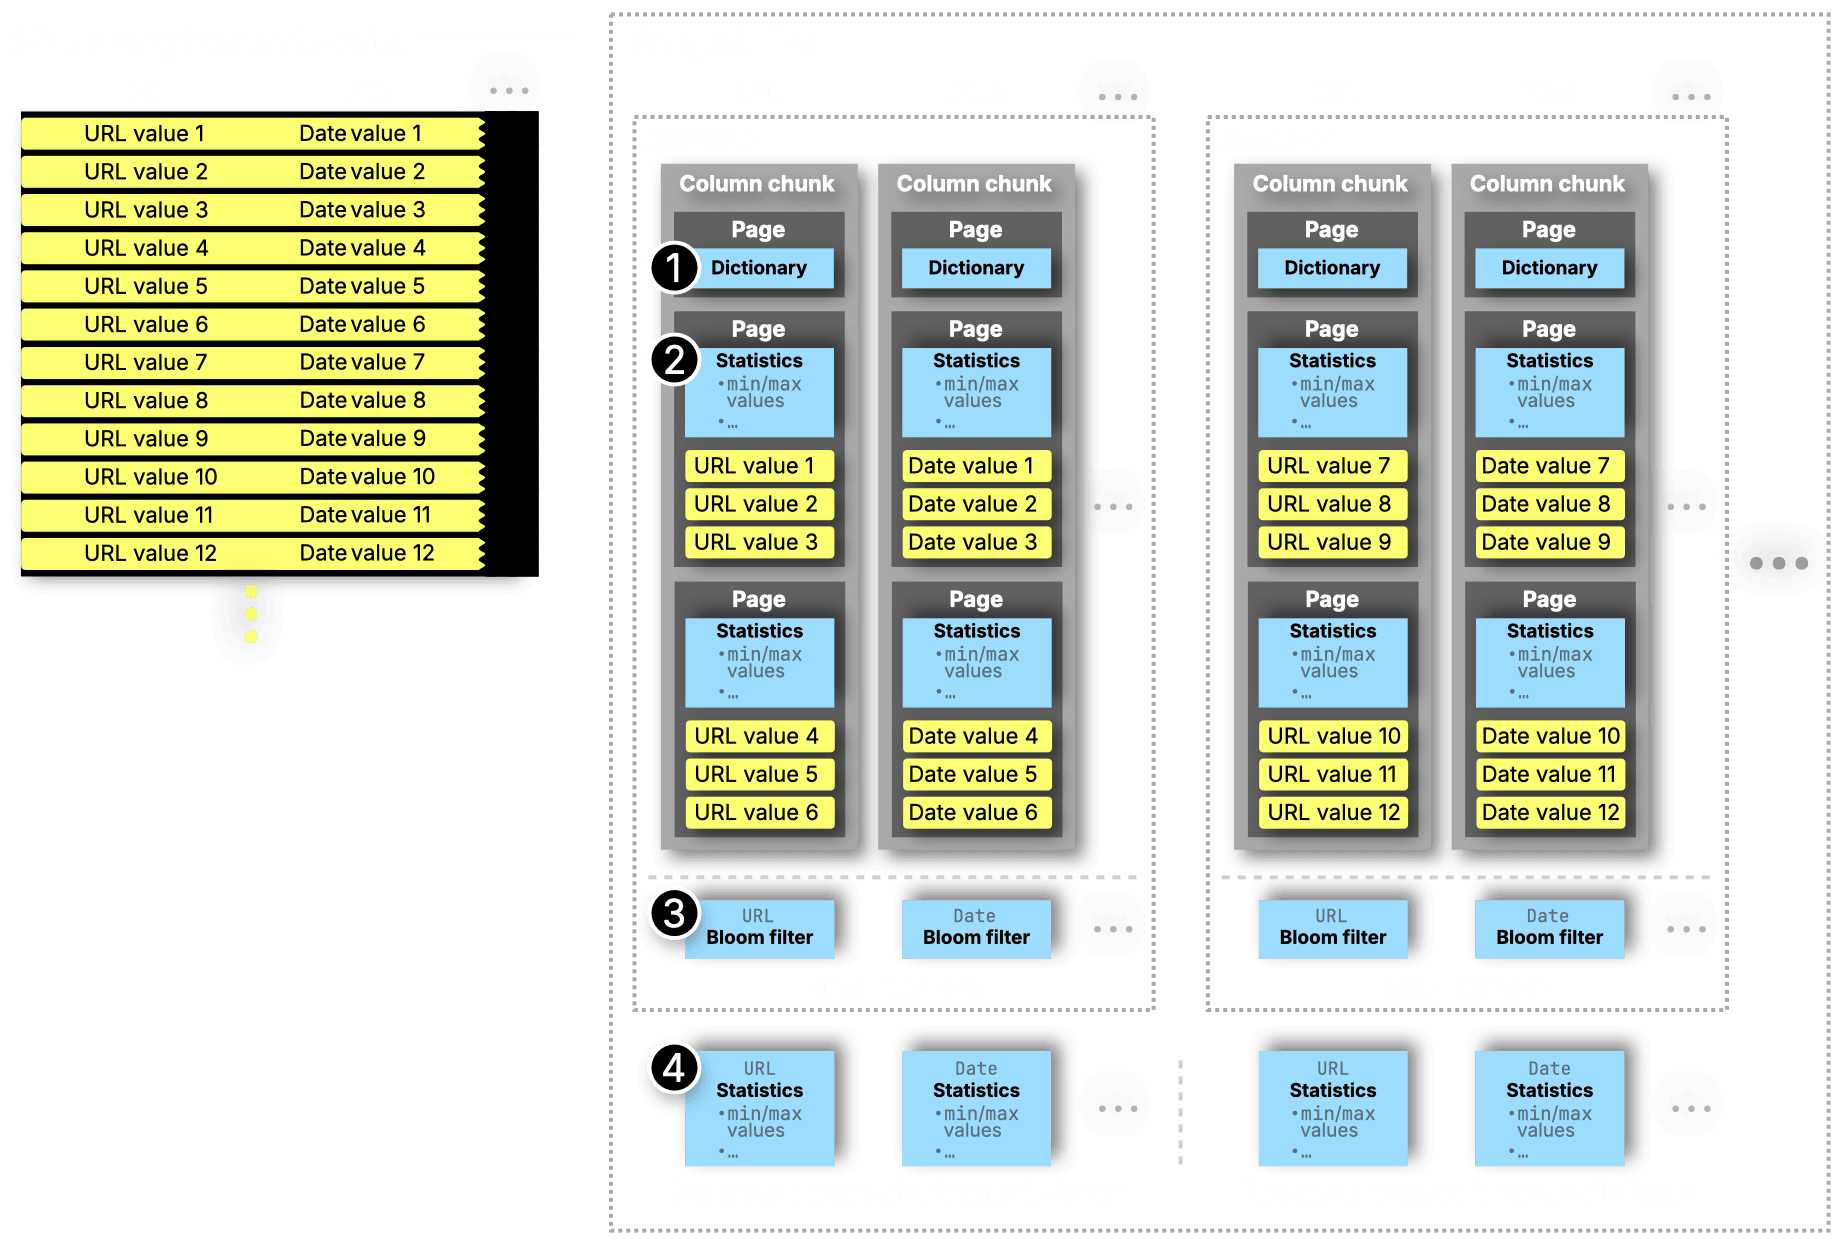
上の図に追加されたメタデータ要素について、以下で詳しく説明します。
① **カラムチャンクレベルの辞書フィルタリング**: カーディナリティの低いカラムに対して、Parquet は[辞書エンコーディング](https://parquet.apache.org/docs/file-format/data-pages/encodings/)を使用します。各カラムチャンクには、一意な値をマッピングする辞書ページが含まれます。クエリが `WHERE status = 'cancelled'` のように特定の値をフィルタリングする場合、リーダーはまず辞書を確認してチャンクにその値が含まれているかどうかを判断し、含まれていなければチャンク全体をスキップできます。
② **ページレベルの最小値/最大値フィルタリング**: Parquet のページには、各ページに格納されているカラムデータの[最小値と最大値](https://github.com/apache/parquet-format/blob/3ce0760933b875bc8a11f5be0b883cd107b95b43/src/main/thrift/parquet.thrift#L306)などの[統計情報を含める](https://github.com/apache/parquet-format/blob/3ce0760933b875bc8a11f5be0b883cd107b95b43/src/main/thrift/parquet.thrift#L691)ことができます。クエリが `WHERE amount > 1000` のように特定の範囲でフィルタリングする場合、リーダーはこれらの統計情報を使用して、すべての値がしきい値を下回っているページをスキップできます。これはソート済みデータで特に効果的であり、大きなブロックを早い段階で除外できるケースが多くなります。
③ **カラムチャンクレベルの Bloom フィルター**: オプションとして、Parquet ファイルには行グループごと、カラムごとに [Bloom フィルター](https://parquet.apache.org/docs/file-format/bloomfilter/)を含めることができます。リーダーはこれらのフィルターを使用して値が存在する可能性があるかどうかを効率的に確認し、確実に存在しない場合はカラムデータの読み取りをスキップできます。
④ **カラムチャンクレベルの最小値/最大値フィルタリング**: ページレベルの統計情報と同様に、Parquet はカラムごとに行グループ単位で最小値/最大値の統計情報を[格納](https://github.com/apache/parquet-format/blob/3ce0760933b875bc8a11f5be0b883cd107b95b43/src/main/thrift/parquet.thrift#L912)できます。これにより、行グループ内の特定カラムがクエリに無関係であることが確実な場合、リーダーはそのカラム全体をスキップできます。
では、ClickHouse の Parquet リーダーは現時点でこれらをどこまでサポートしているでしょうか。
ClickHouse の現行 Parquet リーダーは以下をサポートしています。
③ **[Bloom フィルター](https://clickhouse.com/blog/clickhouse-release-25-02#writing-bloom-filters-for-parquet)**([input_format_parquet_bloom_filter_push_down](https://clickhouse.com/docs/ja/reference/settings/formats) 設定で有効化)
④ **[行グループレベルの最小値/最大値フィルタリング](https://clickhouse.com/blog/clickhouse-release-23-08#reading-files-faster-michael-kolupaevpavel-kruglov)**([input_format_parquet_filter_push_down](https://clickhouse.com/docs/ja/reference/settings/formats) 設定で制御)
近日登場予定のネイティブリーダーでは、以下のサポートが追加されます。
① 辞書フィルタリング
② ページレベルの最小値/最大値フィルタリング
これらの組み込み Parquet 最適化に加えて、新しいネイティブリーダーは ClickHouse 独自の I/O 削減技術、特に [PREWHERE](https://clickhouse.com/docs/ja/concepts/features/performance/prewhere) や[遅延実体化(lazy materialization)](https://clickhouse.com/ja/blog/clickhouse-gets-lazier-and-faster-introducing-lazy-materialization-jp)も統合し、不要な読み取りをさらに削減してパフォーマンスを向上させます。
これで、ClickHouse の現行 Parquet リーダーが並列処理と I/O 削減によってどのようにパフォーマンスを実現しているか、そして今後どのような改善が控えているかについての解説を終わります。現行 Parquet リーダーの仕組みが分かったところで、実際の分析クエリでどのようなパフォーマンスを発揮するかを見ていきましょう。
## Parquet クエリパフォーマンスのベンチマーク
前回の [FastFormats](https://fastformats.clickhouse.com/) ベンチマークでは、(クライアントによって)データが ClickHouse サーバーにプッシュされた際に、さまざまなフォーマットを ClickHouse テーブルへどれだけ速く取り込めるかを[検証](https://clickhouse.com/blog/clickhouse-input-format-matchup-which-is-fastest-most-efficient)しました。
今回はその裏返しとして、ClickHouse クエリエンジンがデータを一切取り込まずに、それらのフォーマットを直接どれだけ速くクエリできるかを検証します。
### ベンチマーク構成: ハードウェア、データセット、ソフトウェア
FastFormats ベンチマークと同じ環境を使用し、以下のセットアップで実施しました。
* **ハードウェア**: AWS EC2 m6i.8xlarge インスタンス(32 vCPU、128 GiB RAM、1 TiB gp3 SSD)
* **データセット**: 匿名化された [Web アナリティクスデータセット](https://clickhouse.com/blog/clickhouse-input-format-matchup-which-is-fastest-most-efficient#dataset)([ClickBench](https://benchmark.clickhouse.com/) で使用されているものと同じ)
* **ClickHouse バージョン**: 25.4.1(Ubuntu Linux 24.04 上で稼働)
### データセットからのファイル生成
FastFormats の[ベンチマーク機構](https://clickhouse.com/blog/clickhouse-input-format-matchup-which-is-fastest-most-efficient#benchmark-mechanics)を再利用し、以下のさまざまな組み合わせを自動[生成](https://github.com/ClickHouse/examples/blob/2f9f05f7b04a1da6269b6d2c41499a9fa336c25c/blog-examples/FastFormatReads/main.sh#L300)しました。
* ファイルサイズ(およびファイル数)
* フォーマット(例: Parquet、JSON、Arrow など)
* 事前ソート(一部のクエリに有利に働くよう、[元のテーブルのソートキー](https://github.com/ClickHouse/ClickBench/blob/f1178a21fbfdf3b2f9c71e7ed1602bb171d0cb2a/clickhouse/create.sql#L108)に一致)
* 圧縮(LZ4、ZSTD、または圧縮なし)
具体的には、テスト対象の各フォーマットについて、データセットの 1 億行を以下のように[分割](https://github.com/ClickHouse/examples/blob/2f9f05f7b04a1da6269b6d2c41499a9fa336c25c/blog-examples/FastFormatReads/main.sh#L31)しました。
* 各 100 万行のファイル 100 件
* 6 つのファイルバージョン: [事前ソート](https://github.com/ClickHouse/examples/blob/2f9f05f7b04a1da6269b6d2c41499a9fa336c25c/blog-examples/FastFormatReads/main.sh#L46)の有無と、[圧縮](https://github.com/ClickHouse/examples/blob/2f9f05f7b04a1da6269b6d2c41499a9fa336c25c/blog-examples/FastFormatReads/main.sh#L48)(LZ4、ZSTD)の有無の全組み合わせ
### クエリの実行: ファイル向け ClickBench
ベンチマークを拡張し、生成された各ファイルセットに対して、[ClickBench の公式 43 クエリ](https://github.com/ClickHouse/ClickBench/blob/main/clickhouse/queries.sql)すべてを順番に単独で自動[実行](https://github.com/ClickHouse/examples/blob/2f9f05f7b04a1da6269b6d2c41499a9fa336c25c/blog-examples/FastFormatReads/main.sh#L227)できるようにしました。実質的に、([file テーブル関数](https://clickhouse.com/docs/ja/reference/functions/table-functions/file)を[使用](https://github.com/ClickHouse/examples/blob/2f9f05f7b04a1da6269b6d2c41499a9fa336c25c/blog-examples/FastFormatReads/run_queries.sh#L46)して)ファイルベースのフォーマット上で ClickBench を実行しています。[ClickBench と同様に](https://github.com/ClickHouse/ClickBench/tree/main?tab=readme-ov-file#results-usage-and-scoreboards), 各クエリは [3 回](https://github.com/ClickHouse/examples/blob/main/blog-examples/FastFormatReads/run_queries.sh#L24)実行され、最初の実行の前に OS ページキャッシュが 1 回[クリア](https://github.com/ClickHouse/examples/blob/2f9f05f7b04a1da6269b6d2c41499a9fa336c25c/blog-examples/FastFormatReads/run_queries.sh#L40)されました。1 回目の実行を*コールド実行時間*とし、*ホット実行時間*には 2 回目と 3 回目の実行の最小値を採用しました。
### クエリエンジンのモード
実行時間やメモリ使用量にとどまらない詳細なランタイムメトリクスを取得するため、すべてのクエリはサーバーモードの ClickHouse エンジンを使用して実行しました。つまり、`clickhouse-client` から `clickhouse-server` プロセスに接続する構成です。ファイルベースのクエリには `clickhouse-local` を使用してスタンドアロンでエンジンを動かすこともできましたが、サーバーを使用することで [query log](https://clickhouse.com/docs/ja/reference/system-tables/query_log) システムテーブルから豊富な統計情報を収集できました。重要な点として、すべてのクエリは依然としてファイルベースのデータ上で直接実行されており、テーブルへのデータ取り込みは行われていません(追加で実施した MergeTree のベンチマークを除く。詳細は[後述](/ja/blog/clickhouse-and-parquet-a-foundation-for-fast-lakehouse-analytics-jp))。また、どちらのエンジンモードを使用しても、内部で動作するクエリエンジンとコードパスはまったく同じです。
### 測定対象
query log を使用して、各クエリの以下のメトリクスを[追跡](https://github.com/ClickHouse/examples/blob/2f9f05f7b04a1da6269b6d2c41499a9fa336c25c/blog-examples/FastFormatReads/metrics.sql)しました。
* **Runtime**: 各クエリの実行時間
* **Memory usage**: 実行中のピークメモリ使用量
* **Read rows**: データセットから読み取られた行数
* **Read bytes**: データセットから読み取られた総データ量
* **Threads participating**: 実行に関与したスレッド数
* **Peak threads usage**: 同時に実行された最大スレッド数
* **DiskReadElapsedMicroseconds**: [読み取りシステムコールを待機していた時間](https://github.com/ClickHouse/ClickHouse/blob/9d60aa01a83346648eae5dc9572530388271f7b0/src/Common/ProfileEvents.cpp#L101)
### 実環境でのパフォーマンス: Parquet と他のフォーマットの比較
それでは、現行の Parquet リーダーの並列処理と I/O 削減の最適化が、代表的な分析クエリで実際のパフォーマンスにどのように反映されるかを見ていきましょう。まずは代表的な ClickBench クエリ 1 つのパフォーマンスを確認し、その後に 43 クエリ全体の結果へと視野を広げます。
#### 前提条件の違いについて
比較のために、同じハードウェア上でサーバーモードのクエリエンジンを用い、ネイティブの MergeTree テーブルに対するクエリパフォーマンスも測定しました。
> Parquet と MergeTree の比較が完全な同一条件(apples to apples)の比較ではないことは認識しています。Parquet は汎用的な*ファイルフォーマット*であるのに対し、MergeTree は高度な統合と長年にわたる性能チューニングが施された専用設計の*テーブルエンジン*です。Parquet が MergeTree を上回る性能を出すとは想定していません。
より直接的な比較対象となるのは、Parquet の上にメタデータや潜在的なインデックスレイヤーを構築する Iceberg や Delta Lake のようなオープンテーブルフォーマットと MergeTree の比較でしょう。しかし、それは今後の記事のテーマです。ここでは基盤部分、つまり ClickHouse が Parquet ファイルを直接どれだけうまくクエリできるか、そして現在のパフォーマンスがどの位置にあるかに焦点を当てます。このレイクハウス基盤への投資を継続し、業界トップのパフォーマンスを目指す中で、その差は今後も縮まり続けるはずです。
#### クエリ 41: 実行時間、並列性、I/O
下のグラフは、選定した 8 種類の入力フォーマットについて、コールドおよびホット実行時間、同時処理スレッド数(query log の `peak_threads_usage` フィールドで追跡)、そして最も重要な指標として、ファイルベースのデータに対して直接 [ClickBench クエリ 41](https://github.com/ClickHouse/ClickBench/blob/a5a02f0da97461506ac78aa5cea257362690c10a/clickhouse/queries.sql#L41) を実行するために処理されたデータ量を比較したものです。
クエリ 41 は、フィルタリング、集約、ソートを行い、LIMIT を適用する典型的な分析ワークロードです。すべてのフォーマットにおいて、データセットは事前ソートされ、ZSTD 圧縮されてディスクに保存されました。
ベースラインとして—[前提条件は異なります](/ja/blog/clickhouse-and-parquet-a-foundation-for-fast-lakehouse-analytics-jp)が—同じ事前ソートおよび ZSTD 圧縮レイアウトを持つネイティブ MergeTree テーブルで同じクエリを実行した結果も含めています。
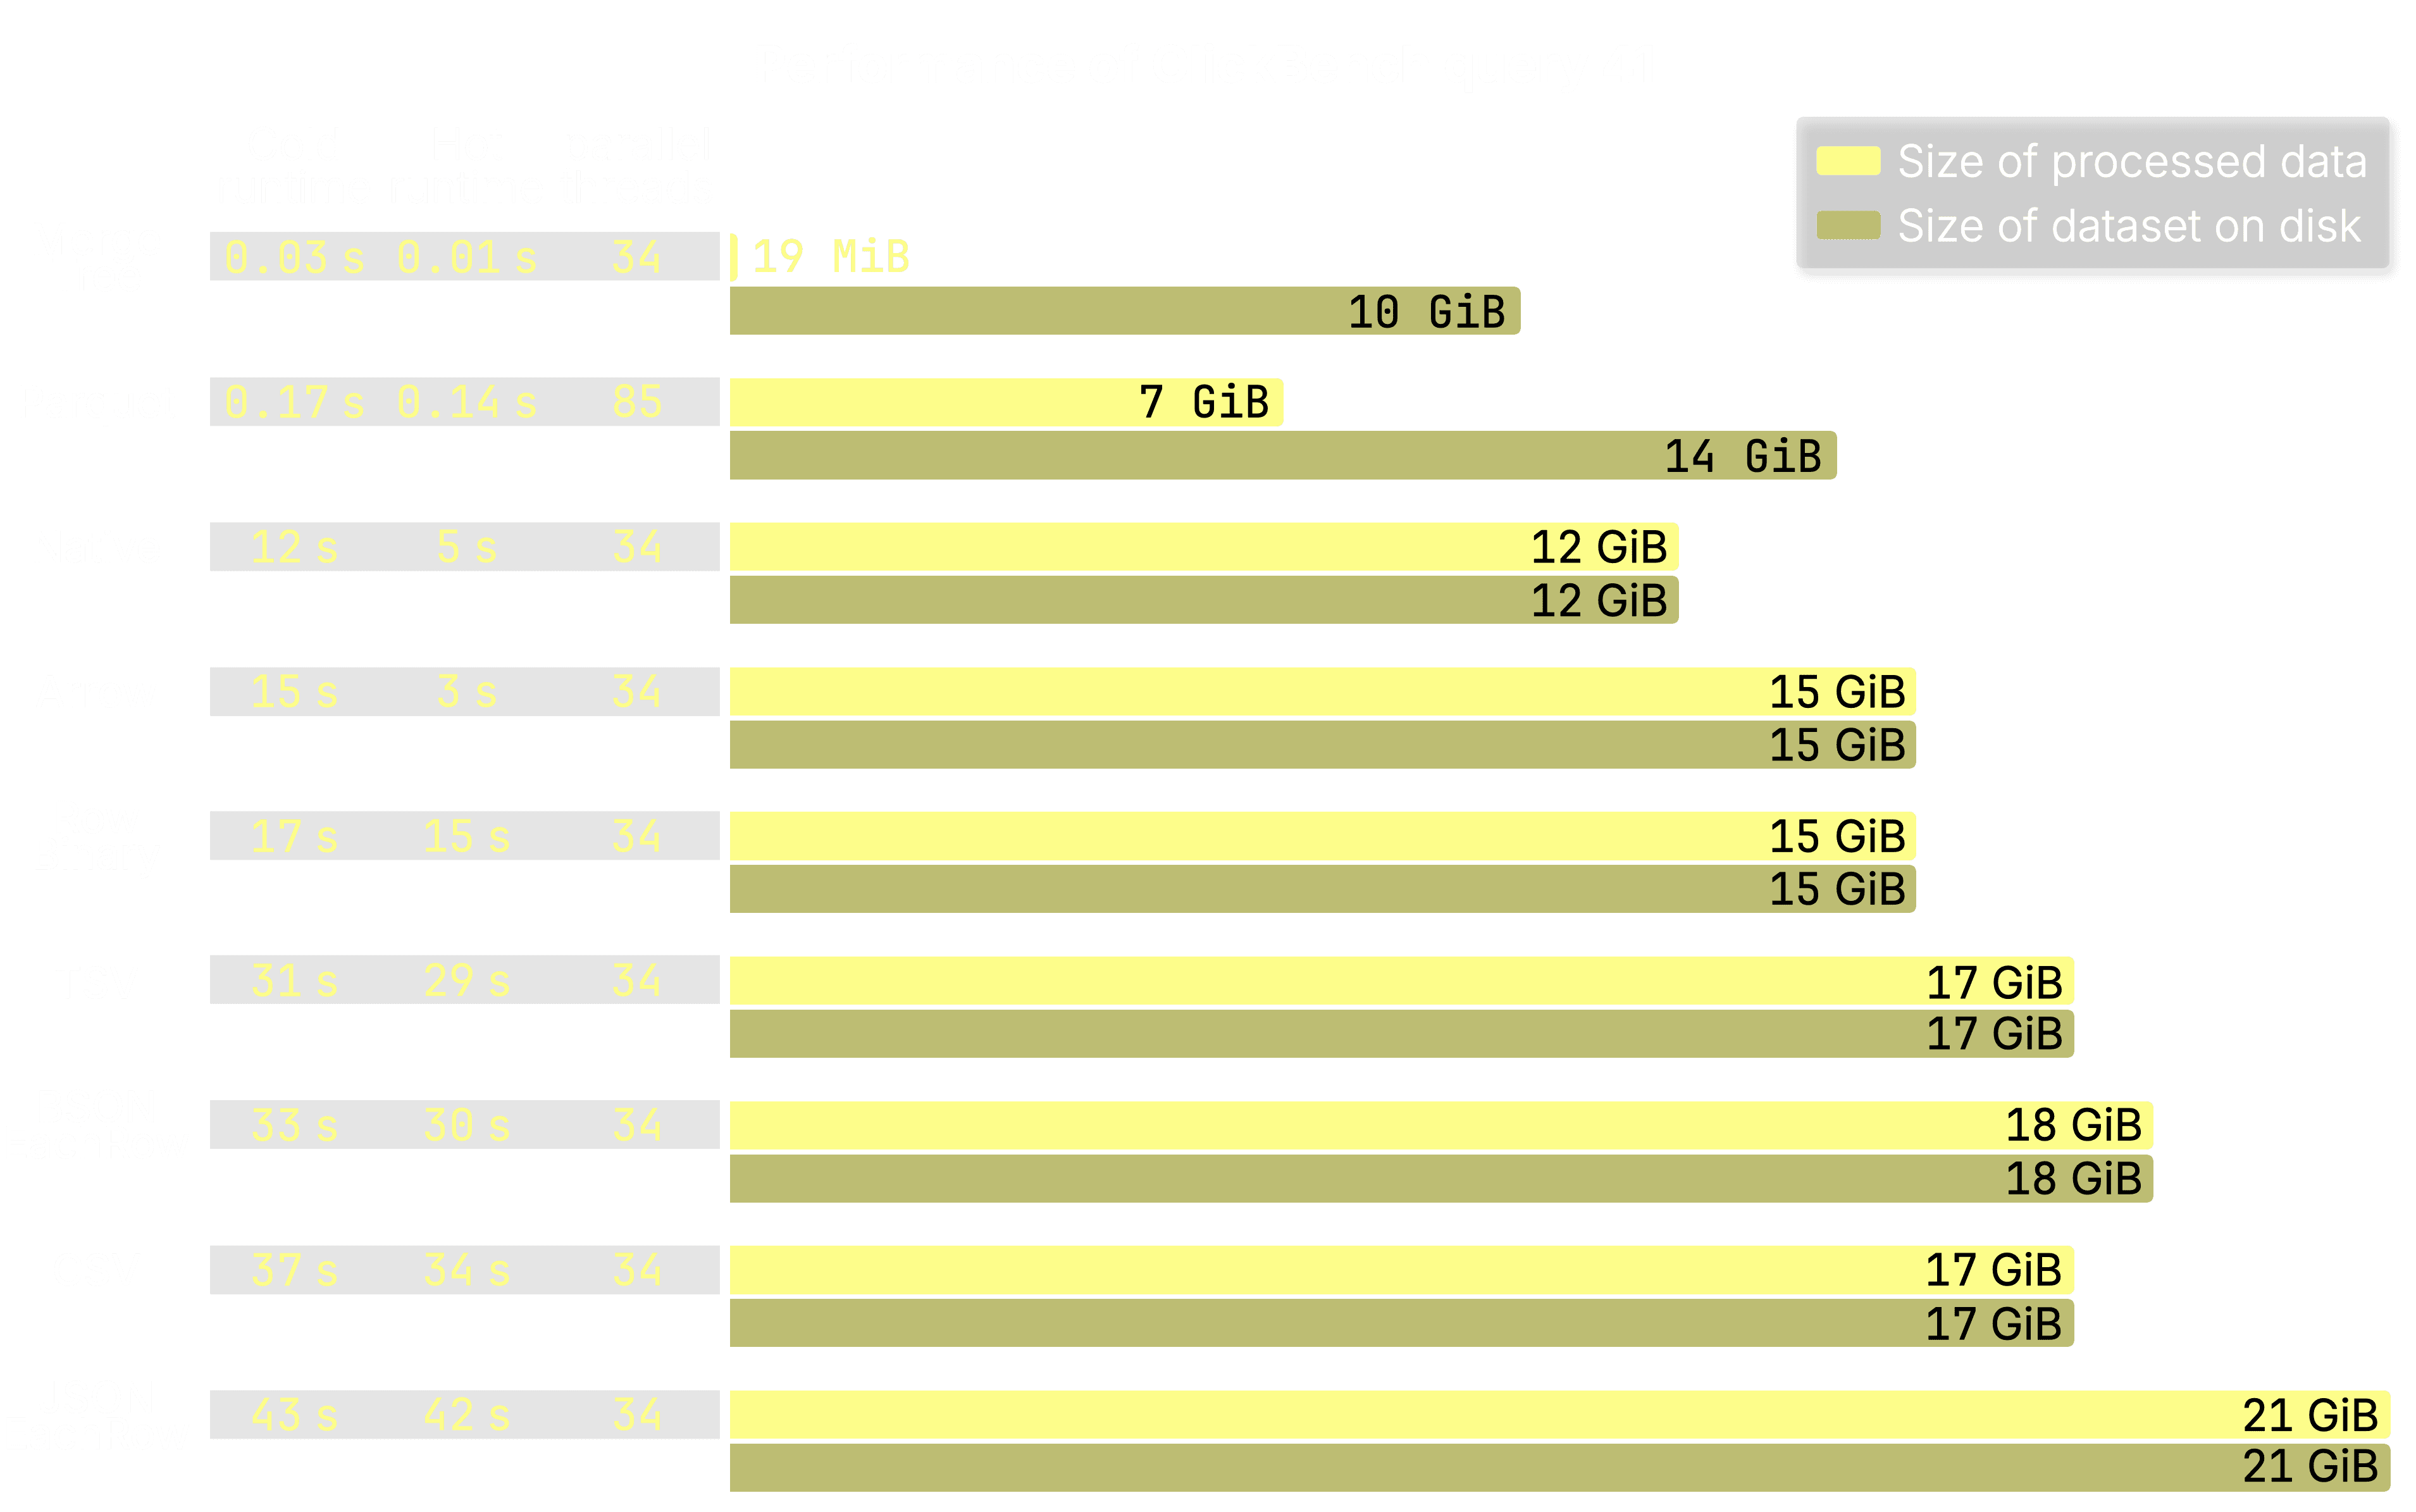
このグラフの主な焦点は、クエリ実行のためにクエリエンジンが全データのうちどれだけの量を処理しなければならなかったかという点にあります。グラフの項目はコールド実行時間の速い順に並んでおり、3 つの重要な観察結果が浮かび上がります。
1. **MergeTree**: ClickHouse の[ネイティブフォーマット](https://clickhouse.com/docs/ja/concepts/core-concepts/parts)である MergeTree は、[PREWHERE](https://clickhouse.com/docs/ja/concepts/features/performance/prewhere) や[遅延実体化](https://clickhouse.com/ja/blog/clickhouse-gets-lazier-and-faster-introducing-lazy-materialization-jp)を含む[最適化のフルスタック](https://clickhouse.com/ja/blog/clickhouse-gets-lazier-and-faster-introducing-lazy-materialization-jp)を活用することで、最も積極的な I/O 削減を実現します。このクエリでは、合計 10 GiB のデータのうち、処理[された](https://github.com/ClickHouse/examples/blob/main/blog-examples/FastFormatReads/clickhouse/results/clickhouse_mergetree_100000000_1746193290.json)のはわずか 19 MiB でした。これは主に、複数の複合主キー述語カラムのインデックスエントリを一度に効率よくスキャンし、ディスク上の物理的なデータ順序に基づいて一致する行グループを選択する[スパースプライマリインデックス](https://clickhouse.com/docs/ja/concepts/core-concepts/primary-indexes)のおかげです。これにより、コールド実行時間わずか 30 ミリ秒、ホット実行時間 10 ミリ秒という極めて低いクエリレイテンシが実現しました。これは高度に最適化された*テーブルエンジン*としては[想定通り](/ja/blog/clickhouse-and-parquet-a-foundation-for-fast-lakehouse-analytics-jp)の結果です。
2. **Parquet**: Parquet ファイルを直接クエリする場合でも、ClickHouse は[述語プッシュダウン](/ja/blog/clickhouse-and-parquet-a-foundation-for-fast-lakehouse-analytics-jp)(最小値/最大値統計および Bloom フィルター)を使用して、すでに I/O を約半分に削減しています。ただし、PREWHERE や遅延実体化がないなどの現時点での制限により、まだ改善の余地があります。それでも性能は良好です。このクエリでは 14 GiB のうち 7 GiB が処理[され](https://github.com/ClickHouse/examples/blob/main/blog-examples/FastFormatReads/results/parquet_100000000_1000000_sorted_zstd_1746194936.json)、高い並列性(85 個の同時スレッド)のおかげで、コールド実行時間は 170 ミリ秒、ホット実行時間は 140 ミリ秒で完了しました。MergeTree より約 5 倍遅いものの、*ファイルフォーマット*としては依然として非常に高速です。
3. **その他のフォーマット**: 他のほとんどの入力フォーマット(**CSV**、**JSON**、**Arrow** など)は、主にデータの簡単なロードを目的としており、**Native** の場合は[システム間の効率的なデータ転送](https://clickhouse.com/blog/clickhouse-input-format-matchup-which-is-fastest-most-efficient)を目的として設計されているため、直接的な分析クエリ向けではありません。その結果、ClickBench クエリ 41 の実行にはコールドで 30〜43 秒、ホットで 29〜42 秒かかりました。これらのフォーマットに対してカラムプロジェクションのような I/O 削減技術を実装することは技術的に可能ですが、大規模な直接分析用途として一般的に想定されていないため、ClickHouse は現在それを行っていません。実際には、全データセット(最大 21 GiB)をスキャンしてパースする必要が生じるケースが多くなります。
#### 全 43 クエリ: 合計実行時間の比較
全体像を把握するために、下のグラフでは前のグラフと同じファイルフォーマット上で直接実行された ClickBench の全 43 クエリの総実行時間を比較しています。簡潔にまとめるため、実行時間の*合計値*のみを掲載しています。前述のとおり、クエリ対象のデータセットは各フォーマットについて事前ソートされ、ZSTD 圧縮されてディスクに保存されています。
比較のため、[単なる関心から](/ja/blog/clickhouse-and-parquet-a-foundation-for-fast-lakehouse-analytics-jp)ではありますが、ファイルベースのフォーマットと同じレイアウトを使用したネイティブ MergeTree テーブルも再度掲載しています。
> このグラフのすべての結果には、各フォーマットの事前ソート済み・ZSTD 圧縮バージョンを使用しています。この構成が、テストしたすべての組み合わせ(事前ソートの有無、圧縮なし・LZ4・ZSTD)の中で一貫して最も高速な実行時間を記録したためです。詳細に関心がある方のために、すべての組み合わせに関する完全な結果を[こちら](https://github.com/ClickHouse/examples/tree/2f9f05f7b04a1da6269b6d2c41499a9fa336c25c/blog-examples/FastFormatReads/results)で公開しており、コールド実行時間の*合計*に関する[要約グラフ](/uploads/Blog_Formats_Reads_016_66ce48c3ea.png)も用意しています。
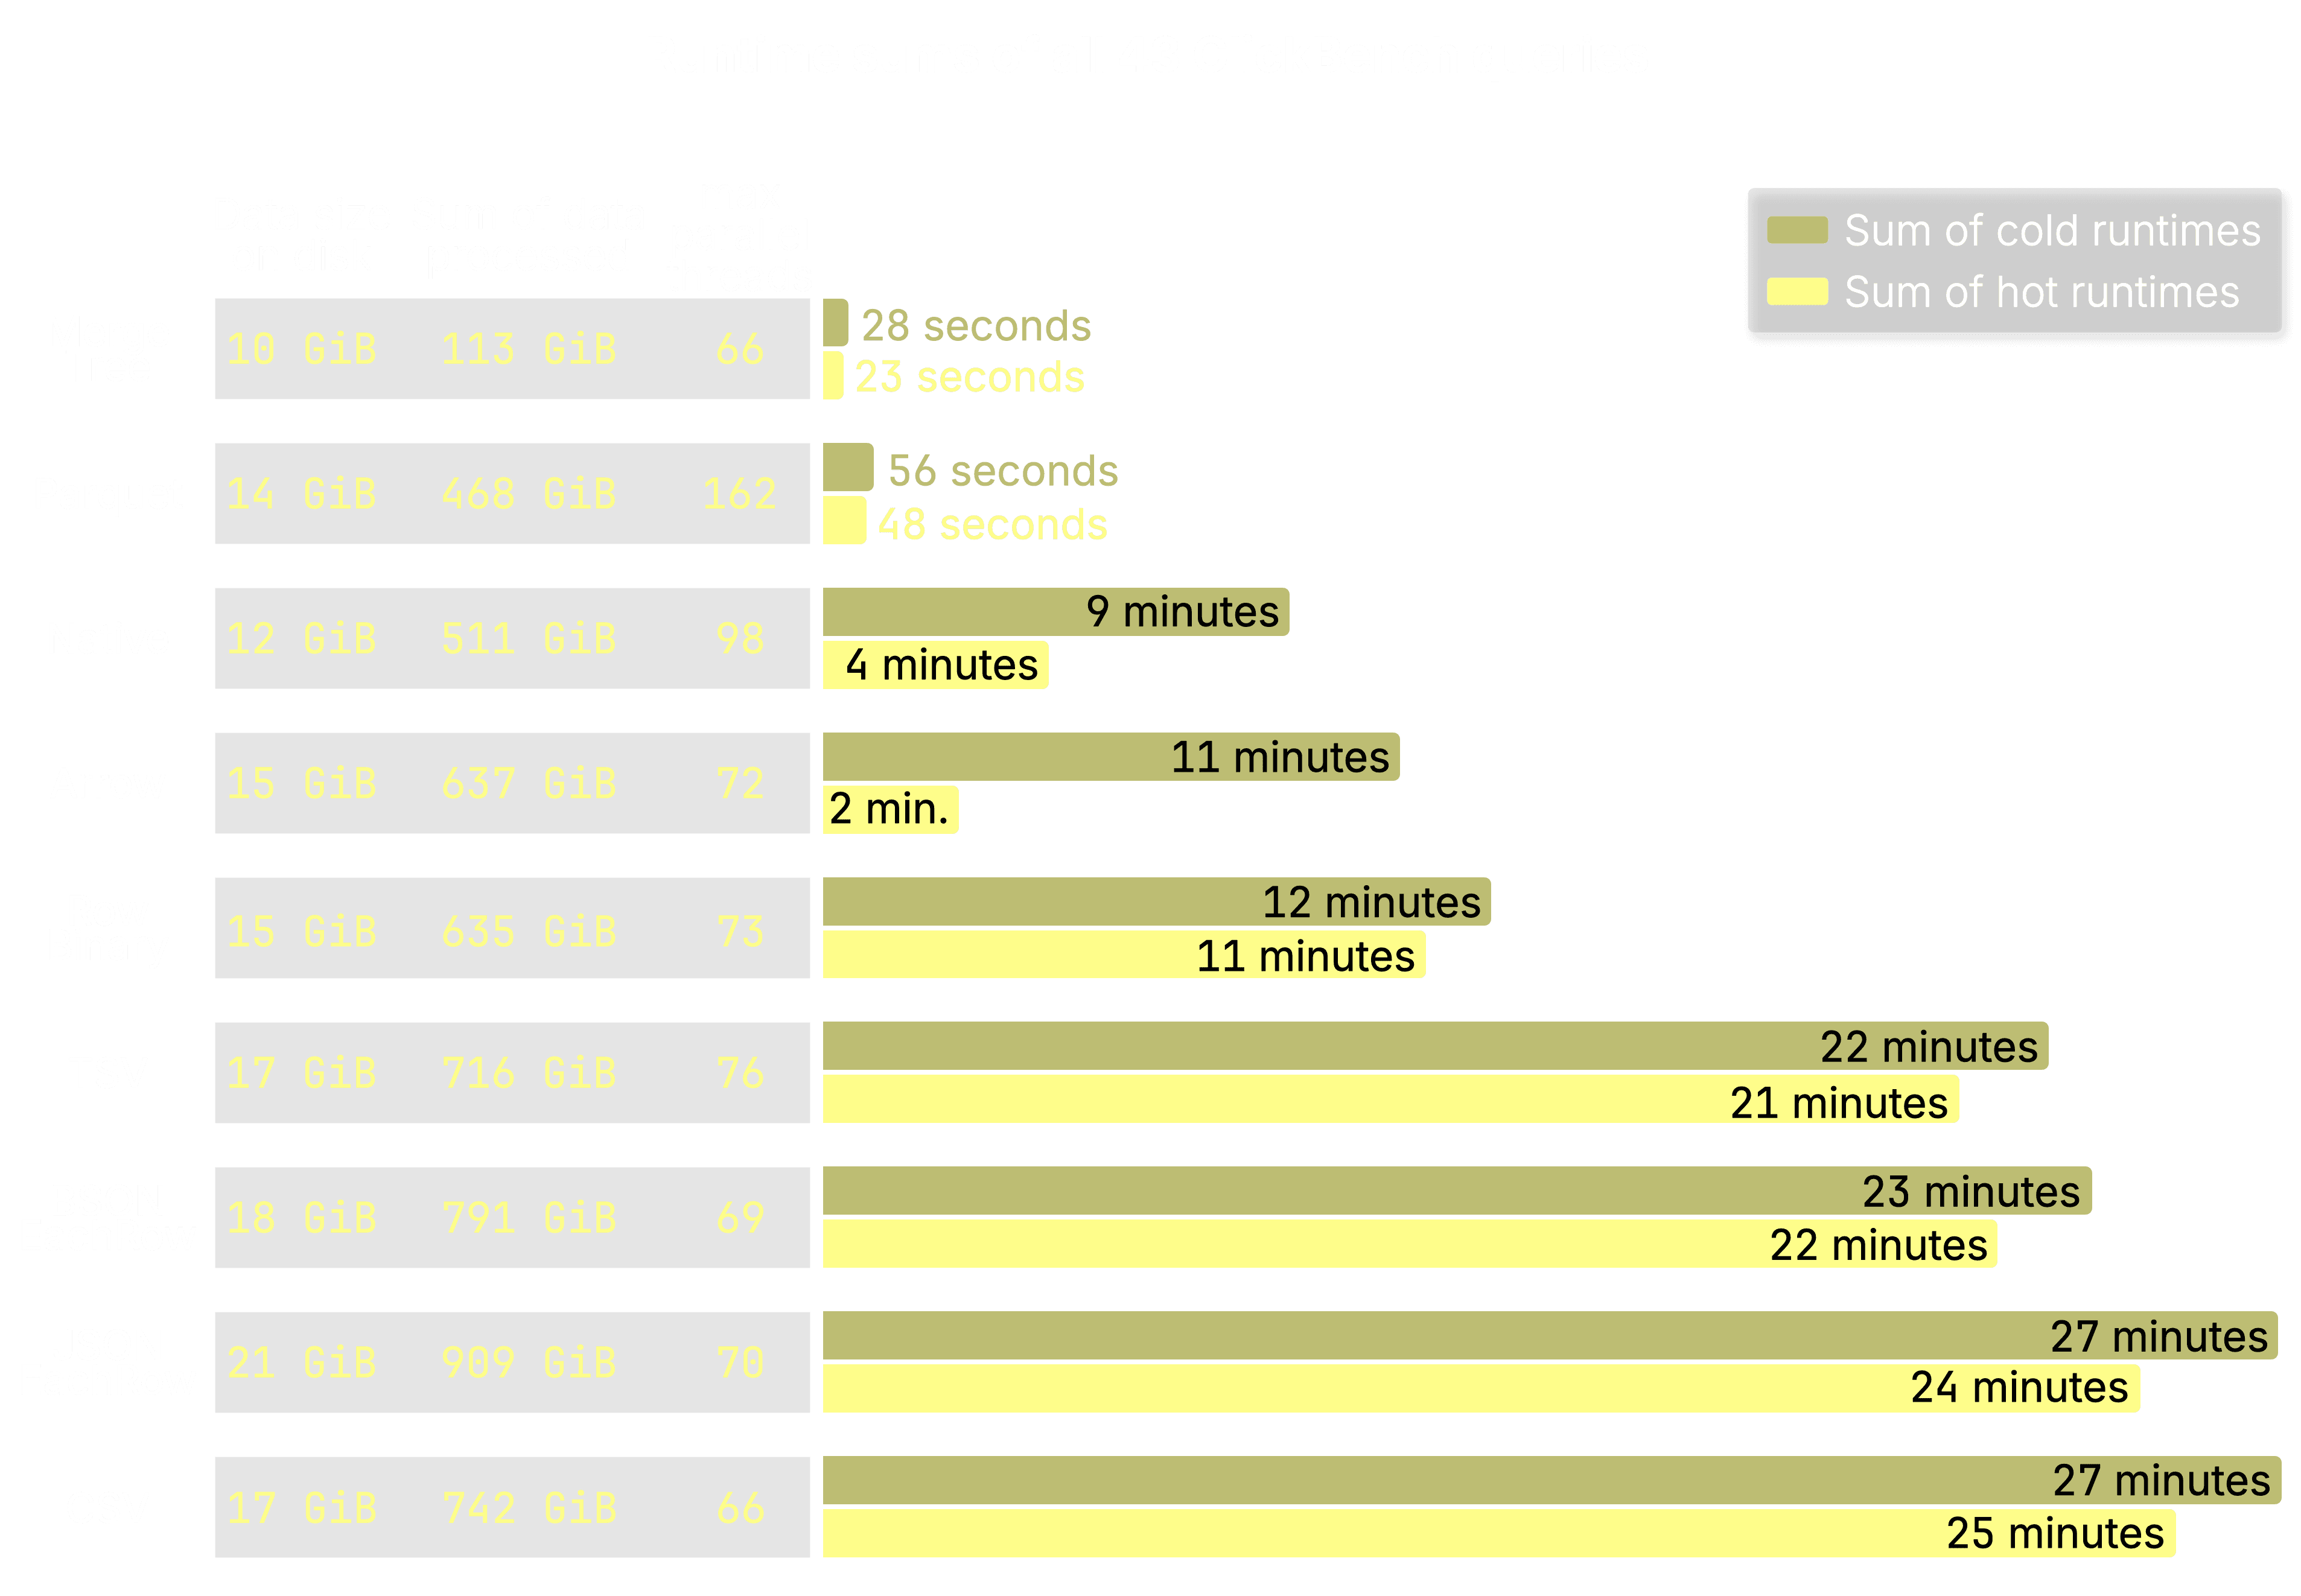
ClickBench の全 43 クエリにわたるコールド実行時間の合計値は、クエリ 41 で見られたものと同じパフォーマンス傾向を示しています。
1. **MergeTree**: 全クエリを通じて処理されたデータ量はわずか 113 GiB であり、MergeTree は圧倒的に効率的で、コールド実行時間はわずか 28 秒で完了しました。これはネイティブの最適化フルスタックによる積極的な I/O 削減の結果です。[予想通り](/ja/blog/clickhouse-and-parquet-a-foundation-for-fast-lakehouse-analytics-jp)の結果と言えます。
2. **Parquet**: PREWHERE や遅延実体化のサポートが現在はないにもかかわらず、現行のリーダーは良好なパフォーマンスを示しています。メタデータに基づく述語プッシュダウンと高い並列性(1 クエリあたり最大 162 個の同時処理スレッド)のおかげで、43 クエリ全体のワークロードをコールド実行時間わずか 56 秒で完了し、処理データ量は 468 GiB に抑えられました。これは、43 クエリのそれぞれがディスクから 14 GiB のデータセット全体を読み取り、フィルタリングなしでスキャンした場合の 602 GiB と比較して大幅な削減です。MergeTree(コールド 28 秒)と比べると約 2 倍遅いものの、*ファイルベースのフォーマット*としては依然として高速な性能を発揮しており、最小値/最大値統計や Bloom フィルターといった Parquet 組み込みの最適化の有効性を証明しています。
3. **その他のフォーマット**: **Native**、**Arrow**、**CSV**、**JSONEachRow** などのフォーマットは、大幅に高い I/O と遅い実行時間を示し、43 クエリ全体のワークロードを完了するのにコールドで 9〜27 分かかりました。これらのフォーマットには述語プッシュダウンや ClickHouse ネイティブの I/O 削減機能がないため、通常はデータセット全体をスキャンしてパースする必要があります。比較すると、Parquet(コールド 56 秒)より 10〜30 倍遅く、MergeTree(コールド 28 秒)より 20〜60 倍遅い結果となっています。
> 上のグラフには示されていませんが、特筆すべき点として、ClickHouse クエリエンジンが Parquet ファイルを直接クエリした場合、多くの一般的なデータストアが自身のネイティブフォーマットをクエリした場合よりも高速であることが挙げられます。同一のハードウェア上で、Postgres、Elasticsearch、MongoDB、MySQL などのエンジンが、それぞれの推奨テーブルレイアウト上で同じ ClickBench ワークロードを完了するのには、[コールド](https://benchmark.clickhouse.com/#eyJzeXN0ZW0iOnsiQWxsb3lEQiI6ZmFsc2UsIkFsbG95REIgKHR1bmVkKSI6ZmFsc2UsIkF0aGVuYSAocGFydGl0aW9uZWQpIjpmYWxzZSwiQXRoZW5hIChzaW5nbGUpIjpmYWxzZSwiQXVyb3JhIGZvciBNeVNRTCI6ZmFsc2UsIkF1cm9yYSBmb3IgUG9zdGdyZVNRTCI6ZmFsc2UsIkJpZ3F1ZXJ5Ijp0cnVlLCJCeUNvbml0eSI6ZmFsc2UsIkJ5dGVIb3VzZSI6ZmFsc2UsImNoREIgKERhdGFGcmFtZSkiOmZhbHNlLCJjaERCIChQYXJxdWV0LCBwYXJ0aXRpb25lZCkiOmZhbHNlLCJjaERCIjpmYWxzZSwiQ0hZVCI6ZmFsc2UsIkNpdHVzIjpmYWxzZSwiQ2xpY2tIb3VzZSBDbG91ZCAoYXdzKSI6ZmFsc2UsIkNsaWNrSG91c2UgQ2xvdWQgKGF6dXJlKSI6ZmFsc2UsIkNsaWNrSG91c2UgQ2xvdWQgKGdjcCkiOmZhbHNlLCJDbGlja0hvdXNlIChkYXRhIGxha2UsIHBhcnRpdGlvbmVkKSI6ZmFsc2UsIkNsaWNrSG91c2UgKGRhdGEgbGFrZSwgc2luZ2xlKSI6ZmFsc2UsIkNsaWNrSG91c2UgKFBhcnF1ZXQsIHBhcnRpdGlvbmVkKSI6ZmFsc2UsIkNsaWNrSG91c2UgKFBhcnF1ZXQsIHNpbmdsZSkiOnRydWUsIkNsaWNrSG91c2UgKHdlYikiOmZhbHNlLCJDbGlja0hvdXNlIjpmYWxzZSwiQ2xpY2tIb3VzZSAodHVuZWQpIjpmYWxzZSwiQ2xpY2tIb3VzZSAodHVuZWQsIG1lbW9yeSkiOmZhbHNlLCJDbG91ZGJlcnJ5IjpmYWxzZSwiQ3JhdGVEQiAodHVuZWQpIjpmYWxzZSwiQ3JhdGVEQiI6ZmFsc2UsIkNydW5jaHkgQnJpZGdlIGZvciBBbmFseXRpY3MgKFBhcnF1ZXQpIjpmYWxzZSwiRGFmdCAoUGFycXVldCwgcGFydGl0aW9uZWQpIjpmYWxzZSwiRGFmdCAoUGFycXVldCwgc2luZ2xlKSI6ZmFsc2UsIkRhdGFiZW5kIjpmYWxzZSwiRGF0YUZ1c2lvbiAoUGFycXVldCwgcGFydGl0aW9uZWQpIjpmYWxzZSwiRGF0YUZ1c2lvbiAoUGFycXVldCwgc2luZ2xlKSI6ZmFsc2UsIkFwYWNoZSBEb3JpcyI6ZmFsc2UsIkRyaWxsIjpmYWxzZSwiRHJ1aWQiOnRydWUsIkR1Y2tEQiAoRGF0YUZyYW1lKSI6ZmFsc2UsIkR1Y2tEQiAobWVtb3J5KSI6ZmFsc2UsIkR1Y2tEQiAoUGFycXVldCwgcGFydGl0aW9uZWQpIjpmYWxzZSwiRHVja0RCIjpmYWxzZSwiRWxhc3RpY3NlYXJjaCI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAodHVuZWQpIjpmYWxzZSwiR2xhcmVEQiI6ZmFsc2UsIkdyZWVucGx1bSI6dHJ1ZSwiSGVhdnlBSSI6ZmFsc2UsIkh5ZHJhIjpmYWxzZSwiU2FsZXNmb3JjZSBIeXBlciAoUGFycXVldCkiOmZhbHNlLCJTYWxlc2ZvcmNlIEh5cGVyIjpmYWxzZSwiSW5mb2JyaWdodCI6ZmFsc2UsIktpbmV0aWNhIjpmYWxzZSwiTWFyaWFEQiBDb2x1bW5TdG9yZSI6ZmFsc2UsIk1hcmlhREIiOmZhbHNlLCJNb25ldERCIjpmYWxzZSwiTW9uZ29EQiI6dHJ1ZSwiTW90aGVyRHVjayI6ZmFsc2UsIk15U1FMIChNeUlTQU0pIjp0cnVlLCJNeVNRTCI6dHJ1ZSwiT2N0b1NRTCI6ZmFsc2UsIk9wdGVyeXgiOmZhbHNlLCJPeGxhIjpmYWxzZSwiUGFuZGFzIChEYXRhRnJhbWUpIjpmYWxzZSwiUGFyYWRlREIgKFBhcnF1ZXQsIHBhcnRpdGlvbmVkKSI6ZmFsc2UsIlBhcmFkZURCIChQYXJxdWV0LCBzaW5nbGUpIjpmYWxzZSwiUGFyc2VhYmxlIChQYXJxdWV0LCBwYXJ0aXRpb25lZCkiOmZhbHNlLCJwZ19kdWNrZGIgKHdpdGggaW5kZXhlcykiOmZhbHNlLCJwZ19kdWNrZGIgKE1vdGhlckR1Y2sgZW5hYmxlZCkiOmZhbHNlLCJwZ19kdWNrZGIiOmZhbHNlLCJwZ19kdWNrZGIgKFBhcnF1ZXQpIjpmYWxzZSwiUG9zdGdyZVNRTCB3aXRoIHBnX21vb25jYWtlIjpmYWxzZSwicGdwcm9fdGFtIChwYXJxdWV0LCBsb2NhbCBzdG9yYWdlKSI6ZmFsc2UsInBncHJvX3RhbSAocGFycXVldCwgbG9jYWwsIHBhcmFsbGVsKSI6ZmFsc2UsInBncHJvX3RhbSAocGFycXVldCwgbG9jYWwgKyBjYWNoZSkiOmZhbHNlLCJwZ3Byb190YW0gKGZlYXRoZXIsIGxvY2FsICsgY2FjaGUpIjpmYWxzZSwiUGlub3QiOnRydWUsIlBvbGFycyAoRGF0YUZyYW1lKSI6ZmFsc2UsIlBvbGFycyAoUGFycXVldCkiOmZhbHNlLCJQb3N0Z3JlU1FMICh3aXRoIGluZGV4ZXMpIjp0cnVlLCJQb3N0Z3JlU1FMIjpmYWxzZSwiUXVlc3REQiI6ZmFsc2UsIlJlZHNoaWZ0IjpmYWxzZSwiU2VsZWN0REIiOmZhbHNlLCJTaWdMZW5zIjpmYWxzZSwiU2luZ2xlU3RvcmUiOmZhbHNlLCJTbm93Zmxha2UiOmZhbHNlLCJTcGFyayI6ZmFsc2UsIlNRTGl0ZSI6dHJ1ZSwiU3RhclJvY2tzIjpmYWxzZSwiVGFibGVzcGFjZSI6ZmFsc2UsIlRlbWJvIE9MQVAgKGNvbHVtbmFyKSI6ZmFsc2UsIlRpbWVzY2FsZSBDbG91ZCI6ZmFsc2UsIlRpbWVzY2FsZURCIChubyBjb2x1bW5zdG9yZSkiOmZhbHNlLCJUaW1lc2NhbGVEQiI6dHJ1ZSwiVGlueWJpcmQgKEZyZWUgVHJpYWwpIjpmYWxzZSwiVW1icmEiOmZhbHNlLCJVcnNhIjpmYWxzZSwiVmljdG9yaWFMb2dzIjpmYWxzZSwiWURCIjpmYWxzZX0sInR5cGUiOnsiQyI6dHJ1ZSwiY29sdW1uLW9yaWVudGVkIjp0cnVlLCJQb3N0Z3JlU1FMIGNvbXBhdGlibGUiOnRydWUsIm1hbmFnZWQiOnRydWUsImdjcCI6dHJ1ZSwic3RhdGVsZXNzIjp0cnVlLCJKYXZhIjp0cnVlLCJDKysiOnRydWUsIk15U1FMIGNvbXBhdGlibGUiOnRydWUsInJvdy1vcmllbnRlZCI6dHJ1ZSwic2VydmVybGVzcyI6dHJ1ZSwiQ2xpY2tIb3VzZSBkZXJpdmF0aXZlIjp0cnVlLCJlbWJlZGRlZCI6dHJ1ZSwiZGF0YWZyYW1lIjp0cnVlLCJZVHNhdXJ1cyI6dHJ1ZSwiYXdzIjp0cnVlLCJhenVyZSI6dHJ1ZSwiYW5hbHl0aWNhbCI6dHJ1ZSwiUnVzdCI6dHJ1ZSwic2VhcmNoIjp0cnVlLCJkb2N1bWVudCI6dHJ1ZSwiR28iOnRydWUsInNvbWV3aGF0IFBvc3RncmVTUUwgY29tcGF0aWJsZSI6dHJ1ZSwicGFycXVldCI6dHJ1ZSwidGltZS1zZXJpZXMiOnRydWUsImxvZ3MiOnRydWUsIlNpZ0xlbnMiOnRydWUsIm9ic2VydmFiaWxpdHkiOnRydWUsImRlZGljYXRlZCI6dHJ1ZX0sIm1hY2hpbmUiOnsiMTYgdkNQVSAxMjhHQiI6dHJ1ZSwiOCB2Q1BVIDY0R0IiOnRydWUsInNlcnZlcmxlc3MiOnRydWUsIjE2YWN1Ijp0cnVlLCJjNmEuNHhsYXJnZSwgNTAwZ2IgZ3AyIjp0cnVlLCJMIjp0cnVlLCJNIjp0cnVlLCJTIjp0cnVlLCJYUyI6dHJ1ZSwiYzZhLm1ldGFsLCA1MDBnYiBncDIiOmZhbHNlLCIxMiB2Q1BVIDQ4R0IiOnRydWUsIjEwIHZDUFUgNDBHQiI6dHJ1ZSwiMTJHaUIsIDEgcmVwbGljYShzKSI6dHJ1ZSwiOEdpQiwgMSByZXBsaWNhKHMpIjp0cnVlLCIxMkdpQiwgMiByZXBsaWNhKHMpIjp0cnVlLCIxMjBHaUIsIDIgcmVwbGljYShzKSI6dHJ1ZSwiMTZHaUIsIDIgcmVwbGljYShzKSI6dHJ1ZSwiMjM2R2lCLCAyIHJlcGxpY2EocykiOnRydWUsIjMyR2lCLCAyIHJlcGxpY2EocykiOnRydWUsIjY0R2lCLCAyIHJlcGxpY2EocykiOnRydWUsIjhHaUIsIDIgcmVwbGljYShzKSI6dHJ1ZSwiMTJHaUIsIDMgcmVwbGljYShzKSI6dHJ1ZSwiMTIwR2lCLCAzIHJlcGxpY2EocykiOnRydWUsIjE2R2lCLCAzIHJlcGxpY2EocykiOnRydWUsIjIzNkdpQiwgMyByZXBsaWNhKHMpIjp0cnVlLCIzMkdpQiwgMyByZXBsaWNhKHMpIjp0cnVlLCI2NEdpQiwgMyByZXBsaWNhKHMpIjp0cnVlLCI4R2lCLCAzIHJlcGxpY2EocykiOnRydWUsImM1bi40eGxhcmdlLCA1MDBnYiBncDIiOnRydWUsIkFuYWx5dGljcy0yNTZHQiAoNjQgdkNvcmVzLCAyNTYgR0IpIjp0cnVlLCJjNS40eGxhcmdlLCA1MDBnYiBncDIiOnRydWUsImM2YS40eGxhcmdlLCAxNTAwZ2IgZ3AyIjp0cnVlLCJYTCI6dHJ1ZSwiSnVtYm8iOnRydWUsIlB1bHNlIjp0cnVlLCJTdGFuZGFyZCI6dHJ1ZSwiMTYgdkNQVSAzMkdCIjp0cnVlLCJkYzIuOHhsYXJnZSI6dHJ1ZSwicmEzLjE2eGxhcmdlIjp0cnVlLCJyYTMuNHhsYXJnZSI6dHJ1ZSwicmEzLnhscGx1cyI6dHJ1ZSwiYzZhLjR4bGFyZ2UsIDcwMGdiIGdwMiI6dHJ1ZSwiUzIiOnRydWUsIlMyNCI6dHJ1ZSwiMlhMIjp0cnVlLCIzWEwiOnRydWUsIjRYTCI6dHJ1ZSwiTDEgLSAxNkNQVSAzMkdCIjp0cnVlLCJjNmEuNHhsYXJnZSwgNTAwZ2IgZ3AzIjp0cnVlLCIxNiB2Q1BVIDY0R0IiOnRydWUsIjQgdkNQVSAxNkdCIjp0cnVlLCI4IHZDUFUgMzJHQiI6dHJ1ZSwiNjQgdkNQVSAyNTZHQiI6dHJ1ZX0sImNsdXN0ZXJfc2l6ZSI6eyIxIjp0cnVlLCIyIjp0cnVlLCIzIjp0cnVlLCI0Ijp0cnVlLCI4Ijp0cnVlLCI5Ijp0cnVlLCIxNiI6dHJ1ZSwiMzIiOnRydWUsIjY0Ijp0cnVlLCIxMjgiOnRydWUsInNlcnZlcmxlc3MiOnRydWUsInVuZGVmaW5lZCI6dHJ1ZX0sIm1ldHJpYyI6ImNvbGQiLCJxdWVyaWVzIjpbdHJ1ZSx0cnVlLHRydWUsdHJ1ZSx0cnVlLHRydWUsdHJ1ZSx0cnVlLHRydWUsdHJ1ZSx0cnVlLHRydWUsdHJ1ZSx0cnVlLHRydWUsdHJ1ZSx0cnVlLHRydWUsdHJ1ZSx0cnVlLHRydWUsdHJ1ZSx0cnVlLHRydWUsdHJ1ZSx0cnVlLHRydWUsdHJ1ZSx0cnVlLHRydWUsdHJ1ZSx0cnVlLHRydWUsdHJ1ZSx0cnVlLHRydWUsdHJ1ZSx0cnVlLHRydWUsdHJ1ZSx0cnVlLHRydWUsdHJ1ZV19)と[ホット](https://benchmark.clickhouse.com/#eyJzeXN0ZW0iOnsiQWxsb3lEQiI6ZmFsc2UsIkFsbG95REIgKHR1bmVkKSI6ZmFsc2UsIkF0aGVuYSAocGFydGl0aW9uZWQpIjpmYWxzZSwiQXRoZW5hIChzaW5nbGUpIjpmYWxzZSwiQXVyb3JhIGZvciBNeVNRTCI6ZmFsc2UsIkF1cm9yYSBmb3IgUG9zdGdyZVNRTCI6ZmFsc2UsIkJpZ3F1ZXJ5Ijp0cnVlLCJCeUNvbml0eSI6ZmFsc2UsIkJ5dGVIb3VzZSI6ZmFsc2UsImNoREIgKERhdGFGcmFtZSkiOmZhbHNlLCJjaERCIChQYXJxdWV0LCBwYXJ0aXRpb25lZCkiOmZhbHNlLCJjaERCIjpmYWxzZSwiQ0hZVCI6ZmFsc2UsIkNpdHVzIjpmYWxzZSwiQ2xpY2tIb3VzZSBDbG91ZCAoYXdzKSI6ZmFsc2UsIkNsaWNrSG91c2UgQ2xvdWQgKGF6dXJlKSI6ZmFsc2UsIkNsaWNrSG91c2UgQ2xvdWQgKGdjcCkiOmZhbHNlLCJDbGlja0hvdXNlIChkYXRhIGxha2UsIHBhcnRpdGlvbmVkKSI6ZmFsc2UsIkNsaWNrSG91c2UgKGRhdGEgbGFrZSwgc2luZ2xlKSI6ZmFsc2UsIkNsaWNrSG91c2UgKFBhcnF1ZXQsIHBhcnRpdGlvbmVkKSI6ZmFsc2UsIkNsaWNrSG91c2UgKFBhcnF1ZXQsIHNpbmdsZSkiOnRydWUsIkNsaWNrSG91c2UgKHdlYikiOmZhbHNlLCJDbGlja0hvdXNlIjpmYWxzZSwiQ2xpY2tIb3VzZSAodHVuZWQpIjpmYWxzZSwiQ2xpY2tIb3VzZSAodHVuZWQsIG1lbW9yeSkiOmZhbHNlLCJDbG91ZGJlcnJ5IjpmYWxzZSwiQ3JhdGVEQiAodHVuZWQpIjpmYWxzZSwiQ3JhdGVEQiI6ZmFsc2UsIkNydW5jaHkgQnJpZGdlIGZvciBBbmFseXRpY3MgKFBhcnF1ZXQpIjpmYWxzZSwiRGFmdCAoUGFycXVldCwgcGFydGl0aW9uZWQpIjpmYWxzZSwiRGFmdCAoUGFycXVldCwgc2luZ2xlKSI6ZmFsc2UsIkRhdGFiZW5kIjpmYWxzZSwiRGF0YUZ1c2lvbiAoUGFycXVldCwgcGFydGl0aW9uZWQpIjpmYWxzZSwiRGF0YUZ1c2lvbiAoUGFycXVldCwgc2luZ2xlKSI6ZmFsc2UsIkFwYWNoZSBEb3JpcyI6ZmFsc2UsIkRyaWxsIjpmYWxzZSwiRHJ1aWQiOnRydWUsIkR1Y2tEQiAoRGF0YUZyYW1lKSI6ZmFsc2UsIkR1Y2tEQiAobWVtb3J5KSI6ZmFsc2UsIkR1Y2tEQiAoUGFycXVldCwgcGFydGl0aW9uZWQpIjpmYWxzZSwiRHVja0RCIjpmYWxzZSwiRWxhc3RpY3NlYXJjaCI6dHJ1ZSwiRWxhc3RpY3NlYXJjaCAodHVuZWQpIjpmYWxzZSwiR2xhcmVEQiI6ZmFsc2UsIkdyZWVucGx1bSI6dHJ1ZSwiSGVhdnlBSSI6ZmFsc2UsIkh5ZHJhIjpmYWxzZSwiU2FsZXNmb3JjZSBIeXBlciAoUGFycXVldCkiOmZhbHNlLCJTYWxlc2ZvcmNlIEh5cGVyIjpmYWxzZSwiSW5mb2JyaWdodCI6ZmFsc2UsIktpbmV0aWNhIjpmYWxzZSwiTWFyaWFEQiBDb2x1bW5TdG9yZSI6ZmFsc2UsIk1hcmlhREIiOmZhbHNlLCJNb25ldERCIjpmYWxzZSwiTW9uZ29EQiI6dHJ1ZSwiTW90aGVyRHVjayI6ZmFsc2UsIk15U1FMIChNeUlTQU0pIjp0cnVlLCJNeVNRTCI6dHJ1ZSwiT2N0b1NRTCI6ZmFsc2UsIk9wdGVyeXgiOmZhbHNlLCJPeGxhIjpmYWxzZSwiUGFuZGFzIChEYXRhRnJhbWUpIjpmYWxzZSwiUGFyYWRlREIgKFBhcnF1ZXQsIHBhcnRpdGlvbmVkKSI6ZmFsc2UsIlBhcmFkZURCIChQYXJxdWV0LCBzaW5nbGUpIjpmYWxzZSwiUGFyc2VhYmxlIChQYXJxdWV0LCBwYXJ0aXRpb25lZCkiOmZhbHNlLCJwZ19kdWNrZGIgKHdpdGggaW5kZXhlcykiOmZhbHNlLCJwZ19kdWNrZGIgKE1vdGhlckR1Y2sgZW5hYmxlZCkiOmZhbHNlLCJwZ19kdWNrZGIiOmZhbHNlLCJwZ19kdWNrZGIgKFBhcnF1ZXQpIjpmYWxzZSwiUG9zdGdyZVNRTCB3aXRoIHBnX21vb25jYWtlIjpmYWxzZSwicGdwcm9fdGFtIChwYXJxdWV0LCBsb2NhbCBzdG9yYWdlKSI6ZmFsc2UsInBncHJvX3RhbSAocGFycXVldCwgbG9jYWwsIHBhcmFsbGVsKSI6ZmFsc2UsInBncHJvX3RhbSAocGFycXVldCwgbG9jYWwgKyBjYWNoZSkiOmZhbHNlLCJwZ3Byb190YW0gKGZlYXRoZXIsIGxvY2FsICsgY2FjaGUpIjpmYWxzZSwiUGlub3QiOnRydWUsIlBvbGFycyAoRGF0YUZyYW1lKSI6ZmFsc2UsIlBvbGFycyAoUGFycXVldCkiOmZhbHNlLCJQb3N0Z3JlU1FMICh3aXRoIGluZGV4ZXMpIjp0cnVlLCJQb3N0Z3JlU1FMIjpmYWxzZSwiUXVlc3REQiI6ZmFsc2UsIlJlZHNoaWZ0IjpmYWxzZSwiU2VsZWN0REIiOmZhbHNlLCJTaWdMZW5zIjpmYWxzZSwiU2luZ2xlU3RvcmUiOmZhbHNlLCJTbm93Zmxha2UiOmZhbHNlLCJTcGFyayI6ZmFsc2UsIlNRTGl0ZSI6dHJ1ZSwiU3RhclJvY2tzIjpmYWxzZSwiVGFibGVzcGFjZSI6ZmFsc2UsIlRlbWJvIE9MQVAgKGNvbHVtbmFyKSI6ZmFsc2UsIlRpbWVzY2FsZSBDbG91ZCI6ZmFsc2UsIlRpbWVzY2FsZURCIChubyBjb2x1bW5zdG9yZSkiOmZhbHNlLCJUaW1lc2NhbGVEQiI6dHJ1ZSwiVGlueWJpcmQgKEZyZWUgVHJpYWwpIjpmYWxzZSwiVW1icmEiOmZhbHNlLCJVcnNhIjpmYWxzZSwiVmljdG9yaWFMb2dzIjpmYWxzZSwiWURCIjpmYWxzZX0sInR5cGUiOnsiQyI6dHJ1ZSwiY29sdW1uLW9yaWVudGVkIjp0cnVlLCJQb3N0Z3JlU1FMIGNvbXBhdGlibGUiOnRydWUsIm1hbmFnZWQiOnRydWUsImdjcCI6dHJ1ZSwic3RhdGVsZXNzIjp0cnVlLCJKYXZhIjp0cnVlLCJDKysiOnRydWUsIk15U1FMIGNvbXBhdGlibGUiOnRydWUsInJvdy1vcmllbnRlZCI6dHJ1ZSwic2VydmVybGVzcyI6dHJ1ZSwiQ2xpY2tIb3VzZSBkZXJpdmF0aXZlIjp0cnVlLCJlbWJlZGRlZCI6dHJ1ZSwiZGF0YWZyYW1lIjp0cnVlLCJZVHNhdXJ1cyI6dHJ1ZSwiYXdzIjp0cnVlLCJhenVyZSI6dHJ1ZSwiYW5hbHl0aWNhbCI6dHJ1ZSwiUnVzdCI6dHJ1ZSwic2VhcmNoIjp0cnVlLCJkb2N1bWVudCI6dHJ1ZSwiR28iOnRydWUsInNvbWV3aGF0IFBvc3RncmVTUUwgY29tcGF0aWJsZSI6dHJ1ZSwicGFycXVldCI6dHJ1ZSwidGltZS1zZXJpZXMiOnRydWUsImxvZ3MiOnRydWUsIlNpZ0xlbnMiOnRydWUsIm9ic2VydmFiaWxpdHkiOnRydWUsImRlZGljYXRlZCI6dHJ1ZX0sIm1hY2hpbmUiOnsiMTYgdkNQVSAxMjhHQiI6dHJ1ZSwiOCB2Q1BVIDY0R0IiOnRydWUsInNlcnZlcmxlc3MiOnRydWUsIjE2YWN1Ijp0cnVlLCJjNmEuNHhsYXJnZSwgNTAwZ2IgZ3AyIjp0cnVlLCJMIjp0cnVlLCJNIjp0cnVlLCJTIjp0cnVlLCJYUyI6dHJ1ZSwiYzZhLm1ldGFsLCA1MDBnYiBncDIiOmZhbHNlLCIxMiB2Q1BVIDQ4R0IiOnRydWUsIjEwIHZDUFUgNDBHQiI6dHJ1ZSwiMTJHaUIsIDEgcmVwbGljYShzKSI6dHJ1ZSwiOEdpQiwgMSByZXBsaWNhKHMpIjp0cnVlLCIxMkdpQiwgMiByZXBsaWNhKHMpIjp0cnVlLCIxMjBHaUIsIDIgcmVwbGljYShzKSI6dHJ1ZSwiMTZHaUIsIDIgcmVwbGljYShzKSI6dHJ1ZSwiMjM2R2lCLCAyIHJlcGxpY2EocykiOnRydWUsIjMyR2lCLCAyIHJlcGxpY2EocykiOnRydWUsIjY0R2lCLCAyIHJlcGxpY2EocykiOnRydWUsIjhHaUIsIDIgcmVwbGljYShzKSI6dHJ1ZSwiMTJHaUIsIDMgcmVwbGljYShzKSI6dHJ1ZSwiMTIwR2lCLCAzIHJlcGxpY2EocykiOnRydWUsIjE2R2lCLCAzIHJlcGxpY2EocykiOnRydWUsIjIzNkdpQiwgMyByZXBsaWNhKHMpIjp0cnVlLCIzMkdpQiwgMyByZXBsaWNhKHMpIjp0cnVlLCI2NEdpQiwgMyByZXBsaWNhKHMpIjp0cnVlLCI4R2lCLCAzIHJlcGxpY2EocykiOnRydWUsImM1bi40eGxhcmdlLCA1MDBnYiBncDIiOnRydWUsIkFuYWx5dGljcy0yNTZHQiAoNjQgdkNvcmVzLCAyNTYgR0IpIjp0cnVlLCJjNS40eGxhcmdlLCA1MDBnYiBncDIiOnRydWUsImM2YS40eGxhcmdlLCAxNTAwZ2IgZ3AyIjp0cnVlLCJYTCI6dHJ1ZSwiSnVtYm8iOnRydWUsIlB1bHNlIjp0cnVlLCJTdGFuZGFyZCI6dHJ1ZSwiMTYgdkNQVSAzMkdCIjp0cnVlLCJkYzIuOHhsYXJnZSI6dHJ1ZSwicmEzLjE2eGxhcmdlIjp0cnVlLCJyYTMuNHhsYXJnZSI6dHJ1ZSwicmEzLnhscGx1cyI6dHJ1ZSwiYzZhLjR4bGFyZ2UsIDcwMGdiIGdwMiI6dHJ1ZSwiUzIiOnRydWUsIlMyNCI6dHJ1ZSwiMlhMIjp0cnVlLCIzWEwiOnRydWUsIjRYTCI6dHJ1ZSwiTDEgLSAxNkNQVSAzMkdCIjp0cnVlLCJjNmEuNHhsYXJnZSwgNTAwZ2IgZ3AzIjp0cnVlLCIxNiB2Q1BVIDY0R0IiOnRydWUsIjQgdkNQVSAxNkdCIjp0cnVlLCI4IHZDUFUgMzJHQiI6dHJ1ZSwiNjQgdkNQVSAyNTZHQiI6dHJ1ZX0sImNsdXN0ZXJfc2l6ZSI6eyIxIjp0cnVlLCIyIjp0cnVlLCIzIjp0cnVlLCI0Ijp0cnVlLCI4Ijp0cnVlLCI5Ijp0cnVlLCIxNiI6dHJ1ZSwiMzIiOnRydWUsIjY0Ijp0cnVlLCIxMjgiOnRydWUsInNlcnZlcmxlc3MiOnRydWUsInVuZGVmaW5lZCI6dHJ1ZX0sIm1ldHJpYyI6ImhvdCIsInF1ZXJpZXMiOlt0cnVlLHRydWUsdHJ1ZSx0cnVlLHRydWUsdHJ1ZSx0cnVlLHRydWUsdHJ1ZSx0cnVlLHRydWUsdHJ1ZSx0cnVlLHRydWUsdHJ1ZSx0cnVlLHRydWUsdHJ1ZSx0cnVlLHRydWUsdHJ1ZSx0cnVlLHRydWUsdHJ1ZSx0cnVlLHRydWUsdHJ1ZSx0cnVlLHRydWUsdHJ1ZSx0cnVlLHRydWUsdHJ1ZSx0cnVlLHRydWUsdHJ1ZSx0cnVlLHRydWUsdHJ1ZSx0cnVlLHRydWUsdHJ1ZV19)のどちらの実行時間においても大幅に多くの時間を要しています。
##
## まとめ
この記事では、ClickHouse クエリエンジンの内部を掘り下げ、Iceberg や Delta Lake などのオープンテーブルフォーマットを支える列指向ストレージフォーマットである Parquet をどのようにクエリしているのか、そして現在のパフォーマンスがどのような水準にあるのかを紹介しました。
ClickHouse クエリエンジンは、設計上意図されたものとしてだけでなく、必然的にレイクハウス対応となっていることを示しました。事前の取り込みを行うことなく外部ファイルを直接クエリする能力は、当初からのコア機能です。
ClickHouse は長年にわたり Parquet 向けに最適化されてきました。私たちの目標はシンプルです。大規模な Parquet クエリにおいて世界最速のエンジンにすることです。
現行の Parquet リーダーはすでに高いパフォーマンスを発揮しており、ファイルの読み取りやパースからフィルタリング、ソート、集約に至るすべてのレイヤーで並列処理を適用し、最小値/最大値統計や Bloom フィルターなどのメタデータを用いて不要な処理をスキップしています。
パフォーマンスの差は歴然としています。ClickHouse は、Parquet ファイルを直接クエリするだけでも、多くの一般的なシステムが自身のネイティブフォーマットをクエリするより高速に動作します。
そして、さらに高速化が進んでいます。新しいネイティブ Parquet リーダーの開発が進んでおり、辞書ベースのフィルタリング、ページレベルの最小値/最大値統計、さらには PREWHERE や遅延実体化といった ClickHouse 独自の最適化機能への対応が予定されています。
最後に、Parquet を他のファイルフォーマットやネイティブの MergeTree と比較してベンチマークを実施しました。前提条件は完全に同じではありませんが(Parquet はファイルフォーマット、MergeTree は専用設計のテーブルエンジン)、クエリエンジンの Parquet に対するパフォーマンスが MergeTree に最も迫ったという結果は雄弁に物語っています。このことから、ClickHouse は Parquet のクエリが高速であるだけでなく、レイクハウスアーキテクチャの強固な基盤となることが分かります。
**この記事は連載の第 1 回です。次回は、ClickHouse がレイクハウススタックの上位レイヤーをどのように処理するかを探っていきます。上位レイヤーはすでに存在しています。ClickHouse はレイクハウスに対応しようとしているのではなく、すでにその領域に到達しています。どうぞご期待ください。**