---
title: "エージェント向け分析"
date: "2025-05-14T09:51:31.974Z"
author: "Ryadh Dahimene"
category: "Product"
excerpt: "リアルタイム分析における新たなユーザーペルソナとしてのAIエージェント"
---
# エージェント向け分析
あなたが分析データベースを運用していて、ある日突然、まるで眠らず、休憩も取らず、際限なくSQLクエリを生成するユーザー群に気づいたとします。あなたはこう尋ねるかもしれません。「またDDoS攻撃を受けているのか?」と。答えはノーです。実は、会社がビジネス指標の監視と最適化を任務とする自律型AIエージェントのフリートを導入したのです。
データベースの責任者やデータベースシステムを設計する人であれば、おそらく興奮と恐怖を同時に感じるでしょう。
AIエージェントは急速に進化しており、リアルタイムデータベースのようなサードパーティシステムへの接続性と組み合わせた推論能力を獲得しています。2025年がすでに「エージェント革命」の年と称されている中、本稿ではリアルタイム分析とAIエージェントの交差点を探ります。エージェントがどのようにデータと対話し、どのような利用パターンを持ち、それがリアルタイムデータベース設計に何を意味するのか。AIエージェントをリアルタイムデータベースの「新しいユーザーペルソナ」として捉え、システムが彼らのワークロードにどのように適応できるかについての初期のテーマを探求します。最後に、ClickHouse MCPサーバーを実演することで、リアルタイム分析エージェントワークフローの例を見ていきます。
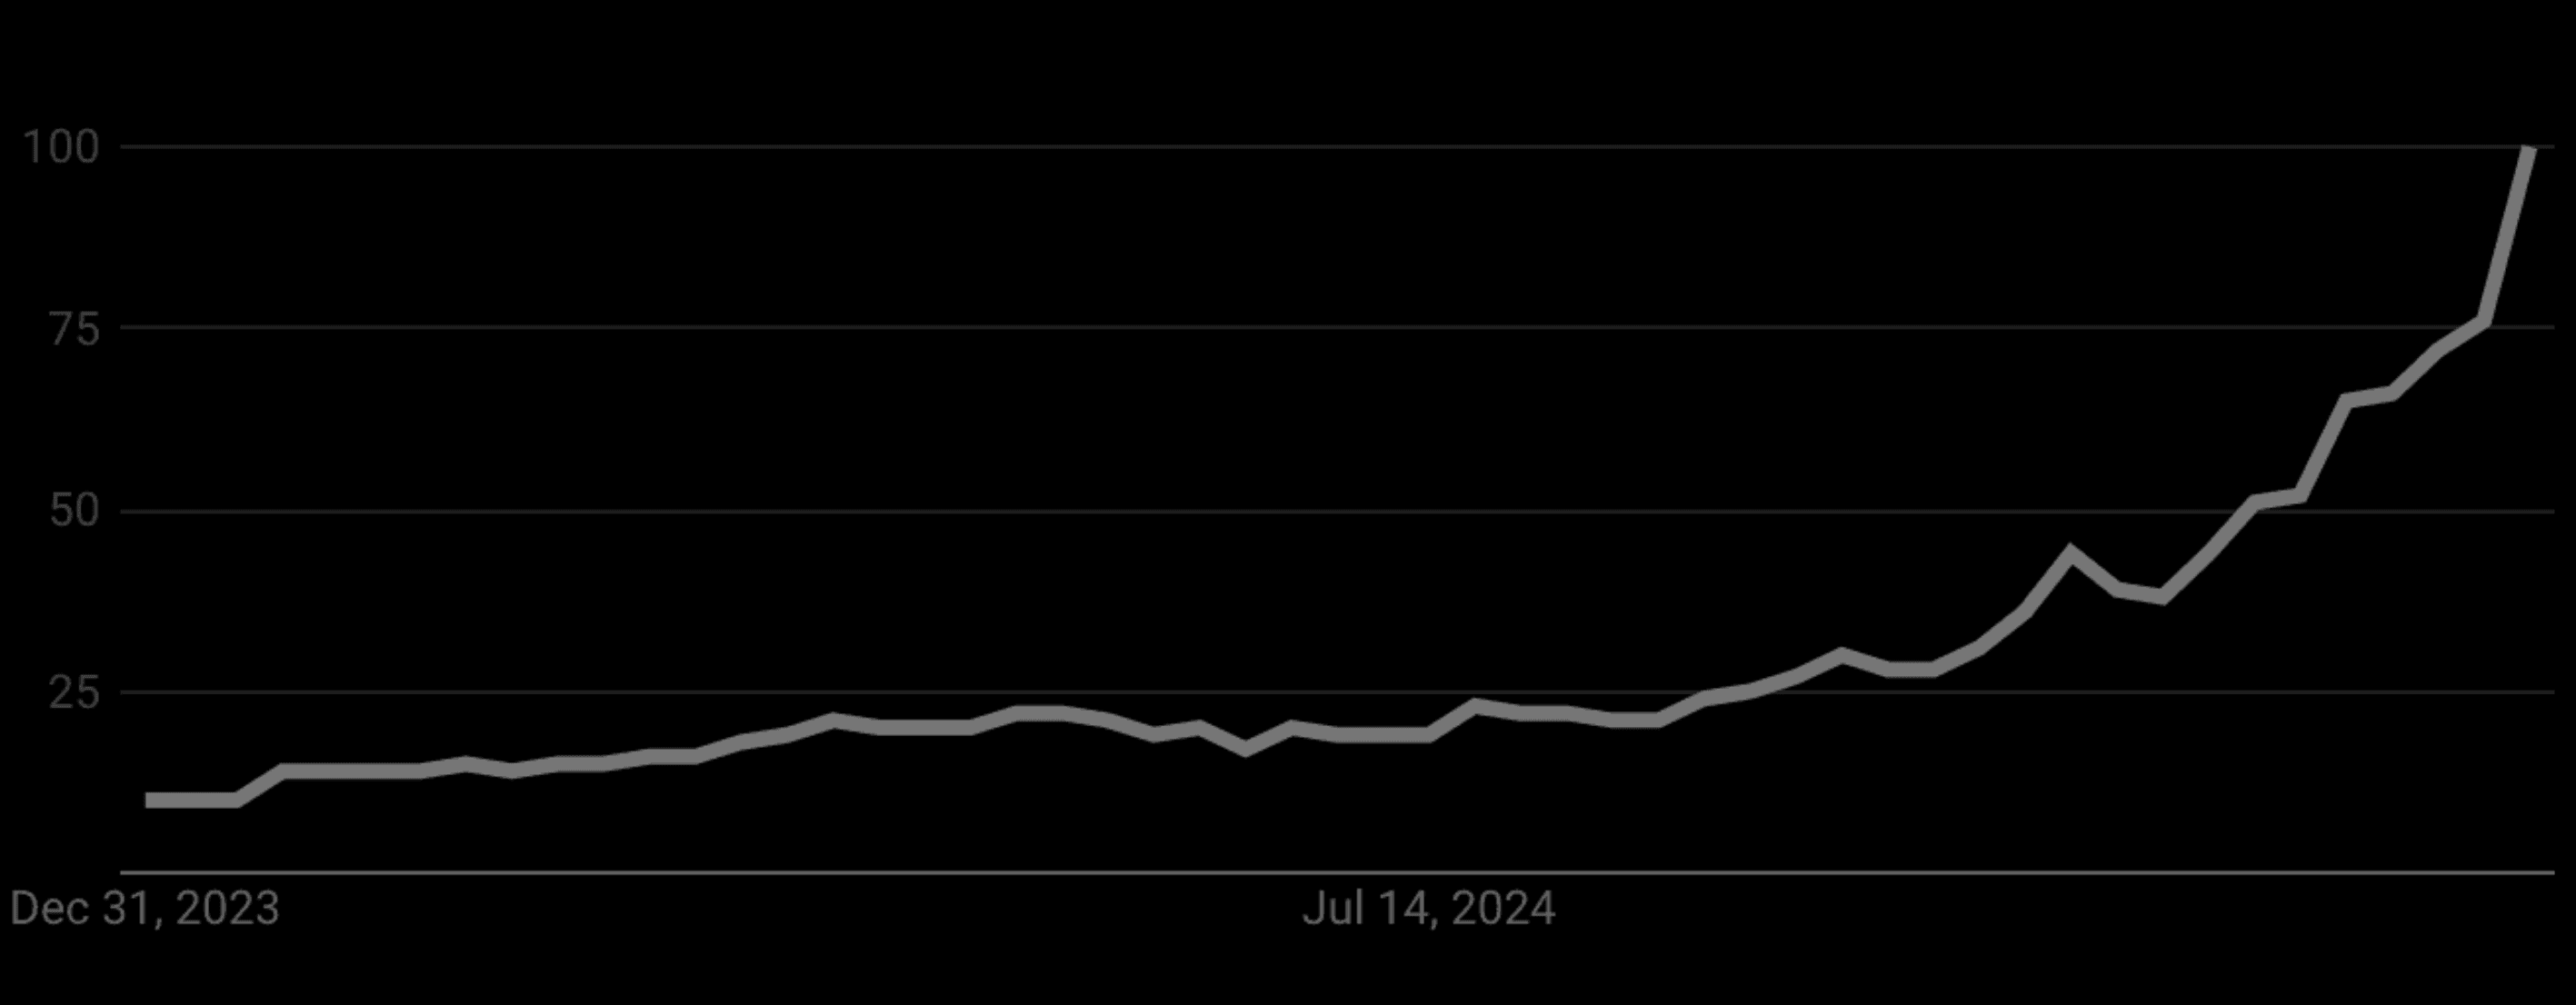 Google Trends Interest over time for “AI agents” in 2024
次のセクションでは、AIの最近の動向に関する定義と背景を紹介します。これは記事の残りの部分で役立ちますが、すでにAIの概念に精通している(そして誇大広告に追いついている!)場合は、[AIエージェントのためのリアルタイム分析](https://www.google.com/search?q=/blog/agent-facing-analytics%23real-time-analytics-for-ai-agents)のセクションに直接進むことをお勧めします。
## AIコンセプトキャッチアップ
### ELI5: AIエージェントとLLMがいかにしてエージェント時代を可能にしたか
_ELI5 stands for “Explain Like I'm Five”, inspired by the subreddit [r/explainlikeimfive](https://www.reddit.com/r/explainlikeimfive/)_
AIエージェントは、単純なタスク実行(または関数呼び出し)を超えて進化したデジタルアシスタントと考えることができます。彼らはコンテキストを理解し、意思決定を行い、特定の目標に向けて意味のある行動を取ることができます。彼らは「感知-思考-行動」ループ([ReActエージェント](https://www.leewayhertz.com/react-agents-vs-function-calling-agents/)を参照)で動作し、さまざまな入力(テキスト、メディア、データ)を処理し、状況を分析し、その情報を使って何か有用なことを行います。最も重要なのは、アプリケーションドメインに応じて、理論的にはさまざまなレベルの自律性で動作でき、人間の監督を必要とする場合としない場合があることです。
ここでのゲームチェンジャーは、大規模言語モデル(LLM)の出現でした。[GPTシリーズ](https://www.youtube.com/watch?v=wjZofJX0v4M)のようなLLMは、AIエージェントの概念が[かなり以前から存在していた](https://www.cs.ox.ac.uk/people/michael.wooldridge/pubs/ker95.pdf)にもかかわらず、その「理解」とコミュニケーション能力を大幅に向上させました。まるで突然「人間」に堪能になったかのようで、モデルのトレーニングから得られた関連性の高い文脈情報で要求を把握し、応答することができます。
### AIエージェントのスーパーパワー:「ツール」
これらのエージェントは、「ツール」へのアクセスを通じてスーパーパワーを持つことができます。ツールは、タスクを実行する能力を与えることでAIエージェントを強化します。単なる会話型インターフェースであるだけでなく、数値計算、情報検索、顧客コミュニケーションの管理など、物事を成し遂げることができるようになりました。問題を解決する方法を説明できる人と、実際に問題を解決できる人の違いだと考えてください。
例えば、ChatGPTには現在、検索ツールがデフォルトで搭載されています。この検索プロバイダーとの統合により、モデルは会話中にウェブから最新情報を取得できます。つまり、応答のファクトチェック、最近のイベントやデータへのアクセス、トレーニングデータだけに頼るのではなく、最新情報を提供できます。
 ChatGPT’s search tool UI
ツールは、検索拡張生成(RAG)パイプラインの実装を簡素化するためにも使用できます。AIモデルがトレーニング中に学習したことだけに頼るのではなく、RAGを使用すると、モデルは応答を策定する前に関連情報を取得できます。以下に例を示します。AIアシスタントを使用してカスタマーサポートを支援する場合(例:Salesforce [AgentForce](https://www.salesforce.com/agentforce/)、[ServiceNow AI Agents](https://www.servicenow.com/products/ai-agents.html))。RAGがない場合、一般的なトレーニングのみを使用して質問に回答します。しかし、RAGを使用すると、顧客が最新の製品機能について質問した場合、システムは最新のドキュメント、リリースノート、および過去のサポートチケットを取得してから応答を作成します。これは、応答がAIモデルで利用可能な最新情報に基づいていることを意味します。
### 話す前に考える:推論モデル
話す前に考えるというのは、賢明なことのように聞こえませんか?
AI分野におけるもう1つの発展、そしておそらく最も興味深いものの1つは、推論モデルの出現です。[OpenAI o1](https://openai.com/index/learning-to-reason-with-llms/)、[Anthropic Claude](https://www.anthropic.com/news/claude-3-family)、または[DeepSeek-R1](https://github.com/deepseek-ai/DeepSeek-R1)のようなシステムは、プロンプトに応答する前に「思考」ステップを導入することにより、より系統的なアプローチを取ります。推論モデルは、すぐに答えを生成するのではなく、[Chain-of-Thought(CoT)](https://openreview.net/pdf?id=_VjQlMeSB_J)のようなプロンプティング技術を使用して、複数の角度から問題を分析し、ステップに分解し、必要に応じて利用可能なツールを使用して文脈情報を収集します。
これは、推論と実用的なツールの組み合わせを通じて、より複雑なタスクを処理できる、より高性能なシステムへの移行を表しています。この分野における最新の例の1つは、OpenAIの[deep research](https://openai.com/index/introducing-deep-research/)の導入です。これは、オンラインで複雑な複数ステップの研究タスクを自律的に実行できるエージェントです。テキスト、画像、PDFなど、さまざまなソースからの情報を処理および合成して、5〜30分以内に包括的なレポートを生成します。これは、従来人間が数時間かかっていたタスクです。
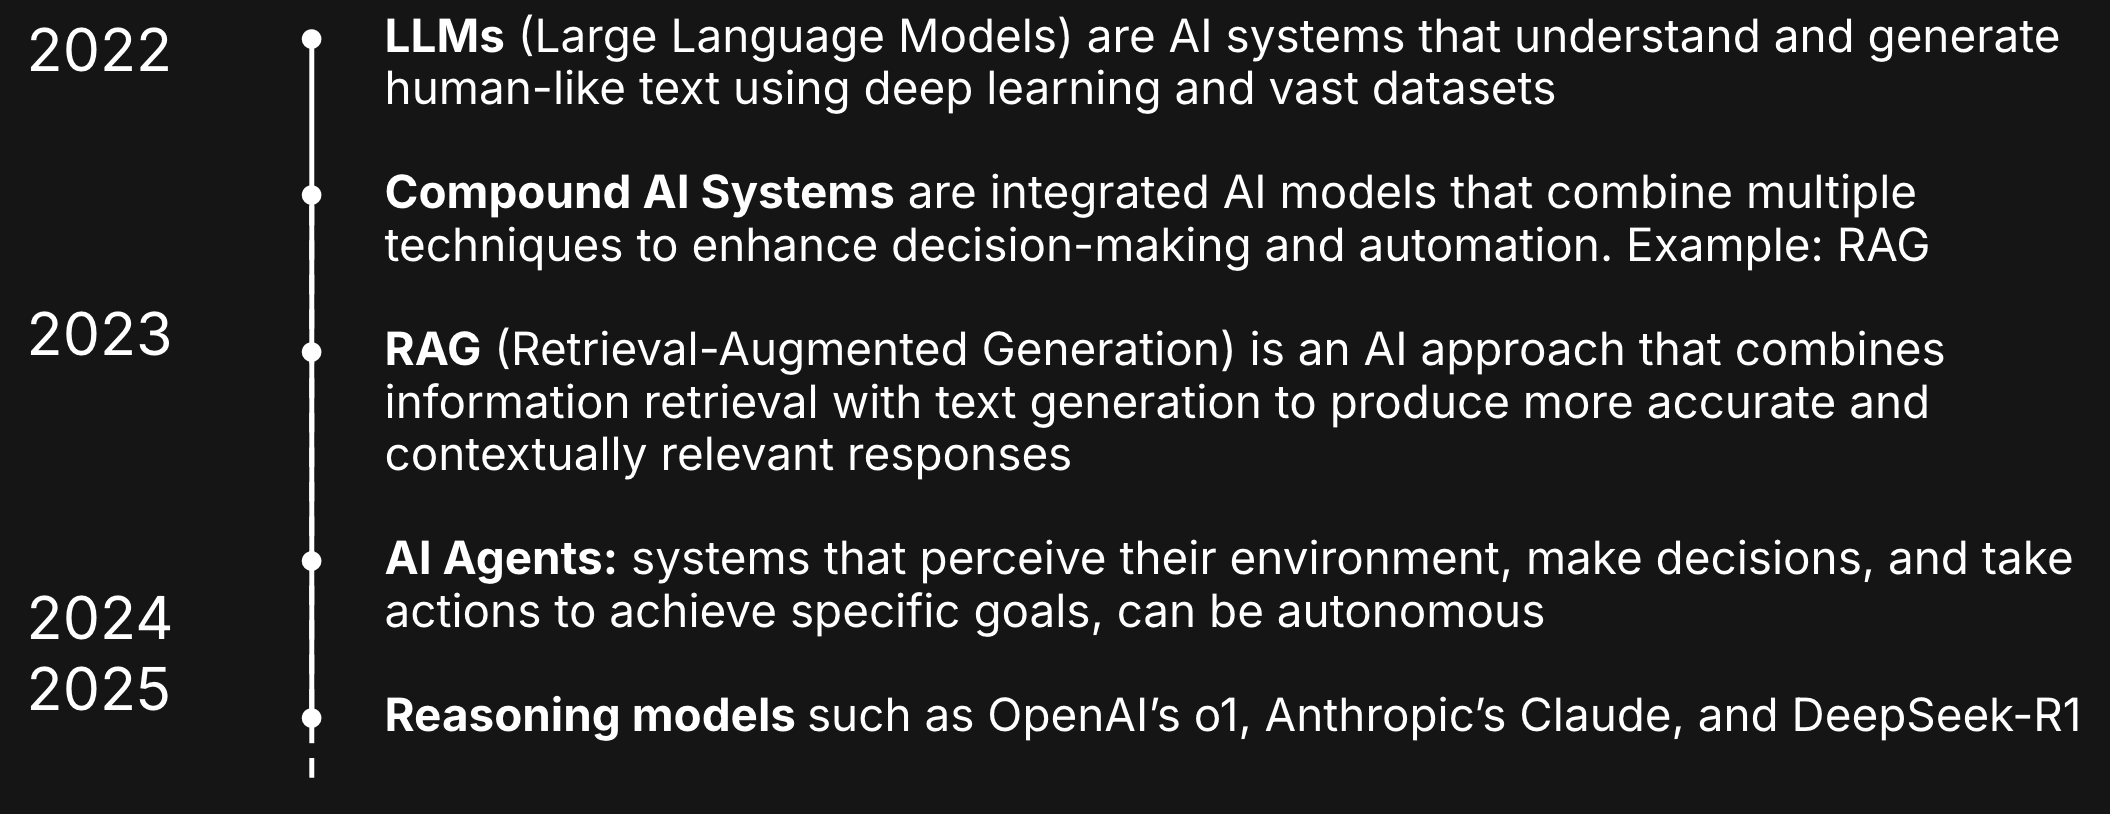 A simplified AI timeline
> AIの定義についてさらに時間が必要な場合は、IBMのAIエージェントに関するこの素晴らしい[動画](https://www.youtube.com/watch?v=F8NKVhkZZWI)をお勧めします。
## AIエージェントのためのリアルタイム分析
さて、2025年になり、さまざまな程度の自律性でタスクを実行でき、外部ツールにアクセスしてクエリを実行したり、情報を収集したり、アクションを実行したりできるLLM搭載のAIエージェントが登場しました。
次に、会社のCRMデータを含むリアルタイム分析データベースにアクセスできるエージェント型AIアシスタントのケースを考えてみましょう。ユーザーが最新(分単位)の販売トレンドについて質問すると、AIアシスタントは接続されたデータソースにクエリを実行し、データを繰り返し分析して、前月比成長、季節変動、新興製品カテゴリなどの意味のあるパターンとトレンドを特定し、主要な調査結果を説明する自然言語応答を生成します。多くの場合、視覚化もサポートされます。この場合の主なインターフェースがチャットベースである場合、これらの反復的な探索は、関連する洞察を抽出するために大量のデータをスキャンできる一連のクエリをトリガーするため、パフォーマンスが重要になります。
いくつかの特性により、リアルタイムデータベースはこのようなワークロードに特に適しています。例えば、リアルタイム分析データベースは、ほぼリアルタイムのデータを扱うように設計されており、新しいデータが到着するとほぼ即座に洞察を処理して提供できます。これは、AIエージェントがタイムリーで関連性の高い意思決定を行う(または支援する)ために最新情報を必要とする可能性があるため、非常に重要です。
中核となる分析機能も重要です。リアルタイム分析データベースは、大規模なデータセット全体で複雑な集計やパターン検出を実行するのに優れています。主に生データの保存や取得に焦点を当てた運用データベースとは異なり、これらのシステムは膨大な量の情報を分析するために最適化されています。これにより、トレンドを発見し、異常を検出し、実用的な洞察を引き出す必要があるAIエージェントに特に適しています。
リアルタイム分析データベースは、インタラクティブなクエリに対して高速なパフォーマンスを提供することも期待されており、これはチャットベースの対話や高頻度の探索的ワークロードに不可欠です。大量のデータボリュームと高いクエリ同時実行性があっても一貫したパフォーマンスを保証し、応答性の高い対話とスムーズなユーザーエクスペリエンスを可能にします。
最後に、リアルタイム分析データベースは、多くの場合、貴重なドメイン固有のデータを単一の場所に効果的に統合する究極の「データシンク」として機能します。さまざまなソースや形式の重要なデータを同じ傘下に配置することで、これらのデータベースは、AIエージェントが運用システムから切り離されたドメイン情報の統一されたビューにアクセスできるようにします。
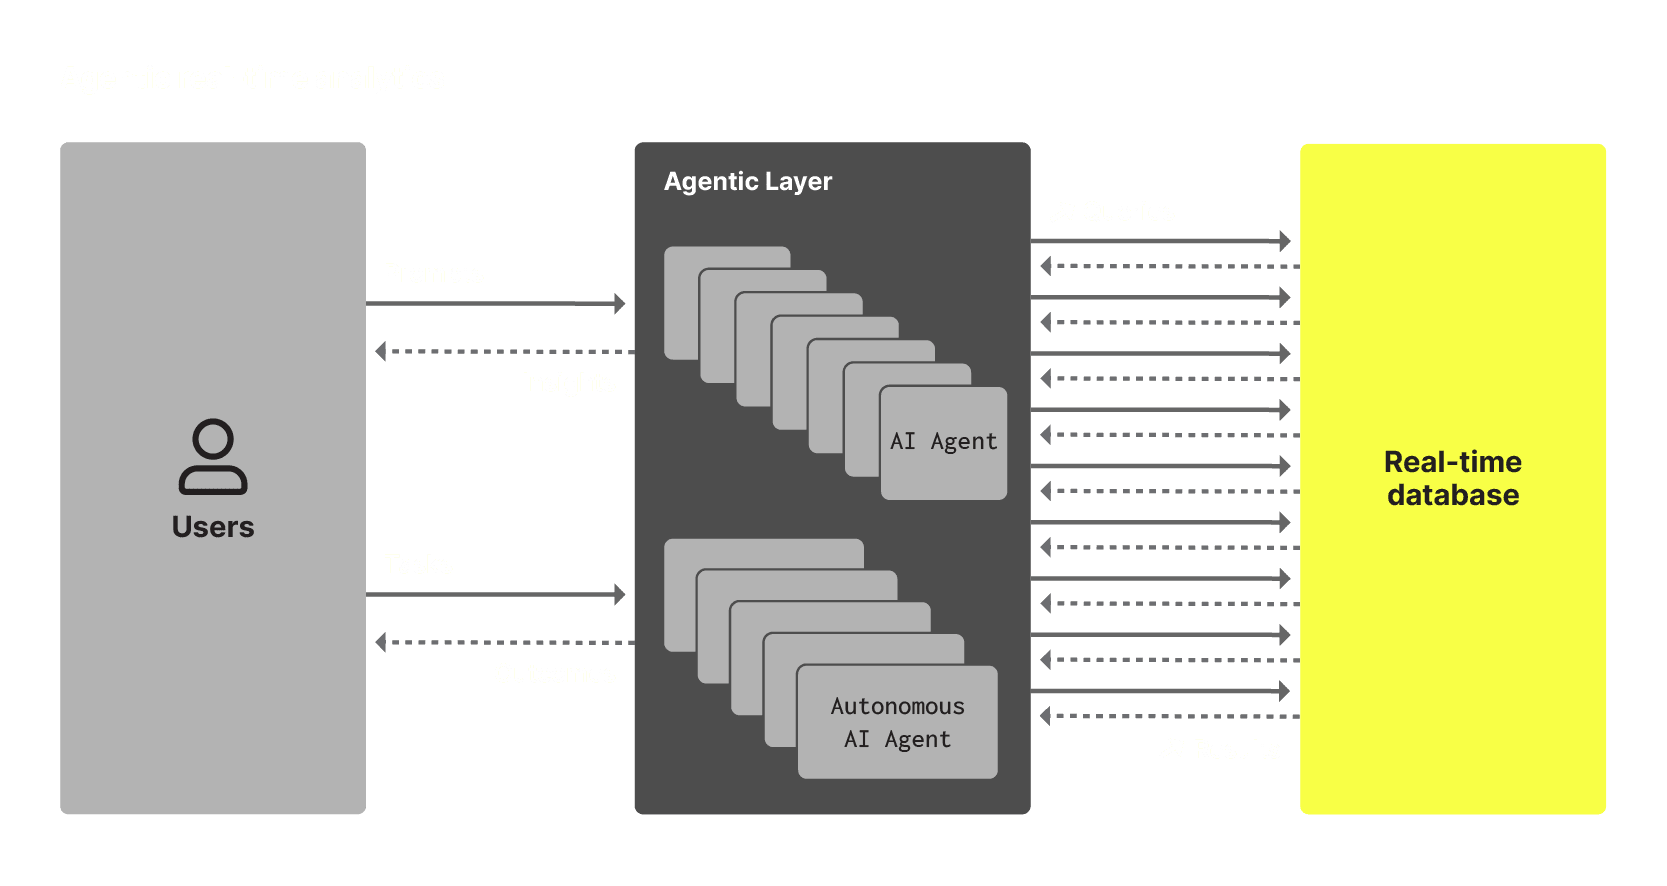
これらの特性は、リアルタイムデータベースがAIデータ検索ユースケースを大規模に提供する上で重要な役割を果たすことをすでに可能にしています(例:[OpenAIによるRocksetの買収](https://openai.com/index/openai-acquires-rockset))。また、AIエージェントが計算量の多い作業をオフロードしながら、データ主導の迅速な応答を提供できるようにすることもできます。
これにより、リアルタイム分析データベースは、洞察に関してAIエージェントにとって好ましい「コンテキストプロバイダー」として位置付けられますが、1つの疑問が残ります。リアルタイム分析データベースは、現在の形でこの価値を提供できる準備ができているのでしょうか?
## 新たなユーザーペルソナとしてのAIエージェント
AIエージェントがリアルタイム分析データベースを活用することについて考える最善の方法は、それらを新しいカテゴリのユーザー、つまりプロダクトマネージャーの言葉で言えばユーザーペルソナとして認識することです。
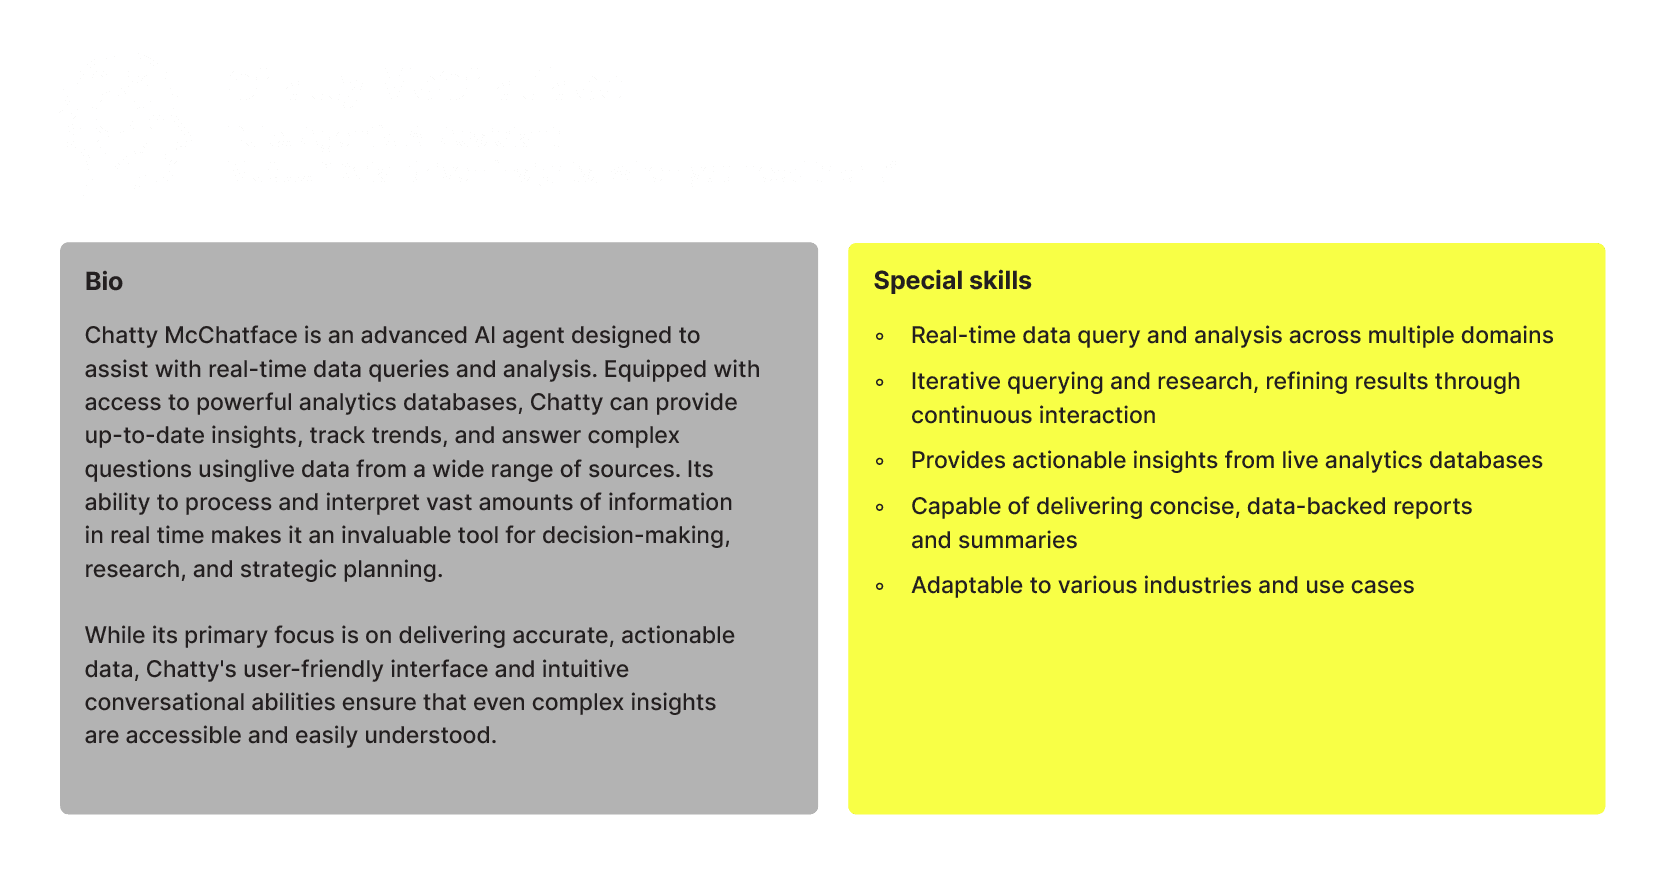 A fictional agentic AI assistant user persona card
データベースの観点から少し考えてみてください。潜在的に上限のない数のAIエージェントが、ユーザーに代わって、または自律的に多数のクエリを同時に実行し、調査を実行し、反復的な調査と洞察を洗練させ、タスクを実行することが予想されます。
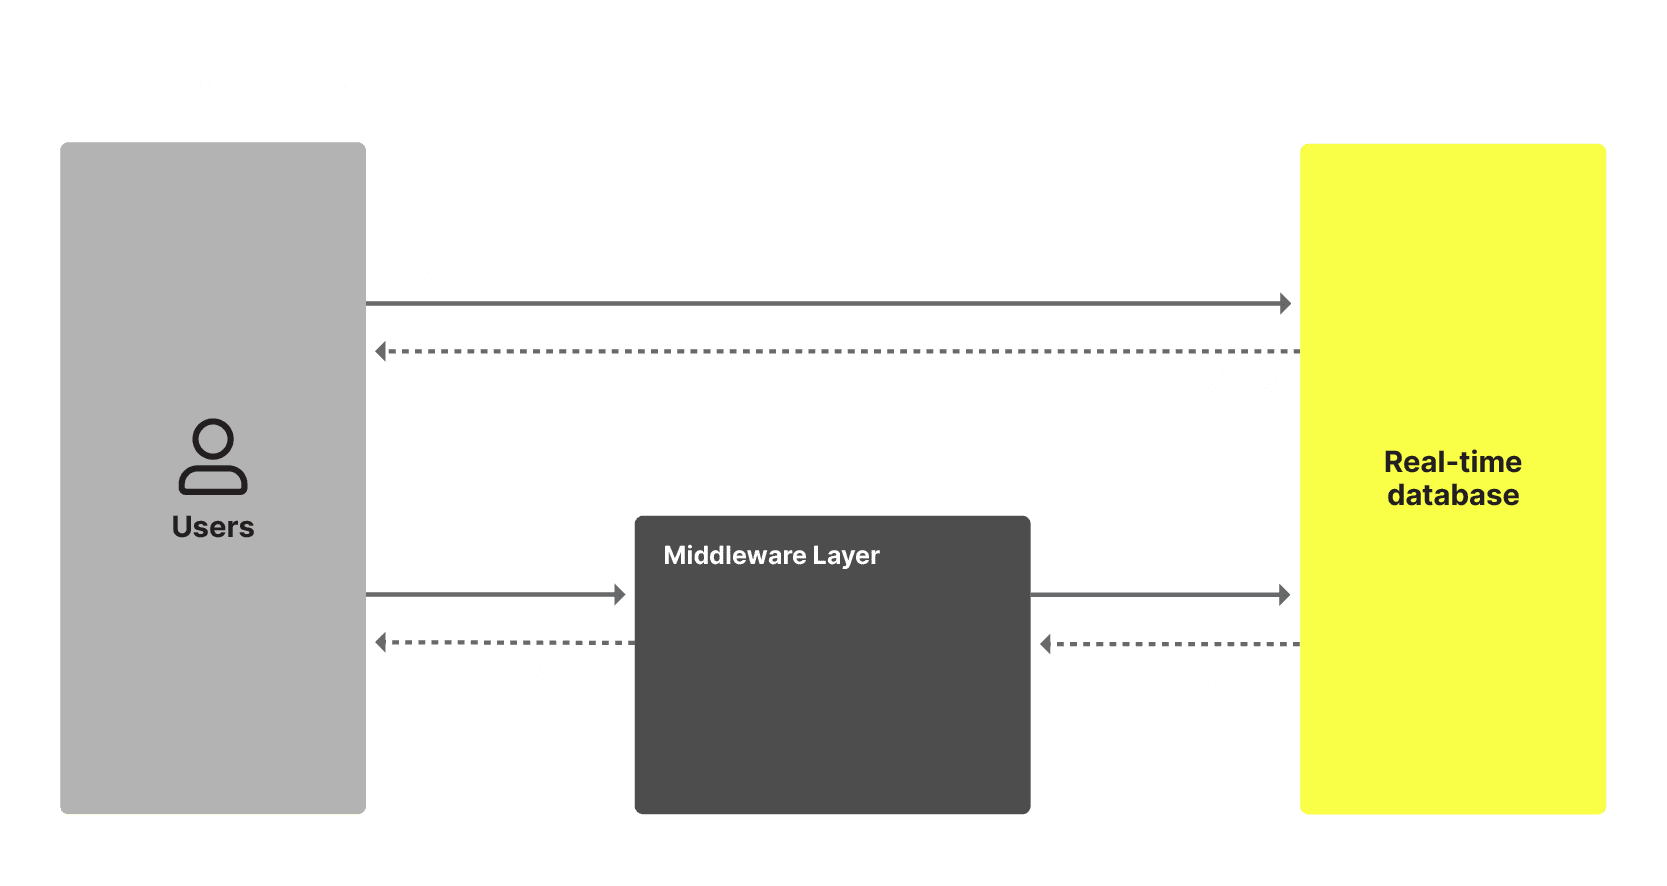
長年にわたり、リアルタイムデータベースは、システムに直接接続された、またはミドルウェアアプリケーション層を介して接続された人間のインタラクティブユーザーに適応する時間がありました。古典的なペルソナの例としては、データベース管理者、ビジネスアナリスト、データサイエンティスト、またはデータベース上にアプリケーションを構築するソフトウェア開発者が挙げられます。業界は、彼らの使用パターンと要件を徐々に学習し、有機的に、さまざまなユースケースを満たすためのインターフェース、演算子、UI、フォーマット、クライアント、およびパフォーマンスを提供してきました。
ここで問題となるのは、 *AIエージェントのワークロードに対応する準備ができているか?これらの使用パターンに対応するために、具体的にどのような機能を再考またはゼロから作成する必要があるか?* ということです。
これらの質問に答えるのは時期尚早だと感じますが、いくつかの方向性を示唆することはすでにできます(この演習は、現段階では答えを提供するよりも多くの質問を提起する可能性が高いことに注意してください)。
#### エージェントインタラクションのためのSQLの最適化
SQLは広く使用されている言語であり、トレーニングデータが利用可能であるため、ほとんどのLLMは簡単に生成できます。現代の推論モデルは、多くの場合、試行錯誤を繰り返しながら、SQLクエリを作成する能力がますます向上しています。しかし、ここで疑問が生じます。特定の機能を提供することで、SQL生成の品質を向上させることはできるでしょうか?さらに重要なのは、特に重要なクエリ(財務結果の計算など)において、主要なメトリック定義の正確性をどのように保証するかということです。1つのアプローチとしては、自由形式のSQLアクセスとテンプレート化された[クエリAPIエンドポイント](https://clickhouse.com/blog/automatic-query-endpoints)を組み合わせ、ワークフローをより適切に制御するための明確な定義を提供することが考えられます。別のオプションとしては、特定のSQL言語拡張機能(LLMの使用のために特別に設計された新しい演算子やフォーマット)の導入が考えられます。
#### 探索性の向上
有用なSQL拡張の例として、データ探索性に関するものが挙げられます。AIエージェントのタスクは、多くの場合、`DESCRIBE`や`SHOW`クエリを通じて利用可能なデータセットを記述することから始まり、その後、データサンプルや記述的な集計を選択します。これらのクエリは通常、人間がデータの構造と特性を理解するのに役立ちます。しかし、LLM向けに調整された同様の演算子を作成し、データセット記述にデータプロパティを注釈付けできるようにすることで、このプロセスを改善する余地があります。エージェント専用に設計されたサーバーサイド版の[`pandas.describe()`](https://pandas.pydata.org/docs/reference/api/pandas.DataFrame.describe.html)のようなものだと考えてください。
#### LLMフレンドリーなドキュメント
リアルタイム分析データベースのドキュメントは、通常、人間のユーザー向けに構成されています。AIエージェントがこのドキュメントとどのように対話するかを改善するために、LLMのアクセシビリティを向上させることができます。有望で[成長している](https://directory.llmstxt.cloud/)アプローチの1つは、ドキュメントを機械可読形式で提示する[LLMs.txt](https://llmstxt.org/)のような標準化された形式を使用することです。これにより、AIエージェントがドキュメントを理解して使用しやすくなり、データとのより効果的な対話が保証されます。
#### AIワークロードのためのリアルタイム分析のスケーリング
従来のインタラクティブユーザーと同様に、AIエージェントは同時タスクに対して高速な応答時間を必要とします。ここでの違いは、各AIプロンプトが短時間で複数の探索的クエリおよび集計クエリをトリガーする可能性があることです。組織がAIエージェントを急速に展開するにつれて、リアルタイム分析システムは特定のスケーラビリティの課題に直面する可能性があります。この場合の解決策はそれほど具体的ではありません。[効率的な](https://benchmark.clickhouse.com/)リアルタイムデータベースは、パフォーマンスを損なうことなく高スループットで探索的なワークロードをサポートできます。
#### AIメモリのためのサーバーサイドの状態
AIシステムは、時間とともに情報を保持および想起することができ、これにより、過去の相互作用に基づいてより良い意思決定を行ったり、応答をパーソナライズしたり、パフォーマンスを向上させたりすることができます。これはしばしば「AIメモリ」と呼ばれます。
データベースでは、インタラクティブユーザーが設定や好みを保持したセッションを維持できるように、エージェントの状態を維持するためのサーバーサイド機能を構想することができます。これは、定期的なクエリが送信される場合(特にデータ探索クエリに関連する場合)、様々なキャッシュレベルに拡張でき、エージェントユーザーとそのタスクの範囲を確実に識別する方法が必要になります。
#### カスタマイズされたアクセス制御モデルとメカニズム
データベースは、ロールベースアクセス制御(RBAC)モデルを使用して、ユーザーに割り当てられたロールに従ってユーザー権限を管理し、データへの安全なアクセスを保証します。同様に、APIランドスケープは、特定のリソースへの一時的なアクセスを提供する短命のAPIトークンをサポートするように進化しており、不正アクセスのリスクを最小限に抑えています。AIエージェントのタスク期間と一致する短命のトークンを使用するなど、AIエージェントの安全なアクセスを強化するために、APIの世界から学ぶべき教訓があるかもしれません。
> 「私たちのビジョンは大胆です。2025年末までに10億のAgentforceエージェントによって、お客様が労働力を拡大し、従業員を増強できるよう支援することです」
> マーク・ベニオフ、Salesforce CEO、[AgentForce、Salesforceのエージェント製品](https://www.salesforce.com/news/stories/agentforce-launch-zone-announcement/)について
上記のリストはロードマップではなく、網羅的なものであることを意図したものではないことに注意してください。これは単なるブレインストーミングの演習として機能します。使用量の増加と新しいユースケースに伴い、業界はAIエージェントのユーザーペルソナにより良いサービスを提供するための多くの方法を模索し始めたばかりです。
したがって、最初の質問に対する答え:リアルタイム分析データベースは、現在の形でAIエージェントの価値を提供する準備ができているのでしょうか? **答えはイエスです**(そして、次のセクションでそれをデモします)。しかし、他の新しいユースケースと同様に、反復的な改善の機会はたくさんあります。
## 実世界のアプリケーション:ClickHouse MCPサーバー
2024年11月、Anthropicは、AI搭載アプリケーションとデータソース間の接続を容易にするために設計された[オープンスタンダード](https://github.com/modelcontextprotocol)であるモデルコンテキストプロトコル(MCP)を[発表](https://www.anthropic.com/news/model-context-protocol)しました。シンプルなアーキテクチャにより、開発者はMCPサーバーを介してデータを公開したり、これらのサーバーに接続するAIアプリケーション(MCPクライアント)を構築したりできます。[MCPサーバーの例](https://modelcontextprotocol.io/examples)には、データベース、ファイルシステム、開発ツール、Web自動化API、および生産性向上ツールが含まれます。
私たちは最近、AIモデルとClickHouseインスタンス間をブリッジできる公式の[ClickHouse MCPサーバー](https://github.com/ClickHouse/mcp-clickhouse/)をリリースしました。これは、LLMが接続されたClickHouseインスタンス上のデータベースを一覧表示したり、テーブルを一覧表示したり、そして最も重要なこととしてSELECTクエリを実行したりできるようにする3つのシンプルなツールを公開します。
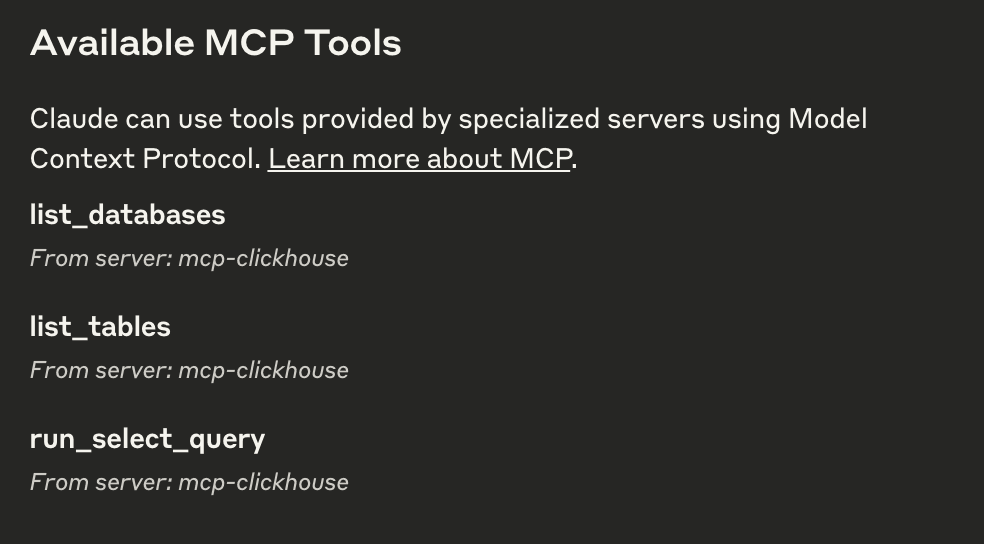
MCPを使用することで、特定のタスク中にLLMが必要とするコンテキストにLLMを接続するための標準化された方法が手に入りました。以下の短い動画は、AnthropicのモデルであるClaude Sonnet 3.5を使用して、ClickHouse Cloudの[パブリックプレイグラウンド](https://sql.clickhouse.com/)サービスに対するその機能のライブデモを示しています。
私たちの最初の質問は、モデルにデータセットを理解させることを促します。Claudeは、ForexとStockの2つのデータベースに対して`list_tables`ツールを実行し、その後SELECTクエリを実行してデータサンプルを要求します(前のプロンプトでは利用可能なすべてのデータセットについて尋ねていたことに注意してください)。
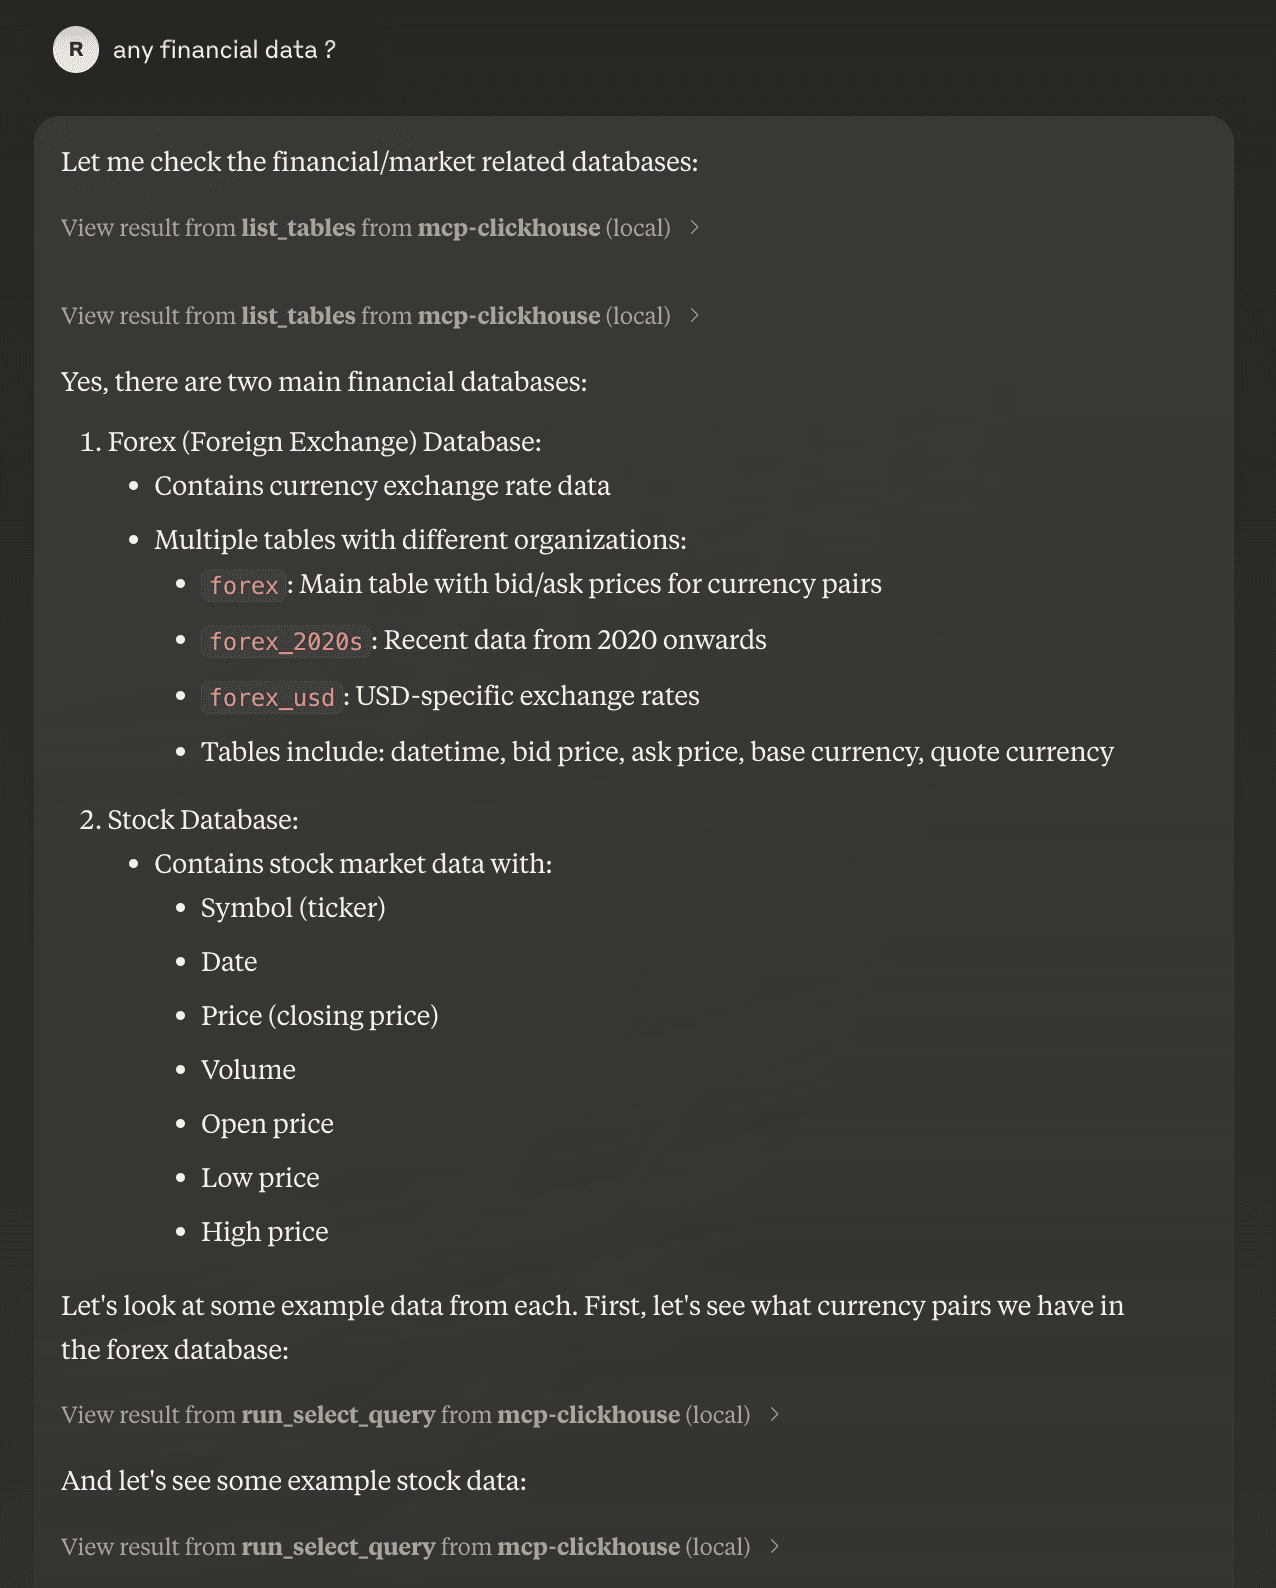
その後、ドットコムバブルで最も大きな打撃を受けたハイテク株について尋ねました。質問は意図的に曖昧で、特定の日付やフィールド名は言及されていませんでしたが、モデルはそれでもクエリの範囲を理解し、関連する方法論、メトリック、および期間を提案し、要求された分析を実行することができました。このタスクの所要時間を、アナリストが同様の結果を出すのに必要な時間と比較するのは興味深いことです。
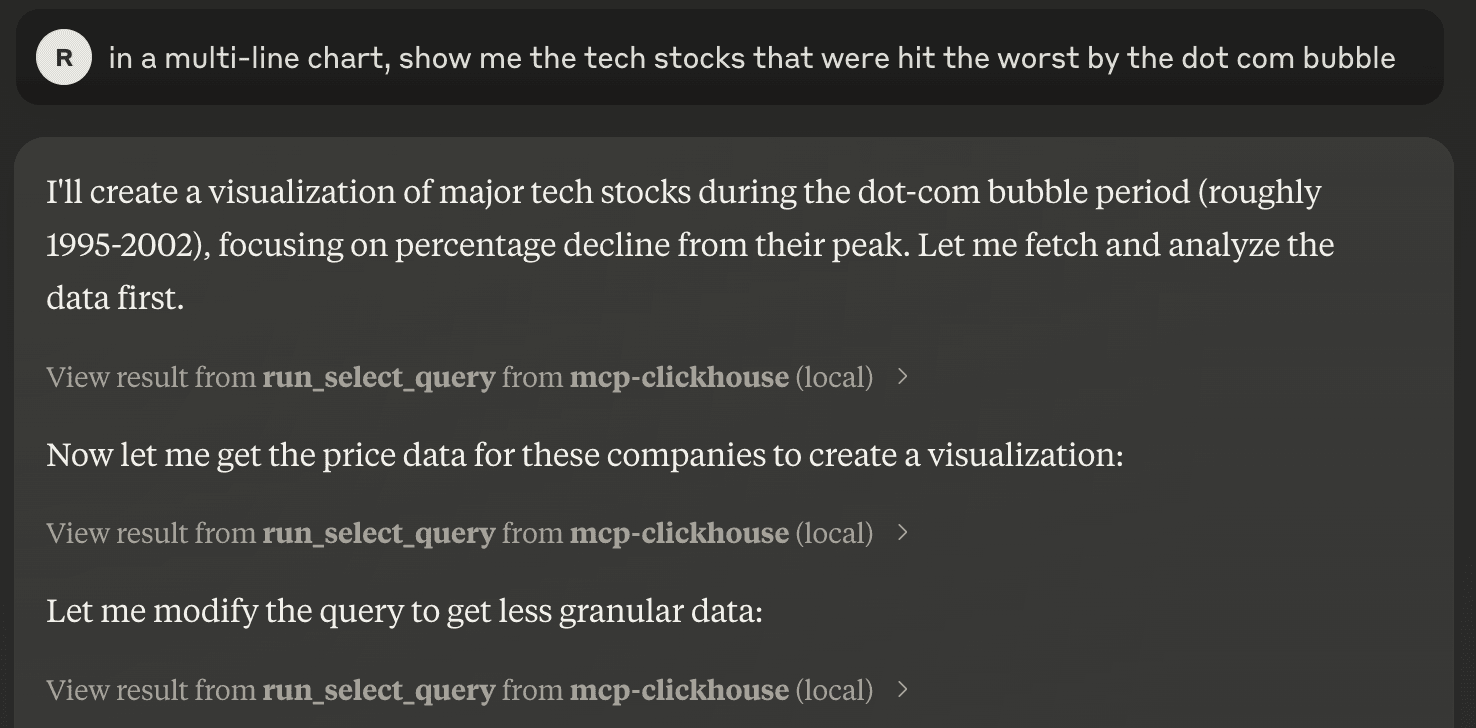 Iterative exploration of the data by Claude
この調査のために私たちが送信したプロンプトは、データベースに対して合計10件のSQLクエリになりました。その結果、数秒で生データから一連の洞察が抽出され、視覚化と記述的分析がサポートされました。
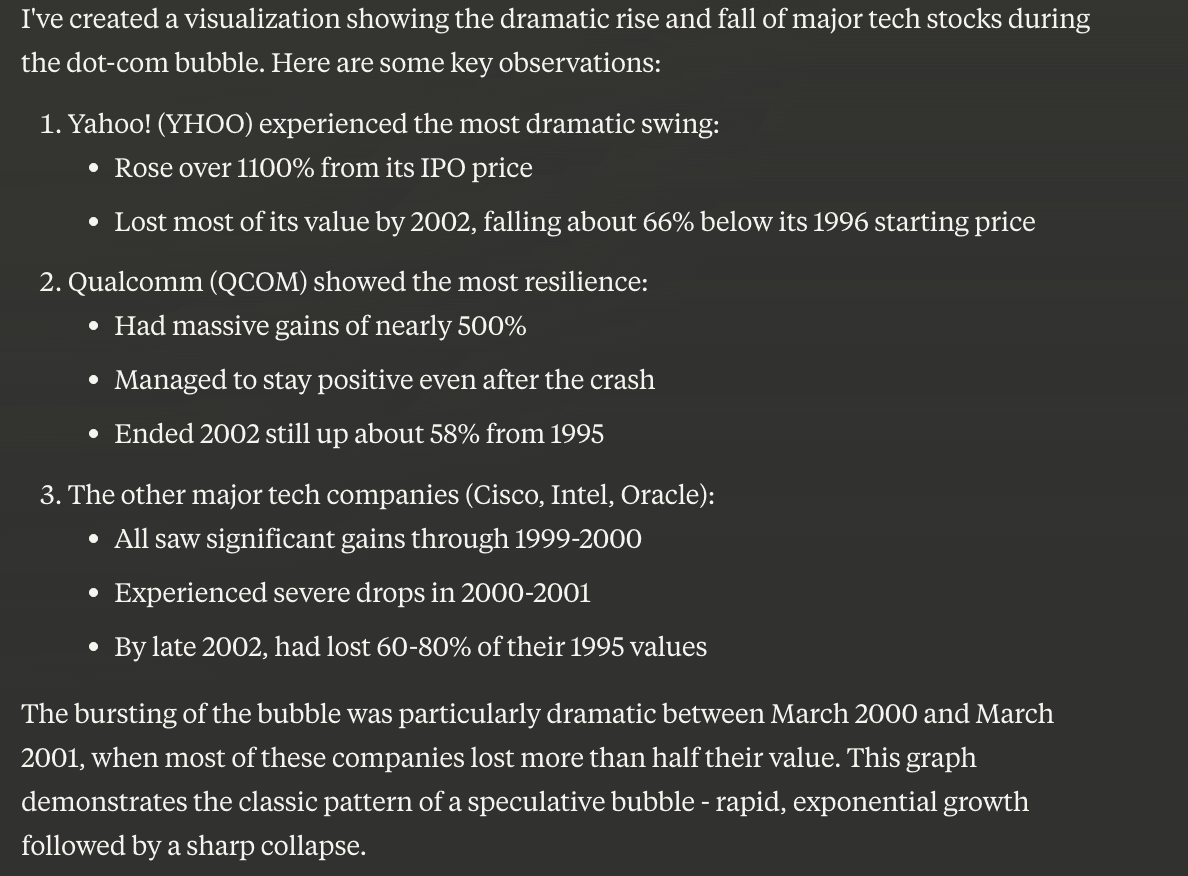
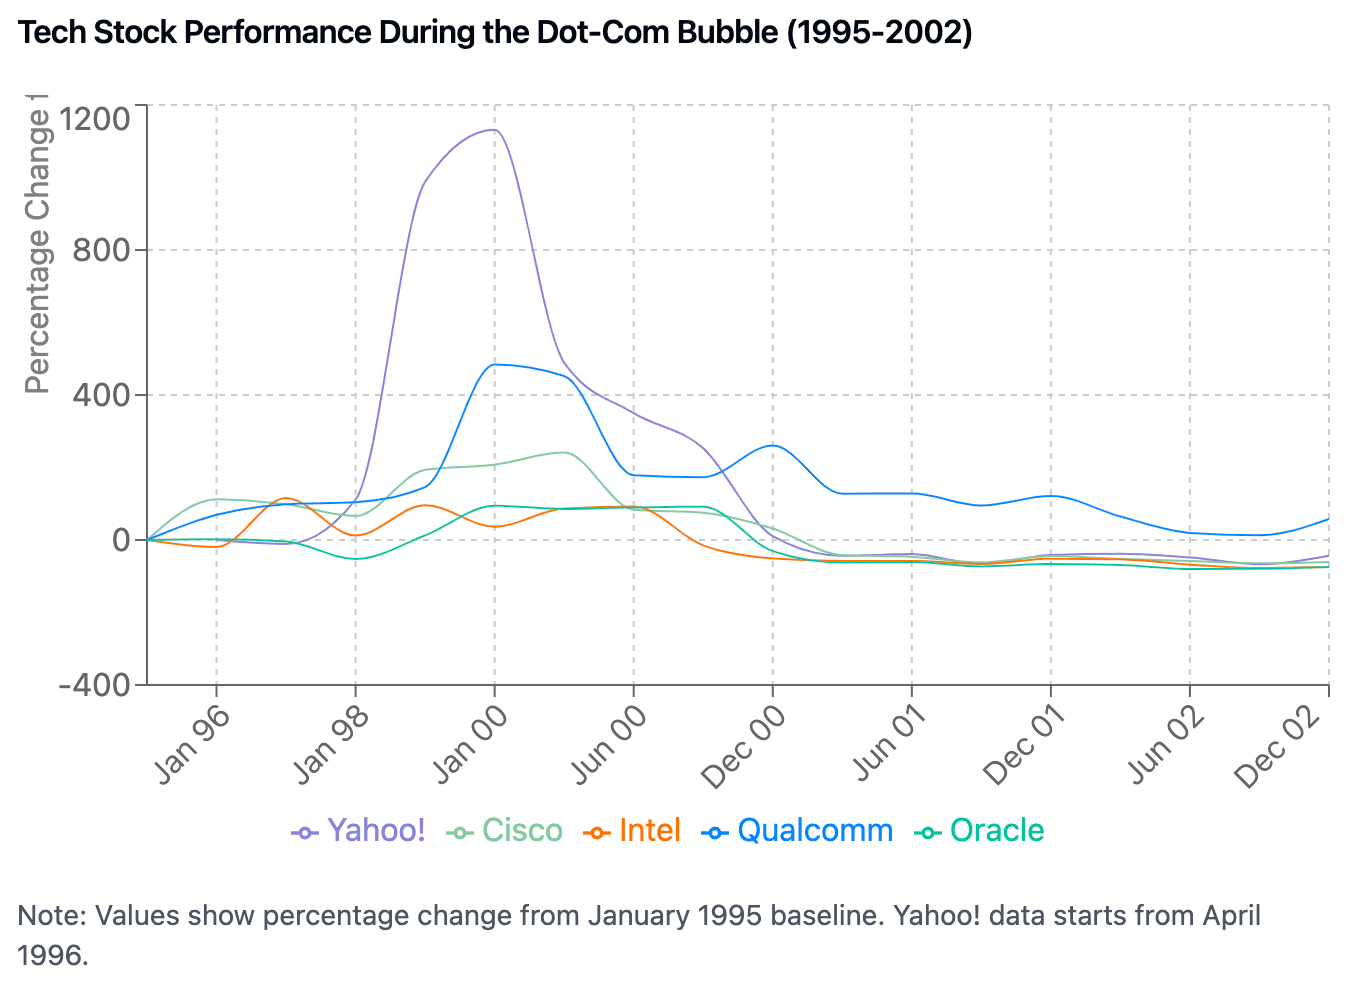
エキサイティングではあるものの、このアプローチには既知の制限があり、万能薬ではありません。リアルタイムデータに基づいて応答を生成することは役立ちますが、AIエージェントはハルシネーション(モデルが誤った情報を高い信頼度で生成する状況)の影響を受けないわけではありません。データ整合性の確保(例:テンプレート化されたクエリを使用)、賢明なデフォルト設定(例:[temperature](https://www.ibm.com/think/topics/llm-temperature))、およびAIが生成した出力を検証するためのセーフガードの実装は、このリスクを最小限に抑えるために必要な重要なステップです。
### あなたのラップトップで実行してみてください!
このユースケースを理解する最良の方法は、自分で試してみることです。ClickHouseパブリックプレイグラウンドサービスへの接続方法の詳細は、私たちの[ドキュメント](https://clickhouse.com/docs/en/getting-started/playground)に記載されています。Claudeデスクトップを使用したClickHouse MCPサーバーのセットアップについても、その[README](https://github.com/ClickHouse/mcp-clickhouse/blob/main/README.md)ファイルに記載されています。最後に、代替のツール互換モデルを使用して、ローカルのオフラインバージョンをセットアップすることもできます。私たちは、次のコンポーネントを使用してローカルセットアップを実験しました。
* モデル:Ollamaで実行されている[llama3.2 3B](https://ollama.com/library/llama3.2)
* クライアント:[mcp-cli](https://github.com/chrishayuk/mcp-cli)
ローカルバージョンはローカルデータ処理を通じてプライバシーを優先しますが(そしてレート制限もありません!)、モデルサイズが小さく、推論能力が限られているため、探索的分析にはあまり適していません。回答に必要なテーブルやフィールドを示唆する直接的な質問の方がうまく機能し、行き詰まるのが早くなります。しかし、希望はあります。DeepSeek R1のようなオープンソースの推論モデルが利用可能になることで、これらの機能の多くが解放されると期待されています(執筆時点では、[DeepSeek R1](https://github.com/deepseek-ai/DeepSeek-R1/issues/9)はツール呼び出しをサポートしていません)。
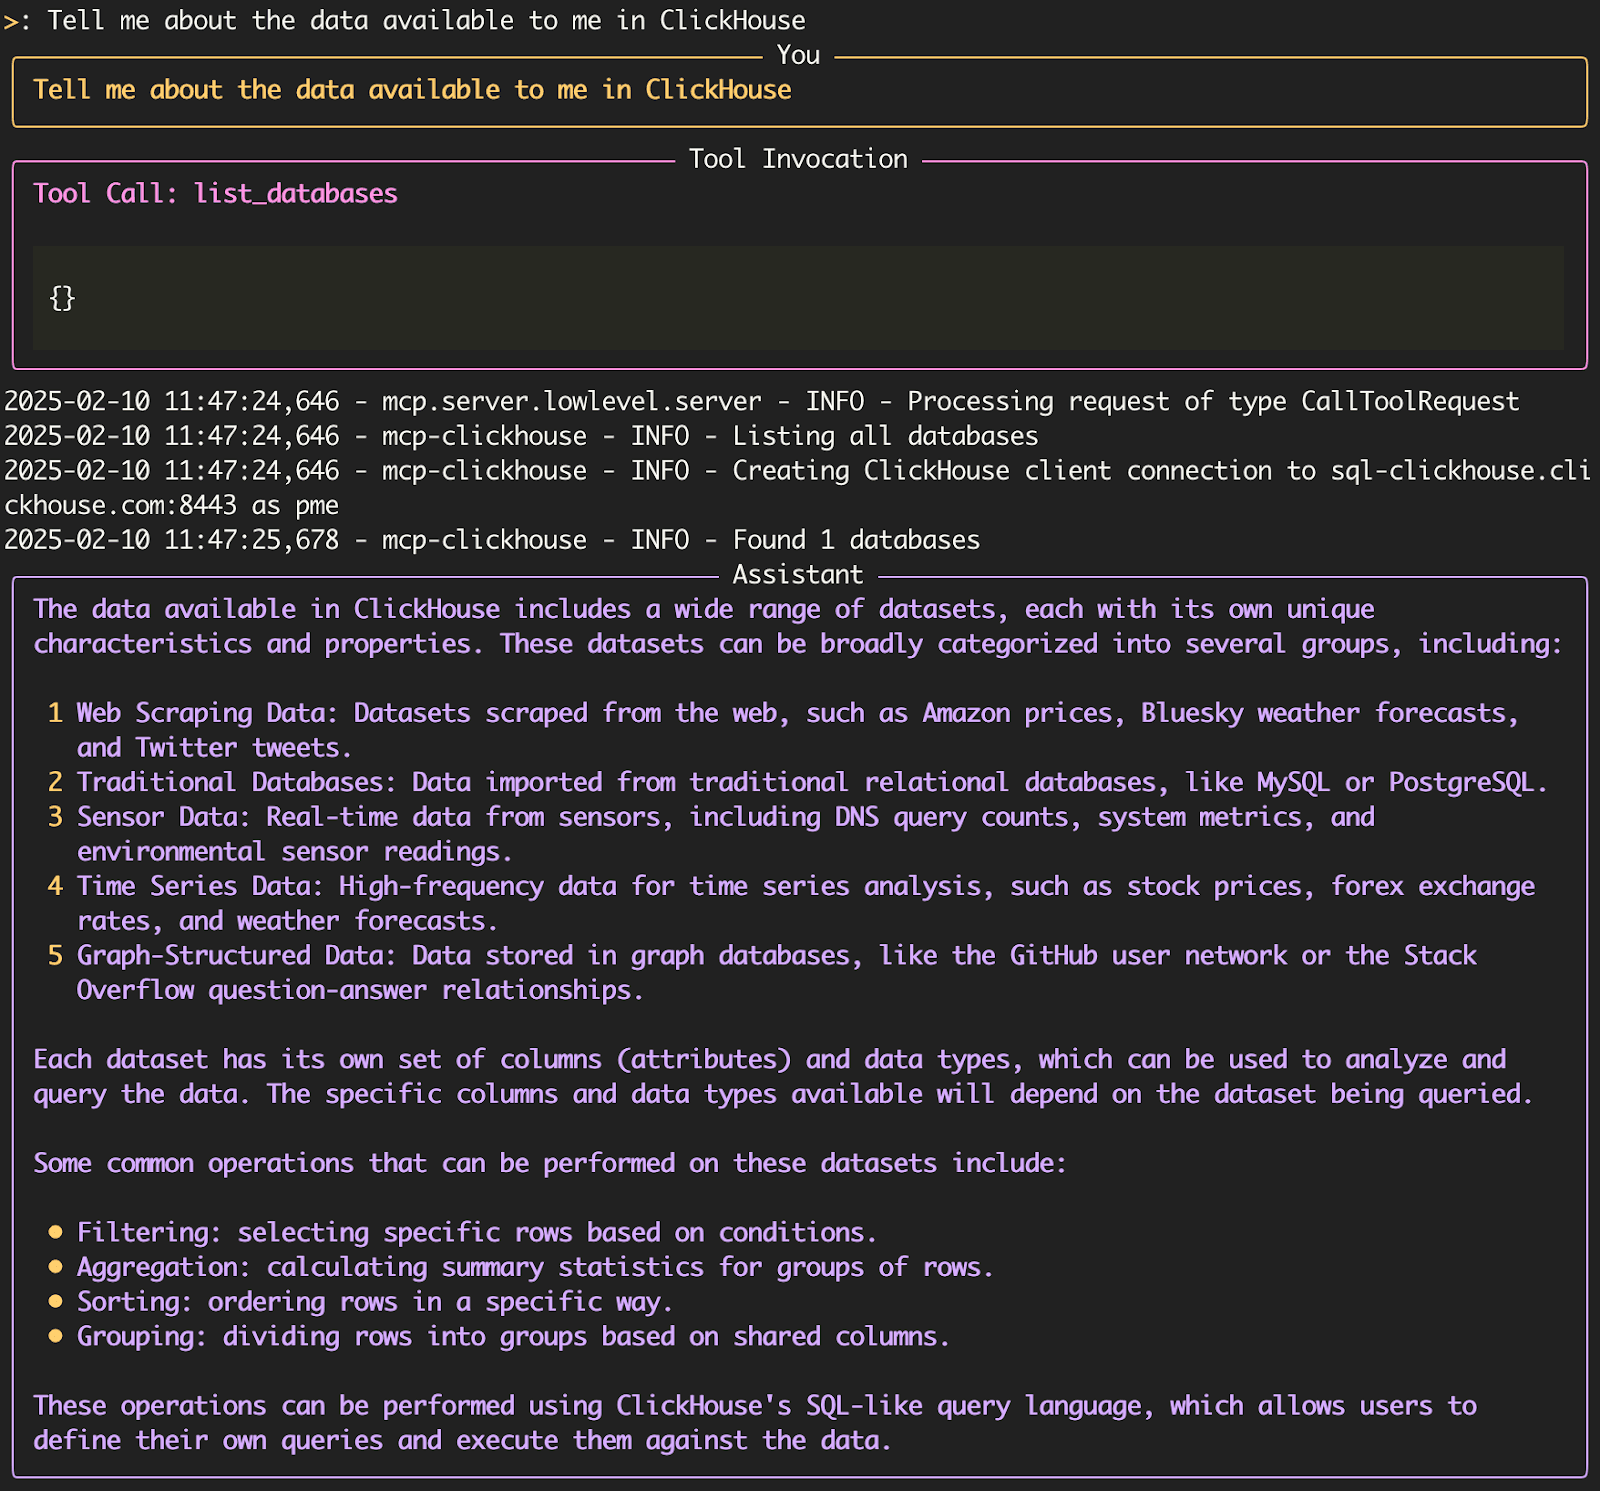 Local deployment of llama3.2 with the ClickHouse MCP server
## まとめ
リアルタイム分析データベースのアクティブユーザーとしてのAIエージェントの出現は、データシステムについて私たちがどのように考えるかという点で興味深い変化を示しています。私たちはまだ初期段階にありますが、モデルコンテキストプロトコルやAI搭載分析ツールの成長するエコシステムのような開発を通じて、基盤はすでに形作られつつあります。
単純なクエリ実行者や「関数呼び出し」から、データについて推論し、コンテキストを維持し、洞察を導き出すことができるエージェントへの道のりは、リアルタイムデータベースにとって機会と課題の両方を提示しています。これらのエージェントがより自律的になり、その展開がより広範になるにつれて、データシステムとの相互作用における新しいパターンが見られるようになり、新しい最適化と機能につながる可能性があります。
リアルタイム分析データベースがユースケースをより良くするためにどのように進化する可能性があるかについて、いくつかの潜在的な方向性を探ってきましたが、私たちはまだその完全な影響を理解し始めたばかりであり、組織がAIエージェントを大規模に展開し続け、新しいユースケースが出現するにつれて、エージェントとリアルタイムデータベースの関係は、私たちがまだ予測していない方法で進化し続ける可能性があります。