

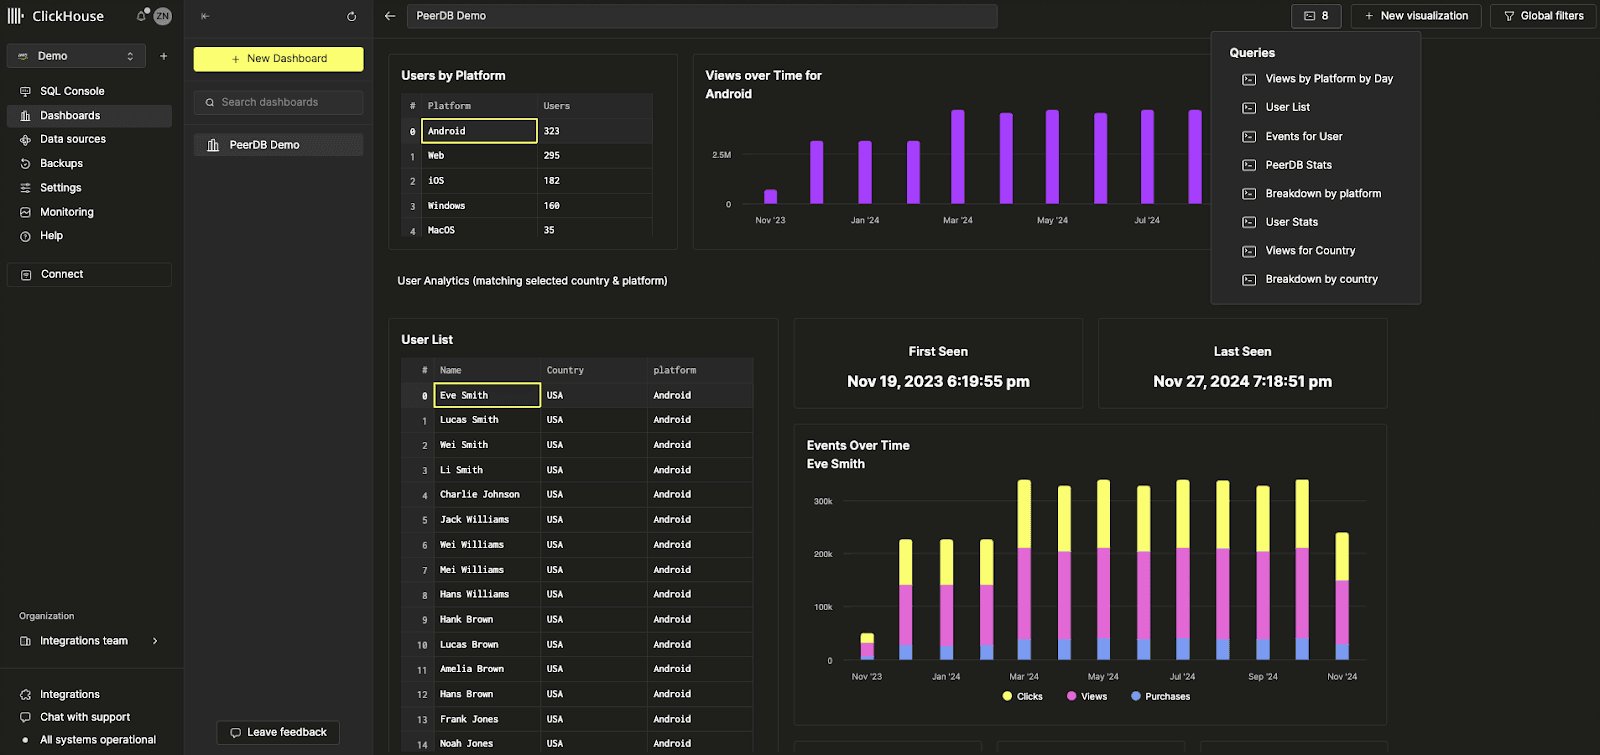
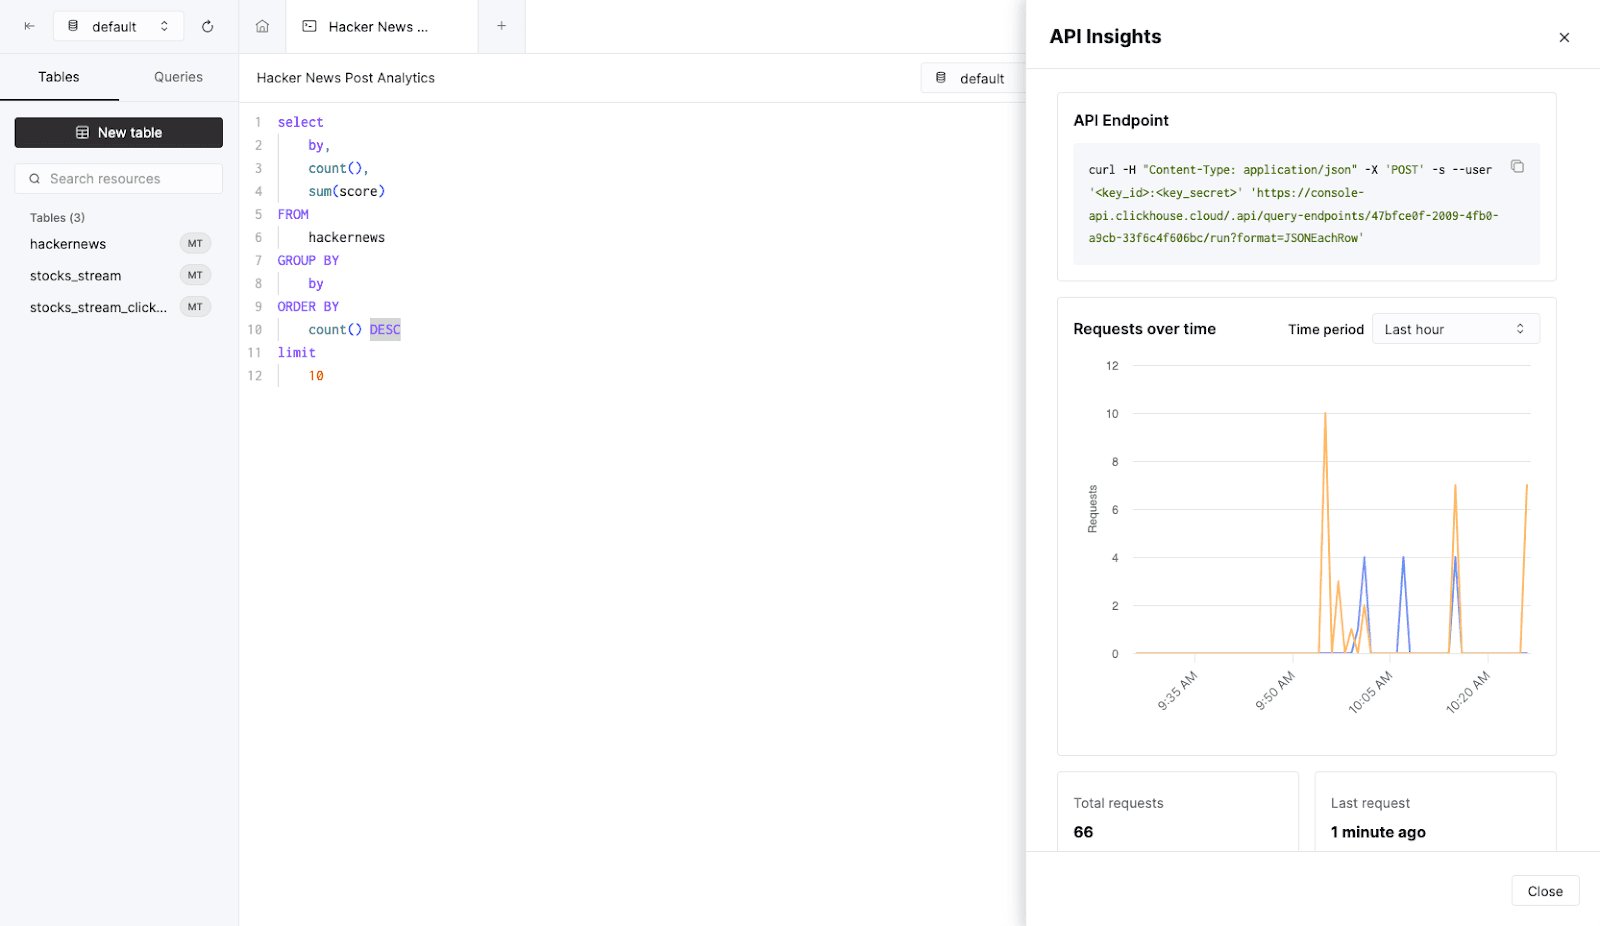
- 降低端点延迟,尤其是冷启动时的延迟
- 增强端点的 RBAC 控制
- 可配置 CORS 允许的域名
- 结果流式传输
- 支持所有与 ClickHouse 兼容的输出格式
MEMORY_LIMIT_EXCEEDED Exception 问题的客户发送通知邮件。
请升级到:
- Kafka-Connect:> 1.2.5
- ClickHouse-Connect (Java) :> 0.8.6
对于希望为受保护健康信息 (PHI) 提供更高级别安全保障的客户,现在可以在 Google Cloud Platform (GCP) 上启用 ClickHouse Cloud。ClickHouse 已落实 HIPAA Security Rule 规定的管理、物理和技术防护措施,并提供可配置的安全设置,可根据您的具体用例和工作负载进行配置。有关可用安全设置的更多信息,请参阅我们的安全功能页面。 该服务目前已在 GCP
us-central-1 区域面向使用 Dedicated 服务类型的客户开放,且需要签署 Business Associate Agreement (BAA)。如需申请使用此功能,或加入更多 GCP、AWS 和 Azure 区域的候补名单,请联系 sales 或 support。
我们最近宣布,AWS 上的 Compute-Compute Separation 已进入私有预览。现在,我们很高兴地宣布,GCP 和 Azure 也已支持该功能。
Compute-compute separation 允许您将特定服务指定为读写服务或只读服务,从而为您的应用设计最优的计算配置,优化成本与性能。更多详情请阅读文档。
启用多重身份验证的客户现在可以获取恢复代码,以便在手机丢失或令牌被误删时使用。首次启用 MFA 的客户会在设置过程中收到该代码。已启用 MFA 的客户可以通过移除现有的 MFA 令牌并添加新的令牌来获取恢复代码。
我们很高兴分享 ClickPipes 的最新更新。作为将数据摄取到 ClickHouse 服务的最简便方式,ClickPipes 此次新增的功能可帮助您更好地控制数据摄取过程,并提升对性能指标的可观测性。
适用于 Kafka 的自定义身份验证证书
ClickPipes for Kafka 现已支持为使用 SASL 和公共 SSL/TLS 的 Kafka 消息代理配置自定义身份验证证书。您可以在 ClickPipe 设置过程中的 SSL Certificate 部分轻松上传自己的证书,从而确保与 Kafka 建立更安全的连接。
为 Kafka 和 Kinesis 推出延迟指标
性能可观测性至关重要。ClickPipes 现已提供延迟图表,让您了解消息从生成 (无论来自 Kafka topic 还是 Kinesis Stream) 到摄取至 ClickHouse Cloud 之间的耗时。借助这一新指标,您可以更密切地关注数据管道的性能,并据此进行优化。
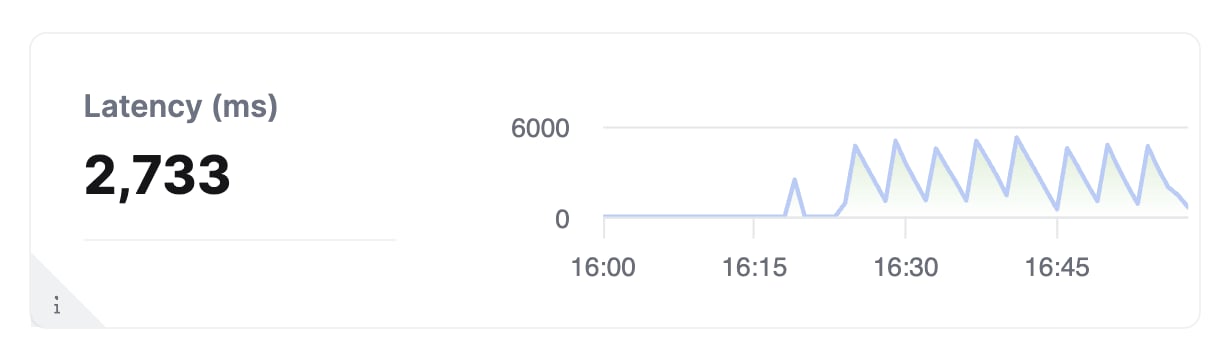
Kafka 和 Kinesis 的扩缩容控制 (私有 Beta) 高吞吐量场景可能需要更多资源,才能满足数据量和延迟方面的需求。我们正在为 ClickPipes 推出横向扩缩容功能,可直接通过 Cloud Console 使用。该功能目前处于私有 Beta 阶段,使您能够根据实际需求更高效地调整资源规模。如需加入 Beta,请联系 support。 Kafka 和 Kinesis 的原始消息摄取 现在,您可以在不解析的情况下直接摄取完整的 Kafka 或 Kinesis 消息。ClickPipes 现已支持
_raw_message 虚拟列,允许用户将完整消息映射到单个 String 列。这让您能够根据需要灵活处理原始数据。
Terraform 可让您以编程方式管理 ClickHouse Cloud 服务,并将配置以代码形式保存。我们的 Terraform provider 下载量已接近 20 万次,现已正式发布 v1.0.0。这个新版本包含多项改进,例如更完善的重试逻辑,以及一个可将专用终结点关联到您的 ClickHouse Cloud 服务的新资源。您可以在此下载 Terraform provider,并在此查看完整更新日志。
我们很高兴地宣布,2024 SOC 2 Type II 报告和更新版 ISO 27001 证书现已可供获取。这两项均涵盖了我们近期在 Azure 上推出的服务,以及 AWS 和 GCP 上持续提供的服务。
我们的 SOC 2 Type II 体现了我们持续致力于保障为 ClickHouse 用户提供的服务在安全性、可用性、处理完整性和保密性方面达到高标准。如需了解更多信息,请参阅美国注册会计师协会 (AICPA) 发布的 SOC 2 - SOC for Service Organizations: Trust Services Criteria,以及国际标准化组织 (ISO) 发布的 What is ISO/IEC 27001。
另请访问我们的 Trust Center,查看安全与 compliance 文档及报告。
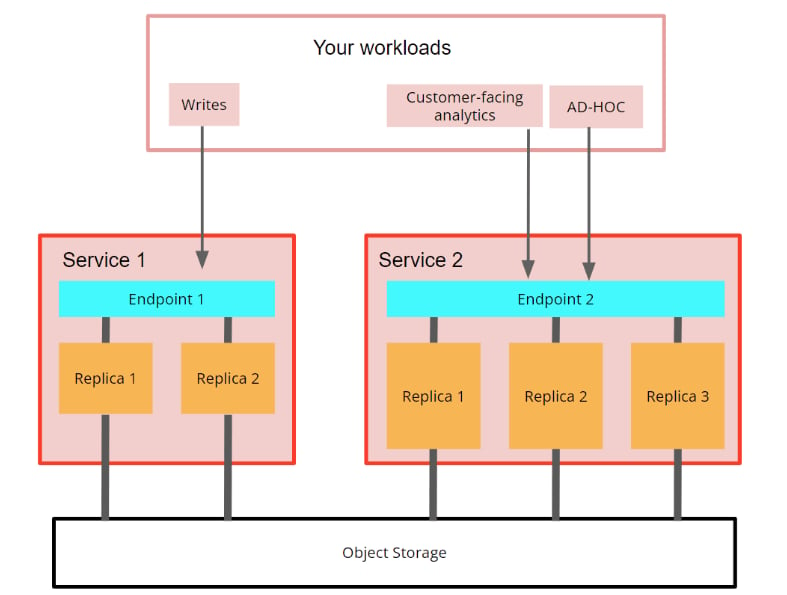
对于现有的 ClickHouse Cloud 服务,副本同时处理读写,且无法将某个特定副本配置为只处理其中一种操作。我们即将推出一项名为 Compute-compute separation 的新特性,它允许你将特定服务指定为读写或只读服务,从而为你的应用设计最佳的计算配置,以优化成本和性能。
全新的 Compute-compute separation 特性支持你创建多个计算节点组,每个节点组都有各自的端点,同时使用同一个对象存储文件夹,因此共享相同的表、视图等。请在此处了解有关 Compute-compute separation 的更多信息。如果你希望获得这项私有预览特性的访问权限,请联系支持团队。
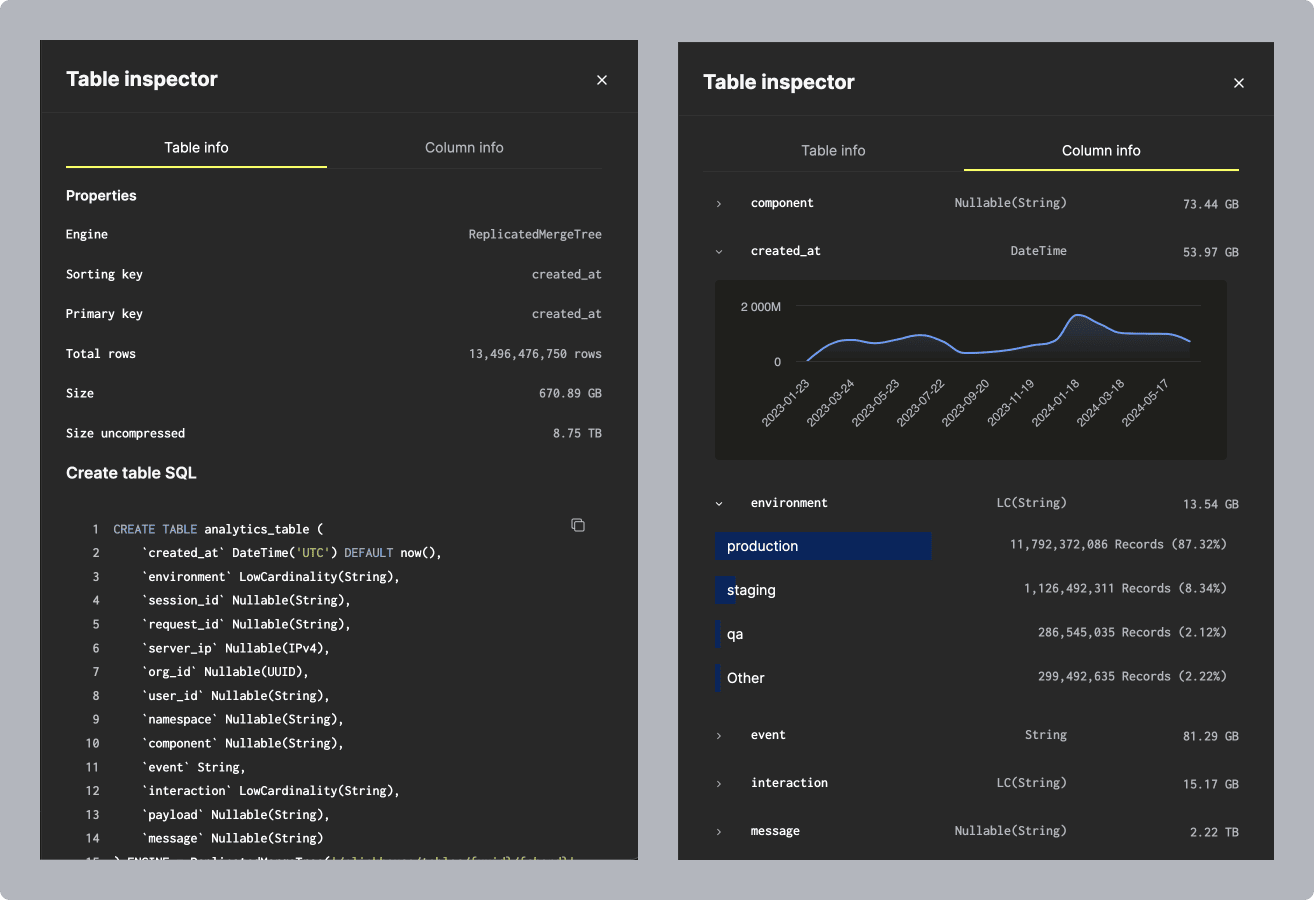
DESCRIBE 之类的命令,让你能够检查表并查看 schema。这些命令会将结果输出到控制台,但通常用起来并不方便,因为你需要组合多条查询,才能获取有关表和列的所有相关信息。
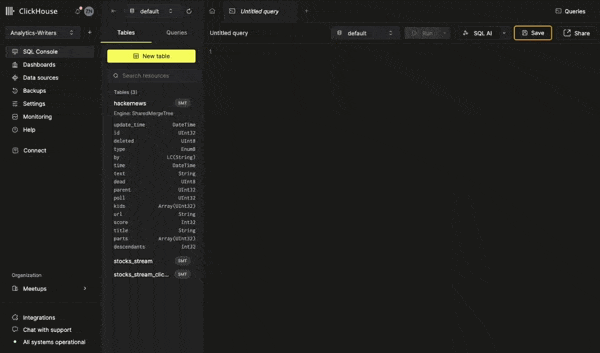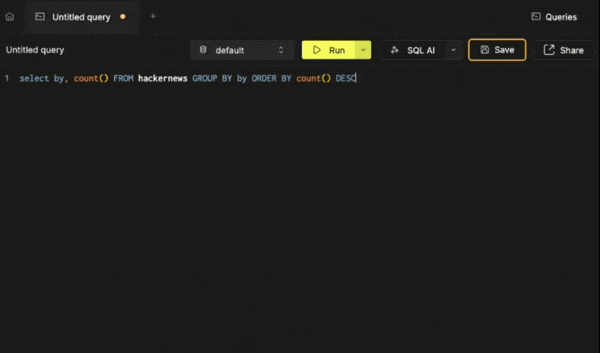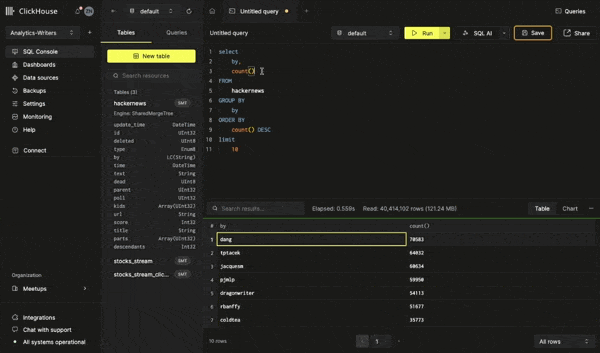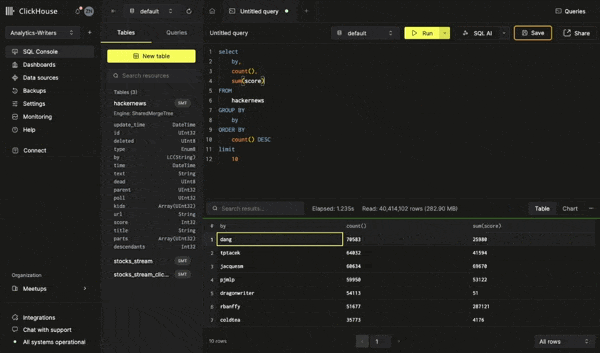
我们最近在 Cloud 控制台中推出了 表检查器,让你无需编写 SQL,就能在 UI 中获取重要的表和列信息。你可以前往 Cloud 控制台,为你的服务试用表检查器。它在一个统一界面中集中展示 schema、存储、压缩等信息。
JOIN。此前,新用户需要通过设置 allow_experimental_analyzer 来启用这项功能。现在,新的 ClickHouse Cloud 服务已默认提供这一改进后的 analyzer。
敬请期待 analyzer 的更多改进,我们还规划了许多进一步的优化。
我们早在今年 5 月就宣布了对 Microsoft Azure 的 Beta 支持。在这次最新的云版本发布中,我们很高兴地宣布,Azure 支持已从 Beta 转为正式可用。至此,ClickHouse Cloud 已支持三大主流云平台:AWS、Google Cloud Platform,以及 Microsoft Azure。
此次发布还支持通过 Microsoft Azure Marketplace 进行订阅。该服务初期将支持以下区域:
- 美国:West US 3 (Arizona)
- 美国:East US 2 (Virginia)
- 欧洲:Germany West Central (Frankfurt)
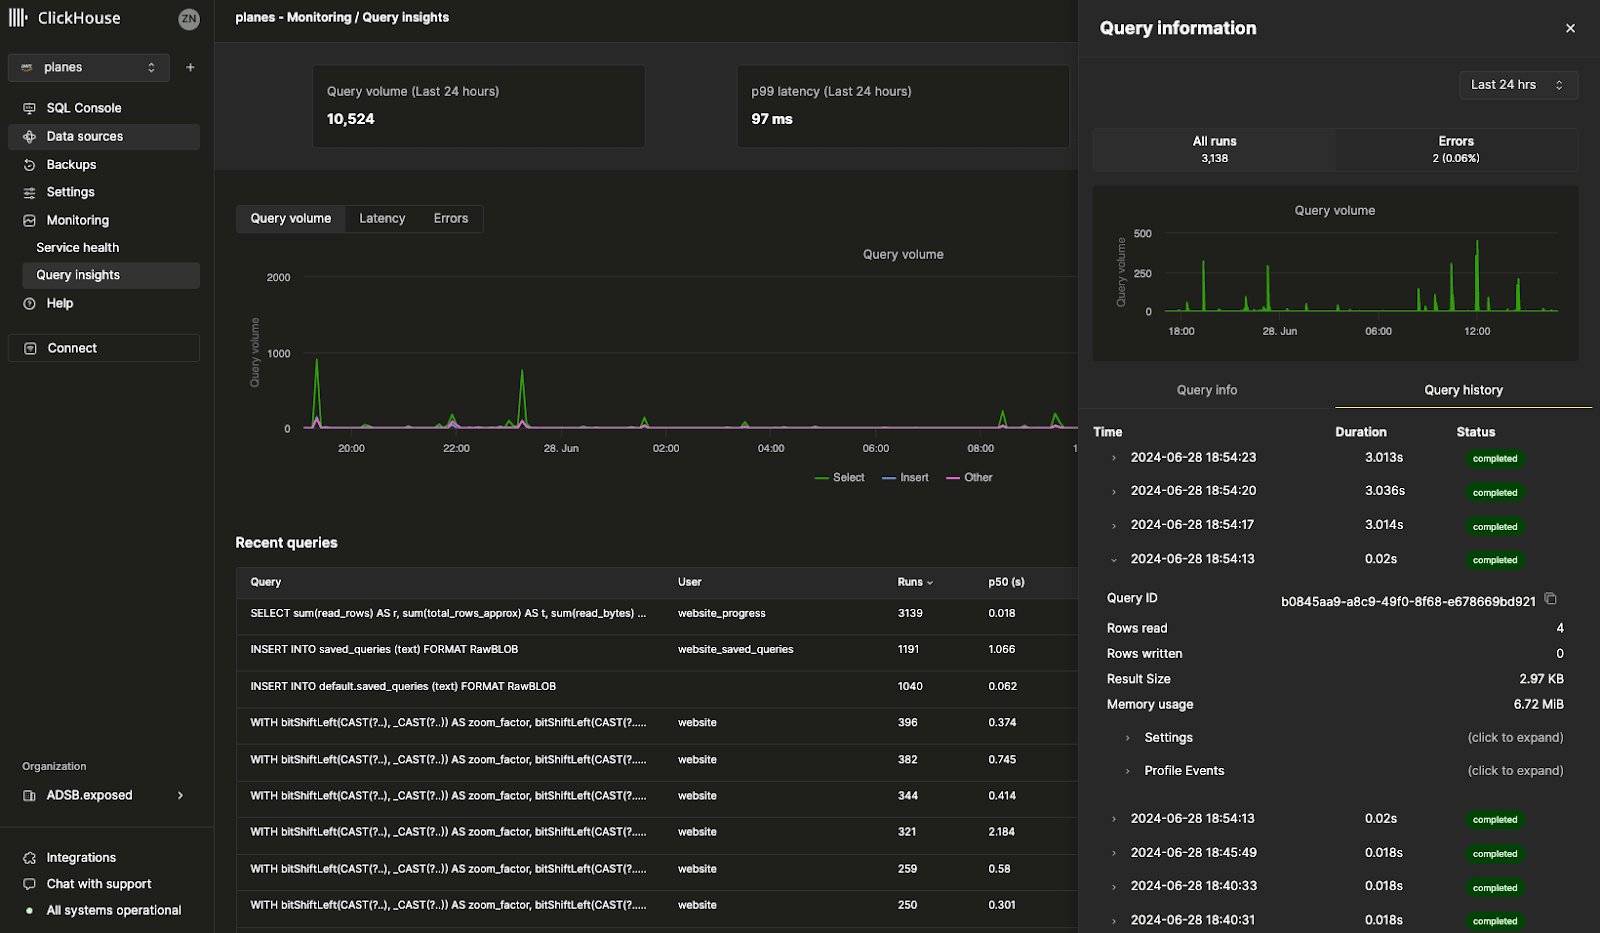
system.query_log 表是查询优化、调试以及监控整体集群健康状况和性能的关键信息来源。唯一需要注意的是:它包含 70 多个字段,而且每个查询会生成多条记录,因此理解查询日志有较高的学习门槛。这个 Query Insights 的初始版本为后续进一步简化查询调试和优化模式提供了蓝图。随着我们持续迭代这一功能,我们非常希望听到你的反馈,欢迎随时联系我们——非常感谢你的意见。
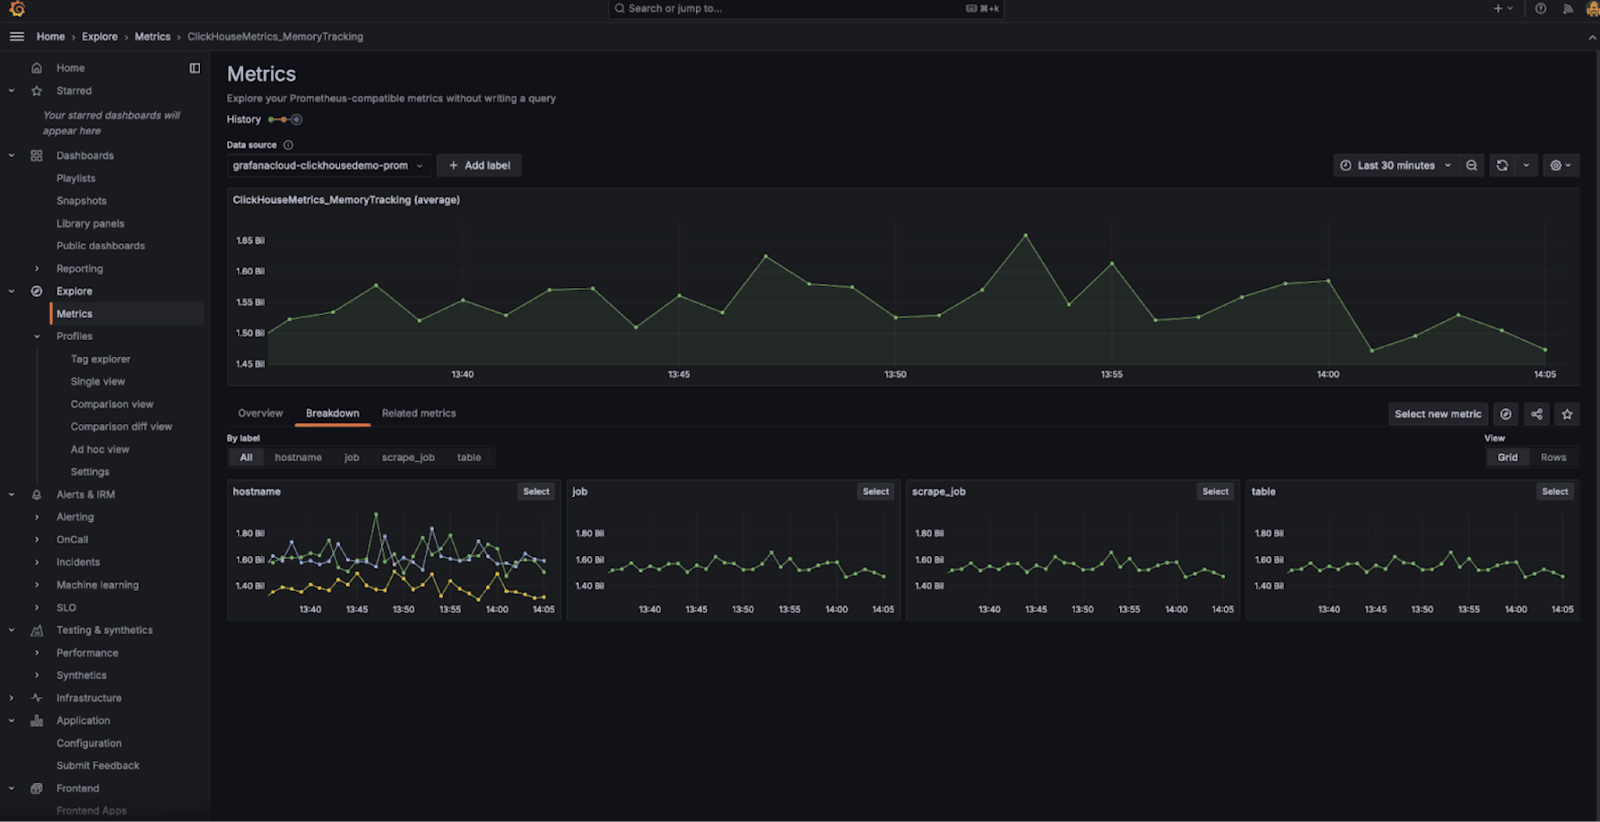
- 可配置备份 现已正式发布,支持配置频率、保留期限和计划等自定义备份策略。
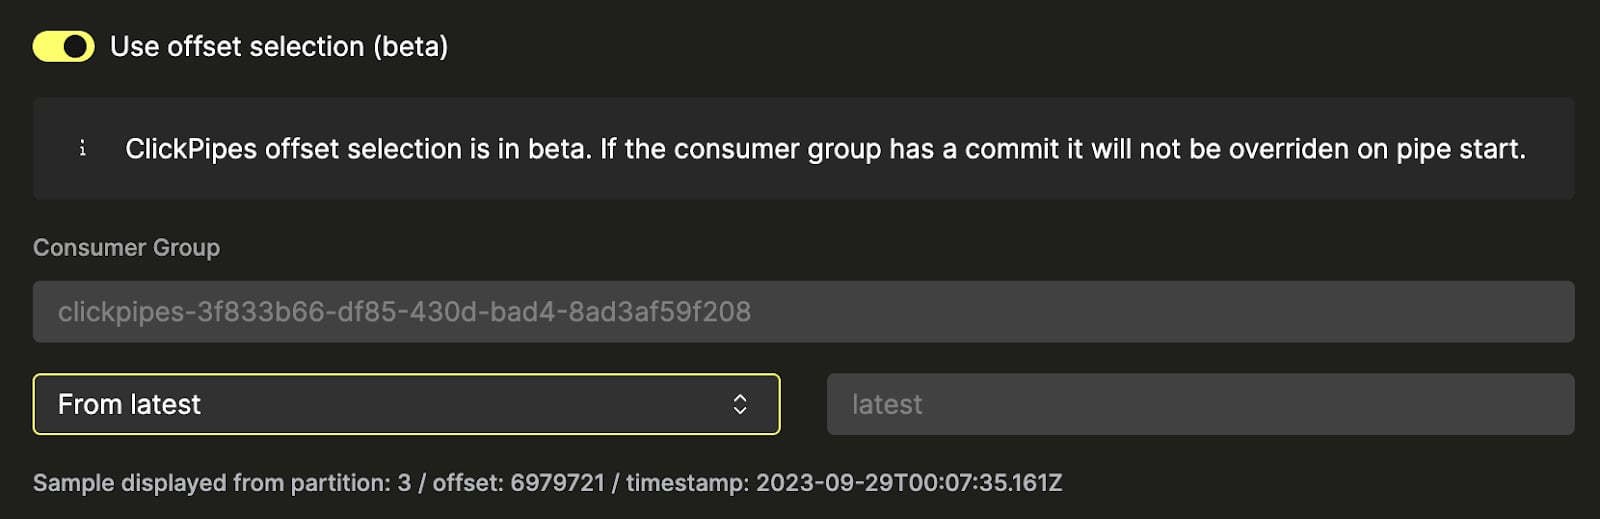
- 从开头开始:从 Kafka topic 的最开头开始消费数据。如果你需要重新处理全部历史数据,此选项非常适合。
- 从最新位置开始:从最新的 offset 开始消费数据。如果你只关心新消息,这个选项很有用。
- 从某个 timestamp 开始:从在某个指定 timestamp 或之后生成的消息开始消费数据。此功能可实现更精确的控制,让你能够从准确的时间点恢复处理。
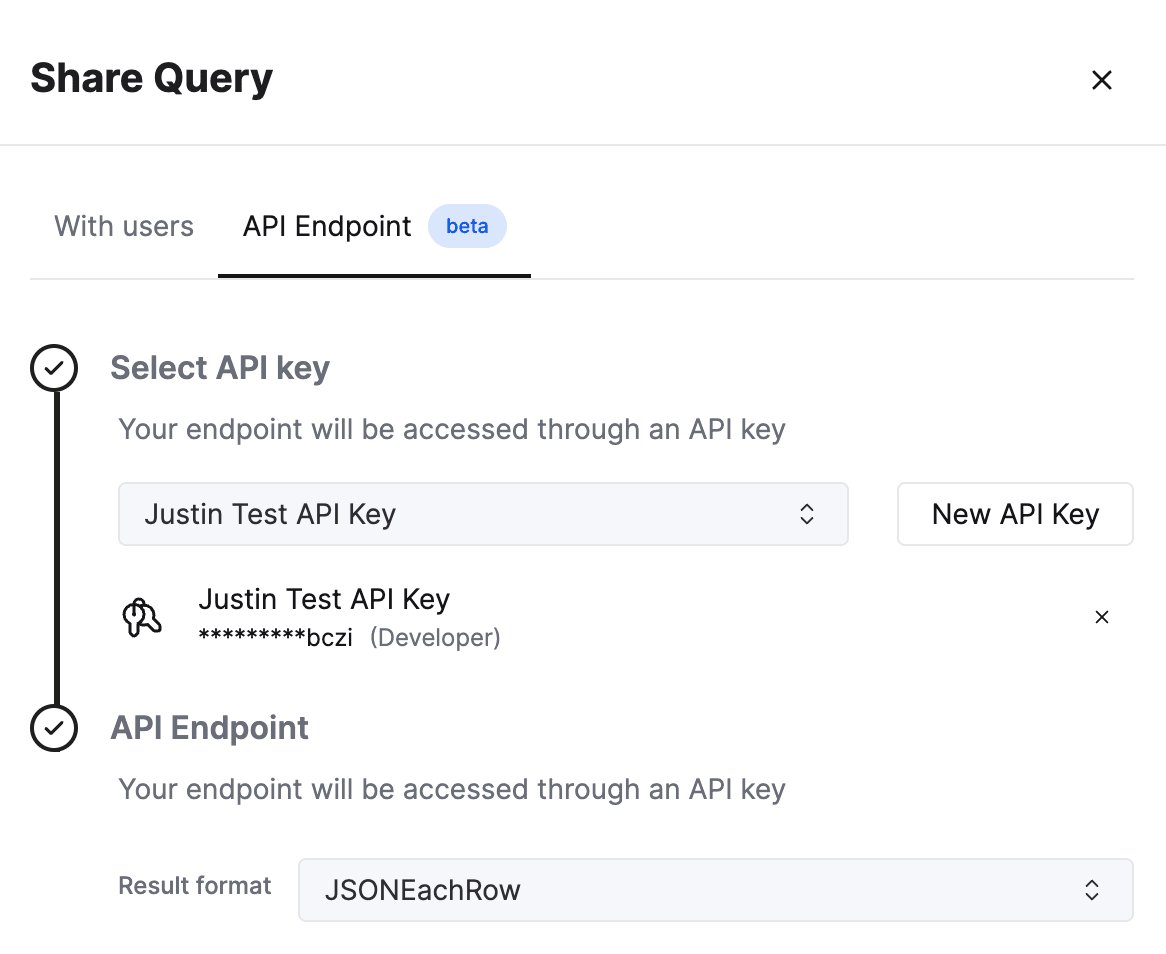
- SQL 控制台现已支持输出格式
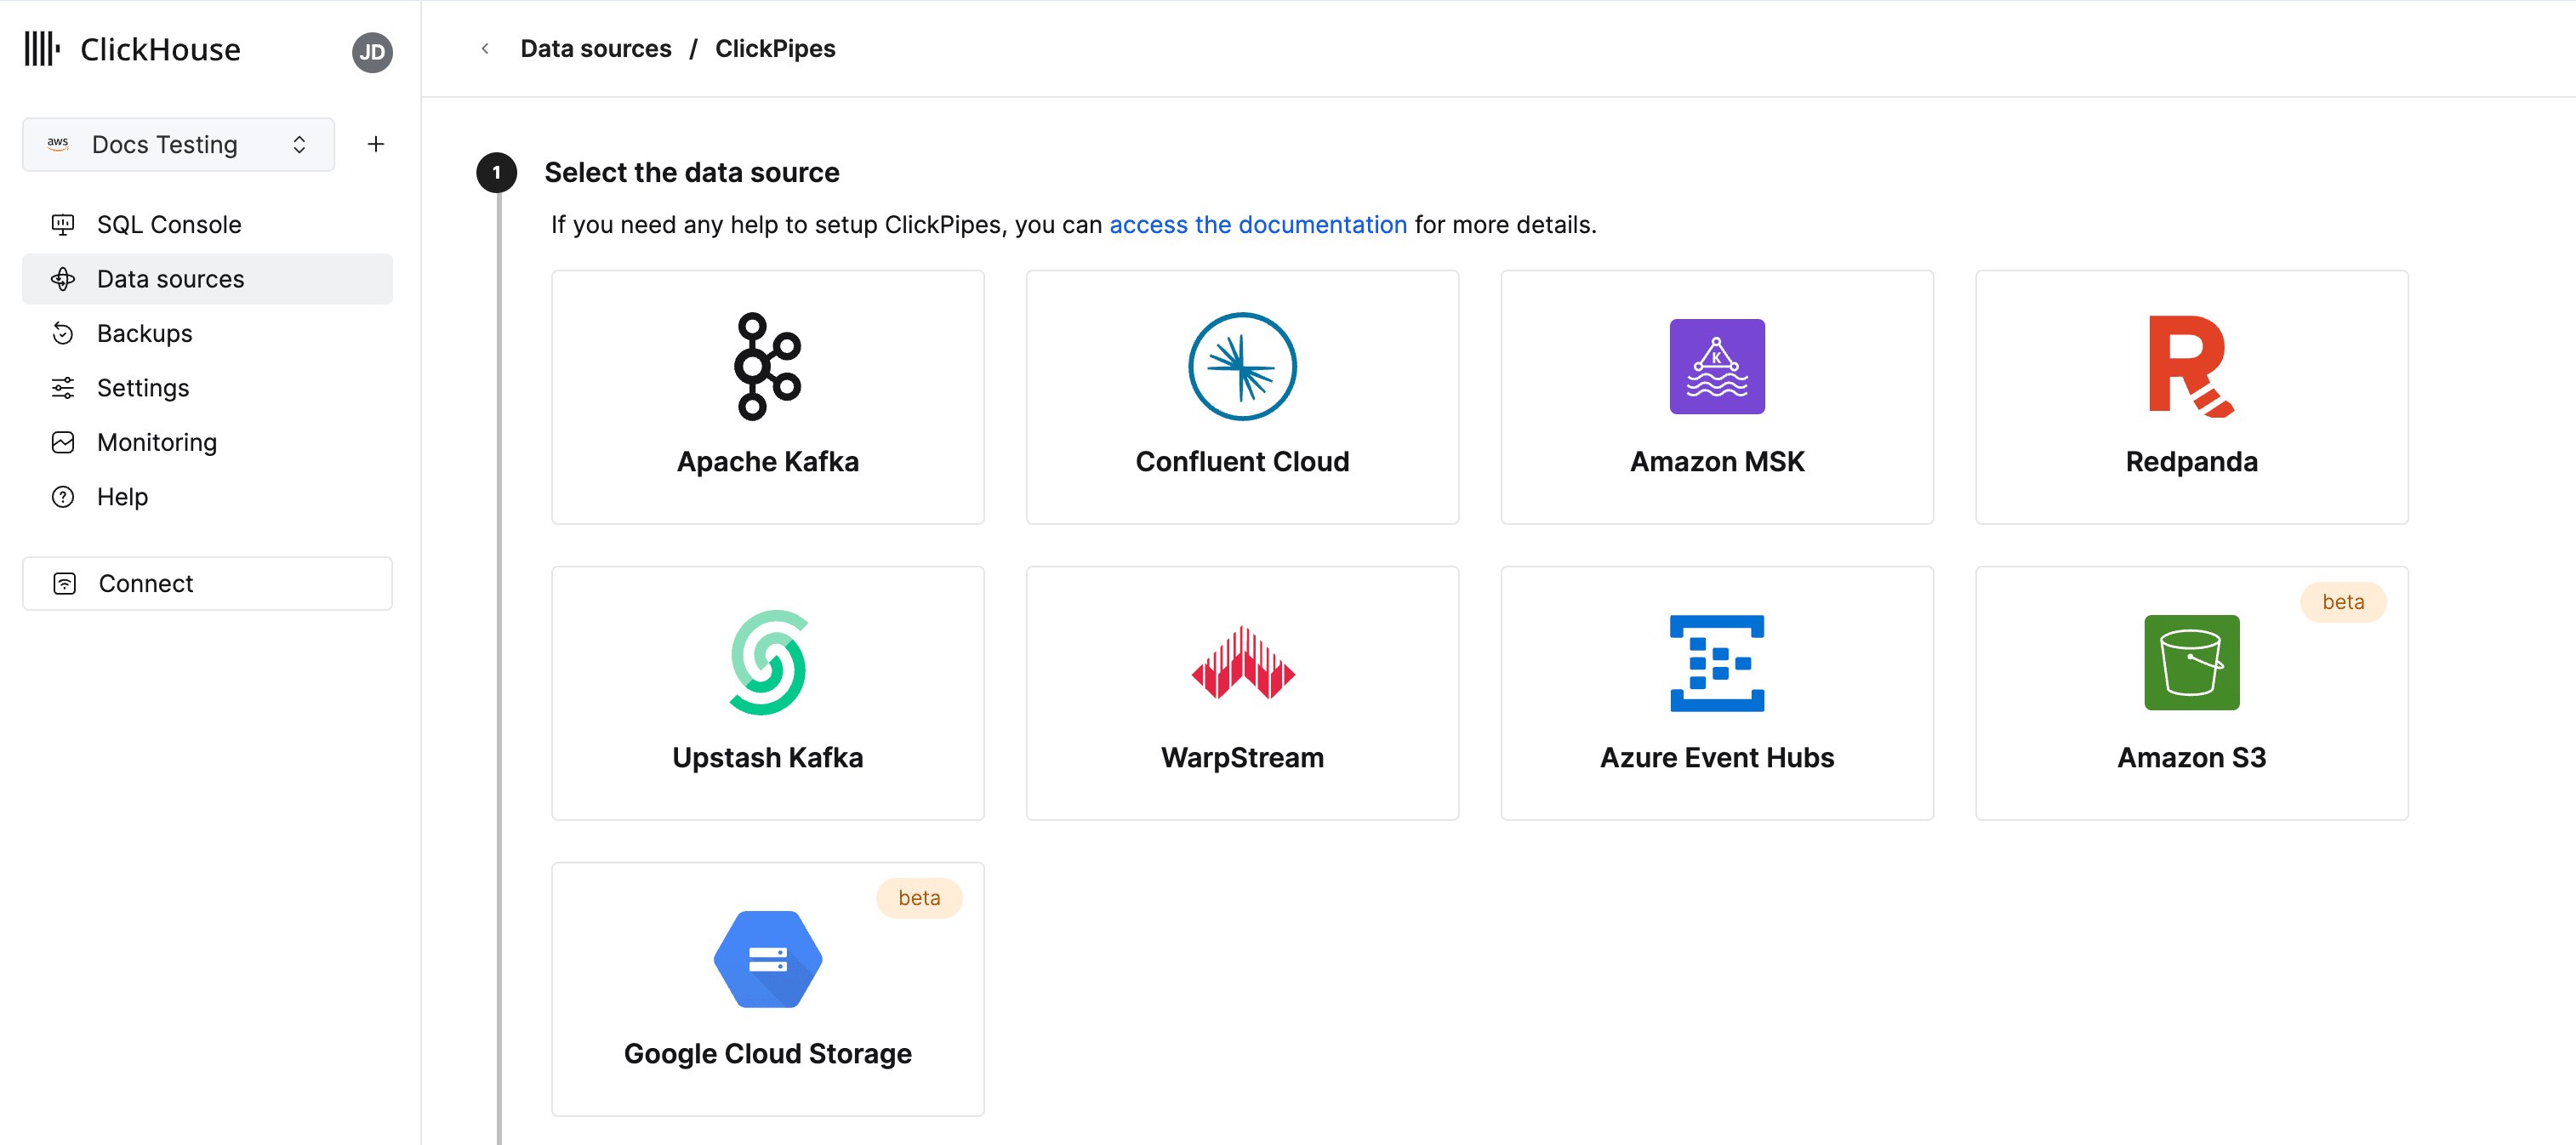
- ClickPipes Kafka 连接器支持多 broker 配置
- PowerBI 连接器支持指定 ODBC 驱动程序配置选项。
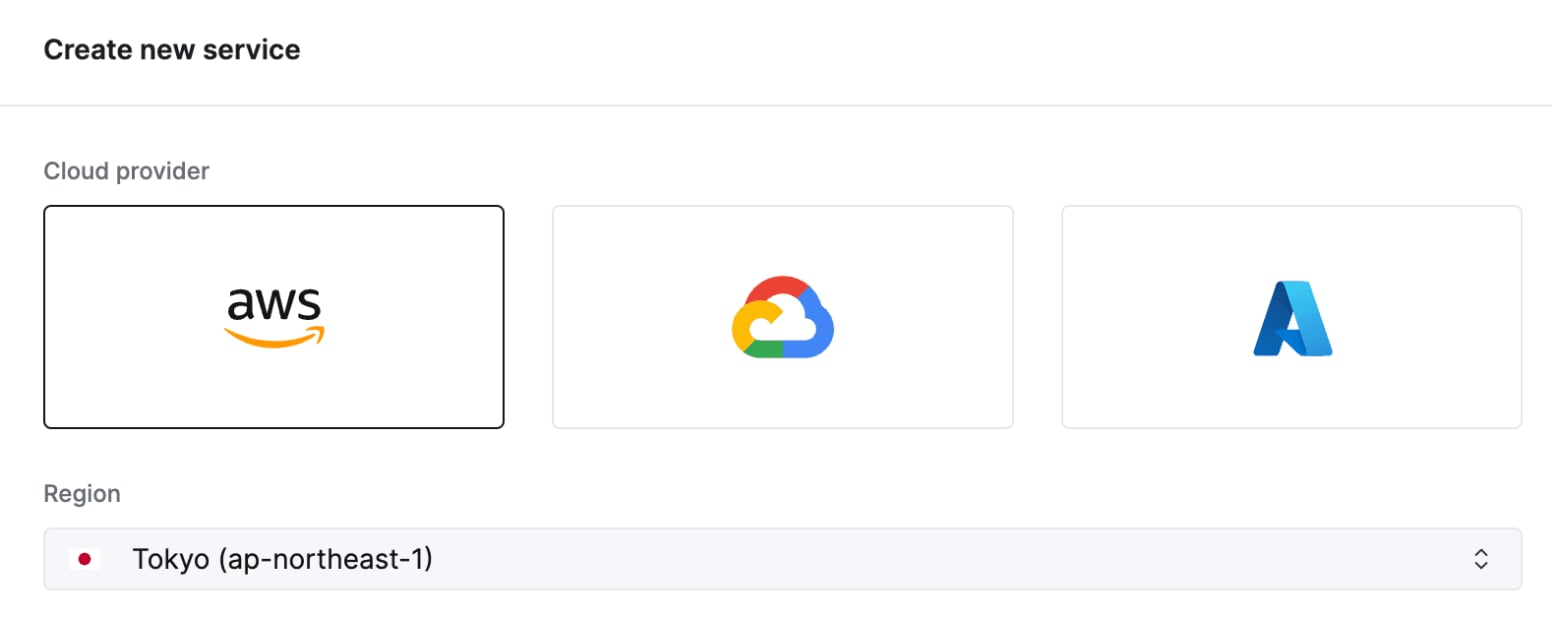
ap-northeast-1) 。为了让 ClickHouse 成为速度最快的数据库,我们正持续为各个云平台扩展更多区域,以尽可能降低延迟。您现在可以在更新后的 Cloud 控制台中创建位于东京的新服务。
- ClickPipes for Kafka 现已正式支持 Avro 格式
- Terraform provider 现已完整支持导入资源 (服务和专用终结点)
- Node.js 客户端重要稳定版本发布:增强了对查询 + ResultSet 的 TypeScript 支持,并支持 URL 配置
- Kafka Connector:修复了写入 DLQ 时忽略异常的 bug,新增对 Avro 枚举类型的支持,并发布了在 MSK 和 Confluent Cloud 上使用该 connector 的指南
- Grafana:修复了 UI 中对 Nullable 类型的支持,修复了对动态 OTel 追踪表名的支持
- DBT:修复了自定义物化的模型设置。
- Java 客户端:修复了错误代码解析不正确的 bug
- Python 客户端:修复了数值类型的参数绑定,修复了查询绑定中数值列表的 bug,并新增了 SQLAlchemy Point 支持。
- 已推出对 Microsoft Azure 的支持,目前处于私有预览阶段。若要获取访问权限,请联系账户管理团队或支持团队,或加入等候名单。
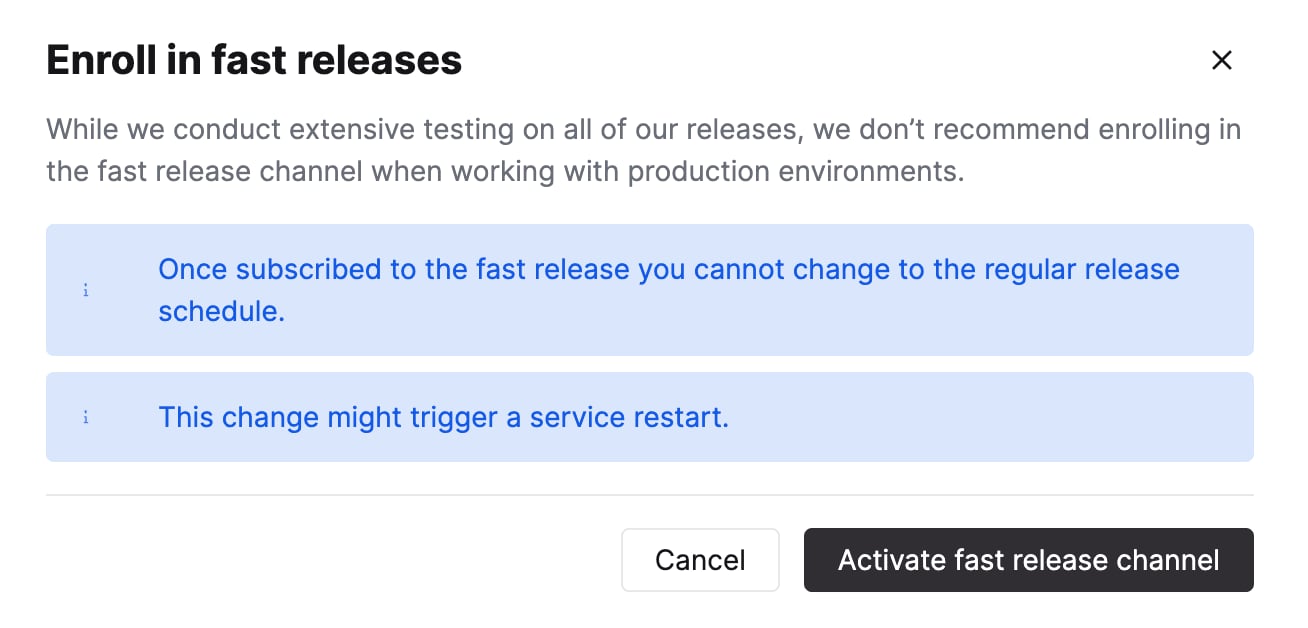
- 推出了发布渠道功能,可根据环境类型指定升级时机。在此版本中,我们新增了“fast”发布渠道,让您能够在生产环境之前升级非生产环境 (如需启用,请联系支持团队) 。
- 新增支持通过 API 进行横向扩缩容配置 (私有预览,如需启用请联系支持团队开通)
- 改进了自动扩缩容,可在服务启动时因内存不足报错时自动扩容
- 新增支持通过 Terraform provider 为 AWS 配置 CMEK
- 新增对 Microsoft 社交登录的支持
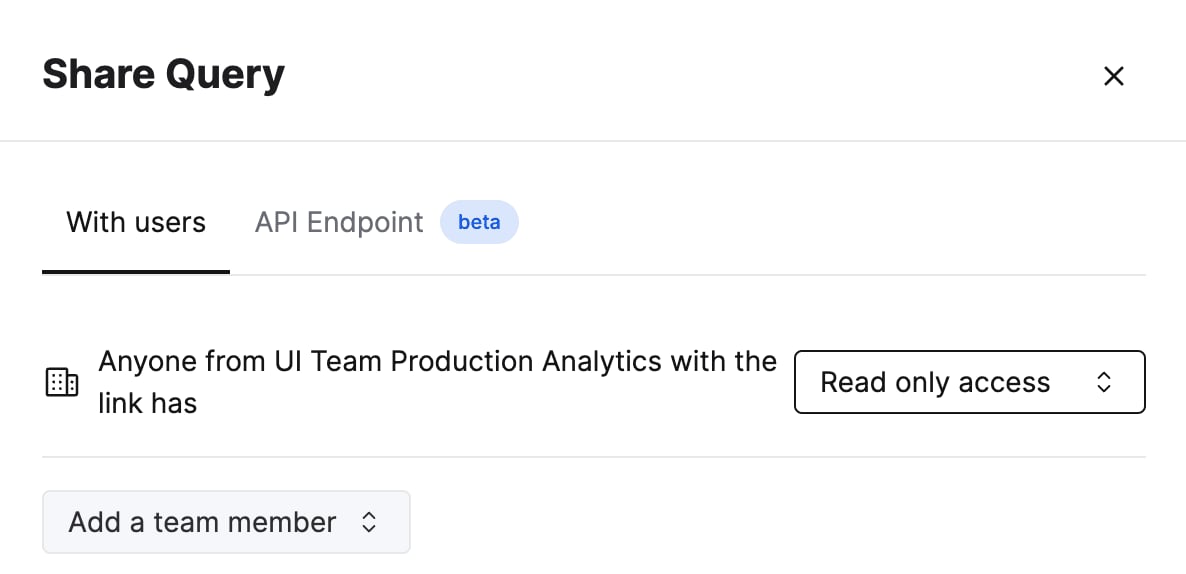
- 新增在 SQL 控制台中共享参数化查询的功能
- 显著提升了查询编辑器的性能 (在部分欧洲区域,延迟从 5 秒降至 1.5 秒)
- ClickHouse OpenTelemetry exporter:新增对 ClickHouse 复制表引擎的支持,并添加了集成测试
- ClickHouse DBT 适配器:新增对字典 物化 宏的支持,以及对生存时间 (TTL) 表达式支持的测试
- ClickHouse Kafka Connect Sink:新增了与 Kafka 插件发现的兼容性 (社区贡献)
- ClickHouse Java 客户端:为新的客户端 API 引入了一个新包,并为 Cloud 测试增加了测试覆盖率
- ClickHouse Node.js 客户端:扩展了针对新的 HTTP keep-alive 行为的测试和文档。自 v0.3.0 版本起可用
- ClickHouse Go 客户端:修复了将枚举用作 Map 键时的一个 bug;并修复了出错连接遗留在连接池中时的一个 bug (社区贡献)
- ClickHouse Python 客户端:新增对通过 PyArrow 进行查询流式传输的支持 (社区贡献)
- 已更新 ClickHouse Cloud,以防止“启用查询缓存时绕过基于角色的访问控制” (CVE-2024-22412)
- 全新的 Cloud 控制台体验现已开放抢先体验 (如果您有兴趣参与,请联系支持团队) 。
- 用于从 S3 和 GCS 进行批量加载的 ClickPipes 现已开放抢先体验 (如果您有兴趣参与,请联系支持团队) 。
- ClickPipes for Kafka 对 Avro 格式 的支持现已开放抢先体验 (如果您有兴趣参与,请联系支持团队) 。
- FINAL 优化、向量化改进以及更快的聚合——详情请参阅 23.12 发布博客。
- 新增了用于处理 punycode、计算字符串相似度和检测异常值的函数,以及针对 merges 和 Keeper 的内存优化——详情请参阅 24.1 发布博客 和 演示文稿。
- 当前的 ClickHouse Cloud 版本基于 24.1,包含数十项新功能、性能提升和缺陷修复。详情请参阅核心数据库更新日志。
- Grafana:修复了 v4 的仪表板迁移问题和即席过滤逻辑
- Tableau Connector:修复了 DATENAME 函数,以及 “real” 参数的舍入问题
- Kafka Connector:修复了连接初始化中的 NPE,并新增了指定 JDBC 驱动选项的能力
- Golang 客户端:降低了处理响应时的内存占用,修复了 Date32 极值问题,并修复了启用压缩时的错误报告问题
- Python 客户端:改进了 datetime 参数中的时区支持,并提升了 Pandas DataFrame 的性能
- 优化了 SQL 控制台应用的初始加载时间
- 修复了 SQL 控制台中的竞态条件,该问题会导致“身份验证失败”错误
- 修复了监控页面上的一个问题:最新的内存分配值有时会显示不正确
- 修复了 SQL 控制台有时会重复发出 KILL QUERY 命令的问题
- 为 ClickPipes 增加了对基于 Kafka 的数据源使用 SCRAM-SHA-256 身份验证方法的支持
- Kafka Connector:扩展了对复杂嵌套结构 (Array、Map) 的支持;新增了对 FixedString 类型的支持;新增了将数据摄取到多个数据库的支持
- Metabase:修复了与 23.8 版本以下 ClickHouse 的兼容性问题
- DBT:新增了在创建模型时传递设置的能力
- Node.js client:新增了对长时间运行查询 (>1hr) 的支持,并可妥善处理空值
- 用于从 S3 持续、定时加载数据的 S3Queue 表引擎现已可用于生产环境——详情请参阅 23.11 发布博客。
- 针对 FINAL 的显著性能提升,以及对 SIMD 指令向量化的改进,使查询速度更快——详情请参阅 23.12 发布博客。
- 此 ClickHouse 云版本基于 23.12,包含数十项新功能、性能提升和缺陷修复。详情请参阅 核心数据库更新日志。
- 新增支持通过 Terraform provider 配置 AWS Private Link 和 GCP Private Service Connect
- 提升了远程文件数据导入的稳定性
- 为所有数据导入新增了导入状态详情弹出面板
- 新增支持使用 key/secret key 凭证进行 S3 数据导入
- Kafka Connect
- 支持用于精确一次语义的 async_insert (默认禁用)
- Golang client
- 修复 DateTime 绑定问题
- 改进批量插入性能
- Java client
- 修复请求压缩问题
- 不再需要
use_mysql_types_in_show_columns。通过 MySQL 接口连接时,它会自动启用。 async_insert_max_data_size的默认值现为10 MiB
- 新增对 Azure Event Hub 的 ClickPipes 支持
- 新服务启动时,默认闲置时间为 15 分钟
- ClickHouse data source for Grafana v4 版本发布
- 彻底重构了查询构建器,为表、日志、时间序列和链路追踪提供专用编辑器
- 彻底重构了 SQL 生成器,以支持更复杂、动态的查询
- 在日志和 trace 视图中新增了对 OpenTelemetry 的原生支持
- 扩展了配置,允许为日志和链路追踪指定默认表和列
- 新增了指定自定义 HTTP 请求头的功能
- 以及更多改进——请查看完整的更新日志
- 数据库 schema 管理工具
- Kafka Connector Sink
- 优化了向带默认值的表摄取数据
- 新增了对 DateTime64 中字符串形式日期的支持
- Metabase
- 新增了对多数据库连接的支持
- 新增 AWS 区域:伦敦 (eu-west-2)
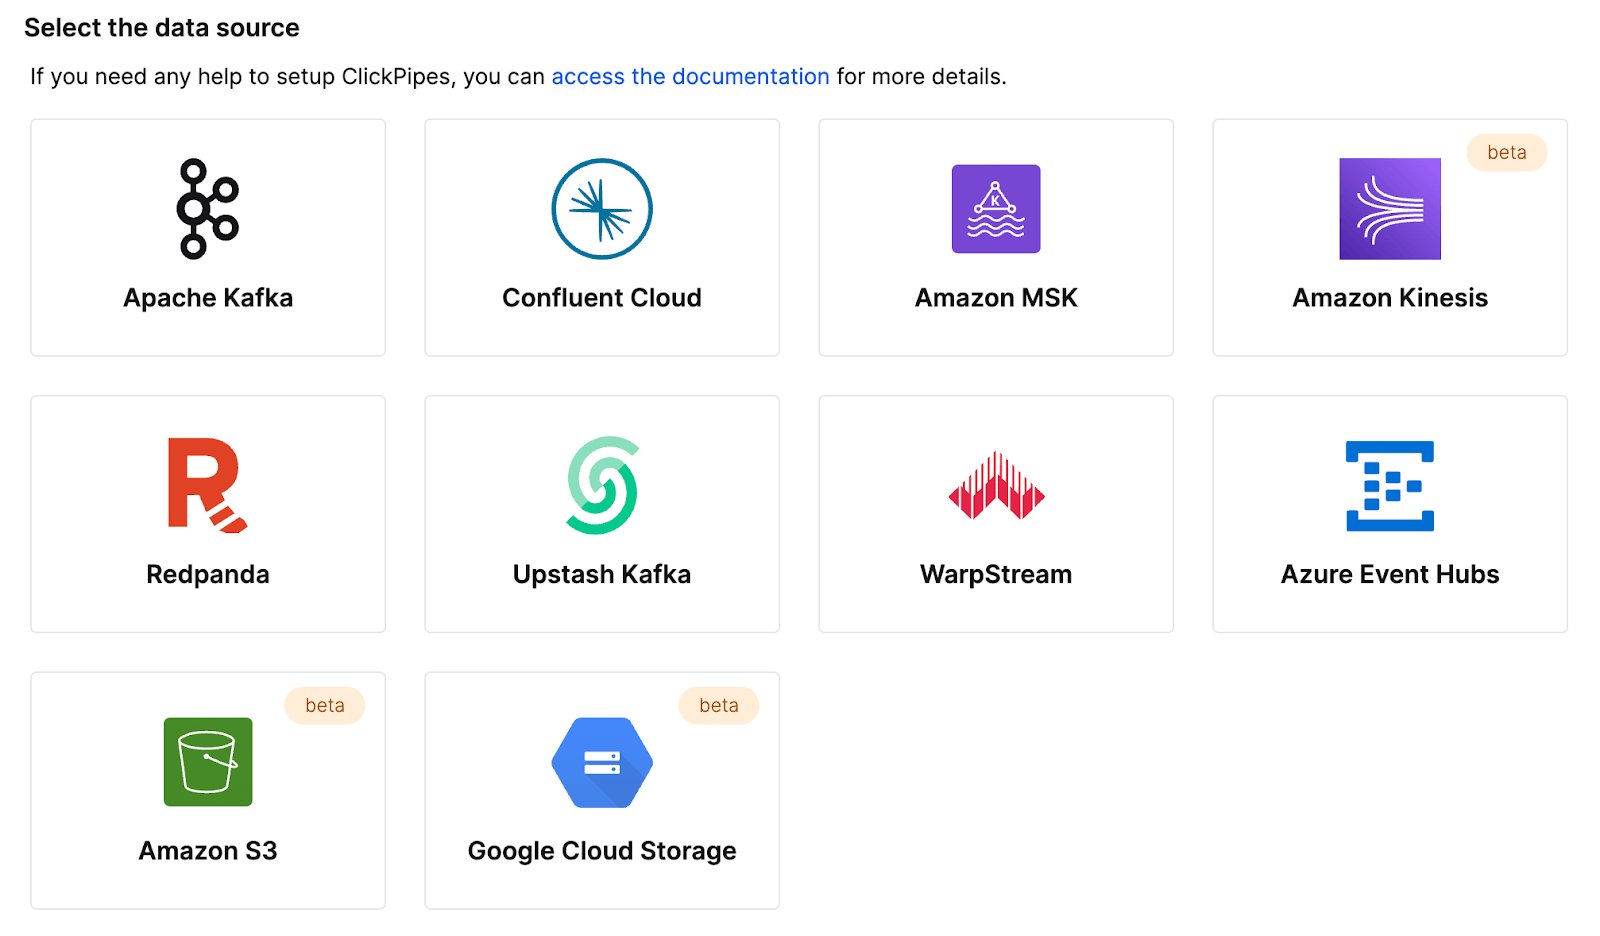
- 新增了 ClickPipes 对 Redpanda、Upstash 和 Warpstream 的支持
- ClickPipes 的身份验证机制现可在 UI 中配置
- Java 客户端:
- 破坏性变更:移除了在调用中指定随机 URL 句柄的能力。此功能已从 ClickHouse 中移除
- 弃用项:Java CLI 客户端和 gRPC 包
- 新增对 RowBinaryWithDefaults 格式的支持,以减小批次大小并降低 ClickHouse 实例上的负载 (应 Exabeam 要求)
- 使 Date32 和 DateTime64 的范围边界与 ClickHouse 保持兼容,并改进了对 Spark Array String 类型和节点选择机制的兼容性
- Kafka Connector:新增了一个用于 Grafana 的 JMX 监控仪表板
- PowerBI:使 ODBC 驱动程序设置可在 UI 中配置
- JavaScript 客户端:提供了查询摘要信息,允许在插入时仅提供指定列的子集,并使 Web 客户端的 keep_alive 可配置
- Python 客户端:为 SQLAlchemy 新增了 Nothing 类型支持
- 面向用户的向后不兼容变更:此前,在某些条件下,两个功能 (is_deleted 和
OPTIMIZE CLEANUP) 可能导致 ClickHouse 中的数据损坏。为了保护用户数据的完整性,同时保留该功能的核心能力,我们调整了这一功能的工作方式。具体来说,MergeTree 设置clean_deleted_rows现已弃用,且不再生效。默认情况下不允许使用CLEANUP关键字 (如需使用,必须启用allow_experimental_replacing_merge_with_cleanup) 。如果你决定使用CLEANUP,则需要确保它始终与FINAL一起使用,并且必须保证在运行OPTIMIZE FINAL CLEANUP之后,不会再插入旧版本的行。