

- Agent - Agent 实例在边缘收集数据,例如在服务器或 Kubernetes 节点上,或直接从应用程序接收事件——这些应用程序已通过 OpenTelemetry SDK 完成埋点。在后一种情况下,agent 实例会与应用程序一起运行,或运行在与应用程序相同的主机上 (例如以 sidecar 或 DaemonSet 守护进程集的形式) 。Agent 可以将数据直接发送到 ClickHouse,也可以发送到 gateway 实例。前者称为 Agent deployment pattern。
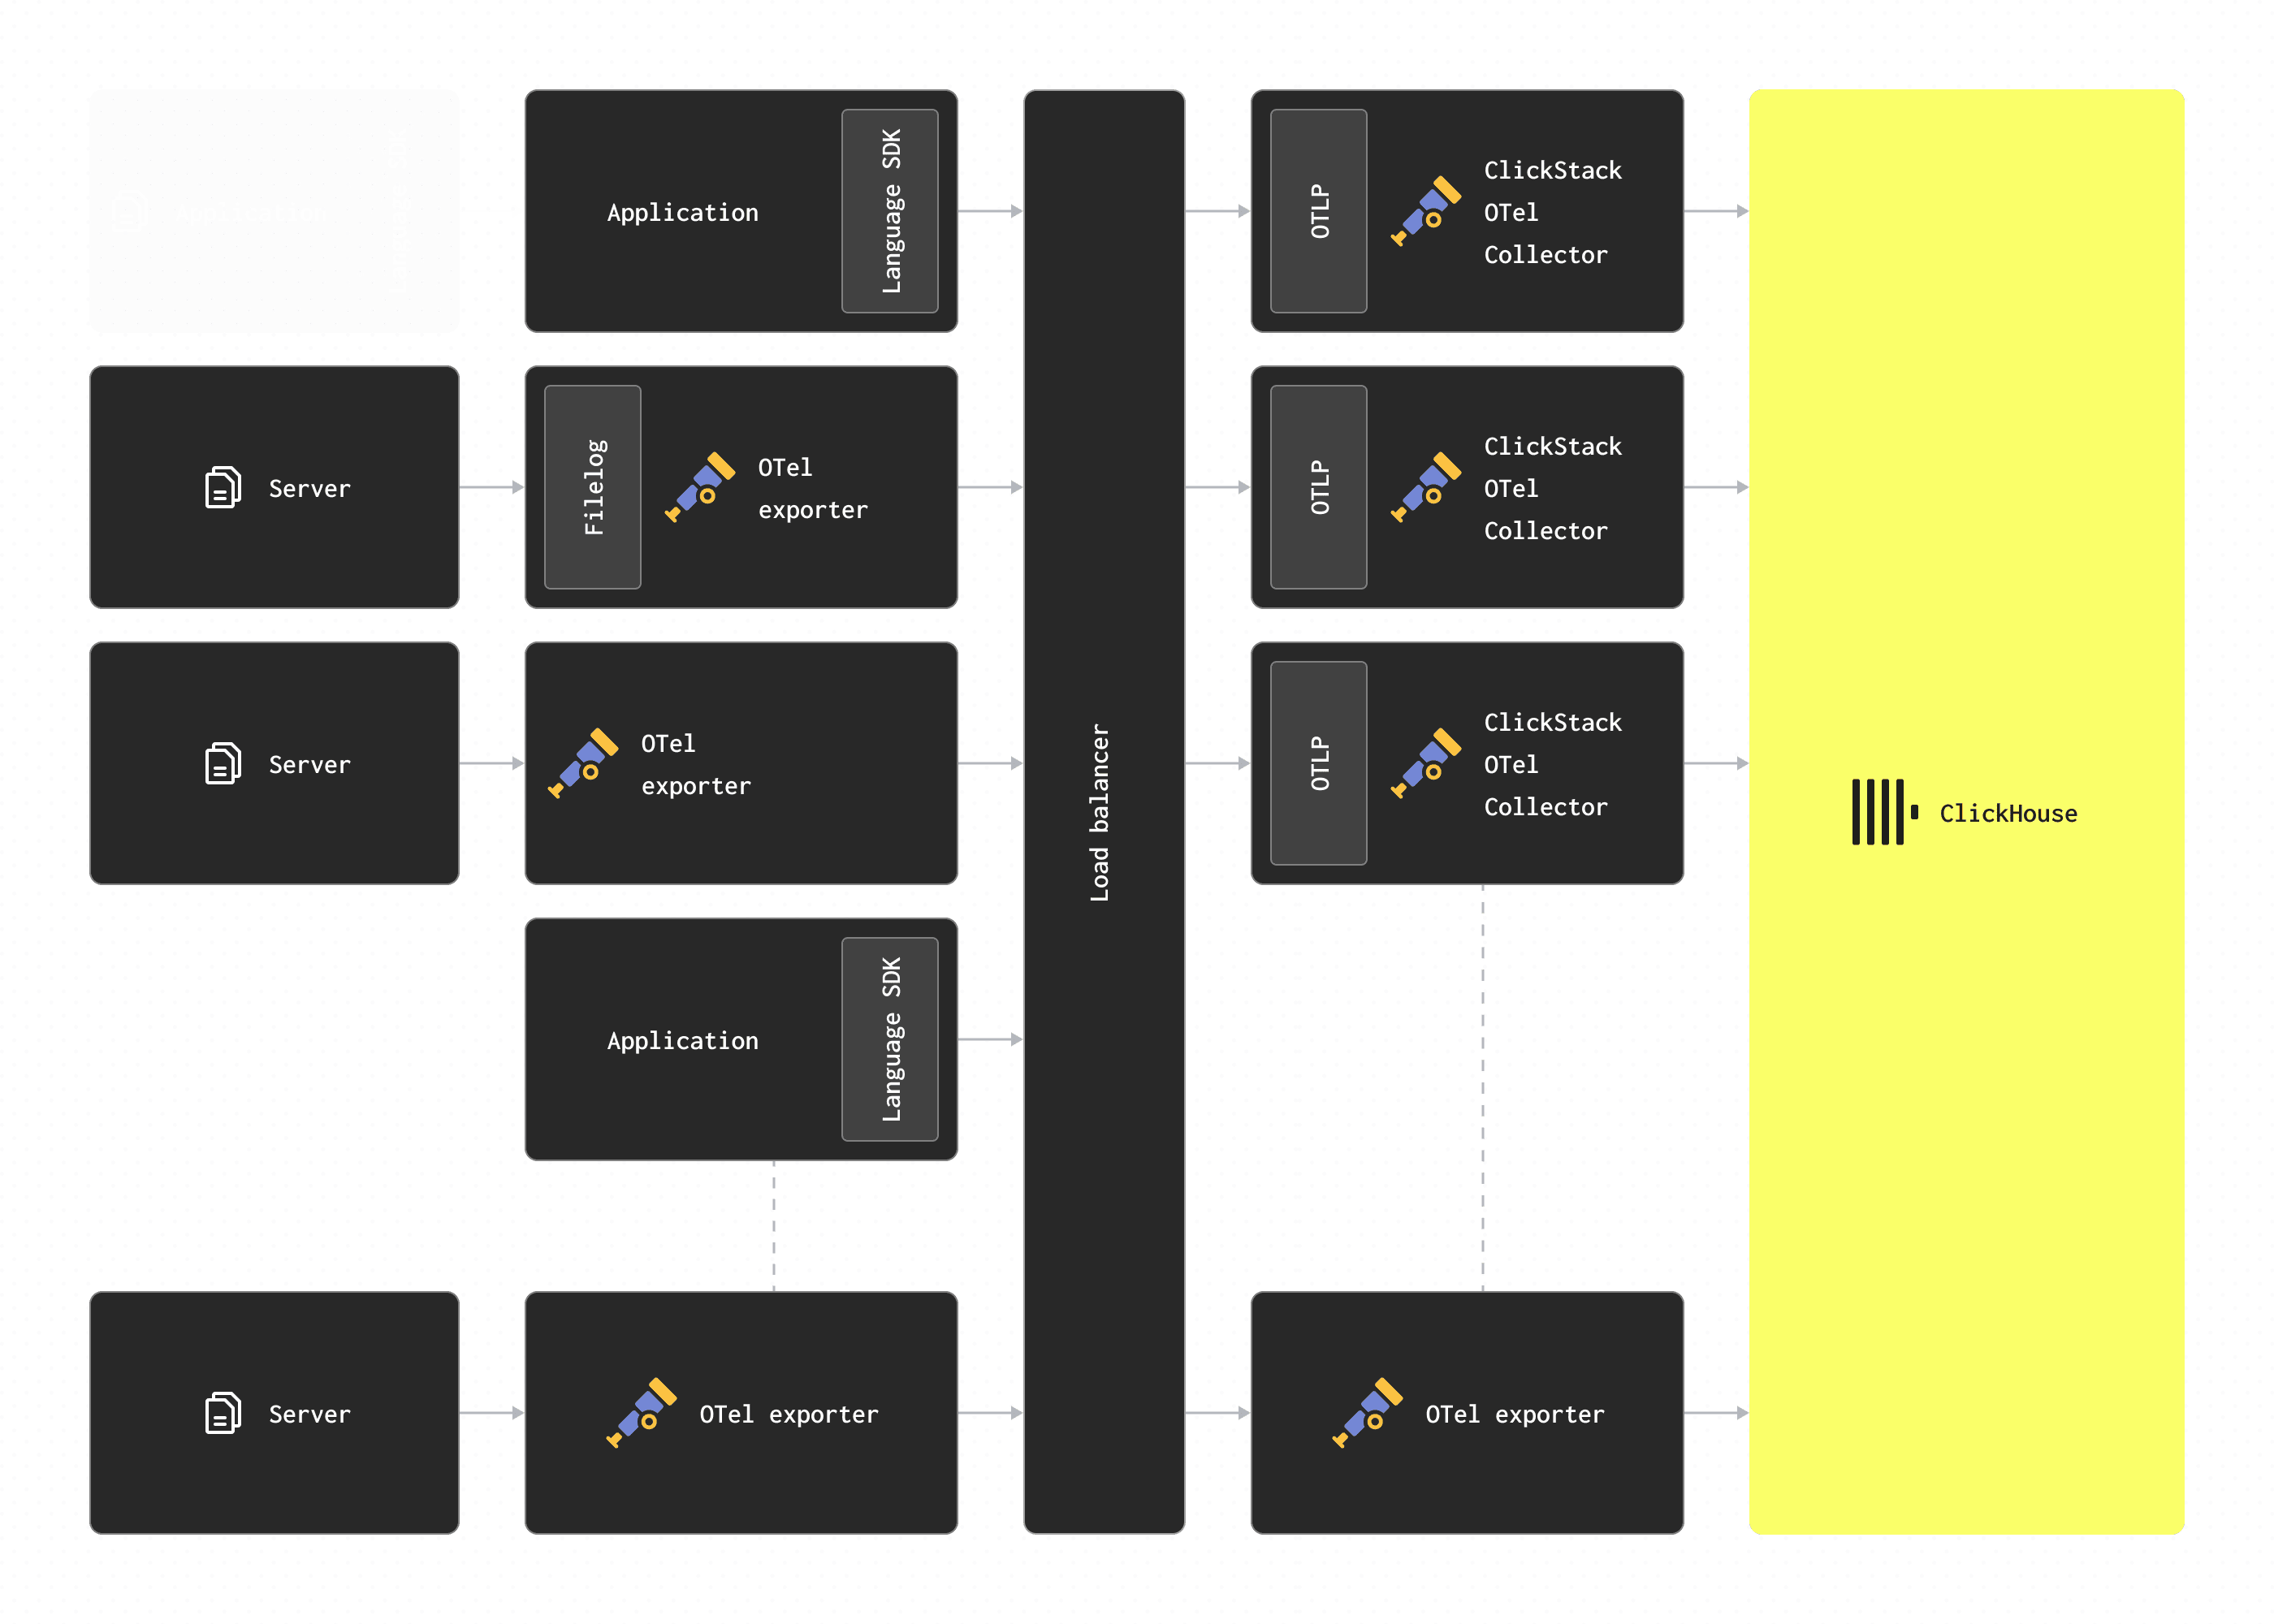
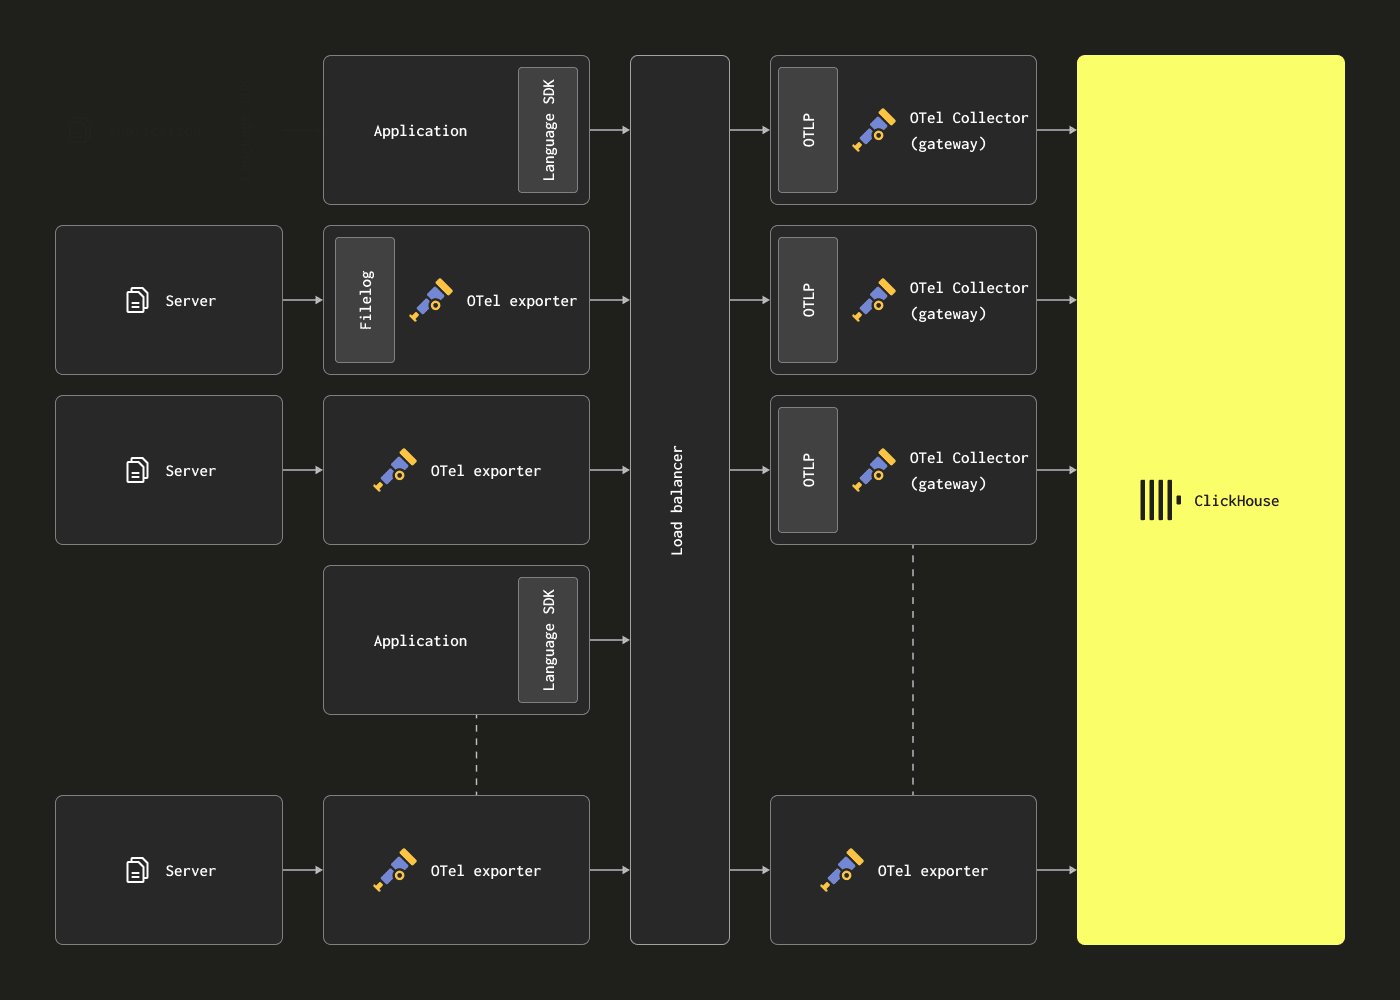
- Gateway - Gateway 实例提供独立服务 (例如 Kubernetes 中的一个部署) ,通常按集群、数据中心或区域部署。它们通过单个 OTLP 端点接收来自应用程序 (或作为 agent 的其他 collectors) 的事件。通常会部署一组 gateway 实例,并使用现成的负载均衡器在它们之间分配负载。如果所有 agent 和应用程序都将其信号发送到这一个端点,通常称为 Gateway deployment pattern。
- 托管 ClickStack
- 开源 ClickStack
在向托管 ClickStack 发送数据时,我们建议尽可能使用官方 ClickStack 发行版的 collector 充当 gateway 角色。如果您选择自行提供,请确保其中包含 ClickHouse exporter。collector 可通过 Helm (推荐用于 Kubernetes) 或 Docker 进行部署。官方 ClickStack Helm 图表 将上游 OpenTelemetry collector Helm 图表 作为子图表嵌入,并预配置了 ClickStack 发行版镜像——如需安装包含 HyperDX 的完整技术栈,请参阅 ClickStack Helm 部署指南。如需单独部署 collector,可直接使用上游图表配合 ClickStack 镜像,如下所示。目标 ClickHouse 实例通过环境变量 ClickStack 版 OTel collector 支持通过挂载自定义配置文件并设置环境变量来扩展基础配置。如需添加自定义 receiver、处理器或管道:使用独立收集器进行部署:如需更复杂的配置,请参阅默认 ClickStack 收集器配置和 ClickHouse 导出器文档。关于如何配置 OTel collectors (包括
- Helm
- Docker
添加上游 OpenTelemetry Helm 仓库:创建一个 安装该 chart:对于生产环境部署,建议将
values.yaml,配置 ClickStack 镜像和托管 ClickStack 凭证:CLICKHOUSE_PASSWORD 存储在 Kubernetes Secret 中,并通过 extraEnvsFrom 引用,而不是直接内联该值。CLICKHOUSE_ENDPOINT、CLICKHOUSE_USER 和 CLICKHOUSE_PASSWORD 进行配置。CLICKHOUSE_ENDPOINT 应为完整的 ClickHouse Cloud HTTP 端点,包含协议和端口,例如 https://99rr6dm6v3.us-central1.gcp.clickhouse.cloud:8443。有关如何获取托管 ClickStack 凭据的详细信息,请参阅此处。生产环境用户在生产环境中,应使用具有相应凭据的用户。
修改配置
配置托管 ClickStack 实例
可以通过环境变量CLICKHOUSE_ENDPOINT、CLICKHOUSE_USER 和 CLICKHOUSE_PASSWORD 将 OpenTelemetry collector 配置为使用托管 ClickStack 实例。这些变量的设置方式取决于您所采用的部署方式:- Helm
- Docker
在
values.yaml 中覆盖 extraEnvs 下的相应条目,然后升级该 release:- 创建一个包含附加配置的自定义配置文件
- 将该文件挂载到
/etc/otelcol-contrib/custom.config.yaml - 设置环境变量
CUSTOM_OTELCOL_CONFIG_FILE=/etc/otelcol-contrib/custom.config.yaml
你只需在自定义配置中定义新的接收器、处理器和管道。基础处理器 (
memory_limiter、batch) 和导出器 (clickhouse) 已定义好——直接按名称引用即可。自定义配置会与基础配置合并,且不能覆盖现有组件。receivers、operators 和 processors) ,更多详情请参考 OpenTelemetry collector 官方文档。Docker Compose
使用 Docker Compose 时,通过与上述相同的环境变量修改 collector 配置:- 托管 ClickStack
- 开源 ClickStack
默认情况下,在 Open Source 发行版之外部署 ClickStack OpenTelemetry collector 时,它不会默认启用安全保护,其 OTLP 端口也不要求身份验证。要保护摄取,请在部署 collector 时通过 此外,我们还建议:这里假设 collector 已配置为使用
OTLP_AUTH_TOKEN 环境变量指定身份验证令牌。具体设置方式取决于你的部署方式:- Helm
- Docker
在 对于生产部署,我们建议将
values.yaml 的 extraEnvs 中添加 OTLP_AUTH_TOKEN,然后升级该 release:OTLP_AUTH_TOKEN 和 CLICKHOUSE_PASSWORD 存储在 Kubernetes Secret 中,并通过 extraEnvsFrom 引用它们。- 将 collector 配置为通过 HTTPS 与 ClickHouse 通信。
- 为摄取创建一个权限受限的专用用户——见下文。
- 为 OTLP 端点启用 TLS,确保 SDK/agents 与 collector 之间的通信经过加密。这可以通过自定义 collector 配置进行配置。
创建摄取用户
我们建议为 OTel collector 创建一个专用 database 和用户,用于向托管 ClickStack 摄取数据。该用户应具备对 ClickStack 创建并使用的表执行创建和插入操作的权限。otel 数据库。这可以通过环境变量 HYPERDX_OTEL_EXPORTER_CLICKHOUSE_DATABASE 进行控制。将其传递给 collector,方式与传递其他环境变量类似。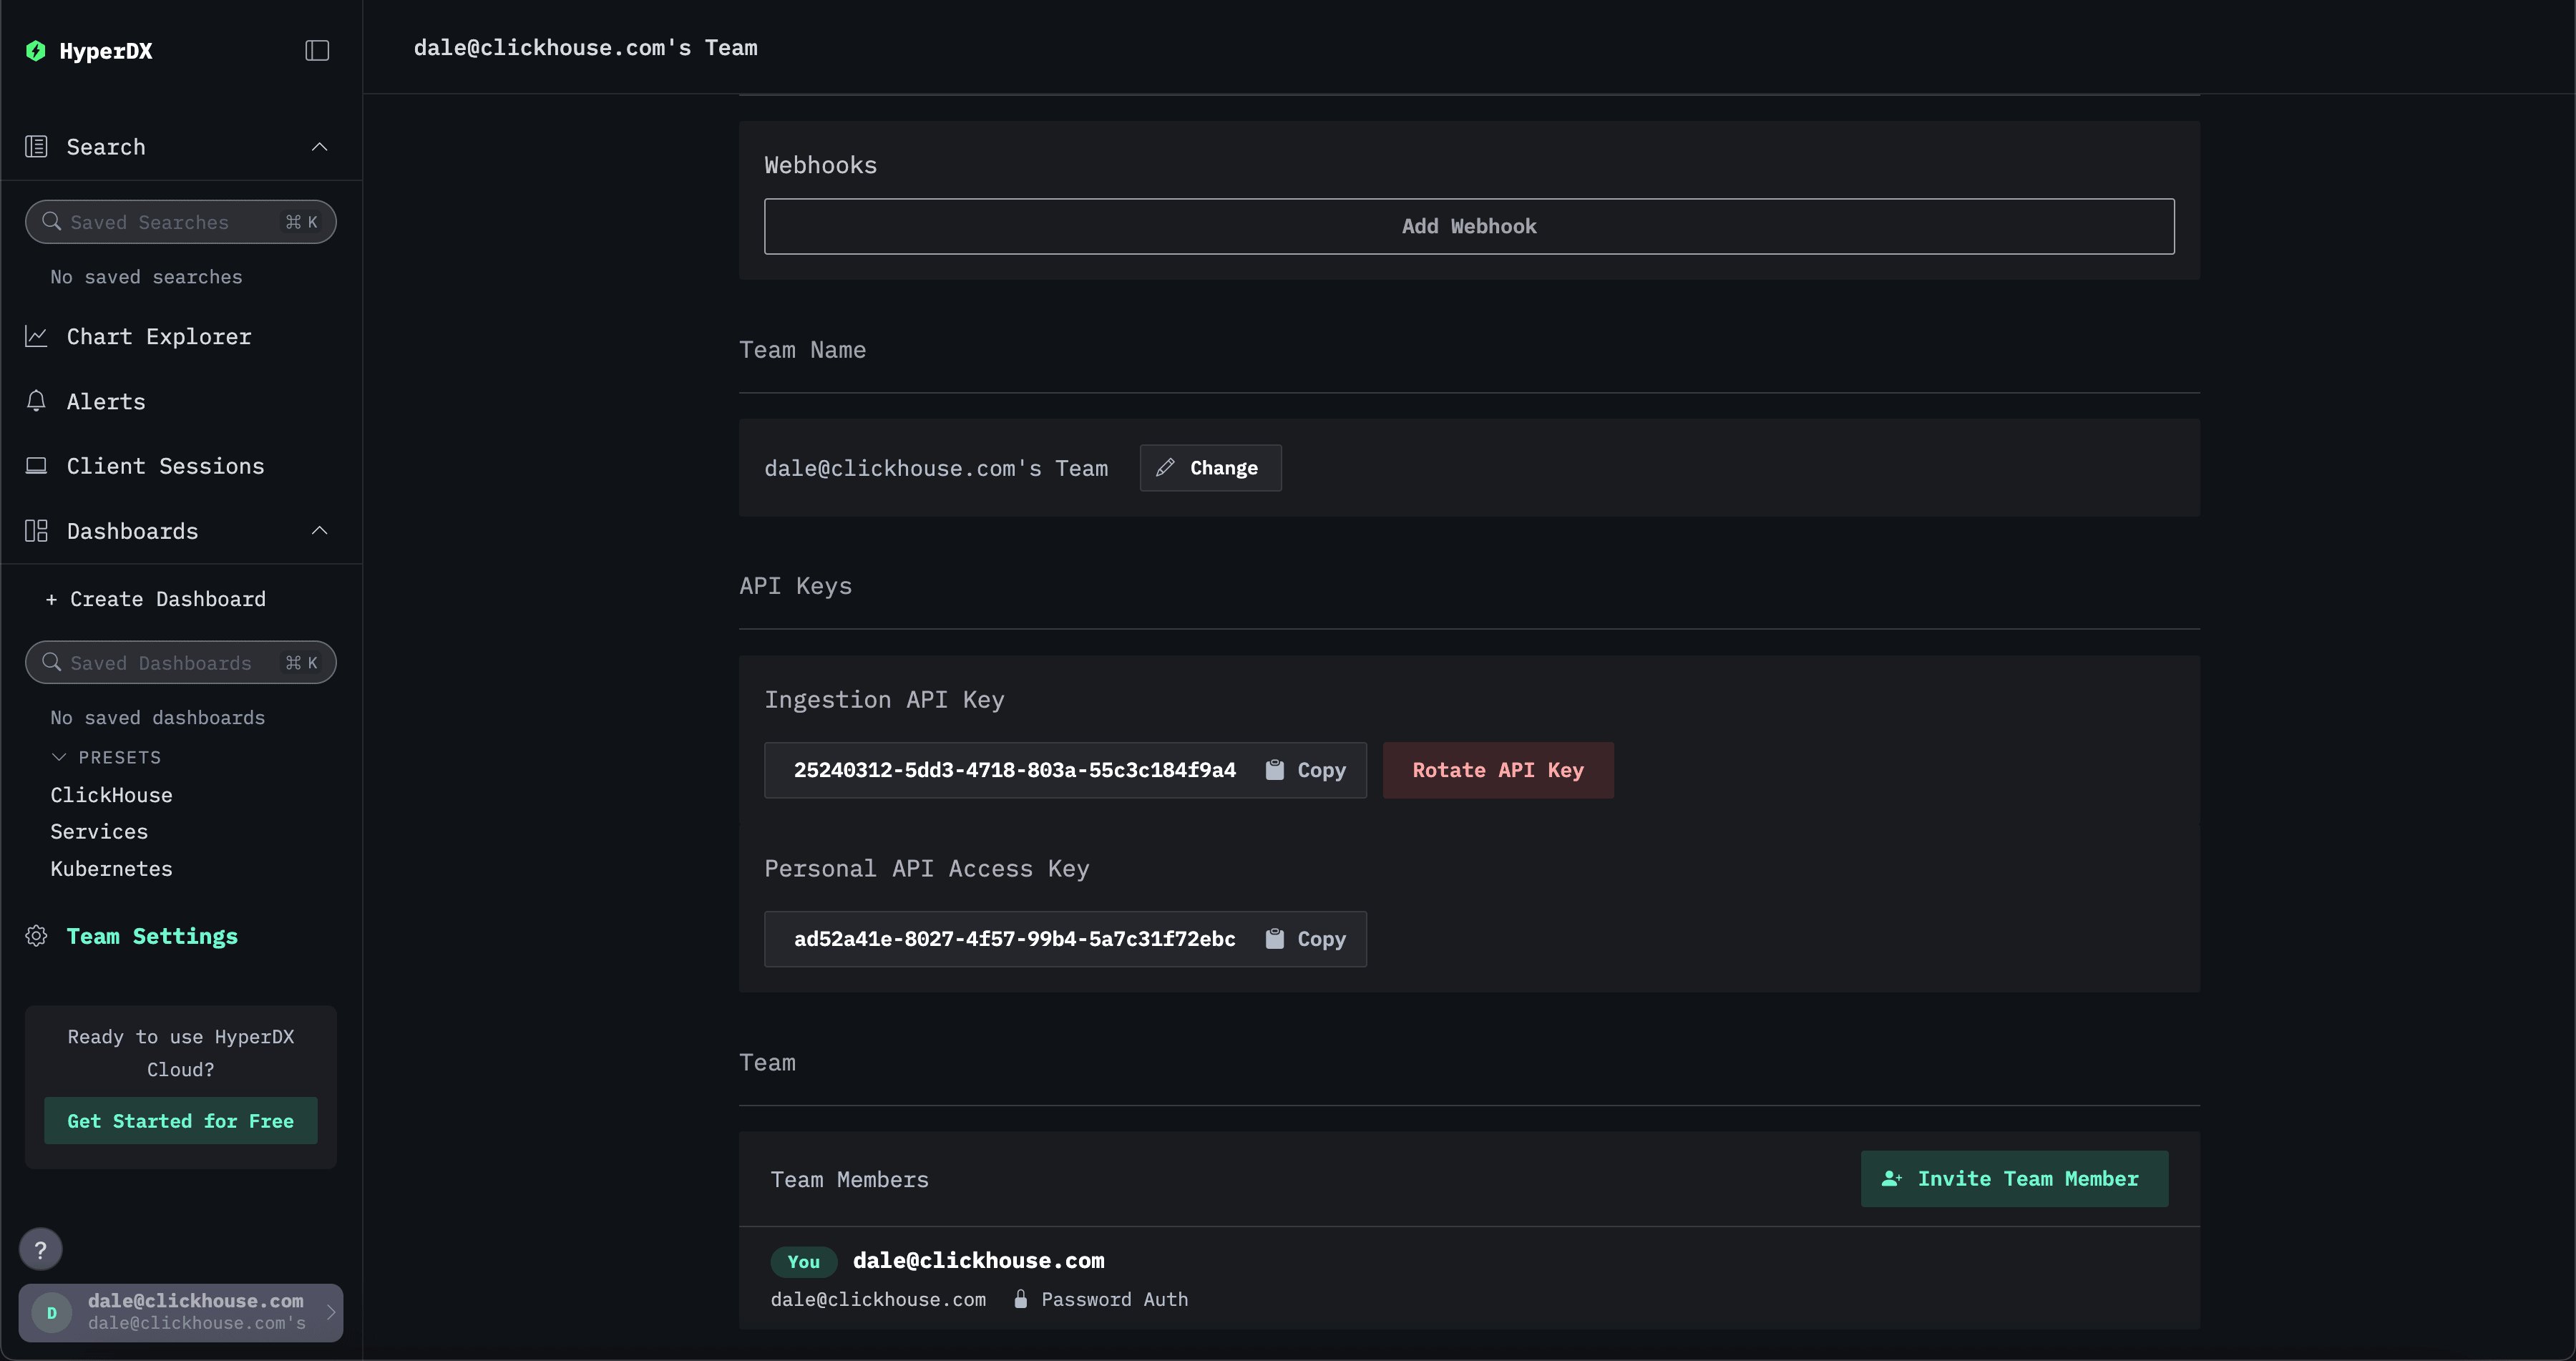
- 部署自有版本的 OTel collector 执行过滤和处理,并通过 OTLP 将事件发送到 ClickStack collector,摄取到 ClickHouse。
- 部署自有版本的 OTel collector,并使用 ClickHouse exporter 将事件直接发送到 ClickHouse。
-
Processors - Processors 会在数据由 receivers 接收后对其进行修改或转换,再发送给 exporters。Processors 会按照 collector 配置中
processors部分定义的顺序依次应用。这些是可选的,但通常建议至少使用最小集合。在将 OTel collector 与 ClickHouse 配合使用时,我们建议将 processors 限制为: - 使用 memory_limiter 防止 collector 出现内存不足的情况。有关建议,请参见资源估算。
- 任何基于上下文进行富集的 processor。例如,Kubernetes Attributes Processor 可以利用 k8s 元数据自动设置 spans、metrics 和 logs 的资源属性,例如用源 pod (容器组) id 为事件补充信息。
- 如果 traces 需要采样,可使用尾部采样或头部采样。
- 基础过滤 - 丢弃不需要的事件;如果无法通过 operator 完成 (见下文) ,则可在这里进行。
- 批处理 - 在与 ClickHouse 配合使用时至关重要,以确保数据按批次发送。请参见“优化插入”。
- Operators - Operators 是 receiver 中可用的最基本处理单元。这里支持基础解析,可设置 Severity 和 Timestamp 等字段。这里还支持 JSON 和正则表达式解析,以及事件过滤和基础转换。我们建议在这里执行事件过滤。
regex_parser) 并过滤事件,同时配合处理器将事件按批次处理并限制内存使用量。
file=code_snippets/ClickStack/config-unstructured-logs-with-processor.yaml
- (1) 如果接收数据的节点出现问题,插入查询会超时 (或返回更具体的错误) ,并且不会收到确认。
- (2) 如果节点已写入数据,但由于网络中断,确认无法返回给查询发送方,那么发送方会收到超时或网络错误。
timeout 到达之前刷新批次,从而确保管道的端到端延迟保持较低,并且各批次的大小保持一致。
通常,当 collector 的吞吐量较低时,用户往往不得不发送更小的批次,但同时仍希望数据能以尽可能低的端到端延迟到达 ClickHouse。在这种情况下,当batch processor 的 timeout 到期时,就会发送小批次。这可能会带来问题,此时就需要使用异步插入。如果你将数据发送到以 Gateway 角色运行的 ClickStack collector,这种情况通常较少见——由于它们充当聚合器,可以缓解这一问题——请参见 Collector 角色。
如果无法保证使用大批次,可以通过 异步插入 将批处理交给 ClickHouse。启用异步插入后,数据会先写入缓冲区,随后再异步写入数据库存储。
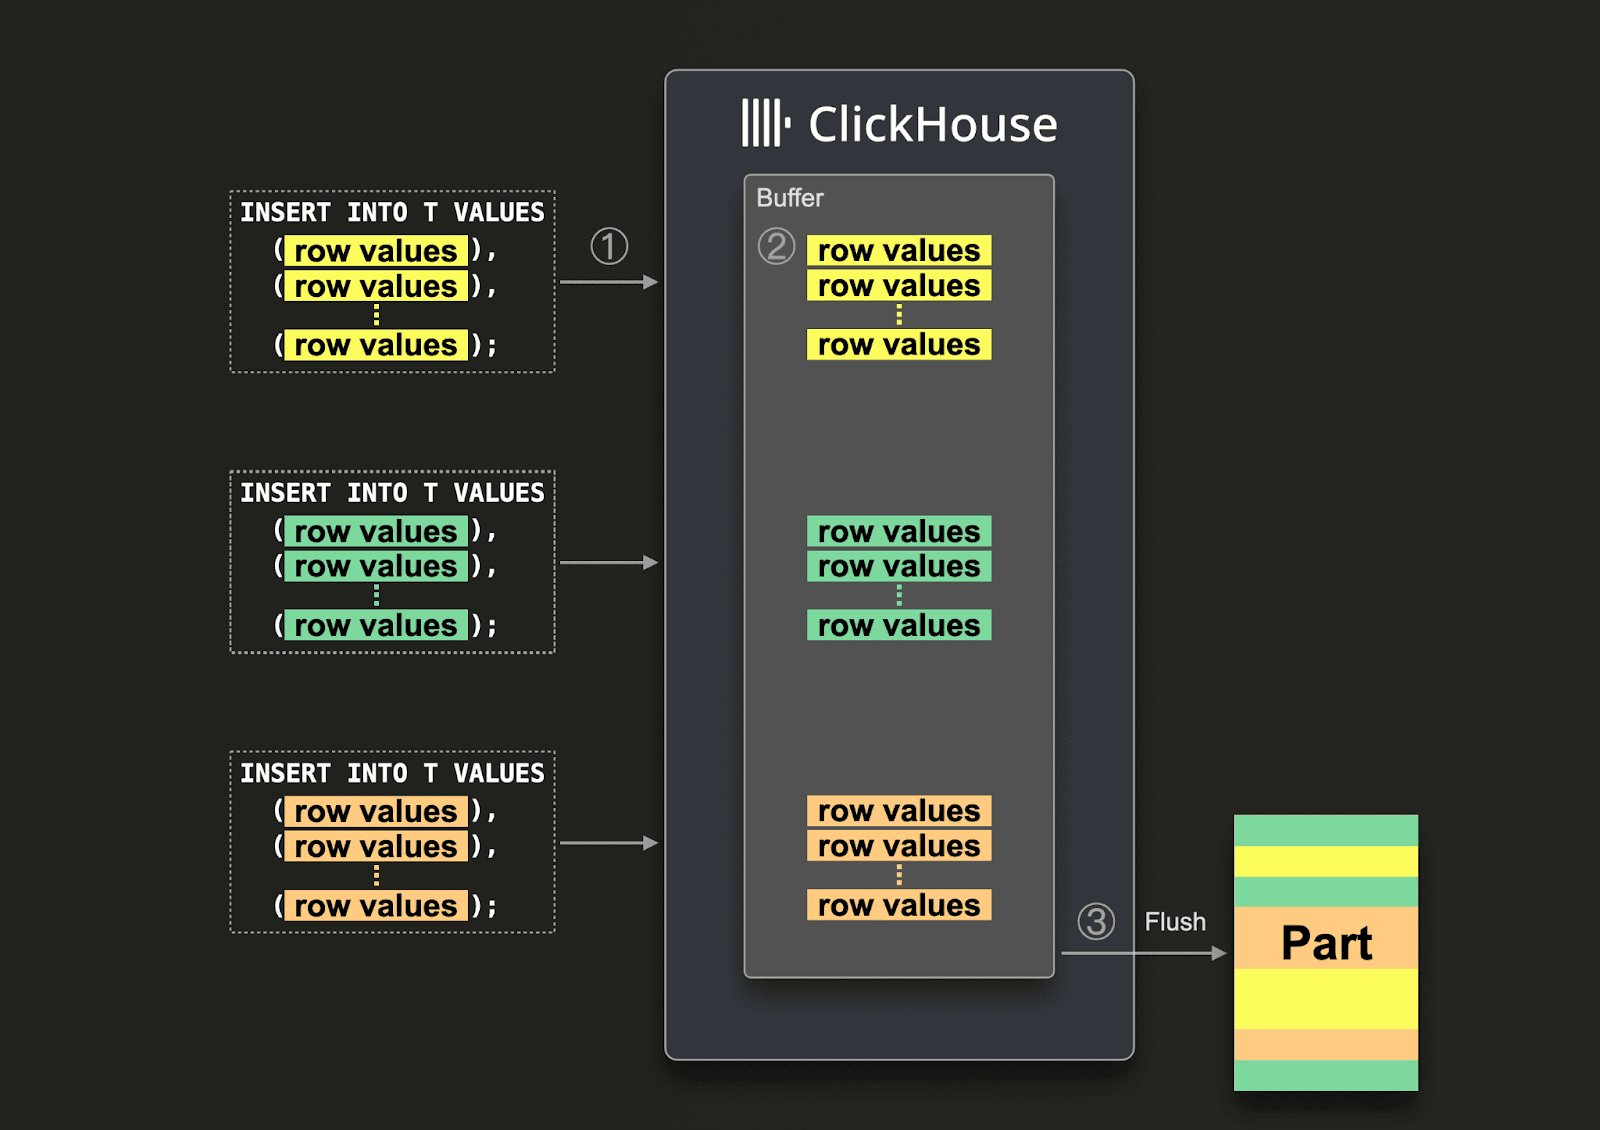
async_insert=1。我们建议使用 wait_for_async_insert=1 (默认值) 来获得投递保证——更多细节请参见这里。
异步插入的数据会在 ClickHouse 缓冲区 flush 后写入。当超过 async_insert_max_data_size 时,或自第一次 INSERT 查询起经过 async_insert_busy_timeout_ms 毫秒后,就会发生这种情况。如果 async_insert_stale_timeout_ms 设置为非零值,则会在距离上一次查询经过 async_insert_stale_timeout_ms milliseconds 后写入数据。你可以调整这些设置来控制管道的端到端延迟。可用于调优缓冲区 flush 的更多设置记录在这里。通常,默认值已经足够合适。
考虑自适应异步插入如果只使用少量 agent、吞吐量较低,但对端到端延迟有严格要求,则自适应异步插入可能会有帮助。一般来说,它们并不适用于 ClickHouse 常见的高吞吐量可观测性用例。
async_insert_deduplicate。
有关如何配置此功能的完整细节,请参见这篇文档页面,或阅读这篇深入讲解的博客文章。
ClickStack OTel collector 作为 gateway 实例运行——参见 Collector roles。它们提供独立服务,通常按每个数据中心或每个区域部署。这些实例通过单一 OTLP 端点接收来自应用程序 (或其他承担 agent 角色的 collector) 的事件。通常会部署一组 collector 实例,并使用现成的负载均衡器在它们之间分摊负载。
OTel collector 配置ClickStack OpenTelemetry collector 发行版可通过自定义 collector 配置接入 Kafka。
ClickStack collector 默认创建的表会将属性存储在
Map(LowCardinality(String), String) 列中。这是可观测性工作负载推荐使用的 schema。Beta 版 JSON 类型 schema 可用于评估属性键集合较小且稳定的工作负载。
如需了解完整对比、各自的适用场景、启用 JSON 类型 schema 所需的环境变量,以及迁移演练,请参阅 Map vs JSON type。