

- 原生 TCP 协议中
Data、Totals、Extremes、Log和ProfileEvents数据包的主体 (TableColumns数据包不是 Native 块,它携带的是两个二进制字符串,因此其布局在原生协议规范中说明) ; - 通过 HTTP 执行
SELECT ... FORMAT Native时的输出; - 通过
INTO OUTFILE ... FORMAT Native导出的文件; - 服务器间的复制载荷。
概述
线上传输中所有承载行数据的单元都是 Block:一种按列存储行的自描述数据块。第 1 列的所有值排在最前,随后是第 2 列的所有值,依此类推。Block 只包含查询所引用的列,绝不会包含整张表。 列的data 按其类型所属的家族进行布局。按解码器复杂度从低到高,这些家族依次为:
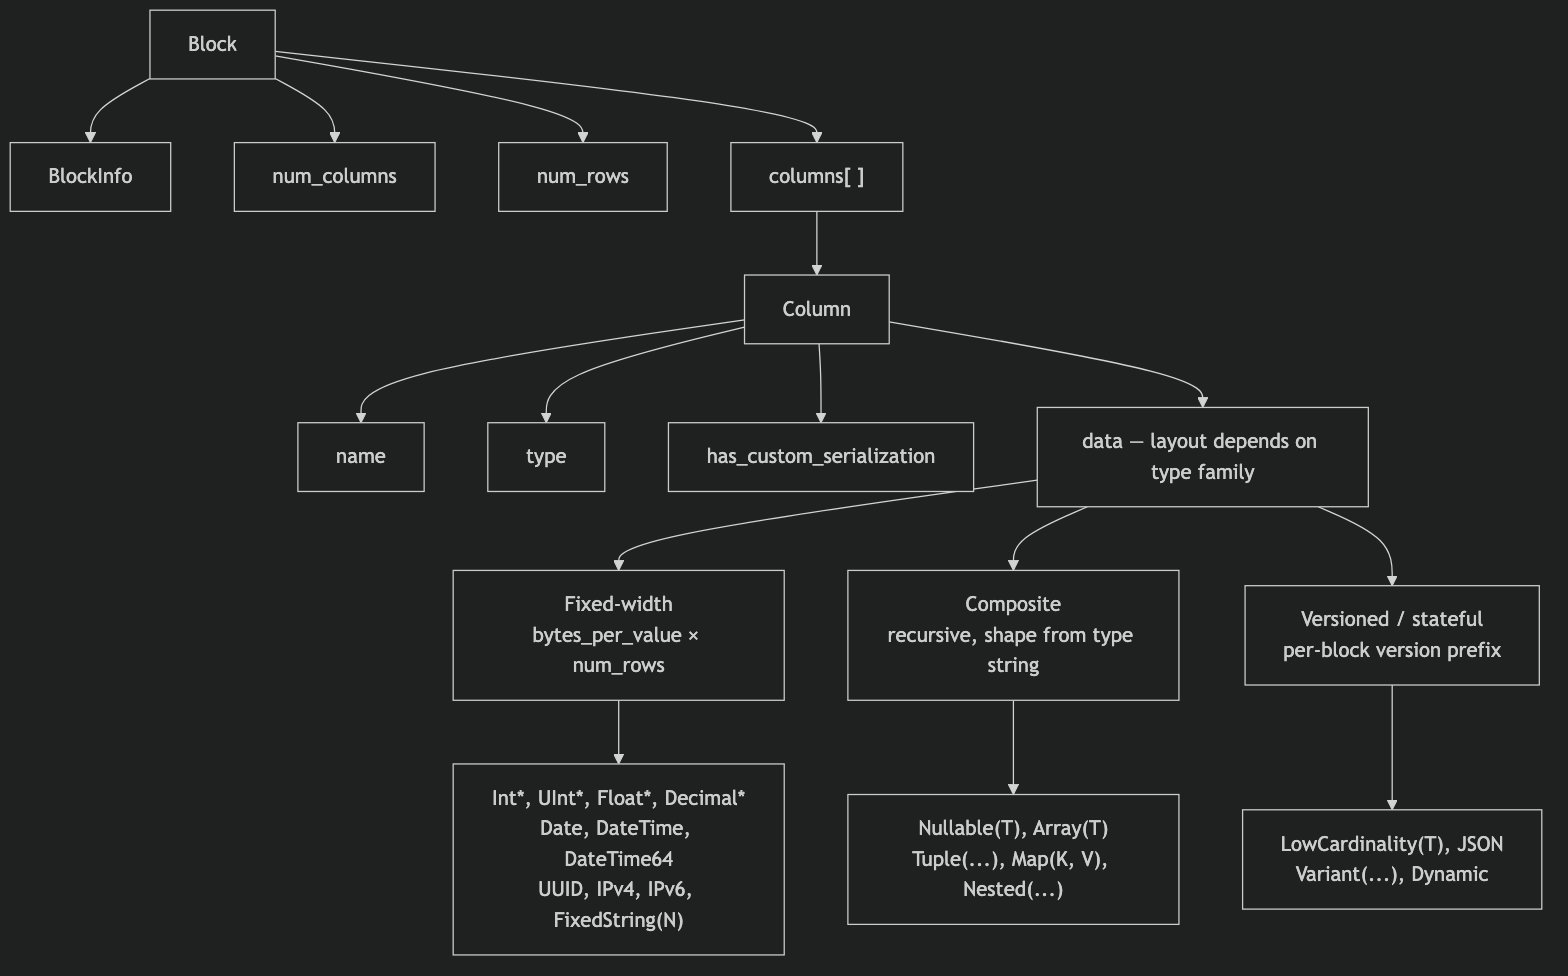
- 定宽类型将
data布局为bytes_per_value × num_rows个原始字节,不含逐行的帧信息。 - 复合类型 (
Nullable、Array、Tuple、Map、Nested) 的递归形态可完全由类型字符串推导得出,既没有版本前缀,也没有跨块状态。 - 版本化 / 有状态类型 (
LowCardinality、JSON、Variant、Dynamic) 在每个非空块的开头都带有序列化版本/状态前缀。在Native传输格式中,该前缀以及字典 (如有) 都是按块存在的——该格式不会跨块保留状态 (写入器会为每个块创建全新的序列化状态,并设置low_cardinality_max_dictionary_size = 0) 。跨块状态属于 MergeTree 磁盘存储层面的问题,与 Native 传输布局无关。
传输基本类型
Native 格式建立在四种基本类型编码之上。VarUInt
一种采用 LEB-128 编码的变长无符号整数。每个字节的第 0–6 位存放 7 个数据位,第 7 位为 1 个延续位。若后面还有字节,延续位为1;最后一个字节的延续位为 0。
对值
300 进行编码:
0xAC 0x02:
定宽整数
例如,UInt32 值
1 编码为 01 00 00 00,Int32 值 -1 则编码为 FF FF FF FF。
String
以长度为前缀的字节序列:0x00 字节,且字符串可以包含任意字节值,包括内嵌的 NUL。例如,字符串 "ab" 编码为 02 61 62;解码时,先读取 VarUInt 长度 (2) ,再读取相应数量的字节。
Bool
占用单个字节。0x00 表示 false;任何非零值均表示 true (规范值为 0x01) 。
块与列结构
块传输布局
BlockInfo 前缀取决于所用的通道,因为写入器以修订版本作为参数 (完整说明请参见 Protocol revision and the Native format,其中也介绍了 client_protocol_version 仅作用于输出这一特性) :
-
在原生 TCP 协议上,服务器按照连接协商所得的修订版本写入块 (这是一个较大的值——
DBMS_TCP_PROTOCOL_VERSION,参见src/Core/ProtocolDefines.h) 。只要该修订版本大于零,就会写入BlockInfo;对于真实连接,这一条件始终成立。每个列中的has_custom_serialization字节 (参见列的线协议布局) 仅在修订版本为54454及以上时写入。 -
Native输出格式——即通过 HTTP 执行的SELECT ... FORMAT Native、INTO OUTFILE ... FORMAT Native,以及 ClickHouse 客户端 (clickhouse-client) 生成的Native格式——默认以修订版本0进行序列化。在修订版本0下,BlockInfo前缀和has_custom_serialization字节均会省略,因此一个块仅由num_columns、num_rows及各列组成。 通过 HTTP 时,该修订版本并不固定:客户端可以通过?client_protocol_version=<n>查询参数调高该值,服务器会将其用作响应的序列化修订版本。 当该值足够大时,HTTP 输出将包含BlockInfo前缀 (修订版本大于0时写入) 和has_custom_serialization字节 (修订版本为54454及以上时写入) ,与 TCP 路径完全相同。因此,客户端不应假定所有 HTTPFORMAT Native载荷的修订版本都是0。
BlockInfo 前缀开头的字节示例描述的是 TCP Data 数据包的载荷;同一查询若通过 FORMAT Native 执行,则会生成与之并列展示的较短形式。
BlockInfo
BlockInfo 由一系列字段组成,每个字段前面都有一个 VarUInt 类型的字段 ID,并以字段 ID0 结尾。该传输格式不是自描述的:字段 ID 不包含其值的长度或类型信息,因此读取器必须预先知道它可能遇到的每个字段 ID 对应的类型。ClickHouse 自身的读取器会将无法识别的字段 ID 视为数据损坏,并引发异常 (UNKNOWN_BLOCK_INFO_FIELD) 。前向兼容性则由协议修订版本来保证:只有当协商出的修订版本不低于某字段的最低修订版本时,发送方才会写入该字段,因此较旧的接收方永远不会遇到它无法识别的字段。
字段
1 和 2 的最低修订版本为 0,因此只要写入了 BlockInfo,这两个字段就一定存在。字段 3 仅在修订版本为 54480 及以上时才会写入。常见情况 (修订版本低于 54480) 下的传输布局如下:
列的传输格式布局
在一个 数据块 中,Column 会出现num_columns 次。
解码器根据
type 字符串进行分派。类型字符串通常会在括号中携带参数;解码器先去掉 (...) 后缀以确定基本类型,再解析其中的参数,以确定大小、精度或内部类型。解析包含嵌套类型的参数列表 (例如 Array 中嵌套 Tuple) 时,需要使用能感知嵌套深度、跟踪括号层级的逗号拆分器,而不能简单地按 , 拆分。
二进制类型编码
type 字段仅在默认模式下才是文本形式的 String。若启用查询设置 output_format_native_encode_types_in_binary_format = 1,该字段将改为二进制类型编码——即数据类型二进制编码中所述的基于标签的编码——同时,展平后的 Dynamic 类型列表中的各类型名称也采用同样的二进制编码。如果解码器总是将字段 2 按带长度前缀的字符串读取,就会把第一个二进制类型标签误当作字符串长度,导致数据流失去同步,因此解码器必须知道数据流采用的是哪种模式。对于 query_kind = SECONDARY_QUERY 的查询 (由另一台服务器针对 remote、Distributed 或并行副本发送,或由 clickhouse-client --query_kind secondary_query 发送) ,通信双方在处理该查询的数据块时都会忽略 output_format_native_encode_types_in_binary_format 和 input_format_native_decode_types_in_binary_format,双向传输的均为文本形式的类型名称。早于该规则的服务器版本则会像对待其他查询一样,对次级查询应用这些设置。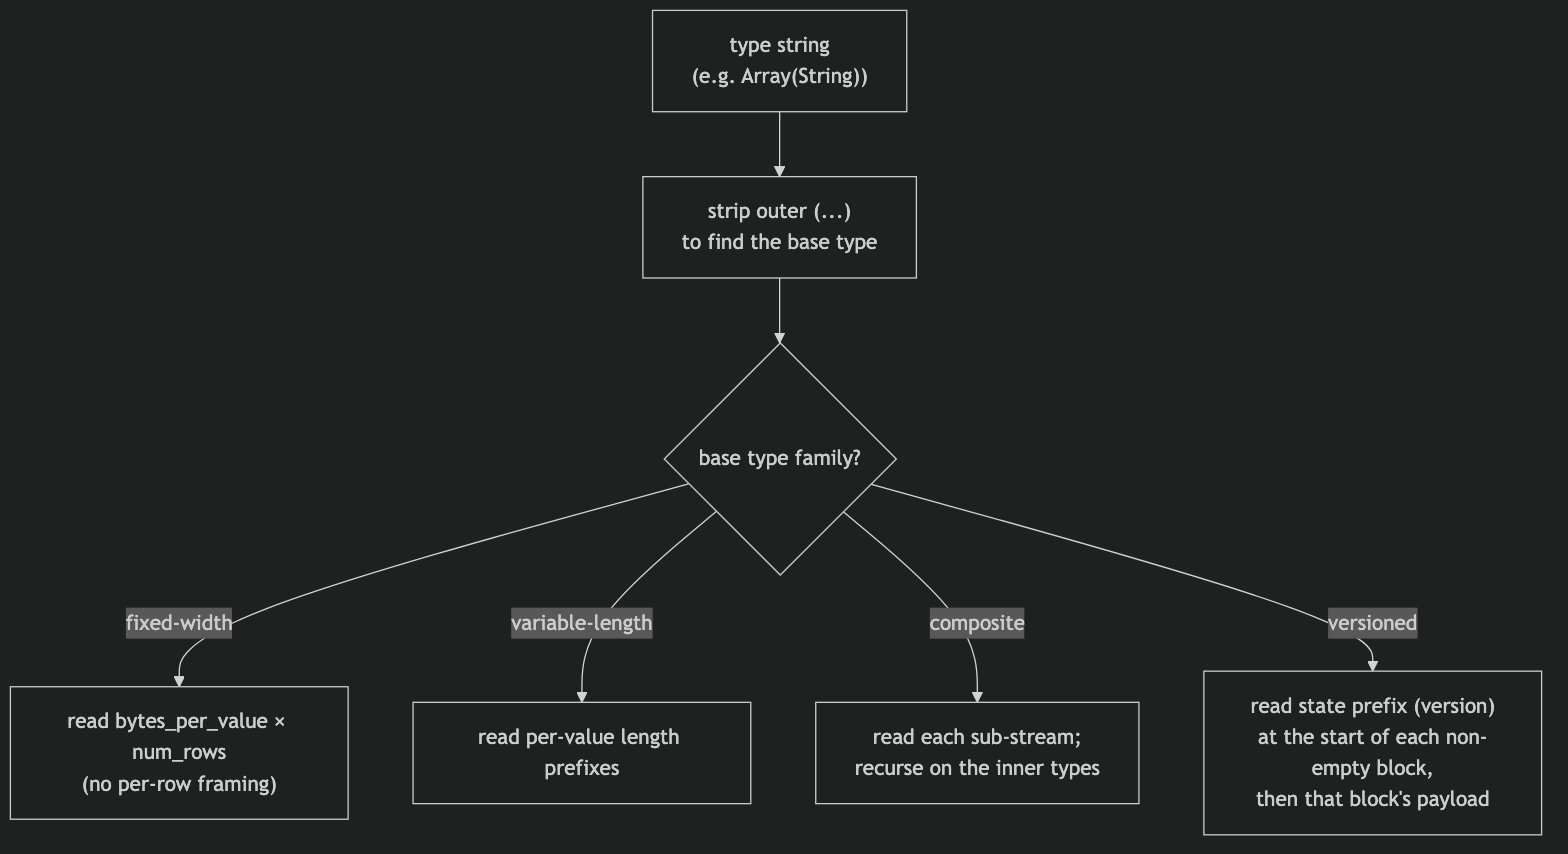
kind_stack 与稀疏编码
kind_stack 字节以枚举值表示某列的非默认序列化方式:
COMBINATION 载荷使用另一套枚举。 上表前五行是紧凑的单字节编码。COMBINATION (0x05) 是一种通用转义,用于表示上述编码未涵盖的任意栈:其后跟随一个 VarUInt count,然后是 count 个单字节条目。这些条目并非上表中的紧凑编码,而是原始的 ISerialization::Kind 值:
这些字节值与紧凑编码不同:
REPLICATED 在该嵌套枚举中为 0x03,而作为紧凑编码时为 0x04;此外也没有 DETACHED_OVER_SPARSE 条目——该组合以 SPARSE、DETACHED 两个连续条目表示。如果解码器在解析嵌套字节时仍沿用紧凑编码表,就会把 0x03/0x04 映射错误,导致解析失去同步。
count 是栈的完整长度,包括每个栈开头的 DEFAULT 条目。由于紧凑编码已涵盖所有包含一个或两个条目的栈,COMBINATION 的 count 始终不小于 3。
Kind 栈的有效性。 对于格式错误的栈,解码器会以 INCORRECT_DATA 拒绝,而不会按其描述构建序列化:
- 栈必须以
DEFAULT开头; - 栈必须是
DEFAULT、SPARSE、REPLICATED、DETACHED的子序列——这也是各 kind 逐层包装的顺序。SPARSE可以位于REPLICATED内部,反之则不行;DETACHED始终位于最后,因为ColumnBLOB保存的是其下层所有内容的序列化形式。这也意味着同一 kind 不会出现两次,因此count不会超过 kind 的总数。
ColumnSparse 将始终保持包装状态。
Tuple 列的递归 kind_stack。 上述 kind_stack 载荷是单个列自身序列化信息对应的字节 (或 COMBINATION 序列) 。Tuple 携带一个 SerializationInfoTuple,它会先写入该 tuple 自身的 kind 栈载荷,再按顺序为每个元素各写入一个完整的 kind 栈载荷;解码器按同样的递归结构读回。因此,对于 Tuple(A, B, C),字段 4 的字节为 [tuple_kind][A_kind][B_kind][C_kind];若某个元素本身又是复合类型,其元素载荷同样是递归的。只要 tuple 自身的信息或任一元素的信息为非默认,就会设置 has_custom_serialization 字节 (字段 3) ,因此即使 Tuple 中只有一个元素是稀疏或副本形式,也会触发 kind 栈载荷。如果解码器对 Tuple 只读取开头的单个枚举字节,就会过早停止,并把剩余的元素 kind 字节误读为列数据。
稀疏传输格式。 当 kind_stack = 0x01 时,列 data 由两个流组成,二者在同一个共享 TCP 流中依次连续写入:
- 偏移流 — 由一系列
VarUInt组成。每个值v有以下两种情况:- 第 62 位 (高位) 未置位的
v:(v & 0x3FFFFFFFFFFFFFFF)= 下一个显式非默认值之前的默认位置数量。该非默认位置为cursor + group_size,其中cursor为当前累计位置;之后cursor前进group_size + 1。 - 第 62 位已置位 (
END_OF_GRANULE_FLAG) 的v:清除该标志后的值 = 最后一个非默认值之后的尾随默认位置数量。该值标志着当前数据块偏移流的结束。
- 第 62 位 (高位) 未置位的
- 值流 —
count个以内部类型紧凑编码的非默认值,其中count为上面读取到的非 EOG VarUInt 的数量。
num_rows 个条目的稠密列时,会用内部类型的默认值填充所有非显式位置 (整数和浮点数为 0,String 为 "",Date 为 0 天,依此类推) 。
稀疏 Nullable(T) 列属于特殊情况,因为 Nullable(T) 的默认值是 NULL。稀疏编码会完全省略常规的 Nullable 空值映射流:偏移流标识非默认 (即非 NULL) 位置,值流仅以 T 类型紧凑存储这些非 NULL 值,所有非显式位置则重建为 NULL。因此,解码器不得在值流中查找空值映射,也不得用实际存在的 0 填充空缺,而应填充 NULL。
Replicated 传输格式。 当 kind_stack = 0x04 时,列的 data 是一个字典:由一组互不相同的元素值,以及每行指向该列表的索引组成 (与 LowCardinality 的查找结构相同) 。如果内部类型本身是版本化类型 (例如 LowCardinality(T)) ,则其状态前缀会先于索引流写入:Replicated 序列化在写入 num_rows 之前,会将前缀阶段交由内部类型处理。前缀为空的内部类型 (叶子类型和普通复合类型) 在此处不写入任何字节。
i 选取 elements[indexes[i]],以此重建稠密列。复合内部类型会递归处理:先按内部类型物化元素列表,再按索引取值。已支持的内部类型包括各叶元素类型、Nullable(T)、Array(T)、Tuple(...)、Map(K, V)、Nested(...) (每个字段均按 Array 方式展开) 以及 LowCardinality(T) (保留共享字典,仅对每个元素的键进行索引) 。
Detached 传输格式。 DETACHED (0x02) 和 DETACHED_OVER_SPARSE (0x03) 确实会出现在网络传输中,并非仅供内部使用。在 TCP 路径上,如果启用了压缩,且协商的修订版本不低于 DBMS_MIN_REVISON_WITH_PARALLEL_BLOCK_MARSHALLING (v54478) ,列将经过以下三个步骤:
- 每个符合条件的列 (非
const、非Tuple,且所在块的行数大于 1) 会被包装到一个ColumnBLOB中,其中保存的是已在主线程之外完成编组和压缩的列。 - 将
DETACHED追加到被包装列的 kind stack 中。 - 列的
data先写入一个VarUInt类型的 blob 大小,随后紧跟相同字节数的 blob 数据。
{DEFAULT, SPARSE, DETACHED},序列化后即为 DETACHED_OVER_SPARSE。客户端解码此类列时,先读取 blob 长度和字节,再解压该 blob,以恢复内部列载荷 (参见压缩部分中的 ColumnBLOB 说明) 。
DETACHED 具有方向性:它只能出现在服务器发送的结果块中,且只能作用于整个顶层列——绝不能作为 Tuple 的某个元素 kind 出现。与其他 kind 不同,它会使运行时列变为 ColumnBLOB,而非所声明类型的列,因此只有当接收方自身的管道能够将该 blob 还原时,接收方才会接受它。正因如此,对于客户端发送的任何块 (无论是外部表数据、标量还是插入数据) ,只要其中包含 DETACHED,服务器都会以 INCORRECT_DATA 拒绝。
Block 变体
所有 Data 家族的数据包都使用相同的 Block 传输格式。各变体之间的区别仅在于列数和行数:字节级示例
本节中的所有示例均取自 TCP Data 数据包路径,因此都包含BlockInfo 前缀和 has_custom_serialization 字节。若通过 FORMAT Native 传输,同样的块会更短——必要时会一并给出对应的等效简短形式。
一个空块 (含 BlockInfo) ,共 8 字节:
SELECT 1 的头部块声明了一个名为 "1"、类型为 UInt8 的列,行数为零。当协议版本 ≥ 54454 时,还会包含 has_custom_serialization 字节:
FORMAT Native (修订版本 0) 输出时,同一个结果块既没有 BlockInfo,也没有 has_custom_serialization 字节——SELECT 1 FORMAT Native 共 11 个字节:
FORMAT Native 输出时不会产生任何字节:该输出格式不会输出空块。)
协议修订版本与 Native 格式
决定 Native 字节流结构的首要因素,是其写入器和读取器所使用的协议修订版本。修订版本本身并不出现在字节中——线上传输的数据里没有修订版本字段——但它仍决定着若干特性是否出现。因此,解码器必须先知道载荷是以哪个修订版本写入的,才能对其进行解析。既然修订版本不在流中,读取器和写入器就必须通过其他方式约定好它。 它是一个UInt64,NativeWriter 和 NativeReader 都通过构造函数参数接收它。写入器将其称为 client_revision,读取器将其称为 server_revision,但二者是同一个数值。当前版本所支持的最新修订版本为 DBMS_TCP_PROTOCOL_VERSION (参见 src/Core/ProtocolDefines.h) 。
修订版本控制哪些特性
每个特性都受一个DBMS_MIN_REVISION_WITH_* 阈值控制。写入器仅在其修订版本达到该阈值时才输出该特性,读取器也按完全相同的规则查找该特性,因此两者始终保持同步——只要任何一方的修订版本设置有误,两者就会失去同步。与 Native 格式 相关的控制项如下:
因此,对几乎所有内容而言,修订版本
0 都是最保守的编码方式:流中没有 BlockInfo,没有 has_custom_serialization 字节,Dynamic/JSON 使用 V1,没有聚合函数版本,DateTime 以裸类型出现且去掉了时区参数。聚合函数状态版本是修订版本 0 下的例外:此时没有可据以推导版本的对端——流由其生成方自行写入并读回 (例如 StripeLog 数据文件、Set/Join 备份、Native 格式文件) ——因此写入器会保留类型上固定的版本 (并照常在类型字符串中写明) ,而不会将状态降级到版本 0;只有未固定版本的类型才会以版本 0 写入。
LowCardinality 是唯一的例外,而且非常重要。写入器的检查条件是 remove_low_cardinality || (client_revision && client_revision < DBMS_MIN_REVISION_WITH_LOW_CARDINALITY_TYPE)。关键在于开头的 client_revision &&:当修订版本恰好为 0 时,整个条件会短路求值为 false。
因此,在修订版本 0 (即 FORMAT Native 的默认值) 下,LowCardinality(T) 不会被剥离。其类型字符串和每个块的状态前缀都会保留在流中,修订版本 0 的读取器可直接将其读回。只有当修订版本非零且低于 54405,或者无论修订版本如何都强制剥离时,才会执行剥离。
强制剥离由 remove_low_cardinality 标志控制。FORMAT Native 输出从不设置该标志,而原生 TCP 路径会在 low_cardinality_allow_in_native_format = 0 (默认值为 1) 时设置它。也就是说,该设置会影响原生 TCP 输出,但对 FORMAT Native 不起作用。
实际结论:默认的 FORMAT Native 流完全可能包含 LowCardinality,因此不要认为该特性在修订版本 0 下不存在。
修订版本从何而来:取决于数据的传输方式
同样的 Native 字节可以经由不同途径传输:原生 TCP 协议、HTTP 请求,或磁盘上的文件。每种途径设置修订版本的方式各不相同。需要注意的是:读取端和写入端是分别配置的,因此二者最终可能使用不同的修订版本。原生 TCP 协议:协商确定,双向生效
在原生 TCP 协议中,修订版本通过 Hello 握手确定。客户端发送DBMS_TCP_PROTOCOL_VERSION,服务器回传自己的版本;此后,双方各自按照对方所通告的修订版本进行序列化:服务器根据 client_tcp_protocol_version 构建 NativeReader/NativeWriter,客户端则使用收到的 server_revision。这里并没有显式的 min 运算,但任何一方都不可能发出自身尚未实现的特性,因此每个方向实际上都以两端中较旧的一方为上限。
当两端是同一个较新的构建版本时,两个方向会采用相同的修订版本 (即 DBMS_TCP_PROTOCOL_VERSION,参见 src/Core/ProtocolDefines.h) ,所有门控条件均处于开启状态。这是常见情况,但并不能保证。如果两端版本不一致或涉及第三方实现,两个方向的修订版本可能不同,因此必须按方向分别判断门控条件:只要修订版本非零,BlockInfo 就会存在;而其余字段 (包括 has_custom_serialization) 只有在该方向的有效修订版本达到相应阈值后才会出现。例如,若某一端通告的修订版本低于 54454,则它既不会发送、也不会接收 has_custom_serialization 字节。
FORMAT Native 输出 —— 默认修订版本为 0,可通过 HTTP 提高
Native 输出格式默认使用修订版本 0。这适用于通过 HTTP 执行的 SELECT ... FORMAT Native、INTO OUTFILE ... FORMAT Native,以及 clickhouse-client 写出的 Native 输出;在这些情况下,输出工厂都会将 FormatSettings::client_protocol_version 直接传给 NativeWriter,由它决定 BlockInfo / has_custom_serialization 帧信息以及 offsets String 布局。因此,如果通过 HTTP 执行 SELECT ... FORMAT Native 时提高了 client_protocol_version (≥ 54492) ,就会写出 offsets 布局;而默认修订版本 0 则保留可移植的逐值布局。
不过在 HTTP 上,默认值并不是最终结果。客户端可以通过 ?client_protocol_version=<n> 查询参数提高该值,HTTP handler 会将其视为保留参数而非 SQL 设置:该参数会写入查询上下文,再由格式层复制到 FormatSettings 中。只要该值足够高,HTTP FORMAT Native 输出就会开始包含 BlockInfo 前缀和 has_custom_serialization 字节,与 TCP 路径完全相同——因此不要假定 HTTP FORMAT Native 载荷一定是修订版本 0。
由于该参数作用于整个查询上下文,它会影响为该请求构建的所有 NativeWriter,而不仅仅是结果流。特别是,如果通过 HTTP 执行服务器端写入 (例如 INSERT INTO FUNCTION file('x.native', 'Native', ...) SELECT ...) 时提高了 ?client_protocol_version=,文件就会以该修订版本写出。这一行为由来已久 (早于 String offsets 序列化的引入,同样适用于 BlockInfo 和 has_custom_serialization) ,而且是不对称的:读取端 (见下文) 不会以同样的方式提高修订版本,因此这样写出的文件无法通过 file(...) 读回。如果请求写入的数据之后还需要再次读取,请不要在该请求中设置 client_protocol_version。INTO OUTFILE 和本地 clickhouse-client 输出没有此类开关,始终保持为 0。
FORMAT Native 输入 — 始终为修订版本 0
Native 输入格式始终以修订版本 0 构建其 NativeReader。无论是解析 INSERT ... FORMAT Native 的请求正文、读取 Native 文件,还是推断 schema,它都不会预期存在 BlockInfo 前缀,也不会读取 has_custom_serialization 字节,并且始终采用默认序列化。?client_protocol_version=<n> 不会提高输入端的修订版本 (只有输出端会读取该参数) 。
由于输入修订版本始终为 0,输入格式始终按逐值 String 布局读取;以 offsets 布局写入的 stream (无论是通过原生 TCP 协议写入,还是通过提高了 client_protocol_version 的 SELECT ... FORMAT Native 写入) 都无法通过 FORMAT Native 输入读回。这与 BlockInfo 帧信息的不对称情况相同。
往返读写的影响
对于FORMAT Native,两端的默认修订版本均为 0。由 SELECT ... FORMAT Native 以修订版本 0 写出的数据,可以直接通过 INSERT ... FORMAT Native 读回,不会出现任何意外。
如果以提高后的输出修订版本 (在 SELECT 上指定 ?client_protocol_version=<n>) 生成数据流,该数据流会携带 BlockInfo 和 has_custom_serialization 帧信息,并采用 offsets String 布局;而输入格式始终处于修订版本 0,这些内容都无法读回。因此,只有当消费者使用原生 TCP 协议时,提高 client_protocol_version 才有意义;通过 HTTP 进行 FORMAT Native 往返读写时则不应这样做。
文件属于非对称情况。在服务器端的 INSERT INTO FUNCTION file(...) (或 s3、url) 上提高 ?client_protocol_version=,会以该修订版本写入文件,但 file(...) 读取时始终以修订版本 0 解析——因此这样的文件无法往返读写。解决办法有两种:一是在写入请求中不指定 client_protocol_version,使文件保持为普通的修订版本 0;二是改用原生 TCP 协议传输数据,此时每个方向都使用握手协商得到的修订版本。
数据类型
本节介绍 Native 格式可在列的data 中承载的各类型的传输编码,并按解码器复杂度由低到高将其分为四个家族。其中 AggregateFunction(func, ...) 和 QBit(T, N[, stride]) 这两种类型虽然是有效的 Native 列类型,但其载荷取决于具体的函数或类型,不在本文讨论范围内;下文会在它们容易被误认为别名的地方专门加以说明。
定长类型
每个值占用固定数量的字节。包含M 行的列在线上传输时恰好占用 bytes_per_row × M 字节,各值依次紧密拼接,中间没有分隔符,也没有填充。
整数类型
UInt8–UInt256 和 Int8–Int256 直接以二进制形式编码整数值。解码器读取 bytes_per_row × num_rows 个字节,并按照对应类型进行解析。
例如,一个存储 [1, 256, 65536] 的 UInt32 列:
[-1, 42] 的 Int32 列:
Float32 和 Float64
标准 IEEE 754 二进制浮点数:4 字节单精度 (binary32) 和 8 字节双精度 (binary64) ,均采用小端序。NaN、±Infinity、±0.0 以及非规格化数在写入后再读回时都能原样保留,不会被规范化。
Float32 值 1.5 (0x3FC00000) :
Float64 值 1.5 (0x3FF8000000000000) :
BFloat16
brain-float 浮点格式:即 IEEE 754Float32 的高 16 位,包含 1 个符号位、8 个指数位和 7 个尾数位。每个值占 2 字节,采用小端序,存储原始的 16 位位模式。要还原数值,需将其扩展回 Float32:把该位模式放入高半部分,并将低半部分清零 (即将 bits << 16 重新解释为 Float32) ;扩展后的值与 Float32 采用相同的文本格式化方式。
BFloat16 值 1.5 (位模式为 0x3FC0,即 Float32 0x3FC00000 的高半部分) :
Bool
与UInt8 在线路格式上兼容:每行 1 字节,0x00 = false,0x01 = true。线上传输的类型字符串就是 Bool 本身 (而非 UInt8) ,因此根据类型字符串进行分派的解码器必须单独识别该类型。
一个 Bool 列 [true, false, true]:
Date 和 Date32
两者都将日期编码为相对于 Unix 纪元1970-01-01 的整数天数,且均不包含时间部分。
Date 值 1970-01-02 (1 天) :
Date32 值 1900-01-01 (-25567 天) :
DateTime
与UInt32 在线路格式上兼容:以秒为单位的 Unix 时间戳,采用 4 字节小端序存储。该类型可能写作 DateTime 或 DateTime('Timezone');时区仅影响显示,并不包含在线路值中。对于同一时刻,两个时区参数不同的 DateTime 列会生成完全相同的字节。解码器会去掉 (...) 参数后缀,并将该列按 UInt32 处理。
DateTime('UTC') 值 2024-03-15 14:30:00 UTC (时间戳 1710513000) :
DateTime64(scale[, timezone])
8 字节,小端序 Int64,表示自 Unix 纪元起经过的 tick 数,每个 tick 为10^-scale 秒。scale 参数 (0–9) 包含在类型字符串中,用于确定时间单位:
该类型的形式为
DateTime64(s) (隐式使用服务器默认时区) 或 DateTime64(s, 'TimezoneName') (显式指定时区,仅影响显示) 。负值表示纪元之前的 tick 数。
DateTime64(3, 'UTC') 类型的值 2024-01-15 12:30:45.123 UTC (1705321845123 ms) :
DateTime64(0) 值 2024-01-15 12:30:45 UTC (1705321845 秒) :
Time 和 Time64(scale)
表示时钟时长,而非某个时间点。Time 是有符号的秒数,以 4 字节小端序 Int32 编码;Time64(scale) 是给定十进制标度 (0–9) 下的有符号 tick 数,以 8 字节小端序 Int64 编码,与 DateTime64 的 wire 形态相同。
其文本形式为 [-]HH:MM:SS[.fraction],但与 DateTime 不同,小时字段不会按一天 24 小时回绕:它表示总小时数,可以超过 23。显示的数值上限为 999:59:59 (3599999 秒) ;超出上限的值在渲染时,秒部分取上限值,而存储的小数部分保持原样,因此 tick 数 3700000.25 会渲染为 999:59:59.250000。CAST 会将存储值饱和截断为目标标度下可表示的最大 tick (对于 Time64(6) 为 999:59:59.999999) ,而非截断到整秒;但算术运算仍可能在列中留下超出范围的 tick 数,这类值仅在显示时才被截断到上限。上述行为均不影响 wire 字节,wire 字节始终是普通的有符号整数。
Time 值 45296 (12:34:56) :
Time64(3) 值 45296789 个 tick (12:34:56.789) :
Time 和 Time64 为实验性类型,需要在服务器上启用 allow_experimental_time_time64_type = 1。Interval
Interval<Unit> — IntervalSecond、IntervalMinute、IntervalHour、IntervalDay、IntervalWeek、IntervalMonth、IntervalQuarter、IntervalYear、IntervalNanosecond 等。所有单位共用同一种传输编码:计数值以有符号 8 字节小端序 Int64 表示。单位信息仅存在于类型字符串中——它既不影响 wire 字节,也不影响文本形式 (即一个裸整数) 。所有单位都由同一条解码器路径处理。
IntervalDay 值 5:
UUID
每个值占 16 字节。其传输编码并非规范形式的 16 个大端序字节,而是将前后两个 8 字节分别独立进行字节反转。 从逻辑上看,UUID 是一个 128 位标识符,其规范文本形式为xxxxxxxx-xxxx-xxxx-xxxx-xxxxxxxxxxxx,按惯例其字节以大端序书写。而在传输层面,则是将这 16 个规范字节拆分为前后两个 8 字节,并分别以小端序写入:
- wire 字节 0..7 = 规范字节 0..7 反转后的结果。
- wire 字节 8..15 = 规范字节 8..15 反转后的结果。
550e8400-e29b-41d4-a716-446655440000:
IPv4 和 IPv6
这是两种相互关联但编码方式不同的地址类型。IPv4 占 4 个字节,以小端序 UInt32 编码,存储规范的 32 位地址 (即由 a.b.c.d 计算得出的值 (a << 24) | (b << 16) | (c << 8) | d) 。其 wire 字节即网络字节序字节的逆序。
192.168.1.10 (规范的 32 位值为 0xC0A8010A) :
IPv6 占 16 字节,按网络字节序原样写入,不做字节交换——与 inet_pton(AF_INET6, ...) 的字节序一致。
2001:db8::1:
u32 形式存储,便于算术运算和紧凑的范围查询;而 IPv6 则沿用了大多数网络 API 通用的网络字节序布局。
Enum8 和 Enum16
分别与Int8 和 Int16 在线路格式上兼容:每行占 1 或 2 个字节,其中 16 位版本采用小端序二进制补码表示。完整的枚举值映射记录在类型字符串中:
(...) 参数后缀,直接按 Int8 / Int16 分派——wire 字节只是整数索引。若客户端需要展示标签,则需从类型字符串中解析出 'name' = value 映射,并将其与该列一并保存:仅凭整数无法还原标签。面向文本的输出会渲染标签 (active) 而非索引;若枚举嵌套在复合类型中,标签还会加上单引号 ('active') 。由于无法从整数列还原该映射,对于 Array(Enum8(...)) 或 Map(Enum16(...), V) 等嵌套枚举,必须保留该映射。
一个 Enum8('active' = 1, 'inactive' = 2) 列 [active, inactive, active]:
Enum16(...) 类型的值 30000:
Decimal(P, S)
按 10 的幂缩放的有符号整数。整数的字节宽度由精度P 隐式决定;标度 S 即负指数 (小数点后的位数) 。两者均包含在类型字符串中。
传输编码为底层整数的小端序二进制补码表示,对应的逻辑十进制值为
wire_integer × 10^(-S)。
无论类型以何种方式声明,ClickHouse 始终输出 Decimal(P, S)。Decimal32(S)、Decimal64(S) 等在线上传输时均会规范化为 Decimal(P, S) (其中 P 取该宽度的自然最大值:9、18、38、76) 。因此,解码器只需识别 Decimal(P, S),即可覆盖服务器输出的所有写法。
Decimal(9, 4) 类型的值 123.4567 → 底层整数 1234567:
Decimal(18, 1) 类型的值 -1.5 → 底层整数 -15:
Decimal(38, 4) 类型的值 123.4567 (共 16 字节) :
Nothing
Nothing 类型不携带任何值。实际上,它只会作为 Nullable(Nothing) 的内部类型出现——对于 SELECT NULL 这类表达式,服务器返回的就是该类型,其唯一有效的值就是“值的缺失”。从概念上讲,它是一种单元类型 (unit type) 。
在线上传输中,它每行恰好占用一个占位字节。服务器写出的是 ASCII 字符 '0' (0x30) ,但反序列化器会忽略这些字节——其内容是未定义的,解码器不得依赖任何特定值。写入的字节数为 num_rows × 1,因此列标题中的 num_rows 即可完全确定需要读取的字节数。
每行一个字节的设计维持了 Block 的不变式:每一列所占的长度都可以由 num_rows 推导得出,因此解码器无需逐单元的长度前缀即可顺序向前扫描。外层的 Nullable 始终将每个位置标记为 NULL,因此这些占位字节永远不会被读取检查。
一个包含 3 行 (全部为 NULL) 的 Nullable(Nothing) 列:
Nullable 帧信息 (参见 Nullable) ;其后的三个字节是 Nothing 载荷,解码器会直接跳过。
变长类型
在线上传输时,每个值都会携带自身的长度。String
类型字符串:String。String 列有两种传输布局,具体使用哪种由协议修订版本决定 (参见 修订版本控制的内容) 。在原生 TCP 协议上,修订版本即协商得出的修订版本;对于 FORMAT Native 输出,修订版本为 client_protocol_version (默认值为 0) ;FORMAT Native 输入的修订版本始终为 0,而 Buffers 格式始终使用逐值布局。
逐值布局 — 修订版本低于 DBMS_MIN_REVISION_WITH_STRING_WITH_SIZE_STREAM_SERIALIZATION (54492) 时使用,FORMAT Native 默认的修订版本 0 也属于这种情况:数据由 num_rows 个带长度前缀的字节序列依次组成:
0x00 字节。该列占用的总字节数为对所有行计算 Σ (varuint_size(len_i) + len_i)。
由 3 个字符串 ["ab", "", "c"] 组成的列 (共 6 字节) :
54492 及以上:由两个流拼接而成,先是累计字节偏移量,然后是全部数据:
Array 通过原生协议发送其偏移量相同。偏移量 i 是值 i 在数据 blob 中的结束位置,因此值 i 的大小为 offset[i] - offset[i-1] (其中 offset[-1] = 0) ,最后一个偏移量即为数据 blob 的总大小。解码器先读取 8 × num_rows 字节的偏移量,再以最后一个偏移量作为确切长度,一次性读取整个数据 blob。这样既能精确预分配缓冲区、以批量复制代替逐行解析,也无需将大小转换为偏移量。num_rows = 0 的列在两个流中均不产生任何字节。
同样的 3 个字符串 ["ab", "", "c"] (共 27 字节) :
String,包括嵌套在复合类型 (Array(String)、Nullable(String)、Map、Tuple、Variant、Dynamic、JSON) 中的 String。但有一个例外:LowCardinality 列的字典始终采用默认的嵌套序列化方式写入,因此无论哪个修订版本,其中的 String 值都保持逐值布局。这一例外适用于 LowCardinality(String)、LowCardinality(Nullable(String)) 以及其他任何包含 String 的 LowCardinality 字典。
在这两种布局下,ClickHouse 的 String 都是面向字节而非面向文本的:不强制校验 UTF-8 有效性,值可以包含任意字节,包括内嵌的 NUL。若解码器的目标类型是 UTF-8 字符串类型,则要么在读取时进行校验,要么将原始字节直接交给调用方处理。
FixedString(N)
类型字符串:FixedString(N),其中 N 为正整数 (例如 FixedString(16)) 。该列恰好由 N × num_rows 个原始字节组成,既没有长度前缀,也没有分隔符。解码器从类型字符串中解析出 N,然后每行读取 N 个字节。
当 SQL 插入的值短于 N 字节时 (例如 CAST('abc' AS FixedString(5))) ,服务器会在右侧用 NUL 字节 (0x00) 补齐至声明的长度。这些填充字节属于所存储值的一部分,会按原样进行线上传输;是否去除填充字节由客户端自行处理。与 String 一样,FixedString(N) 更接近字节数组而非文本,通常用于定长标识符、地址字节或哈希摘要。
两个 FixedString(3) 值 ["abc", "de\0"] (共 6 字节) :
复合类型
复合类型封装一个或多个内部类型,并共享同一种传输模型:每列多个流。一个逻辑列会被编码为两个或更多可独立读取的字节序列,再依次拼接。 它们具有三个共同的结构特性:- 每个 schema 对应固定的形态。 其结构在解码时完全由类型字符串决定。
Array(UInt32)在每个块中的流布局始终相同。 - 自身没有版本前缀。 复合封装层本身不添加版本字节;其帧信息 (偏移量、空值映射、元素流) 在各 ClickHouse 发行版之间保持稳定。这一点仅适用于封装层本身——内部版本化类型的情况,请参阅下文关于前缀阶段的说明。
- 自身没有跨块状态。 封装层的帧信息在每个块内完全自描述;任何跨块状态问题都源自内部的版本化类型,而非封装层。
SerializationArray 会先运行内部类型的前缀阶段,再写入 array 偏移量;Tuple、Map、Nested 和 Nullable 也通过各自的元素序列化执行同样的操作 (Nullable 会在写入空值映射之前运行内部前缀) 。
因此,当复合类型封装的是版本化/有状态类型 (LowCardinality、Variant、Dynamic、JSON) 时,该内部类型的版本/状态前缀会最先输出,排在封装层的偏移量和元素载荷之前。例如,Array(LowCardinality(String)) 的布局为 [LowCardinality state prefix] → [array offsets] → [flattened LowCardinality element payload],而不是先输出偏移量。
如果解码器在运行内部前缀阶段之前就读取偏移量,那么在处理任何包含 LowCardinality、Variant、Dynamic 或 JSON 的复合类型时都会失步。如果所有内部类型都是普通叶类型或其他非版本化复合类型,前缀阶段不会输出任何字节,下文中先读偏移量的描述可原样适用。
Nullable(T)
类型字符串:Nullable(InnerType)。示例:Nullable(UInt32)、Nullable(String)、Nullable(FixedString(16))、Nullable(DateTime('UTC'))。
与其他复合类型一样,Nullable 在写入空值映射之前,会先将前缀阶段交由其内部类型的序列化处理:若内部类型为版本化类型,则会先输出内部类型的状态前缀。因此,Nullable(Tuple(LowCardinality(String))) 以 LowCardinality 的状态前缀开头,而非空值映射。若内部类型为叶子类型或其他非版本化类型,则前缀阶段不输出任何字节。
传输布局依次为内部前缀阶段 (仅当内部类型为版本化类型时非空) 和两个首尾相接的流,其中空值映射在前:
num_rows 字节,每行一个字节:
值流以内部类型的标准编码存储全部
num_rows 行的数据,NULL 位置也包含在内。解码器仍需读取 NULL 位置上的占位字节,以推进流的读取位置,但在解析任何单个值之前,必须先查阅空值映射。发送方可以在 NULL 位置写入任意字节,因此解码器不得依赖特定的占位值。
各内部类型家族对应的占位值:
Nullable(T) 可以出现在 Array、Tuple、Map 和 Nested 内部,其中 Array(Nullable(T)) 和 Tuple(Nullable(T1), T2) 较为常见。Nullable 不能自身嵌套:服务器会拒绝 Nullable(Nullable(T))。
以包含三行数据 [5, NULL, 9] 的 Nullable(UInt8) 为例 (共 6 字节) :
["hello", NULL, "world"] 的 Nullable(String) 列 (共 15 字节) :
Array(T)
类型字符串:Array(InnerType)。示例:Array(UInt32)、Array(String)、Array(Nullable(UInt32))、Array(Array(UInt8))。
其传输布局依次为内部类型的前缀阶段 (仅当内部类型为版本化类型时才非空) ,以及两个拼接在一起的流,其中偏移量流在前:
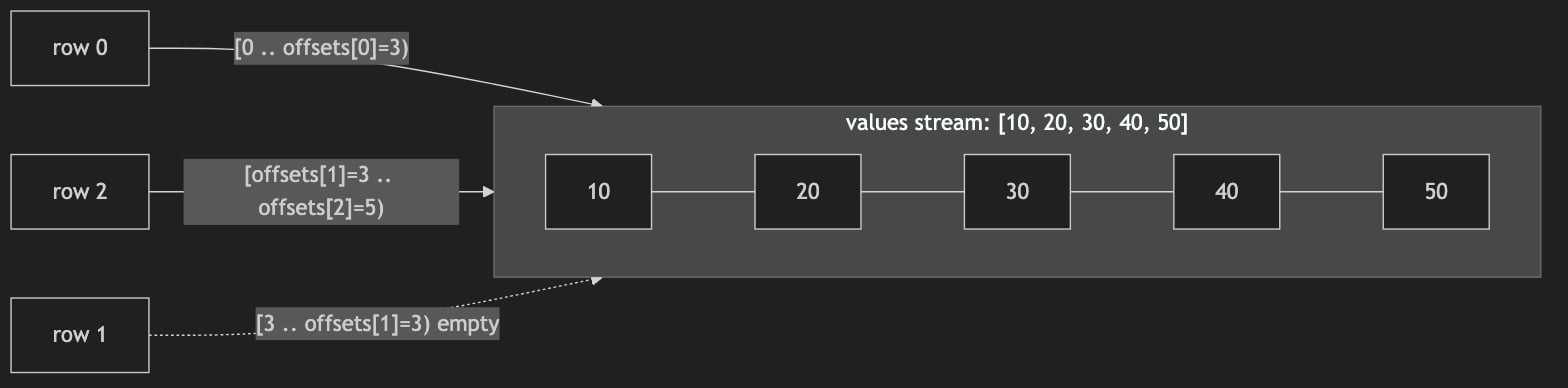
num_rows 个小端序 UInt64 值组成,每个值表示写入该行元素后在 values stream 中的累计结束位置:
- 第
N行的元素起始索引 =offsets[N - 1](当N == 0时为0) 。 - 第
N行的元素结束索引 (不含) =offsets[N]。 - 第
N行的元素数量 =offsets[N] - offsets[N - 1]。
offsets[num_rows - 1] 即为所有行的元素总数,values stream 中包含同样数量的内部值,依次首尾相接。
偏移量 是单调非递减的;相邻两个 偏移量 相等表示该行为空,解码器应将非单调的 偏移量 视为数据损坏并予以拒绝。空列 (num_rows == 0) 不写入任何字节——既没有 偏移量 stream,也没有 values stream。内部类型可以是任意类型,包括其他复合类型:Array(Array(T))、Array(Tuple(...)) 和 Array(Nullable(T)) 均合法。
以行数据为 [[10, 20, 30], [], [40, 50]] 的 Array(UInt32) 为例 (共 44 字节) :
0) 。若相邻两个偏移量相等,则表示该行为空:
[["a", "bb"], []] 的 Array(String) (共 20 字节) :
Array(Array(UInt32)),若其各行为 [[[1,2]], [], [[3], [4,5]]],则会按相同的形态逐层嵌套:
- 外层偏移量:
[1, 1, 3]—— 第 0 行包含 1 个内层数组,第 1 行包含 0 个,第 2 行包含 2 个。 - 中间层的
Array(UInt32)解码 3 行,偏移量为[2, 3, 5]。 - 最内层的
UInt32解码 5 个值:[1, 2, 3, 4, 5]。
Tuple(T1, T2, …)
类型字符串:Tuple(T1, T2, ..., Tn)。示例:Tuple(UInt32, String)、Tuple(Int32)、Tuple(Array(UInt32), String)、Tuple(UInt8, Tuple(Int32, String))。ClickHouse 还支持通过 Tuple(a UInt32, b String) 定义命名元组;名称仅作为元数据,不影响传输格式。
其传输布局依次为:各元素的前缀阶段 (每个版本化元素按声明顺序写入各自的状态前缀;非版本化元素则无前缀) ,随后是按声明顺序拼接的 N 个流,每个元素类型对应一个流:
num_rows 个值。没有长度前缀,没有 偏移量 流,流与流之间也没有分隔符。空列 (num_rows == 0) 在每个流中写入零字节。元素类型可以是任意类型,包括其他复合类型——Tuple(Tuple(...), ...)、Tuple(Array(...), ...) 和 Tuple(Nullable(T1), T2) 都是合法的。
零元素的 Tuple Tuple() 同样合法——它由 SELECT tuple() 或 CAST(x AS Tuple()) 等表达式产生。由于不存在元素流,它转而采用与 Nothing 相同的序列化方式:每行写入一个占位字节 (0x30,即 ASCII '0') ,反序列化器会将其丢弃。行数取自块的头部,与 Nothing 的处理方式完全相同。
包含 3 行 (1,4), (2,5), (3,6) 的 Tuple(UInt8, UInt8):
[1, 2, 3],元素 1 对应 [4, 5, 6]。
包含 (10, "a") 和 (20, "bb") 这 2 行的 Tuple(UInt32, String) (共 13 字节) :
Map(K, V)
类型字符串:Map(KeyType, ValueType)。示例:Map(String, UInt32)、Map(String, Array(UInt32))、Map(UInt8, Tuple(Int32, String))、Map(Array(String), Int8)。传输格式对这两种类型均无限制——K 和 V 都可以是任意受支持的类型,包括复合类型。 (ClickHouse 在 SQL 层面允许使用哪些键类型,其规则在不同发行版中有所变化;请查阅目标服务器版本对应的 SQL 文档。)
其传输布局与 Array(Tuple(K, V)) 逐字节相同,因此开头是内部的前缀阶段 (除非 K 或 V 为版本化类型,否则该阶段为空) :
total_pairs = offsets[num_rows - 1] (当 num_rows == 0 时为 0) 。偏移量流的语义与 Array 相同。键与值按位置对齐:第 i 对为 (keys[i], values[i])。
在 ClickHouse 内存中,Map 列表示为由 Tuple 组成的 array;类型系统将其作为一种独立类型对外呈现,以便在 SQL 中使用 (m['key']、mapKeys、mapValues) 。传输格式直接序列化这一存储结构,因此 Map 与 Array(Tuple(K, V)) 在字节层面完全可以互换。
偏移量单调不减,键流和值流均恰好包含 total_pairs 个值。空列写入零字节。单行内的键通常是唯一的,但这只是语义层面的规则,而非由传输格式强制约束:传输格式允许重复键在写出后原样读回,只有当支持 Map 的函数处理该行时,服务器端才会按语义处理重复键。
Map(UInt8, UInt8),包含 2 行 {1:10, 2:20}、{3:30} (共 22 字节) :
i 个键值对时,会同时读取 keys[i] 和 values[i] 来进行重建。
包含 1 行 {'a':1, 'b':2} 的 Map(String, UInt32) (共 20 字节) :
Nested(name1 T1, name2 T2, …)
Nested 的线上传输表示形式取决于服务器端的 flatten_nested 设置,因此分为两种不同的情况。
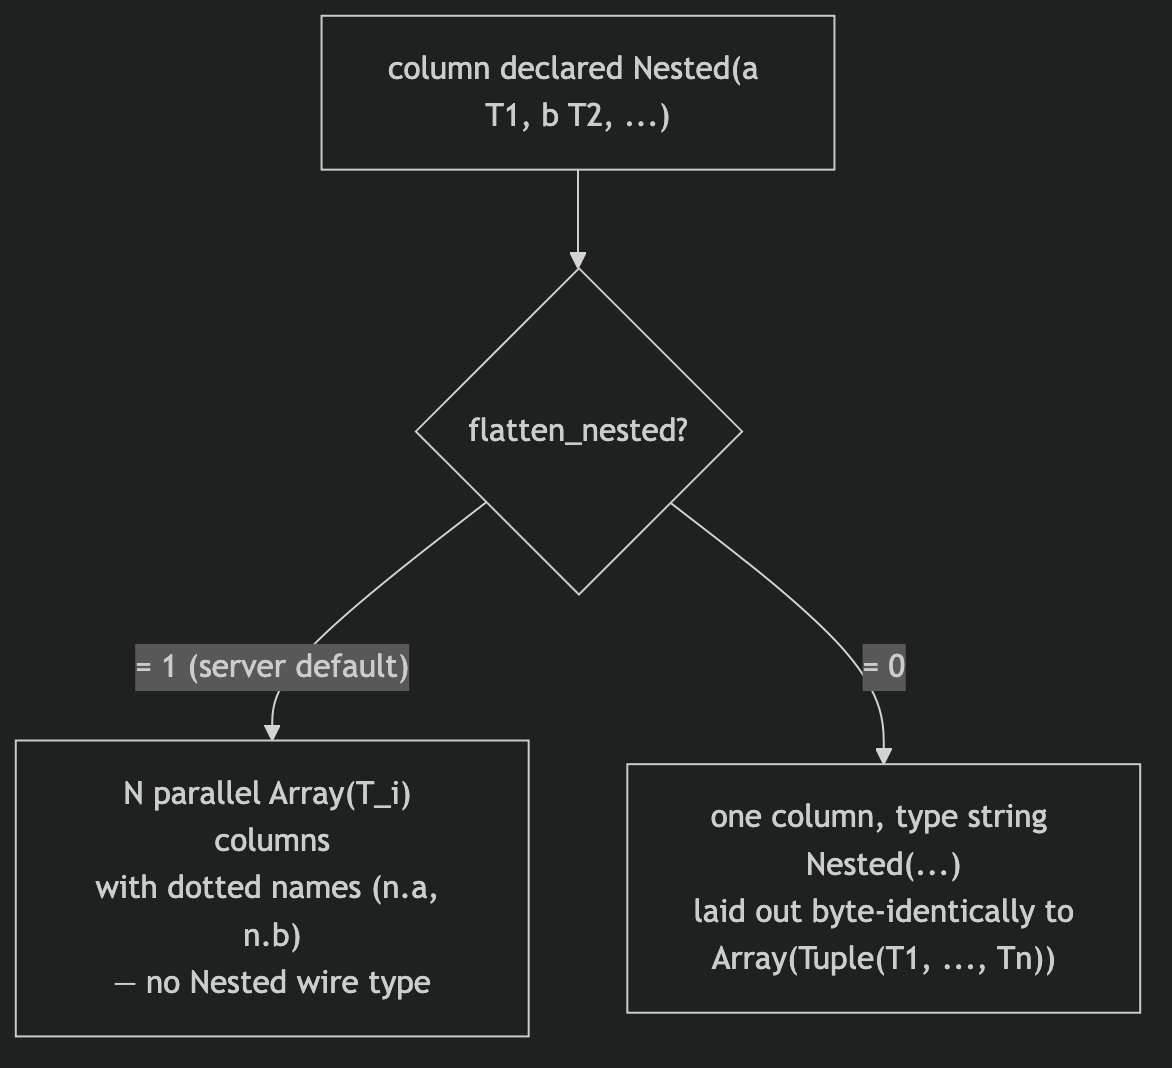
flatten_nested = 1 (服务器默认值) 。 如果表是在默认设置下创建的,Nested 并不是一种 wire type。服务器会将该列存储并呈现为 N 个并行的 Array(T_i) 列,列名以点号分隔 (outer.field1、outer.field2 等) 。对格式层而言,这并没有引入任何新东西——每个带点号的列都只是普通的 Array:
flatten_nested = 0。 如果表在创建时设置了 flatten_nested = 0,则该列在线上传输时表现为单个列,其类型字符串为 Nested(name1 T1, name2 T2, ...),且类型字符串之后的布局与 Array(Tuple(T1, T2, ..., Tn)) 逐字节相同——包括内部的前缀阶段。因此,任何版本化字段 T_i 都会先输出其状态前缀,再输出偏移量。下面的示例使用的是非版本化字段,因此前缀阶段为空:
Nested 会保留字段名 (a、b) ,而 Array(Tuple) 不会以具名槽位的形式保存这些名称。
Case B 的类型字符串是一个以逗号分隔的 (名称, 类型) 对列表。名称与类型之间以第一个空白字符分隔;类型本身还可能包含空白字符、逗号和括号,因此解析时需要使用与 Tuple 相同的、能识别嵌套深度的拆分器。传输布局如下:
total_elements = offsets[num_rows - 1] (当 num_rows == 0 时为 0) 。偏移量单调非递减,且每个字段的数据流恰好包含 total_elements 个值。服务器会在 INSERT 时强制校验:同一行内所有字段的元素数量必须一致。空列不写入任何字节。
以包含 2 行 [(10,'x'),(20,'y')] 和 [(30,'z')] 的 Nested(a UInt8, b String) 为例 (类型字符串之后共 25 字节) :
类型别名
有几种类型是纯粹的别名:服务器在列标题中发送的是别名,但随后的字节属于某个底层类型。解码器只需将该别名映射到对应的底层类型,并复用其编解码器即可,不涉及任何新的传输格式。 地理类型是嵌套数组和元组的别名:
因此,
Point 列的解码方式与 Tuple(Float64, Float64) 完全相同 (渲染为 (1,2)) ,Ring 则按 Array(Tuple(Float64, Float64)) 解码 ([(0,0),(1,1)]) ,更高层级的类型依此类推。
Geometry 同样是别名,但它对应的是 Variant 而非嵌套数组:其载荷是由上述七种地理类型构成的 Variant。列标题中只携带类型字符串 Geometry,不会展开写出该 Variant,因此解码器必须自行展开。与用户显式声明的 Variant 不同,Geometry 的判别值不按名称排序:出于兼容性考虑,这些判别值是固定的,新的地理类型只会追加到末尾。映射关系为 0 = LineString、1 = MultiLineString、2 = MultiPolygon、3 = Point、4 = Polygon、5 = Ring、6 = MultiPoint (26.7 版本新增;旧版本服务器发送的数据流中不会出现判别值 6) 。随后,每个选中的值再按上述对应的地理别名进行解码 (NULL 使用 Variant 的 NULL 判别值 255) 。
SimpleAggregateFunction(func, T) 是其值类型 T 的别名。它存储的是已完成最终计算的聚合值,因此其传输形式和渲染方式与 T 完全相同 (SimpleAggregateFunction(sum, UInt64) 按 UInt64 解码) 。只有带单一值类型的形式才属于这种别名;其底层类型本身可以是复合类型。
有两种相关类型并非别名。它们都是有效的
Native 列类型——例如,客户端可能会从 -State 组合器或分布式聚合中接收到 AggregateFunction 列——但它们各自携带专门的载荷,不在本页讨论范围之内:AggregateFunction(func, ...)保存的是中间聚合状态 (而非最终值) ;其二进制布局取决于具体的聚合函数及其版本。函数名可以带有参数,每个参数均以 SQL 字面量形式输出,例如AggregateFunction(topK(3), UInt64)。某些聚合函数会在参数后输出显式的::Type后缀,例如AggregateFunction(topK('3'::Decimal32(0)), UInt64),这是因为Decimal或宽整数值没有可直接输出的裸字面量形式;是否这样做取决于具体函数,而非格式本身,因此需要检查参数的解码器必须同时接受这两种写法。仅需要参数类型的解码器则不受影响。版本化的聚合函数会将非零状态版本作为类型字符串的第一个参数写出——AggregateFunction(1, quantileDeterministic, UInt64, UInt64)——而版本0不会输出,因此类型字符串仍为AggregateFunction(quantileDeterministic, UInt64, UInt64)。在已协商的连接上 (修订版本大于0) ,写入器仅根据协议修订版本选择版本——绝不会采用其本地类型上恰好固定的版本,因为在传输层面上,版本0与“未通知版本”无法区分——因此同一函数在不同连接上可能通知不同的版本,读取器必须从类型字符串中获取版本,而不能假定其为最新版本。在修订版本0下,不存在需要为其推导版本的 peer——该 stream 是自描述的,并由写入方自行读回——因此类型上固定的版本会保留在 stream 中 (以及所通知的类型字符串中) ,而不会降级为0。quantileDeterministic(包括quantilesDeterministic和medianDeterministic写法) 自修订版本54491起版本化:版本1会在状态末尾追加一个UInt8 skip_degree,其前缀与版本0逐字节相同。低于该修订版本时,写入器输出版本0的状态,因此较旧的 peer 不受影响。uniq自修订版本54493起版本化:版本1会在版本0布局之前添加一个标志字节;当标志的第0位被置位时,还会追加一个由完整 64 位哈希组成的小型附加样本,每个哈希均与常量0x9E3779B97F4A0000进行异或 (依次为UInt8 skip_degree、VarUInt count,然后是 8 字节的值) ,从而在基数超过二十亿时仍能保持估算的准确性;版本0的状态仅携带 32 位主样本。标志的第1位表示 64 位样本不完整——即该状态已合并了一个版本0的状态,而后者的元素从未进入过 64 位样本——此时不会写入 64 位样本,读取器必须仅根据 32 位主样本进行估算 (并在其后续写出的状态中继续标明这一点) ;因此这两个位互斥,读取器必须拒绝同时设置这两个位的状态。其他位均未定义,读取器必须拒绝设置了任何其他位的状态。上述规则同样适用于嵌套在容器类型中的状态——Array、Tuple、Map、Nullable、Variant(其中备选类型写出的版本会改变类型字符串,但不会改变判别值顺序) ,以及Nested/SimpleAggregateFunction包装器。这些规则也适用于聚合函数组合器:作用于版本化函数的透传组合器——uniqIf、uniqArray、uniqForEach、uniqMap、uniqArgMin/uniqArgMax、uniqOrNull/uniqOrDefault、uniqResample,以及隐式的Nullable参数适配器——会将版本传递给其载荷中包含的嵌套状态,在新生成状态的类型字符串中以与普通函数完全相同的方式写出嵌套函数的当前版本 (AggregateFunction(1, uniqIf, UInt64, UInt8)) ,并在已协商的连接上以同样方式根据协议修订版本推导版本。包装器的自定义名称中还包含一份其参数类型的副本,因此写入器必须使用相同的已协商聚合状态版本重建该副本;否则其头部可能会为版本0的载荷通知版本1。Variant有一种边界情况根本无法在传输层面表示:当两个备选类型仅在写出的状态版本上不同时 (这作为列类型是合法的,因为类型字符串不同) ,按已协商修订版本对两者重新设定版本会使它们合并为同一个备选类型,因此发送方必须令传输失败,而不能通知与载荷实际写入版本不符的版本。Dynamic是按修订版本推导版本这一规则的有意例外:Dynamic列会自行通知其嵌套类型——通过其自身的类型列表以及二进制类型编码,后者的显式版本字段携带写出的状态版本 (其共享 variant 中的值即使在静态存储时也以这种方式嵌入其类型) ——这些通知属于该列自身的数据,对任何 peer 和任何介质都完全相同,因此绝不会针对已协商修订版本进行重写。因此,嵌套在Dynamic值中的状态会以其类型中写出的版本写入 (新生成的状态会携带该版本,因为-State查询结果会写出其版本) ;若类型中未写出版本,则以版本0写入,在所有连接和介质上均是如此。QBit(T, N[, stride])以位平面转置的方式存储向量,适用于向量搜索工作负载;其传输层 stream 布局 (按组优先排列的FixedString位平面 stream,显式指定stride时共有element_size * (N / stride)个) 及其二进制类型编码 (标签0x36,当stride != N时为0x37QBitWithStride) 已在QBit数据类型页面和二进制类型编码参考文档中说明,因此Native读取器无需再从 C++ 源代码中推断这些细节。
版本化类型
版本化类型在线上传输时会带有一个序列化版本前缀,用于声明后续数据采用哪一种编码变体。它们也可能使用多个流 (与复合类型类似) 。在Native 线上传输格式中,前缀和字典 (如有) 均以块为单位——这些类型不维护跨块状态 (参见下文的按块前缀说明) ;跨块序列化状态仅存在于 MergeTree 的磁盘存储流中。
这些类型比固定形态的复合类型复杂得多,仅面向简单分析查询的客户端可以暂缓对其提供支持。
序列化版本:概念
序列化版本是一个按类型、按列设置的线上传输版本号,用于声明发送方采用的是该类型编码的哪种变体。它位于列状态前缀的最开头,因此解码器会先读取它,再据此将该列的其余部分交给相应的解析器处理。 它与协议版本不同:
大多数版本化类型会在其他所有状态前缀数据之前,以小端序 UInt64 写入版本号;少数类型使用 VarUInt 或 UInt8。解码器应首先读取版本号,并拒绝未知值 — 更高的版本意味着发送方使用了解码器无法理解的较新格式,一旦解析出错,后续的每一个字节都会被破坏。
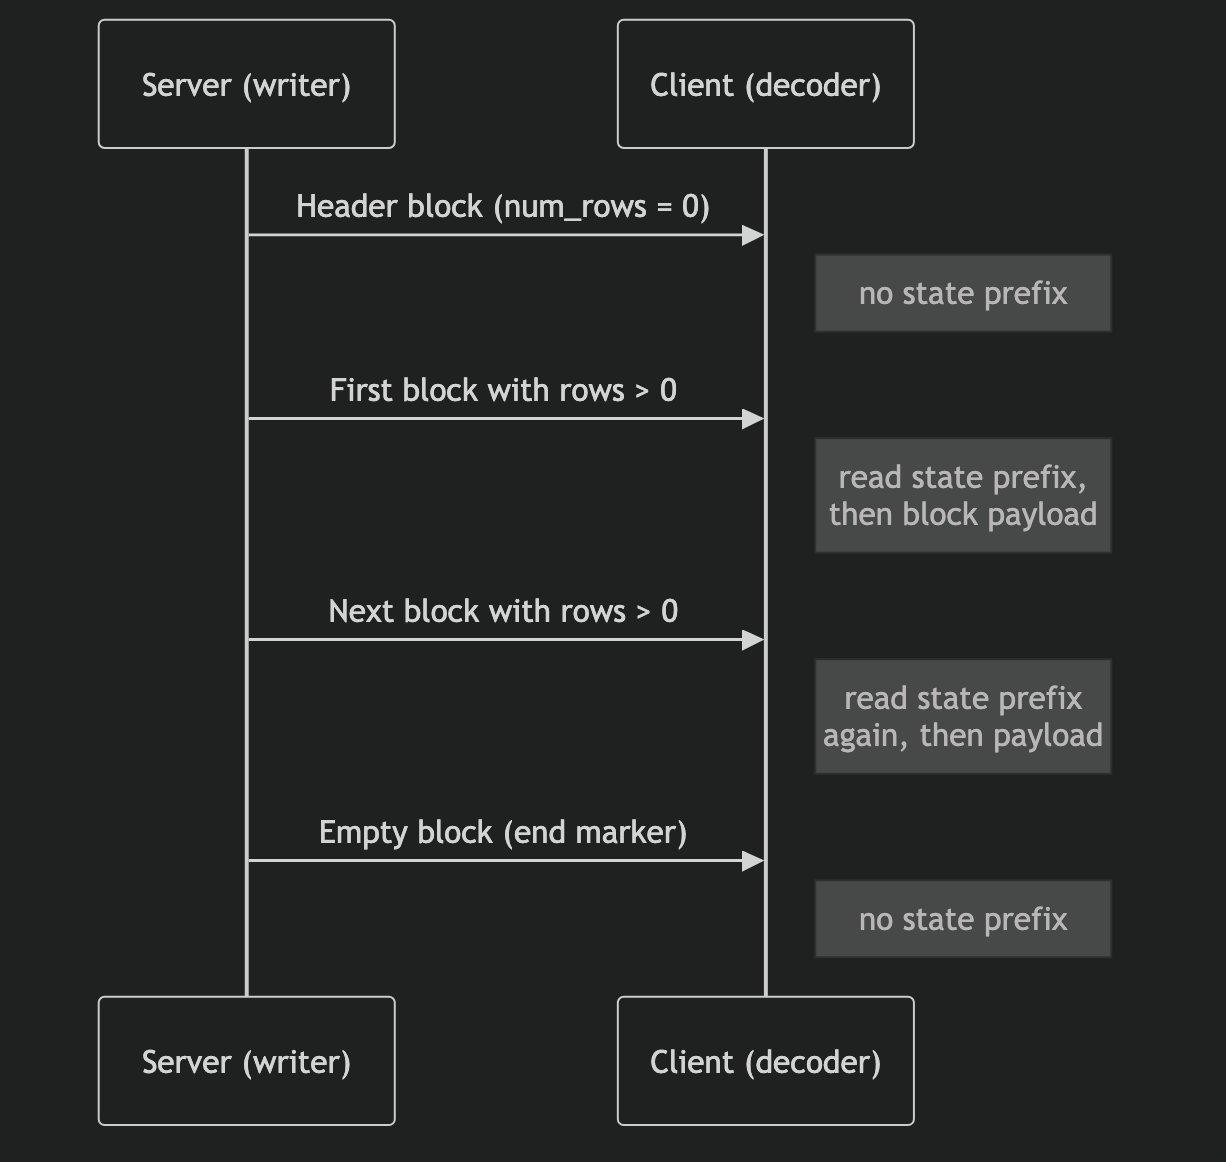
状态前缀会在每个行数大于零的块的开头输出,紧接在该块的载荷之前。
Native 写入器和读取器不会跨块保留序列化状态:
NativeWriter 每写入一个非空列块,都会创建新的序列化状态并写入状态前缀;NativeReader 每读取一个非空块,也会创建新的反序列化状态并读取该前缀 (当 rows == 0 时,两者都会完全跳过前缀) 。
因此,头部块 (行数 = 0) 和空块不会输出任何内容,解码器则必须在每个非空块的开头重新读取状态前缀。如果解码器只读取一次前缀,并将后续块视为仅包含载荷,就会把下一个块的前缀误当作数据读取,从而导致失步:
序列化版本参考
关于上表,有几点值得注意:
- 这些值并不连续。
Dynamic使用1、2、3、4,其中V3对应4,FLATTENED对应3。数值越大并不一定代表版本越新。 - 部分值仅用于 Native 格式。
Object::STRING、Object::FLATTENED和Dynamic::FLATTENED的存在,是为了在原生协议层面兼容那些未完整实现 Object/Dynamic 的客户端。它们不会出现在 MergeTree 的磁盘存储中。 V3仅用于磁盘存储。 之所以列出Object::V3和Dynamic::V3,是因为这些值已被分配、不得复用,而非解码器可能遇到它们:ClickHouse 从不通过Native发送它们,若在该格式中出现,会以INCORRECT_DATA拒绝。它们所承载的全部内容 ——Object::V3的 shared-data 子版本及其分桶和粒度布局 —— 描述的都是 part 而非数据块,因此不在本页讨论范围内。使用原生 TCP 协议的客户端只会遇到V1、V2、STRING或FLATTENED。
LowCardinality(T)
最简单的版本化类型。它将包含N 个内部值的列替换为一个由去重值构成的小型字典,以及 N 个指向该字典的索引。
类型字符串:LowCardinality(InnerType)。示例:LowCardinality(String)、LowCardinality(FixedString(4))、LowCardinality(Nullable(String))。
sharedDictionariesWithAdditionalKeys;其他值均为保留值。
每个块的元数据 UInt64 是一个位字段:
对于每列仅含单个数据块的典型查询响应,元数据为
0x600 (HasAdditionalKeys + NeedUpdateDictionary) 。
dict 值为 dict_size 个以内部类型 T 编码的值。字典会在开头为特殊值预留槽位:非 Nullable 列预留一个 (dict[0] 存放内部类型的默认值,例如 String 的 "") ,实际的不同值从 dict[1] 开始。
对于 LowCardinality(Nullable(T)),dict 仍按普通 T 编码 (没有空值映射流) ,但会预留两个槽位:dict[0] 为 NULL 标记,dict[1] 为内部类型的默认值 (例如 String 的 "") ;实际的不同值从 dict[2] 开始。NULL 行的键指向 dict[0],该槽位在线上传输时写为内部类型默认值的字节。
键是指向 dict 的索引;每个索引占 1 << key_type_code 字节 (1、2、4 或 8) ,第 N 个值通过 dict[keys[N]] 重建。
keys_count 是当前递归层级上 LowCardinality 值的数量,不一定等于块的行数。对于顶层 LowCardinality 列,两者相同。但当 LowCardinality 嵌套在复合类型中时,该计数是复合类型向下传递的展平后值数量:例如对于共三行、总计五个元素的 Array(LowCardinality(String)),keys_count 为 5 而非 3;对于 Map(K, LowCardinality(V)),则为键值对总数,以此类推。解码器必须从该字段读取 keys_count,而不能假定其等于块的行数。当展平后的计数为零时 (例如某个块中的数组全部为空) ,LowCardinality 数据阶段不写入任何内容:仅存在状态前缀 (在复合类型前缀阶段中输出) ,其后不跟元数据、字典或 keys_count。
每个行数大于零的块在开头都会读取状态前缀——请求头块 (rows = 0) 和空块不输出任何内容。在块内,keys_count 等于行数,dict_size 等于 dict stream 中值的数量,每个键占用 1 << key_type_code 字节。
在
Native 格式中,每个块都携带一个自包含的块本地字典——不存在跨块的字典状态。写入器将 low_cardinality_max_dictionary_size 设为 0,因此 SerializationLowCardinality 从不构建共享字典:每个非空块都将其键作为块本地的附加键写入,且不设置 NeedGlobalDictionaryBit (元数据 0x600) ;当 native_format 为 true 时,读取器会拒绝 NeedGlobalDictionaryBit。因此,解码器必须在每个块开始时重置字典,并读取该块中的 dict_size 个条目;若沿用前一个块的字典,就会错误解析下一个块的键。 (跨块持久化 LC 字典属于 MergeTree 磁盘存储层面的问题,与 Native 传输布局无关。)['a', 'b', 'a', 'c', 'b'] 的 LowCardinality(String):
dict[1], dict[2], dict[1], dict[3], dict[2] = ["a", "b", "a", "c", "b"]。
以值为 ['a', NULL, '', 'b'] 的 LowCardinality(Nullable(String)) 为例,可以看到两个预留槽位:dict[0] 用于 NULL,dict[1] 用于空字符串默认值:
dict[2] = "a",dict[0] = NULL,dict[1] = "",dict[3] = "b",即 ["a", NULL, "", "b"]。dict[0] 和 dict[1] 在线上传输时都是空字节;值是否为 NULL 取决于键是否指向槽位 0,而不是由字节本身决定。
JSON (Tier 1:String 回退)
ClickHouse 的JSON 类型有多种传输编码 (参见序列化版本参考) 。Tier 1 是其中最简单的一种:当某个查询设置了 output_format_native_write_json_as_string = 1 时,服务器会将每个 JSON 值展平为序列化后的文本,并将该列以带状态前缀标记的 String 类型输出。
类型字符串:JSON。
1。其他值表示不同的 JSON/Object 编码:0 = V1,2 = V2 (原生 TCP 协议下的默认编码) ,3 = FLATTENED,4 = V3 (参见序列化版本参考) 。如果解码器在此处读到的值不是 1,则说明当前数据并非 String 回退。在每个行数 > 0 的块开头都会读取该前缀,其后的值流是一个包含 num_rows 行的标准 String 列。
JSON 值 '{"a":1}' (一行) :
{"a":1}) ,其中的整数仍保留为整数。该文本只是一个 String 值,因此客户端收到的 JSON 仅可作为不透明数据传递,无法还原出各个路径及其 ClickHouse 类型;若要按路径准确保留类型,需使用下文所述的第 2 层编码。
Variant(T1, T2, …)
一种可辨识联合 (discriminated union) :每一行恰好保存其中某一个 Variant 类型的值,或者为 NULL。每一行都带有一个单字节的全局判别值,用于指明该行的类型;各类型的值随后紧凑存储,每个 Variant 类型对应一段连续数据。 类型字符串:Variant(T1, T2, ...)。服务器会对类型顺序进行规范化 (Variant 类型按名称排序) ,因此接收到的 类型字符串 本身已按全局判别值顺序列出各类型:判别值 0 对应列出的第一个类型,1 对应第二个,依此类推。255 (NULL_DISCRIMINATOR) 表示该行为 NULL。Variant 的元素永远不会是 Nullable——NULL 由判别值来表示。示例:Variant(String, UInt64)、Variant(Array(UInt8), String)。
状态前缀包含一个 UInt64 LE 格式的判别值模式:0 = BASIC (原样写入每一行的判别值) ,1 = COMPACT (基于粒度的游程编码) 。服务器通过原生协议传输时默认使用 BASIC (use_compact_variant_discriminators_serialization = false) ;本文仅介绍 BASIC 模式。
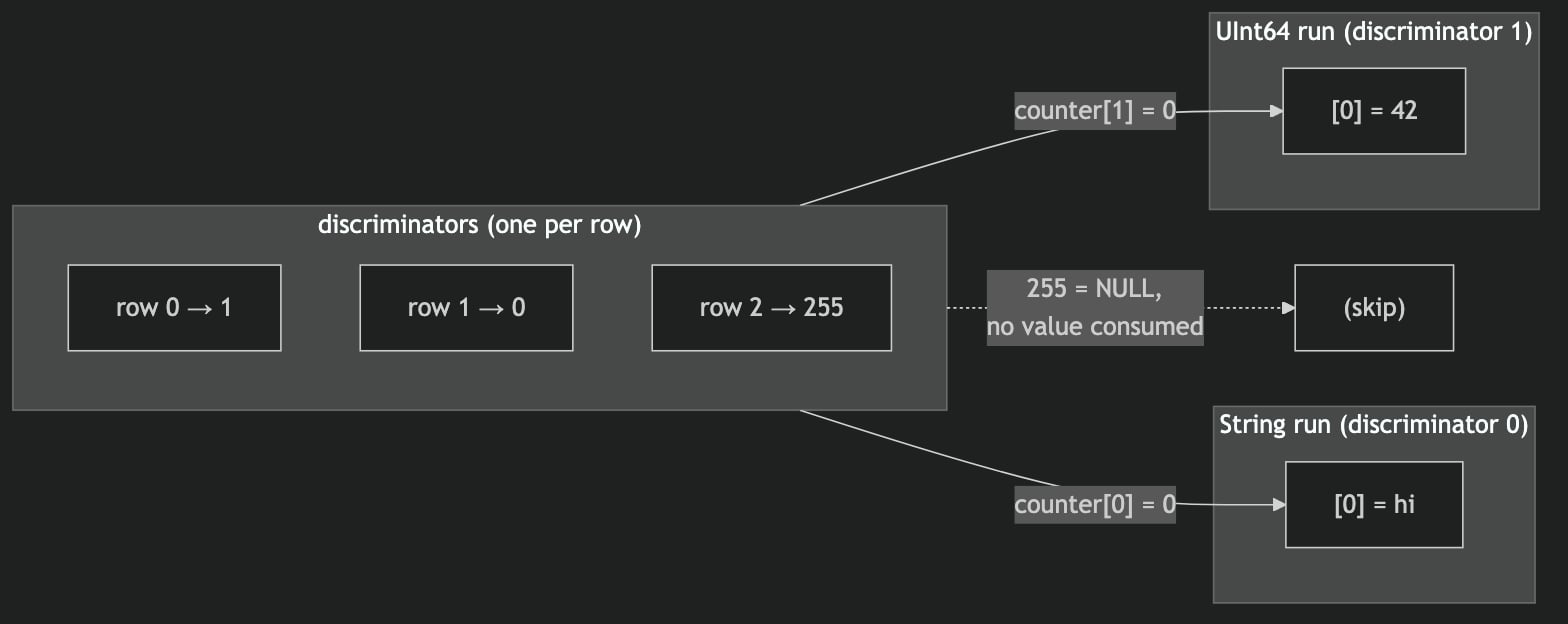
d (≠ 255) 的行 r 从 Variant 类型 d 的值序列中取出索引为 counter[d] 的值,然后将 counter[d] 加一。判别值为 255 的行为 NULL,不消耗任何值序列中的值,因此各类型计数器之和等于非 NULL 行的数量。
状态前缀 (即 mode UInt64) 会在每个行数 > 0 的块开头读取;请求头 块和空块不输出任何内容。每个非 NULL 判别值都小于 Variant 类型的数量,且 Variant 类型 i 恰好解码 count[i] 行。
本身有状态的 Variant 元素 (
LowCardinality、Variant、Dynamic、JSON) 会在逐元素状态前缀阶段输出各自的状态前缀,位于 mode UInt64 之后。叶类型以及普通复合类型 (由叶类型构成的 Array、Tuple、Map) 的状态前缀为空,可自由组合。[42, 'hi', NULL] 的 Variant(String, UInt64) 为例 (按规范顺序,String 排在 UInt64 之前,因此判别值 0 = String,1 = UInt64) :
42;第 1 行 = String run[0] = "hi";第 2 行 = NULL。
判别值流本身就是索引:每个非 NULL 判别值都会从其所属类型的紧凑序列中取出下一个值,而 255 (NULL) 不消耗任何值。Dynamic 也采用同样的遍历方式进行重建,唯一的区别在于 NULL 的编码方式:
Dynamic
一种在运行时才确定值类型的列:每一行保存的值属于某个运行时确定的类型集合中的一种类型,或者为 NULL。与Variant 不同,该类型集合不包含在列的类型字符串中,而是由状态前缀携带。
类型字符串:Dynamic 或 Dynamic(max_types=N)。max_types 参数限定该列最多跟踪多少种不同类型,但不影响下文所述的传输格式。
Dynamic 有四种编码:V1 = 1、V2 = 2、FLATTENED = 3、V3 = 4。服务器输出哪一种编码,取决于所用通道以及查询设置:
- 通过
clickhouse-client和 HTTPFORMAT Native时,写入器的修订版本为0(除非通过client_protocol_version调高) ,因此默认使用 V1。 - 通过原生 TCP 协议并使用协商后的修订版本时,默认使用 V2。
Native写入器不启用统计信息,因此默认的V2载荷不包含按变体划分的统计信息:类型列表之后紧跟嵌套的Variant前缀和数据。 (按变体划分的统计信息属于 MergeTree 磁盘存储层面的内容,不属于 Native 传输格式。) - 查询设置
output_format_native_use_flattened_dynamic_and_json_serialization = 1会覆盖上述两种情况,无论修订版本为何,均输出 FLATTENED (版本 3) 。
适用范围本页仅规定
FLATTENED 布局。非扁平的 V1/V2/V3 二进制布局属于内部/磁盘表示形式 (二进制编码的类型列表、按变体划分的统计信息) ,本页不作规定。客户端若要依据本页解码 Dynamic,必须设置 output_format_native_use_flattened_dynamic_and_json_serialization = 1 以请求 FLATTENED;下文的布局均以该设置为前提。由于版本字节位于前缀开头,解码器可以据此识别实际收到的编码;如果解码器只实现了 FLATTENED,则可拒绝 V1/V2/V3。num_types 种类型外加一个 NULL 槽位的最小无符号整数类型:当 num_types ≤ 255 时为 UInt8,更大时依次为 UInt16、UInt32、UInt64。NULL 对应的判别值就是 num_types 本身,这一点与 Variant 不同,后者的 NULL 固定为 255。重建方式与 Variant 相同,同样采用紧凑遍历:为每种类型维护一个计数器,对于判别值为 d (≠ num_types) 的行 r,从类型 d 的连续序列中取第 counter[d] 个值。
状态前缀 (版本号 + 类型列表) 在每个行数 > 0 的块开头读取;请求头 块和空块不输出任何内容。
计数值损坏
num_types 在所有类型名称之前从流中读取。解码器必须将其视为不可信数据,不得直接据此确定内存分配的大小——无论是接近 SIZE_MAX 的计数 (可能导致中间运算溢出,或抛出非 DB::Exception 的异常) ,还是诸如 100000000 这样很大但仍可表示的计数 (它远低于 vector 的 max_size(),却会在读取任何类型名称之前就分配数 GB 内存) 。ClickHouse 逐条读取类型列表,仅使用有上限的预分配提示,因此损坏的 num_types 要么以 INCORRECT_DATA 被拒绝 (“Dynamic column has too many types”,发生在计数超出容器可容纳范围时) ,要么在流中的类型条目耗尽时以普通读取错误被拒绝——绝不会导致内存不足故障。但是,不要用 ColumnDynamic::MAX_DYNAMIC_TYPES_LIMIT (在 ClickHouse 中为 254) 来限制扁平化的 num_types:扁平化类型列表包含所有不同的运行时类型,包括那些溢出到共享 variant 中的类型,因此一个有效的扁平化块完全可以合法地列出远多于该数量的类型。MAX_DYNAMIC_TYPES_LIMIT 上限仅适用于非扁平 V1/V2/V3 前缀中的 num_dynamic_types 计数,该计数统计的是常规 variant 槽位,并受此上限约束 (ClickHouse 会在为共享 variant 执行 + 1 之前,在该处对其进行校验) 。截断的 stream判别值序列恰好包含
num_rows 个条目,解码器必须验证确实读取了这么多条目,而不能流中有多少就接受多少。较短的序列并不会与其后的内容产生矛盾:每种类型的值计数是根据实际读取的判别值推导出来的,因此与值序列保持一致;而完全由 NULL 标记组成的序列根本不需要任何值字节。ClickHouse 会在执行任何按类型检查之前,以 INCORRECT_DATA (“Mismatch in flattened Dynamic column: N rows are expected, but the indexes stream contains only M rows”) 拒绝过短的判别值序列,因为无论重建列的实际大小如何,它随后都会被当作 num_rows 行来使用。序列化具有状态的运行时类型 (
LowCardinality、Variant、Dynamic、JSON) 会在类型名称列表之后携带嵌套的状态前缀。Variant 的规范化规则——常规 variant 槽位按 DataTypeVariant (类型名称) 顺序写入,因此传输顺序与插入顺序无关。不过,该列表并不总是全局有序的:溢出到共享 variant 中的类型 (例如在 Dynamic(max_types=N) 下) 会按首次出现的顺序追加在常规槽位之后,因此列表末尾可能不符合类型名称顺序。因此,解码器必须以传输的类型列表为准来分配判别值,不得自行重新排序。列表中不允许出现重复类型或 Nothing:两个相同的条目会映射到同一个判别值,而 Nothing 根本不是 variant,因此这两种情况都会导致列表中有一部分内容无处重建。ClickHouse 对这两种情况均以 INCORRECT_DATA 拒绝。对于行 [42::UInt64, "hi", NULL],两种类型分别为 String 和 UInt64,且 "String" 排在 "UInt64" 之前,因此判别值为 0 = String、1 = UInt64、2 = NULL:
42;第 1 行 = String run[0] = "hi";第 2 行 = NULL。各类型的 run 与类型列表采用相同的传输顺序 (String 位于 UInt64 之前) 。
JSON (第 2 层:FLATTENED Object)
一种更丰富的 JSON 编码:它不像第 1 层那样将每个值都扁平化为文本,而是将该列拆分为多个子列,每个 JSON 路径对应一个子列。要选用此编码,需在启用扁平化序列化标志 (output_format_native_use_flattened_dynamic_and_json_serialization = 1) 的同时,不请求第 1 层回退 (output_format_native_write_json_as_string = 0) ;此时服务器会输出序列化版本 3。
路径分为两类:
- 类型化路径在类型字符串中声明,例如
JSON(a UInt32, b String),并按声明的类型解码。若路径名包含点号,在类型字符串中需用反引号括起。 - 动态路径在运行时发现,每个路径都解码为一个 Dynamic 列。
num_rows 个值的普通列。
Dynamic 前缀 (位于前缀阶段) 与其数据 (位于数据阶段) 是分开的。在每个行数 > 0 的块开头都会读取状态前缀,并且每个路径列 (无论是类型化路径还是动态路径) 都恰好包含 num_rows 个值。第 r 行的对象通过读取每个路径在索引 r 处的值组装而成;若某个动态路径在该行的 Dynamic 判别值为 NULL,则该路径不会为对象提供任何键。动态路径名称必须互不相同,且不得与类型字符串中已声明为类型化路径的任何路径重复——这两种情况都会导致组装出的对象在同一个键下出现两个值,因此 ClickHouse 会以 INCORRECT_DATA 拒绝这两种情况。非扁平编码中的动态路径列表同样遵循此规则。
计数值损坏此处所述 FLATTENED 布局中的
num_dynamic_paths,以及非扁平 V1/V2 编码中的动态路径计数,都是在路径名称之前从流中读取的。 (非扁平前缀中没有单独的扁平化路径字段:它们只包含动态路径计数,另外 V1 中还有一个读取后即被丢弃的 max_dynamic_paths 值。) 与 Dynamic 一样,解码器必须将这些计数视为不可信数据,不得直接据此确定内存分配的大小——无论是 SIZE_MAX 量级的计数,还是数值很大但仍可表示的计数。ClickHouse 逐个条目读取路径名称,且只使用有上限的预分配提示,因此损坏的计数会被拒绝:要么以 INCORRECT_DATA 拒绝 (“JSON/Object column has too many paths”,即超出容器可容纳的数量时) ,要么在流中的路径名称耗尽时以普通读取错误拒绝。截断的 stream每个路径列包含
num_rows 个值是硬性要求,而非上界:解码器必须将每个路径列 (包括类型化路径和动态路径) 与块的行数进行核对,而不能指望流恰好在正确位置结束。组装出的对象没有可供比对的独立大小——其行数完全取决于反扁平化的结果——因此长度不足的路径列事后无法被检测出来,而读取其第 r 行时就会越界。ClickHouse 会以 INCORRECT_DATA (“Unexpected size of typed path / flattened path p in flattened Object column”) 拒绝这种情况。对于动态路径,该检查是在其 Dynamic 列内部的等效检查之外额外进行的。JSON 值 {"a": 42, "b": "hi"} (一行,两个路径均为动态路径) 。JSON 整数会被推断为 Int64:
JSON 非扁平编码 (V1/V2)
非扁平化的Object 编码是扁平化标志关闭时服务器在线上传输中输出的编码:通过 clickhouse-client / HTTP FORMAT Native (修订版本 0) 传输时为 V1,通过原生 TCP 协议传输时为 V2。 (第三种非扁平编码 V3 仅写入 MergeTree parts,在线上传输中会被拒绝。) 这些编码包含一个 shared-data 列,本页不对其进行说明。请注意,它们在 Native 线上传输中不携带按路径划分的统计信息:NativeWriter 会禁用统计信息,因此 Object 结构前缀中没有统计信息部分,紧随其后的字节直接就是 typed/dynamic/shared-data 前缀及数据。统计信息仅出现在启用了统计信息的 MergeTree 磁盘路径上。若要按照本页解码 JSON 列,客户端必须选用本页所述的某一层级:设置 output_format_native_write_json_as_string = 1 以使用 String 回退,或设置 output_format_native_use_flattened_dynamic_and_json_serialization = 1 (同时设置 output_format_native_write_json_as_string = 0) 以使用 FLATTENED Object 布局。
压缩帧
ClickHouse 可以使用一种内部帧格式压缩Native 流中的列数据。下文所述的帧布局与传输方式无关——原生 TCP 协议和 HTTP 中使用的是相同的帧——但请求压缩的方式以及帧外围的内容因传输方式而异。
- 原生 TCP 协议。 压缩需按查询显式启用,方法是在 Query 数据包中设置
compression标志。启用后,每个Data、Totals、Extremes、Log和ProfileEvents数据包的正文 (即table_name字符串之后的字节) 都会以帧格式封装。数据包封装本身 (即数据包类型代码和table_name字符串) 不会被压缩,服务器会将其直接写入原始流。NativeWriter输出的所有内容都会进入压缩流,因此帧内首先是BlockInfo前缀,随后是维度和列。也就是说,客户端必须先解压帧,才能读取BlockInfo。 - HTTP。
SELECT ... FORMAT Native&compress=1会将整个FORMAT Native字节流封装在相同的帧中 (服务器使用相同的内部CompressedWriteBuffer) ,而?decompress=1则要求Native输入请求正文采用相同的帧,并通过对应的CompressedReadBuffer进行解码。该路径中没有 TCP 数据包类型、table_name或数据包封装:整个压缩载荷仅由经过帧封装的Native块组成 (与上文的未压缩布局完全一致,仅当协商的修订版本大于0时才包含BlockInfo前缀) 。这种内部的compress/decompress帧信息不同于 HTTP 传输压缩 (Content-Encoding: gzip/zstd,通过enable_http_compression启用) ;后者在 HTTP 层封装响应,并不属于下文所述的帧格式。
FORMAT Native 布局的客户端,仍需额外支持这一帧层,才能读取压缩的 HTTP Native 响应,或发送 decompress=1 请求正文。
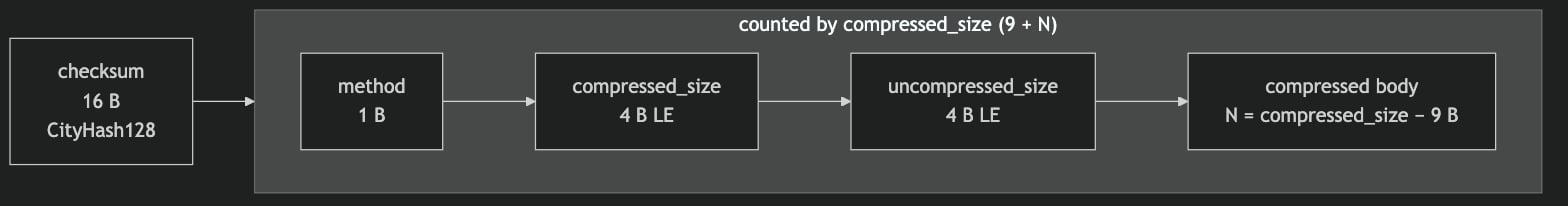
帧格式
16 + compressed_size = 16 + 9 + body_size = 25 + body_size。请注意这两个范围的区别:校验和覆盖 9 字节的头部和请求正文,而 compressed_size 计入头部和请求正文,但不包含校验和本身:
方法字节值
服务器为整流Native 帧信息生成的正是以下三种编解码器:HTTP compress=1 输出使用服务器的默认编解码器 (ZSTD(3)) ,而原生 TCP 协议则根据 network_compression_method 使用 LZ4、ZSTD 或 NONE。通用的 Native 客户端只需生成和解析这几种即可。
方法字节还用于标识列级编解码器。这些编解码器在 MergeTree 磁盘路径上按列应用,而不是作用于整流帧信息;但
decompress=1 HTTP 输入路径会从每个帧的方法字节中读取编解码器,因此这些字节中的任何一个都可能合法地出现在输入中。所以,符合规范的解码器必须能够识别整个已分配的取值空间,遇到未实现的字节时应直接拒绝,而不是错误地解析请求正文。这些编解码器的请求正文格式各不相同,不在本通用帧约定的范围内:
DoubleDelta (0x94) 以 MSB 优先的前缀/符号/幅值位存储二阶差分。基于字的解码会保留这种编码方式、元素数量以及末字节填充。
0x9c (ALP) 是一种适用于 Float32 和 Float64 的 beta 无损编解码器 (自适应无损浮点压缩) 。只有启用 enable_alp_codec 设置后,才能使用 CODEC(ALP) 创建表;但解压时始终接受该方法字节,以确保先前写入的数据仍可读取。0x9d (SZ3) 是一种 Experimental 的误差有界有损编解码器,适用于 Float32、Float64 以及由这些类型构成的 Array。只有启用 enable_sz3_codec 设置后,才能使用 CODEC(SZ3) 创建表;但解压时始终接受该方法字节,以确保先前写入的数据仍可读取。0x9f (ZXC) 是一种 Experimental 的非对称 LZ 编解码器:压缩较慢,但解压极快,压缩率介于 LZ4 和 ZSTD 之间。只有启用 enable_zxc_codec 设置后,才能使用 CODEC(ZXC) 创建表;但解压时始终接受该方法字节,以确保先前写入的数据仍可读取。字节 0x99 (DeflateQpl) 和 0x9b (ZSTD_QPL) 曾分配给现已移除的编解码器,目前作为保留值,不会被复用。
0x9e (Quantized) 是一种 Experimental 的列编解码器,适用于稠密向量列 (Array(Float32) 及类似类型) 。与 NONE 一样,它采用直通方式,全精度请求正文按原样存储;但启用它后会附加一种序列化方式,额外写入一个紧凑的量化伴随流,用于加速向量搜索。只有启用 enable_quantized_codec 设置后,才能使用 CODEC(Quantized(...)) 创建表,而解压时始终接受该方法字节。
校验和
ClickHouse 使用的是 CityHash v1.0.2 (历史版本) ,而非现代的 Google CityHash;两者的输出结果并不相同。 校验和基于 9 个头部字节 (method + compressed_size + uncompressed_size) 以及 N 个请求正文字节计算得出,即覆盖从校验和之后到帧末尾的全部内容。在 16 字节的 CityHash128 输出中,前 8 个字节为低半部分 (LE) ,后 8 个字节为高半部分 (LE) 。解码器会基于接收到的头部和请求正文重新计算 CityHash128,并与开头的 16 个字节进行比对;若两者不一致,则表明数据已损坏,解码器会直接报错。按块划分的边界
块的压缩载荷是由一个或多个帧组成的流,不一定只有单个帧。发送方通过CompressedWriteBuffer 写入序列化后的块:每当其内部缓冲区写满 (约 1 MB,DBMS_DEFAULT_BUFFER_SIZE) 时就输出一个帧,并在块刷写时输出最后一个帧。因此,小块对应一个帧,大块则对应若干个连续的帧。
这一不变量只在单一方向上成立:由于发送方在每个块结束时都会刷写压缩缓冲区,每个块的结尾都与帧边界重合——但反之则不成立。若缓冲区在块写入中途写满,由此产生的中间帧边界位于块的中间,并不是块边界。因此,解码器必须依据块自身的维度 (num_columns/num_rows) 来判断块在何处结束,而不能假定每个帧就是一个完整的块。
接收方以流式方式处理帧:先读取 16 + 9 字节,再精确读取 compressed_size - 9 字节的请求正文数据,将其解压为恰好 uncompressed_size 字节,然后交给块解码器;当解码器所需的数据超出当前帧的内容时,再拉取下一个帧。由于发送方按块刷写,一个块完全解码后,帧缓冲区即为空,下一个块会从一个新帧开始。
在原生 TCP 协议中,数据包封装——即数据包类型 VarUInt 和 table_name 字符串——直接写入原始流,位于压缩载荷之外;只有块的请求正文 (BlockInfo + 列) 会被分帧。HTTP 的 compress/decompress 路径则没有这种封装:整个流都由分帧的块组成。
协商
在原生 TCP 协议中,压缩按查询启用,而非按连接启用。Query 数据包中的compression: bool 字段用于为单个查询请求压缩。服务器会响应该请求,并在查询的整个生命周期内发送经过压缩的 Data/Totals/Extremes/Log/ProfileEvents 数据包体 (Log/ProfileEvents 仅适用于 v54481+) 。同时,服务器也要求客户端发出的 Data 块 (包括外部表、空的数据结束标记以及 INSERT 行) 采用相同的帧格式。同一连接上的后续查询可以采用不同的设置。
通过 HTTP 访问时不存在 Query 数据包:compress=1 查询参数用于为该请求启用分帧输出,而 decompress=1 则声明请求正文已分帧。compress=1 的输出使用服务器的默认编解码器 (ZSTD(3)) 写入,而不是 network_compression_method;decompress=1 读取器根据每个帧的方法字节确定编解码器,因此输入端可接受任意编解码器。
启用压缩后,对于包含多行的块,服务器还可能通过并行块编组 /
ColumnBLOB 路径 (PARALLEL_BLOCK_MARSHALLING,v54478) 传输列。对 INSERT 数据进行压缩的实现必须能够处理该路径 (或显式选择不使用该路径) ,以免数据流失去同步。术语表
块 — Native 格式中数据交换的基本单位。一种自描述、按列存储的行数据块。参见块与列结构。 BlockInfo — 在 TCP Data 数据包路径上位于 块 之前的元数据头 (只要连接修订版本大于零就会写入) 。它由一系列受修订版本控制、以字段 ID 标记的字段组成。Native 输出格式以修订版本 0 进行序列化,因此不包含该部分。参见 BlockInfo。
列数据体 (Column body) — 列中位于列头 (名称、类型、has_custom_serialization 字节) 之后、承载实际值的字节。其布局因类型而异。参见列的线协议布局。
复合类型 (Composite type) — 由一个或多个内部类型构成的类型,每列编码为多个流。其线协议格式稳定,且不带版本。参见复合类型。
字典 (LowCardinality) — LowCardinality(T) 列通过整数索引引用的唯一值数组。参见 LowCardinality。
空块 (Empty block) — num_columns = 0 且 num_rows = 0 的 块。用作哨兵:在客户端表示输入结束,在服务器端表示流边界。参见块的变体。
头部块 (Header block) — num_columns > 0 且 num_rows = 0 的 块,由服务器作为查询响应的第一个 Data 数据包发送,用于声明结果 schema。参见块的变体。
内部类型 (Inner type) — 复合类型所包装的类型。Array(UInt32) 的内部类型为 UInt32;Nullable(T) 的内部类型为 T。
偏移量流 (Offsets stream) — 由累计结束位置构成的 UInt64 数组,Array、Map 和 Nested 借此划定每行元素的边界。参见 Array。
占位值 (Placeholder value) — Nullable(T) 列的值流中写在 null 位置上的字节。解码器会读取这些字节以推进流,但忽略其内容。参见 Nullable。
结果块 (Result block) — num_rows > 0、承载实际查询结果行的 块。参见块的变体。
Schema 块 (Schema block) — 头部块的同义词,用于描述 INSERT 阶段,此时由 schema 块告知客户端预期的列结构。
序列化版本 (Serialization version) — 按类型定义、在线上传输的版本号,版本化类型用它来声明后续采用哪种编码变体。它不同于协议版本。参见序列化版本:概念。
状态前缀 (State prefix) — 版本化类型中位于每个块载荷之前的字节,携带序列化版本以及 (对于 LowCardinality) 每个块的字典元数据。在每个行数 > 0 的块开头写出,不会跨块保留。
流 (Stream) — 列数据体中一段连续的字节,用于编码一个逻辑子组件 (null-map、偏移量数组、值流) 。多流类型会在每列中依次拼接两个或更多流。