

这是关于从 PostgreSQL 迁移到 ClickHouse 的指南的 第 1 部分。本文通过一个实际示例,演示如何采用实时复制 (CDC,变更数据捕获) 的方法高效完成迁移。文中介绍的许多概念同样适用于将数据从 PostgreSQL 手动批量迁移到 ClickHouse 的场景。作为用于展示从 Postgres 迁移到 ClickHouse 典型流程的示例数据集,我们使用此处记录的 Stack Overflow 数据集。该数据集包含 Stack Overflow 从 2008 年到 2024 年 4 月期间产生的所有
post、vote、user、comment 和 badge。该数据的 PostgreSQL schema 如下所示:
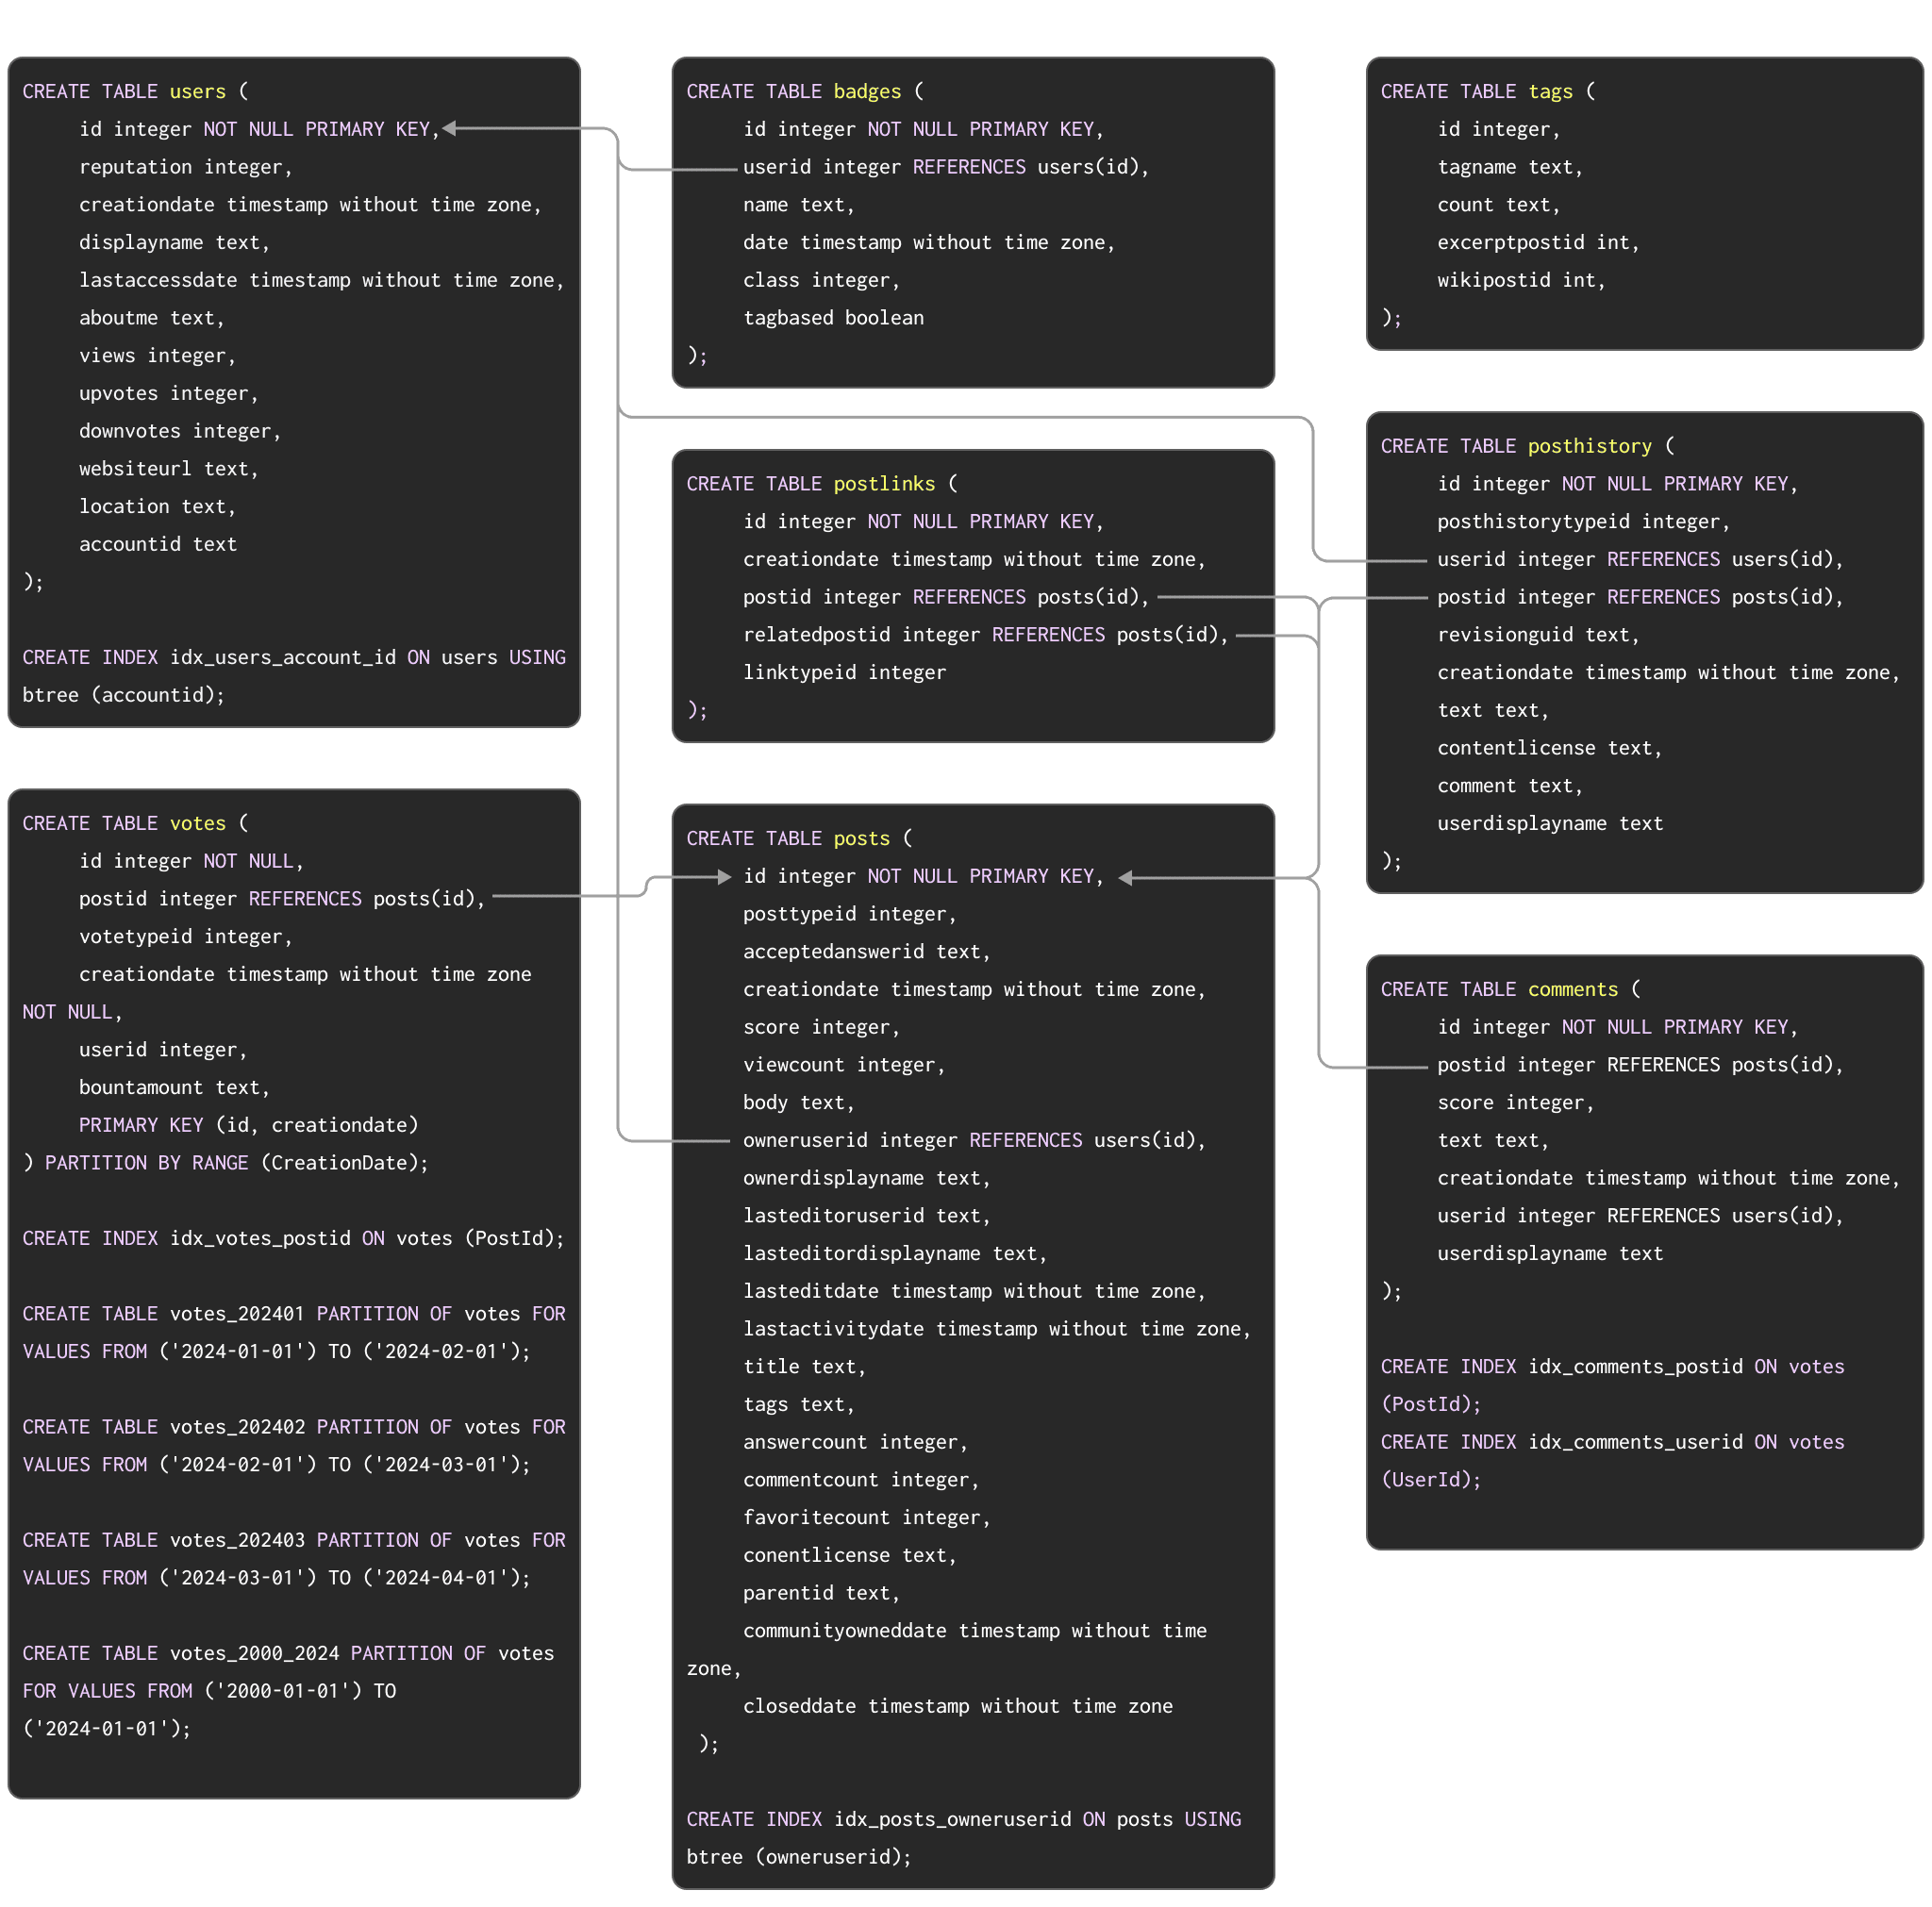
pg_dump 格式的数据下载,以及配套的 DDL,后续的数据加载命令如下所示:
虽然我们的示例结果使用的是完整数据集,以展示 Postgres 与 ClickHouse 之间的性能差异,但下文记录的所有步骤同样适用于这个较小的子集,功能上完全一致。想要将完整数据集加载到 Postgres 的用户,请参见这里。由于上述 schema 中定义了外键约束,PostgreSQL 的完整数据集仅包含满足引用完整性的行。如有需要,也可以直接将无此类约束的 Parquet 版本 轻松加载到 ClickHouse 中。请参考此指南设置 ClickPipes for PostgreSQL。该指南涵盖多种不同类型的 Postgres 源实例。 采用 ClickPipes 或 PeerDB 的 CDC (变更数据捕获) 方法时,PostgreSQL 数据库中的每个表都会自动复制到 ClickHouse 中。 为了近实时处理更新和删除,ClickPipes 使用 ReplacingMergeTree 引擎将 Postgres 表映射到 ClickHouse;该引擎专为在 ClickHouse 中处理更新和删除而设计。你可以在这里了解更多关于数据如何通过 ClickPipes 复制到 ClickHouse 的信息。需要注意的是,使用 CDC (变更数据捕获) 进行复制时,在复制更新或删除操作时会在 ClickHouse 中产生重复行。有关在 ClickHouse 中处理这些重复行的方法,请参阅使用 FINAL 修饰符的相关技术。 下面来看一下使用 ClickPipes 在 ClickHouse 中创建表
users 的方式。
- 表函数 - 在 ClickHouse 中使用 Postgres 表函数 从 Postgres
SELECT数据,并将其INSERT到 ClickHouse 表中。适用于将数百 GB 以内的数据集进行批量加载。 - 导出 - 导出为 CSV 或 SQL 脚本文件等中间格式。然后可以通过客户端使用
INSERT FROM INFILE子句将这些文件加载到 ClickHouse,或者借助对象存储及其相关函数 (如 s3、gcs) 进行加载。
DESCRIBE 命令。以下命令用于查看 PostgreSQL 中 posts 表的结构,请根据你的环境进行修改:
Query
Query
INSERT INTO SELECT 来填充它:从 PostgreSQL 读取数据并插入到 ClickHouse 中。
Query
WHERE 子句应用于 SELECT。如果能够保证更新始终作用于同一列,这种方法也可用于支持更新。不过,若要支持删除,则需要完全重新加载,而随着表不断增长,这可能会越来越难实现。
我们演示如何使用 CreationDate 进行初始加载和增量加载 (我们假设如果行被更新,它也会随之更新) 。
ClickHouse 会将简单的WHERE子句 (如=、!=、>、>=、<、<=和 IN) 下推到 PostgreSQL 服务器。因此,若用于标识变更集的列上存在索引,就能让增量加载更高效。
在使用查询复制时,一种可用于检测 UPDATE 操作的方法是,将点击此处查看第 2 部分XMINsystem column (事务 ID) 用作水位线——该列的变化表明数据已发生变更,因此可以将变更应用到目标表。采用这种方法的用户应注意,XMIN值可能会回绕,而且进行比较时需要全表扫描,这会让变更跟踪变得更加复杂。