

INSERT、UPDATE 和 DELETE 操作流式传输变更。虽然物理复制在某些情况下也能达到类似效果,但逻辑复制在针对特定表和操作、进行数据转换以及支持不同 Postgres 版本方面提供了更高的灵活性。
相比之下,ClickHouse 的分片和副本是与数据分布和冗余相关的两个关键概念。ClickHouse 副本可以类比为 Postgres 副本,不过其复制是最终一致的,并且没有主节点这一概念。与 Postgres 不同,ClickHouse 原生支持分片。
分片是表数据的一部分。你始终至少有一个分片。如果单台服务器的容量不足,可以将数据分片到多台服务器上以分摊负载,并在执行查询时让所有分片并行工作。你可以在不同服务器上手动为某个表创建分片,并将数据直接插入其中。或者,也可以使用分布式表,并通过分片键定义数据应路由到哪个分片。分片键可以是随机的,也可以是某个哈希函数的输出。重要的是,一个分片可以包含多个副本。
副本是数据的一个拷贝。ClickHouse 始终至少保留一份数据副本,因此副本的最小数量为 1。为数据增加第二个副本可以提供容错能力,并可能增加用于处理更多查询的计算资源 (还可以使用 并行副本 将单个查询的计算资源分布到多个副本上,从而降低延迟) 。副本通过 ReplicatedMergeTree 表引擎 实现,它使 ClickHouse 能够在不同服务器之间保持多份数据副本同步。复制是物理层面的:节点之间传输的只有压缩后的 parts,而不是查询。
总之,副本是数据的拷贝,用于提供冗余和可靠性 (以及潜在的分布式处理能力) ;而分片则是数据的一个子集,用于实现分布式处理和负载均衡。
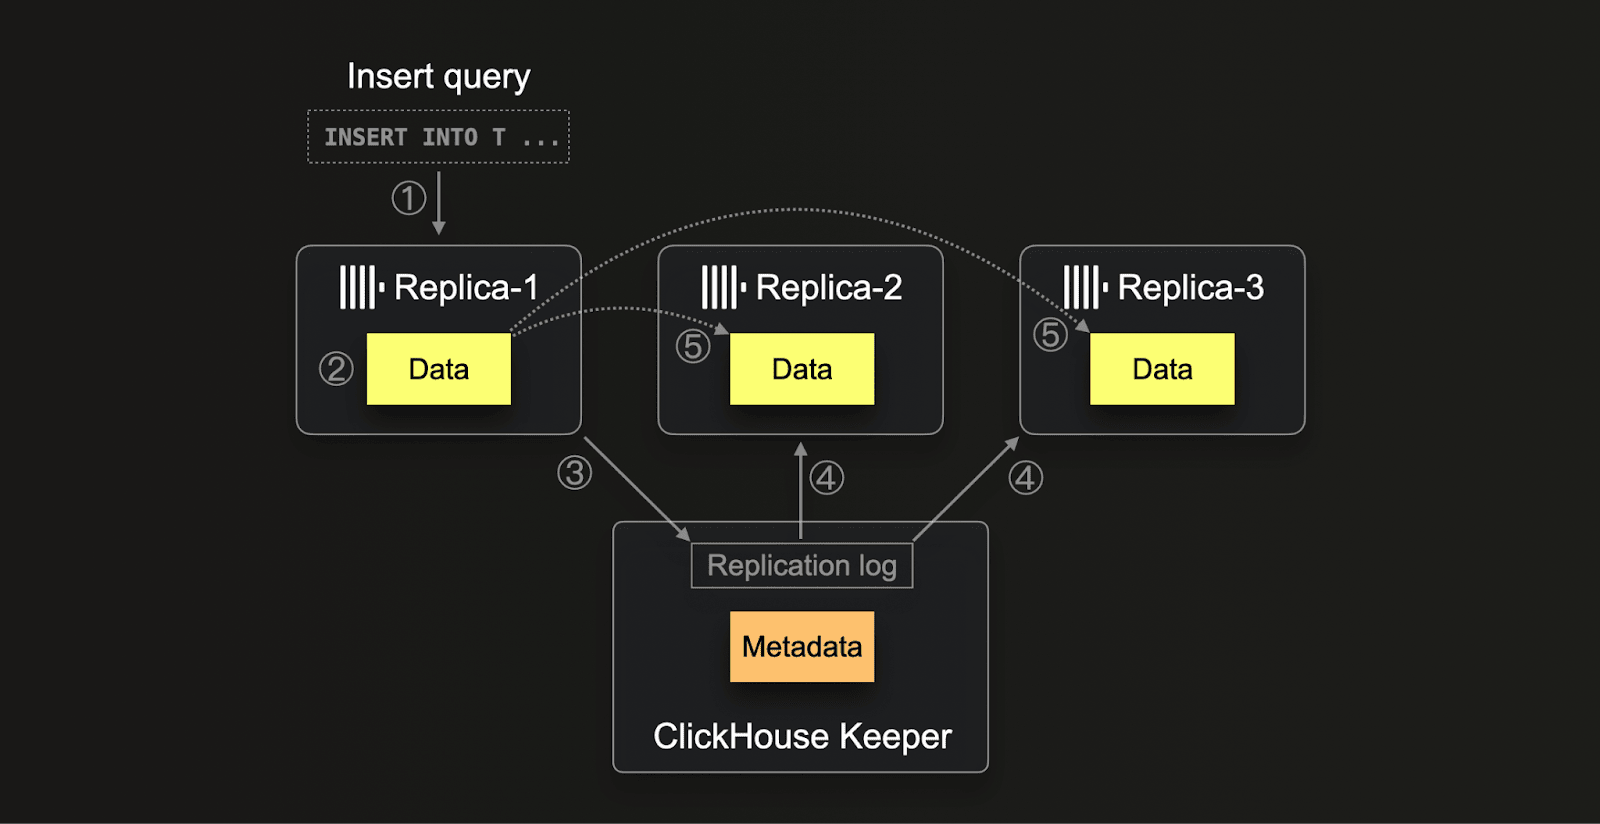
ClickHouse Cloud 使用存储在 S3 中的单份数据,并配备多个计算副本。每个副本节点都可以访问这些数据,并且各自都拥有本地 SSD 缓存。这仅依赖通过 ClickHouse Keeper 进行的元数据复制。ClickHouse 使用 ClickHouse Keeper (一个用 C++ 实现的 ZooKeeper,也可以直接使用 ZooKeeper) 来管理其内部复制机制,主要负责元数据存储并确保最终一致性。Keeper 会在分布式环境中为每次插入分配唯一的顺序编号,这对于在各项操作之间保持顺序和一致性至关重要。该机制还负责处理合并和变更等后台操作,既能将这些任务分发出去,又能保证它们在所有副本上按相同顺序执行。除了元数据之外,Keeper 还充当复制体系的综合控制中心,包括跟踪已存储数据分区片段的校验和,并作为副本之间的分布式通知系统。 ClickHouse 中的复制过程 (1) 始于数据被插入任意一个副本时。这些处于原始插入形式的数据会连同其校验和一起被 (2) 写入磁盘。写入完成后,该副本会 (3) 尝试在 Keeper 中注册这个新的数据分区片段,具体做法是分配唯一的块编号并记录该新分区片段的详细信息。其他副本在 (4) 检测到复制日志中的新条目后,会 (5) 通过内部 HTTP 协议下载相应的数据分区片段,并根据 ZooKeeper 中列出的校验和进行校验。该方法确保即使各副本处理速度不同或存在潜在延迟,最终也都能持有一致且最新的数据。此外,系统还能够并发处理多项操作,从而优化数据管理流程,并提升系统的可扩展性以及应对硬件差异的稳健性。
联系支持团队以获取粘性端点的访问权限。在 OSS 中,要实现这种行为,取决于你的分片和副本拓扑,以及查询时是否使用了分布式表。 当你只有一个分片和多个副本时 (这种情况很常见,因为 ClickHouse 更适合纵向扩展) ,用户会在客户端层选择节点,并直接查询某个副本,同时确保该选择是确定性的。 虽然在不使用分布式表的情况下,也可以采用包含多个分片和副本的拓扑,但这类高级部署通常都有自己的路由基础设施。因此,我们假定只要部署包含多个分片,就会使用分布式表 (分布式表也可用于单分片部署,但通常没有必要) 。 在这种情况下,你应确保基于某个属性进行一致的节点路由,例如
session_id 或 user_id。应在查询中设置 prefer_localhost_replica=0 和 load_balancing=in_order。这样可以确保优先选择各分片的本地副本;否则,在错误数相同的情况下,会优先按照配置中列出的顺序选择副本——如果错误数更高,则会随机选择并执行故障转移。也可以使用 load_balancing=nearest_hostname 作为这种确定性分片选择的替代方案。
创建分布式表时,你需要指定一个集群。这个在 config.xml 中定义的集群会列出各个分片 (及其副本) ,从而让用户可以控制每个节点使用它们的顺序。利用这一点,你可以确保选择具有确定性。在极少数情况下,你可能需要顺序一致性。 数据库中的顺序一致性是指,数据库上的操作看起来会按某种顺序依次执行,并且这一顺序对所有与数据库交互的进程都保持一致。这意味着,每个操作看起来都会在调用到完成之间的某个瞬间立即生效,而且所有进程观察到的操作顺序都是唯一且一致的。 从用户角度来看,这通常表现为:需要将数据写入 ClickHouse,并在读取数据时保证返回最新插入的行。 这可以通过多种方式实现 (按优先顺序排列) :
- 在同一节点上读/写 - 如果你使用原生协议,或者使用 session 通过 HTTP 执行写入/读取,那么你应当连接到同一个副本:在这种情况下,你直接从写入所在的节点读取,因此读取结果始终是一致的。
- 手动同步副本 - 如果你写入一个副本,却从另一个副本读取,可以在读取前执行
SYSTEM SYNC REPLICA LIGHTWEIGHT。 - 启用顺序一致性 - 通过查询设置
select_sequential_consistency = 1。在 OSS 中,还必须指定设置insert_quorum = 'auto'。
有关如何启用这些设置的更多详细信息,请参见此处。
使用顺序一致性会给 ClickHouse Keeper 带来更高负载。结果可能是 插入和读取速度变慢。作为 ClickHouse Cloud 中主要表引擎的 SharedMergeTree,顺序一致性带来的额外开销更低,扩展性也更好。在 OSS 中,你应谨慎使用这种方式,并衡量 Keeper 负载。从 PostgreSQL 迁移而来的用户,可能已经习惯了它对 ACID (原子性、一致性、隔离性、持久性) 特性的强大支持,这使其成为事务型数据库的可靠选择。PostgreSQL 中的原子性确保每个事务都被视为一个单一单元,要么完全成功,要么完全回滚,从而避免部分更新。一致性则通过强制执行约束、触发器和规则来保持,以确保所有数据库事务都会使数据处于有效状态。PostgreSQL 支持从 Read Committed 到 Serializable 的隔离级别,因此可以对并发事务所做更改的可见性进行精细控制。最后,持久性通过预写日志 (WAL) 实现,确保事务一旦提交,即使发生系统故障也不会丢失。 这些特性在作为单一事实来源的 OLTP 数据库中很常见。 尽管功能强大,但这也带来了固有的限制,使扩展到 PB 级规模变得颇具挑战。ClickHouse 在这些特性上做出取舍,以便在大规模场景下提供快速的分析查询,同时保持高写入吞吐量。 ClickHouse 仅在有限配置下提供 ACID 特性——最简单的情况是使用具有单个分区的非复制 MergeTree 表引擎实例。你不应期望在这些场景之外也具备这些特性,并应确保这些特性不是你的硬性要求。 ClickHouse 的列式存储意味着,相比 Postgres,其压缩效果通常会好得多。下图展示了比较两个数据库中所有 Stack Overflow 表存储需求的结果:
Query (Postgres)
Query (ClickHouse)
Response