

- 源 BigQuery 表必须存在。
- 目标 ClickHouse 表必须存在。
- 必须能够从 Dataflow 工作节点访问 ClickHouse 主机。
所有
ClickHouseIO 参数的默认值均可在 ClickHouseIO Apache Beam 连接器中找到。- 模板基于目标 ClickHouse 表构建 schema 对象。
- 模板遍历 BigQuery 数据集,并尝试根据列名进行匹配。
BigQuery 类型会根据你的 ClickHouse 表定义进行转换。因此,上表列出了你的目标 ClickHouse 表中建议采用的映射 (针对给定的 BigQuery 表/查询) :
BigQuery 到 ClickHouse 的Template可通过 Google Cloud CLI 运行。
请务必阅读本文档,尤其是上面的各个章节,以充分了解此Template的配置要求和前置条件。
- Google Cloud Console
- Google Cloud CLI
登录 Google Cloud Console 并搜索 DataFlow。
-
点击
CREATE JOB FROM TEMPLATE按钮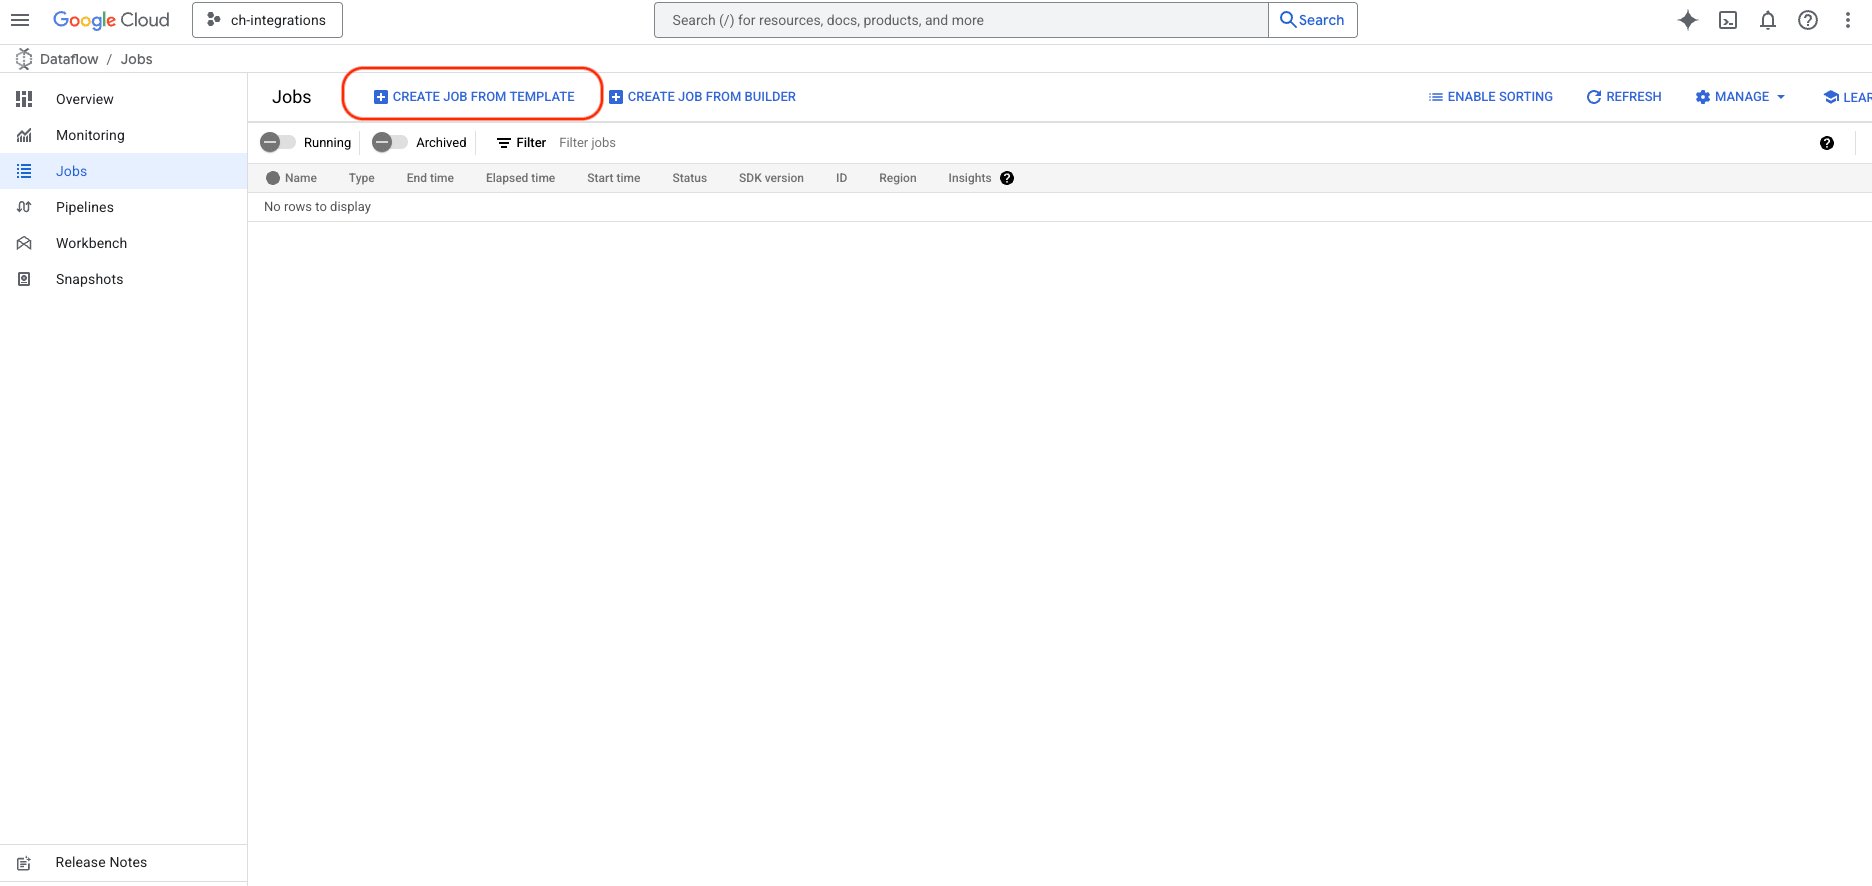
-
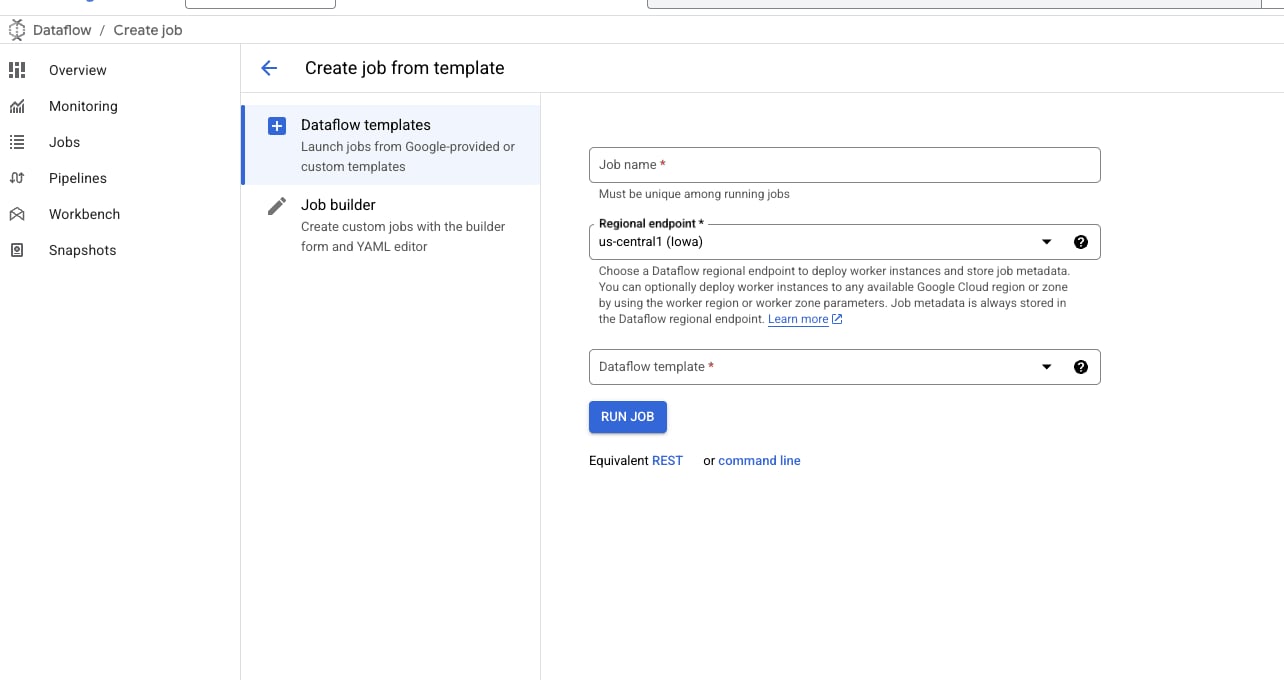
打开Template表单后,输入作业名称并选择所需区域。
-
在
DataFlow Template输入框中,输入ClickHouse或BigQuery,然后选择BigQuery to ClickHouseTemplate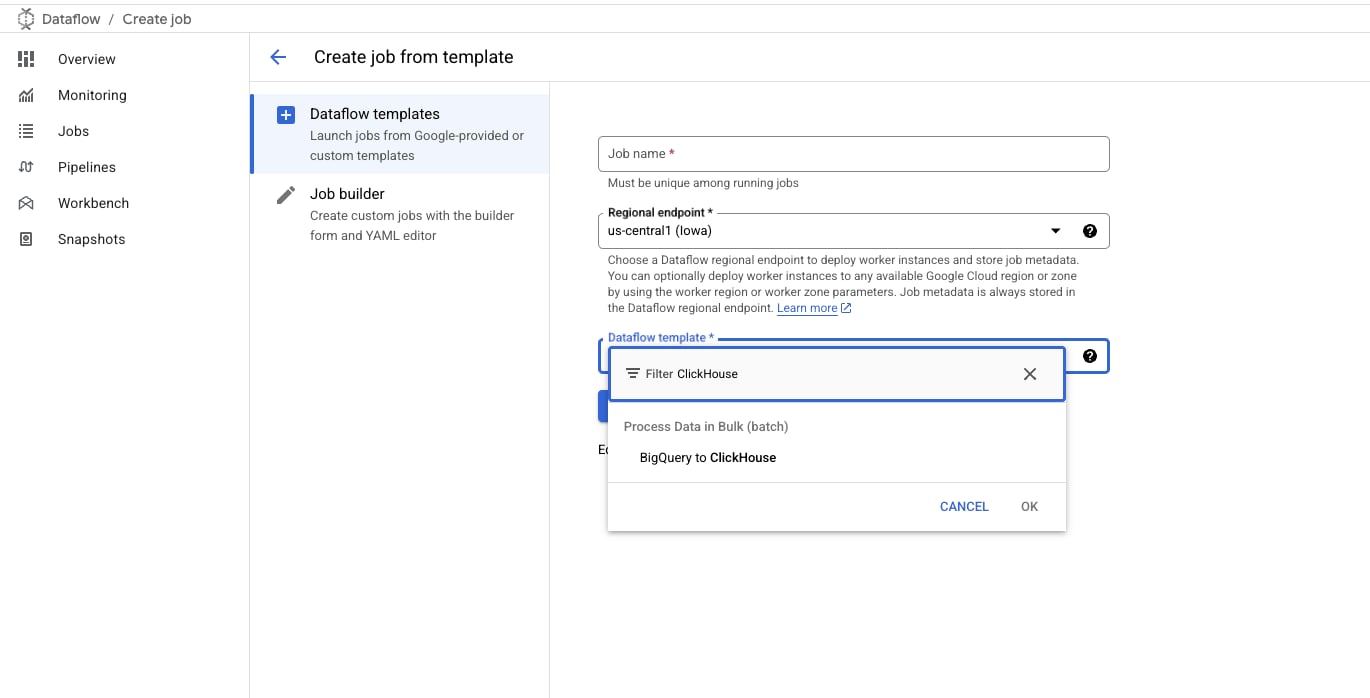
-
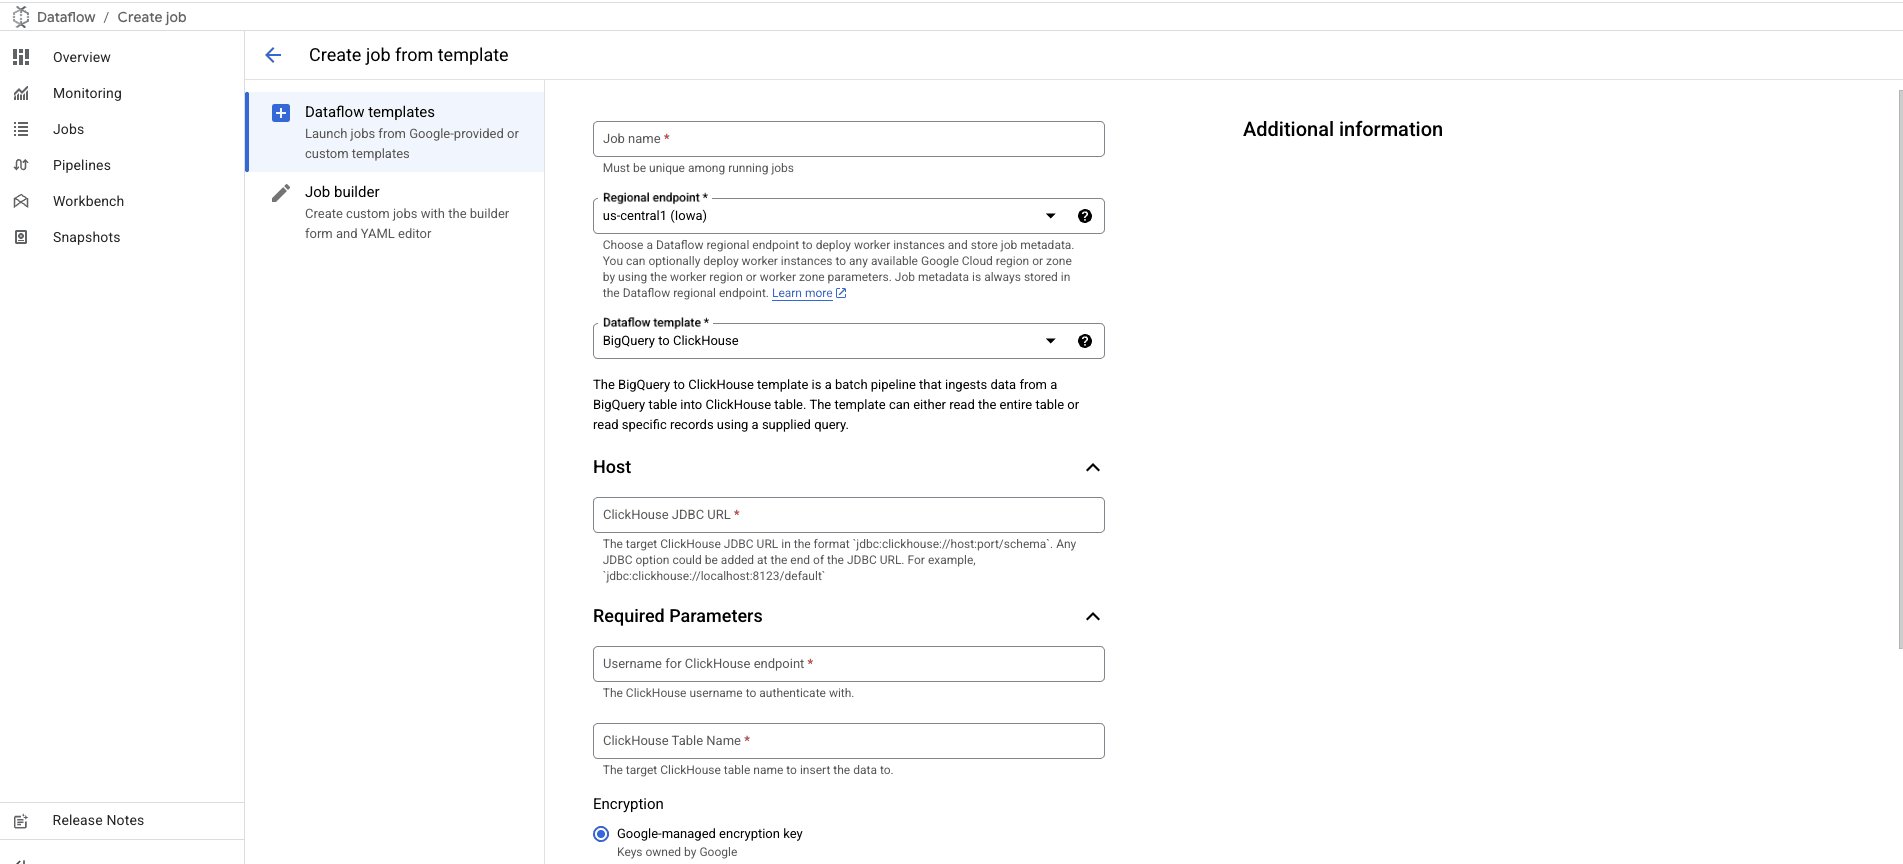
选中后,表单会展开,以便你填写更多详细信息:
- ClickHouse server JDBC URL,格式如下:
jdbc:clickhouse://host:port/schema。 - ClickHouse 用户名。
- ClickHouse 目标表名称。
- ClickHouse server JDBC URL,格式如下:
ClickHouse 密码选项被标记为可选,适用于未配置密码的场景。
如需添加,请向下滚动到
Password for ClickHouse Endpoint 选项。- 根据Template参数部分中的详细说明,自定义并添加任何与 BigQuery/ClickHouseIO 相关的配置
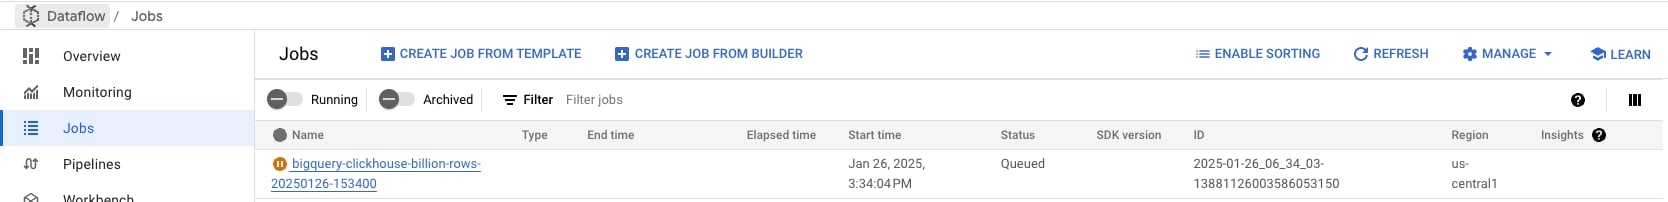
- 增加实例资源:将 ClickHouse server 升级到内存更大的更高规格实例,以承载数据处理负载。
- 减小批次大小:调整 Dataflow 作业配置中的批次大小,向 ClickHouse 发送更小的数据块,从而降低每个批次的内存消耗。这些更改有助于在数据摄取期间平衡资源使用。
GoogleCloudPlatform/DataflowTemplates— Google Cloud Platform 的上游代码仓库。ClickHouse/DataflowTemplates— ClickHouse 的 fork。