

你可以在这里加入私有预览候补名单。
APPENDS 和 CHANGES。
BigQuery ClickPipes 既可通过 ClickPipes UI 手动部署和管理,也可通过 OpenAPI 和 Terraform 以编程方式进行部署和管理。
初始加载
初始加载会将 BigQuery 数据集中选定的表复制到 ClickHouse。初始加载既可以单独运行,也可以在完成后接着进行持续复制。加载过程会使用您提供的 Google Cloud Storage (GCS) 桶作为暂存区。仅执行初始加载的 ClickPipe 会在加载完成后停止。ClickPipes 使用 BigQuery
EXPORT DATA 查询将数据复制到暂存桶。运行这些查询会产生 BigQuery 费用,同时还会产生 GCS 存储费用。持续复制
完成初始加载后,BigQuery ClickPipe 可以轮询新数据并将其写入 ClickHouse。您也可以跳过初始加载,直接启动持续复制。请根据源表的变更方式选择复制方式。以下示例仅展示查询形态;ClickPipes 实际会选取已配置的列以及事件元数据。
使用基于查询的复制时,需要为每个表选择一个水位线列。该列必须是
TIMESTAMP 类型,且必须包含在要复制的列中。每次插入或更新行时都应设置该列的值。如果某行发生了变更但水位线值没有更新,ClickPipes 将无法捕获该变更。如需复制删除操作,请使用 CHANGES。
两种基于事件的方式都要求使用常规 BigQuery 表。APPENDS 无需启用变更历史记录。若要使用 CHANGES,请在创建 ClickPipe 之前为每个源表启用变更历史记录:
CHANGES 还要求目标表配置 BigQuery 主键或自定义 sorting key。请选择能够唯一标识每一行的列,以便 ClickPipes 将更新和删除操作应用到对应的行。BigQuery 不强制执行主键约束,因此源数据必须保证这些值唯一。
APPENDS 和 CHANGES 只能读取源表在 BigQuery 时间旅行窗口内发生的变更。该窗口默认为七天,最短可设为两天。如果复制进度超出该窗口,请重新执行初始加载,以恢复完整的数据副本。BigQuery 会对这三种方法产生的查询收费。为 CHANGES 启用变更历史记录还会增加 BigQuery 存储成本。服务账号凭证
ClickPipes 使用服务账号密钥对你的 Google Cloud 项目进行身份验证。我们建议创建一个专用的服务账号,并仅授予满足要求的最小权限,以便 ClickPipes 能够从 BigQuery 导出数据、将其加载到暂存 GCS 存储桶中,并将其读入 ClickHouse。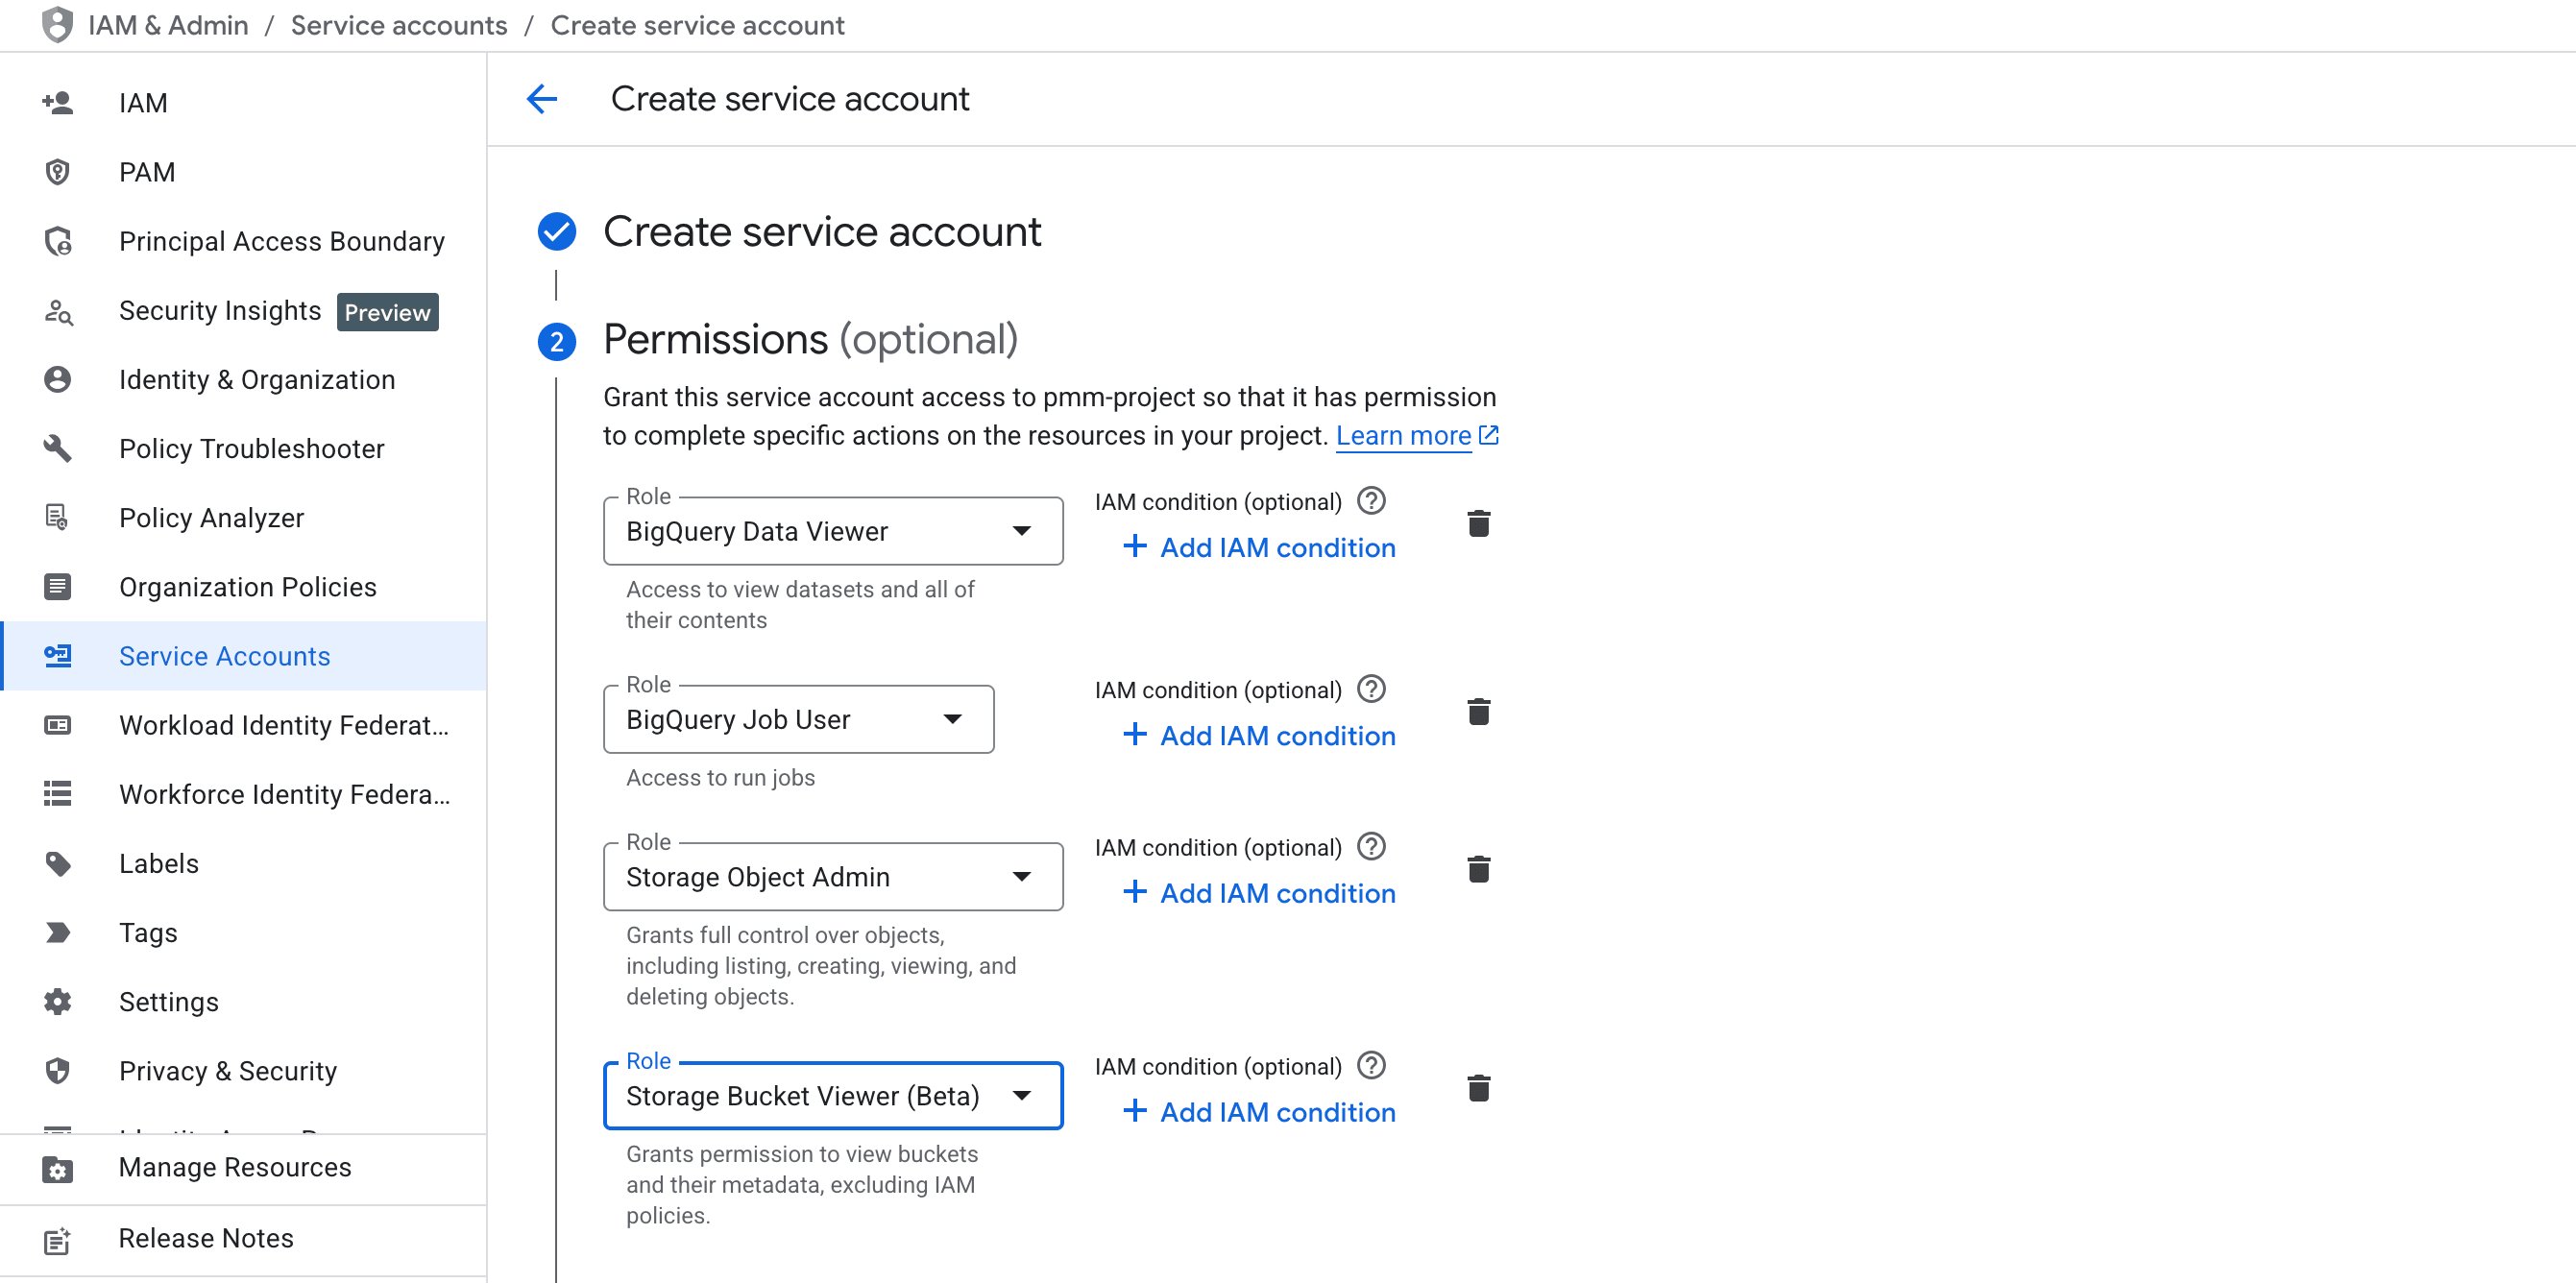
GCP Workload Identity (Beta)
请按照 GCP Workload Identity 指南,从 ClickPipes 服务上下文中获取托管服务账号。为该账号授予下文所列的 BigQuery 和 GCS 角色,然后使用SERVICE_ACCOUNT_WORKLOAD_IDENTITY 身份验证方式创建管道。使用此身份验证方法时,请勿提供服务账号凭证。
BigQuery
ClickPipes 使用的服务账号 (无论是由你提供,还是通过 workload identity 管理) 需要具备以下 BigQuery 角色: 如需启用持续复制,还需在 Google Cloud 项目级别授予roles/bigquery.readSessionUser 角色。ClickPipes 通过 BigQuery Storage Read API 创建读取会话,并读取 CDC (变更数据捕获) 查询结果。该角色无法在数据集级别授予;请保留源数据集或表上的 roles/bigquery.dataViewer 角色,以便服务账号能够读取其中的数据。
为进一步缩小访问范围,我们建议使用 IAM 条件 来限制该角色可访问的资源。例如,你可以将 dataViewer 角色限制为仅可访问包含待同步表的特定数据集:
objectAdmin 和 bucketViewer 角色限制为只能访问专门为 ClickPipes 同步创建的存储桶。