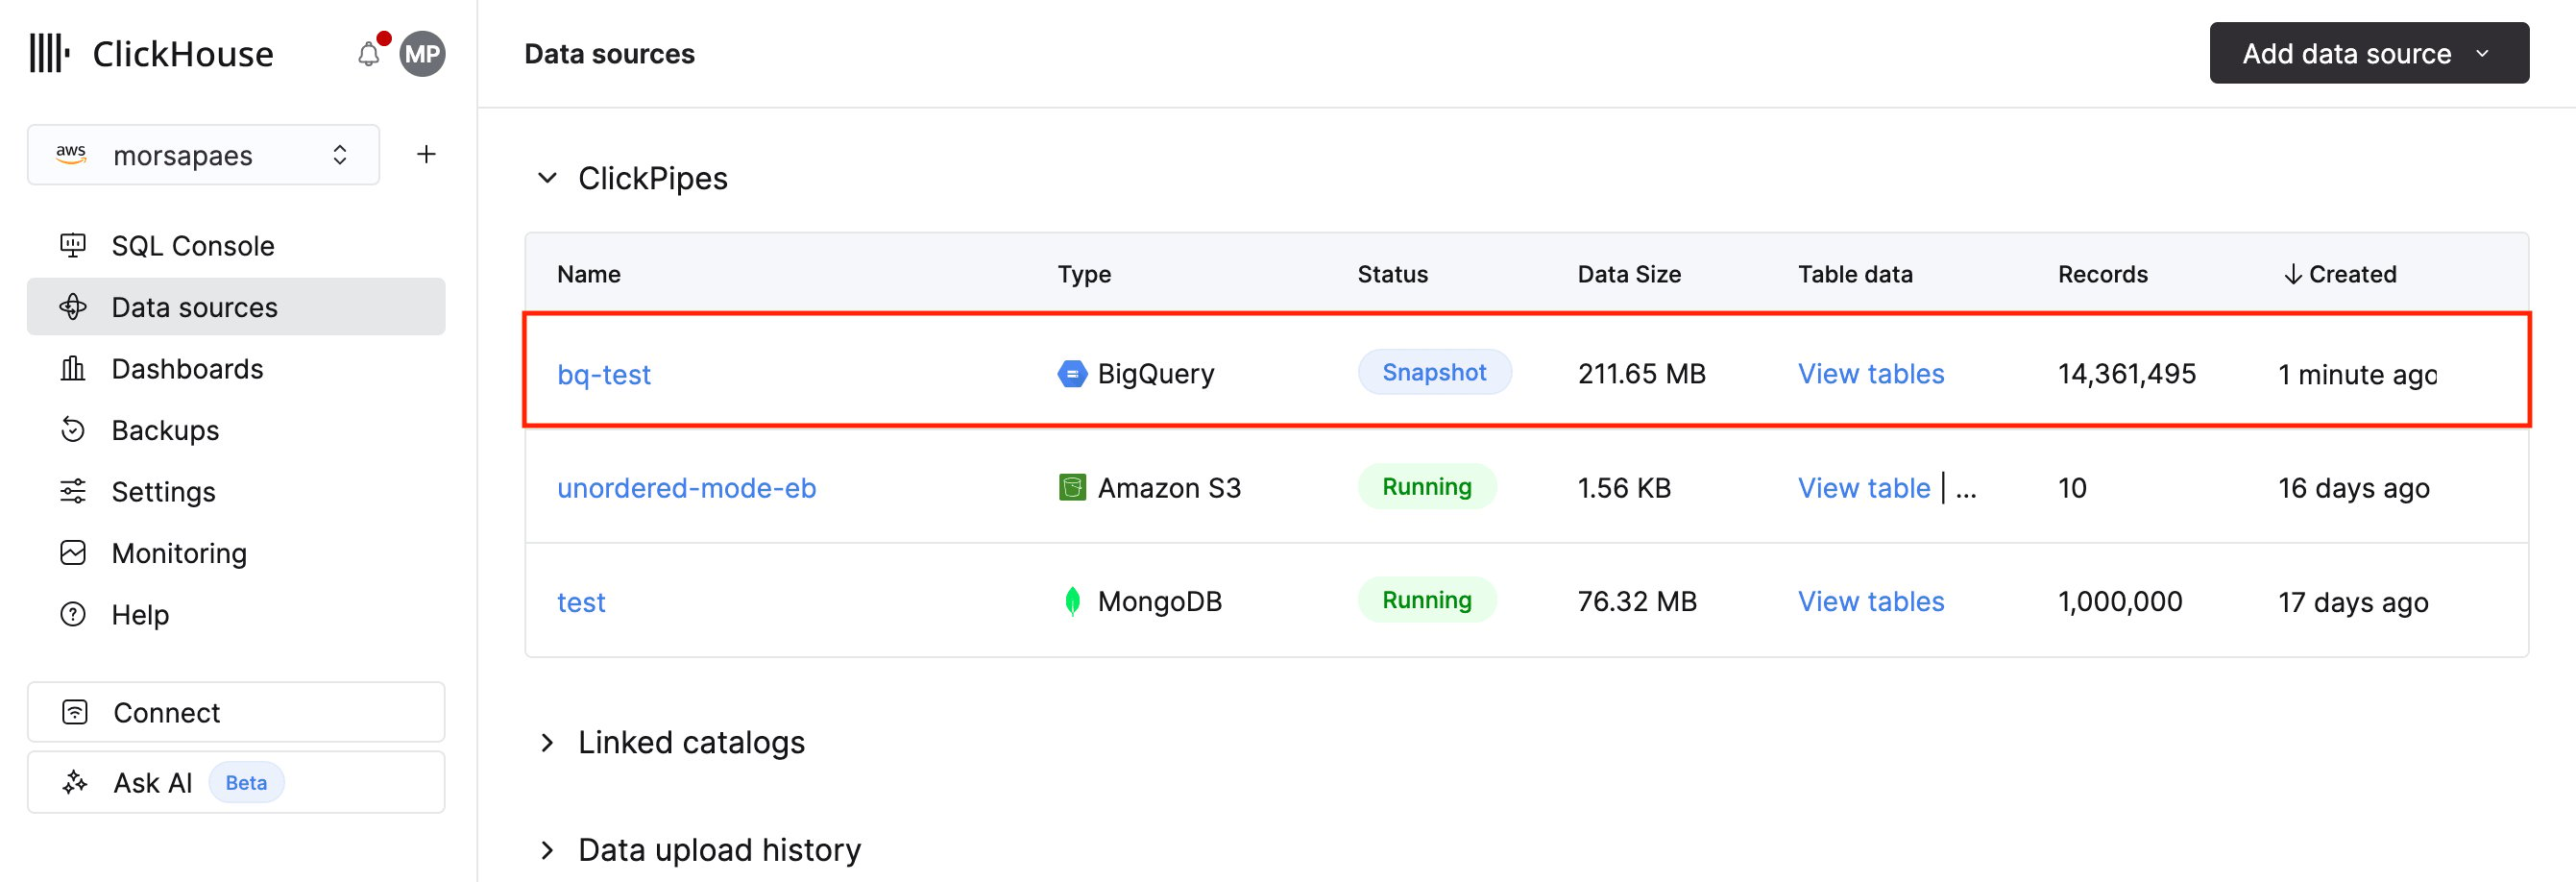
你可以在这里加入私有预览候补名单。
APPENDS 和 CHANGES。
BigQuery ClickPipes 既可通过 ClickPipes UI 手动部署和管理,也可通过 OpenAPI 和 Terraform 以编程方式进行部署和管理。
前提条件
- 您必须具备在 GCP 项目中管理服务账号和 IAM roles 的权限,或者获得管理员协助。我们建议按照官方文档创建一个专用服务账号,并仅授予所需的最小权限。
- 初始加载需要一个 Google Cloud Storage (GCS) 存储桶用于暂存。我们建议按照 Google Cloud 的说明为您的 ClickPipe 创建一个专用存储桶。
- 对于持续复制,请在项目中向该服务账号授予 BigQuery Read Session User 角色。选择表之前,请先查看所选复制方法的要求。
1
选择数据源
1. 在 ClickHouse Cloud 的主导航菜单中选择 数据源,然后点击 创建 ClickPipe。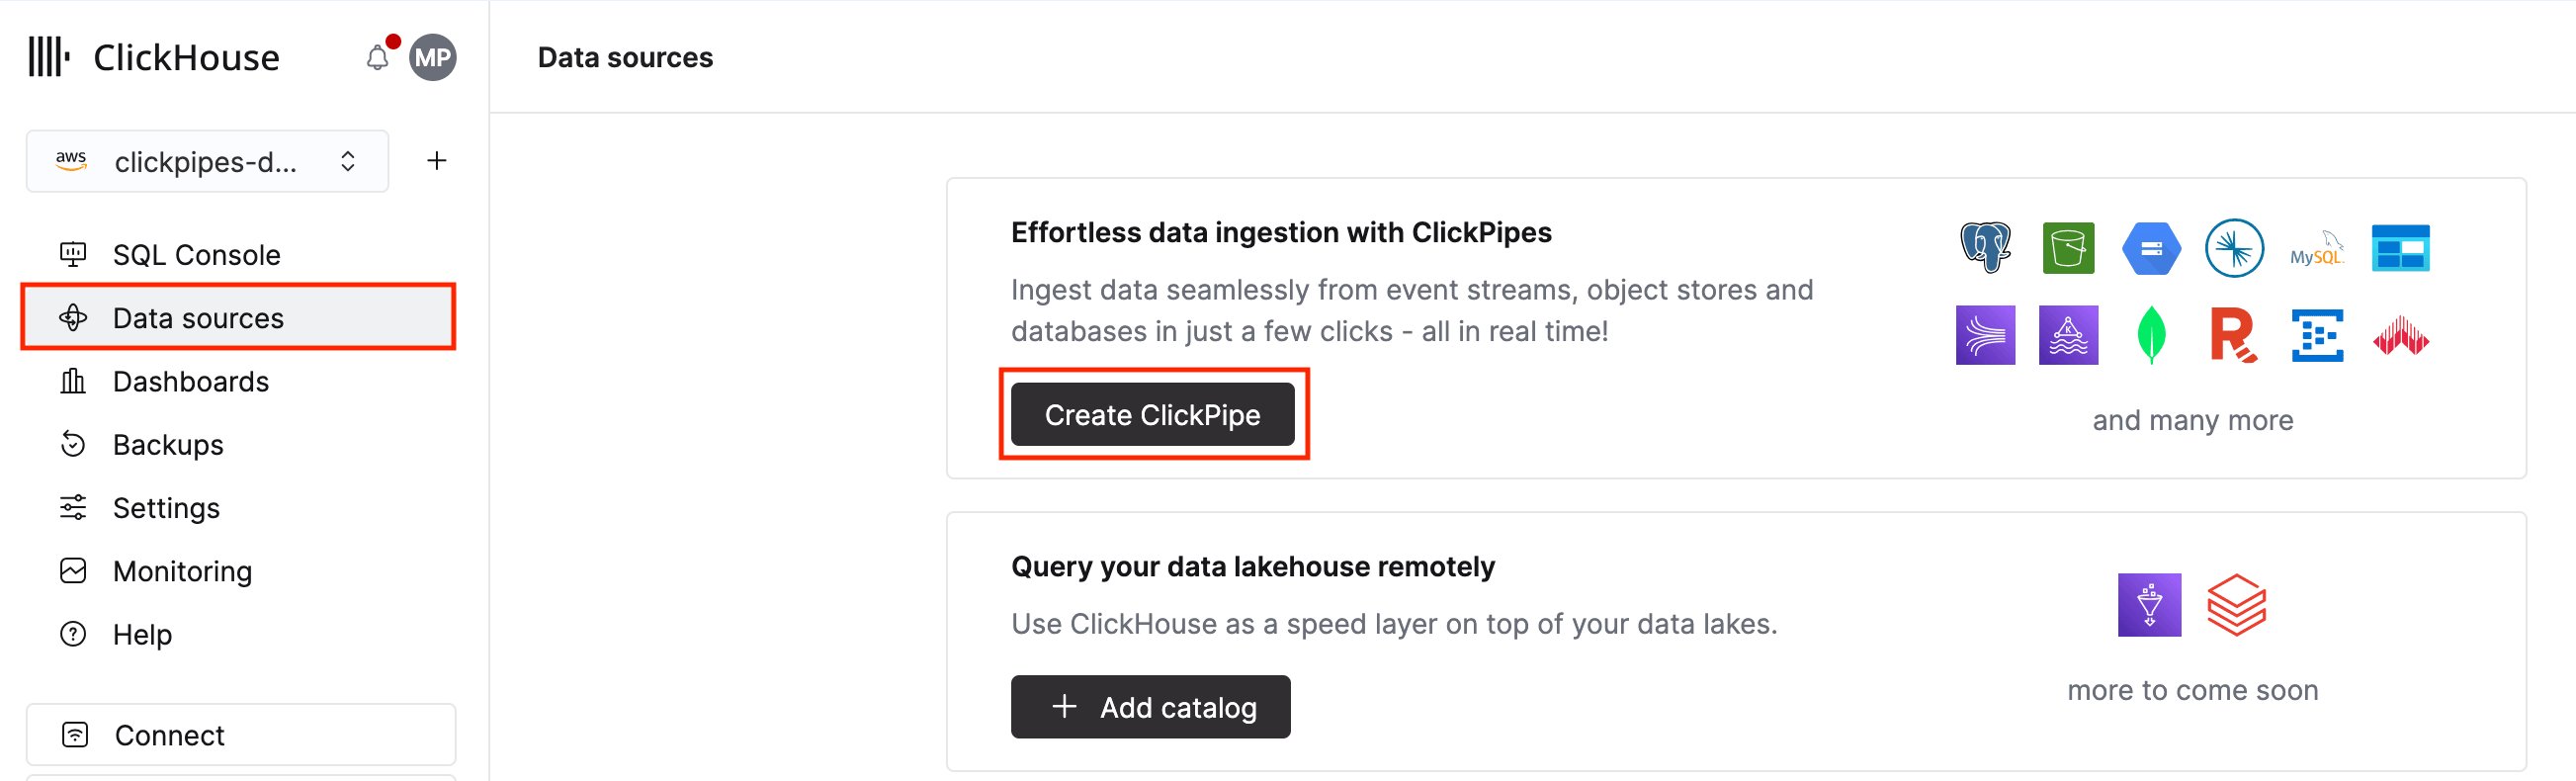
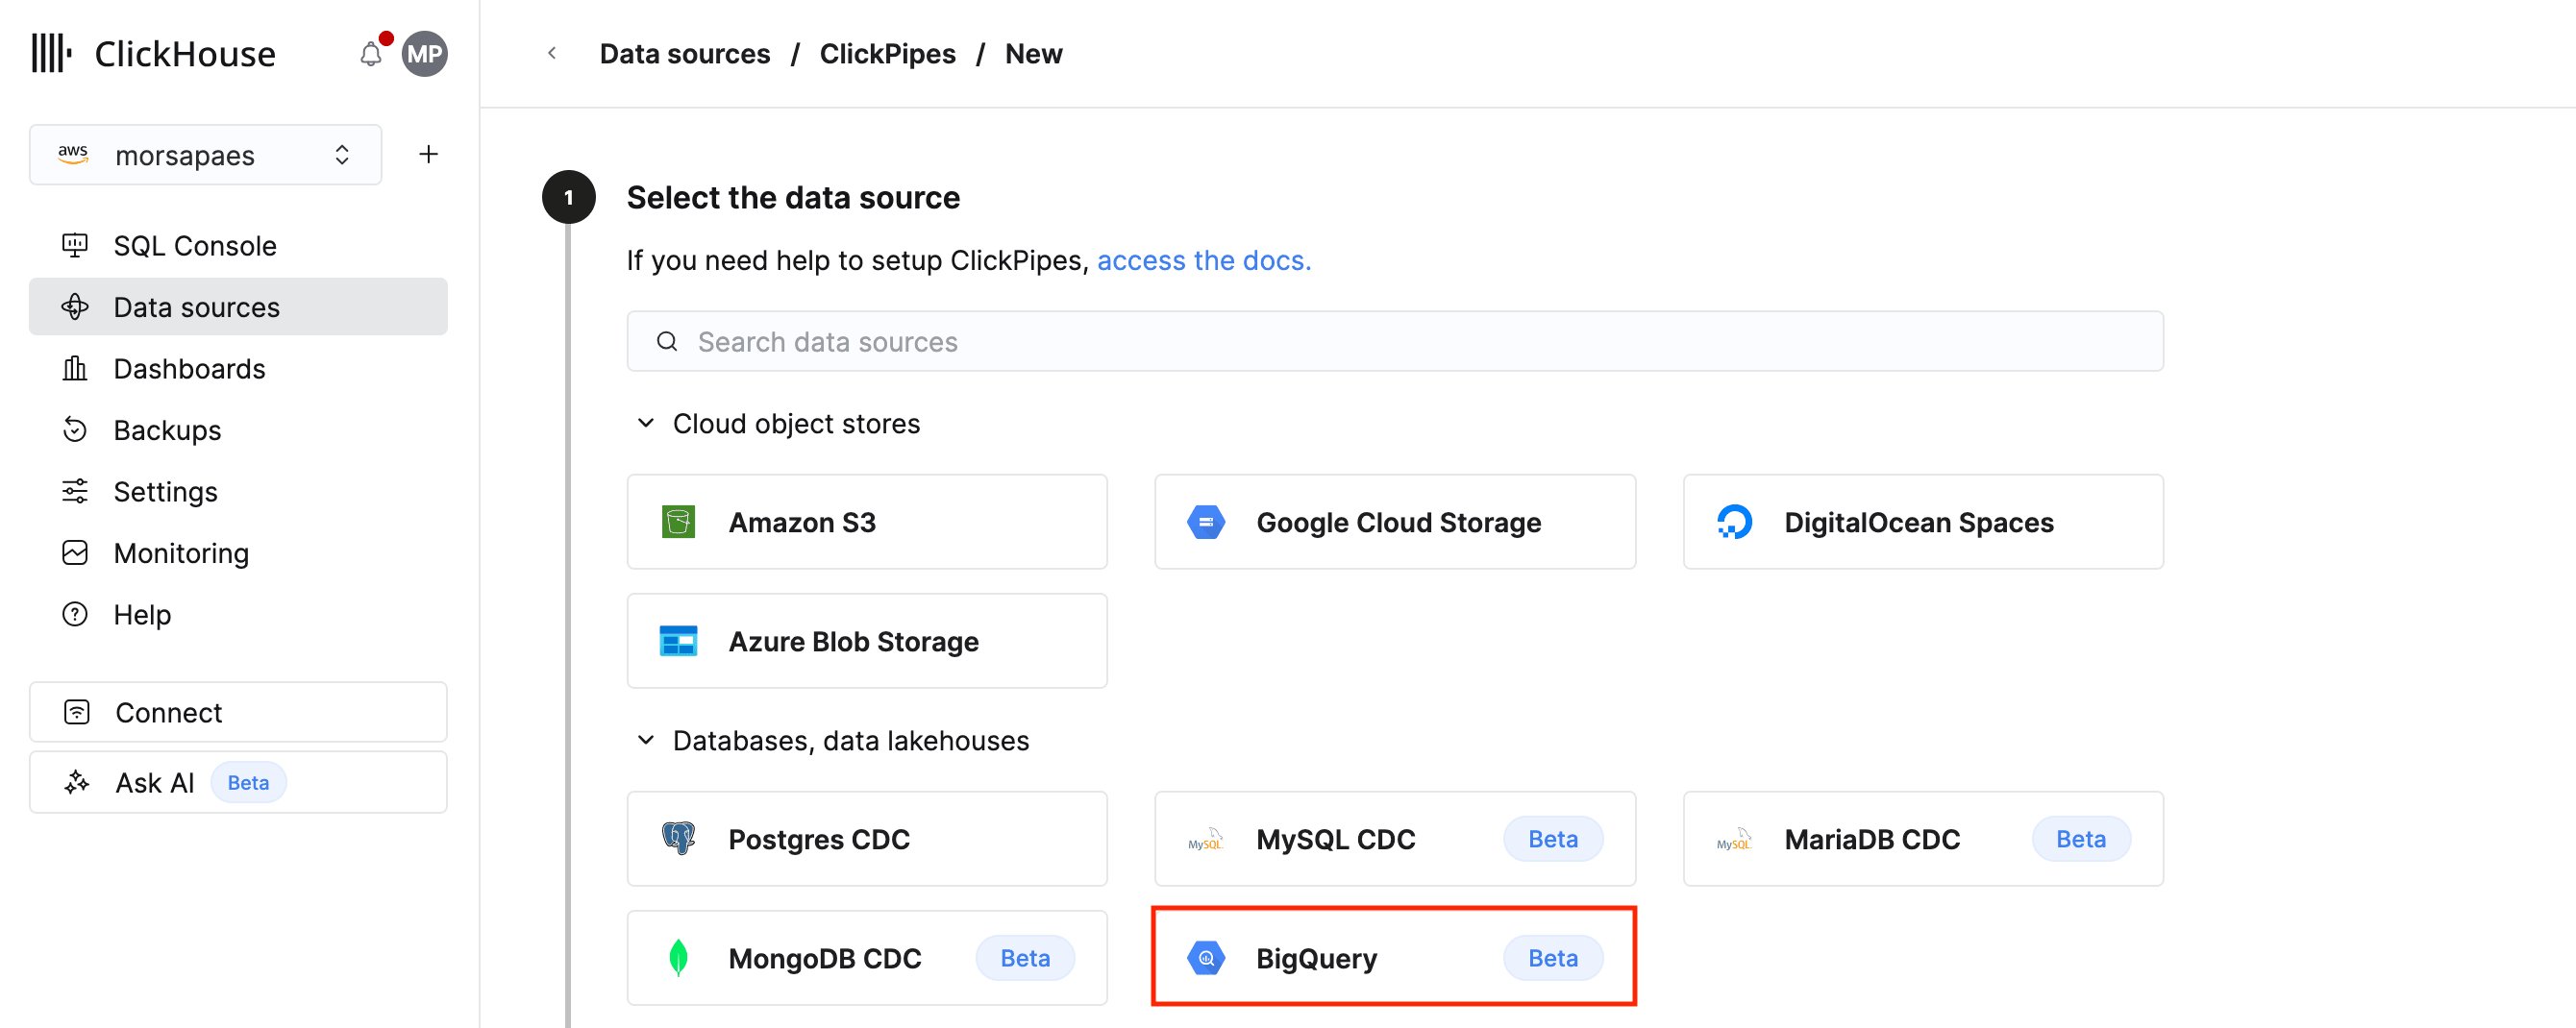
2
配置 ClickPipe 连接
提供 BigQuery 项目的连接信息。如果要执行初始加载,还需提供用于暂存数据的 GCS 存储桶。1. 上传为 ClickPipes 创建的服务账号的 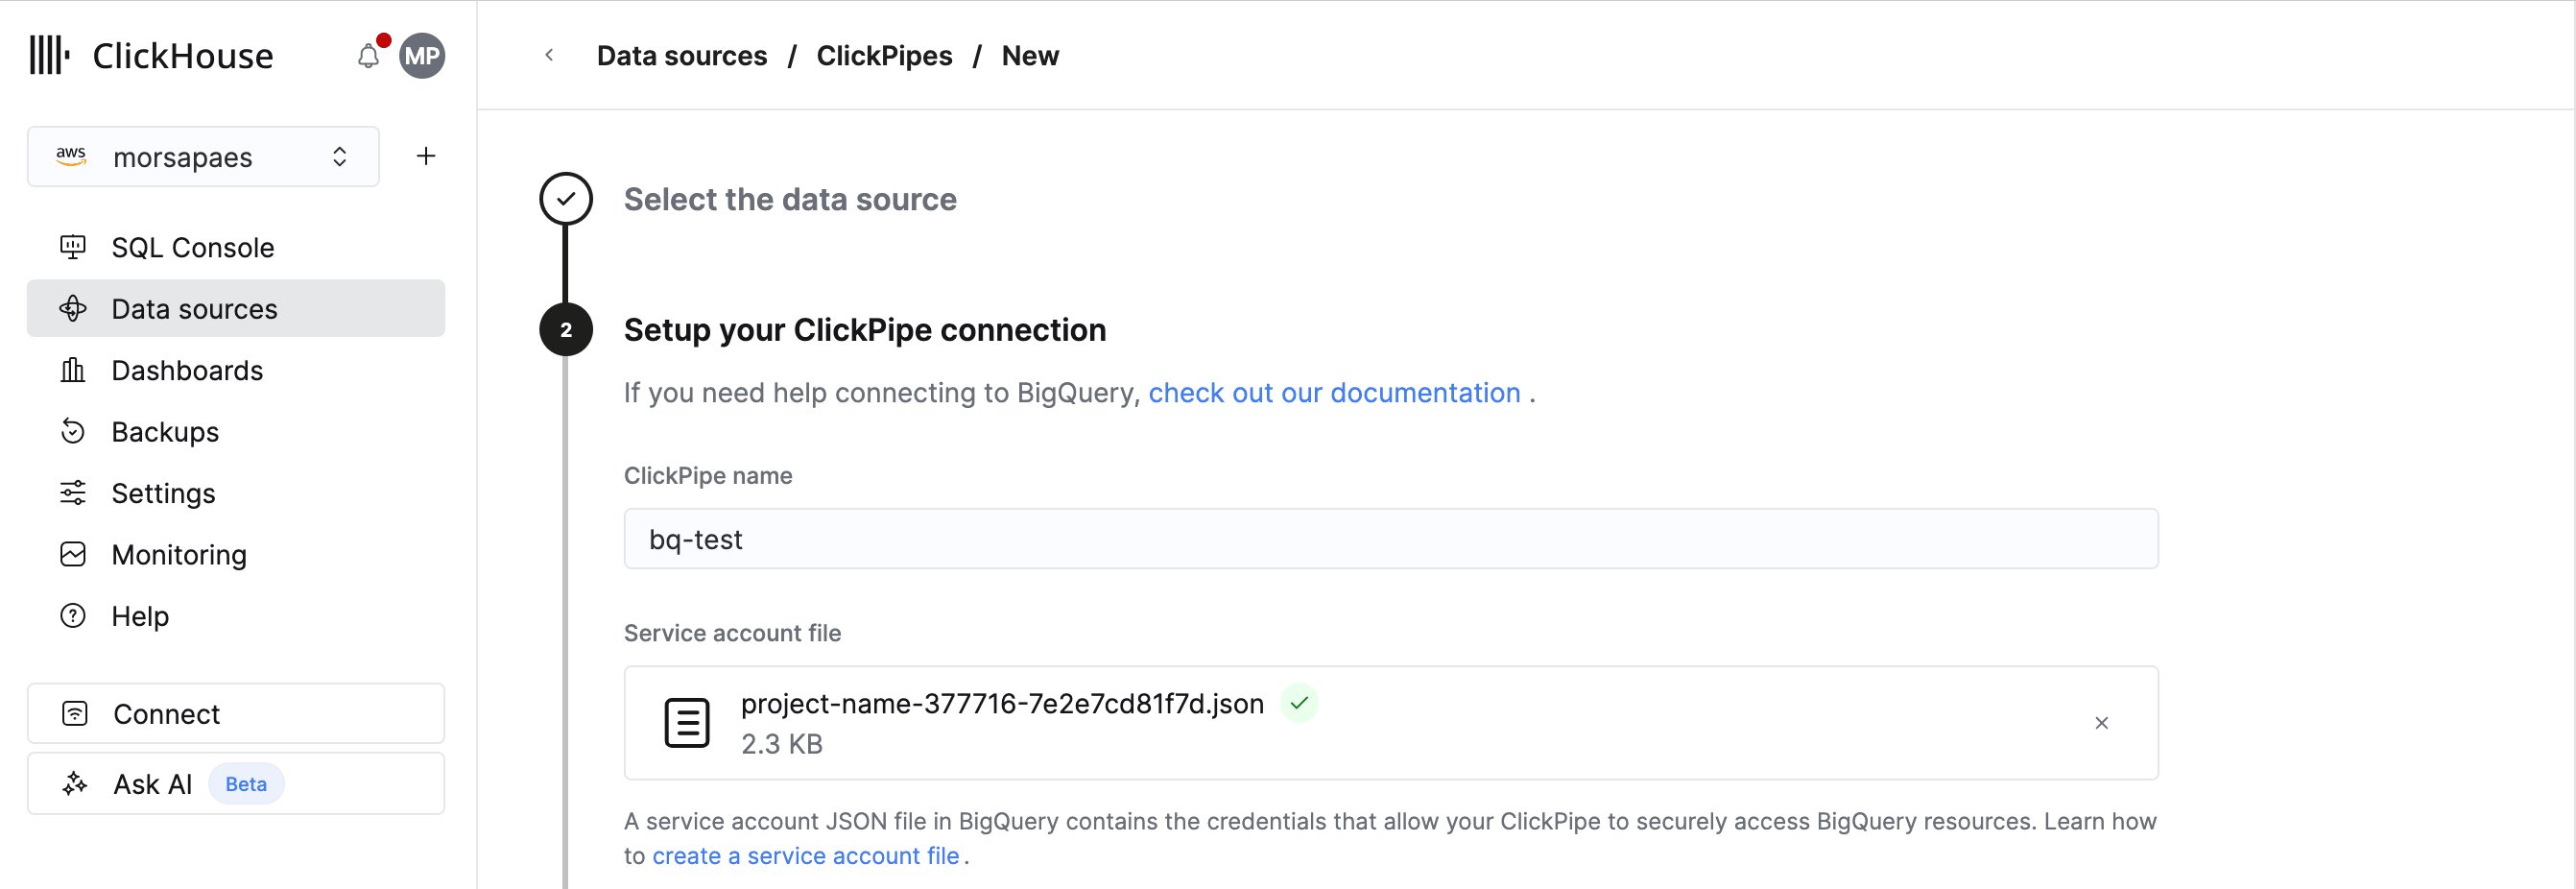
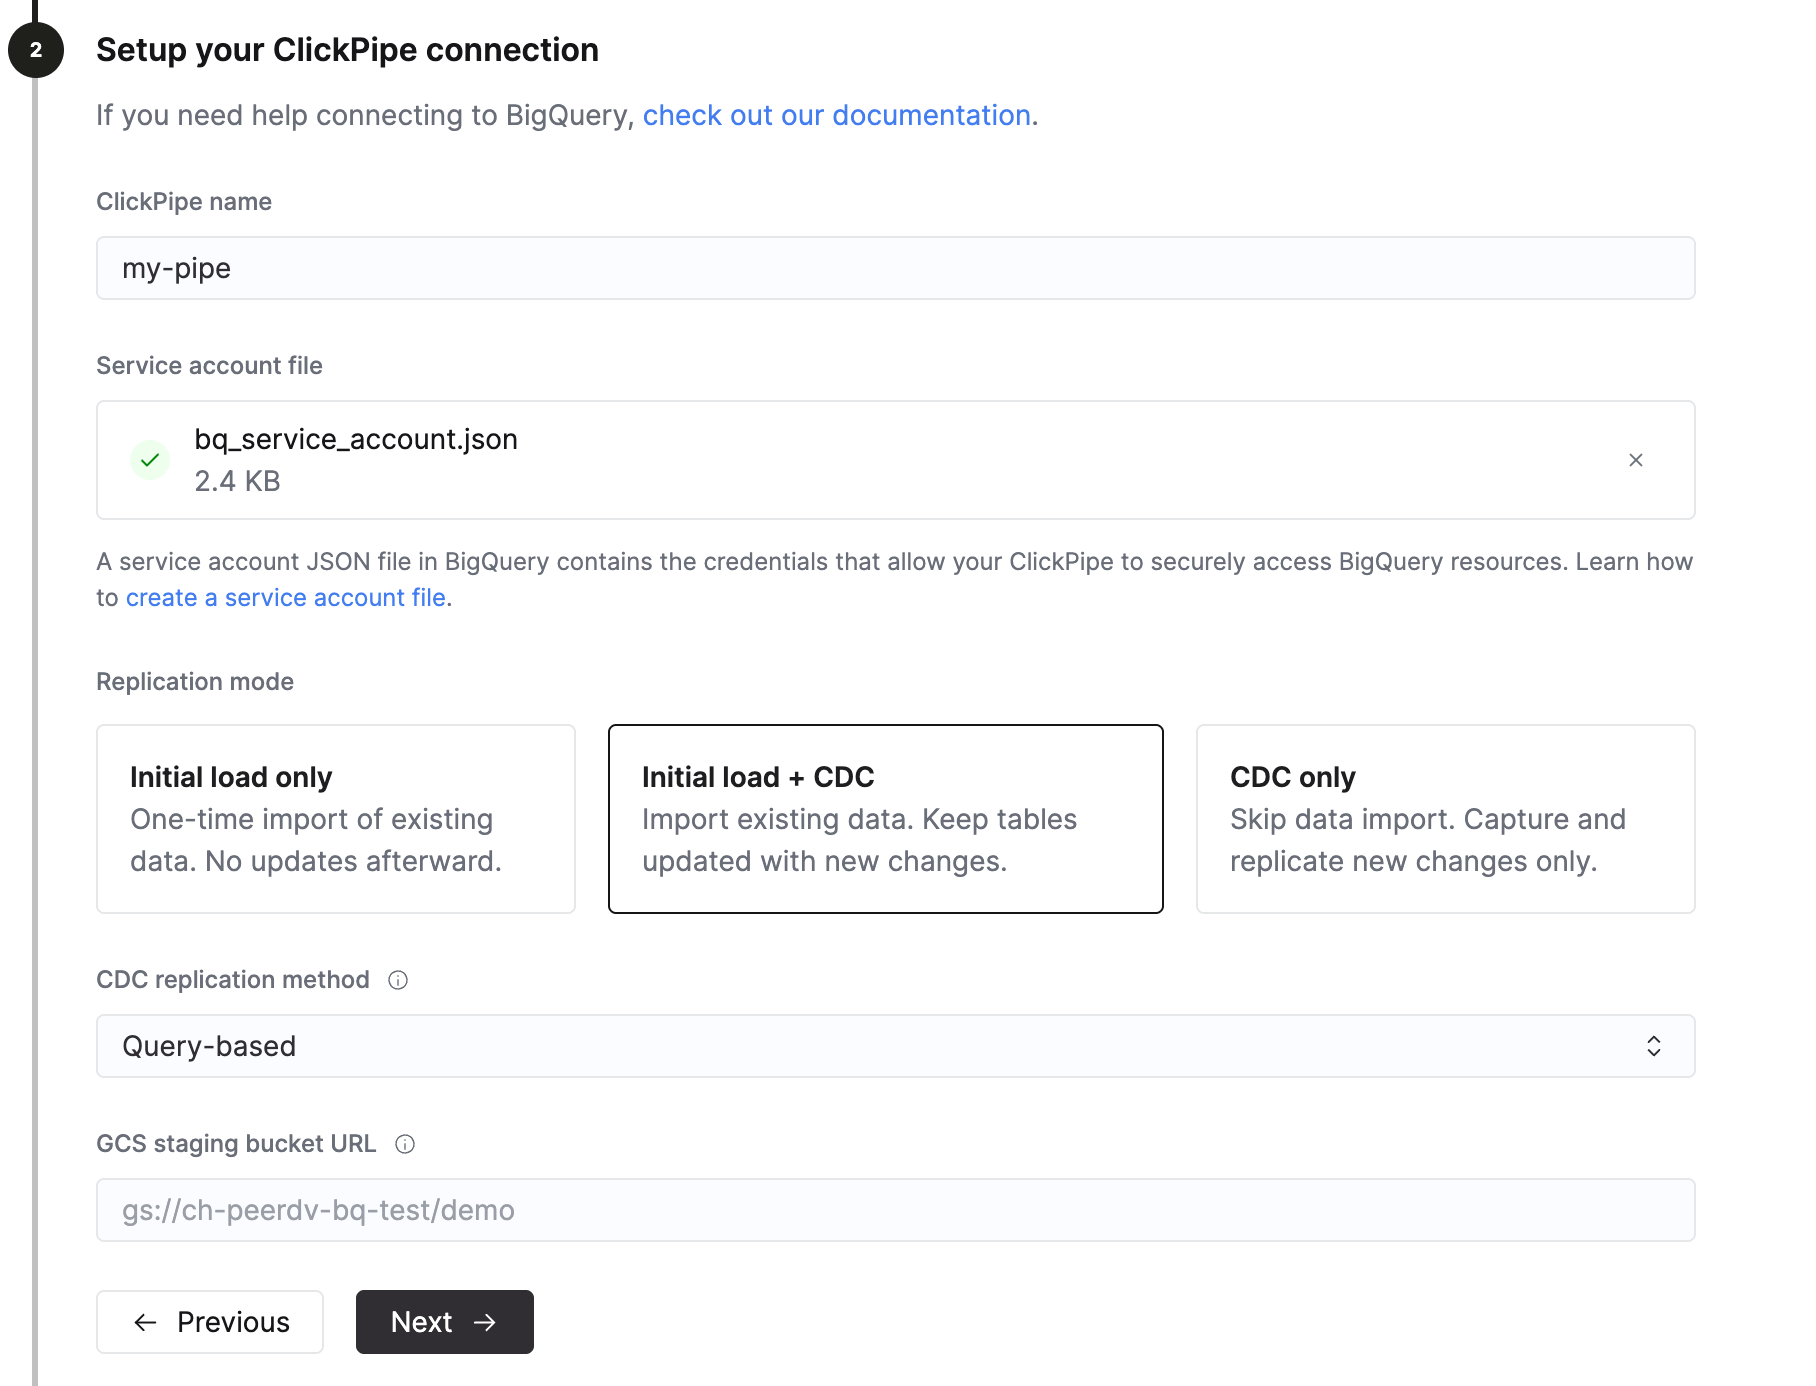
.json 密钥。确保该服务账号具有所需的最低权限。3
配置 ClickPipe
为所选阶段设置以下配置值。初始加载设置仅在 ClickPipe 导入现有数据时生效;CDC 设置仅在 ClickPipe 继续复制变更时生效。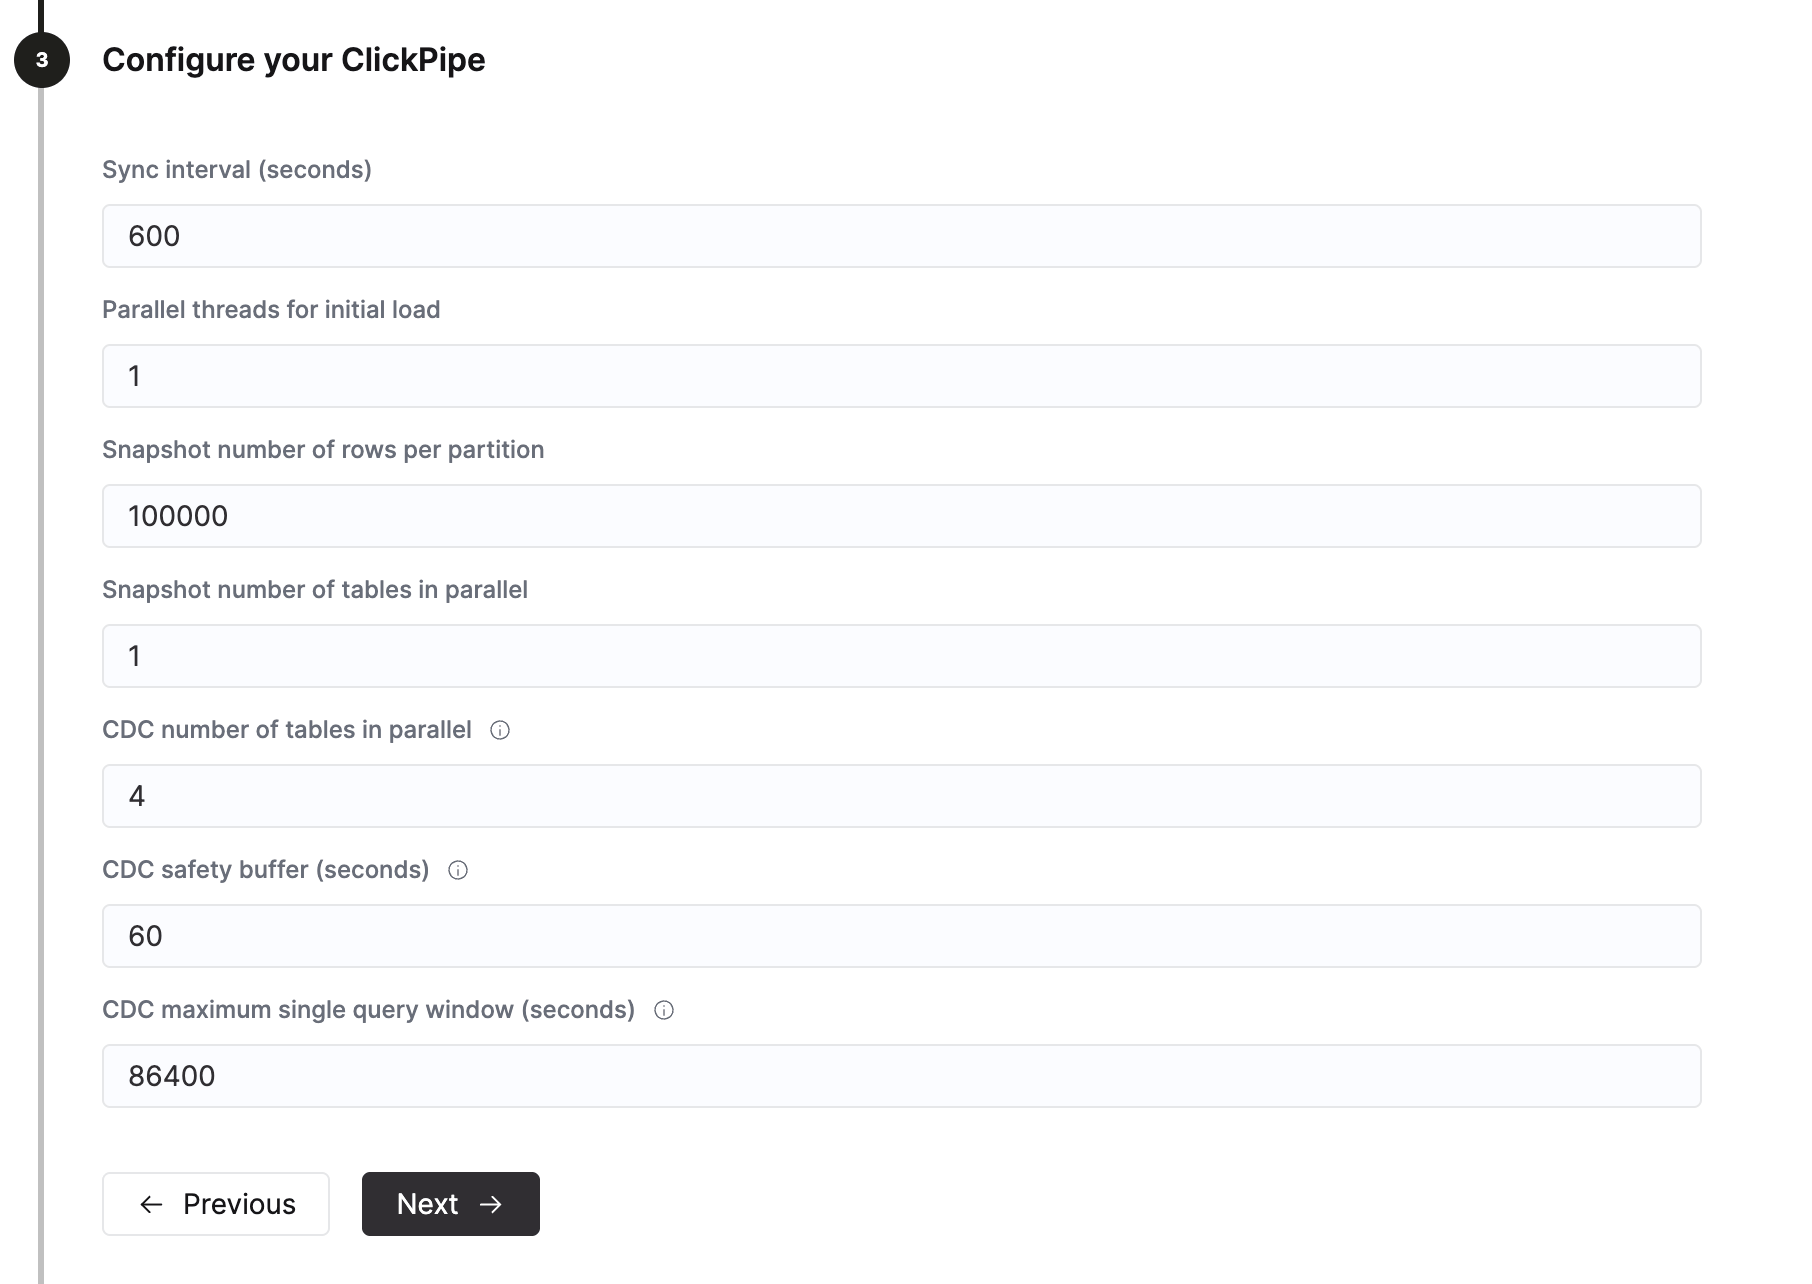
4
配置表
1. 选择用于存放 BigQuery 复制表的 ClickHouse 数据库。可以选择现有数据库,也可以创建新数据库。2. 选择源表。可以修改每个目标表的名称,并在 列设置 中选择要复制的列。列表中仅显示服务账号有权访问的数据集。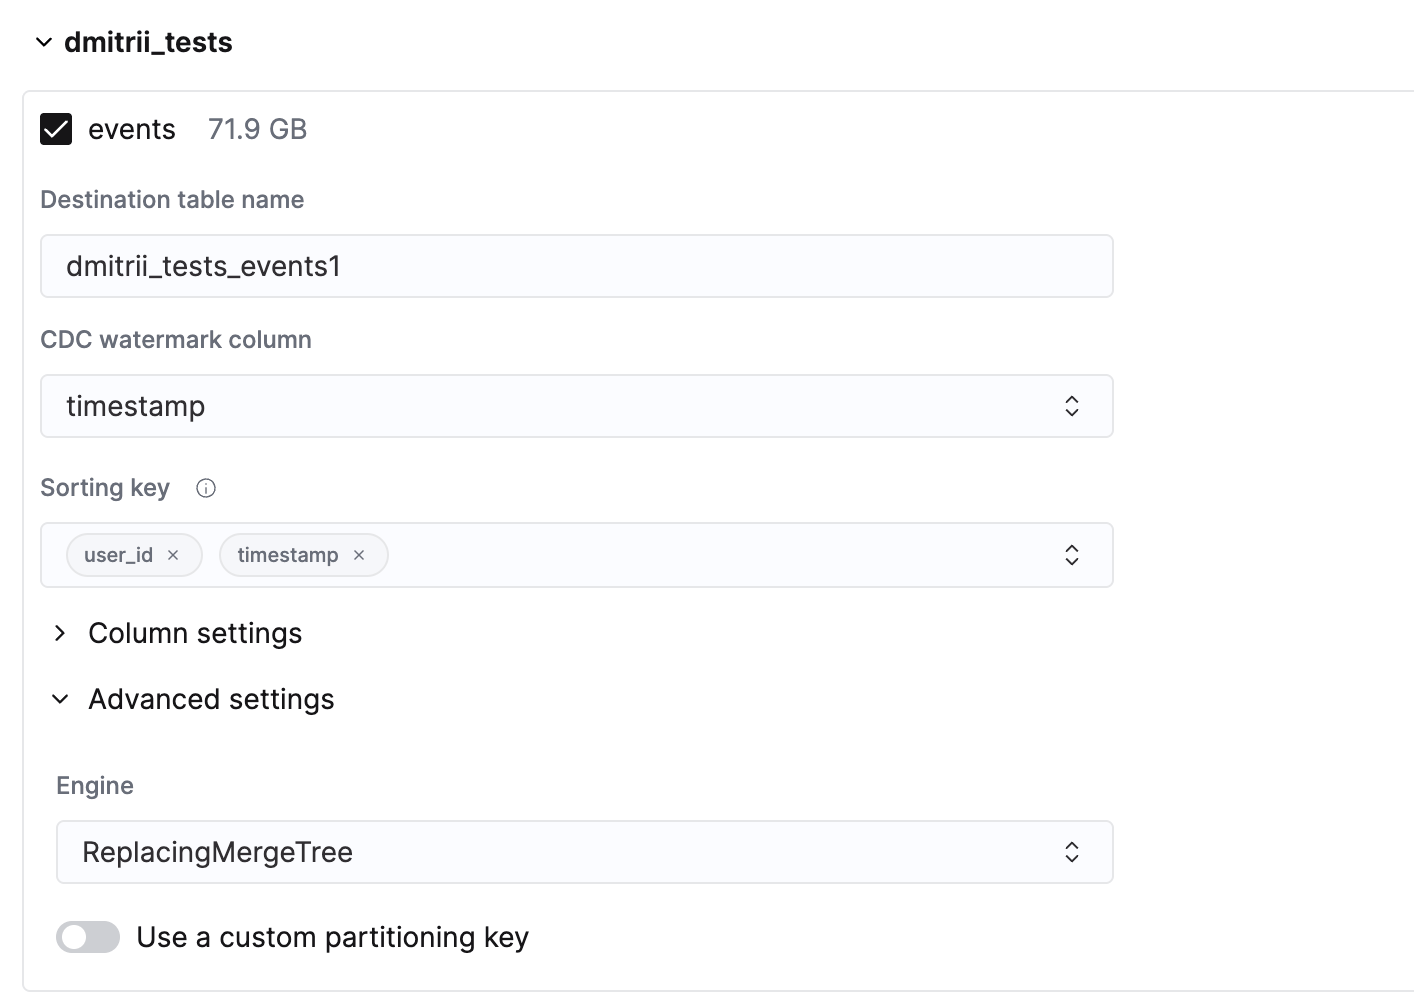
TIMESTAMP 的 CDC 水位线列,将其保留在要复制的列中,并在对应行发生变化时更新该列的值。如果使用基于事件的复制,则改为选择 APPENDS 或 CHANGES。使用 CHANGES 时,源表必须设置 enable_change_history = TRUE。4. 检查 Sorting key。如果行可能被更新或删除,请选择能够标识每一行且值保持不变的列。使用 CHANGES 时,源表必须有主键,否则必须在此处设置 sorting key。ClickHouse 使用 sorting key 组织数据,以便执行查询;如果未设置,则使用 tuple(),且不会建立主索引。5. 打开 高级设置,选择 ClickHouse 表的 引擎,或为初始加载指定可选的分区键。此分区键不会设置目标表的 PARTITION BY 表达式。5
配置权限
最后,您可以为 ClickPipes 内部用户配置权限。权限:ClickPipes 会创建一个专用用户,用于向目标表写入数据。您可以为该内部用户指定自定义角色,也可以选择以下预定义角色之一:
Full access:拥有集群的完全访问权限。如果目标表使用 materialized view 或字典,则必须选择此角色。Only destination:仅拥有向目标表插入数据的权限。
6
完成配置
点击 Create ClickPipe 完成设置。页面随后会跳转至概览页,您可以在这里查看初始数据加载进度,并点击查看 BigQuery ClickPipes 的详细信息。