

pg_stat_ch,
这是一个开源的 Postgres 扩展,会将每条语句的计数器流式传输到
ClickHouse Cloud。遥测数据会在离开 Postgres 之前于数据库内部完成归一化
—— 字面量会被移除并替换为占位符,因此你查询的
确切值绝不会进入遥测流。
打开 Query insights
在 Cloud 控制台中打开你的 ClickHouse Managed Postgres 实例,然后点击 左侧边栏中的 Query insights。该页面分为五个 区域,顺序与实际使用流程一致:- 一个可在单屏内完成数据库健康检查的 概览。
- 一个 慢查询模式 表,对数据库运行过的每种查询模式进行排名, 并可按你怀疑有问题的维度排序。
- 一个 最近查询 面板,按时间倒序列出每次单独执行的查询。
- 一个 Waits 表,按活跃会话的耗时对各等待事件 进行排名。
- 一个 详情弹出面板,汇总单个模式的所有计数器。
概览
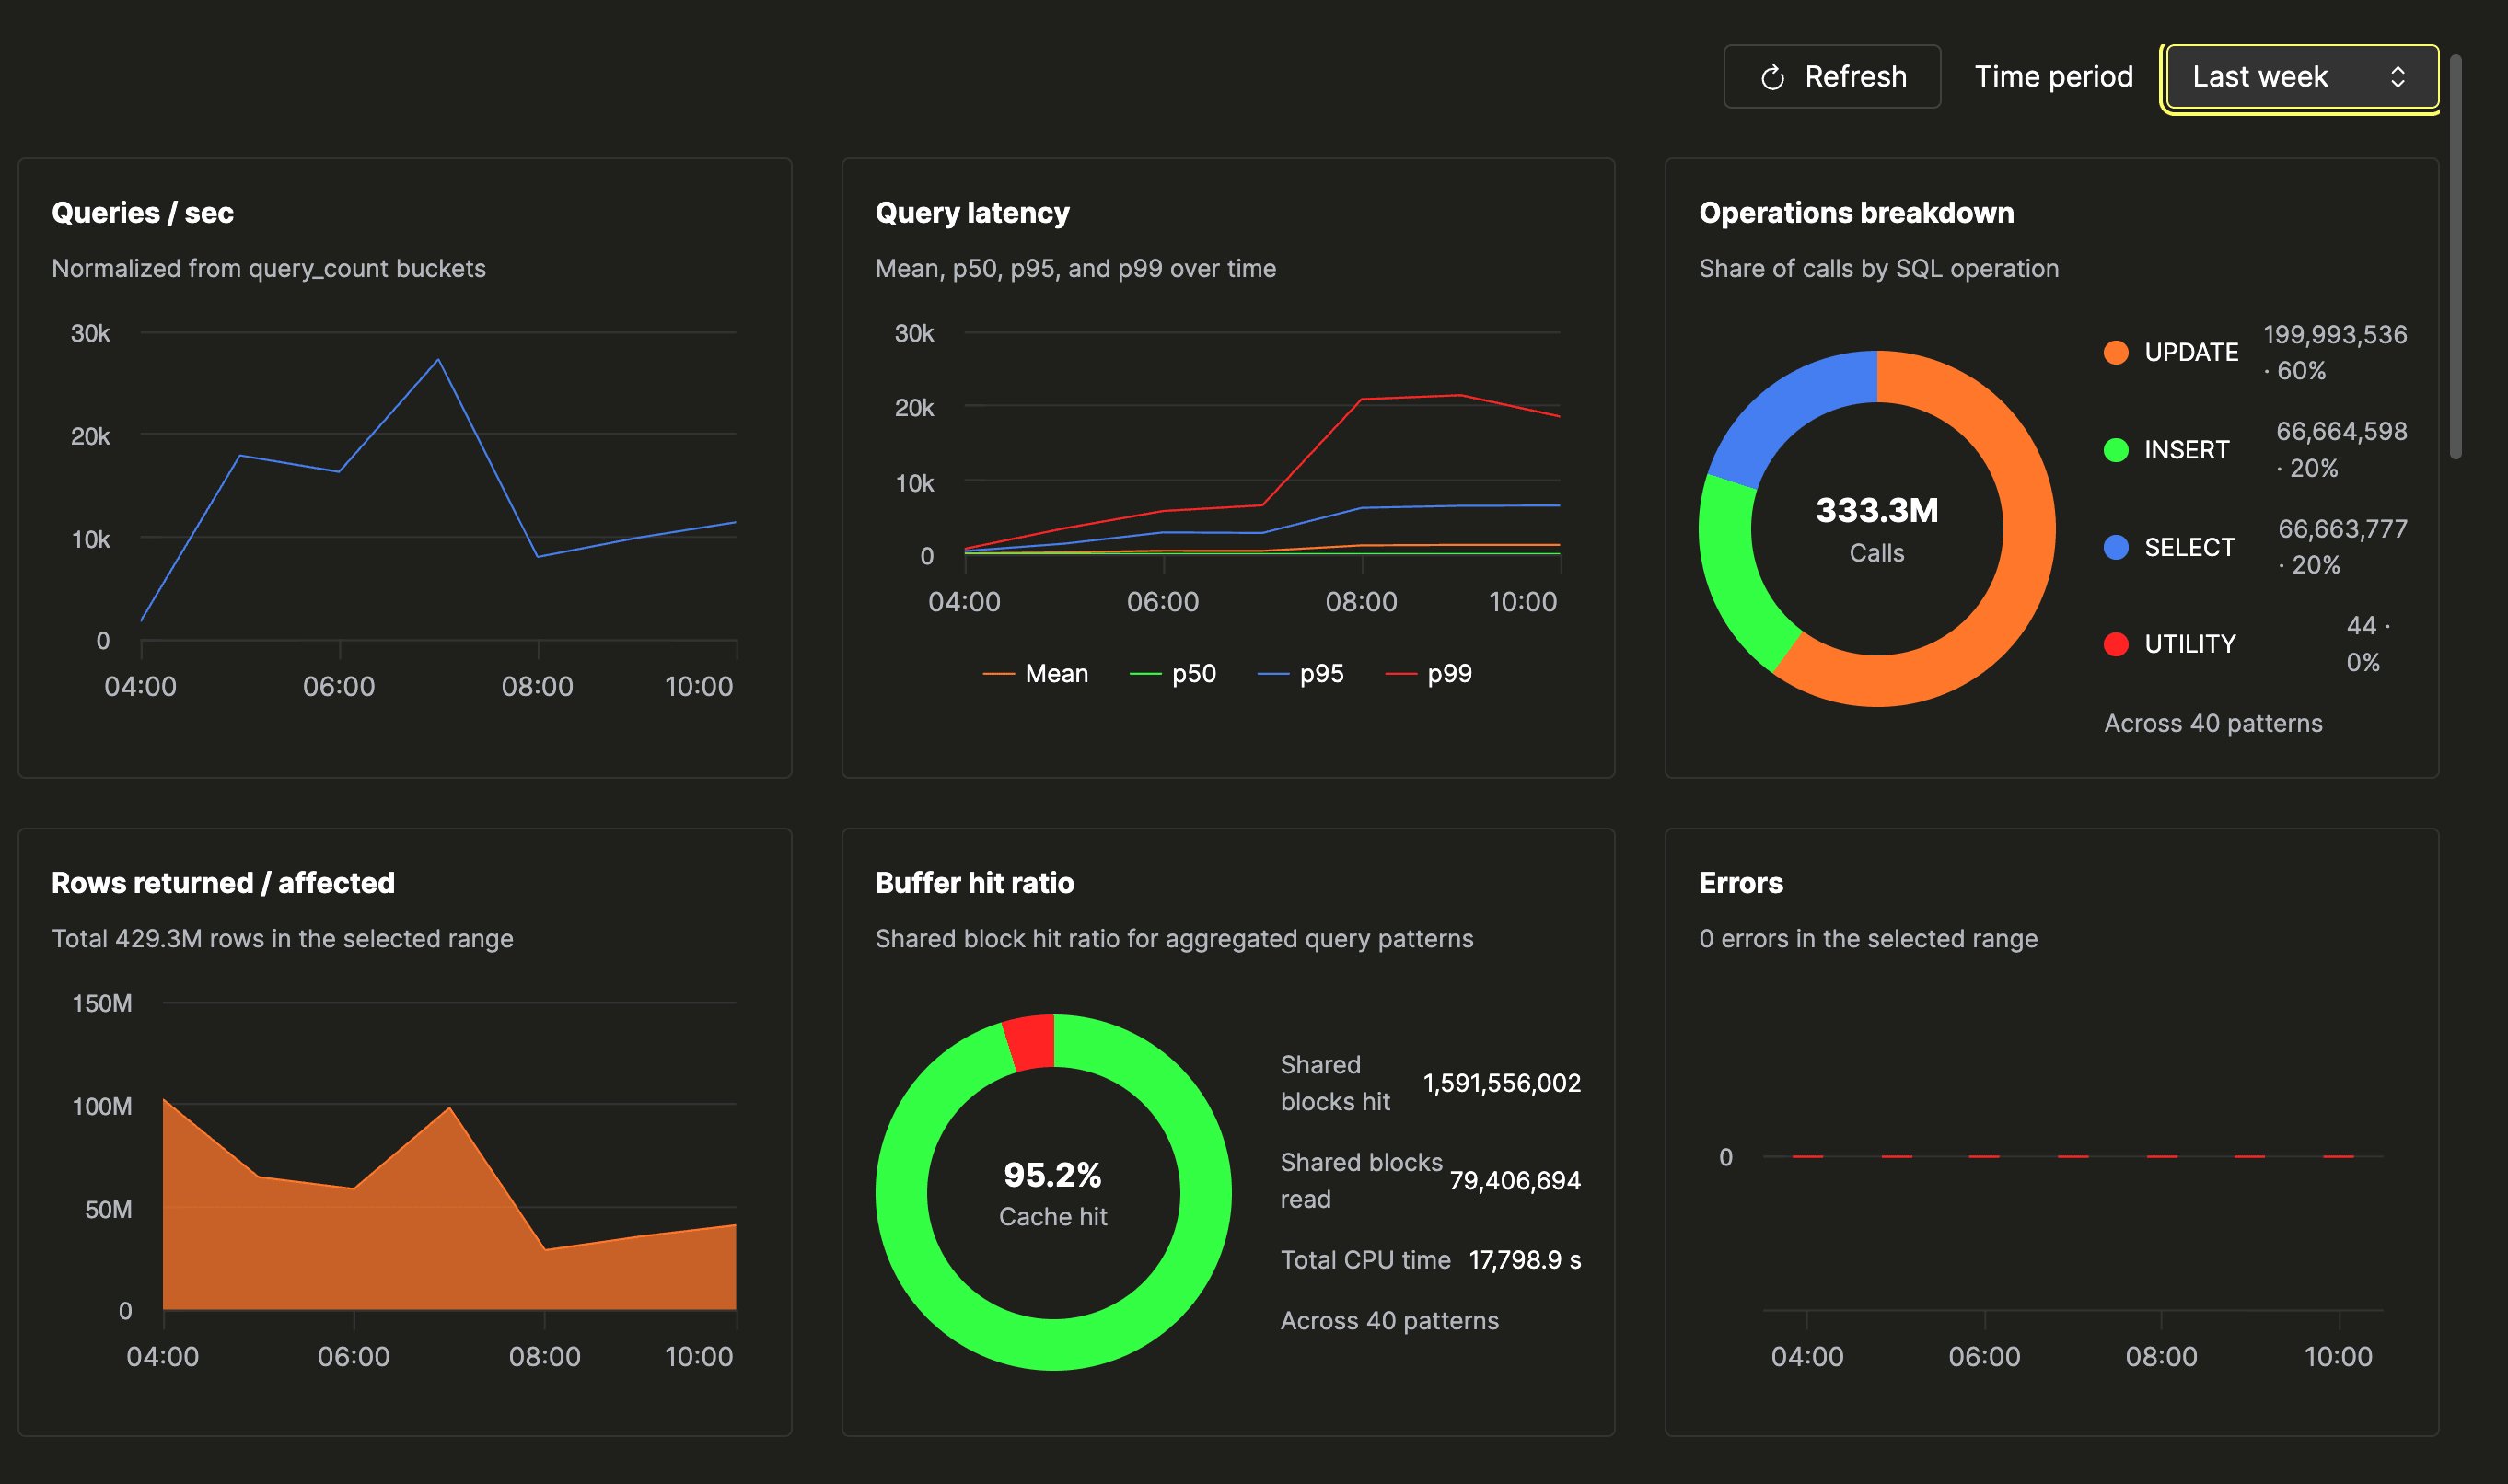
概览由 9 个面板组成,以 3×3 网格显示。前两行涵盖 查询活动:
看这一屏就能判断数据库是否健康。健康的实例
通常会呈现出一种熟悉的特征——缓冲区命中率维持在 90% 多的高位,查询量
随应用流量同步变化,错误率持平或为零,各个百分位
延迟彼此贴近。
等待图表
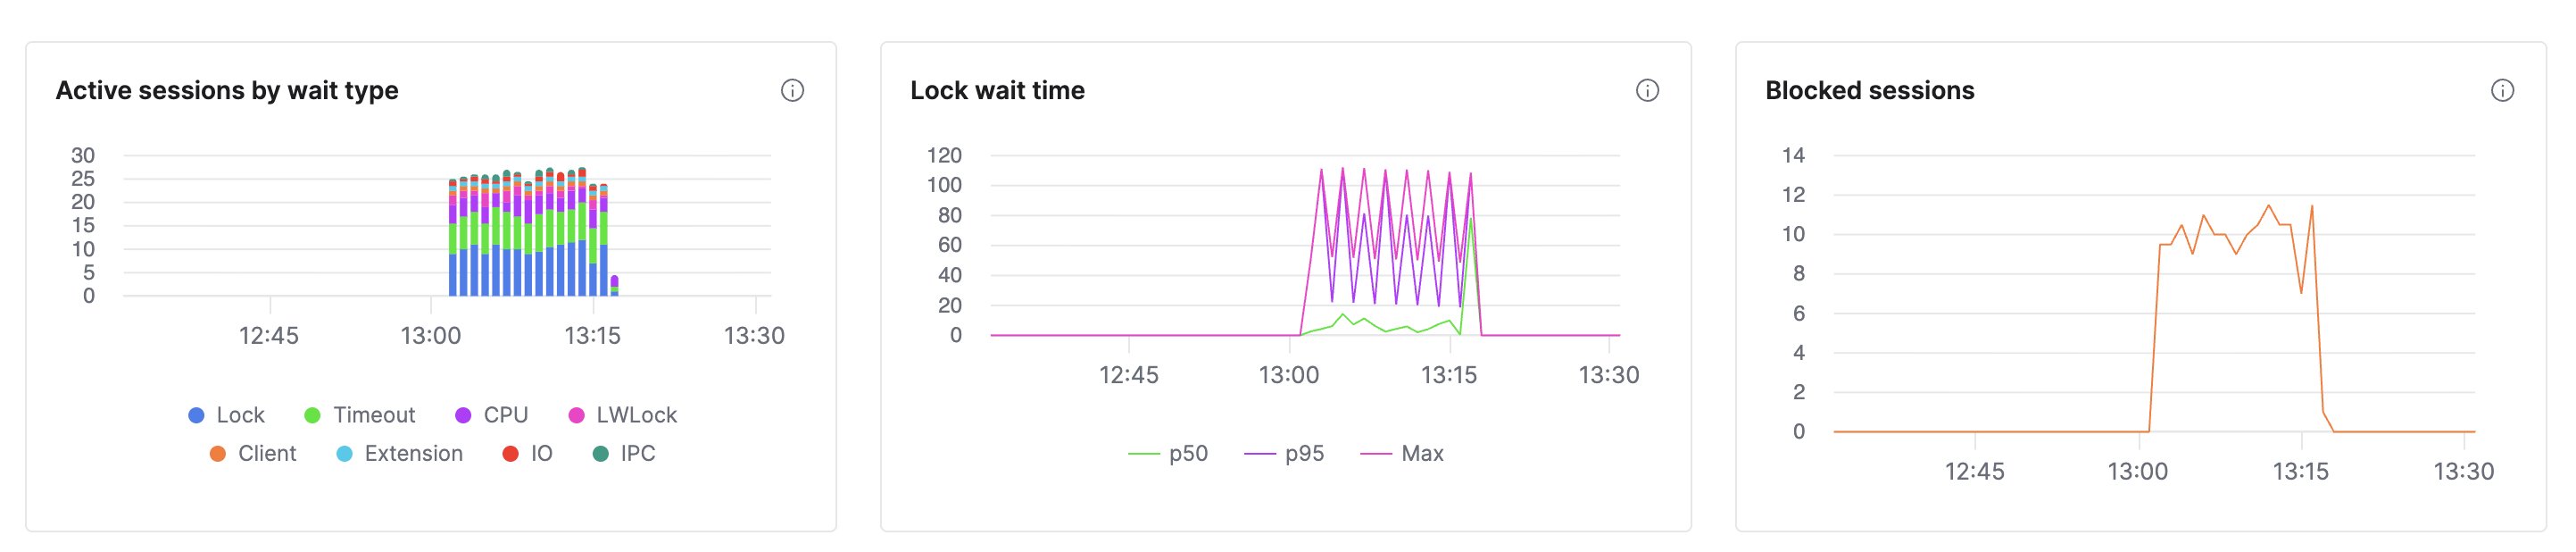
第三行展示主节点上的活跃会话在等待什么,数据来自每 30 秒采集一次的样本:
如果 Blocked sessions 持续高于零,同时 Lock wait
time 不断上升,则可能表明存在持续的锁争用。点击任意等待图表即可打开 Waits 表。
慢查询模式
当概览显示存在问题时,模式表就是调查的起点。每个归一化查询模式各占一行,字面量值已被去除,因此同一语句的多次执行都会归并到同一行。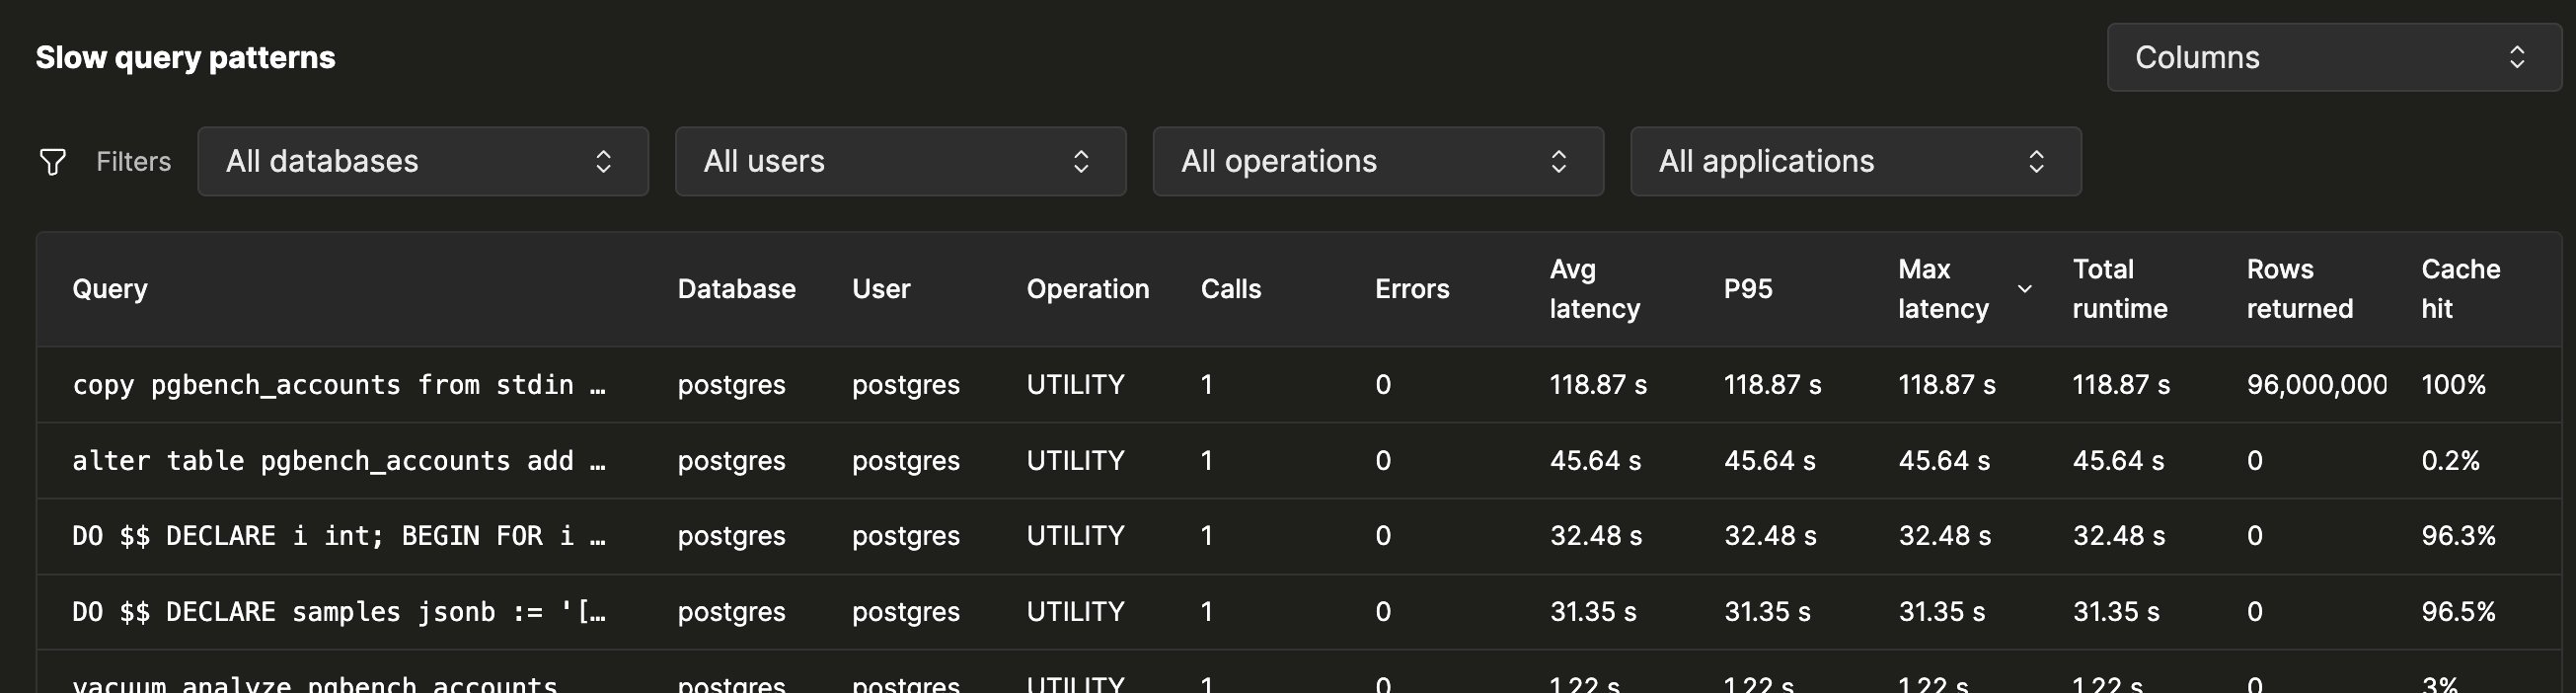
- 总运行时间 — 数据库花费挂钟时间最多的地方。
- CPU 时间 — 计算开销大的模式。
- 调用次数 — 高频模式。
- 错误 — 反复出现的失败。
- 平均值 / P50 / P95 / P99 / 最大延迟 — 按百分位查看离群值。
- 返回行数、读取块数、命中块数、WAL 字节数 — 通过引擎、缓存或预写日志传输数据量最多的模式。
- 数据库
- 用户
- 操作 (
SELECT,INSERT,UPDATE,DELETE, …) - 应用程序 — 连接字符串中的
application_name
sales db 上执行了什么操作”
就对应两个下拉菜单。过滤值会根据你的实例实际运行过的内容自动填充。
最近查询
在模式表下方,最近查询面板会按时间倒序列出每一次单独的 执行——每个已执行的 SQL 语句占一行,而不是每个模式占一行。当你想查看原始事件 流而非聚合结果时,就可以使用它;例如,可用来抽查某项修复是否已生效, 或找出错误发生的确切时刻。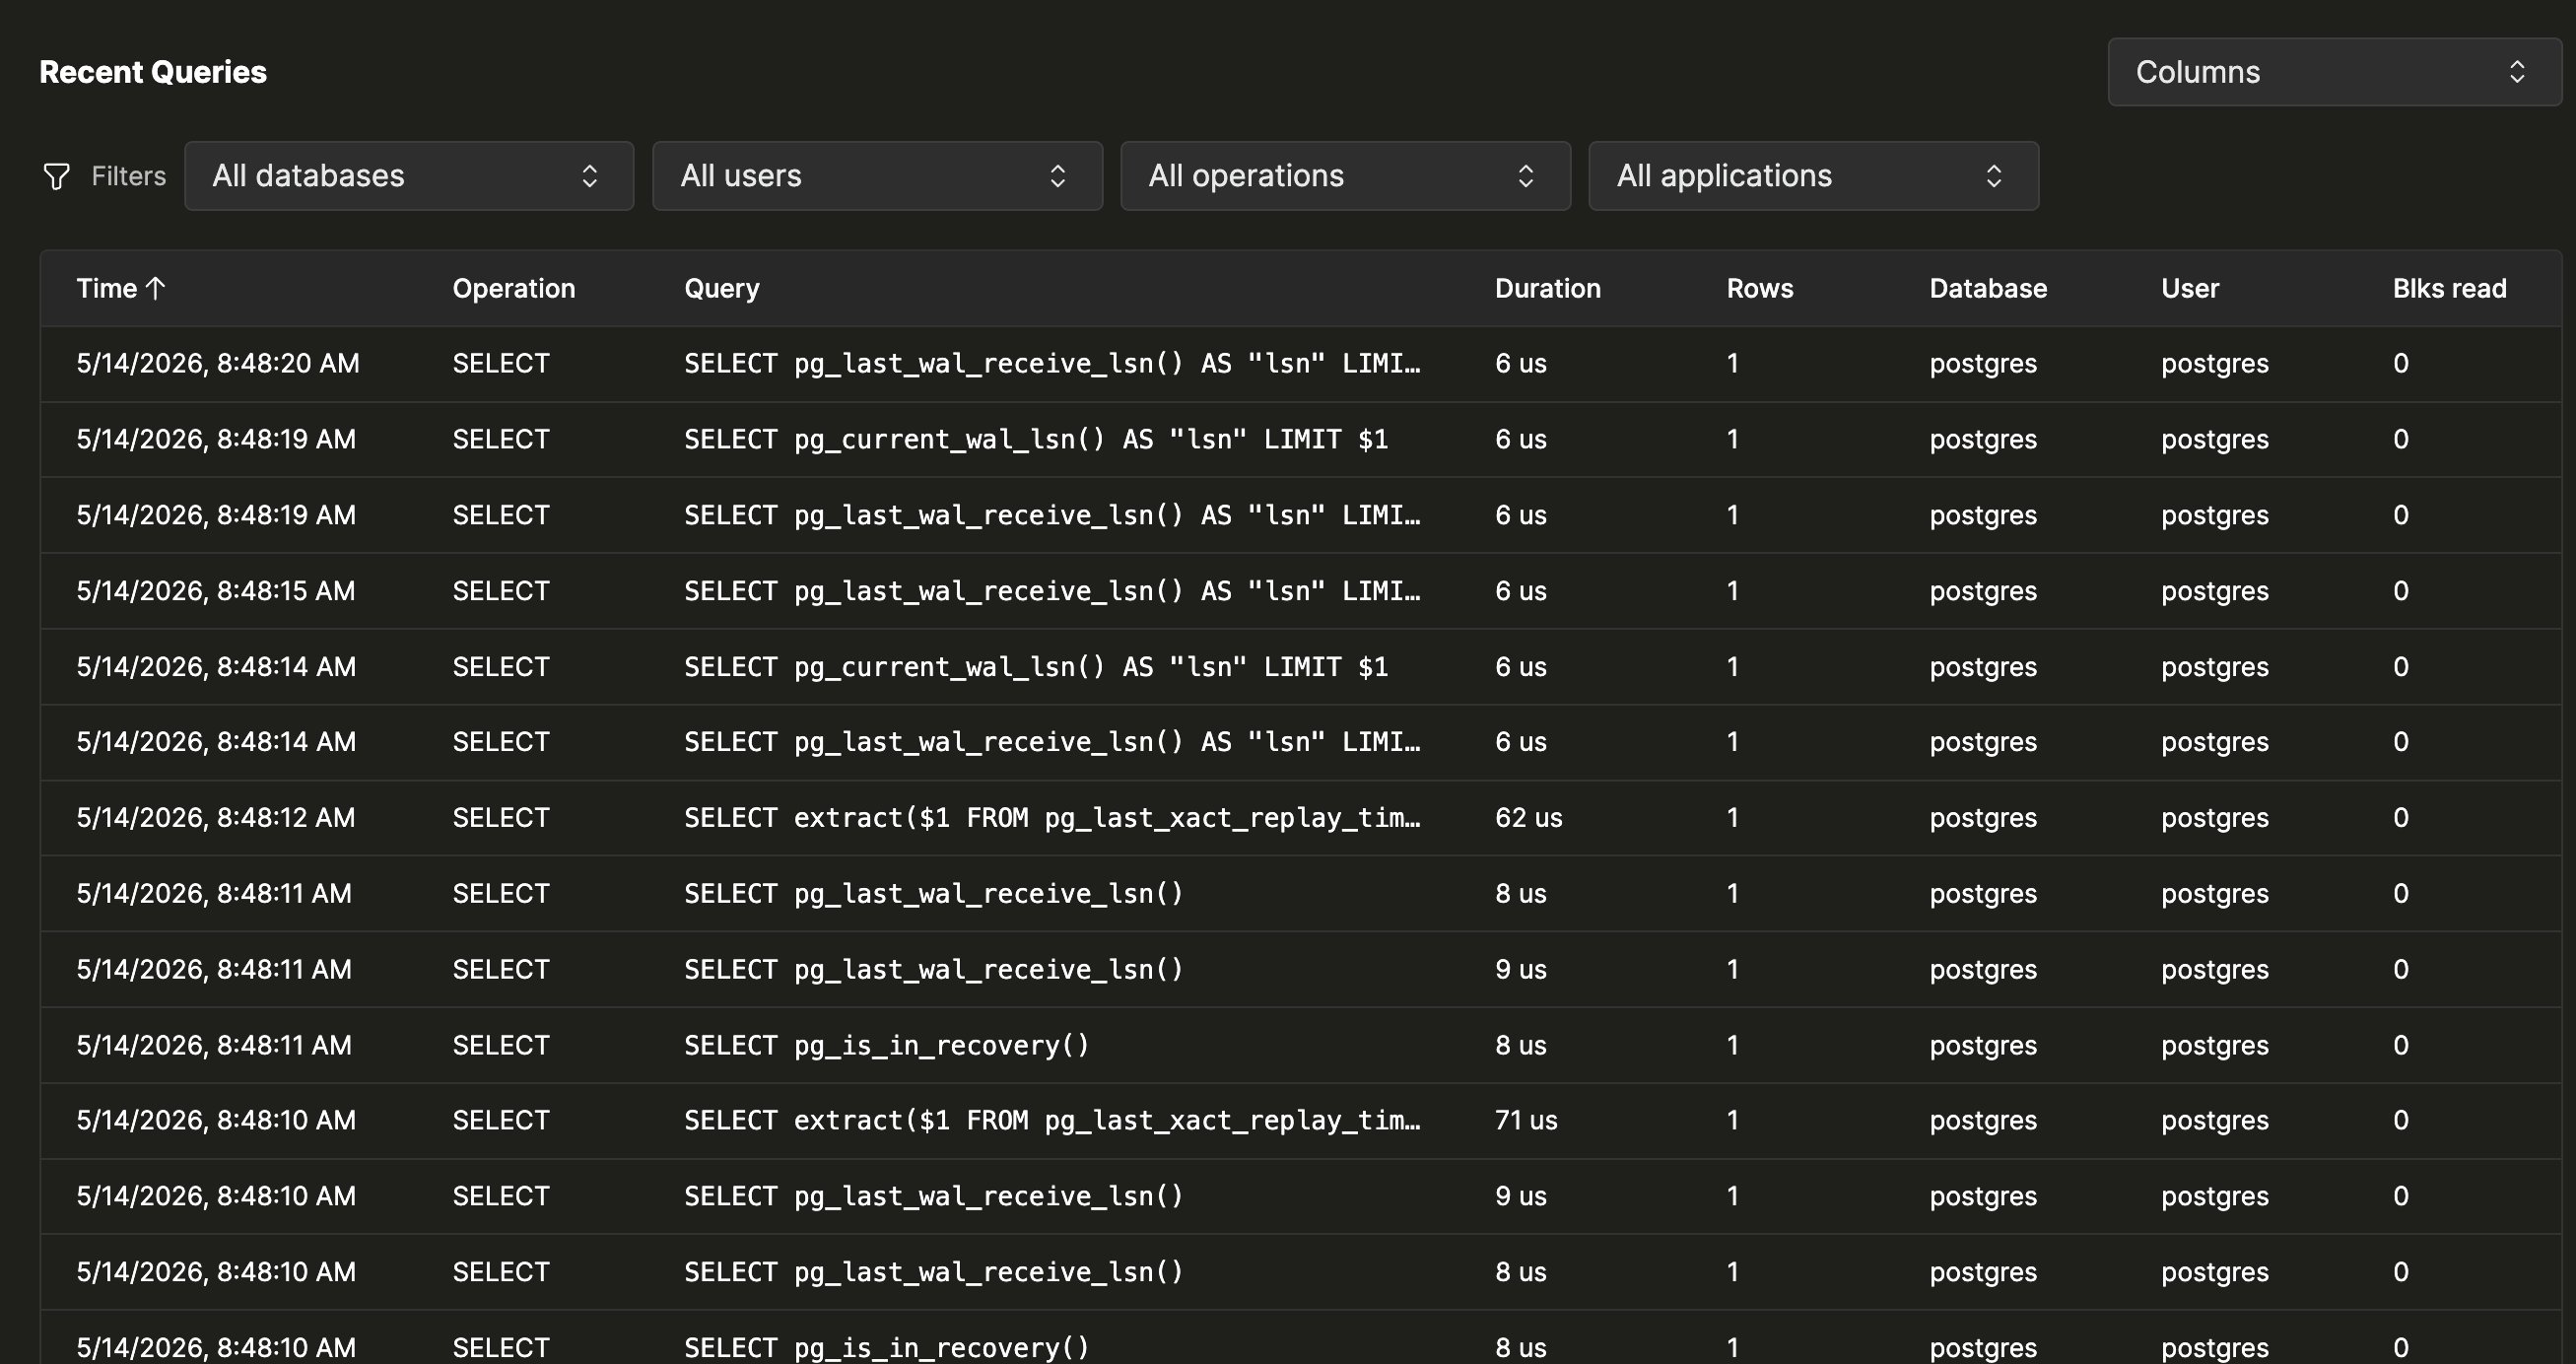
等待
展开 Waits,或点击任一等待图表,即可查看所选时间范围内按平均活跃会话数排序的等待 事件。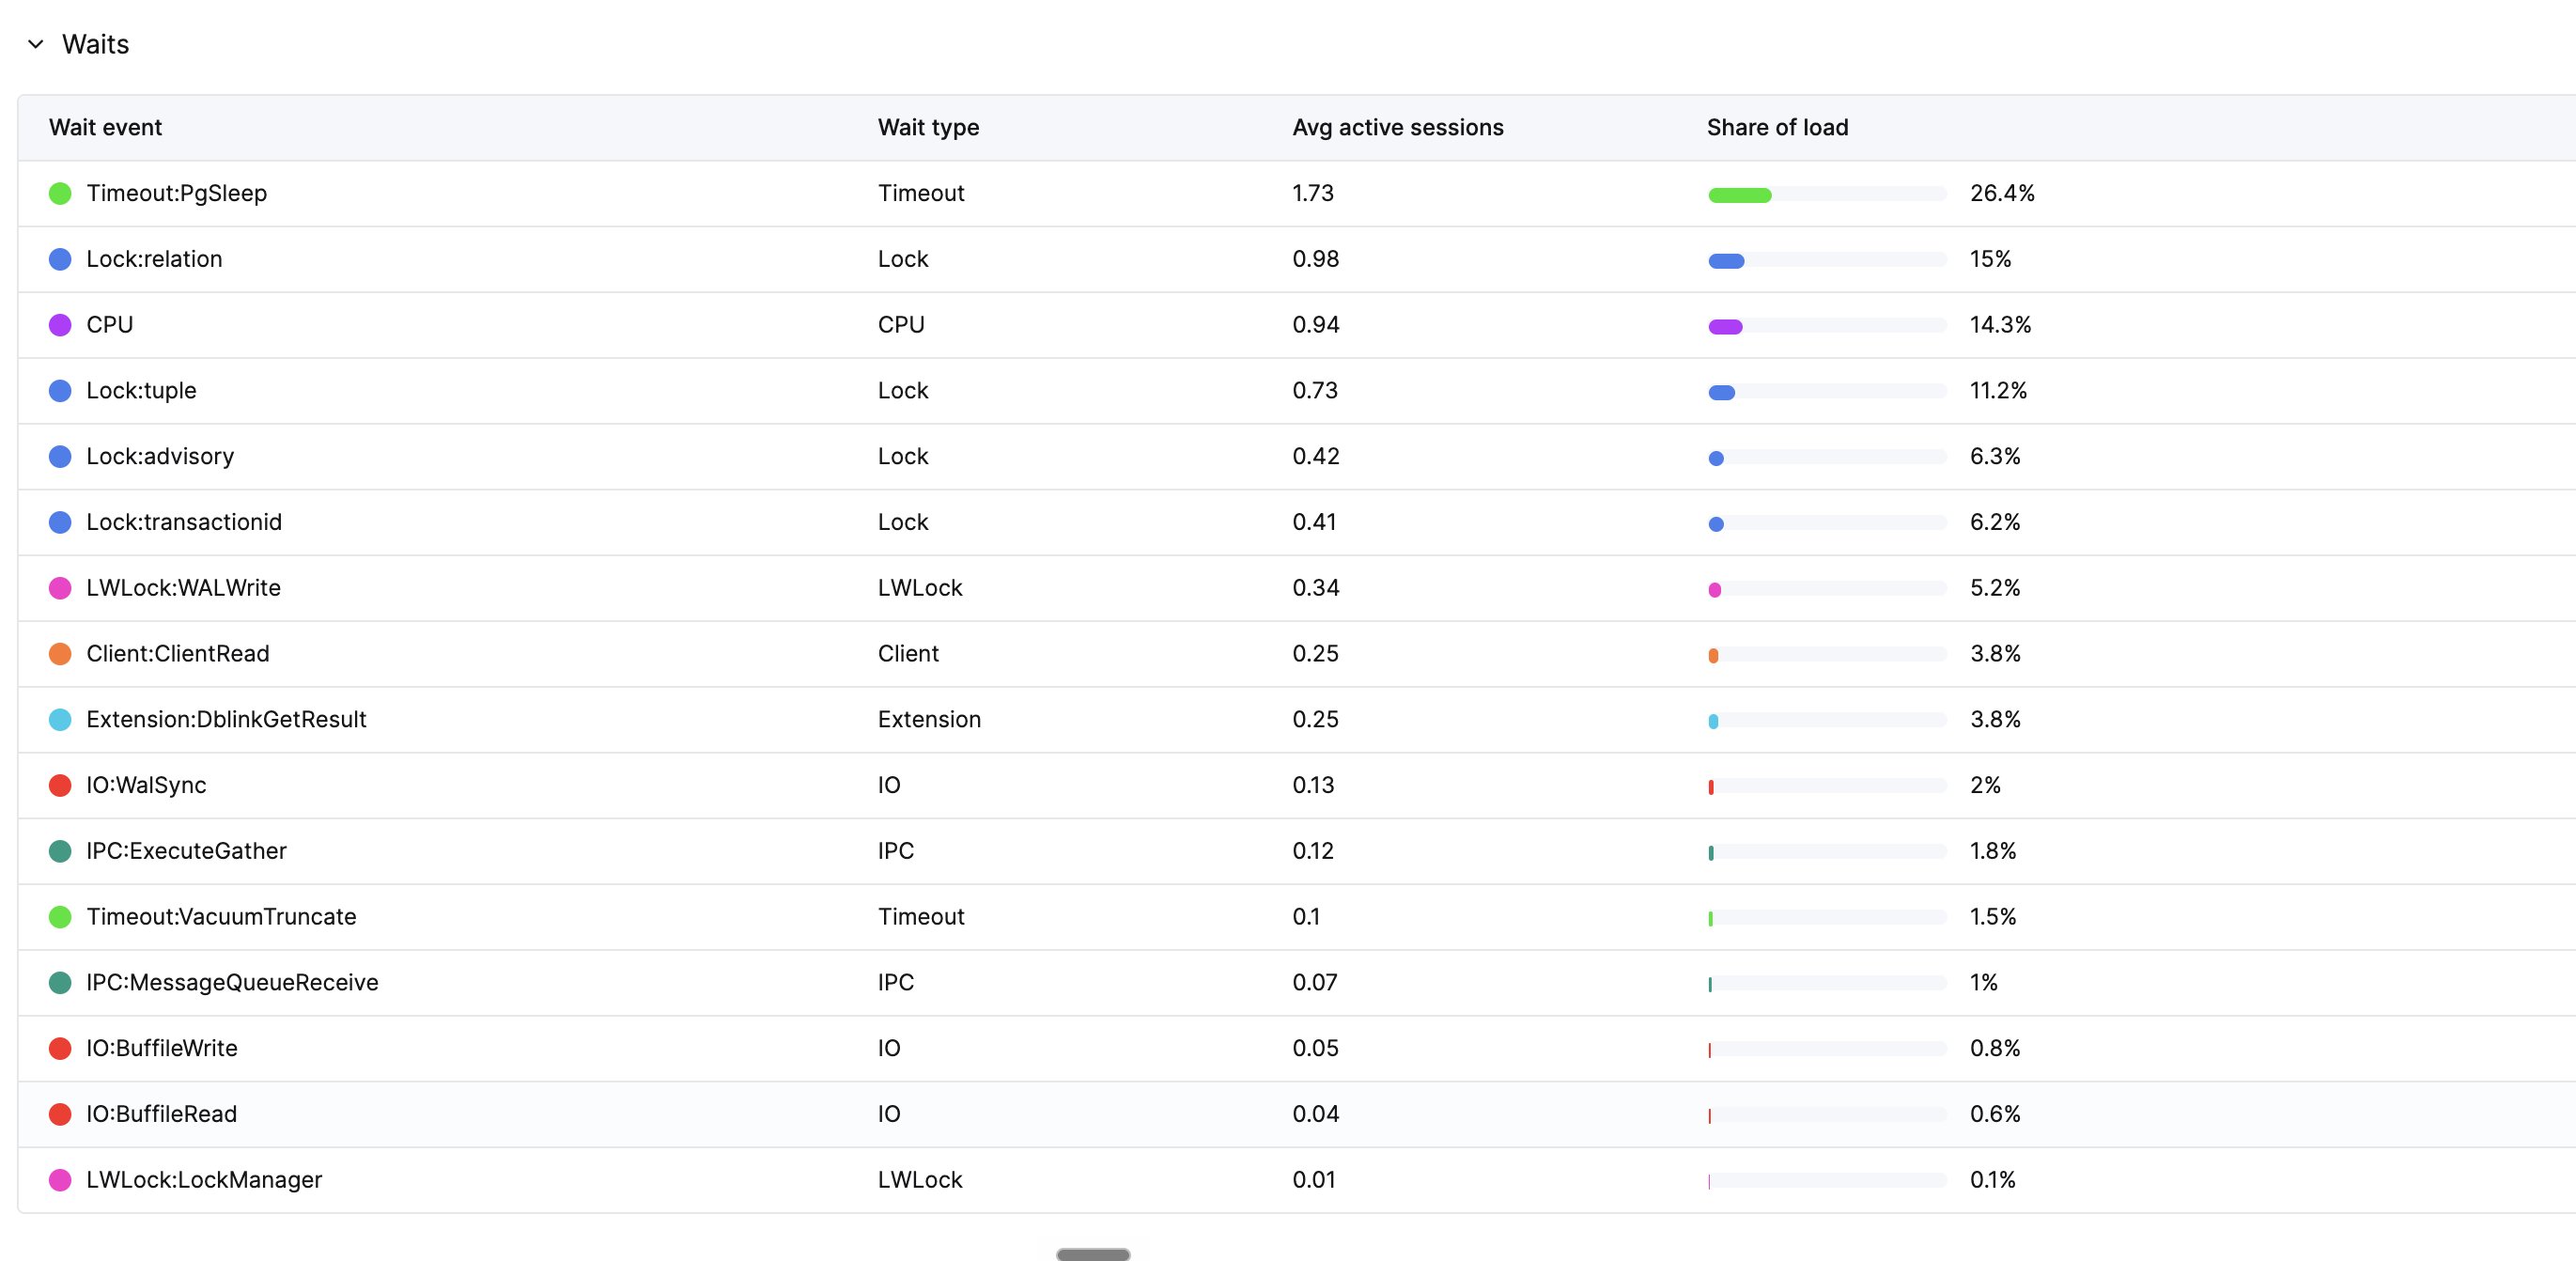
有关各事件的说明,请参阅
Postgres 等待事件参考文档。
详情弹出面板
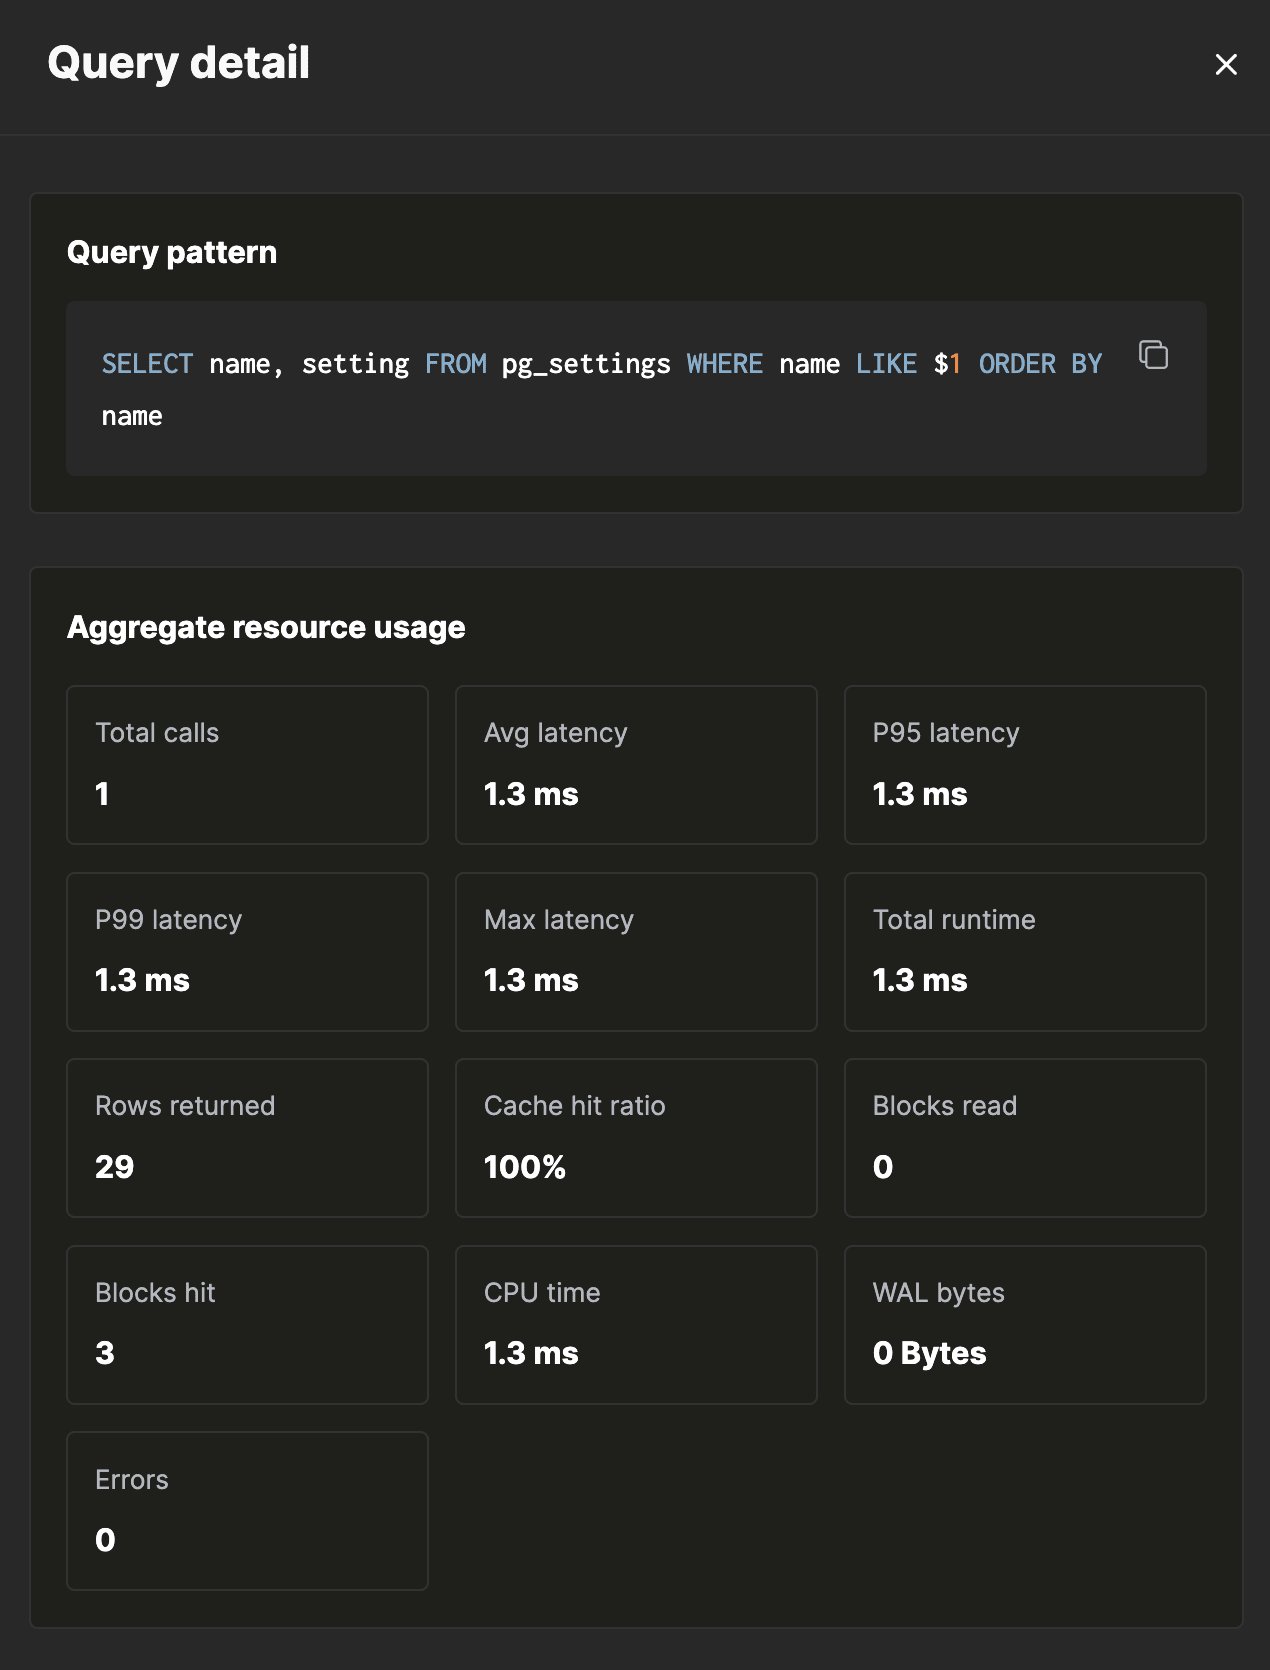
点击模式表或最近查询表中的任意一行,右侧就会打开 查询 详情弹出面板。该弹出面板会汇总所选时间范围内该模式的所有执行, 并聚合用于说明其为何缓慢的各项计数器。 该弹出面板采用单页滚动布局,共分为五个部分:- 查询模式 — 将字面量替换为
$1、$2、… 后的标准化 SQL,以及一个复制到剪贴板按钮。 - 聚合资源使用情况 — 一个包含 13 个统计卡片的网格,涵盖总 调用次数、平均/P95/P99/最大延迟、总运行时间、返回行数、缓存 命中率、读取块数、命中块数、CPU 时间、WAL 字节数以及错误数。
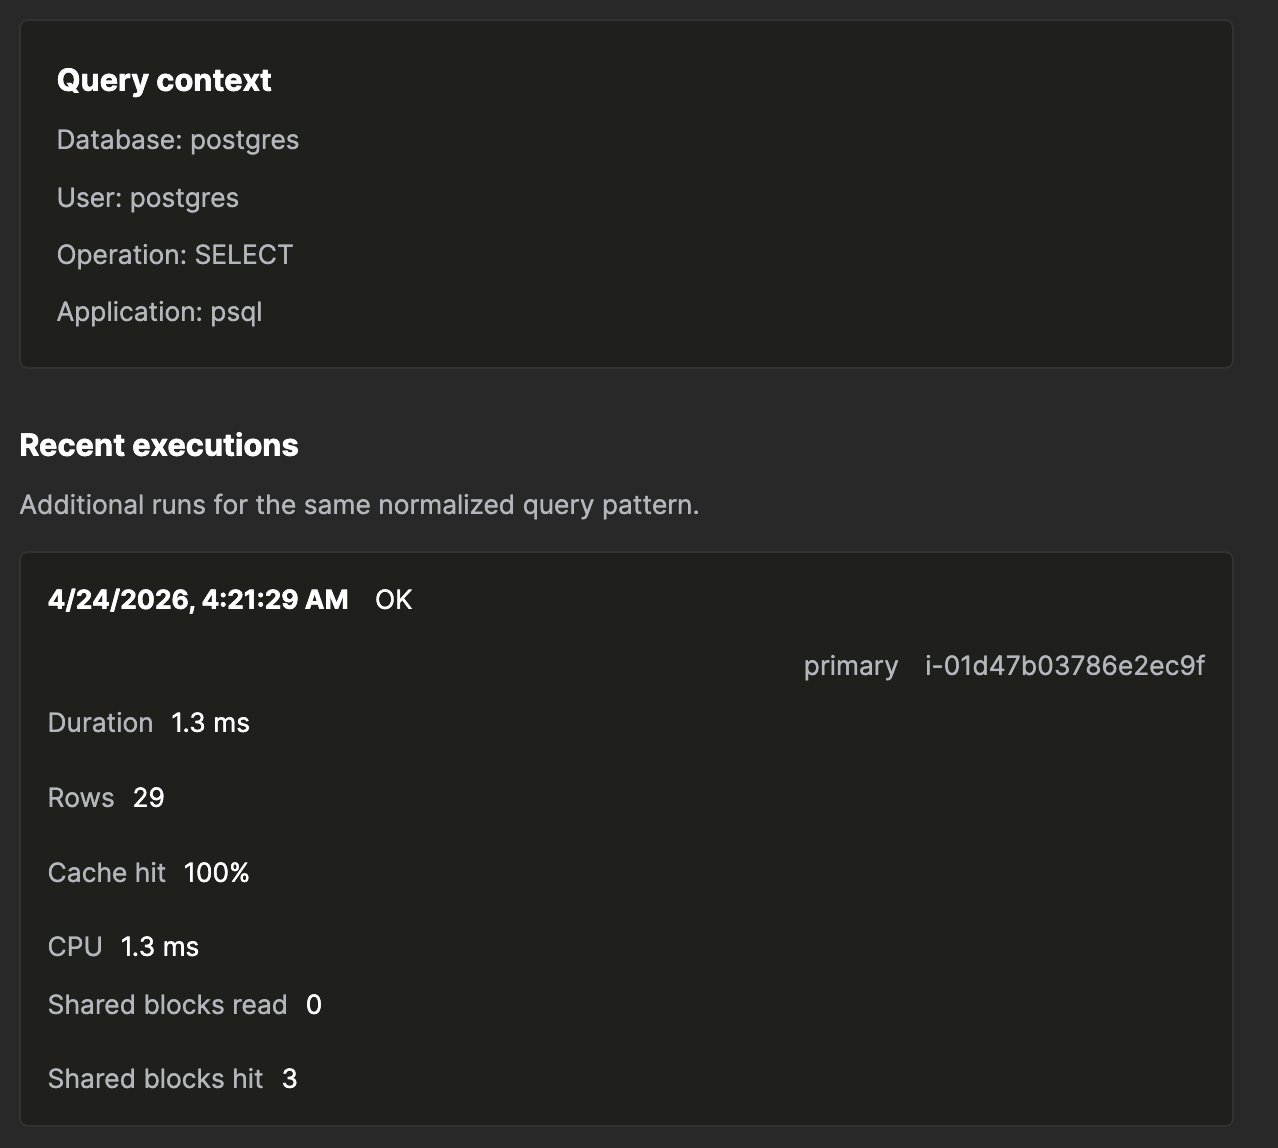
- 查询上下文 — 该模式对应的数据库、用户、操作和应用程序。
- 值得关注的执行 — 错误、异常缓慢的执行以及 返回大量结果的执行,会在完整的最近列表之前优先显示。
- 最近执行 — 同一模式的各次独立执行, 包含每次执行的计数器。
- 共享块 —— read 和 hit 始终显示;written 和 dirtied 仅在非零时显示。
- 本地和临时块操作 —— 临时块操作非零表示某次 sort 或 hash 已落盘。
- 读取 / 写入时间 —— I/O 时间,与 CPU 时间分开显示。
- CPU 时间 —— 分别显示用户态和系统态时间。
- 并行工作线程 —— 计划数量与实际启动数量。
- JIT —— JIT 编译总时间和函数数量。
- WAL —— 字节数和记录数。
Query insights API
按语句统计的遥测数据也可以通过 ClickHouse Cloud OpenAPI 获取。 慢查询模式表对应 list slow query patterns 端点,而详情弹出面板对应 get slow query pattern 端点;该端点会返回某个模式的聚合指标及其 最近执行记录。pg_stat_ch 会挂接到 parse-analyze 阶段,把每个字面量替换为
占位符 ($1、$2、……) ,并将生成的模式缓存在以 queryid 为键的
每个后端 LRU 中。执行器完成该语句时,事件中附带的就是这个
缓存的模式。包含具体值的原始语句永远不会离开数据库。
生产端每条 语句 仅增加约 3% 的开销。入队路径
在共享内存环形缓冲区上使用非阻塞的 try-lock。在高压情况下,
该扩展会丢弃事件并通过计数器记录,而不是对 Postgres
施加反压。
等待数据基于采样
等待图表和 Waits 表所用的样本由主节点每 30 秒采集一次。 短时等待可能恰好发生在两次采样之间,因而不会显示出来, 所以这些视图最适合用于识别持续性等待和锁争用。pg_stat_ch 会为每条已执行的语句 (包括顶层和
嵌套语句) 发出一个原始事件,具体取决于采样设置。查询的百分位数、排名和
细分统计均由 ClickHouse 基于该事件流计算得出。
Insights 后端采用 ClickHouse Cloud。
对于繁忙的 Postgres 实例,单次查询的遥测数据每天可达数百万行;
列式压缩使按执行保留数月的详细数据也能以较低成本实现,
而在数十亿行数据上进行亚秒级聚合,则让 UI 在按一周或一个月切片分析时仍保持流畅交互。
pg_stat_ch 采用 Apache 2.0 许可证。可在任何 Postgres 上运行,并将数据发送到任何
ClickHouse。源代码和问题跟踪见
github.com/clickhouse/pg_stat_ch。
- 监控仪表板 — 内置资源与活动图表
- Prometheus 端点 — 将主机级指标抓取到您自己的可观测性栈中
- ClickHouse Managed Postgres OpenAPI — 以编程方式查询慢查询模式和最近执行记录
- 扩展 — ClickHouse Managed Postgres 实例上可用的扩展
- GitHub 上的
pg_stat_ch— 为 Query Insights 提供支持的开源扩展