

JOIN 子句参考文档。有关执行算法及如何选择算法,请参阅表连接。
尽量避免使用 JOIN
ClickHouse 支持多种 JOIN 类型和算法。不过,JOIN 天生就比从单个反规范化表中查询成本更高。反规范化会将计算工作从查询时转移到插入或预处理阶段,这通常会显著降低运行时延迟。对于实时或对延迟敏感的分析查询,强烈建议采用反规范化。 一般来说,在以下情况下应进行反规范化:- 表很少发生变化,或者可以接受批量刷新。
- 关系不是多对多,并且基数不会过高。
- 实际会查询的列只有一小部分,也就是说,某些列可以不纳入反规范化。
- 你具备将处理工作从 ClickHouse 转移到上游系统 (如 Flink) 的能力,在那里可以管理实时富集或扁平化。
何时需要 JOIN
遵循以下最佳实践可提升 JOIN 性能:- 只需一个匹配项时使用
ANYJOIN。 常规 JOIN 会返回所有匹配的行,若键存在重复,可能产生笛卡尔积。如果一个匹配项即可满足需求,请使用LEFT ANY JOIN或ANY INNER JOIN,以减小结果规模并降低内存占用。 - 在 JOIN 之前缩减两侧数据。 在
WHERE和JOIN ON子句中使用选择性较强的条件。ClickHouse 会尽可能下推过滤器,但显式使用子查询可以确保每个输入在 JOIN 之前都已完成过滤。 - 考虑用
IN代替INNER JOIN。 如果查询只需检查某个键是否存在于另一张表中,IN子查询能更直接地表达这一需求,并且相比生成INNER JOIN结果,可能占用更少内存。 - 对于可复用的查找,优先使用
Join表引擎。Join表引擎会根据声明的 JOIN 类型、严格性和键,存储一个预先计算好的内存结构。在 ClickHouse Cloud 中,它以SharedJoin实现,底层由MergeTree表提供存储,Join(ANY, LEFT, key)可提供支持更新的按键查找。参见 Fast, updatable lookups with the Join table engine。 - 尽可能基于表的 sorting key 进行连接。 当两张表都已按 JOIN 键物理排序时,
full_sorting_merge可以跳过排序步骤并降低内存占用。请确认执行计划,并使用具有代表性的数据,将该算法与默认算法进行基准测试对比。 - 避免会溢写到磁盘的 JOIN。 将 JOIN 的中间状态溢写到磁盘虽然可以让查询不超出内存限制,但磁盘 I/O 通常会增加延迟。哈希连接可在达到配置的落盘阈值时切换为 grace hash,而归并连接则可以使用外部排序。在依赖溢写之前,应先减少输入的行和列,或调整数据模型。详情请参见选择最优 JOIN 算法。
- 在合适的情况下,将默认值用作未匹配标记。 默认设置
join_use_nulls = 0会用对应数据类型的默认值填充外连接中未匹配的列,从而避免使用Nullable包装。仅当查询必须区分未匹配的行与恰好包含默认值的已匹配行时,才需启用join_use_nulls。
选择最佳 JOIN 算法
ClickHouse 支持多种 JOIN 算法,它们在速度与内存之间各有取舍。join_algorithm 的默认值为 direct,parallel_hash,hash,ie_join,ClickHouse 会根据 JOIN 类型、严格性、连接条件和表引擎,选择第一个适用的算法。建议先缩减两侧输入的数据量,并且只有在基于代表性数据的测量结果表明确实需要采用不同的内存或执行策略时,再考虑修改此设置。有关算法执行细节及支持的 JOIN 类型,请参阅选择 JOIN 算法。
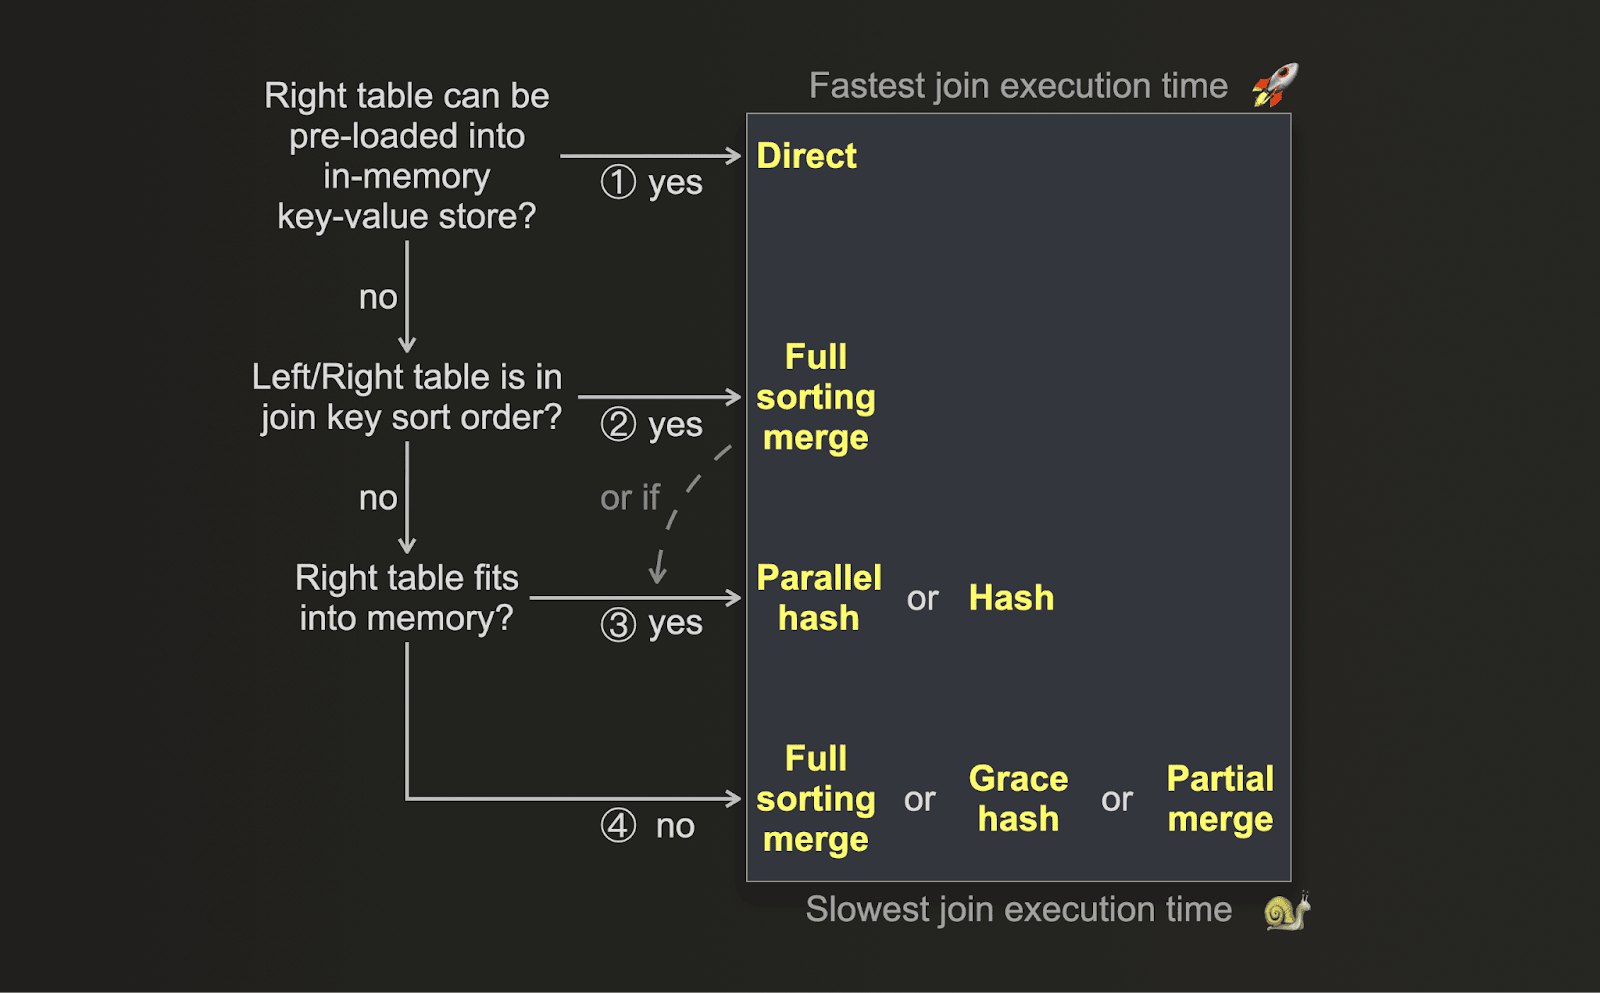
如果您最关注的优化指标是性能,希望连接执行得尽可能快,可以参考以下决策树来选择合适的 JOIN 算法:
-
(1) 如果右表的数据可以预先加载到内存中的低延迟键值数据结构 (例如字典) 中,连接键与底层键值存储的键属性匹配,并且
LEFT ANY JOIN语义足以满足需求,那么可以使用 direct join,它通常是最快的方案。 - (2) 如果表的物理行顺序与连接键的排序顺序一致,则需视具体情况而定。此时,全排序合并连接 会跳过排序阶段,从而显著降低内存使用量;此外,视数据大小和连接键值的分布而定,其执行速度可能比某些哈希连接算法更快。
- (3) 如果右表能够完全放入内存 (即使计入 并行哈希连接 的额外内存开销) ,那么该算法或 哈希连接 可能更快。具体取决于连接键列的数据大小、数据类型以及值分布。
-
(4) 如果右表无法放入内存,当达到
max_bytes_before_external_join或max_bytes_ratio_before_external_join阈值时,哈希连接 和 并行哈希连接 可以切换为 grace hash,将数据溢写到磁盘。全排序合并连接 和 部分合并连接 也可以使用外部存储。哪种方式最快,取决于连接键列的数据量、数据类型以及值分布。
grace_hash_join_initial_buckets 设置用于控制初始桶数量,可在内存使用量与连接速度之间进行权衡。
三种基于磁盘的算法中哪一种最快,取决于数据量、数据类型以及连接键列的值分布。建议始终使用与实际规模相当的数据运行基准测试,以确定最快的算法。
针对内存进行优化
如果您希望优化连接以获得最低的内存使用量,而非最快的执行时间,则可以改用以下决策树: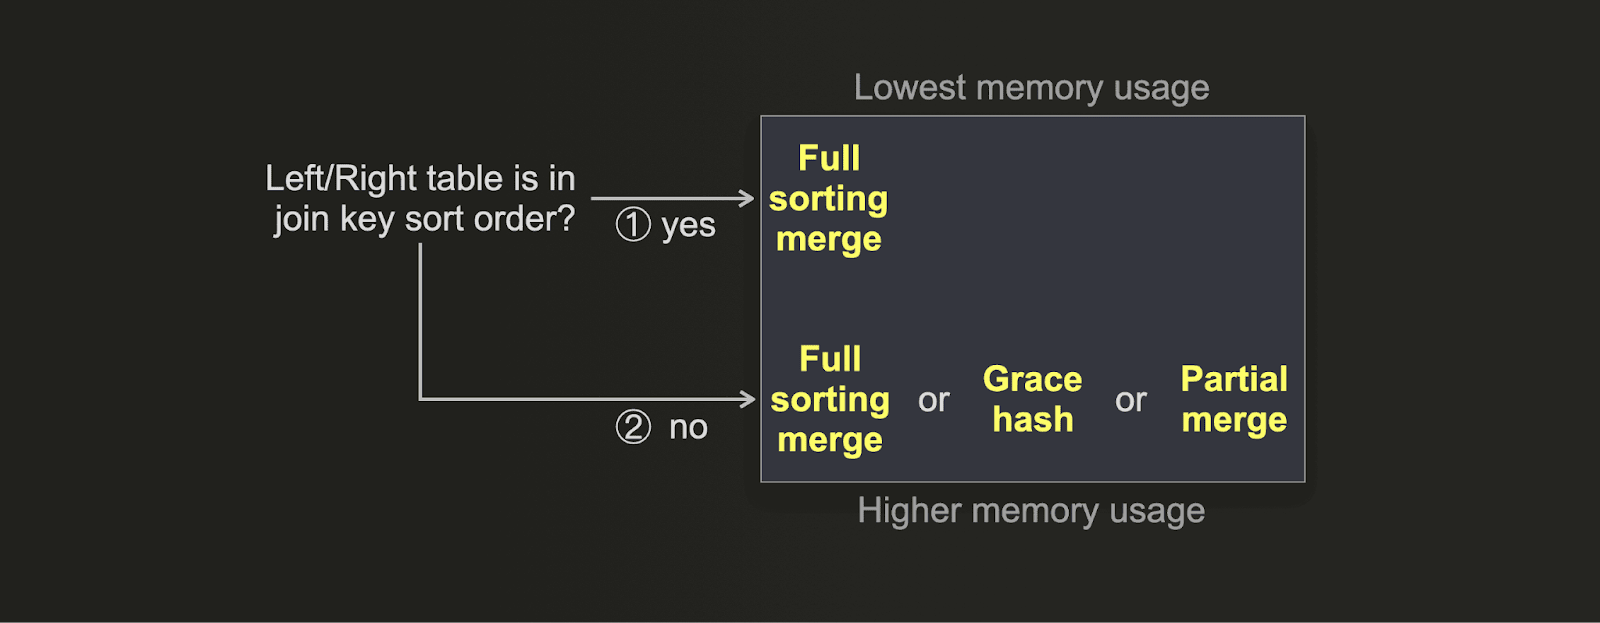
- (1) 如果表的物理行顺序与连接键的排序顺序一致,全排序合并连接的内存使用量即可降至最低;此外,由于排序阶段会被跳过,还能获得良好的连接速度。
- (2) 增大
grace_hash_join_initial_buckets可以将 Grace 哈希连接的内存使用量调至极低,但会牺牲连接速度。部分合并连接在设计上就只占用少量主内存。当行顺序与键的排序顺序不一致时,启用了外部排序的全排序合并连接通常比部分合并连接占用更多内存,但连接执行时间要短得多。哈希连接和并行哈希连接也可以在达到所配置的落盘阈值时切换为 Grace 哈希连接,从而缓解内存压力。
JOIN 优化示例
以下示例使用 Stack Overflow 数据集,并逐步应用上述建议。 下文的测量结果均为在 ClickHouse Cloud 服务 (ClickHouse 26.8.1,max_threads = 4) 上运行五次所得的中位数。每个查询均预热一次,并交替调整查询执行顺序,同时禁用了 use_query_cache 和 use_query_condition_cache。
将 ANY INNER JOIN 替换为 IN
在本次测试中,IN 查询的速度提升了 2.7 倍,峰值内存占用降低了 83%。
该查询统计本身未提及 ClickHouse、但至少有一条评论提及 ClickHouse 的帖子数量:
86。耗时中位数为 27.101 秒,峰值内存占用为 970.01 MiB,共读取 1.5020 亿行、51.77 GiB 数据。
该查询只需确认是否存在匹配的评论即可。改用 IN 子查询可以避免生成 JOIN 结果:
IN 查询同样返回 86,耗时中位数为 10.206 秒,峰值内存占用为 162.81 MiB,共读取 1.7420 亿行、19.02 GiB 数据。
在替换 JOIN 之前先过滤两侧
在此测试中,该重写使中位耗时降低了 18%,峰值内存占用降低了 14%。 此查询统计 2020 年以来创建的 Java 相关帖子所获得的赞成票数。日期条件在 JOIN 之前即已同时应用于两个输入:261915。其耗时中位数为 0.850 秒,峰值内存占用为 59.96 MiB,共读取 8094 万行、1.13 GiB 数据。
对于每条投票,只需确认存在匹配的帖子即可,因此可以将 JOIN 替换为 IN,同时保留两侧输入上的过滤器:
IN 查询同样返回 261915,中位耗时为 0.696 秒,峰值内存占用为 51.70 MiB,共读取 4620 万行、817.49 MiB 数据。