

- в теле пакетов
Data,Totals,Extremes,LogиProfileEventsв собственном TCP-протоколе (пакетTableColumnsне является блоком Native — он содержит две двоичные строки, поэтому его структура описана в спецификации собственного протокола); - в выводе
SELECT ... FORMAT Nativeпо HTTP; - в файлах, экспортируемых с помощью
INTO OUTFILE ... FORMAT Native; - в полезной нагрузке межсерверной репликации.
Обзор
Любые данные, передающие строки по сети, представляют собой блок — самоописывающийся фрагмент строк, хранящихся по столбцам. Сначала идут все значения столбца 1, затем все значения столбца 2 и так далее. Блок содержит только те столбцы, на которые ссылается запрос, и никогда не содержит всю таблицу целиком. Размещениеdata столбца определяется семейством, к которому относится его тип. Семейства в порядке возрастания сложности декодера:
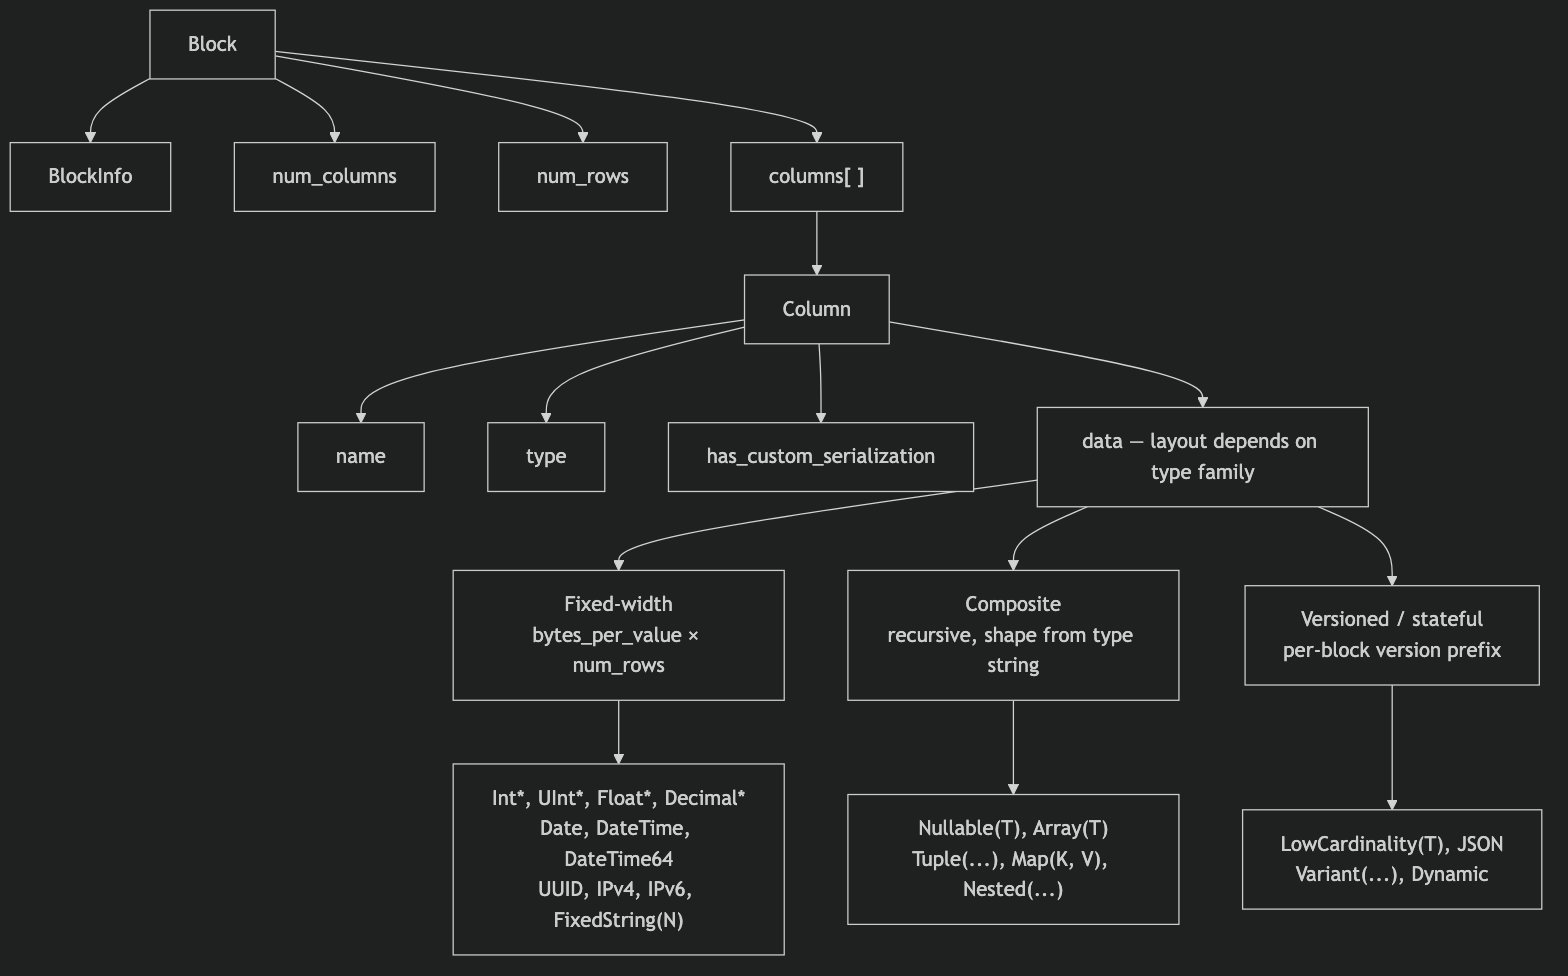
- Типы фиксированной ширины размещают
dataв видеbytes_per_value × num_rowsнеобработанных байтов без построчного кадрирования. - Составные типы (
Nullable,Array,Tuple,Map,Nested) имеют рекурсивную структуру, которая полностью выводится из строки типа; у них нет ни префикса версии, ни состояния между блоками. - Версионируемые типы и типы с сохранением состояния (
LowCardinality,JSON,Variant,Dynamic) начинают каждый непустой блок с префикса версии сериализации или префикса состояния. При передаче в форматеNativeэтот префикс и словарь (если он есть) существуют в пределах одного блока: формат не переносит состояние между блоками (пишущая сторона создаёт новое состояние сериализации для каждого блока и устанавливаетlow_cardinality_max_dictionary_size = 0). Состояние между блоками относится к хранению MergeTree на диске, а не к формату передачи данных Native.
Базовые примитивы формата передачи данных
Формат Native основан на четырёх базовых способах кодирования.VarUInt
Беззнаковое целое число переменной длины в кодировании LEB-128. Каждый байт содержит 7 бит данных в позициях 0–6 и 1 бит продолжения в позиции 7. Бит продолжения равен1, если за текущим байтом следуют другие, и 0 в последнем байте.
Кодирование значения
300:
0xAC 0x02:
Целые числа фиксированной ширины
Например, значение
1 типа UInt32 кодируется как 01 00 00 00, а значение -1 типа Int32 — как FF FF FF FF.
String
Последовательность байтов, которой предшествует её длина:0x00, а строки могут содержать любые значения байтов, в том числе байты NUL. Строка "ab" кодируется как 02 61 62; чтобы её декодировать, прочитайте длину в формате VarUInt (2), а затем — указанное количество байтов.
Bool
Один байт.0x00 означает false, любое ненулевое значение — true (каноническое значение — 0x01).
Структура блоков и столбцов
Формат передачи данных блока
BlockInfo зависит от канала, поскольку пишущая сторона параметризуется ревизией (подробное описание, в том числе того, что client_protocol_version влияет только на вывод, см. в разделе Ревизия протокола и формат Native):
-
В собственном TCP-протоколе сервер записывает блоки с ревизией, согласованной для соединения (это большое значение —
DBMS_TCP_PROTOCOL_VERSION, см.src/Core/ProtocolDefines.h).BlockInfoзаписывается, если эта ревизия больше нуля, а для реального соединения это условие выполняется всегда. Байтhas_custom_serializationв каждом столбце (см. формат передачи данных столбца) записывается начиная с ревизии54454. -
Формат вывода
Native—SELECT ... FORMAT Nativeчерез HTTP,INTO OUTFILE ... FORMAT Nativeи форматNative, который формируетclickhouse-client, — по умолчанию сериализует данные с ревизией0. При ревизии0префиксBlockInfoи байтhas_custom_serializationне записываются, поэтому блок состоит только изnum_columns,num_rowsи самих столбцов. При работе через HTTP ревизия не фиксирована: клиент может повысить её с помощью параметра запроса?client_protocol_version=<n>, и сервер использует это значение как ревизию сериализации ответа. При достаточно большом значении вывод по HTTP содержит префиксBlockInfo(записывается, если ревизия больше0) и байтhas_custom_serialization(записывается начиная с ревизии54454) — точно так же, как при передаче по TCP. Поэтому клиенты не должны рассчитывать на то, что любая полезная нагрузка HTTPFORMAT Nativeимеет ревизию0.
BlockInfo, описывают полезную нагрузку пакета Data в TCP. Тот же запрос, выполненный через FORMAT Native, даёт более короткую форму, показанную рядом.
BlockInfo
BlockInfo — это последовательность полей, каждому из которых предшествует ID поля в формате VarUInt; завершается последовательность полем с ID0. Формат передачи данных не является самоописывающимся: ID поля не кодирует ни длину, ни тип значения, поэтому считыватель должен заранее знать тип каждого ID поля, который может ему встретиться. Собственный считыватель ClickHouse считает нераспознанный ID поля признаком повреждения данных и вызывает исключение (UNKNOWN_BLOCK_INFO_FIELD). Прямая совместимость обеспечивается иначе — за счёт ревизии протокола: отправитель записывает поле, только если согласованная ревизия не ниже минимальной ревизии этого поля, поэтому более старый получатель никогда не получит неизвестное ему поле.
Поля
1 и 2 имеют минимальную ревизию 0, поэтому они присутствуют всегда, когда BlockInfo вообще записывается. Поле 3 записывается только начиная с ревизии 54480. Формат передачи данных для типичного случая (ревизия ниже 54480):
Формат передачи данных столбца
Столбец встречается в блокеnum_columns раз.
Декодер выбирает способ обработки по строке
type. Строки типов часто содержат параметры в круглых скобках: декодер отбрасывает суффикс (...), чтобы определить базовый тип, а затем разбирает параметры, чтобы определить размер, масштаб или вложенный тип. Для разбора списка параметров с вложенными типами (например, Tuple внутри Array) нужен разделитель по запятым, учитывающий глубину вложенности скобок, — простое разбиение по , не подойдёт.
Двоичное кодирование типовПоле
type содержит текстовую String только в режиме по умолчанию. Если задана настройка запроса output_format_native_encode_types_in_binary_format = 1, вместо этого поле содержит двоичное кодирование типа — то же кодирование на основе тегов, что описано в разделе двоичное кодирование типов данных, — а в развёрнутых списках типов Dynamic имена отдельных типов также кодируются в двоичном виде. Декодер, который всегда читает поле 2 как строку с префиксом длины, воспримет первый двоичный тег типа как длину строки и потеряет синхронизацию, поэтому он должен знать, какой режим используется в потоке.Для запроса с query_kind = SECONDARY_QUERY (отправленного другим сервером для remote, Distributed или параллельных реплик либо командой clickhouse-client --query_kind secondary_query) обе стороны игнорируют output_format_native_encode_types_in_binary_format и input_format_native_decode_types_in_binary_format для блоков этого запроса: в обоих направлениях передаются текстовые имена типов. Серверы версий, выпущенных до введения этого правила, применяют эти настройки к вторичному запросу так же, как к любому другому.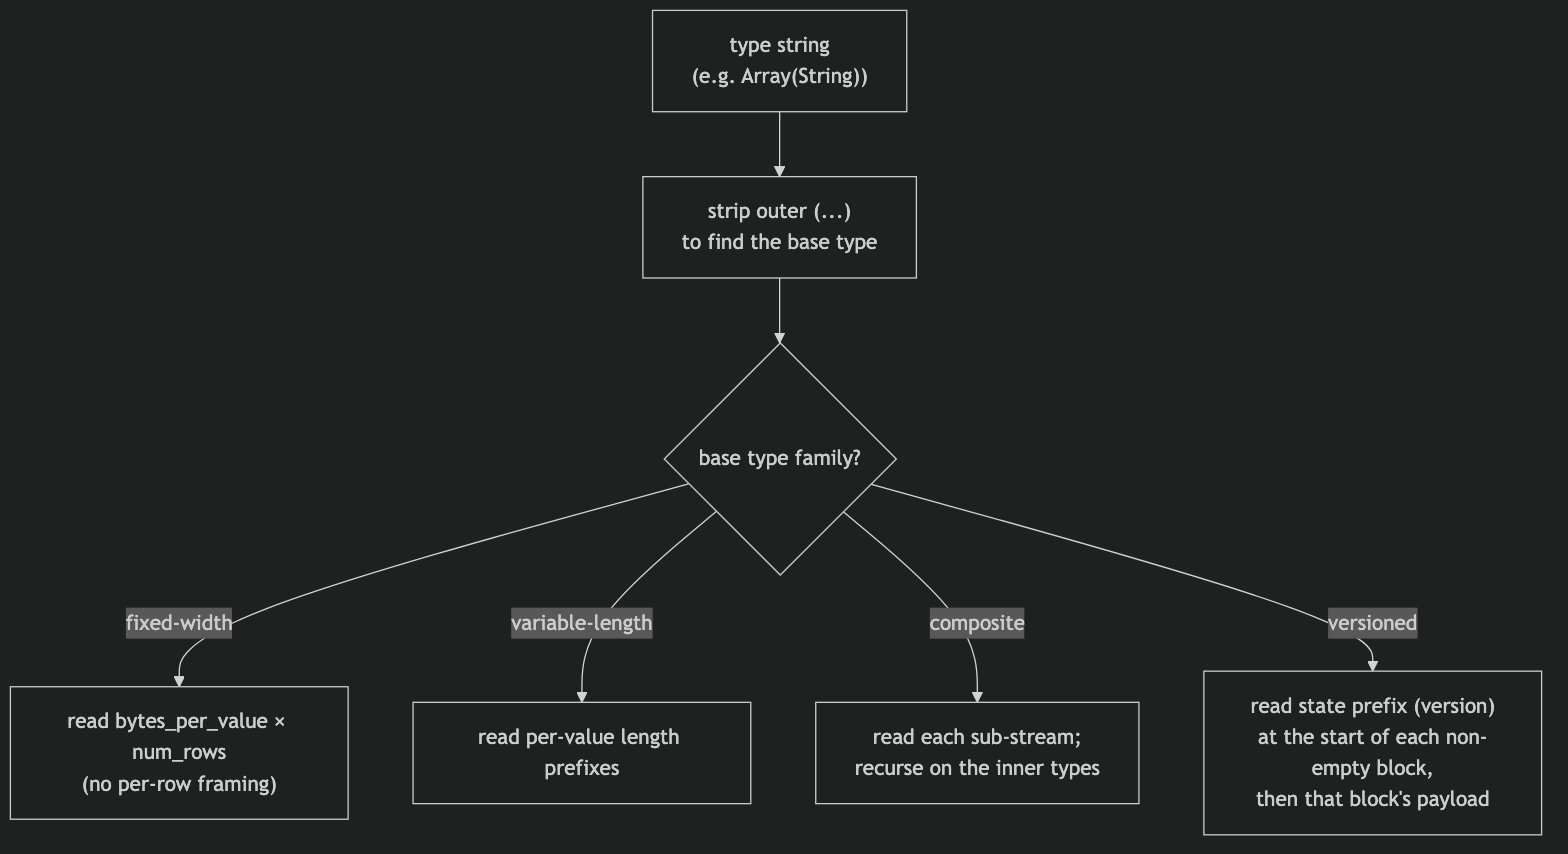
kind_stack и разреженное кодирование
Байтkind_stack задаёт нестандартную сериализацию отдельного столбца:
Полезная нагрузка
COMBINATION использует другое перечисление. Пять строк выше — это компактные однобайтовые коды. COMBINATION (0x05) — универсальный способ описать любой стек, не охваченный ими: за ним следует VarUInt count, а затем count однобайтовых записей. Эти записи — не компактные коды из таблицы, а исходные значения ISerialization::Kind:
Значения байтов отличаются от компактных кодов: во вложенном перечислении
REPLICATED равен 0x03, а как компактный код — 0x04; записи DETACHED_OVER_SPARSE нет вовсе — эта комбинация представляется двумя последовательными записями SPARSE, DETACHED. Декодер, который продолжает применять компактную таблицу к вложенным байтам, неверно сопоставит 0x03/0x04 и потеряет синхронизацию.
count — это полная длина стека, включая начальную запись DEFAULT, с которой начинается любой стек. Компактные коды уже охватывают все стеки из одной и двух записей, поэтому у COMBINATION значение count всегда не меньше трёх.
Корректность стека видов. Декодер отклоняет некорректный стек с ошибкой INCORRECT_DATA, не пытаясь построить описываемую им сериализацию. Корректный стек:
- начинается с
DEFAULT; - является подпоследовательностью
DEFAULT,SPARSE,REPLICATED,DETACHED— именно в таком порядке виды оборачивают друг друга.SPARSEможет находиться внутриREPLICATED, но не наоборот, аDETACHEDвсегда идёт последним, посколькуColumnBLOBхранит сериализованную форму всего, что лежит под ним. Отсюда также следует, что ни один вид не встречается дважды, а значит,countне превышает числа видов.
ColumnSparse, у которого столбец значений сам разреженный или реплицированный, так и останется обёрнутым.
Рекурсивный kind_stack для столбцов Tuple. Описанная выше полезная нагрузка kind_stack — это байт (или последовательность COMBINATION), описывающий сериализацию одного столбца. Tuple содержит SerializationInfoTuple, который сначала записывает собственную полезную нагрузку стека видов кортежа, а затем — полную полезную нагрузку стека видов для каждого элемента по порядку; декодер считывает ту же рекурсивную структуру. Так, для Tuple(A, B, C) байты поля 4 имеют вид [tuple_kind][A_kind][B_kind][C_kind], причём полезная нагрузка элемента сама рекурсивна, если элемент тоже составной. Байт has_custom_serialization (поле 3) устанавливается, если собственная информация кортежа или информация любого из элементов отличается от значения по умолчанию, поэтому Tuple, у которого особым является лишь один разреженный или реплицированный элемент, всё равно порождает полезную нагрузку стека видов. Декодер, считывающий для Tuple только один начальный байт перечисления, остановится слишком рано и ошибочно прочитает оставшиеся байты видов элементов как данные столбца.
Формат передачи разреженных данных. При kind_stack = 0x01 данные столбца data представляют собой два потока, записанные друг за другом в одном общем TCP-потоке:
- Поток смещений — последовательность значений
VarUInt. Каждое значениеvможет быть одним из двух:vсо сброшенным старшим битом в позиции 62:(v & 0x3FFFFFFFFFFFFFFF)= количество позиций со значением по умолчанию перед следующим явно заданным значением, отличным от значения по умолчанию. Позиция этого значения равнаcursor + group_size, гдеcursor— текущая позиция; после этогоcursorувеличивается наgroup_size + 1.vс установленным битом 62 (END_OF_GRANULE_FLAG): значение со сброшенным флагом = количество завершающих позиций со значением по умолчанию после последнего значения, отличного от значения по умолчанию. Такое значение обозначает конец потока смещений для блока.
- Поток значений —
countзначений, отличных от значений по умолчанию, плотно закодированных во внутреннем типе, гдеcount— количество прочитанных выше значений VarUInt, не являющихся маркером EOG.
num_rows записей, заполняя каждую позицию, не заданную явно, значением по умолчанию внутреннего типа (0 для целых чисел и чисел с плавающей точкой, "" для String, 0 дней для Date и т. д.).
Разреженный столбец Nullable(T) — особый случай, поскольку значением по умолчанию для Nullable(T) является NULL. При разреженном кодировании обычный поток карты NULL типа Nullable полностью отсутствует: поток смещений определяет позиции со значениями, отличными от значения по умолчанию, то есть не NULL, поток значений содержит только эти значения, плотно закодированные в T, а каждая позиция, не заданная явно, восстанавливается как NULL. Поэтому декодер не должен искать карту NULL в потоке значений и не должен заполнять пропуски фактическим значением 0 — он заполняет их значением NULL.
Формат передачи данных Replicated. Когда kind_stack = 0x04, данные столбца data представляют собой словарь: список уникальных значений элементов и построчный индекс в этом списке (та же структура поиска, что и у LowCardinality). Если внутренний тип сам является версионируемым — например, LowCardinality(T), — его префикс состояния записывается первым, перед потоком индексов: реплицированная сериализация делегирует фазу префикса внутреннему типу перед записью num_rows. Внутренние типы с пустым префиксом (листовые типы и простые составные типы) не добавляют сюда ни одного байта.
elements[indexes[i]] для каждой выходной строки i. Составные внутренние типы обрабатываются рекурсивно: список элементов материализуется во внутреннем типе, а затем индексируется. К поддерживаемым внутренним типам относятся конечные типы, Nullable(T), Array(T), Tuple(...), Map(K, V), Nested(...) (каждое поле разворачивается как Array) и LowCardinality(T) (общий словарь сохраняется, индексируются только ключи отдельных элементов).
Формат передачи данных detached. DETACHED (0x02) и DETACHED_OVER_SPARSE (0x03) действительно передаются по сети, то есть используются не только внутри сервера. При передаче по TCP, если сжатие включено, а согласованная ревизия не ниже DBMS_MIN_REVISON_WITH_PARALLEL_BLOCK_MARSHALLING (v54478), обработка столбца выполняется в три этапа:
- Каждый подходящий столбец (не
const, неTuple, в блоке из более чем одной строки) оборачивается вColumnBLOB, содержащий столбец, который уже сериализован и сжат вне основного потока. DETACHEDдописывается в стек видов обёрнутого столбца.- Данные столбца
dataзаписываются как размер blob в форматеVarUInt, за которым следует ровно столько же байтов blob.
{DEFAULT, SPARSE, DETACHED} и сериализуется как DETACHED_OVER_SPARSE. Клиент, декодирующий такой столбец, считывает длину и байты blob, а затем распаковывает blob, чтобы получить полезную нагрузку внутреннего столбца (см. примечание о ColumnBLOB в разделе о сжатии).
DETACHED действует только в одном направлении: он может встречаться лишь в блоках результата, отправляемых сервером, и только для целого столбца верхнего уровня — но никогда в качестве одного из видов элементов Tuple. В отличие от остальных видов, он делает столбец времени выполнения столбцом ColumnBLOB, а не столбцом объявленного типа, поэтому получатель принимает его, только если его собственный конвейер преобразует blob обратно. По этой причине сервер отклоняет DETACHED в любом блоке, отправленном клиентом, — будь то данные внешних таблиц, скалярные значения или данные для вставки — с ошибкой INCORRECT_DATA.
Варианты блоков
Все пакеты семейства Data используют один и тот же формат передачи данных блока. Варианты различаются лишь количеством столбцов и строк:Примеры на уровне байтов
Все примеры в этом разделе относятся к пути передачи Data-пакетов по TCP, поэтому в них присутствуют префиксBlockInfo и байт has_custom_serialization. При использовании FORMAT Native те же блоки короче — там, где это уместно, приводится эквивалентная краткая форма.
Пустой блок (с BlockInfo), всего 8 байт:
SELECT 1 объявляет один столбец с именем "1" типа UInt8 и не содержит строк. Начиная с версии протокола ≥ 54454, в него включается байт has_custom_serialization:
FORMAT Native (ревизия 0) тот же блок результата не содержит ни BlockInfo, ни байта has_custom_serialization — SELECT 1 FORMAT Native занимает 11 байт:
FORMAT Native не даёт на выходе ни одного байта: в этом формате вывода пустые блоки не записываются.)
Ревизия протокола и формат Native
Структура байтового потока Native определяется прежде всего ревизией протокола, с которой работают пишущая сторона и считыватель. В самих байтах ревизия нигде не указана — в передаваемых данных нет поля ревизии, — но именно от неё зависит, будут ли вообще присутствовать некоторые возможности. Поэтому, прежде чем разобрать полезную нагрузку, декодер должен знать, с какой ревизией она была записана. А раз ревизии в потоке нет, считыватель и пишущая сторона должны согласовать её каким-то другим способом. Ревизия — это одно значение типаUInt64, которое и NativeWriter, и NativeReader принимают в качестве аргумента конструктора. У пишущей стороны оно называется client_revision, у считывателя — server_revision, но это одно и то же число. Самая новая ревизия, известная данному релизу, — DBMS_TCP_PROTOCOL_VERSION (см. src/Core/ProtocolDefines.h).
Что определяет ревизия
Каждая возможность доступна только начиная с порогового значенияDBMS_MIN_REVISION_WITH_*. Пишущая сторона использует возможность только тогда, когда её ревизия достигает порога, а считыватель ожидает её по точно такому же правилу, поэтому обе стороны остаются согласованными: если на любой из сторон указать неверную ревизию, они рассинхронизируются. Для формата Native важны следующие пороги:
Поэтому ревизия
0 — самое консервативное кодирование почти во всём: поток не содержит BlockInfo и байта has_custom_serialization, использует Dynamic/JSON версии V1, не содержит версии агрегатной функции, а DateTime передаётся без параметра часового пояса. Исключение при ревизии 0 составляют версии состояния агрегатных функций: здесь нет peer, по которому можно было бы определить версию, — поток записывает и считывает обратно тот же, кто его создал (файл данных StripeLog, резервная копия Set/Join, файл в формате Native). Поэтому пишущая сторона сохраняет версию, зафиксированную в типе (как обычно, явно указывая её в строке типа), а не понижает состояние до версии 0; с версией 0 записывается только тип без зафиксированной версии.
LowCardinality — единственное исключение, причём важное. Проверка на пишущей стороне выглядит так: remove_low_cardinality || (client_revision && client_revision < DBMS_MIN_REVISION_WITH_LOW_CARDINALITY_TYPE). Вся хитрость — в начальном client_revision &&: когда ревизия равна ровно 0, всё условие по короткой схеме вычисляется в false.
Таким образом, при ревизии 0 — значении по умолчанию для FORMAT Native — LowCardinality(T) не удаляется. Его строка типа и префикс состояния каждого блока остаются в потоке, и считыватель с ревизией 0 читает их без изменений. Удаление срабатывает только при ненулевой ревизии ниже 54405 либо при принудительном включении независимо от ревизии.
За принудительное включение отвечает флаг remove_low_cardinality. Вывод FORMAT Native никогда его не устанавливает, а вот нативный TCP-путь устанавливает — при low_cardinality_allow_in_native_format = 0 (по умолчанию 1). Иными словами, эта настройка влияет на вывод через нативный TCP, но никак не влияет на FORMAT Native.
Практический вывод: поток FORMAT Native с настройками по умолчанию вполне может содержать LowCardinality, поэтому не считайте, что эта возможность при ревизии 0 отсутствует.
Откуда берётся ревизия в зависимости от способа передачи данных
Одни и те же байты в формате Native могут передаваться разными путями: по собственному TCP-протоколу, в HTTP-запросе или в файле на диске. В каждом случае ревизия задаётся по-своему. Обратите внимание: сторона чтения и сторона записи настраиваются независимо, поэтому их ревизии могут не совпадать.Собственный TCP-протокол — согласование, оба направления
В собственном TCP-протоколе ревизия определяется в ходе рукопожатия Hello. Клиент отправляетDBMS_TCP_PROTOCOL_VERSION, сервер отвечает своим значением, и с этого момента каждая сторона сериализует данные в соответствии с ревизией, объявленной другой стороной: сервер создаёт свои NativeReader/NativeWriter на основе client_tcp_protocol_version, а клиент использует полученное значение server_revision. Явного min здесь нет, однако ни одна из сторон не может отправить возможность, которую она не реализует, поэтому каждое направление фактически ограничено более старым из двух участников.
Если оба участника — одна и та же современная сборка, оба направления используют одну и ту же ревизию (DBMS_TCP_PROTOCOL_VERSION, см. src/Core/ProtocolDefines.h), и все условия выполняются. Так обычно и бывает, но это не гарантировано. Если участники имеют разные версии или один из них — сторонняя реализация, направления могут работать на разных ревизиях, поэтому условия нужно проверять для каждого направления отдельно: BlockInfo присутствует при любой ненулевой ревизии, а остальные поля, включая has_custom_serialization, появляются только тогда, когда эффективная ревизия данного направления достигает соответствующих пороговых значений. Например, участник, объявивший ревизию ниже 54454, не отправляет и не получает байт has_custom_serialization.
Вывод FORMAT Native — по умолчанию ревизия 0, через HTTP её можно повысить
Выходной формат Native по умолчанию использует ревизию 0. Это относится к SELECT ... FORMAT Native через HTTP, к INTO OUTFILE ... FORMAT Native и к выводу Native, который формирует clickhouse-client; во всех этих случаях фабрика вывода передаёт FormatSettings::client_protocol_version напрямую в NativeWriter, а тот определяет как обрамление BlockInfo / has_custom_serialization, так и структуру String со смещениями. Поэтому HTTP-запрос SELECT ... FORMAT Native с повышенным client_protocol_version (≥ 54492) записывает данные в структуре со смещениями, а при ревизии 0, используемой по умолчанию, сохраняется переносимая схема для отдельных значений.
Однако при работе через HTTP значение по умолчанию можно изменить. Клиент может повысить его с помощью параметра запроса ?client_protocol_version=<n>, который HTTP-обработчик рассматривает как зарезервированный параметр, а не как SQL-настройку: значение попадает в контекст запроса, а слой форматов копирует его в FormatSettings. Если задать достаточно высокое значение, вывод HTTP FORMAT Native начнёт включать префикс BlockInfo и байт has_custom_serialization — так же, как при передаче по TCP. Поэтому не стоит рассчитывать на то, что полезная нагрузка HTTP FORMAT Native всегда имеет ревизию 0.
Поскольку параметр попадает в контекст всего запроса, он действует на каждый NativeWriter, созданный для этого запроса, а не только на поток результата. В частности, запись на стороне сервера, например INSERT INTO FUNCTION file('x.native', 'Native', ...) SELECT ... через HTTP с повышенным ?client_protocol_version=, создаёт файл с этой ревизией. Такое поведение существует давно (оно появилось раньше сериализации String со смещениями и затрагивает также BlockInfo и has_custom_serialization) и при этом асимметрично: на стороне чтения (см. ниже) ревизия таким способом не повышается, поэтому прочитать такой файл обратно через file(...) не получится. Не указывайте client_protocol_version в запросах, которые записывают данные, предназначенные для повторного чтения. У INTO OUTFILE и локального вывода clickhouse-client такой настройки нет, и они всегда используют ревизию 0.
Входные данные FORMAT Native — всегда ревизия 0
Входной формат Native всегда создаёт свой NativeReader с ревизией 0. Он никогда не ожидает префикса BlockInfo, никогда не читает байт has_custom_serialization и всегда использует сериализацию по умолчанию — независимо от того, разбирает ли он тело запроса INSERT ... FORMAT Native, читает файл Native или выводит схему. Параметр ?client_protocol_version=<n> не повышает ревизию на входе (этот параметр учитывается только на стороне вывода).
Поскольку ревизия на входе всегда равна 0, входной формат всегда читает структуру String с кодированием для отдельных значений; поток, записанный со структурой String со смещениями (через собственный TCP-протокол или через SELECT ... FORMAT Native с повышенным client_protocol_version), невозможно прочитать обратно через входной формат FORMAT Native — та же асимметрия, что и с обрамлением BlockInfo.
Последствия для обратимого обмена
ДляFORMAT Native по умолчанию на обеих сторонах используется ревизия 0. Данные, записанные через SELECT ... FORMAT Native с ревизией 0, без каких-либо сюрпризов читаются обратно через INSERT ... FORMAT Native.
Поток, сформированный с повышенной выходной ревизией (?client_protocol_version=<n> в SELECT), содержит обрамление BlockInfo и has_custom_serialization, а также структуру String со смещениями. Ничего из этого входной формат, который всегда работает с ревизией 0, прочитать не может. Поэтому повышать client_protocol_version имеет смысл только для потребителя, работающего по собственному TCP-протоколу, но не для обратимого обмена FORMAT Native по HTTP.
Файлы — асимметричный случай. Повышенный ?client_protocol_version= в серверном INSERT INTO FUNCTION file(...) (или s3, url) записывает файл с этой ревизией, однако при чтении через file(...) данные всегда разбираются с ревизией 0, поэтому такой файл не поддерживает обратимый обмен. Либо не указывайте client_protocol_version в запросе на запись, чтобы файл получил обычную ревизию 0, либо передавайте данные по собственному TCP-протоколу, где для каждого направления используется ревизия, согласованная при рукопожатии.
Ревизия протокола и версия сериализацииНе путайте ревизию протокола с версией сериализации. Ревизия здесь задаётся на всё соединение или запрос и никогда не попадает в сами байты. Версия сериализации задаётся для каждого столбца, передаётся версионируемыми типами и записывается в каждый непустой блок. Ревизия определяет, есть ли та или иная возможность вообще; версия сериализации — когда вы уже внутри версионируемого столбца — определяет, какой вариант кодирования данного типа следует далее.
Типы данных
В этом разделе описывается кодирование в формате передачи данных для типов, которые формат Native может передавать в полеdata столбца. Типы разделены на четыре семейства в порядке возрастания сложности декодера. Два типа — AggregateFunction(func, ...) и QBit(T, N[, stride]) — являются допустимыми типами столбцов Native, но их полезная нагрузка зависит от конкретной функции или типа, и её описание выходит за рамки этого документа. Ниже они упоминаются отдельно там, где их можно ошибочно принять за псевдонимы.
Типы фиксированной ширины
Каждое значение занимает постоянное число байт. Столбец изM строк при передаче занимает ровно bytes_per_row × M байт: значения идут подряд, без разделителей и дополнения.
Целочисленные типы
UInt8–UInt256 и Int8–Int256 представляют собой непосредственное двоичное кодирование целочисленных значений. Декодер считывает bytes_per_row × num_rows байт и интерпретирует их в соответствии с типом.
Столбец типа UInt32 со значениями [1, 256, 65536]:
Int32 со значениями [-1, 42]:
Float32 и Float64
Стандартные двоичные числа с плавающей запятой IEEE 754: 4 байта одинарной точности (binary32) и 8 байт двойной точности (binary64), в обоих случаях с порядком байтов little-endian. NaN, ±Infinity, ±0.0 и субнормальные числа поддерживают обратимый обмен без нормализации.
Значение 1.5 типа Float32 (0x3FC00000):
Float64 1.5 (0x3FF8000000000000):
BFloat16
Формат brain floating point: старшие 16 бит числа IEEE 754Float32 — 1 бит знака, 8 бит экспоненты и 7 бит мантиссы. Каждое значение занимает 2 байта в порядке little-endian и хранит исходный 16-битный шаблон. Чтобы получить числовое значение, расширьте его обратно до Float32: поместите шаблон в старшую половину, а младшую обнулите (bits << 16, переинтерпретированное как Float32). После этого расширенное значение форматируется в текст так же, как Float32.
Значение BFloat16 1.5 (шаблон 0x3FC0 — старшая половина Float32 0x3FC00000):
Bool
Совместим на уровне формата передачи сUInt8: 1 байт на строку, 0x00 = false, 0x01 = true. При передаче строка типа — именно Bool (а не UInt8), поэтому декодер, выбирающий обработчик по строке типа, должен распознавать этот тип отдельно.
Столбец Bool со значениями [true, false, true]:
Date и Date32
Оба типа кодируют дату как целое число дней, прошедших с начала эпохи Unix (1970-01-01). Компонента времени ни один из них не содержит.
Значение
Date 1970-01-02 (1 день):
Date32 1900-01-01 (-25567 дней):
DateTime
На уровне формата передачи совместим сUInt32: Unix-временная метка в секундах, 4 байта в порядке little-endian. Тип может быть указан как DateTime или DateTime('Timezone'); часовой пояс влияет только на отображение и не входит в передаваемое значение. Два столбца DateTime с разными параметрами часового пояса для одного и того же момента времени дают одинаковые байты. Декодер отбрасывает суффикс параметра (...) и обрабатывает столбец как UInt32.
Значение DateTime('UTC') 2024-03-15 14:30:00 UTC (временная метка 1710513000):
DateTime64(scale[, timezone])
8 байт: little-endian Int64 — количество тиков длительностью10^-scale секунд, прошедших с начала эпохи Unix. Параметр scale (0–9) указывается в строке типа и задаёт единицу времени:
Тип записывается как
DateTime64(s) (неявно используется часовой пояс сервера по умолчанию) или DateTime64(s, 'TimezoneName') (явно заданный часовой пояс, влияет только на отображение). Отрицательные значения соответствуют тикам до начала эпохи.
Значение DateTime64(3, 'UTC') 2024-01-15 12:30:45.123 UTC (1705321845123 мс):
DateTime64(0) 2024-01-15 12:30:45 UTC (1705321845 с):
Time и Time64(scale)
Длительность по часам, а не момент времени.Time — знаковое количество секунд, 4 байта little-endian Int32; Time64(scale) — знаковое количество тиков при заданном десятичном масштабе (масштаб, 0–9), 8 байт little-endian Int64 — то же бинарное представление, что и у DateTime64.
Текстовая форма — [-]HH:MM:SS[.fraction], однако, в отличие от DateTime, поле часов не приводится по модулю 24 часов: это общее количество часов, и оно может превышать 23. Отображаемая величина ограничена значением 999:59:59 (3599999 секунд); при большей величине секунды выводятся по этому пределу, а сохранённая дробная часть остаётся без изменений, поэтому количество тиков 3700000.25 отображается как 999:59:59.250000. CAST насыщает сохранённое значение до наибольшего представимого тика при целевом масштабе (999:59:59.999999 для Time64(6)), а не до целой секунды, тогда как в результате арифметических операций в столбце всё же может оказаться количество тиков вне допустимого диапазона, которое ограничивается только при отображении. Всё это никак не влияет на байты в бинарном представлении: это обычное знаковое целое число.
Значение Time 45296 (12:34:56):
Time64(3), равное 45296789 тикам (12:34:56.789):
Типы
Time и Time64 являются экспериментальными: для их использования на сервере необходимо включить настройку allow_experimental_time_time64_type = 1.Interval
Interval<Unit> — IntervalSecond, IntervalMinute, IntervalHour, IntervalDay, IntervalWeek, IntervalMonth, IntervalQuarter, IntervalYear, IntervalNanosecond и т. д. Для всех единиц используется одно и то же кодирование в формате передачи данных: количество в виде знакового 8-байтового Int64 в порядке little-endian. Единица измерения указывается только в строке типа: она не влияет ни на передаваемые байты, ни на текстовое представление, которое представляет собой просто целое число. Все единицы обрабатываются одним и тем же путём декодирования.
Значение 5 типа IntervalDay:
UUID
16 байт на значение. Кодирование в формате передачи данных — это не каноническая последовательность из 16 байт в порядке big-endian: каждая 8-байтовая половина переворачивается побайтово независимо от другой. Логически это 128-битный идентификатор в каноническом текстовом видеxxxxxxxx-xxxx-xxxx-xxxx-xxxxxxxxxxxx, где байты принято записывать в порядке big-endian. В формате передачи данных эти 16 канонических байт разбиваются на две 8-байтовые половины, и каждая половина записывается в порядке little-endian:
- Передаваемые байты 0..7 = канонические байты 0..7 в обратном порядке.
- Передаваемые байты 8..15 = канонические байты 8..15 в обратном порядке.
550e8400-e29b-41d4-a716-446655440000:
IPv4 и IPv6
Два родственных типа адресов, которые кодируются по-разному.IPv4 занимает 4 байта и кодируется как UInt32 в порядке little-endian, содержащий каноническое 32-битное значение адреса (значение (a << 24) | (b << 16) | (c << 8) | d для a.b.c.d). Передаваемые байты идут в порядке, обратном сетевому.
192.168.1.10 (каноническое 32-битное значение 0xC0A8010A):
IPv6 занимает 16 байт и записывается как есть, в сетевом порядке байтов, без перестановки — в том же порядке, что и в inet_pton(AF_INET6, ...).
2001:db8::1:
u32, что упрощает арифметические операции и делает запросы по диапазонам компактными, а IPv6 сохраняет сетевой порядок байтов, принятый в большинстве сетевых API.
Enum8 и Enum16
На уровне бинарного представления совместимы сInt8 и Int16 соответственно: 1 или 2 байта на строку, для 16-битного варианта — дополнительный код с порядком байтов little-endian. Полное сопоставление значений перечисления задаётся в строке типа:
(...) и обрабатывать значение как Int8 / Int16 — в передаваемых байтах содержится лишь целочисленный индекс. Клиент, который показывает метку, разбирает соответствие 'name' = value из строки типа и хранит его вместе со столбцом: по одному лишь целому числу метку не восстановить. В текстовых форматах вывода отображается метка (active), а не индекс, причём в одинарных кавычках ('active'), если enum вложен в составной тип. Поскольку соответствие невозможно восстановить по целочисленному столбцу, его необходимо сохранять для вложенных enum, таких как Array(Enum8(...)) или Map(Enum16(...), V).
Столбец Enum8('active' = 1, 'inactive' = 2) со значениями [active, inactive, active]:
30000 типа Enum16(...):
Decimal(P, S)
Знаковое целое число, масштабированное степенью 10. Ширина целого числа в байтах определяется точностьюP; масштаб S — это отрицательный показатель степени (количество цифр после десятичной точки). Оба параметра указываются в строке типа.
При кодировании в формате передачи данных значение кодируется как базовое целое число в дополнительном коде с порядком байтов little-endian, а логическое десятичное значение равно
wire_integer × 10^(-S).
ClickHouse всегда возвращает Decimal(P, S) независимо от того, как был объявлен тип. Decimal32(S), Decimal64(S) и т. д. при передаче приводятся к Decimal(P, S) (где P равно естественному максимуму для данной ширины: 9, 18, 38, 76). Декодеру достаточно распознавать только Decimal(P, S), чтобы поддерживать все варианты записи, которые возвращает сервер.
Значение 123.4567 типа Decimal(9, 4) → базовое целое 1234567:
-1.5 типа Decimal(18, 1) → базовое целое число -15:
123.4567 типа Decimal(38, 4) (всего 16 байт):
Nothing
ТипNothing не содержит значений. На практике он встречается только как внутренний тип в Nullable(Nothing) — именно его сервер возвращает для выражения вроде SELECT NULL, единственным допустимым значением которого является отсутствие значения. Концептуально это единичный тип (unit type).
При передаче по сети он занимает ровно один байт-плейсхолдер на строку. Сервер записывает ASCII-символ '0' (0x30), однако десериализатор игнорирует эти байты: их содержимое не определено, и декодеры не должны полагаться на какое-либо конкретное значение. Количество записываемых байтов равно num_rows × 1, поэтому значение num_rows в заголовке столбца однозначно определяет, сколько байтов нужно прочитать.
Благодаря одному байту на строку инвариант Block сохраняется: длина каждого столбца выводится из num_rows, поэтому декодеры читают данные последовательно, без префиксов длины для каждой ячейки. Внешний Nullable всегда помечает каждую позицию как NULL, так что плейсхолдеры никогда не проверяются.
Столбец Nullable(Nothing) из 3 строк (все NULL):
Nullable (см. Nullable), а три внутренних байта — полезная нагрузка Nothing, которую декодер пропускает.
Типы переменной длины
В передаваемых данных каждое значение сопровождается собственной длиной.String
Строка типа:String. Для столбца String существует два формата передачи данных; какой из них используется, определяется ревизией протокола (см. На что влияет ревизия). В собственном TCP-протоколе используется согласованная ревизия, а для вывода FORMAT Native — значение client_protocol_version (по умолчанию 0). Для ввода FORMAT Native ревизия всегда равна 0, а формат Buffers всегда использует схему для отдельных значений.
Схема для отдельных значений применяется при ревизии ниже DBMS_MIN_REVISION_WITH_STRING_WITH_SIZE_STREAM_SERIALIZATION (54492), в том числе при ревизии 0, которую FORMAT Native использует по умолчанию. Данные представляют собой последовательность из num_rows байтовых последовательностей, каждой из которых предшествует её длина:
0x00. Общий объём, занимаемый столбцом, составляет Σ (varuint_size(len_i) + len_i) байт по всем строкам.
Столбец из 3 строковых значений ["ab", "", "c"] (всего 6 байт):
String со смещениями — начиная с ревизии 54492: два идущих подряд потока — сначала накопительные байтовые смещения, затем все данные:
Array передаёт свои смещения по собственному протоколу. Смещение i — это позиция конца значения i в блоке данных, поэтому размер значения i равен offset[i] - offset[i-1] (при offset[-1] = 0), а последнее смещение равно общему размеру блока данных. Декодер считывает 8 × num_rows байт смещений, а затем читает весь блок данных за один раз, используя последнее смещение в качестве его точной длины. Это позволяет заранее выделить буфер точного размера и выполнить пакетное копирование вместо построчного разбора, а также избавляет от необходимости преобразовывать размеры в смещения. Столбец с num_rows = 0 не добавляет ни байта ни в один из потоков.
Те же 3 строки ["ab", "", "c"] (всего 27 байт):
String со смещениями, она применяется ко всем String в блоке, включая String, вложенные в составные типы (Array(String), Nullable(String), Map, Tuple, Variant, Dynamic, JSON), — за одним исключением: словарь столбца LowCardinality всегда записывается со стандартной вложенной сериализацией, поэтому его значения String сохраняют схему для отдельных значений в любой ревизии. Это касается LowCardinality(String), LowCardinality(Nullable(String)) и любого другого словаря LowCardinality, содержащего String.
В обеих структурах String в ClickHouse является байтовым, а не текстовым типом: корректность UTF-8 не проверяется, и значение может содержать произвольные байты, в том числе NUL. Декодер, отображающий данные на строковый тип UTF-8, либо проверяет их при чтении, либо передаёт вызывающему коду необработанные байты.
FixedString(N)
Строка типа:FixedString(N), где N — положительное целое число (например, FixedString(16)). Столбец занимает ровно N × num_rows необработанных байтов, без префиксов длины и без разделителей. Декодер извлекает N из строки типа и считывает ровно столько байтов на каждую строку.
Если SQL-запрос вставляет значение короче N байтов (например, CAST('abc' AS FixedString(5))), сервер дополняет его справа NUL-байтами (0x00) до объявленной длины. Эти байты дополнения являются частью сохранённого значения и передаются по сети как есть; их удаление — задача клиента. Как и String, тип FixedString(N) по своей природе ближе к массиву байтов, чем к тексту: обычно его используют для идентификаторов фиксированной длины, байтов адресов или хеш-дайджестов.
Два значения FixedString(3) ["abc", "de\0"] (всего 6 байтов):
Составные типы
Составные типы оборачивают один или несколько внутренних типов и используют общую модель передачи данных: несколько потоков на столбец. Один логический столбец кодируется как две или более последовательности байтов, которые читаются независимо и записываются друг за другом. У них есть три общих структурных свойства:- Фиксированная форма для заданной схемы. Структура полностью определяется строкой типа в момент декодирования. У
Array(UInt32)структура потоков всегда одинакова от блока к блоку. - Нет собственного префикса версии. Сама составная обёртка не добавляет байт версии; её фрейминг (смещения, карта NULL, потоки элементов) стабилен во всех релизах ClickHouse. Это относится только к обёртке — о внутренних версионируемых типах см. примечание о фазе префикса ниже.
- Нет собственного межблочного состояния. Фрейминг обёртки полностью самоописывающийся в пределах блока; если межблочное состояние и нужно учитывать, то из-за внутреннего версионируемого типа, а не из-за обёртки.
SerializationArray выполняет фазу префикса внутреннего типа до записи смещений массива, а Tuple, Map, Nested и Nullable делают то же самое через сериализации своих элементов (Nullable выполняет внутренний префикс до своей карты NULL).
Поэтому, когда составной тип оборачивает версионируемый тип или тип с сохранением состояния (LowCardinality, Variant, Dynamic, JSON), префикс версии/состояния этого внутреннего типа записывается первым — до смещений обёртки и полезной нагрузки элементов. Например, Array(LowCardinality(String)) имеет раскладку [LowCardinality state prefix] → [array offsets] → [flattened LowCardinality element payload], а не начинается со смещений.
Декодер, который читает смещения до выполнения внутренней фазы префикса, потеряет синхронизацию на любом составном типе, содержащем LowCardinality, Variant, Dynamic или JSON. Если все внутренние типы — простые листовые или другие неверсионируемые составные типы, фаза префикса не записывает ни одного байта, и приведённое ниже описание, где смещения идут первыми, применимо без изменений.
Nullable(T)
Строка типа:Nullable(InnerType). Примеры: Nullable(UInt32), Nullable(String), Nullable(FixedString(16)), Nullable(DateTime('UTC')).
Как и другие составные типы, Nullable перед записью карты NULL делегирует фазу префикса сериализации внутреннего типа: если внутренний тип версионируемый, его префикс состояния записывается первым. Поэтому Nullable(Tuple(LowCardinality(String))) начинается с префикса состояния LowCardinality, а не с карты NULL. Если внутренний тип конечный (листовой) или иной неверсионируемый, фаза префикса не записывает ни одного байта.
Формат передачи данных: фаза префикса внутреннего типа (пустая, если внутренний тип не версионируемый), а за ней — два последовательно записанных потока, первым из которых идёт карта NULL:
num_rows байт, по одному на каждую строку:
Поток значений содержит данные всех
num_rows строк без исключения, включая позиции NULL, в стандартном кодировании внутреннего типа. Декодер всё равно должен прочитать байты плейсхолдера в позициях NULL, чтобы продвинуться по потоку, но перед интерпретацией любого отдельного значения обязан свериться с картой NULL. Отправитель может записывать в позиции NULL произвольные байты, поэтому декодеры не должны полагаться на конкретное значение плейсхолдера.
Значения плейсхолдеров в зависимости от семейства внутреннего типа:
Nullable(T) может находиться внутри Array, Tuple, Map и Nested — часто встречаются Array(Nullable(T)) и Tuple(Nullable(T1), T2). Nullable нельзя вкладывать сам в себя: сервер отклоняет Nullable(Nullable(T)).
Nullable(UInt8) с тремя строками [5, NULL, 9] (всего 6 байт):
Nullable(String) из трёх строк ["hello", NULL, "world"] (всего 15 байт):
Array(T)
Строка типа:Array(InnerType). Примеры: Array(UInt32), Array(String), Array(Nullable(UInt32)), Array(Array(UInt8)).
Формат передачи данных состоит из фазы префикса внутреннего типа (она пуста, если внутренний тип не версионируемый), за которой следуют два записанных подряд потока — сначала смещения:
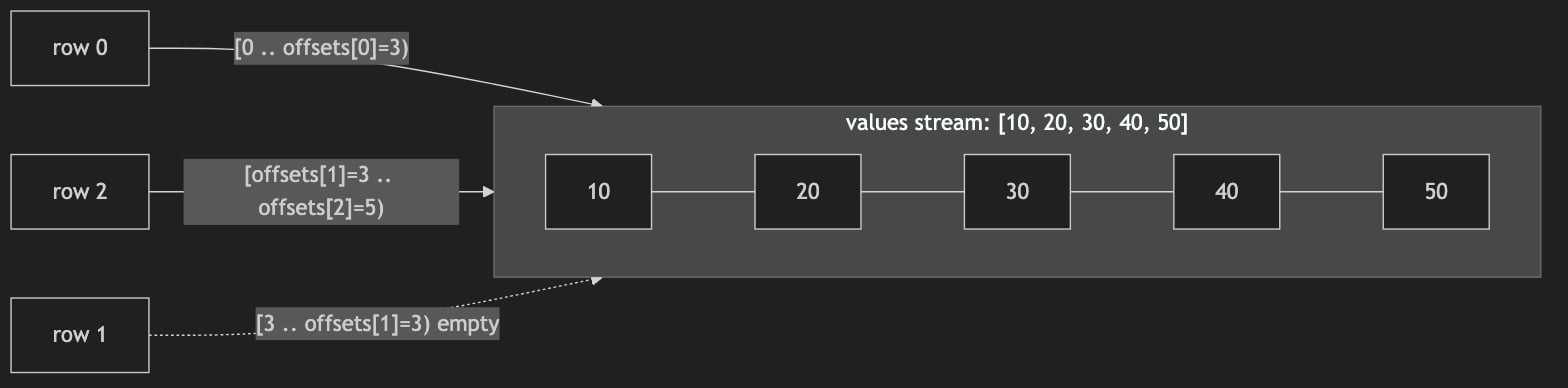
num_rows значений UInt64 в порядке little-endian; каждое из них — это накопленная конечная позиция в потоке значений после элементов соответствующей строки:
- Начальный индекс элементов строки
N=offsets[N - 1](или0, еслиN == 0). - Конечный индекс элементов (не включительно) строки
N=offsets[N]. - Количество элементов в строке
N=offsets[N] - offsets[N - 1].
offsets[num_rows - 1] — это общее количество элементов во всех строках, и поток значений содержит ровно столько внутренних значений, записанных подряд друг за другом.
Смещения монотонно не убывают: равные соседние смещения означают пустую строку, а немонотонные смещения декодер должен отвергать как признак повреждения данных. Для пустого столбца (num_rows == 0) не записывается ни одного байта — нет ни потока смещений, ни потока значений. Внутренний тип может быть любым, в том числе другим составным: Array(Array(T)), Array(Tuple(...)) и Array(Nullable(T)) — всё это допустимые типы.
Array(UInt32) со строками [[10, 20, 30], [], [40, 50]] (всего 44 байта):
0 для строки 0). Два одинаковых смещения подряд обозначают пустую строку:
Array(String) со строками [["a", "bb"], []] (всего 20 байт):
Array(Array(UInt32)) со строками [[[1,2]], [], [[3], [4,5]]] устроен по той же схеме, но с дополнительным уровнем вложенности:
- Внешние смещения:
[1, 1, 3]— строка 0 содержит 1 внутренний массив, строка 1 — 0, строка 2 — 2. - Средний
Array(UInt32)декодирует 3 строки со смещениями[2, 3, 5]. - Самый внутренний
UInt32декодирует 5 значений:[1, 2, 3, 4, 5].
Tuple(T1, T2, …)
Строка типа:Tuple(T1, T2, ..., Tn). Примеры: Tuple(UInt32, String), Tuple(Int32), Tuple(Array(UInt32), String), Tuple(UInt8, Tuple(Int32, String)). ClickHouse также поддерживает именованные Tuple вида Tuple(a UInt32, b String); имена хранятся только в метаданных и не влияют на формат передачи данных.
В формате передачи данных сначала идёт фаза префикса элементов (каждый версионируемый элемент в порядке объявления добавляет свой префикс состояния; для неверсионируемых элементов фаза пуста), а затем — N последовательно записанных потоков, по одному на тип каждого элемента, в порядке объявления:
num_rows значений. Префикса длины, потока смещений и разделителей между потоками нет. Для пустого столбца (num_rows == 0) в каждый поток записывается ноль байт. Элементы могут быть любого типа, в том числе составного: Tuple(Tuple(...), ...), Tuple(Array(...), ...) и Tuple(Nullable(T1), T2) — всё это допустимые типы.
Tuple без элементов Tuple() также допустим — он возникает в выражениях вида SELECT tuple() или CAST(x AS Tuple()). Поскольку потоков элементов у него нет, он сериализуется так же, как Nothing: один байт-плейсхолдер (0x30, ASCII '0') на строку, который при десериализации отбрасывается. Количество строк берётся из заголовка блока — точно так же, как для Nothing.
Tuple(UInt8, UInt8) с 3 строками (1,4), (2,5), (3,6):
[1, 2, 3] для элемента 0 и [4, 5, 6] для элемента 1.
Tuple(UInt32, String) с 2 строками (10, "a"), (20, "bb") (всего 13 байт):
Map(K, V)
Строка типа:Map(KeyType, ValueType). Примеры: Map(String, UInt32), Map(String, Array(UInt32)), Map(UInt8, Tuple(Int32, String)), Map(Array(String), Int8). Формат передачи данных не накладывает ограничений ни на один из типов: и K, и V могут быть любым поддерживаемым типом, включая составные. (Правила ClickHouse на уровне SQL в отношении допустимых типов ключей менялись от релиза к релизу; уточняйте их в документации по SQL для нужной версии сервера.)
Формат передачи данных побайтово идентичен Array(Tuple(K, V)), поэтому он начинается с внутренней фазы префикса (она пуста, если ни K, ни V не являются версионируемыми):
total_pairs = offsets[num_rows - 1] (или 0, если num_rows == 0). Поток смещений имеет ту же семантику, что и у Array. Ключи позиционно выровнены со значениями: пара i — это (keys[i], values[i]).
В памяти ClickHouse столбец Map представлен как массив Tuple; система типов выделяет его в отдельный тип для удобства работы в SQL (m['key'], mapKeys, mapValues). Формат передачи данных является прямой сериализацией этого представления, поэтому Map и Array(Tuple(K, V)) побайтно взаимозаменяемы.
Смещения монотонно не убывают, а потоки ключей и значений содержат ровно по total_pairs значений. Для пустого столбца записывается ноль байт. В пределах одной строки ключи, как правило, уникальны, однако это семантическое правило, а не ограничение формата передачи данных: формат допускает обратимый обмен дублирующимися ключами, а дубликаты разрешаются на стороне сервера только тогда, когда строку обрабатывает функция, поддерживающая Map.
Map(UInt8, UInt8) с 2 строками {1:10, 2:20}, {3:30} (всего 22 байта):
i восстанавливается совместным чтением keys[i] и values[i].
Map(String, UInt32) с одной строкой {'a':1, 'b':2} (всего 20 байт):
Nested(name1 T1, name2 T2, …)
ПредставлениеNested при передаче по сети зависит от серверной настройки flatten_nested, и здесь возможны два случая.
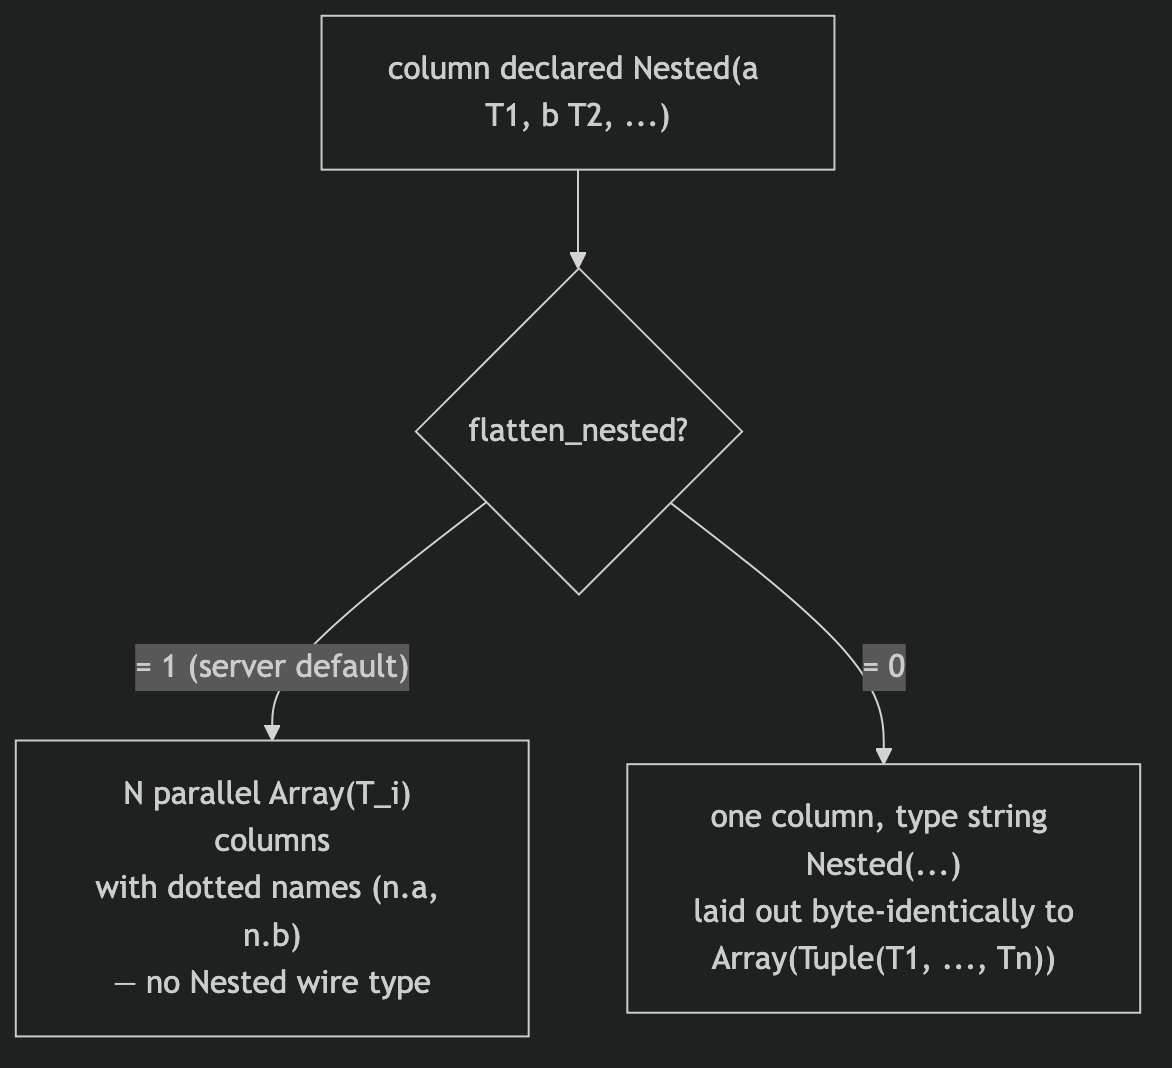
flatten_nested = 1 (значение по умолчанию на сервере). Если таблица была создана с настройками по умолчанию, Nested не является типом передачи (wire type). Сервер хранит и отдаёт столбец в виде N параллельных столбцов Array(T_i) с именами через точку (outer.field1, outer.field2 и так далее). Для уровня формата здесь нет ничего нового: каждый такой столбец — это обычный Array:
flatten_nested = 0. Если таблица была создана с flatten_nested = 0, при передаче по сети столбец представляется одним столбцом со строкой типа Nested(name1 T1, name2 T2, ...), а его структура после строки типа побайтно идентична Array(Tuple(T1, T2, ..., Tn)), включая внутреннюю фазу префикса. Поэтому любое версионируемое поле T_i сначала выдаёт свой префикс состояния и только затем — смещения. В примере ниже используются неверсионируемые поля, поэтому фаза префикса пуста:
Nested сохраняет имена полей (a, b), тогда как в Array(Tuple) они не хранятся как именованные позиции.
Строка типа в случае B представляет собой список пар (имя, тип), разделённых запятыми. Имя отделяется от типа первым пробельным символом; сам тип может содержать дополнительные пробельные символы, запятые и скобки, поэтому для разбора нужен тот же разделитель с учётом глубины вложенности, что и для Tuple. Формат передачи данных:
total_elements = offsets[num_rows - 1] (или 0, если num_rows == 0). Смещения монотонно не убывают, а каждый поток поля содержит ровно total_elements значений. При INSERT сервер проверяет, что в пределах одной строки все поля содержат одинаковое количество элементов. Для пустого столбца не записывается ни одного байта.
Nested(a UInt8, b String) с 2 строками [(10,'x'),(20,'y')] и [(30,'z')] (25 байт после строки типа):
Псевдонимы типов
Некоторые типы являются просто псевдонимами: сервер передаёт имя псевдонима в заголовке столбца, но следующие за ним байты соответствуют базовому типу. Декодер сопоставляет псевдоним с этим типом и использует его кодек — никакого нового формата передачи данных не требуется. Географические типы являются псевдонимами вложенных массивов и Tuple:
Таким образом, столбец
Point декодируется в точности как Tuple(Float64, Float64) (отображается как (1,2)), Ring — как Array(Tuple(Float64, Float64)) ([(0,0),(1,1)]), и так далее вверх по иерархии.
Geometry также является псевдонимом, но не вложенного массива, а Variant: его полезная нагрузка — вариант из семи перечисленных выше гео-типов. Заголовок столбца содержит только строку типа Geometry и не раскрывает состав варианта, поэтому декодер должен развернуть его самостоятельно. В отличие от Variant, явно заданного пользователем, дискриминаторы Geometry не упорядочены по имени: они зафиксированы для обеспечения совместимости, а новые гео-типы лишь дописываются в конец. Соответствие следующее: 0 = LineString, 1 = MultiLineString, 2 = MultiPolygon, 3 = Point, 4 = Polygon, 5 = Ring, 6 = MultiPoint (добавлен в 26.7 — в потоках от более старых серверов дискриминатор 6 попросту не встречается). Затем каждое выбранное значение декодируется через соответствующий гео-псевдоним из таблицы выше (для NULL используется дискриминатор NULL типа Variant — 255).
SimpleAggregateFunction(func, T) является псевдонимом своего типа значения T. Он хранит уже финализированное агрегированное значение, поэтому его форма передачи и отображение полностью совпадают с T (SimpleAggregateFunction(sum, UInt64) декодируется как UInt64). Псевдонимом в этом смысле является только форма с одним типом значения; при этом сам базовый тип может быть составным.
Два связанных типа не являются псевдонимами. Это допустимые типы столбцов
Native — например, клиент может получить столбец AggregateFunction от комбинатора -State или при распределённой агрегации, — но каждый из них несёт собственную специализированную полезную нагрузку, описание которой выходит за рамки этой страницы:AggregateFunction(func, ...)хранит промежуточное состояние агрегации (а не итоговое значение); его бинарная структура зависит от агрегатной функции и её версии. Имя функции может содержать параметры, каждый из которых выводится как SQL-литерал, напримерAggregateFunction(topK(3), UInt64). Некоторые агрегатные функции выводят у параметра явный суффикс::Type, напримерAggregateFunction(topK('3'::Decimal32(0)), UInt64), поскольку у значенияDecimalили широкого целого числа нет литеральной формы без суффикса; делает ли так функция, определяется самой функцией, а не форматом, поэтому декодер, анализирующий параметры, должен принимать оба варианта записи. На декодер, которому нужны только типы аргументов, это не влияет. Версионируемая агрегатная функция записывает ненулевую версию состояния первым аргументом строки типа —AggregateFunction(1, quantileDeterministic, UInt64, UInt64), — а версия0не выводится, и строка типа остаётсяAggregateFunction(quantileDeterministic, UInt64, UInt64). На согласованном соединении (ревизия выше0) пишущая сторона выбирает версию исключительно по ревизии протокола — и никогда по версии, которая может оказаться закреплённой в её локальном типе, поскольку при передаче версия0неотличима от «версия не объявлена», — поэтому одна и та же функция может объявлять разные версии на разных соединениях, и считыватель должен брать версию из строки типа, а не исходить из самой новой. При ревизии0нет peer, для которого нужно выводить версию, — поток самоописывающийся и считывается тем же, кто его записал, — поэтому закреплённая в типе версия сохраняется в потоке (и в объявленной строке типа) и не понижается до0.quantileDeterministic(а также варианты записиquantilesDeterministicиmedianDeterministic) версионируется начиная с ревизии54491: версия1добавляет в конец состоянияUInt8 skip_degree, а её префикс побайтово идентичен версии0. На ревизиях ниже этой пишущая сторона выдаёт состояния версии0, так что на более старый peer это не влияет.uniqверсионируется начиная с ревизии54493: версия1добавляет перед структурой версии0байт флагов и, если установлен бит0флагов, дописывает небольшую дополнительную выборку полных 64-битных хешей, каждый из которых объединён операцией XOR с константой0x9E3779B97F4A0000(UInt8 skip_degree,VarUInt count, затем 8-байтовые значения), что сохраняет точность оценки при кардинальности свыше двух миллиардов; состояние версии0содержит только основную 32-битную выборку. Бит1флагов означает, что 64-битная выборка неполна — состояние поглотило состояние версии0, элементы которого никогда не попадали в 64-битную выборку, — и в этом случае 64-битная выборка не записывается, а считыватель должен выполнять оценку только по основной 32-битной выборке (и продолжать указывать это в состояниях, которые он записывает далее); поэтому эти два бита взаимоисключающие, и считыватель должен отклонять состояние, в котором установлены оба. Другие биты не определены, и считыватель должен отклонять состояние, в котором установлен любой из них. Всё это в равной мере относится к состоянию, вложенному в контейнерный тип —Array,Tuple,Map,Nullable,Variant(где явно записанная версия альтернативы меняет строку типа, не меняя порядок дискриминаторов) или обёрткуNested/SimpleAggregateFunction. То же относится и к комбинаторам агрегатных функций: сквозной комбинатор над версионируемой функцией —uniqIf,uniqArray,uniqForEach,uniqMap,uniqArgMin/uniqArgMax,uniqOrNull/uniqOrDefault,uniqResample, а также неявный адаптер для аргументовNullable— передаёт версию вложенным состояниям, содержащимся в его полезной нагрузке, явно записывает текущую версию вложенной функции в строке типа свежего состояния точно так же, как обычная функция (AggregateFunction(1, uniqIf, UInt64, UInt8)), и аналогичным образом выводит версию из ревизии протокола на согласованном соединении. Пользовательское имя обёртки содержит вторую копию типа её аргумента, поэтому пишущая сторона должна пересобрать эту копию с той же согласованной версией состояния агрегации; иначе заголовок может объявить версию1для полезной нагрузки версии0. Для одного граничного случаяVariantпредставления при передаче не существует вовсе: если две альтернативы различаются только явно записанной версией состояния (что допустимо для типа столбца, так как строки типов различаются), перевод обеих на версию согласованной ревизии слил бы их в одну альтернативу, поэтому отправитель должен прервать передачу, а не объявлять версии, в которых полезная нагрузка не записана.Dynamic— намеренное исключение из выбора версии по ревизии: столбецDynamicсам объявляет свои вложенные типы — через собственные списки типов и через бинарное кодирование типов, явное поле версии которого содержит явно записанную версию состояния (значения его общего варианта встраивают свой тип именно так даже при хранении), — и эти уведомления входят в собственные данные столбца и одинаковы для любого peer и любого носителя, поэтому они никогда не переписываются под согласованную ревизию. Следовательно, состояние, вложенное в значениеDynamic, записывается в версии, указанной в его типе (её содержит свежее состояние, так как результат запроса-Stateявно записывает свою версию), или в версии0, если тип её не указывает, — одинаково на любом соединении и носителе.QBit(T, N[, stride])хранит вектор с транспонированными битовыми плоскостями для задач векторного поиска; структура его потоков при передаче (потоки битовых плоскостейFixedString, упорядоченные по группам, в количествеelement_size * (N / stride)при явномstride) и его бинарное кодирование типа (тег0x36или0x37QBitWithStrideприstride != N) описаны на странице типа данныхQBitи в справочнике по бинарному кодированию типов, так что считывателюNativeне нужно восстанавливать их по исходному коду на C++.
Версионируемые типы
Версионируемые типы передают в сериализованном виде префикс версии сериализации, который указывает, какой вариант кодирования следует за ним. Они также могут использовать несколько потоков (как и составные типы). В форматеNative префикс и словарь (если он есть) передаются в каждом блоке отдельно — эти типы не сохраняют состояние между блоками (см. примечание о префиксе в каждом блоке ниже); состояние сериализации, общее для нескольких блоков, существует только в потоке MergeTree на диске.
Эти типы значительно сложнее составных типов с фиксированной структурой, поэтому клиент, рассчитанный на простые аналитические запросы, может отложить их поддержку.
Версия сериализации: концепция
Версия сериализации — это номер версии в передаваемых данных, задаваемый отдельно для каждого типа и каждого столбца; он указывает, какой вариант кодирования типа использует отправитель. Версия идёт первой в префиксе состояния столбца: декодер считывает её и передаёт разбор оставшейся части столбца нужному парсеру. Её не следует путать с версией протокола:
Большинство версионируемых типов записывают версию как UInt64 в порядке little-endian непосредственно перед всеми остальными данными префикса состояния; некоторые используют VarUInt или UInt8. Декодер сначала считывает версию и отклоняет неизвестные значения: более высокая версия означает более новый формат отправителя, который декодер не поддерживает, а неверный разбор испортит все последующие байты.
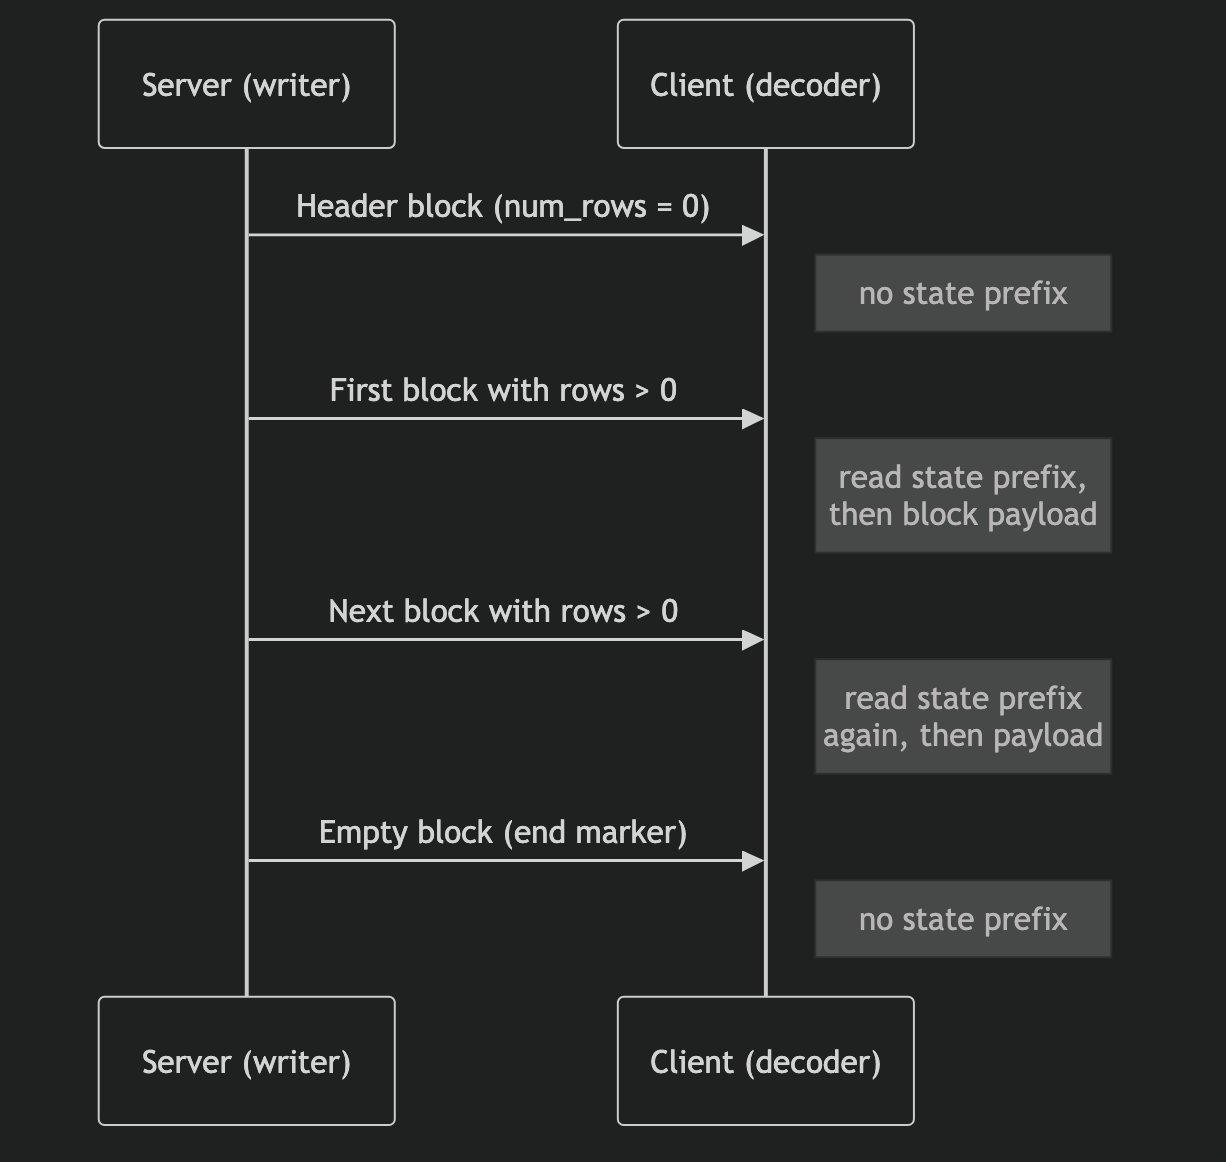
Префикс состояния записывается в начале каждого блока, количество строк в котором больше нуля, непосредственно перед полезной нагрузкой этого блока.
Средство записи Native и считыватель не сохраняют состояние сериализации между блоками:
NativeWriter создаёт новое состояние сериализации и записывает префикс состояния для каждого записываемого непустого блока столбца, а NativeReader создаёт новое состояние десериализации и считывает префикс для каждого читаемого непустого блока (оба полностью пропускают префикс, если rows == 0).
Поэтому для блоков заголовков (rows = 0) и пустых блоков ничего не записывается, а декодер должен заново считывать префикс состояния в начале каждого непустого блока. Декодер, который считывает префикс только один раз и считает, что последующие блоки содержат только полезную нагрузку, прочитает префикс следующего блока как данные и рассинхронизируется:
Справочник версий сериализации
Несколько замечаний к таблице:
- Значения идут не подряд.
Dynamicиспользует1,2,3,4, причёмV3соответствует4, аFLATTENED—3. Большее число не обязательно означает более новую версию. - Некоторые значения используются только в формате Native.
Object::STRING,Object::FLATTENEDиDynamic::FLATTENEDнужны для совместимости по нативному протоколу с клиентами, которые не полностью реализуют Object/Dynamic. В данных MergeTree на диске они не встречаются. V3используется только на диске.Object::V3иDynamic::V3приведены в таблице потому, что эти значения уже заняты и не должны использоваться повторно, а вовсе не потому, что декодер может с ними столкнуться: ClickHouse никогда не передаёт их в форматеNativeи отклоняет их там с ошибкойINCORRECT_DATA. Всё, что с ними связано, — подверсия shared-data вObject::V3, а также её структуры бакетов и гранул, — относится к части, а не к блоку, и поэтому выходит за рамки этой страницы. Клиенты, работающие по собственному TCP-протоколу, видят толькоV1,V2,STRINGилиFLATTENED.
LowCardinality(T)
Простейший версионированный тип. Он заменяет столбец изN внутренних значений небольшим словарём уникальных значений и N индексами, указывающими на элементы этого словаря.
Строка типа: LowCardinality(InnerType). Примеры: LowCardinality(String), LowCardinality(FixedString(4)), LowCardinality(Nullable(String)).
sharedDictionariesWithAdditionalKeys; остальные значения зарезервированы.
Метаданные блока (UInt64) представляют собой битовое поле:
Для типичного ответа на запрос с одним блоком данных на столбец метаданные равны
0x600 (HasAdditionalKeys + NeedUpdateDictionary).
Значения словаря — это dict_size значений, закодированных во внутреннем типе T. В начале словаря резервируются слоты под специальные значения: для столбца без Nullable резервируется один слот (dict[0] содержит значение по умолчанию внутреннего типа, например "" для String), а реальные уникальные значения начинаются с dict[1].
Для LowCardinality(Nullable(T)) словарь по-прежнему кодируется как обычный T (без потока карты NULL), но резервируются два слота: dict[0] — маркер NULL, а dict[1] — значение по умолчанию внутреннего типа (например, "" для String); реальные уникальные значения начинаются с dict[2]. Ключ строки со значением NULL указывает на dict[0], а сам этот слот передаётся как байты значения по умолчанию внутреннего типа.
Ключи — это индексы в словаре; каждый индекс занимает 1 << key_type_code байт (1, 2, 4 или 8), а значение N восстанавливается как dict[keys[N]].
keys_count — это количество значений LowCardinality на текущем уровне рекурсии, и оно не обязательно совпадает с количеством строк блока. Для столбца LowCardinality верхнего уровня они совпадают. Но если LowCardinality вложен в составной тип, это количество равно развёрнутому числу значений, которое передаёт ему составной тип: для Array(LowCardinality(String)) с тремя строками, содержащими в сумме пять элементов, keys_count равно 5, а не 3; для Map(K, LowCardinality(V)) это общее количество пар и т. д. Декодер должен брать keys_count из этого поля, а не полагаться на количество строк блока. Если это развёрнутое количество равно нулю (например, в блоке, где все массивы пусты), фаза данных LowCardinality не записывает ничего: присутствует только префикс состояния (выводимый в фазе префикса составного типа), а метаданные, словарь и keys_count за ним не следуют.
Префикс состояния считывается в начале каждого блока, количество строк в котором больше нуля; блоки-заголовки (rows = 0) и пустые блоки ничего не выводят. Внутри блока keys_count равно количеству строк, dict_size — количеству значений в потоке dict, а каждый ключ занимает не более 1 << key_type_code байт.
В формате
Native каждый блок передаёт самодостаточный словарь, локальный для блока: состояние словаря между блоками не сохраняется. Пишущая сторона Native устанавливает low_cardinality_max_dictionary_size = 0, поэтому SerializationLowCardinality никогда не строит общий словарь: каждый непустой блок записывает свои ключи как локальные для блока дополнительные ключи со сброшенным NeedGlobalDictionaryBit (метаданные 0x600), а средство чтения Native отклоняет NeedGlobalDictionaryBit, если native_format равно true. Поэтому декодер должен сбрасывать словарь в каждом блоке и считывать dict_size записей, присутствующих в этом блоке; если перенести словарь из предыдущего блока, ключи следующего блока будут прочитаны неверно. (Сохранение словаря LC между блоками относится к хранению MergeTree на диске, а не к формату передачи данных Native.)LowCardinality(String) со значениями ['a', 'b', 'a', 'c', 'b']:
dict[1], dict[2], dict[1], dict[3], dict[2] = ["a", "b", "a", "c", "b"].
LowCardinality(Nullable(String)) со значениями ['a', NULL, '', 'b'] демонстрирует оба зарезервированных слота: dict[0] для NULL и dict[1] для значения по умолчанию (пустой строки):
dict[2] = "a", dict[0] = NULL, dict[1] = "", dict[3] = "b", т. е. ["a", NULL, "", "b"]. И dict[0], и dict[1] в передаваемых данных представлены пустой последовательностью байтов; значение NULL определяется тем, что ключ указывает на слот 0, а не содержимым байтов.
JSON (уровень 1: резервный вариант String)
Для типаJSON в ClickHouse существует несколько вариантов кодирования в формате передачи данных (см. справочник версий сериализации). Уровень 1 — самый простой: если для запроса задана настройка output_format_native_write_json_as_string = 1, сервер преобразует каждое значение JSON в сериализованный текст и передаёт столбец как String с маркером префикса состояния.
Строка типа: JSON.
1. Остальные значения обозначают другие варианты кодирования JSON/Object: 0 = V1, 2 = V2 (используется по умолчанию в собственном TCP-протоколе), 3 = FLATTENED, 4 = V3 (см. справочник версий сериализации). Если декодер встречает здесь значение, отличное от 1, значит, перед ним не резервный вариант String. Префикс считывается в начале каждого блока, содержащего более 0 строк, а поток значений представляет собой стандартный столбец типа String из num_rows строк.
Значение JSON '{"a":1}' (одна строка):
{"a":1}, причём целое число остаётся целым числом. Этот текст — просто значение типа String, поэтому клиент получает JSON, который можно передать дальше как есть, но не восстанавливает отдельные пути и их типы ClickHouse; для точной типизации каждого пути требуется кодирование уровня 2, описанное ниже.
Variant(T1, T2, …)
Размеченное объединение: каждая строка содержит значение ровно одного из типов варианта либо NULL. Для каждой строки хранится однобайтовый глобальный дискриминатор, определяющий её тип, а значения каждого типа затем хранятся плотно — одним непрерывным блоком на каждый тип варианта. Строка типа:Variant(T1, T2, ...). Сервер приводит порядок к каноническому виду (типы варианта сортируются по имени), поэтому в полученной строке типа типы уже перечислены в порядке глобальных дискриминаторов: дискриминатор 0 соответствует первому указанному типу, 1 — второму и так далее. 255 (NULL_DISCRIMINATOR) означает, что строка содержит NULL. Элементы Variant никогда не бывают Nullable — за представление NULL отвечает дискриминатор. Примеры: Variant(String, UInt64), Variant(Array(UInt8), String).
Префикс состояния содержит режим дискриминаторов в формате UInt64 LE: 0 = BASIC (дискриминатор каждой строки записывается как есть), 1 = COMPACT (кодирование гранул по длинам серий). По умолчанию при работе через собственный протокол сервер использует BASIC (use_compact_variant_discriminators_serialization = false); здесь описан только режим BASIC.
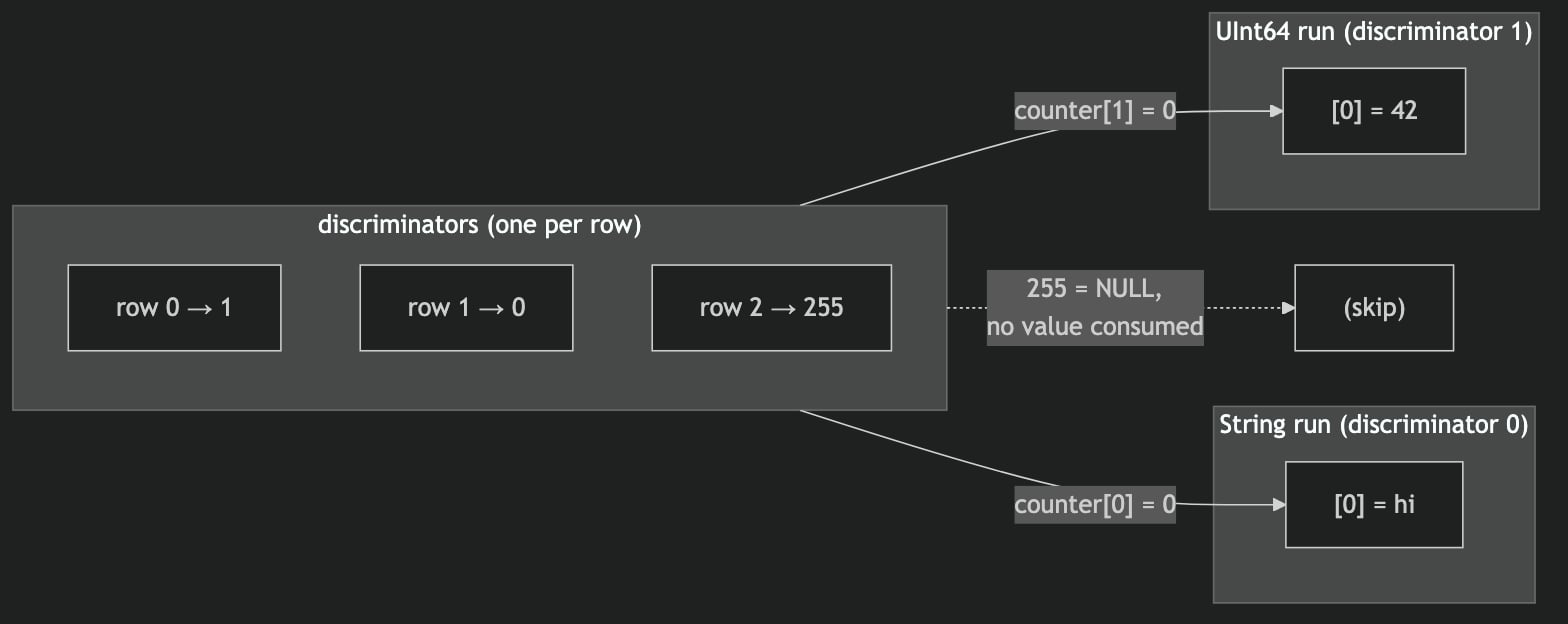
r с дискриминатором d (≠ 255) получает значение с индексом counter[d] из последовательности значений типа варианта d, после чего counter[d] увеличивается на единицу. Строки с дискриминатором 255 содержат NULL и не забирают значений ни из одной последовательности, поэтому сумма счётчиков по всем типам равна количеству строк со значениями, отличными от NULL.
Префикс состояния (режим UInt64) считывается в начале каждого блока, содержащего более 0 строк; для заголовка и пустых блоков ничего не записывается. Каждый дискриминатор, отличный от NULL, меньше количества типов вариантов, а тип варианта i декодируется ровно для count[i] строк.
Элементы Variant, которые сами являются типами с сохранением состояния (
LowCardinality, Variant, Dynamic, JSON), записывают собственный префикс состояния в фазе префикса состояния для каждого элемента — после режима UInt64. Конечные типы и простые составные типы (Array, Tuple, Map из конечных типов) имеют пустые префиксы состояния и могут свободно комбинироваться.Variant(String, UInt64) со значениями [42, 'hi', NULL] (в каноническом порядке String идёт перед UInt64, поэтому дискриминатор 0 = String, 1 = UInt64):
42; строка 1 = String run[0] = "hi"; строка 2 = NULL.
Поток дискриминаторов служит индексом: каждый дискриминатор, отличный от NULL, берёт следующее значение из плотной последовательности своего типа, а 255 (NULL) ничего не потребляет. Тем же обходом восстанавливается и Dynamic, который отличается лишь способом кодирования NULL:
Dynamic
Столбец, тип значений которого определяется во время выполнения: каждая строка содержит значение одного из типов, набор которых определяется во время выполнения, либо NULL. В отличие отVariant, набор типов не входит в строку типа столбца — он передаётся в префиксе состояния.
Строка типа: Dynamic или Dynamic(max_types=N). Параметр max_types ограничивает число различных типов, отслеживаемых столбцом, но не влияет на описанный ниже формат передачи данных.
У Dynamic есть четыре варианта кодирования — V1 = 1, V2 = 2, FLATTENED = 3, V3 = 4. Какой из них использует сервер, зависит от канала и настроек запроса:
- При использовании
clickhouse-clientи HTTPFORMAT Nativeревизия пишущей стороны равна0(если её не повысить с помощьюclient_protocol_version), поэтому по умолчанию используется V1. - В собственном TCP-протоколе при согласованной ревизии по умолчанию используется V2. Пишущая сторона
Nativeне включает статистику, поэтому полезная нагрузкаV2по умолчанию не содержит статистики по вариантам — сразу после списка типов идут вложенный префиксVariantи данные. (Статистика по вариантам относится к хранению на диске в MergeTree и не входит в формат передачи данных Native.) - Настройка запроса
output_format_native_use_flattened_dynamic_and_json_serialization = 1переопределяет оба случая: сервер отправляет FLATTENED (версия 3) независимо от ревизии.
Область примененияНа этой странице описана только структура
FLATTENED. Неуплощённые бинарные структуры V1/V2/V3 — это внутреннее представление на диске (бинарно закодированные списки типов, статистика по вариантам), и здесь они не описываются. Клиент, который хочет декодировать Dynamic по этой странице, должен запросить FLATTENED, установив output_format_native_use_flattened_dynamic_and_json_serialization = 1; описанная ниже структура предполагает, что эта настройка включена. Поскольку префикс начинается с байта версии, декодер может определить, какое кодирование он фактически получил, и отклонить V1/V2/V3, если поддерживает только FLATTENED.num_types типов плюс слот для NULL: UInt8 при num_types ≤ 255, далее UInt16, UInt32, UInt64. NULL кодируется значением дискриминатора, равным самому num_types, — в отличие от Variant, где NULL соответствует фиксированному значению 255. Восстановление выполняется тем же плотным обходом, что и для Variant: для каждого типа ведётся отдельный счётчик, и строка r с дискриминатором d (≠ num_types) получает значение counter[d] из последовательности значений типа d.
Префикс состояния (версия + список типов) считывается в начале каждого блока, у которого число строк > 0; блоки-заголовки и пустые блоки ничего не выводят.
Некорректные счётчики
num_types считывается из потока раньше, чем имена типов. Декодер должен считать это значение недоверенным и не должен напрямую использовать его для определения объёма выделяемой памяти — ни значение, близкое к SIZE_MAX (оно может вызвать переполнение в промежуточных вычислениях или привести к исключению, отличному от DB::Exception), ни большое, но представимое значение, например 100000000 (оно значительно меньше max_size() вектора, но привело бы к выделению гигабайтов памяти ещё до чтения первого имени типа). ClickHouse считывает список типов по одной записи, используя лишь ограниченную подсказку для предварительного выделения памяти, поэтому повреждённое значение num_types отклоняется либо с ошибкой INCORRECT_DATA (“Dynamic column has too many types”, если значение превышает вместимость контейнера), либо как обычная ошибка чтения, когда в потоке заканчиваются записи о типах, — но никогда не как ошибка нехватки памяти.Однако не ограничивайте уплощённое значение num_types величиной ColumnDynamic::MAX_DYNAMIC_TYPES_LIMIT (254 в ClickHouse): уплощённый список типов содержит все различные типы времени выполнения, включая вытесненные в общий вариант, поэтому корректный уплощённый блок вполне может перечислять значительно больше типов. Ограничение MAX_DYNAMIC_TYPES_LIMIT применяется только к счётчику num_dynamic_types в неуплощённых префиксах V1/V2/V3: он подсчитывает слоты обычных вариантов и ограничен этим пределом (ClickHouse проверяет его там до прибавления + 1 для общего варианта).Усечённые потокиПоследовательность дискриминаторов содержит ровно
num_rows записей, и декодер должен убедиться, что прочитал именно столько, а не принимать всё, что оказалось в потоке. Более короткая последовательность ни в чём не противоречит последующим данным: количество значений каждого типа вычисляется по фактически прочитанным дискриминаторам и потому согласуется с последовательностями значений, а последовательность, целиком состоящая из маркеров NULL, вообще не требует байтов значений. ClickHouse отклоняет короткую последовательность дискриминаторов с ошибкой INCORRECT_DATA (“Mismatch in flattened Dynamic column: N rows are expected, but the indexes stream contains only M rows”) ещё до проверок по типам, поскольку восстановленный столбец затем используется для num_rows строк независимо от его фактического размера.Типы времени выполнения с сериализацией с сохранением состояния (
LowCardinality, Variant, Dynamic, JSON) содержат вложенные префиксы состояния после списка имён типов.Variant: слоты обычных вариантов записываются в порядке DataTypeVariant (по имени типа), поэтому порядок передачи не совпадает с порядком вставки. Однако глобально он отсортирован не всегда: типы, вытесненные в общий вариант (например, при Dynamic(max_types=N)), дописываются после обычных слотов в порядке первого появления, так что в конце списка порядок по именам типов может нарушаться. Поэтому декодер должен считать переданный список типов определяющим при назначении дискриминаторов и не должен пересортировывать его самостоятельно. При этом список не может содержать повторяющийся тип или Nothing: две одинаковые записи соответствуют одному дискриминатору, а Nothing вообще не является вариантом, поэтому в обоих случаях части списка не во что восстанавливаться. ClickHouse отклоняет оба случая с ошибкой INCORRECT_DATA. Для строк [42::UInt64, "hi", NULL] используются два типа — String и UInt64, причём при сортировке "String" идёт раньше "UInt64", поэтому дискриминаторы таковы: 0 = String, 1 = UInt64, 2 = NULL:
42; строка 1 = String run[0] = "hi"; строка 2 = NULL. Последовательности значений для каждого типа идут в том же порядке сериализации, что и в списке типов (String перед UInt64).
JSON (уровень 2: FLATTENED Object)
Более функциональное кодирование JSON: вместо преобразования каждого значения в текст (уровень 1) столбец разбивается на подстолбцы — по одному на каждый JSON-путь. Этот режим включается, если не запрашивать резервный вариант уровня 1 (output_format_native_write_json_as_string = 0) и при этом включить флаг уплощённой сериализации (output_format_native_use_flattened_dynamic_and_json_serialization = 1); в этом случае сервер отправляет данные в сериализации версии 3.
Пути бывают двух видов:
- Типизированные пути объявляются в строке типа, например
JSON(a UInt32, b String), и декодируются в объявленном для них типе. Если имя пути содержит точки, в строке типа оно заключается в обратные кавычки. - Динамические пути обнаруживаются во время выполнения, и каждый из них декодируется как столбец Dynamic.
num_rows значений.
Dynamic динамического пути (в фазе префикса) отделён от его данных (в фазе данных). Префикс состояния читается в начале каждого блока с количеством строк > 0, и каждый столбец пути (типизированного или динамического) содержит ровно num_rows значений. Объект строки r собирается путём чтения значения каждого пути по индексу r; динамический путь, у которого дискриминатор Dynamic для этой строки равен NULL, не добавляет ключ в объект. Имена динамических путей должны быть уникальными, и ни одно из них не может совпадать с путём, который строка типа уже объявляет как типизированный: в обоих случаях у собранного объекта оказалось бы два значения под одним ключом, поэтому ClickHouse отклоняет такие данные с ошибкой INCORRECT_DATA. То же относится и к списку динамических путей в неуплощённых кодированиях.
Некорректный счётчик
num_dynamic_paths в описанной здесь структуре FLATTENED — как и счётчик динамических путей в неуплощённых кодированиях V1/V2 — читается из потока перед именами путей. (В неуплощённых префиксах нет отдельного поля для уплощённых путей: они содержат только счётчик динамических путей, а также значение max_dynamic_paths в V1, которое читается и отбрасывается.) Как и в случае Dynamic, декодер должен считать эти счётчики недоверенными и не должен выделять память напрямую на основе их значения — будь то счётчик из семейства SIZE_MAX или большое, но представимое значение. ClickHouse читает имена путей по одной записи, используя лишь ограниченную подсказку для предварительного выделения памяти, поэтому повреждённый счётчик отклоняется либо с ошибкой INCORRECT_DATA («JSON/Object column has too many paths», если он превышает вместимость контейнера), либо с обычной ошибкой чтения, когда имена путей в потоке заканчиваются.Усечённые потокиРовно
num_rows значений в каждом столбце пути — строгое требование, а не верхняя граница: декодер должен сверять каждый столбец пути, как типизированного, так и динамического, с количеством строк блока, а не рассчитывать на то, что поток закончится там, где положено. У собранного объекта нет собственного размера, с которым можно было бы сравнить, — его количество строк определяется результатом обратного уплощения, — поэтому неполный столбец пути на более позднем этапе уже не обнаружить, и чтение его строки r выйдет за пределы столбца. ClickHouse отклоняет такой столбец с ошибкой INCORRECT_DATA («Unexpected size of typed path / flattened path p in flattened Object column»). Для динамического пути эта проверка выполняется в дополнение к аналогичной проверке внутри его столбца Dynamic.JSON {"a": 42, "b": "hi"} (одна строка, оба пути динамические). Целое число JSON выводится как Int64:
JSON non-flat (V1/V2)
Неуплощённые кодированияObject — это то, что сервер передаёт по сети при выключенном флаге уплощения: V1 — через clickhouse-client / HTTP FORMAT Native (ревизия 0), V2 — через собственный TCP-протокол. (V3, третье неуплощённое кодирование, записывается только в части MergeTree и при передаче по сети отклоняется.) Они содержат столбец shared-data и на этой странице не описываются. Обратите внимание, что при передаче в формате Native они не содержат статистику по путям: NativeWriter оставляет статистику отключённой, поэтому в структурном префиксе Object нет раздела статистики, и сразу за ним следуют префиксы typed/dynamic/shared-data и сами данные. Статистика присутствует только в дисковых путях MergeTree, где она включена. Чтобы декодировать JSON-столбец (JSON) по описанию на этой странице, клиент должен выбрать один из описанных уровней: установить output_format_native_write_json_as_string = 1 для резервного варианта String или output_format_native_use_flattened_dynamic_and_json_serialization = 1 (при output_format_native_write_json_as_string = 0) для структуры FLATTENED Object.
Рамка окна сжатия
ClickHouse может сжимать данные столбцов потокаNative с помощью внутреннего формата рамок окна. Описанная ниже структура рамки окна не зависит от транспорта: одни и те же рамки окна используются как в собственном TCP-протоколе, так и в HTTP. Однако способ запроса сжатия и то, что окружает рамки окна, зависят от транспорта.
- Собственный TCP-протокол. Сжатие включается отдельно для каждого запроса флагом
compressionв пакете Query. Если сжатие включено, тело каждого пакетаData,Totals,Extremes,LogиProfileEvents(байты после строкиtable_name) оборачивается в формат рамок окна. Сама оболочка пакета, то есть код типа пакета и строкаtable_name, не сжимается: сервер записывает их в сырой поток. Всё, что выдаётNativeWriter, попадает в сжатый поток, поэтому префиксBlockInfoидёт внутри рамки окна первым, а за ним — размерности и столбцы. Следовательно, клиент должен сначала распаковать рамку окна и только затем читатьBlockInfo. - HTTP.
SELECT ... FORMAT Native&compress=1оборачивает весь поток байтовFORMAT Nativeв такие же рамки окна (сервер использует тот же внутреннийCompressedWriteBuffer), а?decompress=1ожидает такие же рамки окна во входном телеNativeи декодирует их с помощью соответствующегоCompressedReadBuffer. В этом случае нет ни типа TCP-пакета, ниtable_name, ни оболочки пакета: вся сжатая полезная нагрузка — это просто блокиNative, обёрнутые в рамки окна (префиксBlockInfoприсутствует, только если согласованная ревизия больше0, — точно так же, как в описанной выше несжатой структуре). Этот внутренний фреймингcompress/decompressне следует путать с транспортным сжатием HTTP (Content-Encoding: gzip/zstd, включается параметромenable_http_compression): оно оборачивает ответ на уровне HTTP и не имеет отношения к описанному ниже формату рамок окна.
FORMAT Native, всё равно потребуется добавить этот уровень рамок окна, чтобы читать сжатый HTTP-ответ Native или отправлять тело запроса с decompress=1.
Формат рамки окна
16 + compressed_size = 16 + 9 + body_size = 25 + body_size. Обратите внимание на два разных диапазона: контрольная сумма охватывает 9-байтовый заголовок и тело, тогда как compressed_size включает заголовок и тело, но не саму контрольную сумму:
Значения байта метода
Именно эти три кодека сервер использует для фрейминга всего потока в форматеNative: при выводе по HTTP с compress=1 применяется кодек сервера по умолчанию (ZSTD(3)), а собственный TCP-протокол использует LZ4, ZSTD или NONE в зависимости от network_compression_method. Универсальному клиенту Native достаточно уметь формировать и разбирать только их.
Байт метода также кодирует кодеки на уровне столбца. Они применяются к отдельным столбцам на дисковых путях MergeTree, а не при фрейминге всего потока, однако на пути ввода HTTP с
decompress=1 кодек определяется по байту метода каждой рамки окна, поэтому любой из этих байтов вполне может встретиться во входных данных. Следовательно, соответствующий спецификации декодер должен распознавать всё пространство назначенных значений и отклонять неподдерживаемые байты, а не интерпретировать тело неверно. Тела таких рамок окна зависят от конкретного кодека и выходят за рамки этого универсального контракта рамки окна:
DoubleDelta (0x94) хранит вторые разности в виде битов префикса/знака/модуля, начиная со старшего бита. Пословное декодирование сохраняет это кодирование, количество элементов и выравнивание последнего байта.
0x9c (ALP) — кодек сжатия без потерь в статусе бета для Float32 и Float64 (адаптивное сжатие чисел с плавающей запятой без потерь). Таблицу с CODEC(ALP) можно создать только при включённой настройке enable_alp_codec, однако при распаковке этот байт метода принимается всегда, чтобы ранее записанные данные оставались читаемыми. 0x9d (SZ3) — экспериментальный кодек сжатия с потерями и ограниченной погрешностью для Float32, Float64 и Array из этих типов. Таблицу с CODEC(SZ3) можно создать только при включённой настройке enable_sz3_codec, однако при распаковке этот байт метода принимается всегда, чтобы ранее записанные данные оставались читаемыми. 0x9f (ZXC) — экспериментальный асимметричный LZ-кодек: сжимает медленно, но распаковывает очень быстро, а по степени сжатия занимает промежуточное положение между LZ4 и ZSTD. Таблицу с CODEC(ZXC) можно создать только при включённой настройке enable_zxc_codec, однако при распаковке этот байт метода принимается всегда, чтобы ранее записанные данные оставались читаемыми. Байты 0x99 (DeflateQpl) и 0x9b (ZSTD_QPL) были назначены кодекам, которые впоследствии удалили; эти значения зарезервированы и повторно не используются.
0x9e (Quantized) — экспериментальный кодек для столбцов с плотными векторами (Array(Float32) и аналогичных). Как и NONE, он передаёт данные без изменений — тело с полной точностью хранится как есть, — но при его использовании подключается сериализация, которая дополнительно записывает компактный квантованный поток для ускорения векторного поиска. Таблицу с CODEC(Quantized(...)) можно создать только при включённой настройке enable_quantized_codec, а при распаковке этот байт метода принимается всегда.
Контрольная сумма
ClickHouse использует CityHash v1.0.2 (исторический вариант), а не современный Google CityHash; эти версии дают разные результаты. Контрольная сумма вычисляется по 9 байтам заголовка (method + compressed_size + uncompressed_size) и N байтам тела, то есть по всему, что находится между контрольной суммой и концом рамки окна. Первые 8 байт 16-байтового результата CityHash128 — младшая половина (LE), следующие 8 байт — старшая половина (LE). Декодер заново вычисляет CityHash128 по полученным заголовку и телу и сравнивает результат с первыми 16 байтами; несовпадение означает повреждение данных, и декодер завершается с ошибкой.Границы на уровне блока
Сжатая полезная нагрузка Block представляет собой поток из одной или нескольких рамок окна, а не обязательно одну рамку окна. Отправитель записывает сериализованный блок черезCompressedWriteBuffer, который выдаёт рамку окна каждый раз, когда заполняется его внутренний буфер (≈1 МБ, DBMS_DEFAULT_BUFFER_SIZE), а также финальную рамку окна при сбросе блока. Таким образом, небольшой блок занимает одну рамку окна, а крупный — несколько последовательных рамок окна.
Инвариант действует только в одну сторону: поскольку отправитель сбрасывает сжатый буфер в конце каждого блока, конец каждого блока совпадает с границей рамки окна, однако обратное неверно. Промежуточная граница рамки окна, возникающая при заполнении буфера посреди блока, приходится на середину блока и границей блока не является. Поэтому декодер должен определять конец блока по собственным размерностям блока (num_columns/num_rows) и не должен исходить из того, что каждая рамка окна содержит ровно один целый блок.
Приёмник обрабатывает рамки окна в потоковом режиме: читает 16 + 9 байт, затем ровно compressed_size - 9 байт тела, распаковывает их ровно в uncompressed_size байт и передаёт эти байты декодеру блока; если декодеру требуется больше данных, чем содержит текущая рамка окна, читается следующая рамка окна. Поскольку отправитель выполняет сброс после каждого блока, после полного декодирования блока буфер рамки окна оказывается пуст, и следующий блок начинается с новой рамки окна.
В собственном TCP-протоколе оболочка пакета — VarUInt с типом пакета и строка table_name — записывается в сырой поток, за пределами сжатой полезной нагрузки; в рамки окна упаковывается только тело блока (BlockInfo + столбцы). В HTTP-пути compress/decompress такой оболочки нет: весь поток состоит из блоков, упакованных в рамки окна.
Согласование
В собственном TCP-протоколе сжатие включается для отдельного запроса, а не для всего соединения. Полеcompression: bool пакета Query запрашивает сжатие только для этого запроса. Сервер выполняет эту просьбу и на всё время выполнения запроса отправляет сжатые тела пакетов Data/Totals/Extremes/Log/ProfileEvents (Log/ProfileEvents — только начиная с v54481). Кроме того, сервер ожидает, что исходящие блоки Data от клиента — внешние таблицы, пустой маркер конца данных и строки INSERT — будут упакованы в рамки окна таким же образом. Последующие запросы в том же соединении могут использовать другой режим.
В HTTP пакета Query нет: параметр запроса compress=1 включает вывод в рамках окна для данного запроса, а decompress=1 указывает, что тело запроса упаковано в рамки окна. Вывод при compress=1 сжимается кодеком сервера по умолчанию (ZSTD(3)), а не кодеком из network_compression_method; считыватель decompress=1 определяет кодек по байту метода в каждой рамке окна, поэтому на входе допускается любой кодек.
При включённом сжатии сервер может также передавать столбцы через механизм параллельной маршализации блоков /
ColumnBLOB (PARALLEL_BLOCK_MARSHALLING, v54478) для блоков, содержащих более одной строки. Реализация, сжимающая данные INSERT, должна уметь обрабатывать этот механизм (или явно отказаться от него), иначе поток рассинхронизируется.Глоссарий
Block — единица обмена данными в формате Native. Самоописывающийся фрагмент строк, хранящихся по столбцам. См. структура блоков и столбцов. BlockInfo — заголовок метаданных, который предшествует Block при передаче в пакетах Data по TCP (записывается, если ревизия соединения больше нуля). Представляет собой последовательность полей, помеченных ID поля, наличие которых зависит от ревизии. Не записывается форматом выводаNative, который выполняет сериализацию с ревизией 0. См. BlockInfo.
Тело столбца — байты столбца, которые содержат фактические значения и следуют за заголовком столбца (имя, тип, байт has_custom_serialization). Структура зависит от типа. См. структура столбца при передаче.
Составной тип — тип, построенный из одного или нескольких внутренних типов и кодируемый несколькими потоками на столбец. Формат передачи стабилен и не версионируется. См. составные типы.
Словарь (LowCardinality) — массив уникальных значений, на которые столбец LowCardinality(T) ссылается по целочисленным индексам. См. LowCardinality.
Пустой блок — Block с num_columns = 0 и num_rows = 0. Служит маркером: на стороне клиента обозначает конец входных данных, на стороне сервера — границу потока. См. варианты блоков.
Блок заголовка — Block с num_columns > 0 и num_rows = 0, который сервер отправляет первым пакетом Data в ответе на запрос. Сообщает схему результата. См. варианты блоков.
Внутренний тип — тип, который оборачивает составной тип. У Array(UInt32) внутренний тип — UInt32; у Nullable(T) — T.
Поток смещений — массив UInt64 с накопленными конечными позициями, с помощью которого Array, Map и Nested разграничивают элементы каждой строки. См. Array.
Значение-заполнитель — байты, записываемые на позициях NULL в потоке значений столбца Nullable(T). Декодер считывает их, чтобы продвинуться по потоку, но их содержимое игнорирует. См. Nullable.
Блок результата — Block с num_rows > 0, содержащий фактические строки результата запроса. См. варианты блоков.
Блок схемы — синоним блока заголовка, используемый при описании фазы INSERT, на которой блок схемы сообщает клиенту ожидаемую структуру столбцов.
Версия сериализации — передаваемый в потоке номер версии, задаваемый для каждого типа, с помощью которого версионируемые типы указывают, какой вариант кодирования следует далее. Не следует путать с версией протокола. См. версия сериализации: концепция.
Префикс состояния — байты, предшествующие полезной нагрузке блока версионируемого типа. Содержит версию сериализации и (для LowCardinality) метаданные словаря для данного блока. Записывается в начале каждого блока, где число строк > 0; между блоками не сохраняется.
Поток — непрерывная последовательность байтов в теле столбца, кодирующая один логический подкомпонент (карту NULL, массив смещений, поток значений). Многопоточные типы объединяют два или более потоков на столбец.