

- no corpo dos pacotes
Data,Totals,Extremes,LogeProfileEventsdo protocolo TCP nativo (o pacoteTableColumnsnão é um bloco Native — ele transporta duas strings binárias, portanto seu layout é descrito na especificação do protocolo nativo); - na saída de
SELECT ... FORMAT Nativevia HTTP; - em arquivos exportados com
INTO OUTFILE ... FORMAT Native; - nas cargas úteis de replicação entre servidores.
Visão geral
Tudo o que transporta linhas no wire é um bloco: um fragmento autodescritivo de linhas armazenadas coluna por coluna. Primeiro vêm todos os valores da coluna 1, depois todos os da coluna 2 e assim por diante. Um bloco transporta apenas as colunas referenciadas pela consulta, nunca a tabela inteira. Odata de uma coluna é organizado de acordo com a família à qual seu tipo pertence. As famílias, em ordem crescente de complexidade do decodificador, são:
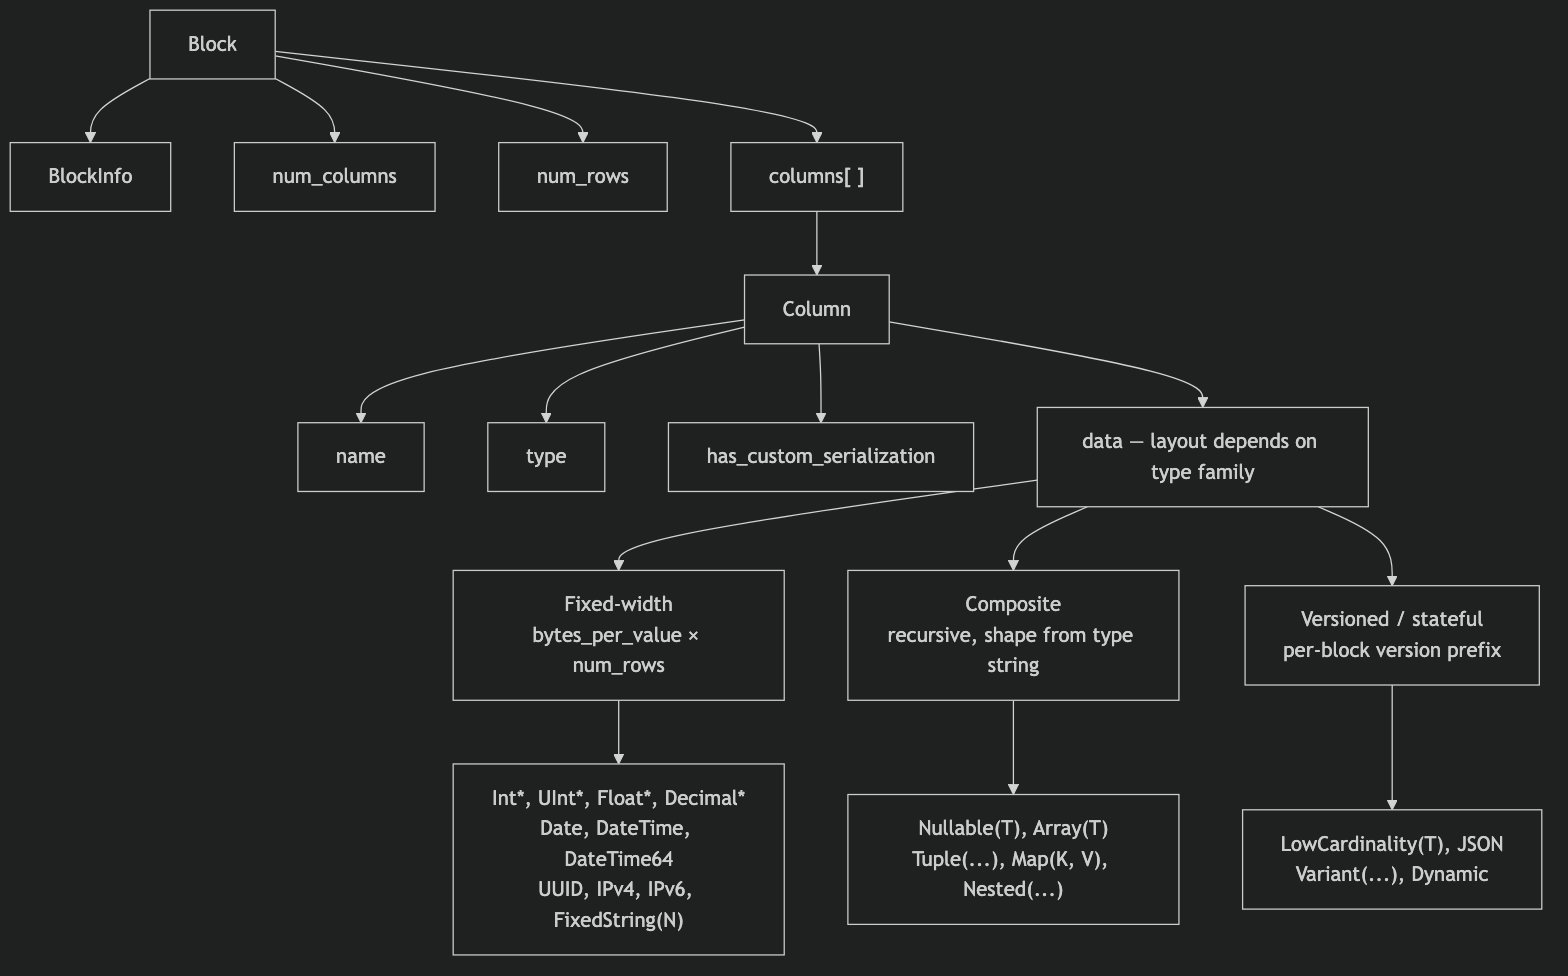
- Tipos de largura fixa organizam
datacomobytes_per_value × num_rowsbytes brutos, sem delimitação por linha. - Tipos compostos (
Nullable,Array,Tuple,Map,Nested) têm uma estrutura recursiva totalmente derivável da string do tipo, sem prefixo de versão e sem estado entre blocos. - Tipos versionados / com estado (
LowCardinality,JSON,Variant,Dynamic) iniciam cada bloco não vazio com um prefixo de versão de serialização/estado. No wireNative, esse prefixo e qualquer dicionário são por bloco: o formato não mantém estado entre blocos (o componente de gravação cria um novo estado de serialização para cada bloco e definelow_cardinality_max_dictionary_size = 0). O estado entre blocos diz respeito ao armazenamento em disco do MergeTree, não ao layout wire do Native.
Primitivas de wire
O formato Native se baseia em quatro codificações primitivas.VarUInt
Um inteiro sem sinal de comprimento variável que usa a codificação LEB-128. Cada byte contém 7 bits de dados nas posições 0–6 e 1 bit de continuação na posição 7. O bit de continuação é1 quando há mais bytes em seguida e 0 no último byte.
Codificação do valor
300:
0xAC 0x02:
Inteiros de largura fixa
Por exemplo, o valor UInt32
1 é codificado como 01 00 00 00, e o valor Int32 -1, como FF FF FF FF.
String
Uma sequência de bytes prefixada pelo seu comprimento:0x00, e as strings podem conter quaisquer valores de byte, inclusive caracteres NUL embutidos. A string "ab" é codificada como 02 61 62; para decodificá-la, leia o comprimento VarUInt (2) e, em seguida, leia essa quantidade de bytes.
Bool
Um único byte.0x00 é false; qualquer valor diferente de zero é true (na forma canônica, 0x01).
Estrutura de blocos e colunas
Layout wire do bloco
BlockInfo depende do canal, porque o mecanismo de gravação é parametrizado por uma revisão (consulte Revisão do protocolo e o formato Native para uma explicação completa, incluindo o fato de client_protocol_version afetar apenas a saída):
-
No protocolo TCP nativo, o servidor grava blocos na revisão negociada da conexão (um valor alto —
DBMS_TCP_PROTOCOL_VERSION, consultesrc/Core/ProtocolDefines.h). OBlockInfoé gravado sempre que essa revisão for maior que zero, o que sempre acontece em uma conexão real. O bytehas_custom_serializationem cada coluna (consulte layout wire da coluna) é gravado a partir da revisão54454. -
O formato de saída
Native—SELECT ... FORMAT Nativevia HTTP,INTO OUTFILE ... FORMAT Nativee o formatoNativeproduzido peloclickhouse-client— serializa na revisão0por padrão. Na revisão0, tanto o prefixoBlockInfoquanto o bytehas_custom_serializationsão omitidos, de modo que um bloco consiste apenas emnum_columns,num_rowse as colunas. Via HTTP, essa revisão não é fixa: um cliente pode aumentá-la com o parâmetro de consulta?client_protocol_version=<n>, e o servidor usa esse valor como revisão de serialização da resposta. Com um valor suficientemente alto, a saída HTTP inclui o prefixoBlockInfo(gravado sempre que a revisão for maior que0) e o bytehas_custom_serialization(gravado a partir da revisão54454), exatamente como no caminho TCP. Portanto, os clientes não devem presumir que toda carga útil HTTPFORMAT Nativeesteja na revisão0.
BlockInfo descrevem a carga útil do pacote Data do TCP. A mesma consulta executada via FORMAT Native produz a forma mais curta mostrada ao lado de cada um deles.
BlockInfo
BlockInfo é uma sequência de campos, cada um precedido por um ID de campo VarUInt e encerrada por um ID de campo0. O formato wire não é autodescritivo: um ID de campo não codifica o comprimento nem o tipo do seu valor, portanto o leitor precisa conhecer de antemão o tipo de cada ID de campo que possa encontrar. O próprio leitor do ClickHouse trata um ID de campo não reconhecido como corrupção e gera uma exceção (UNKNOWN_BLOCK_INFO_FIELD). A compatibilidade futura é garantida, em vez disso, pela revisão do protocolo: o remetente só grava um campo se a revisão negociada for igual ou superior à revisão mínima desse campo, de modo que um receptor mais antigo nunca recebe um campo que não conhece.
Os campos
1 e 2 têm revisão mínima 0, portanto estão presentes sempre que um BlockInfo é gravado. O campo 3 só é gravado a partir da revisão 54480. Layout wire para o caso comum (revisão inferior a 54480):
Layout wire de coluna
Uma Column aparecenum_columns vezes dentro de um bloco.
Um decodificador faz o encaminhamento com base na String de tipo
type. As Strings de tipo costumam trazer parâmetros entre parênteses; o decodificador remove o sufixo (...) para identificar o tipo básico e, em seguida, interpreta os parâmetros para decidir tamanho, escala ou tipo interno. Interpretar uma lista de parâmetros com tipos aninhados (por exemplo, uma Tuple dentro de um Array) exige um divisor de vírgulas que leve em conta a profundidade e acompanhe o aninhamento de parênteses, em vez de simplesmente dividir por ,.
Codificação binária de tipoO campo
type é uma String textual apenas no modo padrão. Quando a configuração de consulta output_format_native_encode_types_in_binary_format = 1 está definida, esse campo passa a ser uma codificação binária de tipo — a mesma codificação baseada em tags documentada em codificação binária de tipos de dados — e as listas achatadas do tipo Dynamic usam a mesma codificação binária para os nomes de cada tipo. Um decodificador que sempre lê o campo 2 como uma string prefixada pelo comprimento interpretaria a primeira tag binária de tipo como o comprimento de uma string e perderia a sincronização; por isso, ele precisa saber qual modo o fluxo utiliza.Em uma consulta com query_kind = SECONDARY_QUERY (enviada por outro servidor para remote, Distributed ou réplicas paralelas, ou por clickhouse-client --query_kind secondary_query), ambos os lados ignoram output_format_native_encode_types_in_binary_format e input_format_native_decode_types_in_binary_format nos blocos dessa consulta, que transportam nomes de tipos textuais nas duas direções. Servidores anteriores a essa regra aplicam essas configurações a uma consulta secundária da mesma forma que a qualquer outra consulta.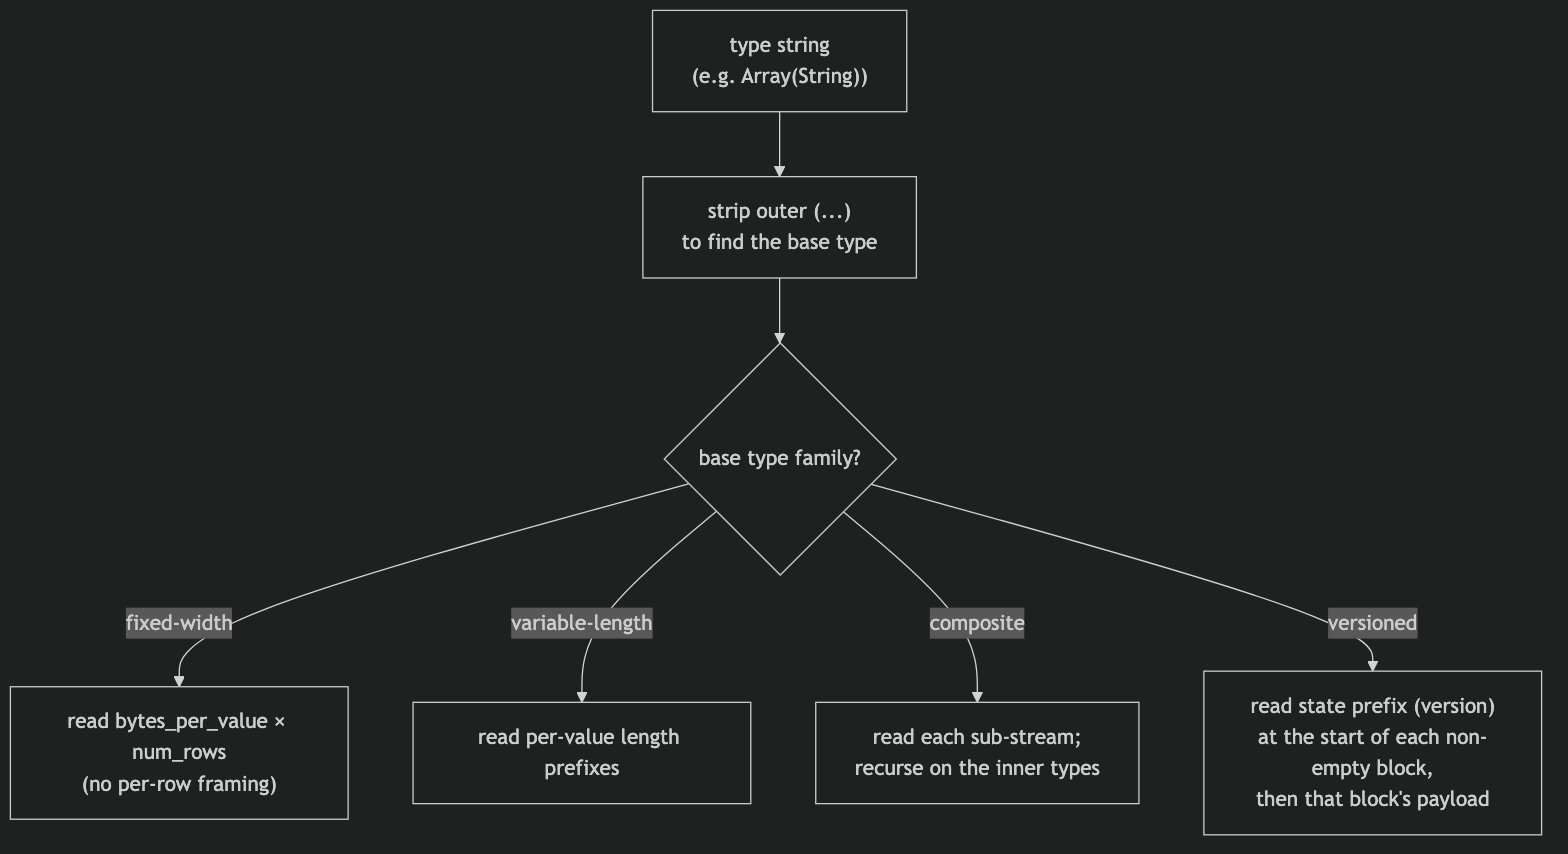
kind_stack e codificação esparsa
O bytekind_stack enumera uma serialização por coluna diferente do padrão:
A carga útil de
COMBINATION usa um enum diferente. As cinco linhas acima são códigos compactos de um byte. COMBINATION (0x05) é o escape genérico para qualquer pilha que eles não cobrem: é seguido por um VarUInt count e, depois, por count entradas de um byte. Essas entradas não são os códigos compactos da tabela — são os valores brutos de ISerialization::Kind:
Os valores dos bytes diferem dos códigos compactos:
REPLICATED é 0x03 nesse enum aninhado, mas 0x04 como código compacto, e não existe entrada DETACHED_OVER_SPARSE — essa combinação aparece como duas entradas consecutivas, SPARSE e DETACHED. Um decodificador que continue usando a tabela compacta para os bytes aninhados vai mapear 0x03/0x04 incorretamente e perder a sincronização.
O count é o comprimento total da pilha, incluindo a entrada DEFAULT inicial com a qual toda pilha começa. Como os códigos compactos já cobrem todas as pilhas de uma e de duas entradas, um COMBINATION sempre tem count igual a pelo menos três.
Validade da pilha de tipos. Um decodificador rejeita uma pilha malformada com INCORRECT_DATA em vez de construir a serialização que ela descreve. Uma pilha válida atende às seguintes condições:
- a pilha começa com
DEFAULT; - a pilha é uma subsequência de
DEFAULT,SPARSE,REPLICATED,DETACHED— a ordem em que os tipos encapsulam uns aos outros.SPARSEpode ficar dentro deREPLICATED, mas não o contrário, eDETACHEDé sempre o último, pois umColumnBLOBcontém a forma serializada de tudo o que está abaixo dele. Isso também significa que nenhum tipo aparece duas vezes, o que limitacountao número de tipos.
ColumnSparse cuja coluna de valores seja, ela própria, esparsa ou replicada permanece encapsulado.
kind_stack recursivo para colunas Tuple. A carga útil de kind_stack descrita acima é o byte (ou a sequência COMBINATION) das informações de serialização de uma única coluna. Um Tuple carrega um SerializationInfoTuple, que primeiro grava a carga útil de pilha de tipos da própria tupla e depois grava uma carga útil completa de pilha de tipos para cada elemento, na ordem; um decodificador lê de volta essa mesma estrutura recursiva. Assim, para Tuple(A, B, C), os bytes do campo 4 são [tuple_kind][A_kind][B_kind][C_kind], e a carga útil de cada elemento também é recursiva se esse elemento for, por sua vez, composto. O byte has_custom_serialization (campo 3) é definido sempre que as informações da própria tupla ou de qualquer elemento forem diferentes do padrão; portanto, um Tuple cujo único elemento especial seja esparso ou replicado também aciona a carga útil de pilha de tipos. Um decodificador que leia apenas o byte de enum inicial de um Tuple vai parar cedo demais e interpretar os bytes de tipo restantes dos elementos, por engano, como dados de coluna.
Formato wire esparso. Quando kind_stack = 0x01, o data da coluna consiste em dois fluxos gravados um após o outro no único stream TCP compartilhado:
- Fluxo de offsets — uma sequência de
VarUInts. Cada valorvpode ser:vcom o bit alto na posição 62 desligado:(v & 0x3FFFFFFFFFFFFFFF)= o número de posições com valor default antes do próximo valor explícito diferente do padrão. Essa posição diferente do padrão écursor + group_size, em quecursoré a posição corrente; em seguida,cursoravançagroup_size + 1.vcom o bit 62 ligado (END_OF_GRANULE_FLAG): o valor com o flag desligado = o número de posições finais com valor default após o último valor diferente do padrão. Isso marca o fim do fluxo de offsets do bloco.
- Stream de valores —
countvalores diferentes do padrão, codificados de forma densa no tipo interno, em quecounté o número de VarUInts não EOG lidos acima.
num_rows entradas preenchendo cada posição não explícita com o valor default do tipo interno (0 para inteiros e floats, "" para String, 0 dias para Date e assim por diante).
Uma coluna Nullable(T) esparsa é um caso especial, pois o valor default de Nullable(T) é NULL. A codificação esparsa elimina por completo o stream de mapa de nulos que Nullable normalmente usa: o fluxo de offsets identifica as posições diferentes do padrão — isto é, não NULL —, o stream de valores contém apenas esses valores não NULL, de forma densa em T, e toda posição não explícita é reconstruída como NULL. Portanto, um decodificador não deve procurar um mapa de nulos no stream de valores nem preencher as lacunas com um 0 presente; ele deve preenchê-las com NULL.
Formato wire Replicated. Quando kind_stack = 0x04, o data da coluna é um dicionário: uma lista de valores distintos de elementos, acompanhada de um índice por linha que aponta para essa lista (a mesma estrutura de lookup de LowCardinality). Quando o próprio tipo interno é versionado — por exemplo, LowCardinality(T) —, seu prefixo de estado é gravado primeiro, antes do stream de índices: a serialização replicada delega a fase de prefixo ao tipo interno antes de gravar num_rows. Tipos internos com prefixo vazio (os tipos folha e os compostos simples) não acrescentam nenhum byte aqui.
elements[indexes[i]] para cada linha de saída i. Tipos internos compostos são processados recursivamente: a lista de elementos é materializada no tipo interno e, em seguida, indexada. Os tipos internos compatíveis incluem os tipos folha, Nullable(T), Array(T), Tuple(...), Map(K, V), Nested(...) (cada campo é expandido como um Array) e LowCardinality(T) (o dicionário compartilhado é mantido; apenas as chaves de cada elemento são indexadas).
Formato wire desanexado. DETACHED (0x02) e DETACHED_OVER_SPARSE (0x03) de fato aparecem na transmissão pela rede — não são puramente internos. No caminho TCP, quando a compressão está habilitada e a revisão negociada é no mínimo DBMS_MIN_REVISON_WITH_PARALLEL_BLOCK_MARSHALLING (v54478), a coluna passa por três etapas:
- Cada coluna elegível (não
const, nãoTuple, em um bloco com mais de uma linha) é encapsulada em umColumnBLOB, que contém a coluna já serializada e comprimida fora da thread principal. DETACHEDé anexado à pilha de tipos da coluna encapsulada.- O
datada coluna é gravado como o tamanho do blob emVarUInt, seguido de exatamente essa quantidade de bytes do blob.
{DEFAULT, SPARSE, DETACHED}, serializada como DETACHED_OVER_SPARSE. Um cliente que decodifica uma coluna desse tipo lê o comprimento e os bytes do blob e, em seguida, descomprime o blob para recuperar a carga útil da coluna interna (consulte a nota sobre ColumnBLOB na seção de compressão).
DETACHED é direcional: só pode aparecer em blocos de resultado enviados por um servidor e apenas para uma coluna inteira de nível superior — nunca como um dos tipos de elemento de uma Tuple. Ao contrário dos outros tipos, ele faz com que a coluna em tempo de execução seja uma ColumnBLOB, e não a coluna do tipo declarado; por isso, um receptor só o aceita quando seu próprio pipeline converte o blob de volta. Assim, um servidor rejeita DETACHED com INCORRECT_DATA em qualquer bloco enviado por um cliente, seja ele de dados de tabela externa, de escalares ou de dados de insert.
Variantes de bloco
Todos os pacotes da família Data compartilham o mesmo formato wire de bloco. As variantes diferem apenas na quantidade de colunas e de linhas:Exemplos em nível de byte
Todos os exemplos desta seção foram extraídos do caminho do Data-packet via TCP, portanto incluem o prefixoBlockInfo e o byte has_custom_serialization. Via FORMAT Native, os mesmos blocos são mais curtos — a forma curta equivalente é apresentada quando for útil.
Um bloco vazio (com BlockInfo), com 8 bytes no total:
SELECT 1 declara uma coluna chamada "1" do tipo UInt8, com zero linhas. A partir da versão de protocolo 54454, o byte has_custom_serialization é incluído:
FORMAT Native (revisão 0), o mesmo bloco de resultado não tem BlockInfo nem o byte has_custom_serialization — SELECT 1 FORMAT Native ocupa 11 bytes:
FORMAT Native: esse formato de saída não emite blocos vazios.)
Revisão do protocolo e o formato Native
Um fluxo de bytes Native é definido, acima de tudo, pela revisão do protocolo usada pelo componente de gravação e pelo leitor. A revisão não aparece em lugar nenhum nos próprios bytes — não existe campo de revisão no wire —, mas ainda assim determina se vários recursos aparecem ou não. Por isso, um decodificador precisa saber em qual revisão uma carga útil foi gravada antes de conseguir interpretá-la. Como a revisão não está no stream, o leitor e o componente de gravação precisam chegar a um acordo sobre ela de alguma outra forma. Trata-se de um únicoUInt64, que tanto NativeWriter quanto NativeReader recebem como argumento do construtor. No componente de gravação, ele se chama client_revision e, no leitor, server_revision, mas é o mesmo número. A revisão mais recente conhecida por este lançamento é DBMS_TCP_PROTOCOL_VERSION (consulte src/Core/ProtocolDefines.h).
O que a revisão controla
Cada recurso depende de um limiarDBMS_MIN_REVISION_WITH_*. O componente de gravação só emite o recurso quando a revisão atinge o limiar, e o leitor o procura seguindo exatamente a mesma regra, de modo que ambos permanecem sincronizados — se a revisão estiver errada em qualquer um dos lados, eles perdem a sincronia. Os controles relevantes para o formato Native são:
Isso torna a revisão
0 a codificação mais conservadora para quase tudo: o stream não carrega BlockInfo nem o byte has_custom_serialization, usa Dynamic/JSON V1, não tem versão de função de agregação e traz um DateTime simples, sem o parâmetro de fuso horário. As versões de estado de funções de agregação são a exceção na revisão 0: não há nenhum par a partir do qual derivar uma versão — o stream é gravado e lido de volta por quem o produziu (um arquivo de dados StripeLog, um backup de Set/Join, um arquivo no formato Native) —, então o escritor mantém a versão fixada no tipo (explicitando-a na string do tipo, como de costume) em vez de rebaixar o estado para a versão 0, e somente um tipo que não fixa nenhuma versão é gravado na versão 0.
LowCardinality é a única exceção, e uma exceção importante. A verificação do escritor é remove_low_cardinality || (client_revision && client_revision < DBMS_MIN_REVISION_WITH_LOW_CARDINALITY_TYPE). O truque está no client_revision && inicial: quando a revisão é exatamente 0, a condição inteira entra em curto-circuito e resulta em falso.
Portanto, na revisão 0 — o padrão para FORMAT Native —, LowCardinality(T) não é removido. Sua string do tipo e o prefixo de estado por bloco permanecem no stream, e o leitor da revisão 0 os lê de volta diretamente. A remoção só ocorre em uma revisão diferente de zero inferior a 54405 ou quando é forçada, independentemente da revisão.
Quem força a remoção é a flag remove_low_cardinality. A saída de FORMAT Native nunca a define, mas o caminho TCP nativo, sim, quando low_cardinality_allow_in_native_format = 0 (padrão 1). Em outras palavras, essa configuração altera a saída TCP nativa, mas não tem efeito algum sobre FORMAT Native.
Na prática: um stream FORMAT Native padrão pode legitimamente conter LowCardinality, portanto não o trate como um recurso ausente na revisão 0.
De onde vem a revisão, dependendo de como os dados trafegam
Os mesmos bytes Native podem trafegar por caminhos diferentes: o protocolo TCP nativo, uma requisição HTTP ou um arquivo em disco. Cada caminho define a revisão à sua maneira. Um ponto de atenção: o lado de leitura e o lado de escrita são configurados separadamente, então podem acabar usando revisões diferentes.Protocolo TCP nativo — negociado, em ambas as direções
No protocolo TCP nativo, a revisão é definida pelo handshake Hello. O cliente enviaDBMS_TCP_PROTOCOL_VERSION, o servidor responde com a sua própria e, a partir daí, cada lado serializa na revisão anunciada pelo outro lado: o servidor cria seu NativeReader/NativeWriter a partir de client_tcp_protocol_version, enquanto o cliente usa o server_revision que recebeu. Não há um min explícito, mas nenhum dos lados consegue emitir um recurso que não implementou; por isso, cada direção fica, na prática, limitada pelo mais antigo dos dois pares.
Quando ambos os pares usam a mesma compilação recente, as duas direções chegam à mesma revisão (DBMS_TCP_PROTOCOL_VERSION, consulte src/Core/ProtocolDefines.h) e todas as condições de controle ficam ativas. Esse é o caso mais comum, mas não é garantido. Com pares de versões diferentes ou de terceiros, as duas direções podem ficar em revisões distintas, então as condições de controle precisam ser avaliadas por direção: BlockInfo está presente em qualquer revisão diferente de zero, mas o restante — incluindo has_custom_serialization — só aparece quando a revisão efetiva daquela direção atinge os respectivos limiares. Um par que anuncia uma revisão inferior a 54454, por exemplo, não envia nem recebe o byte has_custom_serialization.
Saída FORMAT Native — revisão 0 por padrão, elevável via HTTP
O formato de saída Native usa por padrão a revisão 0. Isso abrange SELECT ... FORMAT Native via HTTP, INTO OUTFILE ... FORMAT Native e a saída Native gravada pelo clickhouse-client; em todos esses casos, a fábrica de saída repassa FormatSettings::client_protocol_version diretamente ao NativeWriter, que controla o enquadramento de BlockInfo / has_custom_serialization e o layout de offsets de String. Assim, um SELECT ... FORMAT Native via HTTP com um client_protocol_version elevado (≥ 54492) grava o layout de offsets, enquanto a revisão padrão 0 mantém o layout portável por valor.
Via HTTP, porém, esse padrão não é a história completa. Um cliente pode elevá-lo com o parâmetro de consulta ?client_protocol_version=<n>, que o HTTP handler trata como um parâmetro reservado, e não como uma configuração SQL: ele vai para o contexto da consulta, e a camada de formato o copia para FormatSettings. Com um valor alto o suficiente, a saída FORMAT Native via HTTP passa a incluir o prefixo BlockInfo e o byte has_custom_serialization, assim como no caminho TCP — portanto, não presuma que uma carga útil FORMAT Native via HTTP esteja sempre na revisão 0.
Como o parâmetro é aplicado a todo o contexto da consulta, ele chega a todos os NativeWriter criados para aquela requisição, e não apenas ao stream de resultado. Em particular, uma gravação do lado do servidor como INSERT INTO FUNCTION file('x.native', 'Native', ...) SELECT ... via HTTP com um ?client_protocol_version= elevado grava o arquivo nessa revisão. Esse comportamento é antigo (é anterior à serialização de offsets de String e também se aplica a BlockInfo e has_custom_serialization) e assimétrico: o lado de leitura (veja abaixo) não é elevado da mesma forma, de modo que esse arquivo não pode ser lido de volta por meio de file(...). Não inclua client_protocol_version em requisições que gravem dados que precisarão ser lidos novamente. INTO OUTFILE e a saída local do clickhouse-client não oferecem esse ajuste e permanecem em 0.
Entrada FORMAT Native — sempre revisão 0
O formato de entrada Native sempre cria seu NativeReader na revisão 0. Ele nunca espera um prefixo BlockInfo, nunca lê o byte has_custom_serialization e sempre pressupõe a serialização padrão — seja ao fazer o parsing do corpo de um INSERT ... FORMAT Native, ao ler um arquivo Native ou ao inferir um schema. ?client_protocol_version=<n> não eleva a revisão de entrada (apenas o lado de saída lê esse parâmetro).
Como a revisão de entrada é sempre 0, o formato de entrada sempre lê o layout de String por valor; um stream gravado com o layout de offsets (pelo protocolo TCP nativo ou por meio de um SELECT ... FORMAT Native com client_protocol_version elevado) não pode ser lido de volta pela entrada FORMAT Native — a mesma assimetria que ocorre com o enquadramento BlockInfo.
Implicações de ida e volta
ParaFORMAT Native, o padrão é a revisão 0 em ambas as pontas. Os dados gravados por SELECT ... FORMAT Native na revisão 0 podem ser lidos de volta diretamente por INSERT ... FORMAT Native, sem surpresas.
Um stream produzido com uma revisão de saída elevada (?client_protocol_version=<n> no SELECT) carrega o enquadramento BlockInfo e has_custom_serialization, além do layout de String com offsets, e nada disso é lido de volta pelo formato de entrada, que está sempre na revisão 0. Portanto, elevar client_protocol_version só faz sentido para um consumidor que fala o protocolo TCP nativo, e não para uma ida e volta com FORMAT Native via HTTP.
Arquivos são o caso assimétrico. Um ?client_protocol_version= elevado em um INSERT INTO FUNCTION file(...) (ou s3, url) no lado do servidor grava o arquivo nessa revisão, mas uma leitura com file(...) sempre analisa na revisão 0; por isso, esse arquivo não faz ida e volta. Deixe client_protocol_version fora da requisição de gravação, para que o arquivo fique simplesmente na revisão 0, ou transfira os dados pelo protocolo TCP nativo, no qual cada direção usa a revisão negociada no handshake.
Revisão do protocolo vs. versão de serializaçãoNão confunda a revisão do protocolo com a versão de serialização. A revisão, aqui, vale para toda a conexão ou requisição e nunca aparece nos bytes. A versão de serialização é definida por coluna, carregada pelos tipos versionados, e é gravada em todo bloco não vazio. A revisão determina se um recurso existe ou não; já a versão de serialização, uma vez dentro de uma coluna versionada, define qual variante da codificação daquele tipo específico vem em seguida.
Tipos de dados
Esta seção documenta a codificação no wire dos tipos que o formato Native pode transportar nodata de uma coluna, agrupados em quatro famílias em ordem crescente de complexidade para o decodificador. Dois tipos — AggregateFunction(func, ...) e QBit(T, N[, stride]) — são tipos de coluna Native válidos, mas têm cargas úteis específicas da função ou do tipo, que estão fora do escopo deste documento; eles são sinalizados abaixo nos pontos em que poderiam ser confundidos com aliases.
Tipos de largura fixa
Cada valor ocupa um número constante de bytes. Uma coluna deM linhas ocupa exatamente bytes_per_row × M bytes no wire, concatenados sem separadores nem preenchimento.
Tipos inteiros
UInt8–UInt256 e Int8–Int256 são codificações binárias diretas de valores inteiros. Um decodificador lê bytes_per_row × num_rows bytes e os interpreta de acordo com o tipo.
Uma coluna UInt32 com os valores [1, 256, 65536]:
Int32 contendo [-1, 42]:
Float32 e Float64
Floats binários no padrão IEEE 754: 4 bytes em precisão simples (binary32) e 8 bytes em precisão dupla (binary64), ambos em little-endian. NaN, ±Infinity, ±0.0 e valores subnormais são preservados na ida e volta sem normalização.
Valor Float32 1.5 (0x3FC00000):
Float64 1.5 (0x3FF8000000000000):
BFloat16
O formato brain-floating-point: os 16 bits mais significativos de umFloat32 IEEE 754 — 1 bit de sinal, 8 bits de expoente e 7 bits de mantissa. Cada valor ocupa 2 bytes, em little-endian, e armazena o padrão bruto de 16 bits. Para recuperar o valor numérico, expanda-o de volta para Float32, colocando o padrão na metade superior e zerando a metade inferior (bits << 16 reinterpretado como Float32); o valor expandido passa então a usar a mesma formatação de texto do Float32.
Valor BFloat16 1.5 (padrão 0x3FC0, a metade superior do Float32 0x3FC00000):
Bool
Compatível no wire comUInt8: 1 byte por linha, 0x00 = false, 0x01 = true. A string do tipo no wire é literalmente Bool (e não UInt8); portanto, um decodificador que faz o encaminhamento com base na string do tipo precisa reconhecê-la separadamente.
Uma coluna Bool [true, false, true]:
Date e Date32
Ambos codificam datas como contagens inteiras de dias a partir da Unix epoch1970-01-01. Nenhum dos dois inclui um componente de hora.
Valor
Date 1970-01-02 (1 dia):
Date32 1900-01-01 (-25567 dias):
DateTime
Compatível no wire comUInt32: um timestamp Unix em segundos, codificado em 4 bytes little-endian. O tipo pode aparecer como DateTime ou DateTime('Timezone'); o fuso horário afeta apenas a exibição e não faz parte do valor no wire. Duas colunas DateTime com parâmetros de fuso horário diferentes geram bytes idênticos para o mesmo instante. Um decodificador remove o sufixo de parâmetro (...) e processa a coluna como UInt32.
Valor DateTime('UTC') 2024-03-15 14:30:00 UTC (timestamp 1710513000):
DateTime64(escalar[, timezone])
8 bytes, Int64 little-endian representando ticks no escalar de10^-scale segundos desde a Unix epoch. O parâmetro scale (0–9) fica na string do tipo e define a unidade de tempo:
O tipo aparece como
DateTime64(s) (fuso horário padrão do servidor, implícito) ou DateTime64(s, 'TimezoneName') (fuso horário explícito, usado apenas na exibição). Valores negativos representam ticks anteriores à epoch.
Valor DateTime64(3, 'UTC') 2024-01-15 12:30:45.123 UTC (1705321845123 ms):
DateTime64(0) 2024-01-15 12:30:45 UTC (1705321845 s):
Time e Time64(scale)
Uma duração de relógio, e não um ponto no tempo.Time é uma contagem de segundos com sinal, em 4 bytes Int32 little-endian; Time64(scale) é uma contagem de ticks com sinal no escalar decimal informado (0–9), em 8 bytes Int64 little-endian — o mesmo formato wire de DateTime64.
A forma textual é [-]HH:MM:SS[.fraction], mas, diferentemente de DateTime, o campo de hora não é reiniciado a cada dia de 24 horas: ele representa a contagem total de horas e pode passar de 23. A magnitude exibida é limitada a 999:59:59 (3599999 segundos); uma magnitude maior é exibida com os segundos no limite e a fração armazenada mantida como está, de modo que uma contagem de ticks de 3700000.25 é exibida como 999:59:59.250000. CAST satura o valor armazenado no maior tick representável no escalar de destino (999:59:59.999999 para Time64(6)), e não no segundo inteiro, enquanto operações aritméticas ainda podem deixar na coluna uma contagem de ticks fora do intervalo, que só é limitada na exibição. Nada disso afeta os bytes wire, que são simplesmente o inteiro com sinal.
Valor Time 45296 (12:34:56):
Time64(3) de 45296789 ticks (12:34:56.789):
Time e Time64 são experimentais e exigem allow_experimental_time_time64_type = 1 no servidor.Interval
Interval<Unit> — IntervalSecond, IntervalMinute, IntervalHour, IntervalDay, IntervalWeek, IntervalMonth, IntervalQuarter, IntervalYear, IntervalNanosecond etc. Todas as unidades compartilham a mesma codificação wire: a contagem como um Int64 com sinal de 8 bytes em little-endian. A unidade existe apenas na string do tipo — ela não altera os bytes wire nem a forma textual, que é simplesmente o inteiro. Um único caminho de decodificação trata todas as unidades.
IntervalDay com valor 5:
UUID
16 bytes por valor. A codificação de wire não corresponde aos 16 bytes canônicos em big-endian — cada metade de 8 bytes tem seus bytes invertidos de forma independente. O modelo lógico é um identificador de 128 bits na forma textual canônicaxxxxxxxx-xxxx-xxxx-xxxx-xxxxxxxxxxxx, em que os bytes são, por convenção, escritos em big-endian. O modelo de wire toma esses 16 bytes canônicos, divide-os em duas metades de 8 bytes e grava cada metade em little-endian:
- Bytes de wire 0..7 = bytes canônicos 0..7 em ordem inversa.
- Bytes de wire 8..15 = bytes canônicos 8..15 em ordem inversa.
550e8400-e29b-41d4-a716-446655440000:
IPv4 e IPv6
Dois tipos de endereço relacionados, mas codificados de formas diferentes.IPv4 ocupa 4 bytes e é codificado como um UInt32 little-endian que armazena o endereço canônico de 32 bits (o valor (a << 24) | (b << 16) | (c << 8) | d obtido de a.b.c.d). Os bytes no wire correspondem aos bytes em ordem de rede invertidos.
192.168.1.10 (valor canônico de 32 bits 0xC0A8010A):
IPv6 ocupa 16 bytes, gravados tal como estão, na ordem de bytes de rede (network byte order), sem inversão — a mesma ordem de bytes de inet_pton(AF_INET6, ...).
2001:db8::1:
u32 para permitir operações aritméticas e consultas de intervalo compactas, enquanto o IPv6 mantém o layout em ordem de bytes de rede, comum à maioria das APIs de rede.
Enum8 e Enum16
Compatíveis no wire comInt8 e Int16, respectivamente: 1 ou 2 bytes por linha, em complemento de dois little-endian no caso da variante de 16 bits. O mapeamento completo das variantes fica na string do tipo:
(...) e fazer o encaminhamento como Int8 / Int16, já que os bytes no wire são apenas o índice inteiro. Um cliente que exibe o rótulo interpreta o map 'name' = value a partir da string do tipo e o mantém junto à coluna, pois o inteiro sozinho não permite recuperar o rótulo. A saída em formato de texto exibe o rótulo (active) em vez do índice, entre aspas simples ('active') quando o enum está aninhado em um tipo composto. Como o map não pode ser recuperado a partir da coluna de inteiros, ele deve ser preservado para enums aninhados, como Array(Enum8(...)) ou Map(Enum16(...), V).
Uma coluna Enum8('active' = 1, 'inactive' = 2) com os valores [active, inactive, active]:
Enum16(...) igual a 30000:
Decimal(P, S)
Um inteiro com sinal escalado por uma potência de 10. A largura em bytes do inteiro é determinada pela precisãoP; a escala S é o expoente negativo (o número de dígitos após o separador decimal). Ambos fazem parte da string do tipo.
A codificação no wire é o inteiro subjacente em complemento de dois, little-endian, e o valor decimal lógico é
wire_integer × 10^(-S).
O ClickHouse sempre emite Decimal(P, S), independentemente de como o tipo foi declarado. Decimal32(S), Decimal64(S) e os demais são todos normalizados para Decimal(P, S) no wire (com P definido como o máximo natural para a largura: 9, 18, 38, 76). Um decodificador que reconheça apenas Decimal(P, S) cobre todas as grafias que o servidor emite.
Valor 123.4567 do tipo Decimal(9, 4) → inteiro subjacente 1234567:
-1.5 do tipo Decimal(18, 1) → inteiro subjacente -15:
123.4567 do tipo Decimal(38, 4) (16 bytes no total):
Nothing
O tipoNothing não carrega nenhum valor. Na prática, ele aparece apenas como o tipo interno de Nullable(Nothing) — o que o servidor retorna para uma expressão como SELECT NULL, cujo único valor válido é a ausência de valor. Conceitualmente, trata-se de um tipo unitário.
No wire, ocupa exatamente um byte de preenchimento por linha. O servidor emite o caractere ASCII '0' (0x30), mas o desserializador ignora esses bytes — o conteúdo é indefinido e os decodificadores não devem depender de nenhum valor específico. O número de bytes gravados é num_rows × 1, portanto o num_rows do cabeçalho da coluna determina inteiramente quantos bytes devem ser consumidos.
O byte por linha preserva a invariante do bloco: toda coluna ocupa um comprimento derivável de num_rows, de modo que os decodificadores leem sequencialmente, sem prefixos de comprimento por célula. O Nullable envolvente sempre indica todas as posições como NULL, portanto os marcadores nunca são inspecionados.
Uma coluna Nullable(Nothing) com 3 linhas (todas NULL):
Nullable (consulte Nullable); os três bytes internos correspondem à carga útil de Nothing, que o decodificador ignora.
Tipos de comprimento variável
Cada valor carrega o próprio comprimento no wire.String
String do tipo:String. Uma coluna String tem dois layouts wire, selecionados pela revisão do protocolo (consulte O que a revisão controla). A revisão é aquela negociada no protocolo TCP nativo e, para a saída FORMAT Native, é client_protocol_version (padrão 0); a entrada FORMAT Native usa sempre a revisão 0, e o formato Buffers sempre usa o layout por valor.
Layout por valor — abaixo de DBMS_MIN_REVISION_WITH_STRING_WITH_SIZE_STREAM_SERIALIZATION (54492), o que inclui a revisão padrão 0 de FORMAT Native: uma sequência de num_rows sequências de bytes prefixadas pelo comprimento:
0x00. O total de bytes ocupados pela coluna é Σ (varuint_size(len_i) + len_i) somado sobre todas as linhas.
Uma coluna com 3 strings ["ab", "", "c"] (6 bytes no total):
54492: dois fluxos concatenados, primeiro os offsets cumulativos em bytes e, em seguida, todos os dados:
Array envia seus offsets pelo protocolo nativo. O offset i é a posição final do valor i no blob de dados; assim, o tamanho do valor i é offset[i] - offset[i-1] (com offset[-1] = 0) e o último offset corresponde ao tamanho total do blob de dados. Um decodificador lê 8 × num_rows bytes de offsets e, em seguida, lê todo o blob de dados de uma só vez, usando o último offset como comprimento exato. Isso permite pré-alocar o buffer com precisão e fazer cópia em massa em vez de parsing linha a linha, além de dispensar a conversão de tamanhos em offsets. Uma coluna com num_rows = 0 não contribui com nenhum byte em nenhum dos fluxos.
As mesmas 3 strings ["ab", "", "c"] (27 bytes no total):
String no bloco, incluindo String aninhada em tipos compostos (Array(String), Nullable(String), Map, Tuple, Variant, Dynamic, JSON), com uma exceção: o dicionário de uma coluna LowCardinality é sempre gravado com a serialização aninhada padrão, de modo que seus valores String mantêm o layout por valor em todas as revisões. Isso abrange LowCardinality(String), LowCardinality(Nullable(String)) e qualquer outro dicionário LowCardinality que contenha String.
Em ambos os layouts, a String do ClickHouse é orientada a bytes, e não a texto: a validade UTF-8 não é verificada, e um valor pode conter quaisquer bytes, incluindo NUL embutido. Um decodificador que mapeie para um tipo de string UTF-8 deve validar os dados na leitura ou expor os bytes brutos ao chamador.
FixedString(N)
String do tipo:FixedString(N), em que N é um inteiro positivo (por exemplo, FixedString(16)). A coluna tem exatamente N × num_rows bytes brutos, sem prefixos de comprimento e sem separadores. Um decodificador interpreta N a partir da string do tipo e consome essa quantidade de bytes por linha.
Quando o SQL faz o insert de um valor com menos de N bytes (por exemplo, CAST('abc' AS FixedString(5))), o servidor preenche à direita com bytes NUL (0x00) até atingir o comprimento declarado. Esses bytes de preenchimento fazem parte do valor armazenado e são enviados no wire como estão; removê-los é responsabilidade do cliente. Assim como String, FixedString(N) se comporta mais como um array de bytes do que como texto — normalmente é usado para identificadores de largura fixa, bytes de endereço ou digests de hash.
Dois valores FixedString(3) ["abc", "de\0"] (6 bytes no total):
Tipos compostos
Os tipos compostos encapsulam um ou mais tipos internos e compartilham um modelo wire comum: múltiplos fluxos por coluna. Uma única coluna lógica é codificada como duas ou mais sequências de bytes, lidas de forma independente e concatenadas. Eles compartilham três propriedades estruturais:- Forma fixa por schema. A estrutura é determinada inteiramente pela string do tipo no momento da decodificação.
Array(UInt32)sempre tem o mesmo layout de fluxos, de um bloco para outro. - Sem prefixo de versão próprio. O wrapper composto em si não adiciona nenhum byte de versão; seu enquadramento (offsets, mapa de nulos, fluxos de elementos) permanece estável entre os lançamentos do ClickHouse. Isso vale apenas para o wrapper. Para tipos internos versionados, consulte a observação sobre a fase de prefixo abaixo.
- Sem estado próprio entre blocos. O enquadramento do wrapper é totalmente autodescritivo em cada bloco; qualquer questão de estado entre blocos decorre de um tipo interno versionado, e não do wrapper.
SerializationArray executa a fase de prefixo do seu tipo interno antes de gravar os offsets do array, e Tuple, Map, Nested e Nullable fazem o mesmo por meio das serializações de seus elementos (Nullable executa o prefixo interno antes do seu mapa de nulos).
Portanto, quando um tipo composto encapsula um tipo versionado/com estado (LowCardinality, Variant, Dynamic, JSON), o prefixo de versão/estado desse tipo interno é emitido primeiro, antes dos offsets e da carga útil de elementos do wrapper. Por exemplo, Array(LowCardinality(String)) é organizado como [LowCardinality state prefix] → [array offsets] → [flattened LowCardinality element payload], e não com os offsets primeiro.
Um decodificador que lê os offsets antes de executar a fase de prefixo interna perderá a sincronização em qualquer tipo composto que contenha LowCardinality, Variant, Dynamic ou JSON. Quando todos os tipos internos são folhas simples ou outros compostos não versionados, a fase de prefixo não emite nenhum byte, e a descrição com offsets primeiro, apresentada abaixo, se aplica sem alterações.
Nullable(T)
String do tipo:Nullable(InnerType). Exemplos: Nullable(UInt32), Nullable(String), Nullable(FixedString(16)), Nullable(DateTime('UTC')).
Assim como os demais tipos compostos, Nullable delega a fase de prefixo à serialização do seu tipo interno antes da gravação do mapa de nulos: quando o tipo interno é versionado, o prefixo de estado do tipo interno é emitido primeiro. Portanto, Nullable(Tuple(LowCardinality(String))) começa com o prefixo de estado de LowCardinality, e não com o mapa de nulos. Quando o tipo interno é um tipo folha ou outro tipo não versionado, a fase de prefixo não emite nenhum byte.
O layout wire consiste na fase de prefixo do tipo interno (vazia, a menos que o tipo interno seja versionado), seguida de dois fluxos concatenados, começando pelo mapa de nulos:
num_rows bytes, um por linha:
O fluxo de valores contém a codificação padrão do tipo interno para todas as
num_rows linhas, incluindo as posições nulas. Um decodificador ainda precisa ler os bytes de marcador nas posições nulas para avançar no fluxo, mas deve consultar o mapa de nulos antes de interpretar qualquer valor individual. Os remetentes podem gravar quaisquer bytes nas posições nulas; portanto, os decodificadores não devem depender de um valor específico de marcador.
Valores de marcador por família de tipo interno:
Nullable(T) pode aparecer dentro de Array, Tuple, Map e Nested — Array(Nullable(T)) e Tuple(Nullable(T1), T2) são comuns. A nulabilidade não pode ser aninhada em si mesma: Nullable(Nullable(T)) é rejeitado pelo servidor.
Um Nullable(UInt8) com três linhas [5, NULL, 9] (6 bytes no total):
Nullable(String) com três linhas ["hello", NULL, "world"] (15 bytes no total):
Array(T)
String do tipo:Array(InnerType). Exemplos: Array(UInt32), Array(String), Array(Nullable(UInt32)), Array(Array(UInt8)).
O layout wire é composto pela fase de prefixo do tipo interno (vazia, a menos que o tipo interno seja versionado), seguida de dois fluxos concatenados, começando pelos offsets:
num_rows valores UInt64 little-endian, cada um representando a posição final cumulativa no fluxo de valores após os elementos daquela linha:
- Índice inicial dos elementos da linha
N=offsets[N - 1](ou0quandoN == 0). - Índice final dos elementos (exclusivo) da linha
N=offsets[N]. - Número de elementos da linha
N=offsets[N] - offsets[N - 1].
offsets[num_rows - 1] é o número total de elementos em todas as linhas, e o fluxo de valores contém exatamente essa quantidade de valores internos, concatenados em sequência.
Os offsets são monotonicamente não decrescentes; offsets consecutivos iguais indicam uma linha vazia, e um decodificador deve rejeitar offsets não monotônicos, tratando-os como dados corrompidos. Uma coluna vazia (num_rows == 0) grava zero bytes, ou seja, não há fluxo de offsets nem fluxo de valores. Os tipos internos podem ser de qualquer tipo, inclusive outros tipos compostos: Array(Array(T)), Array(Tuple(...)) e Array(Nullable(T)) são todos válidos.
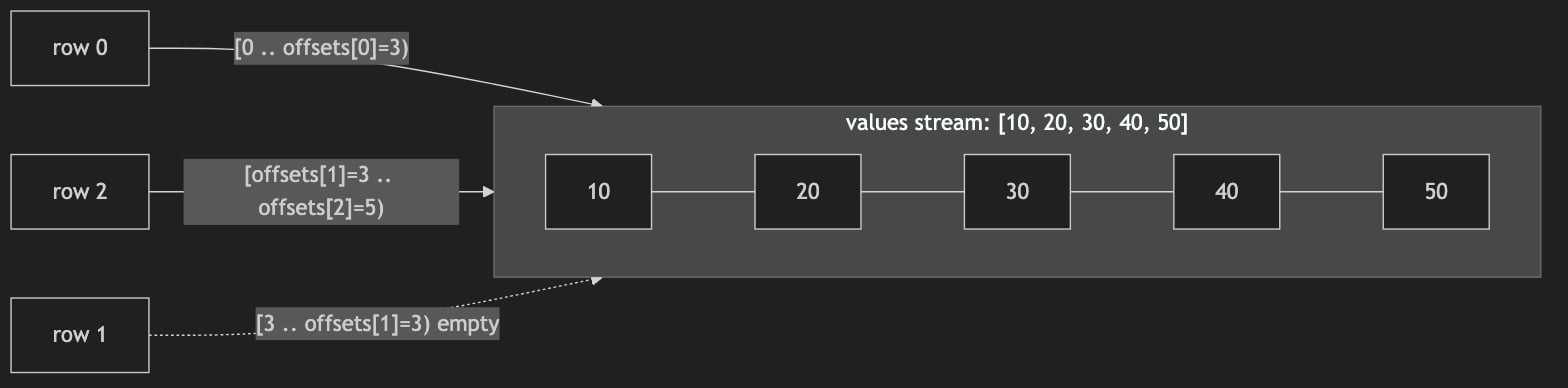
Array(UInt32) com as linhas [[10, 20, 30], [], [40, 50]] (44 bytes no total):
0 para a linha 0). Offsets consecutivos iguais indicam uma linha vazia:
Array(String) com as linhas [["a", "bb"], []] (20 bytes no total):
Array(Array(UInt32)) com as linhas [[[1,2]], [], [[3], [4,5]]] aninha a mesma estrutura:
- Offsets externos:
[1, 1, 3]— a linha 0 tem 1 array interno, a linha 1 tem 0 e a linha 2 tem 2. - O
Array(UInt32)intermediário decodifica 3 linhas com offsets[2, 3, 5]. - O
UInt32mais interno decodifica 5 valores:[1, 2, 3, 4, 5].
Tuple(T1, T2, …)
String do tipo:Tuple(T1, T2, ..., Tn). Exemplos: Tuple(UInt32, String), Tuple(Int32), Tuple(Array(UInt32), String), Tuple(UInt8, Tuple(Int32, String)). O ClickHouse também oferece suporte a tuplas nomeadas por meio de Tuple(a UInt32, b String); os nomes são apenas metadados e não afetam o formato wire.
O layout wire consiste na fase de prefixo dos elementos (cada elemento versionado contribui com seu prefixo de estado, na ordem de declaração; a fase fica vazia para elementos não versionados), seguida de N fluxos concatenados, um por tipo de elemento, na ordem de declaração:
num_rows valores. Não há prefixo de comprimento, nem fluxo de offsets, nem separadores entre os fluxos. Uma coluna vazia (num_rows == 0) grava zero bytes por fluxo. Os elementos podem ser de qualquer tipo, inclusive outros tipos compostos — Tuple(Tuple(...), ...), Tuple(Array(...), ...) e Tuple(Nullable(T1), T2) são todos válidos.
A tupla sem elementos Tuple() também é válida — ela surge de expressões como SELECT tuple() ou CAST(x AS Tuple()). Como não possui fluxos de elementos, ela é serializada da mesma forma que Nothing: um byte marcador (0x30, ASCII '0') por linha, que o desserializador descarta. A contagem de linhas vem do cabeçalho do bloco, exatamente como no caso de Nothing.
Tuple(UInt8, UInt8) com 3 linhas (1,4), (2,5), (3,6):
[1, 2, 3] para o elemento 0 e [4, 5, 6] para o elemento 1.
Tuple(UInt32, String) com 2 linhas (10, "a") e (20, "bb") (13 bytes no total):
Map(K, V)
String do tipo:Map(KeyType, ValueType). Exemplos: Map(String, UInt32), Map(String, Array(UInt32)), Map(UInt8, Tuple(Int32, String)), Map(Array(String), Int8). O formato wire não impõe restrição a nenhum dos dois tipos — tanto K quanto V podem ser qualquer tipo compatível, inclusive tipos compostos. (As regras do ClickHouse no nível SQL sobre os tipos de chave aceitos variaram entre lançamentos; consulte a documentação de SQL referente à versão do servidor de destino.)
O layout wire é idêntico byte a byte ao de Array(Tuple(K, V)); portanto, começa com a fase de prefixo interna (vazia, a menos que K ou V seja versionado):
total_pairs = offsets[num_rows - 1] (ou 0 quando num_rows == 0). O fluxo de offsets tem a mesma semântica de Array. As chaves são alinhadas posicionalmente com os valores: o par i é (keys[i], values[i]).
No ClickHouse, a representação em memória de uma coluna Map é um array de tuplas; o sistema de tipos a expõe como um tipo distinto para facilitar o uso em SQL (m['key'], mapKeys, mapValues). O formato wire é uma serialização direta desse armazenamento, de modo que Map e Array(Tuple(K, V)) são intercambiáveis byte a byte.
Os offsets são monotonicamente não decrescentes, e tanto o fluxo de chaves quanto o fluxo de valores contêm exatamente total_pairs valores. Uma coluna vazia não grava nenhum byte. Em uma mesma linha, as chaves normalmente são únicas, mas essa é uma regra semântica, e não uma imposição do formato wire: o formato wire permite que chaves duplicadas sobrevivam à ida e volta, e a semântica do lado do servidor só resolve duplicatas quando uma função compatível com Map consome a linha.
Map(UInt8, UInt8) com 2 linhas {1:10, 2:20}, {3:30} (22 bytes no total):
i é reconstruído pela leitura conjunta de keys[i] e values[i].
Map(String, UInt32) com 1 linha {'a':1, 'b':2} (20 bytes no total):
Nested(name1 T1, name2 T2, …)
A representação on-wire deNested depende da configuração flatten_nested do lado do servidor, o que dá origem a dois casos distintos.
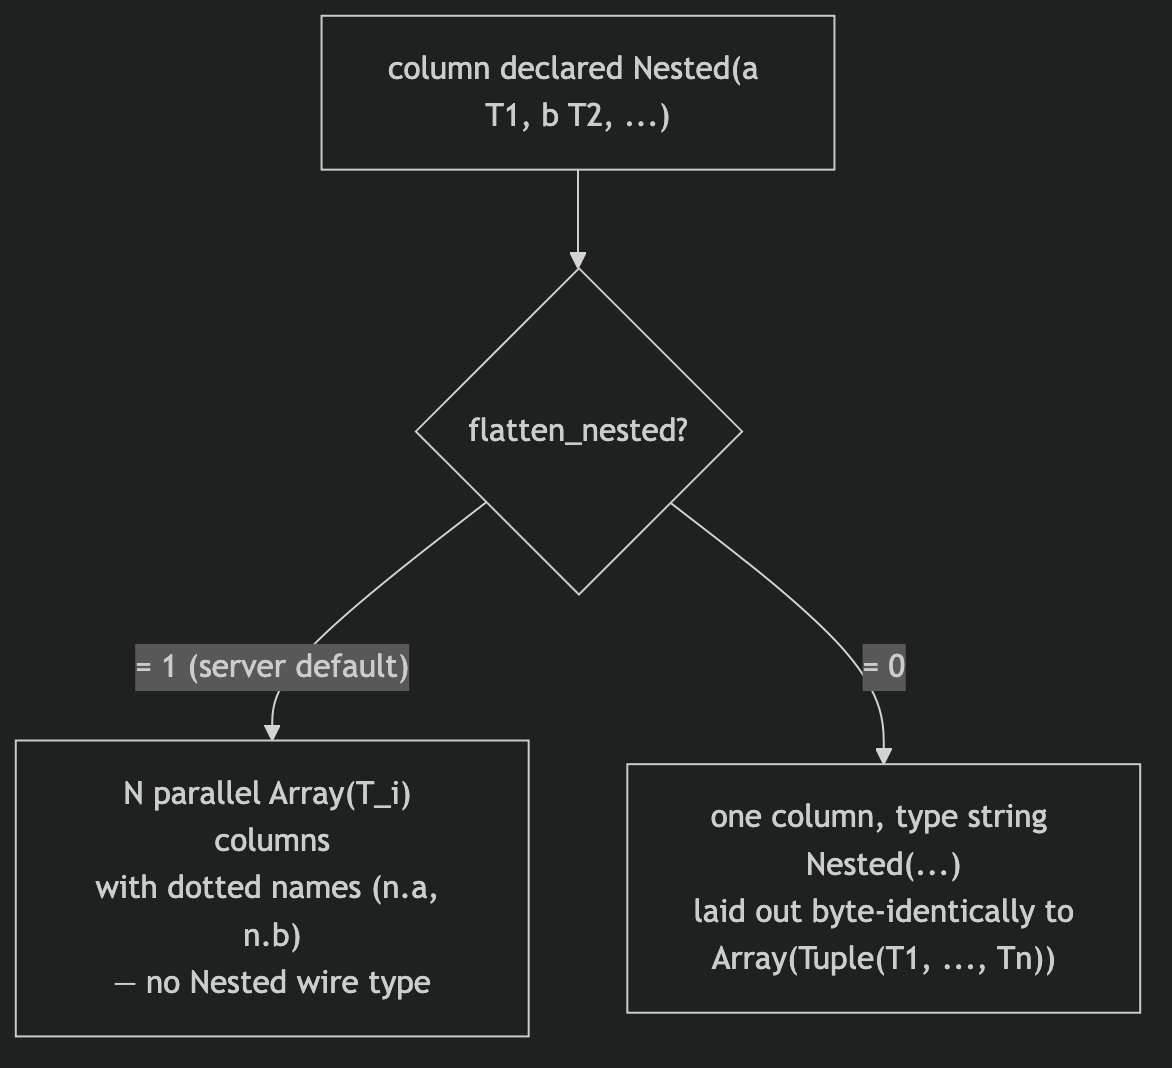
flatten_nested = 1 (padrão do servidor). Quando a tabela é criada com as configurações padrão, Nested não é um wire type. O servidor armazena e apresenta a coluna como N colunas Array(T_i) paralelas com nomes separados por ponto (outer.field1, outer.field2 e assim por diante). Para a camada de formato, não há nada de novo: cada coluna com ponto no nome é um Array comum:
flatten_nested = 0. Quando a tabela é criada com flatten_nested = 0, a coluna aparece no wire como uma única coluna com a string do tipo Nested(name1 T1, name2 T2, ...), e seu layout após a string do tipo é idêntico byte a byte a Array(Tuple(T1, T2, ..., Tn)) — incluindo a fase de prefixo interna. Assim, qualquer campo versionado T_i emite primeiro seu prefixo de estado, antes dos offsets. O exemplo abaixo usa campos não versionados, portanto a fase de prefixo fica vazia:
Nested preserva os nomes dos campos (a, b), que Array(Tuple) não mantém como slots nomeados.
A string do tipo do Caso B é uma lista de pares (nome, tipo) separados por vírgulas. O primeiro espaço em branco separa o nome do tipo; o próprio tipo pode conter outros espaços em branco, vírgulas e parênteses, então o parsing exige o mesmo divisor sensível à profundidade usado para Tuple. O layout wire:
total_elements = offsets[num_rows - 1] (ou 0 quando num_rows == 0). Os offsets são monotonicamente não decrescentes, e cada fluxo de campo contém exatamente total_elements valores. No momento do INSERT, o servidor garante que, dentro de uma mesma linha, todos os campos tenham o mesmo número de elementos. Uma coluna vazia não grava nenhum byte.
Nested(a UInt8, b String) com 2 linhas [(10,'x'),(20,'y')] e [(30,'z')] (25 bytes após a string do tipo):
Aliases de tipos
Vários tipos são apenas aliases: o servidor envia o nome do alias no cabeçalho da coluna, mas os bytes seguintes são os de um tipo subjacente. Um decodificador mapeia o alias para esse tipo e reutiliza seu codec — nenhum novo formato wire está envolvido. Os tipos geográficos são aliases de arrays e tuplas aninhados:
Assim, uma coluna
Point é decodificada exatamente como Tuple(Float64, Float64) (renderizada como (1,2)), um Ring como Array(Tuple(Float64, Float64)) ([(0,0),(1,1)]), e assim por diante, subindo na hierarquia.
Geometry também é um alias, mas de um Variant, e não de um array aninhado: sua carga útil é o variant dos sete tipos geográficos acima. O cabeçalho da coluna traz apenas a string do tipo Geometry — ele não detalha o variant —, portanto o decodificador precisa expandi-lo por conta própria. Diferentemente de um Variant declarado explicitamente pelo usuário, os discriminadores de Geometry não seguem a ordem crescente por nome: eles são fixos por questões de compatibilidade, e novos tipos geográficos são sempre anexados ao final. O mapeamento é 0 = LineString, 1 = MultiLineString, 2 = MultiPolygon, 3 = Point, 4 = Polygon, 5 = Ring, 6 = MultiPoint (adicionado na versão 26.7 — fluxos de servidores mais antigos simplesmente nunca contêm o discriminador 6). Cada valor selecionado é então decodificado por meio do respectivo alias geográfico acima (NULL usa o discriminador NULL do Variant, 255).
SimpleAggregateFunction(func, T) é um alias para seu tipo de valor T. Ele armazena um valor agregado já finalizado, de modo que sua forma no wire e sua renderização são exatamente as de T (SimpleAggregateFunction(sum, UInt64) é decodificado como UInt64). Somente a forma com um único tipo de valor funciona como alias dessa maneira; o próprio tipo subjacente pode ser composto.
Dois tipos relacionados não são aliases. Eles são tipos de coluna
Native válidos — um cliente pode receber uma coluna AggregateFunction de um combinador -State ou de uma agregação distribuída, por exemplo —, mas cada um carrega sua própria carga útil especializada, que está fora do escopo desta página:AggregateFunction(func, ...)contém um estado de agregação intermediário (não um valor finalizado); seu layout binário é específico da função de agregação e da versão. O nome da função pode conter parâmetros, cada um impresso como um literal SQL, como emAggregateFunction(topK(3), UInt64). Algumas funções de agregação imprimem um sufixo::Typeexplícito em um parâmetro, como emAggregateFunction(topK('3'::Decimal32(0)), UInt64), porque um valorDecimalou inteiro largo não tem uma forma literal simples que possa ser impressa; fazer isso ou não é uma propriedade de cada função, e não do formato, portanto um decodificador que inspeciona parâmetros deve aceitar ambas as grafias. Um decodificador que precisa apenas dos tipos dos argumentos não é afetado. Uma função de agregação versionada explicita uma versão de estado diferente de zero como primeiro argumento da string do tipo —AggregateFunction(1, quantileDeterministic, UInt64, UInt64)—, enquanto a versão0não é impressa, de modo que a string do tipo continua sendoAggregateFunction(quantileDeterministic, UInt64, UInt64). Em uma conexão negociada (revisão acima de0), o componente de gravação escolhe a versão somente com base na revisão do protocolo — nunca com base em uma versão que porventura esteja fixada em seu tipo local, porque a versão0é indistinguível, no wire, de “nenhuma versão anunciada” —, portanto a mesma função pode anunciar versões diferentes em conexões diferentes, e um leitor deve obter a versão da string do tipo em vez de presumir a mais recente. Na revisão0não há peer para o qual derivar uma versão — o fluxo é autodescritivo e lido de volta por quem o gravou —, então uma versão fixada no tipo é mantida no fluxo (e na string do tipo anunciada) em vez de ser rebaixada para0.quantileDeterministic(incluindo as grafiasquantilesDeterministicemedianDeterministic) é versionada a partir da revisão54491: a versão1acrescenta umUInt8 skip_degreeao final do estado, e seu prefixo é idêntico byte a byte ao da versão0. Abaixo dessa revisão, o componente de gravação emite estados na versão0, de modo que um peer mais antigo não é afetado.uniqé versionada a partir da revisão54493: a versão1acrescenta um byte de flags no início do layout da versão0e, quando o bit0das flags está definido, acrescenta ao final uma pequena amostra adicional de hashes completos de 64 bits, cada um combinado via XOR com a constante0x9E3779B97F4A0000(UInt8 skip_degree,VarUInt counte, em seguida, os valores de 8 bytes), o que mantém a estimativa precisa em cardinalidades acima de dois bilhões; um estado na versão0carrega apenas a amostra principal de 32 bits. O bit1das flags indica que a amostra de 64 bits está incompleta — o estado absorveu um estado na versão0, cujos elementos nunca foram oferecidos a uma amostra de 64 bits —, caso em que nenhuma amostra de 64 bits é gravada e um leitor deve estimar somente a partir da amostra principal de 32 bits (e continuar indicando isso nos estados que vier a gravar); os dois bits são, portanto, mutuamente exclusivos, e um leitor deve rejeitar um estado que defina ambos. Nenhum outro bit é definido, e um leitor deve rejeitar um estado que defina algum deles.uniqis versioned from revision54493: version1prepends a flags byte to the version-0layout and, when bit0of the flags is set, appends a small additional sample of full 64-bit hashes, each XOR-ed with the constant0x9E3779B97F4A0000(UInt8 skip_degree,VarUInt count, then the 8-byte values), which keeps the estimate accurate at cardinalities above two billion; a version0state carries the 32-bit main sample only. Bit1of the flags says that the 64-bit sample is incomplete — the state has absorbed a version0state, whose elements were never offered to a 64-bit sample — in which case no 64-bit sample is written and a reader must estimate from the 32-bit main sample alone (and keep saying so in the states it goes on to write); the two bits are therefore mutually exclusive, and a reader must reject a state that sets both. No other bit is defined, and a reader must reject a state that sets one. Tudo isso se aplica igualmente a um estado aninhado em um tipo contêiner —Array,Tuple,Map,Nullable,Variant(em que a versão explicitada da alternativa altera a string do tipo sem alterar a ordem do discriminador) ou um wrapperNested/SimpleAggregateFunction. Isso também vale para combinadores de funções de agregação: um combinador de repasse aplicado a uma função versionada —uniqIf,uniqArray,uniqForEach,uniqMap,uniqArgMin/uniqArgMax,uniqOrNull/uniqOrDefault,uniqResamplee o adaptador implícito de argumentoNullable— repassa a versão aos estados aninhados contidos em sua carga útil, explicita a versão atual da função aninhada na string do tipo de um estado recém-criado exatamente como a função simples (AggregateFunction(1, uniqIf, UInt64, UInt8)) e, em uma conexão negociada, deriva a versão da revisão do protocolo da mesma forma. O nome personalizado de um wrapper contém uma segunda cópia do seu tipo de argumento, portanto o componente de gravação deve reconstruir essa cópia com a mesma versão de estado de agregação negociada; caso contrário, seu cabeçalho pode anunciar a versão1para uma carga útil na versão0. Um caso extremo deVariantnão tem nenhuma representação no wire: quando duas alternativas diferem apenas em uma versão de estado explicitada (o que é válido como tipo de coluna, já que as strings do tipo diferem), reversionar ambas para a revisão negociada as fundiria em uma única alternativa, portanto o remetente deve abortar a transferência em vez de anunciar versões diferentes daquelas com que a carga útil foi gravada.Dynamicé a exceção deliberada ao versionamento derivado da revisão: uma colunaDynamicanuncia por conta própria seus tipos aninhados — por meio de suas próprias listas de tipos e da codificação binária de tipos, cujo campo de versão explícito carrega uma versão de estado explicitada (os valores de sua variante compartilhada incorporam o tipo dessa forma mesmo em repouso) —, e esses anúncios fazem parte dos próprios dados da coluna, idênticos para qualquer peer e qualquer meio, portanto nunca são reescritos para uma revisão negociada. Assim, um estado aninhado em um valorDynamicé gravado na versão explicitada em seu tipo (que um estado recém-criado carrega, já que o resultado de uma consulta-Stateexplicita sua versão) e na versão0quando o tipo não explicita nenhuma, da mesma forma em qualquer conexão e meio.QBit(T, N[, stride])armazena um vetor com seus planos de bits transpostos para cargas de trabalho de busca vetorial; o layout de seu fluxo on-wire (fluxos de planos de bitsFixedStringordenados por grupo, totalizandoelement_size * (N / stride)com umstrideexplícito) e sua codificação binária de tipo (tag0x36, ou0x37QBitWithStridequandostride != N) estão documentados na página do tipo de dadosQBite na referência de codificação binária de tipos, de modo que um leitorNativenão precisa deduzi-los do código-fonte C++.
Tipos versionados
Tipos versionados carregam, on-wire, um prefixo de versão de serialização que indica qual variante da codificação vem em seguida. Eles também podem usar múltiplos fluxos (assim como os tipos compostos). No wireNative, o prefixo e eventuais dicionários são definidos por bloco — esses tipos não mantêm estado entre blocos (veja a nota sobre o prefixo por bloco abaixo); o estado de serialização entre blocos existe apenas no fluxo em disco do MergeTree.
Esses tipos são consideravelmente mais complexos do que os tipos compostos de formato fixo, e um cliente voltado para consultas analíticas simples pode deixar o suporte a eles para depois.
Versão de serialização: conceito
Uma versão de serialização é um número de versão on-wire, por tipo e por coluna, que indica qual variante da codificação de um tipo o remetente está usando. Ela é o primeiro elemento do prefixo de estado da coluna; assim, o decodificador a lê e faz o encaminhamento para o parser adequado ao restante da coluna. Ela não se confunde com a versão do protocolo:
A maioria dos tipos versionados grava a versão como um UInt64 little-endian imediatamente antes de qualquer outro dado do prefixo de estado; alguns usam VarUInt ou UInt8. O decodificador lê a versão primeiro e rejeita valores desconhecidos — uma versão mais alta indica um formato de remetente mais recente que o decodificador não reconhece, e interpretá-lo incorretamente corrompe todos os bytes seguintes.
O prefixo de estado é emitido no início de cada bloco cuja contagem de linhas é maior que zero, imediatamente antes da carga útil desse bloco.
O gravador Native e o leitor não mantêm o estado de serialização entre blocos: o
NativeWriter cria um novo estado de serialização e grava um prefixo de estado para cada bloco de coluna não vazio que escreve, e o NativeReader cria um novo estado de desserialização e o lê para cada bloco não vazio que lê (ambos ignoram totalmente o prefixo quando rows == 0).
Por isso, blocos de cabeçalho (rows = 0) e blocos vazios não emitem nada, e o decodificador deve ler o prefixo de estado novamente no início de cada bloco não vazio. Um decodificador que lê o prefixo apenas uma vez e trata os blocos seguintes como se contivessem só carga útil lerá o prefixo do próximo bloco como dados e perderá a sincronização:
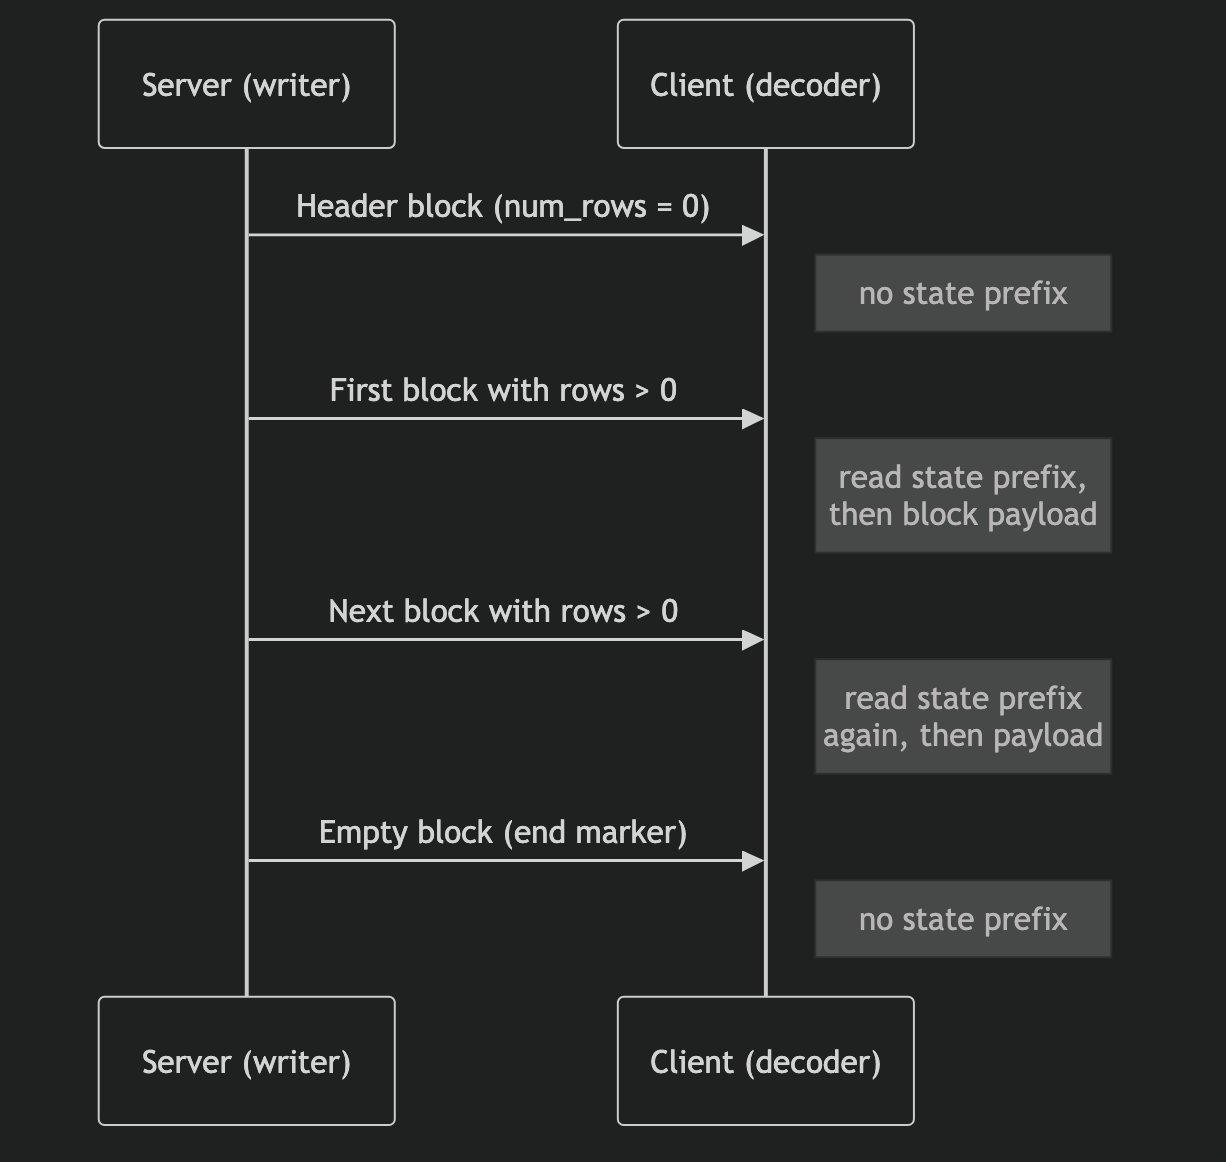
Referência de versões de serialização
Alguns pontos importantes sobre a tabela:
- Os valores não são contíguos.
Dynamicusa1,2,3e4, comV3em4eFLATTENEDem3. Um número maior não indica necessariamente uma versão mais recente. - Alguns valores existem apenas no formato Native.
Object::STRING,Object::FLATTENEDeDynamic::FLATTENEDexistem para compatibilidade do protocolo nativo com clientes que não implementam Object/Dynamic por completo. Eles não aparecem no armazenamento em disco do MergeTree. V3existe apenas em disco.Object::V3eDynamic::V3constam da lista porque esses valores já foram atribuídos e não devem ser reutilizados, e não porque um decodificador possa encontrá-los: o ClickHouse nunca os envia viaNativee, nesse formato, os rejeita comINCORRECT_DATA. Tudo o que eles carregam — a subversão de shared-data deObject::V3e seus layouts de bucket e de granule — descreve uma parte, e não um bloco, e por isso está fora do escopo desta página. Clientes que consomem o protocolo TCP nativo recebemV1,V2,STRINGouFLATTENED.
LowCardinality(T)
O tipo versionado mais simples. Ele substitui uma coluna deN valores internos por um pequeno dicionário de valores únicos, acompanhado de N índices que apontam para esse dicionário.
String do tipo: LowCardinality(InnerType). Exemplos: LowCardinality(String), LowCardinality(FixedString(4)), LowCardinality(Nullable(String)).
sharedDictionariesWithAdditionalKeys; os demais valores são reservados.
O metadado UInt64 por bloco é um campo de bits:
Em uma resposta de consulta típica, com um único bloco de dados por coluna, o metadado é
0x600 (HasAdditionalKeys + NeedUpdateDictionary).
Os valores do dict são dict_size valores codificados com o tipo interno T. O dicionário reserva os slots iniciais para valores especiais: uma coluna não anulável reserva um (dict[0] contém o valor default do tipo interno, por exemplo "" para String), e os valores distintos reais começam em dict[1].
Em LowCardinality(Nullable(T)), o dict continua codificado como T simples (sem stream de mapa de nulos), mas dois slots são reservados: dict[0] é o marcador NULL e dict[1] é o valor default do tipo interno (por exemplo "" para String); os valores distintos reais começam em dict[2]. A chave de uma linha NULL aponta para dict[0], e esse slot é gravado no wire com os bytes do valor default do tipo interno.
As chaves são índices no dict; cada índice ocupa 1 << key_type_code bytes (1, 2, 4 ou 8), e o valor N é reconstruído como dict[keys[N]].
keys_count é o número de valores LowCardinality no nível recursivo atual, não necessariamente a contagem de linhas do bloco. Em uma coluna LowCardinality de nível superior, os dois coincidem. Mas, quando o LowCardinality está dentro de um tipo composto, a contagem corresponde ao número achatado de valores que o tipo composto repassa: em Array(LowCardinality(String)) com três linhas contendo cinco elementos no total, keys_count é 5, e não 3; em Map(K, LowCardinality(V)), é o número total de pares, e assim por diante. Um decodificador deve obter keys_count deste campo em vez de presumir a contagem de linhas do bloco. Quando essa contagem achatada é zero — por exemplo, em um bloco cujos arrays estão todos vazios —, a fase de dados do LowCardinality não grava absolutamente nada: apenas o prefixo de estado (emitido na fase de prefixo do tipo composto) está presente, sem metadado, dicionário ou keys_count em seguida.
O prefixo de estado é lido no início de cada bloco cuja contagem de linhas é maior que zero — blocos de cabeçalho (rows = 0) e blocos vazios não emitem nada. Dentro de um bloco, keys_count é igual à contagem de linhas, dict_size é igual ao número de valores no stream do dict, e cada chave cabe em 1 << key_type_code bytes.
No formato
Native, cada bloco carrega um dicionário autocontido e local ao bloco — não existe estado de dicionário compartilhado entre blocos. O gravador Native define low_cardinality_max_dictionary_size = 0, de modo que SerializationLowCardinality nunca constrói um dicionário compartilhado: cada bloco não vazio grava suas chaves como chaves adicionais locais ao bloco, com NeedGlobalDictionaryBit desativado (metadado 0x600), e o leitor Native rejeita NeedGlobalDictionaryBit quando native_format é true. Portanto, um decodificador deve redefinir o dicionário a cada bloco e ler as dict_size entradas presentes nesse bloco; reaproveitar o dicionário de um bloco anterior levaria a uma leitura incorreta das chaves do bloco seguinte. (Persistir um dicionário LC entre blocos é uma questão do armazenamento em disco do MergeTree, e não do layout wire do Native.)LowCardinality(String) com os valores ['a', 'b', 'a', 'c', 'b']:
dict[1], dict[2], dict[1], dict[3], dict[2] = ["a", "b", "a", "c", "b"].
LowCardinality(Nullable(String)) com os valores ['a', NULL, '', 'b'] mostra os dois slots reservados — dict[0] para NULL e dict[1] para o valor padrão de string vazia:
dict[2] = "a", dict[0] = NULL, dict[1] = "", dict[3] = "b", ou seja, ["a", NULL, "", "b"]. Tanto dict[0] quanto dict[1] são bytes vazios no wire; o valor nulo é determinado pela chave que aponta para o slot 0, e não pelos bytes.
JSON (Tier 1: fallback String)
O tipoJSON do ClickHouse tem várias codificações wire (consulte a referência de versões de serialização). O Tier 1 é o mais simples: quando a configuração por consulta output_format_native_write_json_as_string = 1 está definida, o servidor converte cada valor JSON em seu texto serializado e emite a coluna como String, com um marcador de prefixo de estado.
String do tipo: JSON.
1 para este fallback String. Os demais valores indicam diferentes codificações de JSON/Object: 0 = V1, 2 = V2 (o padrão no protocolo TCP nativo), 3 = FLATTENED, 4 = V3 (consulte a referência de versões de serialização). Se o decodificador encontrar aqui um valor diferente de 1, não se trata do fallback String. O prefixo é lido no início de cada bloco com linhas > 0, e o stream de valores é uma coluna String padrão com num_rows linhas.
Valor JSON '{"a":1}' (uma linha):
{"a":1}, com o inteiro preservado como inteiro. O texto é apenas um valor String; assim, o cliente recebe o JSON para trânsito opaco, mas não recupera os caminhos individuais nem seus tipos do ClickHouse. Para obter uma tipagem fiel por caminho, é necessária a codificação Tier 2 descrita abaixo.
Variant(T1, T2, …)
Uma união discriminada: cada linha contém um valor de exatamente um dos tipos variantes, ou NULL. Cada linha carrega um discriminador global de um byte que seleciona seu tipo, e os valores de cada tipo são então armazenados de forma densa, em um bloco contíguo por tipo variante. String do tipo:Variant(T1, T2, ...). O servidor normaliza a ordem (os tipos variantes são ordenados por nome), de modo que a string do tipo, tal como é recebida, já lista os tipos na ordem do discriminador global: o discriminador 0 seleciona o primeiro tipo listado, 1 o segundo, e assim por diante. 255 (NULL_DISCRIMINATOR) indica que a linha é NULL. Os elementos de Variant nunca são Nullable, pois representar NULL é função do discriminador. Exemplos: Variant(String, UInt64), Variant(Array(UInt8), String).
O prefixo de estado carrega o modo de discriminante como UInt64 LE: 0 = BASIC (o discriminador de cada linha é gravado literalmente), 1 = COMPACT (codificação run-length por granule). Por padrão, o servidor usa BASIC no protocolo nativo (use_compact_variant_discriminators_serialization = false); apenas o BASIC é especificado aqui.
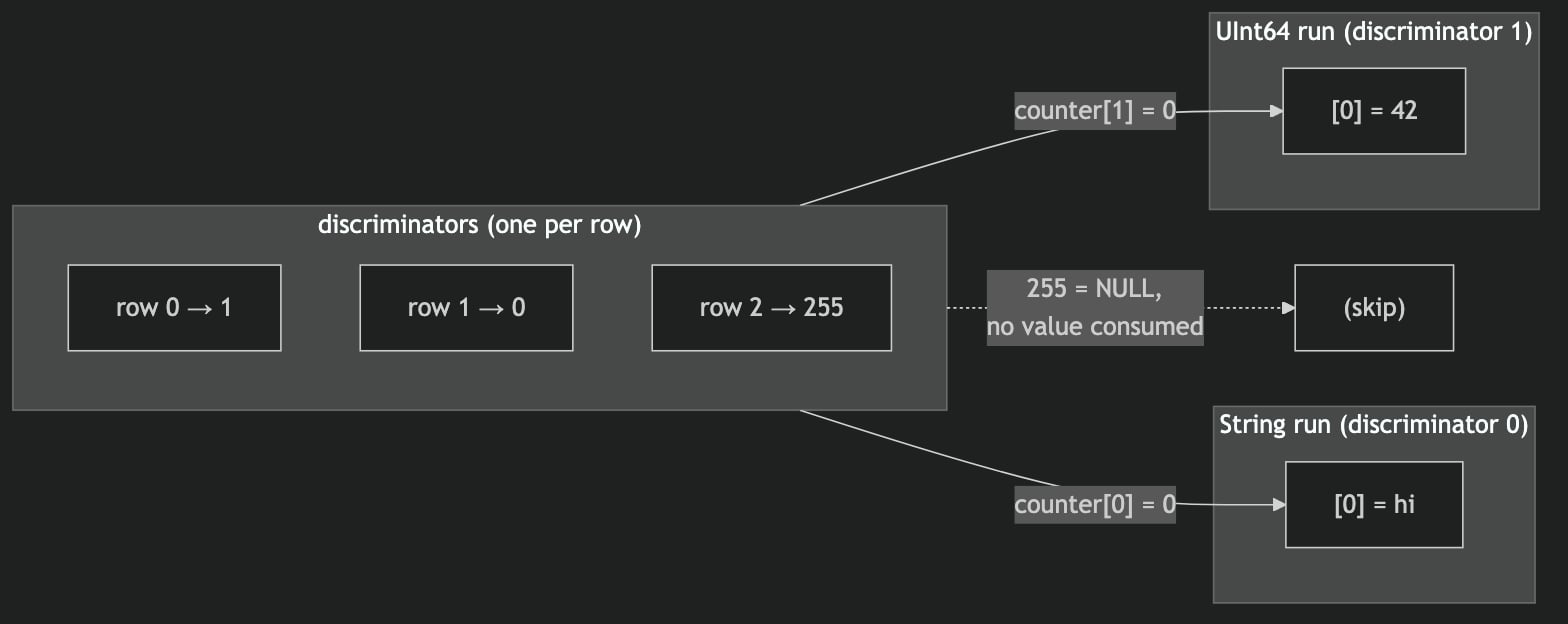
r com discriminador d (≠ 255) recebe o valor no índice counter[d] da sequência de valores do tipo variante d e, em seguida, counter[d] é incrementado. Linhas com discriminador 255 são NULL e não consomem valor de nenhuma sequência; assim, a soma dos contadores por tipo é igual ao número de linhas não NULL.
O prefixo de estado (o UInt64 de modo) é lido no início de cada bloco com linhas > 0; blocos de cabeçalho e blocos vazios não emitem nada. Cada discriminador não NULL é menor que o número de tipos variantes, e o tipo variante i é decodificado para exatamente count[i] linhas.
Elementos de Variant que também são stateful (
LowCardinality, Variant, Dynamic, JSON) emitem seu próprio prefixo de estado na fase de prefixo de estado por elemento, após o UInt64 de modo. Tipos folha e os tipos compostos simples (Array, Tuple, Map de tipos folha) têm prefixos de estado vazios e podem ser combinados livremente.Variant(String, UInt64) com os valores [42, 'hi', NULL] (a ordem canônica coloca String antes de UInt64; portanto, discriminador 0 = String, 1 = UInt64):
42; linha 1 = String run[0] = "hi"; linha 2 = NULL.
O stream de discriminadores atua como índice: cada discriminador não NULL extrai o próximo valor da sequência densa do seu tipo, enquanto 255 (NULL) não consome nada. Esse mesmo percurso reconstrói o Dynamic, que difere apenas na forma como o NULL é codificado:
Dynamic
Uma coluna cujo tipo de valor é descoberto em tempo de execução: cada linha contém um valor de um dos tipos de um conjunto determinado em tempo de execução, ou NULL. Diferentemente deVariant, o conjunto de tipos não está na string do tipo da coluna — ele é transportado no prefixo de estado.
String do tipo: Dynamic ou Dynamic(max_types=N). O parâmetro max_types limita quantos tipos distintos a coluna rastreia, mas não afeta o formato wire descrito abaixo.
Dynamic tem quatro codificações — V1 = 1, V2 = 2, FLATTENED = 3, V3 = 4. A codificação emitida pelo servidor depende do canal e das configurações da consulta:
- Via
clickhouse-cliente HTTPFORMAT Native, a revisão do componente de gravação é0(a menos que seja elevada comclient_protocol_version); portanto, o padrão é V1. - Via protocolo TCP nativo, na revisão negociada, o padrão é V2. O componente de gravação
Nativemantém as estatísticas desabilitadas, então uma carga útilV2padrão não contém estatísticas por variante — logo após a lista de tipos vêm o prefixo e os dados doVariantaninhado. (Estatísticas por variante dizem respeito ao armazenamento em disco do MergeTree e não fazem parte do formato wire Native.) - A configuração de consulta
output_format_native_use_flattened_dynamic_and_json_serialization = 1se sobrepõe a ambos os casos e emite FLATTENED (versão 3), independentemente da revisão.
EscopoEsta página especifica apenas o layout
FLATTENED. Os layouts binários não flat V1/V2/V3 correspondem à representação interna/em disco (listas de tipos codificadas em binário, estatísticas por variante) e não são especificados aqui. Um cliente que queira decodificar Dynamic com base nesta página deve solicitar FLATTENED definindo output_format_native_use_flattened_dynamic_and_json_serialization = 1; o layout abaixo pressupõe essa configuração. Como o byte de versão fica no início do prefixo, um decodificador consegue identificar a codificação efetivamente recebida e rejeitar V1/V2/V3 caso implemente apenas FLATTENED.num_types tipos mais o slot de NULL — UInt8 para num_types ≤ 255, depois UInt16, UInt32, UInt64. NULL corresponde ao próprio valor de discriminador num_types, diferentemente de Variant, em que NULL é o valor fixo 255. A reconstrução segue o mesmo percurso denso de Variant: mantenha um contador por tipo; a linha r com discriminador d (≠ num_types) recebe o valor counter[d] da sequência do tipo d.
O prefixo de estado (versão + lista de tipos) é lido no início de cada bloco com linhas > 0; blocos de cabeçalho e blocos vazios não emitem nada.
Contagens malformadas
num_types é lido do stream antes de qualquer nome de tipo. Um decodificador deve tratá-lo como não confiável e não deve usá-lo diretamente para dimensionar uma alocação — nem uma contagem próxima de SIZE_MAX (que pode causar overflow na aritmética intermediária ou lançar uma exceção que não seja DB::Exception), nem uma contagem grande, porém representável, como 100000000 (que está muito abaixo do max_size() de um vetor, mas alocaria gigabytes antes mesmo de um único nome de tipo ser lido). O ClickHouse lê a lista de tipos uma entrada por vez, usando apenas uma dica de pré-alocação limitada, de modo que um num_types corrompido é rejeitado como INCORRECT_DATA (“Dynamic column has too many types”, quando a contagem excede o que o contêiner comporta) ou como um erro de leitura comum quando o stream fica sem entradas de tipo — nunca como uma falha por falta de memória.Não limite, porém, o num_types achatado por ColumnDynamic::MAX_DYNAMIC_TYPES_LIMIT (254 no ClickHouse): a lista de tipos achatada contém todos os tipos de tempo de execução distintos, incluindo aqueles que transbordaram para a variante compartilhada, de modo que um bloco achatado válido pode legitimamente listar muito mais do que isso. O limite MAX_DYNAMIC_TYPES_LIMIT se aplica apenas à contagem num_dynamic_types nos prefixos não flat V1/V2/V3, que conta os slots de variantes regulares e é limitada por esse valor (o ClickHouse a valida nesse ponto, antes do + 1 referente à variante compartilhada).Streams truncadosA sequência de discriminadores contém exatamente
num_rows entradas, e um decodificador deve verificar se leu essa quantidade, em vez de aceitar o que quer que o stream contenha. Uma sequência mais curta não entra em contradição com nada do que vem depois dela: as contagens de valores por tipo são derivadas dos discriminadores efetivamente lidos, portanto permanecem consistentes com as sequências de valores, e uma sequência composta apenas de marcadores NULL não exige nenhum byte de valor. O ClickHouse rejeita uma sequência de discriminadores curta com INCORRECT_DATA (“Mismatch in flattened Dynamic column: N rows are expected, but the indexes stream contains only M rows”) antes de qualquer verificação por tipo, porque a coluna reconstruída passa então a ser usada para num_rows linhas, independentemente de seu tamanho real.Tipos de tempo de execução cuja serialização é stateful (
LowCardinality, Variant, Dynamic, JSON) carregam prefixos de estado aninhados após a lista de nomes de tipo.Variant — os slots de variantes regulares são gravados na ordem de DataTypeVariant (por nome de tipo), de modo que a ordem no fluxo binário não corresponde à ordem de inserção. No entanto, ela nem sempre está ordenada globalmente: tipos que transbordaram para a variante compartilhada (por exemplo, com Dynamic(max_types=N)) são anexados após os slots regulares na ordem em que apareceram pela primeira vez, então o final da lista pode quebrar a ordem por nome de tipo. Portanto, um decodificador deve considerar a lista de tipos transmitida como a referência definitiva para a atribuição de discriminadores e não deve reordená-la por conta própria. O que a lista não pode conter é um tipo repetido ou Nothing: duas entradas iguais são mapeadas para um único discriminador, e Nothing nem sequer é uma variante; em ambos os casos, portanto, parte da lista não tem onde ser reconstruída. O ClickHouse rejeita os dois casos com INCORRECT_DATA. Para as linhas [42::UInt64, "hi", NULL], os dois tipos são String e UInt64, e "String" vem antes de "UInt64" na ordenação, então os discriminadores são 0 = String, 1 = UInt64, 2 = NULL:
42; linha 1 = String run[0] = "hi"; linha 2 = NULL. Os runs de cada tipo seguem a mesma ordem de wire da lista de tipos (String antes de UInt64).
JSON (Tier 2: FLATTENED Object)
A codificação JSON mais rica: em vez de converter cada valor em texto (Tier 1), a coluna é dividida em uma subcoluna por caminho JSON. Ela é selecionada quando não se solicita o fallback do Tier 1 (output_format_native_write_json_as_string = 0) e a flag de serialização achatada está ativada (output_format_native_use_flattened_dynamic_and_json_serialization = 1); nesse caso, o servidor emite a serialização versão 3.
Há dois tipos de caminho:
- Caminhos tipados são declarados na string do tipo, por exemplo
JSON(a UInt32, b String), e decodificados no tipo declarado. Nomes de caminho que contêm pontos são delimitados por backticks na string do tipo. - Caminhos dinâmicos são descobertos em tempo de execução, e cada um é decodificado como uma coluna Dynamic.
num_rows valores.
Dynamic de um caminho dinâmico (na fase de prefixo) fica separado de seus dados (na fase de dados). O prefixo de estado é lido no início de cada bloco com linhas > 0, e cada coluna de caminho (tipado ou dinâmico) contém exatamente num_rows valores. O objeto da linha r é montado lendo o valor de cada caminho no índice r; um caminho dinâmico cujo discriminador Dynamic seja NULL nessa linha não contribui com nenhuma chave. Os nomes dos caminhos dinâmicos devem ser distintos, e nenhum deles pode repetir um caminho que a string do tipo já declara como tipado — em qualquer um dos casos, o objeto montado teria dois valores sob a mesma chave; por isso, o ClickHouse rejeita ambos com INCORRECT_DATA. O mesmo vale para a lista de caminhos dinâmicos das codificações não flat.
Contagens malformadas
num_dynamic_paths no layout FLATTENED documentado aqui — e a contagem de caminhos dinâmicos nas codificações não flat V1/V2 — é lido do stream antes dos nomes dos caminhos. (Não há um campo separado de caminhos achatados nos prefixos não flat: eles trazem apenas a contagem de caminhos dinâmicos, além de um valor max_dynamic_paths em V1 que é lido e descartado.) Assim como em Dynamic, um decodificador deve tratar essas contagens como não confiáveis e não deve dimensionar uma alocação diretamente a partir delas — nem uma contagem da família SIZE_MAX, nem uma contagem grande, porém representável. O ClickHouse lê os nomes dos caminhos uma entrada por vez, usando apenas uma dica de pré-alocação limitada; assim, uma contagem corrompida é rejeitada com INCORRECT_DATA (“JSON/Object column has too many paths”, quando excede o que o contêiner comporta) ou como um erro de leitura comum quando os nomes de caminhos no stream se esgotam.Streams truncadosOs
num_rows valores por coluna de caminho são um requisito obrigatório, não um limite superior: um decodificador deve verificar cada coluna de caminho, tipado e dinâmico, com base na contagem de linhas do bloco, em vez de confiar que o stream terminará onde deveria. O objeto montado não tem um tamanho independente para comparação — sua contagem de linhas é simplesmente o resultado da reconstrução —, portanto uma coluna de caminho incompleta não pode ser detectada depois, e ler a linha r dela ultrapassa seu final. O ClickHouse a rejeita com INCORRECT_DATA (“Unexpected size of typed path / flattened path p in flattened Object column”). No caso de um caminho dinâmico, isso se soma à verificação equivalente dentro de sua coluna Dynamic.JSON {"a": 42, "b": "hi"} (uma linha, ambos os caminhos dinâmicos). Um inteiro JSON é inferido como Int64:
JSON não flat (V1/V2)
As codificações não achatadas deObject são o que o servidor emite no wire quando a flag de achatamento está desativada: V1 via clickhouse-client / HTTP FORMAT Native (revisão 0) e V2 via protocolo TCP nativo. (V3, a terceira codificação não flat, é gravada apenas em partes MergeTree e é rejeitada no wire.) Essas codificações contêm uma coluna de dados compartilhados (shared-data) e não são especificadas nesta página. Observe que elas não contêm estatísticas por caminho no wire Native: o NativeWriter mantém as estatísticas desabilitadas, portanto o prefixo de estrutura de Object não tem seção de estatísticas, e os bytes que vêm depois dele já são diretamente os prefixos e os dados typed/dynamic/shared-data. As estatísticas aparecem apenas nos caminhos em disco do MergeTree que as habilitam. Para decodificar uma coluna JSON com base nesta página, o cliente deve escolher um dos tiers documentados: definir output_format_native_write_json_as_string = 1 para o fallback String ou output_format_native_use_flattened_dynamic_and_json_serialization = 1 (com output_format_native_write_json_as_string = 0) para o layout FLATTENED Object.
Frame de compressão
O ClickHouse pode comprimir os dados de coluna de um streamNative usando um formato de frame interno. O layout do frame abaixo é independente do transporte — os mesmos frames aparecem tanto no protocolo TCP nativo quanto no HTTP —, mas a forma de solicitar a compressão, e o que envolve os frames, varia conforme o transporte.
- Protocolo TCP nativo. A compressão é opcional e ativada por consulta, por meio da flag
compressionno pacote Query. Quando ativa, o corpo de cada pacoteData,Totals,Extremes,LogeProfileEvents— os bytes após a stringtable_name— é encapsulado no formato de frame. O envelope do pacote em si, ou seja, o código do tipo de pacote e a stringtable_name, não é comprimido; o servidor os grava no stream bruto. Tudo o que oNativeWriteremite vai para o stream comprimido, de modo que o prefixoBlockInfoé a primeira coisa dentro do frame, junto com as dimensões e as colunas. Portanto, o cliente precisa descomprimir o frame antes de ler oBlockInfo. - HTTP.
SELECT ... FORMAT Native&compress=1encapsula todo o stream de bytes doFORMAT Nativenos mesmos frames (o servidor usa o mesmoCompressedWriteBufferinterno), e?decompress=1espera os mesmos frames em um corpo de entradaNative, decodificando-os por meio doCompressedReadBuffercorrespondente. Nesse caminho, não há tipo de pacote TCP,table_namenem envelope de pacote: toda a carga útil comprimida consiste apenas em blocosNativeenquadrados (o prefixoBlockInfosó está presente se a revisão negociada for maior que0, exatamente como no layout não comprimido acima). Esse enquadramento interno decompress/decompressnão se confunde com a compressão de transporte HTTP (Content-Encoding: gzip/zstd, habilitada porenable_http_compression), que encapsula a resposta na camada HTTP e não corresponde ao formato de frame abaixo.
FORMAT Native ainda precisa adicionar essa camada de frames para ler uma resposta HTTP Native comprimida ou para enviar um corpo da requisição com decompress=1.
Formato do frame
16 + compressed_size = 16 + 9 + body_size = 25 + body_size. Observe os dois intervalos: o checksum cobre o cabeçalho de 9 bytes mais o corpo, enquanto compressed_size contabiliza o cabeçalho e o corpo, mas não o próprio checksum:
Valores do byte de método
Estes três codecs são os que o servidor produz para o enquadramentoNative de stream completo: a saída HTTP com compress=1 usa o codec padrão do servidor (ZSTD(3)), e o protocolo TCP nativo usa LZ4, ZSTD ou NONE, conforme o valor de network_compression_method. Um cliente Native genérico só precisa produzir e consumir esses três.
O byte de método também codifica os codecs em nível de coluna. Eles são aplicados por coluna nos caminhos em disco do MergeTree, e não ao enquadramento de stream completo, mas o caminho de entrada HTTP com
decompress=1 obtém o codec a partir do byte de método de cada frame; por isso, qualquer um desses bytes pode aparecer legitimamente na entrada. Assim, um decodificador em conformidade deve reconhecer todo o espaço de valores atribuídos e rejeitar os bytes que não implementa, em vez de interpretar o corpo de forma incorreta. Os corpos desses codecs têm formato específico de cada um e estão fora deste contrato genérico de frame:
DoubleDelta (0x94) armazena diferenças de segunda ordem como bits de prefixo/sinal/magnitude, com o MSB primeiro. A decodificação baseada em palavras preserva essa codificação, a contagem de elementos e o preenchimento do byte final.
0x9c (ALP) é um codec sem perdas em beta para Float32 e Float64 (compressão adaptativa de ponto flutuante sem perdas). Só é possível criar uma tabela com CODEC(ALP) quando a configuração enable_alp_codec está habilitada, mas o byte de método é sempre aceito na descompressão, para que dados gravados anteriormente continuem legíveis. 0x9d (SZ3) é um codec com perdas experimental, com erro limitado, para Float32, Float64 e Array desses tipos. Só é possível criar uma tabela com CODEC(SZ3) quando a configuração enable_sz3_codec está habilitada, mas o byte de método é sempre aceito na descompressão, para que dados gravados anteriormente continuem legíveis. 0x9f (ZXC) é um codec LZ assimétrico experimental: lento na compressão, mas muito rápido na descompressão, com taxa de compressão entre a do LZ4 e a do ZSTD. Só é possível criar uma tabela com CODEC(ZXC) quando a configuração enable_zxc_codec está habilitada, mas o byte de método é sempre aceito na descompressão, para que dados gravados anteriormente continuem legíveis. Os bytes 0x99 (DeflateQpl) e 0x9b (ZSTD_QPL) foram atribuídos a codecs que já foram removidos; eles permanecem reservados e não são reutilizados.
0x9e (Quantized) é um codec de coluna experimental para colunas vetoriais densas (Array(Float32) e tipos semelhantes). Assim como o NONE, ele apenas repassa os dados — o corpo em precisão total é armazenado sem alterações —, mas sua presença anexa uma serialização que grava um stream complementar, compacto e quantizado, usado para acelerar a busca vetorial. Só é possível criar uma tabela com CODEC(Quantized(...)) quando a configuração enable_quantized_codec está habilitada, e o byte de método é sempre aceito na descompressão.
Checksum
O ClickHouse usa o CityHash v1.0.2 (a variante histórica), e não o CityHash moderno do Google; os dois produzem saídas diferentes. O checksum é calculado sobre os 9 bytes do cabeçalho (method + compressed_size + uncompressed_size) mais os N bytes do corpo, ou seja, tudo o que está entre o checksum e o fim do frame. Os primeiros 8 bytes da saída de 16 bytes do CityHash128 correspondem à metade inferior (LE), e os 8 bytes seguintes, à metade superior (LE). Um decodificador recalcula o CityHash128 sobre o cabeçalho e o corpo recebidos e compara o resultado com os 16 bytes iniciais; qualquer divergência indica corrupção, e o decodificador falha.Fronteiras por bloco
A carga útil comprimida de um bloco é um stream de um ou mais frames, não necessariamente um único frame. O remetente grava o bloco serializado por meio de umCompressedWriteBuffer, que emite um frame sempre que seu buffer interno fica cheio (≈1 MB, DBMS_DEFAULT_BUFFER_SIZE) e um frame final quando é feito o flush do bloco. Assim, um bloco pequeno corresponde a um único frame; um bloco grande, a vários frames consecutivos.
O invariante vale em apenas um sentido: como o remetente faz o flush do buffer comprimido ao final de cada bloco, o fim de cada bloco coincide com uma fronteira de frame, mas o inverso não é verdadeiro. Uma fronteira de frame intermediária, emitida quando o buffer ficou cheio no meio de um bloco, cai no meio desse bloco e não é uma fronteira de bloco. Portanto, um decodificador deve usar as próprias dimensões do bloco (num_columns/num_rows) para determinar onde ele termina; não deve presumir que cada frame seja um bloco completo.
Um receptor processa os frames em stream: lê 16 + 9 bytes, lê exatamente compressed_size - 9 bytes do corpo, descomprime para exatamente uncompressed_size bytes e repassa esses bytes ao decodificador de blocos; quando o decodificador precisa de mais dados do que o frame atual contém, lê o próximo frame. Como o remetente faz o flush a cada bloco, depois que um bloco é totalmente decodificado, o buffer de frame fica vazio e o próximo bloco começa em um novo frame.
No protocolo TCP nativo, o envelope do pacote (o VarUInt do tipo de pacote e a string table_name) é gravado no stream raw, fora da carga útil comprimida; apenas o corpo do bloco (BlockInfo + colunas) é encapsulado em frames. O caminho HTTP compress/decompress não tem esse envelope: o stream inteiro é composto de blocos encapsulados em frames.
Negociação
No protocolo TCP nativo, a compressão é definida por consulta, e não por conexão. O campocompression: bool do pacote Query a solicita apenas para aquela consulta. O servidor atende à requisição e emite corpos Data/Totals/Extremes/Log/ProfileEvents comprimidos durante todo o ciclo de vida da consulta (Log/ProfileEvents somente a partir da v54481). Ele também espera que os blocos Data enviados pelo cliente — tabelas externas, o marcador vazio de fim de dados e as linhas de INSERT — usem o mesmo enquadramento. Consultas subsequentes na mesma conexão podem se comportar de forma diferente.
No HTTP não existe pacote Query: o parâmetro de consulta compress=1 seleciona a saída enquadrada para aquela requisição, e decompress=1 indica que o corpo da requisição está enquadrado. A saída de compress=1 é gravada com o codec padrão do servidor (ZSTD(3)), e não com network_compression_method; o leitor de decompress=1 obtém o codec a partir do byte de método de cada frame, portanto qualquer codec é aceito na entrada.
Com a compressão ativada, o servidor também pode encaminhar colunas pelo caminho de serialização paralela de blocos /
ColumnBLOB (PARALLEL_BLOCK_MARSHALLING, v54478) para blocos com mais de uma linha. Uma implementação que comprime dados de INSERT precisa estar preparada para lidar com esse caminho (ou desativá-lo explicitamente), para evitar a dessincronização do stream.Glossário
Bloco — a unidade de troca de dados no formato Native. Um bloco autodescritivo de linhas armazenadas em formato colunar. Consulte estrutura de bloco e coluna. BlockInfo — o cabeçalho de metadados que precede um bloco no caminho de pacotes Data via TCP (gravado sempre que a revisão da conexão for maior que zero). É uma sequência de campos condicionados à revisão e identificados por ID de campo. É omitido pelo formato de saídaNative, que serializa na revisão 0. Consulte BlockInfo.
Corpo da coluna — os bytes de uma coluna que contêm os valores propriamente ditos, após o cabeçalho da coluna (nome, tipo, byte has_custom_serialization). O layout é específico de cada tipo. Consulte layout de coluna no wire.
Tipo composto — um tipo construído a partir de um ou mais tipos internos, codificado como múltiplos streams por coluna. O formato no wire é estável e não versionado. Consulte tipos compostos.
Dicionário (LowCardinality) — o array de valores únicos que uma coluna LowCardinality(T) referencia por meio de índices inteiros. Consulte LowCardinality.
Bloco vazio — um bloco com num_columns = 0 e num_rows = 0. É usado como sentinela: um marcador de fim de entrada no lado do cliente e um marcador de limite de stream no lado do servidor. Consulte variantes de bloco.
Bloco de cabeçalho — um bloco com num_columns > 0 e num_rows = 0, enviado pelo servidor como o primeiro pacote Data da resposta a uma consulta. Anuncia o schema do resultado. Consulte variantes de bloco.
Tipo interno — o tipo encapsulado por um tipo composto. O tipo interno de Array(UInt32) é UInt32; o de Nullable(T) é T.
Stream de offsets — o array UInt64 de posições finais cumulativas que Array, Map e Nested usam para delimitar os elementos de cada linha. Consulte Array.
Valor de preenchimento — os bytes gravados nas posições nulas do stream de valores de uma coluna Nullable(T). O decodificador os lê para avançar no stream, mas ignora seu conteúdo. Consulte Nullable.
Bloco de resultado — um bloco com num_rows > 0 que transporta linhas reais do resultado da consulta. Consulte variantes de bloco.
Bloco de esquema — sinônimo de bloco de cabeçalho, usado ao descrever a fase de INSERT, na qual o bloco de esquema informa ao cliente a estrutura de colunas esperada.
Versão de serialização — um número de versão no wire, definido por tipo, que os tipos versionados usam para declarar qual variante da codificação vem a seguir. Não deve ser confundida com a versão do protocolo. Consulte versão de serialização: conceito.
Prefixo de estado — os bytes que precedem a carga útil de cada bloco em um tipo versionado. Contém a versão de serialização e (no caso de LowCardinality) os metadados do dicionário de cada bloco. É emitido no início de cada bloco com rows > 0 e não é mantido entre blocos.
Stream — uma sequência contígua de bytes dentro do corpo de uma coluna, que codifica um subcomponente lógico (um null-map, um array de offsets, um stream de valores). Tipos com múltiplos streams concatenam dois ou mais streams por coluna.