

이 가이드에서 다룰 내용은 다음과 같습니다:
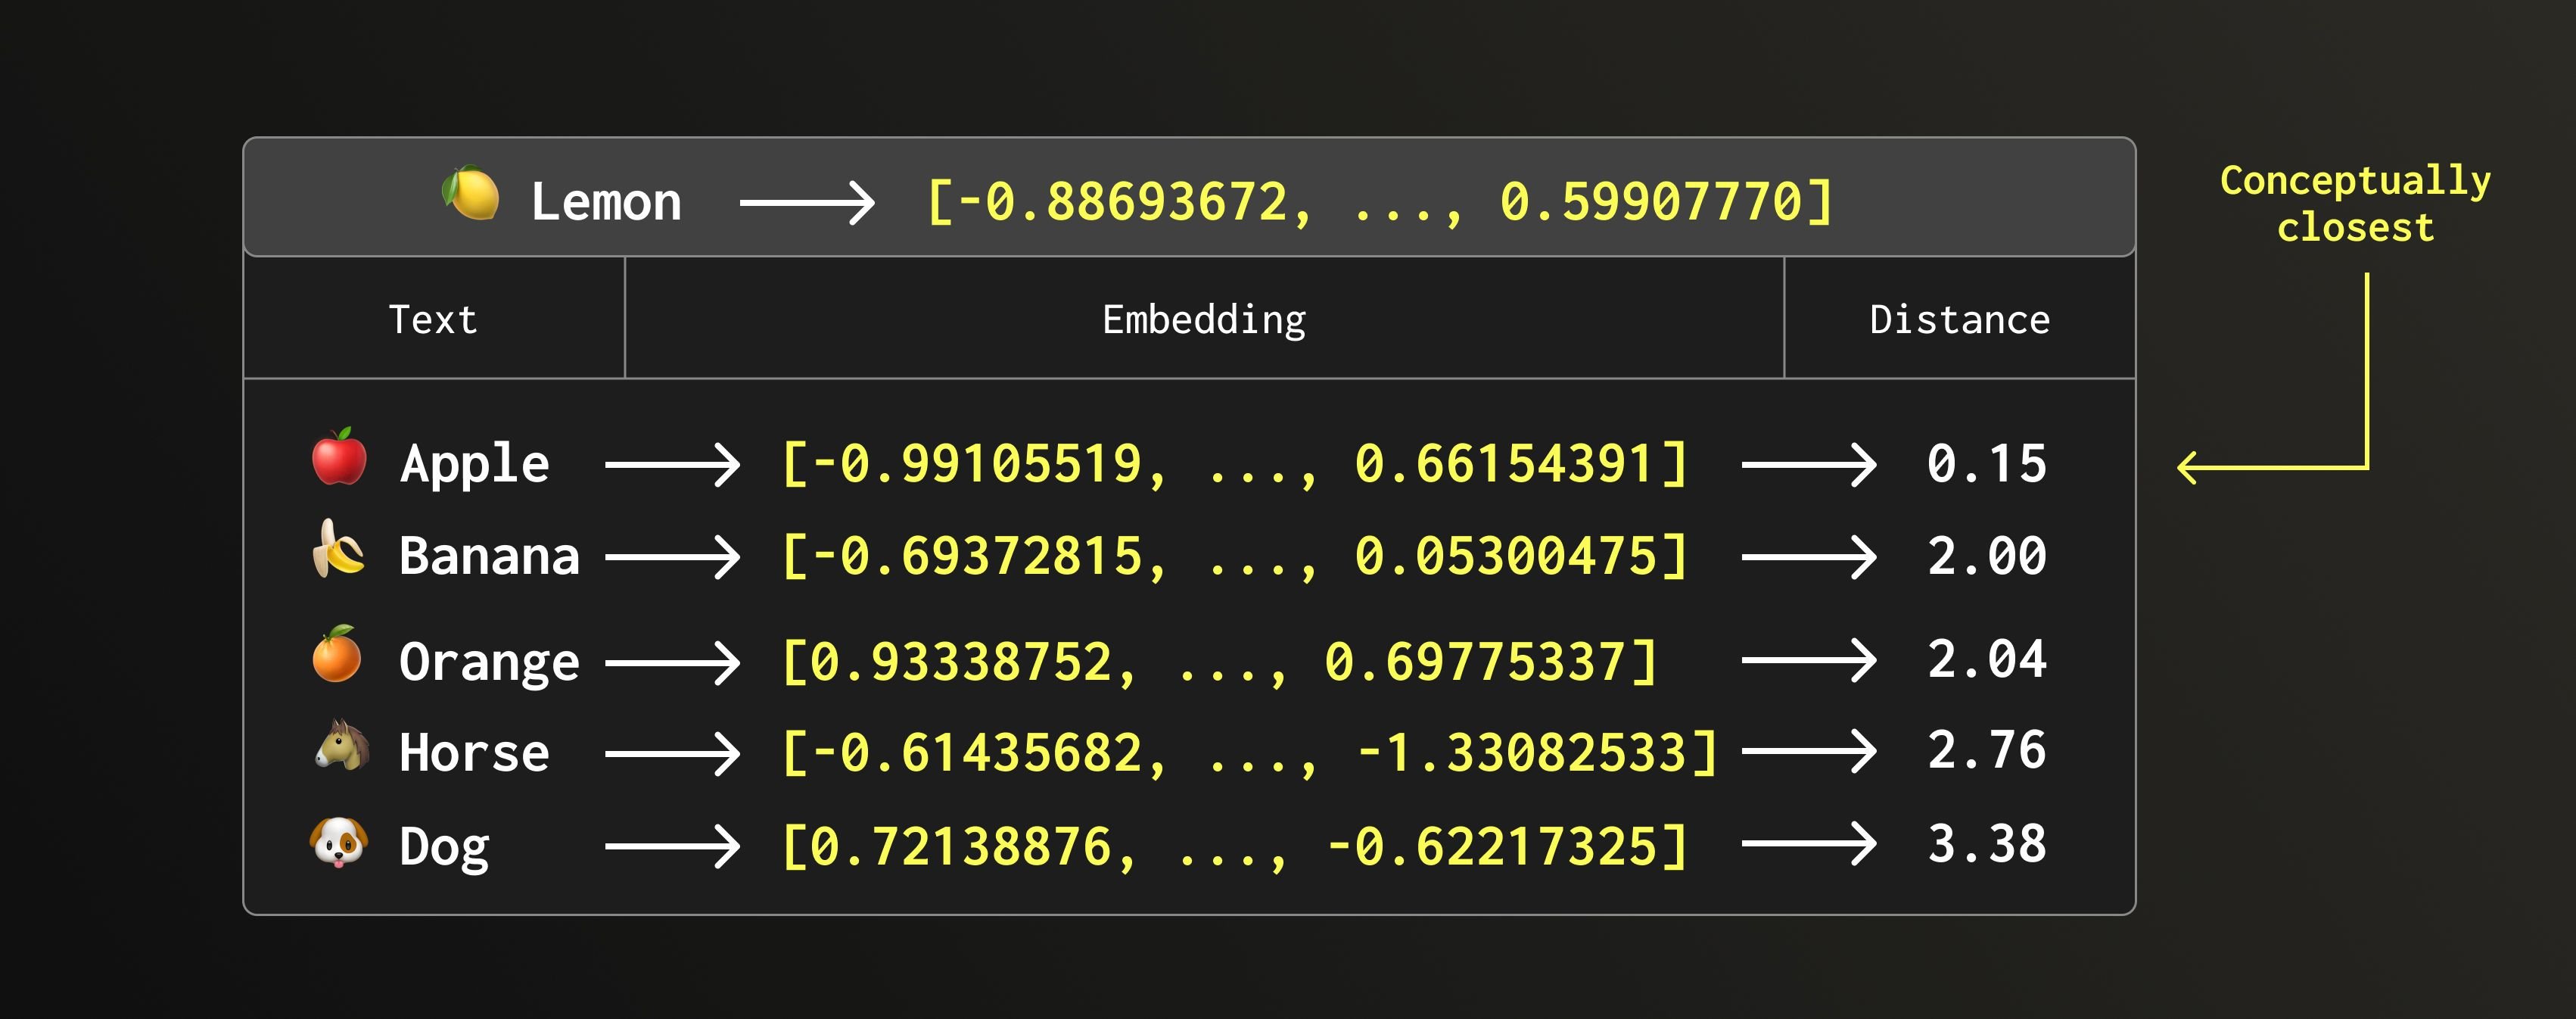
- 벡터 검색을 간략히 소개합니다
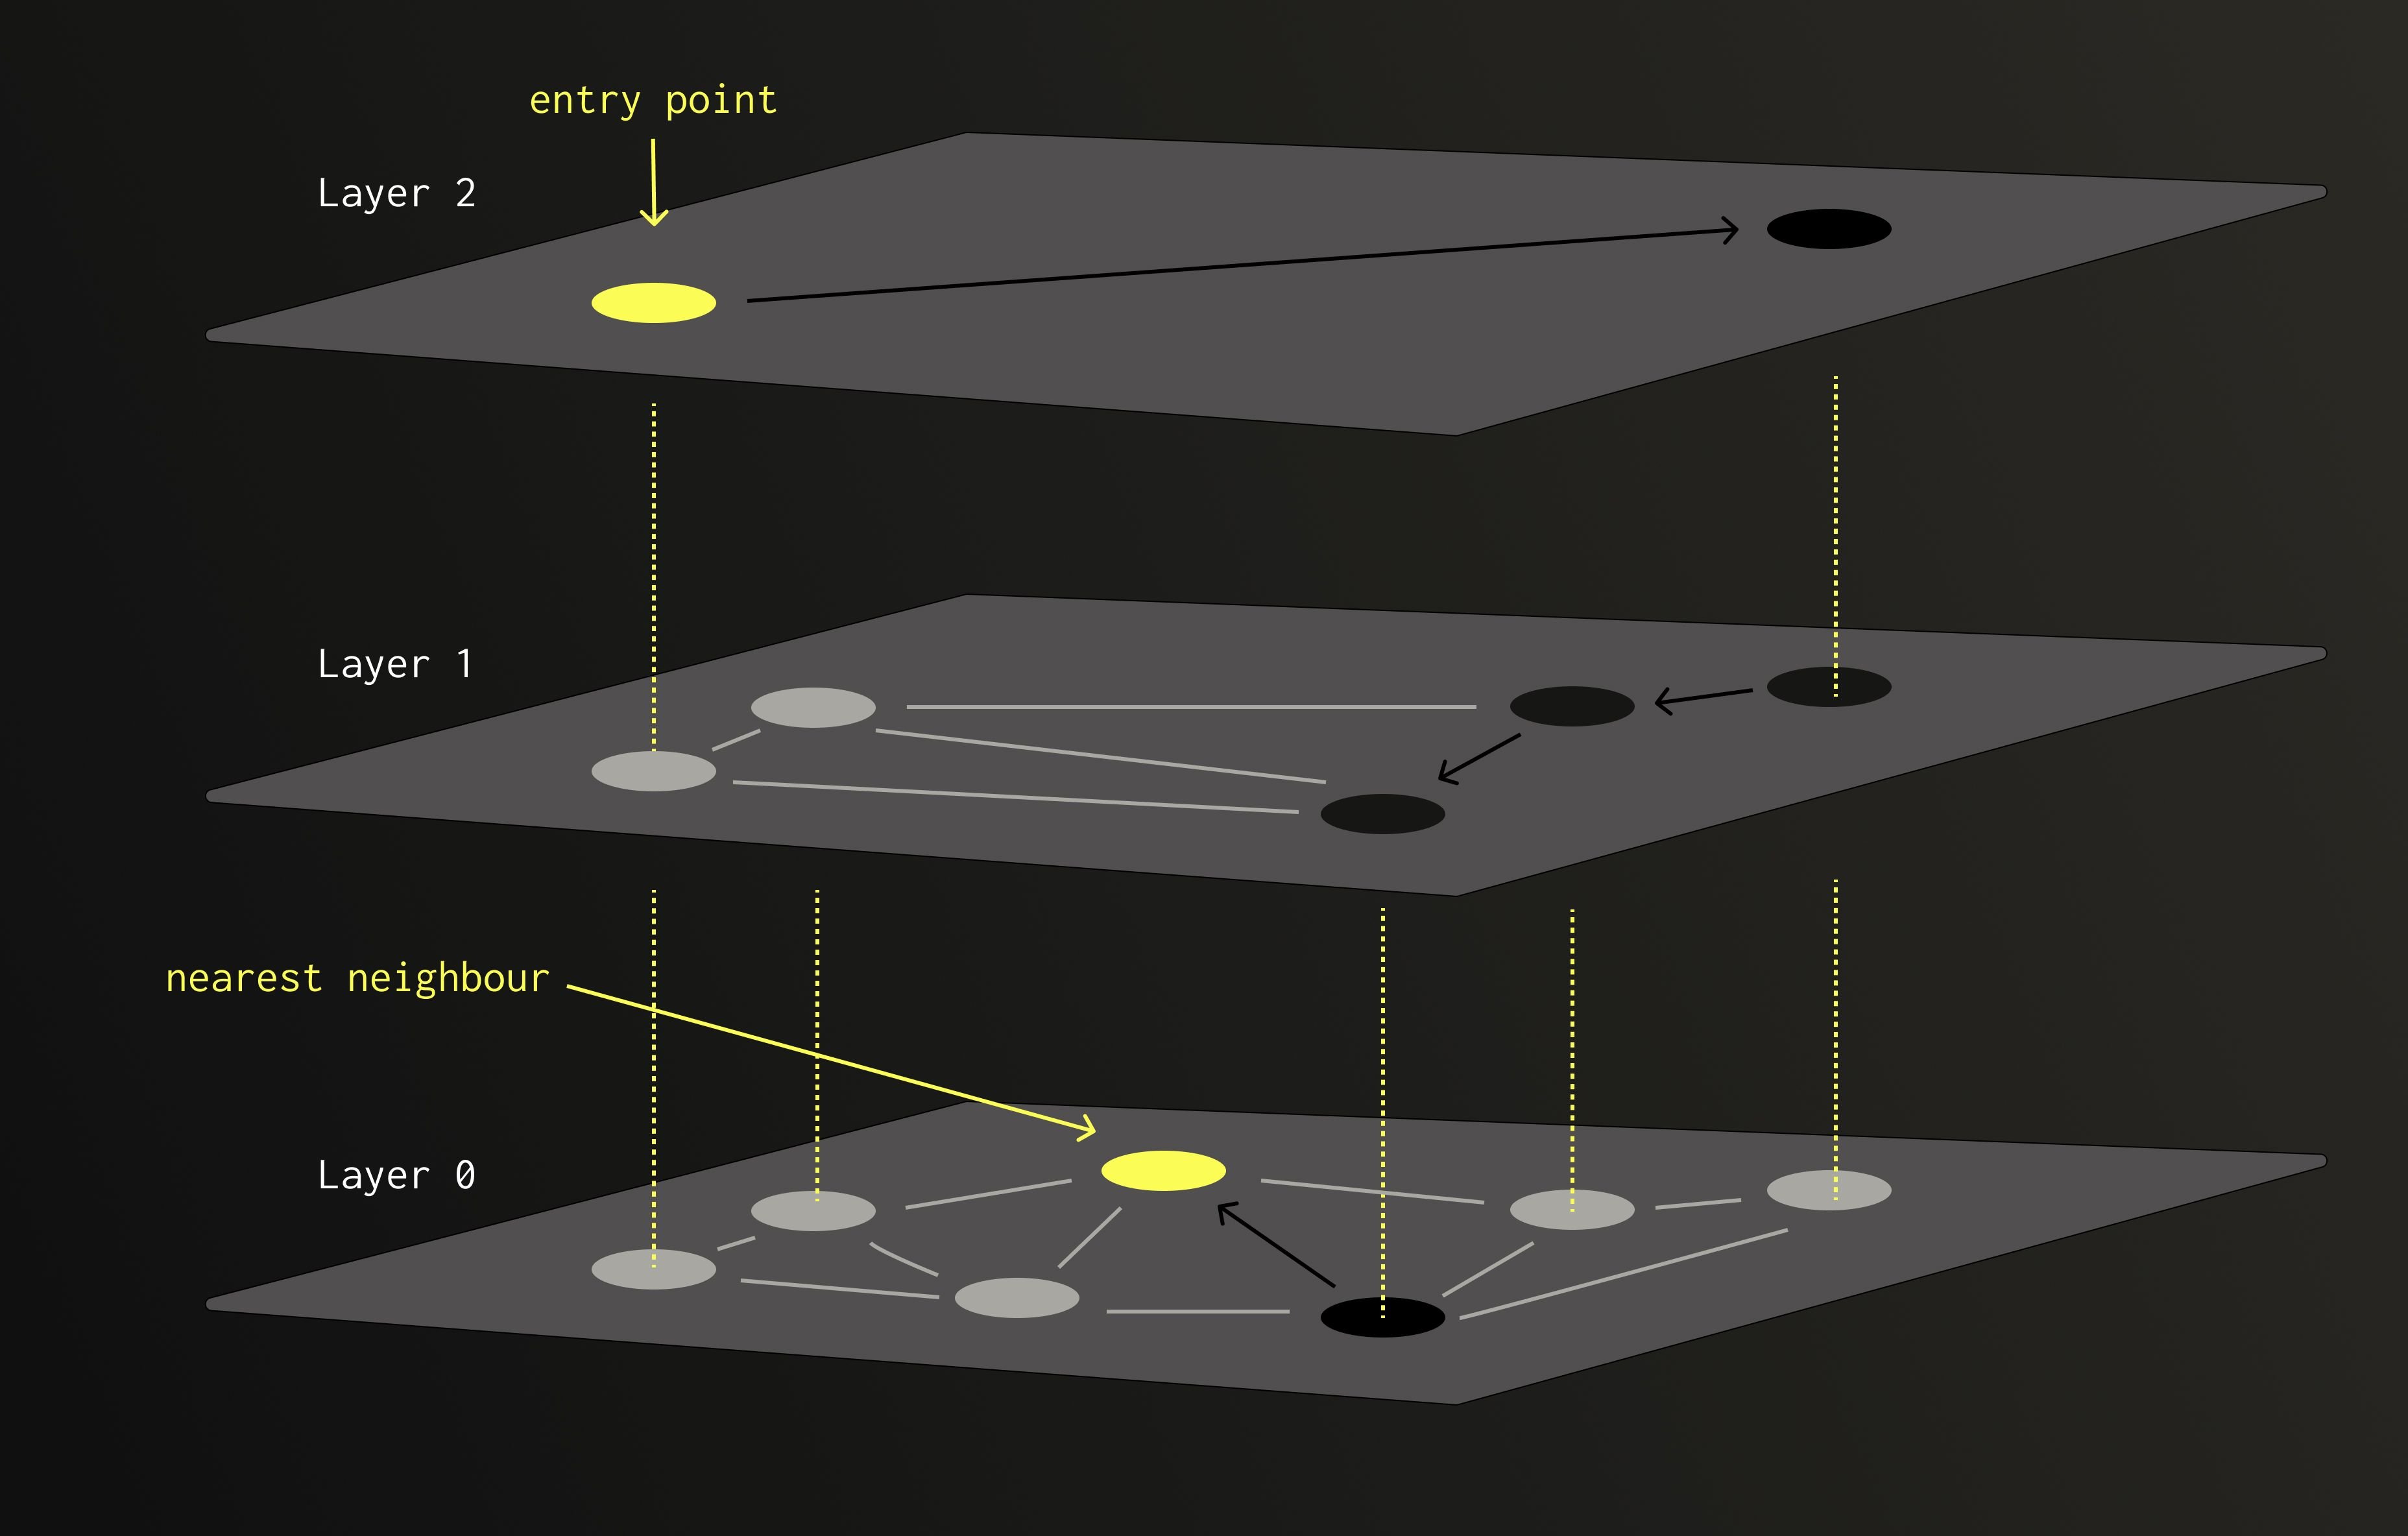
- 근사 최근접 이웃(ANN)과 Hierarchical Navigable Small World(HNSW)에 대해 알아봅니다
- Quantised Bit(QBit)에 대해 알아봅니다
- QBit를 사용해 DBPedia 데이터셋으로 벡터 검색을 수행합니다
- 양자화된 복사본을 원본 컬럼과 함께 유지합니다 - 저장 공간은 두 배로 늘어나지만, 언제든 전체 정밀도로 되돌릴 수 있으므로 안전합니다
- 원래 값을 완전히 대체합니다 (삽입 시 다운캐스팅) - 공간과 I/O를 절약할 수 있지만, 되돌릴 수 없는 선택입니다
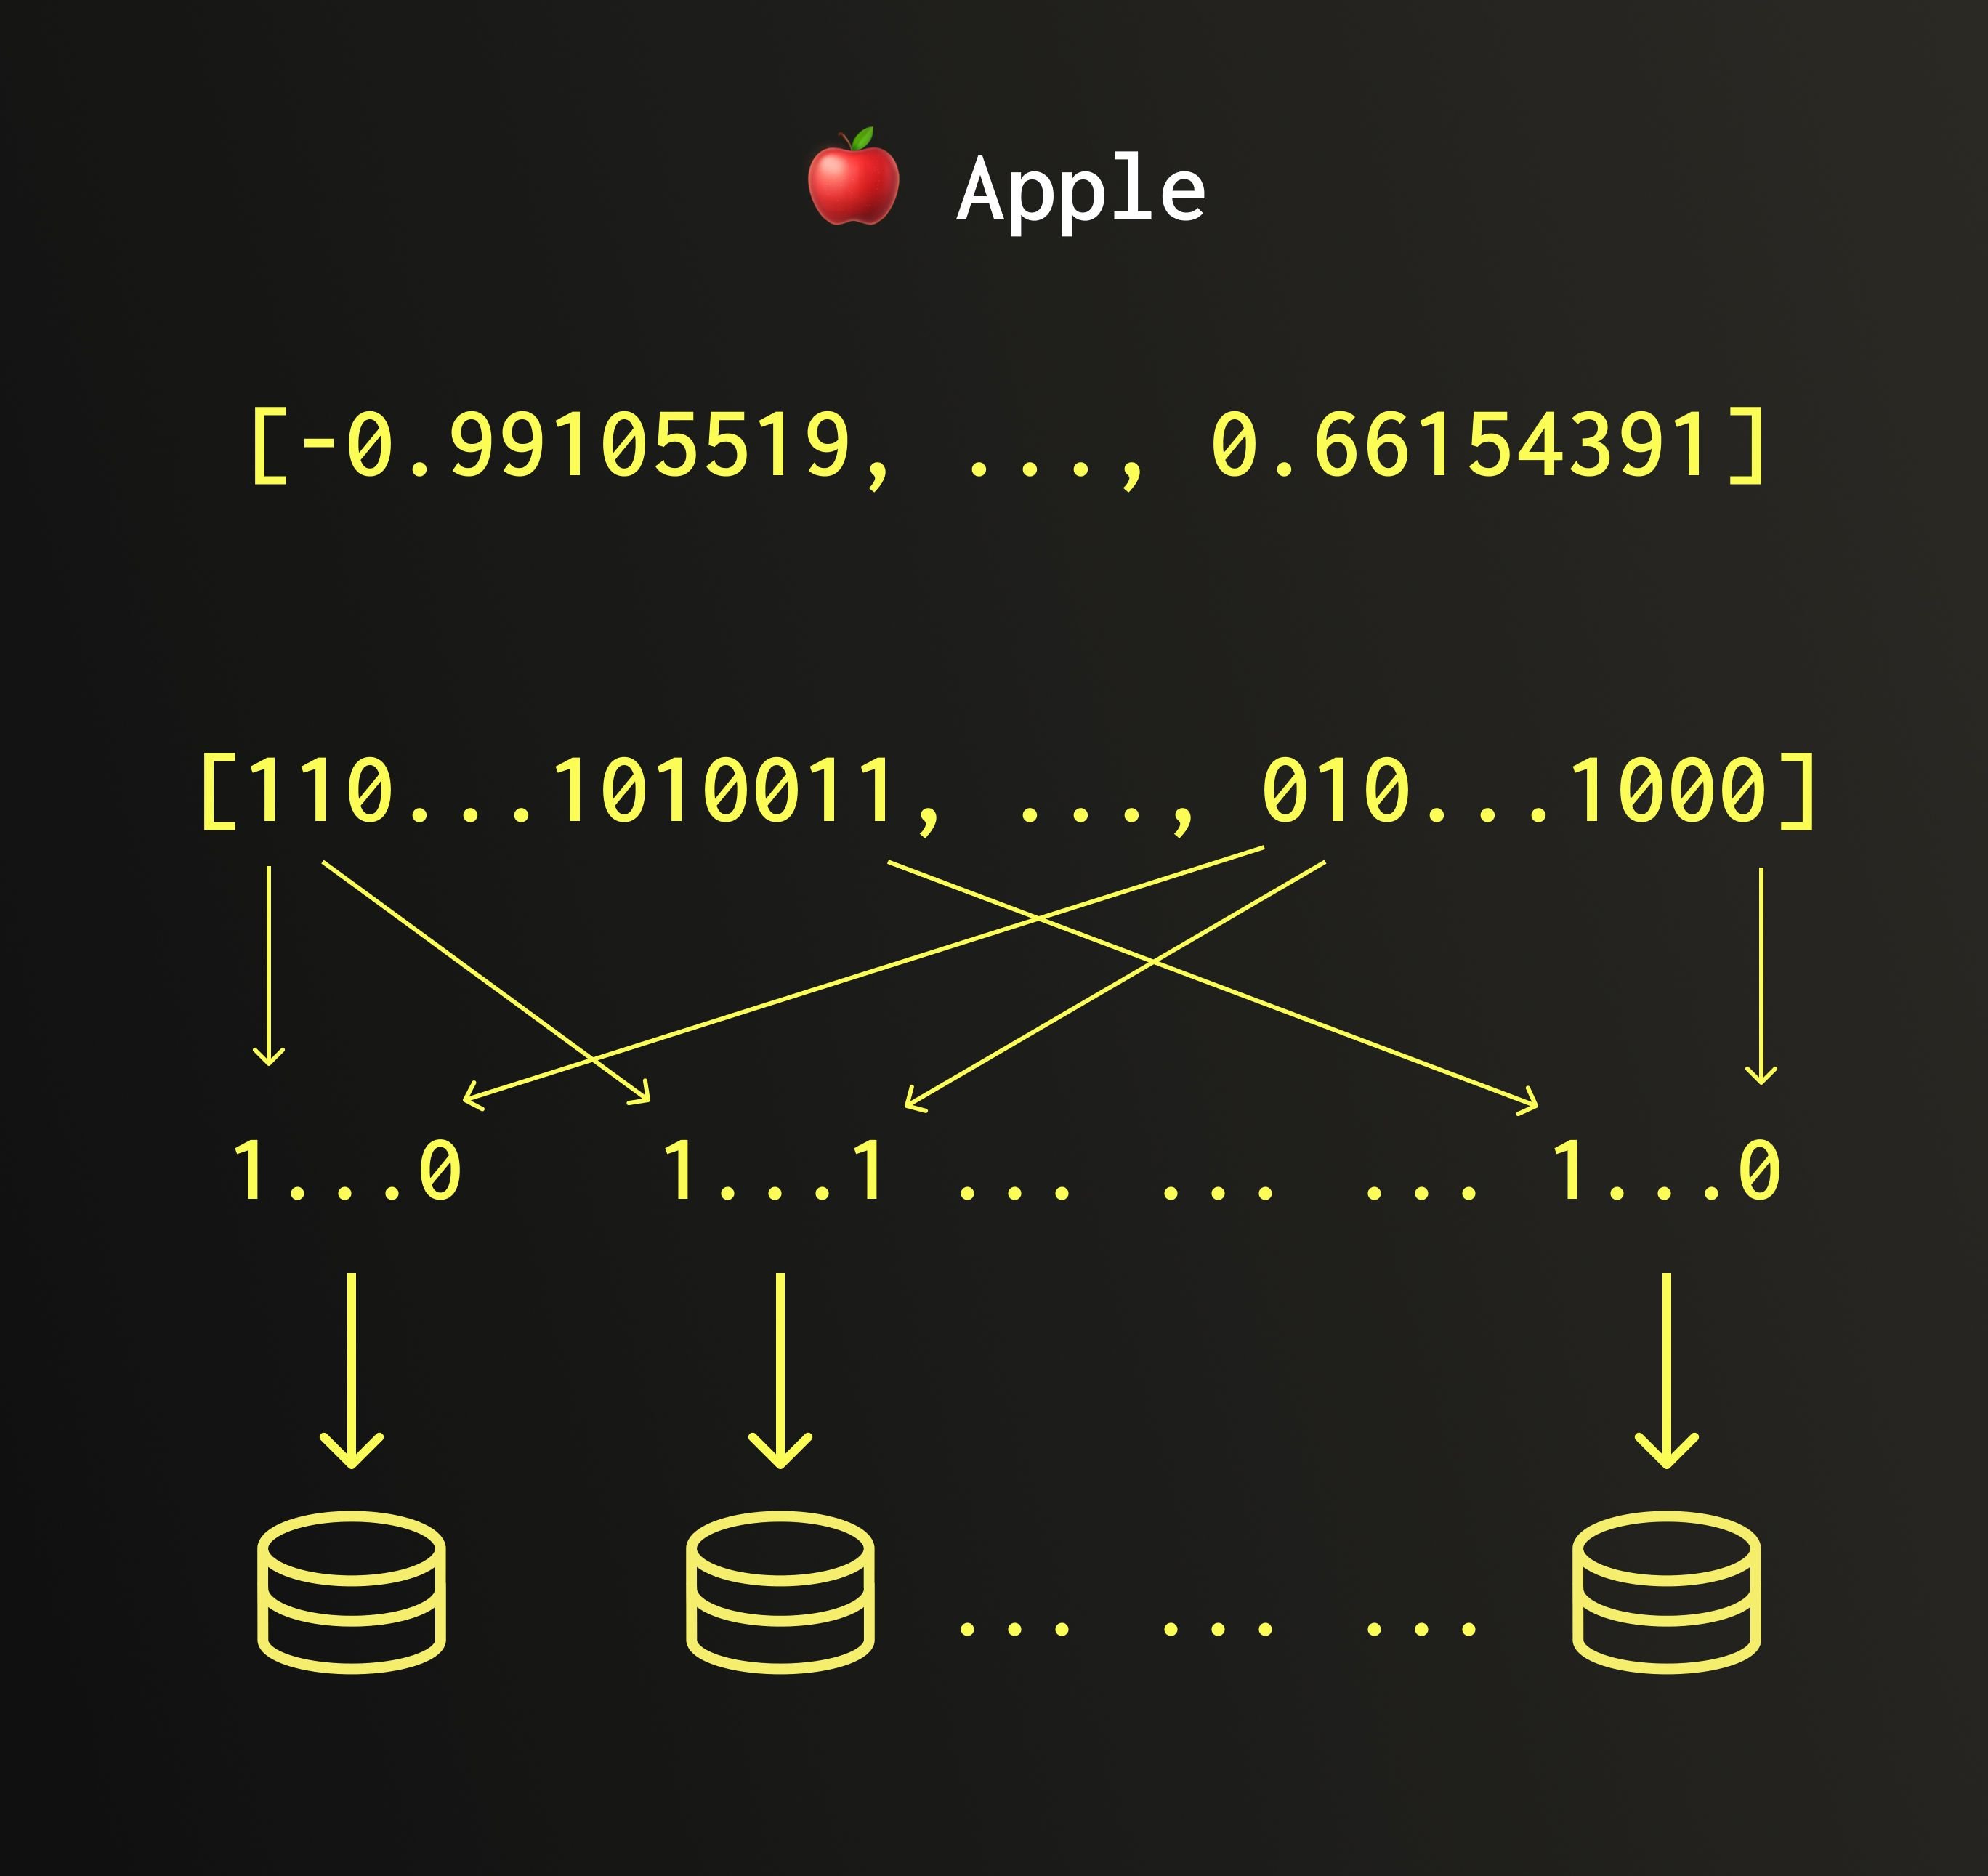
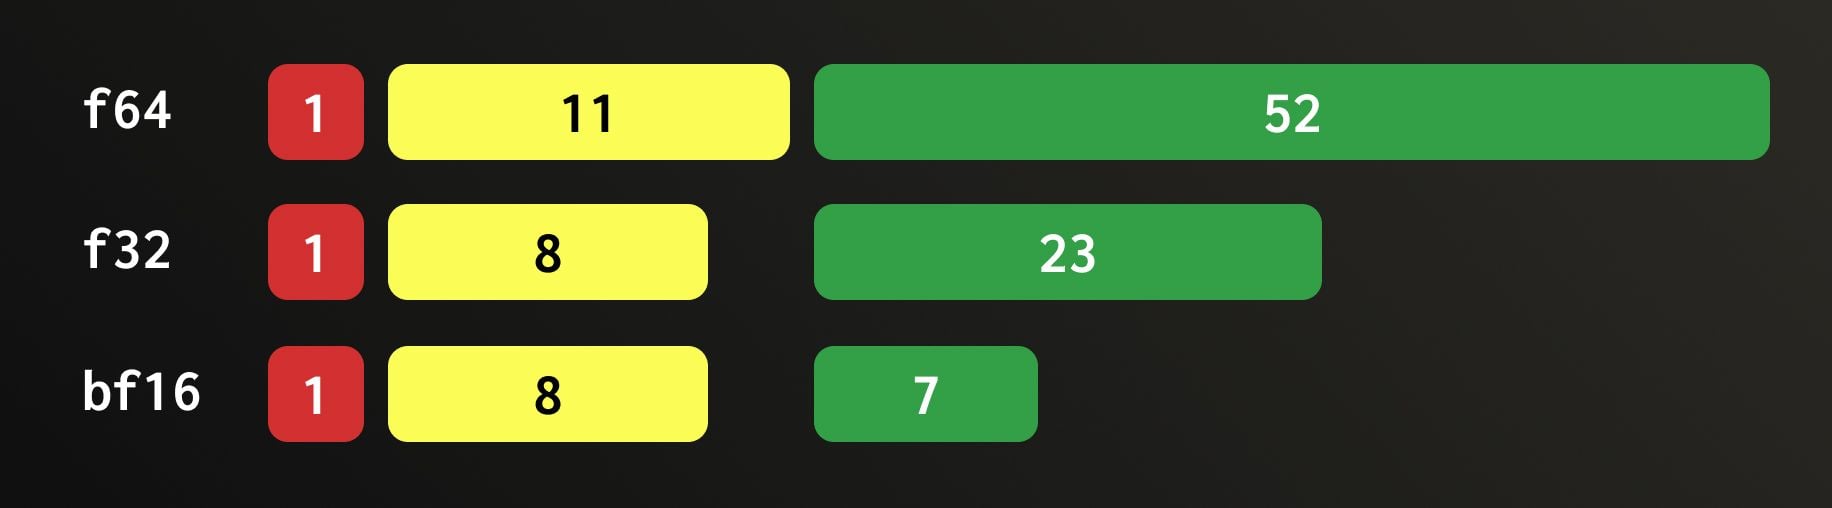
QBit는 부동소수점 수가 비트로 표현되는 방식을 활용해
BFloat16, Float32, Float64 값을 저장할 수 있는 새로운 데이터 구조입니다.
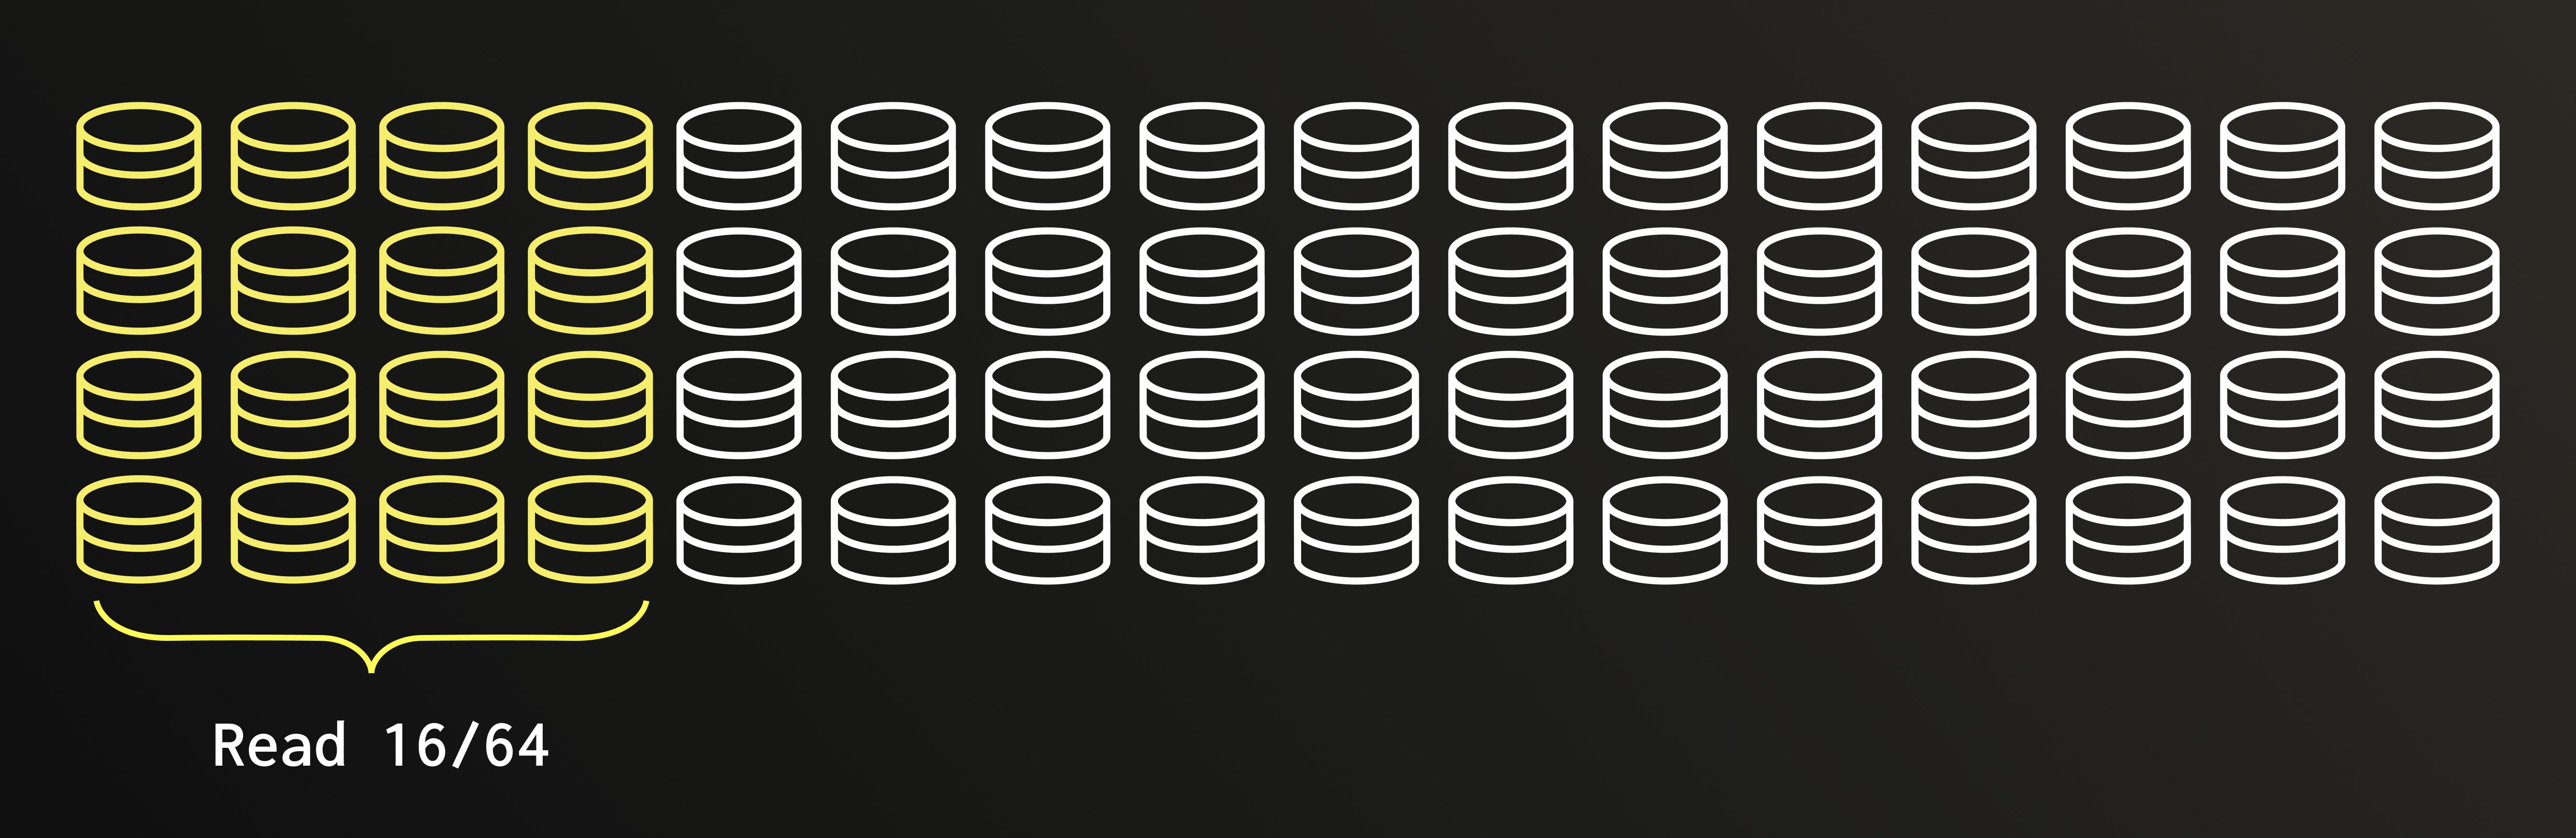
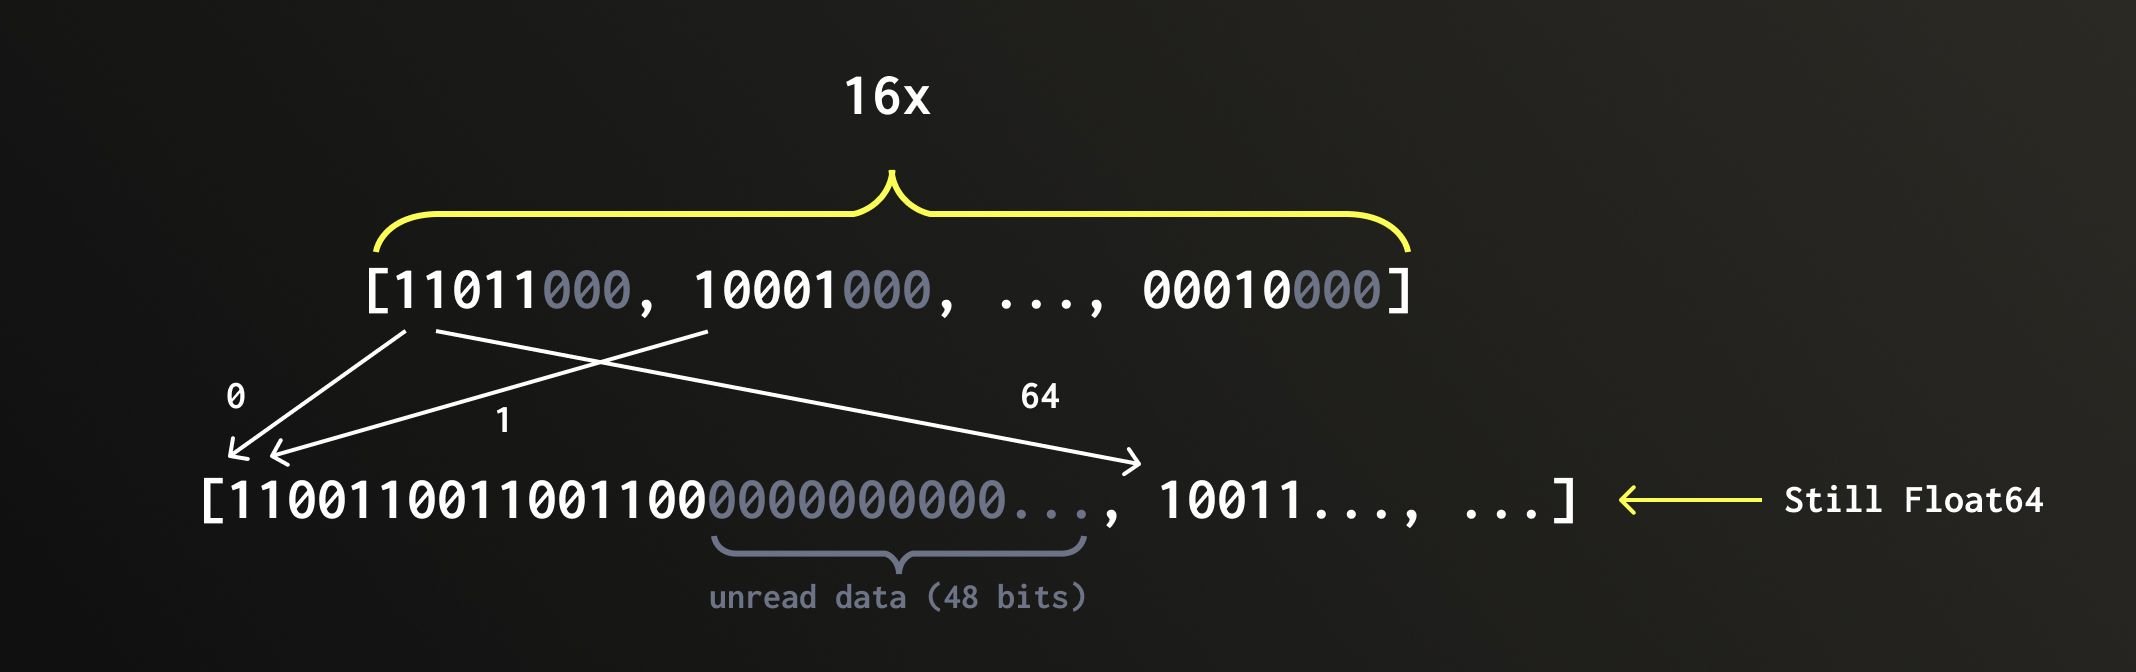
각 숫자를 통째로 저장하는 대신, QBit는 값을 비트 평면으로 나눕니다. 즉, 각 값의 첫 번째 비트들, 두 번째 비트들, 세 번째 비트들처럼 분리합니다.
한계QBit는 벡터 검색 속도를 높여 주지만, 계산 복잡도는 여전히 O(n)입니다. 다시 말해, 데이터셋이 충분히 작아 HNSW 인덱스가 RAM에 무리 없이 올라간다면, 여전히 그 방식이 가장 빠른 선택입니다.
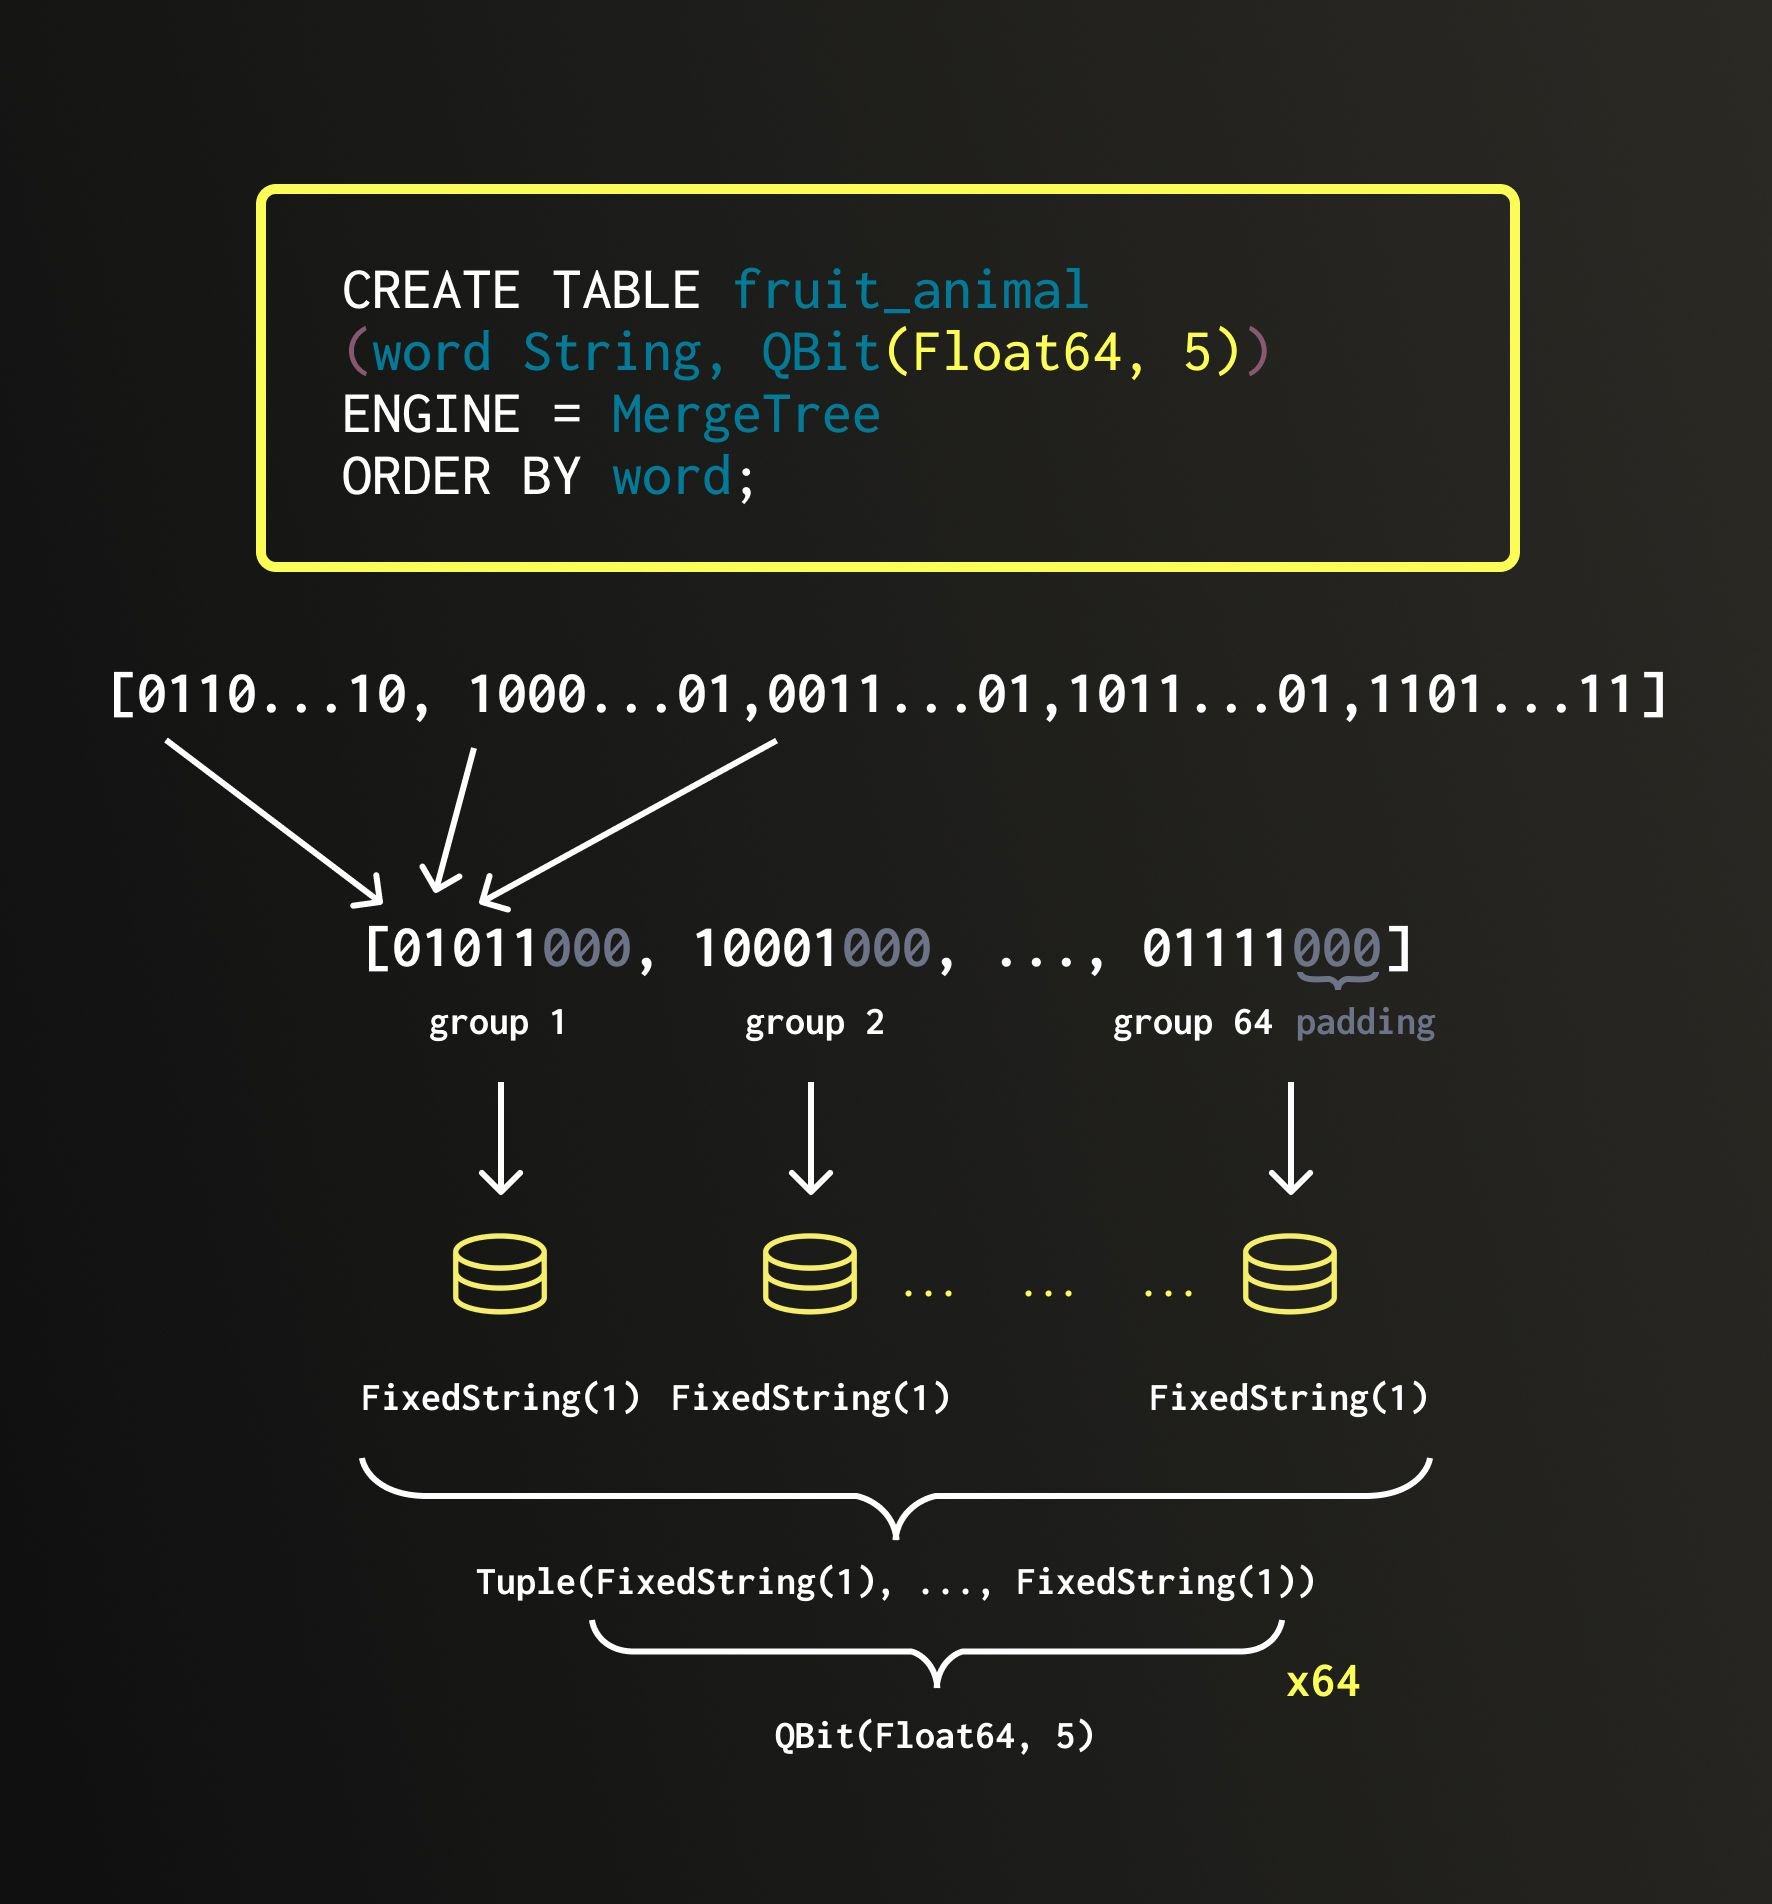
FixedString(N) 컬럼에 저장됩니다. 즉, 길이가 N바이트로 고정된 문자열이 메모리에 구분자 없이 연속해서 저장됩니다. 이후 이 모든 그룹이 하나의 Tuple로 묶이며, 이것이 QBit의 기본 구조를 이룹니다.
예시: 8×Float64 요소로 이루어진 벡터에서 시작하면 각 그룹에는 8비트가 들어갑니다. Float64는 64비트이므로 최종적으로 64개의 그룹(비트마다 하나씩)이 생깁니다. 따라서 QBit(Float64, 8)의 내부 레이아웃은 64×FixedString(1) 컬럼으로 구성된 Tuple과 같습니다.
QBit을 사용해 쿼리하려면 precision 매개변수와 함께 L2DistanceTransposed 함수를 사용하십시오:
브루트포스 검색과의 성능 비교
브루트포스 검색과의 성능 비교
Raufs Dunamalijevs의 블로그 게시물을 바탕으로 작성되었으며, 2025년 10월 28일 게시