

- 네이티브 TCP 프로토콜의
Data,Totals,Extremes,Log,ProfileEvents패킷 본문(TableColumns패킷은 Native 블록이 아닙니다. 이 패킷은 2개의 바이너리 문자열을 전달하므로 그 레이아웃은 native protocol 명세에서 다룹니다) - HTTP를 통해 실행한
SELECT ... FORMAT Native의 출력 INTO OUTFILE ... FORMAT Native로 내보낸 파일- 서버 간 복제 payload
개요
wire 상에서 행을 전달하는 모든 것은 블록입니다. 블록은 행을 컬럼 단위로 저장하는 자기 기술적(self-describing) 청크입니다. 컬럼 1의 모든 값이 먼저 오고, 이어서 컬럼 2의 모든 값이 오는 식입니다. 블록에는 쿼리가 참조하는 컬럼만 포함되며, 테이블 전체가 담기는 경우는 없습니다. 컬럼의data는 해당 타입이 속한 *계열(family)*에 따라 배치됩니다. 디코더 복잡도가 낮은 것부터 순서대로 나열하면 다음과 같습니다.
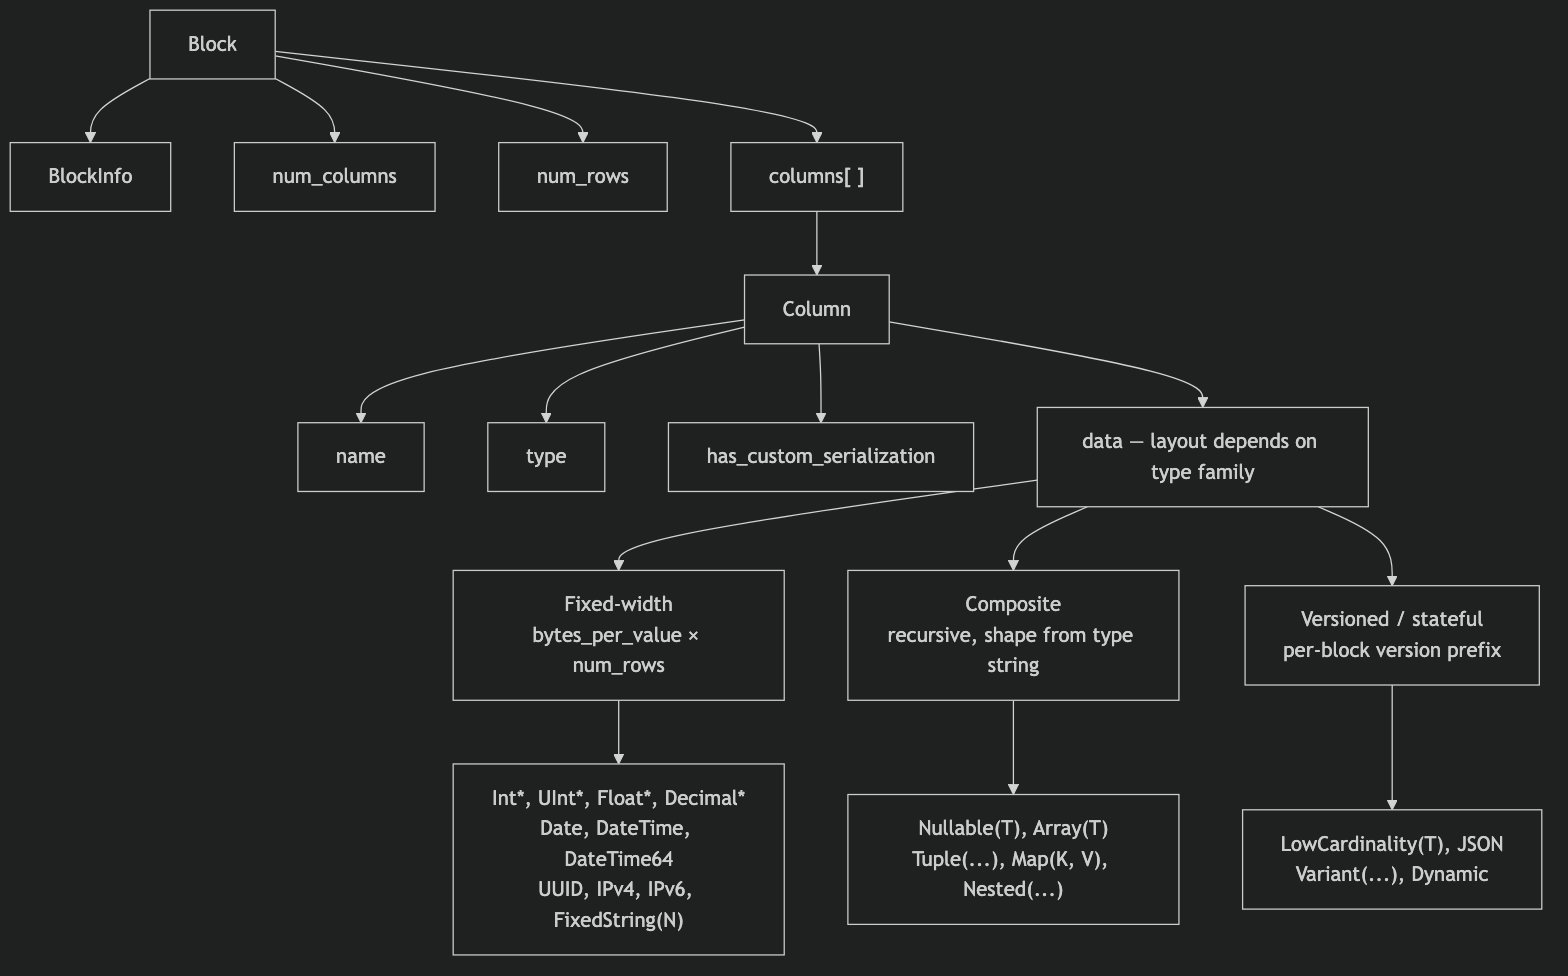
- 고정 폭(Fixed-width) 타입은
data를bytes_per_value × num_rows크기의 원시 바이트(raw bytes)로 배치하며, 행 단위 프레이밍이 없습니다. - 복합(Composite) 타입(
Nullable,Array,Tuple,Map,Nested)은 타입 문자열만으로 완전히 도출할 수 있는 재귀적 구조를 가지며, 버전 접두사나 블록 간 상태가 없습니다. - 버전 지정 / 상태 유지형(Versioned / stateful) 타입(
LowCardinality,JSON,Variant,Dynamic)은 비어 있지 않은 모든 블록의 시작 부분에 직렬화 버전/상태 접두사가 있습니다.Nativewire에서는 이 접두사와 딕셔너리가 모두 블록 단위로 존재하며, 블록 간에 전달되는 상태는 없습니다(writer는 블록마다 새로운 직렬화 상태를 생성하고low_cardinality_max_dictionary_size = 0으로 설정합니다). 블록 간 상태는 MergeTree의 디스크 저장 방식에 해당하는 개념으로, Native wire 레이아웃과는 무관합니다.
Wire 기본 타입
Native 형식은 4가지 기본 인코딩을 바탕으로 구성됩니다.VarUInt
LEB-128 인코딩을 사용하는 가변 길이 부호 없는 정수입니다. 각 바이트는 0–6번 위치에 7개의 데이터 비트를, 7번 위치에 1개의 연속 비트(continuation bit)를 담습니다. 연속 비트는 뒤에 바이트가 더 이어지면1, 마지막 바이트에서는 0입니다.
값
300을 인코딩하는 예시는 다음과 같습니다.
0xAC 0x02를 디코딩하는 과정은 다음과 같습니다:
고정 폭 정수
예를 들어 UInt32 값
1은 01 00 00 00으로, Int32 값 -1은 FF FF FF FF로 인코딩됩니다.
String
길이 접두사가 붙은 바이트 시퀀스입니다.0x00 바이트 하나로 인코딩되며, 문자열에는 중간에 포함된 NUL을 비롯해 임의의 바이트 값이 들어갈 수 있습니다. 예를 들어 문자열 "ab"는 02 61 62로 인코딩됩니다. 디코딩할 때는 먼저 VarUInt 길이(2)를 읽은 다음, 그 길이만큼 바이트를 읽으십시오.
Bool
1바이트로 표현됩니다.0x00은 false이며, 0이 아닌 모든 값은 true입니다(정규 값은 0x01).
블록 및 컬럼 구조
블록 wire 레이아웃
BlockInfo 접두사의 존재 여부는 채널에 따라 달라집니다. writer가 revision을 매개변수로 받기 때문입니다(client_protocol_version이 출력에만 적용된다는 점을 포함한 자세한 설명은 Protocol revision and the Native format을 참조하십시오):
-
네이티브 TCP 프로토콜에서 서버는 연결 시 협상된 revision(큰 값 —
DBMS_TCP_PROTOCOL_VERSION,src/Core/ProtocolDefines.h참조)으로 블록을 작성합니다.BlockInfo는 이 revision이 0보다 크면 항상 작성되며, 실제 연결에서는 언제나 이 조건을 만족합니다. 각 컬럼의has_custom_serialization바이트(컬럼 wire 레이아웃 참조)는 revision54454이상에서 작성됩니다. -
Native출력 형식 — HTTP를 통한SELECT ... FORMAT Native,INTO OUTFILE ... FORMAT Native, 그리고clickhouse-client가 생성하는Native형식 — 은 기본적으로 revision0으로 직렬화됩니다. revision0에서는BlockInfo접두사와has_custom_serialization바이트가 모두 생략되므로, 블록은num_columns,num_rows, 그리고 컬럼으로만 구성됩니다. HTTP에서는 이 revision이 고정되어 있지 않습니다. 클라이언트는?client_protocol_version=<n>쿼리 매개변수로 revision을 높일 수 있으며, 서버는 이 값을 응답의 직렬화 revision으로 사용합니다. 값이 충분히 높으면 HTTP 출력에도 TCP 경로와 똑같이BlockInfo접두사(revision이0보다 크면 작성됨)와has_custom_serialization바이트(revision54454이상에서 작성됨)가 포함됩니다. 따라서 클라이언트는 모든 HTTPFORMAT Nativepayload가 revision0이라고 가정해서는 안 됩니다.
BlockInfo 접두사로 시작하는 바이트 예시는 TCP 데이터 패킷의 payload를 나타냅니다. 같은 쿼리를 FORMAT Native로 실행하면 함께 제시된 더 짧은 형태가 생성됩니다.
BlockInfo
BlockInfo는 필드의 시퀀스로, 각 필드 앞에는 VarUInt 필드 ID가 붙고 필드 ID0으로 끝납니다. wire 형식은 자기 기술적(self-describing)이지 않습니다. 즉, 필드 ID에는 해당 값의 길이나 유형이 인코딩되지 않으므로, 리더는 마주칠 수 있는 모든 필드 ID의 유형을 미리 알고 있어야 합니다. ClickHouse 자체 리더는 인식할 수 없는 필드 ID를 데이터 손상으로 간주하고 예외(UNKNOWN_BLOCK_INFO_FIELD)를 발생시킵니다. 상위 호환성은 그 대신 프로토콜 revision으로 처리됩니다. 송신 측은 협상된 revision이 해당 필드의 최소 revision 이상인 경우에만 필드를 기록하므로, 이전 버전의 수신 측이 알지 못하는 필드를 받는 일은 없습니다.
필드
1과 2는 최소 revision이 0이므로, BlockInfo가 기록되는 경우에는 항상 포함됩니다. 필드 3은 revision 54480 이상에서만 기록됩니다. 일반적인 경우(revision 54480 미만)의 wire 레이아웃은 다음과 같습니다.
컬럼 wire 레이아웃
컬럼은 하나의 블록 안에num_columns번 나타납니다.
디코더는
type 문자열에 따라 처리를 분기합니다. 타입 문자열에는 괄호 안에 매개변수가 포함되는 경우가 많습니다. 디코더는 (...) 접미사를 제거해 기본 타입을 확인한 다음, 매개변수를 파싱하여 크기, 스케일 또는 내부 타입을 결정합니다. 중첩 타입(예: Array 안의 Tuple)이 포함된 매개변수 목록을 파싱하려면 ,로 단순히 분할하는 대신 괄호 중첩 깊이를 추적하는 쉼표 분할기가 필요합니다.
바이너리 타입 인코딩
type 필드가 텍스트 String인 것은 기본 모드에서뿐입니다. 쿼리 설정 output_format_native_encode_types_in_binary_format = 1을 지정하면 이 필드는 바이너리 타입 인코딩이 됩니다. 이는 데이터 타입 바이너리 인코딩에 설명된 것과 동일한 태그 기반 인코딩이며, 평탄화된 Dynamic 타입 목록의 타입별 이름에도 같은 바이너리 인코딩이 사용됩니다. 필드 2를 항상 길이 접두사가 붙은 문자열로 읽는 디코더는 첫 번째 바이너리 타입 태그를 문자열 길이로 잘못 해석해 동기화가 어긋나게 됩니다. 따라서 디코더는 스트림이 어떤 모드를 사용하는지 반드시 알고 있어야 합니다.query_kind = SECONDARY_QUERY인 쿼리(remote, Distributed 또는 병렬 레플리카를 위해 다른 서버가 보내거나 clickhouse-client --query_kind secondary_query로 보낸 쿼리)에서는 양쪽 모두 해당 쿼리의 블록에 대해 output_format_native_encode_types_in_binary_format과 input_format_native_decode_types_in_binary_format을 무시하므로, 양방향 모두 텍스트 타입 이름이 전달됩니다. 이 규칙이 도입되기 전 버전의 서버는 보조 쿼리에도 다른 쿼리와 마찬가지로 이 설정들을 적용합니다.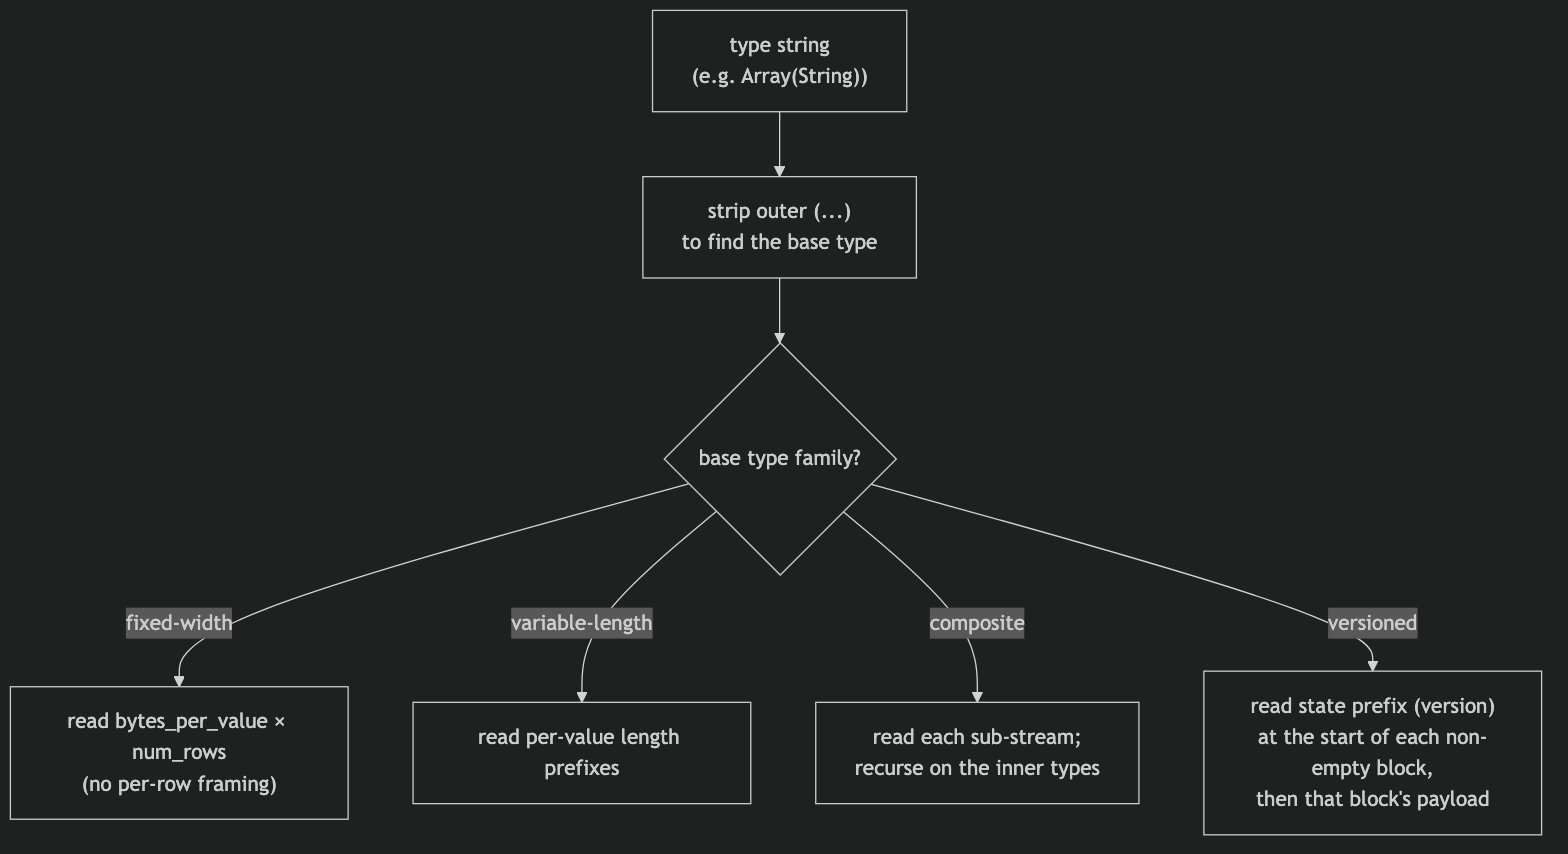
kind_stack과 희소 인코딩
kind_stack 바이트는 기본값이 아닌 컬럼별 직렬화의 종류를 나타냅니다:
COMBINATION payload는 다른 enum을 사용합니다. 위의 다섯 행은 압축된(compact) 1바이트 코드입니다. COMBINATION(0x05)은 이 코드들로 표현할 수 없는 모든 스택을 위한 범용 이스케이프로, 뒤에 VarUInt count가 오고 이어서 count개의 1바이트 엔트리가 옵니다. 이 엔트리는 표의 압축 코드가 아니라 원시 ISerialization::Kind 값입니다:
바이트 값은 압축 코드와 다릅니다.
REPLICATED는 이 중첩 enum에서는 0x03이지만 압축 코드로는 0x04이며, DETACHED_OVER_SPARSE 엔트리는 없습니다. 이 조합은 SPARSE, DETACHED라는 두 개의 연속된 엔트리로 표현됩니다. 중첩 바이트에도 압축 코드 표를 그대로 적용하는 디코더는 0x03/0x04를 잘못 매핑하여 동기화가 어긋납니다.
count는 모든 스택의 맨 앞에 오는 DEFAULT 엔트리를 포함한 전체 스택 길이입니다. 엔트리가 1개 또는 2개인 스택은 모두 압축 코드로 표현되므로, COMBINATION의 count는 항상 3 이상입니다.
Kind 스택 유효성. 디코더는 잘못된 스택을 받으면 그 스택이 기술하는 직렬화를 구성하지 않고 INCORRECT_DATA로 거부합니다:
- 스택은
DEFAULT로 시작해야 합니다. - 스택은
DEFAULT,SPARSE,REPLICATED,DETACHED의 부분 시퀀스(subsequence)여야 합니다. 이 순서는 kind들이 서로를 감싸는 순서입니다.SPARSE는REPLICATED안에 들어갈 수 있지만 그 반대는 불가능하며,ColumnBLOB은 그 아래에 있는 모든 것의 직렬화된 형태를 담으므로DETACHED는 항상 마지막에 옵니다. 따라서 같은 kind가 두 번 나타날 수 없으며,count는 kind의 개수를 넘을 수 없습니다.
ColumnSparse는 감싸진 상태 그대로 남습니다.
Tuple 컬럼의 재귀적 kind_stack. 위의 kind_stack payload는 한 컬럼 자체의 직렬화 정보를 나타내는 바이트(또는 COMBINATION 시퀀스)입니다. Tuple은 SerializationInfoTuple을 가지며, 이는 먼저 튜플 자체의 kind-stack payload를 쓴 다음 각 원소의 전체 kind-stack payload를 순서대로 씁니다. 디코더도 같은 재귀 구조로 읽어 들입니다. 따라서 Tuple(A, B, C)의 필드 4 바이트는 [tuple_kind][A_kind][B_kind][C_kind]이며, 원소가 다시 복합 타입이면 해당 원소의 payload도 재귀적으로 구성됩니다. has_custom_serialization 바이트(필드 3)는 튜플 자체의 정보 또는 원소 중 하나의 정보라도 기본값이 아니면 설정되므로, 희소이거나 복제된 원소 하나만 특수한 Tuple도 kind-stack payload를 포함하게 됩니다. Tuple에 대해 맨 앞의 enum 바이트 하나만 읽는 디코더는 너무 일찍 읽기를 멈추고, 나머지 원소 kind 바이트를 컬럼 데이터로 잘못 해석합니다.
희소 wire 형식. kind_stack = 0x01이면 컬럼 data는 하나의 공유 TCP 스트림에 연달아 기록되는 두 개의 스트림으로 구성됩니다:
- 오프셋 스트림(Offset stream) —
VarUInt의 시퀀스입니다. 각 값v는 다음 중 하나입니다.- 62번 위치의 상위 비트가 0인
v:(v & 0x3FFFFFFFFFFFFFFF)= 다음 명시적 non-default 값 앞에 오는 기본값 위치의 개수입니다. 해당 non-default 위치는cursor + group_size이며, 여기서cursor는 현재 진행 중인 위치입니다. 이후cursor는group_size + 1만큼 증가합니다. - 62번 비트가 설정된
v(END_OF_GRANULE_FLAG): 플래그를 해제한 값 = 마지막 non-default 값 뒤에 오는 후행 기본값 위치의 개수입니다. 이 값은 해당 블록의 오프셋 스트림이 끝났음을 나타냅니다.
- 62번 위치의 상위 비트가 0인
- values 스트림 — 내부 타입으로 조밀하게 인코딩된
count개의 non-default 값입니다. 여기서count는 위에서 읽은 VarUInt 중 EOG가 아닌 값의 개수입니다.
0, String은 "", Date는 0일 등)으로 채워 num_rows개 엔트리로 구성된 조밀한 컬럼을 재구성합니다.
희소 Nullable(T) 컬럼은 Nullable(T)의 기본값이 NULL이므로 특수한 경우에 해당합니다. 희소 인코딩에서는 일반적인 Nullable null-map 스트림을 완전히 생략합니다. 오프셋 스트림은 non-default 위치, 즉 non-NULL 위치를 식별하고, values 스트림은 해당 non-NULL 값만 T로 조밀하게 담으며, 명시되지 않은 모든 위치는 NULL로 재구성됩니다. 따라서 디코더는 values 스트림에서 null map을 찾아서는 안 되며, 빈 위치를 실제 값 0으로 채워서도 안 됩니다. 빈 위치는 NULL로 채워야 합니다.
Replicated wire 형식. kind_stack = 0x04이면 컬럼 data는 딕셔너리입니다. 즉, 서로 다른 원소 값의 목록과 그 목록을 가리키는 행별 인덱스로 구성됩니다(LowCardinality와 동일한 조회 구조). 내부 타입 자체가 버전 관리되는 타입이면(예: LowCardinality(T)) 해당 타입의 상태 접두사가 인덱스 스트림보다 먼저 기록됩니다. 복제된 직렬화는 num_rows를 기록하기 전에 prefix 단계를 내부 타입에 위임하기 때문입니다. 접두사가 비어 있는 내부 타입(리프 타입과 일반 복합 타입)은 여기에 아무 바이트도 기록하지 않습니다.
i에 대해 elements[indexes[i]]를 선택하여 밀집(dense) 컬럼을 재구성합니다. 복합 내부 타입은 재귀적으로 처리됩니다. 즉, 원소 목록을 먼저 내부 타입으로 구체화한 다음 인덱싱합니다. 지원되는 내부 타입에는 리프 타입, Nullable(T), Array(T), Tuple(...), Map(K, V), Nested(...)(각 필드는 Array처럼 확장됨), LowCardinality(T)(공유 딕셔너리는 유지되고 원소별 키만 인덱싱됨)가 있습니다.
분리된 wire 형식. DETACHED(0x02)와 DETACHED_OVER_SPARSE(0x03)는 내부에서만 쓰이는 것이 아니라 실제로 네트워크 전송 데이터에도 나타납니다. TCP 경로에서 압축이 활성화되어 있고 협상된 revision이 DBMS_MIN_REVISON_WITH_PARALLEL_BLOCK_MARSHALLING(v54478) 이상이면, 컬럼은 다음 세 단계를 거칩니다.
- 대상 컬럼(
const나Tuple이 아니면서 행이 2개 이상인 블록에 속한 컬럼)은 각각ColumnBLOB으로 래핑됩니다. 이ColumnBLOB에는 메인 스레드 외부에서 미리 마셜링 및 압축된 컬럼이 담깁니다. - 래핑된 컬럼의 kind stack에
DETACHED가 추가됩니다. - 컬럼
data는VarUInt형식의 blob 크기와, 그 뒤에 이어지는 정확히 해당 크기만큼의 blob 바이트로 기록됩니다.
{DEFAULT, SPARSE, DETACHED}가 되며, 이는 DETACHED_OVER_SPARSE로 직렬화됩니다. 이러한 컬럼을 디코딩하는 클라이언트는 blob 길이와 바이트를 읽은 다음, blob의 압축을 해제하여 내부 컬럼 payload를 복원합니다(압축 섹션의 ColumnBLOB 참고 사항 참조).
DETACHED에는 방향성이 있습니다. 서버가 보내는 결과 블록에서만, 그리고 최상위 컬럼 전체에 대해서만 나타날 수 있으며, Tuple의 원소 kind 중 하나로는 결코 나타나지 않습니다. 다른 kind와 달리 DETACHED는 런타임 컬럼을 선언된 유형의 컬럼이 아닌 ColumnBLOB로 만듭니다. 따라서 수신 측은 자체 파이프라인에서 blob을 다시 변환하는 경우에만 이를 허용합니다. 이러한 이유로 서버는 클라이언트가 보내는 모든 블록(외부 테이블 데이터, 스칼라, 삽입 데이터 등)에 DETACHED가 포함되어 있으면 INCORRECT_DATA 오류로 거부합니다.
블록 변형
모든 Data 계열 패킷은 동일한 블록 wire 형식을 사용합니다. 각 변형은 컬럼 수와 행 수만 다릅니다.바이트 수준 예시
이 섹션의 모든 예시는 TCP 데이터 패킷 경로를 기준으로 하므로BlockInfo 접두사와 has_custom_serialization 바이트가 포함되어 있습니다. FORMAT Native를 사용하면 같은 블록이 더 짧아지며, 필요한 경우 이에 해당하는 짧은 형태도 함께 제시합니다.
빈 블록(BlockInfo 포함), 총 8바이트:
SELECT 1의 헤더 블록은 이름이 "1"이고 UInt8 타입인 컬럼 1개를 행 0개와 함께 알립니다. 프로토콜 버전이 54454 이상이면 has_custom_serialization 바이트가 포함됩니다.
FORMAT Native(revision 0)를 사용하면 동일한 결과 블록에 BlockInfo도, has_custom_serialization 바이트도 포함되지 않습니다. 따라서 SELECT 1 FORMAT Native의 크기는 11바이트입니다.
FORMAT Native로 출력할 때 바이트를 전혀 생성하지 않습니다. 이 출력 형식은 빈 블록을 내보내지 않기 때문입니다.)
프로토콜 revision과 Native 형식
Native 바이트 스트림의 구조를 가장 크게 좌우하는 것은 해당 스트림의 writer와 리더가 사용하는 프로토콜 revision입니다. revision은 바이트 자체 어디에도 들어 있지 않습니다. 즉, wire 상에는 revision 필드가 없습니다. 그럼에도 revision에 따라 일부 기능이 스트림에 나타나는지 여부 자체가 결정됩니다. 따라서 디코더는 payload를 파싱하기 전에 해당 payload가 어떤 revision으로 작성되었는지 알고 있어야 합니다. revision이 스트림에 포함되지 않으므로, 리더와 writer는 별도의 방법으로 revision을 맞춰야 합니다. revision은 하나의UInt64 값이며, NativeWriter와 NativeReader 모두 이 값을 생성자 인수로 받습니다. writer에서는 client_revision, 리더에서는 server_revision이라고 부르지만 둘은 같은 숫자입니다. 이 릴리스가 인식하는 최신 revision은 DBMS_TCP_PROTOCOL_VERSION입니다(src/Core/ProtocolDefines.h 참조).
revision이 제어하는 기능
각 기능은DBMS_MIN_REVISION_WITH_* 임계값에 의해 제어됩니다. writer는 revision이 임계값에 도달한 경우에만 해당 기능을 내보내고, 리더도 정확히 같은 규칙에 따라 해당 기능을 찾으므로 양쪽이 동기화된 상태를 유지합니다. 어느 한쪽에서라도 revision을 잘못 지정하면 동기화가 깨집니다. Native 형식과 관련된 게이트는 다음과 같습니다.
따라서 revision
0은 거의 모든 항목에서 가장 보수적인 인코딩입니다. 스트림에는 BlockInfo도, has_custom_serialization 바이트도 없으며, V1 Dynamic/JSON이 사용되고, 집계 함수 버전도 없고, 시간대 매개변수가 제거된 순수한 DateTime만 포함됩니다. 다만 revision 0에서 집계 함수 state 버전은 예외입니다. 버전을 도출할 기준이 되는 피어가 없기 때문입니다. 이 스트림은 이를 생성한 쪽(StripeLog 데이터 파일, Set/Join 백업, Native 포맷 파일)이 직접 쓰고 다시 읽습니다. 그래서 writer는 state를 버전 0으로 낮추지 않고 유형에 고정된 버전을 그대로 유지하며(평소처럼 유형 문자열에 명시함), 고정된 버전이 없는 유형만 버전 0으로 기록됩니다.
LowCardinality는 유일한 예외이자 중요한 예외입니다. writer의 검사 조건은 remove_low_cardinality || (client_revision && client_revision < DBMS_MIN_REVISION_WITH_LOW_CARDINALITY_TYPE)입니다. 핵심은 앞부분의 client_revision &&입니다. revision이 정확히 0이면 전체 조건이 단락 평가(short-circuit)되어 false가 됩니다.
따라서 FORMAT Native의 기본값인 revision 0에서는 LowCardinality(T)가 제거되지 않습니다. 유형 문자열과 블록별 상태 접두사가 스트림에 그대로 남고, revision 0 리더가 이를 그대로 다시 읽어 들입니다. 제거는 revision이 0이 아니면서 54405 미만인 경우, 또는 revision과 관계없이 강제된 경우에만 이루어집니다.
이 강제 제거를 담당하는 것이 remove_low_cardinality 플래그입니다. FORMAT Native 출력은 이 플래그를 설정하지 않지만, 네이티브 TCP 경로는 low_cardinality_allow_in_native_format = 0(기본값 1)일 때 이 플래그를 설정합니다. 즉, 이 설정은 네이티브 TCP 출력에는 영향을 주지만 FORMAT Native에는 아무런 영향도 주지 않습니다.
실무적으로 정리하면, 기본 FORMAT Native 스트림에는 LowCardinality가 정상적으로 포함될 수 있으므로 이를 revision 0에서 지원되지 않는 기능으로 간주해서는 안 됩니다.
데이터 전송 방식에 따른 revision 결정 방식
동일한 Native 바이트는 네이티브 TCP 프로토콜, HTTP 요청, 디스크의 파일 등 여러 경로를 통해 전달될 수 있습니다. revision을 설정하는 방식은 경로마다 다릅니다. 한 가지 주의할 점은 읽기 측과 쓰기 측이 각각 따로 설정되므로 양쪽의 revision이 서로 달라질 수 있다는 것입니다.네이티브 TCP 프로토콜 — 협상 방식, 양방향
네이티브 TCP 프로토콜에서는 revision이 Hello 핸드셰이크를 통해 결정됩니다. 클라이언트가DBMS_TCP_PROTOCOL_VERSION을 보내면 서버는 자신의 값을 회신하며, 이후 양측은 각각 상대측이 알려 준 revision에 맞춰 직렬화합니다. 즉, 서버는 client_tcp_protocol_version을 기준으로 NativeReader/NativeWriter를 구성하고, 클라이언트는 수신한 server_revision을 사용합니다. 명시적인 min 연산은 없지만 어느 쪽도 구현하지 않은 기능을 내보낼 수는 없으므로, 각 방향의 상한은 사실상 두 피어 중 더 오래된 쪽이 결정합니다.
두 피어가 동일한 최신 빌드라면 두 방향 모두 같은 revision(DBMS_TCP_PROTOCOL_VERSION, src/Core/ProtocolDefines.h 참조)으로 맞춰지며 모든 게이트가 활성화됩니다. 대부분은 이렇게 동작하지만 항상 보장되지는 않습니다. 버전이 서로 다른 피어나 타사 피어가 섞여 있으면 두 방향의 revision이 달라질 수 있으므로, 게이트는 방향별로 따로 판단해야 합니다. BlockInfo는 revision이 0만 아니면 항상 포함되지만, has_custom_serialization을 비롯한 나머지 항목은 해당 방향의 유효 revision이 각각의 임계값에 도달해야만 나타납니다. 예를 들어 54454보다 낮은 revision을 알리는 피어는 has_custom_serialization 바이트를 보내지도 받지도 않습니다.
FORMAT Native 출력 — 기본값은 revision 0이며 HTTP에서는 높일 수 있음
Native 출력 포맷의 기본 revision은 **0**입니다. 이는 HTTP를 통한 SELECT ... FORMAT Native, INTO OUTFILE ... FORMAT Native, 그리고 clickhouse-client가 쓰는 Native 출력에 모두 해당합니다. 어느 경우든 출력 팩토리는 FormatSettings::client_protocol_version을 그대로 NativeWriter에 전달하며, 이 값이 BlockInfo / has_custom_serialization 프레이밍과 오프셋 기반 String 레이아웃을 함께 결정합니다. 따라서 client_protocol_version을 높인(≥ 54492) HTTP SELECT ... FORMAT Native는 오프셋 레이아웃으로 기록하고, 기본 revision 0에서는 이식성 있는 값별(per-value) 레이아웃이 그대로 유지됩니다.
다만 HTTP에서는 이 기본값이 고정되어 있지 않습니다. 클라이언트는 ?client_protocol_version=<n> 쿼리 매개변수로 이 값을 높일 수 있으며, HTTP 핸들러는 이를 SQL 설정이 아닌 예약된 매개변수로 취급합니다. 이 값은 쿼리 Context에 저장되고, 포맷 계층이 이를 FormatSettings로 복사합니다. 값을 충분히 높이면 HTTP FORMAT Native 출력에도 TCP 경로와 마찬가지로 BlockInfo 접두사와 has_custom_serialization 바이트가 포함됩니다. 따라서 HTTP FORMAT Native payload가 항상 revision 0이라고 가정해서는 안 됩니다.
이 매개변수는 쿼리 Context 전체에 적용되므로, 결과 스트림뿐 아니라 해당 요청에서 생성되는 모든 NativeWriter에 영향을 줍니다. 특히 ?client_protocol_version=을 높인 상태로 HTTP를 통해 INSERT INTO FUNCTION file('x.native', 'Native', ...) SELECT ...와 같은 서버 측 쓰기를 수행하면 파일도 해당 revision으로 기록됩니다. 이는 오래전부터 유지되어 온 동작으로(String 오프셋 직렬화가 도입되기 전부터 존재했으며 BlockInfo와 has_custom_serialization에도 적용됨), 비대칭적으로 동작합니다. 읽기 측(아래 참조)의 revision은 같은 방식으로 높아지지 않으므로, 이렇게 기록된 파일은 file(...)로 다시 읽을 수 없습니다. 나중에 다시 읽을 데이터를 쓰는 요청에는 client_protocol_version을 지정하지 마십시오. INTO OUTFILE과 로컬 clickhouse-client 출력에는 이러한 조정 수단이 없으므로 항상 0으로 유지됩니다.
FORMAT Native 입력 — 항상 revision 0
Native 입력 형식은 항상 revision **0**으로 NativeReader를 생성합니다. BlockInfo 접두사를 기대하지 않고, has_custom_serialization 바이트를 읽지 않으며, 항상 기본 직렬화(default serialization)를 가정합니다. 이는 INSERT ... FORMAT Native의 body를 파싱할 때, Native 파일을 읽을 때, 스키마를 추론할 때 모두 마찬가지입니다. ?client_protocol_version=<n>을 지정해도 입력 revision은 올라가지 않습니다(이 매개변수는 출력 측에서만 읽습니다).
입력 revision이 항상 0이므로 입력 형식은 항상 값별 String 레이아웃(per-value String layout)을 읽습니다. 따라서 오프셋 레이아웃(offsets layout)으로 기록된 스트림(네이티브 TCP 프로토콜을 통해 기록되었거나, client_protocol_version을 높여 실행한 SELECT ... FORMAT Native로 기록된 스트림)은 FORMAT Native 입력으로 다시 읽어 들일 수 없습니다. 이는 BlockInfo 프레이밍에서와 같은 비대칭성입니다.
왕복(round-trip) 시 고려 사항
FORMAT Native에서는 양쪽 모두 기본 revision이 0입니다. revision 0에서 SELECT ... FORMAT Native로 기록한 데이터는 INSERT ... FORMAT Native로 문제없이 그대로 다시 읽어 들일 수 있습니다.
출력 revision을 높여(SELECT에 ?client_protocol_version=<n> 지정) 생성한 스트림에는 BlockInfo 및 has_custom_serialization 프레이밍과 오프셋 String 레이아웃이 포함됩니다. 그러나 항상 revision 0으로 동작하는 입력 형식은 이 중 어느 것도 다시 읽지 못합니다. 따라서 client_protocol_version을 높이는 것은 네이티브 TCP 프로토콜을 사용하는 컨슈머에서만 의미가 있으며, HTTP를 통한 FORMAT Native 왕복에는 적합하지 않습니다.
파일은 비대칭적으로 동작합니다. 서버 측 INSERT INTO FUNCTION file(...)(또는 s3, url)에 높은 ?client_protocol_version=을 지정하면 해당 revision으로 파일을 기록하지만, file(...) 읽기는 항상 revision 0으로 파싱하므로 이렇게 만든 파일은 왕복할 수 없습니다. 기록 요청에서 client_protocol_version을 생략하여 파일을 일반 revision 0으로 유지하거나, 방향마다 핸드셰이크로 협상된 revision을 사용하는 네이티브 TCP 프로토콜로 데이터를 전송하십시오.
프로토콜 revision과 직렬화 버전의 차이프로토콜 revision을 직렬화 버전과 혼동하지 마십시오. 여기서 말하는 revision은 연결 또는 요청 전체에 적용되며 바이트에는 나타나지 않습니다. 반면 직렬화 버전은 컬럼 단위로 버전이 지정된 타입에 포함되며, 비어 있지 않은 모든 블록에 기록됩니다. revision은 특정 기능이 존재하는지 여부 자체를 결정하고, 직렬화 버전은 버전이 지정된 컬럼 안에서 해당 타입 인코딩의 어떤 변형이 이어지는지를 결정합니다.
데이터 유형
이 섹션에서는 Native 형식에서 컬럼의data에 담을 수 있는 유형별 wire 인코딩을 설명합니다. 각 유형은 디코더 복잡도가 낮은 순서대로 네 가지 계열로 그룹화되어 있습니다. AggregateFunction(func, ...)와 QBit(T, N[, stride]) 두 유형은 유효한 Native 컬럼 유형이지만, 함수나 유형에 따라 payload가 달라지므로 이 문서에서는 다루지 않습니다. 다만 별칭으로 오인될 수 있는 부분에서는 아래에 따로 언급합니다.
고정 폭 유형
각 값은 일정한 바이트 수를 차지합니다.M개의 행으로 이루어진 컬럼은 wire 상에서 정확히 bytes_per_row × M 바이트를 차지하며, 각 값은 구분자나 패딩 없이 연속으로 이어 붙여집니다.
정수 유형
UInt8–UInt256과 Int8–Int256은 정수 값을 바이너리로 직접 인코딩한 형식입니다. 디코더는 bytes_per_row × num_rows 바이트를 읽은 다음 유형에 맞게 해석합니다.
[1, 256, 65536]을 저장하는 UInt32 컬럼의 예는 다음과 같습니다.
[-1, 42]를 담은 Int32 컬럼:
Float32 및 Float64
표준 IEEE 754 이진 부동소수점 형식으로, 4바이트 단정밀도(binary32)와 8바이트 배정밀도(binary64)를 사용하며 둘 다 리틀 엔디언입니다. NaN, ±Infinity, ±0.0 및 비정규 수(subnormal)는 모두 정규화되지 않고 그대로 왕복됩니다.
Float32 값 1.5(0x3FC00000):
Float64 값 1.5(0x3FF8000000000000):
BFloat16
브레인 부동소수점(brain-floating-point) 포맷으로, IEEE 754Float32의 상위 16비트에 해당합니다. 부호 비트 1개, 지수 비트 8개, 가수 비트 7개로 구성됩니다. 각 값은 2바이트이며, 원시 16비트 패턴을 리틀 엔디언으로 저장합니다. 숫자 값을 복원하려면 패턴을 상위 절반에 배치하고 하위 절반을 0으로 채워 Float32로 다시 확장하십시오(bits << 16을 Float32로 재해석). 이렇게 확장된 값은 Float32와 동일한 텍스트 서식을 따릅니다.
BFloat16 값 1.5(패턴 0x3FC0, Float32 0x3FC00000의 상위 절반):
Bool
UInt8과 wire 호환됩니다. 행당 1바이트를 사용하며, 0x00 = false, 0x01 = true입니다. 다만 wire 상의 유형 문자열은 UInt8이 아니라 문자 그대로 Bool이므로, 유형 문자열을 기준으로 분기하는 디코더는 이를 별도로 인식해야 합니다.
[true, false, true] 값을 갖는 Bool 컬럼의 예:
Date 및 Date32
두 타입 모두 날짜를 Unix epoch1970-01-01로부터 경과한 일수를 나타내는 정수로 인코딩하며, 시간 구성 요소는 포함하지 않습니다.
Date 값 1970-01-02(1일):
Date32 값 1900-01-01(-25567일):
DateTime
UInt32와 wire 호환됩니다. 즉, 초 단위 Unix 타임스탬프를 4바이트 리틀 엔디언으로 저장합니다. 이 유형은 DateTime 또는 DateTime('Timezone') 형태로 표기될 수 있으며, 시간대는 표시 방식에만 영향을 줄 뿐 wire 값에는 포함되지 않습니다. 따라서 시간대 매개변수가 서로 다른 두 DateTime 컬럼이라도 같은 시점에 대해서는 동일한 바이트를 생성합니다. 디코더는 (...) 매개변수 접미사를 제거한 뒤 해당 컬럼을 UInt32로 처리합니다.
DateTime('UTC') 값 2024-03-15 14:30:00 UTC(타임스탬프 1710513000):
DateTime64(scale[, timezone])
8바이트 리틀 엔디언 Int64로, Unix epoch 이후 경과한 시간을10^-scale초 단위의 틱 수로 나타냅니다. scale 매개변수(0–9)는 유형 문자열에 포함되며 시간 단위를 결정합니다.
이 유형은
DateTime64(s)(서버 기본 시간대를 암시적으로 사용) 또는 DateTime64(s, 'TimezoneName')(시간대를 명시적으로 지정하며, 표시에만 영향) 형식으로 표기됩니다. 음수 값은 epoch 이전의 틱을 나타냅니다.
DateTime64(3, 'UTC') 값 2024-01-15 12:30:45.123 UTC(1705321845123 ms):
DateTime64(0) 값 2024-01-15 12:30:45 UTC(1705321845초):
Time 및 Time64(scale)
특정 시점이 아닌 시계상의 지속 시간을 나타냅니다.Time은 부호 있는 초 단위 값으로, 4바이트 리틀 엔디언 Int32입니다. Time64(scale)는 지정된 10진 스케일(0–9)의 부호 있는 틱 수로, 8바이트 리틀 엔디언 Int64이며 DateTime64와 wire 형태가 동일합니다.
텍스트 형식은 [-]HH:MM:SS[.fraction]이지만, DateTime과 달리 시간 필드는 24시간 단위로 순환되지 않습니다. 즉 시간 필드는 전체 시간 수를 나타내며 23을 초과할 수 있습니다. 표시되는 크기는 최대 999:59:59(3599999초)로 제한됩니다. 이보다 큰 값은 초 부분이 상한값으로 표시되고 저장된 소수 부분은 그대로 유지되므로, 틱 수 3700000.25는 999:59:59.250000으로 표시됩니다. CAST는 저장된 값을 정수 초가 아니라 대상 스케일에서 표현 가능한 최대 틱 값(Time64(6)에서는 999:59:59.999999)으로 포화시킵니다. 반면 산술 연산 결과로는 범위를 벗어난 틱 수가 컬럼에 그대로 남을 수 있으며, 이 값은 표시할 때만 상한이 적용됩니다. 이러한 동작은 wire 바이트에 아무런 영향을 주지 않으며, wire 바이트는 단순한 부호 있는 정수입니다.
Time 값 45296(12:34:56):
Time64(3) 값 45296789틱(12:34:56.789):
Time 및 Time64는 실험적 기능이므로 서버에서 allow_experimental_time_time64_type = 1을 설정해야 합니다.Interval
Interval<Unit> — IntervalSecond, IntervalMinute, IntervalHour, IntervalDay, IntervalWeek, IntervalMonth, IntervalQuarter, IntervalYear, IntervalNanosecond 등이 있습니다. 모든 단위는 동일한 wire 인코딩을 사용하며, 개수를 부호 있는 8바이트 리틀 엔디언 Int64로 저장합니다. 단위 정보는 오직 유형 문자열에만 담기며, wire 바이트와 텍스트 형식(정수 값 그대로)은 단위와 관계없이 동일합니다. 따라서 디코더 경로 하나로 모든 단위를 처리할 수 있습니다.
IntervalDay 값 5:
UUID
값당 16바이트입니다. wire 인코딩은 정규 형식인 16바이트 빅 엔디언이 아닙니다. 8바이트씩 나눈 두 절반의 바이트 순서가 각각 독립적으로 뒤집힙니다. 논리적 모델은 정규 텍스트 형식xxxxxxxx-xxxx-xxxx-xxxx-xxxxxxxxxxxx로 표현되는 128비트 식별자이며, 바이트는 관례적으로 빅 엔디언으로 기록됩니다. wire 모델은 이 16개의 정규 바이트를 8바이트씩 두 절반으로 나눈 다음, 각 절반을 리틀 엔디언으로 기록합니다.
- wire 바이트 0..7 = 정규 바이트 0..7을 역순으로 배치한 값
- wire 바이트 8..15 = 정규 바이트 8..15를 역순으로 배치한 값
550e8400-e29b-41d4-a716-446655440000:
IPv4 및 IPv6
서로 관련이 있지만 인코딩 방식이 다른 두 가지 주소 타입입니다.IPv4는 4바이트이며, 정규 32비트 주소(a.b.c.d로부터 계산한 값 (a << 24) | (b << 16) | (c << 8) | d)를 담은 리틀 엔디언 UInt32로 인코딩됩니다. wire 바이트는 네트워크 바이트 순서의 바이트를 역순으로 뒤집은 것입니다.
192.168.1.10(정규 32비트 값 0xC0A8010A):
IPv6는 16바이트이며, 바이트 스왑 없이 네트워크 바이트 순서(network byte order) 그대로 기록됩니다. 이는 inet_pton(AF_INET6, ...)의 바이트 순서와 동일합니다.
2001:db8::1:
u32로 저장되는 반면, IPv6는 대부분의 네트워킹 API에서 흔히 사용하는 네트워크 바이트 순서 레이아웃을 그대로 유지합니다.
Enum8 및 Enum16
각각Int8 및 Int16과 wire 호환됩니다. 행당 1바이트 또는 2바이트를 사용하며, 16비트 버전은 2의 보수 리틀 엔디언 방식으로 인코딩됩니다. 전체 값 매핑은 타입 문자열에 포함됩니다:
(...) 매개변수 접미사를 제거하고 Int8 / Int16으로 처리할 수 있습니다. wire 바이트는 정수 인덱스에 불과하기 때문입니다. 레이블을 노출하는 클라이언트는 타입 문자열에서 'name' = value 맵을 파싱하여 컬럼과 함께 보관해야 합니다. 정수만으로는 레이블을 복원할 수 없기 때문입니다. 텍스트 기반 출력에서는 인덱스 대신 레이블(active)이 렌더링되며, enum이 복합 타입 안에 중첩되어 있으면 작은따옴표로 감싸서('active') 표시됩니다. 정수 컬럼만으로는 맵을 복원할 수 없으므로, Array(Enum8(...))나 Map(Enum16(...), V)처럼 중첩된 enum에서는 반드시 맵을 유지해야 합니다.
Enum8('active' = 1, 'inactive' = 2) 컬럼 [active, inactive, active]:
Enum16(...) 값 30000의 경우:
Decimal(P, S)
10의 거듭제곱으로 스케일링된 부호 있는 정수입니다. 정수의 바이트 폭은 정밀도(precision)P로 결정되며, 스케일(scale) S는 음의 지수(소수점 이하 자릿수)입니다. 두 값 모두 타입 문자열에 포함됩니다.
wire 인코딩은 기반 정수를 리틀 엔디언 2의 보수로 나타낸 것이며, 논리적 십진수 값은
wire_integer × 10^(-S)입니다.
ClickHouse는 타입을 어떻게 선언했는지와 관계없이 항상 Decimal(P, S)를 내보냅니다. Decimal32(S), Decimal64(S) 등은 모두 wire 상에서 Decimal(P, S)로 정규화됩니다(이때 P는 해당 폭의 기본 최댓값인 9, 18, 38, 76으로 설정됩니다). 따라서 Decimal(P, S)만 인식하는 디코더로도 서버가 내보내는 모든 표기를 처리할 수 있습니다.
Decimal(9, 4) 값 123.4567 → 기반 정수 1234567:
Decimal(18, 1) 값 -1.5 → 기반 정수 -15:
Decimal(38, 4) 값 123.4567(총 16바이트):
Nothing
Nothing 타입은 어떤 값도 담지 않습니다. 실제로는 Nullable(Nothing)의 내부 타입으로만 나타나며, 이는 SELECT NULL처럼 유효한 값이 오직 값의 부재뿐인 표현식에 대해 서버가 반환하는 타입입니다. 개념적으로는 유닛 타입(unit type)에 해당합니다.
wire 상에서는 정확히 행당 1개의 플레이스홀더 바이트를 차지합니다. 서버는 ASCII 문자 '0'(0x30)을 출력하지만, 역직렬화기는 이 바이트를 무시합니다. 내용은 정의되어 있지 않으므로 디코더는 특정 값에 의존해서는 안 됩니다. 기록되는 바이트 수는 num_rows × 1이므로, 컬럼 헤더의 num_rows만으로 읽어야 할 양이 완전히 결정됩니다.
행당 1바이트를 사용하면 Block 불변식이 그대로 유지됩니다. 즉, 모든 컬럼의 길이를 num_rows로부터 도출할 수 있으므로, 디코더는 셀별 길이 프리픽스 없이 순차적으로 읽어 나갈 수 있습니다. 이를 감싸는 Nullable이 항상 모든 위치를 NULL로 표시하므로 플레이스홀더를 검사할 일은 없습니다.
3개의 행(모두 NULL)으로 구성된 Nullable(Nothing) 컬럼:
Nullable 프레이밍(framing)입니다(Nullable 참조). 그 안의 3바이트는 Nothing payload이며, 디코더는 이 부분을 건너뜁니다.
가변 길이 타입
각 값은 wire 상에서 자체 길이 정보를 함께 담고 있습니다.String
타입 문자열:String. String 컬럼에는 2가지 wire 레이아웃이 있으며, 프로토콜 revision에 따라 둘 중 하나가 선택됩니다(revision이 게이트하는 항목 참조). revision은 네이티브 TCP 프로토콜에서는 협상된 revision이고, FORMAT Native 출력에서는 client_protocol_version입니다(기본값 0). FORMAT Native 입력은 항상 revision 0이며, Buffers 포맷은 항상 값별 레이아웃(per-value layout)을 사용합니다.
값별 레이아웃(Per-value layout) — revision이 DBMS_MIN_REVISION_WITH_STRING_WITH_SIZE_STREAM_SERIALIZATION(54492) 미만인 경우(FORMAT Native의 기본값인 revision 0 포함)에 사용되며, 길이 프리픽스가 붙은 바이트 시퀀스 num_rows개로 구성됩니다:
0x00 바이트 1개로 표현됩니다. 컬럼이 차지하는 총 바이트 수는 모든 행에 대해 합산한 Σ (varuint_size(len_i) + len_i)입니다.
문자열 3개 ["ab", "", "c"]로 구성된 컬럼(총 6바이트):
54492 이상: 두 개의 스트림을 이어 붙인 형태로, 누적 바이트 오프셋이 먼저 오고 그 뒤에 전체 데이터가 이어집니다:
Array가 native protocol로 오프셋을 전송하는 것과 동일한 방식으로 그대로 전송됩니다. 오프셋 i는 데이터 blob에서 값 i가 끝나는 위치이므로, 값 i의 크기는 offset[i] - offset[i-1](단, offset[-1] = 0)이고 마지막 오프셋은 데이터 blob의 전체 크기가 됩니다. 디코더는 8 × num_rows 바이트의 오프셋을 읽은 뒤, 마지막 오프셋을 정확한 길이로 삼아 데이터 blob 전체를 한 번에 읽습니다. 따라서 행 단위로 파싱하는 대신 버퍼를 정확한 크기로 미리 할당하고 대량 복사를 수행할 수 있으며, 크기를 오프셋으로 변환할 필요도 없습니다. num_rows = 0인 컬럼은 두 스트림 어디에도 바이트를 기록하지 않습니다.
앞과 동일한 3개의 문자열 ["ab", "", "c"](총 27바이트):
String에 적용되며, 복합 타입(Array(String), Nullable(String), Map, Tuple, Variant, Dynamic, JSON) 내부에 중첩된 String도 마찬가지입니다. 단, 한 가지 예외가 있습니다. LowCardinality 컬럼의 딕셔너리는 항상 기본 중첩 직렬화 방식으로 기록되므로, 이 딕셔너리의 String 값은 revision과 관계없이 항상 값별 레이아웃(per-value layout)을 유지합니다. 이는 LowCardinality(String), LowCardinality(Nullable(String))를 비롯해 String을 포함하는 모든 LowCardinality 딕셔너리에 해당합니다.
두 레이아웃 모두에서 ClickHouse String은 텍스트가 아닌 바이트 단위로 다뤄집니다. 즉, UTF-8 유효성을 강제하지 않으며, 값에는 중간에 포함된 NUL을 비롯해 어떤 바이트든 들어갈 수 있습니다. UTF-8 문자열 타입으로 디코딩하는 디코더는 읽을 때 유효성을 검사하거나, 원시 바이트를 호출자에게 그대로 노출해야 합니다.
FixedString(N)
타입 문자열:FixedString(N)이며, 여기서 N은 양의 정수입니다(예: FixedString(16)). 컬럼은 정확히 N × num_rows 바이트의 원시 바이트로 구성되며, 길이 프리픽스나 구분자는 없습니다. 디코더는 타입 문자열에서 N을 파싱한 뒤 행마다 해당 바이트 수만큼 읽습니다.
SQL로 N 바이트보다 짧은 값을 삽입하면(예: CAST('abc' AS FixedString(5))) 서버는 선언된 길이가 되도록 값의 오른쪽을 NUL 바이트(0x00)로 채웁니다. 이 패딩 바이트는 저장된 값의 일부이므로 wire 상에서도 그대로 전송되며, 패딩 제거는 클라이언트 측에서 처리해야 합니다. String과 마찬가지로 FixedString(N)은 텍스트보다는 바이트 배열에 가까우며, 주로 고정 길이 식별자, 주소 바이트, 해시 다이제스트 등에 사용됩니다.
FixedString(3) 값 2개 ["abc", "de\0"](총 6바이트):
복합 타입
복합 타입(composite types)은 하나 이상의 내부 타입을 감싸며, 컬럼당 여러 개의 스트림이라는 공통 wire 모델을 공유합니다. 하나의 논리적 컬럼은 독립적으로 읽히는 두 개 이상의 바이트 시퀀스를 이어 붙인 형태로 인코딩됩니다. 복합 타입은 다음 세 가지 구조적 속성을 공유합니다.- 스키마별로 고정된 형태. 구조는 디코딩 시점의 타입 문자열만으로 결정됩니다.
Array(UInt32)는 어느 블록에서든 항상 동일한 스트림 레이아웃을 가집니다. - 자체 버전 접두사 없음. 복합 래퍼 자체는 버전 바이트를 추가하지 않으며, 래퍼의 프레이밍(오프셋, null-map, 원소 스트림)은 ClickHouse 릴리스가 바뀌어도 안정적으로 유지됩니다. 이는 래퍼에만 해당하며, 버전이 지정된 내부 타입에 대해서는 아래의 prefix 단계 관련 설명을 참조하십시오.
- 자체 블록 간 상태 없음. 래퍼의 프레이밍은 블록 단위로 완전히 자기 기술적(self-describing)입니다. 블록 간 상태와 관련된 문제는 래퍼가 아니라 버전이 지정된 내부 타입에서 발생합니다.
SerializationArray는 배열 오프셋을 쓰기 전에 내부 타입의 prefix 단계를 실행하며, Tuple, Map, Nested, Nullable도 각 원소 직렬화를 통해 같은 방식으로 동작합니다(Nullable은 null map보다 먼저 내부 접두사를 실행합니다).
따라서 복합 타입이 버전이 지정된/상태 유지형 타입(LowCardinality, Variant, Dynamic, JSON)을 감싸면, 해당 내부 타입의 버전/상태 접두사가 래퍼의 오프셋과 원소 payload보다 먼저 출력됩니다. 예를 들어 Array(LowCardinality(String))은 오프셋이 먼저 오는 것이 아니라 [LowCardinality state prefix] → [array offsets] → [flattened LowCardinality element payload] 순서로 배치됩니다.
내부 prefix 단계를 실행하기 전에 오프셋을 읽는 디코더는 LowCardinality, Variant, Dynamic 또는 JSON을 포함하는 복합 타입에서 항상 동기화가 어긋납니다. 모든 내부 타입이 일반 리프 타입이거나 버전이 지정되지 않은 다른 복합 타입이라면 prefix 단계에서 출력되는 바이트가 없으므로, 아래의 오프셋 우선 설명이 그대로 적용됩니다.
Nullable(T)
타입 문자열:Nullable(InnerType). 예시: Nullable(UInt32), Nullable(String), Nullable(FixedString(16)), Nullable(DateTime('UTC')).
다른 복합 타입과 마찬가지로 Nullable은 null 맵(null map)을 쓰기 전에 prefix 단계를 내부 직렬화에 위임합니다. 즉, 내부 타입이 버전이 지정된(versioned) 타입이면 내부 타입의 상태 접두사가 먼저 출력됩니다. 따라서 Nullable(Tuple(LowCardinality(String)))은 null 맵이 아니라 LowCardinality 상태 접두사로 시작합니다. 내부 타입이 리프이거나 버전이 지정되지 않은(non-versioned) 다른 타입이면 prefix 단계에서는 바이트가 출력되지 않습니다.
wire 레이아웃(wire layout)은 내부 prefix 단계(내부 타입이 버전이 지정된 타입일 때만 내용이 있음)와 그 뒤에 이어 붙은 두 개의 스트림으로 구성되며, null 맵이 먼저 옵니다.
num_rows 바이트로, 행마다 1바이트씩 할당됩니다:
values 스트림에는 null 위치를 포함한 모든
num_rows개 행이 내부 타입의 표준 인코딩으로 들어 있습니다. 디코더는 스트림을 계속 읽어 나가려면 null 위치의 플레이스홀더 바이트도 반드시 읽어야 하지만, 개별 값을 해석하기 전에는 반드시 null-map을 확인해야 합니다. 송신 측은 null 위치에 임의의 바이트를 기록할 수 있으므로, 디코더는 특정 플레이스홀더 값을 가정해서는 안 됩니다.
내부 타입 계열별 플레이스홀더 값은 다음과 같습니다:
Nullable(T)는 Array, Tuple, Map, Nested 내부에 올 수 있으며, Array(Nullable(T))와 Tuple(Nullable(T1), T2) 형태가 흔히 사용됩니다. Nullable은 중첩할 수 없으며, Nullable(Nullable(T))는 서버에서 거부됩니다.
3개의 행 [5, NULL, 9]를 갖는 Nullable(UInt8)(총 6바이트):
["hello", NULL, "world"] 3개 행으로 구성된 Nullable(String)(총 15바이트):
Array(T)
타입 문자열:Array(InnerType). 예시: Array(UInt32), Array(String), Array(Nullable(UInt32)), Array(Array(UInt8)).
wire 레이아웃은 내부 타입의 prefix 단계(내부 타입에 버전 정보가 없으면 비어 있음)와 그 뒤에 연결된 2개의 스트림으로 구성되며, offsets 스트림이 먼저 옵니다.
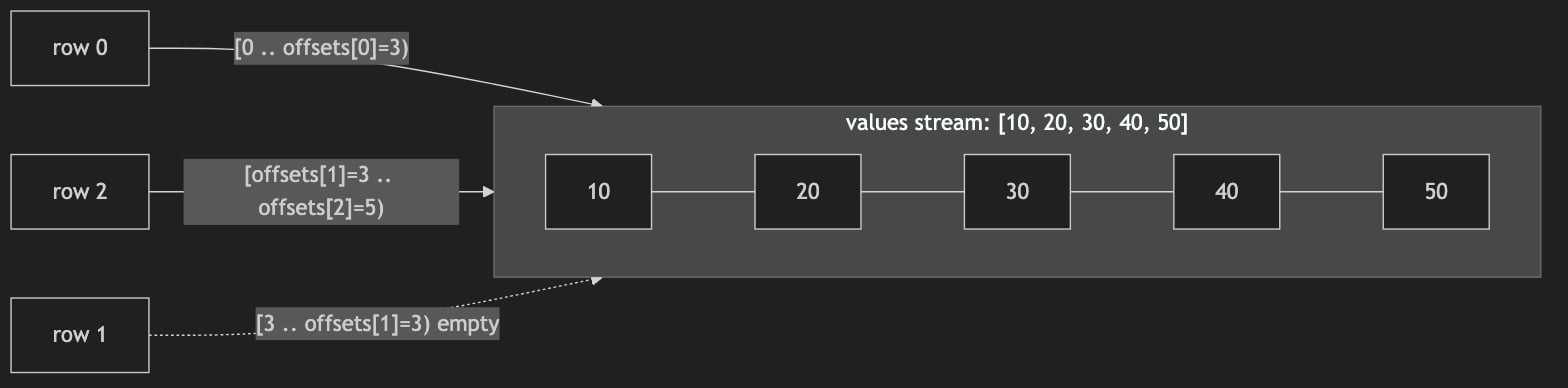
num_rows개의 리틀 엔디언 UInt64 값으로 구성되며, 각 값은 해당 행의 원소까지 기록한 뒤의 values 스트림 내 누적 끝 위치를 나타냅니다.
- 행
N의 원소 시작 인덱스 =offsets[N - 1](N == 0이면0) - 행
N의 원소 끝 인덱스(미포함) =offsets[N] - 행
N의 원소 개수 =offsets[N] - offsets[N - 1]
offsets[num_rows - 1]은 전체 행의 총 원소 개수이며, values 스트림에는 그 개수만큼의 내부 값이 순서대로 연결되어 저장됩니다.
오프셋은 단조 비감소입니다. 연속된 오프셋 값이 같으면 빈 행을 의미하며, 디코더는 단조성을 위반하는 오프셋을 데이터 손상으로 간주하여 거부해야 합니다. 빈 컬럼(num_rows == 0)은 아무 바이트도 기록하지 않으므로 offsets 스트림과 values 스트림이 모두 존재하지 않습니다. 내부 타입으로는 다른 복합 타입을 포함한 모든 타입을 사용할 수 있으며, Array(Array(T)), Array(Tuple(...)), Array(Nullable(T)) 모두 허용됩니다.
행이 [[10, 20, 30], [], [40, 50]]인 Array(UInt32)의 예시(총 44바이트):
0입니다. 연속된 두 오프셋 값이 같으면 빈 행을 나타냅니다.
[["a", "bb"], []]인 Array(String)(총 20바이트):
Array(Array(UInt32))의 행이 [[[1,2]], [], [[3], [4,5]]]이면 같은 구조가 중첩됩니다.
- 외부 오프셋:
[1, 1, 3]— 행 0에는 내부 배열이 1개, 행 1에는 0개, 행 2에는 2개 있습니다. - 중간의
Array(UInt32)는 오프셋[2, 3, 5]로 3개의 행을 디코딩합니다. - 가장 안쪽의
UInt32는 5개의 값[1, 2, 3, 4, 5]를 디코딩합니다.
Tuple(T1, T2, …)
타입 문자열:Tuple(T1, T2, ..., Tn). 예시: Tuple(UInt32, String), Tuple(Int32), Tuple(Array(UInt32), String), Tuple(UInt8, Tuple(Int32, String)). ClickHouse는 Tuple(a UInt32, b String) 형태의 named tuple도 지원합니다. 이름은 메타데이터일 뿐이며 wire 형식에는 영향을 주지 않습니다.
wire 레이아웃은 먼저 원소들의 prefix 단계가 오고(버전이 지정된 원소는 선언 순서대로 각자의 상태 접두사를 기록하며, 버전이 지정되지 않은 원소는 아무것도 기록하지 않음), 그 뒤에 원소 타입별로 하나씩 선언 순서대로 연결된 N개의 스트림이 이어지는 구조입니다:
num_rows개의 값을 인코딩합니다. 길이 프리픽스, offsets 스트림, 스트림 간 구분자는 없습니다. 빈 컬럼(num_rows == 0)은 스트림마다 0바이트를 기록합니다. 원소 타입으로는 다른 복합 타입을 포함한 모든 타입을 사용할 수 있으며, Tuple(Tuple(...), ...), Tuple(Array(...), ...), Tuple(Nullable(T1), T2)는 모두 유효합니다.
원소가 없는 튜플 Tuple()도 유효하며, SELECT tuple()이나 CAST(x AS Tuple()) 같은 표현식에서 생성됩니다. 원소 스트림이 없으므로 Nothing과 같은 방식으로 직렬화됩니다. 즉, **행마다 플레이스홀더 바이트 1개(0x30, ASCII '0')**를 기록하며, 역직렬화기는 이 바이트를 버립니다. 행 수는 Nothing과 마찬가지로 블록 헤더에서 가져옵니다.
행 3개 (1,4), (2,5), (3,6)으로 구성된 Tuple(UInt8, UInt8):
[1, 2, 3], 원소 1은 [4, 5, 6]이 됩니다.
(10, "a"), (20, "bb") 2개 행으로 구성된 Tuple(UInt32, String)(총 13바이트):
Map(K, V)
타입 문자열:Map(KeyType, ValueType). 예시: Map(String, UInt32), Map(String, Array(UInt32)), Map(UInt8, Tuple(Int32, String)), Map(Array(String), Int8). wire 형식에서는 두 타입 모두 제한이 없으며, K와 V 모두 복합 타입을 포함해 지원되는 어떤 타입이든 될 수 있습니다. (ClickHouse에서 허용되는 키 타입에 관한 SQL 수준의 규칙은 릴리스에 따라 달라져 왔으므로, 대상 서버 버전의 SQL 문서를 참조하십시오.)
wire 레이아웃은 Array(Tuple(K, V))와 바이트 수준에서 동일하므로, 내부 prefix 단계로 시작합니다(K 또는 V가 버전이 지정된 타입이 아니면 이 단계는 비어 있습니다):
total_pairs = offsets[num_rows - 1]입니다(num_rows == 0이면 0). offsets 스트림의 의미는 배열과 동일합니다. 키와 값은 위치상으로 정렬되어 있으며, 쌍 i는 (keys[i], values[i])입니다.
ClickHouse에서 Map 컬럼의 인메모리 표현은 튜플의 배열이며, 타입 시스템은 SQL 사용 편의성(m['key'], mapKeys, mapValues)을 위해 이를 별도의 타입으로 노출합니다. wire 형식은 이 저장 구조를 그대로 직렬화한 것이므로 Map과 Array(Tuple(K, V))는 바이트 단위까지 완전히 호환됩니다.
오프셋은 단조 비감소이며, keys 스트림과 values 스트림에는 모두 정확히 total_pairs개의 값이 들어 있습니다. 빈 컬럼은 0바이트를 기록합니다. 한 행 안에서 키는 일반적으로 고유하지만, 이는 의미론적 규칙일 뿐 wire 수준에서 강제되는 규칙은 아닙니다. wire 형식에서는 중복 키도 손실 없이 그대로 기록하고 다시 읽을 수 있으며, 서버 측에서는 Map을 인식하는 함수가 해당 행을 처리할 때에만 중복이 해소됩니다.
2개 행 {1:10, 2:20}, {3:30}을 담은 Map(UInt8, UInt8)(총 22바이트):
i번째 쌍은 keys[i]와 values[i]를 함께 읽어 재구성합니다.
{'a':1, 'b':2} 1개 행을 담은 Map(String, UInt32)(총 20바이트):
Nested(name1 T1, name2 T2, …)
Nested가 wire 상에서 표현되는 방식은 서버 측 flatten_nested 설정에 따라 달라지며, 크게 두 가지 경우로 나뉩니다.
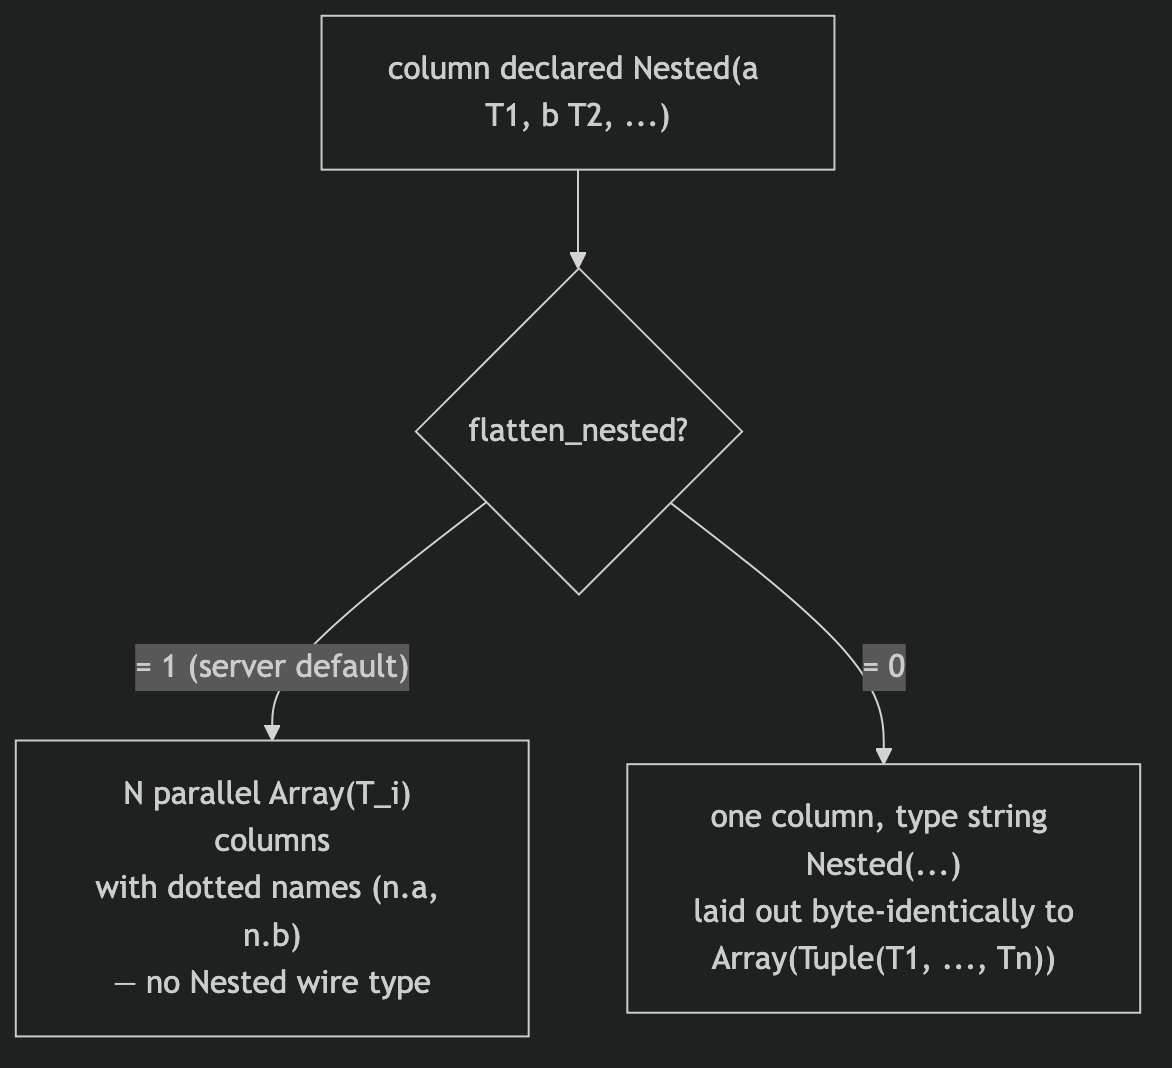
flatten_nested = 1 (서버 기본값). 테이블을 기본 설정으로 생성했다면 Nested는 wire 타입이 아닙니다. 서버는 해당 컬럼을 점으로 구분된 이름(outer.field1, outer.field2 등)을 가진 N개의 병렬 Array(T_i) 컬럼으로 저장하고 표시합니다. 포맷 계층에서는 새로 처리할 것이 없으며, 점으로 구분된 각 컬럼은 일반 배열과 같습니다.
flatten_nested = 0. 테이블이 flatten_nested = 0으로 생성되었다면, 해당 컬럼은 wire 상에서 타입 문자열이 Nested(name1 T1, name2 T2, ...)인 단일 컬럼으로 나타나며, 타입 문자열 이후의 레이아웃은 내부 prefix 단계까지 포함하여 Array(Tuple(T1, T2, ..., Tn))와 바이트 수준에서 동일합니다. 따라서 버전이 지정된 필드 T_i는 오프셋보다 앞서 자신의 상태 접두사를 먼저 내보냅니다. 아래 예시에서는 버전이 지정되지 않은 필드를 사용하므로 prefix 단계가 비어 있습니다.
Nested는 필드 이름(a, b)을 유지하지만, Array(Tuple)은 이를 이름이 있는 슬롯으로 담지 않습니다.
Case B의 타입 문자열은 (이름, 타입) 쌍을 쉼표로 구분한 목록입니다. 첫 번째 공백 문자가 이름과 타입을 구분하며, 타입 자체에도 공백 문자, 쉼표, 괄호가 추가로 포함될 수 있습니다. 따라서 파싱(parsing)할 때는 Tuple에서 사용하는 것과 동일한, 중첩 깊이를 인식하는 분할기가 필요합니다. wire 레이아웃은 다음과 같습니다.
total_elements = offsets[num_rows - 1]입니다(num_rows == 0이면 0). 오프셋은 단조 비감소하며, 모든 필드 스트림에는 정확히 total_elements개의 값이 담깁니다. 서버는 INSERT 시점에 하나의 행 안에서 모든 필드의 원소 개수가 동일한지 검사합니다. 빈 컬럼은 0바이트를 기록합니다.
[(10,'x'),(20,'y')]와 [(30,'z')] 2개의 행으로 구성된 Nested(a UInt8, b String)(타입 문자열 이후 25바이트):
타입 별칭
일부 타입은 순수한 별칭입니다. 서버는 컬럼 헤더에 별칭 이름을 보내지만, 그 뒤에 오는 바이트는 기반 타입의 바이트입니다. 디코더는 별칭을 해당 타입에 매핑하고 그 타입의 코덱을 재사용하므로 새로운 wire 형식은 필요하지 않습니다. 지리 타입은 중첩된 배열과 튜플의 별칭입니다.
따라서
Point 컬럼은 Tuple(Float64, Float64)와 똑같이 디코딩되고((1,2)로 표시됨), Ring은 Array(Tuple(Float64, Float64))([(0,0),(1,1)])로 디코딩됩니다. 상위 계층도 같은 방식으로 디코딩됩니다.
Geometry도 별칭이지만, 중첩 배열이 아니라 Variant의 별칭입니다. payload는 위의 7개 지리 타입으로 구성된 variant입니다. 컬럼 헤더에는 타입 문자열 Geometry만 담기며 variant 구성은 명시되지 않으므로, 디코더가 직접 이를 확장해야 합니다. 사용자가 직접 작성한 Variant와 달리, Geometry의 판별자는 이름 정렬 순서를 따르지 않습니다. 판별자는 호환성을 위해 고정되어 있으며, 새로운 지리 타입은 항상 끝에만 추가됩니다. 매핑은 0 = LineString, 1 = MultiLineString, 2 = MultiPolygon, 3 = Point, 4 = Polygon, 5 = Ring, 6 = MultiPoint입니다(6은 26.7에서 추가되었으며, 이전 버전 서버의 스트림에는 판별자 6이 나타나지 않습니다). 선택된 각 값은 위의 해당 지리 별칭을 통해 디코딩됩니다(NULL은 Variant의 NULL 판별자 255를 사용합니다).
SimpleAggregateFunction(func, T)는 값 타입 T의 별칭입니다. 이미 최종 처리된 집계 값을 저장하므로 wire 형태와 표시 방식이 T와 완전히 같습니다(SimpleAggregateFunction(sum, UInt64)는 UInt64로 디코딩됩니다). 이와 같이 별칭으로 취급되는 것은 단일 값 타입을 갖는 형태뿐이며, 기반 타입 자체는 복합 타입일 수 있습니다.
관련된 두 타입은 별칭이 아닙니다. 두 타입 모두 유효한
Native 컬럼 타입이지만(예를 들어 클라이언트는 -State 결합자나 분산 집계를 통해 AggregateFunction 컬럼을 받을 수 있습니다), 각각 이 페이지의 범위를 벗어나는 고유한 특수 payload를 가집니다.AggregateFunction(func, ...)는 최종 값이 아닌 중간 집계 상태(aggregation state)를 보관하며, 바이너리 레이아웃은 집계 함수와 버전에 따라 달라집니다. 함수 이름에는 매개변수가 포함될 수 있으며, 각 매개변수는AggregateFunction(topK(3), UInt64)처럼 SQL 리터럴로 출력됩니다. 일부 집계 함수는AggregateFunction(topK('3'::Decimal32(0)), UInt64)처럼 매개변수에 명시적인::Type접미사를 붙여 출력하는데, 이는Decimal이나 와이드 정수 값에는 접미사 없이 출력할 수 있는 리터럴 형식이 없기 때문입니다. 이렇게 출력할지 여부는 포맷이 아니라 해당 함수의 특성이므로, 매개변수를 검사하는 디코더는 두 가지 표기를 모두 허용해야 합니다. 인수 타입만 필요한 디코더는 영향을 받지 않습니다. 버전이 지정된 집계 함수는 0이 아닌 상태 버전을 타입 문자열의 첫 번째 인수로 명시합니다(AggregateFunction(1, quantileDeterministic, UInt64, UInt64)). 반면 버전0은 출력되지 않으므로 타입 문자열은AggregateFunction(quantileDeterministic, UInt64, UInt64)그대로 유지됩니다. 협상된 연결(revision이0보다 큰 경우)에서 라이터는 프로토콜 revision 만으로 버전을 선택하며, 로컬 타입에 고정된 버전은 절대 사용하지 않습니다. 버전0은 wire 상에서 “버전이 공지되지 않음”과 구별할 수 없기 때문입니다. 따라서 같은 함수라도 연결마다 다른 버전을 공지할 수 있으며, 리더는 최신 버전이라고 가정하지 말고 타입 문자열에서 버전을 읽어야 합니다. revision0에서는 버전을 도출할 대상 피어가 없습니다. 스트림이 자기 기술적(self-describing)이며 이를 작성한 쪽이 다시 읽기 때문입니다. 따라서 타입에 고정된 버전은0으로 낮춰지지 않고 스트림(및 공지되는 타입 문자열)에 그대로 남습니다.quantileDeterministic(quantilesDeterministic및medianDeterministic표기 포함)은 revision54491부터 버전이 지정됩니다. 버전1은 상태 끝에UInt8 skip_degree를 추가하며, 그 앞부분은 버전0과 바이트 수준에서 동일합니다. 이 revision 미만에서는 라이터가 버전0상태를 내보내므로 이전 버전의 피어는 영향을 받지 않습니다.uniq는 revision54493부터 버전이 지정됩니다. 버전1은 버전0레이아웃 앞에 플래그 바이트를 붙이고, 플래그의 비트0이 설정된 경우 각각 상수0x9E3779B97F4A0000과 XOR 연산한 전체 64비트 해시의 소규모 추가 샘플(UInt8 skip_degree,VarUInt count, 이어서 8바이트 값들)을 끝에 덧붙입니다. 이를 통해 카디널리티가 20억을 넘어도 추정치의 정확도가 유지됩니다. 버전0상태에는 32비트 주 샘플만 담깁니다. 플래그의 비트1은 64비트 샘플이 불완전함을 나타냅니다. 즉 해당 상태가 버전0상태를 흡수했으며, 그 요소들은 64비트 샘플에 한 번도 반영된 적이 없다는 의미입니다. 이 경우 64비트 샘플은 작성되지 않으며, 리더는 32비트 주 샘플만으로 추정해야 합니다(또한 이후 작성하는 상태에서도 계속 이를 표시해야 합니다). 따라서 두 비트는 상호 배타적이며, 리더는 두 비트가 모두 설정된 상태를 거부해야 합니다. 그 밖의 비트는 정의되어 있지 않으므로, 리더는 다른 비트가 설정된 상태도 거부해야 합니다.uniqis versioned from revision54493: version1prepends a flags byte to the version-0layout and, when bit0of the flags is set, appends a small additional sample of full 64-bit hashes, each XOR-ed with the constant0x9E3779B97F4A0000(UInt8 skip_degree,VarUInt count, then the 8-byte values), which keeps the estimate accurate at cardinalities above two billion; a version0state carries the 32-bit main sample only. Bit1of the flags says that the 64-bit sample is incomplete — the state has absorbed a version0state, whose elements were never offered to a 64-bit sample — in which case no 64-bit sample is written and a reader must estimate from the 32-bit main sample alone (and keep saying so in the states it goes on to write); the two bits are therefore mutually exclusive, and a reader must reject a state that sets both. No other bit is defined, and a reader must reject a state that sets one. 이 모든 내용은 컨테이너 타입 안에 중첩된 상태에도 동일하게 적용됩니다. 여기에는Array,Tuple,Map,Nullable,Variant(대안 타입에 명시된 버전은 판별자 순서는 그대로 둔 채 타입 문자열만 바꿉니다), 그리고Nested/SimpleAggregateFunction래퍼가 포함됩니다. 집계 함수 결합자에도 마찬가지로 적용됩니다. 버전이 지정된 함수 위의 통과형 결합자(uniqIf,uniqArray,uniqForEach,uniqMap,uniqArgMin/uniqArgMax,uniqOrNull/uniqOrDefault,uniqResample및 암시적Nullable인수 어댑터)는 payload에 포함된 중첩 상태에 버전을 전달하고, 새로 생성된 상태의 타입 문자열에 중첩 함수의 현재 버전을 일반 함수와 똑같이 명시하며(AggregateFunction(1, uniqIf, UInt64, UInt8)), 협상된 연결에서는 같은 방식으로 프로토콜 revision에서 버전을 도출합니다. 래퍼의 사용자 지정 이름에는 인수 타입의 사본이 하나 더 들어 있으므로, 라이터는 협상된 것과 동일한 집계 상태 버전으로 이 사본도 다시 구성해야 합니다. 그렇지 않으면 헤더가 버전0payload에 대해 버전1을 공지할 수 있습니다.Variant에는 wire 상에서 아예 표현할 수 없는 예외 상황이 하나 있습니다. 두 대안 타입이 명시된 상태 버전만 다른 경우(타입 문자열이 다르므로 컬럼 타입으로는 유효함), 협상된 revision에 맞춰 둘 다 버전을 다시 지정하면 같은 대안 타입으로 합쳐집니다. 따라서 송신 측은 payload의 실제 작성 버전과 다른 버전을 공지하는 대신 전송을 실패 처리해야 합니다.Dynamic은 revision 기반 버전 지정의 의도적인 예외입니다.Dynamic컬럼은 자체 타입 목록과 바이너리 타입 인코딩을 통해 중첩 타입을 직접 공지하며, 바이너리 타입 인코딩의 명시적 버전 필드에는 명시된 상태 버전이 담깁니다(공유 variant의 값은 저장된 상태에서도 이 방식으로 타입을 포함합니다). 이러한 공지는 컬럼 자체 데이터의 일부로, 모든 피어와 모든 매체에서 동일하므로 협상된 revision에 맞춰 다시 작성되지 않습니다. 따라서Dynamic값 안에 중첩된 상태는 연결이나 매체와 관계없이 항상 타입에 명시된 버전으로 작성되며(-State쿼리 결과는 버전을 명시하므로 새로 생성된 상태에는 버전이 포함됩니다), 타입에 버전이 명시되지 않은 경우에는 버전0으로 작성됩니다.QBit(T, N[, stride])는 벡터 검색 워크로드를 위해 비트 평면을 전치한 형태로 벡터를 저장합니다. wire 상의 스트림 레이아웃(그룹 우선FixedString비트 평면 스트림이며, 명시적stride가 있으면element_size * (N / stride)개)과 바이너리 타입 인코딩(태그0x36,stride != N이면0x37QBitWithStride)은QBit데이터 타입 페이지와 바이너리 타입 인코딩 참고 문서에 설명되어 있으므로,Native리더가 C++ 소스를 보고 이를 직접 알아낼 필요는 없습니다.
버전 지정 타입
버전 지정 타입(Versioned types)은 wire 상에 직렬화 버전 접두사를 포함하며, 이 접두사는 뒤에 이어지는 인코딩이 어떤 변형인지를 나타냅니다. 또한 복합 타입과 마찬가지로 여러 스트림을 사용할 수 있습니다.Native wire에서는 접두사와 딕셔너리가 블록마다 따로 존재하므로 이러한 타입은 블록 간 상태를 유지하지 않습니다(아래의 블록 단위 접두사 참고 사항 참조). 블록 간 직렬화 상태는 MergeTree의 디스크 상 스트림에만 존재합니다.
이러한 타입은 형태가 고정된 복합 타입보다 훨씬 복잡하므로, 단순한 분석 쿼리만 처리하는 클라이언트라면 지원을 나중으로 미뤄도 됩니다.
직렬화 버전: 개념
**직렬화 버전(serialization version)**은 타입별, 컬럼별로 지정되는 on-wire 버전 번호로, 송신 측이 해당 타입 인코딩의 어떤 변형을 사용하는지를 나타냅니다. 이 값은 컬럼 상태 접두사의 맨 앞에 위치하므로, 디코더는 이 값을 먼저 읽은 뒤 컬럼의 나머지 부분을 처리할 적절한 파서로 분기합니다. 직렬화 버전은 프로토콜 버전과 다른 개념입니다.
대부분의 버전 지정 타입은 다른 상태 접두사 데이터보다 먼저 버전을 리틀 엔디언 UInt64로 기록하며, 일부 타입은 VarUInt 또는 UInt8을 사용합니다. 디코더는 버전을 먼저 읽고 알 수 없는 값은 거부해야 합니다. 더 높은 버전은 디코더가 해석할 수 없는 새로운 송신 측 포맷을 의미하며, 이를 잘못 파싱하면 그 뒤의 모든 바이트가 손상됩니다.
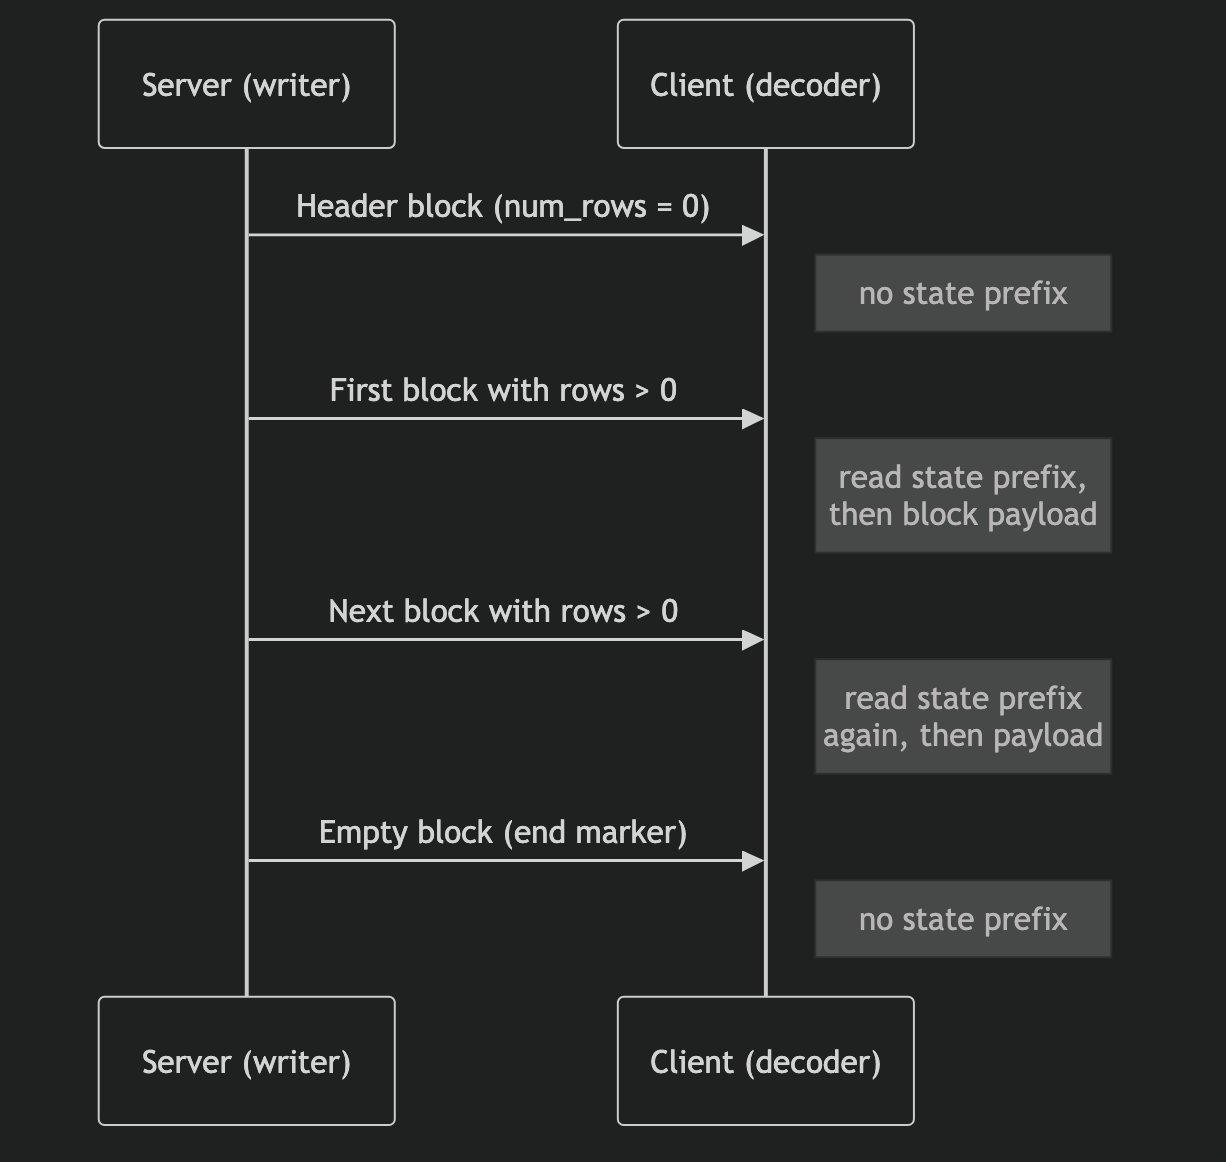
상태 접두사는 행 수가 0보다 큰 모든 블록의 시작 부분, 즉 해당 블록의 payload 바로 앞에 기록됩니다.
Native 라이터와 리더는 블록 간에 직렬화 상태를 유지하지 않습니다.
NativeWriter는 비어 있지 않은 컬럼 블록을 기록할 때마다 새로운 직렬화 상태를 생성하고 상태 접두사를 기록하며, NativeReader는 비어 있지 않은 블록을 읽을 때마다 새로운 역직렬화 상태를 생성하고 상태 접두사를 읽습니다(rows == 0이면 둘 다 접두사를 완전히 건너뜁니다).
따라서 헤더 블록(rows = 0)과 빈 블록은 아무것도 기록하지 않으며, 디코더는 비어 있지 않은 블록마다 시작 부분에서 상태 접두사를 다시 읽어야 합니다. 접두사를 한 번만 읽고 이후 블록에는 payload만 있다고 간주하는 디코더는 다음 블록의 접두사를 데이터로 읽게 되어 동기화가 어긋납니다.
직렬화 버전 참고
이 표에서 유의할 점은 다음과 같습니다.
- 값이 연속적이지 않습니다.
Dynamic은1,2,3,4를 사용하며,V3가4,FLATTENED가3입니다. 숫자가 크다고 해서 반드시 더 최신 버전인 것은 아닙니다. - 일부 값은 Native 포맷 전용입니다.
Object::STRING,Object::FLATTENED,Dynamic::FLATTENED는 Object/Dynamic을 완전히 구현하지 않은 클라이언트와 네이티브 프로토콜 호환성을 유지하기 위해 존재합니다. 이 값들은 MergeTree의 디스크 저장소에는 나타나지 않습니다. V3는 디스크 전용입니다.Object::V3와Dynamic::V3를 표에 포함한 것은 디코더가 이 값을 접할 수 있어서가 아니라, 이미 할당된 값이므로 재사용하면 안 되기 때문입니다. ClickHouse는 이 값들을Native로 전송하지 않으며,Native에서 이 값들을 받으면INCORRECT_DATA로 거부합니다. 이 값들에 담긴 내용, 즉Object::V3의 shared data 하위 버전과 해당 버킷 및 그래뉼 레이아웃은 모두 블록이 아닌 파트에 관한 것이므로 이 페이지의 범위를 벗어납니다. 네이티브 TCP 프로토콜을 사용하는 클라이언트에는V1,V2,STRING,FLATTENED만 나타납니다.
LowCardinality(T)
가장 단순한 버전 지정(versioned) 타입입니다.N개의 내부 값으로 이루어진 컬럼을, 고유 값으로 구성된 작은 딕셔너리와 이 딕셔너리를 참조하는 N개의 인덱스로 대체합니다.
타입 문자열: LowCardinality(InnerType). 예시: LowCardinality(String), LowCardinality(FixedString(4)), LowCardinality(Nullable(String)).
sharedDictionariesWithAdditionalKeys를 나타내며, 그 외의 값은 예약되어 있습니다.
블록별 메타데이터 UInt64는 다음과 같은 비트 필드입니다.
컬럼당 데이터 블록이 하나인 일반적인 쿼리 응답에서는 메타데이터가
0x600(HasAdditionalKeys + NeedUpdateDictionary)입니다.
dict 값은 내부 타입 T로 인코딩된 dict_size개의 값입니다. 딕셔너리는 특수 값을 위해 앞쪽 슬롯을 예약합니다. 널을 허용하지 않는 컬럼은 슬롯 1개를 예약하며(dict[0]에는 내부 타입의 기본값이 들어감. 예: String의 경우 ""), 실제 고유 값은 dict[1]부터 시작합니다.
LowCardinality(Nullable(T))에서도 dict는 일반 T로 인코딩되지만(null-map 스트림 없음), 예약되는 슬롯은 2개입니다. dict[0]은 NULL 마커이고 dict[1]은 내부 타입의 기본값(예: String의 경우 "")이며, 실제 고유 값은 dict[2]부터 시작합니다. NULL 행의 키는 dict[0]을 가리키며, 이 슬롯은 wire에서 내부 타입의 기본값 바이트로 기록됩니다.
키는 dict를 가리키는 인덱스입니다. 각 인덱스의 크기는 1 << key_type_code 바이트(1, 2, 4 또는 8)이며, 값 N은 dict[keys[N]]으로 복원됩니다.
keys_count는 현재 재귀 수준에서의 LowCardinality 값 개수로, 블록의 행 수와 반드시 같지는 않습니다. 최상위 LowCardinality 컬럼에서는 두 값이 일치합니다. 그러나 LowCardinality가 복합 타입 내부에 있으면, 이 개수는 복합 타입이 하위로 전달하는 평탄화된 값의 개수가 됩니다. 예를 들어 3개의 행에 총 5개의 원소가 들어 있는 Array(LowCardinality(String))에서는 keys_count가 3이 아니라 5이고, Map(K, LowCardinality(V))에서는 전체 쌍의 개수가 되는 식입니다. 디코더는 블록 행 수로 가정하지 말고 반드시 이 필드에서 keys_count를 읽어야 합니다. 평탄화된 개수가 0이면(예: 모든 배열이 비어 있는 블록) LowCardinality 데이터 단계에서는 아무것도 기록되지 않습니다. 상태 접두사(복합 타입 prefix 단계에서 출력됨)만 존재하며, 그 뒤에 메타데이터, 딕셔너리, keys_count는 오지 않습니다.
상태 접두사는 행 수가 0보다 큰 모든 블록의 시작 부분에서 읽힙니다. 헤더 블록(rows = 0)과 빈 블록은 아무것도 출력하지 않습니다. 블록 내에서 keys_count는 행 수와 같고, dict_size는 dict 스트림에 있는 값의 개수와 같으며, 각 키의 크기는 1 << key_type_code 바이트 이내입니다.
Native 형식에서는 각 블록이 자체 완결적인 블록 로컬 딕셔너리를 함께 전송하며, 블록 간에 공유되는 딕셔너리 상태는 없습니다. Native writer는 low_cardinality_max_dictionary_size = 0으로 설정하므로 SerializationLowCardinality는 공유 딕셔너리를 생성하지 않습니다. 비어 있지 않은 모든 블록은 NeedGlobalDictionaryBit를 설정하지 않은 상태(메타데이터 0x600)로 키를 블록 로컬 추가 키로 기록하며, Native reader는 native_format이 true이면 NeedGlobalDictionaryBit를 거부합니다. 따라서 디코더는 블록마다 딕셔너리를 초기화하고 해당 블록에 있는 dict_size개의 엔트리를 읽어야 합니다. 이전 블록의 딕셔너리를 그대로 이어서 사용하면 다음 블록의 키를 잘못 해석하게 됩니다. (LC 딕셔너리를 블록 간에 유지하는 것은 MergeTree의 디스크 저장 방식과 관련된 사항이며, Native wire 레이아웃과는 무관합니다.)['a', 'b', 'a', 'c', 'b']인 LowCardinality(String)의 예:
dict[1], dict[2], dict[1], dict[3], dict[2] = ["a", "b", "a", "c", "b"].
값이 ['a', NULL, '', 'b']인 LowCardinality(Nullable(String))에서는 예약된 슬롯 2개를 모두 확인할 수 있습니다. dict[0]은 NULL에, dict[1]은 기본값인 빈 문자열에 사용됩니다.
dict[2] = "a", dict[0] = NULL, dict[1] = "", dict[3] = "b", 즉 ["a", NULL, "", "b"]입니다. dict[0]과 dict[1]은 wire 상에서 모두 빈 바이트이며, null 여부는 바이트 자체가 아니라 키가 슬롯 0을 가리키는지에 따라 결정됩니다.
JSON (Tier 1: String 폴백)
ClickHouse의JSON 타입에는 여러 가지 wire 인코딩이 있습니다(직렬화 버전 참고 참조). Tier 1은 그중 가장 단순한 방식입니다. 쿼리별 설정 output_format_native_write_json_as_string = 1을 지정하면 서버는 모든 JSON 값을 직렬화된 텍스트로 평탄화하고, 해당 컬럼을 상태 접두사 마커가 붙은 String으로 출력합니다.
타입 문자열: JSON.
1입니다. 그 외의 값은 각각 다른 JSON/Object 인코딩을 나타냅니다. 0 = V1, 2 = V2 (네이티브 TCP 프로토콜(native TCP protocol)의 기본값), 3 = FLATTENED, 4 = V3입니다(직렬화 버전 참고 참조). 디코더가 이 위치에서 1이 아닌 값을 읽었다면 String 폴백이 아닌 다른 인코딩을 처리하고 있는 것입니다. 접두사는 행이 1개 이상인 모든 블록의 시작 부분에서 읽으며, values 스트림은 num_rows개 행으로 이루어진 표준 String 컬럼입니다.
JSON 값 '{"a":1}' (1개 행):
{"a":1} 형태로 출력되며, 정수는 정수 그대로 유지됩니다. 이 텍스트는 단순한 String 값이므로 클라이언트는 JSON을 내용 해석 없이 그대로 전달받을 수는 있지만, 개별 경로와 각 경로의 ClickHouse 타입은 복원하지 못합니다. 경로별 타입을 정확하게 보존하려면 아래의 Tier 2 인코딩을 사용해야 합니다.
Variant(T1, T2, …)
판별 공용체(discriminated union)입니다. 각 행은 variant 타입 중 정확히 하나에 해당하는 값을 가지거나 NULL입니다. 모든 행에는 해당 행의 타입을 선택하는 1바이트 **전역 판별자(global discriminator)**가 있으며, 타입별 값은 variant 타입마다 하나의 연속된 구간에 조밀하게 저장됩니다. 타입 문자열:Variant(T1, T2, ...). 서버가 순서를 정규화하므로(variant 타입은 이름순으로 정렬됨), 수신한 타입 문자열에는 타입이 이미 전역 판별자 순서대로 나열되어 있습니다. 즉, 판별자 0은 첫 번째로 나열된 타입을, 1은 두 번째 타입을 선택하는 방식입니다. 255(NULL_DISCRIMINATOR)는 해당 행이 NULL임을 의미합니다. Variant 원소는 절대 Nullable이 아니며, NULL 표현은 판별자가 담당합니다. 예시: Variant(String, UInt64), Variant(Array(UInt8), String).
상태 접두사에는 UInt64 LE 판별자 모드가 담깁니다. 0 = BASIC(모든 행의 판별자를 그대로 기록), 1 = COMPACT(그래뉼 단위 런 렝스 인코딩)입니다. 서버는 native protocol에서 기본적으로 BASIC을 사용하며(use_compact_variant_discriminators_serialization = false), 이 문서에서는 BASIC만 다룹니다.
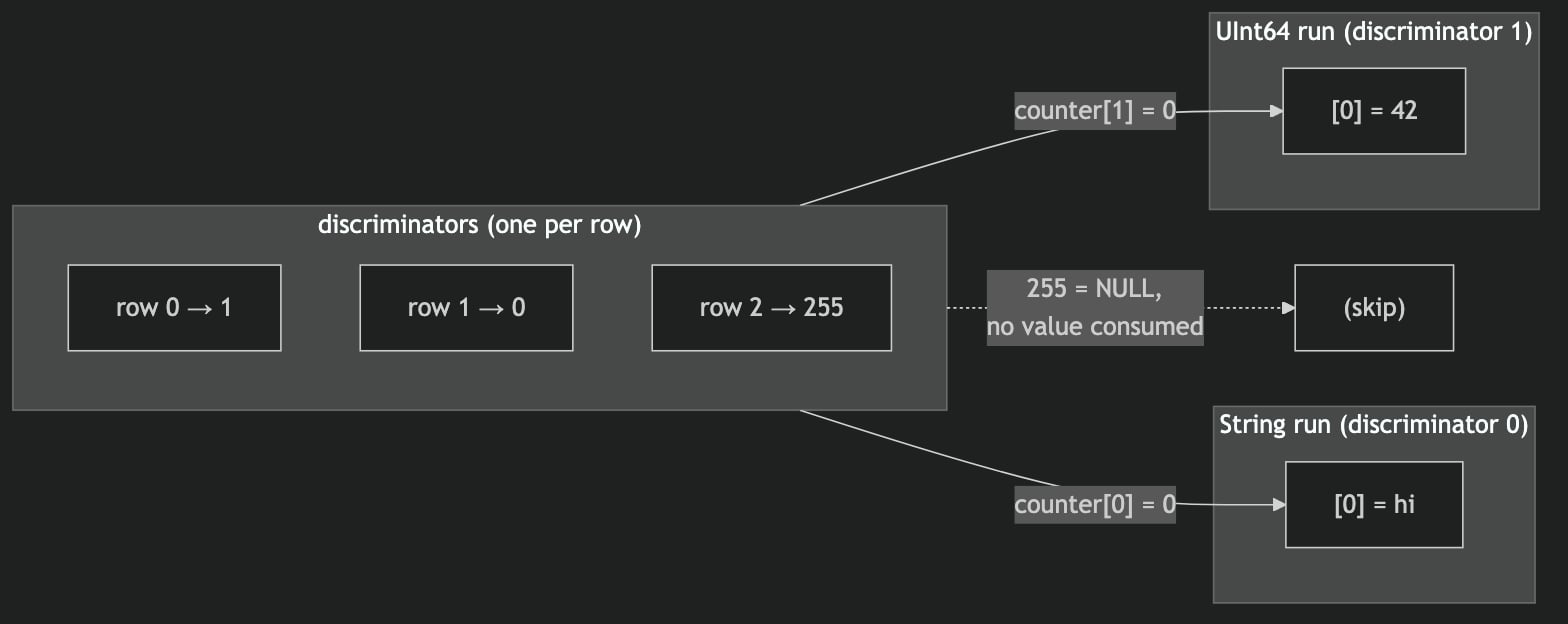
d(≠ 255)인 행 r은 variant 타입 d의 값 연속 구간에서 인덱스 counter[d] 위치의 값을 가져오고, 이후 counter[d]가 1 증가합니다. 판별자가 255인 행은 NULL이며 어떤 구간의 값도 소비하지 않으므로, 타입별 카운터의 합은 non-NULL 행의 개수와 같습니다.
상태 접두사(모드 UInt64)는 행이 1개 이상인 모든 블록의 시작 부분에서 읽습니다. 헤더 블록과 빈 블록은 아무것도 출력하지 않습니다. non-NULL 판별자는 모두 variant 타입의 개수보다 작으며, variant 타입 i는 정확히 count[i]개의 행만큼 디코딩됩니다.
자체적으로 상태 유지형인 Variant 원소(
LowCardinality, Variant, Dynamic, JSON)는 모드 UInt64 다음에 오는 원소별 상태 prefix 단계에서 자체 상태 접두사를 출력합니다. 리프 타입과 단순 복합 타입(리프 타입으로 구성된 Array, Tuple, Map)은 상태 접두사가 비어 있으므로 자유롭게 조합할 수 있습니다.[42, 'hi', NULL]인 Variant(String, UInt64)의 예시입니다(정규 순서에서는 String이 UInt64보다 앞에 정렬되므로 판별자 0 = String, 1 = UInt64):
42; 행 1 = String 구간[0] = "hi"; 행 2 = NULL.
판별자(discriminator) 스트림 자체가 인덱스 역할을 합니다. NULL이 아닌 판별자는 각각 해당 타입의 밀집 구간에서 다음 값을 가져오고, 255(NULL)는 아무 값도 소비하지 않습니다. Dynamic도 동일한 순회 방식으로 복원되며, NULL을 인코딩하는 방식만 다릅니다.
Dynamic
값의 타입이 런타임에 결정되는 컬럼입니다. 각 행은 런타임에 결정되는 타입 집합 중 하나에 속하는 값 또는 NULL을 가집니다.Variant와 달리 타입 집합은 컬럼의 타입 문자열에 포함되지 않으며, 상태 접두사를 통해 전달됩니다.
타입 문자열: Dynamic 또는 Dynamic(max_types=N). max_types 매개변수는 컬럼이 추적하는 서로 다른 타입의 최대 개수를 제한하지만, 아래의 wire 형식에는 영향을 주지 않습니다.
Dynamic에는 V1 = 1, V2 = 2, FLATTENED = 3, V3 = 4의 4가지 인코딩이 있습니다. 서버가 어떤 인코딩을 내보내는지는 채널과 쿼리 설정에 따라 달라집니다.
clickhouse-client및 HTTPFORMAT Native에서는 writer의 revision이0이므로(client_protocol_version으로 올리지 않는 한) 기본값은 V1입니다.- 네이티브 TCP 프로토콜에서 협상된 revision을 사용하면 기본값은 V2입니다.
Nativewriter는 통계를 비활성화하므로 기본V2payload에는 variant별 통계가 포함되지 않으며, 타입 목록 바로 뒤에 중첩된Variant접두사와 데이터가 이어집니다. (variant별 통계는 MergeTree의 디스크 저장 형식에 해당하는 사항이며 Native wire에는 포함되지 않습니다.) - 쿼리 설정
output_format_native_use_flattened_dynamic_and_json_serialization = 1은 위 두 경우를 모두 재정의하며, revision과 관계없이 FLATTENED (version 3)를 내보냅니다.
범위이 페이지에서는
FLATTENED 레이아웃만 다룹니다. 평탄화되지 않은 V1/V2/V3 바이너리 레이아웃은 내부/디스크 저장용 표현(바이너리로 인코딩된 타입 목록, variant별 통계)이므로 여기에서는 다루지 않습니다. 이 페이지를 기준으로 Dynamic을 디코딩하려는 클라이언트는 output_format_native_use_flattened_dynamic_and_json_serialization = 1을 설정하여 FLATTENED를 요청해야 하며, 아래 레이아웃은 이 설정을 전제로 합니다. 버전 바이트가 접두사의 맨 앞에 오므로 디코더는 실제로 수신한 인코딩을 판별할 수 있으며, FLATTENED만 구현한 경우 V1/V2/V3를 거부할 수 있습니다.num_types개의 타입과 NULL 슬롯을 인덱싱할 수 있는 가장 작은 부호 없는 정수입니다. num_types ≤ 255이면 UInt8이고, 그보다 크면 차례로 UInt16, UInt32, UInt64를 사용합니다. NULL은 판별자 값 num_types 자체로 표현되며, NULL이 고정값 255인 Variant와는 이 점이 다릅니다. 재구성 방식은 Variant와 동일한 밀집(dense) 순회입니다. 타입별 카운터를 유지하며, 판별자가 d(≠ num_types)인 행 r은 타입 d의 연속 구간에서 counter[d]번째 값을 가져옵니다.
상태 접두사(버전 + 타입 목록)는 행 수가 0보다 큰 모든 블록의 시작 부분에서 읽습니다. 헤더 블록과 빈 블록에서는 아무것도 출력되지 않습니다.
잘못된 개수 값
num_types는 타입 이름보다 먼저 스트림에서 읽힙니다. 디코더는 이 값을 신뢰할 수 없는 값으로 취급해야 하며, 할당 크기를 정하는 데 직접 사용해서는 안 됩니다. SIZE_MAX에 가까운 개수(중간 연산에서 오버플로우가 발생하거나 DB::Exception이 아닌 예외가 발생할 수 있음)는 물론이고, 100000000처럼 크지만 표현 가능한 개수(벡터의 max_size()보다 훨씬 작지만 타입 이름을 하나도 읽기 전에 수 기가바이트를 할당하게 됨)도 마찬가지입니다. ClickHouse는 상한이 정해진 사전 할당 힌트만 사용하여 타입 목록을 엔트리 단위로 하나씩 읽습니다. 따라서 손상된 num_types는 INCORRECT_DATA(개수가 컨테이너가 담을 수 있는 범위를 초과하는 경우 “Dynamic column has too many types”)로 거부되거나, 스트림에서 타입 엔트리가 바닥나는 시점에 일반적인 읽기 오류로 거부되며, 메모리 부족 오류로 이어지는 일은 없습니다.다만 flattened num_types를 ColumnDynamic::MAX_DYNAMIC_TYPES_LIMIT(ClickHouse에서는 254)로 제한해서는 안 됩니다. flattened 타입 목록에는 공유 variant로 넘친 타입을 포함한 모든 고유 런타임 타입이 담기므로, 유효한 flattened 블록에 이보다 훨씬 많은 타입이 나열되는 것은 정상입니다. MAX_DYNAMIC_TYPES_LIMIT 경계는 non-flat V1/V2/V3 접두사의 num_dynamic_types 개수에만 적용됩니다. 이 값은 일반 variant 슬롯 수를 나타내며 해당 한도를 상한으로 합니다(ClickHouse는 공유 variant를 위한 + 1을 더하기 전에 이 값을 검사합니다).잘린 스트림판별자 구간에는 정확히
num_rows개의 엔트리가 담기며, 디코더는 스트림에 들어 있는 만큼을 그대로 받아들이지 말고 실제로 그만큼 읽었는지 확인해야 합니다. 구간이 더 짧더라도 뒤따르는 내용과 모순이 생기지는 않습니다. 타입별 값 개수는 실제로 읽은 판별자에서 도출되므로 값 구간과 계속 일치하며, NULL 마커로만 이루어진 구간은 값 바이트를 전혀 필요로 하지 않기 때문입니다. 재구성된 컬럼은 실제 크기와 관계없이 num_rows개 행으로 사용되므로, ClickHouse는 타입별 검사보다 먼저 짧은 판별자 구간을 INCORRECT_DATA(“Mismatch in flattened Dynamic column: N rows are expected, but the indexes stream contains only M rows”)로 거부합니다.직렬화가 상태 유지형인 런타임 타입(
LowCardinality, Variant, Dynamic, JSON)은 타입 이름 목록 뒤에 중첩된 상태 접두사를 포함합니다.Variant 정규화를 따릅니다. 즉, 일반 variant 슬롯은 DataTypeVariant(타입 이름) 순서로 기록되므로 wire order는 삽입 순서와 다릅니다. 그러나 목록이 항상 전역적으로 정렬되어 있는 것은 아닙니다. 공유 variant로 넘친 타입(예: Dynamic(max_types=N) 사용 시)은 일반 슬롯 뒤에 처음 등장한 순서대로 추가되므로, 목록의 뒷부분은 타입 이름 순서를 벗어날 수 있습니다. 따라서 디코더는 판별자 할당 시 전송된 타입 목록을 그대로 기준으로 삼아야 하며, 임의로 다시 정렬해서는 안 됩니다. 반면 목록에 중복된 타입이나 Nothing이 포함되어서는 안 됩니다. 동일한 두 엔트리는 하나의 판별자에 매핑되고 Nothing은 애초에 variant가 아니므로, 어느 경우든 목록의 일부를 재구성할 대상이 없기 때문입니다. ClickHouse는 두 경우 모두 INCORRECT_DATA로 거부합니다. 행 [42::UInt64, "hi", NULL]에서 두 타입은 String과 UInt64이고 "String"이 "UInt64"보다 먼저 정렬되므로, 판별자는 0 = String, 1 = UInt64, 2 = NULL입니다:
42; 행 1 = String 구간[0] = "hi"; 행 2 = NULL. 타입별 구간은 타입 목록과 동일한 wire 순서를 따릅니다(String이 UInt64보다 앞에 옴).
JSON (Tier 2: FLATTENED Object)
더 풍부한 JSON 인코딩입니다. 모든 값을 텍스트로 평탄화하는 방식(Tier 1)과 달리, 컬럼을 JSON 경로별 서브컬럼으로 분할합니다. 이 인코딩은 flattened 직렬화 플래그가 켜진 상태(output_format_native_use_flattened_dynamic_and_json_serialization = 1)에서 Tier 1 폴백을 요청하지 않으면(output_format_native_write_json_as_string = 0) 선택되며, 이때 서버는 직렬화 버전 3을 전송합니다.
경로에는 두 가지 종류가 있습니다.
- **타입이 지정된 경로(Typed paths)**는 타입 문자열에 선언되며(예:
JSON(a UInt32, b String)), 선언된 타입으로 디코딩됩니다. 점이 포함된 경로 이름은 타입 문자열에서 백틱으로 감쌉니다. - **동적 경로(Dynamic paths)**는 런타임에 발견되며, 각각 Dynamic 컬럼으로 디코딩됩니다.
num_rows개의 값으로 구성된 전체 컬럼입니다.
Dynamic 접두사(접두사 단계)는 해당 데이터(데이터 단계)와 떨어져 있습니다. 상태 접두사는 행 수가 0보다 큰 모든 블록의 시작 부분에서 읽으며, 모든 경로 컬럼(타입이 지정된 경로와 동적 경로 모두)은 정확히 num_rows개의 값을 가집니다. 행 r의 객체는 각 경로에서 인덱스 r의 값을 읽어 조립합니다. 해당 행에서 Dynamic 판별자가 NULL인 동적 경로는 키를 추가하지 않습니다. 동적 경로 이름은 서로 중복되어서는 안 되며, 타입 문자열에서 이미 타입이 지정된 경로로 선언한 경로와도 겹쳐서는 안 됩니다. 어느 경우든 조립된 객체의 한 키에 값이 두 개 생기므로, ClickHouse는 두 경우 모두 INCORRECT_DATA로 거부합니다. 비평탄(non-flat) 인코딩의 동적 경로 목록에도 동일한 규칙이 적용됩니다.
잘못된 개수 값여기서 설명하는 FLATTENED 레이아웃의
num_dynamic_paths와 비평탄 V1/V2 인코딩의 동적 경로 개수는 경로 이름보다 먼저 스트림에서 읽습니다. (비평탄 접두사에는 별도의 평탄화된 경로 필드가 없으며, 동적 경로 개수와 V1에서 읽은 뒤 버리는 max_dynamic_paths 값만 포함됩니다.) Dynamic과 마찬가지로, 디코더는 이러한 개수 값을 신뢰할 수 없는 값으로 취급해야 하며, 이 값을 그대로 메모리 할당 크기로 사용해서는 안 됩니다. SIZE_MAX 계열의 값이든, 표현 가능하지만 큰 값이든 마찬가지입니다. ClickHouse는 상한이 있는 사전 할당 힌트만 사용하여 경로 이름을 한 엔트리씩 읽으므로, 손상된 개수 값은 INCORRECT_DATA(컨테이너가 수용할 수 있는 범위를 초과하는 경우 “JSON/Object column has too many paths”)로 거부되거나, 스트림에서 경로 이름이 바닥나는 시점에 일반 읽기 오류로 거부됩니다.잘린 스트림경로 컬럼별
num_rows개의 값은 상한이 아니라 반드시 충족해야 하는 요구 사항입니다. 디코더는 스트림이 올바른 위치에서 끝날 것이라고 가정하지 말고, 타입이 지정된 경로와 동적 경로를 포함한 모든 경로 컬럼을 블록의 행 수와 대조하여 검사해야 합니다. 조립된 객체에는 비교 기준이 될 별도의 크기 정보가 없습니다. 객체의 행 수는 평탄화 해제 결과에 따라 정해지므로, 값이 부족한 경로 컬럼은 나중에 감지할 수 없으며 해당 컬럼의 행 r을 읽으면 컬럼의 끝을 넘어서게 됩니다. ClickHouse는 이를 INCORRECT_DATA(“Unexpected size of typed path / flattened path p in flattened Object column”)로 거부합니다. 동적 경로에는 해당 Dynamic 컬럼 내부의 동일한 검사에 더해 이 검사가 추가로 수행됩니다.JSON 값 {"a": 42, "b": "hi"}(1개의 행, 두 경로 모두 동적)의 예입니다. JSON 정수는 Int64로 추론됩니다:
JSON non-flat (V1/V2)
평탄화되지 않은(non-flattened)Object 인코딩은 flattened 플래그가 꺼져 있을 때 서버가 wire 상에서 내보내는 형식입니다. clickhouse-client / HTTP FORMAT Native(revision 0)에서는 V1이, 네이티브 TCP 프로토콜에서는 V2가 사용됩니다. (세 번째 non-flat 인코딩인 V3는 MergeTree 파트에만 기록되며 wire 상에서는 거부됩니다.) 이 인코딩들은 shared data 컬럼을 포함하며, 이 페이지에서는 다루지 않습니다. 또한 Native wire 상에서는 경로별 통계(statistics)를 포함하지 않는다는 점에 유의하십시오. NativeWriter는 통계를 비활성화한 상태로 두므로 Object 구조체 접두사에는 통계 섹션이 없고, 그 바로 뒤에 타입이 지정된/동적/shared data 프리픽스와 데이터가 이어집니다. 통계는 통계를 활성화한 MergeTree 온디스크 경로에만 나타납니다. 이 페이지를 참고하여 JSON 컬럼을 디코딩하려면 클라이언트는 문서에 설명된 단계 중 하나를 선택해야 합니다. String 폴백을 사용하려면 output_format_native_write_json_as_string = 1을 설정하고, FLATTENED Object 레이아웃을 사용하려면 output_format_native_write_json_as_string = 0과 함께 output_format_native_use_flattened_dynamic_and_json_serialization = 1을 설정하십시오.
압축 프레임
ClickHouse는 내부 프레임 포맷을 사용하여Native 스트림의 컬럼 데이터를 압축할 수 있습니다. 아래의 프레임 레이아웃은 전송 방식과 무관합니다. 즉, 네이티브 TCP 프로토콜과 HTTP 모두에서 동일한 프레임이 사용되지만, 압축을 요청하는 방법과 프레임을 둘러싼 구조는 전송 방식에 따라 다릅니다.
- 네이티브 TCP 프로토콜. 압축은 Query 패킷의
compression플래그를 통해 쿼리별로 선택하여 활성화합니다. 압축이 활성화되면 각Data,Totals,Extremes,Log,ProfileEvents패킷의 body, 즉table_name문자열 뒤의 바이트가 프레임 포맷으로 감싸집니다. 패킷 엔벌로프 자체, 즉 패킷 유형 코드와table_name문자열은 압축되지 않으며, 서버는 이를 원시 스트림에 그대로 기록합니다.NativeWriter가 출력하는 모든 내용은 압축 스트림에 기록되므로,BlockInfo접두사는 차원 및 컬럼과 함께 프레임 내부에 위치하며 그중 가장 앞에 옵니다. 따라서 클라이언트는BlockInfo를 읽으려면 먼저 프레임의 압축을 해제해야 합니다. - HTTP.
SELECT ... FORMAT Native&compress=1은FORMAT Native바이트 스트림 전체를 동일한 프레임으로 감싸며(서버는 동일한 내부CompressedWriteBuffer를 사용합니다),?decompress=1은Native입력 body가 동일한 프레임으로 구성되어 있다고 간주하고 이에 대응하는CompressedReadBuffer로 디코딩합니다. 이 경로에는 TCP 패킷 유형,table_name, 패킷 엔벌로프가 없으며, 압축된 payload 전체가 프레임으로 감싼Native블록으로만 이루어집니다(위의 비압축 레이아웃과 마찬가지로BlockInfo접두사는 협상된 revision이0보다 큰 경우에만 포함됩니다). 이 내부compress/decompress프레이밍은 HTTP 전송 압축(Content-Encoding: gzip/zstd,enable_http_compression으로 활성화)과는 별개입니다. HTTP 전송 압축은 HTTP 계층에서 응답을 감싸는 방식으로, 아래에서 설명하는 프레임 포맷과는 다릅니다.
FORMAT Native 레이아웃만 구현한 클라이언트는 압축된 HTTP Native 응답을 읽거나 decompress=1 요청 body를 전송하려면 이 프레임 계층을 추가로 구현해야 합니다.
프레임 포맷
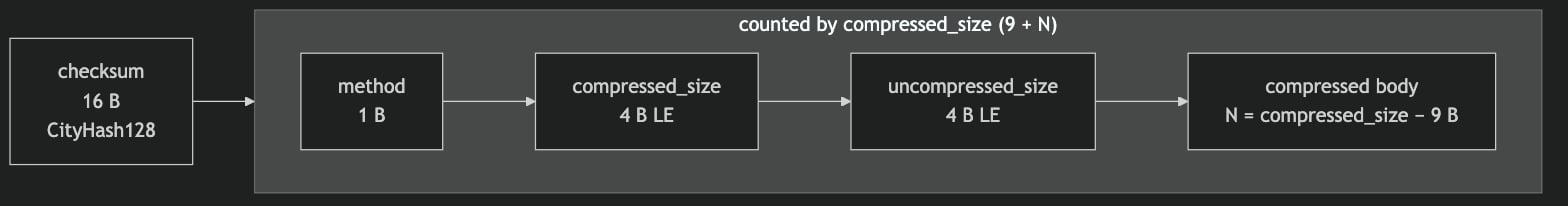
16 + compressed_size = 16 + 9 + body_size = 25 + body_size입니다. 여기서 두 범위가 서로 다르다는 점에 유의하십시오. 체크섬은 9바이트 헤더와 body를 대상으로 계산되며, compressed_size도 헤더와 body를 포함하지만 체크섬 자체는 포함하지 않습니다.
메서드 바이트 값
다음 세 가지 코덱은 서버가 스트림 전체에 대한Native 프레이밍에서 생성하는 코덱입니다. HTTP compress=1 출력은 서버의 기본 코덱(ZSTD(3))을 사용하고, 네이티브 TCP 프로토콜은 network_compression_method에 따라 LZ4, ZSTD 또는 NONE을 사용합니다. 범용 Native 클라이언트는 이 세 가지만 생성하고 처리할 수 있으면 됩니다.
메서드 바이트는 컬럼 수준 코덱도 인코딩합니다. 이 코덱들은 스트림 전체 프레이밍이 아니라 MergeTree 디스크 저장 경로에서 컬럼별로 적용됩니다. 하지만
decompress=1 HTTP 입력 경로는 각 프레임의 메서드 바이트를 보고 코덱을 결정하므로, 이러한 바이트도 입력에 정상적으로 나타날 수 있습니다. 따라서 규격을 준수하는 디코더는 할당된 값 공간 전체를 인식해야 하며, 구현하지 않은 바이트를 만나면 body를 잘못 해석하지 말고 거부해야 합니다. 이들 코덱의 body 형식은 코덱마다 다르며 이 범용 프레임 규약의 범위에 포함되지 않습니다.
DoubleDelta(0x94)는 2차 차분을 MSB 우선 방식의 접두사/부호/크기 비트로 저장합니다. 워드 단위로 디코딩하더라도 이 인코딩 방식, 요소 개수, 마지막 바이트 패딩은 그대로 유지됩니다.
0x9c(ALP)는 Float32 및 Float64용 베타 무손실 코덱(적응형 무손실 부동소수점 압축)입니다. CODEC(ALP)로 테이블을 생성하려면 enable_alp_codec 설정이 활성화되어 있어야 하지만, 이전에 기록된 데이터를 계속 읽을 수 있도록 압축 해제 시에는 이 메서드 바이트가 항상 허용됩니다. 0x9d(SZ3)는 Float32, Float64 및 해당 타입의 Array를 위한 실험적 오차 한정 손실 코덱입니다. CODEC(SZ3)로 테이블을 생성하려면 enable_sz3_codec 설정이 활성화되어 있어야 하지만, 이전에 기록된 데이터를 계속 읽을 수 있도록 압축 해제 시에는 이 메서드 바이트가 항상 허용됩니다. 0x9f(ZXC)는 실험적 비대칭 LZ 코덱으로, 압축은 느리지만 압축 해제는 매우 빠르며 압축률은 LZ4와 ZSTD의 중간 수준입니다. CODEC(ZXC)로 테이블을 생성하려면 enable_zxc_codec 설정이 활성화되어 있어야 하지만, 이전에 기록된 데이터를 계속 읽을 수 있도록 압축 해제 시에는 이 메서드 바이트가 항상 허용됩니다. 바이트 0x99(DeflateQpl)와 0x9b(ZSTD_QPL)는 현재 제거된 코덱에 할당되었던 값으로, 예약된 상태이며 재사용되지 않습니다.
0x9e(Quantized)는 밀집 벡터 컬럼(Array(Float32) 등)을 위한 실험적 컬럼 코덱입니다. NONE과 마찬가지로 패스스루 코덱이므로 원래 정밀도의 body가 그대로 저장되지만, 이 코덱을 지정하면 벡터 검색 가속에 사용되는 압축된 양자화 보조 스트림을 기록하는 직렬화가 함께 연결됩니다. CODEC(Quantized(...))로 테이블을 생성하려면 enable_quantized_codec 설정이 활성화되어 있어야 하며, 압축 해제 시에는 이 메서드 바이트가 항상 허용됩니다.
체크섬
ClickHouse는 최신 Google CityHash가 아닌 CityHash v1.0.2(과거 버전)를 사용하며, 두 버전의 출력 결과는 서로 다릅니다. 체크섬은 9바이트의 헤더(method + compressed_size + uncompressed_size)와 N바이트의 body, 즉 체크섬 바로 뒤부터 프레임 끝까지의 모든 바이트를 대상으로 계산합니다. 16바이트 CityHash128 출력 중 처음 8바이트는 하위 절반(LE)이고, 다음 8바이트는 상위 절반(LE)입니다. 디코더는 수신한 헤더와 body로 CityHash128을 다시 계산한 뒤 앞쪽 16바이트와 비교합니다. 값이 일치하지 않으면 데이터 손상으로 간주하며 디코딩은 실패합니다.블록별 경계
블록의 압축된 payload는 단일 프레임이라는 보장이 없으며, 하나 이상의 프레임으로 이루어진 스트림입니다. 송신 측은 직렬화된 블록을CompressedWriteBuffer를 통해 기록합니다. 이 버퍼는 내부 버퍼가 가득 찰 때마다(약 1 MB, DBMS_DEFAULT_BUFFER_SIZE) 프레임을 하나씩 내보내고, 블록이 플러시될 때 마지막 프레임을 내보냅니다. 따라서 작은 블록은 하나의 프레임이 되고, 큰 블록은 여러 개의 연속된 프레임이 됩니다.
이 불변식은 한 방향으로만 성립합니다. 송신 측이 각 블록의 끝에서 압축 버퍼를 플러시하므로 모든 블록의 끝은 프레임 경계와 일치하지만, 그 역은 성립하지 않습니다. 블록을 기록하는 도중에 버퍼가 가득 차서 생긴 중간 프레임 경계는 블록의 중간에 위치하므로 블록 경계가 아닙니다. 따라서 디코더는 블록 자체의 차원 정보(num_columns/num_rows)를 사용하여 블록이 끝나는 위치를 판단해야 하며, 각 프레임이 하나의 완전한 블록이라고 가정해서는 안 됩니다.
수신 측은 프레임을 스트리밍 방식으로 처리합니다. 16 + 9바이트를 읽고, 정확히 compressed_size - 9바이트의 body를 읽은 다음, 이를 정확히 uncompressed_size바이트로 압축 해제하여 블록 디코더에 전달합니다. 디코더가 현재 프레임에 담긴 것보다 많은 데이터를 필요로 하면 다음 프레임을 가져옵니다. 송신 측이 블록 단위로 플러시하므로, 블록 하나가 완전히 디코딩되면 프레임 버퍼는 비어 있게 되고 다음 블록은 새 프레임에서 시작합니다.
네이티브 TCP 프로토콜에서는 패킷 엔벌로프(패킷 유형 VarUInt와 table_name 문자열)가 압축된 payload 바깥의 원시 스트림에 기록되며, 블록 body(BlockInfo + 컬럼)만 프레임으로 구성됩니다. HTTP compress/decompress 경로에는 이러한 엔벌로프가 없으며, 스트림 전체가 프레임 단위로 구성된 블록으로 이루어집니다.
협상
네이티브 TCP 프로토콜에서 압축은 연결 단위가 아니라 쿼리 단위로 적용됩니다. Query 패킷의compression: bool 필드는 해당 쿼리 하나에 대해서만 압축을 요청합니다. 서버는 이 요청에 따라 쿼리가 실행되는 동안 압축된 Data/Totals/Extremes/Log/ProfileEvents body를 전송합니다(Log/ProfileEvents는 v54481 이상에서만 해당). 또한 서버는 클라이언트가 송신하는 Data 블록(외부 테이블, 비어 있는 데이터 종료 마커, INSERT 행)도 같은 방식으로 프레임화되어 있을 것으로 예상합니다. 같은 연결에서 이후에 실행되는 쿼리는 압축 여부가 다를 수 있습니다.
HTTP에는 Query 패킷이 없습니다. 대신 compress=1 쿼리 매개변수를 지정하면 해당 요청의 출력이 프레임 형식으로 전송되고, decompress=1을 지정하면 요청 body가 프레임 형식임을 알립니다. compress=1 출력은 network_compression_method가 아닌 서버의 기본 코덱(ZSTD(3))으로 작성됩니다. 반면 decompress=1 리더는 각 프레임의 메서드 바이트에서 코덱을 확인하므로 입력에는 어떤 코덱이든 사용할 수 있습니다.
압축이 활성화된 경우, 서버는 행이 2개 이상인 블록의 컬럼을 병렬 블록 마샬링 /
ColumnBLOB 경로(PARALLEL_BLOCK_MARSHALLING, v54478)로 라우팅할 수도 있습니다. INSERT 데이터를 압축하는 구현체는 스트림 동기화가 어긋나지 않도록 이 경로를 처리하거나 명시적으로 비활성화할 수 있어야 합니다.용어집
블록 — Native 형식에서 데이터를 교환하는 단위입니다. 행들을 컬럼 형식으로 저장한 자기 기술적(self-describing) 청크입니다. 블록 및 컬럼 구조를 참조하십시오. BlockInfo — TCP Data 패킷 경로에서 블록 앞에 오는 메타데이터 헤더입니다(연결 revision이 0보다 크면 항상 기록됩니다). revision에 따라 포함 여부가 결정되며 필드 ID로 태그된 필드들의 시퀀스입니다. revision0으로 직렬화하는 Native 출력 형식에서는 생략됩니다. BlockInfo를 참조하십시오.
컬럼 body — 컬럼에서 컬럼 헤더(이름, 타입, has_custom_serialization 바이트) 뒤에 위치하며 실제 값을 담는 바이트입니다. 레이아웃은 타입마다 다릅니다. 컬럼 wire 레이아웃을 참조하십시오.
Composite type — 하나 이상의 내부 타입으로 구성된 타입으로, 컬럼마다 여러 개의 스트림으로 인코딩됩니다. wire 포맷은 안정적이며 버전 구분이 없습니다. 복합 타입을 참조하십시오.
Dictionary (LowCardinality) — LowCardinality(T) 컬럼이 정수 인덱스로 참조하는 고유 값들의 배열입니다. LowCardinality를 참조하십시오.
Empty 블록 — num_columns = 0이고 num_rows = 0인 블록입니다. 센티널로 사용되며, 클라이언트 측에서는 입력 종료 마커로, 서버 측에서는 스트림 경계 마커로 쓰입니다. 블록 변형을 참조하십시오.
Header 블록 — num_columns > 0이고 num_rows = 0인 블록으로, 서버가 쿼리 응답의 첫 번째 Data 패킷으로 전송합니다. 결과 스키마를 알리는 역할을 합니다. 블록 변형을 참조하십시오.
Inner type — 복합 타입이 감싸는 타입입니다. Array(UInt32)의 내부 타입은 UInt32이고, Nullable(T)의 내부 타입은 T입니다.
Offsets stream — Array, Map, Nested가 행별 요소 경계를 구분하는 데 사용하는 UInt64 배열로, 누적 종료 위치를 담고 있습니다. Array를 참조하십시오.
Placeholder value — Nullable(T) 컬럼의 values 스트림에서 null 위치에 기록되는 바이트입니다. 디코더는 스트림을 앞으로 진행하기 위해 이 바이트를 읽지만 내용은 무시합니다. Nullable을 참조하십시오.
Result 블록 — num_rows > 0이며 실제 쿼리 결과 행을 담고 있는 블록입니다. 블록 변형을 참조하십시오.
Schema 블록 — header 블록과 같은 의미로, INSERT 단계를 설명할 때 사용하는 용어입니다. 이 단계에서 schema 블록은 클라이언트에 예상되는 컬럼 형태를 알려줍니다.
Serialization version — 버전이 있는 타입이 뒤이어 오는 인코딩 변형을 선언하는 데 사용하는 타입별 on-wire 버전 번호입니다. 프로토콜 버전과는 다른 개념입니다. 직렬화 버전: 개념을 참조하십시오.
State prefix — 버전이 있는 타입에서 블록별 페이로드 앞에 오는 바이트입니다. 직렬화 버전과 (LowCardinality의 경우) 블록별 딕셔너리 메타데이터를 담습니다. 행이 1개 이상인 모든 블록의 시작 부분에 기록되며, 다음 블록으로 유지되지 않습니다.
Stream — 컬럼 body 내에서 하나의 논리적 하위 구성 요소(null-map, offsets 배열, values 스트림)를 인코딩하는 연속된 바이트 구간입니다. 다중 스트림 타입은 컬럼마다 2개 이상의 스트림을 이어 붙입니다.