

- UI and Alerting: データのクエリ、ダッシュボードの構築、アラートの管理を行うためのツール。
- Storage and Query Engine: オブザーバビリティデータの保存と分析クエリの実行を担うバックエンドシステム。
- Data Collection and ETL: テレメトリーデータを収集し、インジェスト前に処理するエージェントとパイプライン。
ClickStack は、収集から UI まで一貫して OpenTelemetry ネイティブであり、オープン標準と相互運用性を重視しています。これに対して Elastic は、proprietary なエージェントとフォーマットを備えた、より垂直統合型の密結合なエコシステムを提供します。
Elasticsearch と ClickHouse は、それぞれのスタックにおいてデータの保存、処理、クエリ実行を担う中核エンジンであるため、その違いを理解することは重要です。これらのシステムは、オブザーバビリティアーキテクチャ全体の性能、スケーラビリティ、柔軟性を支えています。次のセクションでは、データモデル、インジェスト処理、クエリ実行、ストレージ管理の違いを含め、Elasticsearch と ClickHouse の主な相違点を詳しく見ていきます。
ClickHouse と Elasticsearch では、データの整理やクエリに用いる基盤となるモデルは異なりますが、多くの中核概念は似た役割を担っています。このセクションでは、Elastic に慣れている方に向けて主要な対応関係を示し、ClickHouse でそれに相当する概念を整理します。用語は異なっていても、オブザーバビリティのワークフローの大半は ClickStack で再現でき、多くの場合、より効率的に実現できます。
Elasticsearch は、dynamic mappings によるスキーマの柔軟性で知られています。フィールドはドキュメントのインジェスト時に作成され、スキーマが指定されていない限り、型は自動的に推論されます。ClickHouse はデフォルトではより厳格で、テーブルは明示的なスキーマで定義されますが、
Dynamic、Variant、JSON 型によって柔軟性も備えています。これらにより、半構造化データを取り込むことができ、Elasticsearch と同様に動的なカラム作成や型推論が可能になります。同様に、Map 型では任意のキー・バリューのペアを格納できますが、キーと値にはそれぞれ単一の型が適用されます。
型の柔軟性に対する ClickHouse のアプローチは、より明示的で制御しやすいものです。型の競合によってインジェストエラーが発生することがある Elasticsearch とは異なり、ClickHouse では Variant カラムに複数の型が混在するデータを格納でき、JSON 型を使ってスキーマの進化にも対応できます。
JSON を使用しない場合、スキーマは静的に定義されます。行に値が指定されていない場合は、Nullable として定義するか (ClickStack では使用されません) 、その型のデフォルト値 (たとえば String なら空文字列) が使用されます。
Elasticsearch では、インデックス作成前にドキュメントを変換するために、プロセッサ (例: enrich、rename、grok) を含む ingest pipeline を使用します。ClickHouse では、同様の機能を インクリメンタルmaterialized view で実現できます。これにより、入力データを フィルタリングや変換 したり、エンリッチ したりして、その結果をターゲットテーブルに insert できます。materialized view の出力のみを保存したい場合は、Null table engine にデータを insert することもできます。つまり、保持されるのは materialized view の結果だけで、元のデータは破棄されるため、ストレージ容量を節約できます。
エンリッチについては、Elasticsearch は、ドキュメントにコンテキストを追加するための専用の enrich processor をサポートしています。ClickHouse では、dictionaries を クエリ時 と インジェスト時 の両方で使用して、行をエンリッチできます。たとえば、IP を場所に対応付ける ことや、INSERT 時に ユーザーエージェントのルックアップ を適用することができます。
Elasticsearch は、DSL、ES|QL、EQL、KQL (Lucene スタイル) クエリを含む、複数のクエリ言語をサポートしていますが、join のサポートは限定的で、ES|QL 経由で利用できるのは left outer joins のみです。ClickHouse は、すべての join タイプ、window functions、サブクエリ (相関サブクエリを含む) 、CTE を含む 完全な SQL 構文 をサポートしています。これは、オブザーバビリティシグナルとビジネスデータまたはインフラストラクチャデータを相関付ける必要がある場合に大きな利点となります。
ClickStack では、ClickHouse バックエンド経由で完全な SQL をサポートするとともに、移行しやすいように Lucene 互換の検索インターフェイスを UI で提供しています。この構文は、Elastic query string の構文に近いものです。この構文の正確な比較については、“Searching in ClickStack and Elastic” を参照してください。
Elasticsearch は JSON (および限定的な CSV サポート) でのインジェストをサポートしています。ClickHouse は Parquet、Protobuf、Arrow、CSV などを含む 70 種類以上のファイルフォーマットをサポートしており、インジェストとエクスポートの両方で利用できます。これにより、外部のパイプラインやツールとの統合が容易になります。
どちらのシステムも REST API を提供していますが、ClickHouse はさらに、低レイテンシかつ高スループットなやり取りのための ネイティブプロトコルも提供しています。ネイティブインターフェイスは、HTTP よりも効率的にクエリの進行状況、圧縮、ストリーミングをサポートしており、ほとんどの本番環境でのインジェストでデフォルトとして使われています。
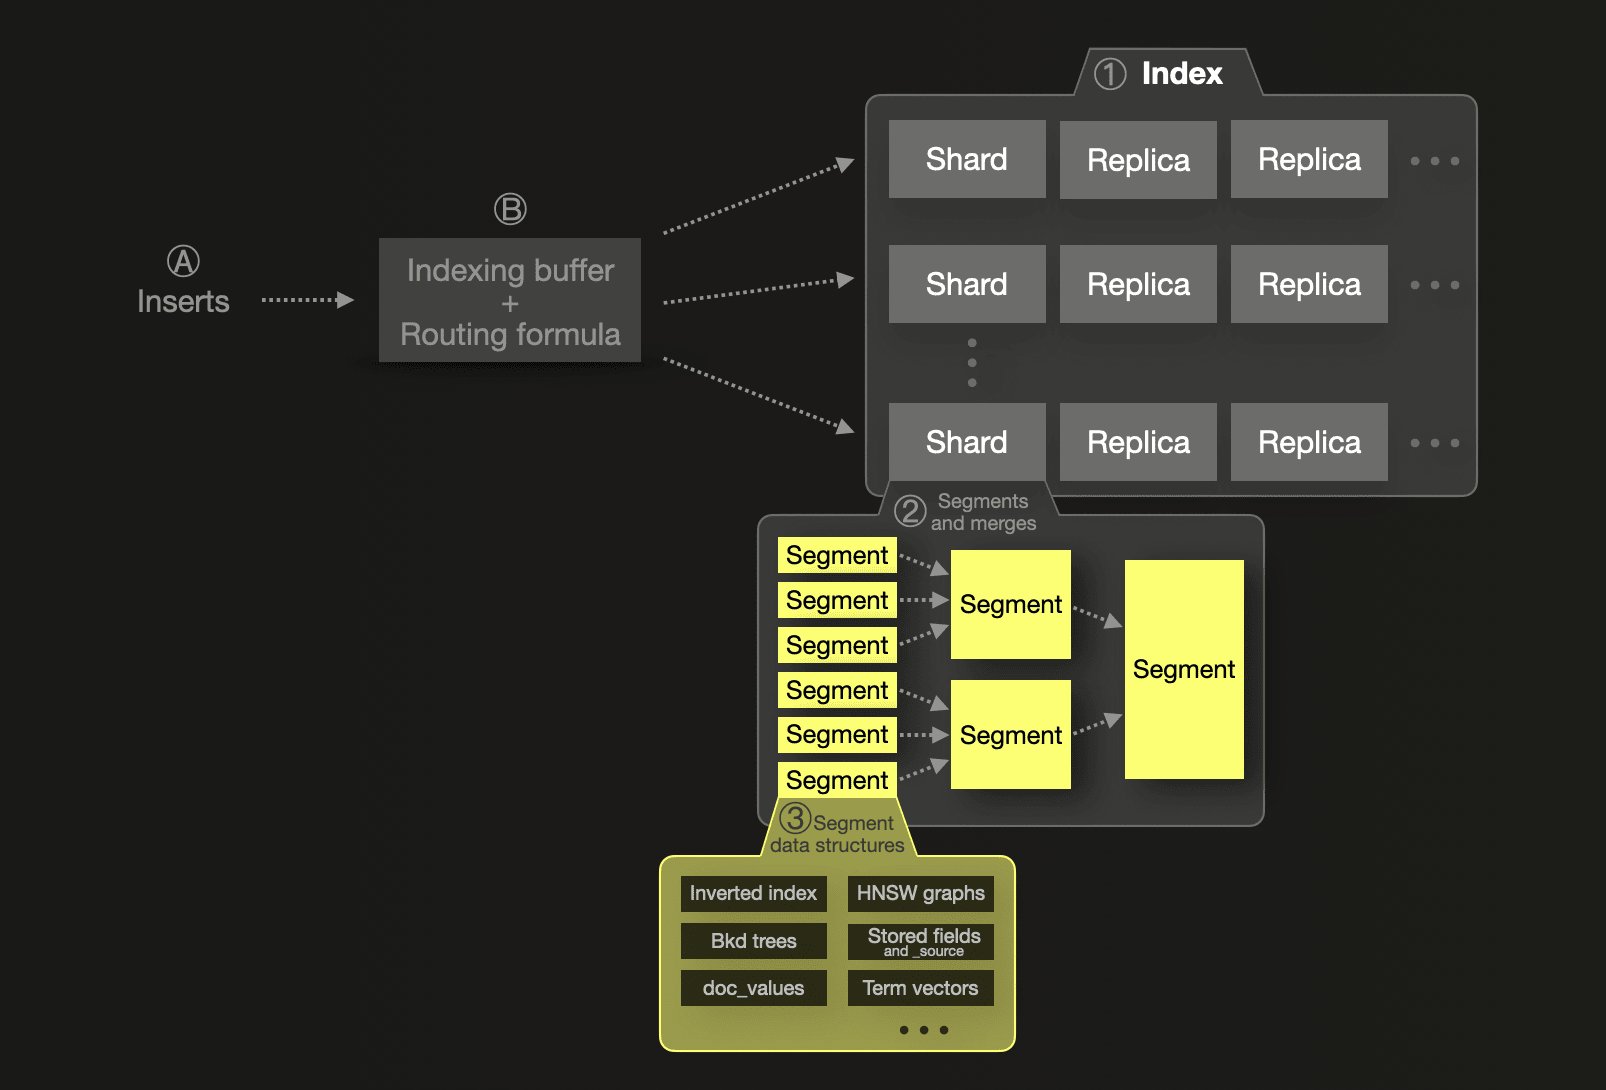
Elasticsearch における挿入処理Ⓐ 新しく挿入されたドキュメントは、まずメモリ内のインデックスバッファに入り、このバッファはデフォルトで 1 秒ごとにフラッシュされます。フラッシュされたドキュメントの送信先分片はルーティング式によって決定され、その分片に対して新しいセグメントがディスクに書き込まれます。クエリ効率を向上させ、削除または更新されたドキュメントを物理的に削除できるようにするため、セグメントはバックグラウンドで継続的により大きなセグメントへマージされ、最大サイズの 5 GB に達するまで統合されます。ただし、より大きなセグメントへのマージを強制することも可能です。
_source に保存する点です (LZ4、Deflate、または ZSTD で圧縮) 。一方、ClickHouse は別個のドキュメント表現を保存しません。データはクエリ時にカラムから再構築されるため、ストレージ容量を節約できます。Elasticsearch でも Synthetic _source を使えば同様のことが可能ですが、いくつかの制約があります。また、_source を無効化することにも、ClickHouse には当てはまらない影響があります。
Elasticsearch では、index mappings (ClickHouse におけるテーブルスキーマに相当) が、フィールドの型と、その永続化およびクエリに使用されるデータ構造を制御します。
これに対して ClickHouse は カラム指向 です。つまり、各カラムは独立して保存されますが、常にテーブルの主キー / ordering key に従ってソートされます。この並び順により、スパースプライマリ索引 が機能し、ClickHouse はクエリ実行時にデータを効率よくスキップできます。クエリが主キーフィールドでフィルタする場合、ClickHouse は各カラムの関連する部分だけを読み取るため、ディスク I/O を大幅に削減し、すべてのカラムに完全な索引がなくても高い性能を実現できます。
_source の JSON 保存にのみ適用されます) 。
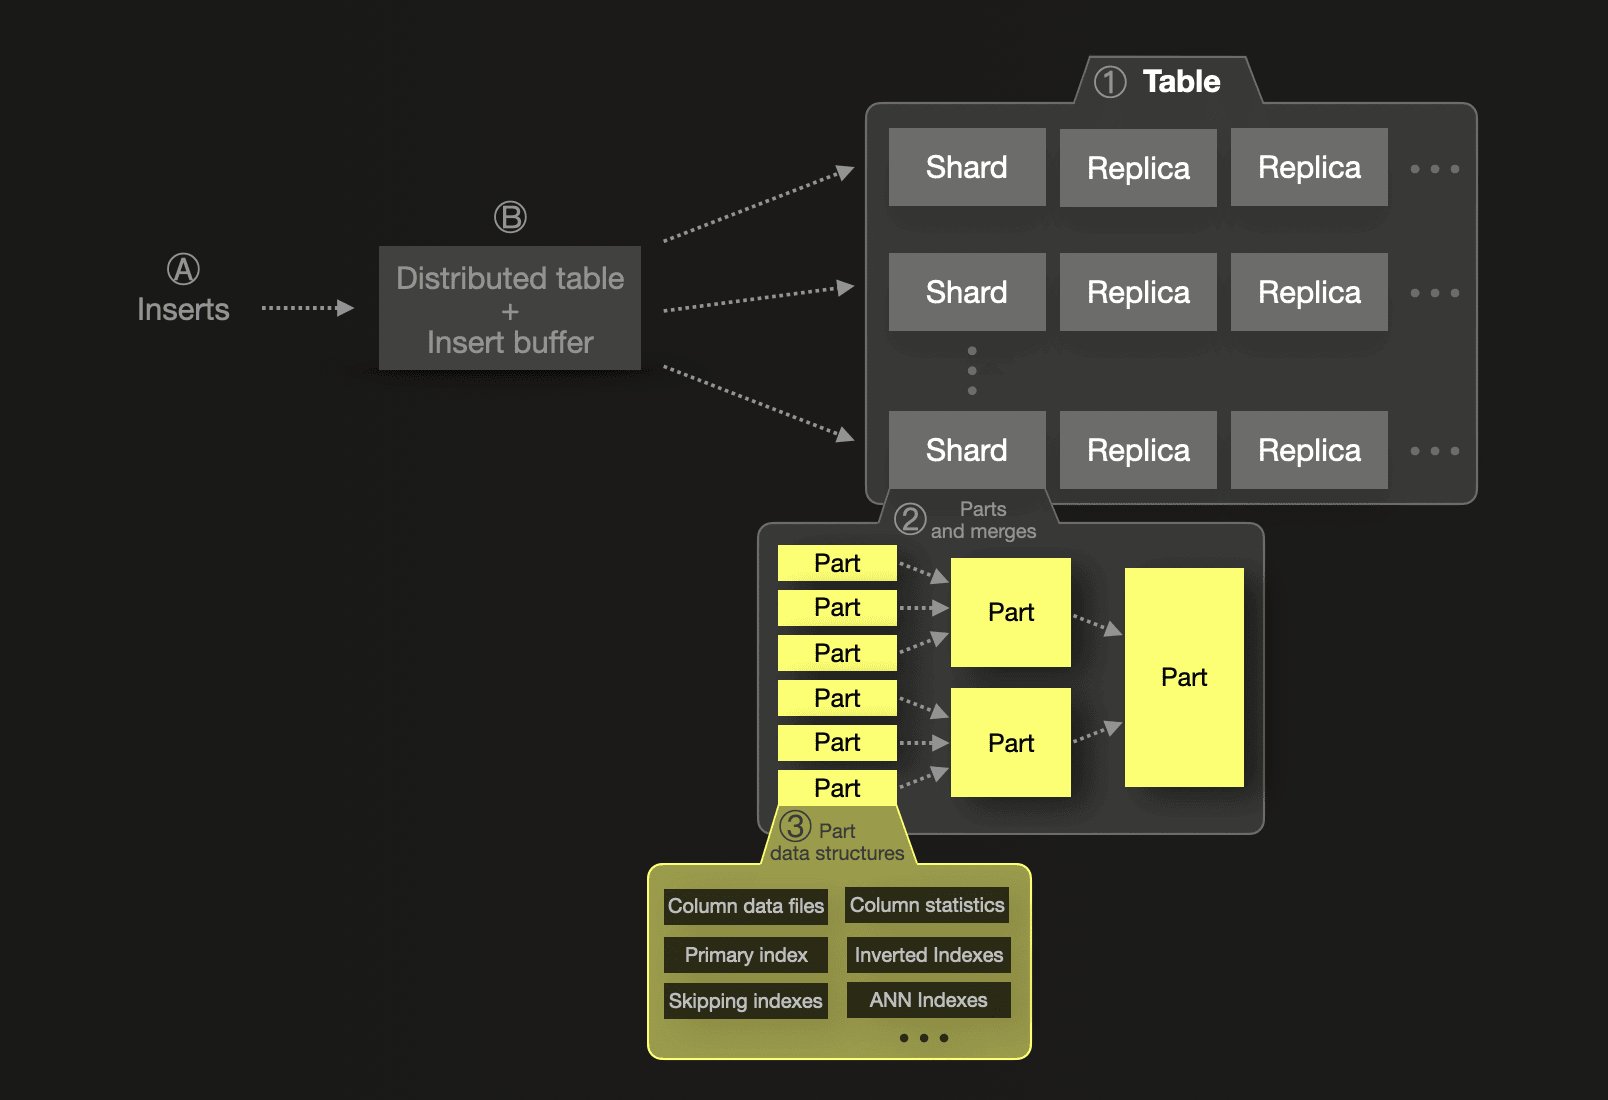
ClickHouse もシャーディングをサポートしていますが、そのモデルは 垂直スケーリング を優先するよう設計されています。単一の分片で 数兆行 を格納でき、メモリ、CPU、ディスクの余力がある限り、高い性能を維持できます。Elasticsearch とは異なり、分片ごとの 厳密な行数上限 はありません。ClickHouse の分片は論理的なもので、実質的には個別のテーブルであり、データセットが単一ノードの容量を超えない限り、パーティション化は不要です。これは通常、ディスク容量の制約によって発生し、その場合にのみ、水平スケールアウトが必要になった時点でシャーディング ① が導入されるため、複雑さとオーバーヘッドを抑えられます。この場合、Elasticsearch と同様に、1 つの分片がデータの一部を保持します。単一の分片内のデータは、③ 複数のデータ構造を含む ② 不変のデータパーツの集合として構成されます。
ClickHouse の分片内の処理は 完全に並列化 されており、ノード間でのデータ移動に伴うネットワークコストを避けるため、できるだけ垂直スケーリングすることが推奨されます。
ClickHouse における挿入処理ClickHouse の挿入は、デフォルトでは同期的 です。つまり、書き込みはコミット後にのみ確認応答されます。ただし、Elastic のようなバッファリングやバッチ処理に合わせて、非同期挿入 に設定することもできます。asynchronous data inserts を使用する場合、Ⓐ 新たに挿入された行はまず Ⓑ メモリ内の挿入バッファに入り、これはデフォルトで 200 ミリ秒ごとにフラッシュされます。複数の分片を使用する場合は、新たに挿入された行を対象の分片へルーティングするために 分散テーブル が使用されます。新しいパーツがその分片のディスク上に書き込まれます。
SELECT クエリをすべての分片に転送して結果をマージします。INSERT 操作では、データを各分片に均等にルーティングして負荷を分散します。ClickHouse のレプリケーションは非常に柔軟で、任意のレプリカ (分片のコピー) が書き込みを受け付けられ、すべての変更は他のレプリカへ非同期に同期されます。このアーキテクチャにより、障害時やメンテナンス中でもクエリ提供を中断せずに済み、再同期も自動で処理されるため、データレイヤーで primary-secondary を強制する必要がありません。
ClickHouse CloudClickHouse Cloud では、アーキテクチャとして shared-nothing のコンピュートモデルが採用されており、単一の 分片がオブジェクトストレージに支えられます。これにより、従来のレプリカベースの高可用性を置き換え、1 つの分片を 複数のノードから同時に読み書きできる ようになります。ストレージとコンピュートを分離することで、明示的なレプリカ管理なしに弾力的なスケーリングが可能になります。
- Elastic: 分片は JVM メモリに結び付いた物理的な Lucene 構造です。分片を過剰に増やすと性能低下を招きます。レプリケーションは同期的で、master node によって調整されます。
- ClickHouse: 分片は論理的で、垂直方向にスケールでき、ローカル実行の効率も非常に高くなっています。レプリケーションは非同期ですが (逐次的にすることも可能) 、協調の仕組みは軽量です。
_id に基づいてドキュメントの重複を排除し、それに応じて分片にルーティングします。ClickHouse はデフォルトの行識別子を保存しませんが、挿入時の重複排除をサポートしているため、失敗した insert を安全に再試行できます。より細かく制御したい場合は、ReplacingMergeTree やその他のテーブルエンジンを使って、特定のカラムに基づく重複排除を行えます。
Elasticsearch のインデックスルーティングでは、特定のドキュメントが常に特定の分片にルーティングされるようになっています。ClickHouse では、分片キーを定義するか、Distributed テーブルを使用することで、同様のデータ局所性を実現できます。
どちらのシステムもデータの集計をサポートしていますが、ClickHouse は統計、近似、特化した分析関数などを含む、より多くの関数を提供しています。
オブザーバビリティのユースケースでは、集計の最も一般的な用途の 1 つは、特定のログメッセージやイベントがどれくらいの頻度で発生するかを数えることです (頻度が異常な場合はアラートします)。
ClickHouse の SELECT count(*) FROM ... GROUP BY ... SQLクエリに相当する Elasticsearch の機能は、terms aggregation で、これは Elasticsearch の bucket aggregation の 1 つです。
ClickHouse の count(*) を使った GROUP BY と Elasticsearch の terms aggregation は、機能面では概ね同等ですが、実装、パフォーマンス、結果の品質には大きな違いがあります。
Elasticsearch におけるこの集計は、クエリ対象のデータが複数の分片にまたがる場合、“top-N” クエリの結果を推定します (たとえば、件数上位 10 件のホスト)。この推定によって速度は向上しますが、正確性が損なわれる可能性があります。この誤差は、doc_count_error_upper_bound を確認し、shard_size パラメータを増やすことで抑えられますが、その代償としてメモリ使用量の増加とクエリパフォーマンスの低下が生じます。
Elasticsearch では、すべてのバケット集約に対して size 設定 も必要です。上限を明示的に設定せずに、すべての一意なグループを返す方法はありません。高カーディナリティの集計では、max_buckets 制限 に達するおそれがあるほか、composite 集約 を使ったページネーションが必要になる場合がありますが、これはしばしば複雑で非効率です。
これに対して ClickHouse は、追加の設定なしで正確な集計を実行します。count(*) のような関数は設定調整を必要とせずに正確な結果を返すため、クエリの挙動がよりシンプルで予測しやすくなります。
ClickHouse には size の制限がありません。大規模なデータセットに対して、上限なしの group-by クエリを実行できます。メモリのしきい値を超えた場合、ClickHouse はディスクにスピルできます。主キーのプレフィックスでグループ化する集計はとくに効率的で、最小限のメモリ消費で実行できることがよくあります。
上記の違いは、Elasticsearch と ClickHouse の実行モデルに起因しています。両者は、クエリ実行と並列化に対して根本的に異なるアプローチを取っています。
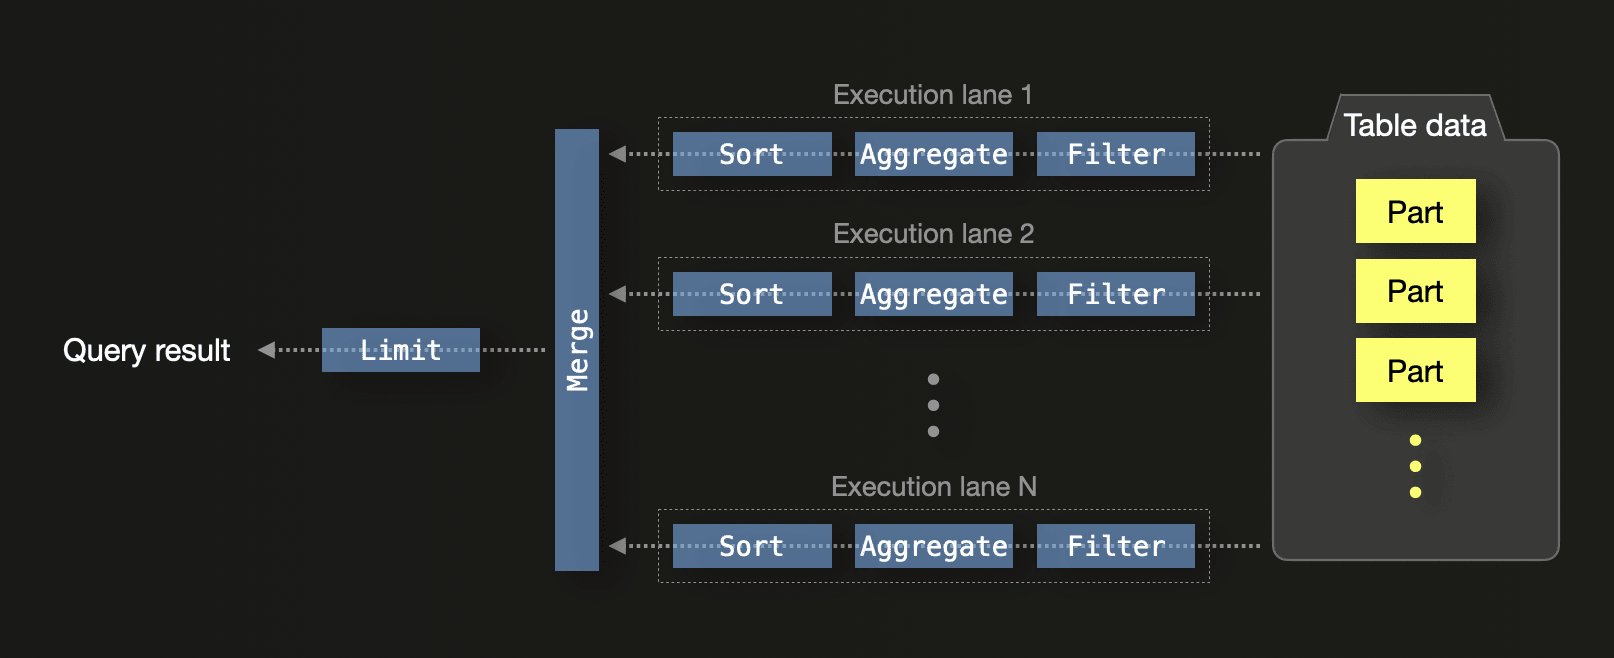
ClickHouse は、最新のハードウェアで効率を最大限に引き出せるよう設計されています。デフォルトでは、ClickHouse は N 個の CPU コアを持つマシン上で、N 本の同時実行レーンを使って SQL クエリを実行します。
- SIMD ベクトル化: 列指向データに対する操作では CPU SIMD 命令 (例: AVX512) を使用し、値をバッチ処理できます。
- クラスター レベルの並列化: 分散構成では、各ノードがローカルでクエリ処理を実行します。部分集計状態 はクエリを開始したノードにストリーミングされ、そこでマージされます。クエリの
GROUP BYキーが分片キーと一致していれば、マージは最小限に抑えるか、完全に回避することも可能です。
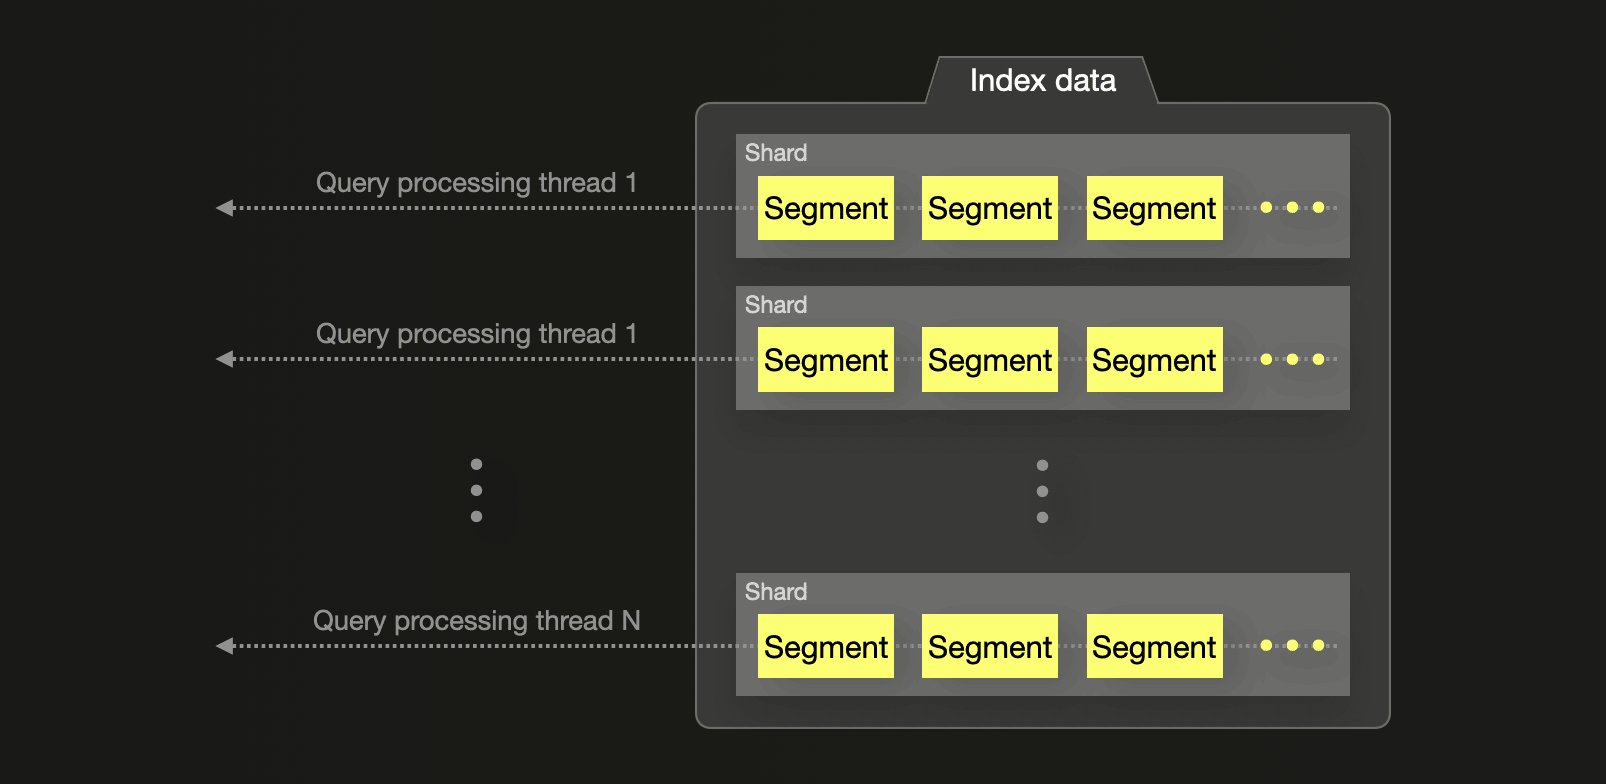
このモデルにより、コアやノードをまたいで効率的にスケールできるため、ClickHouse は大規模な分析処理に適しています。部分集計状態 を使用することで、異なるスレッドやノードからの中間結果を精度を損なうことなくマージできます。 一方 Elasticsearch では、多くの集計で、利用可能な CPU コア数にかかわらず、通常は 1 分片あたり 1 スレッドが割り当てられます。これらのスレッドは分片ローカルな top-N の結果を返し、それがコーディネーティングノードでマージされます。このアプローチでは、システムリソースを十分に活用できないことがあり、特に頻出する項目が複数の分片に分散している場合、グローバル集計で不正確さが生じる可能性があります。精度は
shard_size パラメータを増やすことで向上できますが、その代償としてメモリ使用量とクエリレイテンシが増加します。
MergeTree のようなネイティブのテーブルエンジンによって 階層型ストレージ をサポートしており、カスタムルールに基づいて古いデータを異なる ボリューム (例: SSD から HDD、さらにオブジェクトストレージへ) 間で自動的に移動できます。これにより、Elastic の hot-warm-cold アプローチを再現できますが、複数のノードロールやクラスターを管理する複雑さはありません。
ClickHouse CloudClickHouse Cloud では、これはさらにシームレスです。すべてのデータは オブジェクトストレージ (例: S3) に保存され、コンピュートは分離されています。データはクエリされるまでオブジェクトストレージに保持され、クエリ時にローカル (または分散キャッシュ) に取得されてキャッシュされます。これにより、Elastic の frozen tier と同等のコスト特性を実現しつつ、より優れた性能特性を得られます。このアプローチでは、データをストレージ階層間で移動する必要がないため、hot-warm アーキテクチャは不要になります。
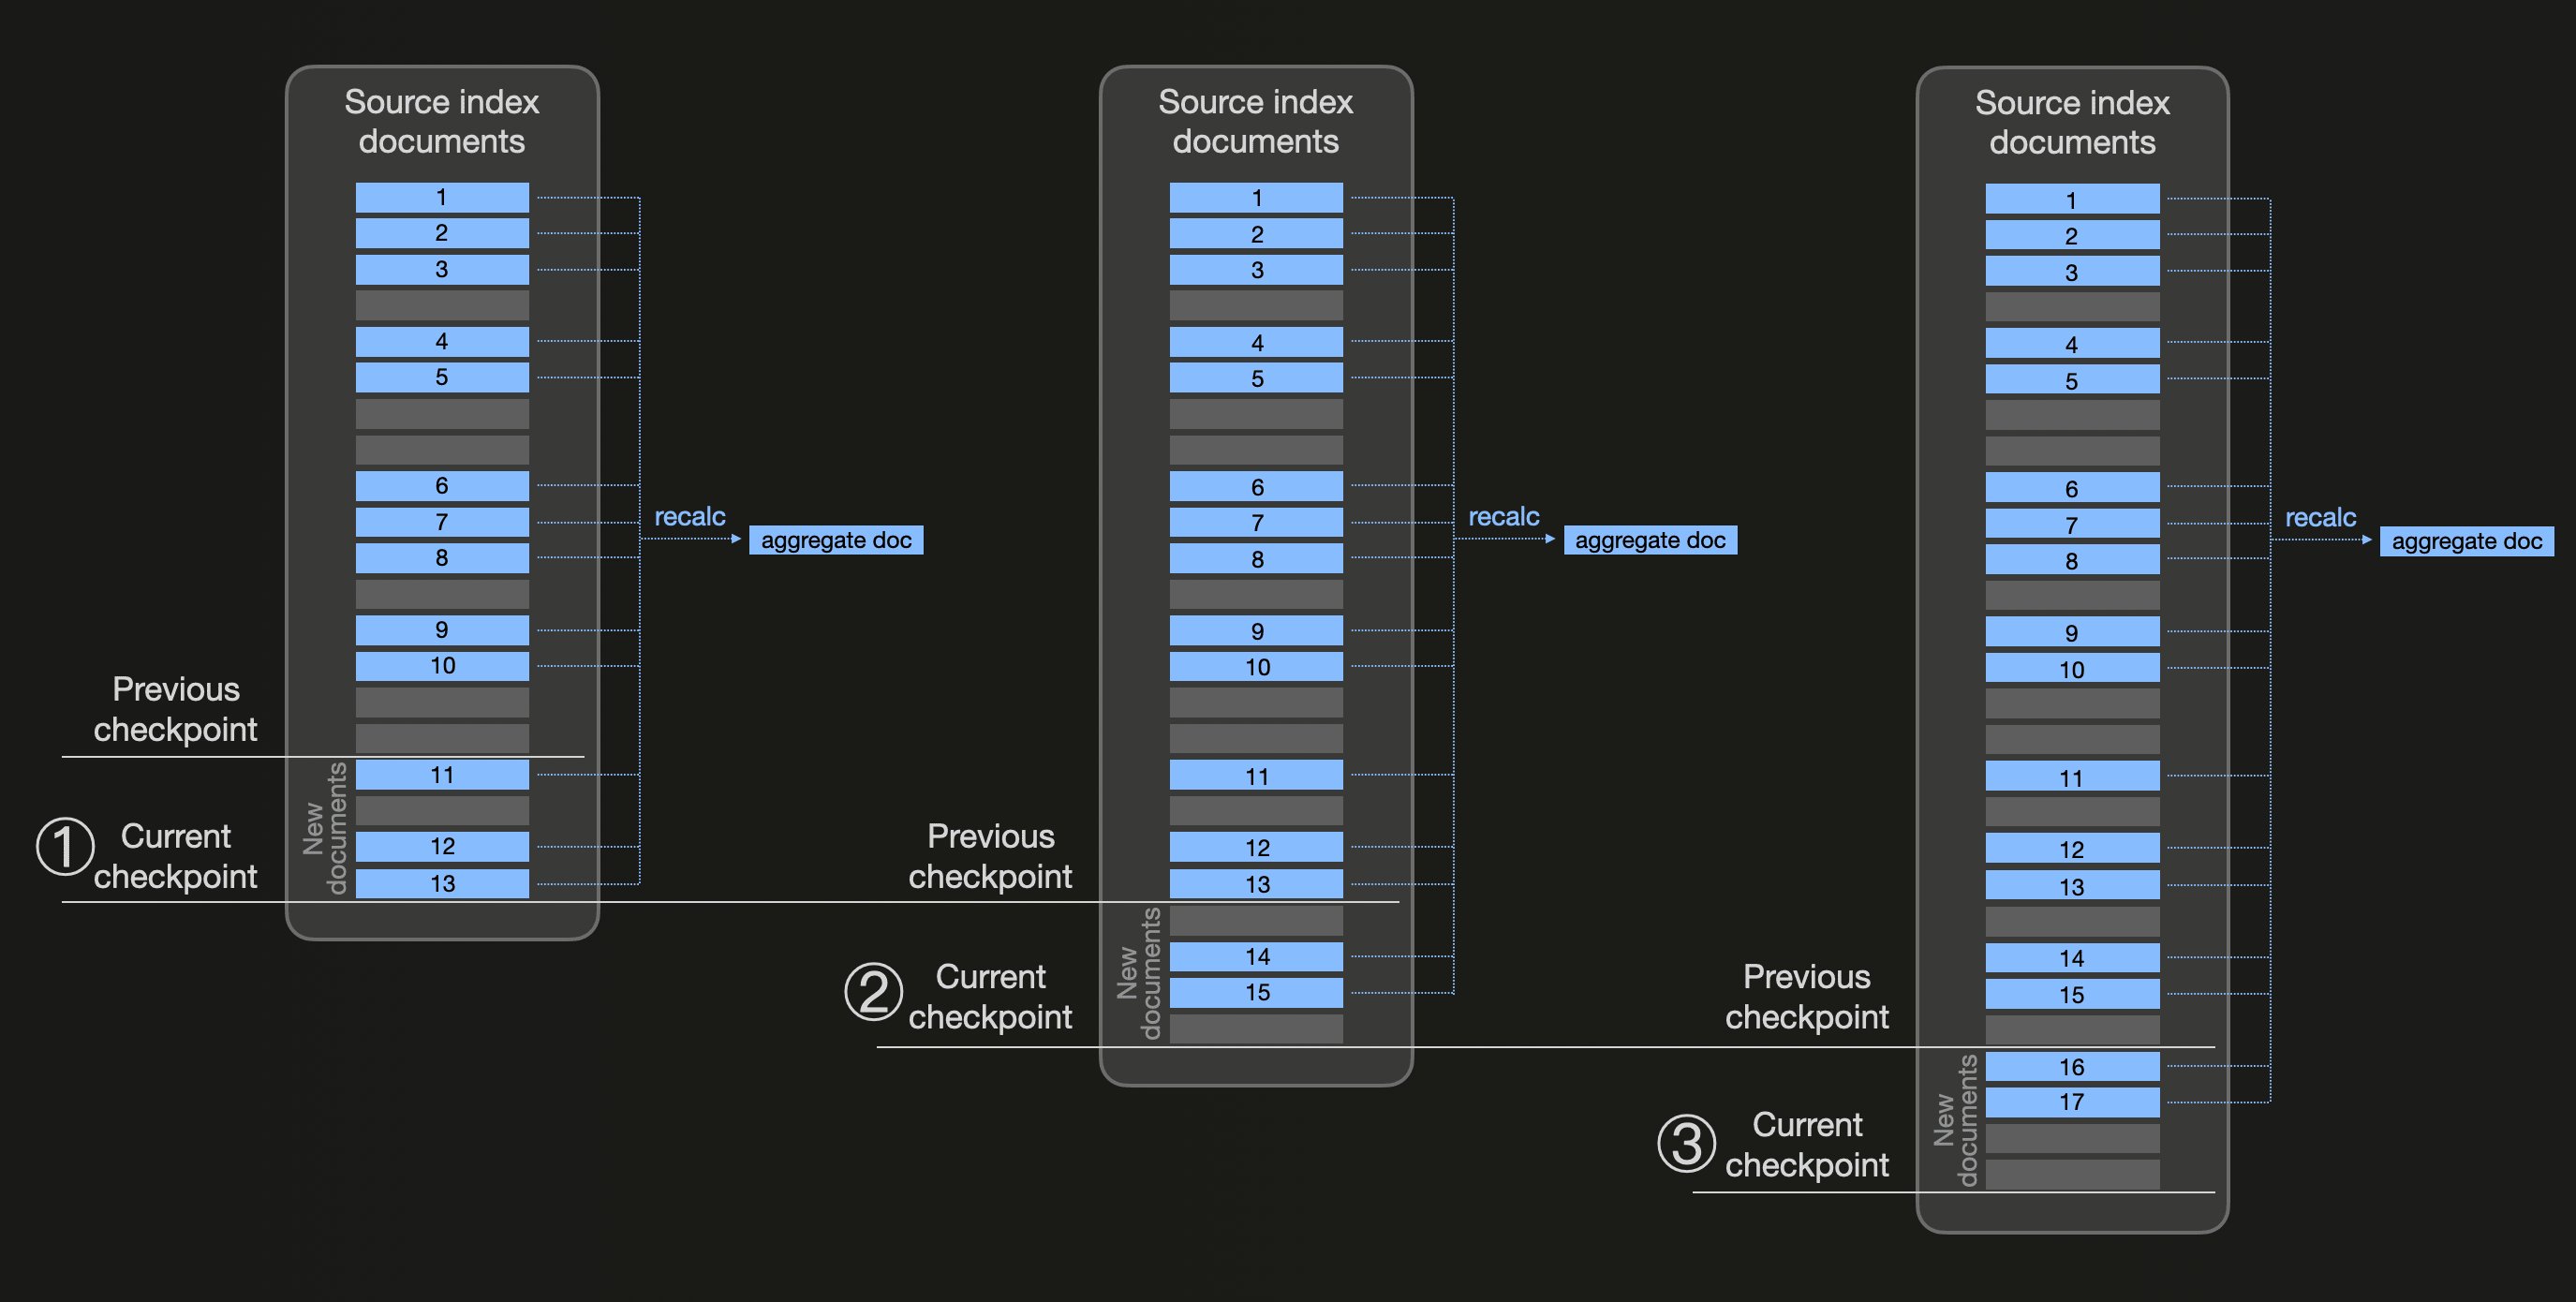
blue document (11、12、13) を検出します。そのため、source index は既存のすべての blue document を対象にフィルタリングされ、composite 集約 (結果の pagination を利用するため) によって集計値が再計算されます (そして宛先 index は、以前の集計値を含む document を置き換える document で更新されます) 。同様に ② と ③ でも、変更を確認し、同じ blue bucket に属する既存のすべての document から集計値を再計算することで、新しい checkpoint が処理されます。
一方、ClickHouse は根本的に異なるアプローチを取ります。定期的にデータを再集計するのではなく、ClickHouse は インクリメンタルmaterialized view をサポートしており、データを 挿入時 に変換・集計します。新しいデータがソーステーブルに書き込まれると、materialized view は新たに 挿入 された block に対してのみ、あらかじめ定義された SQL の集計クエリを実行し、その集計結果をターゲットテーブルに書き込みます。
このモデルは、ClickHouse が partial aggregate states をサポートしていることで実現されています。これは、保存して後からマージできる集計関数の中間表現です。これにより、高速にクエリでき、更新コストも低い部分集計結果を維持できます。データの到着時に集計が行われるため、高コストな定期 job を実行したり、古いデータを再度要約したりする必要はありません。
次に、インクリメンタルmaterialized view の仕組みを抽象的に示します (なお、事前に集計値を計算したい同じグループに属するすべての行を青色で表しています) :
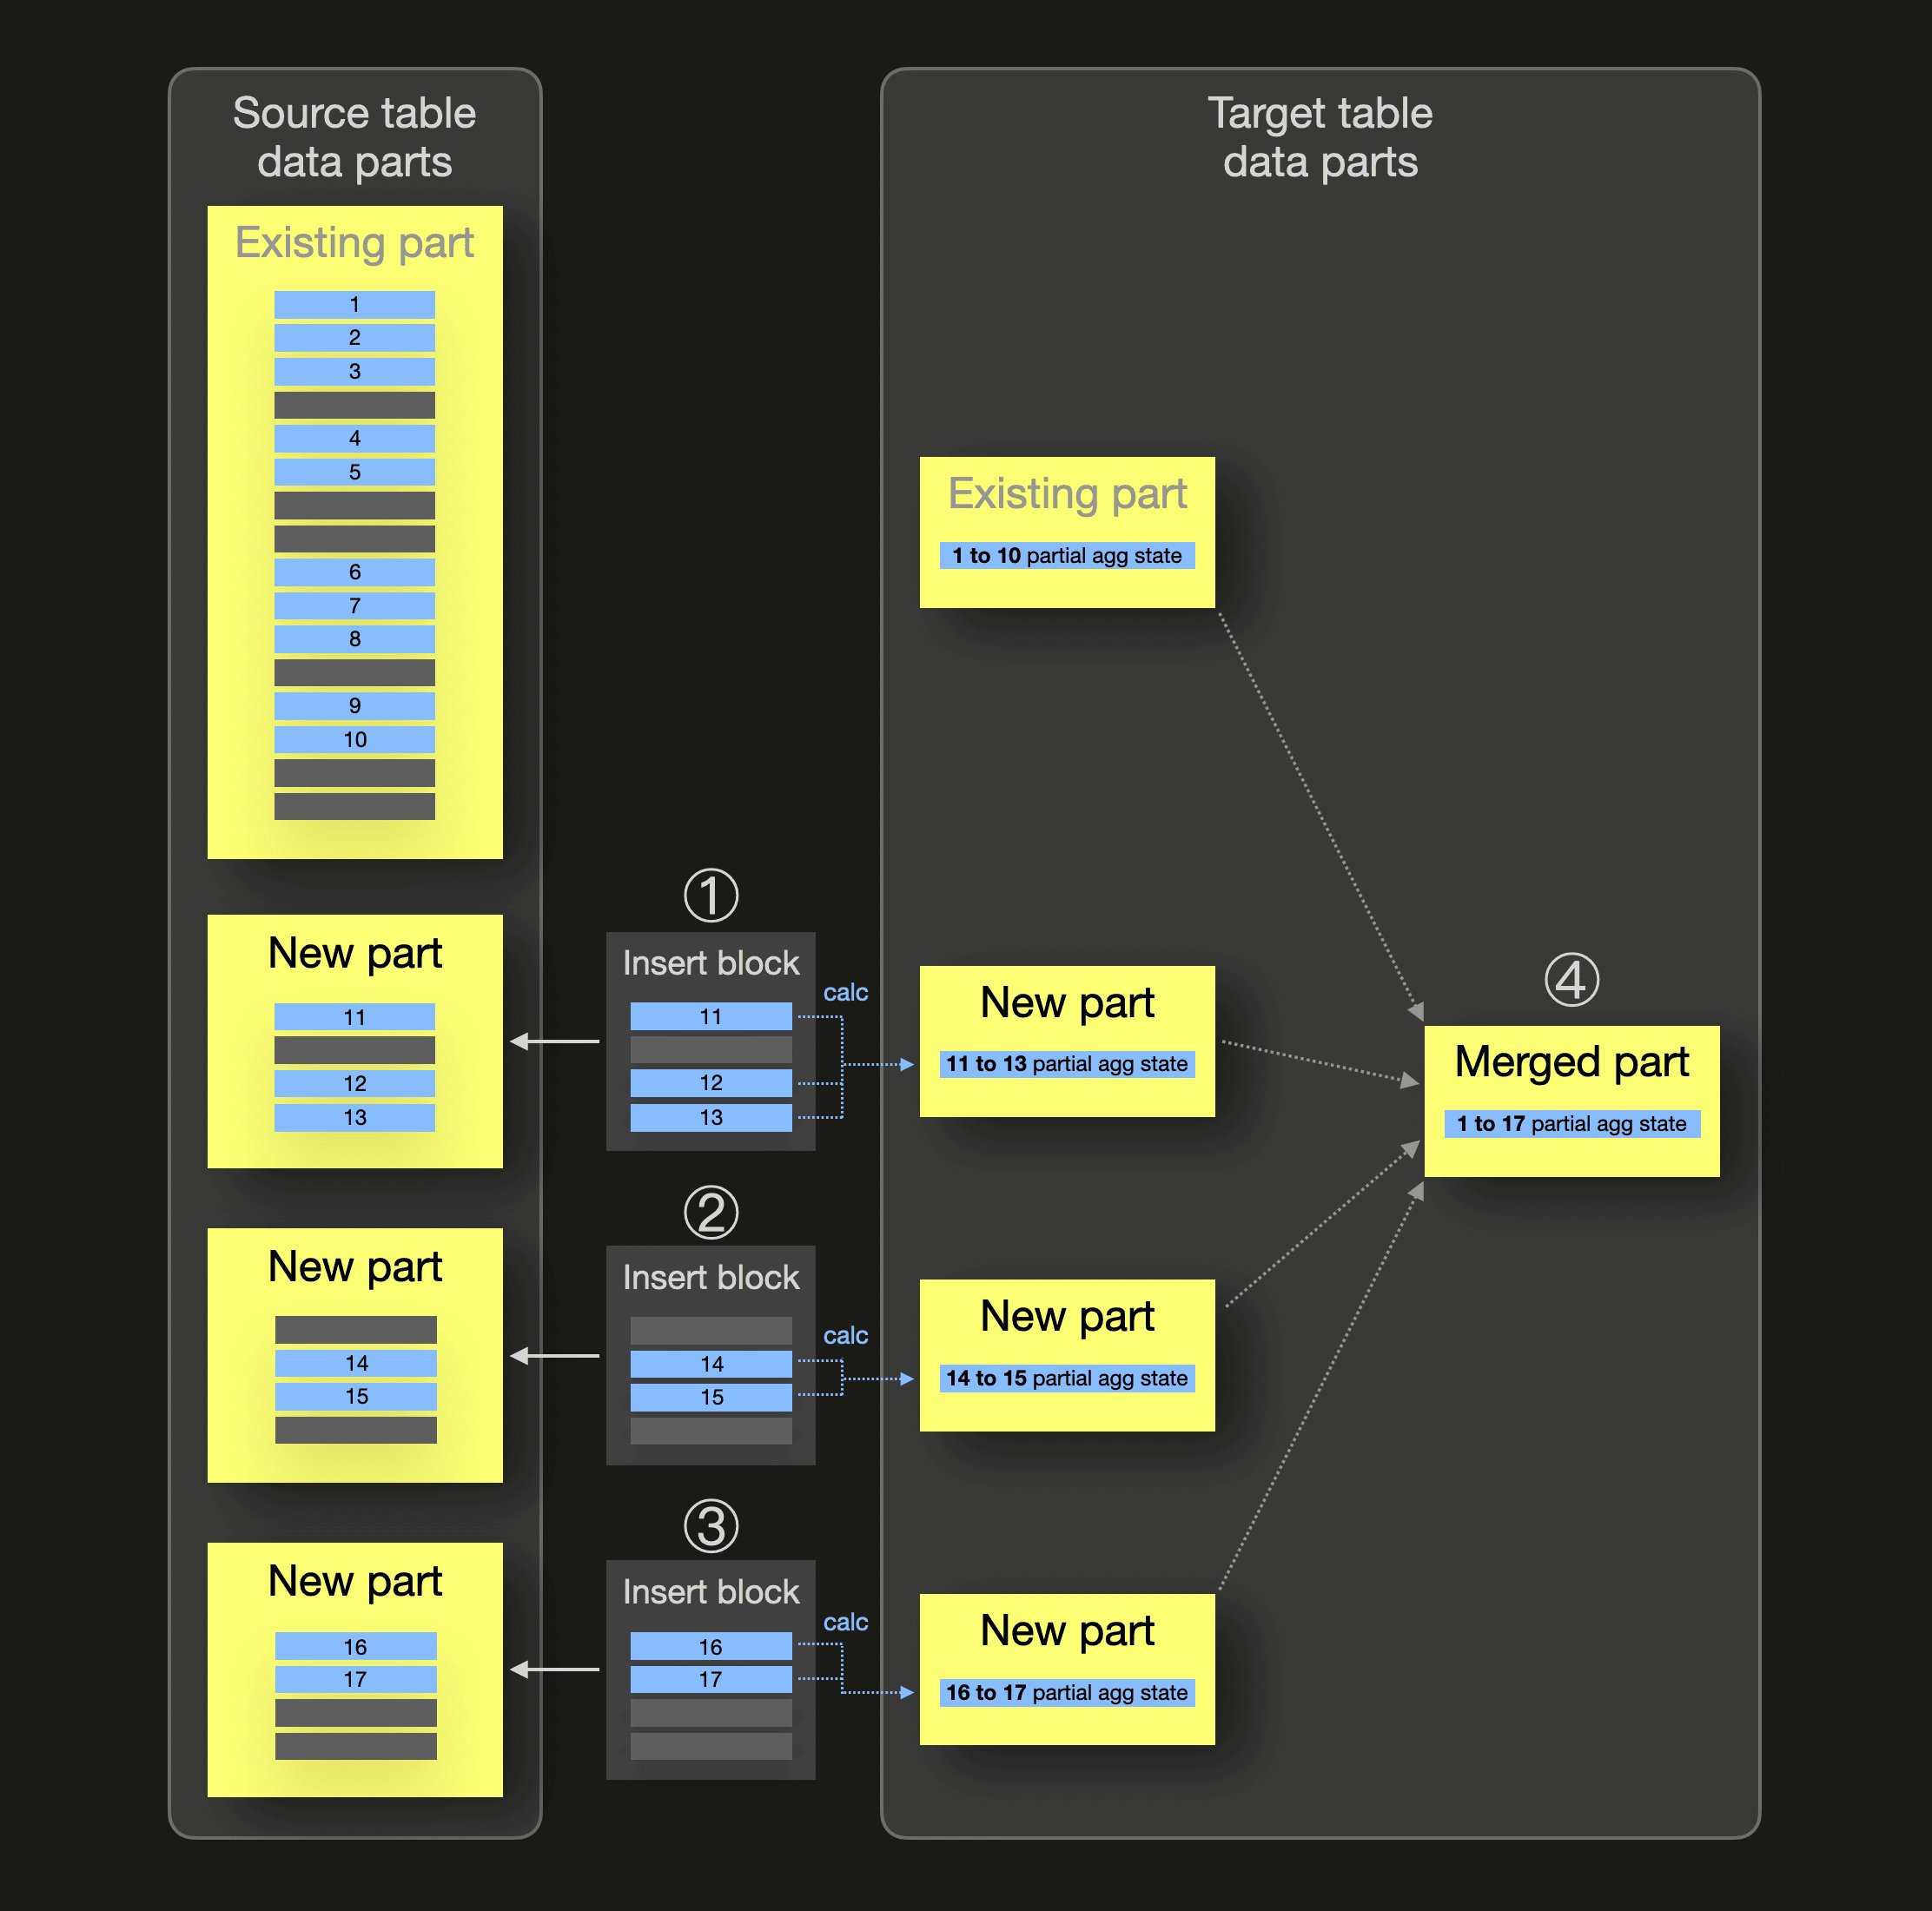
blue 行 (1〜10) を格納した data part がすでに含まれています。このグループについては、view のターゲットテーブルにも、blue グループの 部分集計状態 を格納した data part がすでに存在します。新しい行を伴う ① ② ③ のソーステーブルへの insert が行われると、各 insert ごとに対応するソーステーブルの data part が作成され、同時に、新たに挿入された行の各 block に対してのみ 部分集計状態 が計算され、data part の形で materialized view のターゲットテーブルに挿入されます。④ バックグラウンドでの part merge の際に 部分集計状態 がマージされ、インクリメンタルなデータ集計が実現されます。
なお、aggregate functions は、その aggregate function combinators との組み合わせも含めて、すべて (90 種類以上) が 部分集計状態 をサポートしています。
Elasticsearch と ClickHouse におけるインクリメンタル集計の、より具体的な比較については、この example を参照してください。
ClickHouse のアプローチには、次のような利点があります:
- 常に最新の集計: materialized view は常にソーステーブルと同期されています。
- バックグラウンドジョブ不要: 集計はクエリ時ではなく挿入時に行われます。
- 優れたリアルタイム性能: 最新の集計結果が即座に必要なオブザーバビリティのワークロードやリアルタイム分析に最適です。
- 組み合わせ可能: materialized view は、より複雑なクエリ高速化戦略に向けて、他のビューやテーブルと重ねたり結合したりできます。
- 異なる有効期限 (TTL): materialized view のソーステーブルとターゲットテーブルには、それぞれ異なる TTL 設定を適用できます。
- データカタログインテグレーション: ClickHouse は AWS Glue などのデータカタログとのインテグレーションをサポートしており、オブジェクトストレージ内のテーブルを自動的に検出してアクセスできます。
- オブジェクトストレージのサポート: データを移動させることなく、S3、GCS、Azure Blob Storage 上のデータをクエリできるネイティブサポート。
- クエリフェデレーション: external dictionaries や table functions を使用して、レイクハウステーブル、従来型データベース、ClickHouse テーブルなど、複数のログソースにまたがるデータを相関付ける機能。
- 増分ロード: S3Queue や ClickPipes などの機能を使用して、レイクハウステーブルからローカルの MergeTree テーブルへの継続的なロードをサポートします。
- パフォーマンス最適化: パフォーマンス向上のため、cluster functions を使用してレイクハウスデータに対する分散クエリ実行を行います。