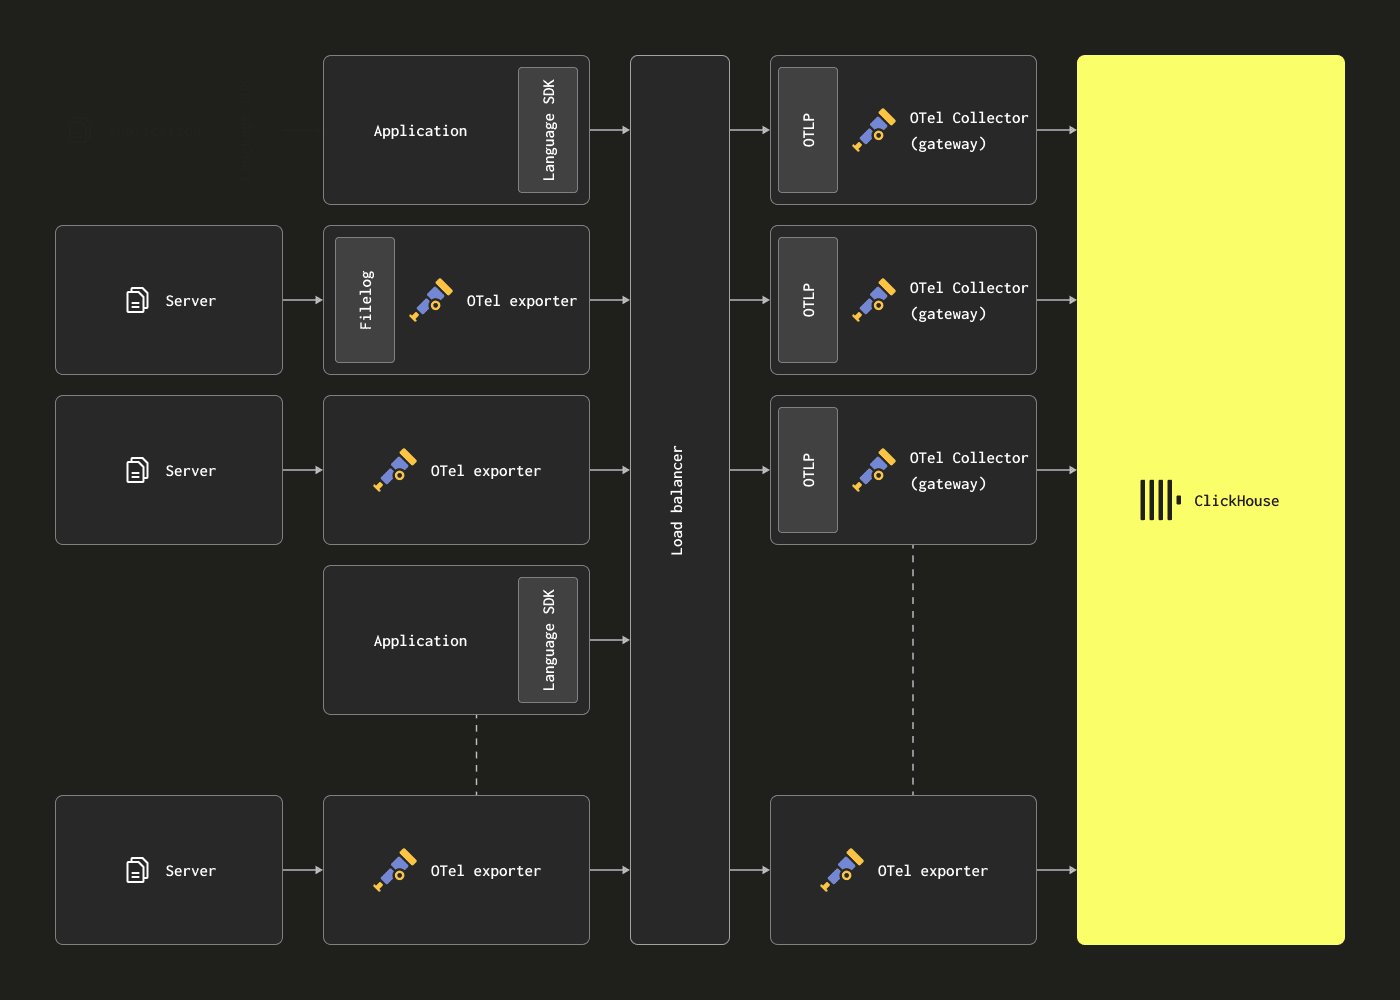
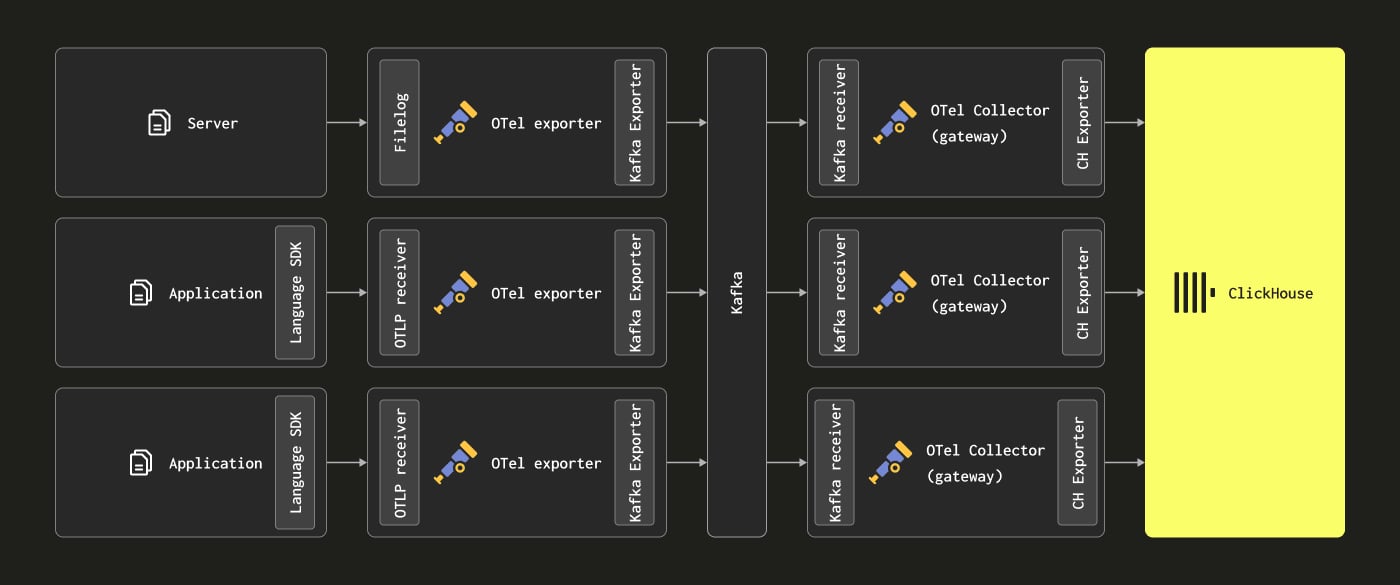
- OpenTelemetry Collector は、テレメトリーデータを受信、処理、エクスポートする proxy です。ClickHouse ベースのソリューションでは、このコンポーネントをログ収集と、バッチ化および insert 前のイベント処理の両方に使用します。
- テレメトリーデータの仕様、API、エクスポートを実装する Language SDKs です。これらの SDK は、アプリケーションコード内で trace が正しく記録されるようにし、構成要素である spans を生成するとともに、metadata を介してサービス間で context が伝播されることを保証します。これにより分散 traces が形成され、spans を相関付けられるようになります。さらに、これらの SDK は一般的なライブラリやフレームワークに自動で対応するエコシステムによって補完されているため、ユーザーはコードを変更せずに、すぐに使えるインストルメンテーションを利用できます。
- collector のサイズを小さくして、collector のデプロイ時間を短縮できる
- アタックサーフェスを縮小することで、collector のセキュリティを向上できる
- エージェント - エージェントインスタンスは、サーバー上や Kubernetes ノード上などのエッジでデータを収集するか、OpenTelemetry SDK でインストルメントされたアプリケーションからイベントを直接受信します。後者の場合、エージェントインスタンスはアプリケーションと一緒に、またはアプリケーションと同じホスト上で実行されます (サイドカーやデーモンセットなど) 。エージェントは、データを ClickHouse に直接送信することも、ゲートウェイインスタンスに送信することもできます。前者のケースは、Agent deployment pattern と呼ばれます。
- ゲートウェイ - ゲートウェイインスタンスは、独立したサービス (たとえば Kubernetes 上のデプロイメント) を提供し、通常はクラスターごと、データセンターごと、またはリージョンごとに配置されます。これらは、単一の OTLP エンドポイントを介して、アプリケーション (またはエージェントとして動作する他の collector) からイベントを受信します。通常は複数のゲートウェイインスタンスがデプロイされ、組み込みのロードバランサーを使用してそれらの間で負荷を分散します。すべてのエージェントとアプリケーションがシグナルをこの単一のエンドポイントに送信する場合、これはしばしば Gateway deployment pattern と呼ばれます。
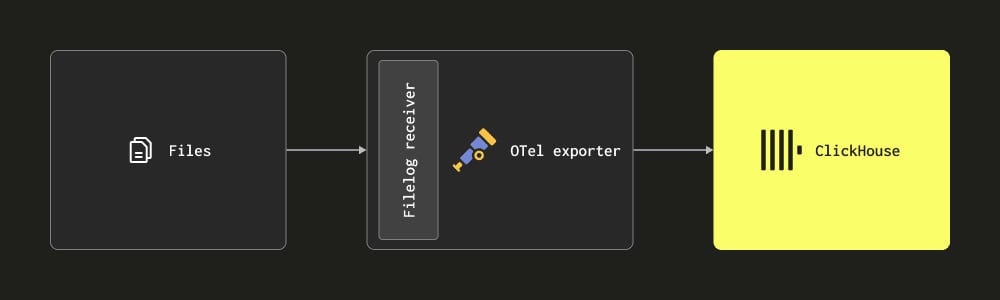
- Filelog receiver によるスクレイピング - この receiver はディスク上のファイルを tail し、ログメッセージを生成して ClickHouse に送信します。この receiver は、複数行メッセージの検出、ログローテーションへの対応、再起動時の耐障害性を高めるためのチェックポイント管理、構造の抽出といった複雑な処理も担います。さらに、Docker や Kubernetes のコンテナログも tail でき、Helm チャートとしてデプロイ可能で、そこから構造を抽出し、ポッドの詳細情報でエンリッチすることもできます。
ヒント:
otelbin.iootelbin.io は、設定の検証や可視化に役立ちます。filelog receiver で読み込み、生成されたメッセージを stdout に出力する OTel Collector のシンプルな構成です。ここではログが構造化されているため、json_parser operator を使用します。access-structured.log ファイルへのパスは適宜変更してください。
パースには ClickHouse の利用を検討してください以下の例では、ログから timestamp を抽出しています。これには
json_parser operator を使用する必要があります。この operator はログ行全体を JSON 文字列に変換し、その結果を LogAttributes に格納します。これは計算コストが高くなる可能性がありますが、ClickHouse ではより効率的に実行できます - SQL による構造の抽出。同等の非構造化ログの例として、regex_parser を使用して同じことを実現するものをこちらで確認できます。filelog receiver を含む) を使用するように手順を読み替えることです。たとえば、otelcol_0.102.1_darwin_arm64.tar.gz ではなく、otelcol-contrib_0.102.1_darwin_arm64.tar.gz をダウンロードします。リリースはこちらで確認できます。
インストール後、OTel collector は次のコマンドで実行できます。
Body フィールド内に文字列として保持される一方で、json_parser によって JSON が Attributes フィールドに自動的に抽出されていることです。同じ operator を使って、タイムスタンプも適切な Timestamp カラムに抽出されています。OTel でログを処理する際の推奨事項については、処理を参照してください。
オペレーターオペレーターは、ログ処理の最も基本的な単位です。各オペレーターは、ファイルから行を読み取る、フィールドから JSON をパースするといった単一の役割を担います。その後、目的の結果を得るために、これらのオペレーターをパイプライン内で連結して使用します。
TraceID または SpanID フィールドが含まれていません。これらが存在する場合、たとえばユーザーが分散トレーシングを実装しているケースでは、上で示したのと同じ手法を使って JSON から抽出できます。
ローカルまたは Kubernetes のログファイルを収集する必要があるユーザーは、filelog receiver で利用できる設定オプションに加え、offsets と 複数行ログのパースがどのように処理されるか について理解しておくことを推奨します。
Kubernetesログの収集については、OpenTelemetryのドキュメントガイドを参照することを推奨します。Kubernetes Attributes Processorは、ログやメトリクスにポッドのメタデータを付与するために推奨されています。これにより、ラベルなどの動的なメタデータが生成され、ResourceAttributes カラムに格納される場合があります。ClickHouseでは現在、このカラムに Map(String, String) 型を使用しています。この型の扱い方や最適化の詳細については、Using MapsおよびExtracting from mapsを参照してください。
コードをインストルメントしてトレースを収集したい場合は、公式のOTel ドキュメントに従うことをお勧めします。
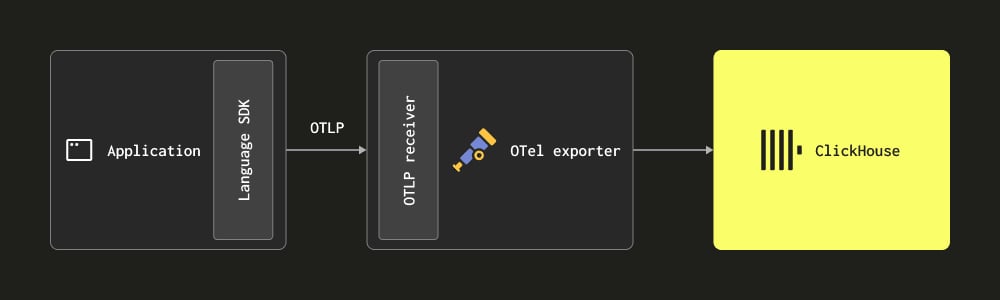
イベントを ClickHouse に送信するには、適切な receiver を介して OTLP プロトコルでトレースイベントを受信する OTel collector をデプロイする必要があります。OpenTelemetry Demo には、サポート対象の各言語をインストルメントする例と、イベントを collector に送信する方法が示されています。イベントを stdout に出力する適切な collector configuration の例を以下に示します。
トレースは OTLP 経由で受信する必要があるため、トレースデータの生成には telemetrygen ツールを使用します。インストールについては、こちら の手順に従ってください。
次の構成では、トレースイベントを OTLP receiver で受信し、その後 stdout に送信します。
config-traces.xml
telemetrygen を使用してトレースイベントを collector に送信します:
-
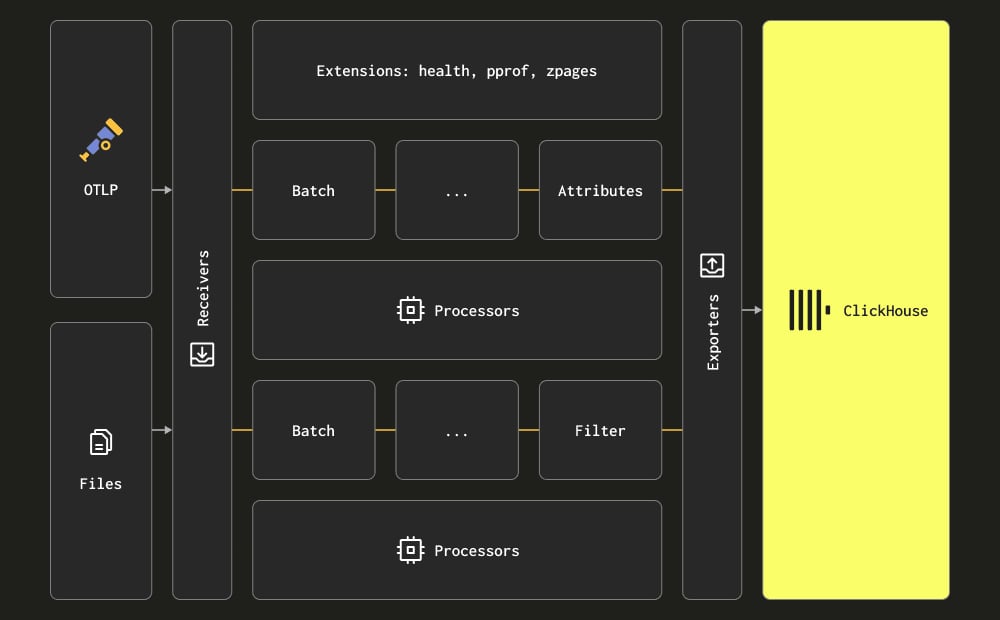
プロセッサ - プロセッサは、receiver が収集したデータを変更または変換し、exporter に送信する前に処理します。プロセッサは、collector 設定の
processorsセクションで設定した順序で適用されます。これらは必須ではありませんが、最小限のセットを使うことが一般的に推奨されています。ClickHouse と組み合わせて OTel collector を使う場合は、プロセッサを次のものに絞ることを推奨します。- memory_limiter は、collector でメモリ不足が発生するのを防ぐために使用します。推奨事項については Estimating Resources を参照してください。
- コンテキストに基づくエンリッチを行う任意のプロセッサ。たとえば Kubernetes Attributes Processor を使うと、spans、メトリクス、logs の resource attributes に k8s メタデータを自動的に設定できます。たとえば、イベントに送信元のポッド ID を付与してエンリッチできます。
- traces で必要に応じた Tail または head sampling。
- 基本的なフィルタリング - 不要なイベントを破棄します。これを operator で実行できない場合に使用します (下記参照) 。
- Batching - データをバッチ単位で送信するために、ClickHouse では不可欠です。“Exporting to ClickHouse” を参照してください。
- Operators - Operators は、receiver で利用できる最も基本的な処理単位です。基本的なパースがサポートされており、Severity や Timestamp などのフィールドを設定できます。ここでは JSON と regex のパースに加えて、イベントのフィルタリングや基本的な変換もサポートされています。イベントのフィルタリングはここで行うことを推奨します。
regex_parser を使用してログ行から構造を抽出し、イベントをフィルタリングする operator と、イベントをバッチ化してメモリ使用量を制限する プロセッサ を使用している点に注目してください。
config-unstructured-logs-with-processor.yaml
OpenTelemetry Collector Contrib を使用するClickHouse exporter はコアディストリビューションではなく、OpenTelemetry Collector Contrib の一部です。contrib ディストリビューションを使用することも、独自の collector をビルドする こともできます。
- pipelines - 上記の設定では、pipelines を使用しています。これは receiver、processor、exporter のセットで構成され、logs 用と traces 用にそれぞれ 1 つずつ定義されています。
- endpoint - ClickHouse との通信は
endpointパラメータで設定します。接続文字列tcp://localhost:9000?dial_timeout=10s&compress=lz4&async_insert=1を指定すると、TCP 経由で通信が行われます。トラフィック切り替えの都合で HTTP を使いたい場合は、こちら の説明に従ってこの接続文字列を変更してください。ユーザー名とパスワードをこの接続文字列内で指定する方法を含む完全な接続情報についても、こちら に記載されています。
- ttl - ここで指定する値で、データをどれくらい保持するかが決まります。詳細は “Managing data” を参照してください。値は 72h のように、時間単位で指定する必要があります。以下の例ではデータが 2019 年のものであり、挿入すると ClickHouse によって直ちに削除されてしまうため、有効期限 (TTL) を無効にしています。
- traces_table_name と logs_table_name - ログテーブルとトレーステーブルの名前を指定します。
- create_schema - 起動時にデフォルトのスキーマで table を作成するかどうかを指定します。Getting Started ではデフォルトで true です。実運用では false に設定し、独自のスキーマを定義してください。
- database - 移行先データベース。
- retry_on_failure - 失敗した batch を再試行するかどうかを決める設定です。
- batch - batch processor は、イベントを batch 単位で送信するためのものです。少なくとも 10,000、timeout は 5s を推奨します (メモリに余裕があれば 100,000 まで使用できます) 。このどちらかの条件に先に達した時点で、exporter へ flush する batch が開始されます。これらの値を小さくすると、データをより早くクエリできるようになり、パイプラインの latency は下がりますが、その分 ClickHouse に送信される connections と batches は増えます。非同期挿入 を使用していない場合、ClickHouse で パーツが多すぎる 問題を引き起こす可能性があるため、これは推奨されません。一方、非同期挿入を使用している場合は、クエリ可能になるまでの時間は非同期挿入の設定にも左右されますが、データ自体はより早く connector から flush されます。詳細は Batching を参照してください。
- sending_queue - 送信 queue のサイズを制御します。queue 内の各項目には 1 つの batch が含まれます。たとえば ClickHouse に接続できない状態でもイベントが到着し続けてこの queue の上限を超えると、batches は破棄されます。
telemetrygen ツールを使って次のコマンドを実行します。
create_schema 設定で無効にできます。さらに、logs テーブル名と traces テーブル名は、上記の設定を使ってデフォルトの otel_logs と otel_traces から変更できます。
以下のスキーマでは、有効期限 (TTL) が 72h に設定されているものとします。
otelcol-contrib v0.102.1) :
- デフォルトでは、テーブルは
PARTITION BY toDate(Timestamp)によって日付単位でパーティション化されます。これにより、有効期限が切れたデータを効率よく削除できます。 - 有効期限 (TTL) は
TTL toDateTime(Timestamp) + toIntervalDay(3)で設定され、collector の設定で指定した値に対応します。ttl_only_drop_parts=1は、含まれるすべての行の有効期限が切れた場合にのみ、パーツ全体を削除することを意味します。これは、コストの高い delete を伴うパーツ内の行削除よりも効率的です。この設定は常に有効にすることを推奨します。詳細は TTL によるデータ管理 を参照してください。 - テーブルは標準的な
MergeTreeエンジン を使用します。これはログとトレースに推奨されており、通常は変更する必要はありません。 - テーブルは
ORDER BY (ServiceName, SeverityText, toUnixTimestamp(Timestamp), TraceId)で並べ替えられます。つまり、クエリはServiceName、SeverityText、Timestamp、TraceIdに対するフィルタに最適化されます。リスト内で前にあるカラムほど、後ろのカラムより高速にフィルタできます。たとえば、ServiceNameによるフィルタはTraceIdによるフィルタより大幅に高速です。想定されるアクセスパターンに応じて、この並び順を変更してください。詳しくは 主キーの選び方 を参照してください。 - 上記のスキーマでは、カラムに
ZSTD(1)を適用しています。これはログに対して最適な圧縮を提供します。より高い圧縮率を得るために ZSTD の圧縮レベル (デフォルトの 1 より上) を上げることもできますが、効果があるケースはまれです。この値を上げると、insert time の CPU オーバーヘッド (圧縮時) は増えますが、展開処理 (したがってクエリ性能) はほぼ同程度に保たれます。詳細は こちら を参照してください。さらに、ディスク上のサイズ削減を目的として、Timestamp には追加の delta encoding も適用されています。 ResourceAttributes、LogAttributes、ScopeAttributesがマップである点に注目してください。これらの違いを理解することが重要です。これらのマップへのアクセス方法と、その中のキーへのアクセスを最適化する方法については、“Using maps” を参照してください。- ここにある他のほとんどの型も、たとえば
ServiceNameの LowCardinality のように最適化されています。なお、サンプルログでは JSON であるBodyは、String として保存されます。 - ブルームフィルタは、マップのキーと値、および
Bodyカラムに適用されています。これらは、これらのカラムにアクセスするクエリの実行時間短縮を目的としていますが、通常は必須ではありません。詳しくは Secondary/Data skipping indices を参照してください。
- (1) データを受信するノードで問題が発生した場合、INSERT クエリはタイムアウトするか、より具体的なエラーを返し、確認応答は返されません。
- (2) データはノードに書き込まれたものの、ネットワークの中断によってクエリ送信元に確認応答を返せない場合、送信側ではタイムアウトまたはネットワークエラーになります。
timeout に達する前にバッチをフラッシュするため、パイプライン全体のエンドツーエンドのレイテンシを低く保ちつつ、バッチサイズも一定に保てます。
通常、collector のスループットが低い場合、ユーザーはより小さなバッチを送らざるを得ません。それでも、データはエンドツーエンドのレイテンシをできるだけ抑えて ClickHouse に到達することが期待されます。この場合、batch processor の timeout が期限に達すると、小さなバッチが送信されます。これは問題を引き起こす可能性があり、そのような場合に非同期挿入 が必要になります。このケースは通常、エージェントの役割の collector が ClickHouse に直接送信するよう設定されている場合に発生します。ゲートウェイは集約ポイントとして機能することで、この問題を緩和できます。詳しくは ゲートウェイによるスケーリング を参照してください。
大きなバッチを保証できない場合は、非同期挿入 を使用して、batching を ClickHouse に委譲できます。非同期挿入 では、データはまずバッファに挿入され、その後データベースストレージに後から、つまり非同期に書き込まれます。
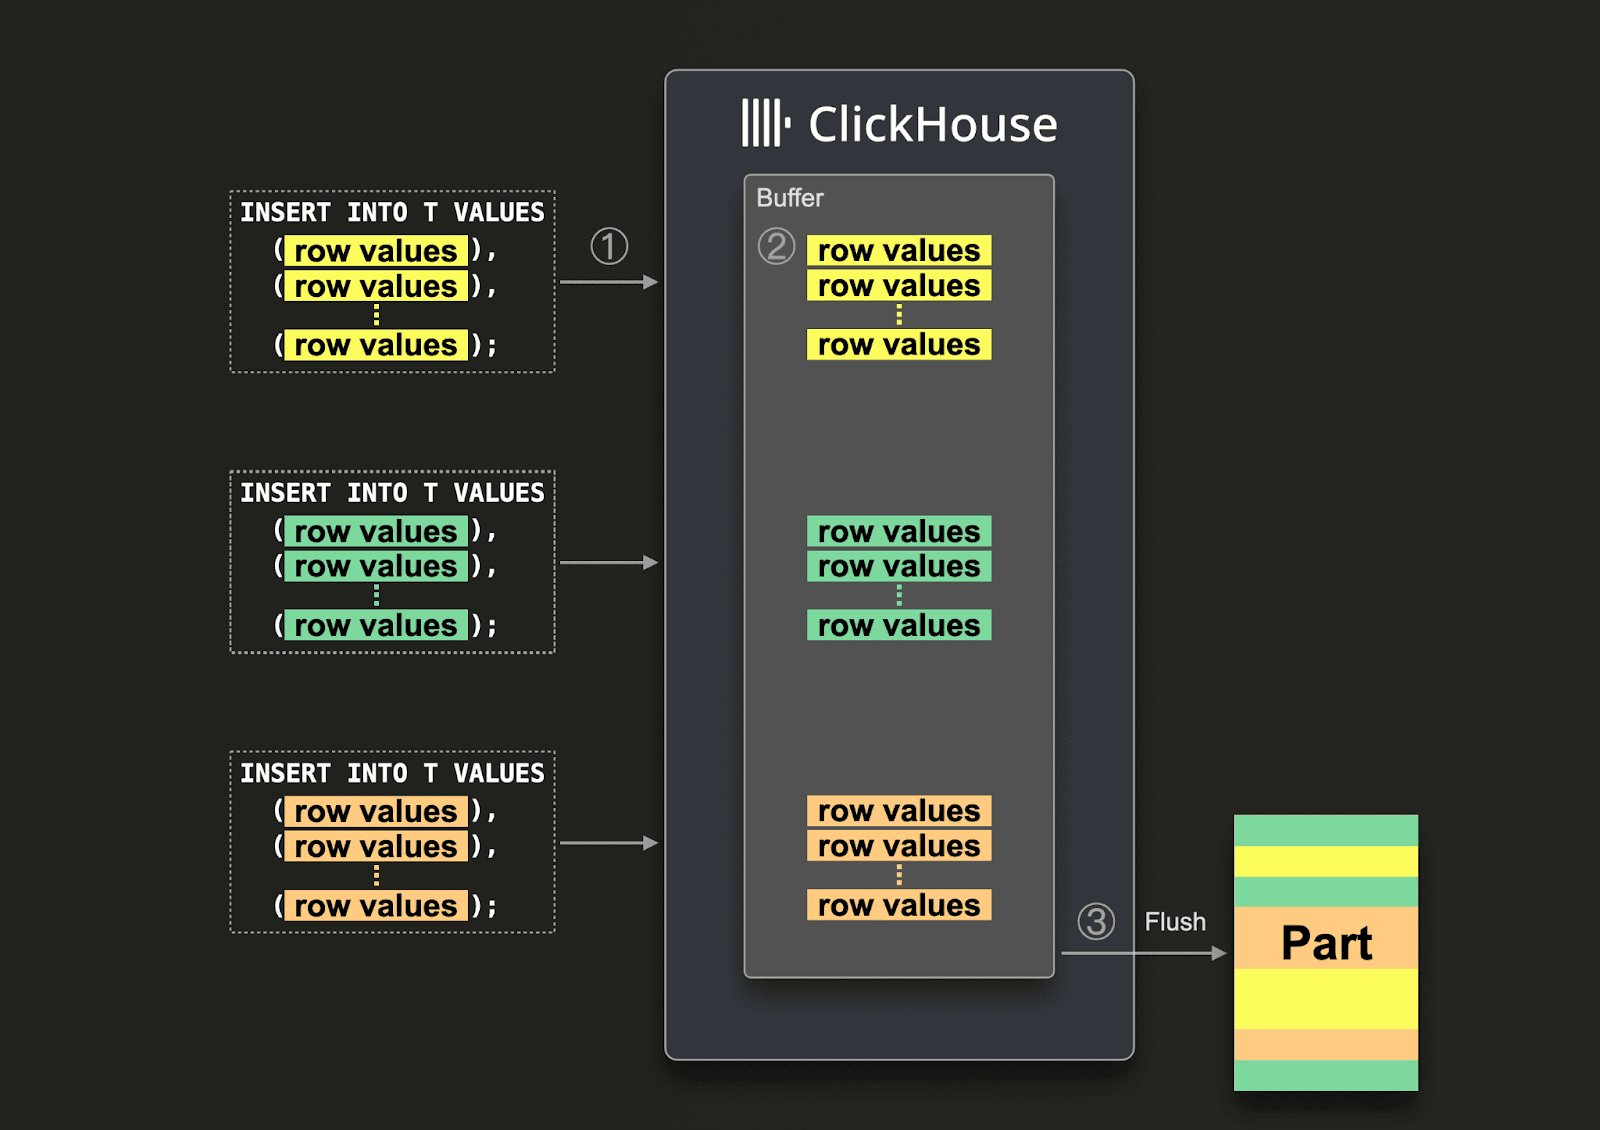
async_insert=1 を追加します。配信保証を得るため、wait_for_async_insert=1 (デフォルト) を使用することを推奨します。詳しくは こちら を参照してください。
非同期挿入 のデータは、ClickHouse のバッファが flush されると挿入されます。これは、async_insert_max_data_size を超えた後、または最初の INSERT クエリから async_insert_busy_timeout_ms ミリ秒が経過した後のいずれかで発生します。async_insert_stale_timeout_ms が 0 以外の値に設定されている場合、最後のクエリから async_insert_stale_timeout_ms milliseconds 後にデータが挿入されます。これらの設定を調整することで、pipeline のエンドツーエンド レイテンシを制御できます。バッファ flushing の調整に使用できるその他の設定は こちら に記載されています。一般的には、デフォルト値で十分です。
適応型非同期挿入 を検討する使用する agent の数が少なく、スループットは低い一方で、エンドツーエンド レイテンシ要件が厳しい場合は、adaptive asynchronous inserts が役立つことがあります。一般に、これらは ClickHouse に見られるような高スループットのオブザーバビリティのユースケースには適していません。
async_insert_deduplicate を参照してください。
この機能の設定に関する完全な詳細は こちら にあり、さらに詳しい解説は こちら にあります。
ClickHouse で OTel collector を使用する際には、複数のデプロイメント アーキテクチャが考えられます。以下でそれぞれの構成と、どのようなケースに適しているかを説明します。
エージェントのみのアーキテクチャでは、ユーザーは OTel collector をエッジにエージェントとしてデプロイします。これらはローカルアプリケーションからトレースを受信し (例: サイドカーコンテナーとして) 、サーバーや Kubernetes ノードからログを収集します。このモードでは、エージェントはデータを ClickHouse に直接送信します。
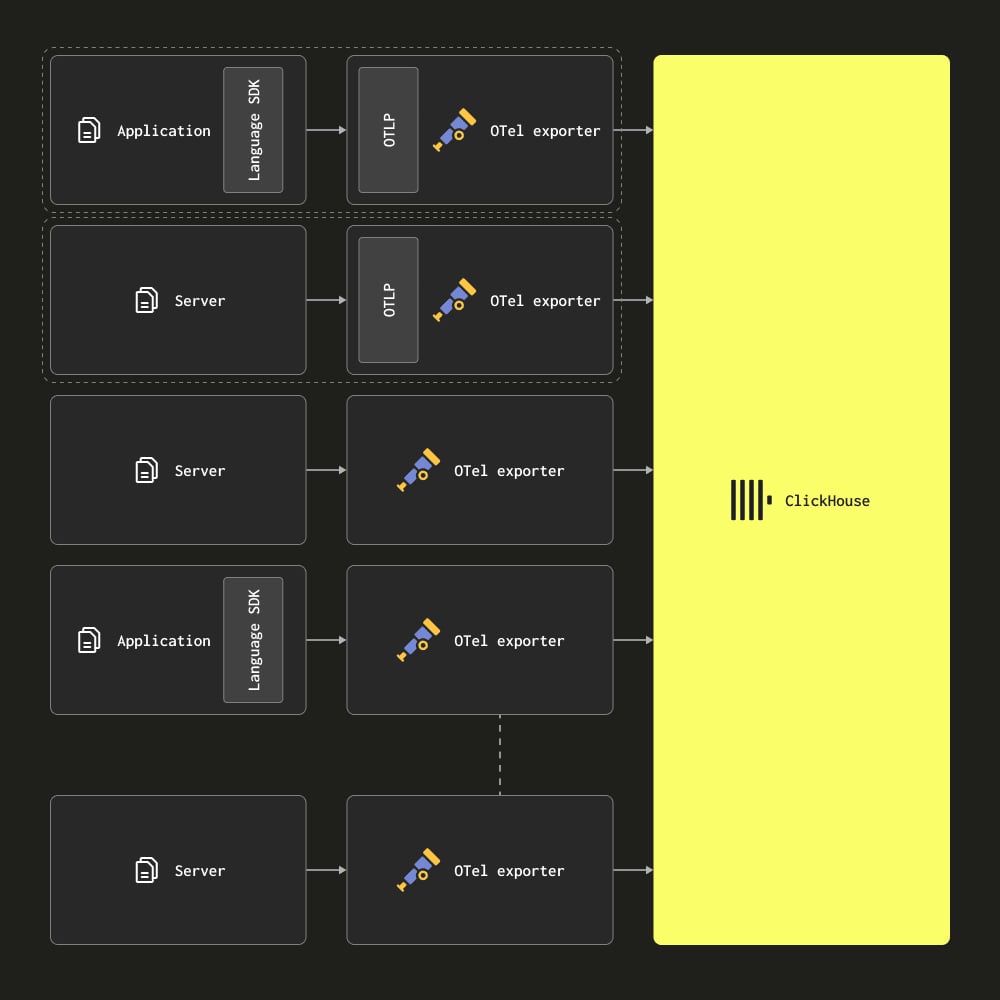
- 接続数のスケーリング - 各エージェントは ClickHouse への接続を確立します。ClickHouse は数百、場合によっては数千の同時実行 insert 接続を維持できますが、最終的にはこれが制約要因となり、insert の効率も低下します。つまり、ClickHouse は接続の維持により多くのリソースを費やすことになります。ゲートウェイを使用すると接続数を最小限に抑えられ、insert の効率も向上します。
- エッジでの処理 - このアーキテクチャでは、あらゆる変換やイベント処理をエッジ側または ClickHouse 内で実行する必要があります。これは制約が大きいだけでなく、複雑な ClickHouse materialized view が必要になったり、重要なサービスに影響する可能性があり、しかもリソースが限られるエッジ側に大きな計算負荷をかけたりすることを意味します。
- 小さなバッチとレイテンシー - エージェント collector は、それぞれが収集するイベント数がごく少ない場合があります。通常これは、配信 SLA を満たすために、一定の間隔で flush するよう設定する必要があることを意味します。その結果、collector が ClickHouse に小さなバッチを送信することがあります。これは欠点ではありますが、非同期挿入によって軽減できます。詳細は insert の最適化 を参照してください。