

これは、PostgreSQL から ClickHouse への移行ガイドの第1部です。実践的な例を用いて、リアルタイムレプリケーション (CDC (変更データキャプチャ) ) のアプローチで移行を効率的に進める方法を解説します。ここで取り上げる概念の多くは、PostgreSQL から ClickHouse への手動による大規模データ転送にも適用できます。Postgres から ClickHouse への典型的な移行例を示すサンプルデータセットとして、こちらで説明している Stack Overflow データセットを使用します。これには、2008 年から 2024 年 4 月までに Stack Overflow で発生したすべての
post、vote、user、comment、badge が含まれています。このデータの PostgreSQL スキーマを以下に示します。
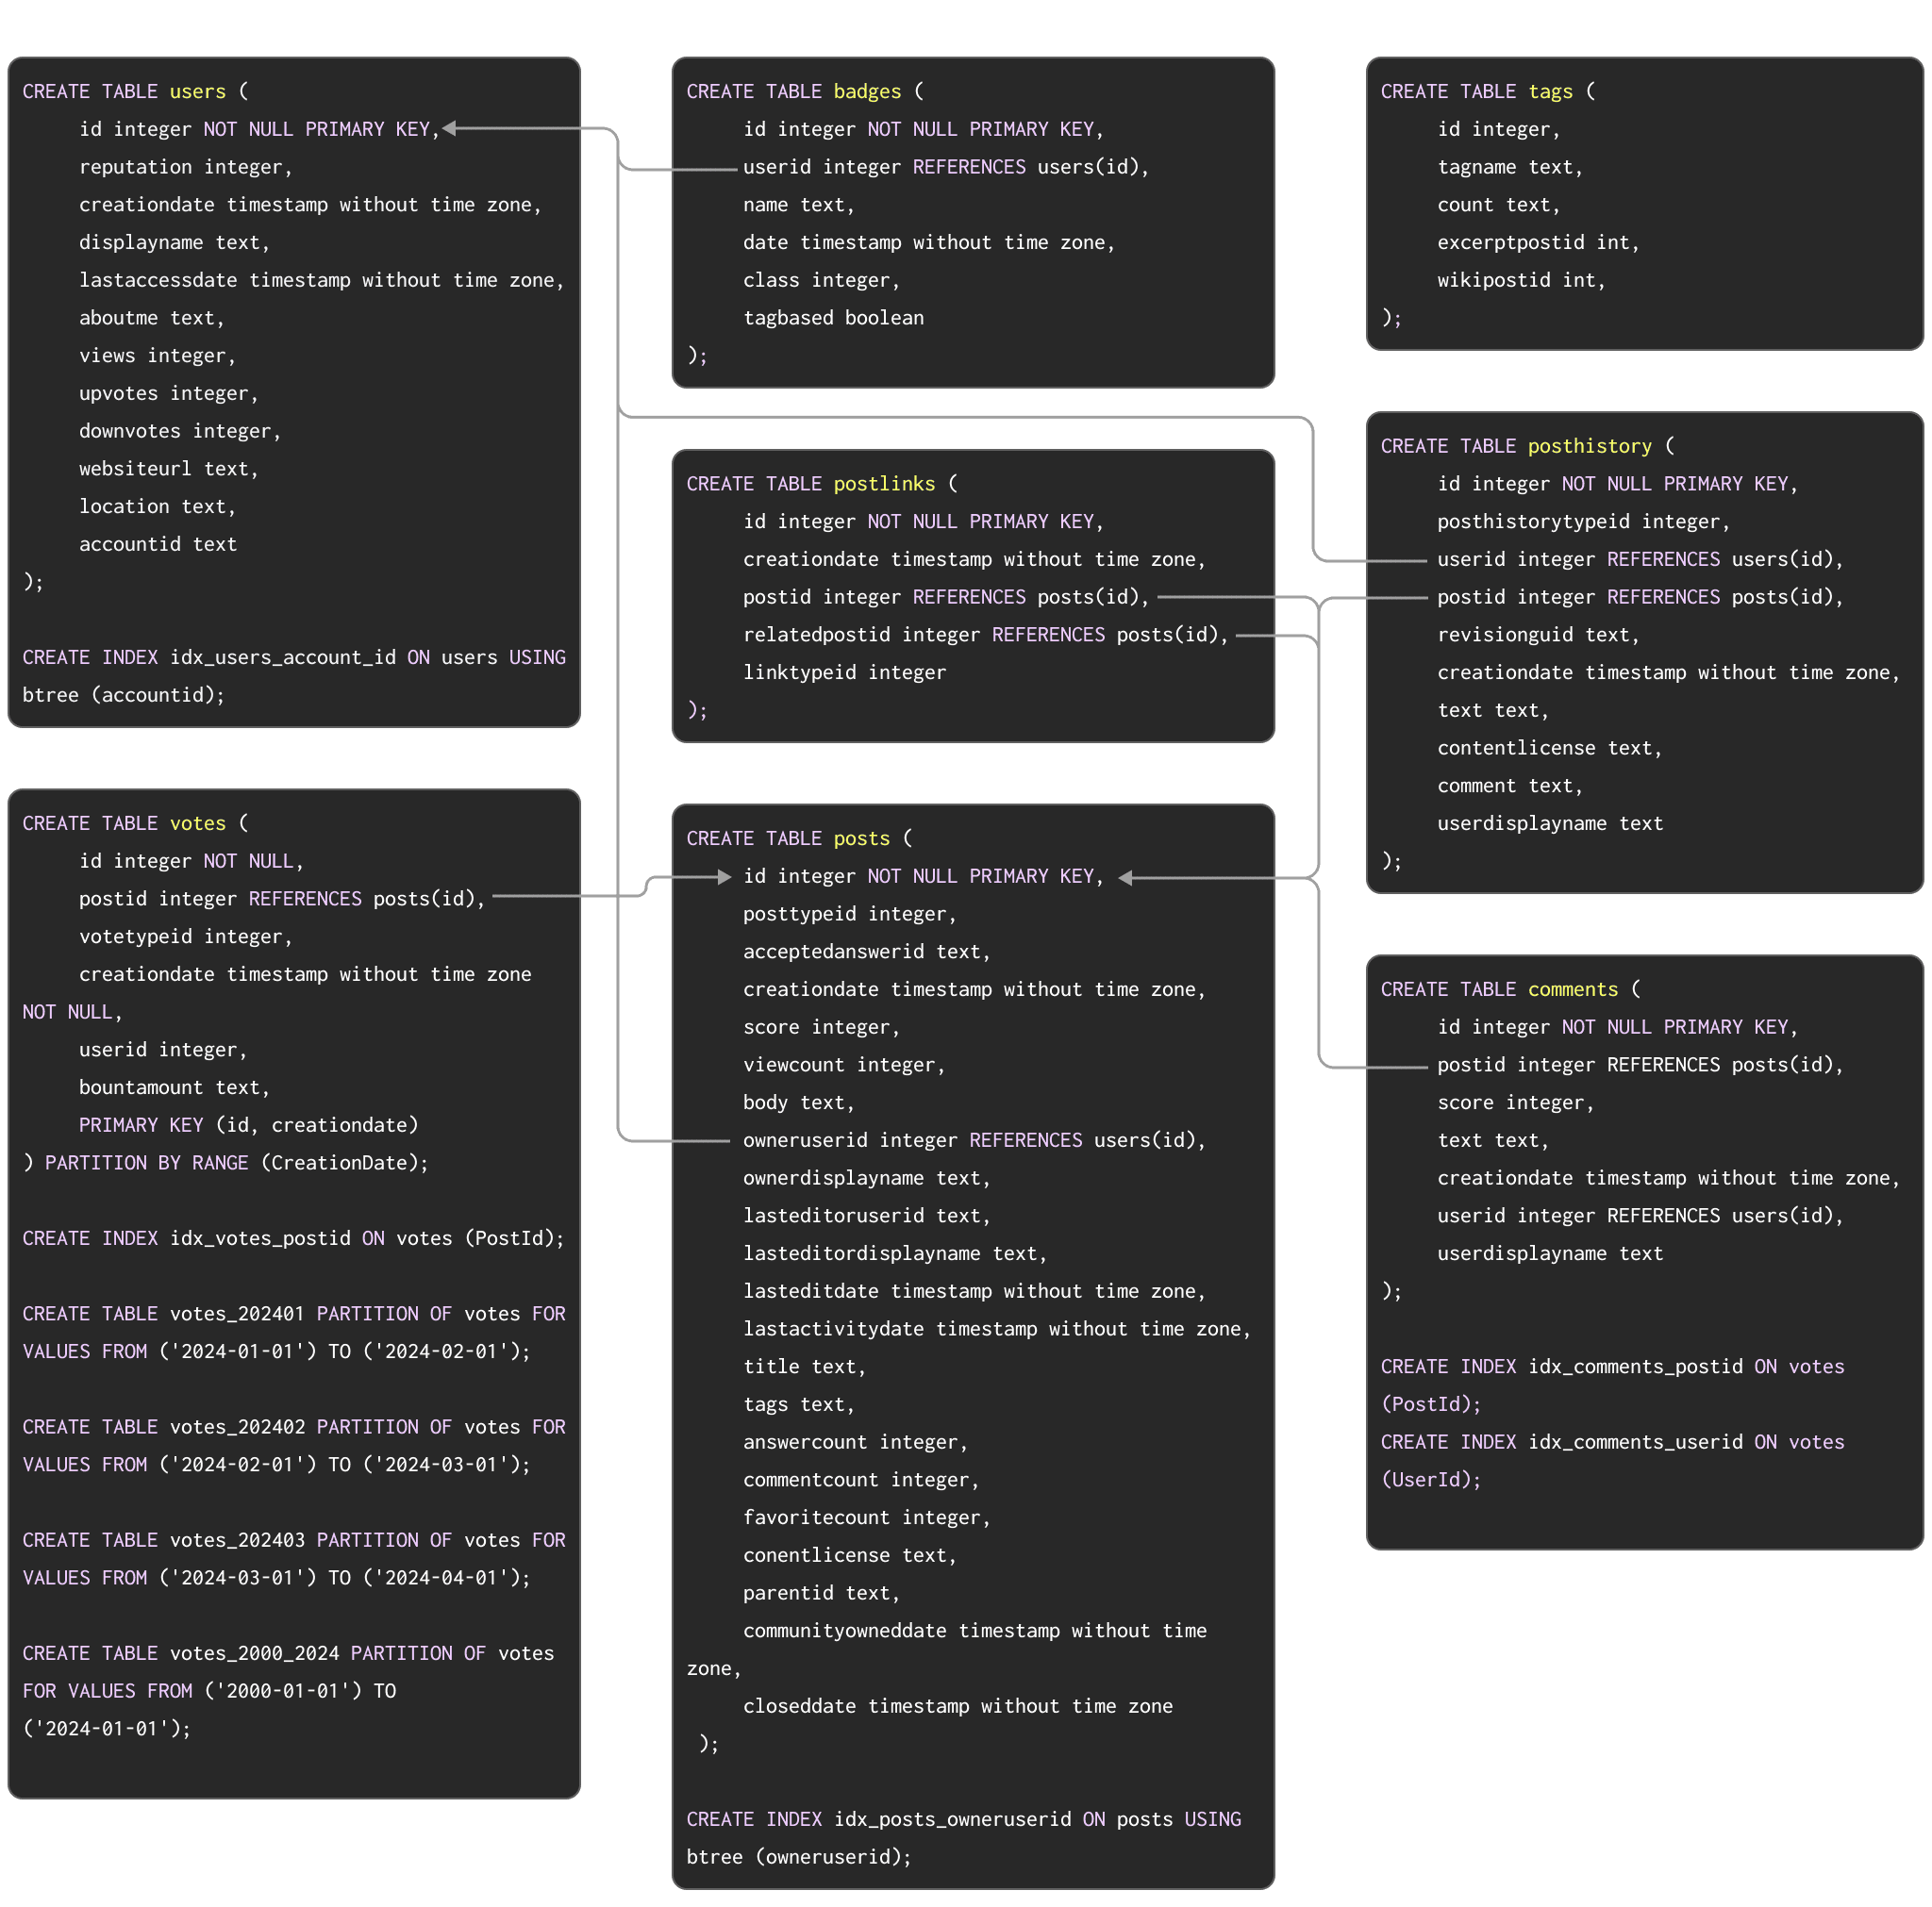
pg_dump フォーマットのデータもダウンロードできるようにしています。後続のデータ読み込みコマンドを以下に示します。
この例の結果では、Postgres と ClickHouse の性能差を示すために完全なデータセットを使用していますが、以下に記載する手順はすべて、より小さいサブセットでも機能的にはまったく同じです。完全なデータセットを Postgres に読み込みたい場合は、こちらを参照してください。上記のスキーマで課される外部キー制約のため、PostgreSQL 用の完全なデータセットには、参照整合性を満たす行のみが含まれます。このような制約のない Parquet バージョン は、必要に応じて ClickHouse に直接簡単に読み込めます。ClickPipes for PostgreSQL をセットアップするには、このガイドを参照してください。このガイドでは、さまざまな種類のソース Postgres インスタンスを対象としています。 ClickPipes または PeerDB を使用する CDC (変更データキャプチャ) アプローチでは、PostgreSQL データベース内の各テーブルが ClickHouse に自動的にレプリケートされます。 更新と削除をほぼリアルタイムで処理するため、ClickPipes は Postgres のテーブルを、ClickHouse での更新と削除の処理向けに特別に設計された ReplacingMergeTree エンジンを使用して ClickHouse にマッピングします。ClickPipes を使用してデータが ClickHouse にどのようにレプリケートされるかについては、こちらで詳しく確認できます。CDC (変更データキャプチャ) を使用したレプリケーションでは、更新または削除操作をレプリケートする際に、ClickHouse 内に重複した行が作成される点に注意が必要です。ClickHouse でこれらに対処するには、FINAL 修飾子を使用する手法を参照してください。 ClickPipes を使用して ClickHouse にテーブル
users がどのように作成されるかを見てみましょう。
- テーブル関数 - ClickHouse の Postgres table function を使用して、Postgres からデータを
SELECTし、ClickHouse のテーブルにINSERTします。数百 GB 程度までのデータセットのバルクロードに適しています。 - エクスポート - CSV や SQL スクリプトファイルなどの中間フォーマットにエクスポートします。これらのファイルは、その後クライアントから
INSERT FROM INFILE句を使用するか、オブジェクトストレージと関連する関数 (s3、gcs など) を使用して ClickHouse に読み込めます。
DESCRIBE コマンドを使用できます。次のコマンドは PostgreSQL の posts テーブルを表示します。お使いの環境に合わせて変更してください。
Query
Query
INSERT INTO SELECT で投入できます:
Query
insert のみで、単調増加する id または timestamp が存在する場合は、上記のテーブル関数のアプローチを使って増分データをロードできます。つまり、SELECT に WHERE 句を適用できます。このアプローチは、更新時に常に同じカラムが更新されることが保証されている場合、更新への対応にも利用できます。ただし、削除に対応するには完全な再ロードが必要であり、テーブルが大きくなるにつれて、その実施は難しくなる可能性があります。
ここでは、CreationDate を使用した初期ロードと増分ロードを示します (行が更新された場合は、これも更新されるものと仮定します) 。.
ClickHouse は、=,!=,>,>=,<,<=, IN などの単純なWHERE句を PostgreSQL サーバーにプッシュダウンできます。そのため、変更セットの特定に使うカラムに索引を作成しておくことで、増分ロードをより効率化できます。
クエリレプリケーションの使用時に UPDATE 操作を検出する方法の 1 つとして、第2部はこちらXMINsystem column (トランザクション ID) をウォーターマークとして使う方法があります。このカラムの値が変化した場合は変更があったことを示すため、その変更を宛先テーブルに適用できます。この方法を採用する場合は、XMINの値が周回する可能性があること、また比較にはフルテーブルスキャンが必要になるため、変更の追跡がより複雑になる点に注意してください。