

INSERT、UPDATE、DELETE 操作に基づく変更をストリーミングする、より高レベルな抽象化です。結果として物理レプリケーションと同様のことが可能な場合もありますが、特定のテーブルや操作を対象にしたり、データ変換を行ったり、異なる Postgres バージョンをサポートしたりできるため、より高い柔軟性があります。
これに対して、ClickHouse の分片とレプリカは、データ分散と冗長性に関する 2 つの重要な概念です。ClickHouse のレプリカは Postgres のレプリカに似ていますが、レプリケーションは結果整合性であり、プライマリという概念はありません。一方、シャーディングは Postgres と違ってネイティブにサポートされています。
分片は、テーブルデータの一部です。分片は常に少なくとも 1 つ存在します。データを複数のサーバーにまたがってシャーディングすることで、単一サーバーの容量を超える場合でも負荷を分散できます。このとき、すべての分片がクエリを並列に実行するために使われます。異なるサーバー上にテーブルの分片を手動で作成し、そこへ直接データを挿入することもできます。あるいは、データをどの分片に振り分けるかを定義するシャーディングキーを持つ分散テーブルを使うこともできます。シャーディングキーにはランダムな値を使うことも、ハッシュ関数の出力を使うこともできます。重要なのは、1 つの分片が複数のレプリカで構成される場合があるという点です。
レプリカは、データのコピーです。ClickHouse には常に少なくとも 1 つのデータのコピーが存在するため、レプリカの最小数は 1 です。データの 2 つ目のレプリカを追加すると、耐障害性が得られ、さらに多くのクエリを処理するための追加のコンピュートも利用できる可能性があります (単一のクエリのコンピュートを分散してレイテンシを下げるために、並列レプリカ を使うこともできます) 。レプリカは ReplicatedMergeTree テーブルエンジン によって実現され、これにより ClickHouse は異なるサーバー間で複数のデータコピーの同期を保てます。レプリケーションは物理的です。ノード間で転送されるのはクエリではなく、圧縮されたパーツだけです。
要約すると、レプリカは冗長性と信頼性 (場合によっては分散処理も) を提供するデータのコピーであり、分片は分散処理と負荷分散を可能にするデータの一部分です。
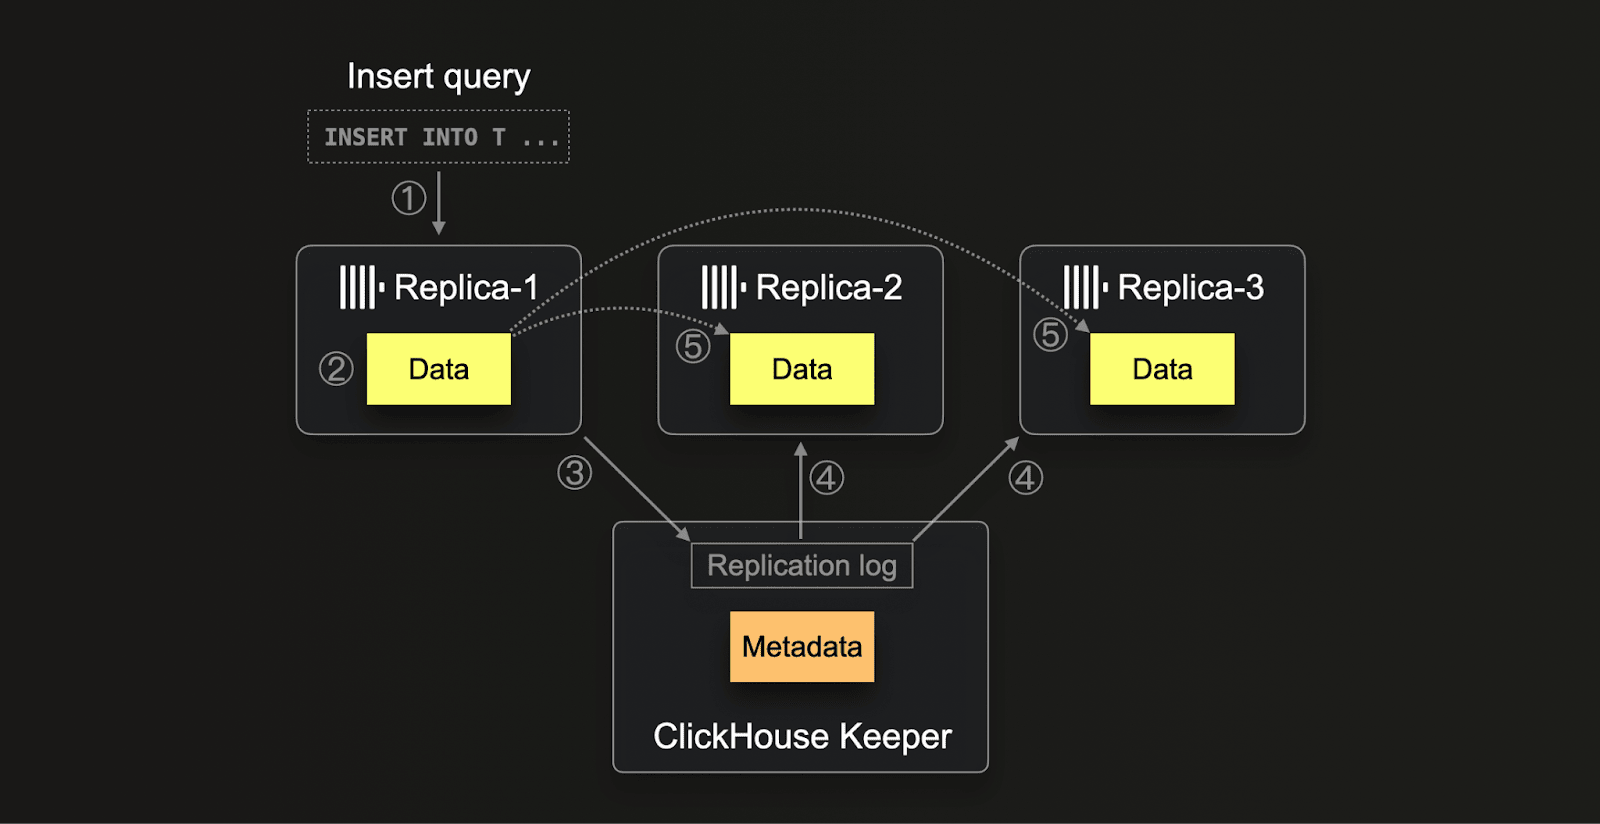
ClickHouse Cloud は、S3 をバックエンドとする単一のデータコピーと、複数のコンピュートレプリカを使用します。データは各レプリカノードから利用でき、各ノードにはローカルSSD cache があります。これは、ClickHouse Keeper を通じたメタデータのレプリケーションのみに依存しています。ClickHouse は、内部のレプリケーション機構の管理に ClickHouse Keeper (C++ 製の ZooKeeper 実装。ZooKeeper を使用することも可能) を使用しており、主にメタデータの保存と結果整合性の確保を担っています。Keeper は、分散環境内で各 insert に一意の連番を割り当てるために使われます。これは、各操作の順序と整合性を維持するうえで重要です。この仕組みは、マージやミューテーションといったバックグラウンド処理も管理し、それらの作業を分散しつつ、すべてのレプリカで同じ順序で実行されることを保証します。さらに Keeper は、メタデータの管理に加えて、保存された パーツ のチェックサムの追跡を含むレプリケーション全体の制御センターとして機能し、レプリカ間の分散通知システムとしても機能します。 ClickHouse におけるレプリケーションのプロセスは、(1) いずれかのレプリカにデータが挿入されると始まります。このデータは、挿入されたままの生データとして、(2) チェックサムとともにディスクに書き込まれます。書き込みが完了すると、そのレプリカは (3) 一意の block 番号を割り当て、新しいパーツの詳細を記録することで、この新しい パーツ を Keeper に登録しようとします。ほかのレプリカは、レプリケーションログ内の新しいエントリを (4) 検出すると、(5) 内部 HTTP プロトコルを介して対応する パーツ をダウンロードし、ZooKeeper に記録されたチェックサムと照合して検証します。この方法により、処理速度の違いや遅延があっても、最終的にはすべてのレプリカが一貫した最新データを保持できるようになります。さらにこのシステムは、複数の操作を同時実行で処理できるため、データ管理プロセスを最適化し、システムの拡張性とハードウェア差異に対する堅牢性を高めます。
スティッキーエンドポイントを利用するには、サポートに連絡してください。OSS でこの動作を実現する方法は、分片とレプリカのトポロジー、およびクエリに 分散テーブル を使用しているかどうかに依存します。 分片が 1 つでレプリカがある場合 (ClickHouse は一般に垂直スケールするため、よくある構成です) 、ユーザーはクライアント層でノードを選択し、レプリカに直接クエリを実行します。このとき、選択が決定論的になるようにする必要があります。 複数の分片とレプリカを持つトポロジーは、分散テーブルがなくても構成可能です。ただし、このような高度なデプロイメントでは通常、独自のルーティング用インフラストラクチャが用意されています。そのため、複数の分片を持つデプロイメントでは分散テーブルを使用しているものと想定します (分散テーブルは単一分片のデプロイメントでも使用できますが、通常は不要です) 。 この場合、
session_id や user_id などのプロパティに基づいて、一貫したノードルーティングが行われるようにする必要があります。設定 prefer_localhost_replica=0 と load_balancing=in_order は、クエリで設定 する必要があります。これにより、まず各分片のローカルレプリカが優先され、ローカルレプリカがない場合は設定に記載された順序でレプリカが優先されます。ただし、これはエラー数が同じ場合に限られ、エラー数が多い場合はランダム選択でフェイルオーバーします。決定論的な分片選択の代替として、load_balancing=nearest_hostname も使用できます。
分散テーブルを作成するときは、クラスターを指定します。config.xml で指定するこのクラスター定義には、分片 (およびそのレプリカ) が列挙されます。これにより、各ノードからどの順序で使用するかをユーザーが制御できます。これを利用すれば、選択を決定論的にできます。例外的なケースでは、逐次整合性が必要になることがあります。 データベースにおける逐次整合性とは、データベース上の操作が何らかの逐次的な順序で実行されているように見え、その順序がデータベースとやり取りするすべてのプロセスで一貫していることを指します。つまり、すべての操作は呼び出しから完了までのどこかの時点で瞬時に反映されたように見え、すべてのプロセスが観測する操作順序は単一の合意された順序になります。 ユーザーの観点では、これは通常、ClickHouse にデータを書き込んだあとに読み取る際、直近に挿入された行が必ず返されることを保証したい、という要件として現れます。 これはいくつかの方法で実現できます (推奨順) :
- 同じノードに対して読み書きする - ネイティブプロトコルを使用している場合、または HTTP 経由で書き込み/読み取りを行うセッション を使用している場合は、同じレプリカに接続している必要があります。この場合、書き込み先のノードから直接読み取るため、読み取り結果は常に一貫します。
- レプリカを手動で同期する - 1 つのレプリカに書き込み、別のレプリカから読み取る場合は、読み取り前に
SYSTEM SYNC REPLICA LIGHTWEIGHTを実行できます。 - 逐次整合性を有効にする - クエリ設定
select_sequential_consistency = 1を使用します。OSS では、設定insert_quorum = 'auto'も指定する必要があります。
これらの設定を有効にする方法の詳細は、こちら を参照してください。
逐次整合性を使用すると、ClickHouse Keeper への負荷が増加します。その結果、 書き込みと読み取りが遅くなる可能性があります。ClickHouse Cloud でメインのテーブルエンジンとして使われている SharedMergeTree では、逐次整合性のオーバーヘッドが小さく、より高いスケーラビリティが得られます。OSS では、この方法は慎重に使用し、Keeper の負荷を測定してください。PostgreSQL から移行するユーザーにとって、ACID (アトミック性、整合性、分離性、耐久性) 特性に対する PostgreSQL の堅牢なサポートはなじみ深いものでしょう。そのため、PostgreSQL はトランザクション処理向けデータベースとして信頼性の高い選択肢となっています。PostgreSQL のアトミック性により、各トランザクションはひとまとまりの単位として扱われ、完全に成功するか、完全にロールバックされるかのいずれかとなるため、中途半端な更新は発生しません。整合性は、すべてのデータベーストランザクションが正しい状態に到達することを保証する制約、トリガー、ルールの適用によって維持されます。PostgreSQL は Read Committed から Serializable までの分離レベルをサポートしており、同時実行されるトランザクションによる変更の可視性をきめ細かく制御できます。最後に、耐久性は先行書き込みログ (WAL) によって実現され、いったんトランザクションがコミットされると、システム障害が発生してもその状態が保持されます。 これらの特性は、信頼できる正本として機能する OLTP データベースでは一般的です。 一方で、こうした特性には本質的な制約が伴うため、PB 規模へのスケールは難しくなります。ClickHouse は、高い書き込みスループットを維持しながら大規模で高速な分析クエリを実現するために、これらの特性の一部をトレードオフしています。 ClickHouse は、限定的な構成 において ACID 特性を提供します。最も単純なのは、1 つのパーティションを持つ MergeTree テーブルエンジンの非レプリケートなインスタンスを使用する場合です。これらのケース以外でこれらの特性を期待すべきではないため、それらが要件でないことを確認してください。 ClickHouseのカラム指向ストレージでは、Postgresと比べて圧縮効率が大幅に高くなることがよくあります。以下は、両方のデータベースにおけるStack Overflowの全テーブルの必要ストレージ容量を比較したものです。
Query (Postgres)
Query (ClickHouse)
Response