

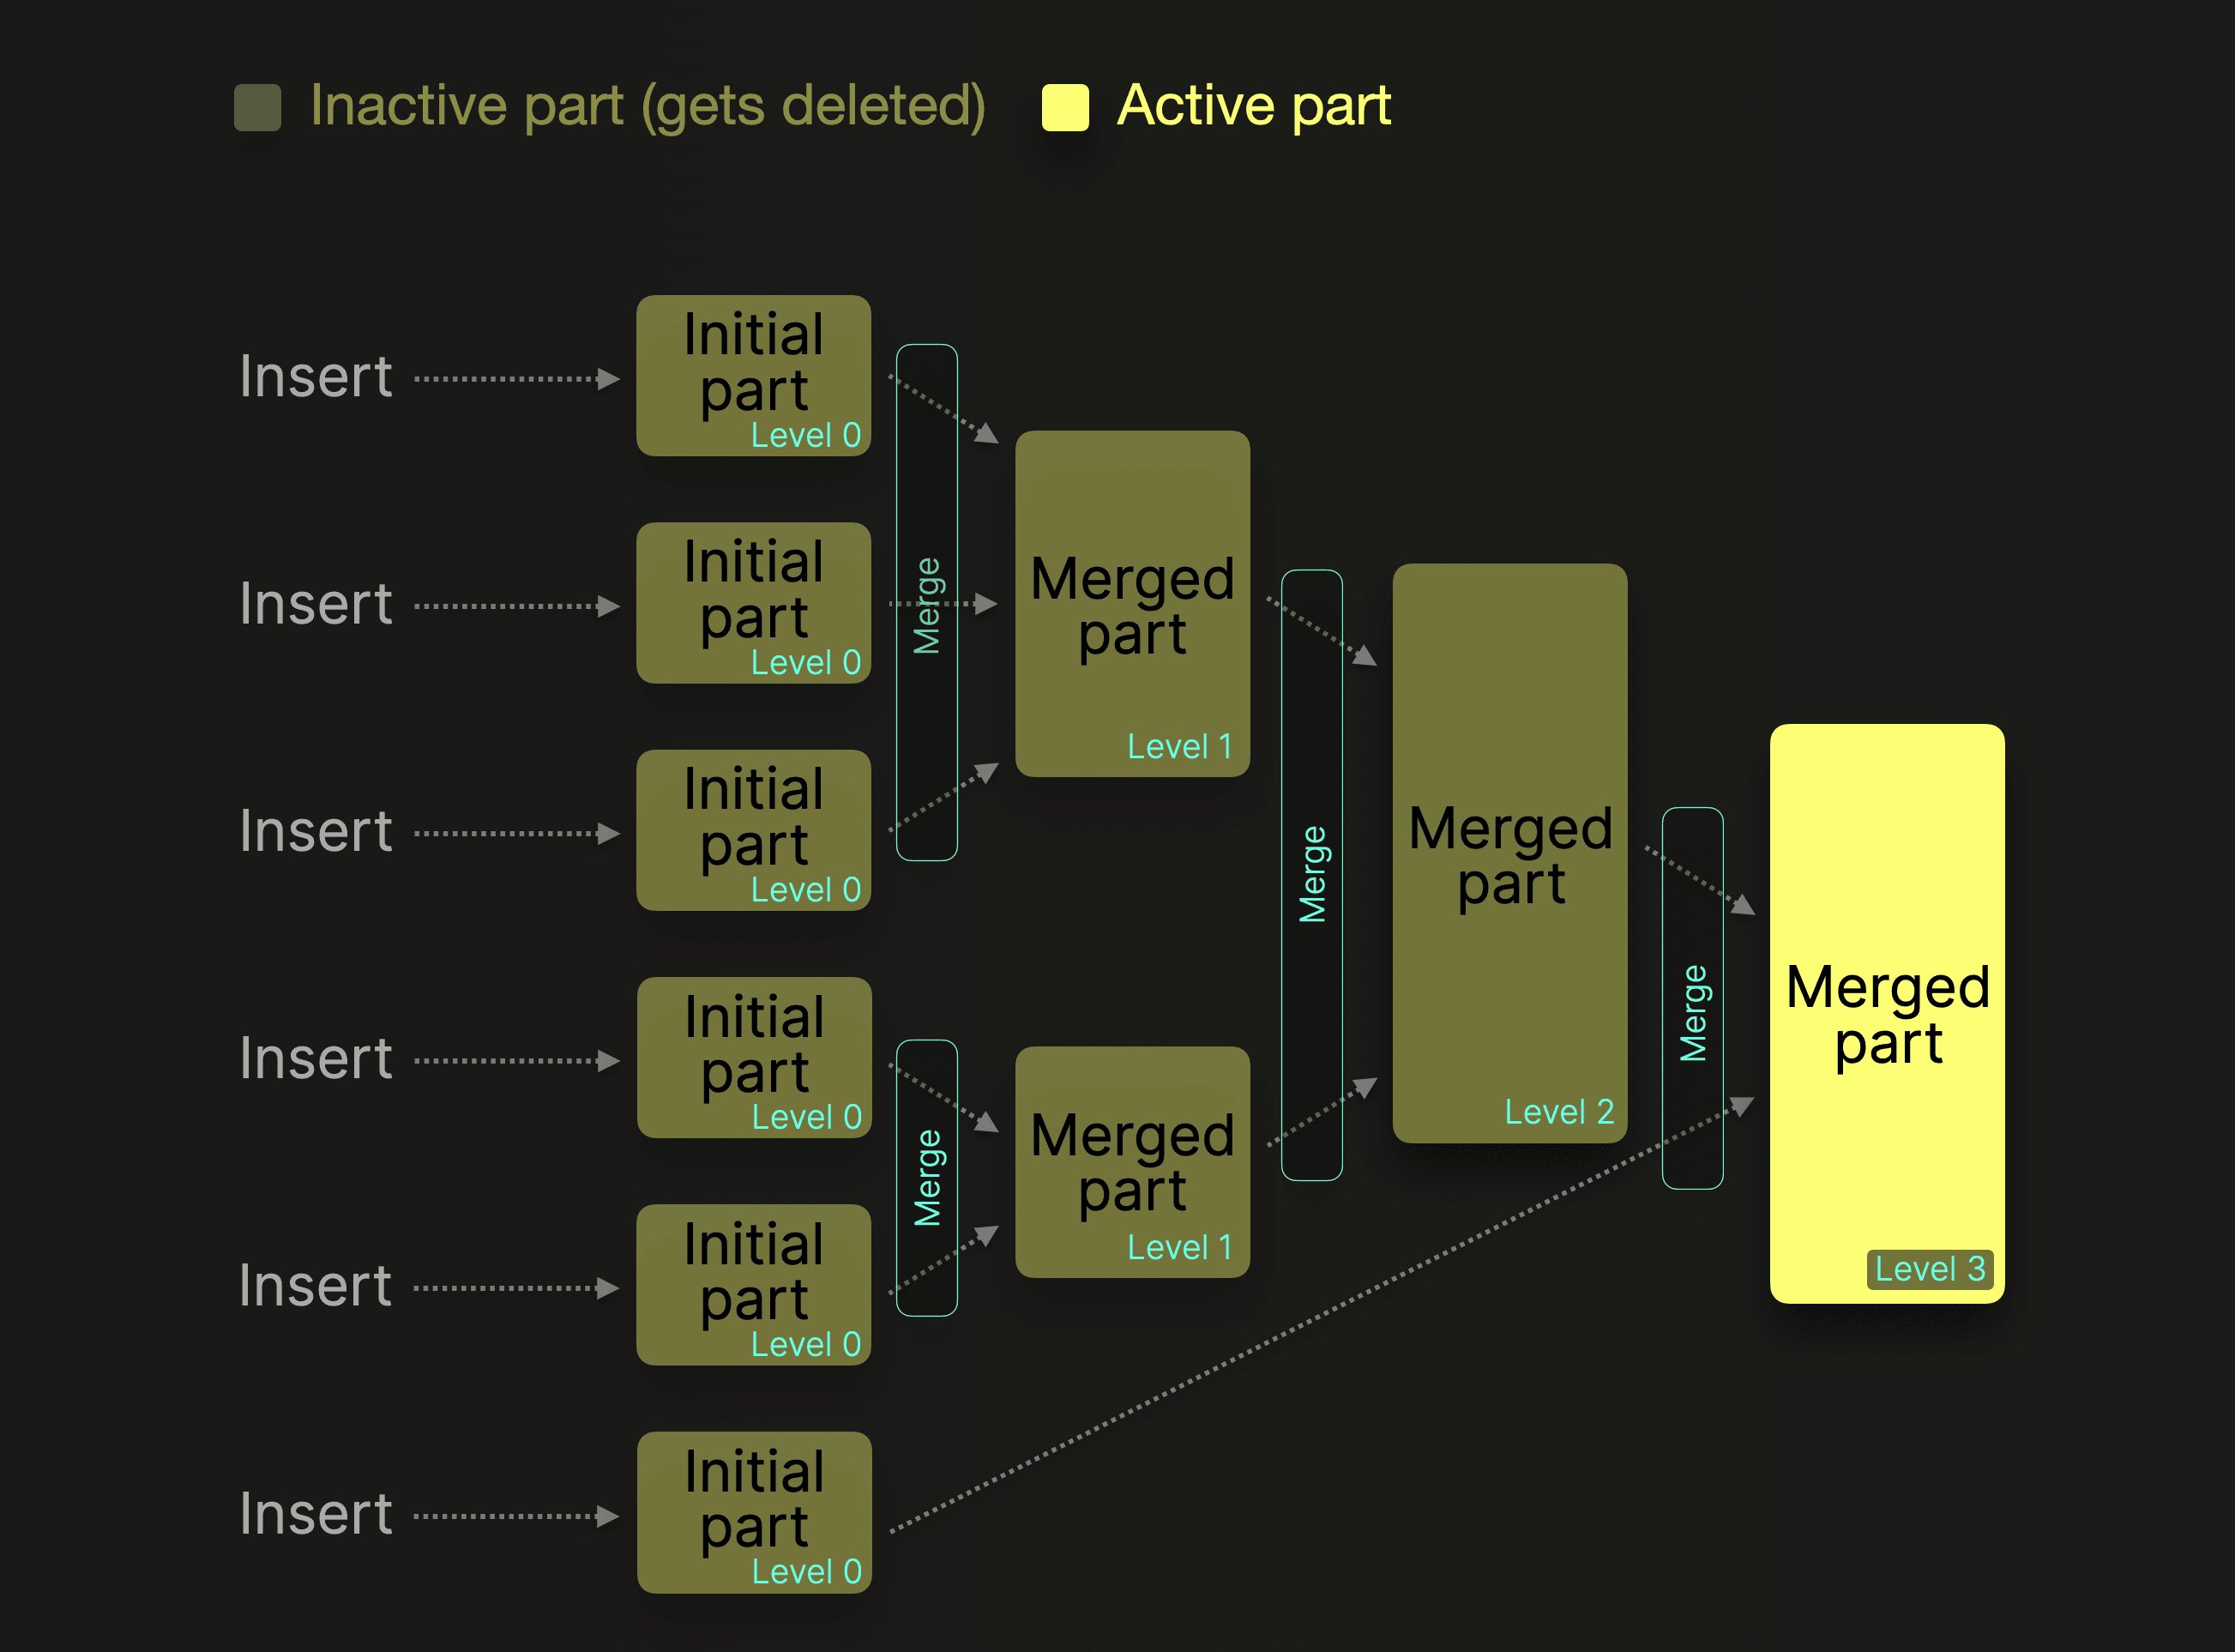
ClickHouse が高速なのは、クエリだけでなく insert でも同様です。これは、LSM trees に似た仕組みで動作するストレージ層によるものです。 ① MergeTree エンジン ファミリーのテーブルへの insert では、ソート済みで不変のデータパーツが作成されます。 ② すべてのデータ処理は、バックグラウンドでのパーツマージにオフロードされます。 その結果、データの書き込みは軽量で、非常に効率的になります。 テーブルごとのパーツ数を制御し、上記の ② を実現するために、ClickHouse はバックグラウンドで小さなパーツを大きなパーツへ継続的にマージし (パーティションごと) 、圧縮サイズがおよそ ~150 GB に達するまでこれを続けます。 次の図は、このバックグラウンドマージのプロセスを概略的に示したものです。
パーツの
merge level は、マージのたびに 1 ずつ増加します。レベル 0 は、そのパーツが新規作成されたもので、まだマージされていないことを意味します。より大きなパーツにマージされたパーツはinactiveとしてマークされ、最終的には設定可能な時間の経過後に削除されます (デフォルトは 8 分) 。時間の経過とともに、これによりマージ済みパーツのツリーが形成されます。これが merge tree テーブルという名前の由来です。
テーブルパーツとはの例では、ClickHouse がすべてのテーブルパーツを parts システムテーブルで追跡していることを示しました。この例のテーブルにあるアクティブな各パーツについて、マージレベルと保存されている行数を取得するために、次のクエリを使用しました。
/merges HTTP ハンドラー経由で利用でき、この例のテーブルで発生するすべてのパーツマージを可視化できます。
上のダッシュボードの録画では、最初のデータ挿入から単一パーツへの最終的なマージまで、プロセス全体を確認できます。 ① アクティブなパーツ数。 ② ボックスで視覚的に表したパーツマージ (サイズはパーツの大きさを反映) 。 ③ 書き込み増幅。 1 台の ClickHouse サーバーは、複数のバックグラウンドマージスレッドを使用して、パーツの同時マージを実行します。
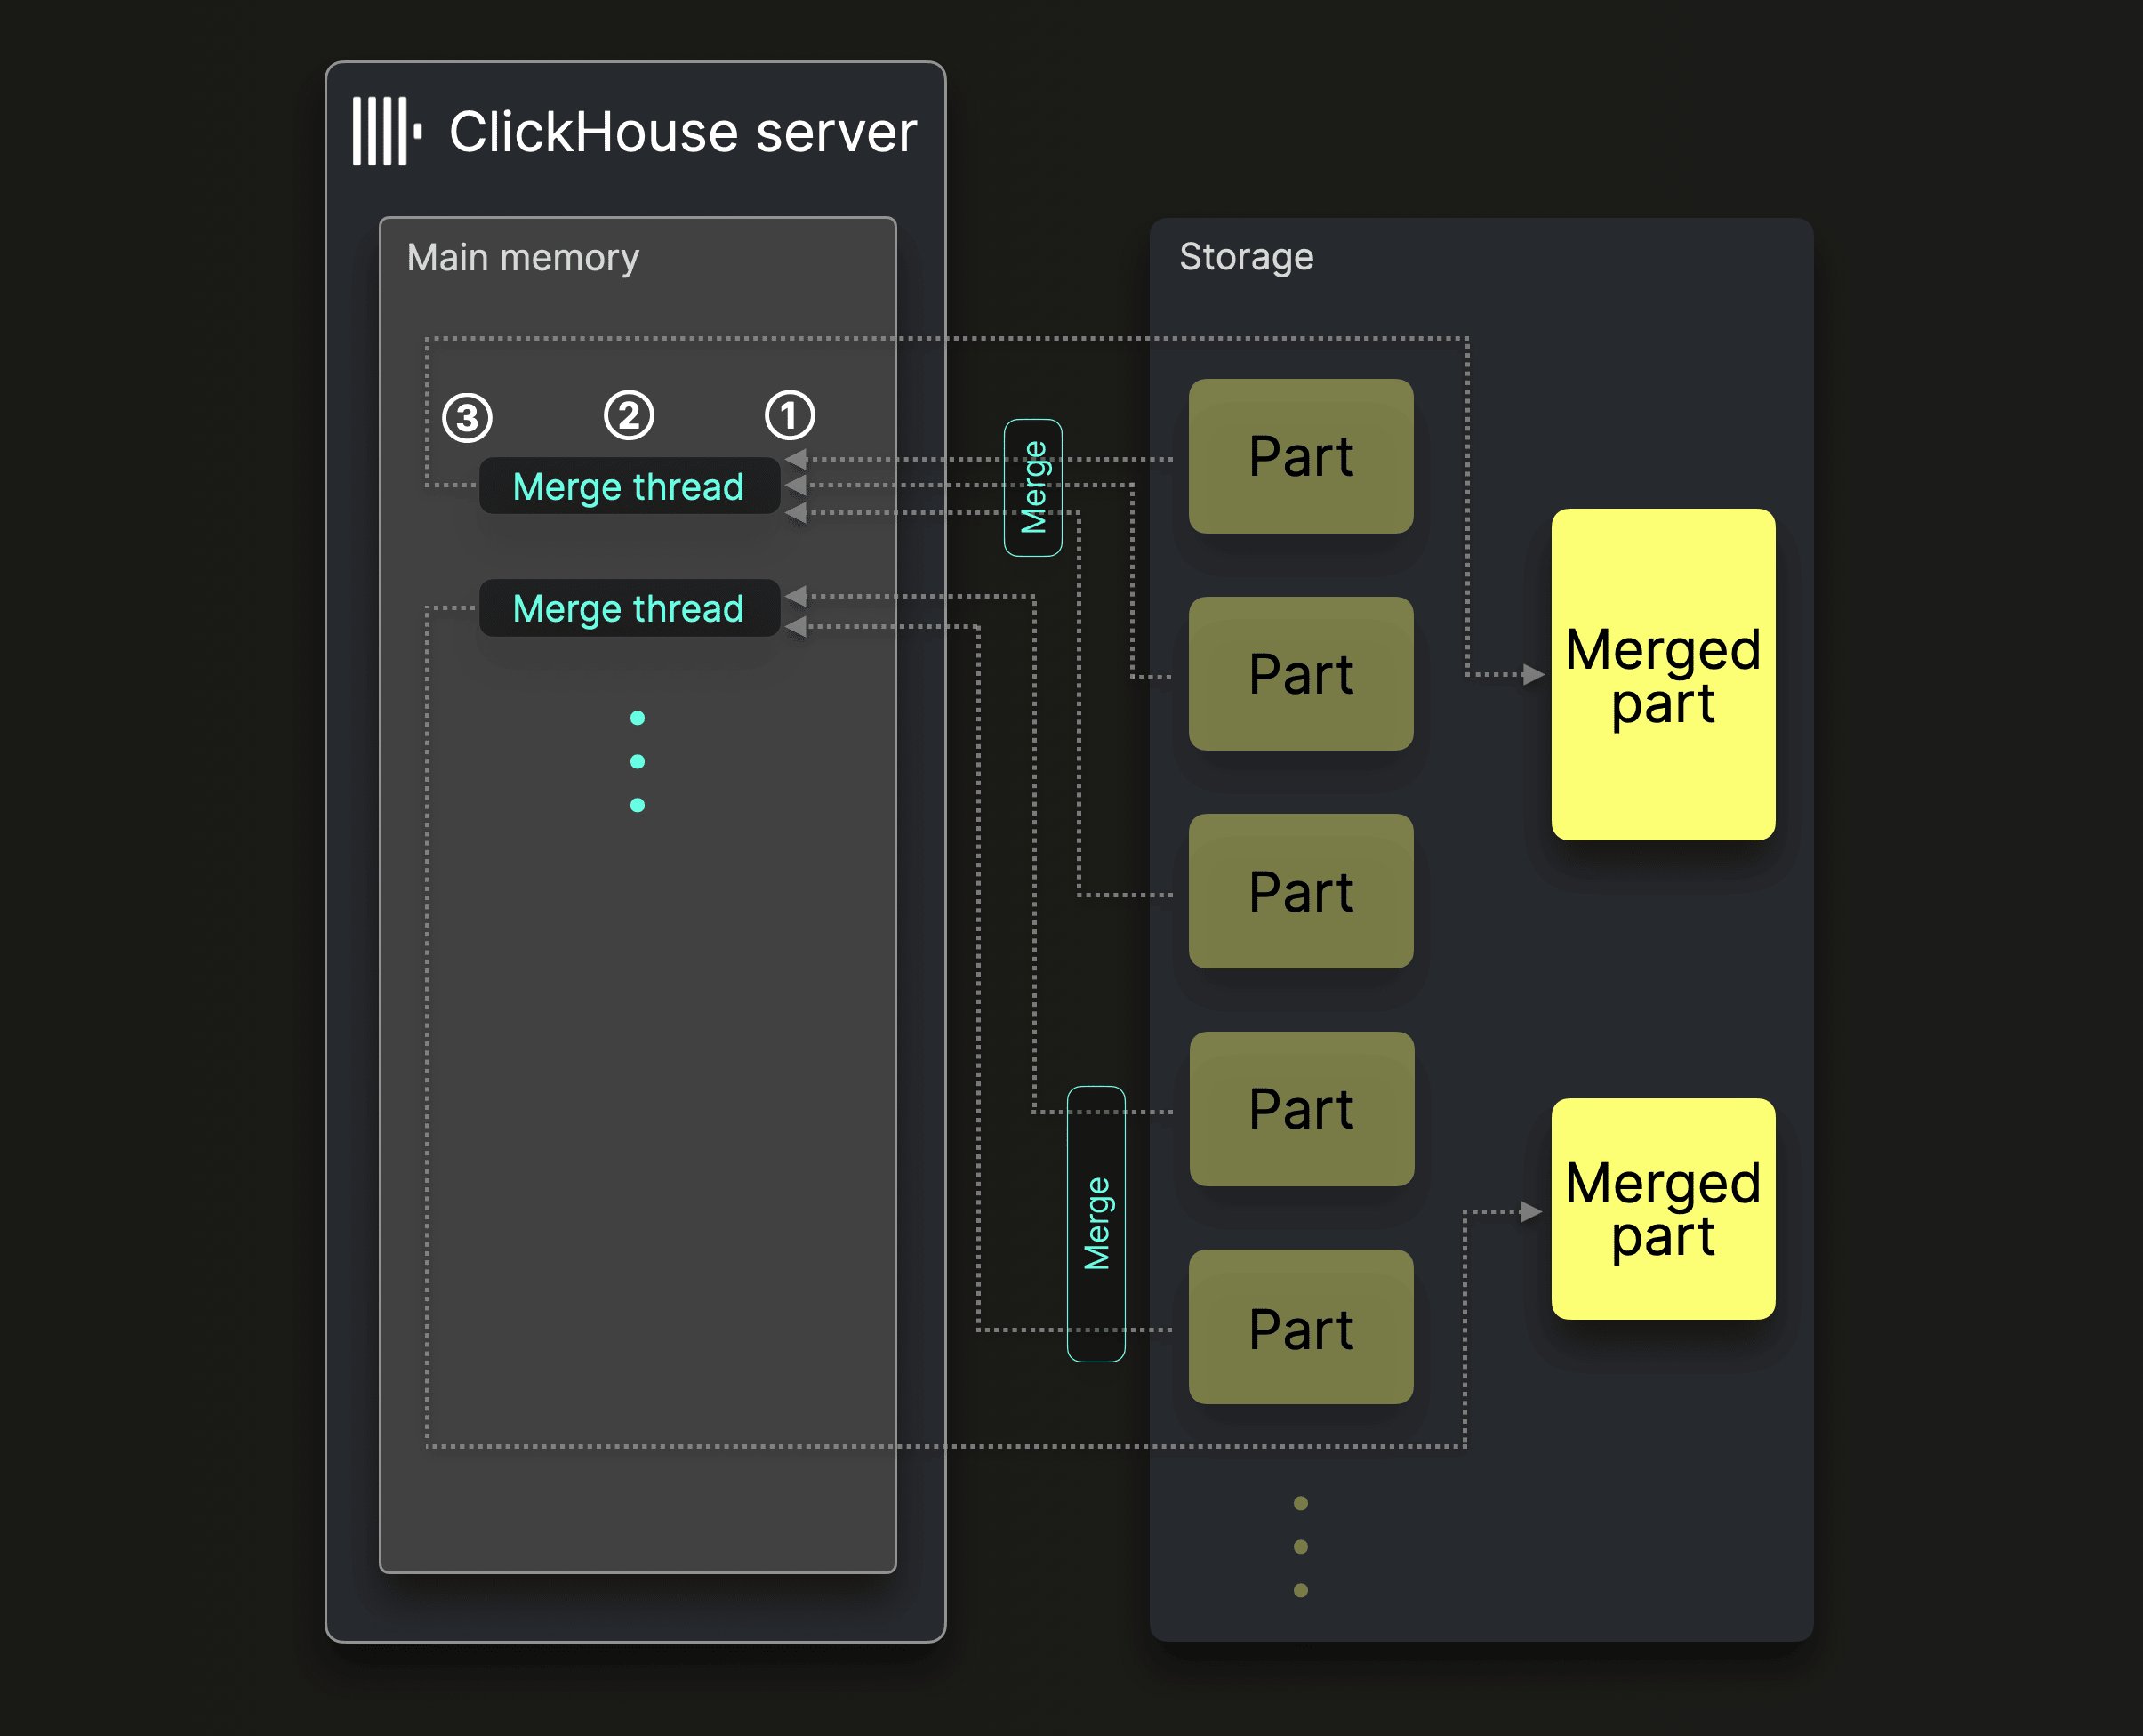
各マージスレッドは、次のループを実行します。
1
パーツをメモリに読み込む
次にマージするパーツを決定し、それらのパーツをメモリに読み込みます。
2
パーツをマージする
メモリ内でパーツをより大きなパーツにマージします。
3
ディスクに書き込む
マージされたパーツをディスクに書き込み、ステップ 1 に戻ります。
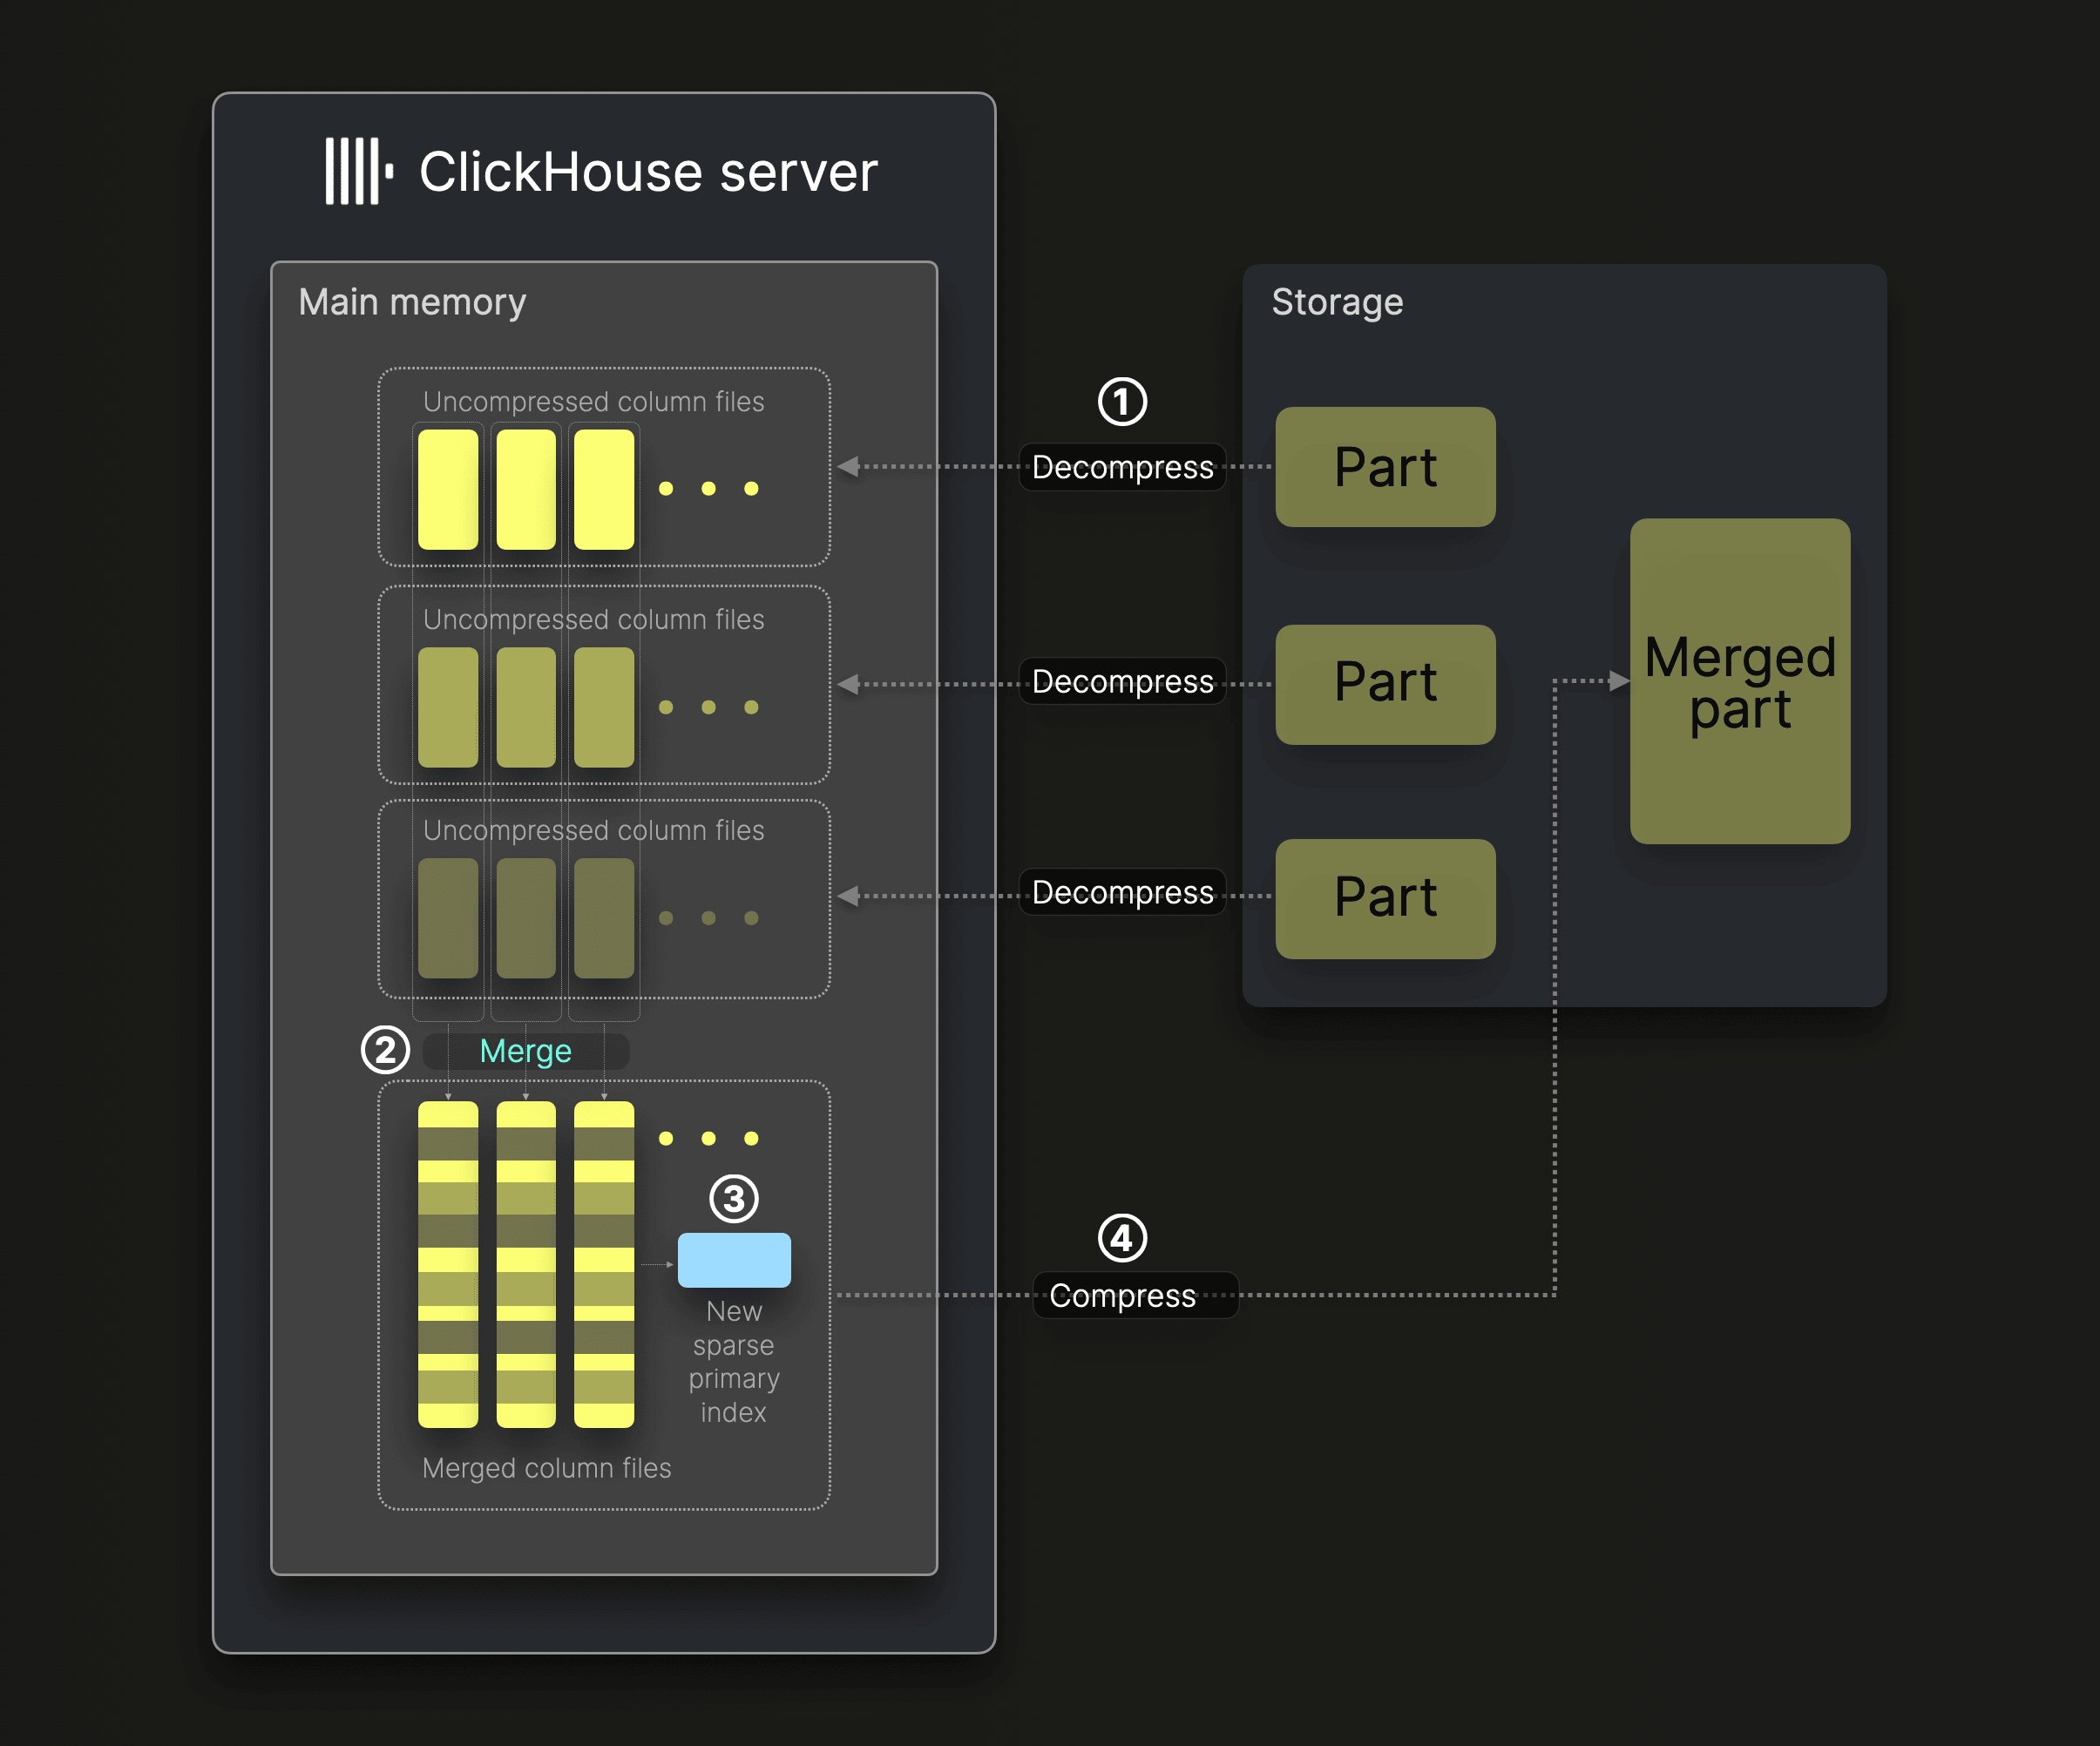
パーツマージは、いくつかのステップで実行されます:
1
解凍と読み込み
マージ対象のパーツに含まれる圧縮済みバイナリカラムファイルを解凍し、メモリに読み込みます。
2
マージ
データを、より大きなカラムファイルへマージします。
3
索引作成
マージ後のカラムファイルに対して、新しいスパースプライマリインデックスが生成されます。
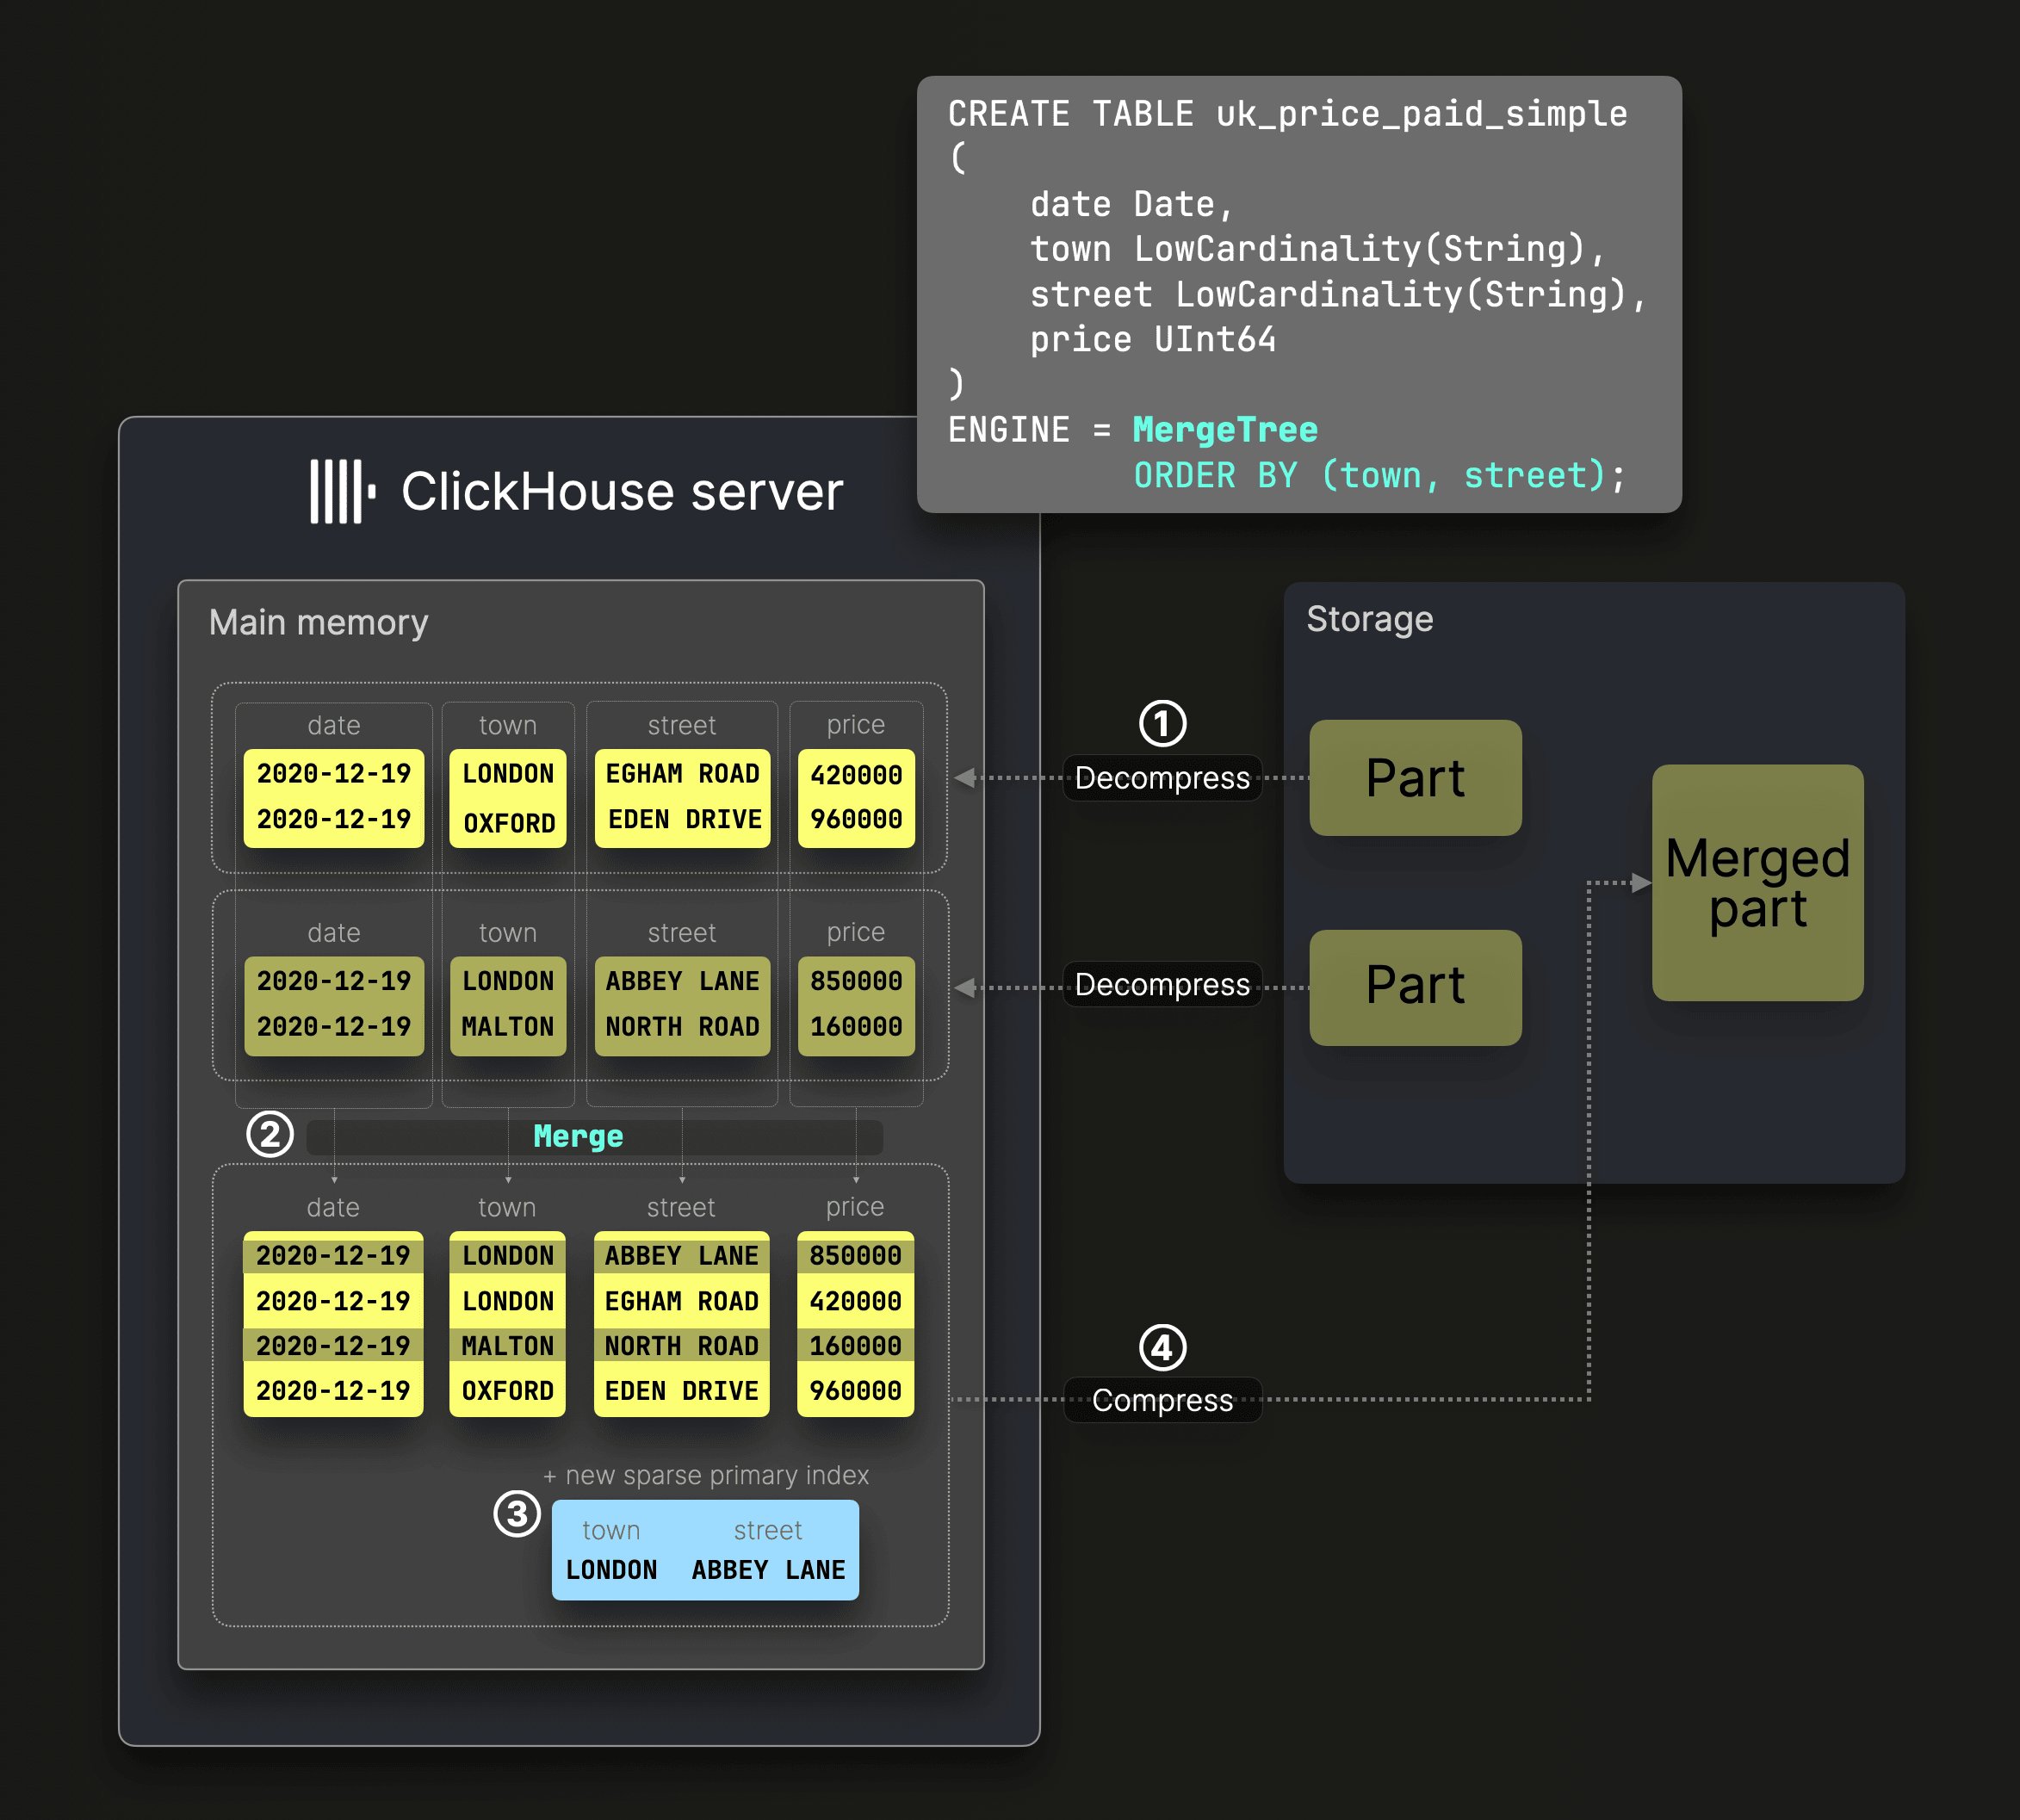
上図のDDLステートメントは、ソートキーが
(town, street) の MergeTree テーブルを作成します。つまり、ディスク上のデータはこれらのカラムでソートされ、それに応じてスパースプライマリインデックスが生成されることを意味します。
① 圧縮解除され、あらかじめソートされたテーブルのカラムが、テーブルのソートキーで定義された全体のソート順を維持したまま ② マージされ、③ 新しいスパースプライマリインデックスが生成され、④ マージ後のカラムファイルと索引が圧縮されて、ディスク上の新しいデータパーツとして保存されます。
ReplacingMergeTree テーブルのパーツマージは、標準的なマージ と同様に動作しますが、各行については最新バージョンのみが保持され、古いバージョンは破棄されます。
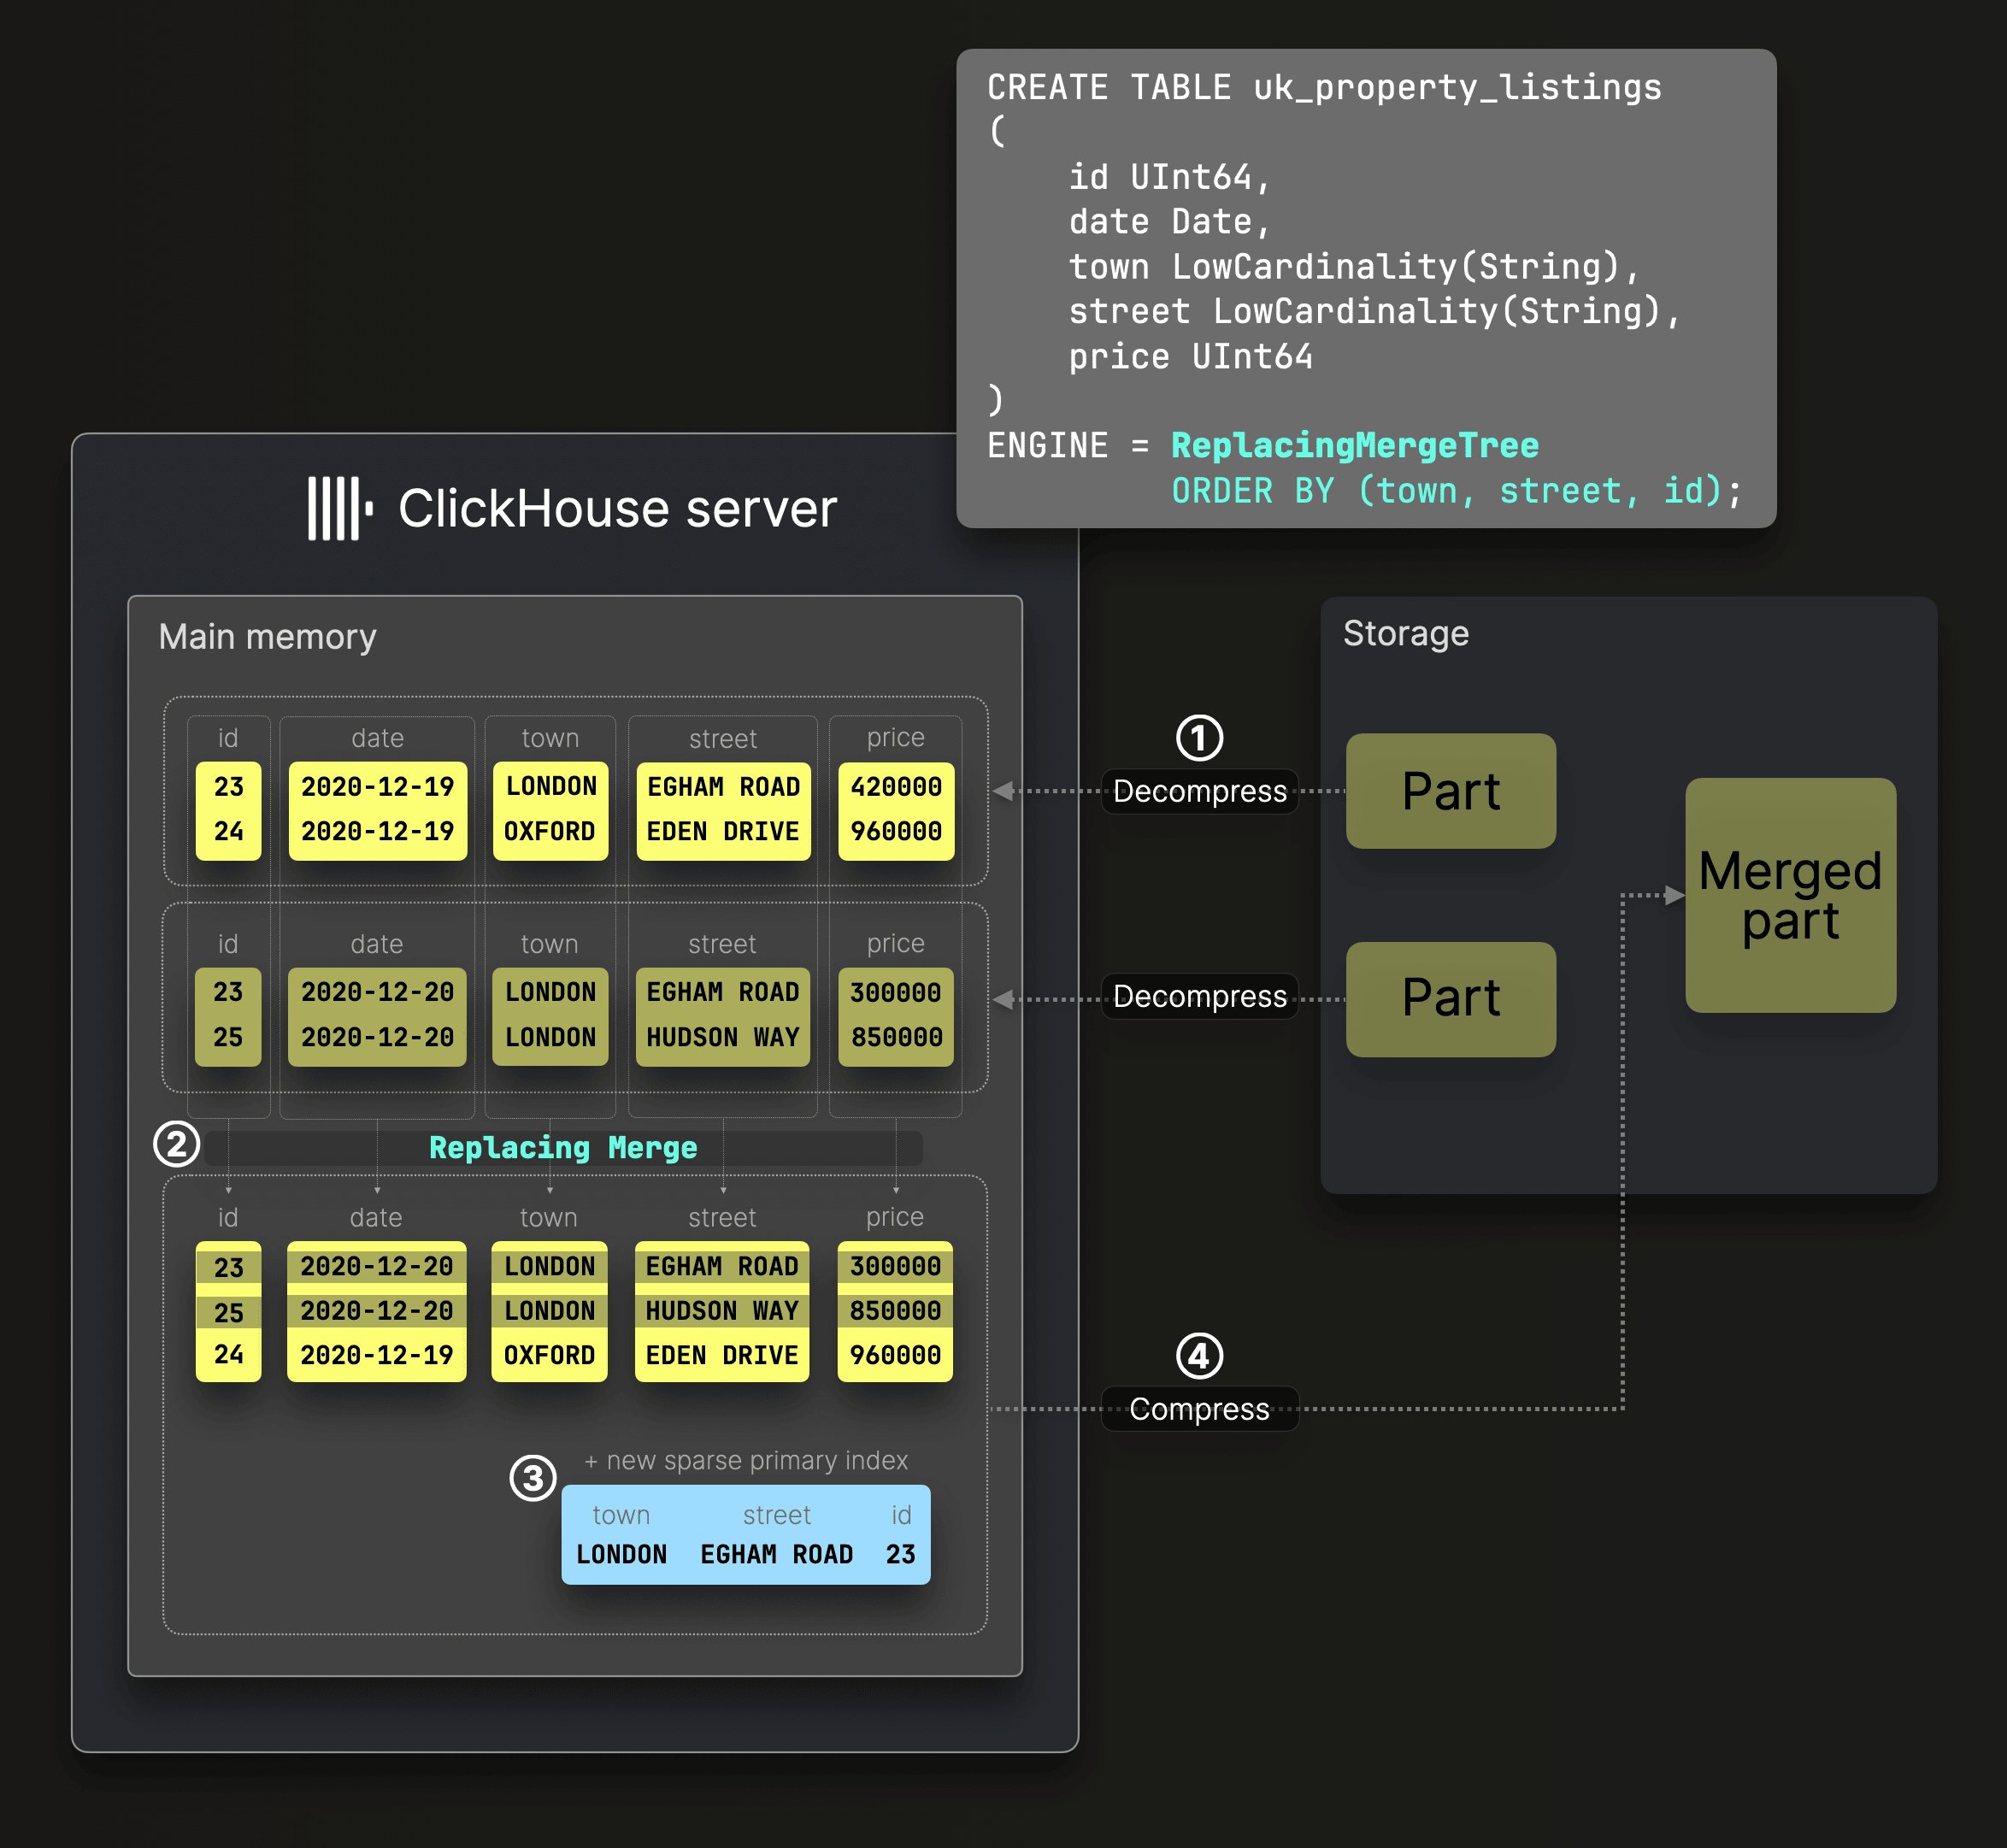
上の図の DDL ステートメントは、ソートキー
(town, street, id) を持つ ReplacingMergeTree テーブルを作成しています。これは、ディスク上のデータがこれらのカラム順にソートされ、それに応じてスパースプライマリインデックスが生成されることを意味します。
② のマージ処理は、標準的な MergeTree テーブルと同様に動作し、グローバルなソート順を維持しながら、解凍済みで事前にソートされたカラムを結合します。
ただし、ReplacingMergeTree では同じソートキーを持つ重複行が削除され、その行を含むパーツの作成タイムスタンプに基づいて最新の行だけが保持されます。
数値データは、SummingMergeTree テーブルのパーツのマージ時に自動的に集計されます。
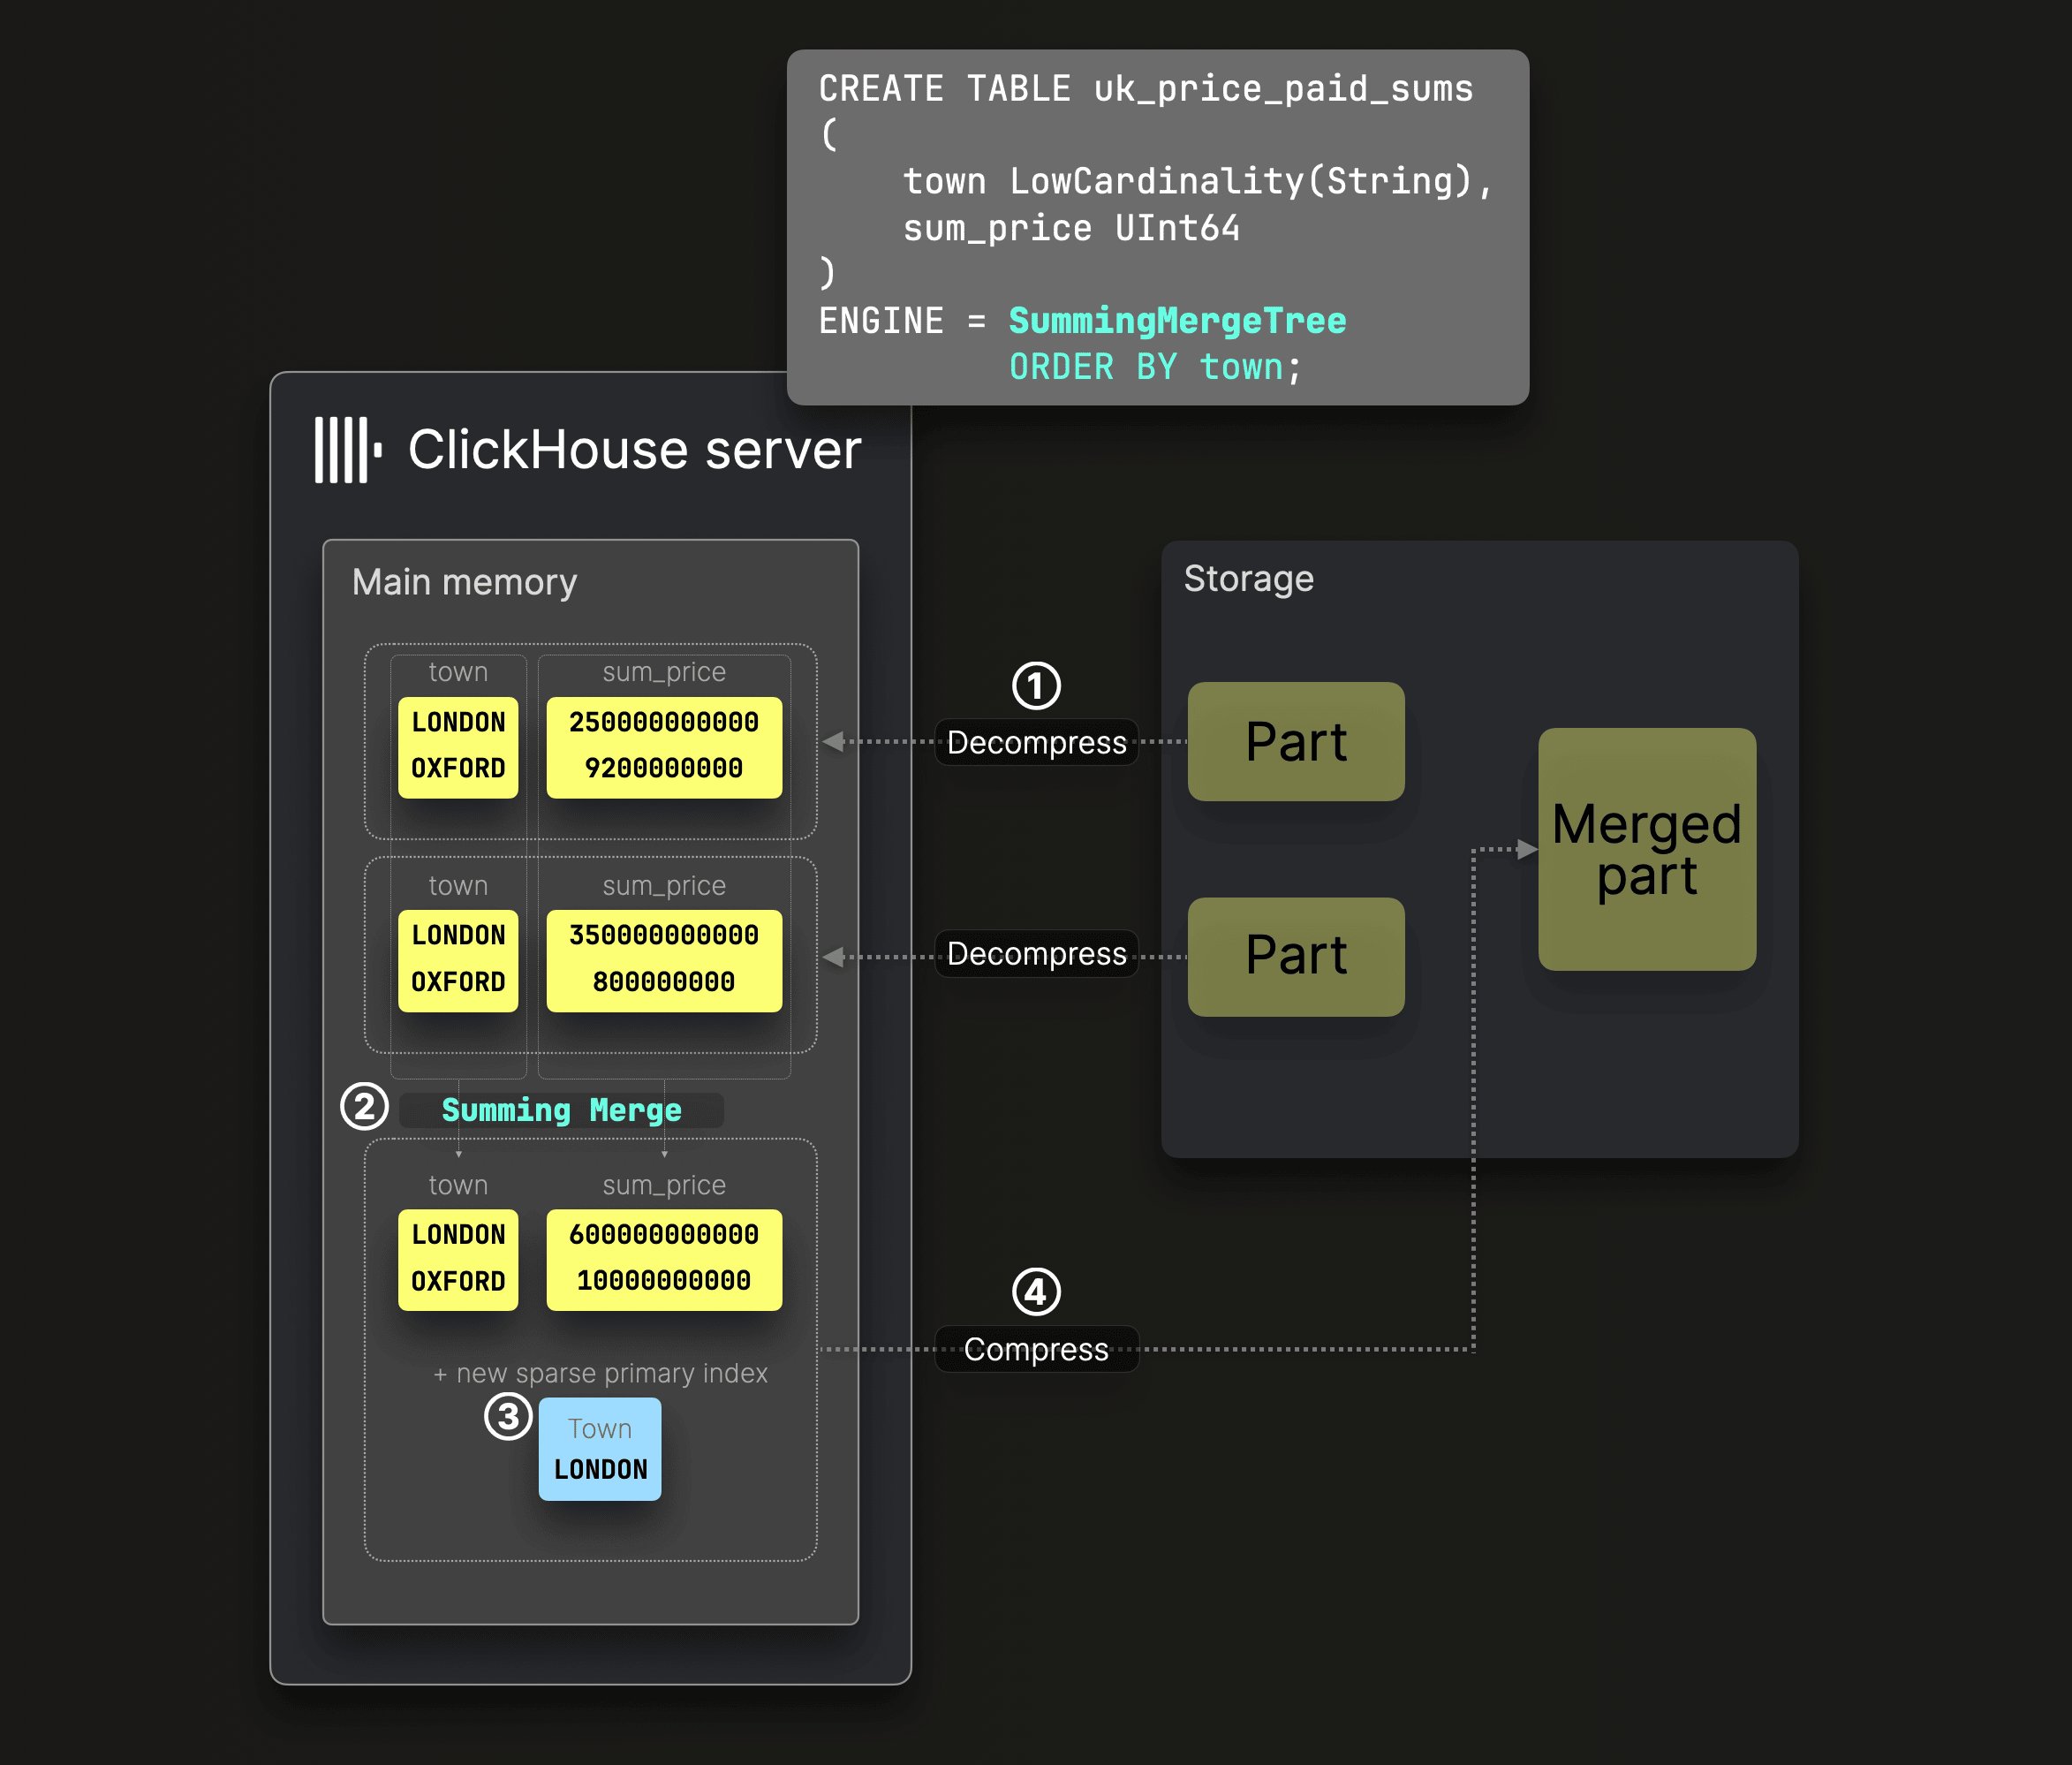
上の図の DDLステートメントでは、
town をソートキーとする SummingMergeTree テーブルを定義しています。これは、ディスク上のデータがこのカラムでソートされ、それに対応するスパースプライマリインデックスが作成されることを意味します。
② のマージ処理では、ClickHouse は同じソートキーを持つすべての行を 1 つの行に置き換え、数値カラムの値を合計します。
前述の SummingMergeTree テーブルの例は、AggregatingMergeTree テーブルの特化版であり、パートのマージ時に 90+ の任意の集計関数を適用することで、データの自動インクリメンタル変換 を可能にします。
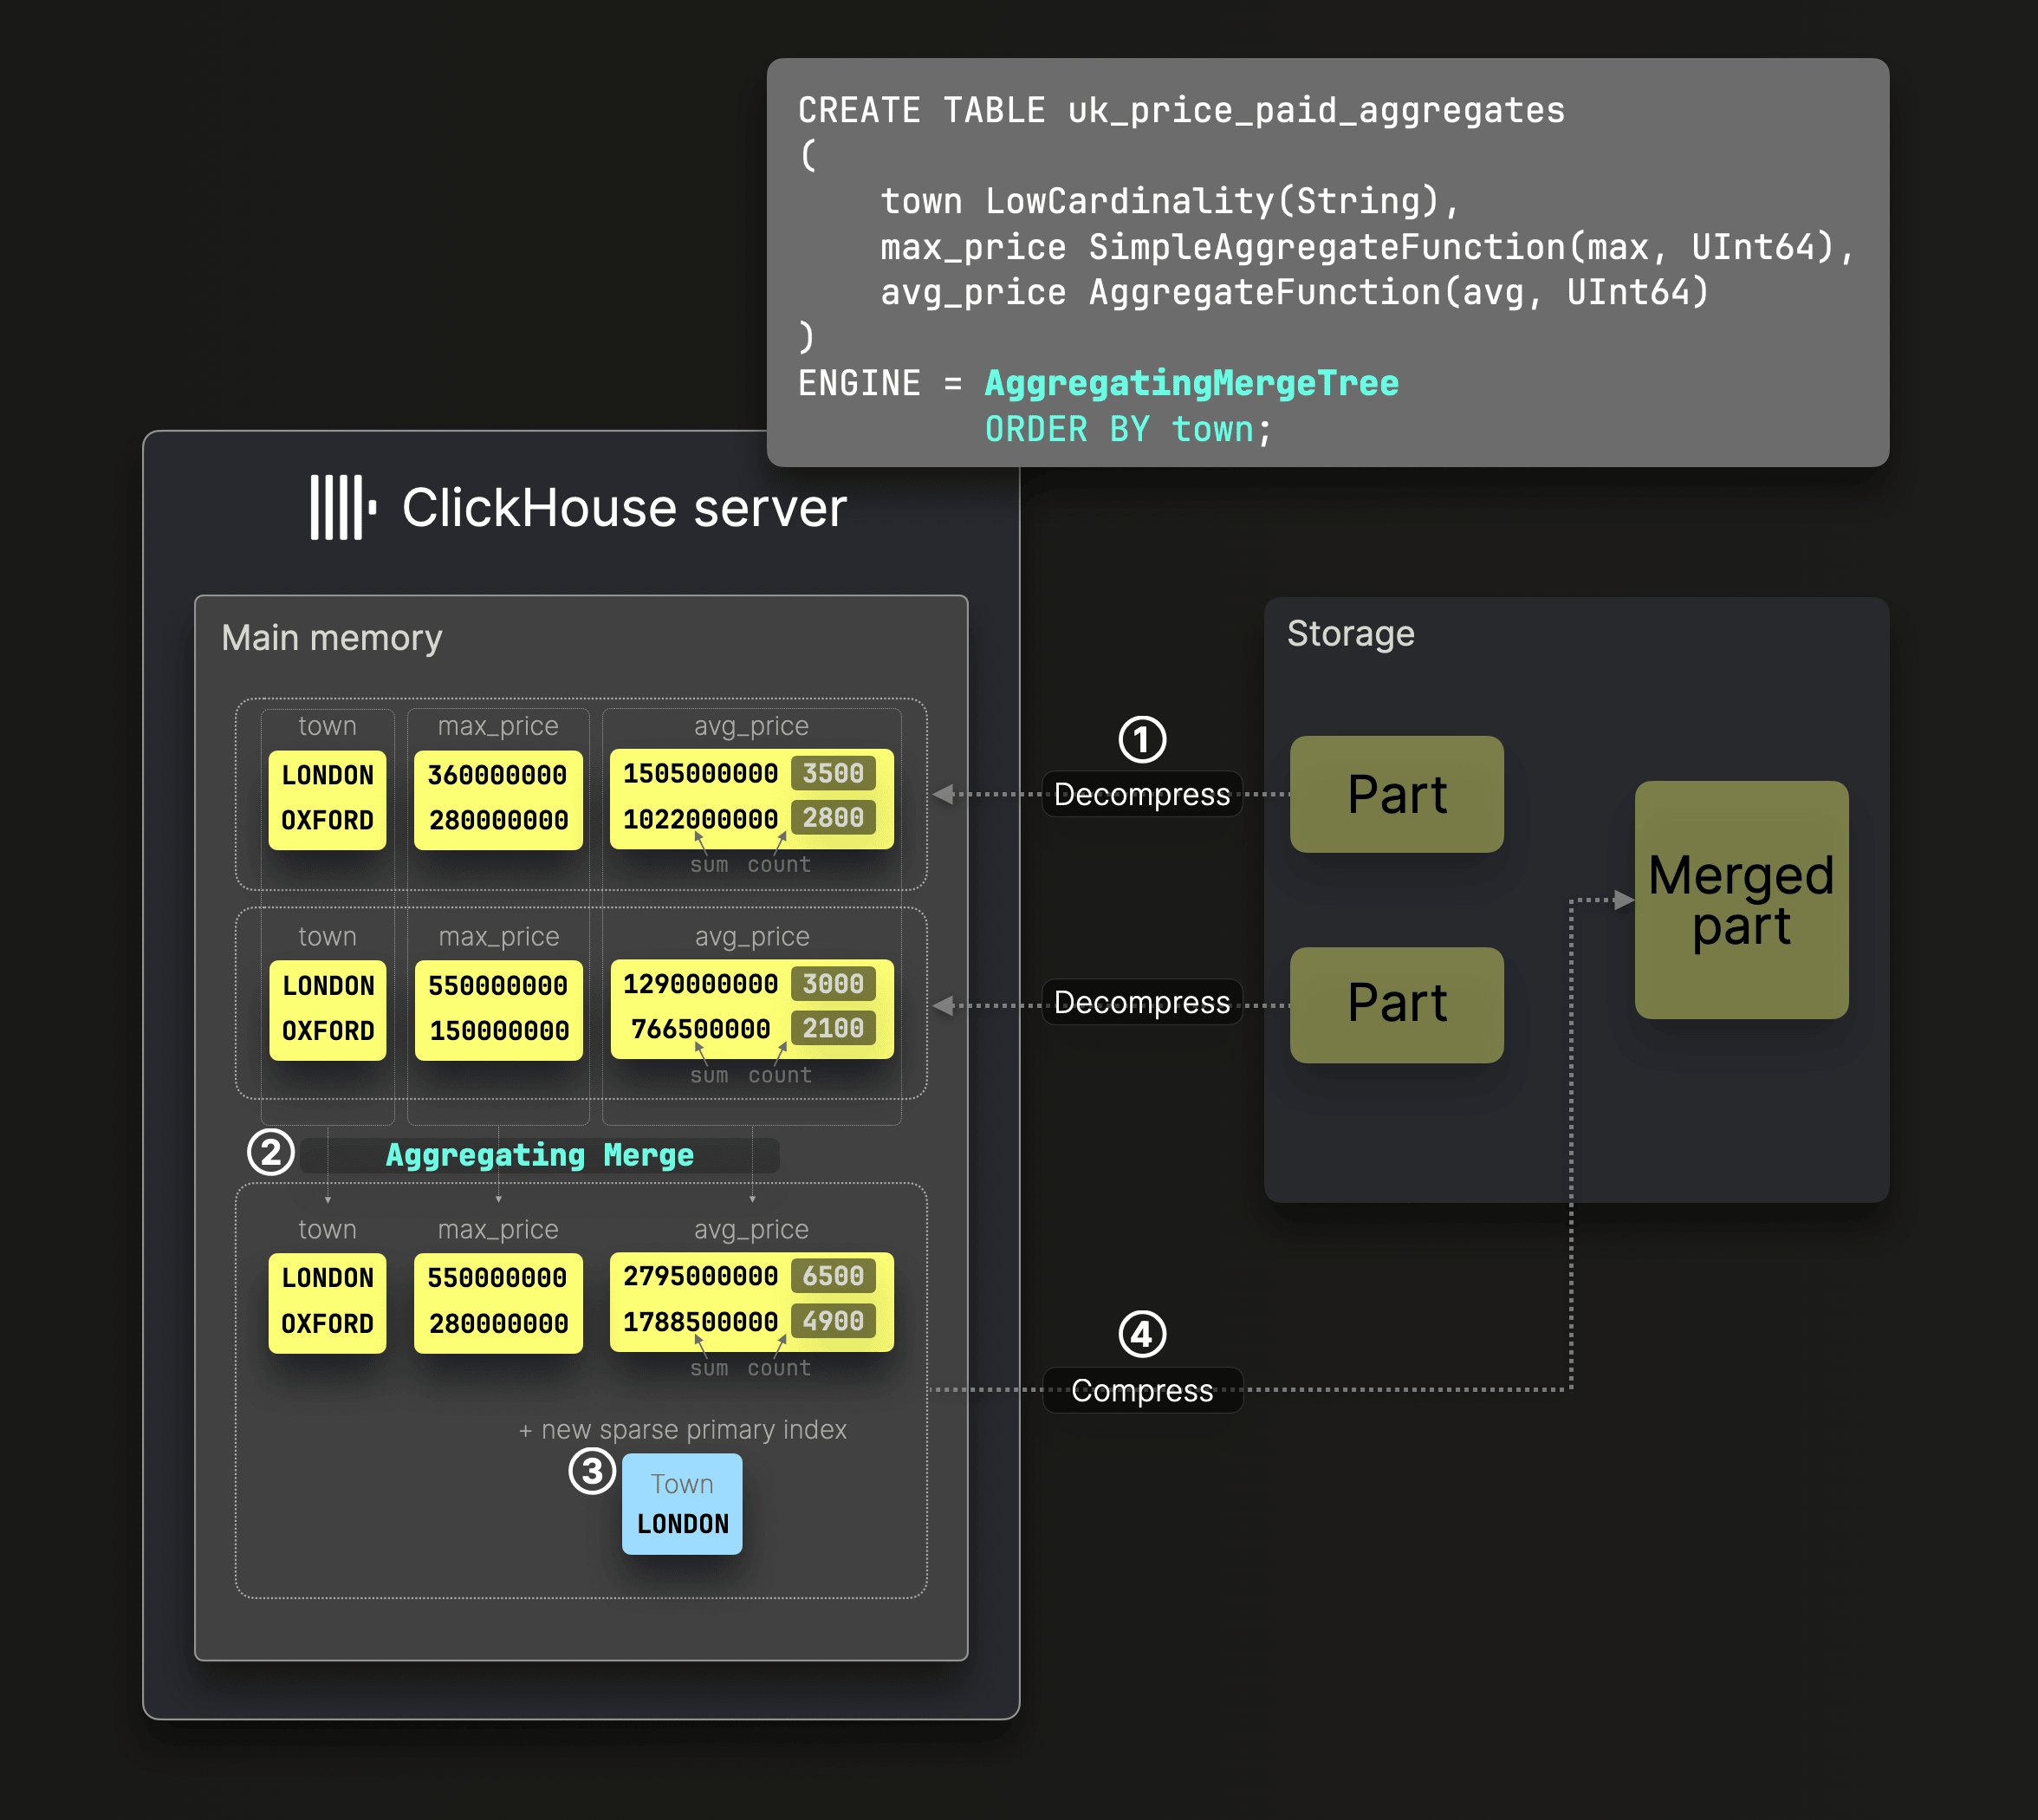
上の図の DDL ステートメントは、
town をソートキーとする AggregatingMergeTree テーブルを作成し、このカラムに基づいてデータがディスク上で順序付けられ、対応するスパースプライマリインデックスが生成されるようにします。
② のマージ中、ClickHouse は同じソートキーを持つすべての行を、部分集計状態 を格納した 1 行に置き換えます (たとえば、avg() に対する sum と count) 。これらの状態により、インクリメンタルなバックグラウンドマージを通じて正確な結果が保証されます。