

背景
インクリメンタルmaterialized view (Materialized Views) を使用すると、計算コストをクエリ時から挿入時に移せるため、SELECT クエリを高速化できます。
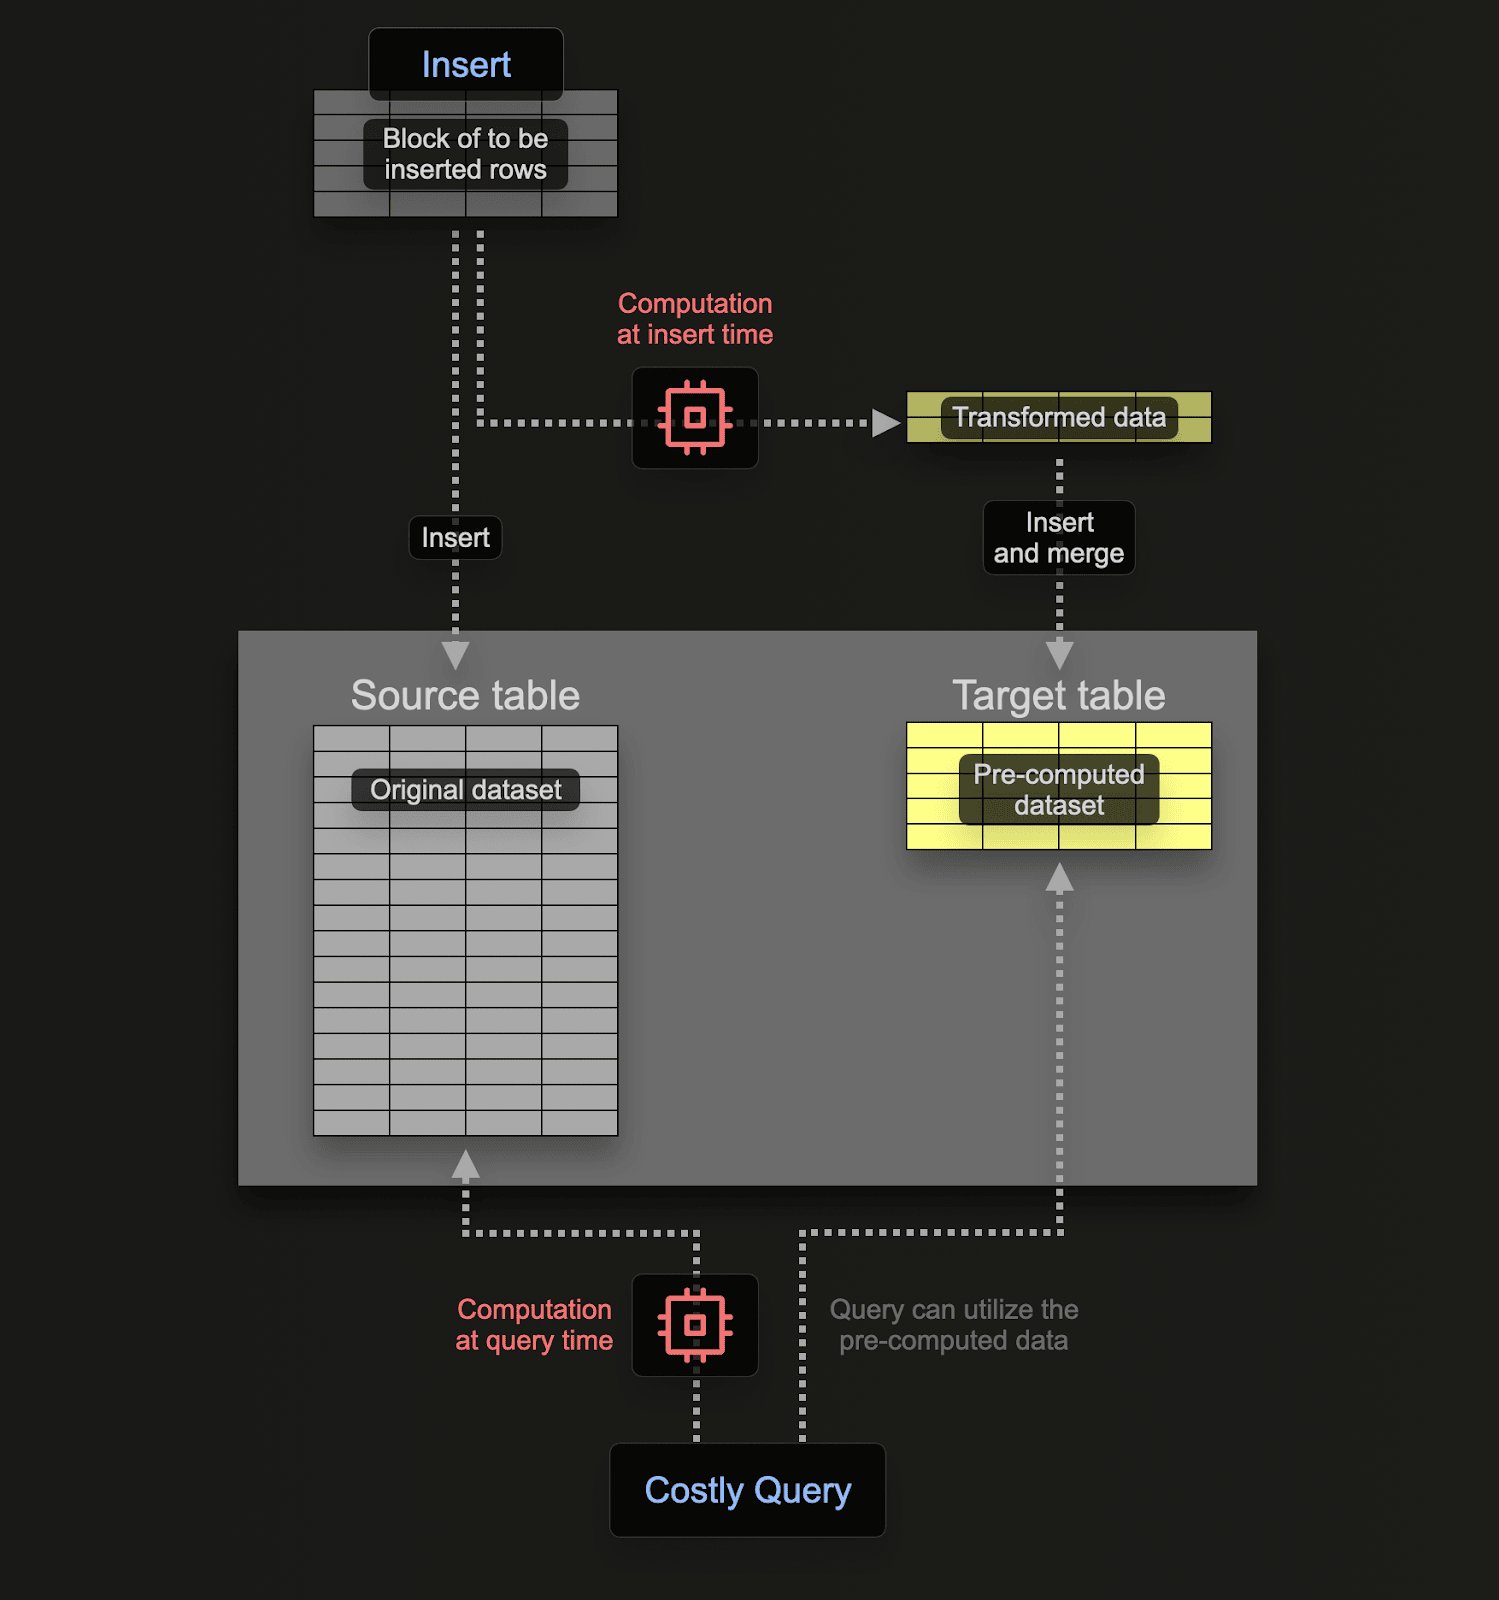
Postgres のようなトランザクションデータベースとは異なり、ClickHouse の materialized view は、データがテーブルに挿入される際に、その block に対してクエリを実行する単なるトリガーです。このクエリの結果は、2 つ目のターゲットテーブルに挿入されます。さらに行が挿入されると、結果は再びターゲットテーブルに送られ、そこで中間結果が更新・マージされます。このマージ後の結果は、元のすべてのデータに対してクエリを実行した場合と同等です。
Materialized Views の主な目的は、ターゲットテーブルに挿入される結果が、行に対する集計、フィルタリング、または変換の結果を表すことにあります。こうした結果は、多くの場合、元データをより小さく表現したものになります (集計の場合は部分的なスケッチになります) 。これに加えて、ターゲットテーブルから結果を読み取るクエリもシンプルになるため、同じ計算を元データに対して実行する場合よりもクエリ時間が短くなります。つまり、計算 (ひいてはクエリレイテンシ) をクエリ時から挿入時へ移せます。
ClickHouse の materialized view は、基になるテーブルにデータが流入するとリアルタイムで更新され、継続的に更新される索引のように機能します。これは、Materialized Views が通常、更新が必要なクエリの静的なスナップショットである他のデータベースとは対照的です (ClickHouse のリフレッシュ可能なマテリアライズドビューに似ています) 。
toStartOfDay 関数を使えば、ClickHouse では比較的シンプルなクエリで実現できます。
votesに挿入されたデータに対して上記のSELECTを実行し、その結果をup_down_votes_per_dayに送信します。
TO 句が重要で、結果の送信先 (つまり up_down_votes_per_day) を指定します。
先ほどの insert を使って、Votes テーブルに再度データを投入できます:
up_down_votes_per_day のサイズを確認しましょう。1 日につき 1 行になっているはずです。
votes) から 5000 まで実質的に減らしています。ただし重要なのは、新しい投票が votes テーブルに挿入されると、その日の新しい値が up_down_votes_per_day に送られ、そこでバックグラウンドで非同期に自動的にマージされ、1 日あたり 1 行だけが保持されるという点です。したがって、up_down_votes_per_day は常に小さく、かつ最新の状態に保たれます。
行のマージは非同期で行われるため、ユーザーがクエリを実行した時点では、1 日あたり複数の行が存在する可能性があります。未処理の行がクエリ時に確実にマージされるようにするには、2 つの方法があります。
- テーブル名に
FINALmodifier を使用します。上の count クエリではこの方法を使いました。 - 最終テーブルで使用しているソートキー、つまり
CreationDateで集約し、メトリクスを合計します。通常はこちらの方が効率的で柔軟です (テーブルをほかの用途にも使えるため) が、クエリによっては前者の方がシンプルな場合もあります。以下では両方を示します。
Score の 99.9 パーセンタイルと、CommentCount の平均です。これを計算するクエリは、次のようになります。
posts テーブルに挿入されるたびに、上記のクエリを実行する materialized view を作成できます。
ここでは例として、また posts データを S3 から読み込まないようにするため、posts と同じスキーマを持つ複製テーブル posts_null を作成します。ただし、このテーブル自体にはデータは保存されず、行が挿入されたときに materialized view が利用するためだけに使われます。データが保存されないようにするには、Null テーブルエンジン を使用できます。
/dev/null のようなものだと考えてください。materialized view は、posts_null テーブルが insert 時に行を受け取ると、要約統計を計算して保存します。つまり、これは単なるトリガーです。ただし、生データは保存されません。今回のケースではおそらく元の posts も保存したいところですが、この方法を使えば、生データの保存オーバーヘッドを避けながら集計を計算できます。
したがって、materialized view は次のようになります。
State を付けていることに注目してください。これにより、最終結果ではなく、その関数の集約状態が返されます。これには、この部分状態をほかの状態とマージするための追加情報が含まれます。たとえば平均値の場合、そのカラムの件数と合計が含まれます。
正しい結果を得るには、部分集約状態が必要です。たとえば平均値を計算する場合、単に各部分範囲の平均をさらに平均しても、正しい結果にはなりません。次に、このビュー
post_stats_per_day のターゲットテーブルを作成します。このテーブルには、これらの部分集約状態が格納されます:
SummingMergeTree で十分でしたが、他の関数では、より高度なエンジン型である AggregatingMergeTree が必要です。
ClickHouse に集約状態が保存されることを認識させるため、Score_quantiles と AvgCommentCount を型 AggregateFunction として定義し、部分状態の関数ソースと、その元になるカラムの型を指定します。SummingMergeTree と同様に、同じ ORDER BY キー値を持つ行はマージされます (上記の例では Day) 。
materialized view を介して post_stats_per_day にデータを投入するには、posts のすべての行を posts_null に挿入するだけです。
本番環境では、materialized view は最終的なクエリでは、関数にpostsテーブルにアタッチするのが一般的です。ここでは、Nullテーブルを示すためにposts_nullを使用しています。
Merge 接尾辞を使用する必要があります (カラムには部分集約状態が格納されているためです) :
FINAL の代わりに GROUP BY を使用している点に注意してください。
ここまでは主に、materialized view を使ってデータの部分集約を増分更新し、計算をクエリ時から挿入時へ移す方法に焦点を当ててきました。この一般的なユースケース以外にも、materialized view にはさまざまな用途があります。
状況によっては、INSERT 時に行やカラムの一部だけを挿入したいことがあります。この場合、posts_null テーブルで INSERT を受け取り、SELECT クエリで行をフィルタリングしてから posts テーブルに挿入できます。たとえば、posts テーブルの Tags カラムを変換したいとします。このカラムには、タグ名がパイプ区切りのリストとして格納されています。これを配列に変換することで、個々のタグの値ごとに集計しやすくなります。
この変換は、この変換のための materialized view を以下に示します。INSERT INTO SELECTの実行時に行うこともできます。materialized view を使えば、このロジックを ClickHouse の DDL にカプセル化し、INSERTをシンプルに保ったまま、新しく追加されるすべての行に変換を適用できます。
comments テーブルを考えてみましょう。
PostId で絞り込むクエリ向けにテーブルが最適化されます。
たとえば、特定の UserId で絞り込み、その平均 Score を計算したい場合を考えます:
UserId に対するソートキー値 PostId をルックアップできます。これらの値を使うことで、効率的なルックアップを実行できます。
この例では、materialized view は非常にシンプルで、INSERT 時に comments から PostId と UserId だけを選択します。これらの結果は、さらに UserId で順序付けされた comments_posts_users テーブルに送られます。以下では、Comments テーブルの null 版を作成し、これを使って view と comments_posts_users テーブルにデータを投入します。
リフレッシュ可能なマテリアライズドビュー以下はインクリメンタルmaterialized viewにのみ当てはまります。リフレッシュ可能なマテリアライズドビューは、対象データセット全体に対して定期的にクエリを実行するため、JOIN を完全にサポートします。結果の鮮度が多少下がっても許容できる場合は、複雑な JOIN にはこちらの利用を検討してください。
JOIN 操作を完全にサポートしていますが、重要な制約が 1 つあります。materialized view がトリガーされるのは、ソーステーブル (クエリ内で最も左にあるテーブル) への insert 時だけです。 JOIN の右側のテーブルは、データが変更されても更新のトリガーにはなりません。この挙動は、挿入時にデータを集計または変換する インクリメンタルmaterialized view を構築する場合に特に重要です。
インクリメンタルmaterialized view を JOIN を使って定義した場合、SELECT クエリ内で最も左にあるテーブルがソースとして機能します。このテーブルに新しい行が挿入されると、ClickHouse はその新たに挿入された行に対してのみ materialized view クエリを実行します。JOIN の右側のテーブルはこの実行時に全件読み取られますが、それらの変更だけではビューはトリガーされません。
この挙動により、Materialized Views における JOIN は、静的なディメンションデータに対するスナップショット join に近いものになります。
これは、参照テーブルやディメンションテーブルでデータを enrich する用途ではうまく機能します。ただし、右側のテーブル (たとえばユーザーメタデータ) に対する更新は、materialized view にはさかのぼって反映されません。更新後のデータを反映させるには、ソーステーブルに新たな insert が必要です。
Stack Overflow データセットを使って、具体的な例を見ていきましょう。materialized view を使用して、users テーブルのユーザー表示名を含むユーザーごとの日次バッジ数を計算します。
念のため再掲すると、テーブルのスキーマは次のとおりです。
users テーブルには、あらかじめデータが投入されているものとします。
グループ化と並び順の整合性materialized view の
GROUP BY 句には、SummingMergeTree ターゲットテーブルの ORDER BY と一致するよう、DisplayName、UserId、Day を含める必要があります。これにより、行が正しく集計・マージされます。これらのいずれかを省略すると、不正確な結果や非効率なマージにつながる可能性があります。daily_badges_by_user テーブルにデータが投入されます。
-
一番左のテーブルをトリガーとして使用します。 materialized view をトリガーするのは、
SELECTステートメントの左側にあるテーブルだけです。右側のテーブルへの変更では更新はトリガーされません。 - JOIN するデータは事前に挿入しておきます。 ソーステーブルに行を挿入する前に、JOIN 対象のテーブルにデータが存在していることを確認してください。JOIN は挿入時に評価されるため、データが欠けていると一致しない行や NULL が発生します。
- JOIN で取得するカラムを制限します。 メモリ使用量を最小限に抑え、挿入時のレイテンシを減らすために、JOIN 対象のテーブルからは必要なカラムだけを選択してください (以下を参照) 。
- 挿入時のパフォーマンスを評価します。 JOIN は挿入のコストを増加させます。特に右側のテーブルが大きい場合に顕著です。本番相当の代表的なデータを使用して挿入レートをベンチマークしてください。
- 単純なルックアップには Dictionaries を優先します。高コストな JOIN 演算を避けるため、キー・バリューのルックアップ (例: ユーザー ID から名前) には Dictionaries を使用してください。挿入時のルックアップを確実に行うには、データを完全にロードするタイプの Dictionary レイアウトを使用してください。キャッシュベースのレイアウト を使用すると、インジェストがローカルのウォームアップ済みキャッシュに依存してしまう可能性があります。
-
マージ効率のために
GROUP BYとORDER BYを揃えます。SummingMergeTreeまたはAggregatingMergeTreeを使用する場合は、効率的に行をマージできるよう、GROUP BYがターゲットテーブルのORDER BY句と一致していることを確認してください。 - 明示的なカラムの別名を使用します。 テーブル間で同名のカラムがある場合は、あいまいさを防ぎ、ターゲットテーブルで正しい結果を得られるように、別名を使用してください。
- 挿入量と頻度を考慮します。 JOIN は中程度の挿入ワークロードでは有効に機能します。高スループットのインジェストでは、ステージングテーブル、事前 JOIN、または Dictionaries や リフレッシュ可能なマテリアライズドビュー などの他の方法の使用を検討してください。
mvw1 と mvw2 があり、どちらも似た処理を行いますが、ソーステーブル t0 の参照方法にわずかな違いがあります。
mvw1 では、テーブル t0 は JOIN の右側にある (SELECT * FROM t0) サブクエリ内で直接参照されています。t0 にデータが insert されると、materialized view のクエリは、t0 が挿入されたデータの block に置き換えられた状態で実行されます。つまり、JOIN 演算はテーブル全体ではなく、新たに挿入された行に対してのみ実行されます。
2 つ目の vt0 を join するケースでは、ビューは t0 からすべてのデータを読み取ります。これにより、JOIN 演算では新たに挿入された block だけでなく、t0 内のすべての行が考慮されます。
重要な違いは、ClickHouse が materialized view のクエリ内でソーステーブルをどのように扱うかにあります。materialized view が insert によってトリガーされると、ソーステーブル (この場合は t0) は挿入されたデータの block に置き換えられます。この挙動はクエリの最適化に活用できますが、意図しない結果を避けるため、注意して扱う必要があります。
実際には、この挙動を利用して、ソーステーブル内のデータの一部だけを処理すればよい materialized view を最適化できます。たとえば、サブクエリを使ってソーステーブルを他のテーブルと結合する前に絞り込むことができます。これにより、materialized view で処理するデータ量を減らし、パフォーマンスを向上させることができます。
IN (SELECT id FROM t0) サブクエリから作成される集合には新たに挿入された行だけが含まれるため、それを使って t1 を絞り込むことができます。
users table のユーザー表示名も含めて、ユーザーごとの 1 日あたりの badges 数を計算する先ほどの materialized view の例を見てみましょう。
badges テーブルへの insert レイテンシに大きな影響を及ぼしました。例えば、
users テーブルに絞り込み条件を追加します:
2936484 について、users テーブルからは 1 行だけが取得されます。このルックアップも、テーブルのソートキー Id によって最適化されます。
UNION ALL クエリは、複数のソーステーブルのデータを 1 つの結果セットにまとめるためによく使われます。
UNION ALL はインクリメンタルmaterialized view では直接サポートされていませんが、SELECT の各分岐ごとに個別の materialized view を作成し、その結果を共通のターゲットテーブルに書き込むことで、同じことを実現できます。
この例では、Stack Overflow データセットを使用します。以下の badges テーブルと comments テーブルは、それぞれユーザーが獲得したバッジと、投稿に付けたコメントを表しています。
INSERT INTO コマンドでデータを挿入できます。
badges または comments のいずれかに新しい行が挿入されるたびに更新したい場合、この問題に対する単純なアプローチとしては、前述のユニオン クエリを使って materialized view を作成しようとすることです。
comments テーブルへの insert の場合だけです。例えば:
badges テーブルへの挿入ではビューがトリガーされないため、user_activity は更新されません:
comments テーブルに挿入する場合は次のとおりです。
badgesテーブルへの挿入はuser_activityテーブルに反映されます。
並列処理と順次処理
前の例で示したように、1 つのテーブルを複数の Materialized View のソースとして使用できます。これらの実行順序は、設定parallel_view_processing によって決まります。
デフォルトでは、この設定は 0 (false) であり、Materialized View は uuid の順に順次実行されます。
たとえば、次の source テーブルと 3 つの Materialized View を考えてみましょう。各 View は行を target テーブルに送信します。
target テーブルに行を挿入する前に 1 秒待機する点に注目してください。
source テーブルに 1 行挿入するのに約 3 秒かかり、各ビューは順番に実行されます。
SELECT を使って、各行が到着していることを確認できます:
uuidに対応しています:
parallel_view_processing=1 を有効にして1行を insert した場合に何が起こるかを見てみましょう。これを有効にすると、ビューは並列に実行されるため、行がターゲットテーブルに到達する順序は保証されません。
parallel_view_processing=1 を有効にすると、上で示したように insert スループットを大幅に向上できる場合があります。特に、1 つのテーブルに複数の Materialized Views が関連付けられている場合に効果的です。ただし、そのトレードオフを理解しておくことが重要です。
- insert 負荷の増加: すべての Materialized Views が同時に実行されるため、CPU 使用率とメモリ使用量が増加します。各 view で重い計算や JOIN を実行する場合、システムに過負荷がかかるおそれがあります。
- 厳密な実行順序が必要: まれなワークフローでは、view の実行順序が重要になることがあります (たとえば、連鎖した依存関係がある場合) 。このような場合、並列実行によって state の不整合や race condition が発生する可能性があります。これを回避できるよう設計することも可能ですが、そのような構成は脆弱で、将来のバージョンで破綻するおそれがあります。
過去のデフォルトと安定性長い間、逐次実行がデフォルトでした。その理由の一部は、error 処理の複雑さにありました。従来は、1 つの materialized view で障害が発生すると、ほかの view が実行されなくなることがありました。新しいバージョンでは、障害を block 単位で分離することで改善されていますが、それでも逐次実行のほうが障害時の振る舞いはより明確です。
parallel_view_processing=1 を有効にしてください。
- 複数の独立した Materialized Views がある
- insert パフォーマンスを最大化したい
- 同時実行の view 実行にシステムが耐えられることを把握している
- Materialized Views が相互に依存している
- 予測可能で順序どおりの実行が必要
- insert の挙動を debugging または監査しており、決定論的なリプレイが必要
共通テーブル式 (CTE) は materializeされませんClickHouse は CTE を materialize しません。代わりに、CTE の定義をクエリ内に直接展開するため、同じexpressionが複数回評価される可能性があります (CTE を複数回使用した場合) 。
- CTE がソーステーブル (つまり、materialized view がアタッチされているテーブル) とは別のテーブルを参照しており、
JOINまたはIN句で使われている場合、それはトリガーではなく、サブクエリまたは join として動作します。 - materialized view 自体は引き続きメインのソーステーブルへの INSERT でのみトリガーされますが、CTE は INSERT のたびに再実行されるため、特に参照先のテーブルが大きい場合は不要なオーバーヘッドが発生する可能性があります。