

このガイドで説明する内容は、GCS や Azure Blob storage など、それぞれ専用のテーブル関数を持つ他のオブジェクトストレージ実装にも適用できます。
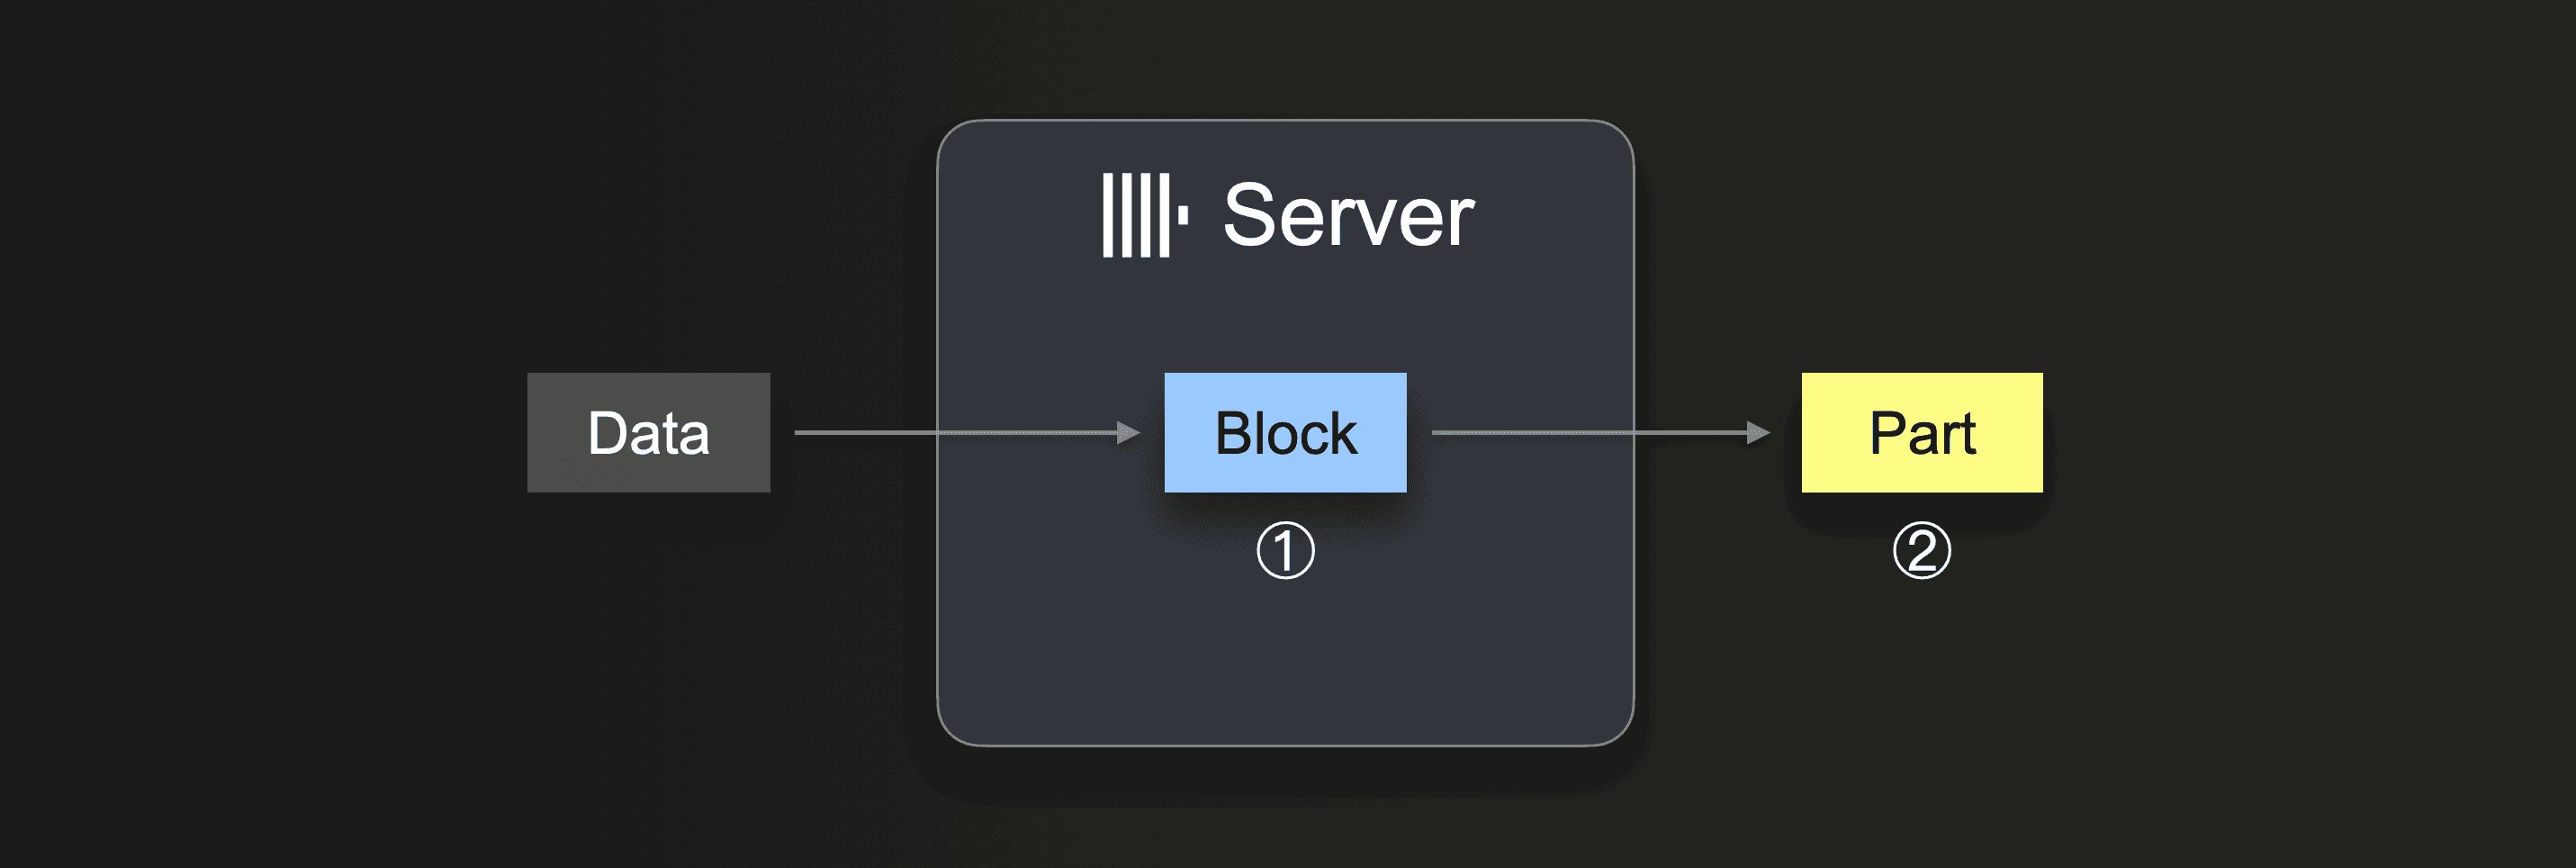
INSERT INTO SELECT を実行すると、ClickHouse は受信したデータの一部を受け取り、① そのデータから (パーティションキーごとに) 少なくとも 1 つのインメモリ挿入ブロックを形成します。ブロック内のデータはソートされ、テーブルエンジン固有の最適化が適用されます。その後、データは圧縮され、② 新しいデータパーツとしてデータベースストレージに書き込まれます。
挿入ブロックサイズは、ClickHouseサーバーのディスクファイル I/O 使用量とメモリ使用量の両方に影響します。挿入ブロックが大きいほど使用メモリは増えますが、生成される初期パーツは大きくなり、その数は少なくなります。大量のデータをロードする際に ClickHouse が作成する必要のあるパーツが少ないほど、ディスクファイル I/O は減り、自動バックグラウンドマージに必要な処理も少なくなります。
インテグレーションのテーブルエンジンまたはテーブル関数と組み合わせて INSERT INTO SELECT クエリを使用する場合、データは ClickHouseサーバーによってプルされます:
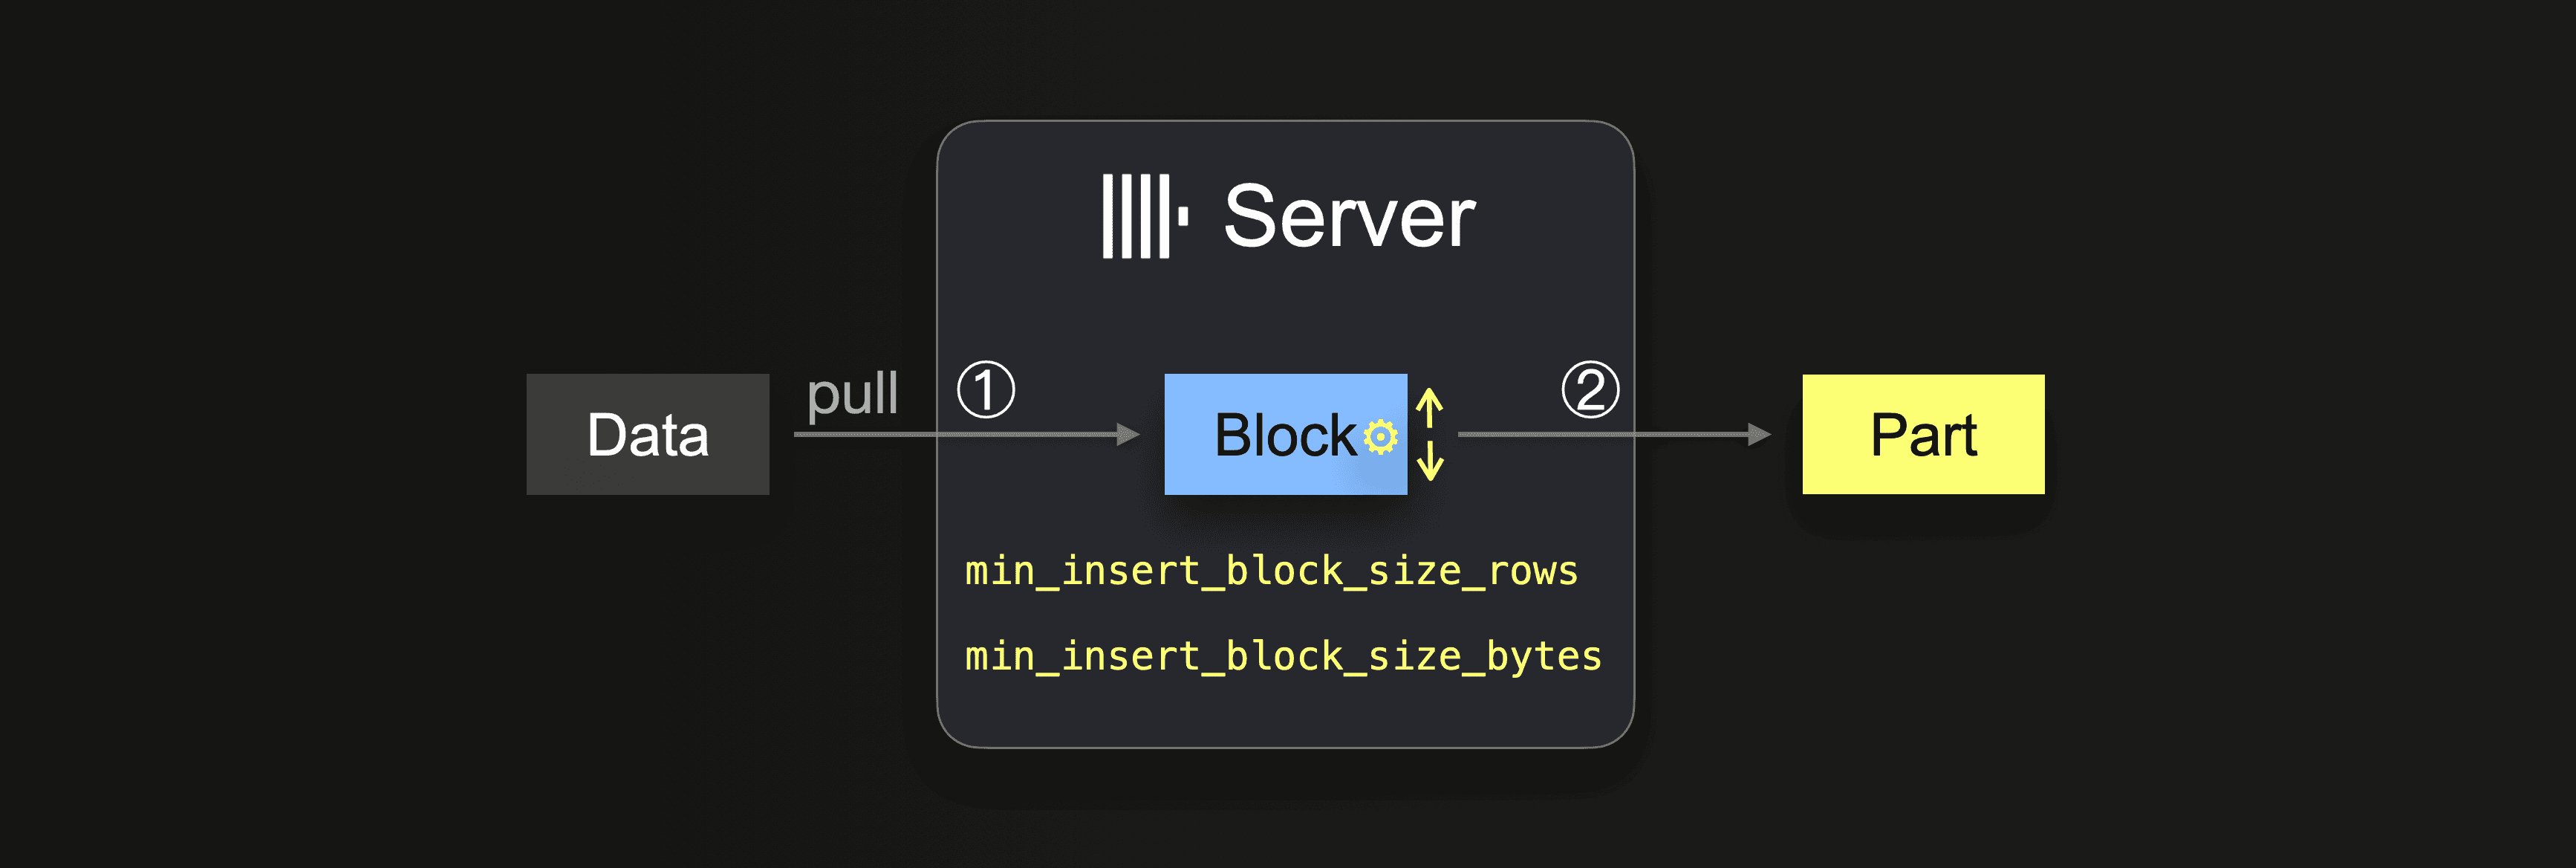
min_insert_block_size_rows(デフォルト:1048545行)min_insert_block_size_bytes(デフォルト:256 MiB)
min_insert_block_size_bytes の値は、非圧縮のインメモリブロックサイズを表します (圧縮後のディスク上のパーツサイズではありません) 。また、作成されるブロックやパーツに、設定した行数やバイト数が厳密に含まれることはほとんどありません。これは、ClickHouse がデータを行単位のブロックごとにストリーミングして処理するためです。したがって、これらの設定は最小しきい値を指定するものです。
設定された挿入ブロックサイズが小さいほど、大量のデータロード時に作成される初期パーツは増え、データのインジェストと並行して実行されるバックグラウンドのパーツマージも増えます。これにより、リソース競合 (CPU とメモリ) が発生し、さらにインジェスト完了後も、パーツ数が適正 (3000) な水準に達するまで追加の時間が必要になる場合があります。
ClickHouse は、圧縮サイズが約 150 GiB に達するまで、継続的にパーツをマージして、より大きなパーツへとまとめていきます。この図は、ClickHouse サーバーがパーツをどのようにマージするかを示しています。
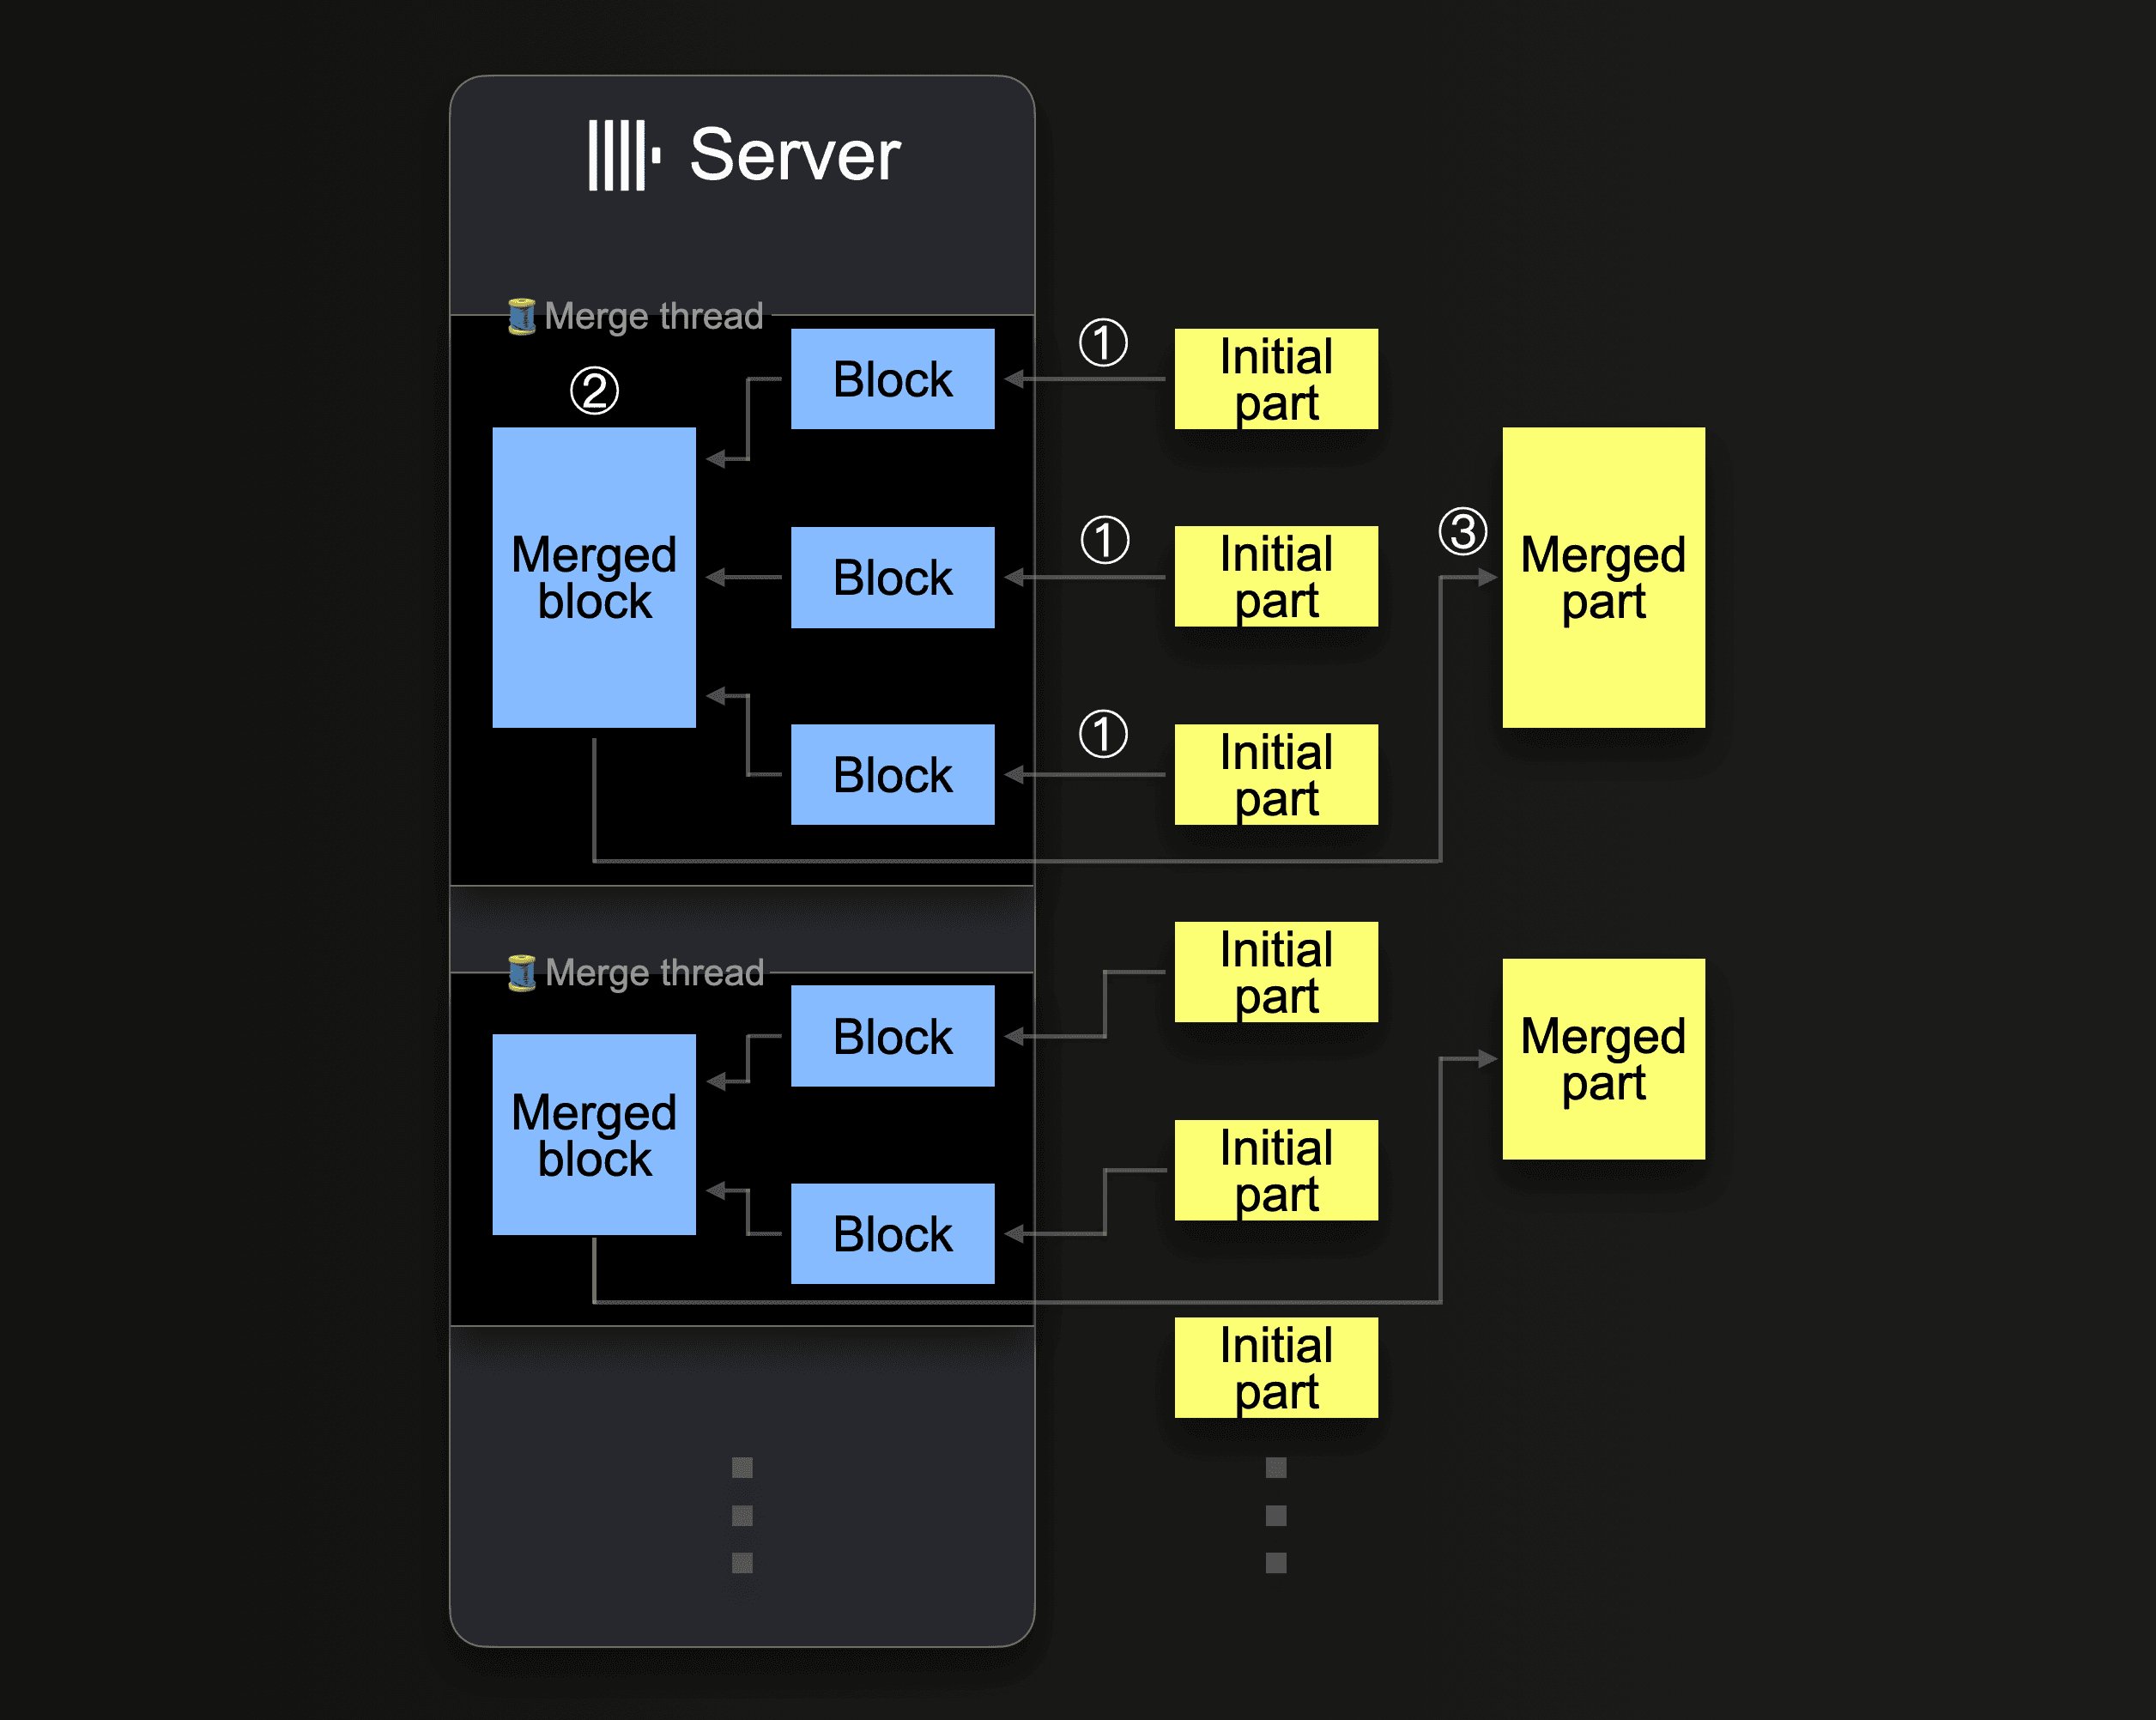
1
パーツをメモリにロードする
次にマージするパーツを決定し、それらのパーツをブロックとしてメモリにロードします。
2
ブロックをマージする
メモリにロードしたブロックをマージして、より大きなブロックにします。
3
ディスクに書き込む
マージしたブロックをディスク上の新しいパーツに書き込み、ステップ 1 に戻ります。
MergeTree テーブルという名前の由来です) 。
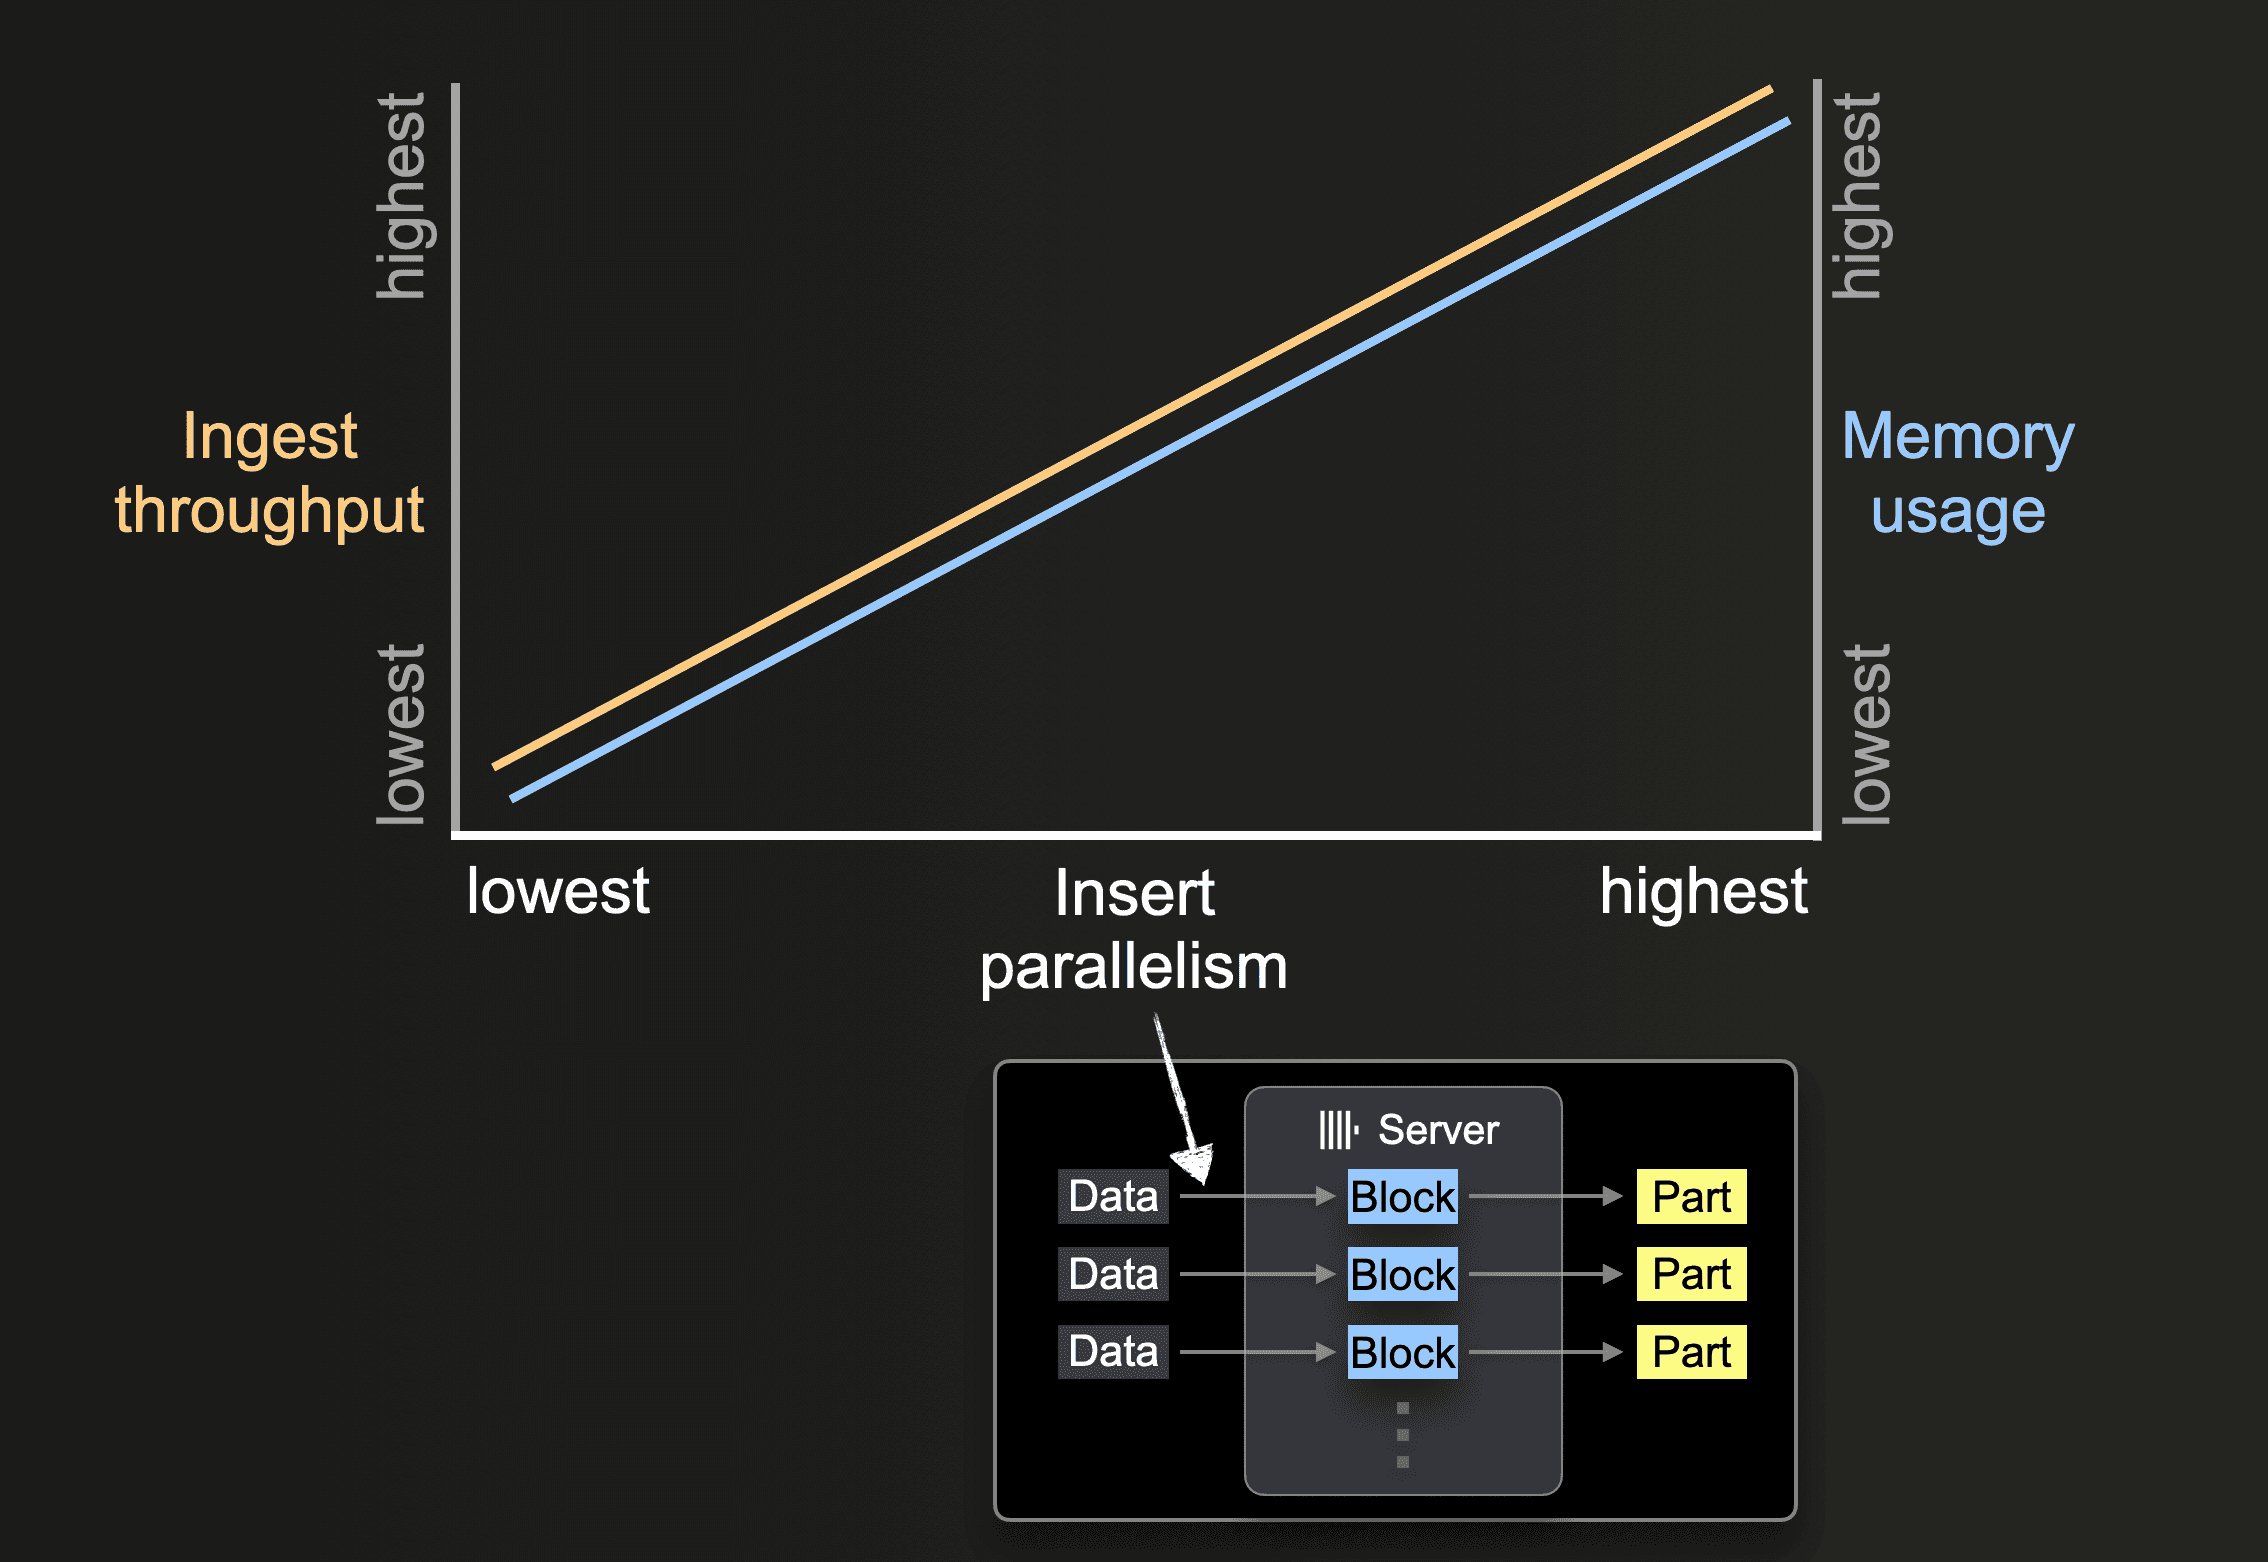
s3 のようなテーブル関数では、glob パターンを使ってロード対象のファイル名の集合を指定できます。glob パターンが複数の既存ファイルに一致する場合、ClickHouse は、並行して実行される挿入スレッド (server ごと) を利用して、ファイル間および各ファイル内の読み取りを並列化し、データをテーブルに並列に挿入できます。
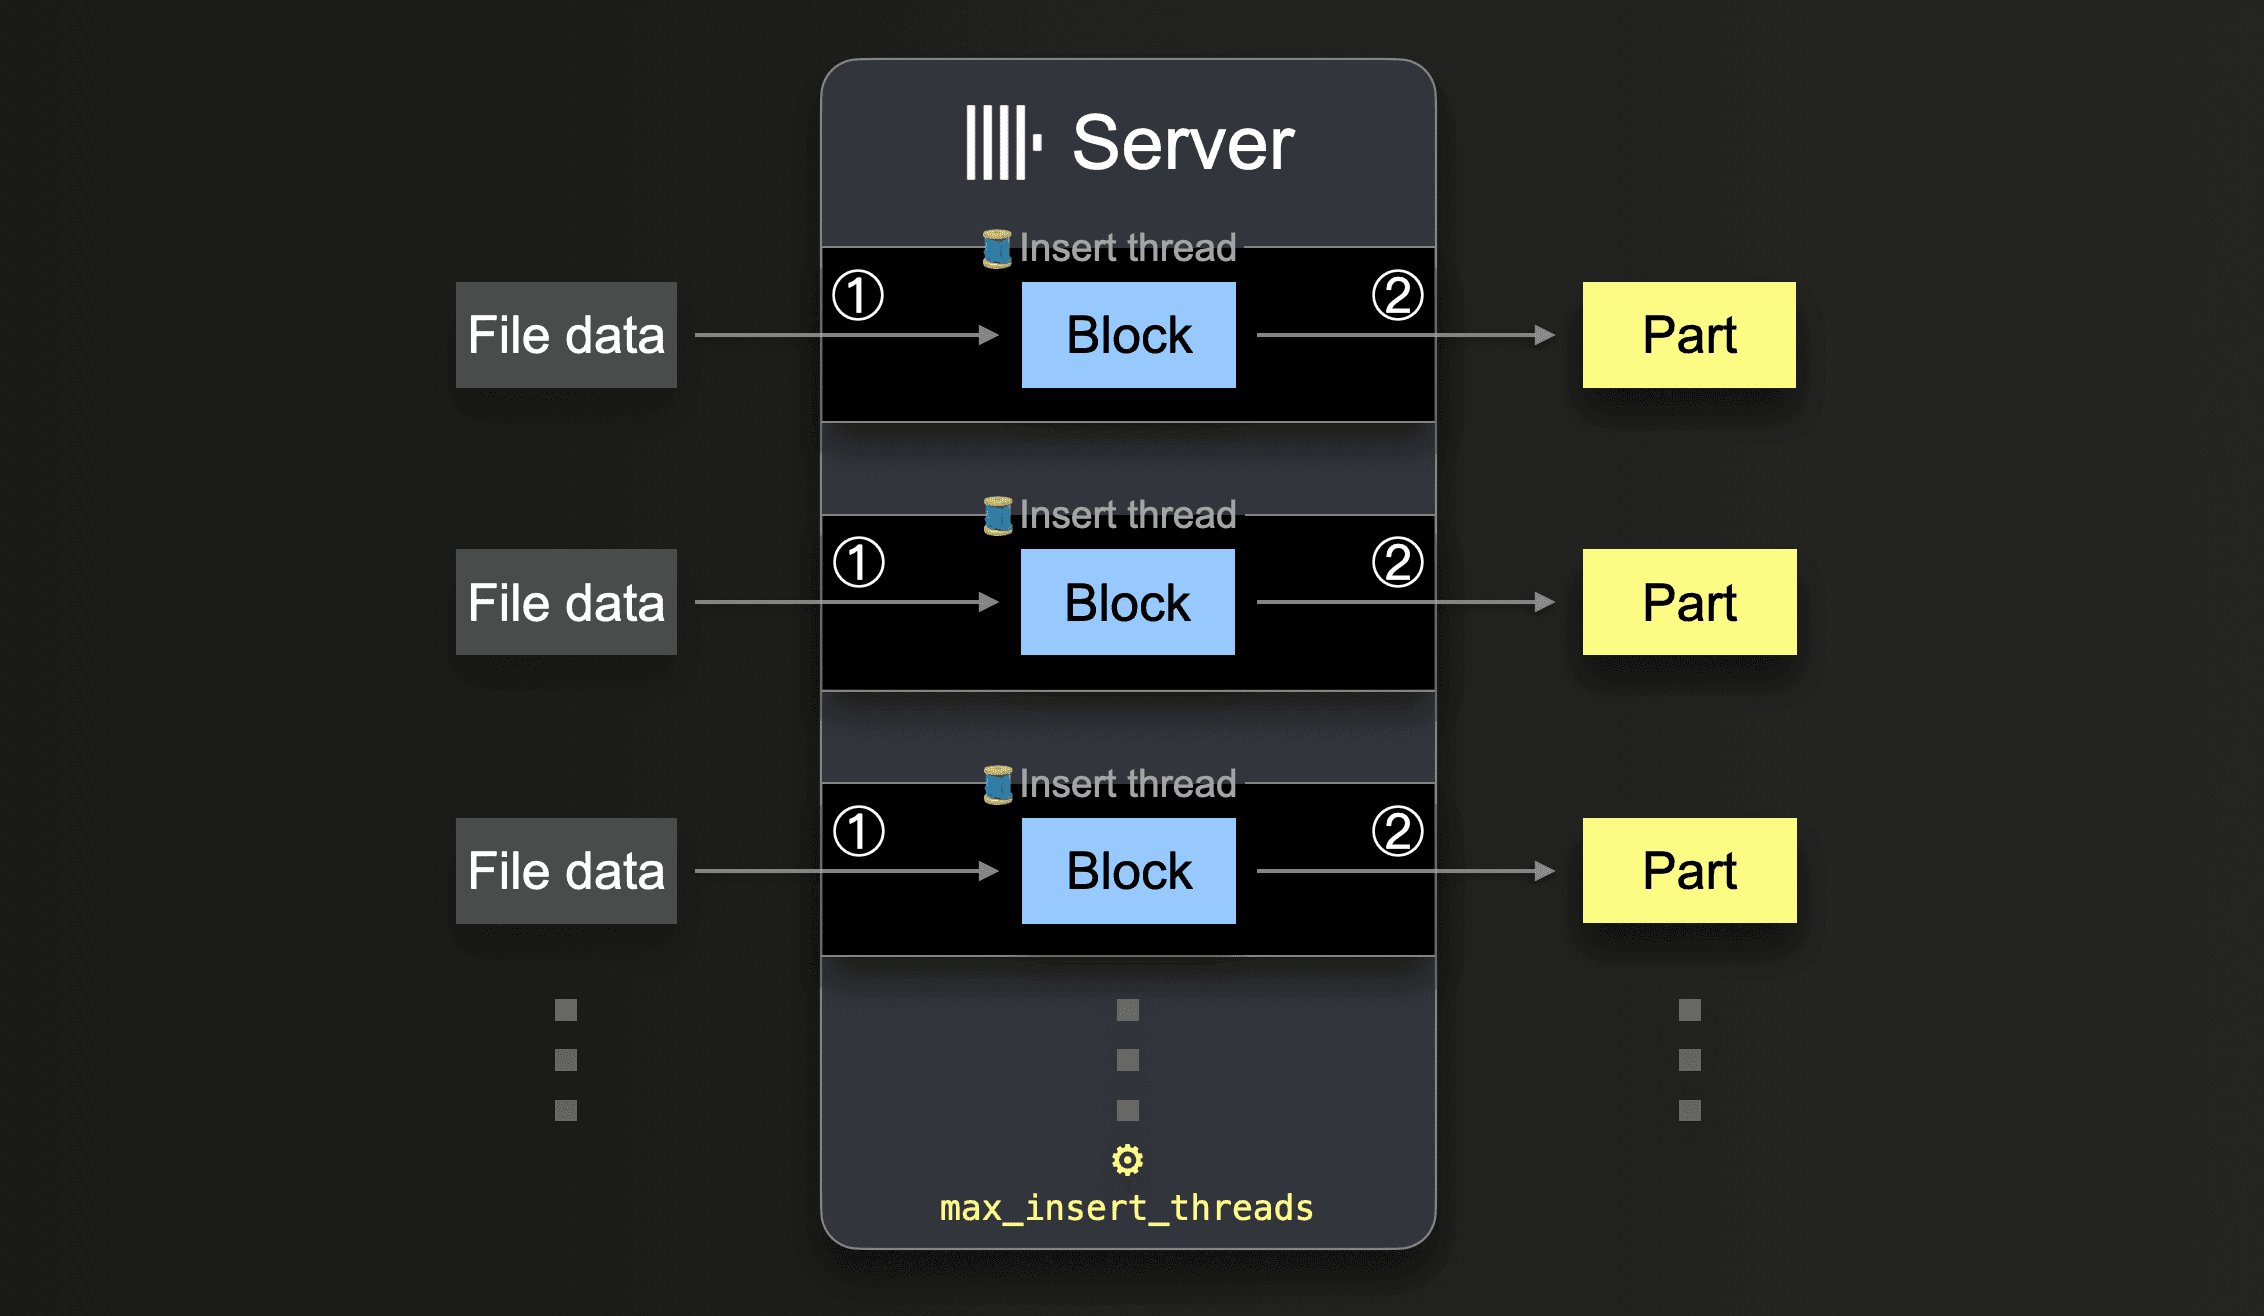
max_insert_threads 設定で構成できます。オープンソース版 ClickHouse では、26.8 以降のデフォルト値は 0 です (auto: CPU コア数。メモリ逼迫時には減少) 。ClickHouse Cloud では、デフォルトはメモリ 8 GiB のノードで 1、16 GiB のノードで 2、より大きなノードで 4 です。
ファイル数が多い場合は、複数の挿入スレッドによる並列処理が効果的に機能します。これにより、利用可能な CPU コアとネットワーク帯域幅 (並列ファイルダウンロード時) の両方を最大限に活用できます。一方、少数の大きなファイルだけをテーブルに読み込む場合、ClickHouse は自動的に高いデータ処理の並列性を確保し、大きなファイル内の複数の異なる範囲を並列に読み取る (ダウンロードする) ために、各挿入スレッドごとに追加のリーダースレッドを生成して、ネットワーク帯域幅の利用を最適化します。
s3 関数およびテーブルでは、個々のファイルを並列ダウンロードするかどうかは、max_download_threads と max_download_buffer_size の値によって決まります。ファイルが並列にダウンロードされるのは、そのサイズが 2 * max_download_buffer_size を超える場合だけです。デフォルトでは、max_download_buffer_size は 10MiB に設定されています。場合によっては、このバッファサイズを 50 MB (max_download_buffer_size=52428800) まで安全に増やし、各ファイルが単一のスレッドでダウンロードされるようにすることも可能です。これにより、各スレッドが S3 呼び出しに費やす時間を短縮でき、結果として S3 の待機時間も削減できます。さらに、並列読み取りには小さすぎるファイルについては、スループットを向上させるため、ClickHouse はそのようなファイルを非同期に先読みして自動的にデータを prefetch します。
S3 table function を使用するクエリのパフォーマンス最適化は、データをその場でクエリする場合、つまり ClickHouse のコンピュートのみを使用し、データは元のフォーマットのまま S3 に保持した状態でアドホッククエリを実行する場合と、S3 から ClickHouse MergeTree table engine にデータを挿入する場合の両方で必要です。特に明記しない限り、以下の推奨事項はどちらのシナリオにも当てはまります。
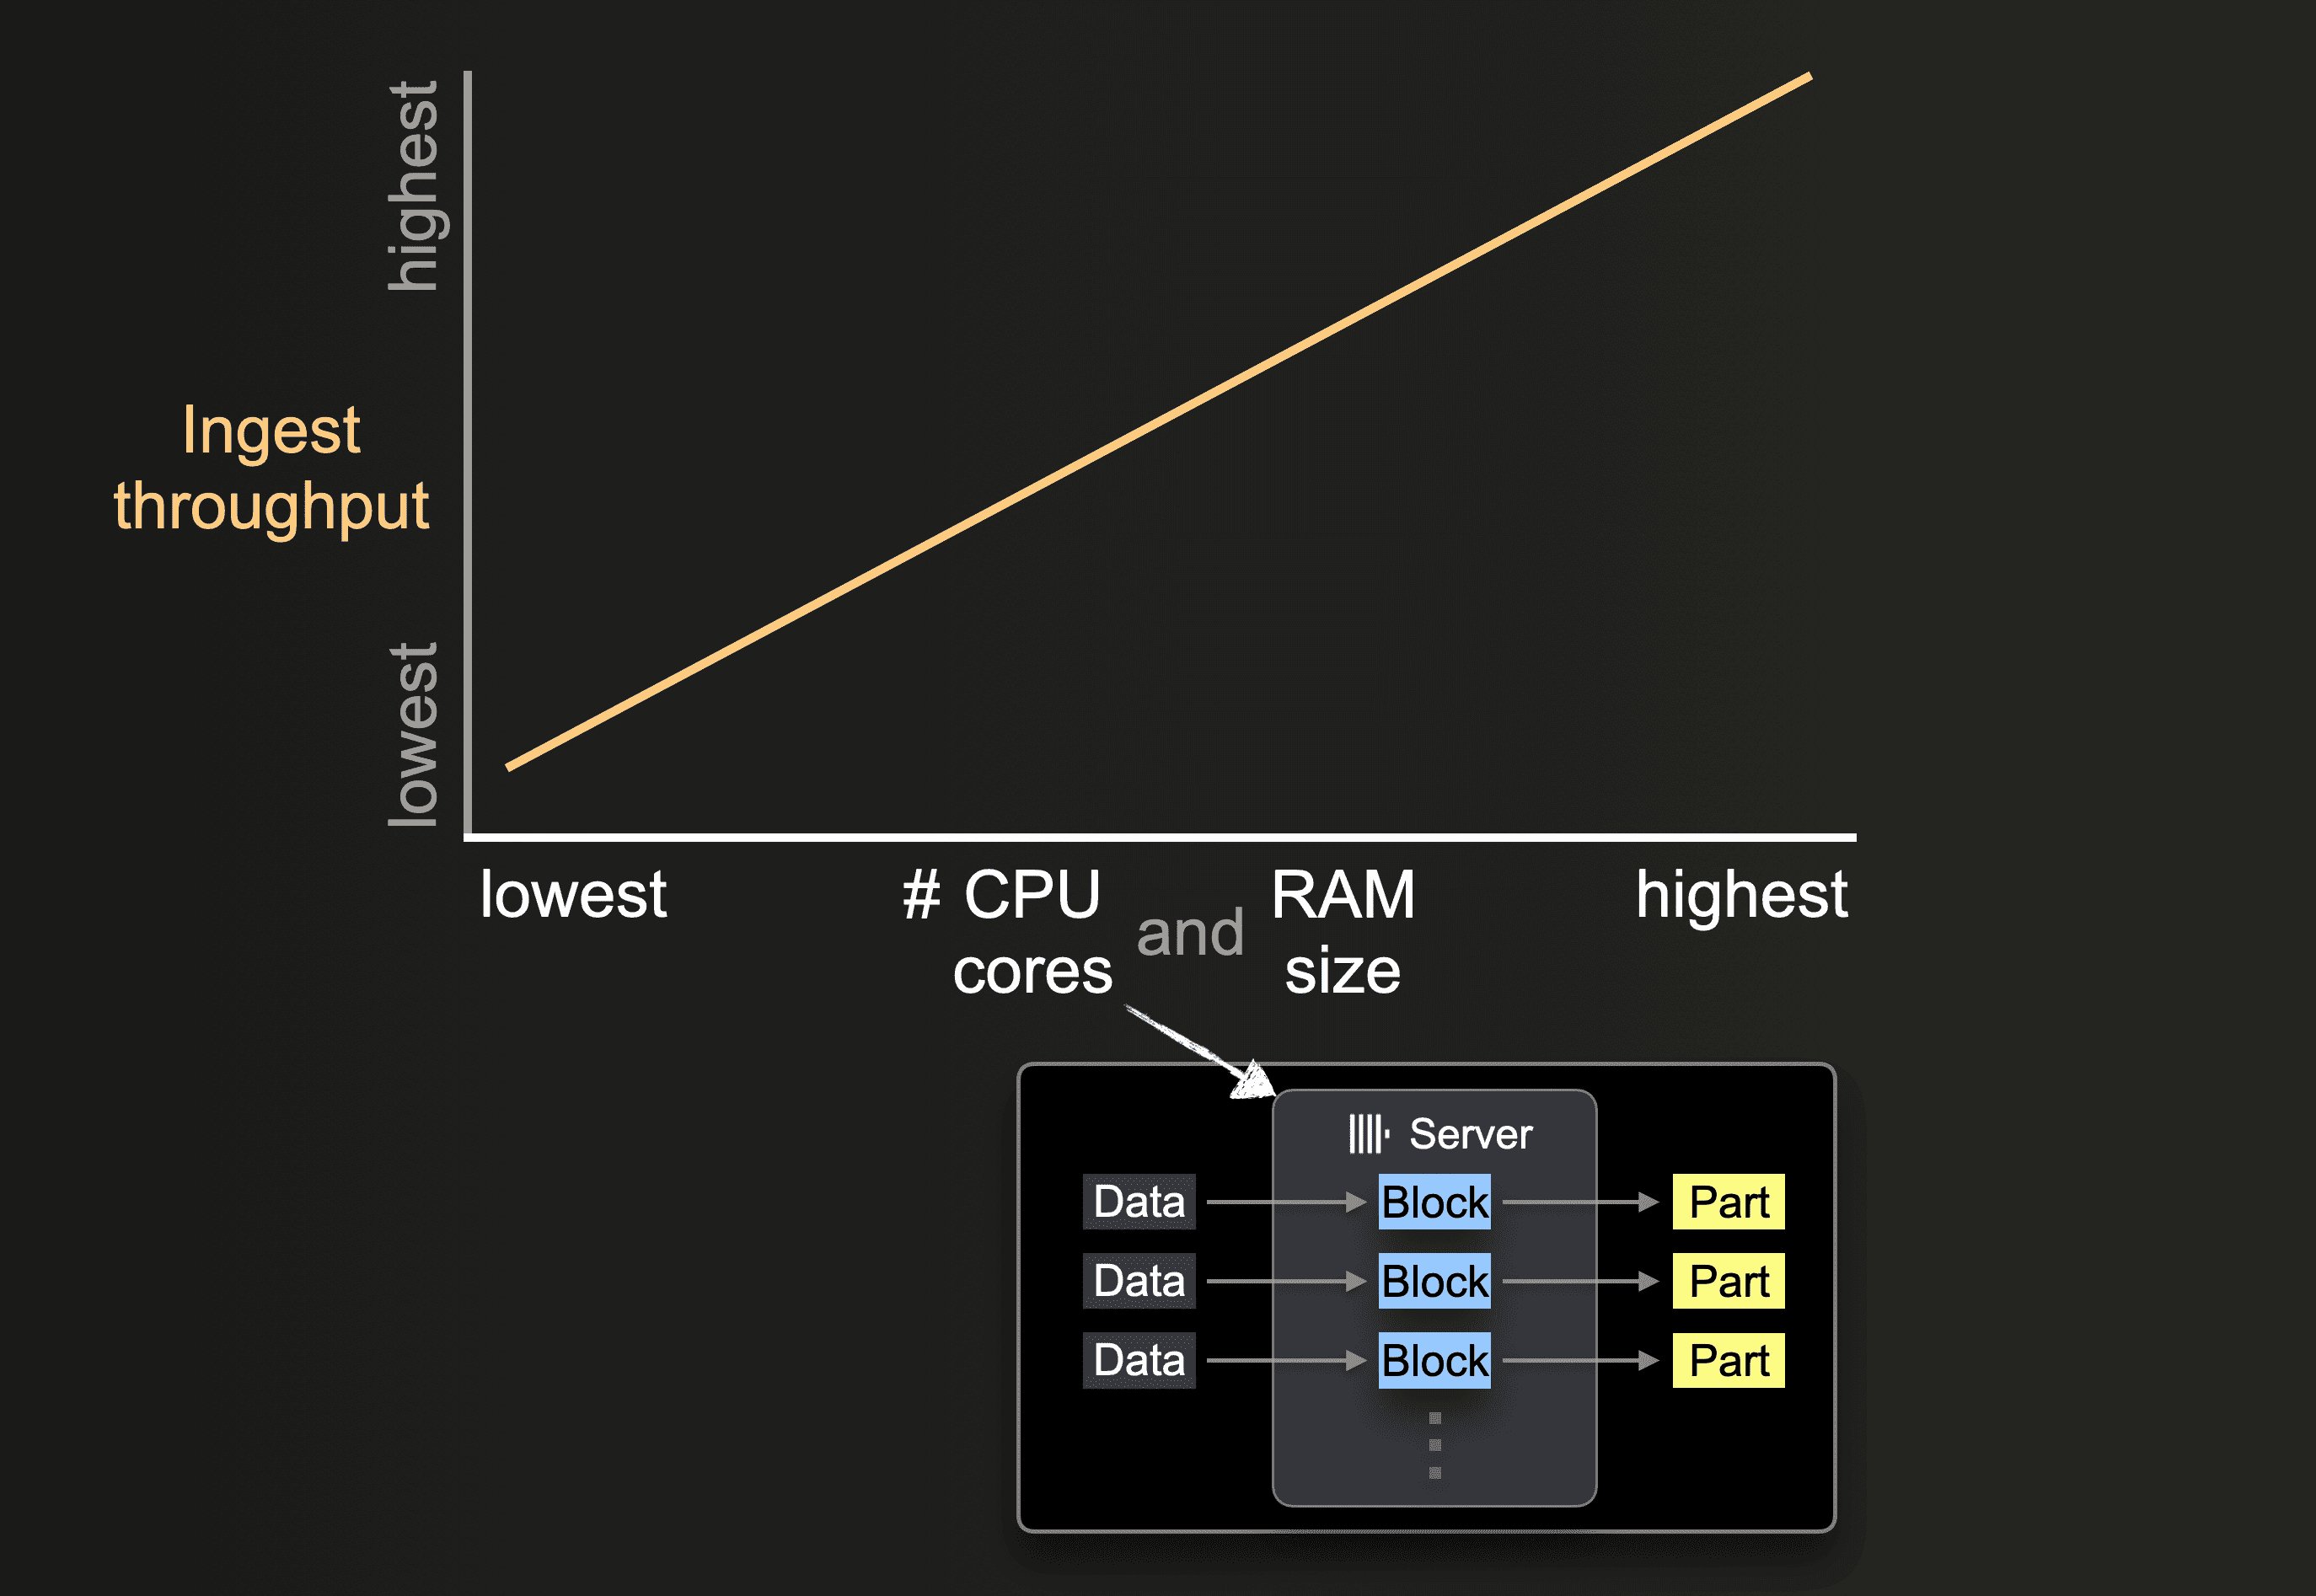
- パーツの初期サイズの上限
- 挿入の並列度として設定可能なレベル
- バックグラウンドのパーツマージのスループット
s3 関数と S3 エンジンを使って、S3 バケットに保存されたファイルを対応フォーマットで読み取ることができます。生ファイルを読み取る場合、これらのフォーマットの一部には特有の利点があります。
- Native、Parquet、CSVWithNames、TabSeparatedWithNames のようにカラム名がエンコードされているフォーマットでは、
s3関数でカラム名を指定する必要がないため、クエリをより簡潔に記述できます。これは、カラム名から必要な情報を推定できるためです。 - フォーマットによって、読み取りおよび書き込みのスループット性能は異なります。Native と Parquet は、もともとカラム指向でコンパクトでもあるため、読み取り性能の面で最適なフォーマットです。また、Native フォーマットは ClickHouse のメモリ内データ配置との親和性も高く、データを ClickHouse にストリーミングする際の処理オーバーヘッドをさらに低減できます。
- ブロックサイズは、大きなファイルの読み取りレイテンシに影響することがよくあります。これは、たとえば上位 N 行だけを返すようにデータをサンプルする場合に特に顕著です。CSV や TSV のようなフォーマットでは、一定数の行を返すためにもファイルをパースする必要があります。そのため、Native や Parquet のようなフォーマットでは、より高速にサンプリングできます。
- 圧縮フォーマットにはそれぞれ長所と短所があり、一般に圧縮率と速度のバランスや、圧縮性能と展開性能のどちらを重視するかが異なります。CSV や TSV のような生ファイルを圧縮する場合、lz4 は圧縮率を犠牲にする代わりに、最も高速な展開性能を提供します。Gzip は通常、読み取り速度がやや遅くなる代わりに、より高い圧縮率を実現します。Xz はさらにその傾向が強く、通常は最も高い圧縮率を提供する一方で、圧縮および展開の性能は最も低速です。エクスポート時の圧縮速度は、Gz と lz4 でおおむね同程度です。これらは接続速度との兼ね合いで判断してください。展開や圧縮が速くても、S3 バケットへの接続が遅ければ、その利点は簡単に相殺されます。
- Native や Parquet のようなフォーマットでは、通常、圧縮のオーバーヘッドに見合う効果は得られません。これらのフォーマットはもともとコンパクトであるため、データサイズの削減効果はごくわずかであることがほとんどです。圧縮や展開にかかる時間がネットワーク転送時間を相殺できることはまれです。特に、S3 はグローバルに利用可能で、ネットワーク帯域幅も比較的高いためです。
SELECT クエリの性能を測定する場合は、クエリに null フォーマット を使用するか、結果を Null エンジン に送るようにします。これにより、クライアントがデータ量に圧倒されたり、ネットワークが飽和したりするのを防げます。
クエリでデータを読み込む場合、最初のクエリは、同じクエリを繰り返し実行した場合よりも遅く見えることがよくあります。これは、S3 自体のキャッシュに加え、ClickHouse Schema Inference Cache も影響しているためです。これにはファイルの推論済みスキーマが保存されるため、以降のアクセスではスキーマ推論のステップを省略でき、クエリ時間の短縮につながります。
- 通常、
max_threadsのデフォルト値、つまりコア数で十分です。クエリのメモリ使用量が多く、これを抑えたい場合や、結果のLIMITが小さい場合は、この値を低めに設定できます。十分なメモリがある場合は、S3 からの読み取りスループット向上を期待して、この値を増やして試してみる価値があります。一般に効果があるのは、コア数が少ないマシン、つまり < 10 の場合に限られます。通常は、ネットワークや CPU 競合など別のリソースがボトルネックになるため、並列化をさらに進めても効果は次第に小さくなります。 - 22.3.1 より前の ClickHouse では、
s3関数またはS3テーブルエンジンを使用した場合、読み取りの並列化は複数ファイル間でしか行われませんでした。そのため、最適な読み取り性能を得るには、ファイルを S3 上で chunk に分割し、glob パターンを使って読み取れるようにしておく必要がありました。新しいバージョンでは、1 つのファイル内のダウンロードも並列化されます。 - スレッド数が少ない環境では、
remote_filesystem_read_methodを “read” に設定して、S3 からのファイル読み取りを同期的に行うようにすると効果が出る場合があります。 s3関数とテーブルでは、個々のファイルの並列ダウンロードはmax_download_threadsとmax_download_buffer_sizeの値で決まります。max_download_threadsは使用するスレッド数を制御しますが、ファイルが並列ダウンロードされるのは、そのサイズが 2 *max_download_buffer_sizeを超える場合だけです。デフォルトでは、max_download_buffer_sizeのデフォルト値は 10MiB に設定されています。場合によっては、このバッファサイズを 50 MB (max_download_buffer_size=52428800) まで安全に増やし、より小さなファイルが単一スレッドでのみダウンロードされるようにすることもできます。これにより、各スレッドが S3 呼び出しに費やす時間を短縮でき、結果として S3 の待機時間も減らせます。例については、このブログ記事を参照してください。
system.query_log を使用してください。
先ほどのクエリでは、max_threads を 16 に倍増すると (max_thread のデフォルト値はノード上のコア数です) 、メモリ消費は増えるものの、読み取りクエリの性能は 2 倍に向上します。さらに max_threads を増やしても、示されているとおり効果は逓減します。
- 挿入ブロックサイズを設定する値が大きいほど、ClickHouse が作成する必要のあるパーツは少なくなり、必要な ディスクファイル I/O と バックグラウンドマージ も少なくなります。
- 並列に実行する挿入スレッド数を多く設定するほど、データはより速く処理されます。
min_insert_block_size_rows を 0 に設定して (行数ベースのしきい値を無効化) 、max_insert_threads は選択した値に、min_insert_block_size_bytes は上記の式で計算した値に設定できます。
先ほどの Stack Overflow の例にこの式を当てはめると、次のようになります。
max_insert_threads=4(ノードあたり 8 コア)peak_memory_usage_in_bytes- 32 GiB (ノードリソースの 100%) または34359738368バイト。min_insert_block_size_bytes=34359738368/(3*4) = 2863311530
33% 以上向上しました。単一ノードのパフォーマンスをさらに向上できるかどうかは、読者の皆さん自身でお確かめください.
リソースとノードを使ったスケーリングは、読み取りクエリと 挿入 クエリの両方に適用されます。
これまでのチューニングとクエリでは、ClickHouse Cloud クラスター内の単一ノードしか使用していませんでした。一方で、実際には複数の ClickHouse ノードを利用できることもよくあります。初期段階では、まず垂直スケーリングを行うことを推奨します。これにより、S3 のスループットはコア数に応じてほぼ比例して向上します。先ほどの 挿入 クエリと読み取りクエリを、適切な設定のもとで、リソースを 2 倍 (64GiB、16 vCPU) に増やしたより大きな ClickHouse Cloud ノードで再実行すると、どちらもおおよそ 2 倍の速さで実行されます。
個々のノードでも、ネットワークや S3 GET リクエストがボトルネックとなり、スケールアップしても性能が比例して向上しない場合があります。
s3Cluster 関数を使用する必要があります。これにより、読み取りをノード間で分散できます。
最初に INSERT クエリを受信したサーバーは、まず glob パターン を展開し、その後、一致した各ファイルの処理を自身と他のサーバーに動的に振り分けます。
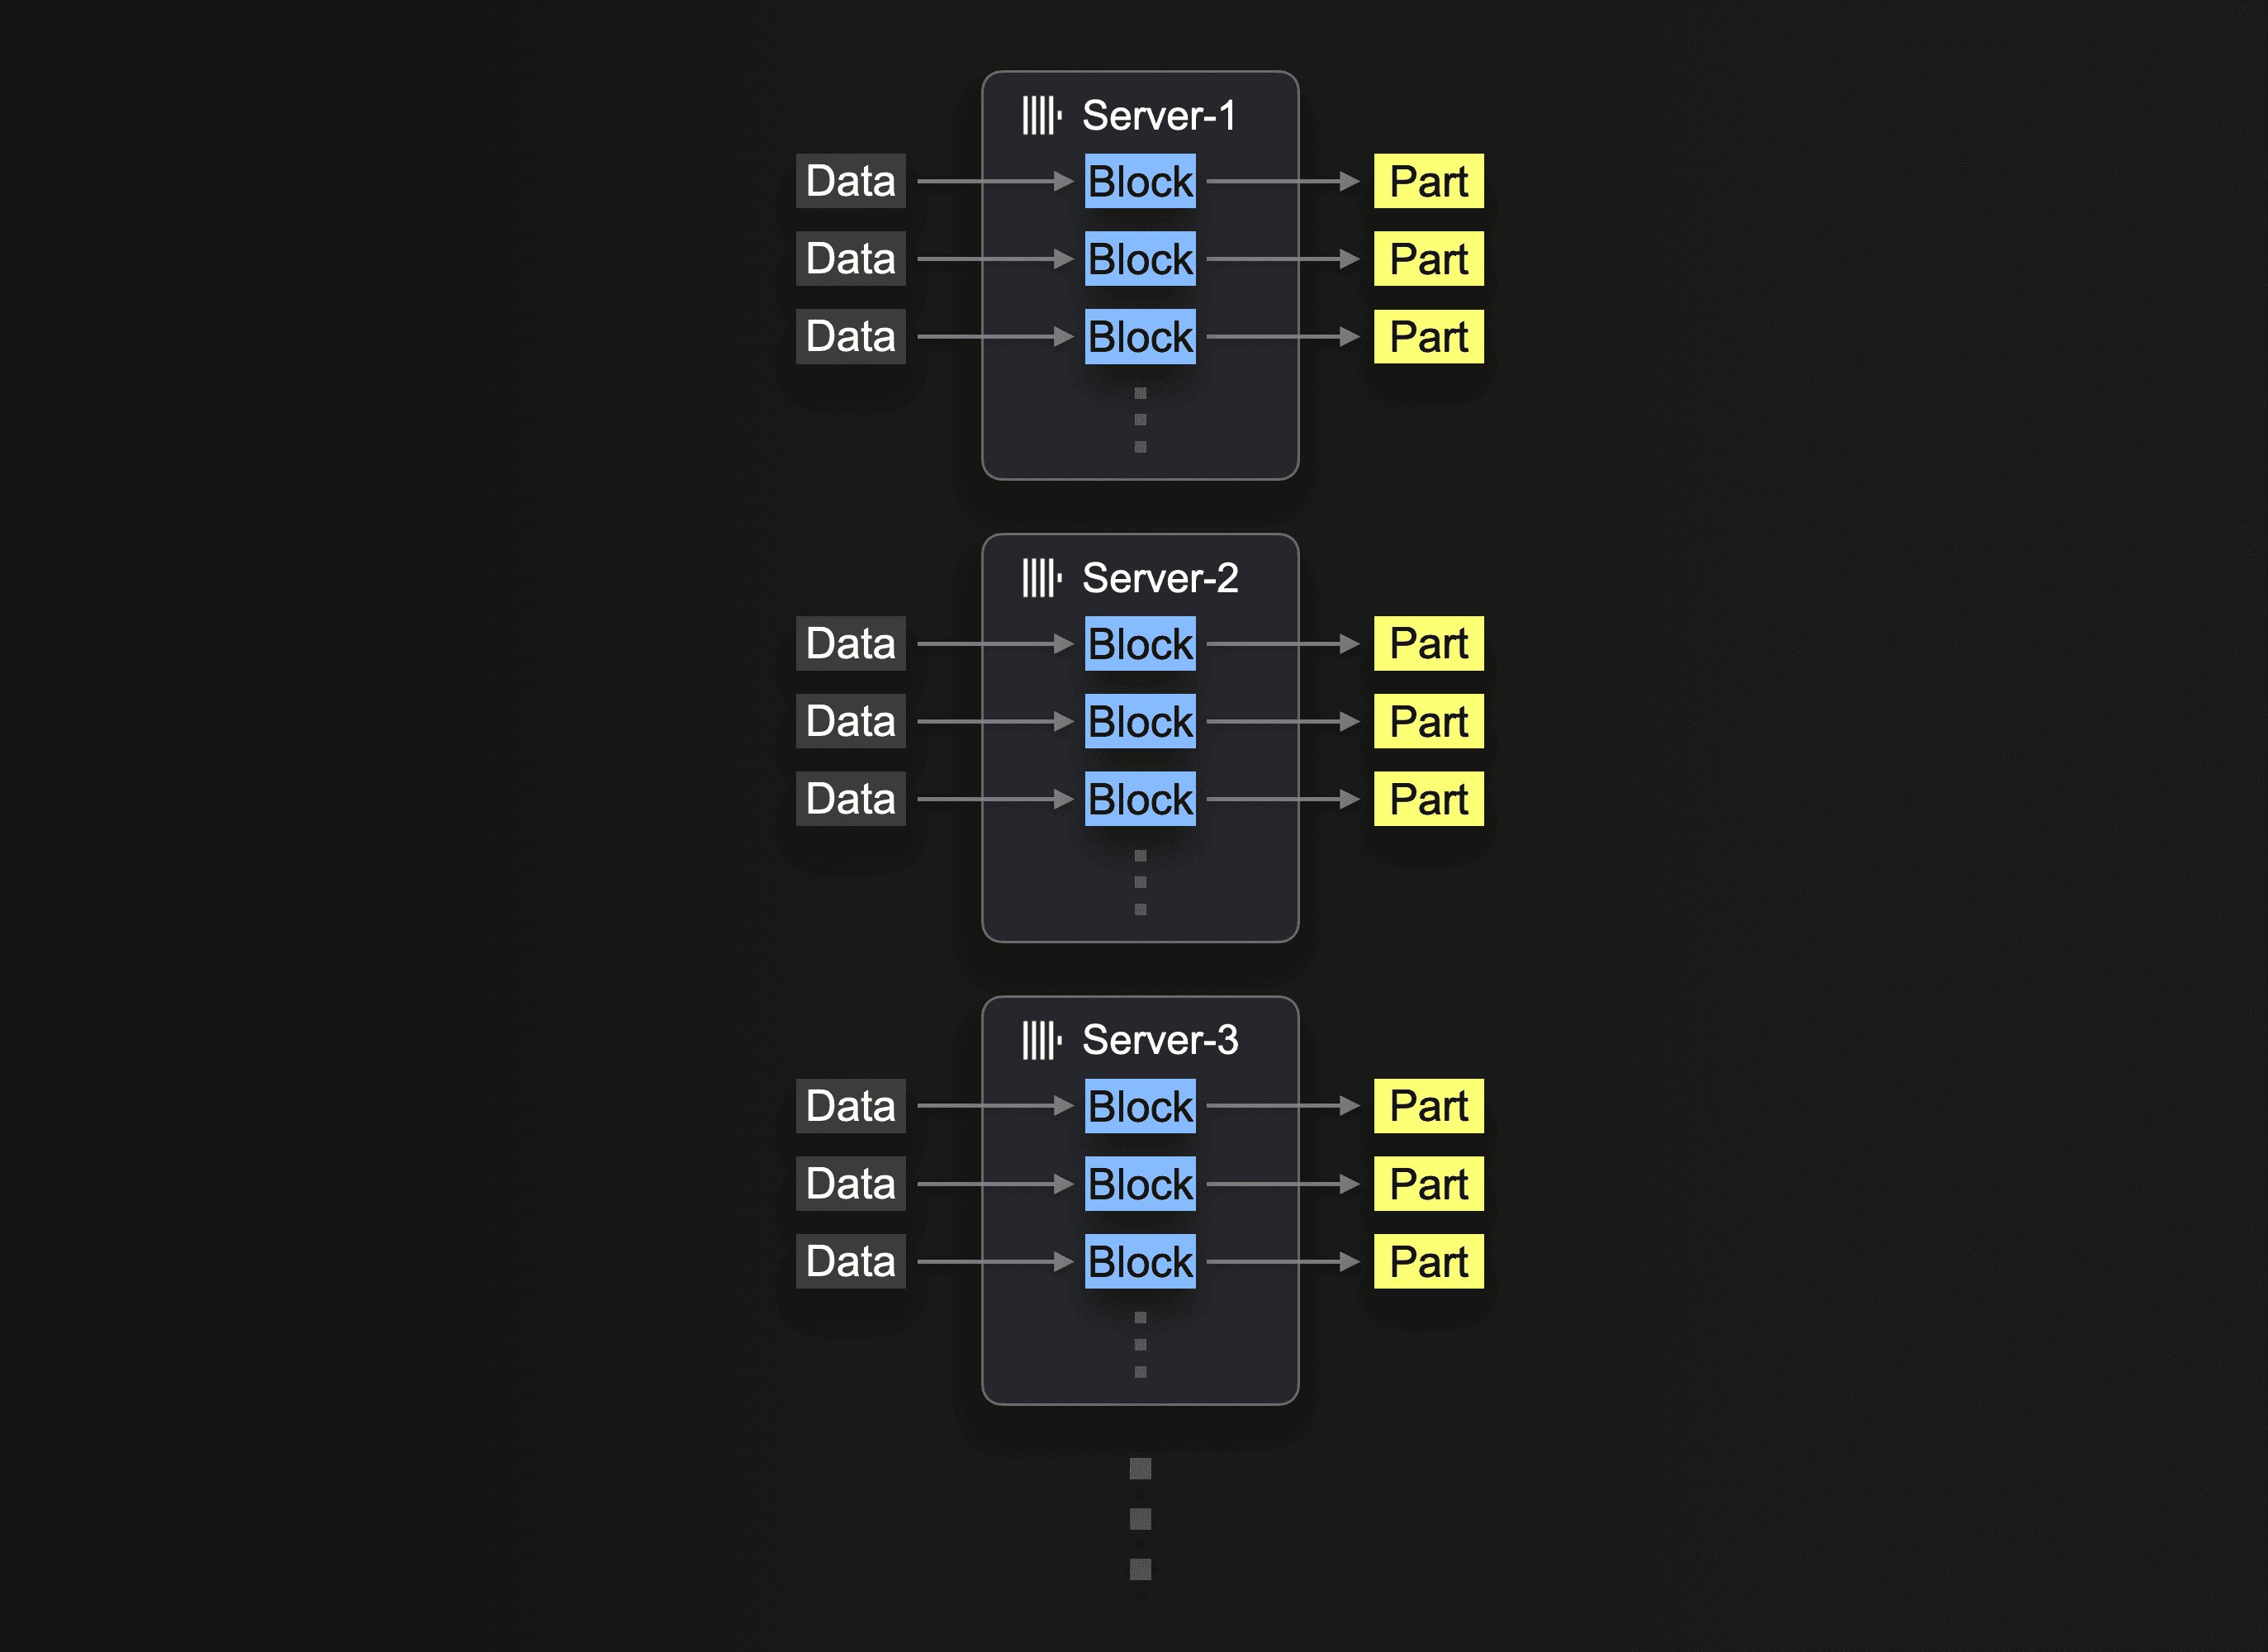
s3Cluster を使う形に調整します。ClickHouse Cloud では、default クラスターを参照することで、これは自動的に実行されます。
Utilizing Clusters で述べたとおり、この処理はファイル単位で分散されます。この機能の恩恵を受けるには、十分な数のファイル、つまり少なくともノード数を上回る数のファイルが必要です。
s3Cluster を使って分散されますが、挿入 はイニシエーター ノードに対して実行されます。つまり、読み取り自体は各ノードで実行されるものの、結果の行は分散のためにイニシエーターに送られます。高スループットのシナリオでは、これがボトルネックになる可能性があります。これに対処するには、s3cluster 関数のパラメータ parallel_distributed_insert_select を設定します。
これを parallel_distributed_insert_select=2 に設定すると、SELECT と INSERT は各ノード上の Distributed エンジンの基になるテーブルに対して、各分片で実行されます。
INSERT INTO SELECT を実行する場合には不要なこともあります。この機能を挿入時に無効にすることで、以下に示すようにパフォーマンスを向上できます。
optimize_on_insert 設定で、INSERT 処理中にデータパーツをマージするかどうかを制御します。有効な場合 (デフォルトでは optimize_on_insert = 1) 、小さなパーツは挿入時により大きなパーツへマージされるため、読み取る必要があるパーツ数が減り、クエリ性能が向上します。ただし、このマージによって INSERT 処理にオーバーヘッドが加わるため、高スループットでの挿入では速度が低下する可能性があります。
この設定を無効にすると (optimize_on_insert = 0) 、INSERT 時のマージはスキップされ、データをより高速に書き込めるようになります。特に、小規模な挿入が頻繁に発生する場合に効果的です。マージ処理はバックグラウンドに回されるため、挿入パフォーマンスは向上しますが、一時的に小さなパーツの数が増え、バックグラウンドマージが完了するまではクエリが遅くなる可能性があります。この設定は、挿入パフォーマンスを優先したい場合や、後からバックグラウンドのマージ処理で効率的に最適化できる場合に適しています。以下に示すように、この設定を無効にすると挿入スループットを向上できます。
- メモリが少ない環境で S3 に書き込む場合は、
max_insert_delayed_streams_for_parallel_writeを下げることを検討してください。