

- ソースとなる BigQuery テーブルが存在している必要があります。
- ClickHouse のターゲットテーブルが存在している必要があります。
- Dataflow のワーカーマシンから ClickHouse ホストにアクセスできる必要があります。
ClickHouseIO のすべてのパラメータのデフォルト値は、ClickHouseIO Apache Beam コネクタで確認できます。- Templateは、ClickHouse のターゲットテーブルに基づいてスキーマオブジェクトを構築します。
- Templateは BigQuery のデータセットを走査し、カラム名に基づいて一致を試みます。
BigQuery の型は、ClickHouse のテーブル定義に基づいて変換されます。したがって、上の表には、 (指定した BigQuery のテーブル/クエリに対して) ClickHouse のターゲットテーブルで推奨される型マッピングを示しています。
BigQuery から ClickHouse へのTemplateは、Google Cloud CLI 経由で実行できます。
このドキュメント、特に上記の各セクションを確認し、Templateの設定要件と前提条件を十分に理解しておいてください。
- Google Cloud Console
- Google Cloud CLI
Google Cloud Console にサインインし、DataFlow を検索します。
-
CREATE JOB FROM TEMPLATEボタンをクリックします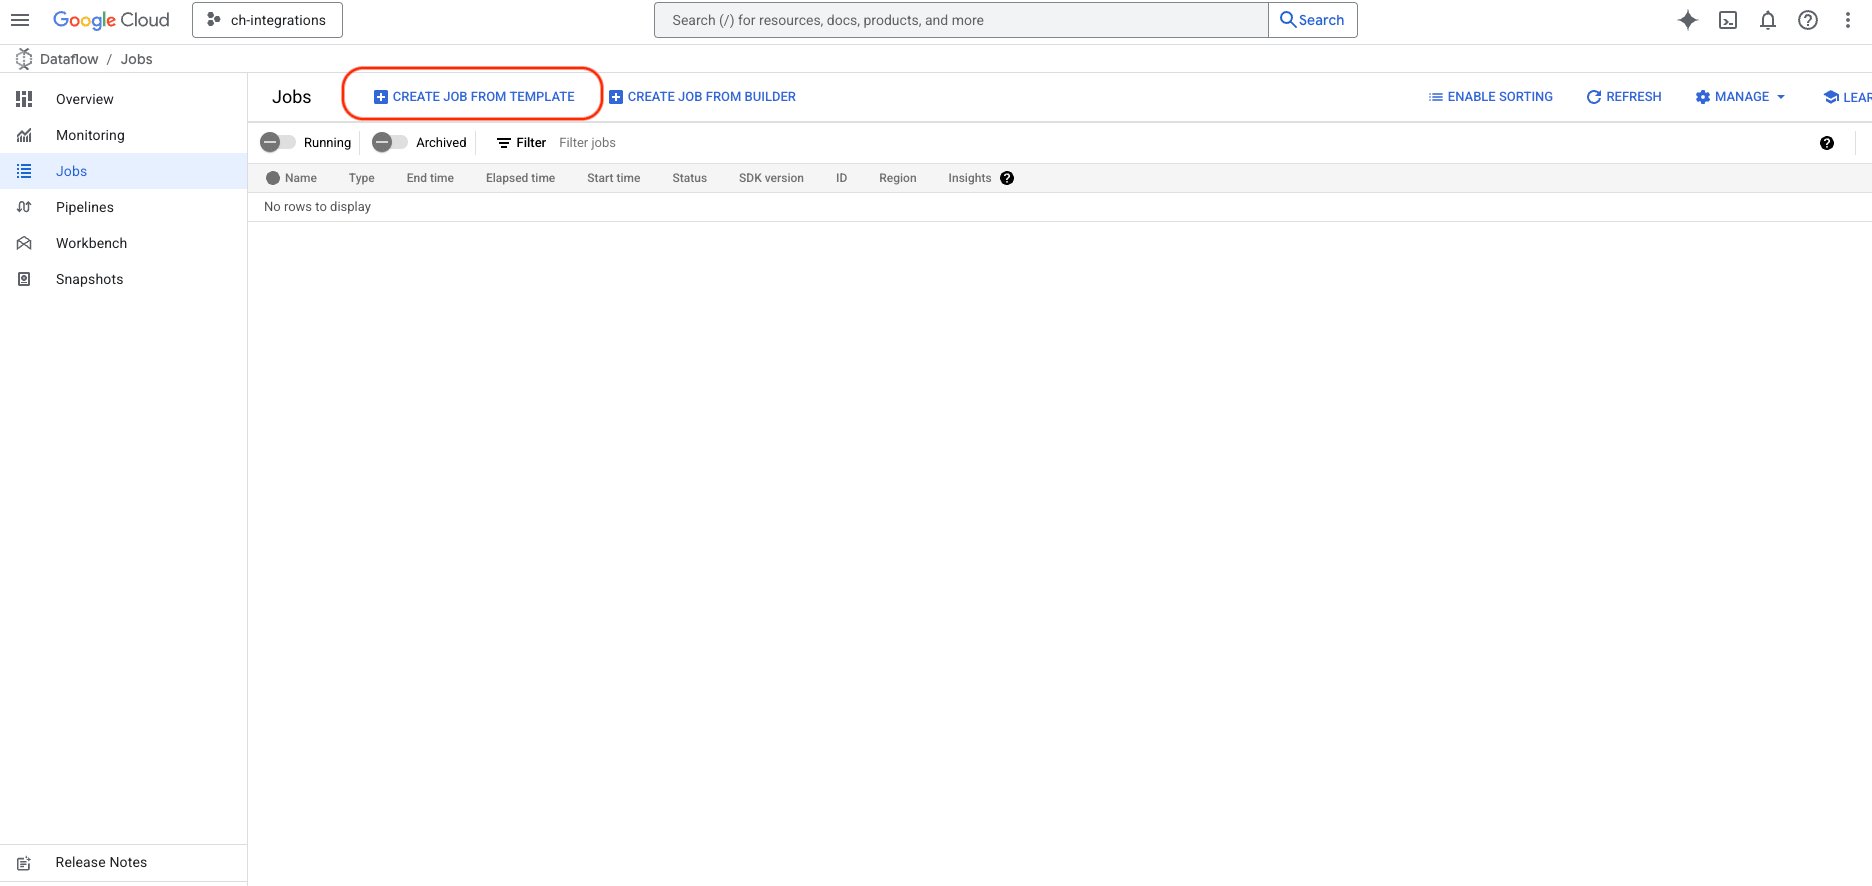
-
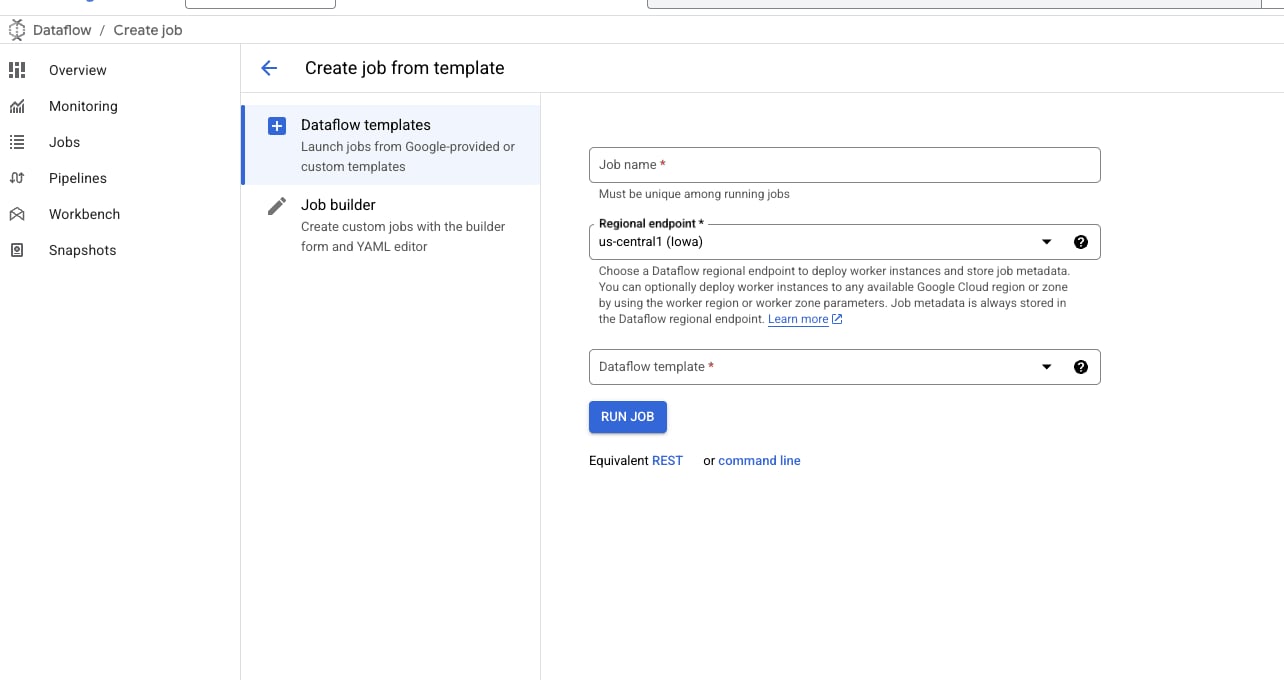
Templateフォームが開いたら、ジョブ名を入力し、目的のリージョンを選択します。
-
DataFlow Templateの入力欄にClickHouseまたはBigQueryと入力し、BigQuery to ClickHouseTemplateを選択します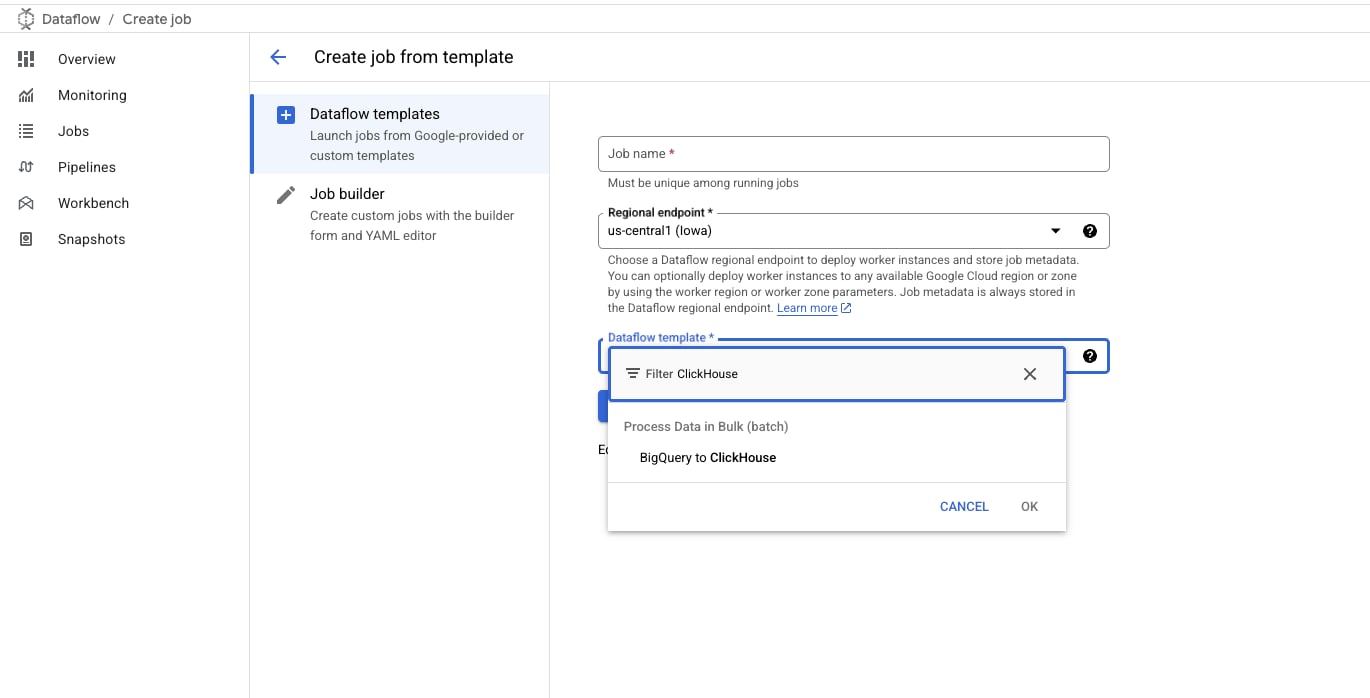
-
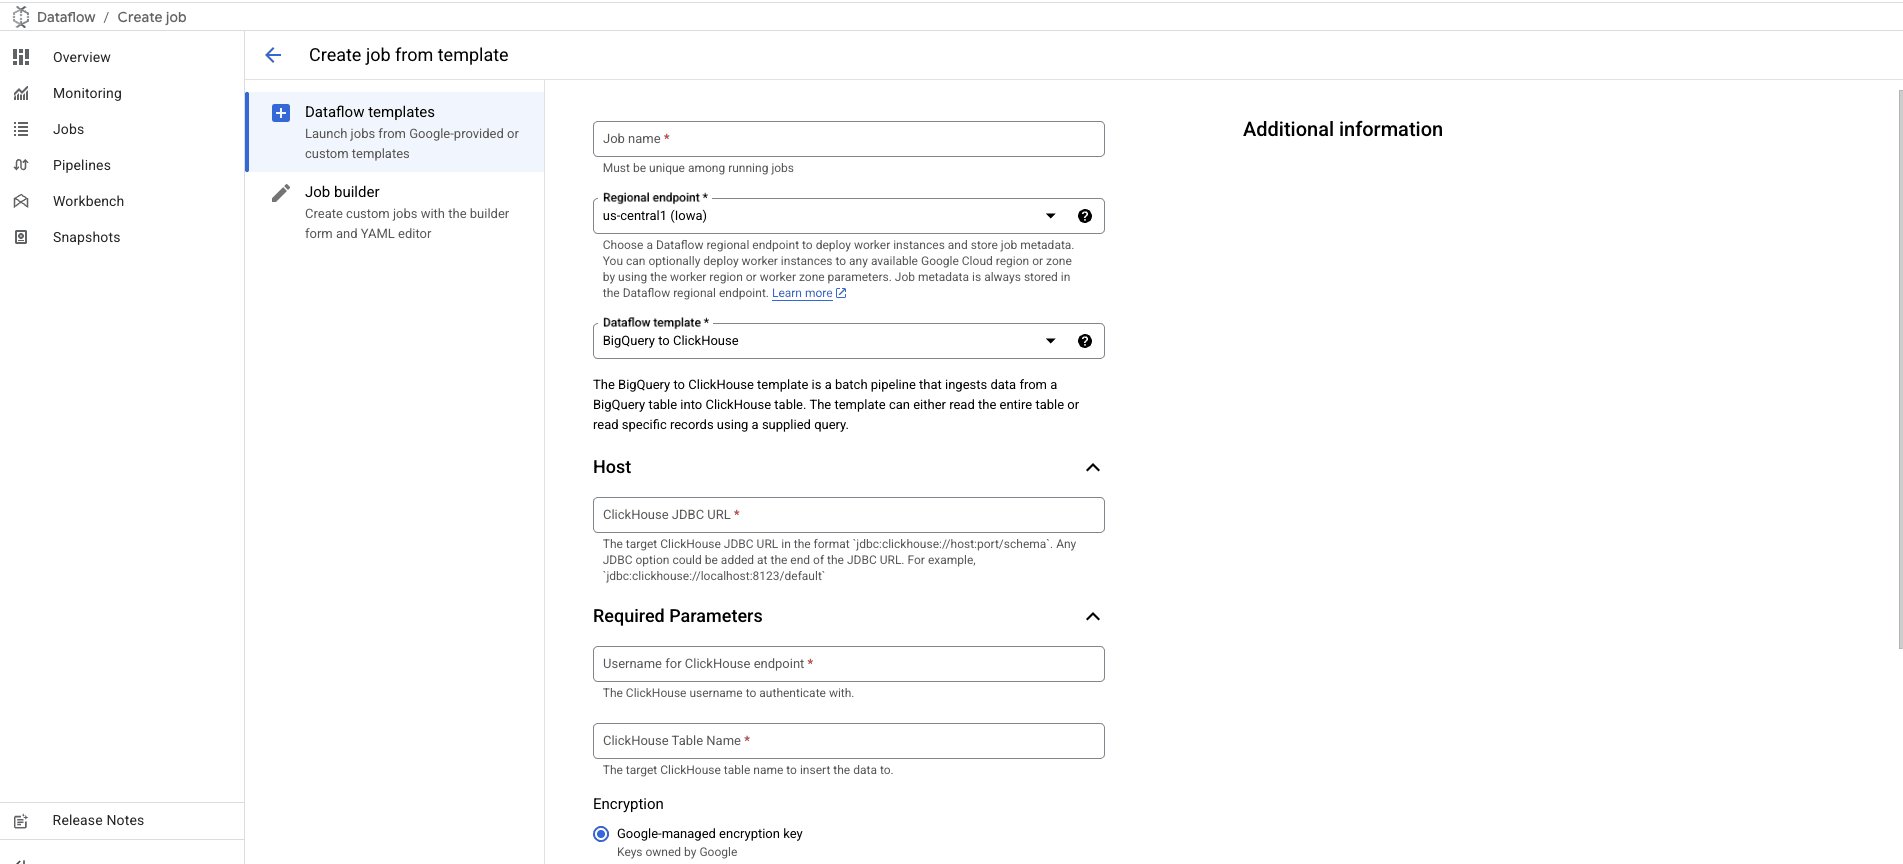
選択するとフォームが展開され、追加情報を入力できるようになります。
- 次の形式の ClickHouse server JDBC URL:
jdbc:clickhouse://host:port/schema - ClickHouse のユーザー名。
- ClickHouse のターゲットテーブル名。
- 次の形式の ClickHouse server JDBC URL:
ClickHouse のパスワードオプションは、パスワードが設定されていないユースケース向けに任意項目として表示されます。
追加するには、下にスクロールして
Password for ClickHouse Endpoint オプションを指定してください。- Template パラメータ セクションの説明に従って、 BigQuery/ClickHouseIO 関連の設定を必要に応じてカスタマイズして追加します
- インスタンスのリソースを増やす: より多くのメモリを搭載した大きなインスタンスに ClickHouse server をアップグレードし、データ処理の負荷に対応します。
- バッチサイズを小さくする: Dataflow ジョブの設定でバッチサイズを調整し、より小さな chunk のデータを ClickHouse に送信することで、バッチごとのメモリ消費を抑えます。これらの変更は、データのインジェスト時にリソース使用量のバランスを取るのに役立ちます。
GoogleCloudPlatform/DataflowTemplates— Google Cloud Platform のアップストリーム リポジトリ。ClickHouse/DataflowTemplates— ClickHouse のフォーク。