

_peerdb_version) を持つ行の insert として表現され、削除はより新しいバージョンを持ち、_peerdb_is_deleted が true に設定された行の insert として表現されます。ReplacingMergeTree エンジンはバックグラウンドでデータの重複排除とマージを行い、指定された主キー (id) ごとに最新バージョンの行を保持することで、UPDATE と DELETE をバージョン付き insert として効率的に処理できます。
以下は、ClickPipes が ClickHouse にテーブルを作成する際に実行する CREATE TABLE ステートメントの例です。
users を同期する基本的な例を示しています。
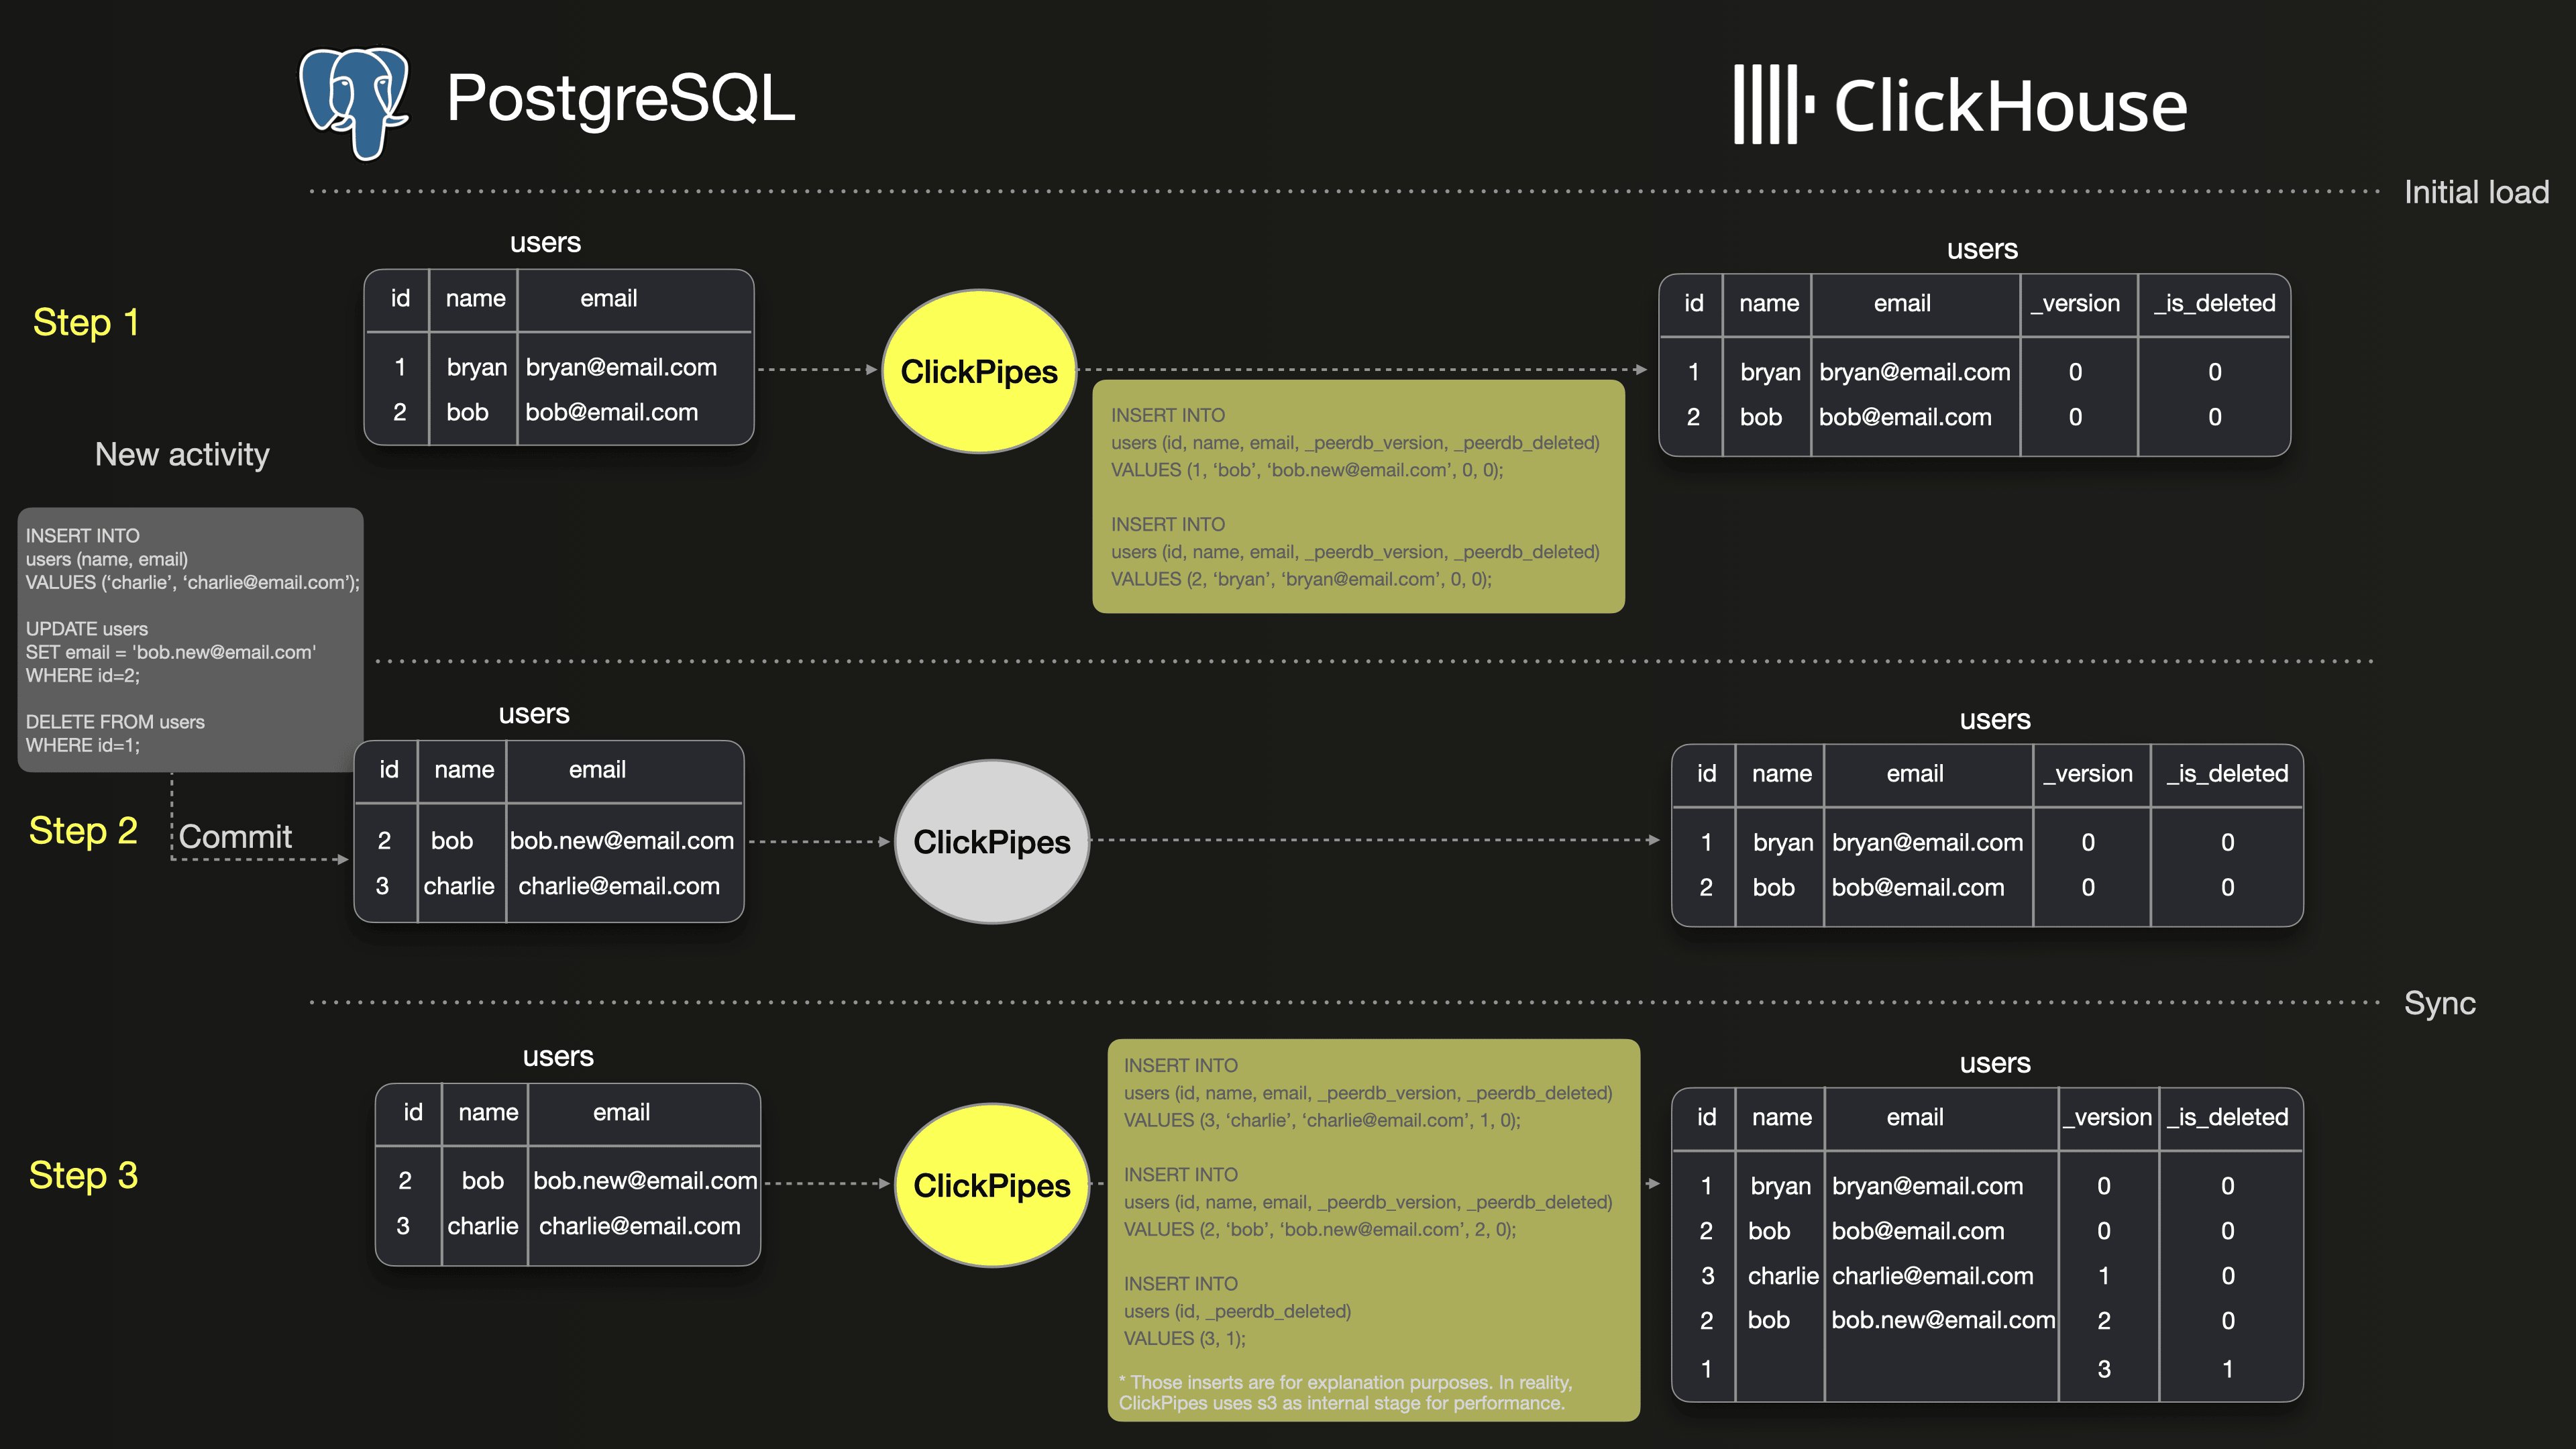
_is_deleted が true に設定された ID 1 の新しいバージョンとして現れます。このため、ClickHouse には PostgreSQL より 3 行多く存在することになります。
その結果、SELECT count(*) FROM users; のような単純なクエリを実行すると、ClickHouse と PostgreSQL で異なる結果になる場合があります。ClickHouse のマージに関するドキュメント によると、古い行バージョンは最終的にマージ処理の中で破棄されます。ただし、このマージがいつ行われるかは予測できないため、それまでは ClickHouse のクエリが一貫しない結果を返す可能性があります。
ClickHouse と PostgreSQL の両方で同一のクエリ結果を確実に得るには、どうすればよいでしょうか?
ClickHouseのクエリでデータを重複排除する推奨方法は、FINAL修飾子 を使用することです。これにより、重複排除後の行だけが返されます。
これを3種類のクエリにどう適用するかを見ていきましょう。
以下のクエリでは、削除された行を除外するためのWHERE句に注目してください。
- シンプルな件数カウントクエリ: posts の数をカウントします。
- JOIN を使った単純な集計: 最も多くの閲覧数を獲得しているユーザー上位 10 人。
_peerdb_is_deleted = 0 フィルタを隠す簡単な方法は、ROW POLICY. を使用することです。以下は、テーブル votes に対するすべてのクエリから削除済みの行を除外する ROW POLICY を作成する例です。
ROW POLICY は、ユーザーとロールの一覧に対して適用されます。この例では、すべてのユーザーとロールに適用されます。必要に応じて、特定のユーザーまたはロールのみに適用するよう調整できます。分析用データセットを PostgreSQL から ClickHouse に移行する場合、データの扱いやクエリ実行の違いを考慮して、アプリケーションのクエリを修正する必要が生じることが少なくありません。 このセクションでは、元のクエリを変更せずにデータを重複排除する手法を紹介します。 ビュー は、データを保存せず、アクセスのたびに別のテーブルから読み取るだけなので、クエリから FINAL キーワードを隠すのに便利です。 以下は、ClickHouse でデータベース内の各テーブルに対し、FINAL キーワードと削除済みの行を除外するフィルタを含むビューを作成する例です。
deduplicated_posts を通常どおりクエリできます。