

- クエリのパフォーマンスを向上させる。特に
JOINと組み合わせて使用する場合 - インジェスト処理を遅くすることなく、取り込みデータをその場でエンリッチする
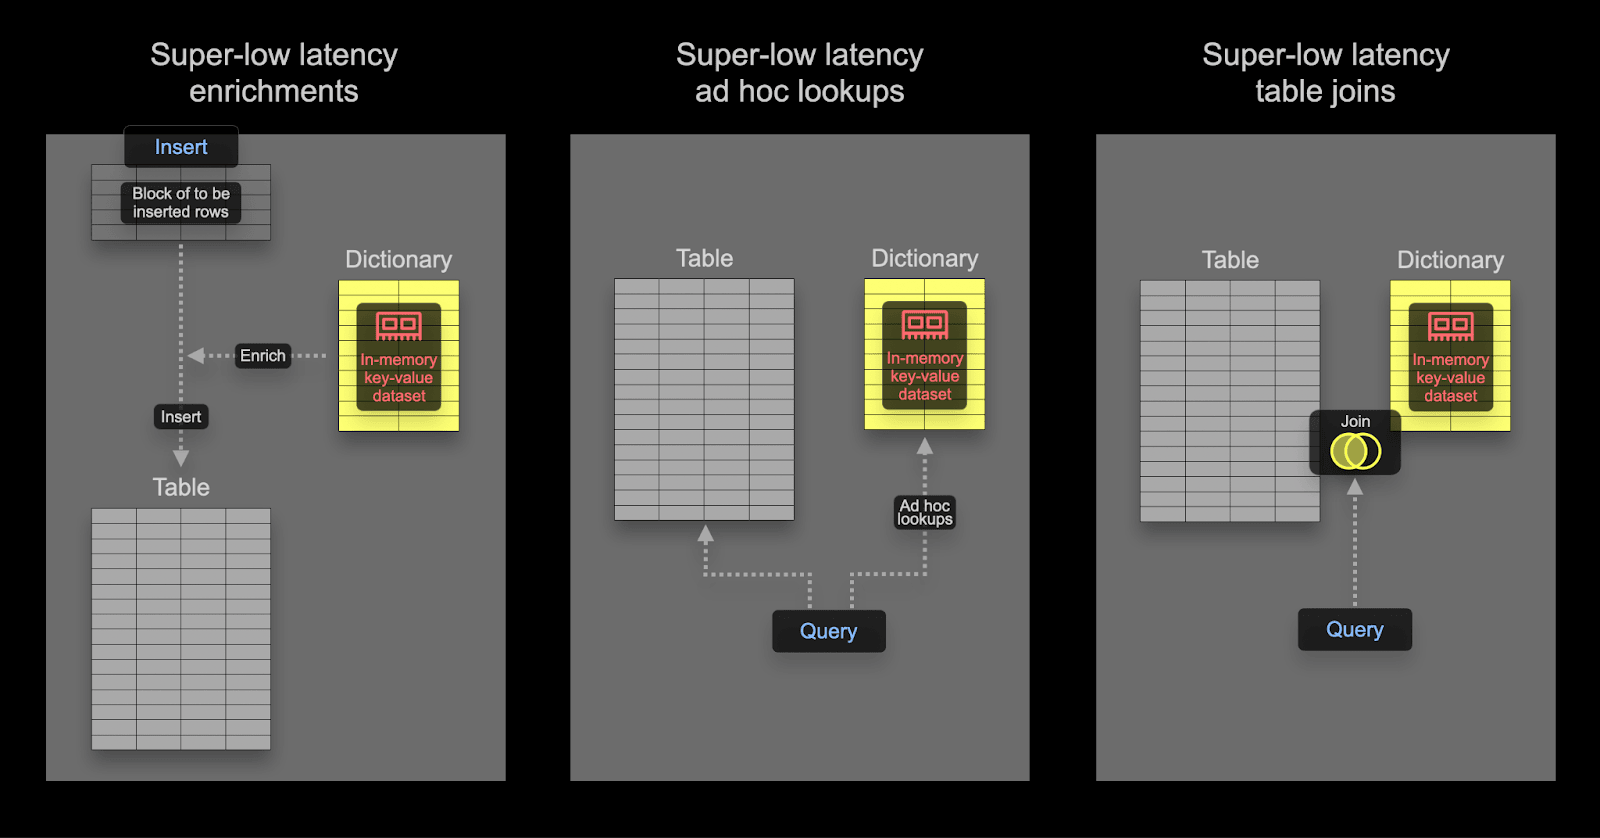
Dictionary を使用した JOIN の高速化
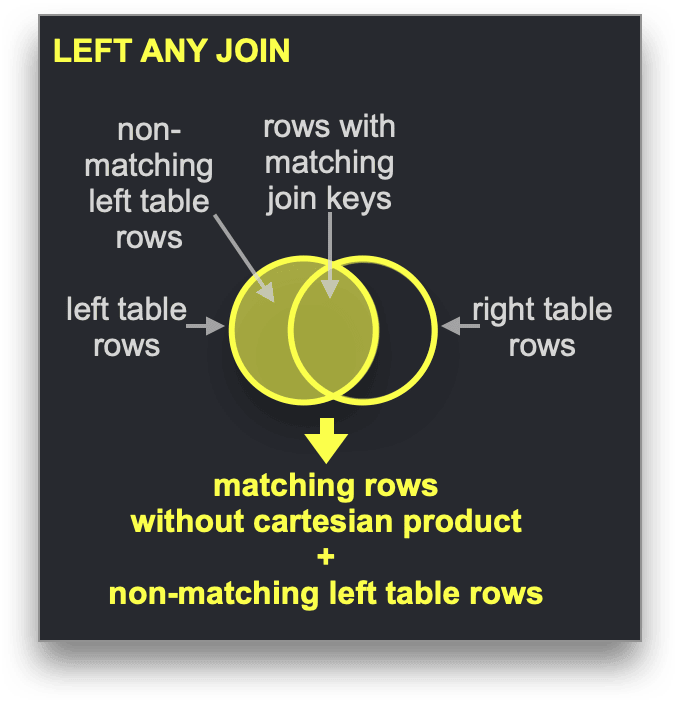
Dictionary は、特定の種類のJOIN を高速化するために使用できます。具体的には、結合キーが基盤となるキー・バリュー ストレージのキー属性と一致している必要がある LEFT ANY 型 です。
posts テーブルと votes テーブルを使った JOIN を必要とします。
このクエリは高速ですが、高いパフォーマンスを得るには、JOINの右側には、より小さいデータセットを使用してください: このクエリは、PostIdによる絞り込みを外側のクエリとサブクエリの両方で行っているため、必要以上に冗長に見えるかもしれません。これは、クエリの応答時間を高速に保つためのパフォーマンス最適化です。最適なパフォーマンスを得るには、JOINの右側が常により小さい集合であり、できるだけ小さくなるようにしてください。JOIN のパフォーマンスを最適化するためのヒントや、利用可能なアルゴリズムを理解するには、このブログ記事シリーズを参照することをお勧めします。
JOIN を注意深く記述する必要があります。理想的には、まず投稿のうち “SQL” を含むものだけに絞り込み、そのうえで、その投稿の部分集合について UpVote と DownVote の件数を確認し、メトリクスを計算できるのが望ましいです。
これらの概念を説明するために、投票データに Dictionary を使用します。Dictionary は通常メモリ上に保持されるため (例外は ssd_cache です) 、データサイズを意識する必要があります。まず、votes テーブルのサイズを確認します。
以下の例では、Dictionary の元データは ClickHouse テーブルです。これは Dictionary で最も一般的なデータソースですが、さまざまなソース がサポートされており、ファイル、HTTP、Postgres などのデータベースも利用できます。後で示すように、Dictionary は自動的に更新できるため、頻繁に変更される小規模なデータセットを direct joins で使える状態に保つのに最適です。この Dictionary では、ルックアップを行うための主キーが必要です。これは概念的にはトランザクションデータベースの主キーと同じで、一意である必要があります。上記のクエリでは、結合キー
PostId に対するルックアップが必要です。したがって、Dictionary には votes テーブルから PostId ごとの賛成票と反対票の合計を格納する必要があります。この Dictionary 用のデータを取得するクエリは次のとおりです。
セルフマネージドの OSS では、上記のコマンドをすべてのノードで実行する必要があります。ClickHouse Cloud では、Dictionary は自動的にすべてのノードへレプリケートされます。上記の処理は RAM 64GB の ClickHouse Cloud ノードで実行しており、読み込みには 36 秒かかりました。Dictionary が消費しているメモリを確認するには:
PostIdに対する賛成票と反対票は、シンプルなdictGet関数で取得できるようになりました。以下では、投稿11227902の票数を取得します。
controversial の値だけを保存するようにすれば、さらに最適化できます。
Dictionariesを使用すると、クエリ時に値を参照できます。これらの値は結果として返したり、集計に使用したりできます。たとえば、ユーザーIDを所在地に対応付けるDictionaryを作成するとします。
インデックス時のエンリッチメント
上の例では、クエリ時に Dictionary を使って 結合 を不要にしました。Dictionary は、挿入 時に行をエンリッチするためにも使用できます。これは通常、エンリッチメントに使う値が変化せず、かつ Dictionary の投入元として使える外部ソースに存在する場合に適しています。この場合、挿入 時に行をエンリッチしておけば、クエリ時に Dictionary へのルックアップを行う必要がなくなります。レイテンシの予測可能性やソースの可用性が重要な場合は、挿入 時のエンリッチメントに cache ベースの Dictionary レイアウトを使用しないでください。各サーバーはそれぞれ独立したローカルキャッシュを保持しており、再起動や置き換えが発生するとキャッシュは空になります。その結果、挿入処理はコールドキャッシュ状態での Dictionary ソースへのルックアップに依存することになります。ClickHouse Cloud では、オートスケーリングやマネージドなノードの置き換えによって、こうした状況がより発生しやすくなります。各サーバー上に Dictionary 全体を読み込むレイアウトを選択してください。詳しくは インジェスト経路における cache Dictionary を参照してください。
Location は変わらないと仮定しましょう (実際には変わります) 。具体的には、users テーブルの Location カラムです。location ごとに posts テーブルを分析するクエリを実行したいとします。このテーブルには UserId が含まれています。
Dictionary は、users テーブルを基に、ユーザー ID から location へのマッピングを提供します。
posts テーブルでこのDictionaryをデータ挿入時に利用するには、スキーマを変更する必要があります。Id < 0のユーザーは除外します。これにより、HashedDictionary 型を使用できます。Id < 0のユーザーはシステムユーザーです。
Location は MATERIALIZED カラムとして宣言されています。これは、値を INSERT クエリの一部として指定でき、その場合でも常に計算されることを意味します。
ClickHouse は DEFAULT カラム もサポートしています (この場合、値は挿入することも、指定されていない場合は計算させることもできます) 。
テーブルにデータを投入するには、通常どおり S3 からの INSERT INTO SELECT を使用できます:
MIN 600 MAX 900 の LIFETIME を指定しました。LIFETIME はDictionaryの更新間隔で、ここでの値を指定すると、600〜900 秒のランダムな間隔で定期的に再読み込みされます。このランダムな間隔は、多数のサーバーで更新する際に Dictionary ソースへの負荷を分散するために必要です。更新中もDictionaryの古いバージョンに対して引き続きクエリを実行できますが、クエリがブロックされるのは初期ロード時だけです。なお、(LIFETIME(0)) を設定するとDictionaryは更新されなくなります。
Dictionary は SYSTEM RELOAD DICTIONARY コマンドを使って強制的に再読み込みできます。
ClickHouse や Postgres などのデータベースソースでは、一定間隔で更新する代わりに、Dictionary が実際に変更された場合にのみ更新するクエリを設定できます (これを判定するのはそのクエリの応答です) 。詳しくは こちら を参照してください。
ClickHouse は、Hierarchical、Polygon、Regular Expression の Dictionary にも対応しています。
参考資料
- Dictionaryのベストプラクティス — レイアウトの選択、DictionaryとJOINの比較、監視
- Dictionaryを使ってクエリを高速化する
- Dictionaryの高度な設定