

JOIN 句リファレンスを参照してください。実行アルゴリズムとその選択方法については、テーブルの結合を参照してください。
JOINはできるだけ避ける
ClickHouse は多種多様な JOINの種類とアルゴリズムをサポートしています。ただし、JOIN は本質的に、単一の非正規化されたテーブルに対するクエリよりもコストが高くなります。非正規化では、計算処理をクエリ実行時から INSERT 時または前処理時に移すため、実行時のレイテンシを大幅に低減できることがよくあります。リアルタイム処理やレイテンシに敏感な分析クエリでは、非正規化を強く推奨します。 一般に、次のような場合は非正規化を検討してください。- テーブルの更新頻度が低い、またはバッチ更新を許容できる。
- 関係が多対多ではなく、カーディナリティも極端に高くない。
- クエリされるカラムが一部に限られており、つまり特定のカラムは非正規化の対象から外せる。
- Flink のような上流システムに処理を移し、リアルタイムの enrichment やフラット化を管理できる体制がある。
JOIN が必要な場合
JOIN のパフォーマンスを向上させるには、以下のベストプラクティスに従ってください。- 一致が 1 件あれば十分な場合は
ANYJOIN を使用します。 通常の JOIN は一致するすべての行を返すため、キーが重複しているとデカルト積が生じる可能性があります。1 件の一致で十分な場合は、LEFT ANY JOINまたはANY INNER JOINを使用して、結果のサイズとメモリ使用量を削減してください。 - JOIN の前に両側のデータを絞り込みます。
WHERE句およびJOIN ON句で選択性の高い条件を適用してください。ClickHouse は可能な限りフィルタをプッシュダウンしますが、明示的にサブクエリを使用すれば、JOIN の前に各入力を確実にフィルタできます。 INNER JOINの代わりにINを検討します。 相手テーブルにキーが存在するかどうかを確認するだけでよいクエリでは、INサブクエリを使うとその意図を直接表現でき、INNER JOINの結果を生成するよりもメモリ使用量を抑えられる場合があります。- 繰り返し使用するルックアップには
Joinテーブルエンジンを使用します。Joinテーブルエンジンは、宣言された JOINの種類、strictness、キーに基づいて、事前計算済みのインメモリ構造を保持します。ClickHouse Cloud では、MergeTreeをバックエンドテーブルとするSharedJoinとして実装されており、Join(ANY, LEFT, key)を使うとキー単位で更新可能なルックアップを実現できます。詳細は Fast, updatable lookups with the Join table engine を参照してください。 - 可能であればテーブルの sorting key で結合します。 両方のテーブルが 結合キーで物理的にソートされている場合、
full_sorting_mergeはソート処理を省略でき、メモリ使用量を削減できます。実行計画を確認したうえで、代表的なデータを用いてこのアルゴリズムとデフォルトのアルゴリズムをベンチマークで比較してください。 - ディスクへのスピルが発生する JOIN は避けます。 JOIN の中間状態をディスクにスピルすればクエリをメモリ制限内に収められますが、通常はディスク I/O によってレイテンシが増加します。ハッシュ結合は設定されたスピル threshold に達すると grace hash に切り替えることができ、マージ結合は外部ソートを使用できます。スピルに頼る前に、入力の行数やカラム数を減らす、あるいはデータモデルを見直すといった対策を検討してください。詳細は 最適な JOIN アルゴリズムの選択 を参照してください。
- 必要に応じてデフォルト値を不一致のマーカーとして利用します。 デフォルトの
join_use_nulls = 0では、外部 JOIN で一致しなかったカラムはそのデータ型のデフォルト値で埋められるため、Nullableでラップされずに済みます。一致しなかった行と、デフォルト値を含む一致した行をクエリで区別する必要がある場合にのみ、join_use_nullsを有効化してください。
最適な JOIN アルゴリズムの選択
ClickHouse は、速度とメモリのトレードオフが異なる複数の JOIN アルゴリズムをサポートしています。join_algorithm のデフォルト値は direct,parallel_hash,hash,ie_join で、ClickHouse は JOIN の種類、strictness、条件、テーブルエンジンに対して適用可能な最初のアルゴリズムを選択します。この設定の変更を検討するのは、両方の入力を削減したうえで、代表的なデータでの計測により別のメモリ戦略または実行戦略が必要だと判明した場合に限ってください。アルゴリズムの実行の詳細とサポートされる JOIN の種類については、JOIN アルゴリズムの選択を参照してください。
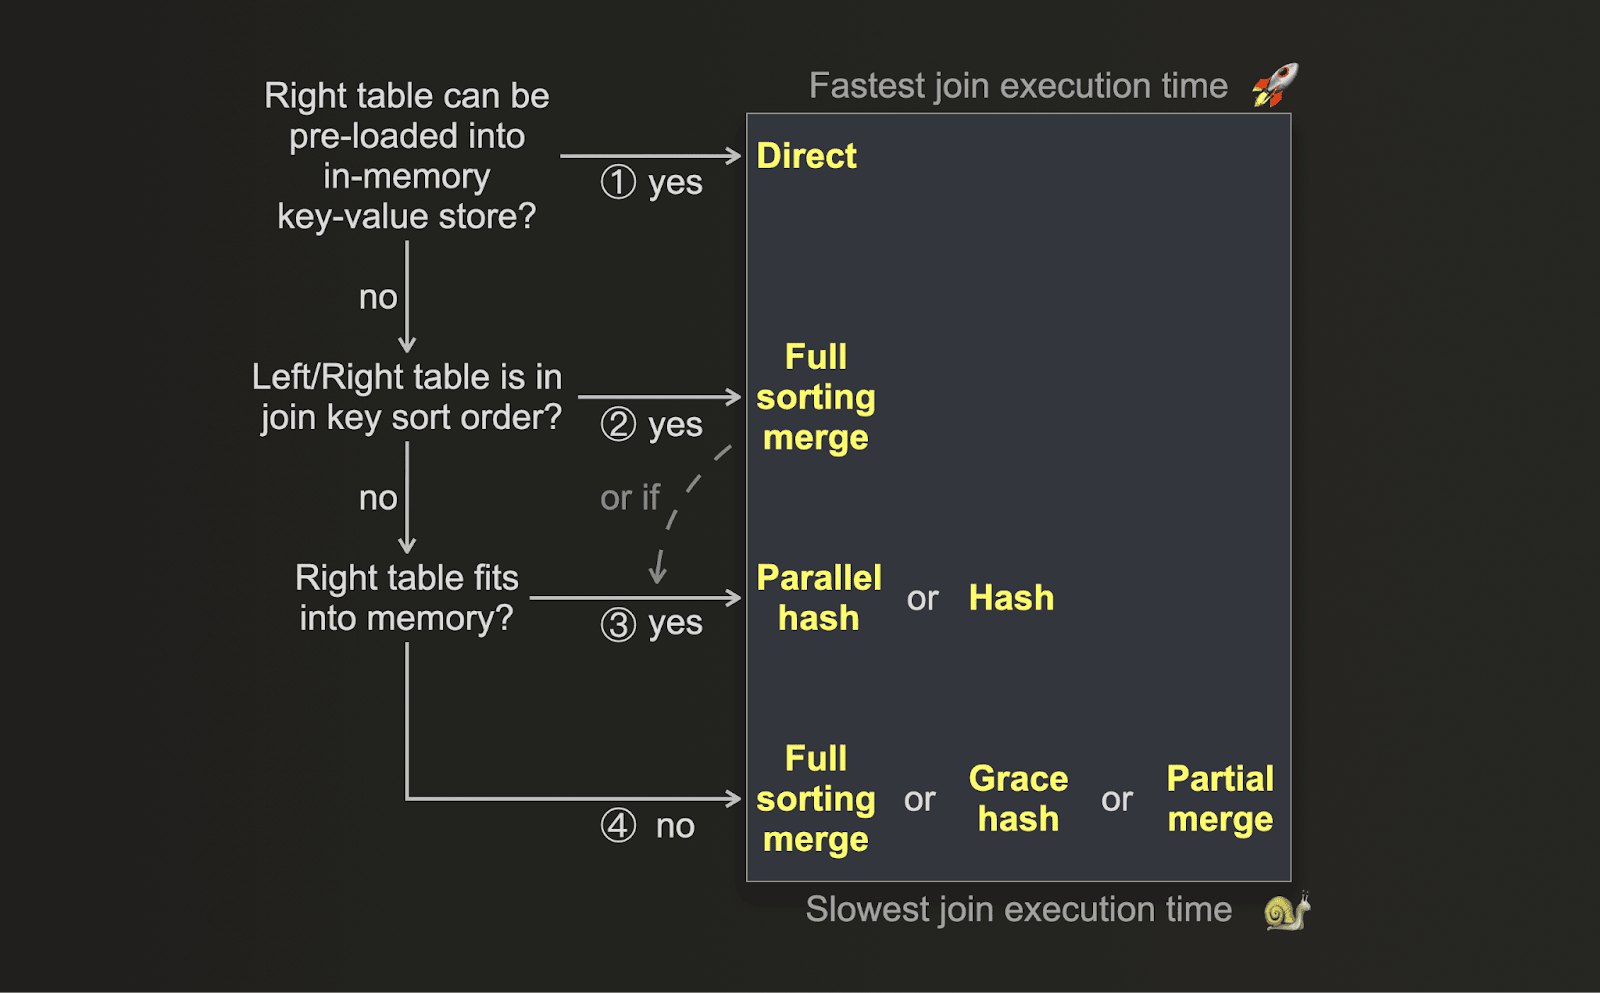
最適化で最も重視する指標がパフォーマンスであり、結合をできるだけ高速に実行したい場合は、次の決定木を使って適切な結合アルゴリズムを選択できます。
-
(1) 右側テーブルのデータを Dictionary などの低レイテンシなインメモリのキー・バリューデータ構造に事前ロードでき、結合キーが基盤となるキー・バリューストレージのキー属性と一致し、かつ
LEFT ANY JOINのセマンティクスで十分な場合は、direct join を適用できます。多くの場合、これが最も高速な方法です。 - (2) テーブルの物理的な行の順序が結合キーのソート順と一致する場合は、状況次第です。この場合、完全ソートマージ結合 はソートフェーズをスキップするため、メモリ使用量が大幅に削減されます。さらに、データサイズや結合キーの値の分布によっては、一部のハッシュ結合アルゴリズムより実行時間が短くなります。
- (3) 並列ハッシュ結合 の追加のメモリ使用量のオーバーヘッドを考慮しても右テーブルがメモリに収まる場合は、このアルゴリズムまたはハッシュ結合の方が高速になる可能性があります。どちらが速いかは、データサイズ、データ型、および結合キーカラムの値の分布によって決まります。
-
(4) 右テーブルがメモリに収まらない場合、ハッシュ結合 と 並列ハッシュ結合 は、
max_bytes_before_external_joinまたはmax_bytes_ratio_before_external_joinに達した時点で grace hash に切り替え、ディスクへスピルできます。完全ソートマージ結合 と 部分マージ結合 も外部ストレージを使用できます。どの方法が最も高速かは、データ量、データ型、および結合キーカラムの値の分布によって決まります。
grace_hash_join_initial_buckets 設定は初期バケット数を制御するもので、メモリ使用量と結合速度のバランスを調整できます。
3 つのディスクベースのアルゴリズムのうちどれが最も高速かは、データ量、データ型、および結合キーカラムの値の分布によって決まります。最速のアルゴリズムを見極めるには、実運用に近いデータ量でベンチマークを実施するのが最善です。
メモリ最適化
結合の最適化において、実行時間の短さよりもメモリ使用量の少なさを優先したい場合は、代わりに次の決定木を利用できます。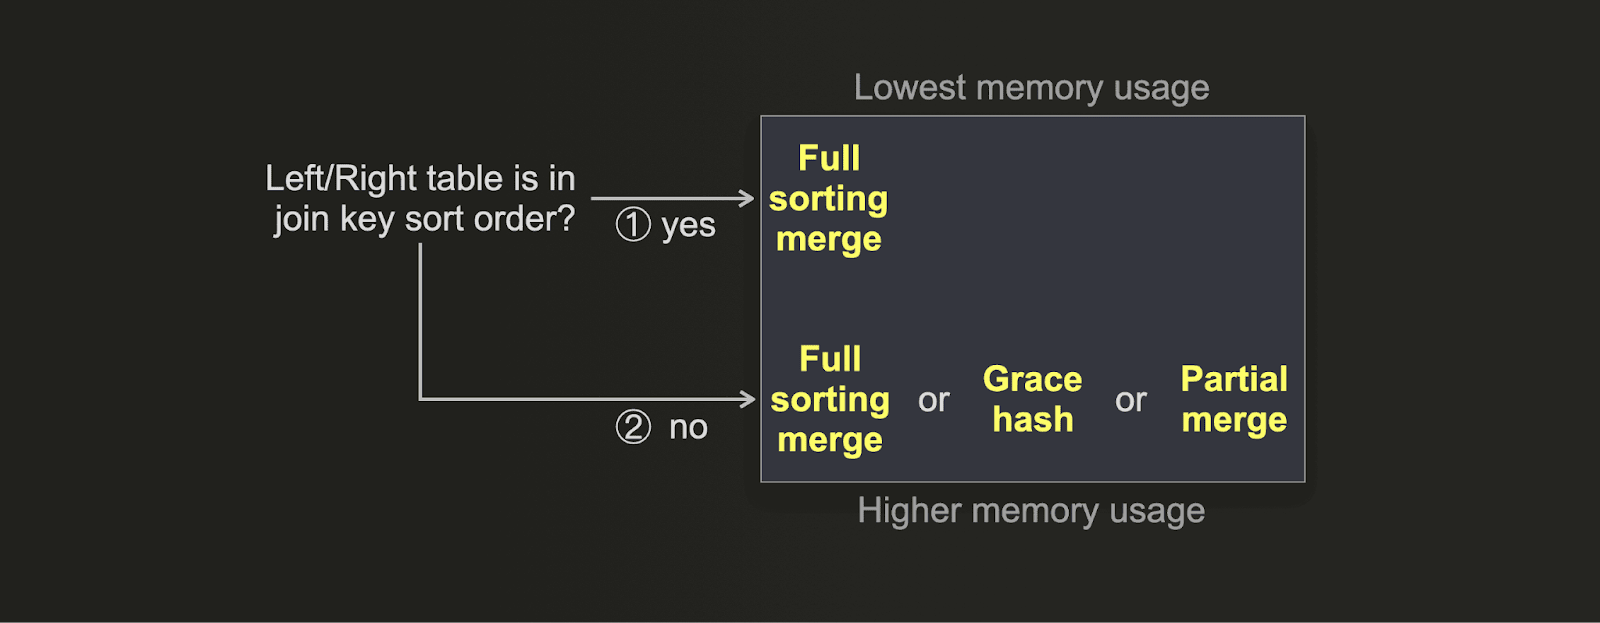
- (1) テーブルの物理的な行順序が結合キーのソート順と一致している場合、完全ソートマージ結合のメモリ使用量は最小限に抑えられます。さらに、ソートフェーズが無効化されるため、良好な結合速度も得られます。
- (2) Grace Hash Joinは、
grace_hash_join_initial_bucketsを増やすことで、結合速度と引き換えにメモリ使用量を非常に低く抑えるようチューニングできます。部分マージ結合は、主記憶の使用量が少なくなるよう意図的に設計されています。外部ソートを有効にした完全ソートマージ結合は、行順序がキーのソート順と一致しない場合、一般に部分マージ結合よりも多くのメモリを使用しますが、その代わりに結合の実行時間は大幅に短縮されます。ハッシュ結合および並列ハッシュ結合も、設定済みのスピル threshold に達した時点で grace hash に切り替えることで、メモリ逼迫を軽減できます。
JOIN の最適化の例
以下の例では Stack Overflow データセット を使用し、推奨事項を段階的に適用していきます。 以下の測定値は、ClickHouse 26.8.1 が稼働する ClickHouse Cloud サービス上でmax_threads = 4 を設定し、5 回実行した結果の中央値です。各クエリは事前に 1 回ウォームアップし、クエリの実行順序を交互に入れ替えたうえで、use_query_cache と use_query_condition_cache を無効化して計測しています。
ANY INNER JOIN を IN に置き換える
このテストでは、IN を使用したクエリのほうが 2.7 倍高速で、ピークメモリ使用量も 83% 少なくなりました。
このクエリは、本文では ClickHouse に言及していないものの、ClickHouse に言及しているコメントが少なくとも 1 件ある投稿の数をカウントします。
86 を返します。経過時間の中央値は 27.101 秒、ピークメモリ使用量は 970.01 MiB でした。読み取ったデータは 1億5,020万行、51.77 GiB です。
このクエリでは、一致するコメントが存在するかどうかさえわかれば十分です。IN サブクエリを使用すれば、JOIN結果を生成せずに済みます。
IN クエリも 86 を返します。経過時間の中央値は 10.206 秒、ピークメモリ使用量は 162.81 MiB でした。読み取ったデータは 1 億 7,420 万行、19.02 GiB です。
JOIN を置き換える前に両側をフィルタする
このテストでは、書き換えによって経過時間の中央値が 18%、ピークメモリ使用量が 14% 削減されました。 このクエリは、2020 年以降に作成された Java 関連の投稿に対する賛成票の数を集計します。日付の条件は、JOIN の前に両方の入力に適用されています。261915 を返します。経過時間の中央値は 0.850 秒、ピークメモリ使用量は 59.96 MiB でした。読み取った行数は 8,094 万行、データ量は 1.13 GiB です。
各投票について必要なのは一致する投稿が存在するかどうかだけなので、両方の入力に対するフィルタを維持したまま、JOIN を IN に置換できます。
IN クエリも 261915 を返します。経過時間の中央値は 0.696 秒、ピークメモリ使用量は 51.70 MiB でした。読み取ったのは 4,620 万行、817.49 MiB のデータです。